Trong quá trình triển khai AI tại doanh nghiệp, các ứng dụng của RAG (Retrieval-Augmented Generation) đang trở thành kiến trúc tiêu chuẩn để giải quyết bài toán tin cậy. Thay vì để mô hình ngôn ngữ lớn (LLM) tự suy diễn dựa trên dữ liệu cũ, RAG kết nối thực tế với kho tri thức sống của tổ chức.
RAG biến AI từ một mô hình xác suất thành một cộng sự tra cứu chính xác theo thời gian thực, giúp doanh nghiệp khai thác dữ liệu độc quyền mà không cần tốn kém chi phí huấn luyện lại.
Về bản chất, cách tiếp cận này triệt tiêu rủi ro ảo giác (hallucination) – trạng thái mô hình tự tin đưa ra thông tin sai lệch để lấp đầy khoảng trống kiến thức. Đối với kỹ sư giải pháp, RAG vừa nâng cao độ chính xác vừa tối ưu bài toán kinh tế khi đưa AI vào sản phẩm thực tế.
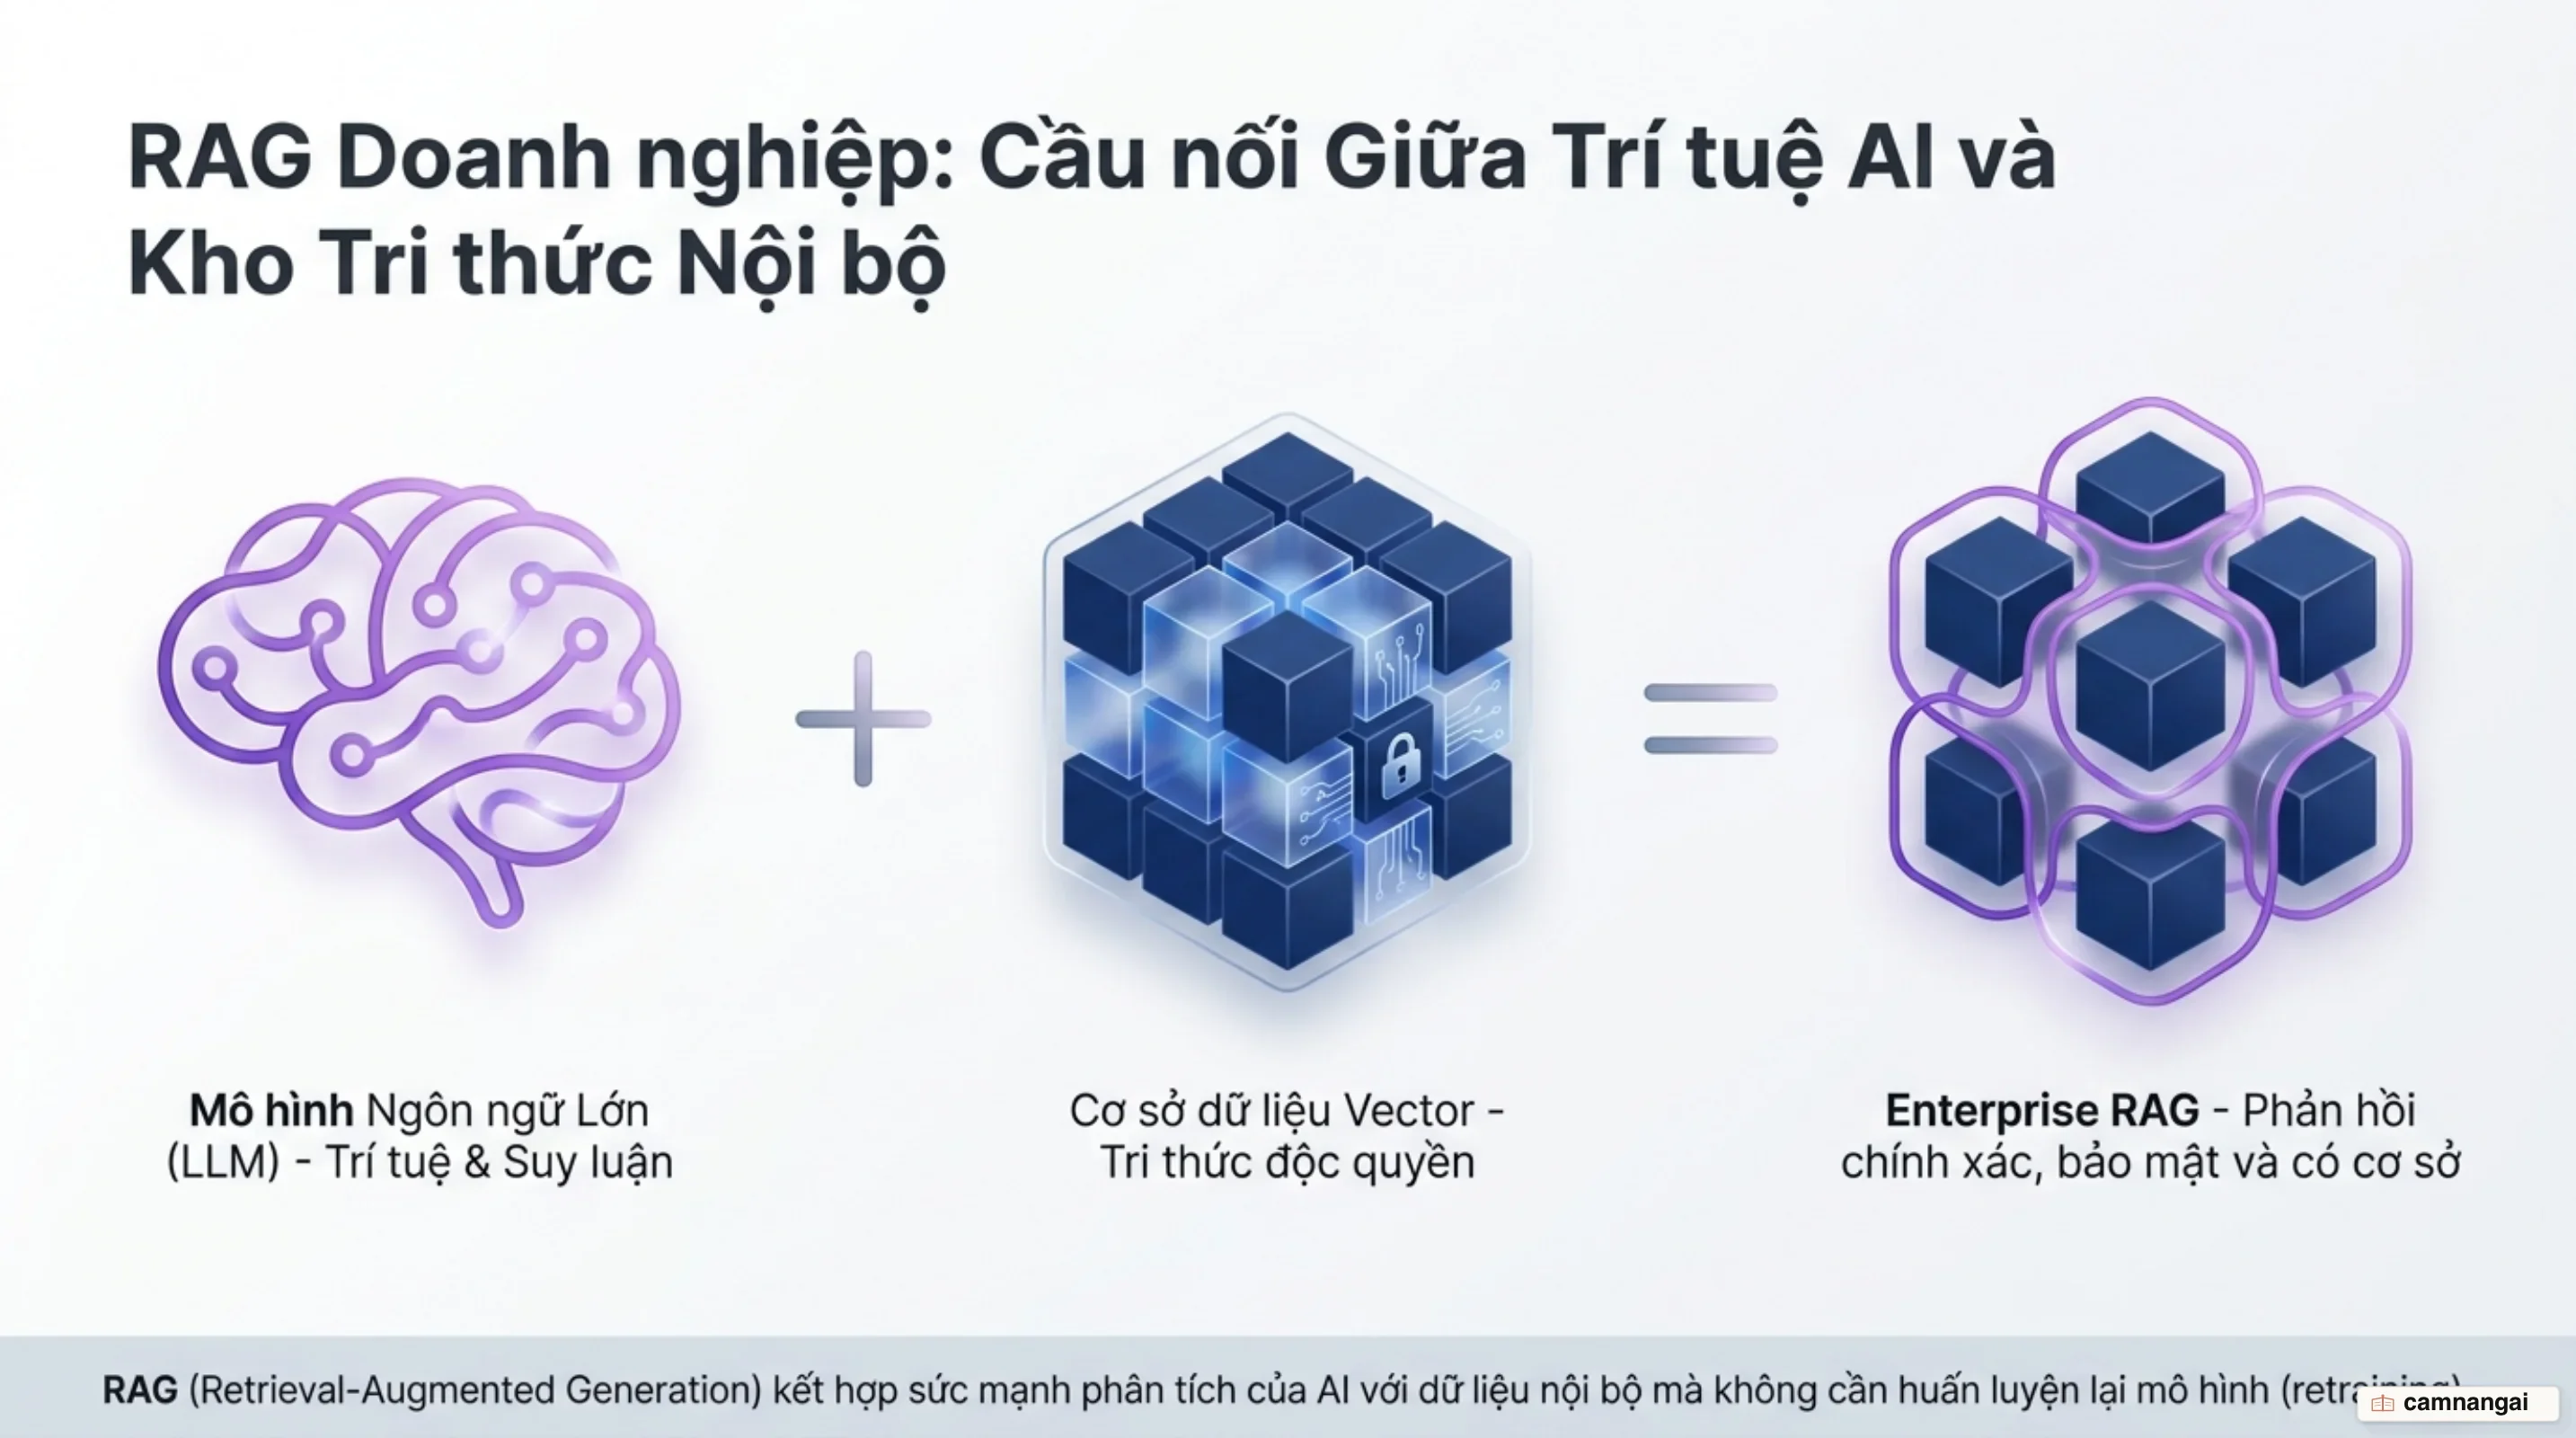
Vì sao doanh nghiệp cần RAG thay vì chỉ dựa vào LLM?
Dưới góc độ kỹ thuật, các mô hình nền tảng dù mạnh mẽ vẫn vấp phải ba rào cản cốt lõi khi bước vào môi trường doanh nghiệp:
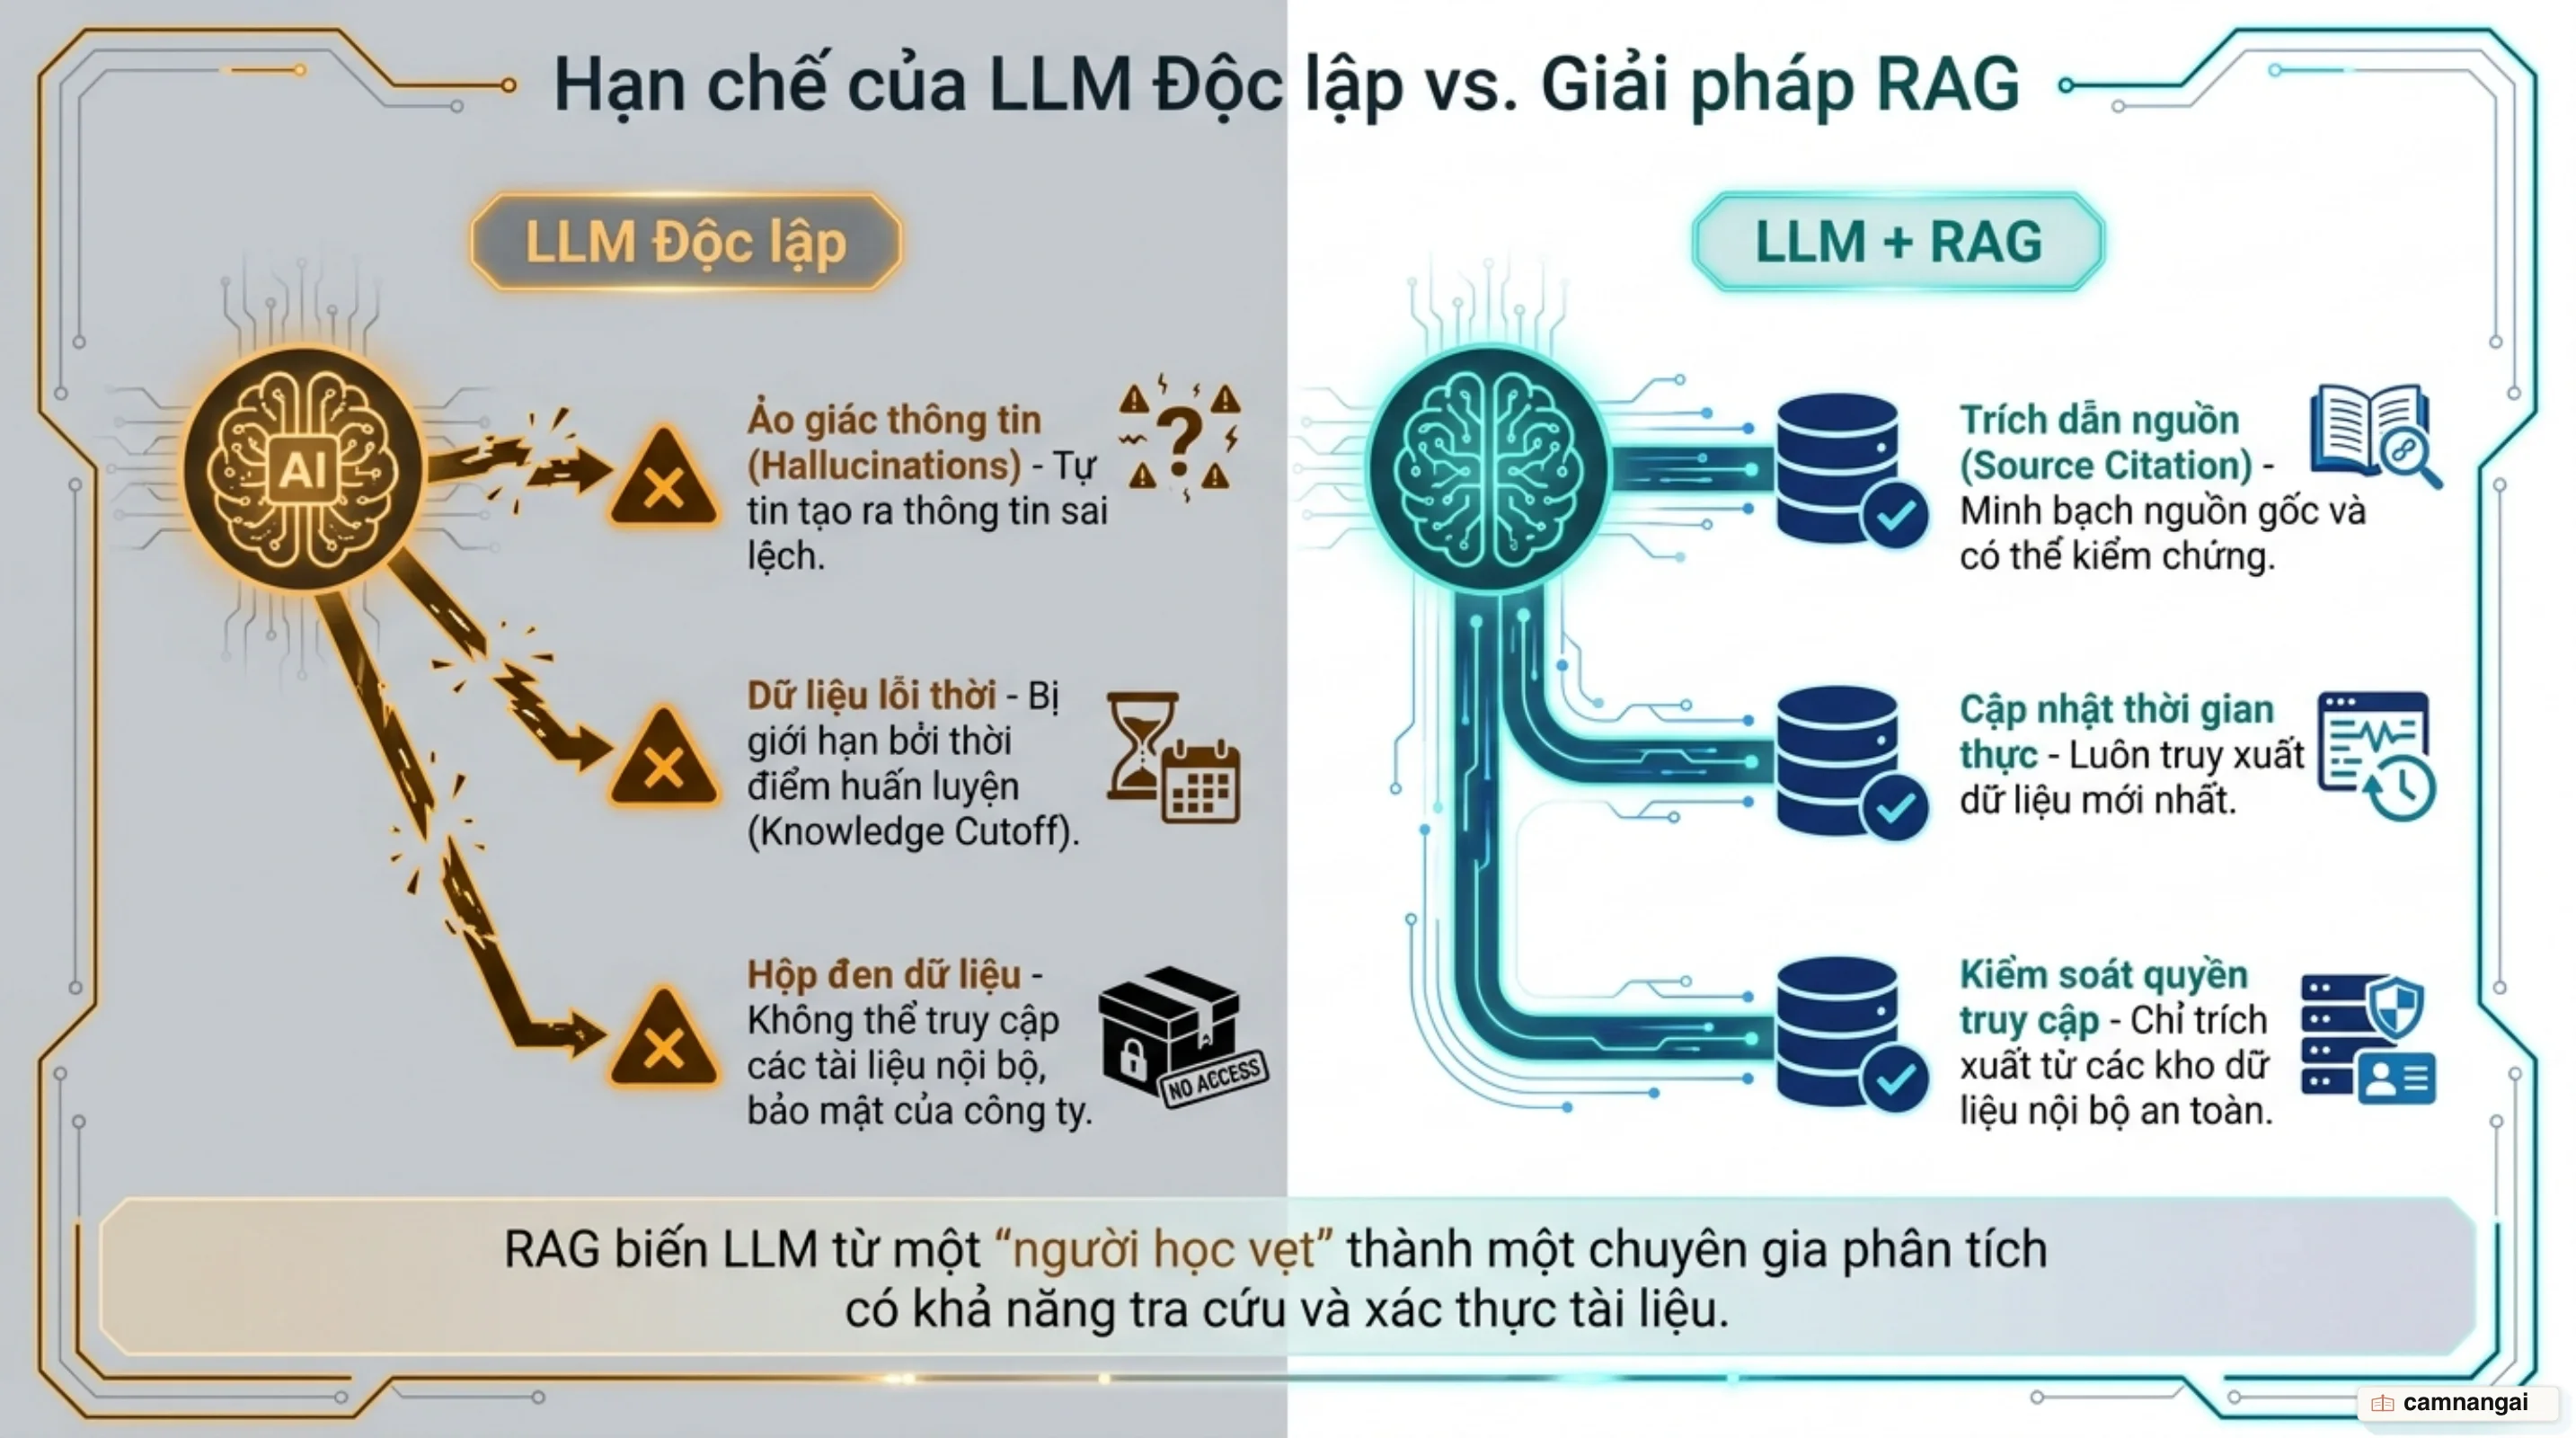
- Điểm dừng kiến thức (Knowledge cutoff): LLM bị giới hạn bởi thời điểm đóng băng dữ liệu huấn luyện. Nếu bạn hỏi về một chính sách nhân sự mới cập nhật sáng nay, mô hình sẽ không có câu trả lời hoặc tự suy đoán sai lệch.
- Thiếu hụt dữ liệu độc quyền: Bí mật kinh doanh, quy trình vận hành và email nội bộ là dữ liệu đóng mà LLM công cộng không bao giờ tiếp cận được.
- Xu hướng ảo giác (Hallucination): Khi gặp các truy vấn chuyên sâu vượt quá bộ nhớ tĩnh, LLM dự đoán xác suất từ tiếp theo mà không có căn cứ thực tế.
Nhiều doanh nghiệp cân nhắc giữa RAG hay fine-tuning. Tuy nhiên, RAG mang lại lợi thế vượt trội về cả kỹ thuật lẫn vận hành:
- Kiểm soát dữ liệu: Doanh nghiệp hoàn toàn làm chủ nguồn tin AI được phép truy cập theo từng cấp độ bảo mật.
- Khả năng trích dẫn (Citation): RAG dẫn chiếu trực tiếp nguồn tài liệu gốc, giúp người dùng kiểm chứng thông tin và xây dựng lòng tin.
- Tính kinh tế của suy luận: Việc gửi toàn bộ tài liệu vào prompt sẽ làm phình to cửa sổ ngữ cảnh, kéo theo chi phí token và độ trễ tăng cao. RAG giải quyết điểm nghẽn này bằng cách chỉ trích xuất những đoạn văn bản thực sự liên quan.
- Bảo mật: Dữ liệu nhạy cảm lưu trữ trong hạ tầng riêng, chỉ chuyển vào mô hình dưới dạng ngữ cảnh tạm thời tại thời điểm truy vấn.
1. Tìm kiếm tri thức nội bộ và trợ lý kỹ thuật
Ứng dụng trực diện nhất của RAG là quản trị kho tài liệu khổng lồ của doanh nghiệp. Hệ thống kết nối với wiki nội bộ, kho tài liệu kỹ thuật và quy trình vận hành để biến chúng thành một công cụ truy vấn thông minh. Nhân viên không còn phải lục tìm thủ công trong hàng nghìn thư mục; họ chỉ cần đặt câu hỏi và nhận về câu trả lời có kèm nguồn xác thực.
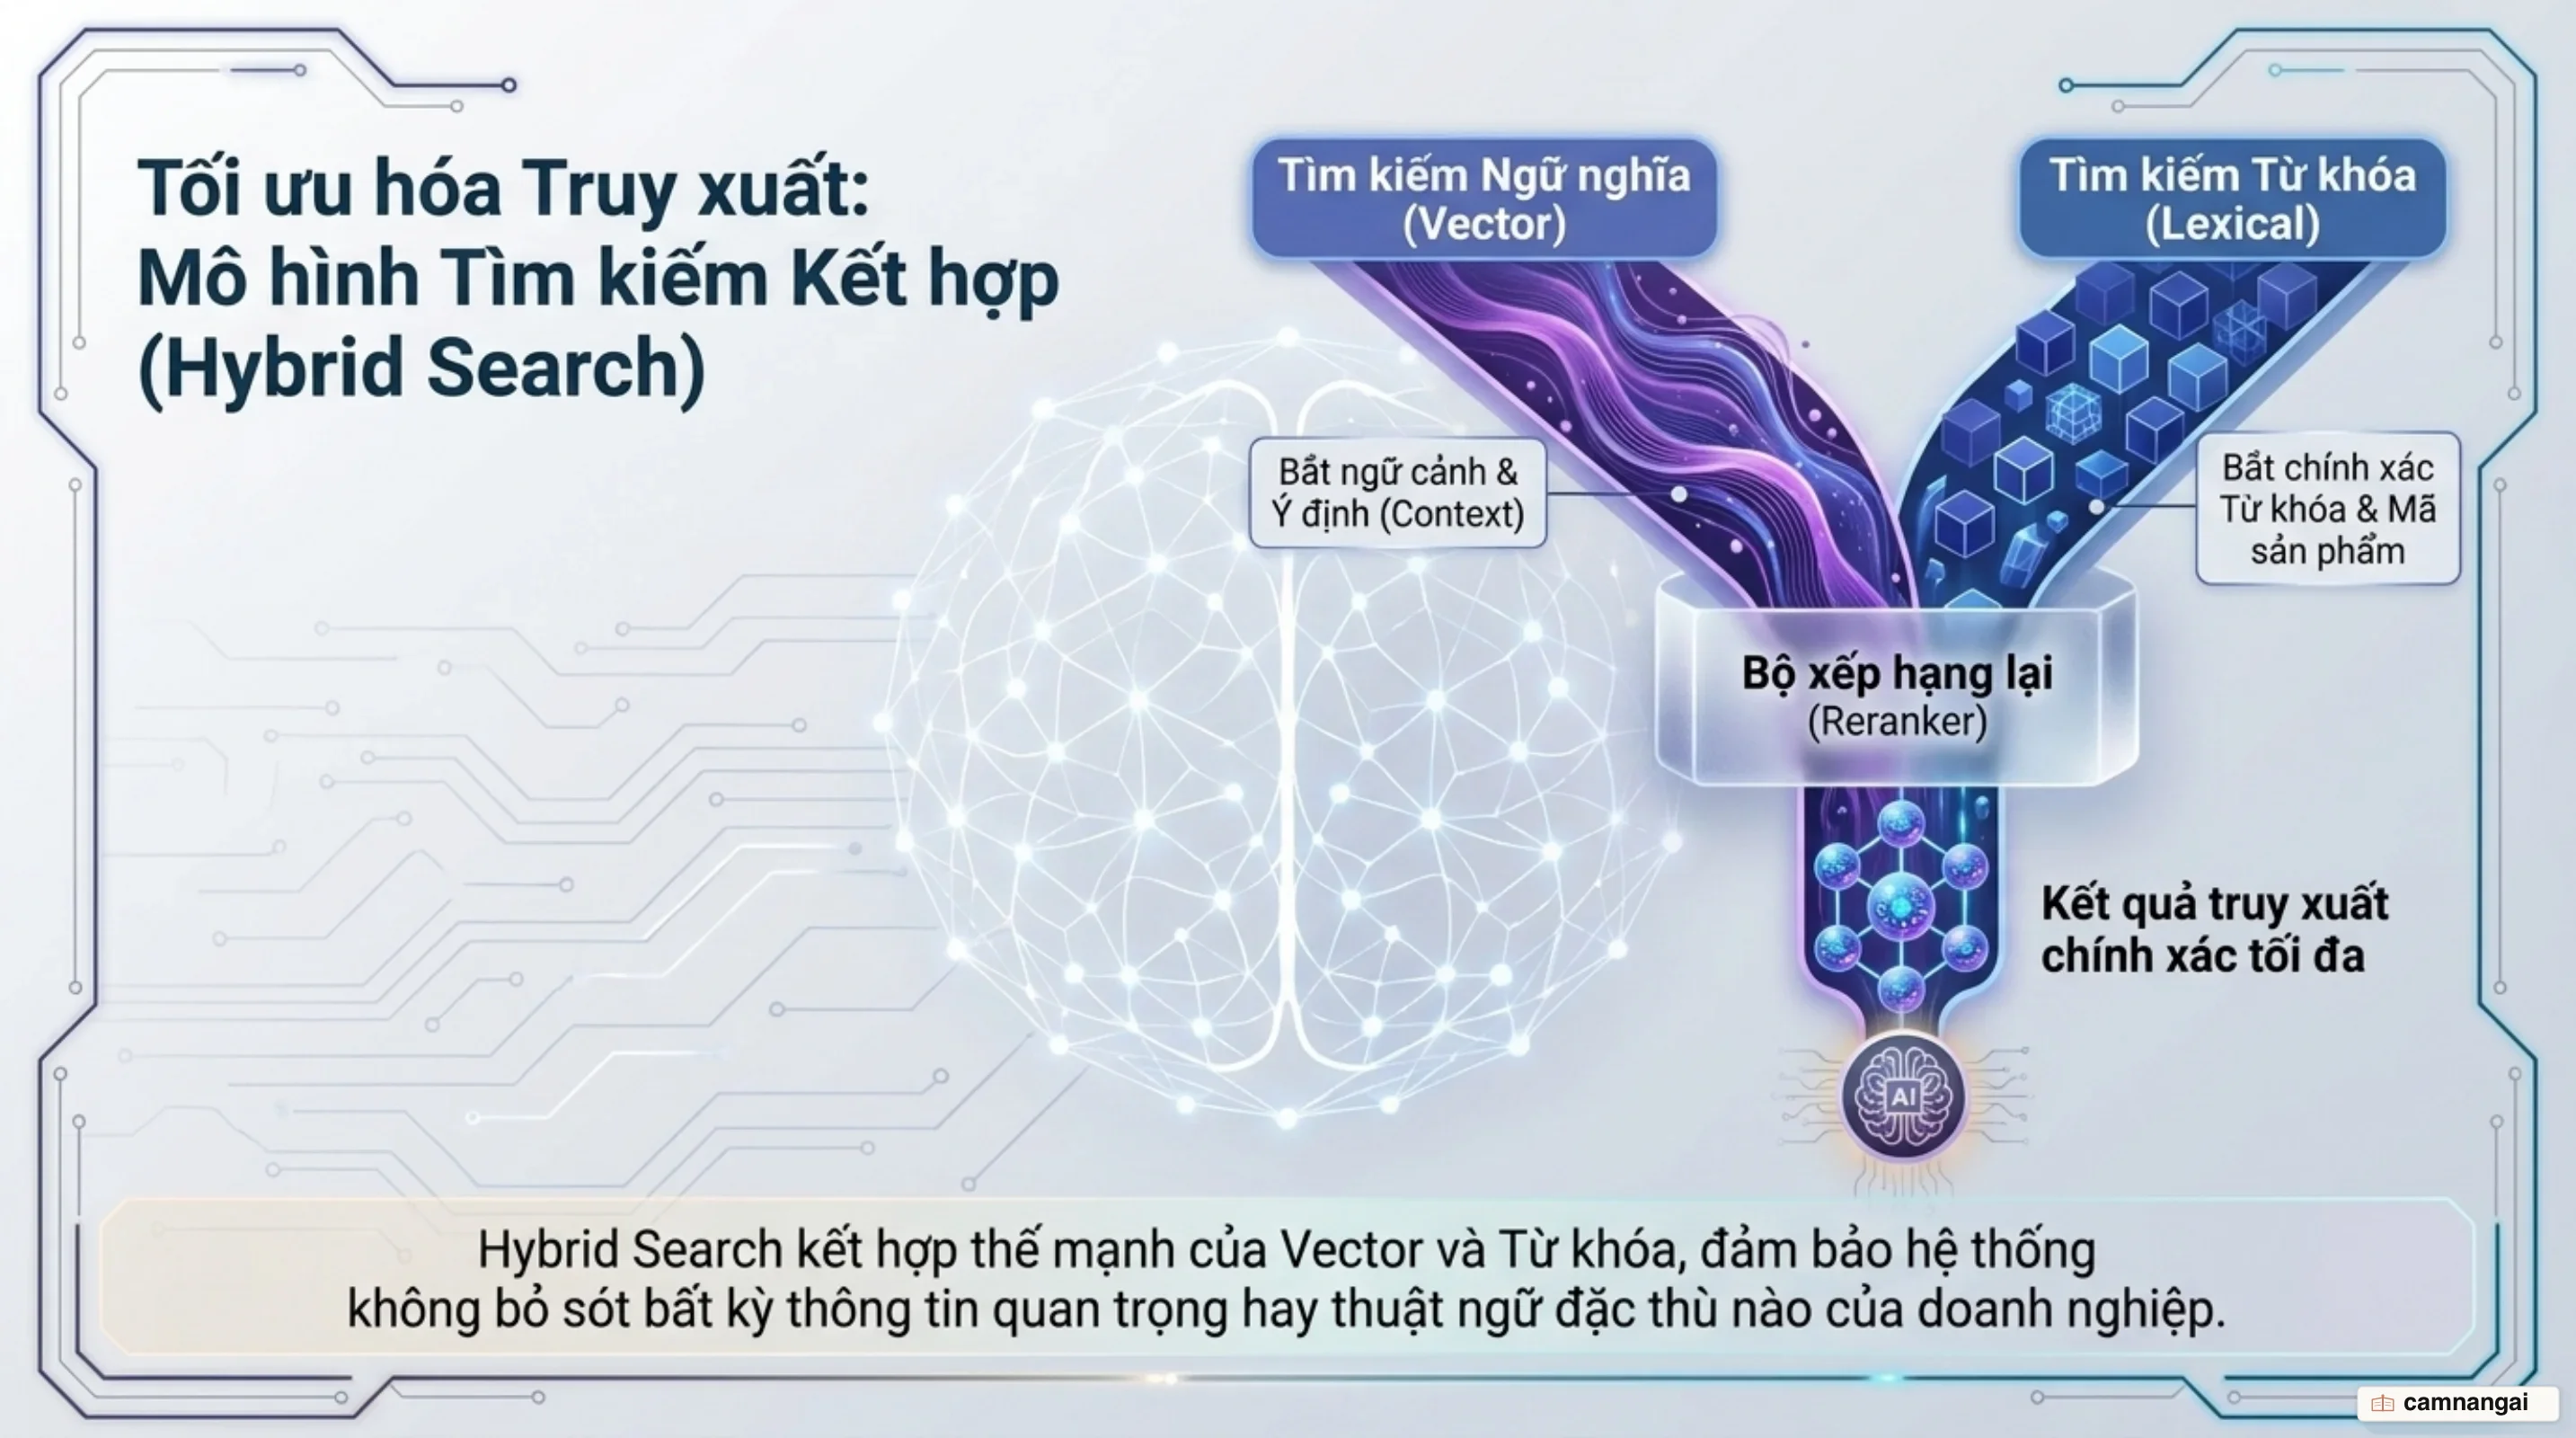
Trong thực tế, việc kết hợp giữa tìm kiếm ngữ nghĩa (semantic search) và tìm kiếm từ khóa truyền thống (hybrid search) giúp hệ thống nhận diện chính xác các mã linh kiện, tên hàm hoặc thuật ngữ viết tắt đặc thù. JetBlue đã triển khai chatbot "BlueBot" sử dụng RAG để giúp các bộ phận truy cập dữ liệu nội bộ theo phân quyền: đội tài chính tra cứu hồ sơ pháp lý, trong khi đội vận hành truy xuất thông tin bảo dưỡng máy bay. Trợ lý "Latte" của Experian cũng hỗ trợ nhân viên khai thác tài liệu kỹ thuật và tinh chỉnh prompt nhanh chóng.
Tại tập đoàn ô tô Cycle & Carriage, RAG được dùng để khai thác hàng chục nghìn trang tài liệu bảo dưỡng và nhật ký kỹ thuật. Nhờ đó, cả những nhân viên tư vấn thông thường cũng có thể tra cứu chính xác quy trình xử lý sự cố xe hơi để hỗ trợ khách hàng ngay lập tức.
2. Tự động hóa hỗ trợ khách hàng và IT Helpdesk
RAG nâng cấp chatbot hỗ trợ khách hàng từ các kịch bản cứng nhắc thành những trợ lý có khả năng truy cập thông tin sản phẩm và chính sách theo thời gian thực. Thay vì phải cấu hình lại mô hình mỗi khi có cập nhật, bạn chỉ cần nạp dữ liệu mới vào cơ sở dữ liệu vector (vector database).
Khi khách hàng hỏi về chính sách bảo hành hoặc tình trạng dịch vụ, hệ thống truy xuất các điều khoản hiện hành để tạo câu trả lời kèm đường dẫn đến văn bản gốc. Điều này giúp doanh nghiệp mở rộng quy mô hỗ trợ khách hàng 24/7 mà không cần tăng tương ứng nhân sự trực ca.
Đối với IT Helpdesk nội bộ, RAG cho phép nhân viên tự khắc phục các sự cố phần cứng, phần mềm và cấp quyền truy cập bằng cách đối chiếu câu hỏi với kho dữ liệu sự cố trước đây. Quy trình giải quyết vé hỗ trợ (ticket) được rút ngắn đáng kể, giải phóng thời gian cho đội ngũ IT tập trung vào các sự cố hạ tầng trọng yếu.
3. Phân tích tài liệu phức tạp: Pháp lý, tài chính và y tế
Trong các lĩnh vực đòi hỏi độ chuẩn xác cao và chịu sự kiểm soát nghiêm ngặt, khả năng dẫn nguồn của RAG là yếu tố sống còn:
- Pháp lý: RAG hỗ trợ luật sư và chuyên viên pháp chế rà soát hàng nghìn trang hợp đồng, đối chiếu điều khoản với các văn bản quy phạm pháp luật và án lệ liên quan.
- Tài chính: Chuyên viên phân tích tận dụng RAG để tổng hợp báo cáo tài chính quý, trích xuất chỉ số kinh doanh và so sánh xu hướng thị trường mà không sợ sai lệch số liệu.
- Y tế và lâm sàng: RAG hỗ trợ bác sĩ tra cứu các hướng dẫn điều trị và nghiên cứu y khoa mới nhất dựa trên hồ sơ bệnh án cụ thể, với điều kiện mọi đề xuất đều phải đi kèm trích dẫn tài liệu y khoa được xác thực.
4. Multi-modal RAG: Xử lý slide deck và bảng biểu dữ liệu
Không chỉ dừng lại ở văn bản thuần túy, RAG hiện đại xử lý hiệu quả các định dạng tài liệu bán cấu trúc như bảng biểu số liệu và slide thuyết trình thông qua kiến trúc Multi-vector retriever.
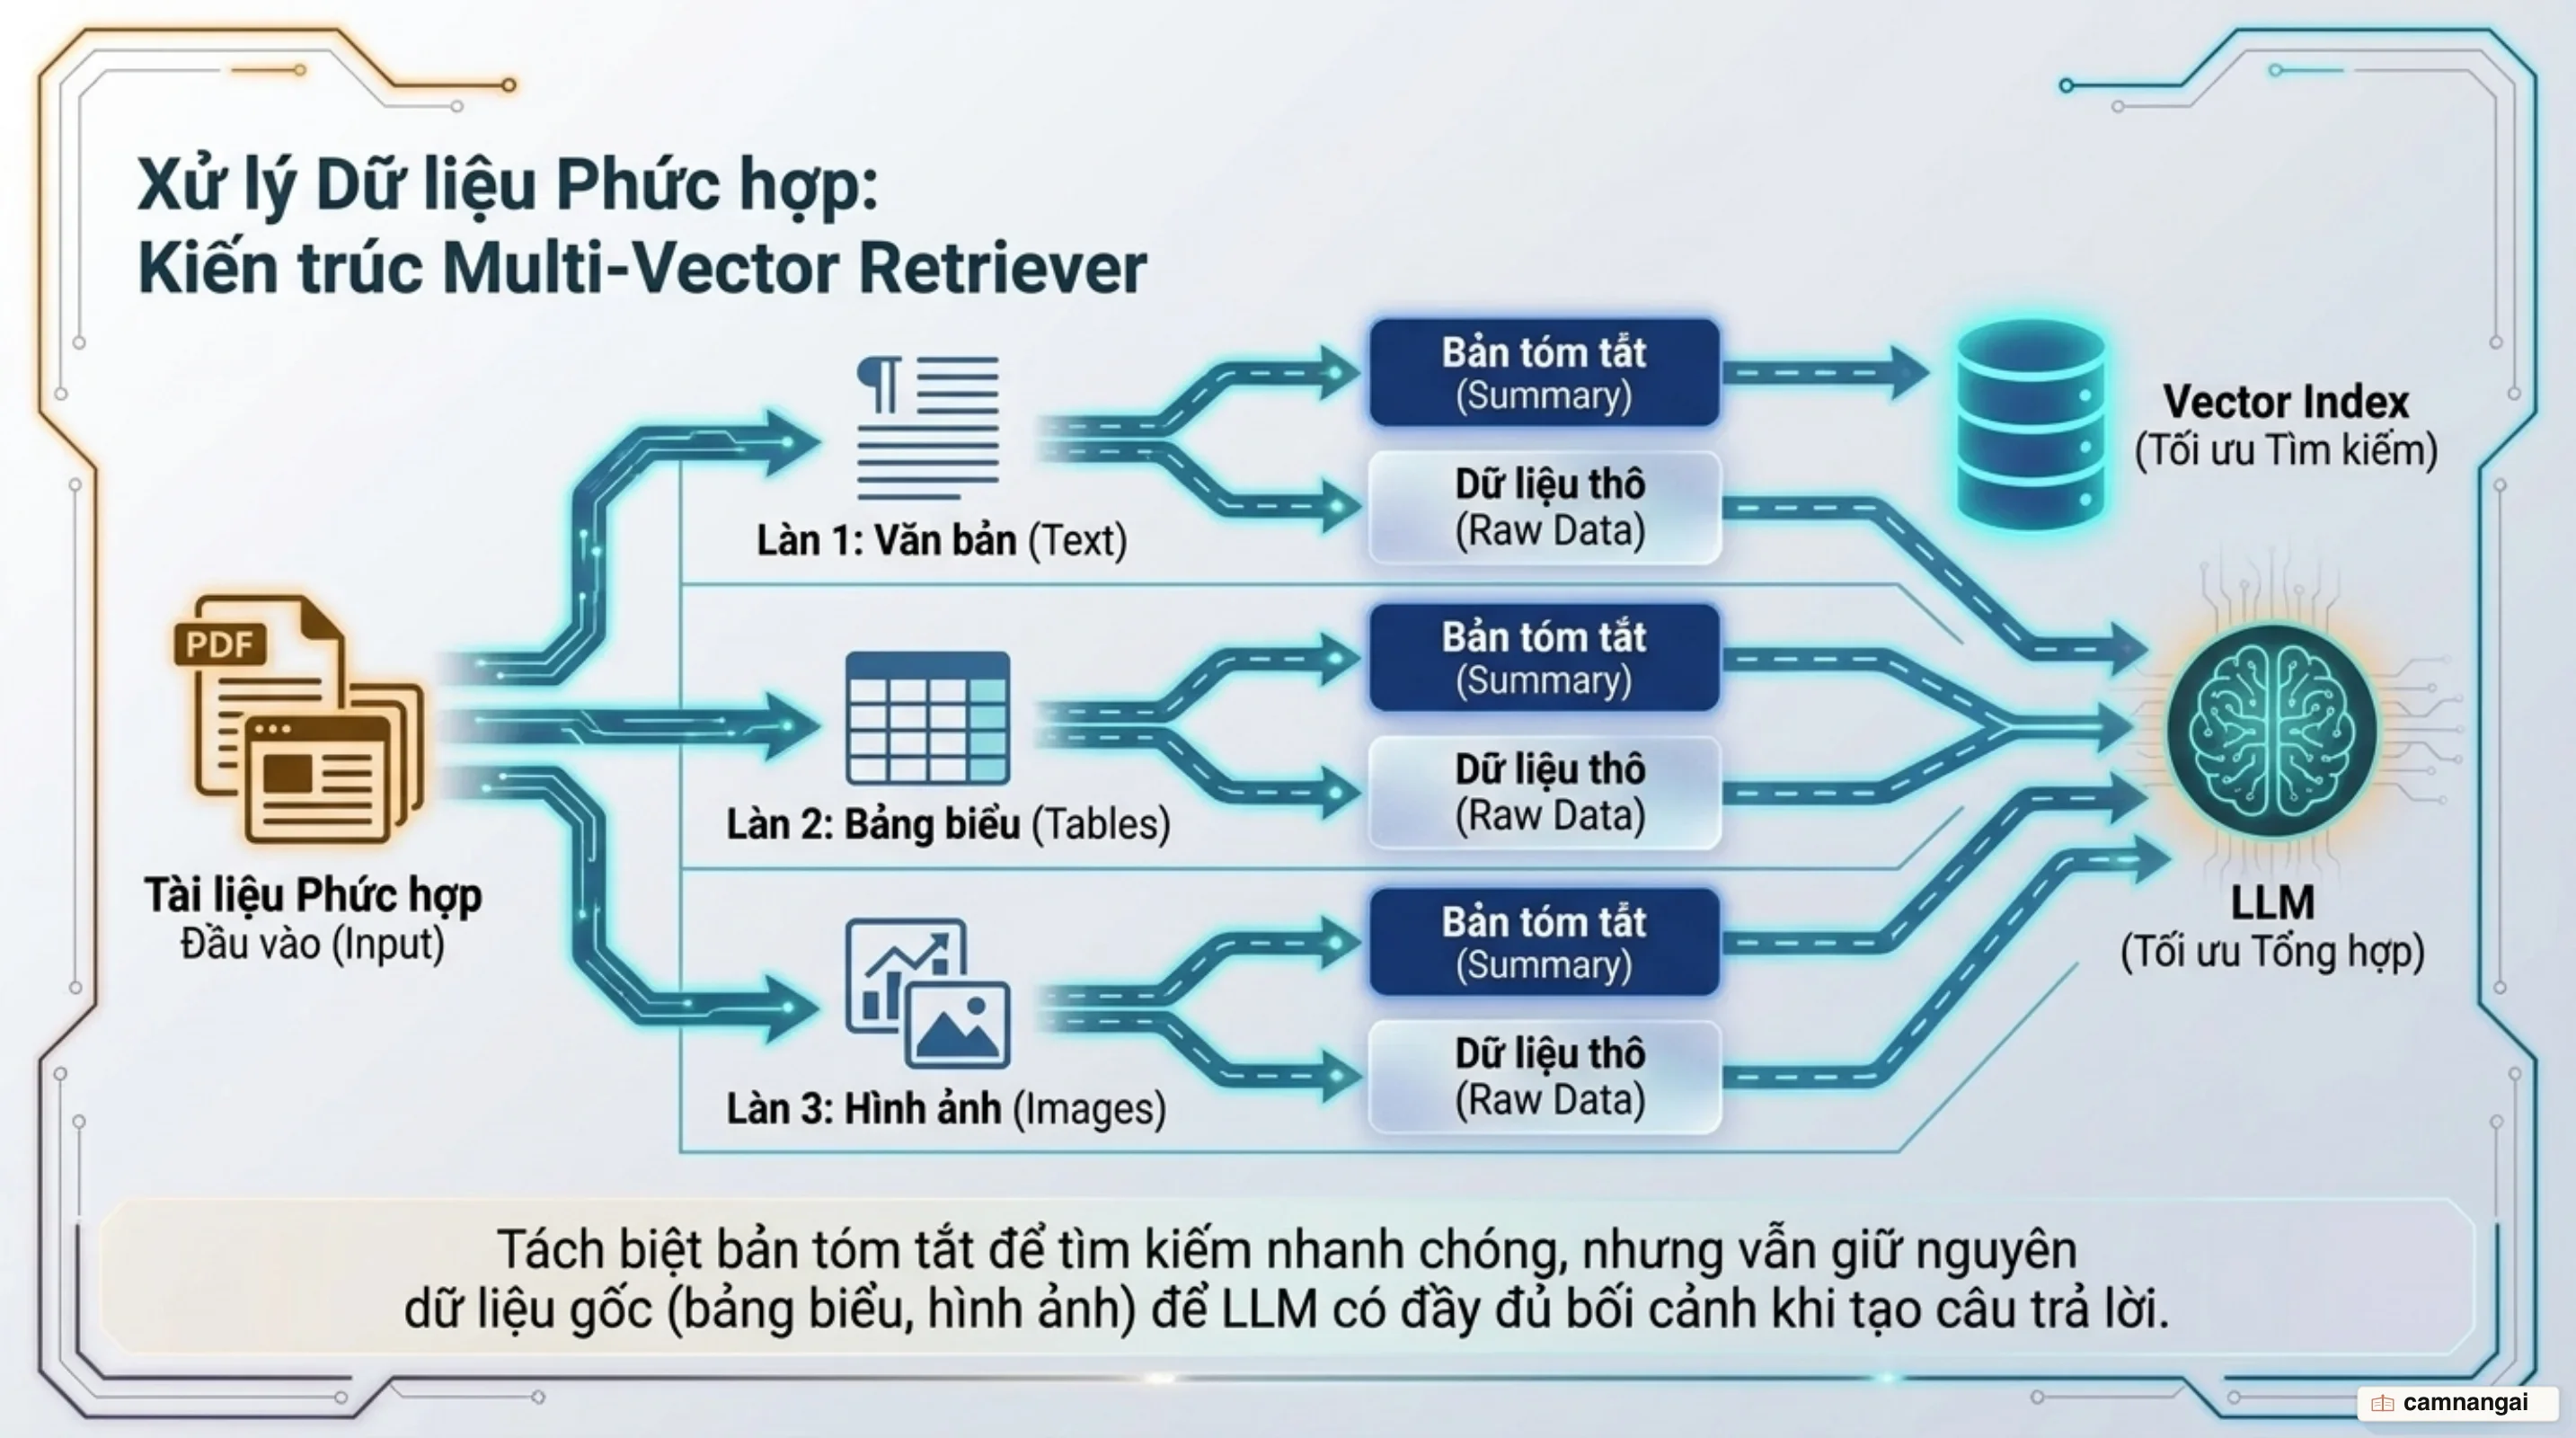
Thách thức lớn nhất của bảng biểu là các hàng và cột số liệu rời rạc thường khiến mô hình embedding thông thường hiểu sai ngữ cảnh. Để giải quyết, quy trình xử lý tài liệu tách bạch rõ ràng:
- Phân tách cấu trúc: Sử dụng các mô hình thị giác máy tính để nhận diện vùng bảng biểu và hình ảnh trong file PDF hoặc slide.
- Tạo bản tóm tắt (Summary): Dùng mô hình ngôn ngữ sinh đoạn tóm tắt ngữ nghĩa cho từng bảng biểu và sơ đồ.
- Lưu trữ đa vector: Bản tóm tắt dạng văn bản được đưa vào vector store để phục vụ truy vấn ngữ nghĩa, nhưng khi trích xuất ngữ cảnh cho LLM, hệ thống gửi nguyên vẹn bảng số liệu gốc (raw data) để đảm bảo dữ liệu tính toán không bị thất thoát.
5. RAG hỗ trợ Agentic Workflows và Tool Calling
Bước chuyển biến rõ rệt nhất hiện nay là từ quy trình RAG tuyến tính cố định sang Agentic RAG. Trong pipeline truyền thống, luồng dữ liệu chỉ đi một chiều: nhận câu hỏi -> truy xuất -> sinh câu trả lời.
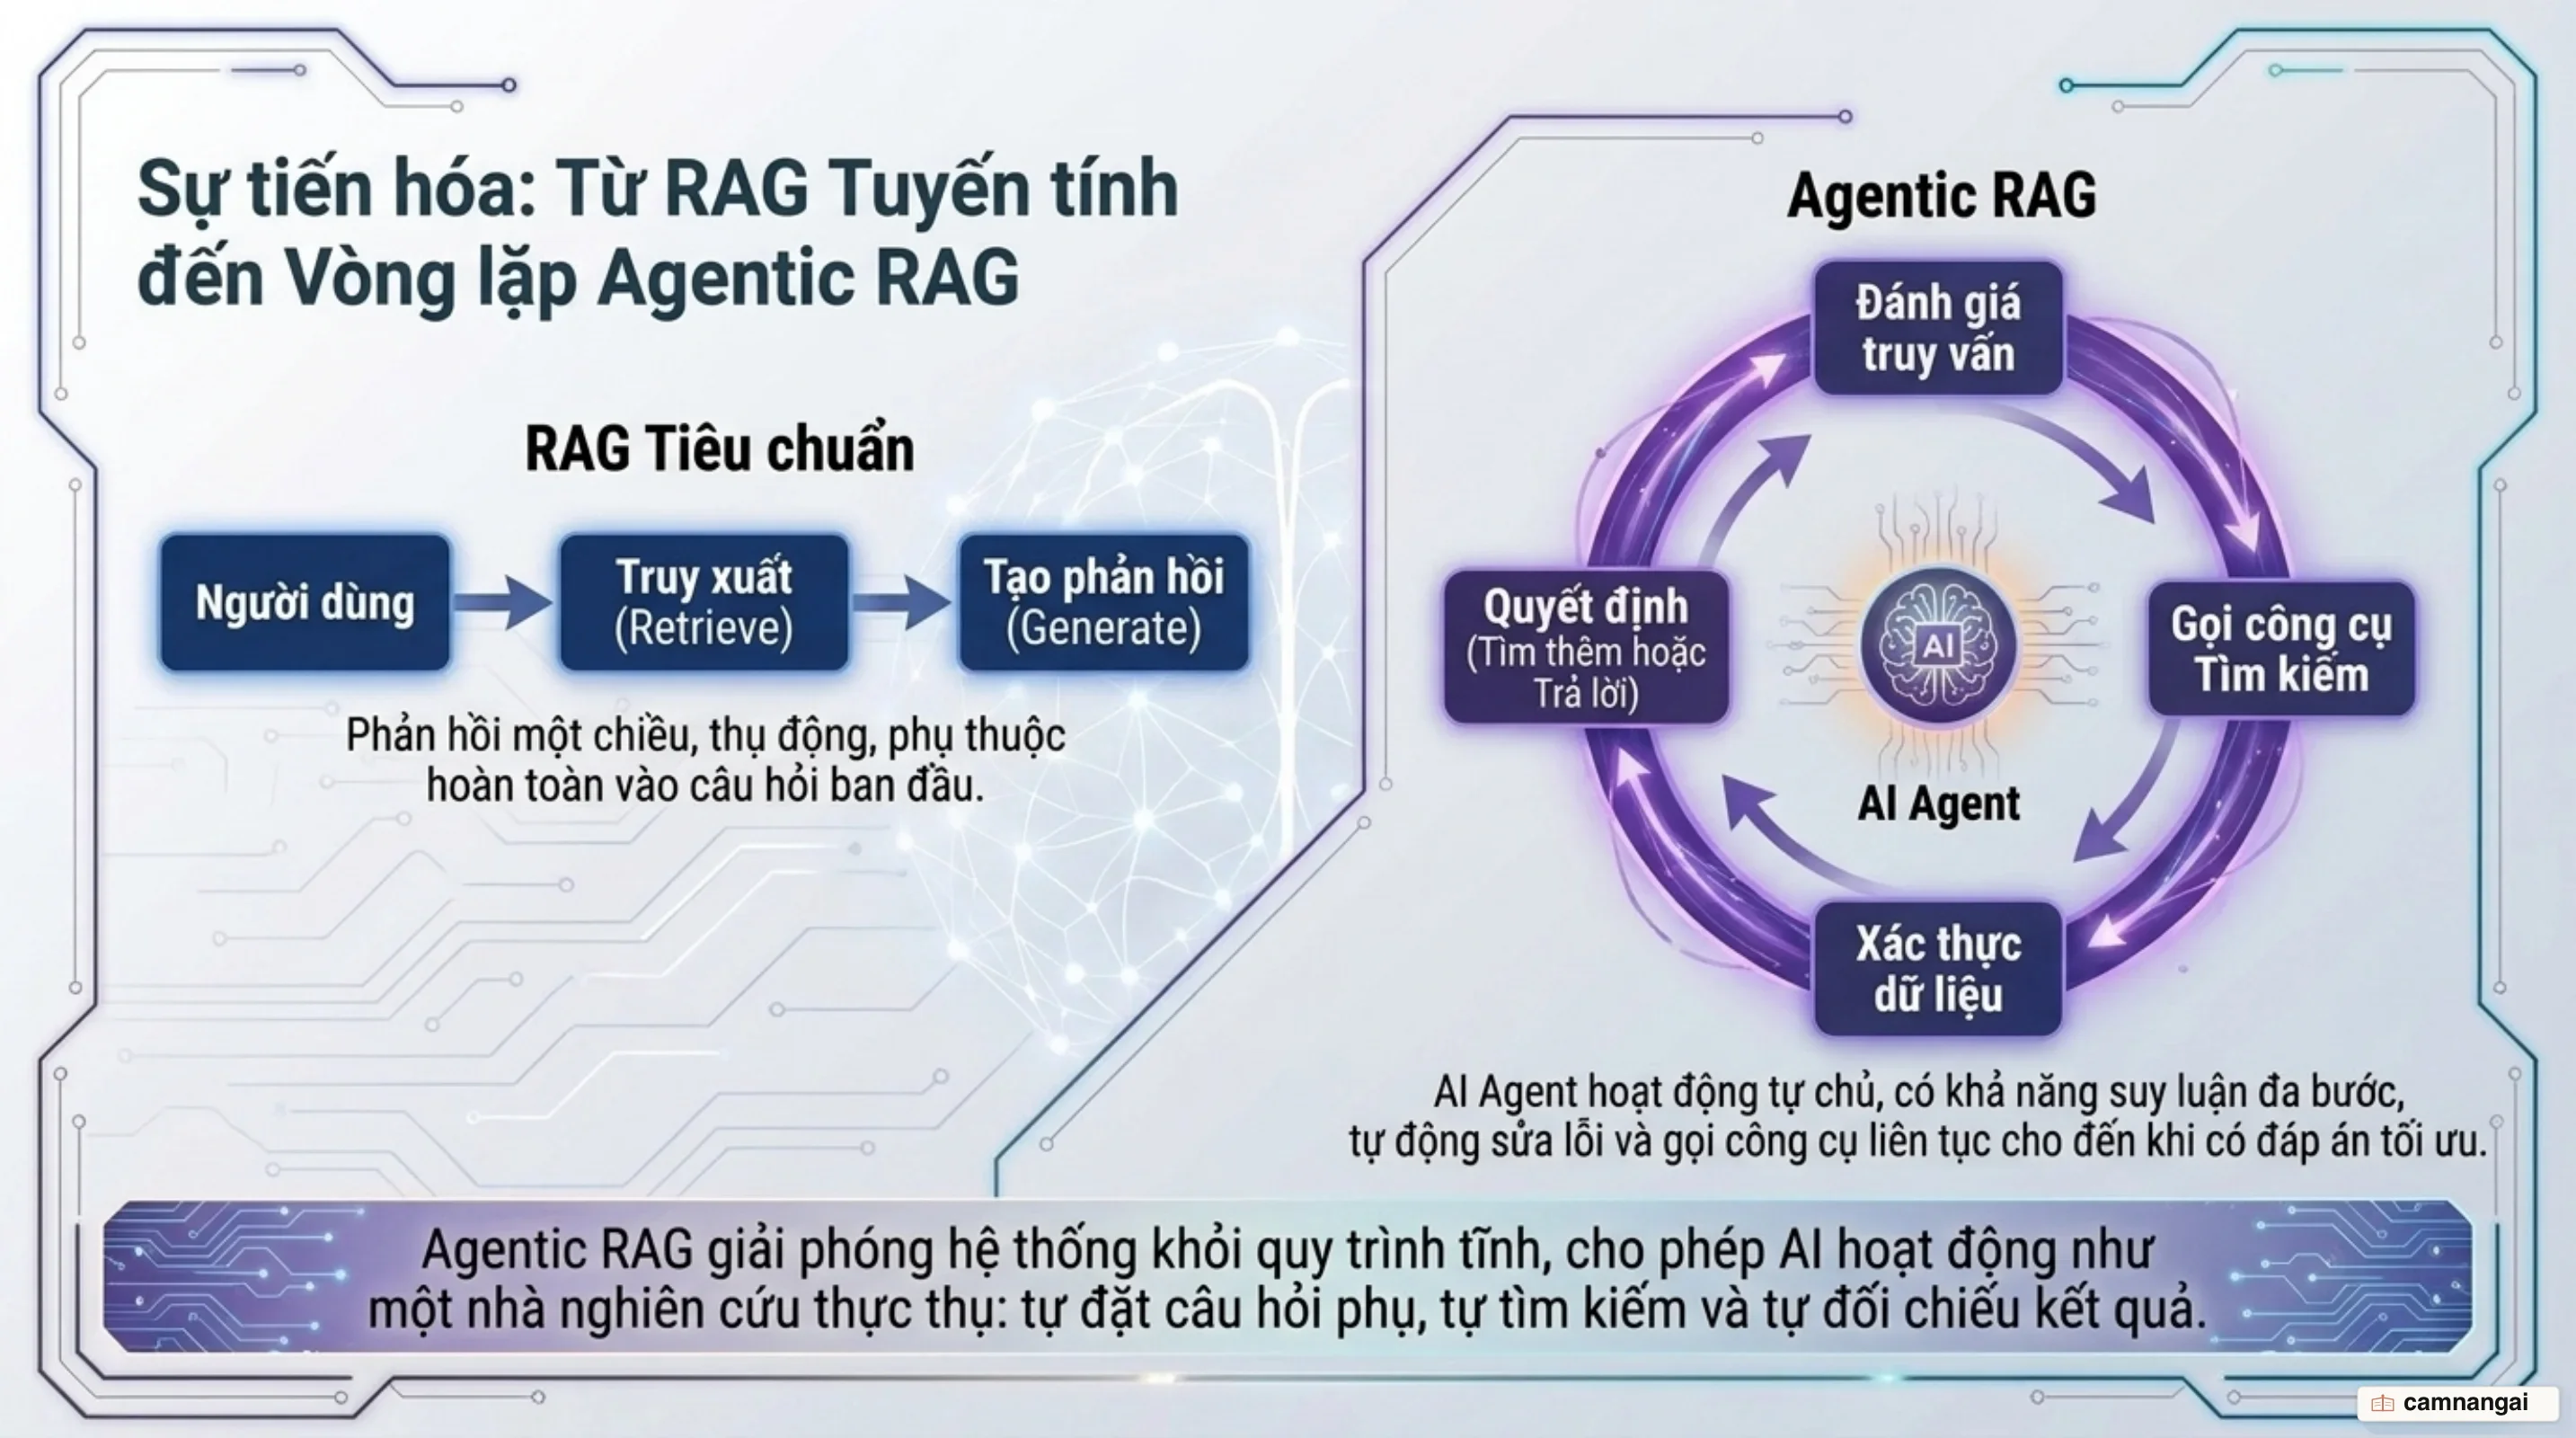
Trong Agentic RAG, việc truy xuất tri thức được xem như một công cụ (tool) trong tay AI Agent:
- Tự chủ gọi công cụ (Tool Calling): Agent tự phân tích yêu cầu để quyết định có cần tra cứu dữ liệu hay không, nên tra ở kho tài liệu nào (tài liệu kỹ thuật, bảng giá, hay cơ sở dữ liệu SQL) và khi nào cần tra cứu thêm.
- Suy luận lặp (Iterative reasoning): Với các câu hỏi phức tạp, agent phân tách thành nhiều truy vấn con, tự đánh giá tính đầy đủ của ngữ cảnh vừa tìm được và tiếp tục đào sâu nếu thông tin chưa đủ để đưa ra kết luận chuẩn xác.
Tiêu chí đánh giá khi nào nên triển khai RAG
Triển khai RAG là một quyết định kỹ thuật cần đo lường cẩn trọng:
- Dữ liệu thay đổi thường xuyên: Ưu tiên RAG khi thông tin cập nhật liên tục theo ngày hoặc theo giờ (tài liệu sản phẩm, chính sách giá, hồ sơ hỗ trợ).
- Yêu cầu độ tin cậy và minh bạch: Khi câu trả lời bắt buộc phải có bằng chứng đối chiếu và không chấp nhận rủi ro bịa đặt.
- Tối ưu ngân sách token: Sử dụng RAG để giữ cửa sổ ngữ cảnh gọn gàng, giảm độ trễ và chi phí suy luận so với việc nhồi nhét dữ liệu thô.
Đặc biệt, hệ thống RAG đưa vào môi trường thực tế bắt buộc phải có cơ chế đánh giá dựa trên tập dữ liệu chuẩn (ground truth evaluation). Hãy đo lường định kỳ độ liên quan của bước truy xuất và độ trung thực của câu trả lời sinh ra trước khi nghĩ đến các biện pháp phức tạp hơn như huấn luyện lại (fine-tuning).
Tài liệu tham khảo
- What is RAG? - Retrieval-Augmented Generation AI Explained - AWS
- What is RAG (Retrieval Augmented Generation)? | IBM
- Retrieval-Augmented Generation (RAG) | Pinecone
- What is Retrieval Augmented Generation (RAG)? | Databricks
- Top Use Cases of Retrieval-Augmented Generation (RAG) in AI
- Multi-Vector Retriever for RAG on tables, text, and images
- Design and Develop a RAG Solution on Azure - Azure Architecture Center | Microsoft Learn