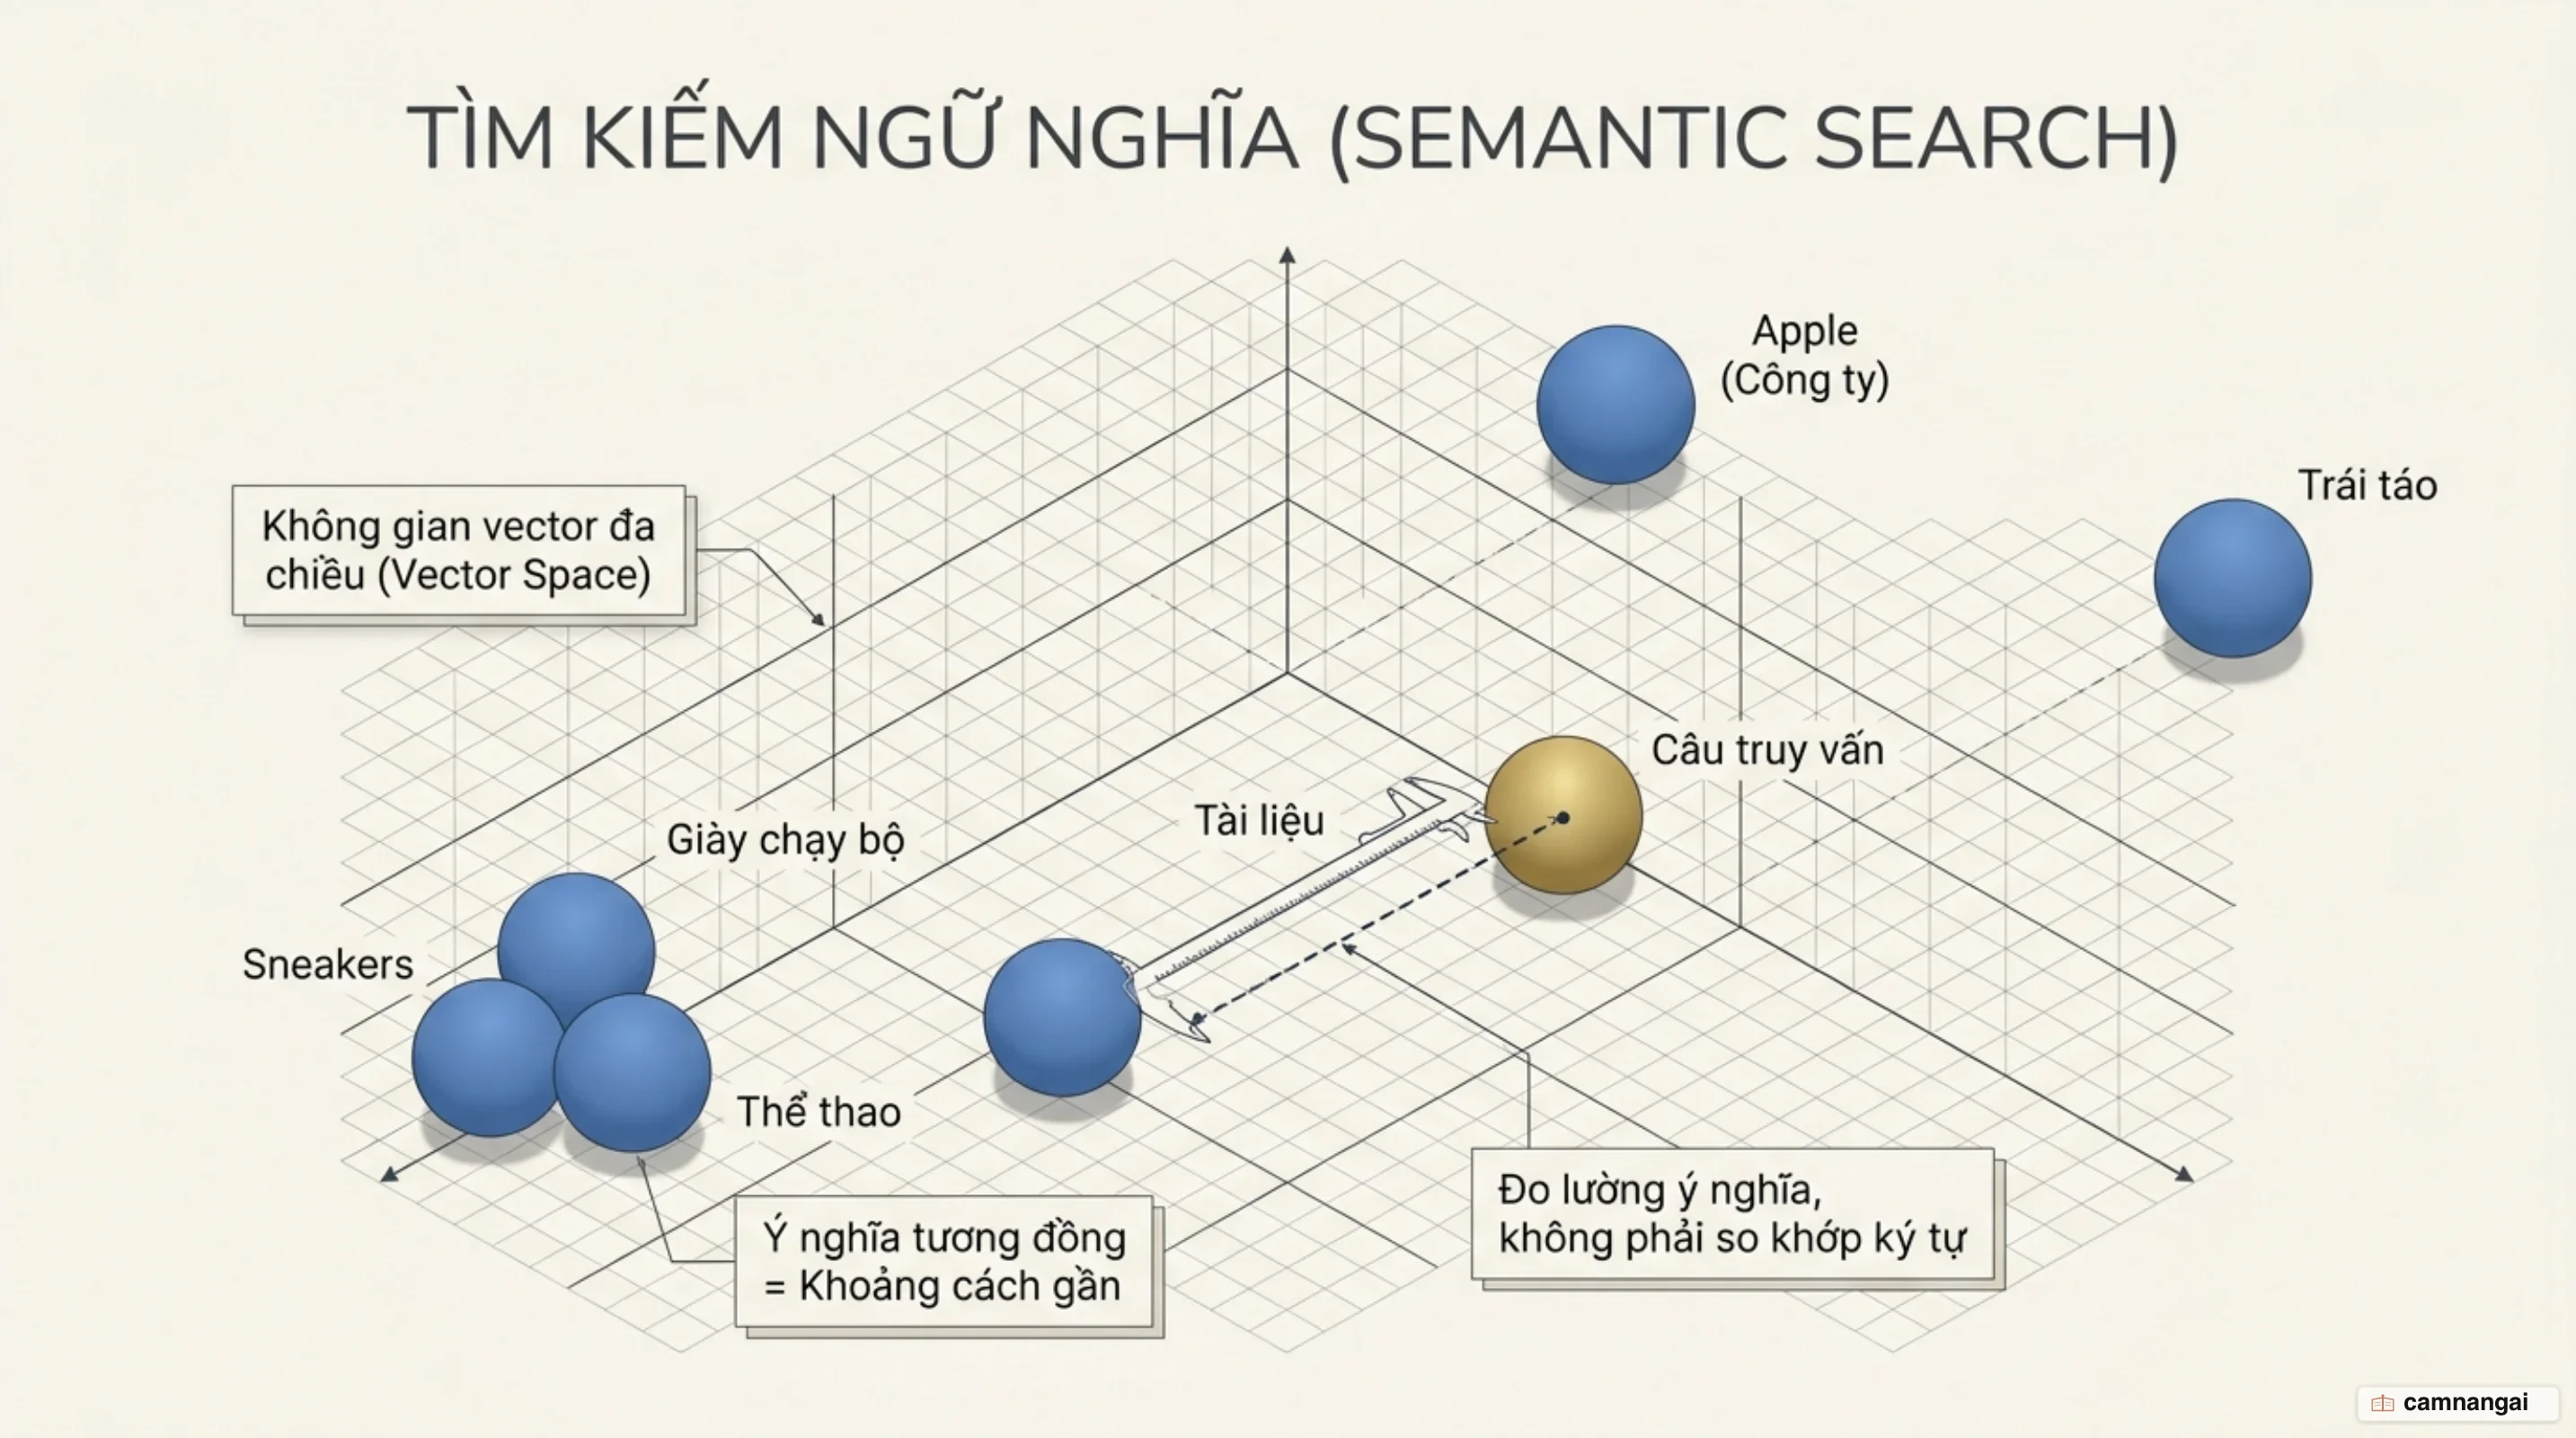
Tìm kiếm ngữ nghĩa (Semantic Search) là phương pháp truy hồi thông tin sử dụng các mô hình học sâu để ánh xạ dữ liệu vào một không gian vector đa chiều, nơi ý nghĩa và ngữ cảnh được định vị bằng các tọa độ toán học thay vì so khớp ký tự truyền thống.
Thay vì phụ thuộc vào sự trùng lặp ký tự đơn thuần, hệ thống chuyển đổi ngôn ngữ tự nhiên thành các điểm dữ liệu liên tục để nắm bắt mục đích thực sự của người dùng.
Đối với các kỹ sư xây dựng hệ thống RAG, làm chủ tìm kiếm ngữ nghĩa là chìa khóa để cân bằng giữa độ trễ, độ phủ và độ chính xác trên quy mô hàng tỷ bản ghi.
Kỹ thuật này tạo nền tảng cho việc định tuyến ngữ cảnh chính xác, ngăn ngừa hiện tượng sinh ảo giác và tối ưu hóa hiệu năng tổng thể của mô hình ngôn ngữ lớn.
Tìm kiếm ngữ nghĩa vs. Truy hồi từ khóa (Lexical Retrieval)
Sự khác biệt cốt lõi giữa hai phương pháp này nằm ở cách biểu diễn dữ liệu trong hạ tầng truy hồi.
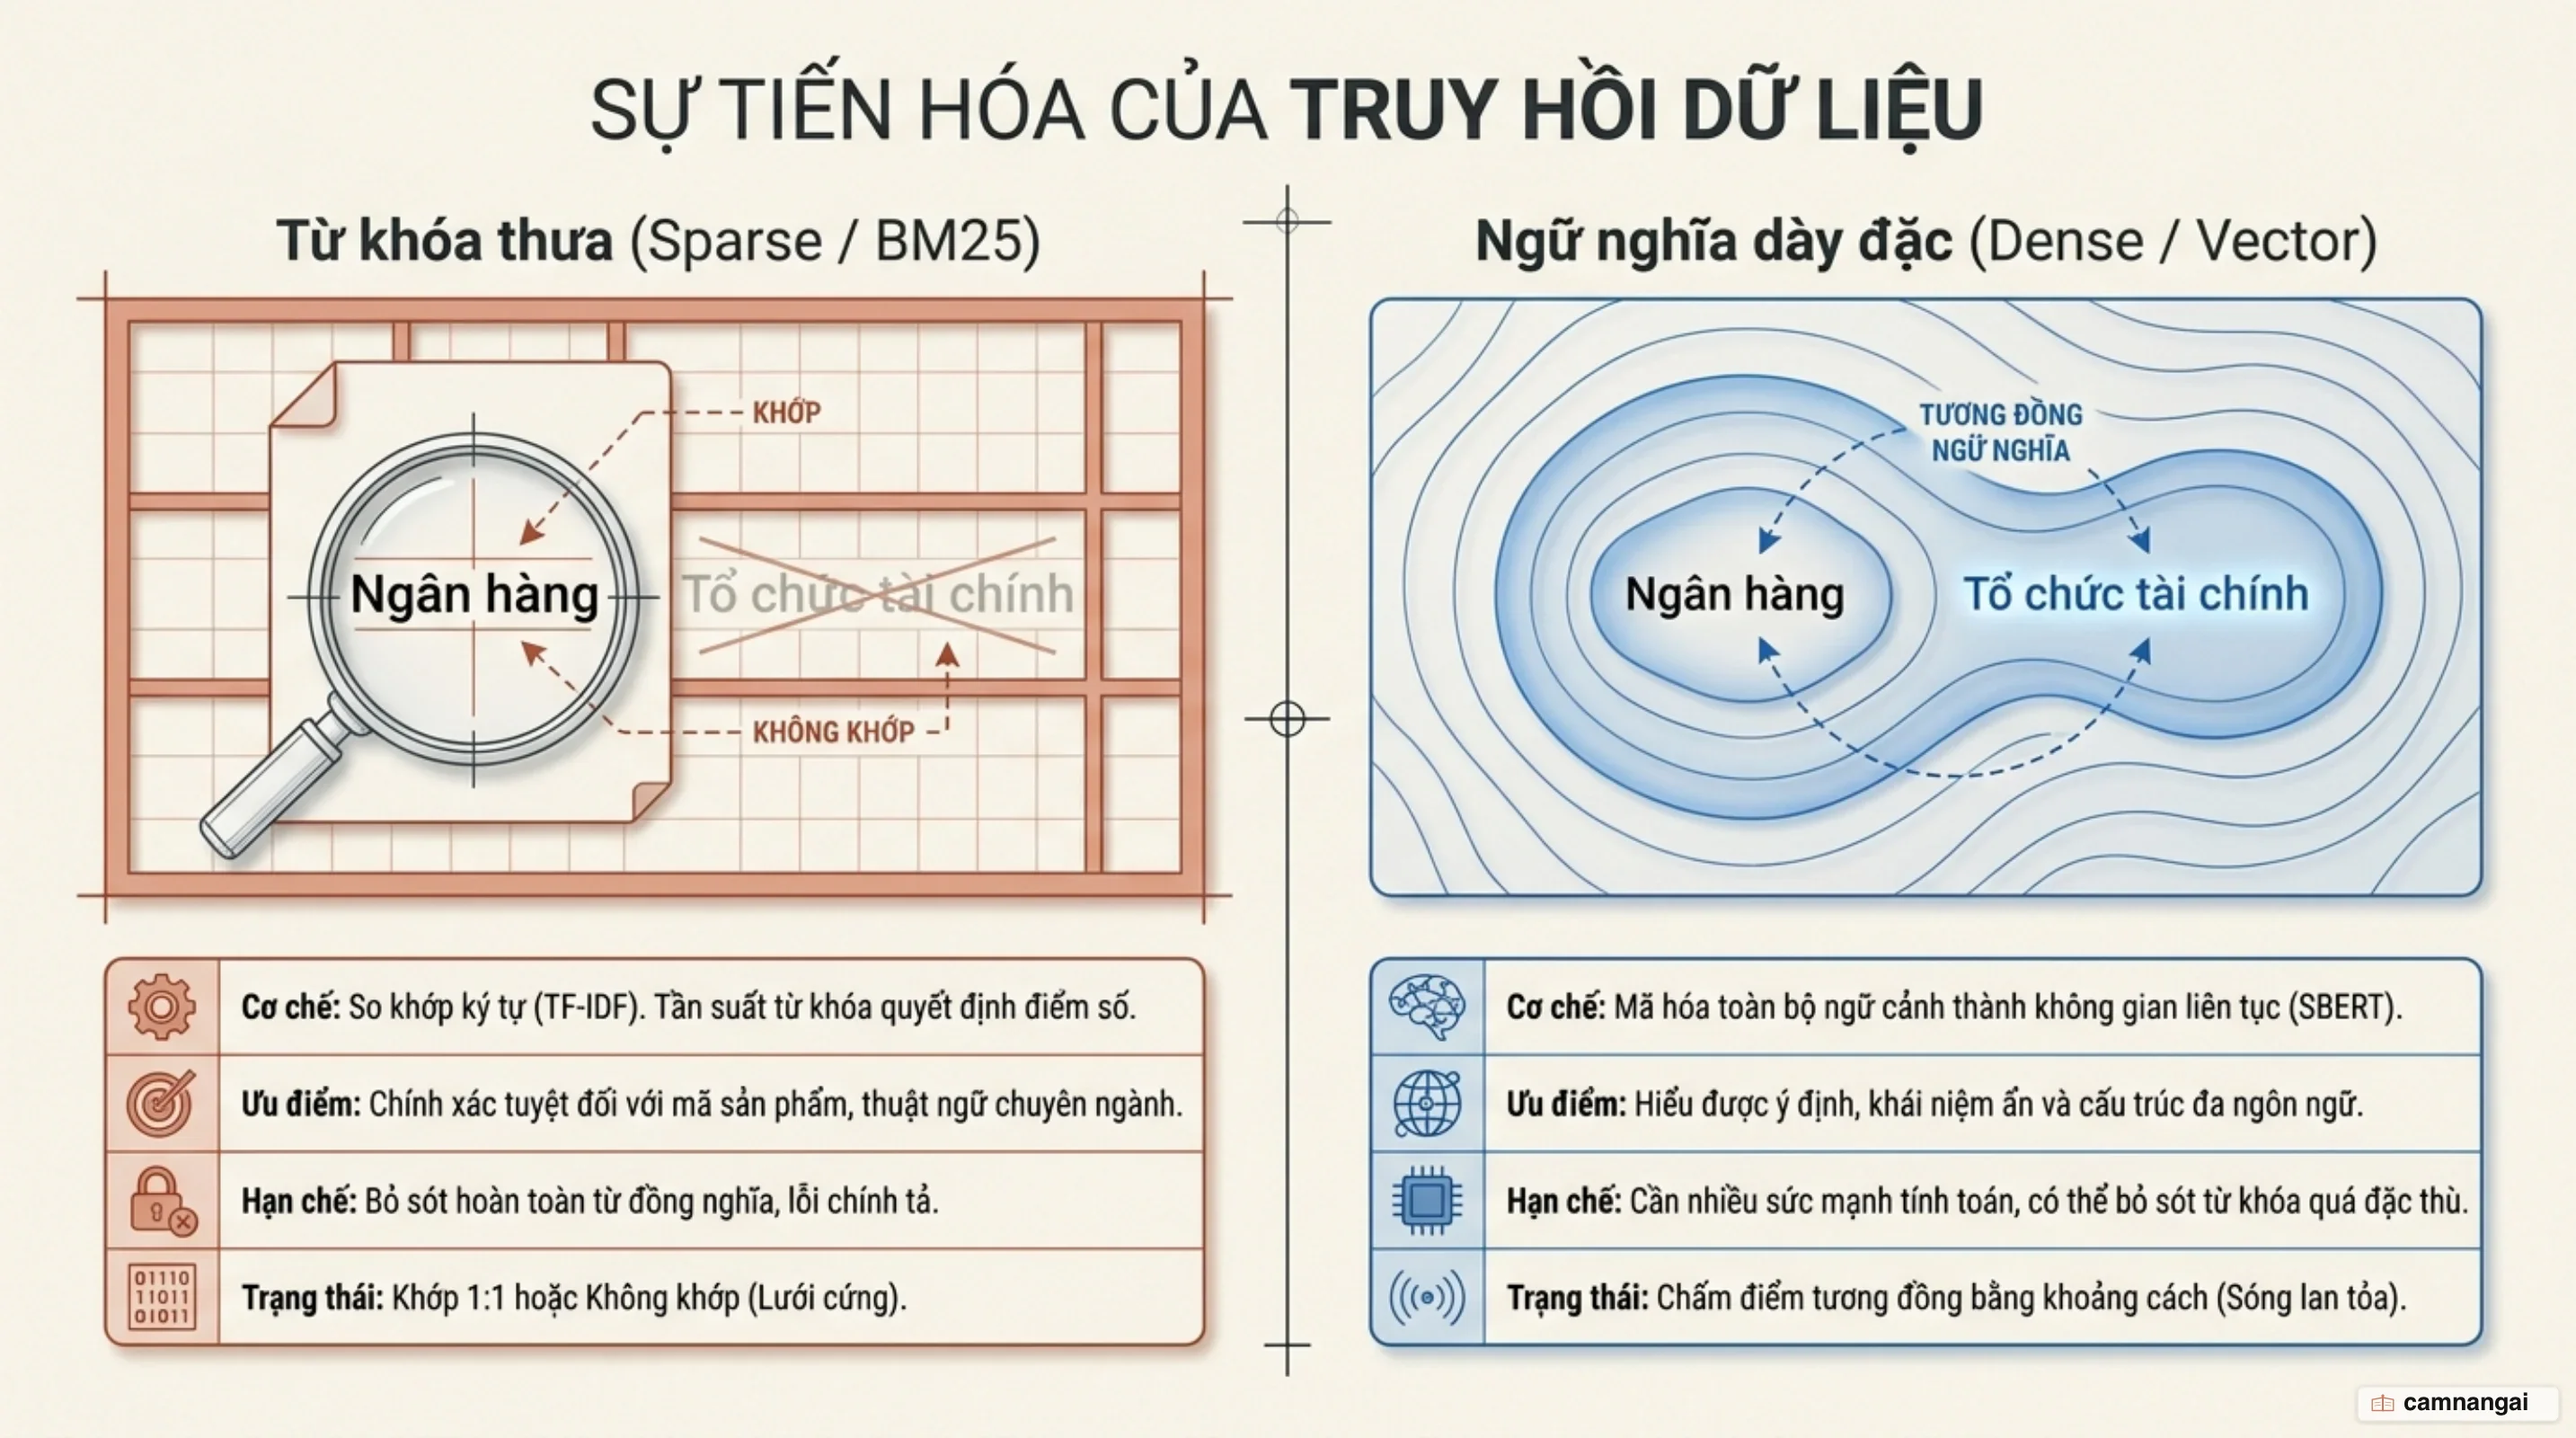
Ở nhánh truy hồi từ khóa (Sparse Retrieval), các thuật toán như BM25 hay TF-IDF biểu diễn tài liệu bằng những vector thưa thớt có số chiều bằng toàn bộ kích thước từ điển, nơi phần lớn giá trị là số 0. Cách tiếp cận này chỉ hoạt động khi có sự trùng lặp chính xác về token. Nếu người dùng gõ "smartphone" nhưng tài liệu ghi "điện thoại di động", hệ thống từ khóa sẽ bỏ qua kết quả vì không tìm thấy ký tự trùng khớp.
Ngược lại, nhánh truy hồi ngữ nghĩa (Dense Retrieval) nén toàn bộ nội dung văn bản vào các vector dày đặc có số chiều cố định (thường là 768 hoặc 1536 chiều) thông qua kỹ thuật vector embedding. Mỗi chiều đại diện cho một đặc tính trừu tượng được học từ các tập dữ liệu lớn. Nhờ đó, hệ thống nhận diện được các khái niệm tương đồng dựa trên khoảng cách hình học trong không gian vector, dù câu từ người dùng dùng có khác biệt hoàn toàn.
Cơ chế Vector hóa và Không gian đa chiều
Hệ thống sử dụng các mô hình Transformer (như BERT, RoBERTa hoặc E5) để chuyển đổi văn bản thành các vector liên tục. Trong không gian này, các phép đo độ tương đồng toán học như Cosine Similarity hoặc Dot Product được sử dụng để xác định mức độ liên quan.
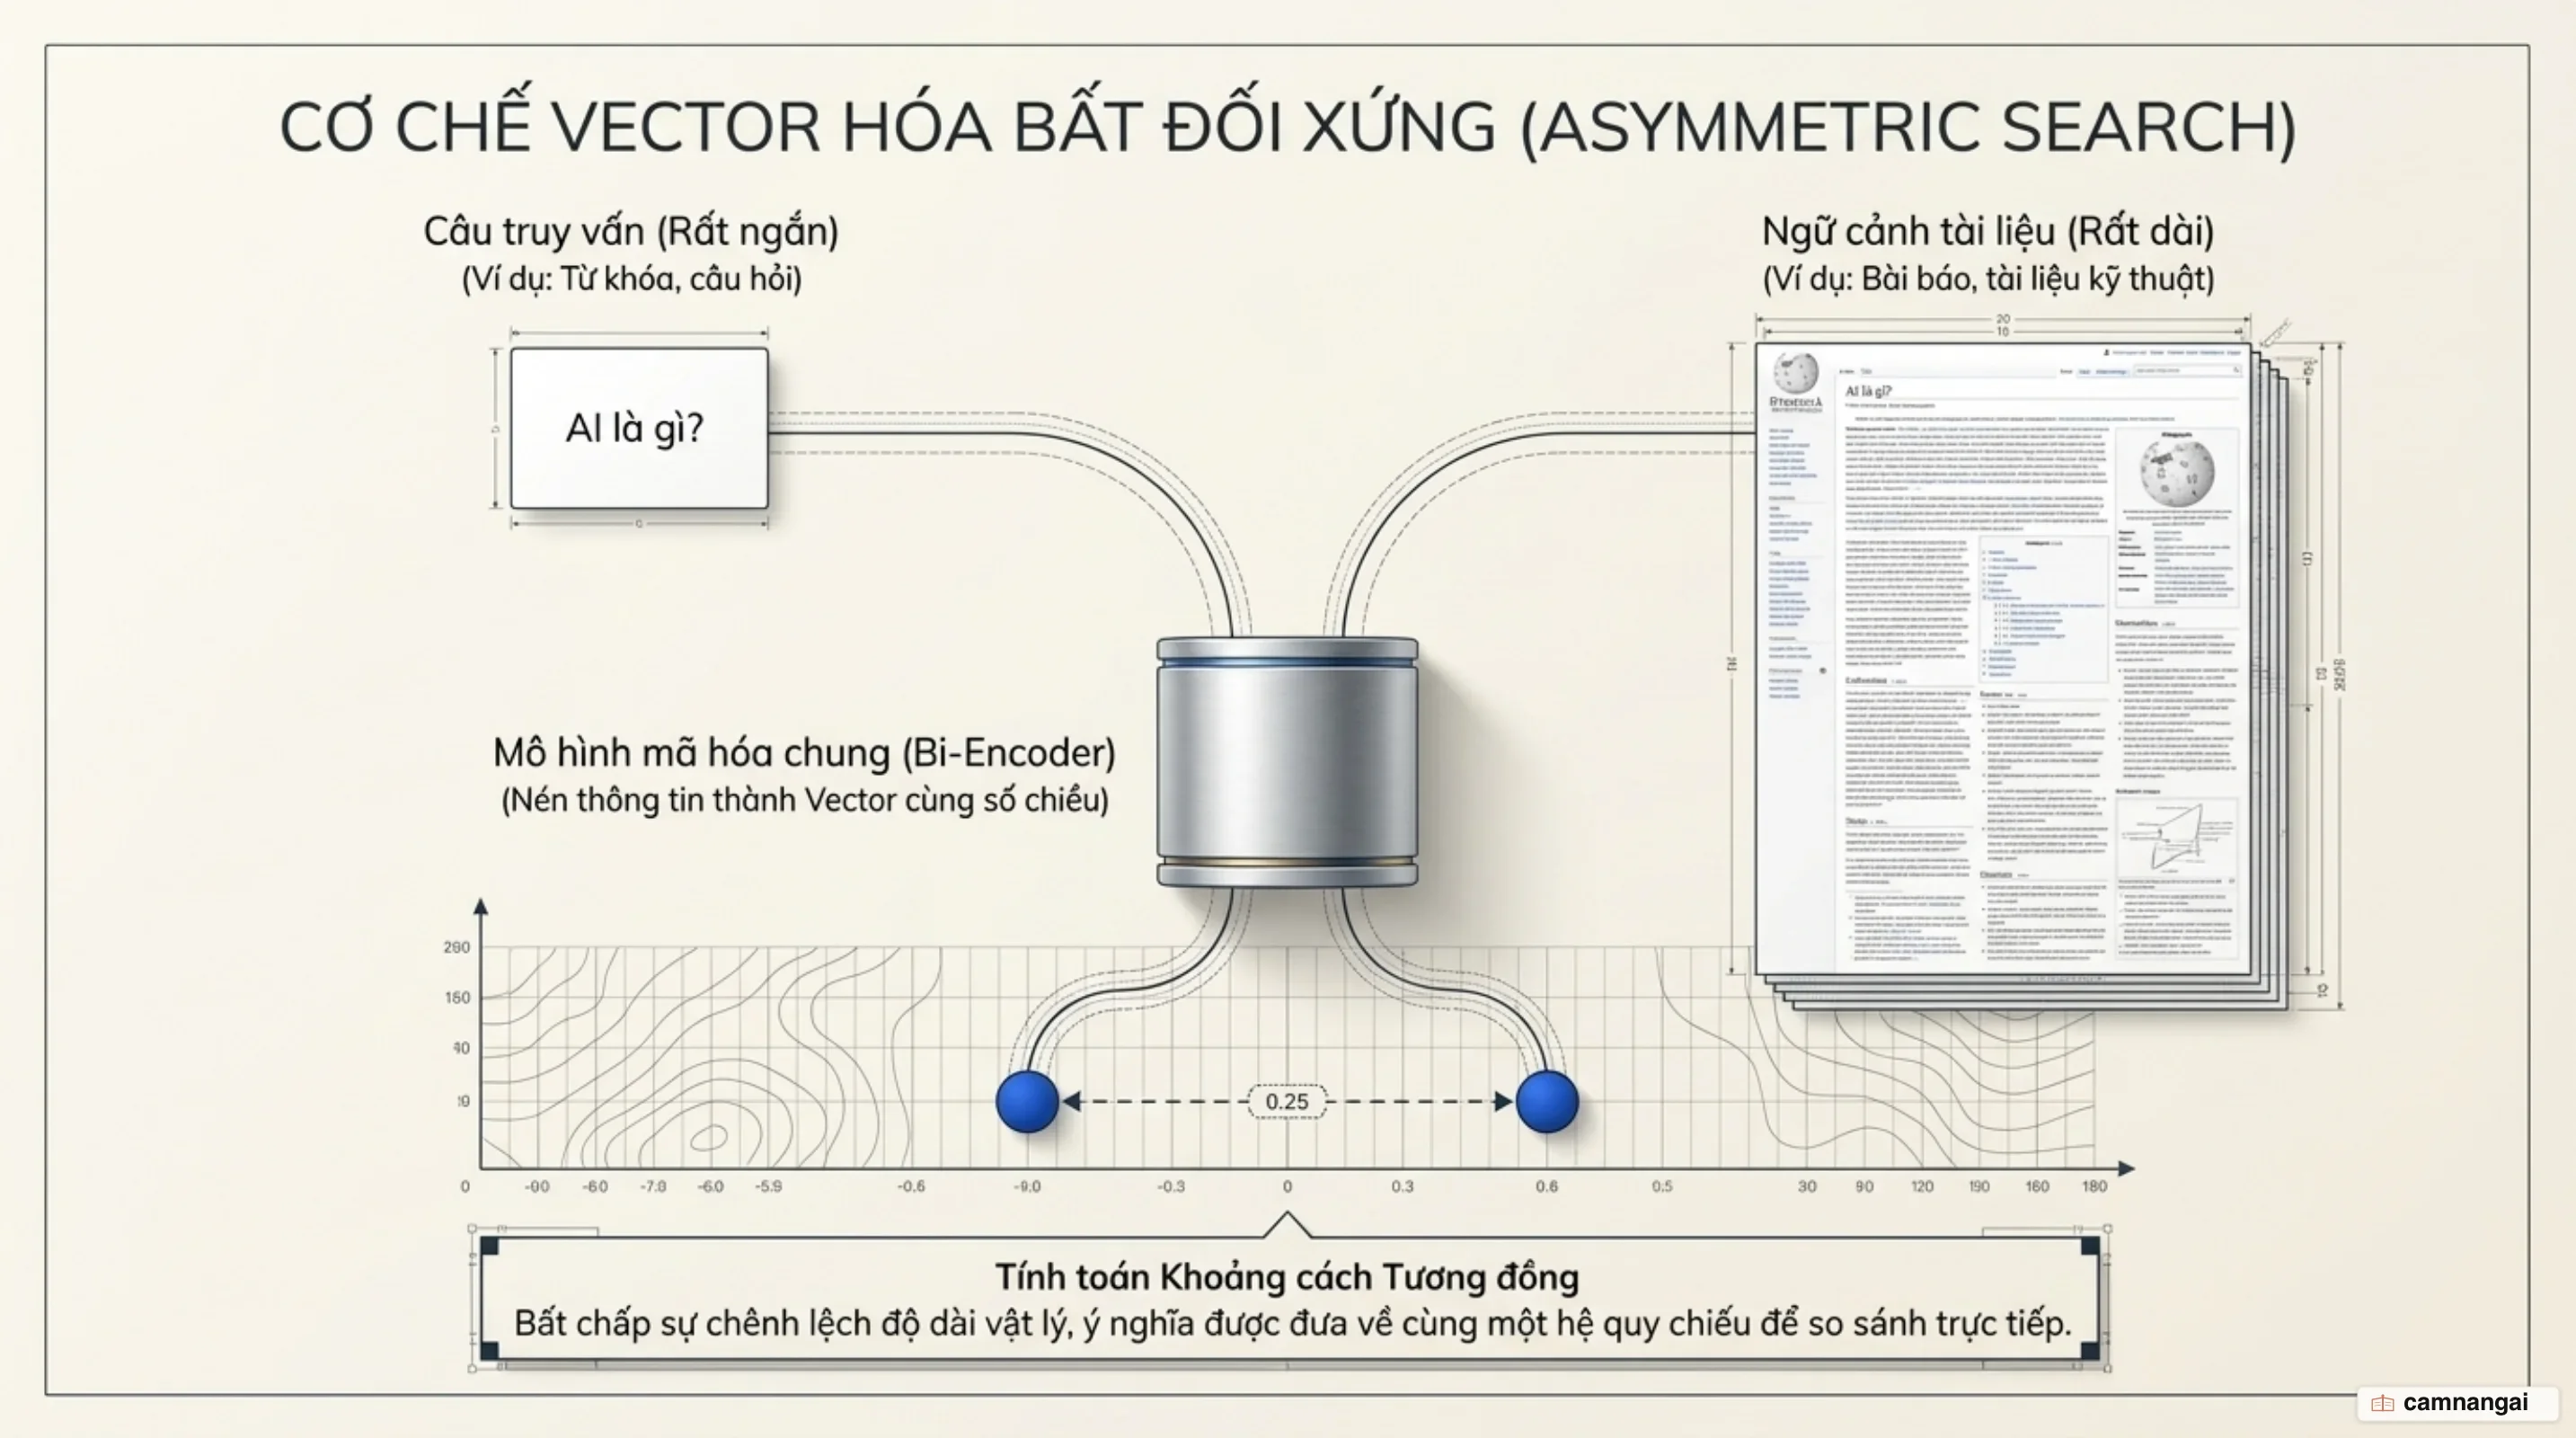
Một chi tiết kỹ thuật quan trọng khi thiết kế hệ thống là phân định rõ giữa tìm kiếm đối xứng (Symmetric Search) và bất đối xứng (Asymmetric Search). Trong tìm kiếm đối xứng, câu truy vấn và tài liệu có độ dài tương đương nhau, chẳng hạn tìm các câu hỏi trùng ý trong kho FAQ. Còn trong tìm kiếm bất đối xứng—trường hợp phổ biến nhất ở môi trường production—một câu truy vấn ngắn của người dùng phải đối chiếu với các đoạn văn dài chứa lời giải.
Để tối ưu hiệu năng trong Asymmetric Search, các thư viện như sentence-transformers cung cấp các phương thức chuyên biệt là encode_query và encode_document. Việc sử dụng đúng phương thức giúp mô hình xử lý các đặc tính ngữ cảnh khác nhau của câu hỏi và câu trả lời, tránh hiện tượng giảm hiệu năng khi truy vấn thực tế.
Dưới đây là ví dụ thực hiện tìm kiếm tương đồng vector bằng Python, sử dụng GPU để tối ưu tốc độ:
from sentence_transformers import SentenceTransformer, util
import torch

# Khởi tạo mô hình (ví dụ: mô hình hỗ trợ cả query và document encoding)
model = SentenceTransformer('all-MiniLM-L6-v2')

# Tập dữ liệu mẫu (Corpus)
corpus = [
    "Học máy là một lĩnh vực nghiên cứu cho phép máy tính có khả năng học hỏi.",
    "Mạng nơ-ron nhân tạo được lấy cảm hứng từ cấu trúc não bộ sinh học.",
    "Tàu thăm dò sao Hỏa là thiết bị được thiết kế để di chuyển trên bề mặt hành tinh."
]

# Mã hóa tài liệu (Document embeddings) - encode_document xử lý context dài
corpus_embeddings = model.encode_document(corpus, convert_to_tensor=True)

# Truy vấn của người dùng
query = "Mạng lưới thần kinh hoạt động như thế nào?"
# encode_query tối ưu cho các câu truy vấn ngắn
query_embedding = model.encode_query(query, convert_to_tensor=True)

# Sử dụng util.semantic_search (đã được tối ưu hóa hơn so với tính toán thủ công)
# convert_to_tensor=True giúp giữ tính toán trên GPU nếu khả dụng
hits = util.semantic_search(query_embedding, corpus_embeddings, top_k=2)

for hit in hits[0]:
    print(f"Tài liệu ID: {hit['corpus_id']} | Score: {hit['score']:.4f}")
Kiến trúc Two-Stage Retrieval: Bi-Encoder và Cross-Encoder
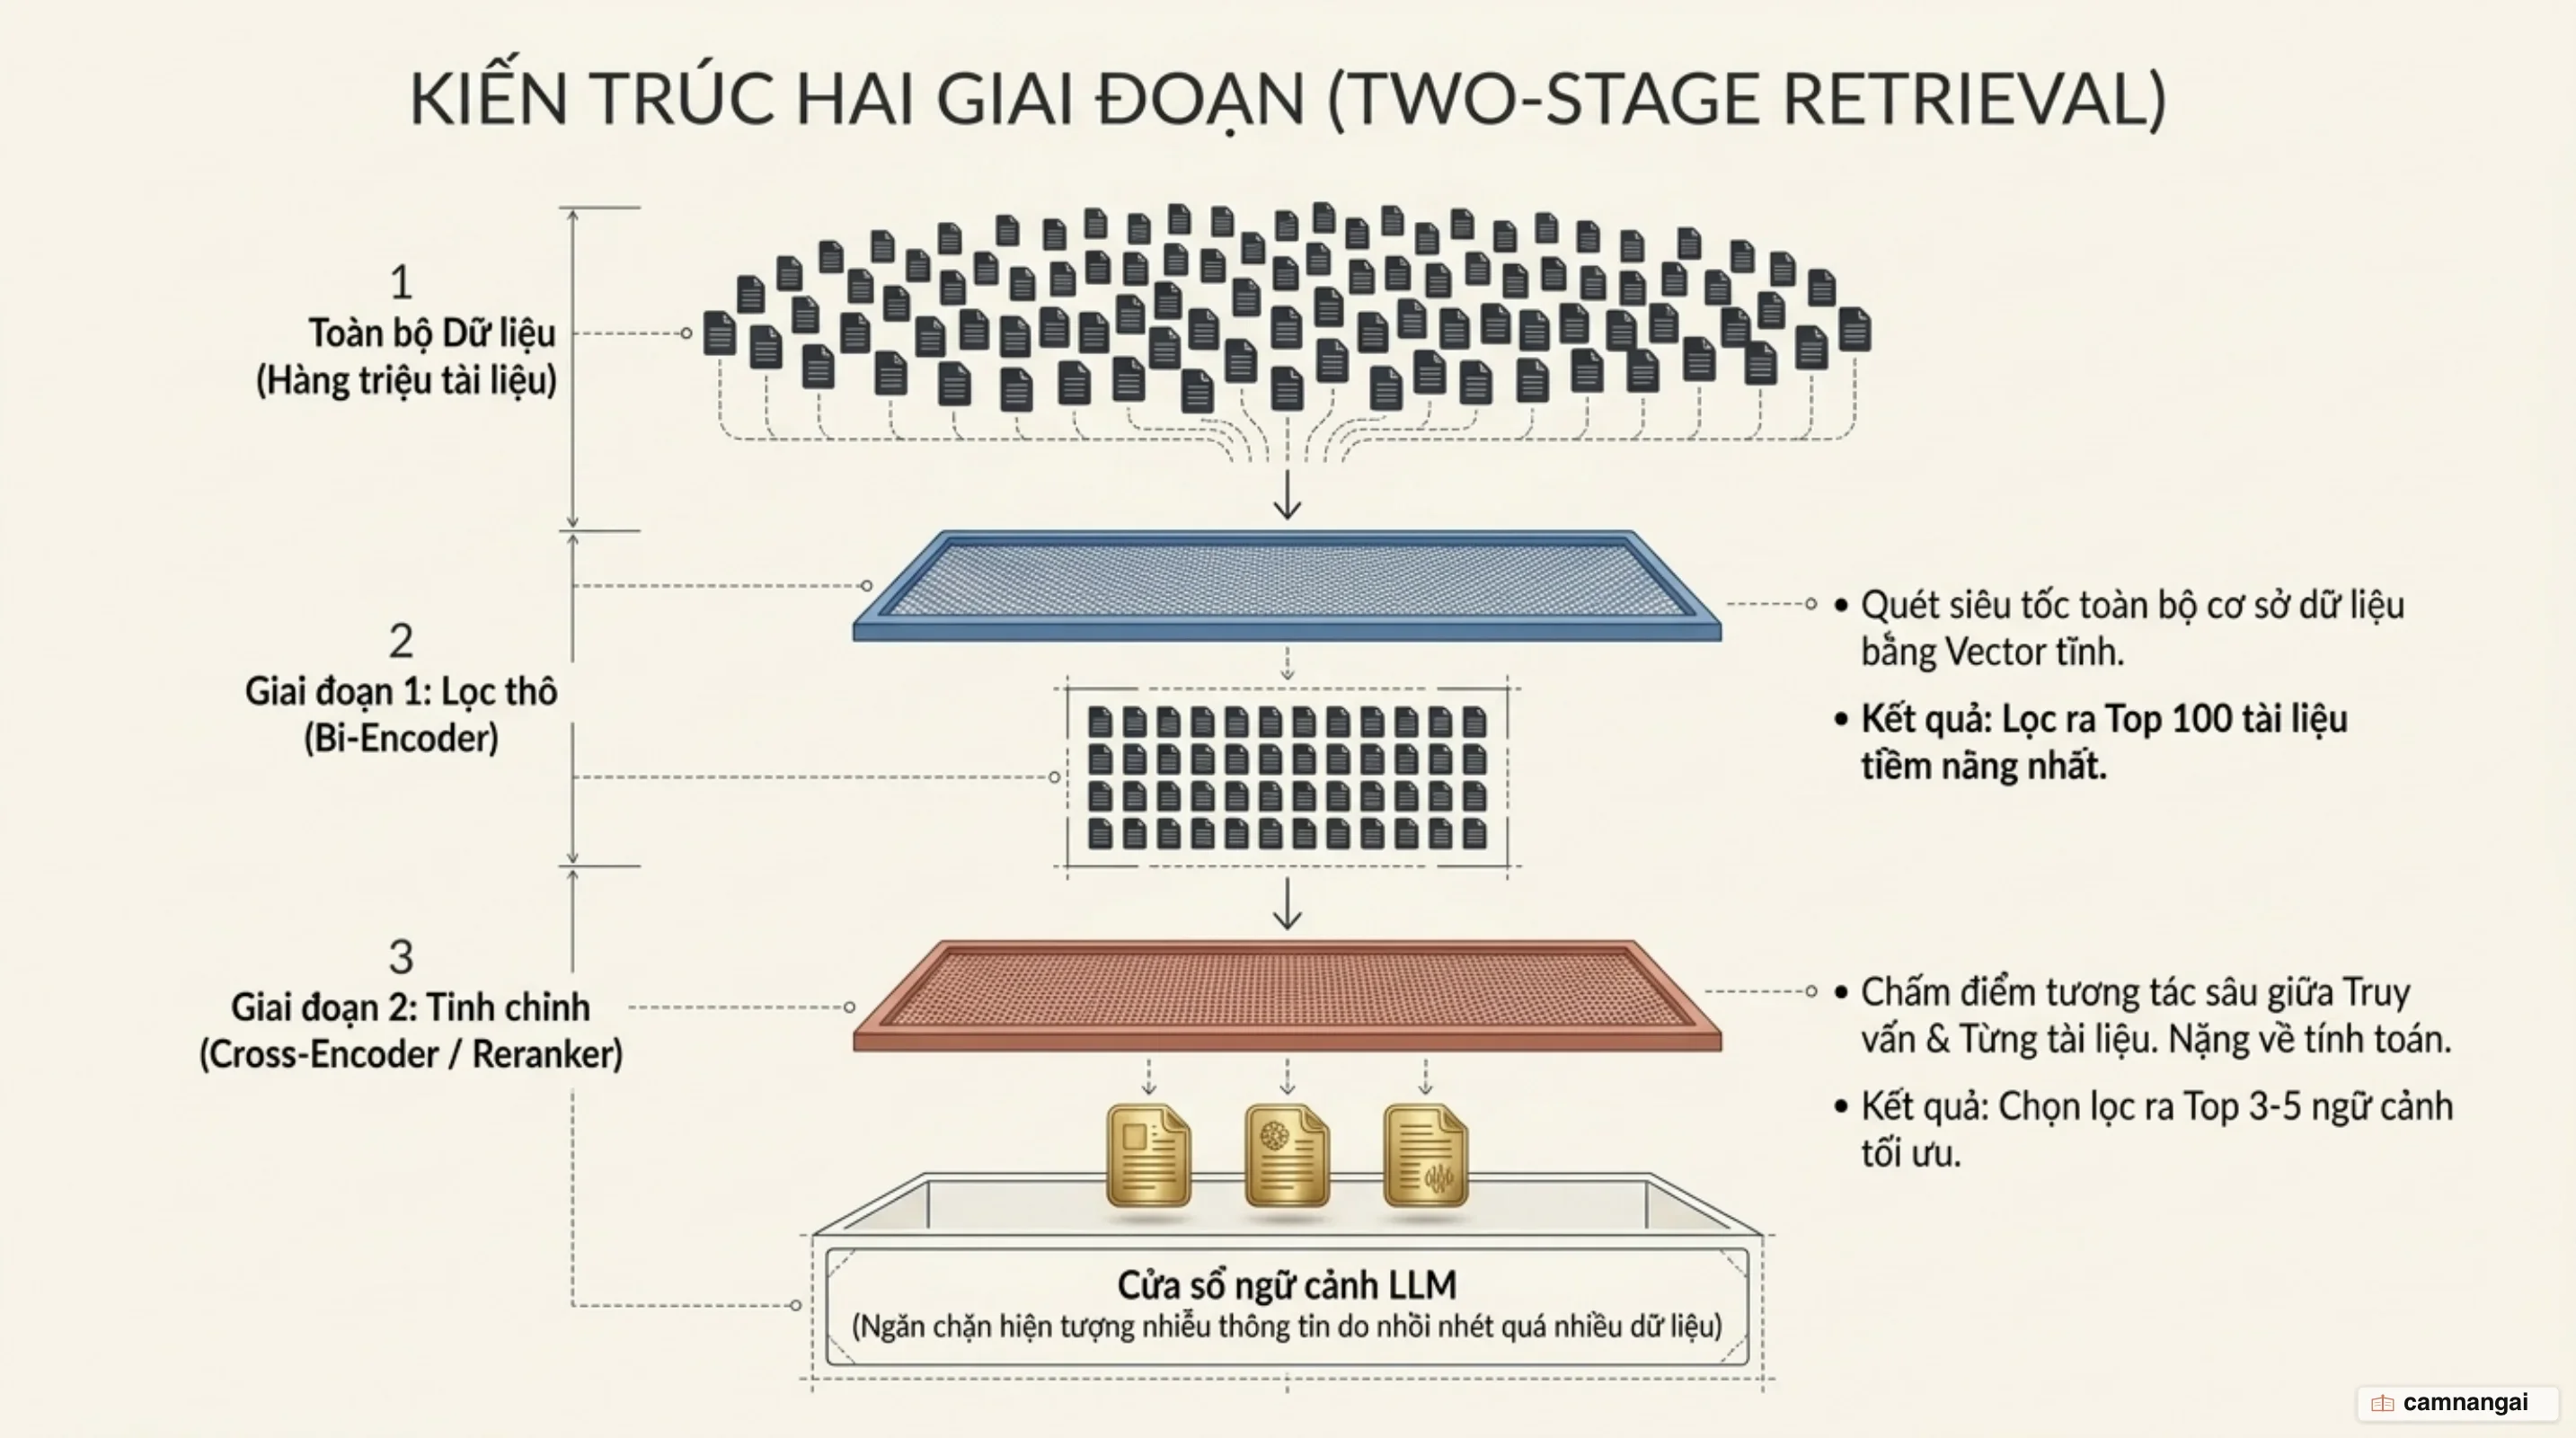
Trong thực tế, việc so sánh vector trên hàng triệu tài liệu vẫn tốn tài nguyên. Do đó, các hệ thống AI hiện đại lưu trữ dữ liệu trên vector database và sử dụng kiến trúc hai giai đoạn để tối ưu hóa đồng thời Recall và Precision.
Giai đoạn 1: Recall với Bi-Encoder
Bi-Encoder mã hóa truy vấn và tài liệu độc lập thành các vector. Các vector tài liệu được tính toán trước (pre-compute) và đánh chỉ mục bằng các kỹ thuật ANN (Approximate Nearest Neighbor) như HNSW hoặc Annoy. Mục tiêu chính ở giai đoạn này là tối đa hóa Recall@K, tức đảm bảo các tài liệu liên quan nhất nằm trong top 100 đến 200 kết quả đầu tiên. Ưu thế nằm ở tốc độ mili-giây và khả năng mở rộng quy mô lớn, dẫu việc nén thông tin thành vector cố định khó tránh khỏi việc thất thoát các sắc thái chi tiết.
Giai đoạn 2: Precision với Cross-Encoder (Reranker)
Cross-Encoder đưa đồng thời cặp truy vấn và tài liệu qua cơ chế Attention của Transformer. Mô hình không nén thông tin thành một vector đơn lẻ mà tính toán trực tiếp sự tương tác giữa từng từ trong câu hỏi với từng từ trong văn bản. Cách này giúp tối đa hóa độ chính xác và thứ hạng (NDCG). Đổi lại, độ chính xác rất cao đòi hỏi chi phí tính toán lớn, nên trong thực tế hệ thống chỉ chuyển từ 100 đến 200 tài liệu tiềm năng nhất từ giai đoạn Recall sang cho Reranker xử lý.
Ví dụ sử dụng Reranker để tinh chỉnh kết quả từ giai đoạn Recall:
# Giả định 'docs' là top kết quả từ Bi-Encoder
query = "RLHF là gì và tại sao nó quan trọng?"
documents = ["Văn bản 1...", "Văn bản 2...", "Văn bản 3..."]

# Gọi API Rerank (ví dụ theo cấu trúc Cohere/Pinecone)
rerank_results = pc.inference.rerank(
    model="bge-reranker-v2-m3",
    query=query,
    documents=documents,
    top_n=3,
    return_documents=True
)

for result in rerank_results.data:
    print(f"Thứ hạng mới: {result.index} | Score: {result.score:.4f}")
Các "điểm mù" và Giới hạn thực tế
Dù mạnh mẽ, tìm kiếm ngữ nghĩa thuần túy vẫn có những điểm yếu mà một kỹ sư hạ tầng cần lường trước:
- Lỗi Mã định danh và SKU: Các mô hình embedding thường xử lý kém các chuỗi ký tự đặc thù như mã sản phẩm (SKU), mã lỗi kỹ thuật (ví dụ:
0x8004210B) hoặc tên riêng quá mới. Các token này thường bị coi là out-of-vocabulary hoặc bị ánh xạ vào các vùng vector không chính xác. - Semantic Drift (Trôi dạt ngữ nghĩa): Đây là bẫy phổ biến nhất. Vector search có thể trả về các đoạn văn bản có sự tương đồng về chủ đề nhưng sai lệch về tính xác thực. Ví dụ: Một tài liệu nói về "Doanh thu tăng trưởng" và một tài liệu nói về "Doanh thu sụt giảm" sẽ có vector nằm rất gần nhau vì chúng cùng thuộc chủ đề tài chính, dù ý nghĩa thực tế là trái ngược.
- Thuật ngữ chuyên ngành (Out-of-domain): Nếu mô hình được huấn luyện trên dữ liệu thông thường nhưng được sử dụng để tìm kiếm trong kho dữ liệu y khoa hoặc luật pháp chuyên sâu, hiệu quả truy hồi sẽ giảm đáng kể.
Hybrid Search và Thuật toán Reciprocal Rank Fusion (RRF)
Để giải quyết các điểm mù trên, chuẩn mực hiện nay là Hybrid Search kết hợp kết quả từ Sparse Retrieval (BM25) và Dense Retrieval (Vector).
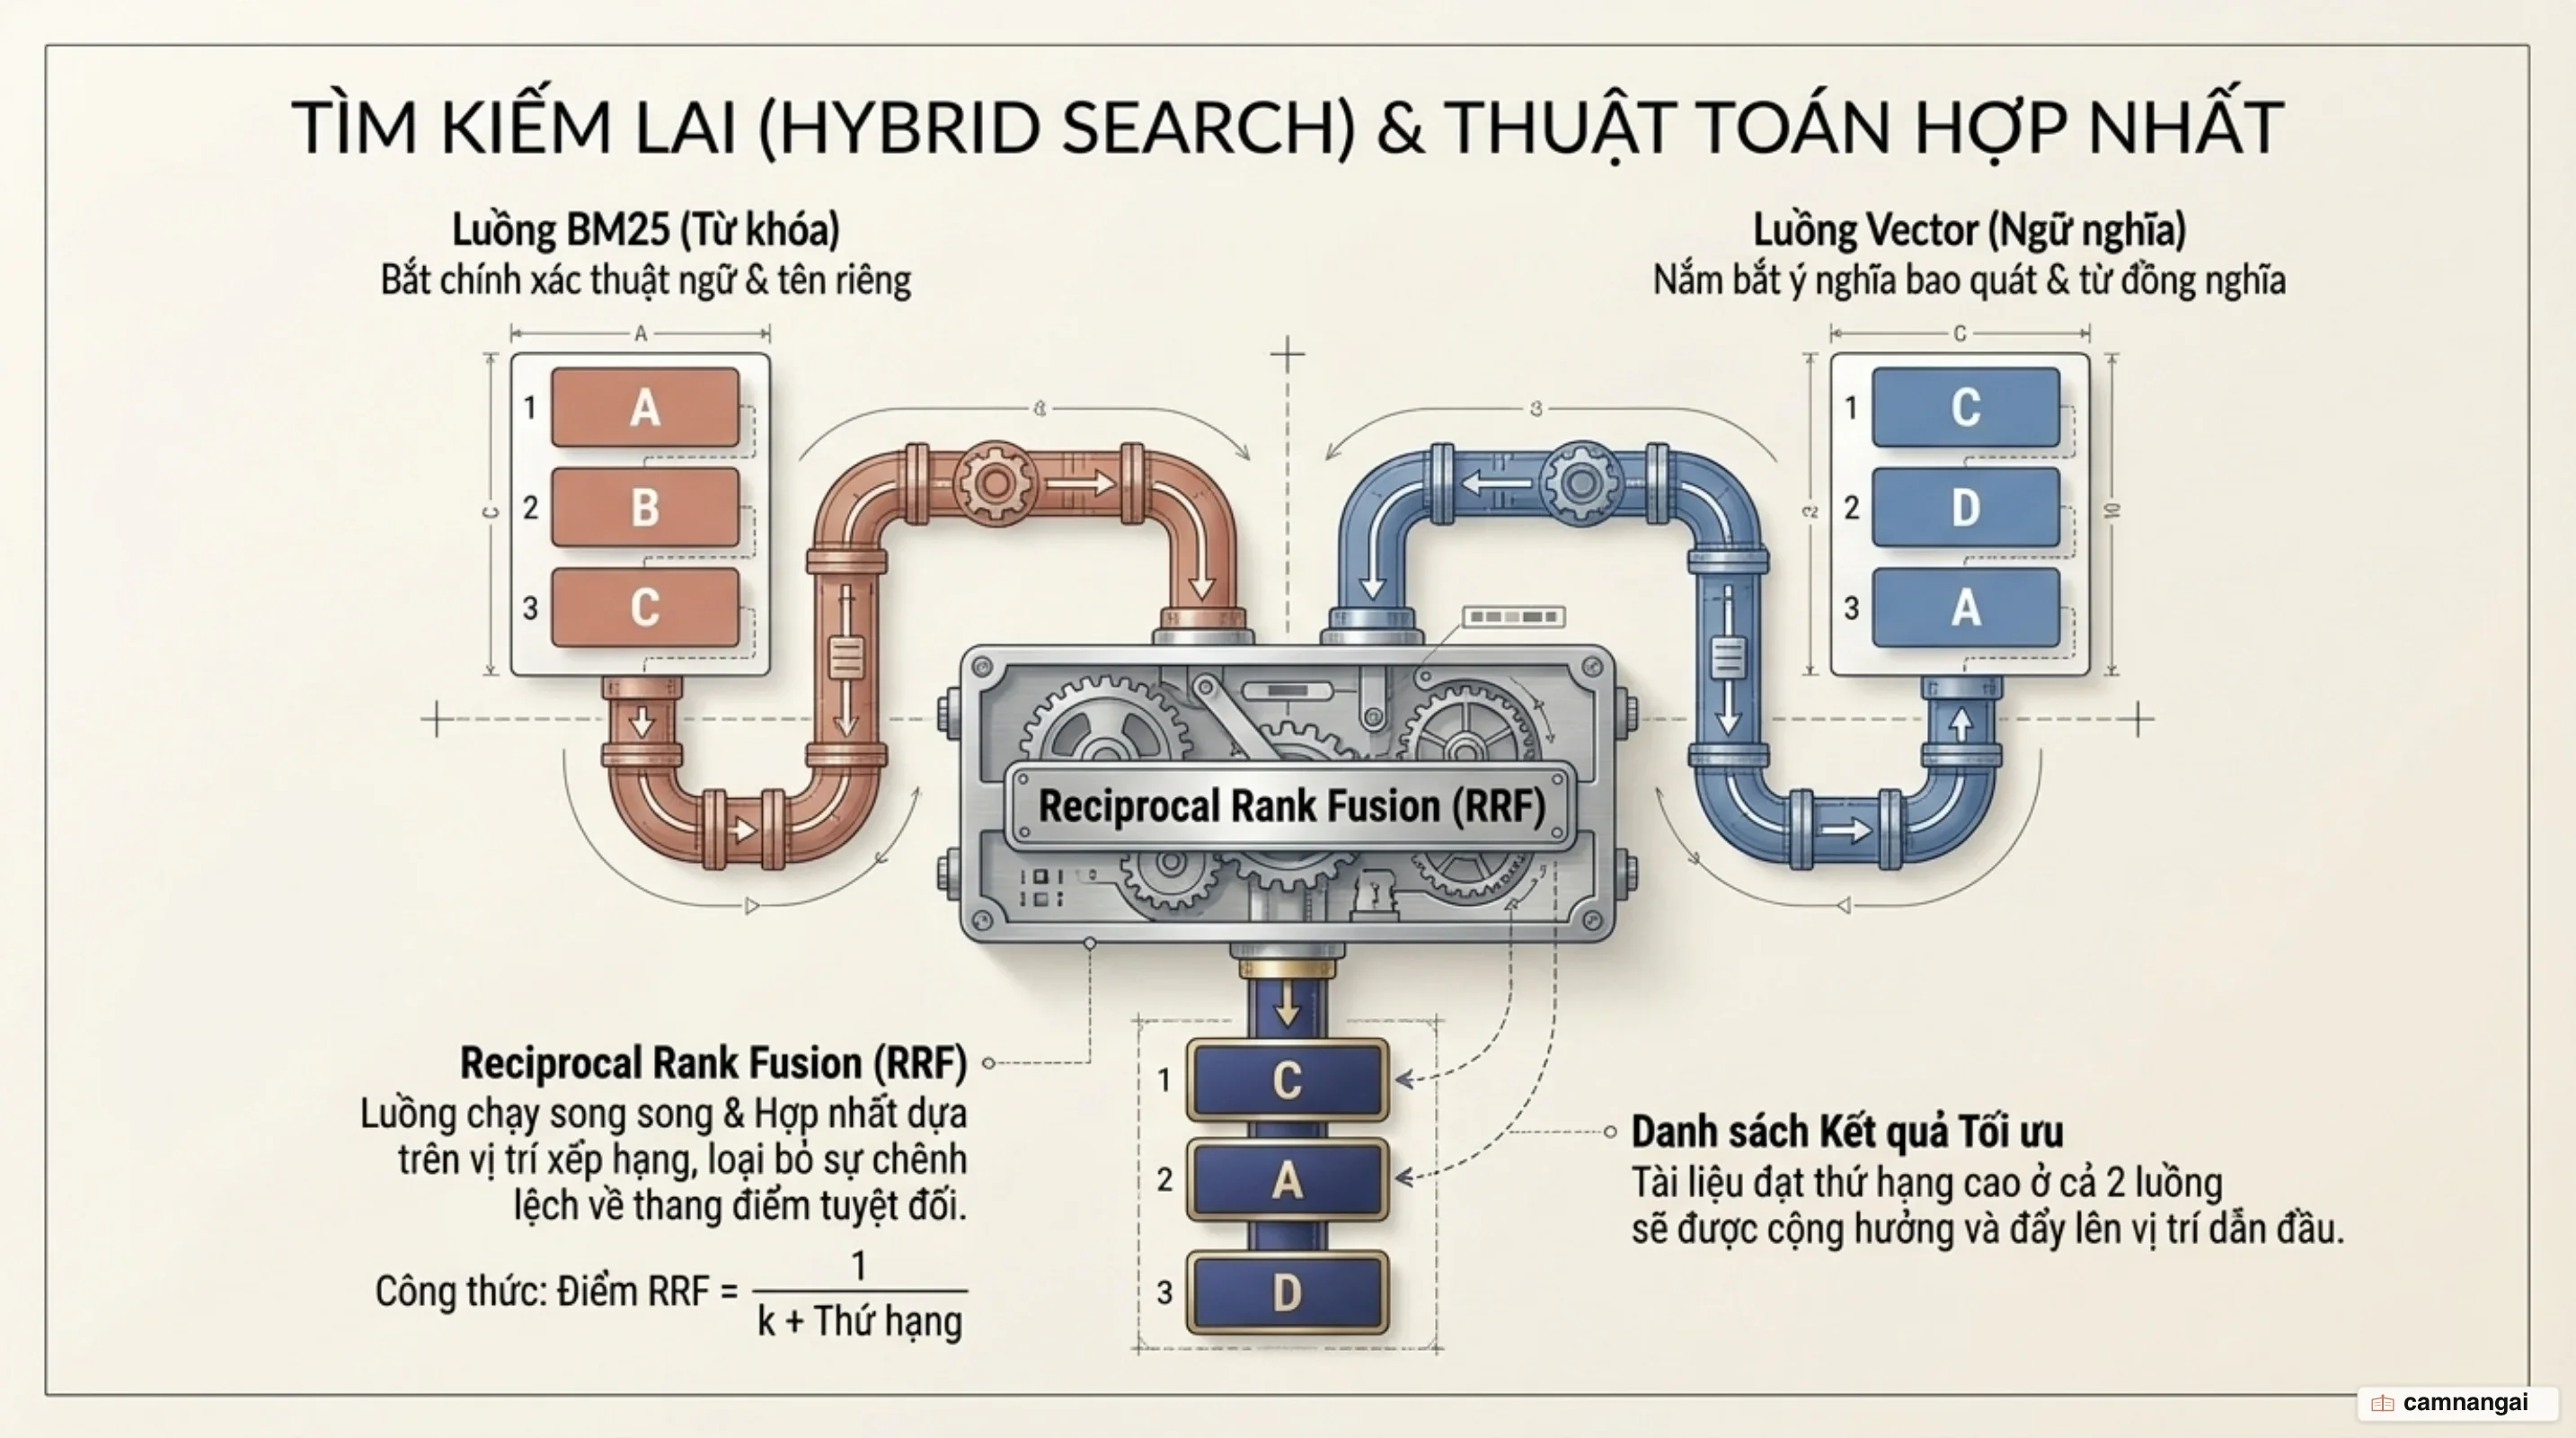
Để trộn hai danh sách kết quả có thang điểm khác nhau, thuật toán Reciprocal Rank Fusion (RRF) được sử dụng. RRF tính điểm dựa trên thứ hạng (rank) của tài liệu thay vì điểm số thô, giúp hệ thống ổn định hơn mà không cần tinh chỉnh trọng số thủ công liên tục.
Công thức tính điểm RRF:
score(d) = sum(1 / (k + r(d)))
Trong đó hằng số k thường được đặt là 60 (con số tiêu chuẩn trong Weaviate và Elasticsearch) để giảm thiểu tác động của các tài liệu có thứ hạng quá thấp lên kết quả cuối cùng.
Cấu hình Hybrid Search trong Weaviate minh họa sự khác biệt giữa các kiểu fusion:
response = (
    client.query
    .get("Article", ["title", "content"])
    .with_hybrid(
        query="hướng dẫn cài đặt SKU-9921",
        # Alpha=0.5 cân bằng trọng số khi dùng relativeScoreFusion
        alpha=0.5,
        # Sử dụng rankedFusion để áp dụng thuật toán RRF (không phụ thuộc alpha)
        fusion_type="rankedFusion"
    )
    .do()
)
Architectural Decision Record: Lựa chọn kiến trúc tối ưu
Việc quyết định kiến trúc tìm kiếm cần dựa trên kịch bản thực tế thay vì chạy theo mô hình phức tạp nhất:
- Với hệ thống FAQ tổng quát, sử dụng ngôn ngữ tự nhiên: Vector Search thuần túy (Dense Retrieval) là đủ, vì ưu tiên hàng đầu là hiểu ý định người dùng và dữ liệu không chứa nhiều mã định danh hay thuật ngữ đặc thù.
- Với bài toán tìm kiếm sản phẩm thương mại điện tử hoặc tài liệu kỹ thuật: Bắt buộc dùng Hybrid Search (BM25 kết hợp Vector). Bạn cần sự chính xác tuyệt đối với mã SKU, mã lỗi từ BM25, đồng thời vẫn giữ được khả năng bắt ý nghĩa của vector. RRF giúp hai nhánh này dung hòa mà không cần tốn công căn chỉnh alpha liên tục.
- Với hệ thống RAG yêu cầu độ chính xác tối đa cho LLM: Kết hợp Hybrid Search với Cross-Encoder Reranker. Hệ thống dùng Hybrid để đạt Recall@100, sau đó dùng Reranker lọc ra top 3 đến 5 ngữ cảnh chuẩn xác nhất, loại bỏ tạp âm trước khi nạp vào cửa sổ ngữ cảnh của mô hình ngôn ngữ lớn.
Các kỹ sư nên bắt đầu bằng việc đo lường Recall@K để đánh giá giai đoạn Recall và NDCG để đánh giá giai đoạn Rerank trước khi quyết định nâng cấp hạ tầng.
Tài liệu tham khảo
- Pinecone Learn: Semantic Search: Measuring Meaning From Jaccard to Bert
- Google Cloud: What is semantic search, and how does it work?
- Sentence Transformers: Semantic Search with Sentence Transformers
- Pinecone Learn: Rerankers and Two-Stage Retrieval
- Weaviate Blog: Hybrid Search Explained
- Weaviate Blog: Unlocking the Power of Hybrid Search - A Deep Dive into Weaviate's Fusion Algorithms
- Cohere: Semantic Search with Embeddings