Anomaly Detection bằng Vector Embeddings là kỹ thuật chuyển đổi dữ liệu thô (văn bản, hình ảnh, logs) thành các chuỗi số đa chiều, sau đó sử dụng các phép đo khoảng cách toán học để xác định các điểm dữ liệu nằm ngoài phân phối thông thường.
Thay vì dựa trên các quy tắc cứng (rules) dễ bị qua mặt, phương pháp này tìm kiếm sự bất thường dựa trên ý nghĩa ngữ nghĩa và vị trí tương đối trong không gian vector.
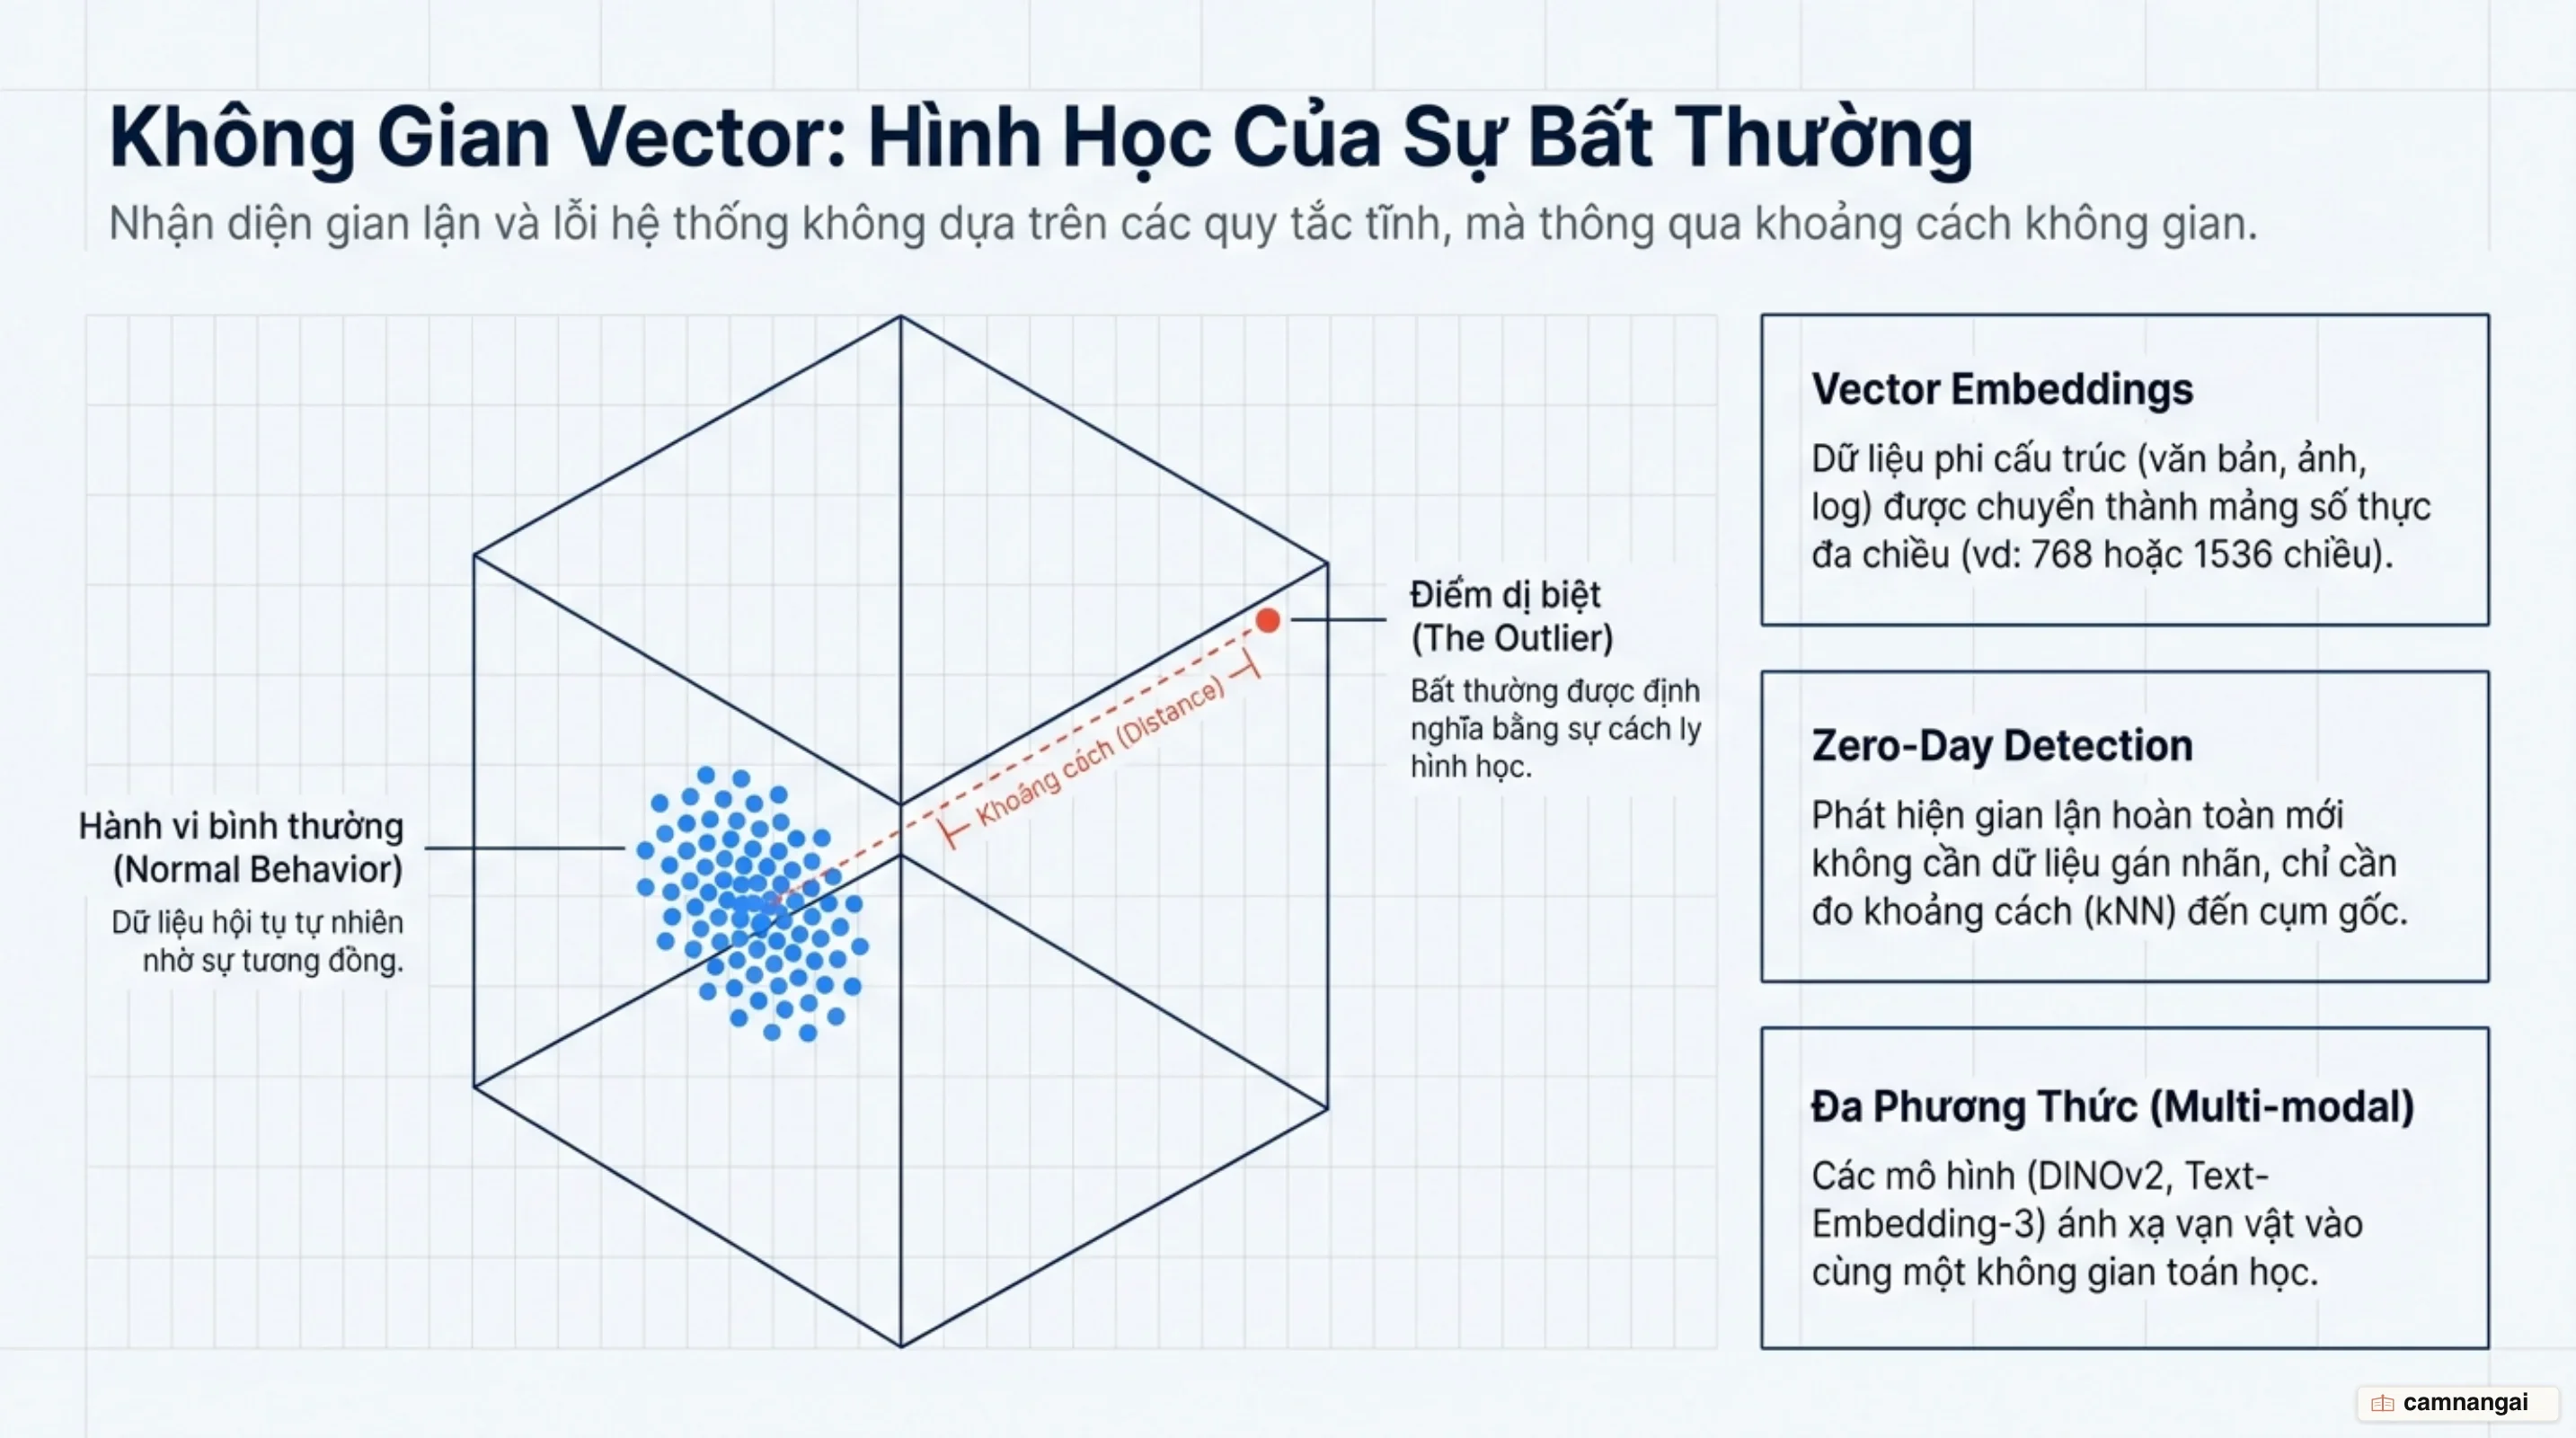
Cơ chế vận hành của hệ thống dựa trên một logic hình học trực quan: khoảng cách ngắn = bình thường, khoảng cách dài = bất thường. Trong không gian đa chiều, các thực thể dữ liệu có nội dung hoặc hành vi tương đồng sẽ "cụm" lại gần nhau. Ngược lại, các điểm dữ liệu lạ hoặc có dấu hiệu gian lận sẽ bị đẩy ra xa các cụm baseline này. Điều này cho phép kiến trúc sư hệ thống xây dựng các cơ chế phòng thủ linh hoạt, tự động nhận diện các biến thể gian lận mới mà không cần cập nhật luật thủ công.
Vì sao phương pháp phát hiện bất thường truyền thống gặp khó với dữ liệu phi cấu trúc?
Các thủ đoạn gian lận kỹ thuật số đang biến đổi nhanh hơn nhiều so với khả năng thích ứng của các hệ thống cũ. Theo báo cáo "2026 State of Document Fraud" của Inscribe, các vụ giả mạo do trí tuệ nhân tạo (AI) tạo ra đã tăng gấp 5 lần chỉ trong giai đoạn cuối năm 2025. Hiện nay, trung bình 1/16 tài liệu được xử lý trong các tổ chức tài chính có dấu hiệu giả mạo. Các hệ thống dựa trên luật (rule-based) cũ kỹ đang sụp đổ trước áp lực này, khi việc rà soát thủ công tốn tới 30 phút cho mỗi hồ sơ, tạo ra một nút thắt cổ chai nghiêm trọng về vận hành và chi phí.
Vấn đề cốt lõi nằm ở "lời nguyền đa chiều" (curse of dimensionality) và sự bùng nổ của dữ liệu phi cấu trúc. Việc chọn lọc đặc trưng thủ công (manual feature engineering) trở nên bất khả thi với các tệp dữ liệu như hình ảnh hay văn bản tự do, vốn chứa hàng triệu thuộc tính tiềm ẩn. Các phương pháp truyền thống không thể bắt kịp tính thích ứng (Adaptability) của các thủ đoạn deepfake hoặc chỉnh sửa tài liệu tinh vi ở mức pixel. Khi các thuộc tính dữ liệu thay đổi liên tục, hệ thống dựa trên luật sẽ nhanh chóng mất đi tính nhất quán (Consistency) và khả năng mở rộng (Scale).
Dưới góc độ kỹ thuật, việc duy trì hàng ngàn bộ quy tắc "nếu-thì" cho các trường hợp gian lận khác nhau vừa gây tốn kém, vừa làm tăng tỷ lệ báo động giả (false positives). Một hệ thống hạ tầng trí tuệ nhân tạo (AI Infrastructure) hiện đại cần khả năng tự động hóa việc trích xuất đặc trưng và định lượng hóa sự tương đồng ngữ nghĩa. Vector Embeddings giải quyết triệt để vấn đề này bằng cách biến mọi thuộc tính định tính thành một tọa độ chính xác trong không gian toán học, giúp hệ thống "hiểu" được bản chất dữ liệu thay vì chỉ đối khớp từ khóa đơn thuần.
Không gian vector biến bài toán phát hiện bất thường thành bài toán khoảng cách như thế nào?
Trong kiến trúc AI, Vector là một cấu trúc toán học dạng mảng chứa các giá trị số (ví dụ: [0, -2, ... 4]). Mô hình nhúng (Embedding Model) đóng vai trò như một mạng nơ-ron đã được loại bỏ lớp phân loại cuối cùng (last layer removed). Thay vì đưa ra một nhãn cụ thể, nó trích xuất các đặc trưng tiềm ẩn của dữ liệu thô để tạo ra một bản đại diện số học. Quá trình này giúp chuyển đổi các thực thể trừu tượng thành các điểm dữ liệu có thể tính toán được vị trí tương đối.
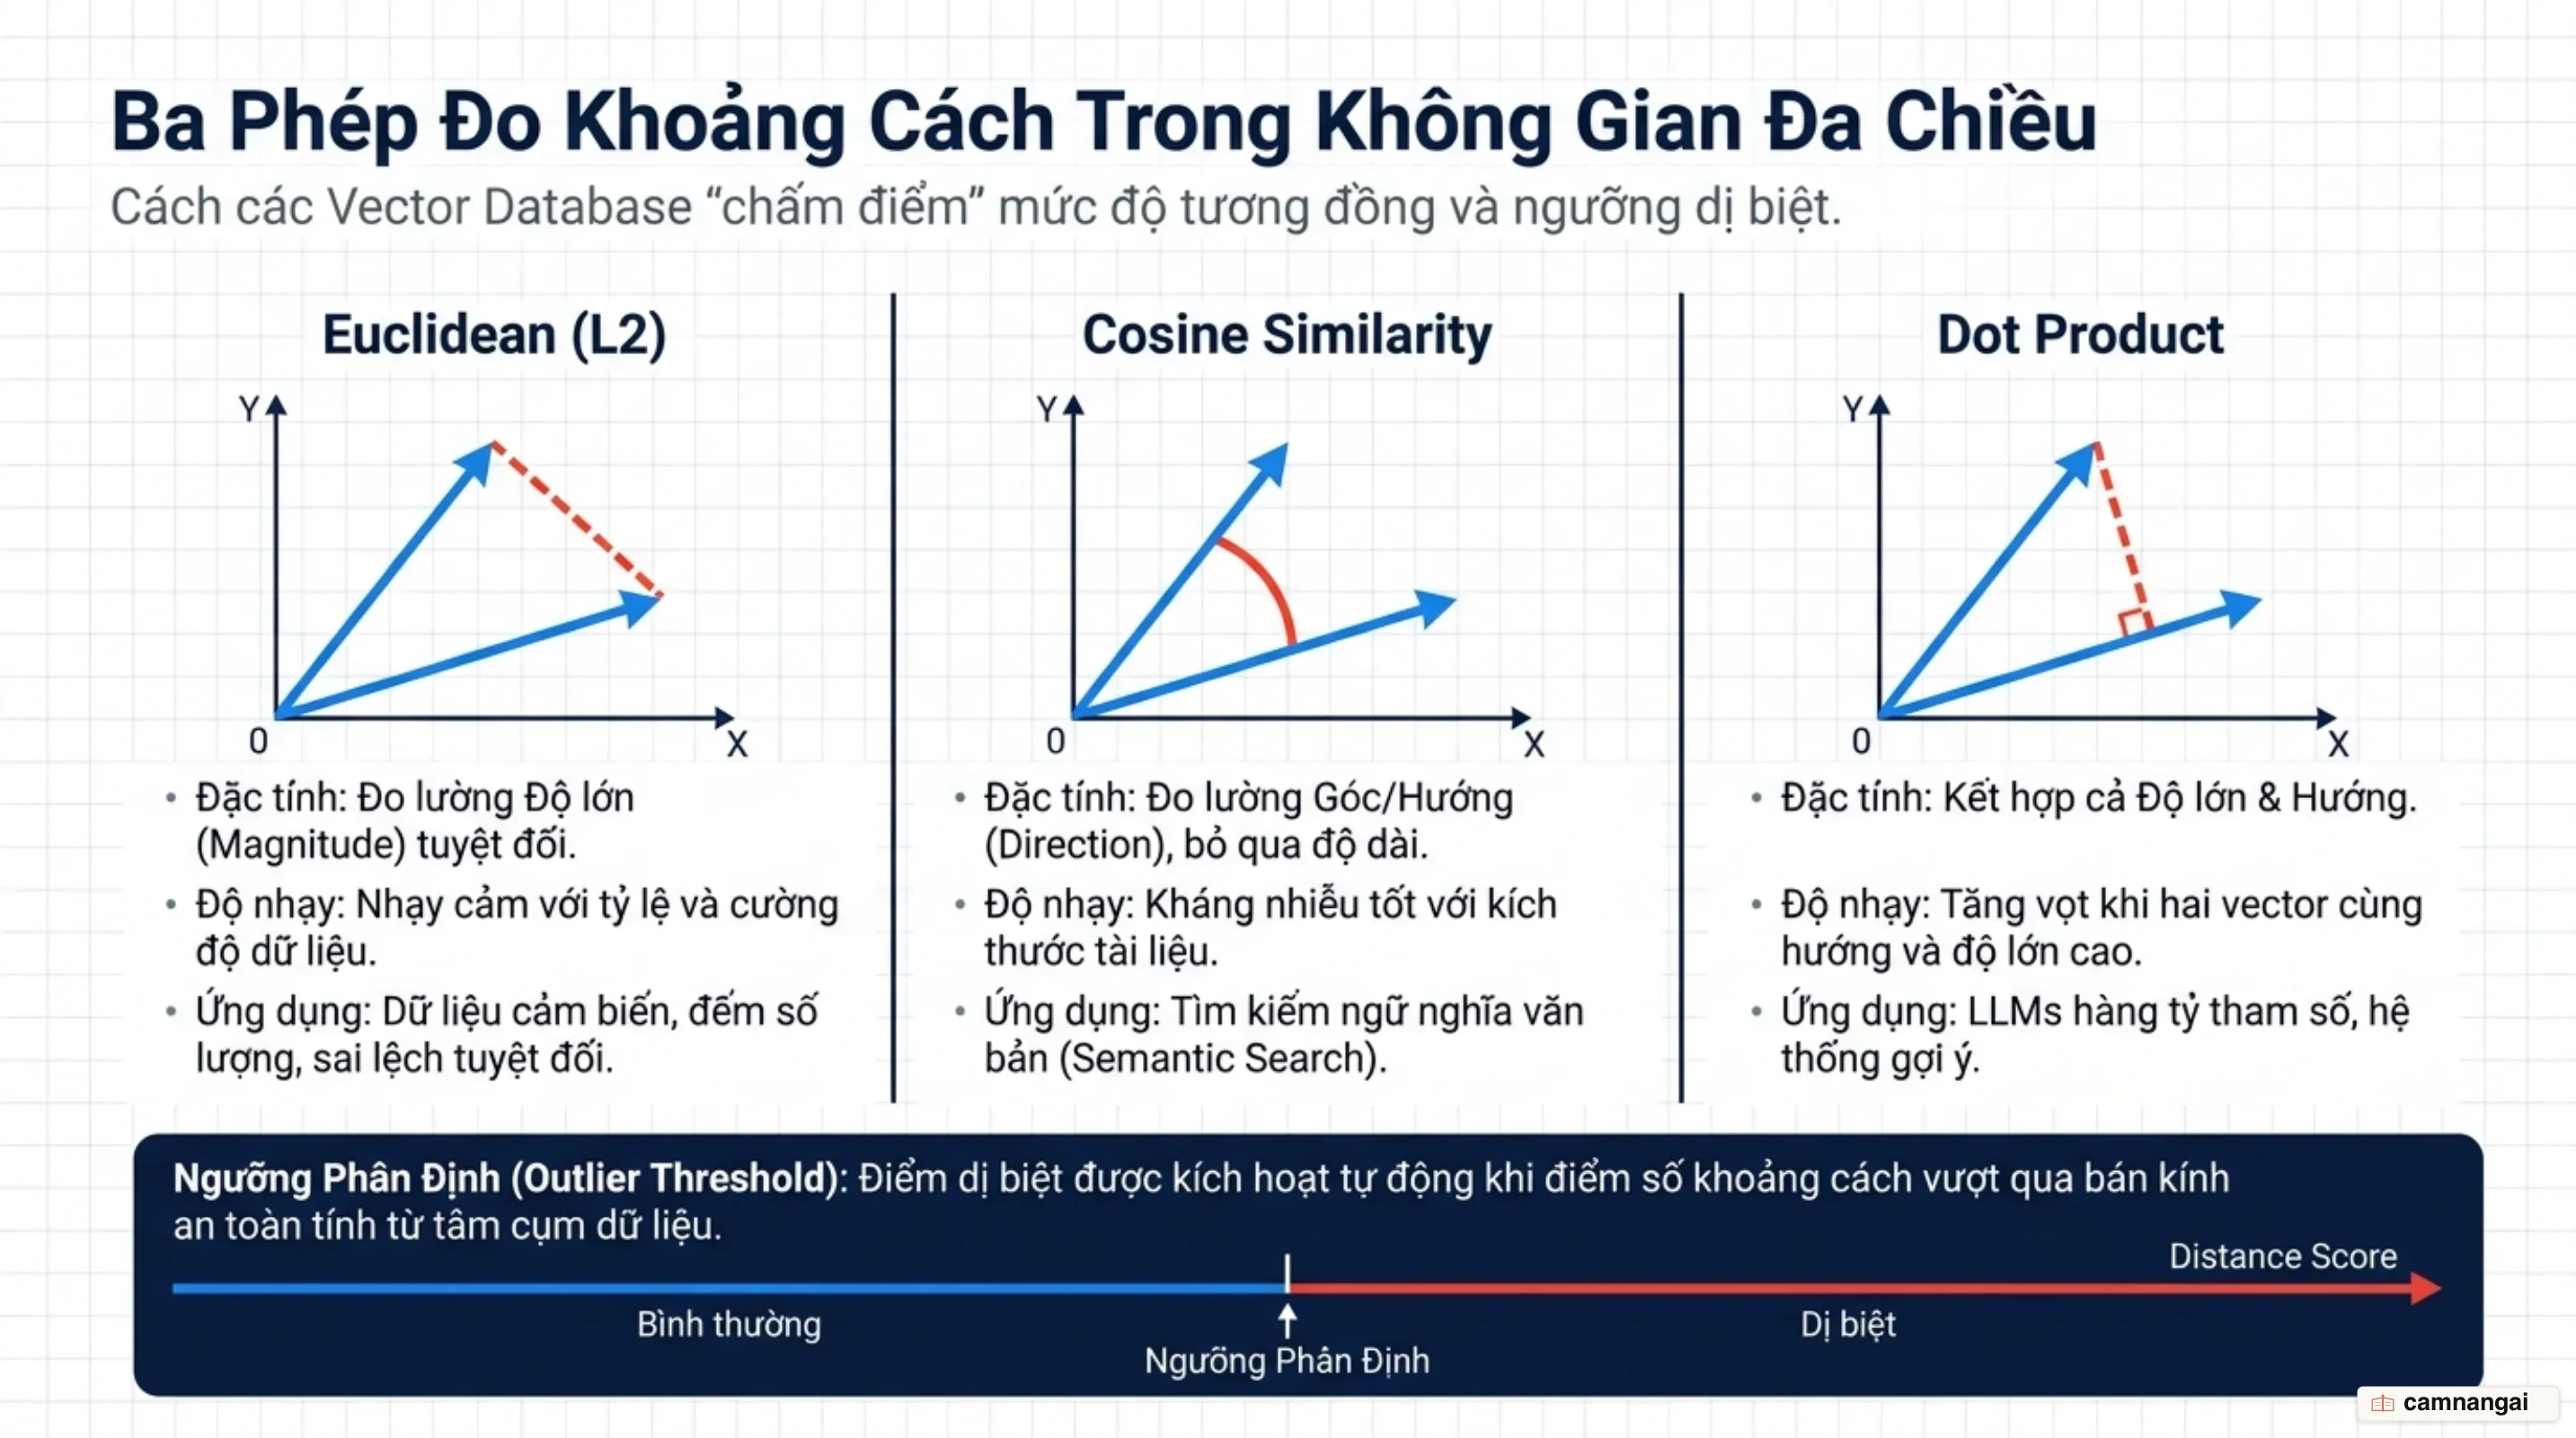
Để xác định sự bất thường trong bài toán Anomaly Detection, chúng ta sử dụng ba phép đo khoảng cách chính:
- Euclidean: Đo khoảng cách đường thẳng giữa hai điểm. Phép đo này cực kỳ nhạy cảm với độ lớn (magnitude), phù hợp cho các bài toán mà cường độ của dữ liệu mang thông tin quan trọng.
- Cosine: Đo góc giữa các vector để xác định sự tương đồng về hướng và ngữ nghĩa. Đây là phép đo chuẩn cho văn bản vì nó không bị ảnh hưởng bởi độ dài của tài liệu.
- Dot Product: Kết hợp cả độ lớn và hướng. Một lưu ý quan trọng cho các kỹ sư: nếu muốn Dot Product hoạt động tương đương với Cosine Similarity, bạn phải thực hiện chuẩn hóa (normalization) các vector trước khi tính toán.
Logic toán học này biến các bài toán logic phức tạp thành các phép tính hình học đơn giản: dữ liệu bình thường sẽ tạo thành các cụm (clusters) dày đặc, trong khi dữ liệu bất thường là những điểm đơn lẻ bị đẩy ra xa. Bằng cách thiết lập một ngưỡng (threshold) khoảng cách, hệ thống có thể ngay lập tức gắn thẻ một thực thể là "outlier" nếu nó nằm ngoài phạm vi phân phối của baseline đã biết.
Các chiến lược phát hiện bất thường phổ biến trên Vector Embeddings
Phương pháp hiệu quả nhất hiện nay là chiến lược hai bước (Two-step approach): đầu tiên là nhúng (Embed) và sau đó là phát hiện (Detect). Cách tiếp cận này đã được chứng minh trong các nghiên cứu như NLP-ADBench và TAD-Bench là hiệu quả hơn hẳn các mô hình end-to-end cứng nhắc nhờ tính linh hoạt trong việc lựa chọn encoder và detector.
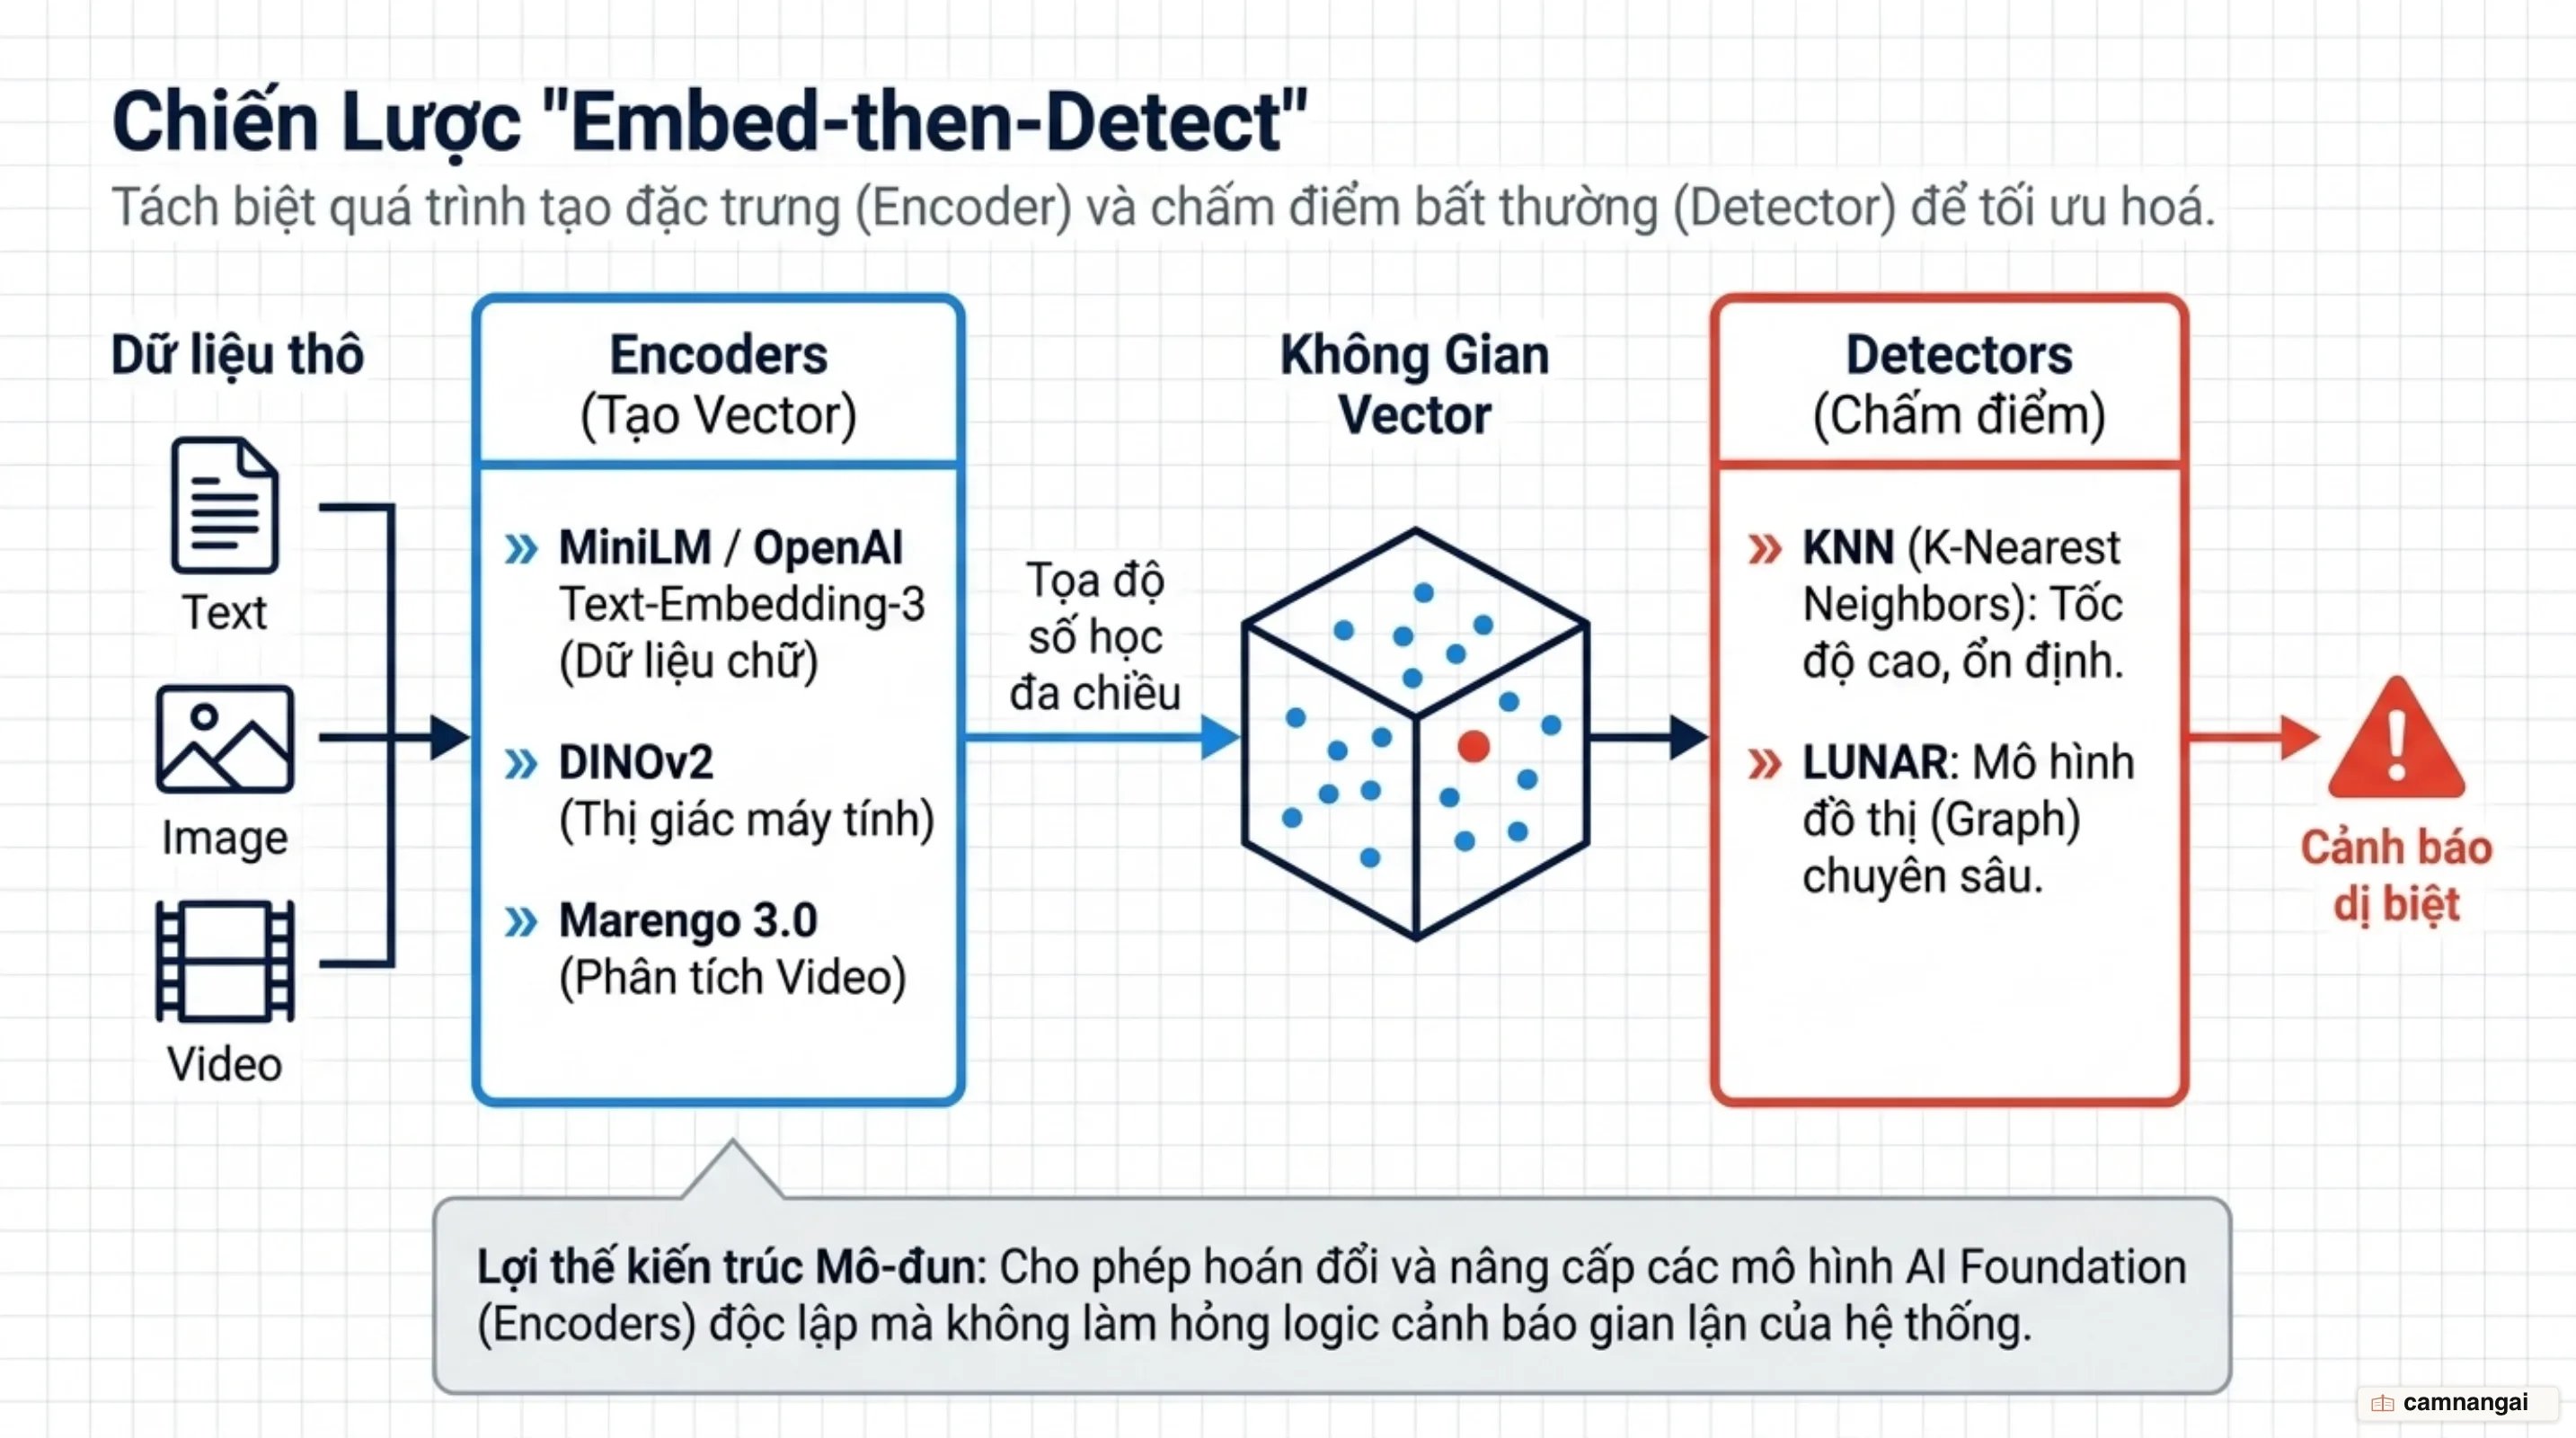
Các tổ hợp công nghệ phổ biến thường sử dụng các encoder như MiniLM (384d) cho hiệu suất cao, DINOv2 cho hình ảnh, hoặc OpenAI Large (3072d) cho các bài toán yêu cầu độ chi tiết ngữ nghĩa cao nhất. Các vector này sau đó được đưa vào các thuật toán phát hiện chuyên dụng như KNN, Isolation Forest (IForest), hoặc LUNAR. Trong đó, LUNAR thường đạt hiệu quả tốt nhất trong các bài thử nghiệm văn bản nhờ khả năng học phân phối dữ liệu cục bộ (local distribution) tốt hơn so với các mô hình học phân phối toàn cục. Để xử lý các hồ sơ đa phương tiện, kỹ thuật MultiModalOD được sử dụng để hợp nhất điểm số bất thường từ cả ảnh và chữ thành một chỉ số rủi ro duy nhất.
Dưới đây là pipeline minh họa sử dụng thư viện PyOD với class EmbeddingOD:
from pyod.models.embedding import EmbeddingOD

# Cấu hình pipeline: Sử dụng MiniLM để nhúng và KNN để phát hiện
# Chiến lược 'Embed then Detect' đạt hiệu quả cao trên NLP-ADBench
clf = EmbeddingOD(encoder='all-MiniLM-L6-v2', detector='KNN')

# Huấn luyện trên tập baseline (dữ liệu bình thường)
clf.fit(train_data)

# Trích xuất điểm số rủi ro và nhãn dự đoán (0: bình thường, 1: bất thường)
anomaly_scores = clf.decision_function(test_data)
labels = clf.predict(test_data)
Kiến trúc triển khai với Vector Database: Từ lưu trữ baseline đến truy vấn thời gian thực
Kiến trúc triển khai hiện đại bắt đầu với việc lưu trữ dữ liệu thô trên Amazon S3, sau đó được điều phối bất đồng bộ qua hàng đợi SQS/Celery để đảm bảo tính sẵn sàng. Dữ liệu văn bản sẽ được trích xuất qua Amazon Textract, trong khi các vector nhúng được tạo ra thông qua Amazon Bedrock. Toàn bộ luồng xử lý từ lúc người dùng tải lên đến khi nhận kết quả đánh giá rủi ro được tối ưu để hoàn tất trong dưới 90 giây.
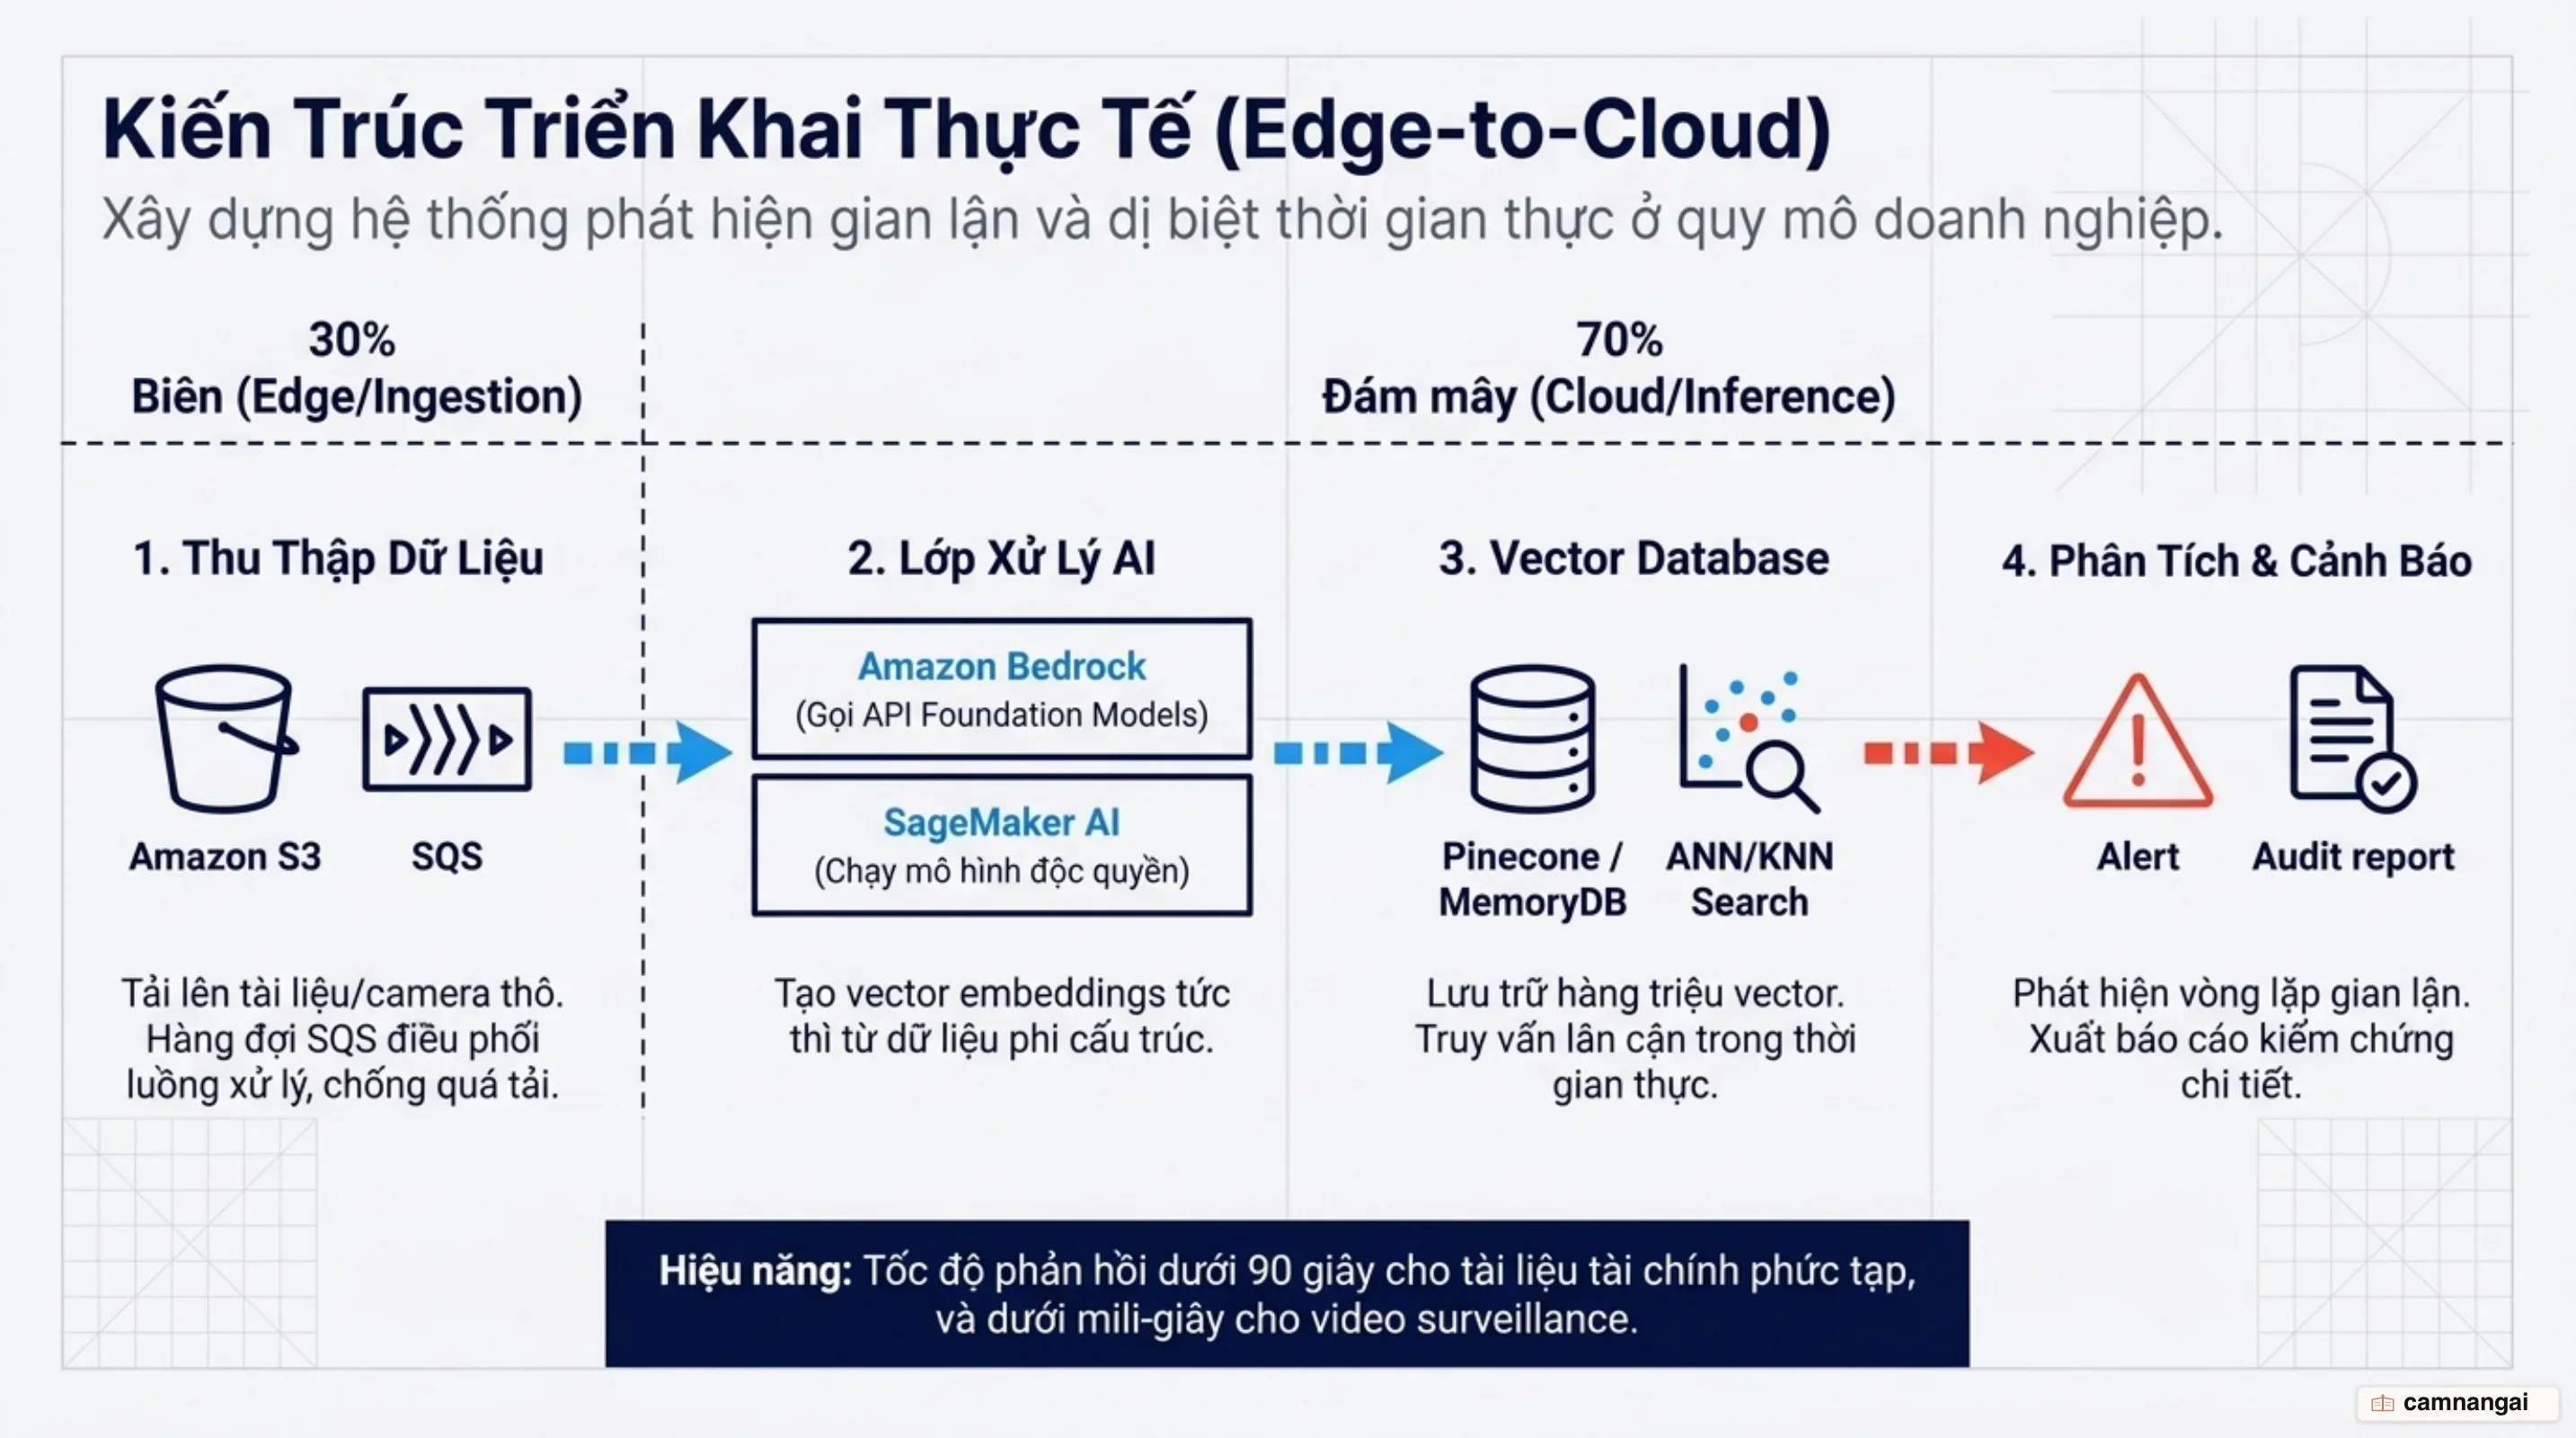
Vai trò then chốt trong hạ tầng này là Vector Database (như Amazon MemoryDB, Cloudflare Vectorize hoặc Pinecone). Nó đóng vai trò là "trí nhớ dài hạn", lưu trữ các vector baseline và cho phép thực hiện truy vấn KNN/ANN chỉ trong vài mili giây. Việc sử dụng Vector Database giúp hệ thống không phải tính toán lại toàn bộ dữ liệu mỗi khi có truy vấn mới, từ đó duy trì tốc độ phản hồi cực nhanh ngay cả khi quy mô dữ liệu lên tới hàng triệu bản ghi.
Một nguyên tắc "vàng" trong thiết kế hệ thống là khớp phép đo khoảng cách (distance metric) của index với phép đo được dùng trong huấn luyện mô hình nhúng. Ví dụ, nếu bạn sử dụng các mô hình của OpenAI vốn mặc định dùng Cosine Similarity, thì index của bạn cũng phải cấu hình theo Cosine. Sự sai lệch giữa metric của index và model sẽ trực tiếp dẫn đến việc giảm độ chính xác và làm mất đi các tín hiệu bất thường tinh vi trong không gian đa chiều.
Ứng dụng thực tế: Từ phát hiện gian lận tài chính đến giám sát an ninh mạng
Hệ thống phát hiện bất thường qua vector đã chứng minh hiệu quả kinh tế rõ rệt thông qua các số liệu case study. BHG Financial đã giảm được 90% thời gian rà soát thủ công bằng cách tự động hóa các bước kiểm tra sơ bộ. Logix Federal Credit Union ngăn chặn hơn 3 triệu USD gian lận trong 8 tháng đầu triển khai nhờ phát hiện kịp thời các tài liệu giả mạo bằng AI. Đặc biệt, BCU đã ngăn chặn thành công 5,6 triệu USD bằng cách nhận diện các mạng lưới gian lận (fraud rings) thông qua việc đối chiếu các đặc trưng vector tương đồng giữa các hồ sơ tưởng chừng như không liên quan.
Hệ thống cho phép các tổ chức vận hành ở quy mô từ 10 đến 10.000 hồ sơ/ngày mà không cần tăng nhân sự tương ứng. Khả năng phát hiện các tín hiệu tinh vi bao gồm:
- Forensics mức Pixel: Sử dụng các mô hình độc quyền (proprietary models) được host trên Amazon SageMaker AI để phát hiện các dấu hiệu chỉnh sửa ảnh và giả mạo chữ ký mà mắt thường không thể thấy.
- Phân tích ngữ cảnh: Phát hiện sự mâu thuẫn giữa thông tin trong căn cước công dân và các bảng sao kê ngân hàng thông qua việc nhúng toàn bộ bộ hồ sơ vào không gian ngữ nghĩa chung.
- Phát hiện chuỗi gian lận: Liên kết các hồ sơ có các đặc trưng vector gần nhau để bẻ gãy các chiến dịch tấn công có tổ chức.
Khi nào nên dùng Vector Embeddings để phát hiện bất thường?
Vector Embeddings là giải pháp tối ưu khi dữ liệu là phi cấu trúc, khối lượng lớn và yêu cầu tốc độ phản hồi thời gian thực. Tuy nhiên, kỹ sư cần cảnh báo việc sử dụng Cosine Similarity khi độ lớn (magnitude) của vector mang thông tin quan trọng. Trong các bài toán phát hiện gian lận trên hình ảnh, việc sử dụng Cosine có thể làm mất đi các thông tin về cường độ pixel hoặc độ tương phản vật lý, vốn là những yếu tố then chốt để nhận diện giả mạo. Trong những trường hợp đó, Dot Product với dữ liệu đã chuẩn hóa hoặc Euclidean Distance sẽ là lựa chọn an toàn hơn để bảo toàn toàn bộ tín hiệu rủi ro.
Tài liệu tham khảo
- How Inscribe uses Amazon Bedrock to stop document fraud in seconds — AWS Machine Learning Blog
- Text and Image Detectors (EmbeddingOD & MultiModalOD) — PyOD Documentation
- Vector Embeddings for Developers: The Basics — Pinecone
- Vector Similarity Explained — Pinecone
- What is a vector database? — Cloudflare Vectorize Docs
- Vectorize and Workers AI — Cloudflare Vectorize Docs
- Vector Embeddings — OpenAI API
- New Embedding Models and API Updates — OpenAI