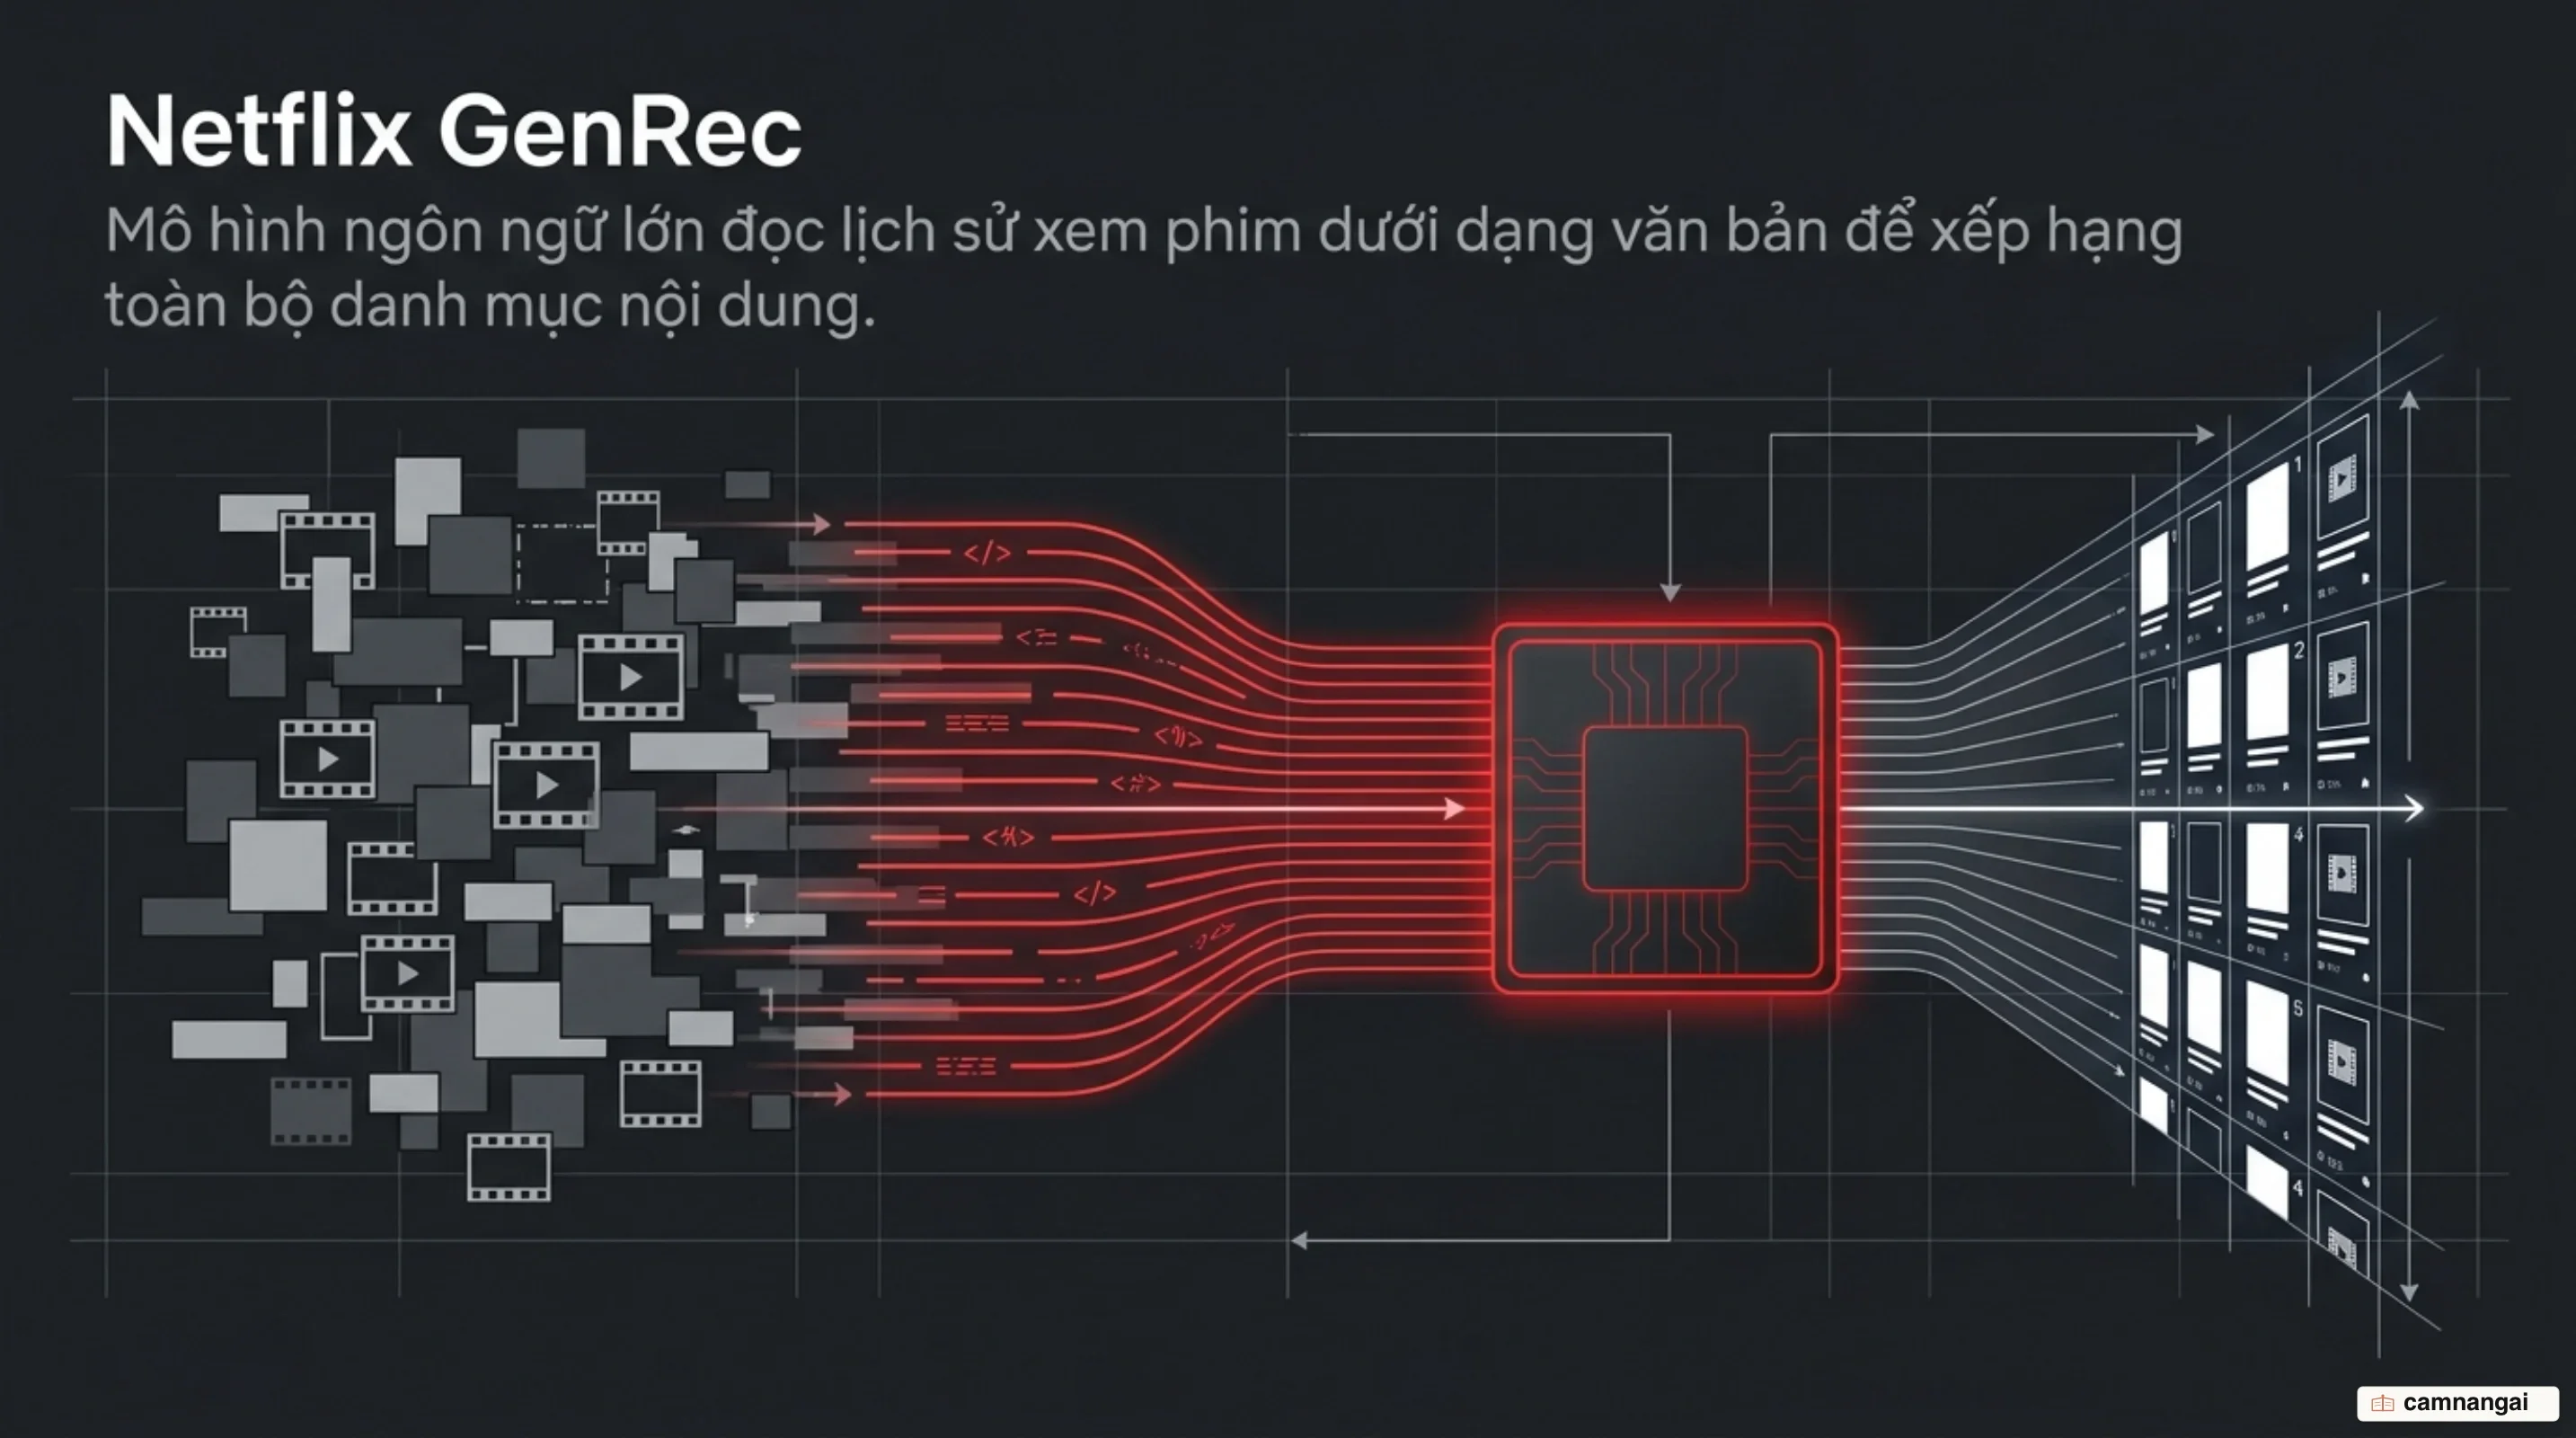
Để xếp hạng toàn bộ danh mục nội dung cho hàng trăm triệu người dùng, Netflix đã phát triển Netflix GenRec, một hệ thống xếp hạng gợi ý (recommendation ranker) dựa trên mô hình ngôn ngữ lớn (LLM).
Thay vì dựa vào hàng nghìn đặc trưng tính toán thủ công, GenRec viết lịch sử tương tác và ngữ cảnh của bạn thành các đoạn văn bản tự nhiên (verbalized prompts), rồi dùng mô hình LLM nền tảng nội bộ của Netflix để chấm điểm và xếp hạng danh mục nội dung.
Đối thủ mà GenRec phải vượt qua không hề dễ chơi: bộ xếp hạng đang chạy thật (production ranker) lâu năm của Netflix, nhưng GenRec vẫn xếp hạng chính xác hơn. GenRec đạt kết quả này dù dùng ít hơn tới 40 lần dữ liệu gán nhãn ở giai đoạn huấn luyện sau (Phase 2 post-training) và ít tín hiệu đầu vào thô hơn hẳn.
Hệ thống gợi ý cũ của Netflix vướng ở đâu?
Kiến trúc hệ thống gợi ý truyền thống của Netflix chạy trên hàng nghìn đặc trưng (features) do kỹ sư thiết kế thủ công, phủ từ tín hiệu người dùng, mục nội dung (items) cho đến từng tương tác chi tiết. Để phục vụ cùng lúc nhiều mục tiêu kinh doanh, hệ thống cũ phải nuôi cả một dàn thành phần: các mạng tương tác đặc trưng (feature-interaction networks) kiểu DLRM (Deep Learning Recommendation Model của Meta), các mô hình two-tower (một tháp mã hóa người dùng, một tháp mã hóa nội dung), các khối attention tùy biến, cùng những thiết lập học đa nhiệm (multi-task learning) quy mô lớn.
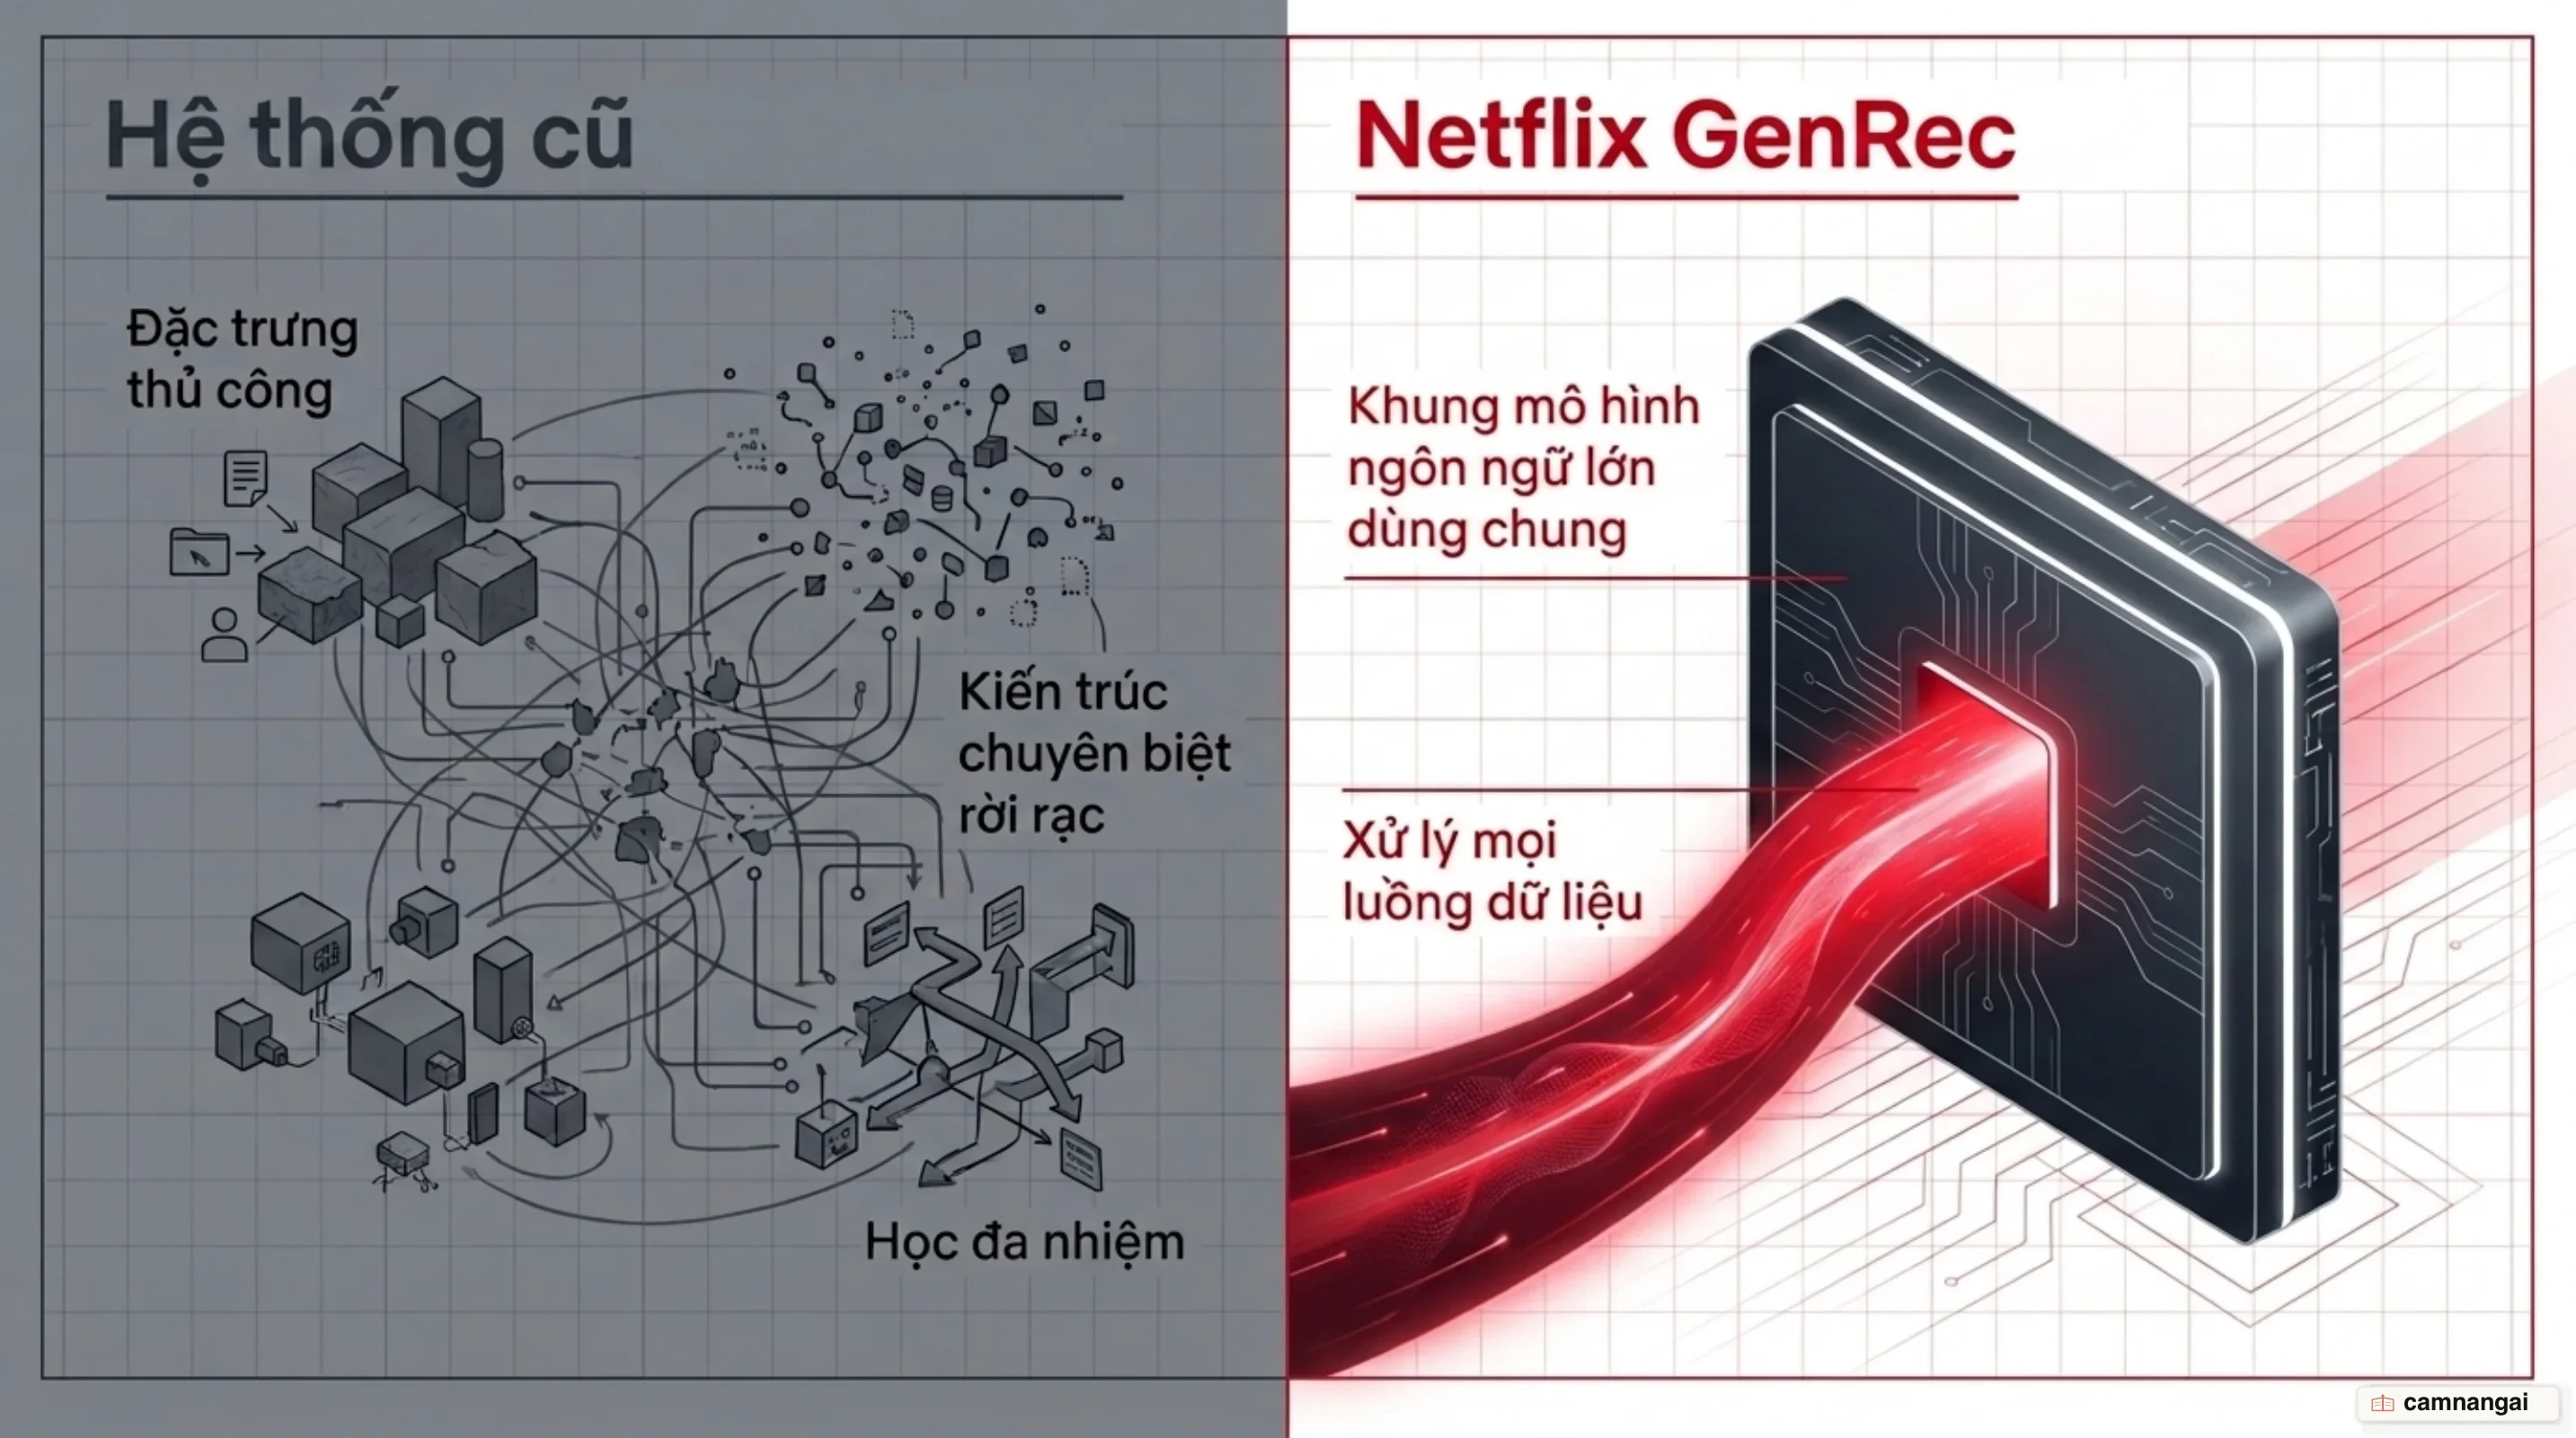
Khi Netflix mở rộng sang các dạng nội dung mới (phim điện ảnh, phim truyền hình, trò chơi điện tử, sự kiện trực tiếp, podcast) và nhiều bề mặt giao diện (UI surfaces) khác nhau, chi phí vận hành kiến trúc này đội lên rất nhanh. Mỗi lần muốn đưa một loại nội dung hay một bề mặt gợi ý mới vào hệ thống, đội kỹ sư lại phải đi hết một vòng dài: thiết kế lại đặc trưng, chỉnh kiến trúc mô hình, sửa hạ tầng dữ liệu rồi chạy thử nghiệm A/B tốn kém, nên mỗi bề mặt mới gần như là một dự án mới.
Sau nhiều năm tinh chỉnh, việc đắp thêm các đường ống tạo đặc trưng thủ công (feature engineering pipelines) đã rơi vào vùng lợi ích giảm dần (diminishing returns): công bỏ ra ngày càng nhiều trong khi điểm số nhích lên ngày càng ít. Lối ra Netflix chọn là dựa vào khả năng hiểu ngữ nghĩa của mô hình ngôn ngữ lớn (LLM) để gom cả hệ thống phức tạp này về một mô hình nền tảng duy nhất.
Hai giai đoạn huấn luyện: từ LLM nền đến bộ xếp hạng
Chỗ dễ nhầm nhất nằm ở đây: mô hình "Foundation Model for Personalized Recommendation" do Netflix công bố vào tháng 3/2025, với kỹ thuật gộp hành động người dùng tương tự BPE (Byte Pair Encoding, cách tokenizer gộp các cặp ký hiệu hay đi cùng nhau), cơ chế sparse attention và sliding window sampling, là một nghiên cứu riêng có từ trước, không phải Phase 1 của Netflix GenRec.
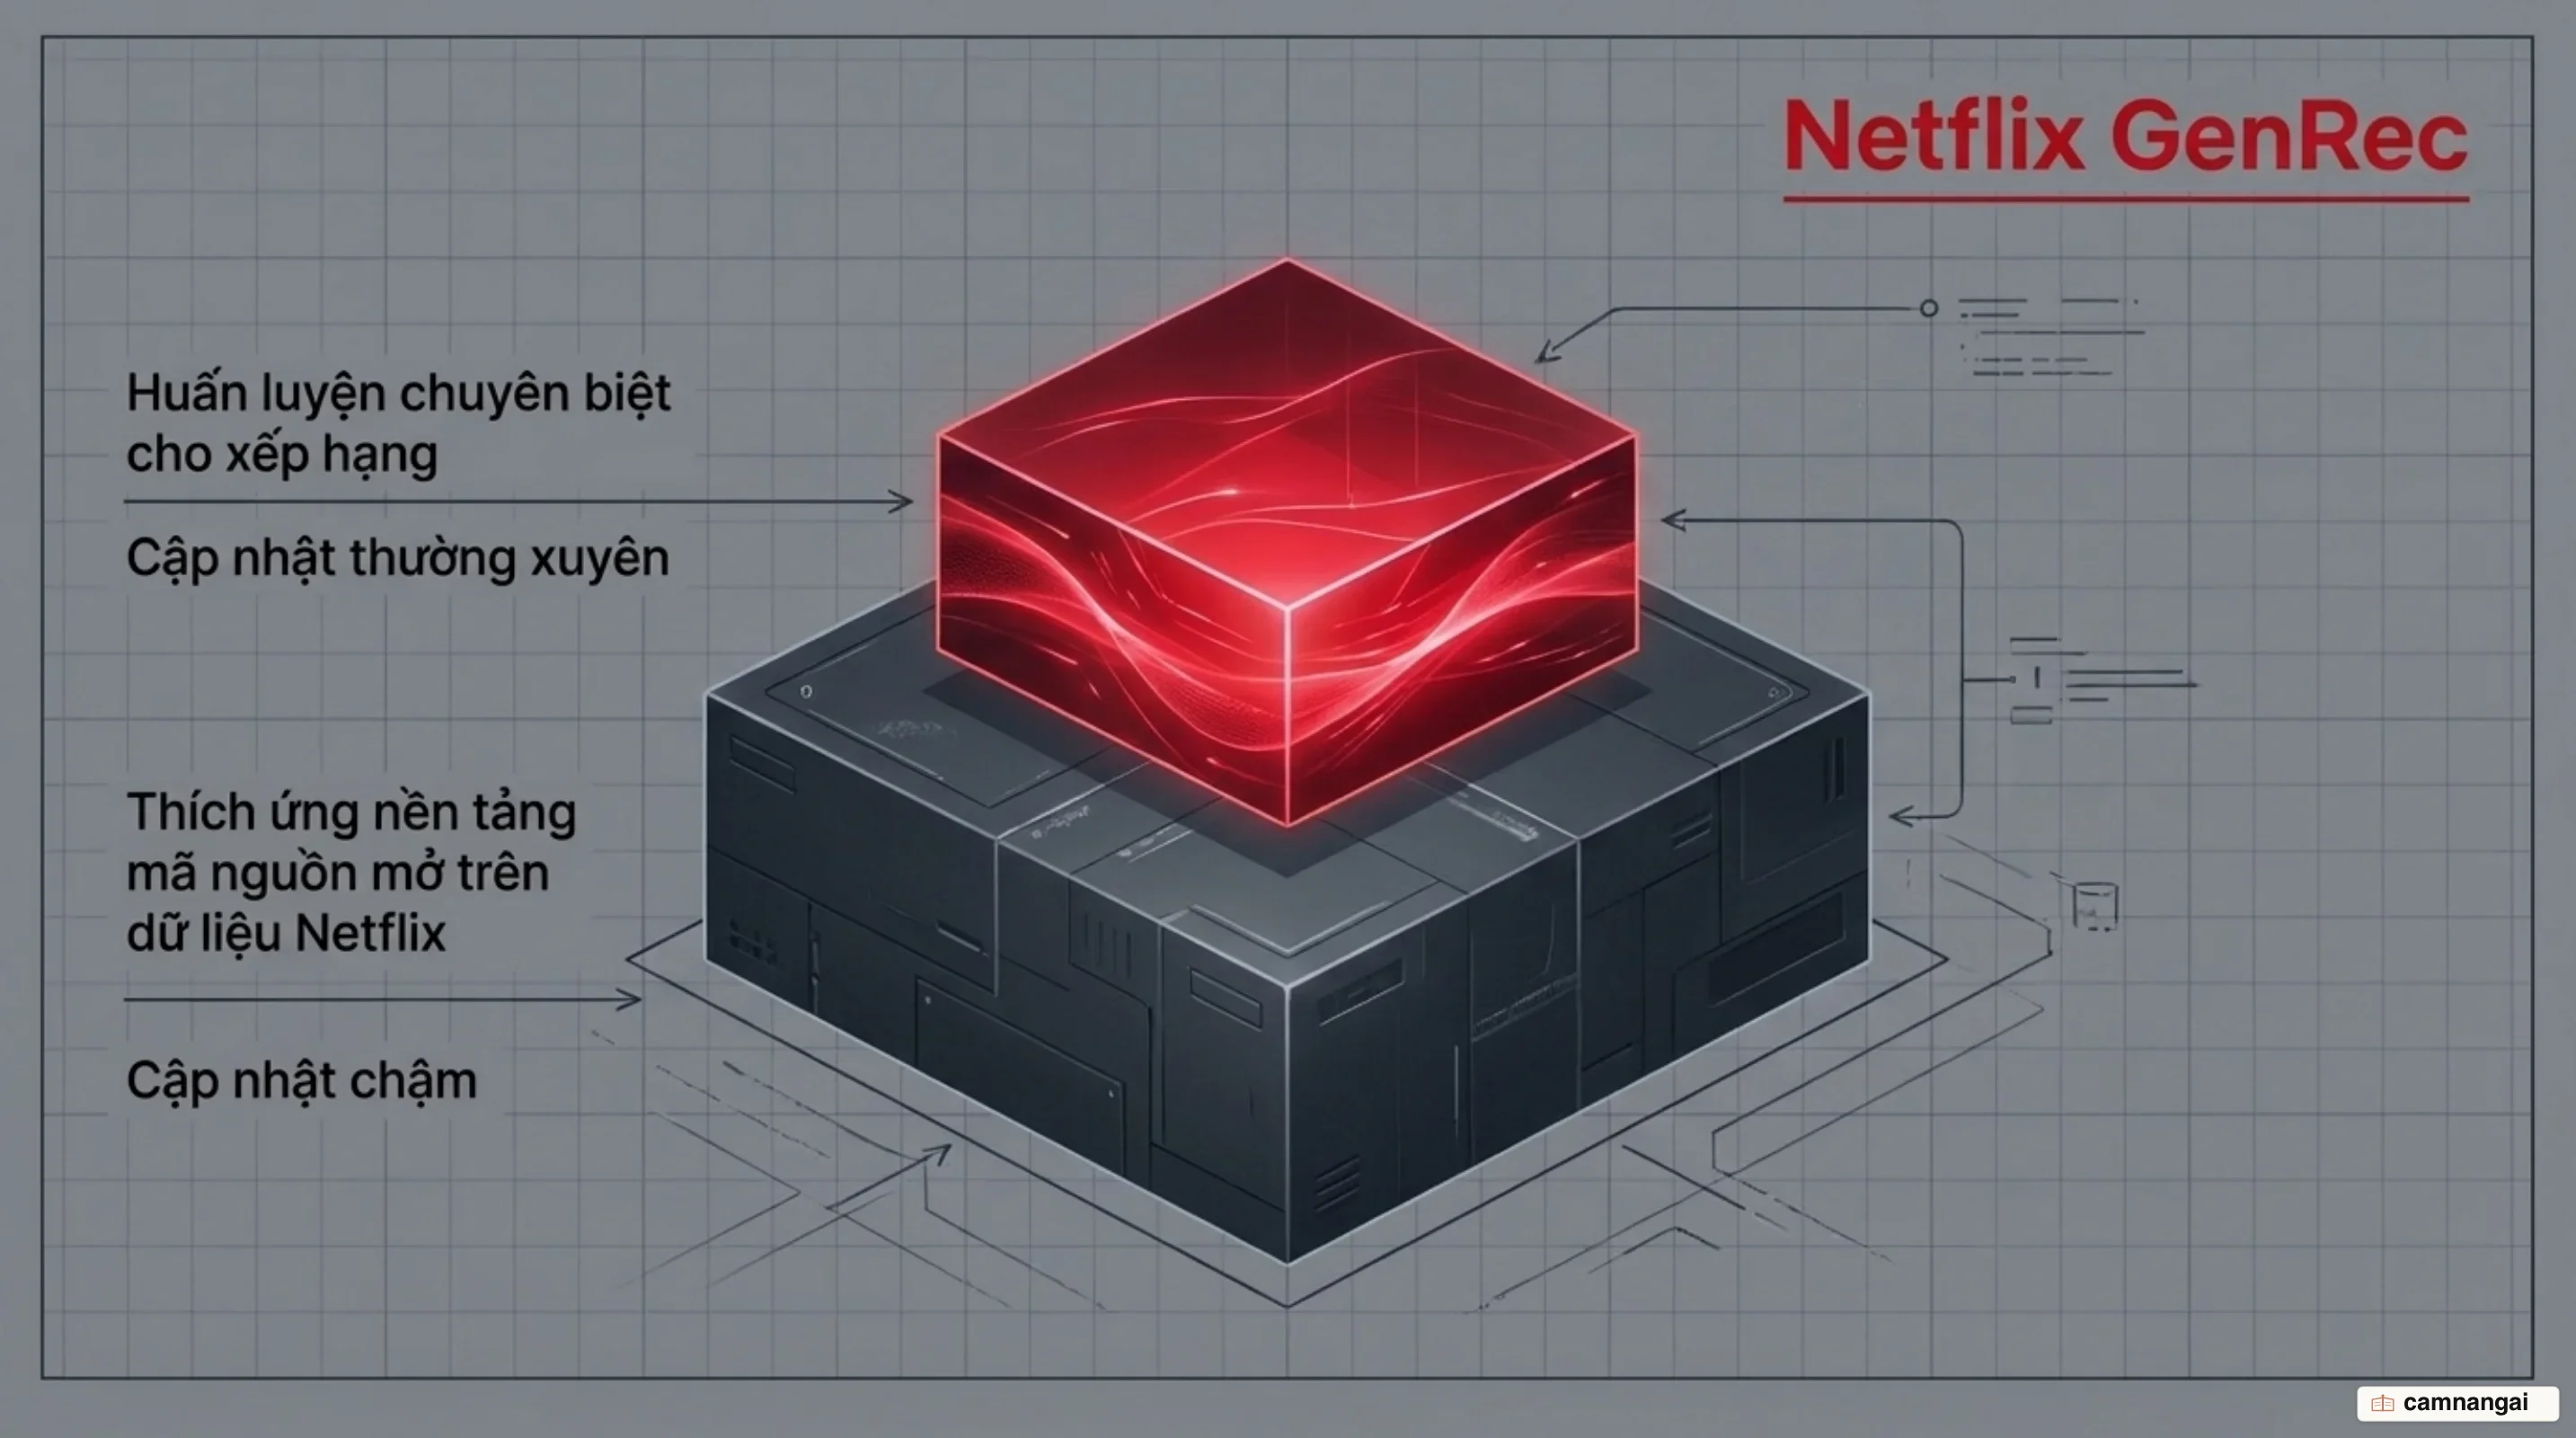
GenRec được huấn luyện qua hai giai đoạn, mỗi giai đoạn cập nhật theo một nhịp riêng:
- Phase 1 (Netflix-Adapted Foundation LLM): Netflix chọn một mô hình ngôn ngữ lớn (LLM) decoder-only (chỉ dùng khối giải mã của Transformer) mã nguồn mở rồi thích ứng nó trên tập dữ liệu độc quyền của hãng. Qua giai đoạn này, mô hình hiểu sâu toàn bộ danh mục nội dung Netflix và học cách mô hình hóa hành vi người dùng, trong khi vẫn giữ năng lực xử lý ngôn ngữ tự nhiên tổng quát. Mô hình nền tảng Phase 1 làm phần xương sống (backbone) dùng chung và chỉ được cập nhật với tần suất tương đối thấp.
- Phase 2 (GenRec Post-Training): Giai đoạn này biến LLM nền tảng Phase 1 thành một bộ xếp hạng gợi ý rẻ khi chạy và được cập nhật thường xuyên. Nhật ký tương tác người dùng được viết lại theo dạng hội thoại (conversational format), gồm các lượt user message và assistant message. Định dạng hội thoại này chỉ dùng lúc huấn luyện, để phục vụ mục tiêu mô hình hóa ngôn ngữ (language modeling objective); khi triển khai thực tế (inference), mô hình bỏ qua hoàn toàn phần sinh hội thoại và chỉ chạy ở chế độ tính điểm. Netflix huấn luyện lại Phase 2 liên tục để theo kịp các bộ phim mới ra mắt và thị hiếu vốn đổi rất nhanh của người dùng.
Context engineering thay cho feature engineering
Trong kiến trúc GenRec, quy trình xây dựng prompt (prompt construction) thay thế hoàn toàn khâu kỹ thuật tạo đặc trưng (feature engineering) truyền thống, theo đúng tinh thần "prompt chính là vectơ đặc trưng mới" (prompt as the new feature vector): toàn bộ nhật ký tương tác của người dùng, ngữ cảnh thiết bị, vị trí địa lý, thời gian và siêu dữ liệu nội dung đều được chuyển thành văn bản tự nhiên có cấu trúc.
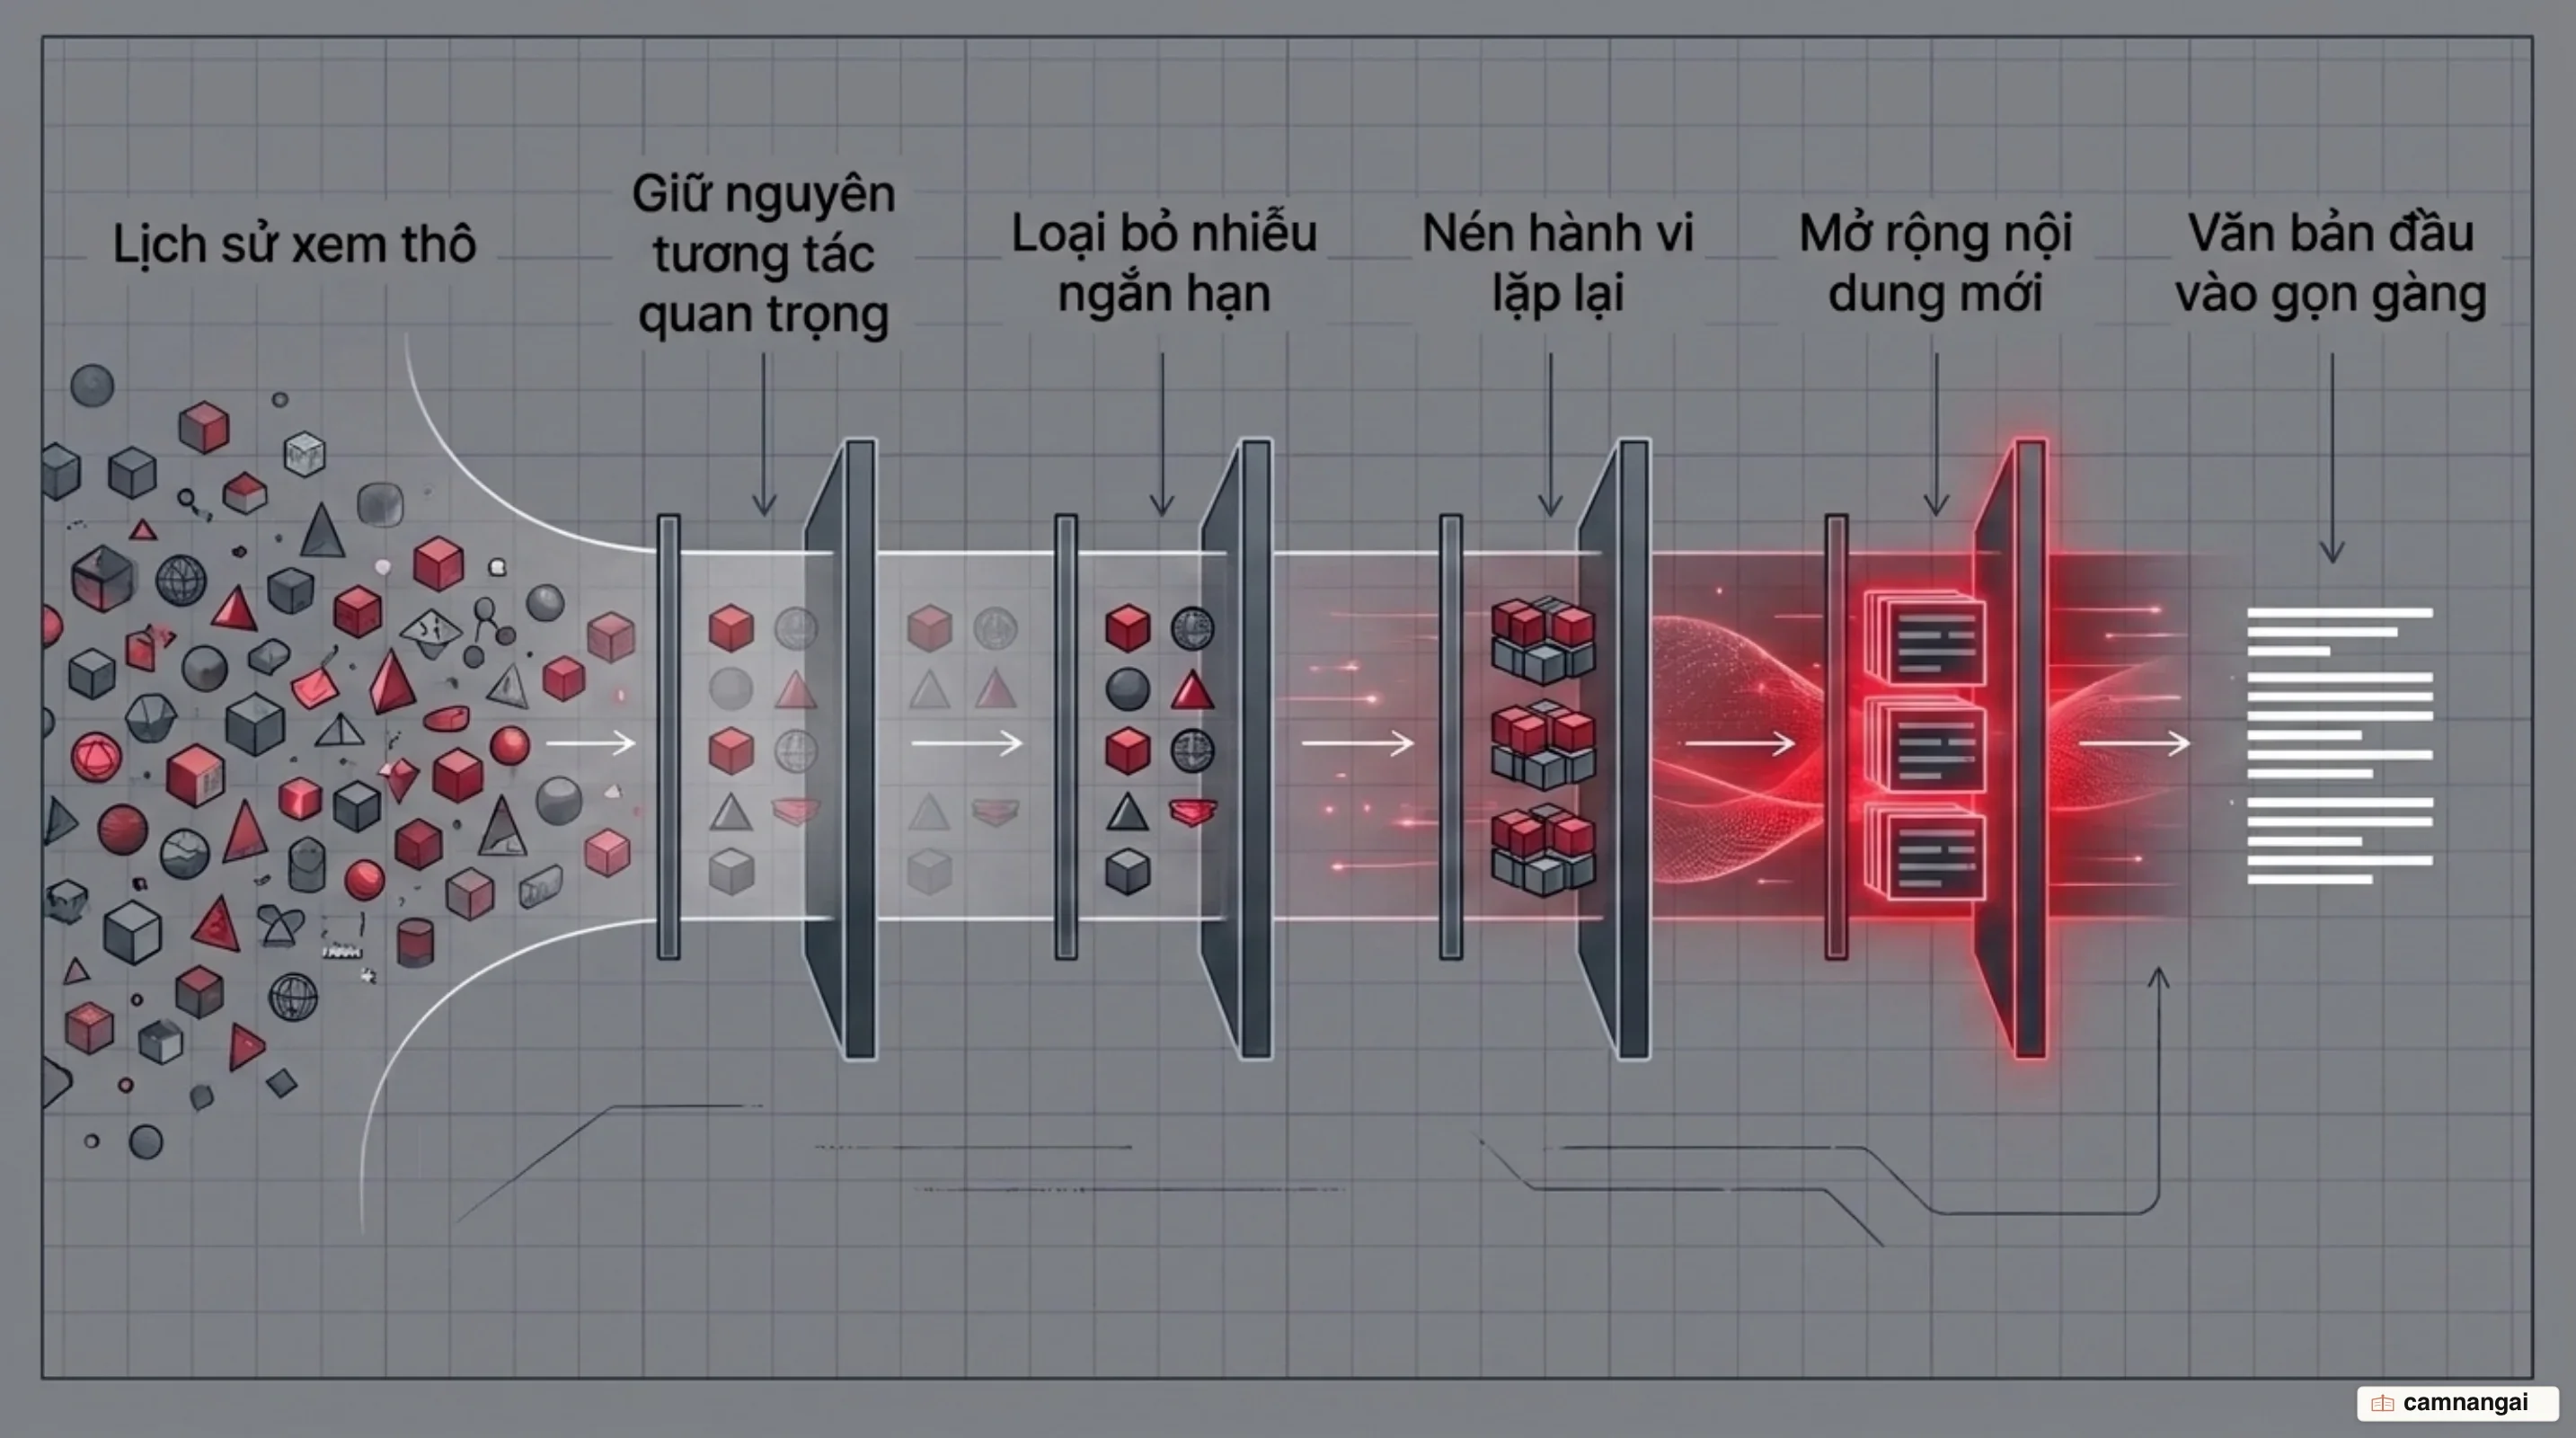
Cửa sổ ngữ cảnh (context window) của mô hình ngôn ngữ lớn (LLM) bị giới hạn bởi chi phí tính toán và độ trễ, nên Netflix không nhét mọi thứ vào prompt mà lọc theo 4 quy tắc tối ưu hóa ngữ cảnh (context engineering):
- Retention (Giữ nguyên toàn bộ): Các sự kiện có tín hiệu mạnh (xem thời lượng dài, ấn thumbs-up) được giữ nguyên vẹn, kèm theo siêu dữ liệu chi tiết.
- Omission (Loại bỏ hoàn toàn): Các sự kiện tín hiệu yếu hoặc nhiễu (xem vài giây rồi ngắt, lướt qua nhanh) bị loại khỏi prompt để khỏi phí token.
- Compression (Nén dữ liệu): Các hành vi lặp đi lặp lại (như xem liền một mạch nhiều tập phim/binge-watching) được tóm lại thành một dòng thông tin gọn.
- Selective Elaboration (Mở rộng có chọn lọc): Với nội dung mới ra mắt hoặc đang gặp vấn đề cold-start, hệ thống mở rộng siêu dữ liệu chi tiết để bù cho phần lịch sử tương tác còn thiếu.
Phía hạ tầng phục vụ, Netflix sắp xếp prompt sao cho phần tiền tố dùng chung (shared prefix) dài nhất có thể, để tỷ lệ trúng bộ nhớ đệm tiền tố (prefix cache hit rate) trên vLLM (thư viện mã nguồn mở để phục vụ LLM) lên cao nhất. Cái được của việc dọn dẹp tỉ mỉ này rất cụ thể: nhờ kết hợp các quy tắc nén ngữ cảnh với cấu trúc prompt đó, GenRec rút prompt từ ~5.000 token xuống còn ~1.700 token (chỉ còn khoảng 1/3 ngân sách token ban đầu) mà chất lượng xếp hạng ngoại tuyến (MRR) gần như không suy giảm, và chi phí hạ tầng phục vụ cũng giảm theo, còn khoảng 1/3.
Thưởng cho sự hài lòng lâu dài, không chỉ lượt xem kế tiếp
Netflix huấn luyện GenRec bằng một hàm mất mát (loss) đa mục tiêu, kết hợp loss xếp hạng, loss mô hình hóa ngôn ngữ (LM loss) trên văn bản và, khi cần, các mục tiêu phụ khác (miscellaneous):
L = α · L_ranking + β · L_language + γ · L_miscellaneousvới các hệ số thỏa mãn α + β + γ = 1 và α, β, γ ≥ 0.
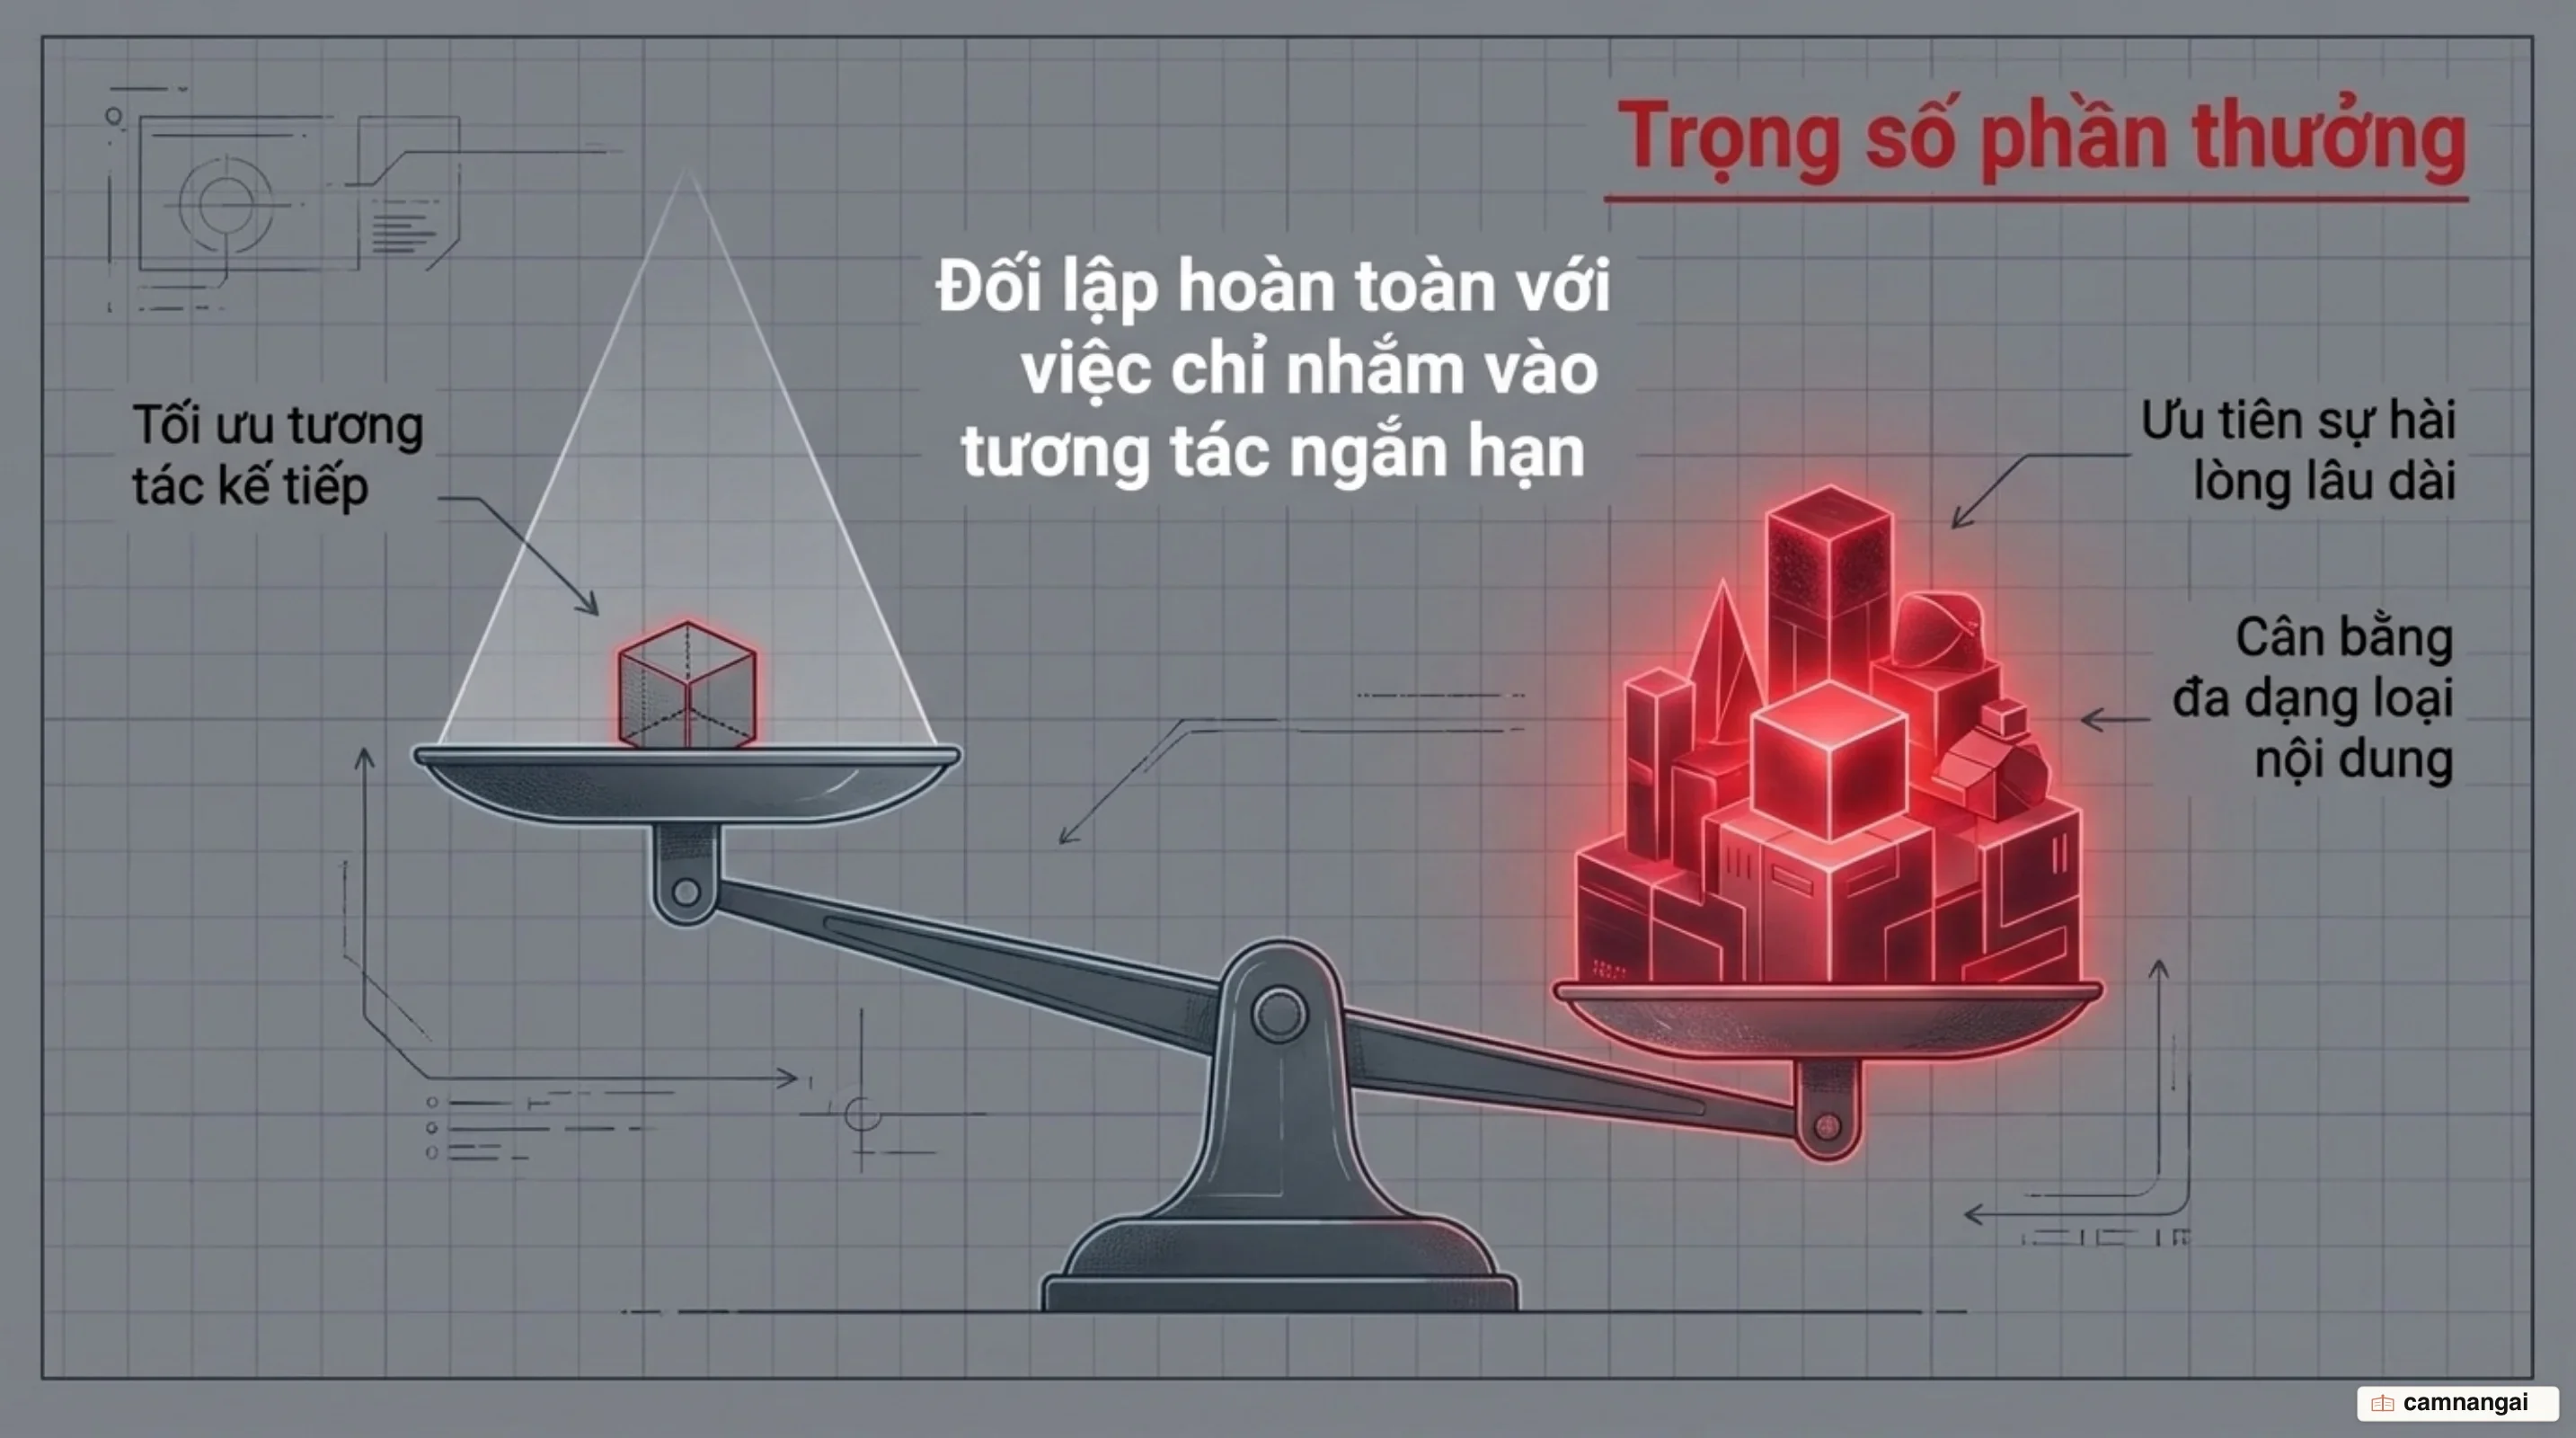
Nếu chỉ tinh chỉnh bằng phương pháp tinh chỉnh có giám sát (Supervised Fine-Tuning, SFT) thông thường dựa trên lượt nhấp tiếp theo, mô hình ngôn ngữ lớn (LLM) dễ sa vào kiểu gợi ý ngắn hạn (myopic recommendations), chẳng hạn cứ gợi ý phim để cày một mạch (binge-watching), thiên vị nội dung video hơn trò chơi, hoặc ưu tiên lượt nhấp ngắn hạn hơn sự gắn bó lâu dài.
Để xử lý chuyện này, Netflix không cộng thêm một thành phần loss riêng, mà lấy các trọng số vô hướng cấp mẫu (sample-level scalar weights w_i) từ các mô hình phần thưởng (reward models) độc lập rồi nhân thẳng vào loss xếp hạng cross-entropy (w_i · L_ranking):
- Tín hiệu hài lòng lâu dài: Gán trọng số
w_icao hơn cho các tương tác khiến người dùng quay lại ứng dụng, chịu xem thử các thể loại nội dung mới và giữ thời gian xem ổn định. - Tín hiệu cân bằng kinh doanh: Điều chỉnh độ phủ giữa các loại hình nội dung (phim điện ảnh, trò chơi, sự kiện trực tiếp, podcast) và giữa các giai đoạn phát hành (nội dung mới ra mắt vs. nội dung kinh điển).
Tôi thích lựa chọn này vì nó thực dụng. So với các phương pháp học tăng cường (reinforcement learning) toàn phần như GRPO, việc nhân trọng số phần thưởng vào hàm loss xếp hạng (w_i · L_ranking) đơn giản hơn, ổn định hơn và rẻ hơn khi phải triển khai trên một hệ thống đang chạy thật, cập nhật với tần suất cao.
Xếp hạng mà không sinh chữ: scoring head và chạy prefill-only
Netflix GenRec bỏ hẳn quá trình sinh tự hồi quy (autoregressive decoding), tức kiểu sinh từng token một vốn rất chậm của mô hình ngôn ngữ lớn (LLM), vì một bộ xếp hạng cần điểm số chứ không cần câu chữ. Thay vào đó, kiến trúc này dùng một đầu tính điểm nhận biết danh mục (Catalog-Aware Scoring Head) và chế độ chạy prefill-only: mô hình chỉ chạy giai đoạn prefill, tức bước LLM đọc toàn bộ prompt trong một lượt trước khi sinh token đầu tiên, rồi dừng ở đó.
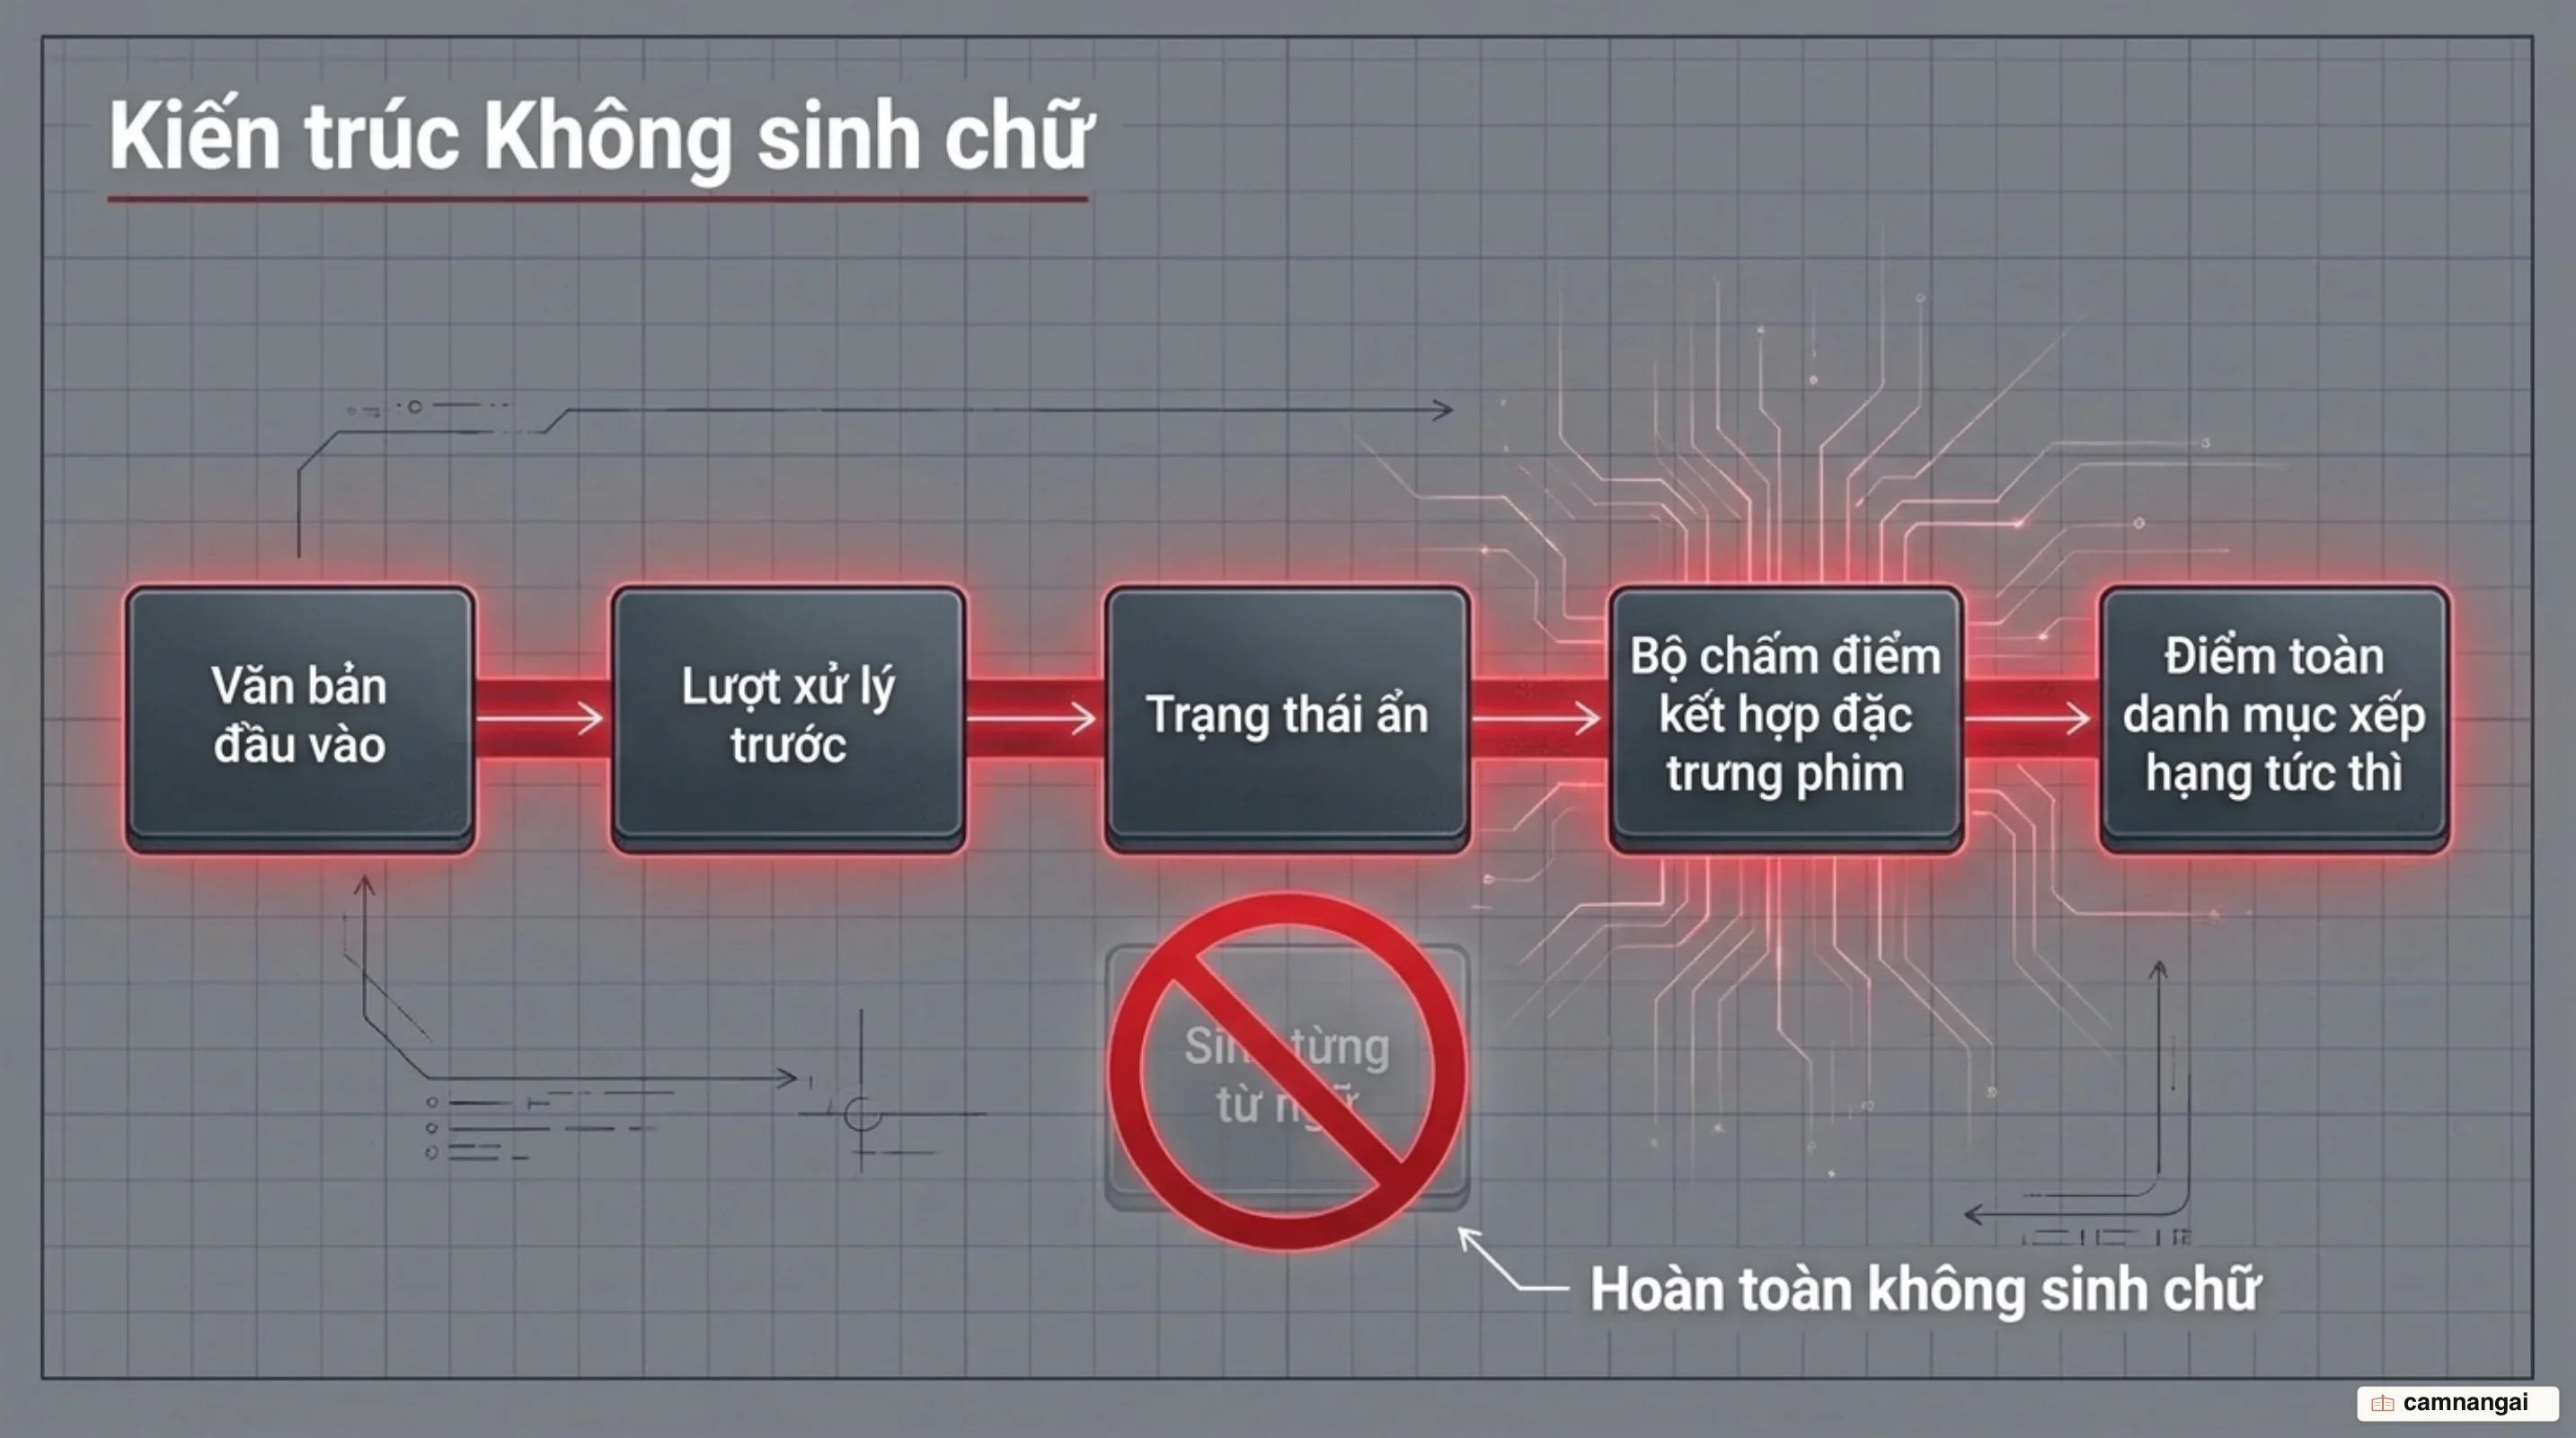
- Quy trình tính điểm: Bộ chuyển đổi văn bản
Vbiến lịch sử và ngữ cảnh thành chuỗix. LLM mã hóaxthành một trạng thái ẩn thu gọn (pooled hidden state)hbiểu diễn sở thích người dùng. Đầu tính điểmφkết hợphvới các vectơ nhúng (embeddings)e_iđã học của từng itemi ∈ Ctrong danh mục, rồi tính điểm cho toàn bộ danh mục chỉ trong một lượt lan truyền tiến (forward pass) duy nhất. Khi kích thước danh mục|C|quá lớn để tính hết trong lúc huấn luyện, GenRec dùng kỹ thuật sampled-softmax trên tập mẫu tiêu cực (negative candidate sets) để giữ chi phí tính toán trong tầm kiểm soát. - Thực thi Prefill-Only: Mô hình được triển khai trên hạ tầng LLM nội bộ của Netflix, dùng thư viện
vLLM, và chỉ chạy giai đoạn prefill để đánh giá toàn bộ danh mục hoặc tập ứng viên cùng một lúc mà không sinh ra token văn bản nào. - Tối ưu hóa server: Phía server, vLLM bật cơ chế tự động lưu đệm tiền tố (Automatic Prefix Caching), nên cách sắp phần tiền tố dùng chung ở phần trước phát huy tác dụng đúng chỗ này.
GenRec thực sự tốt hơn bao nhiêu?
Đối chứng là bộ xếp hạng đang chạy thật (production baseline) đã được Netflix tối ưu nhiều năm, và Netflix GenRec thắng nó ở cả thử nghiệm ngoại tuyến lẫn thử nghiệm thực tế:
- Chỉ số xếp hạng ngoại tuyến (Offline Metrics): GenRec đạt mức tăng tương đối +1.6% MRR (Mean Reciprocal Rank) so với baseline, dù chỉ dùng ít hơn 40 lần dữ liệu gán nhãn ở Phase 2 và ít tín hiệu đầu vào thô hơn nhiều.
- Đóng góp của từng Phase:
- Phase 1: Dùng LLM nền tảng đã được Netflix thích ứng giúp tăng +10% đến +20% MRR so với dùng một mô hình ngôn ngữ lớn (LLM) mã nguồn mở nguyên bản.
- Phase 2: Đem lại thêm +35% đến +50% MRR khi Phase 1 còn mới. Sau 2 tuần, mức chênh lệch này tăng lên tới ~80% MRR vì mô hình Phase 1 dần lỗi thời so với xu hướng nội dung mới, nên bỏ bê việc cập nhật Phase 2 là trả giá thấy rõ.
- Thử nghiệm thực tế (Online A/B Testing): Đợt thử nghiệm chạy trên ~10% lượng truy cập toàn cầu của Netflix trong 4 tuần (trên các bề mặt tính toán theo đợt/batch-compute) và ghi nhận mức tăng có ý nghĩa thống kê: +0.115% ở chỉ số tương tác trang chủ ngắn hạn và +0.006% (tương đối) ở chỉ số cốt lõi dài hạn. Con số +0.006% nhìn thì như sai số làm tròn, nhưng nó vẫn có ý nghĩa thống kê trước một baseline đã được tối ưu nhiều năm.
- Tối ưu chi phí: Cắt độ dài ngữ cảnh prompt đi khoảng 3 lần kéo chi phí tính toán khi phục vụ (serving compute cost) xuống còn khoảng 1/3, do ở chế độ prefill-only chi phí tỉ lệ tuyến tính với độ dài ngữ cảnh.
Bài học cho AI engineer từ GenRec
Nếu phải mang một điều từ Netflix GenRec về đội mình, tôi chọn điều này: với một hệ thống gợi ý dựa trên mô hình ngôn ngữ lớn (LLM), đòn bẩy đã dời khỏi kiến trúc mạng sang những gì được đưa vào prompt. Netflix không thắng bộ xếp hạng cũ bằng một khối tương tác đặc trưng tinh vi hơn, mà bằng cách chọn kỹ sự kiện nào được giữ, bỏ, nén hay mở rộng, căn chỉnh bằng trọng số phần thưởng, rồi chạy prefill-only với scoring head để chi phí phục vụ nằm trong mức chấp nhận được.
Cái giá đi kèm là kỷ luật cập nhật: Phase 1 có thể đổi chậm, nhưng Phase 2 phải được huấn luyện lại đều đặn, vì chỉ sau 2 tuần, phần đóng góp của nó đã lên tới ~80% MRR.
Tài liệu tham khảo
- How Netflix Taught an LLM to Recommend Movies So That You Keep Watching — ByteByteGo
- GenRec: Towards LLM-Native Recommendation at Netflix — Netflix TechBlog
- GenRec: An LLM-Backed Recommendation Ranker at Netflix — arXiv
- Foundation Model for Personalized Recommendation — Netflix TechBlog
- Automatic Prefix Caching — vLLM
- Improving Recommendation Systems & Search in the Age of LLMs — Eugene Yan