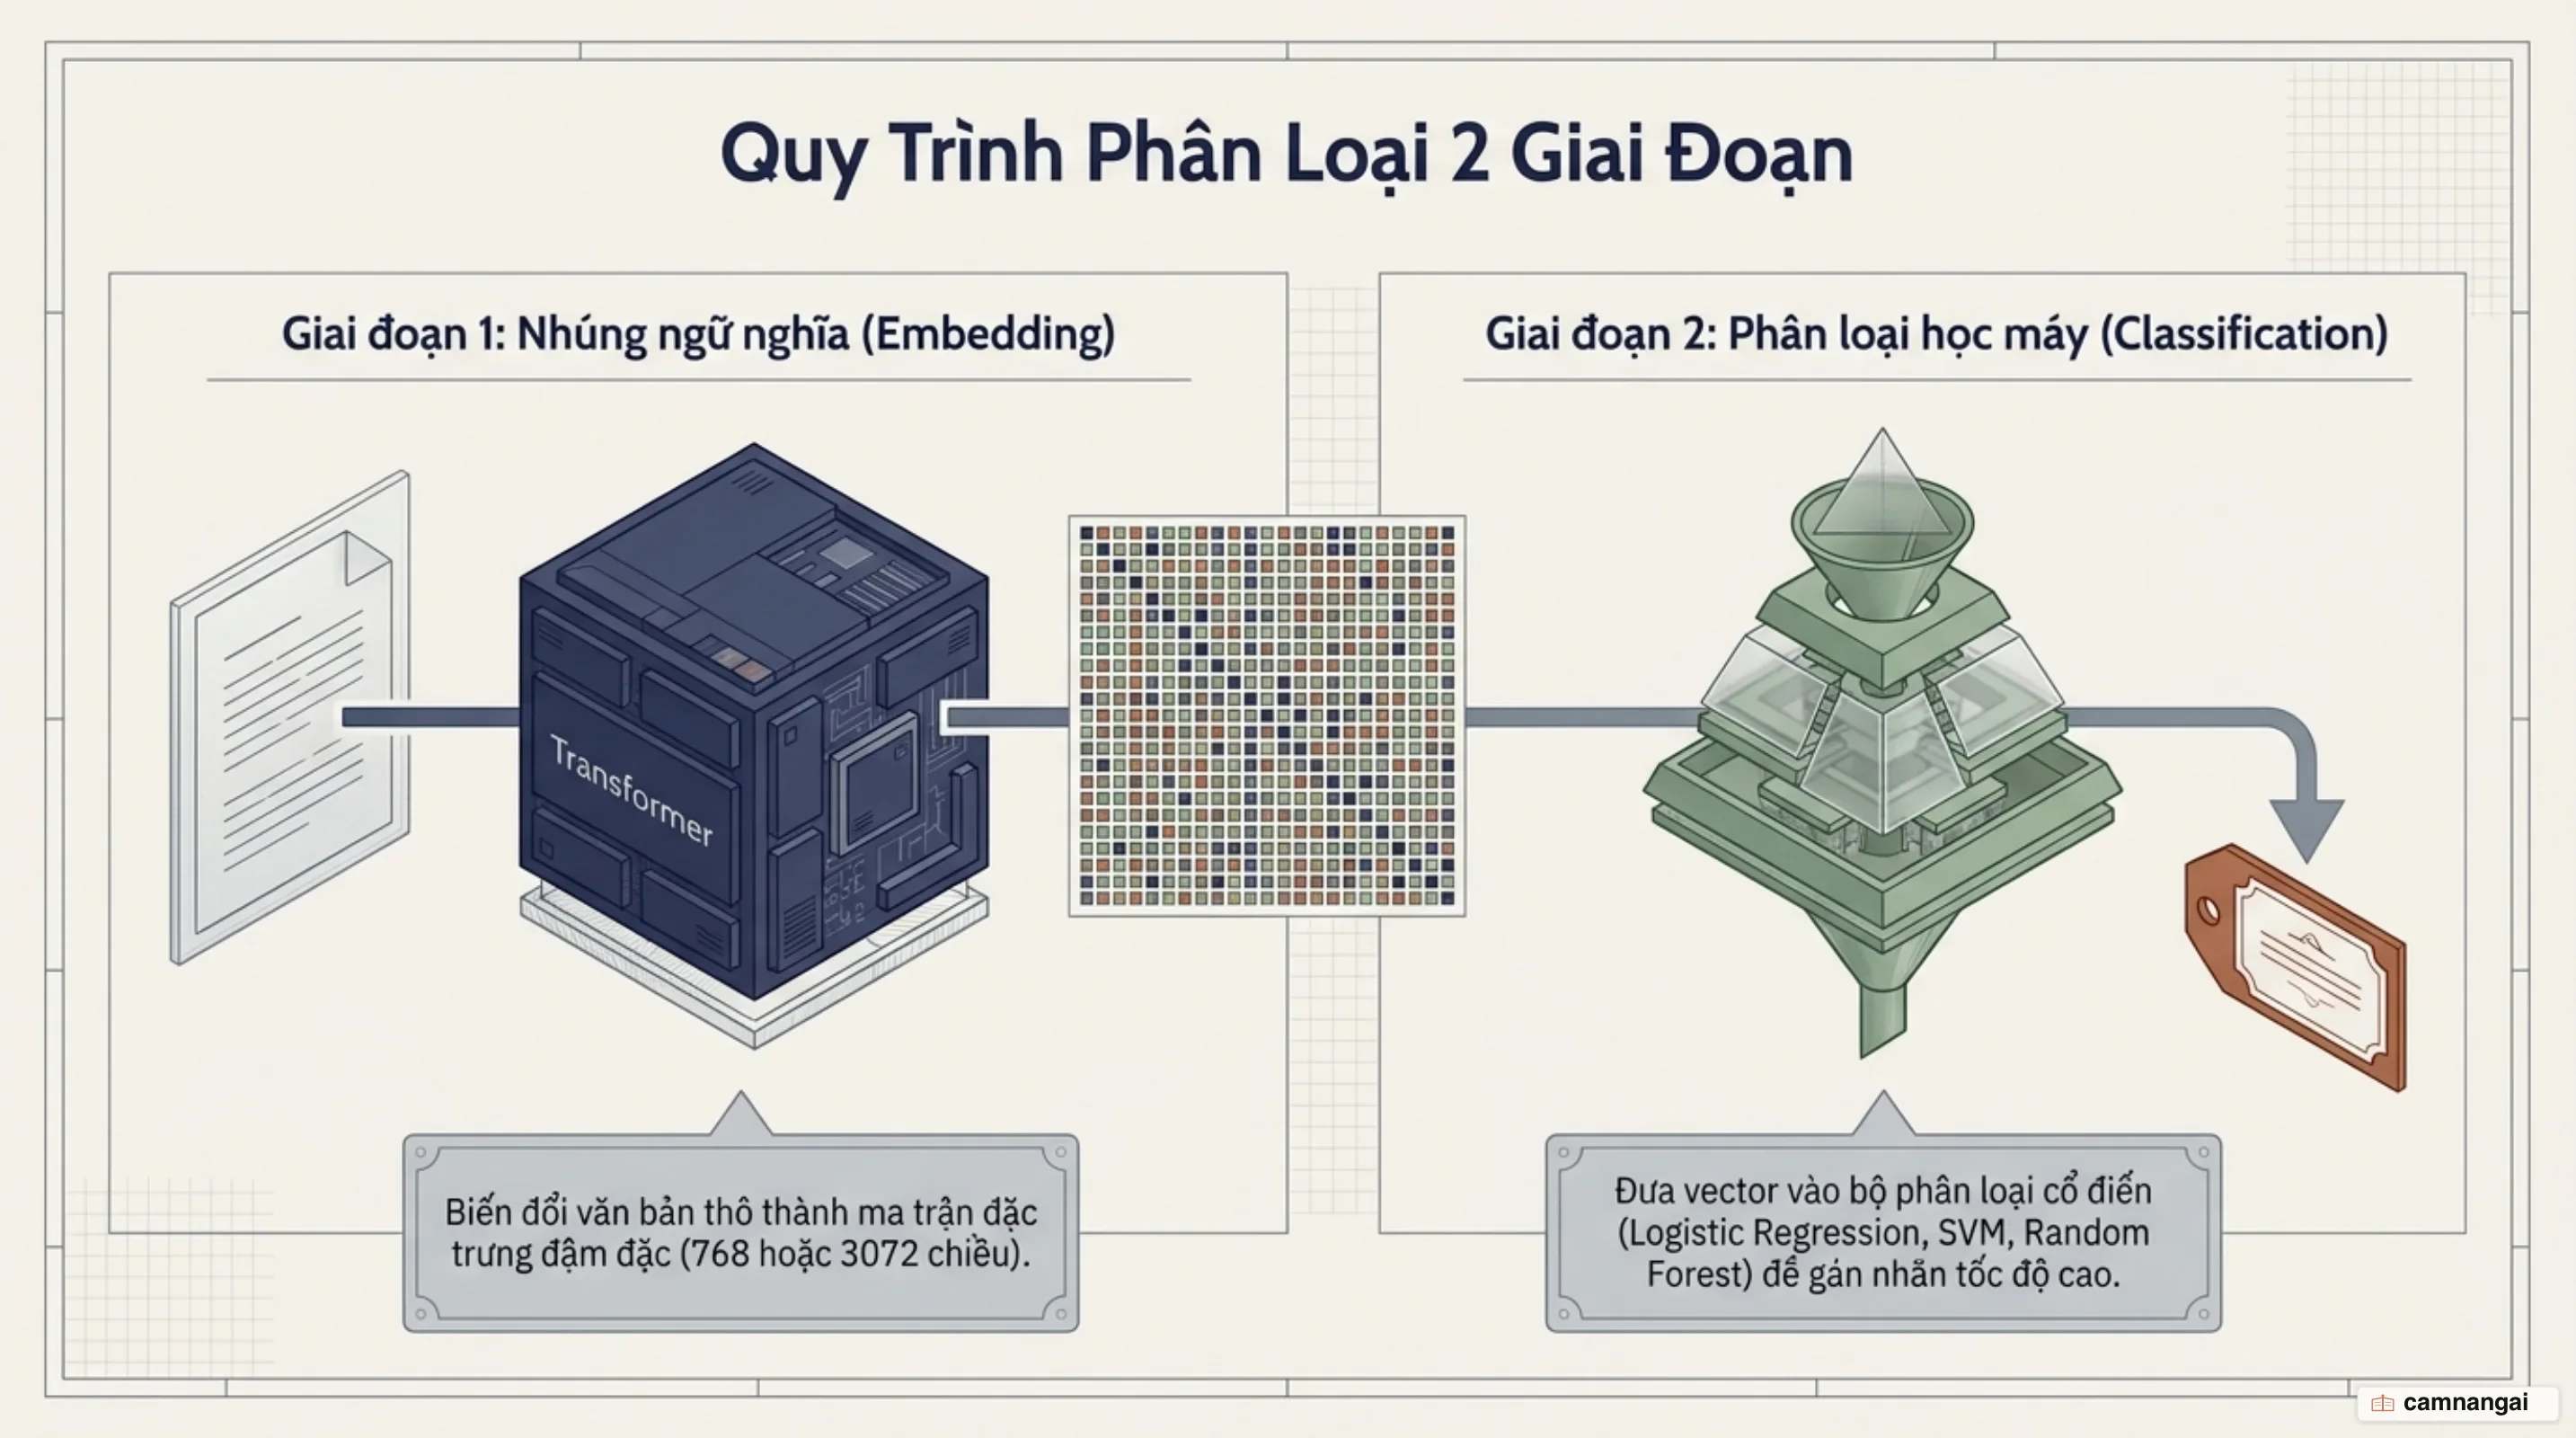
Phân loại dữ liệu bằng embedding là phương pháp chuyển đổi văn bản phi cấu trúc thành các vector đậm đặc (dense vectors) để làm đầu vào cho các thuật toán học máy.
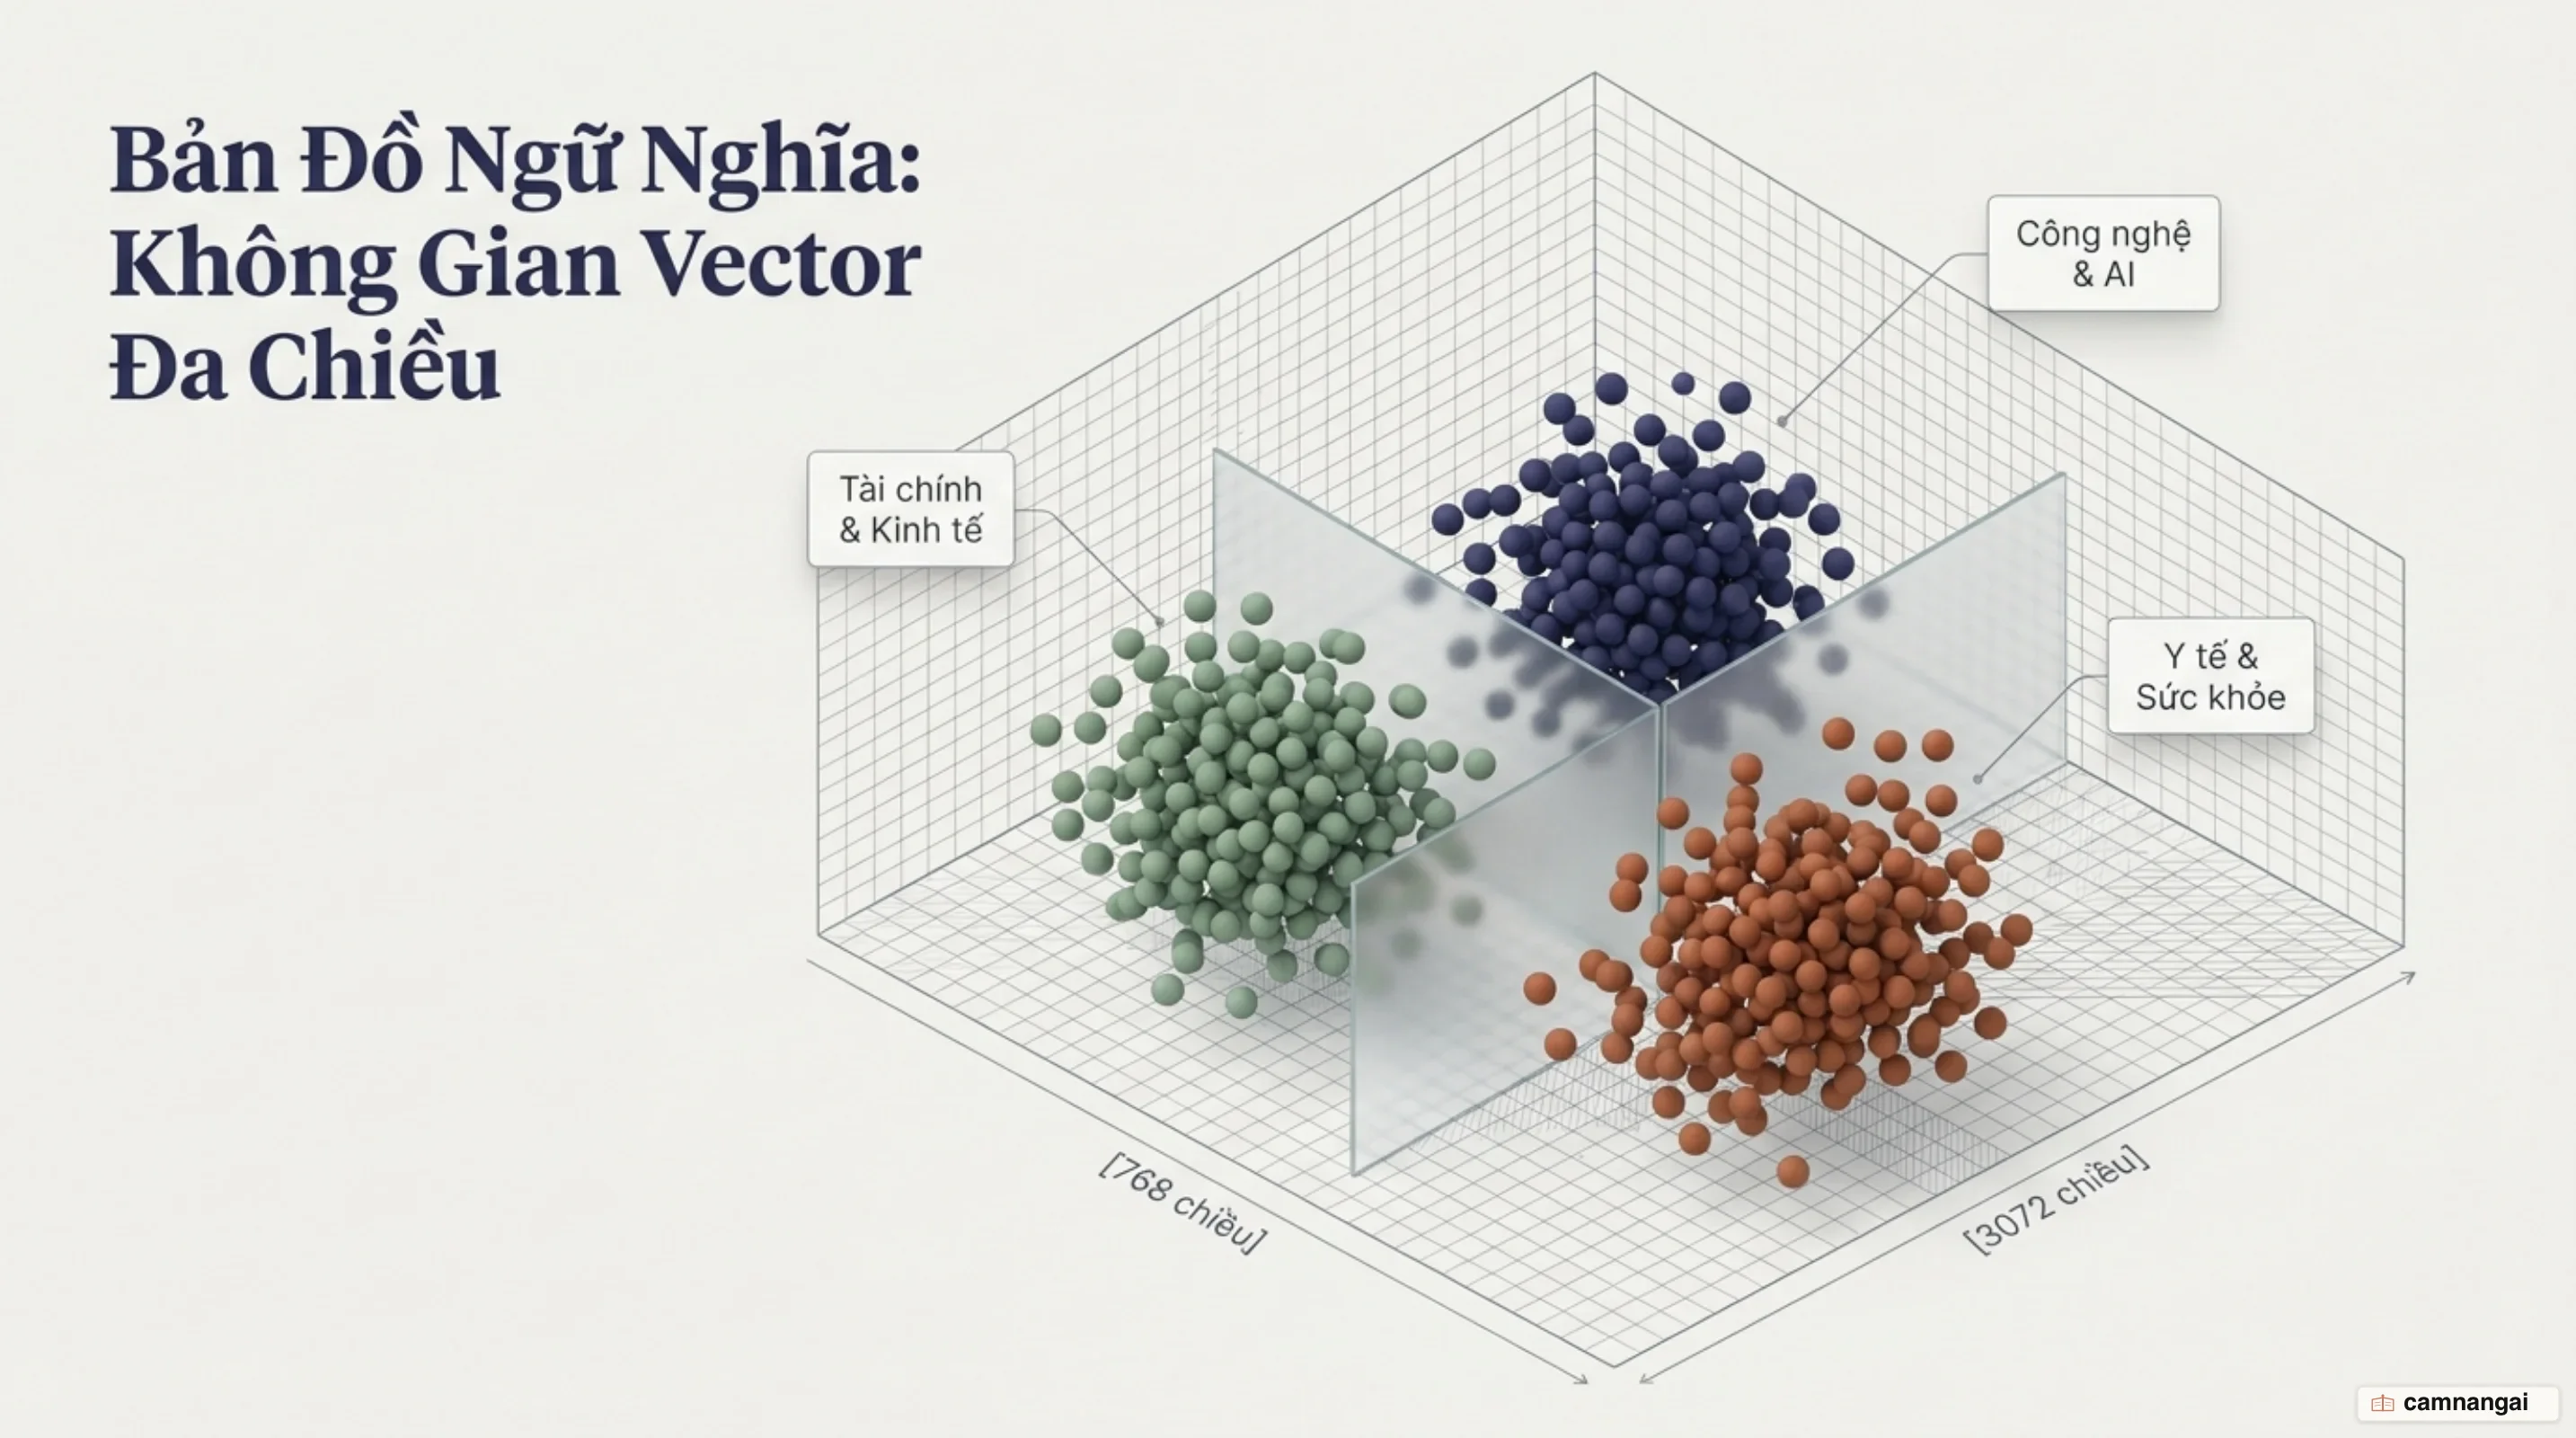
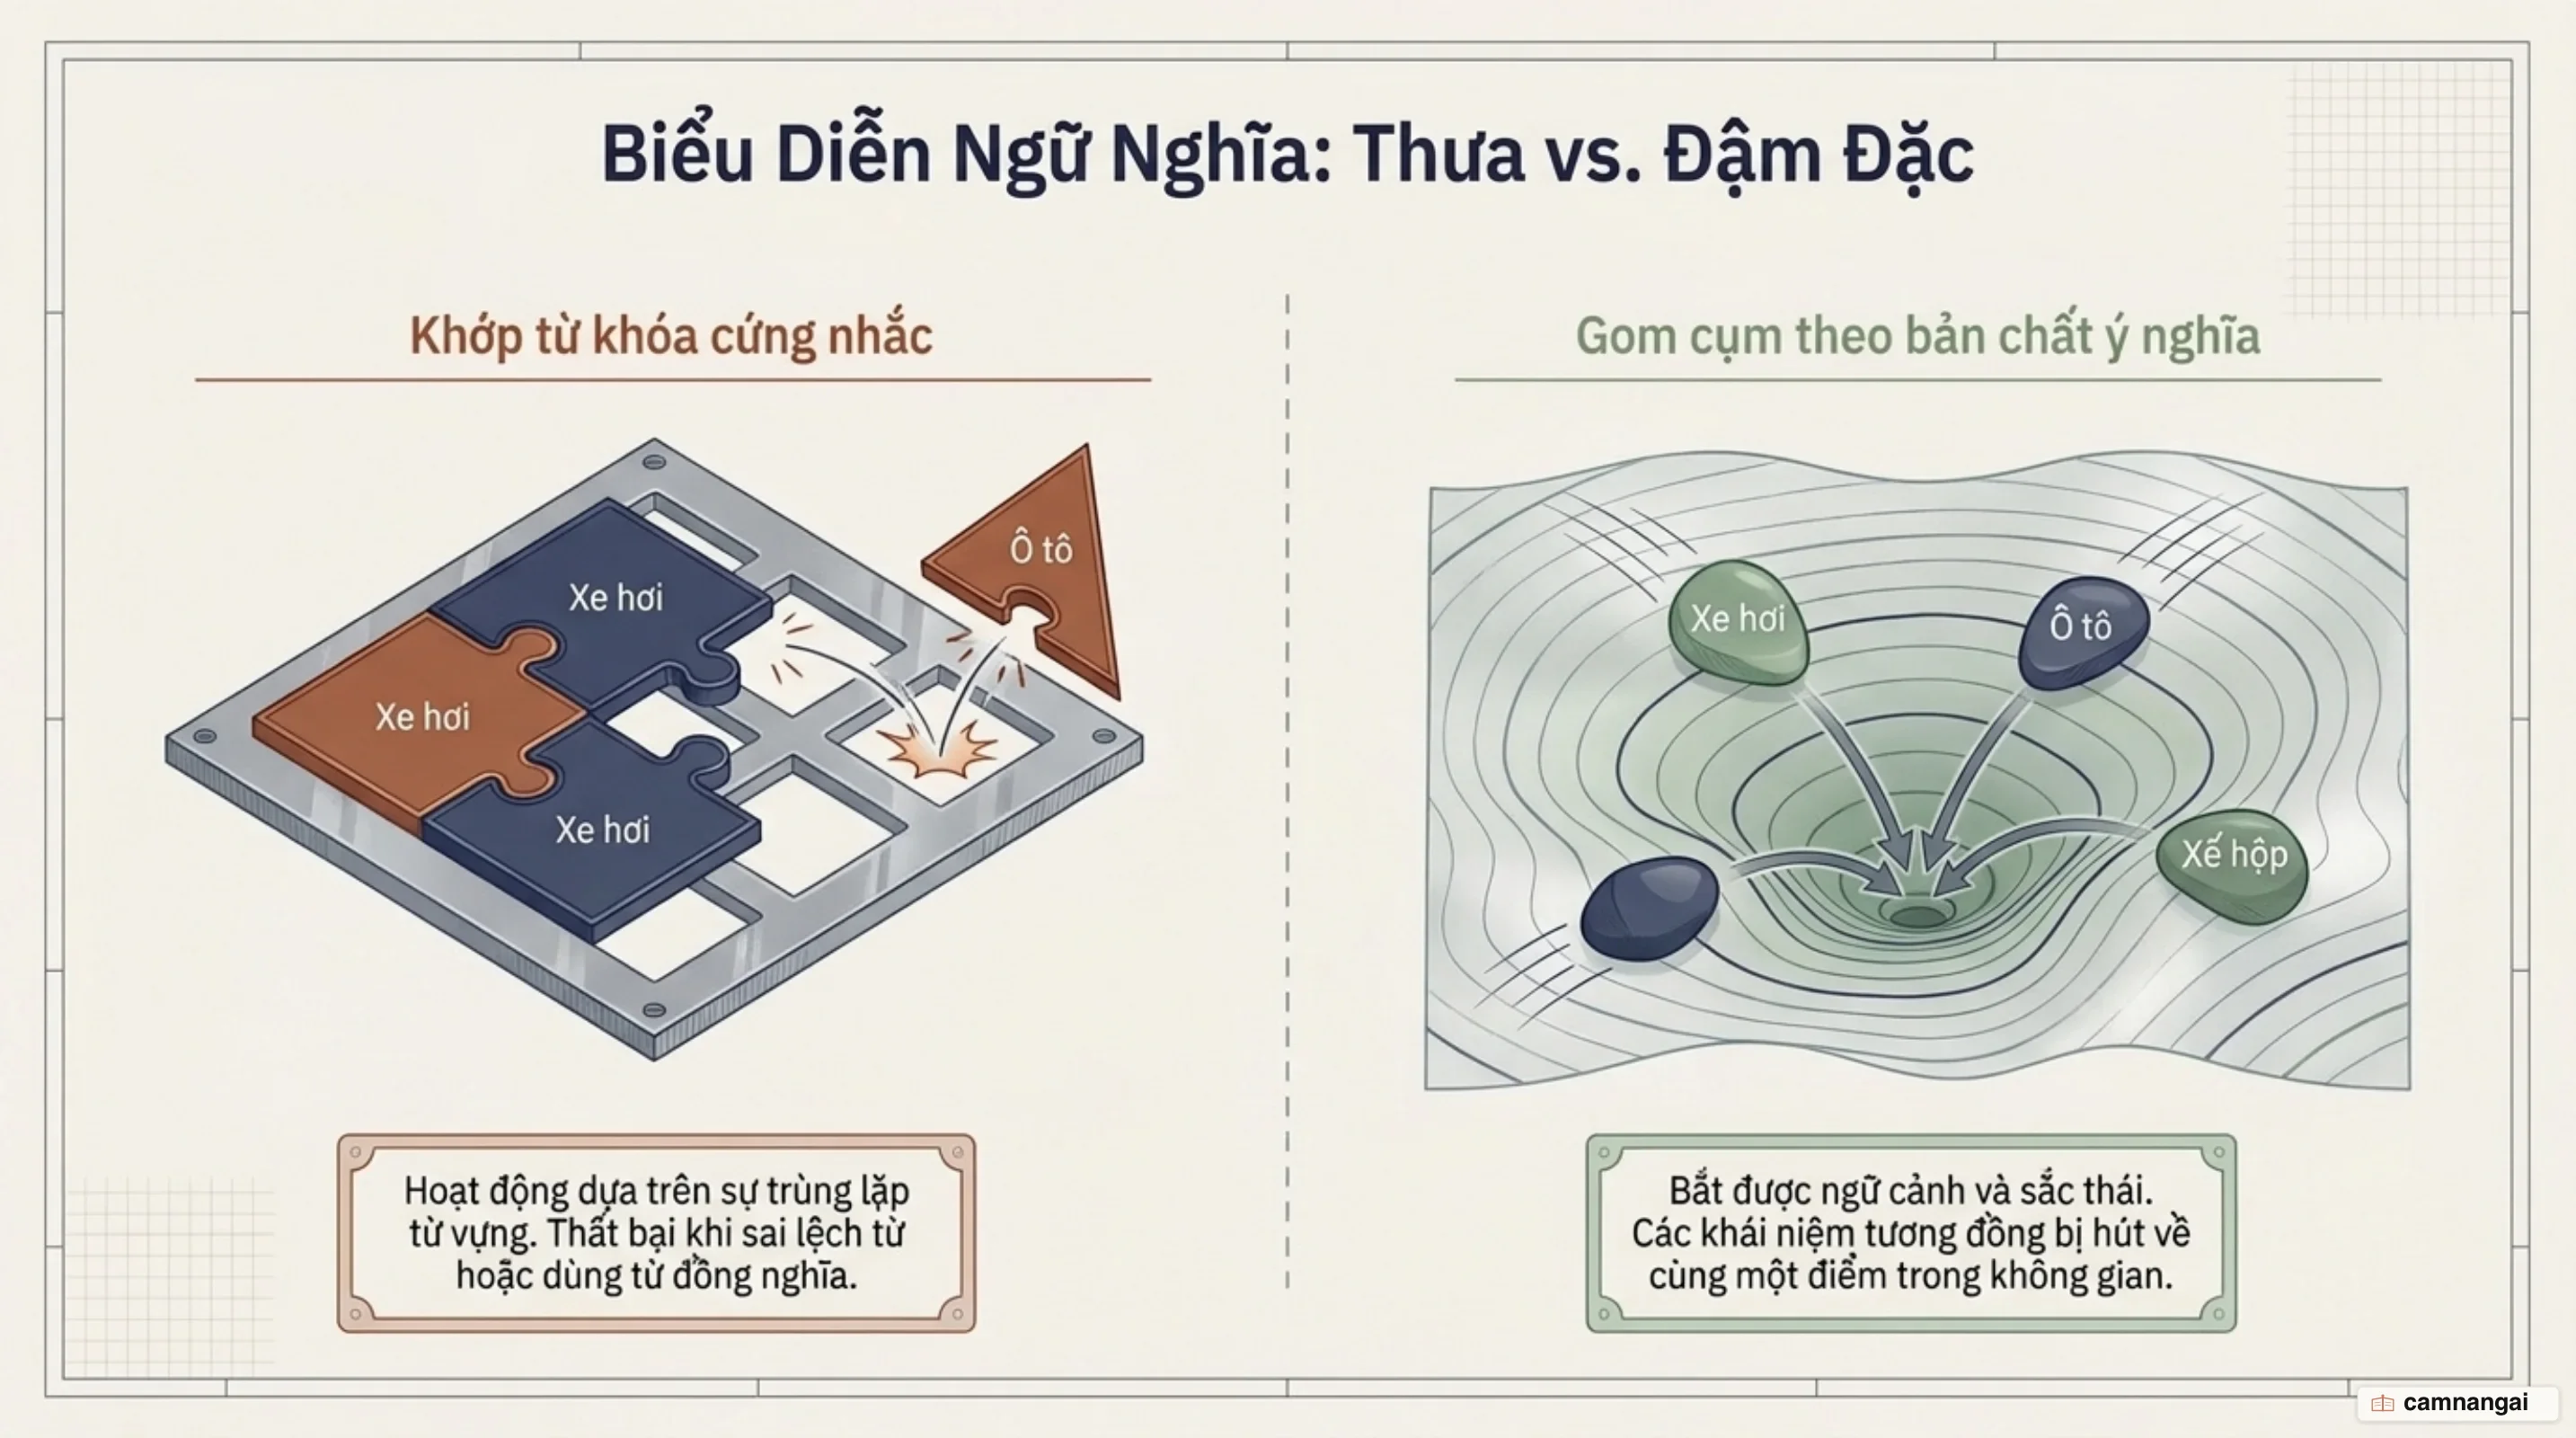
Thay vì dựa trên việc khớp từ khóa đơn thuần, kỹ sư ánh xạ ngôn ngữ tự nhiên vào không gian toán học đa chiều. Tại đây, các đặc trưng ngữ nghĩa được đại diện bởi tọa độ vector, giúp hệ thống thực hiện phân loại dữ liệu chính xác dựa trên bản chất nội dung thay vì cú pháp bề mặt.
Trong thực tế triển khai, việc sử dụng embedding giúp giải quyết bài toán hiểu ngữ cảnh mà các phương pháp vector thưa truyền thống thường bỏ sót. Bằng cách kết hợp sức mạnh biểu diễn của các mô hình ngôn ngữ lớn (LLM) với tính hiệu quả của các bộ phân loại học máy (ML) cổ điển, bạn có thể xây dựng những hệ thống có khả năng mở rộng cao, tối ưu cả về chi phí lẫn tốc độ phản hồi trên môi trường production.
Phân loại dữ liệu bằng embedding là gì và hoạt động ra sao?
Về mặt kiến trúc, phân loại dữ liệu bằng embedding dựa trên việc sử dụng các vector đậm đặc để đại diện cho thông tin. Các mô hình hiện đại cung cấp số chiều vector đa dạng: ví dụ gemini-embedding-001 sử dụng 3072 chiều, trong khi nhiều mô hình khác sử dụng 768 chiều. Khác với vector thưa (sparse vectors) vốn ánh xạ từ vựng trực tiếp thành số, dense vectors sử dụng phương pháp học sâu để nén ý nghĩa văn bản vào không gian vector, nơi các đoạn văn có nội dung tương đồng sẽ nằm gần nhau.
Để xử lý dữ liệu cho mô hình phân loại, bạn thường lưu trữ vector dưới dạng chuỗi trong tệp CSV và cần chuyển đổi chúng về định dạng mảng số học để tính toán. Dưới đây là cách xử lý dữ liệu sử dụng thư viện NumPy và module ast theo chuẩn OpenAI:
import pandas as pd
import numpy as np
from ast import literal_eval

# Tải dữ liệu và chuyển đổi chuỗi embedding thành mảng NumPy
df = pd.read_csv("data_with_embeddings_1k.csv")
df["embedding"] = df.embedding.apply(literal_eval).apply(np.array)
Vì sao embedding hiệu quả hơn các phương pháp phân loại truyền thống?
Lý do kỹ sư ưu tiên chọn embedding thay vì vector thưa là khả năng đại diện ngữ nghĩa. Dense vectors cho phép hệ thống tìm kiếm và phân loại dựa trên ý nghĩa của truy vấn ngay cả khi không có sự trùng lặp về từ vựng hoặc ngôn ngữ cụ thể giữa đầu vào và tập huấn luyện.
Một tham số kỹ thuật quan trọng cần lưu ý là output_dimensionality. Các mô hình hiện đại cho phép người dùng chủ động giảm số chiều của vector đầu ra. Việc này giúp tối ưu dung lượng lưu trữ và tăng hiệu suất tính toán cho các ứng dụng hạ nguồn (downstream applications) mà không làm suy giảm đáng kể chất lượng phân loại. Đây là yếu tố then chốt khi cân bằng giữa độ chính xác và tài nguyên hệ thống.
Các thuật toán phân loại phổ biến trên không gian vector
Khi dữ liệu đã được ánh xạ vào không gian vector chất lượng cao, chúng thường có tính phân tách tuyến tính tốt. Do đó, các mô hình tuyến tính thường là lựa chọn tối ưu về hiệu năng:
- Logistic Regression: Mô hình tiêu chuẩn, dễ triển khai và cho kết quả ổn định.
- Ridge Classifier: Đây là lựa chọn ưu tiên khi xử lý bài toán nhiều lớp (multiclass). Ridge Classifier nhanh hơn đáng kể so với Logistic Regression vì nó coi bài toán phân loại như một bài toán hồi quy đa đầu ra và chỉ cần tính toán ma trận chiếu $(X^T X)^-1 X^T$ duy nhất một lần.
- Random Forest Classifier: Phù hợp khi cần xử lý các mối quan hệ phi tuyến phức tạp trong không gian vector.
- SGDClassifier: Lựa chọn hàng đầu cho tập dữ liệu cực lớn hoặc học trực tuyến (online learning) nhờ tối ưu hóa gradient ngẫu nhiên.
So sánh kiến trúc: Embedding + Classifier, Fine-tuning và Zero-shot Prompting
Việc lựa chọn kiến trúc phụ thuộc vào quy mô dữ liệu và tài nguyên tính toán:
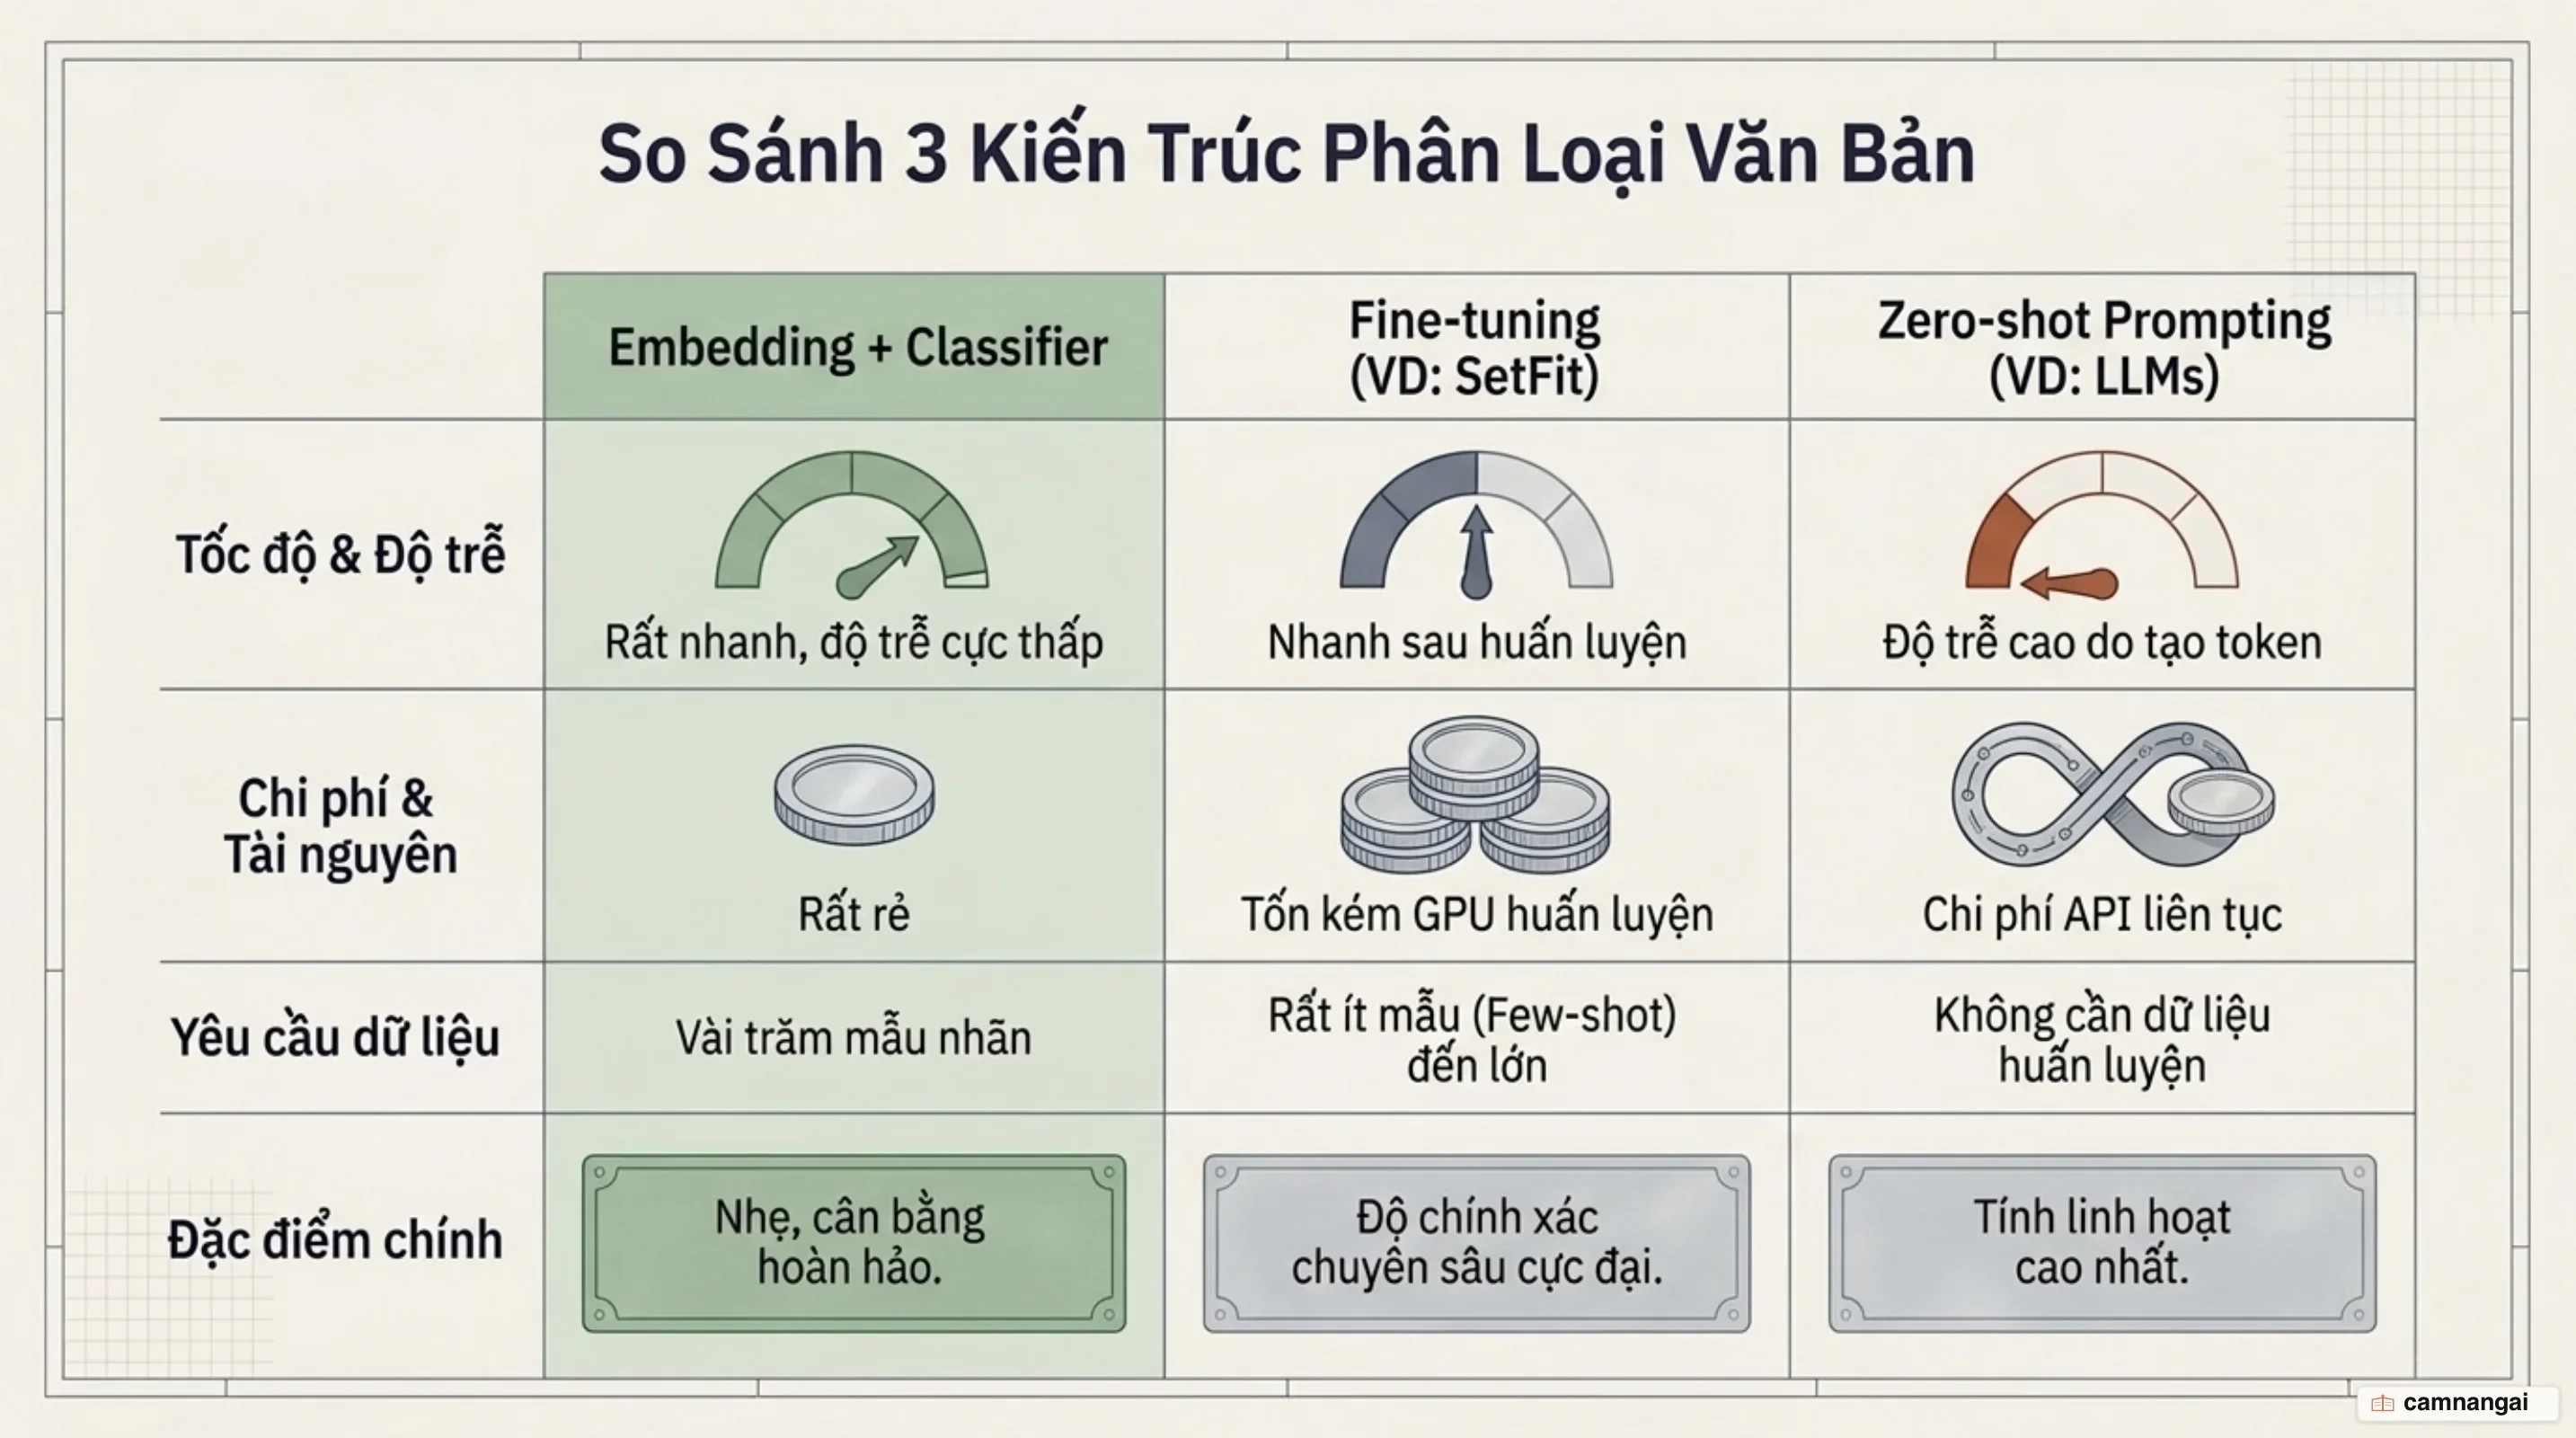
- Fine-tuning: Thông thường, các mô hình được tinh chỉnh sẽ cho kết quả tốt hơn embedding trong các tác vụ phân loại đặc thù. Tuy nhiên, chi phí huấn luyện và duy trì mô hình lớn hơn nhiều.
- Embedding + Classifier: Huấn luyện một bộ phân loại nhẹ (như Random Forest) trên vector embedding tiết kiệm tài nguyên hơn và linh hoạt hơn. Một quy tắc thực nghiệm quan trọng từ OpenAI là số lượng mẫu huấn luyện ($N$) nên lớn hơn số chiều của embedding ($D$) để tránh hiện tượng quá khớp (overfitting).
- Zero-shot Prompting: Linh hoạt nhất nhưng thường có độ trễ cao và chi phí token lớn khi chạy ở quy mô lớn.
Ứng dụng thực tế và những cạm bẫy kỹ thuật cần tránh
Trong bài toán phân loại review đồ ăn (1-5 sao), dữ liệu cho thấy các nhãn cực đoan (1 và 5 sao) rất dễ phân biệt. Tuy nhiên, độ chính xác cực cao ở nhãn 5 sao thường do hiện tượng mất cân bằng dữ liệu (đây là lớp chiếm đa số) hơn là do tính rõ ràng ngữ nghĩa. Các nhãn trung gian (2-4 sao) khó phân loại hơn do tính chủ quan của con người.
Về mặt kỹ thuật, cần lưu ý:
- Đa cộng tuyến (Multicollinearity): Các đặc trưng trong embedding có thể liên quan chặt chẽ, gây nhiễu cho mô hình tuyến tính.
- Dữ liệu ngoại lai (Outliers): Nếu dữ liệu vector bị nhiễu, hãy sử dụng Huber Regression. Khác với RANSAC, Huber Regression không bỏ qua các điểm ngoại lai mà gán cho chúng trọng số thấp hơn (linear loss thay vì squared loss). Ngoài ra, Huber còn có ưu điểm là tính bất biến theo tỉ lệ (scaling invariant), giúp duy trì tính mạnh mẽ khi dữ liệu $X$ và $y$ thay đổi thang đo.
Khi nào nên dùng embedding để phân loại dữ liệu trong production?
Trong hệ thống production, sự kết hợp giữa embedding và các mô hình học máy nhẹ là phương án tối ưu khi ưu tiên tốc độ phản hồi và chi phí thấp. Hệ thống này cho phép cập nhật logic phân loại nhanh chóng mà không cần tái huấn luyện các LLM phức tạp.
Một lưu ý kỹ thuật bắt buộc: phải chuẩn hóa ma trận đặc trưng $X$ trước khi huấn luyện. Việc chuẩn hóa đảm bảo các thành phần trong vector được đối xử công bằng khi áp dụng hình phạt L2 (trong Ridge hoặc Logistic Regression). Nếu không chuẩn hóa, các đặc trưng có thang đo lớn hơn sẽ bị phạt không công bằng, làm giảm tính ổn định và độ chính xác của bộ phân loại.
Tài liệu tham khảo
- Classification using embeddings — OpenAI Cookbook
- Get text embeddings — Google Cloud Vertex AI
- Introduction to Embeddings — Cohere Documentation
- SetFit: Efficient Few-Shot Learning Without Prompts — Hugging Face
- Zero-shot Image Classification with OpenAI's CLIP — Pinecone
- 1.1. Linear Models — scikit-learn Documentation
- Pretrained Models and Cross-Encoders — Sentence Transformers Documentation