Hệ thống gợi ý là một giải pháp kỹ thuật nhằm tạo ra danh sách các ứng viên (candidates) liên quan nhất dựa trên truy vấn (query) của người dùng từ một kho dữ liệu khổng lồ.
Mô hình ánh xạ các tương tác và hành vi phức tạp thành một tập hợp hữu hạn các đề xuất có giá trị cao nhất thông qua các cấu trúc dữ liệu và mô hình tối ưu.
Trong các hệ thống quy mô công nghiệp, việc xử lý hàng triệu mục (items) đòi hỏi sự thay đổi về mặt kiến trúc từ các phương pháp truyền thống sang sử dụng vector embeddings. Bằng cách chuyển đổi dữ liệu thành các vector trong không gian toán học, bạn có thể tính toán mức độ tương đồng giữa người dùng và sản phẩm hiệu quả, đảm bảo độ trễ thấp ngay cả khi khối lượng dữ liệu cực lớn.
Quy trình triển khai hiện đại thường được phân tầng để cân bằng giữa hiệu suất (efficiency) và độ chính xác (precision). Việc kết hợp giữa các mô hình học sâu (Deep Learning) và cơ sở dữ liệu vector (Vector Database) đóng vai trò là xương sống kỹ thuật cho các nền tảng đề xuất nội dung và thương mại điện tử quy mô lớn.
Vì sao hệ thống gợi ý hiện đại chuyển sang vector embeddings?
Sự dịch chuyển từ Ma trận phân rã (Matrix Factorization) sang các kiến trúc dựa trên Mạng nơ-ron sâu (Deep Neural Networks - DNN) là hệ quả tất yếu khi hệ thống gợi ý cần xử lý các đặc trưng phức tạp. Ma trận phân rã có những hạn chế cố hữu: nó chỉ có thể truy vấn các người dùng hoặc sản phẩm đã xuất hiện trong tập huấn luyện, đồng thời khó tích hợp các đặc trưng phụ (side features) như ngữ cảnh thời gian hay vị trí địa lý. Hơn nữa, phương pháp này thường bị thiên kiến bởi các mục phổ biến (popularity bias), làm giảm khả năng cá nhân hóa.
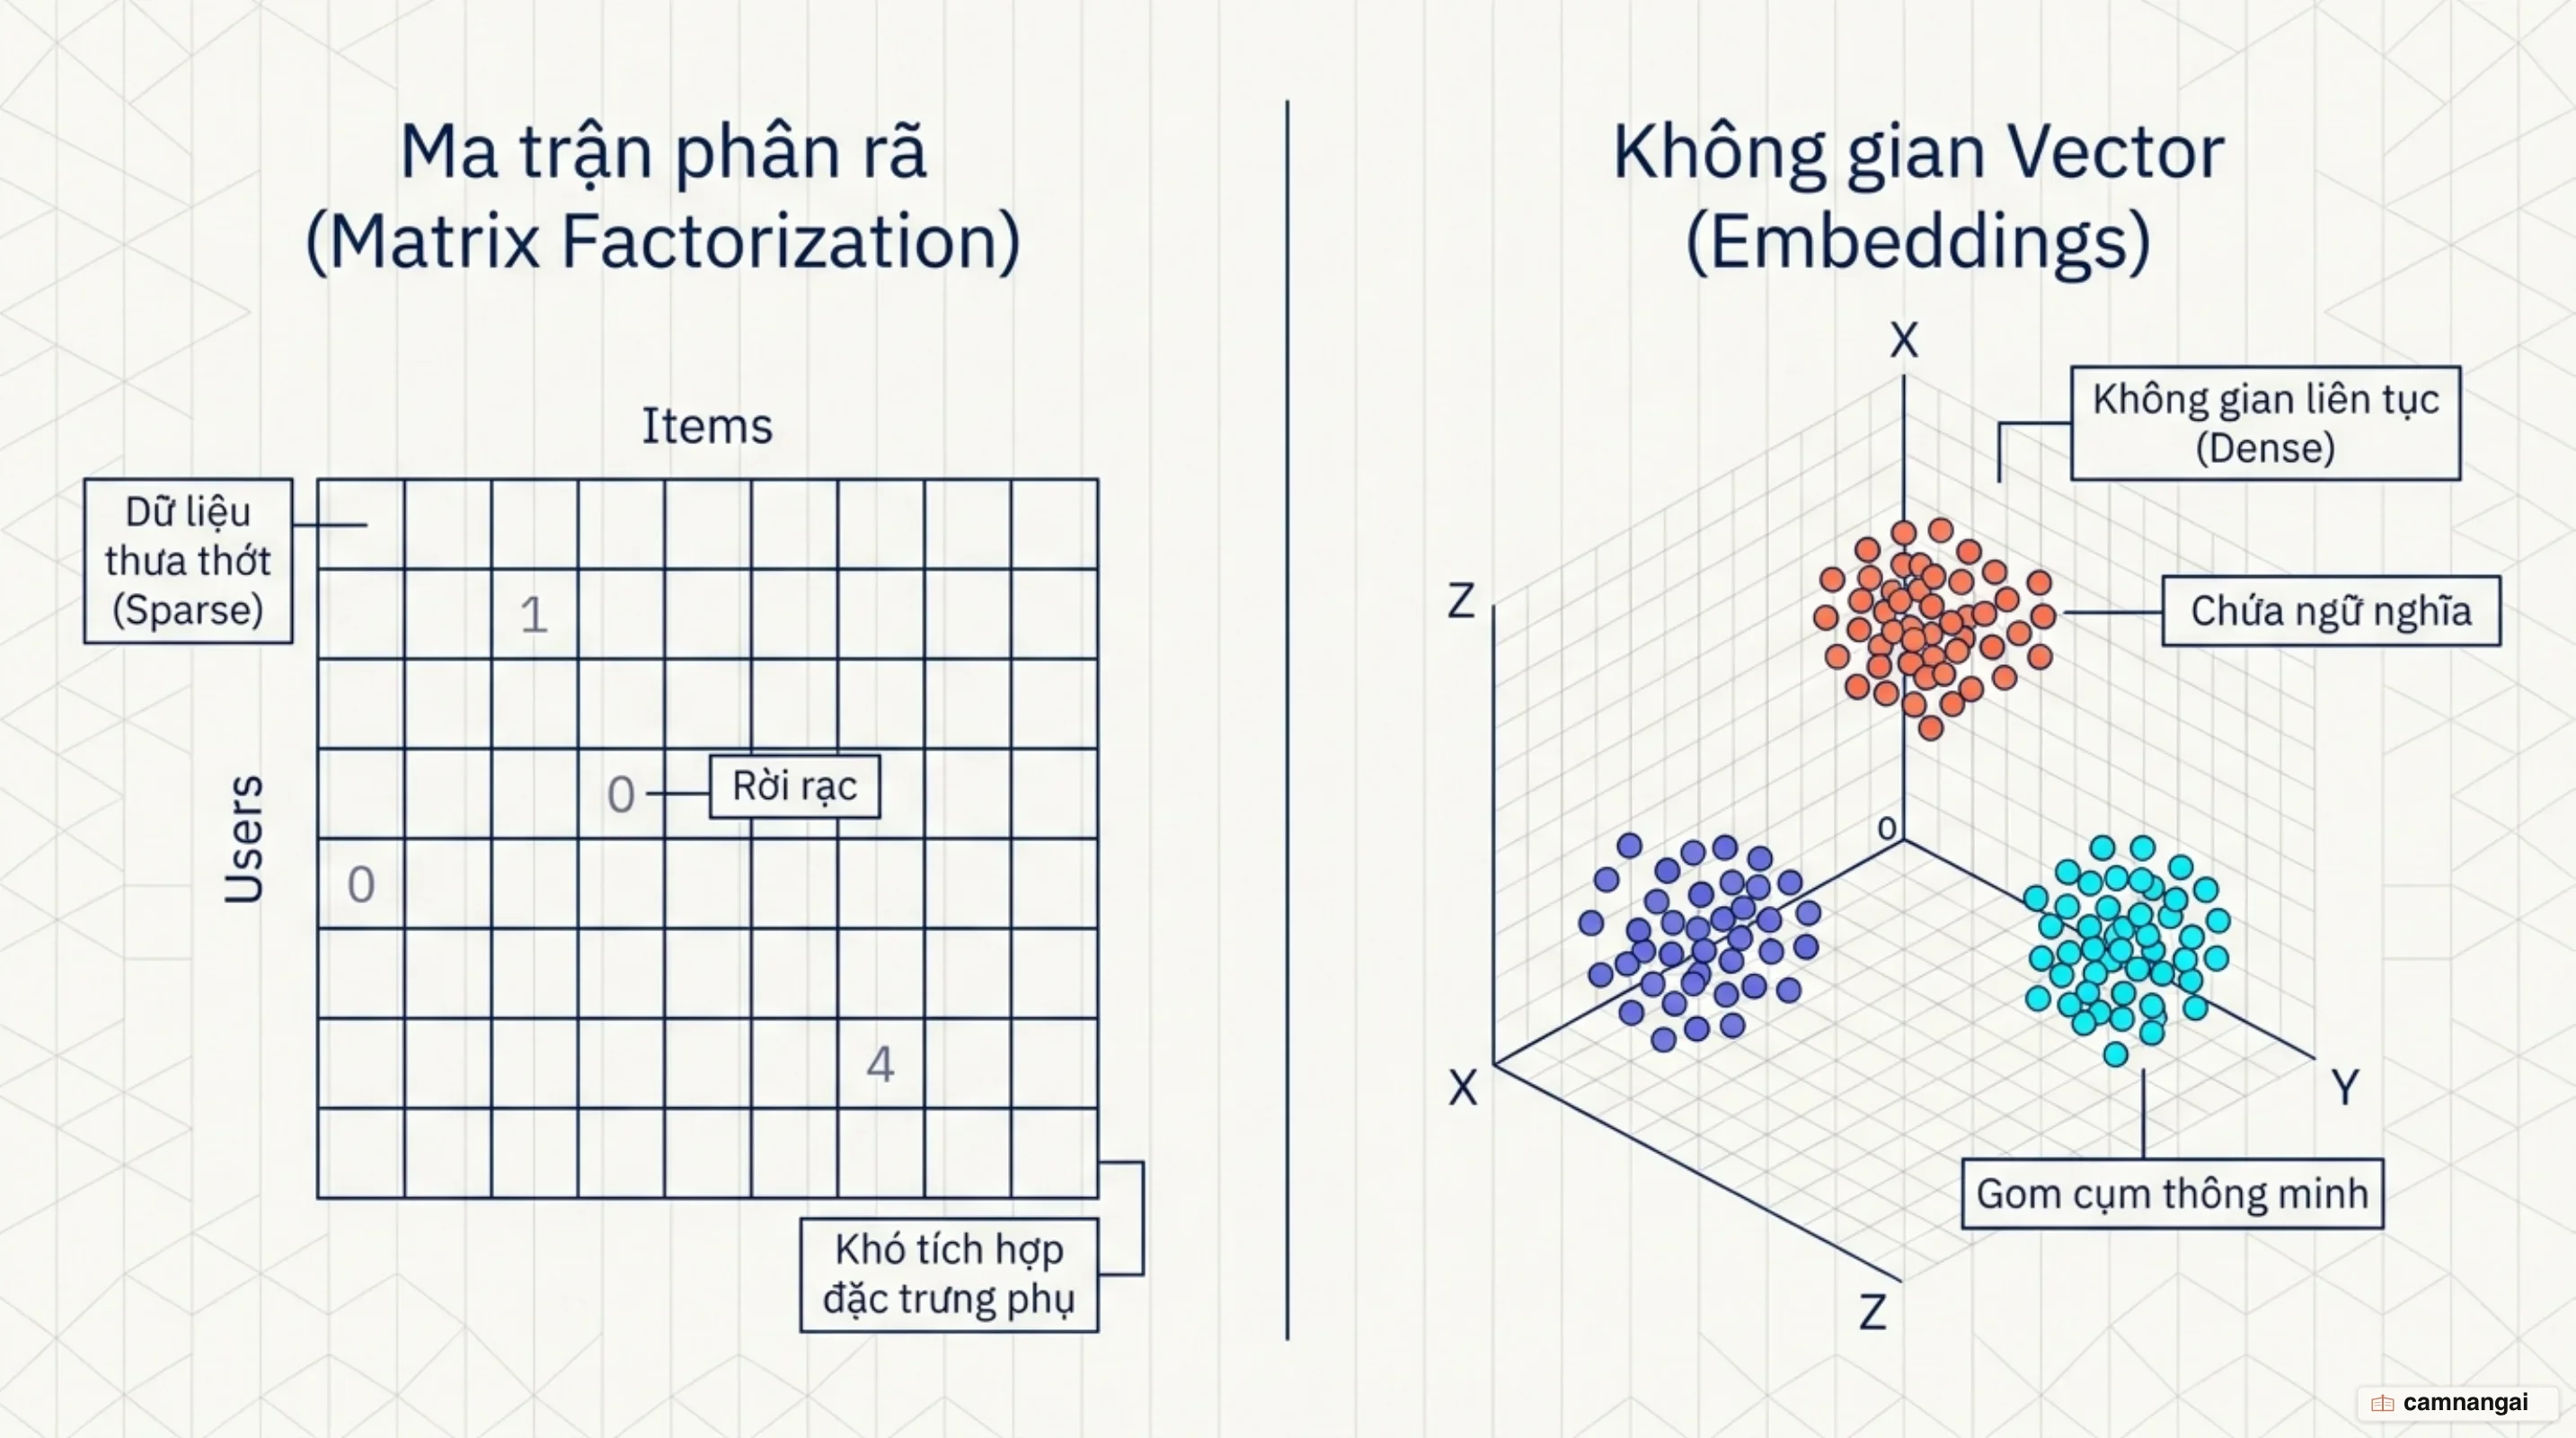
Về mặt kỹ thuật, DNN là một sự tổng quát hóa của Ma trận phân rã, trong đó phía người dùng hoặc truy vấn được thay thế bằng một hàm phi tuyến ψ(x). Chúng ta định nghĩa không gian embedding (E = R^d) để ánh xạ các mục và truy vấn vào một không gian vector có số chiều thấp, giúp bảo toàn cấu trúc tiềm ẩn của dữ liệu. Các thực thể tương đồng sẽ nằm gần nhau (closeness) trong không gian này.
Tuy nhiên, bạn cần lưu ý về phép đo tương đồng. Phép toán Tích vô hướng (Dot Product) nhạy cảm với độ dài (norm) của vector. Các mục phổ biến thường có norm lớn và dễ được ưu tiên quá mức. Ngược lại, các mục hiếm nếu được khởi tạo với norm lớn mà không được điều chỉnh (regularization) đúng cách sẽ dẫn đến các gợi ý sai lệch.
Kiến trúc Two-Tower: Cầu nối giữa người dùng và sản phẩm
Kiến trúc Two-Tower (Hai tháp) là tiêu chuẩn để mô hình hóa mối quan hệ user-item ở quy mô lớn, cho phép bạn tách biệt quá trình tính toán embedding cho người dùng và sản phẩm:
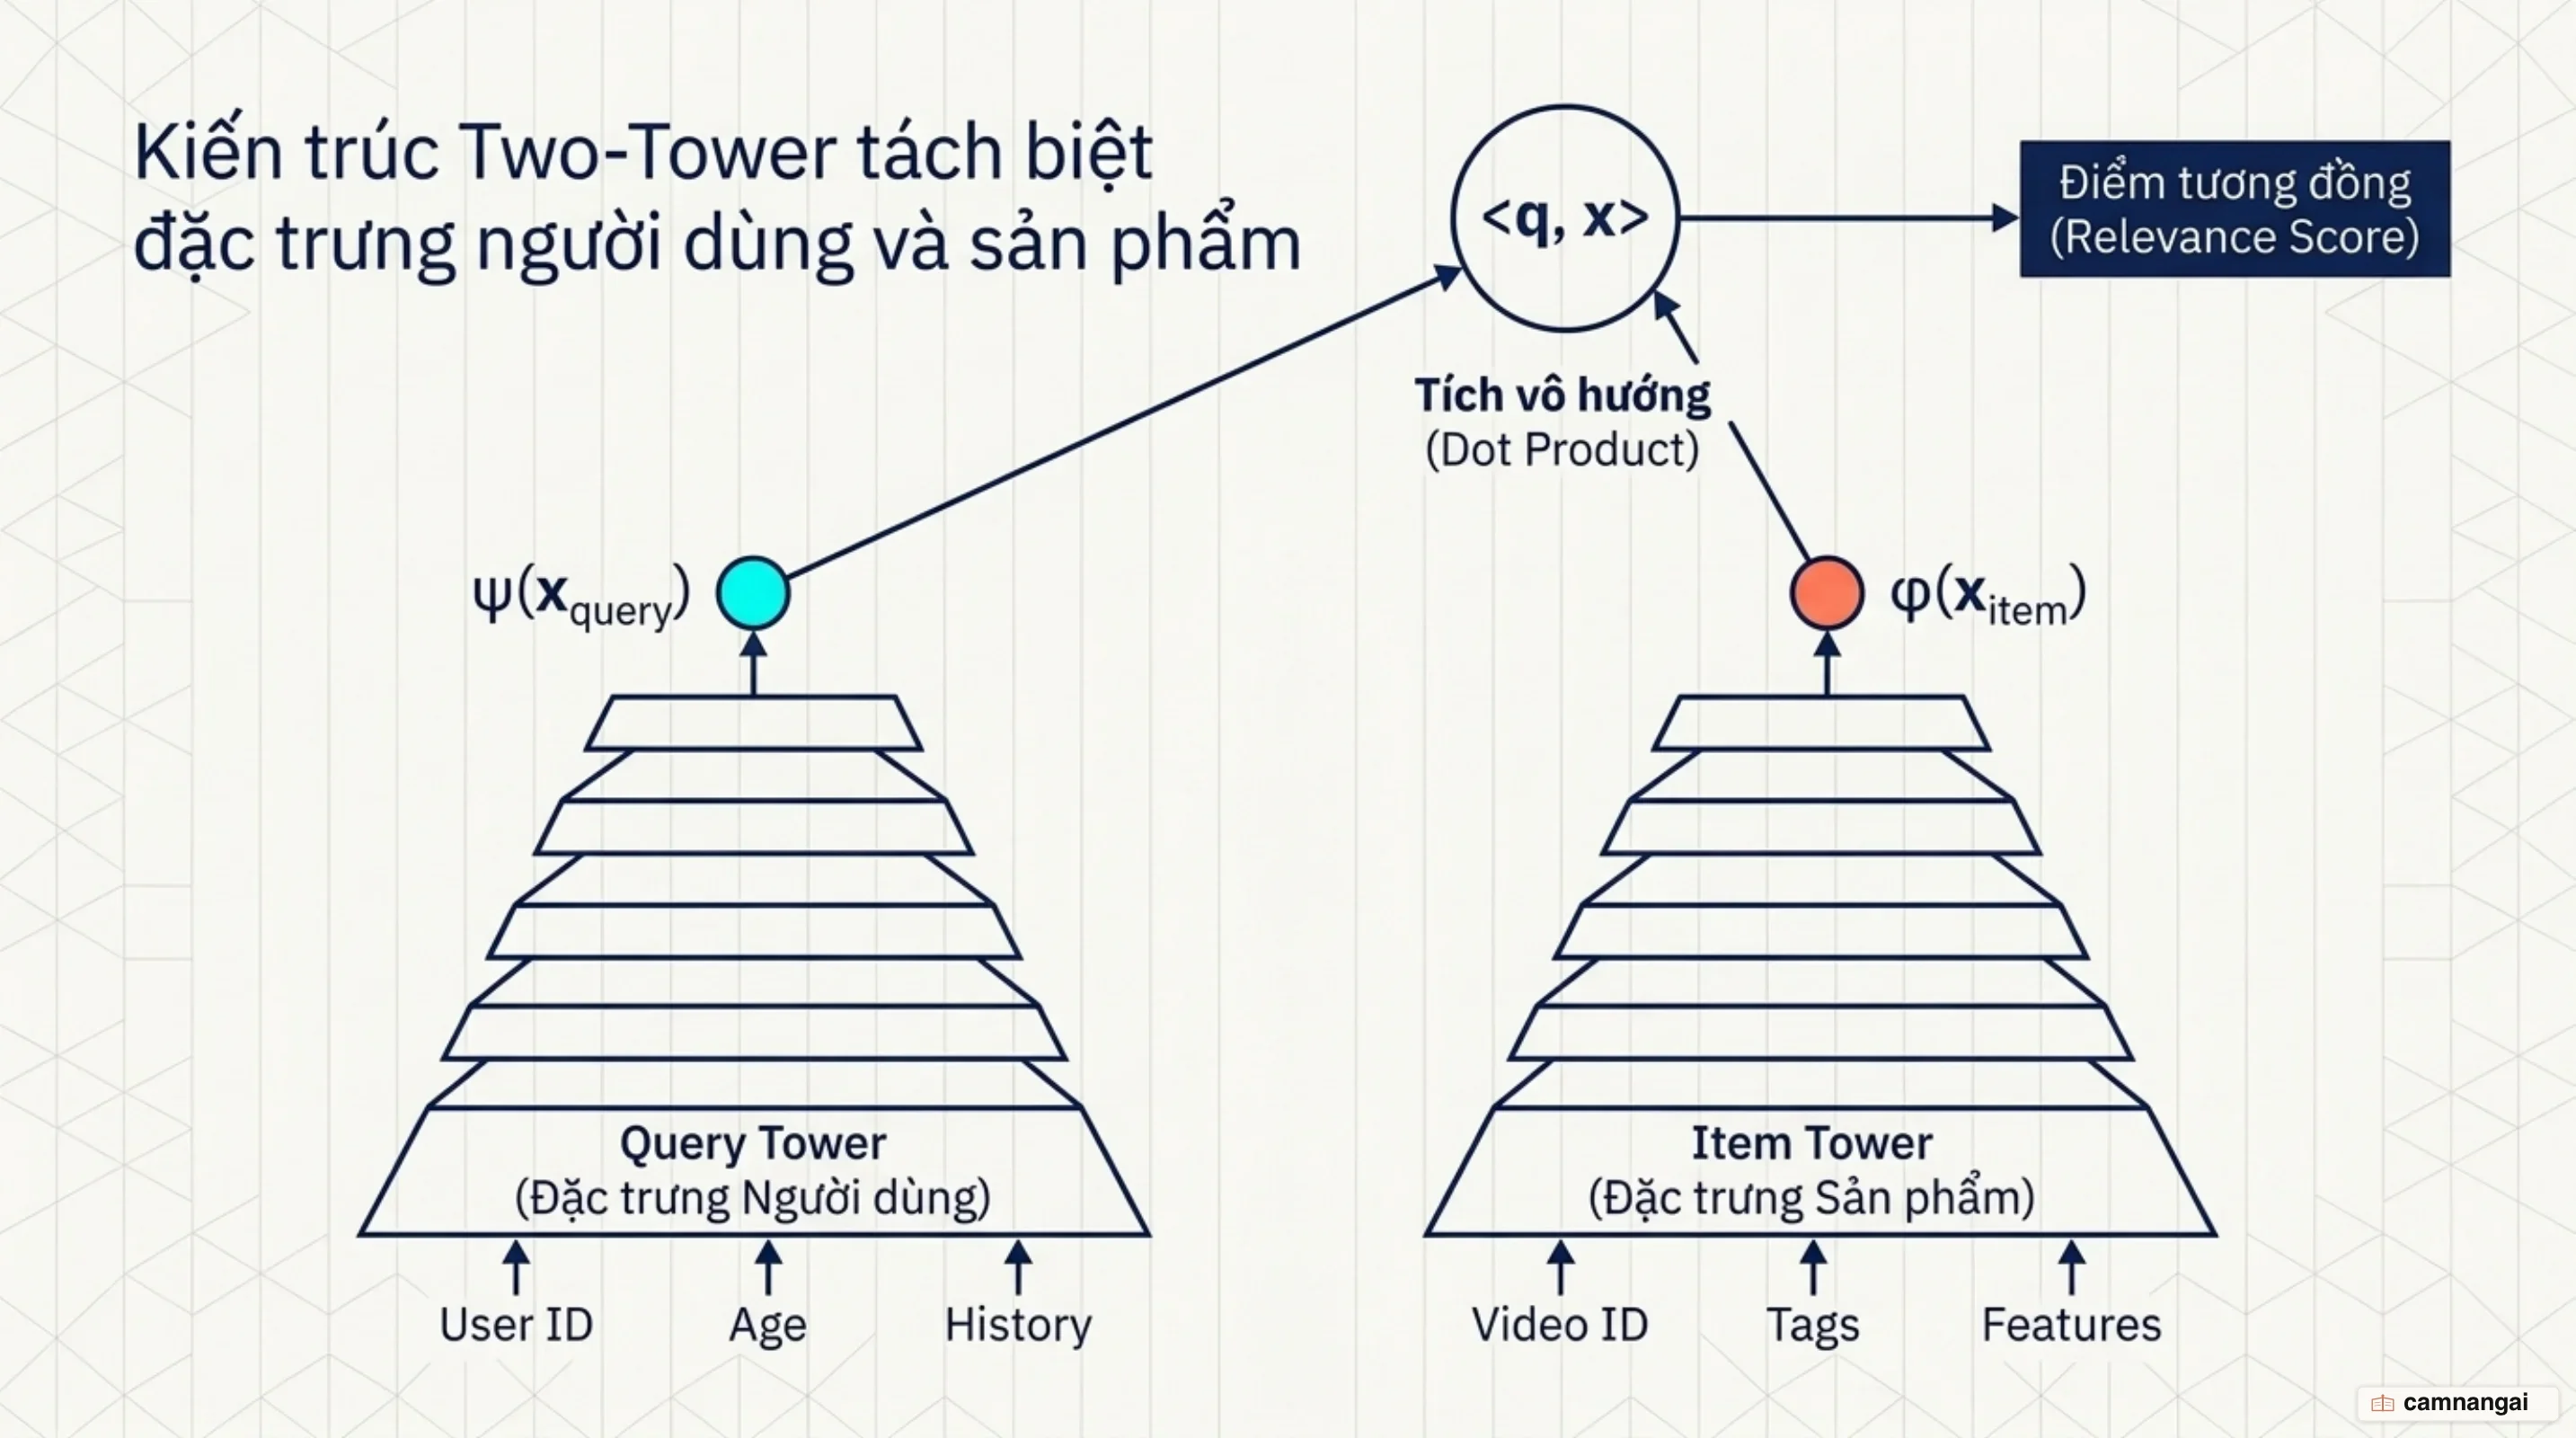
- Query Tower (Tháp truy vấn): Ánh xạ các đặc trưng đầu vào của người dùng và ngữ cảnh (tuổi, lịch sử xem, quốc gia) thành một vector đại diện
ψ(x_query) ∈ R^d. - Item Tower (Tháp sản phẩm): Ánh xạ các đặc điểm sản phẩm thành vector
ϕ(x_item) ∈ R^d. Một ưu điểm kỹ thuật quan trọng là tháp này cho phép giải quyết bài toán Cold-start: bạn có thể tạo embedding cho sản phẩm mới (Out-of-vocabulary - OOV) đơn giản bằng cách đưa các đặc trưng của nó qua tháp sản phẩm.
Đầu ra của mô hình là tích vô hướng ⟨ψ(x_query), ϕ(x_item)⟩. Mạng nơ-ron sâu trong kiến trúc này xử lý tốt cả đặc trưng dày đặc (dense) và thưa thớt (sparse), cho phép học các mối quan hệ phi tuyến tính mà Ma trận phân rã truyền thống bỏ lỡ. Điểm mấu chốt trong vận hành thực tế là bạn có thể tính toán trước toàn bộ vector của tháp sản phẩm và nạp vào bộ chỉ mục tìm kiếm, giúp giảm thời gian truy vấn trực tiếp xuống mức tối thiểu.
Quy trình đa tầng: Từ Candidate Generation đến Ranking
Để vận hành hệ thống gợi ý trong môi trường thực tế, các nền tảng kỹ thuật quy mô lớn áp dụng quy trình 4 giai đoạn nhằm cân bằng giữa chi phí tính toán và chất lượng gợi ý:
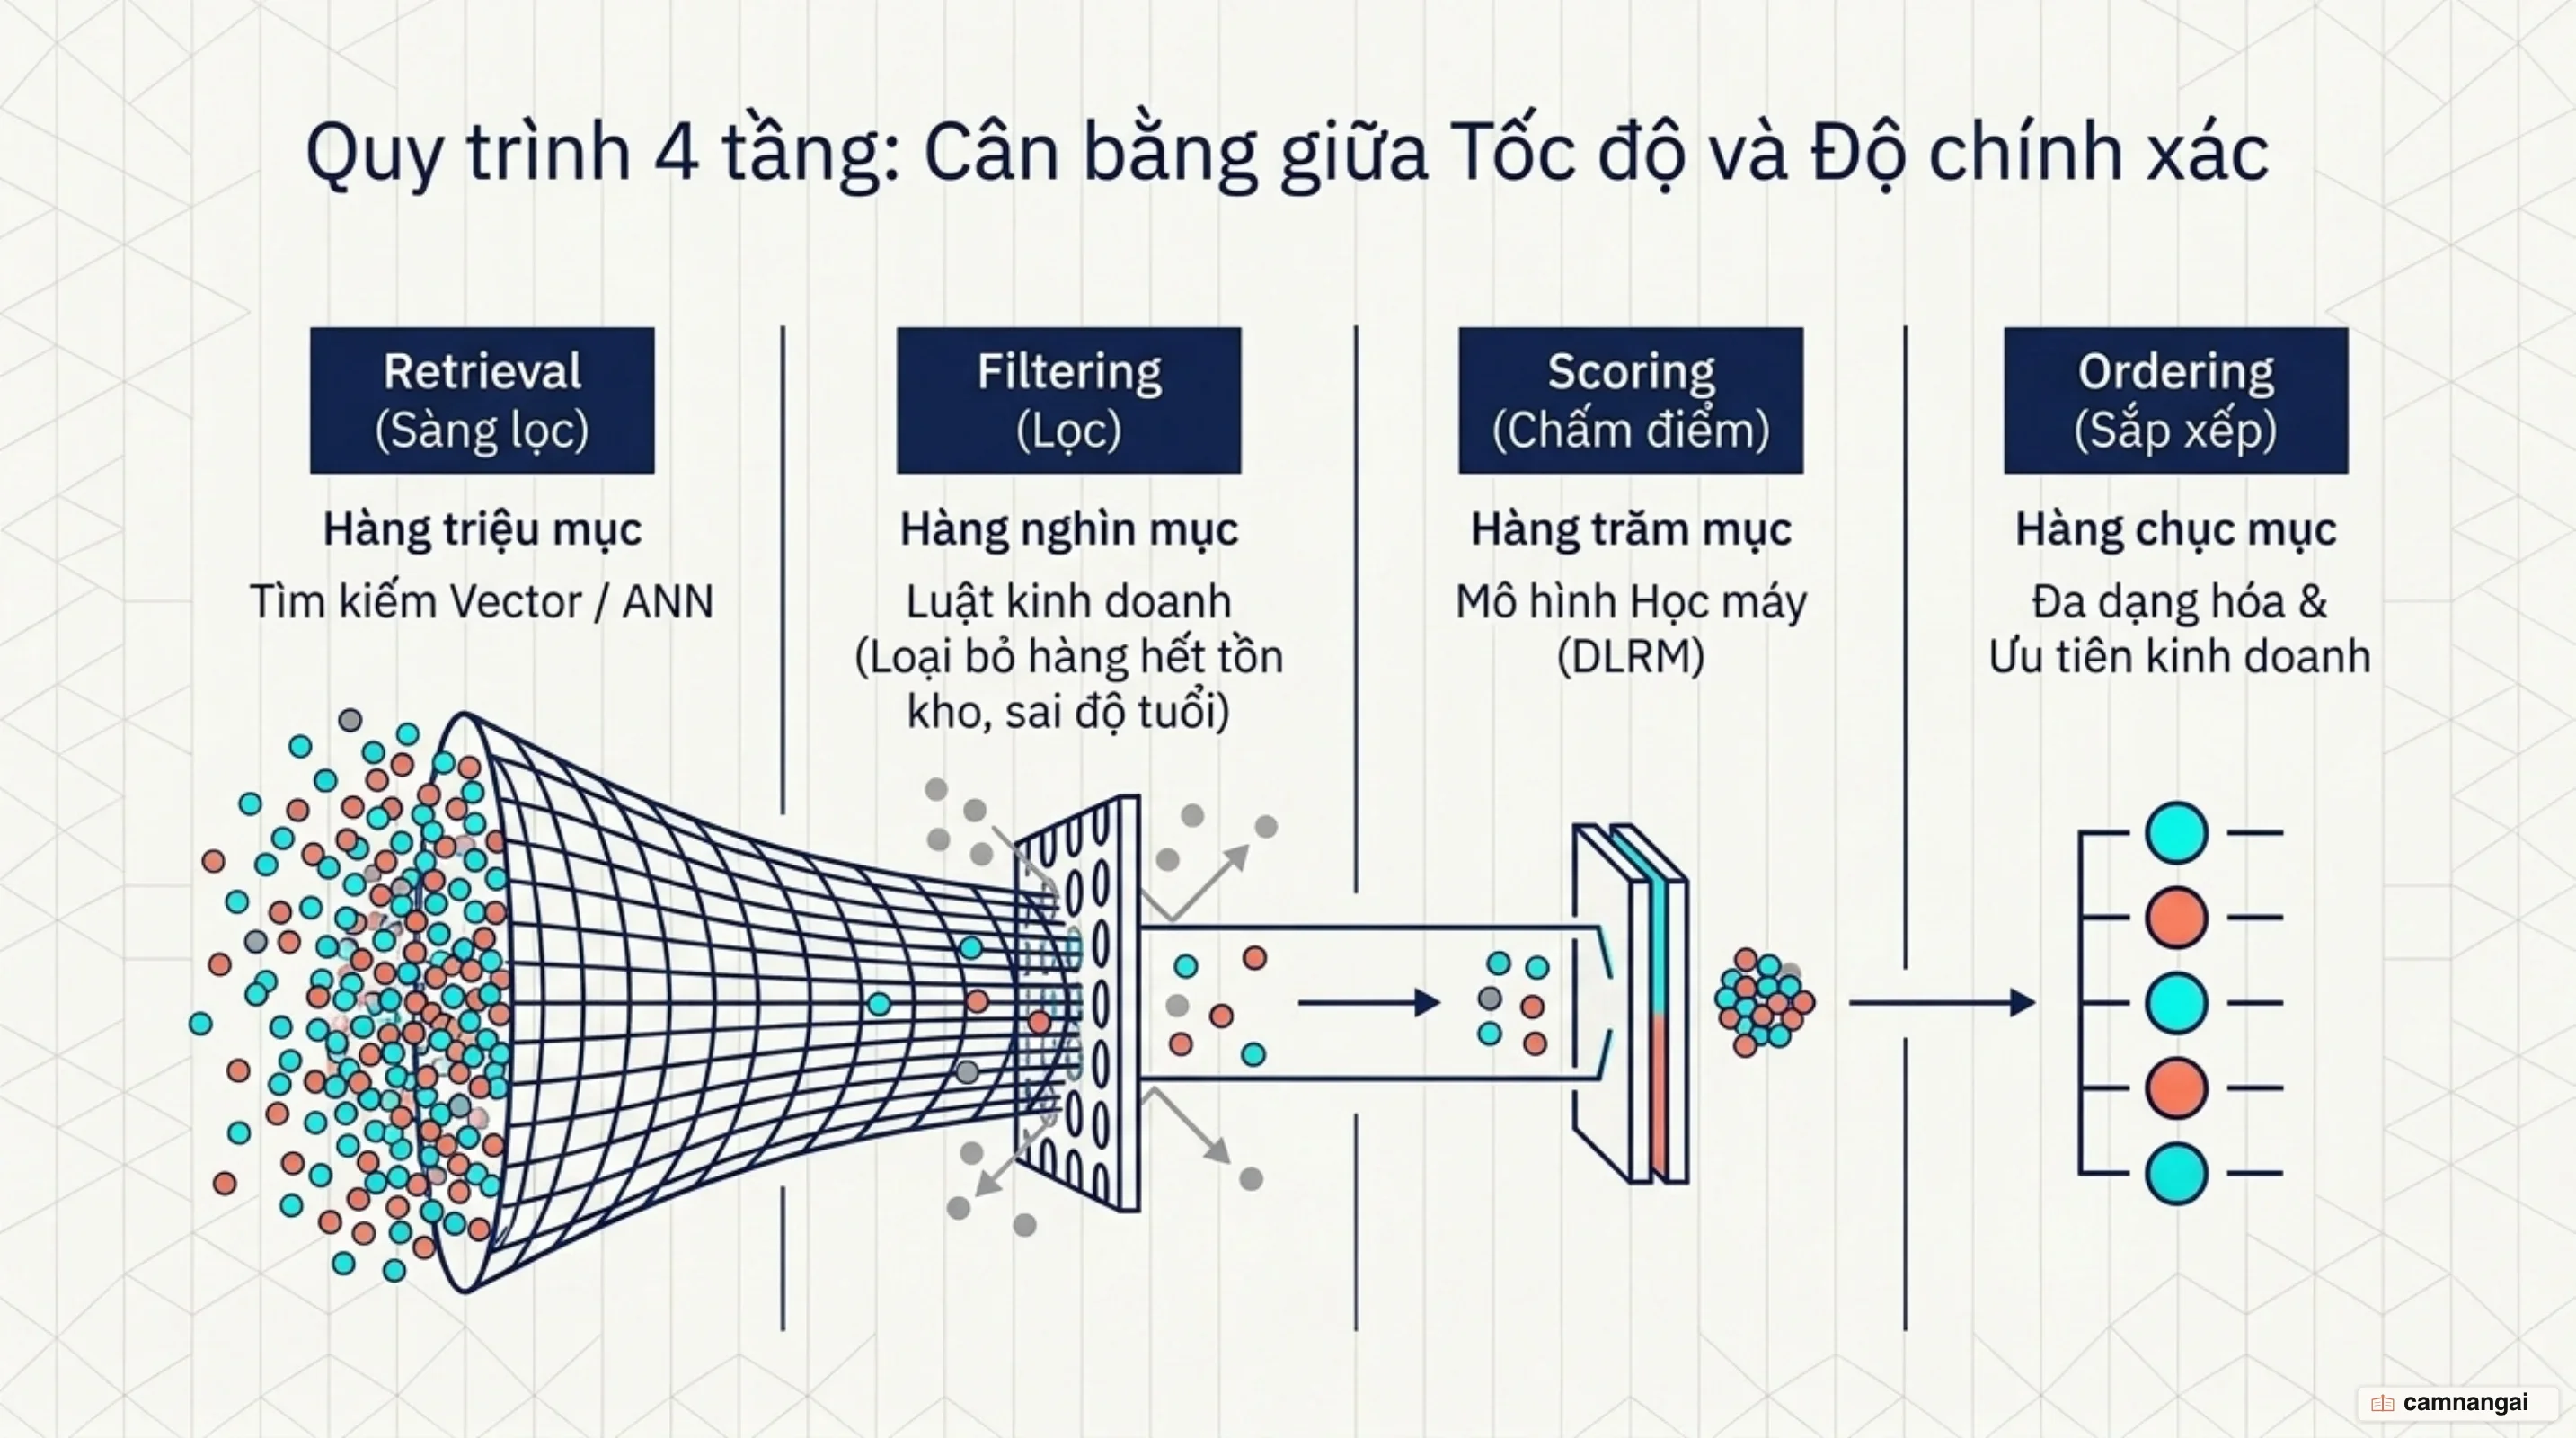
- Retrieval (Thu thập / Candidate Generation): Giai đoạn này ưu tiên tốc độ, sàng lọc từ hàng triệu mục xuống còn vài trăm ứng viên tiềm năng bằng vector embeddings. Mục tiêu là đạt Recall (độ phủ) cao nhất có thể trong thời gian cực ngắn (dưới 20–50 ms).
- Filtering (Lọc): Tại đây, bạn áp dụng các quy tắc logic kinh doanh cứng mà mô hình học máy khó tự học được, ví dụ: loại bỏ sản phẩm đã hết hàng, nội dung giới hạn độ tuổi, hoặc các mục người dùng vừa mới tương tác gần đây.
- Scoring/Ranking (Xếp hạng): Sử dụng các mô hình học máy phức tạp hơn (như DLRM) để dự đoán chính xác xác suất tương tác (CTR, CVR) cho danh sách ứng viên đã lọc. Giai đoạn này ưu tiên Precision (độ chính xác) và có thể sử dụng hàng trăm hoặc hàng ngàn đặc trưng chi tiết.
- Ordering (Sắp xếp / Re-ranking): Bước cuối cùng để điều chỉnh kết quả theo các ràng buộc như tính đa dạng (diversity) hoặc tính mới (novelty), tránh việc hệ thống chỉ lặp lại một loại nội dung gây nhàm chán cho người dùng.
Tìm kiếm vector tương đồng (ANN) và vai trò của Vector Database
Trong quá trình phục vụ trực tiếp (serving), việc so sánh vector truy vấn với mọi vector sản phẩm (Brute-force) có độ phức tạp thuật toán O(N) là bất khả thi khi catalog có hàng triệu mục. Thay vào đó, bạn phải sử dụng các thuật toán Tìm kiếm lân cận gần đúng (Approximate Nearest Neighbor - ANN) như HNSW (Hierarchical Navigable Small World) để giảm độ phức tạp xuống mức O(log N).
Lựa chọn phép đo khoảng cách là một quyết định hạ tầng quan trọng:
- Dot Product: Nhạy cảm với độ lớn của vector, phù hợp nếu bạn muốn tích hợp sẵn yếu tố phổ biến của mục vào điểm số gợi ý.
- Cosine Similarity: Chỉ tập trung vào hướng (góc giữa hai vector), loại bỏ hoàn toàn ảnh hưởng của độ dài vector, phù hợp cho bài toán tìm kiếm tương đồng thuần ngữ nghĩa.
- Euclidean Distance: Đo khoảng cách hình học trực tiếp giữa hai điểm trong không gian. Khi các vector đã được chuẩn hóa (normalized), bình phương khoảng cách Euclidean tỷ lệ nghịch với Dot Product, mang lại kết quả xếp hạng tương đương.
Các giải pháp Vector Database đóng vai trò quản lý chỉ mục vector, hỗ trợ truy vấn lọc kết hợp (hybrid search / filtered search) và đảm bảo tính nhất quán của dữ liệu khi hệ thống mở rộng theo chiều ngang.
Thách thức kỹ thuật: Cold-start, độ trễ và cập nhật embedding thời gian thực
Vận hành hệ thống gợi ý quy mô Terabyte đòi hỏi các giải pháp hạ tầng chuyên sâu để giải quyết các nút thắt cổ chai:
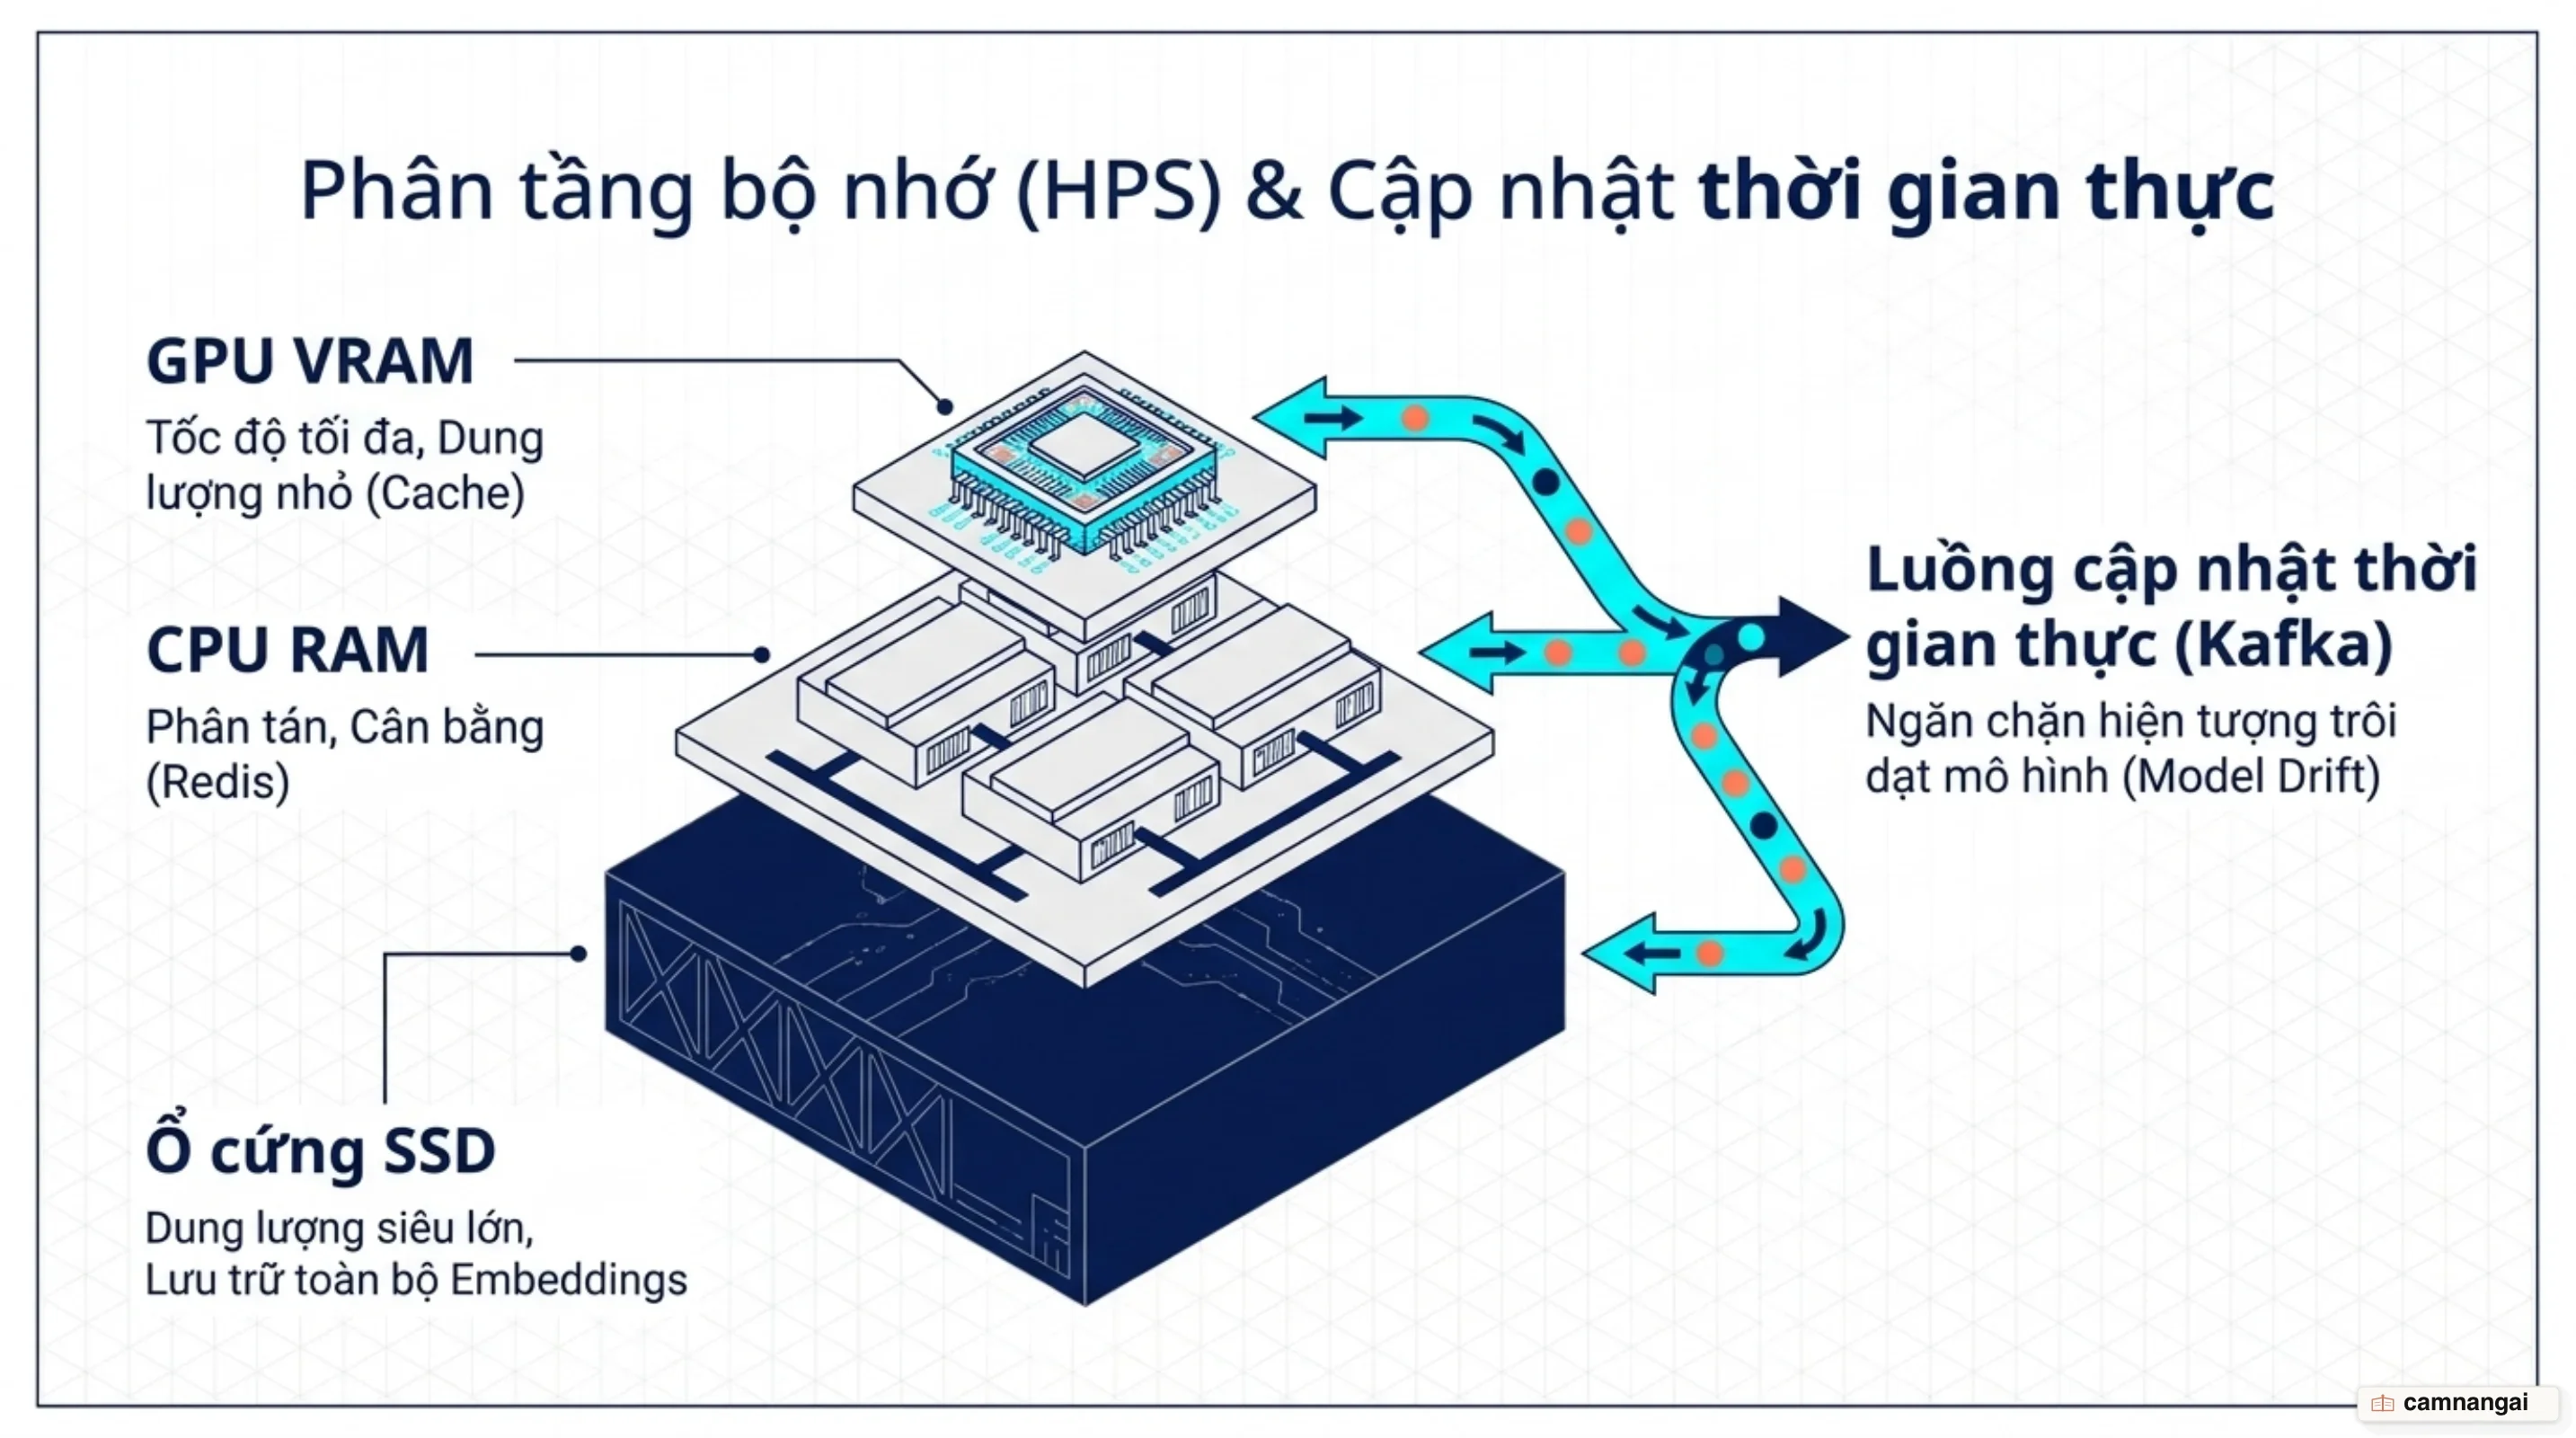
- Hệ thống phân tầng bộ nhớ (Hierarchical Parameter Server - HPS): Do bảng embedding quá lớn không thể nằm trọn trong bộ nhớ GPU, bạn cần sử dụng kiến trúc phân tầng: GPU cache cho các embedding truy cập thường xuyên nhất, bộ nhớ CPU/Redis để duy trì dung lượng lớn, và ổ cứng SSD để đảm bảo tính bền vững và khả năng phục hồi lỗi.
- Xử lý Cold-start: Giải quyết bằng cách sử dụng đặc trưng nội dung (metadata, mô tả, danh mục) thay vì ID đơn thuần, cho phép tháp sản phẩm suy luận vector cho người dùng hoặc sản phẩm mới ngay lập tức mà không cần chờ lịch sử tương tác.
- Cập nhật thời gian thực: Sử dụng hạ tầng luồng dữ liệu (như Apache Kafka) để truyền phát các cập nhật embedding cho server suy luận (inference engine). Điều này cho phép thực hiện Online Training (huấn luyện và cập nhật mô hình song song với việc phục vụ người dùng) mà không làm gián đoạn hệ thống.
Khi nào nên xây dựng hệ thống gợi ý bằng vector embeddings?
Bạn nên đầu tư vào kiến trúc hệ thống gợi ý dựa trên vector embeddings khi kho dữ liệu vượt ngưỡng hàng chục nghìn mục và yêu cầu cá nhân hóa thời gian thực (với độ trễ dưới 100–300 ms) là trọng tâm của sản phẩm. Đối với các nhu cầu đơn giản hơn như gợi ý qua email định kỳ hoặc số lượng sản phẩm ít, việc xử lý theo lô (offline batch) và lưu kết quả vào bộ nhớ đệm sẽ giúp tiết kiệm đáng kể chi phí vận hành và giảm độ phức tạp hạ tầng.
Tuy nhiên, nếu bạn đang xây dựng một ứng dụng có lưu lượng tương tác cao với danh mục biến động liên tục, việc triển khai kiến trúc đa tầng kết hợp với Vector Database và các framework chuyên dụng (như TensorFlow Recommenders) là lựa chọn tối ưu để đạt được sự cân bằng giữa quy mô, tốc độ truy xuất và độ chính xác cá nhân hóa.
Tài liệu tham khảo
- Tổng quan về Candidate Generation — Google Developers
- Mô hình mạng nơ-ron sâu trong hệ thống gợi ý — Google Developers
- Gợi ý phim: Kiến trúc truy hồi Two-Tower — TensorFlow Recommenders
- Thiết kế hệ thống cho gợi ý và tìm kiếm — Eugene Yan
- Tổng quan về Vector Search — Google Cloud Documentation
- Giải thích về độ tương đồng vector — Pinecone
- Khái niệm tìm kiếm và gợi ý — Qdrant
- Lưu trữ đặc trưng thời gian thực cho hệ thống gợi ý — NVIDIA Technical Blog