Kiến trúc Transformer là mô hình học sâu được giới thiệu năm 2017, vận hành hoàn toàn dựa trên cơ chế tự chú ý (self-attention) để xử lý song song toàn bộ chuỗi dữ liệu mà không cần mạng hồi quy hay tích chập.
Việc loại bỏ hoàn toàn các vòng lặp tuần tự theo trục thời gian cho phép hệ thống tính toán đồng thời tất cả các vị trí trong chuỗi đầu vào trên hạ tầng phần cứng GPU, duy trì liên kết trực tiếp giữa các token bất kể khoảng cách địa lý trong văn bản.
Trong kỹ nghệ xây dựng hệ thống học máy quy mô lớn, khả năng mở rộng của mô hình phụ thuộc vào việc tối ưu hóa năng lực tính toán song song của phần cứng và giải quyết hiện tượng tiêu biến đạo hàm trên các chuỗi ngữ cảnh dài.
Bằng cách thay thế bước lặp tuần tự bằng các phép toán ma trận đồng thời, kiến trúc Transformer đã biến việc mở rộng quy mô mô hình từ một nút thắt cổ chai thành bài toán tỷ lệ thuận với năng lực tính toán.
Giới hạn của RNN/LSTM và lý do Transformer ra đời
Các mạng nơ-ron hồi quy (Recurrent Neural Networks - RNN) truyền thống cùng các biến thể LSTM và GRU xử lý dữ liệu chuỗi bằng cách truyền trạng thái ẩn theo từng bước thời gian. Trạng thái ẩn h_t tại vị trí t được tính toán thông qua hàm số h_t = f(h_{t-1}, x_t), trong đó h_{t-1} là trạng thái ẩn của bước liền trước và x_t là đầu vào hiện tại. Ràng buộc tuần tự này ép buộc quá trình tính toán phải diễn ra nối tiếp, ngăn cản khả năng song song hóa dữ liệu bên trong một mẫu huấn luyện trên các phần cứng gia tốc như GPU. Khi độ dài chuỗi n tăng lên, giới hạn bộ nhớ ngăn cản việc gộp cụm (batching) các chuỗi dài, tạo ra nút thắt cổ chai về mặt hiệu năng và thời gian huấn luyện.
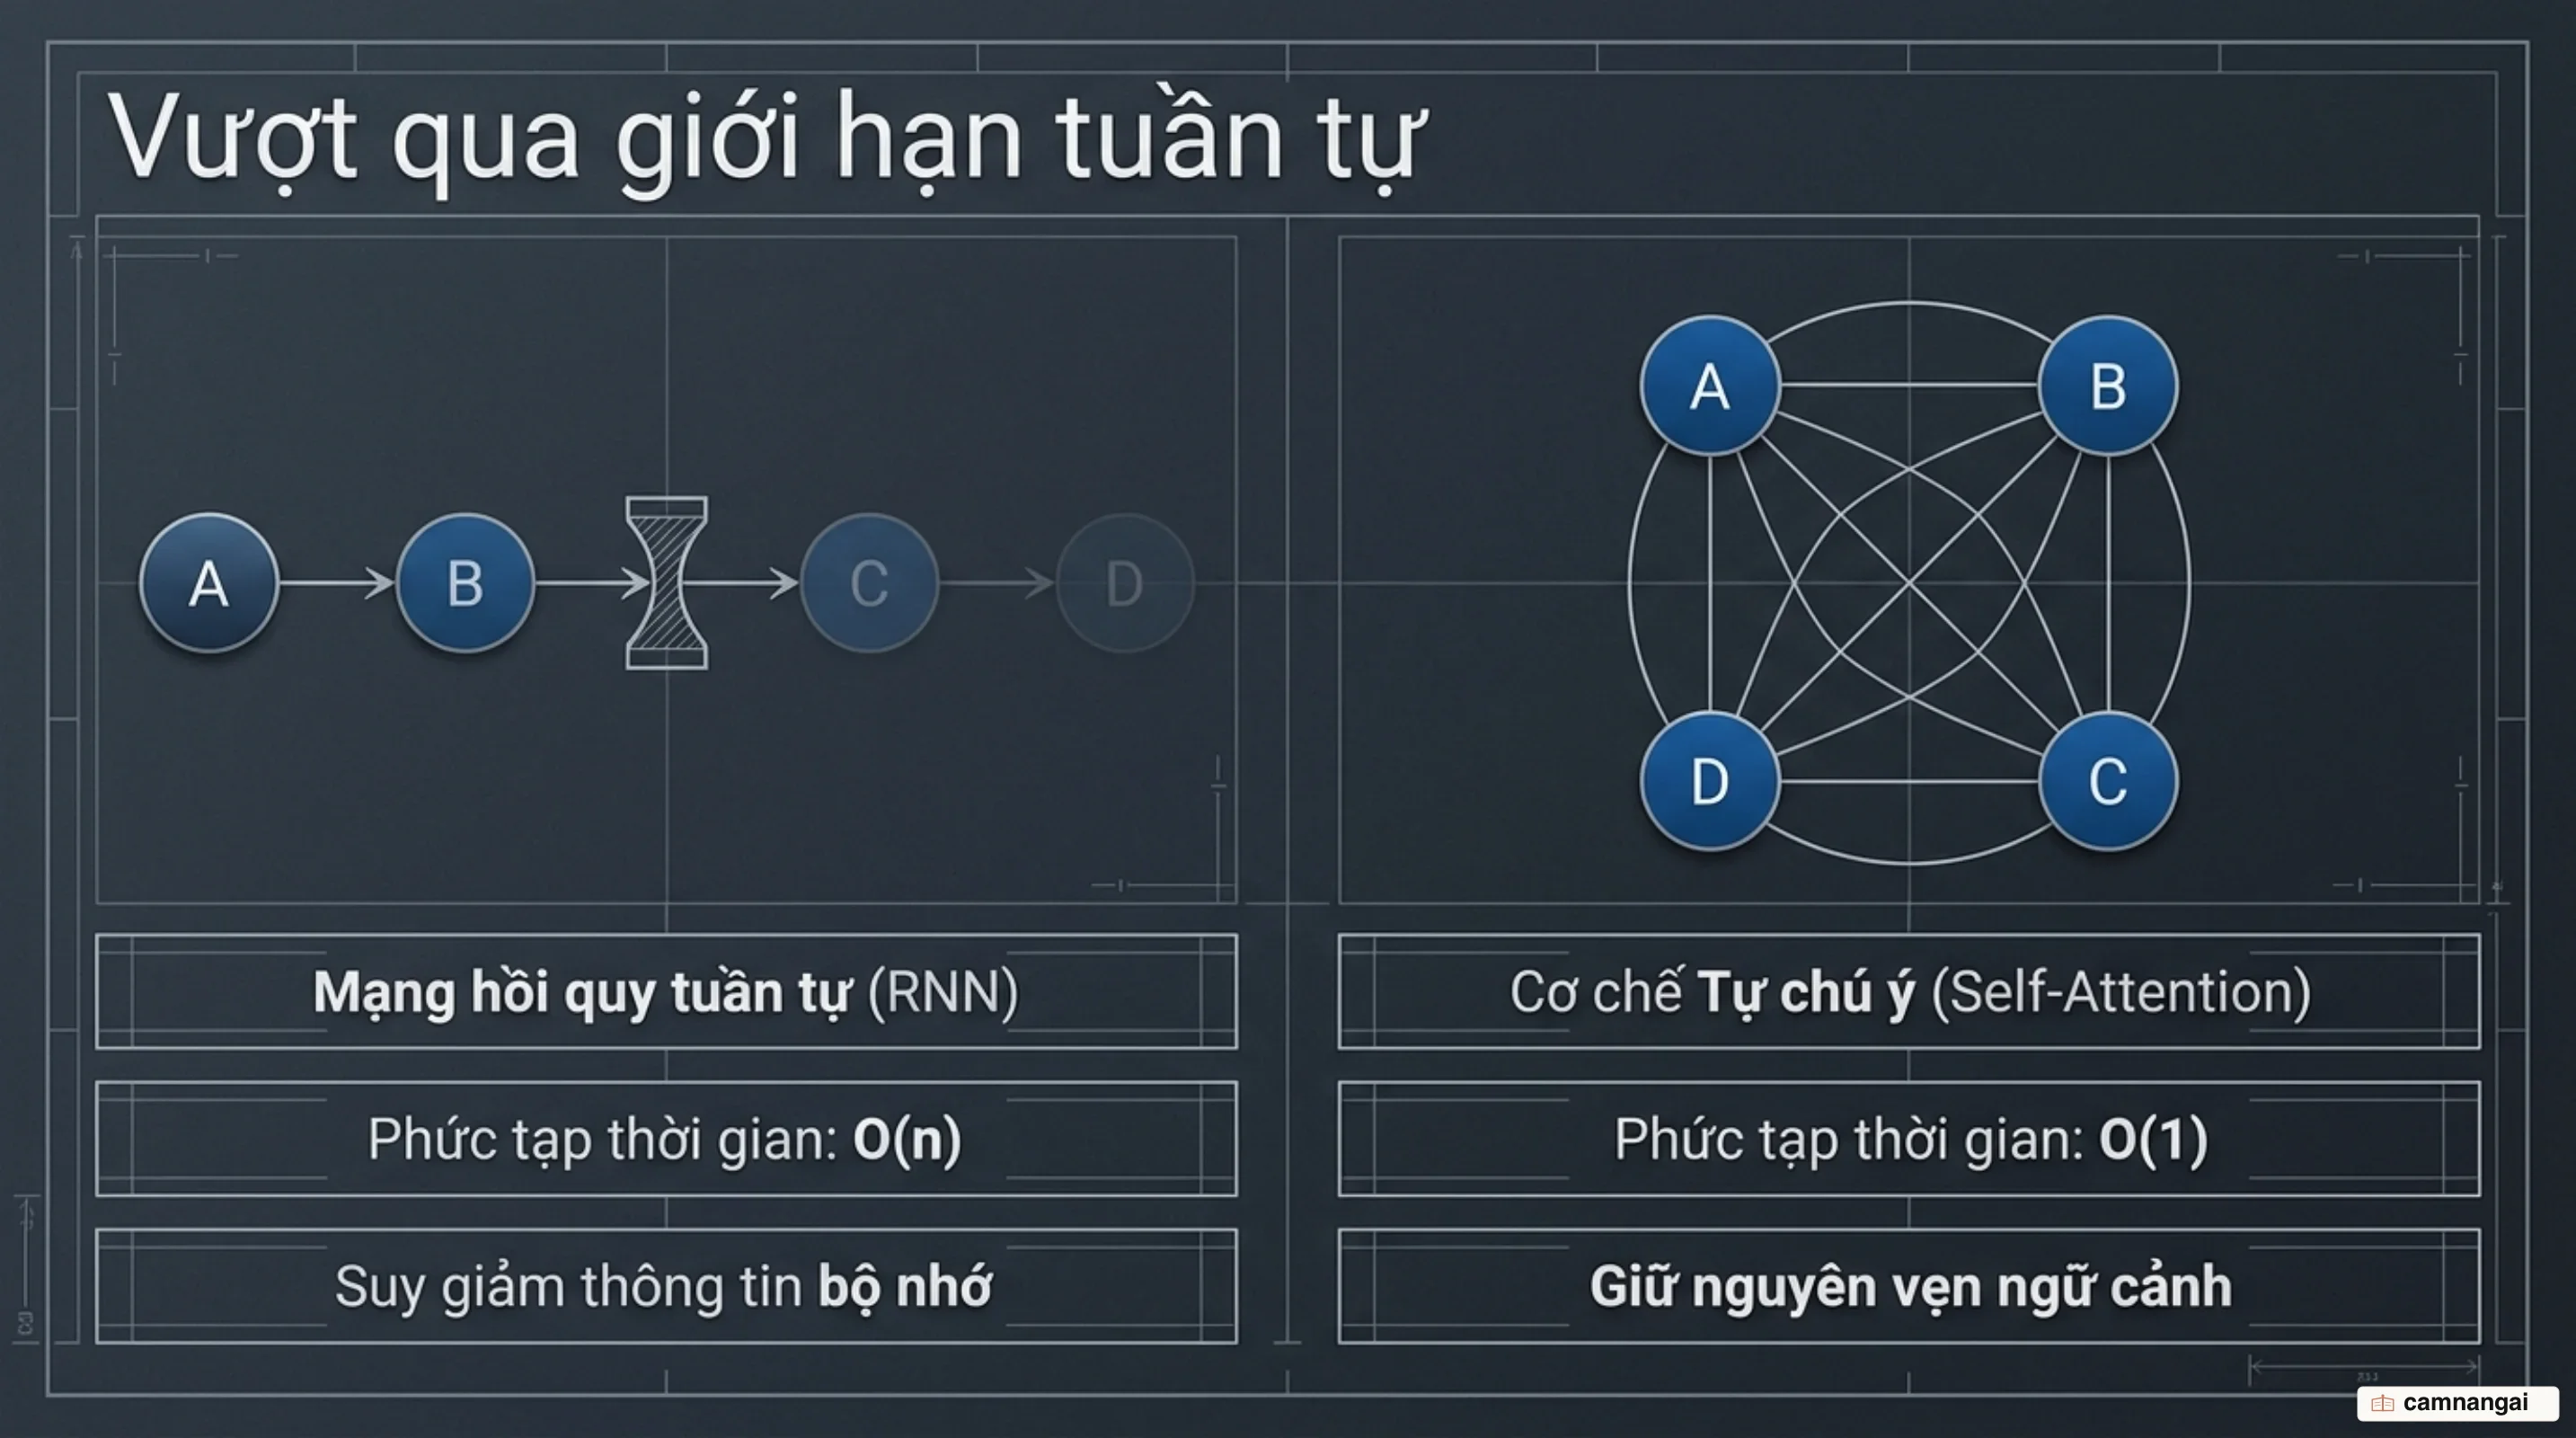
Vấn đề kỹ thuật thứ hai của kiến trúc hồi quy là khó khăn trong việc học các mối phụ thuộc xa (long-range dependencies). Khi lan truyền ngược qua thời gian (Backpropagation Through Time - BPTT), tín hiệu đạo hàm phải duyệt qua đường dẫn có độ dài tỷ lệ thuận với chuỗi dữ liệu O(n). Phép nhân liên tiếp các ma trận trọng số qua nhiều bước thời gian dẫn đến hiện tượng tiêu biến đạo hàm (vanishing gradients) hoặc bùng nổ đạo hàm (exploding gradients). Mặc dù cơ chế cổng trong LSTM và GRU hỗ trợ duy trì dòng thông tin tốt hơn, khoảng cách hiệu quả để truyền tải chính xác ngữ cảnh giữa các token nằm xa nhau vẫn bị giới hạn đáng kể.
Các kiến trúc tích chập (Convolutional Neural Networks - CNN) như ConvS2S hay ByteNet từng được phát triển nhằm tính toán song song các biểu diễn ẩn cho tất cả vị trí token. Mặc dù CNN giải quyết được bài toán song song hóa, số lượng phép toán cần thiết để kết nối thông tin giữa hai vị trí bất kỳ trong chuỗi vẫn tăng theo khoảng cách: tăng tuyến tính O(n/k) trong ConvS2S (với k là kích thước nhân tích chập) hoặc tăng theo tỷ lệ logarit O(log_k n) trong ByteNet. Độ dài đường dẫn này khiến việc liên kết ngữ cảnh giữa các từ cách xa nhau trong văn bản gặp trở ngại tính toán.
Cơ chế tự chú ý (self-attention) trong kiến trúc Transformer ra đời để giải quyết triệt để các giới hạn trên bằng cách kết nối trực tiếp tất cả các vị trí trong chuỗi thông qua một phép toán ma trận duy nhất, đưa độ dài đường dẫn truyền tín hiệu giữa hai token bất kỳ về mức hằng số O(1). Sự thay đổi này chuyển đổi bản chất đánh đổi tính toán: độ phức tạp tính toán nối tiếp trên mỗi tầng giảm từ O(n) của RNN xuống O(1), trong khi độ phức tạp tính toán tổng thể mỗi tầng là O(n^2 · d) (với n là độ dài chuỗi và d là chiều biểu diễn). Khi độ dài chuỗi n nhỏ hơn chiều biểu diễn d_model (trường hợp phổ biến trong hầu hết các tác vụ xử lý ngôn ngữ), Self-Attention tối ưu hóa khả năng tính toán song song trên phần cứng GPU.
Toàn cảnh kiến trúc Transformer: Luồng dữ liệu qua Encoder và Decoder
Kiến trúc Transformer nguyên bản áp dụng mô hình Encoder-Decoder cho các bài toán biến đổi chuỗi (sequence transduction) như dịch máy. Bộ Encoder tiếp nhận chuỗi biểu diễn token đầu vào (x_1, ..., x_n) và ánh xạ thành chuỗi các vectơ biểu diễn liên tục z = (z_1, ..., z_n). Dựa trên ma trận biểu diễn trung gian z, bộ Decoder sinh ra chuỗi ký hiệu đầu ra (y_1, ..., y_m) từng phần tử một theo phương thức tự hồi quy (autoregressive), trong đó các token sinh ra ở bước trước được đưa ngược lại làm đầu vào bổ sung cho bước dự đoán tiếp theo.
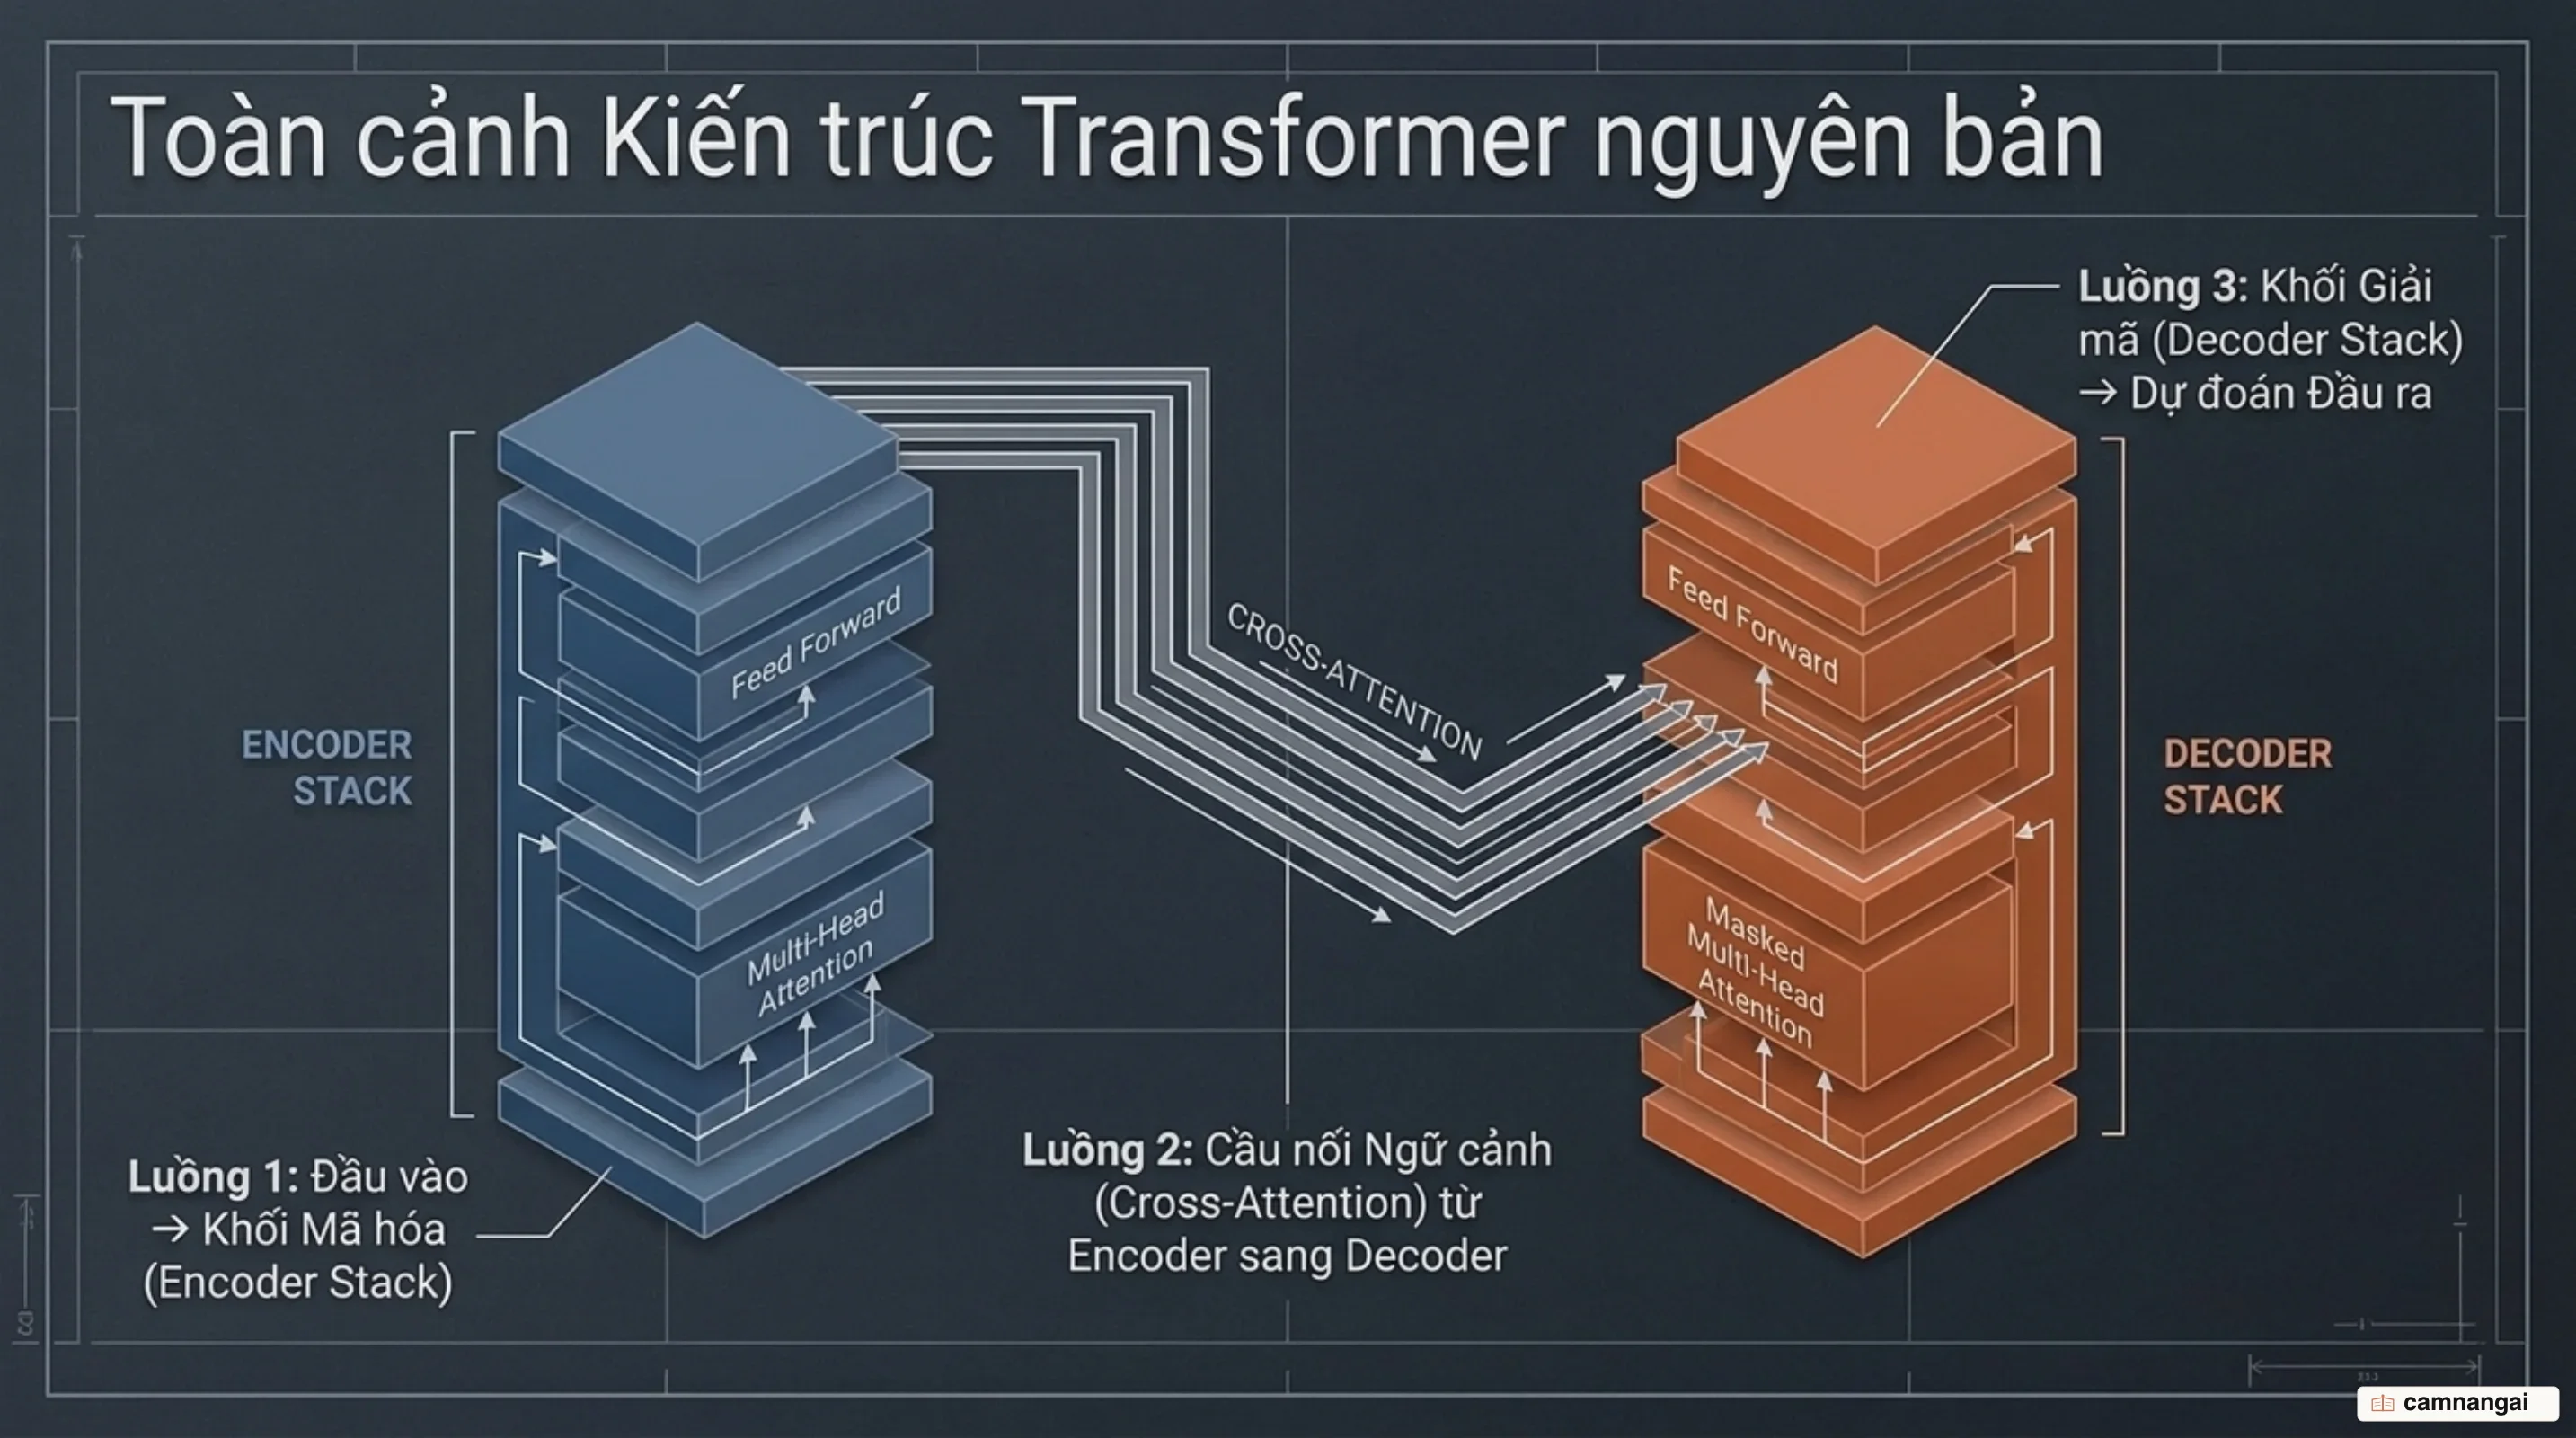
Khối Encoder bao gồm một chồng gồm N = 6 tầng (layers) đồng dạng. Mỗi tầng được cấu thành từ hai tầng con (sub-layers): tầng con thứ nhất là cơ chế tự chú ý đa đầu (Multi-Head Self-Attention), và tầng con thứ hai là mạng truyền tiến theo từng vị trí (Position-wise Feed-Forward Network). Xung quanh mỗi tầng con, mô hình áp dụng một kết nối tắt residual nối tiếp với bước chuẩn hóa tầng (Layer Normalization). Để đảm bảo phép cộng trong kết nối residual hợp lệ, tất cả các tầng con và tầng nhúng (embedding) đều duy trì kích thước đầu ra cố định d_model = 512.
Khối Decoder cũng bao gồm một chồng N = 6 tầng đồng dạng. Ngoài hai tầng con tương tự Encoder, từng tầng Decoder chèn thêm một tầng con thứ ba ở giữa: tầng Encoder-Decoder Cross-Attention. Tầng này thực hiện cơ chế chú ý trên ma trận đầu ra z của Encoder stack. Tầng tự chú ý đầu tiên trong Decoder được điều chỉnh bằng mặt nạ nhân quả (causal masking) nhằm ngăn không cho vị trí hiện tại chú ý đến các token phía sau trong chuỗi đích. Điều này đảm bảo tính chất tự hồi quy: dự đoán tại vị trí i chỉ phụ thuộc vào các đầu ra đã biết tại các vị trí nhỏ hơn i.
Luồng biến đổi tensor trong kiến trúc Transformer nguyên bản được thực thi theo các bước tuần tự:
- Chuỗi ký tự thô được tách thành chuỗi chỉ số nguyên (Integer Tokens).
- Tầng Input Embedding ánh xạ các chỉ số nguyên thành tensor biểu diễn có chiều
d_model = 512, sau đó nhân với trị số√d_model. - Tensor Positional Encoding cùng kích thước được cộng trực tiếp vào tensor Input Embedding để tích hợp thông tin thứ tự.
- Tensor đi qua
N = 6tầng Encoder, xuất ra ma trận biểu diễn ngữ cảnh trung gianz(Memory Latents). - Chuỗi token đích phía Decoder (đã lệch 1 vị trí về bên phải) đi qua Target Embedding, cộng Positional Encoding, rồi đi vào
N = 6tầng Decoder. Các tầng này truy xuất ma trận Memory Latents từ Encoder làm Keys và Values cho tầng Cross-Attention. - Đầu ra của tầng Decoder cuối cùng đi qua tầng biến đổi tuyến tính (Linear Projection) để nâng chiều từ
d_modellên kích thước từ vựng (vocab_size). - Hàm Softmax chuyển đổi các trị số logits thành phân phối xác suất dự đoán token tiếp theo.
Bản chất toán học của cơ chế Self-Attention: Ma trận Q, K, V
Cơ chế tự chú ý (Self-Attention) trong kiến trúc Transformer biến đổi ma trận biểu diễn đầu vào X có kích thước [batch_size, seq_len, d_model] thành ba tập tensor toán học riêng biệt: Query (Q), Key (K), và Value (V). Các tensor này được tính toán thông qua phép nhân ma trận giữa X và các ma trận trọng số khả trình W^Q, W^K, và W^V:
Q = X · W^Q   (kích thước: [batch_size, seq_len, d_k])
K = X · W^K   (kích thước: [batch_size, seq_len, d_k])
V = X · W^V   (kích thước: [batch_size, seq_len, d_v])
Về mặt bản chất: Q đóng vai trò là vectơ truy vấn tìm kiếm thông tin của vị trí hiện tại, K đóng vai trò như nhãn định danh của các thông tin trong chuỗi, và V chứa đựng nội dung giá trị ngữ nghĩa thực sự của các token.
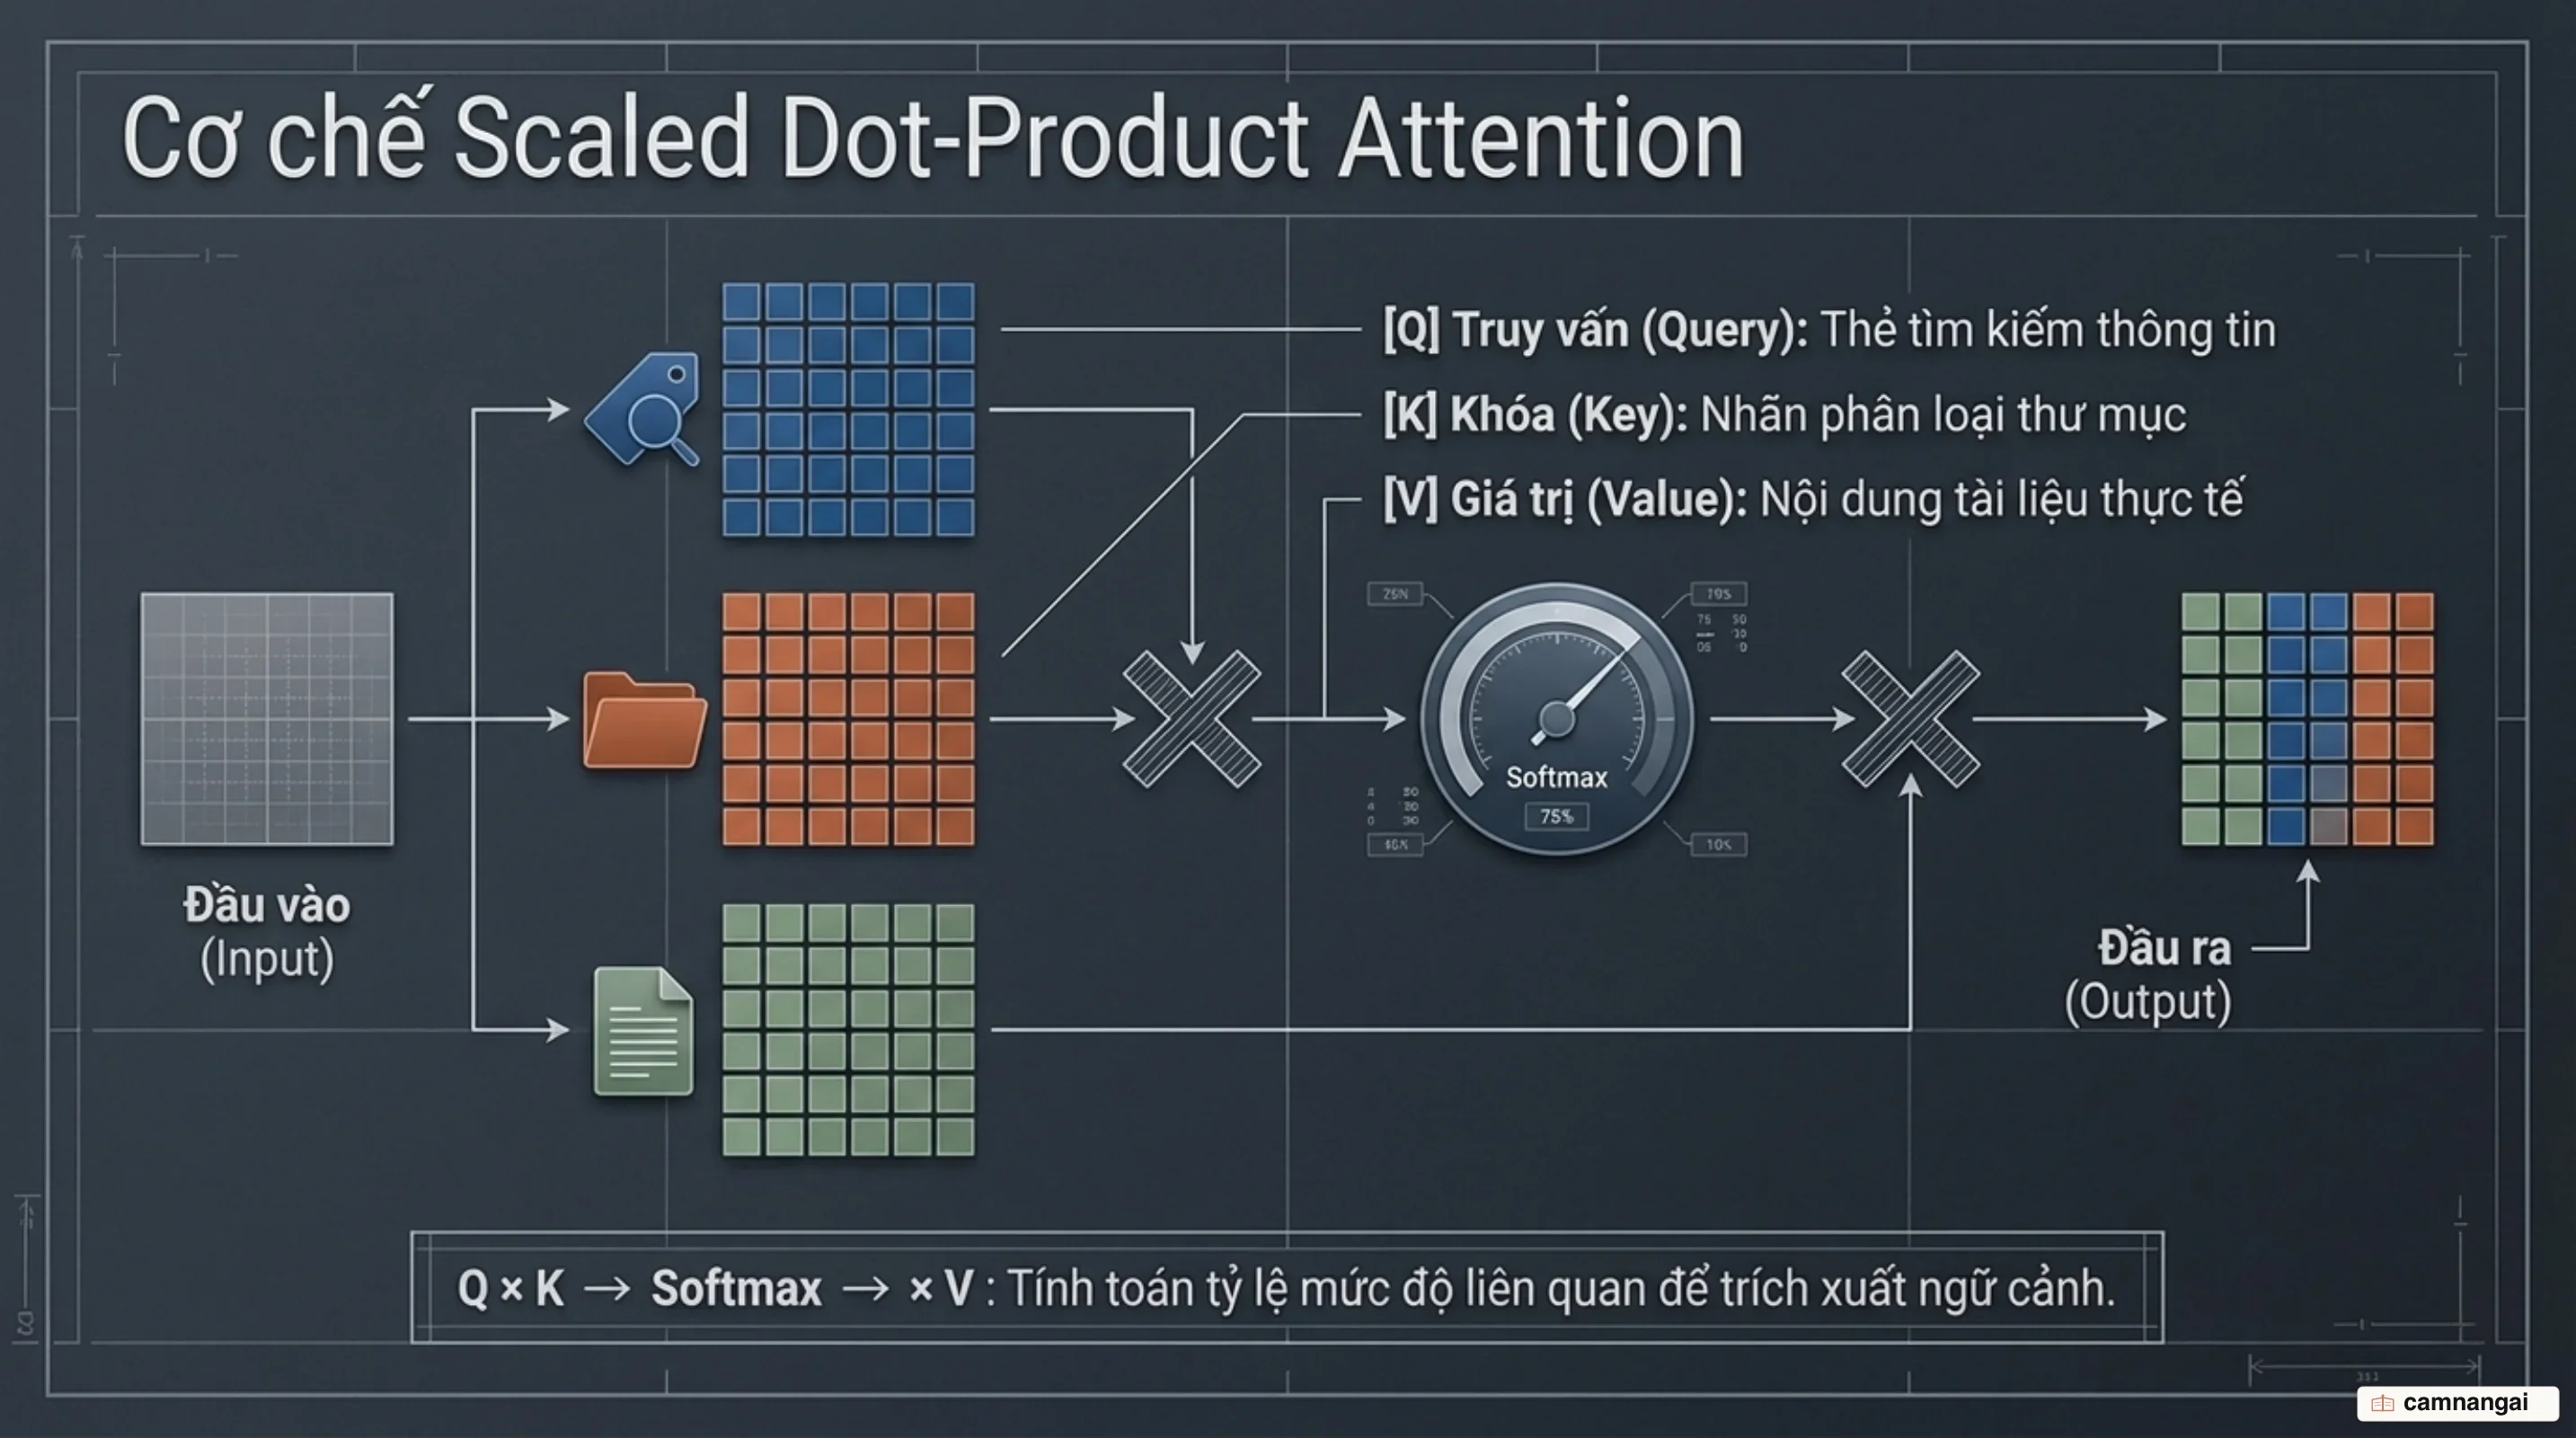
Phép toán chú ý chấm có tỷ lệ (Scaled Dot-Product Attention) xử lý đồng thời các ma trận Q, K, V theo công thức:
Attention(Q, K, V) = softmax((Q · K^T) / √d_k) · VQuá trình đại số tuyến tính này diễn ra qua các bước cụ thể:
- Tính tích vô hướng
Q · K^Tđể đo độ tương đồng giữa từng Query và tất cả các Key trong câu. - Chia ma trận điểm số này cho
√d_k(thừa số tỷ lệ - scaling factor). - Áp dụng hàm Softmax theo hàng để thu được ma trận trọng số chú ý
alphavới các giá trị chuẩn hóa nằm trong khoảng[0, 1]và có tổng mỗi hàng bằng 1. - Nhân ma trận trọng số
alphavới ma trận ValueVđể thu được tensor ngữ cảnhZ.
Thừa số chia √d_k đóng vai trò cốt tử trong việc giữ ổn định đạo hàm. Khi chiều không gian d_k lớn, tích vô hướng giữa các vectơ có thể đạt trị số tuyệt đối rất lớn. Giả sử các phần tử của Q và K là các biến ngẫu nhiên độc lập có trung bình bằng 0 và phương sai bằng 1, tích vô hướng của chúng sẽ có trung bình bằng 0 nhưng phương sai tăng lên mức d_k. Phương sai cao đẩy các giá trị của Q · K^T vào vùng bão hòa có đạo hàm cực nhỏ của hàm Softmax, gây ra hiện tượng tiêu biến đạo hàm trong quá trình lan truyền ngược. Việc chia cho √d_k kéo phương sai về mức 1, giữ cho ma trận đầu vào Softmax nằm trong vùng tính toán ổn định.
Đoạn mã PyTorch dưới đây minh họa chuẩn xác thuật toán Scaled Dot-Product Attention:
import torch
import torch.nn.functional as F
import math

def scaled_dot_product_attention(query, key, value, mask=None):
    # query, key shape: [batch_size, num_heads, seq_len, d_k]
    # value shape: [batch_size, num_heads, seq_len, d_v]
    d_k = query.size(-1)

    # Bước 1 & 2: Q * K^T / sqrt(d_k)
    scores = torch.matmul(query, key.transpose(-2, -1)) / math.sqrt(d_k)

    # Áp dụng mask nếu có (ví dụ: causal mask hoặc padding mask)
    if mask is not None:
        scores = scores.masked_fill(mask == 0, -1e9)

    # Bước 3: Softmax thu được ma trận trọng số chú ý alpha
    p_attn = F.softmax(scores, dim=-1)

    # Bước 4: Nhân trọng số chú ý với Value
    context = torch.matmul(p_attn, value)

    return context, p_attn
Multi-Head Attention: Mở rộng khả năng quan sát ngữ cảnh
Cơ chế chú ý đơn lẻ (single-head attention) giới hạn khả năng tập trung của mô hình do việc trung bình hóa các trọng số chú ý trên toàn bộ chiều biểu diễn làm triệt tiêu khả năng truy xuất đồng thời nhiều không gian con (subspaces) thông tin khác nhau. Cơ chế chú ý đa đầu (Multi-Head Attention) trong kiến trúc Transformer khắc phục điều này bằng cách chiếu các không gian Q, K, V qua h tập ma trận trọng số tuyến tính độc lập, cho phép mô hình quan sát chuỗi dữ liệu ở nhiều góc độ song song.
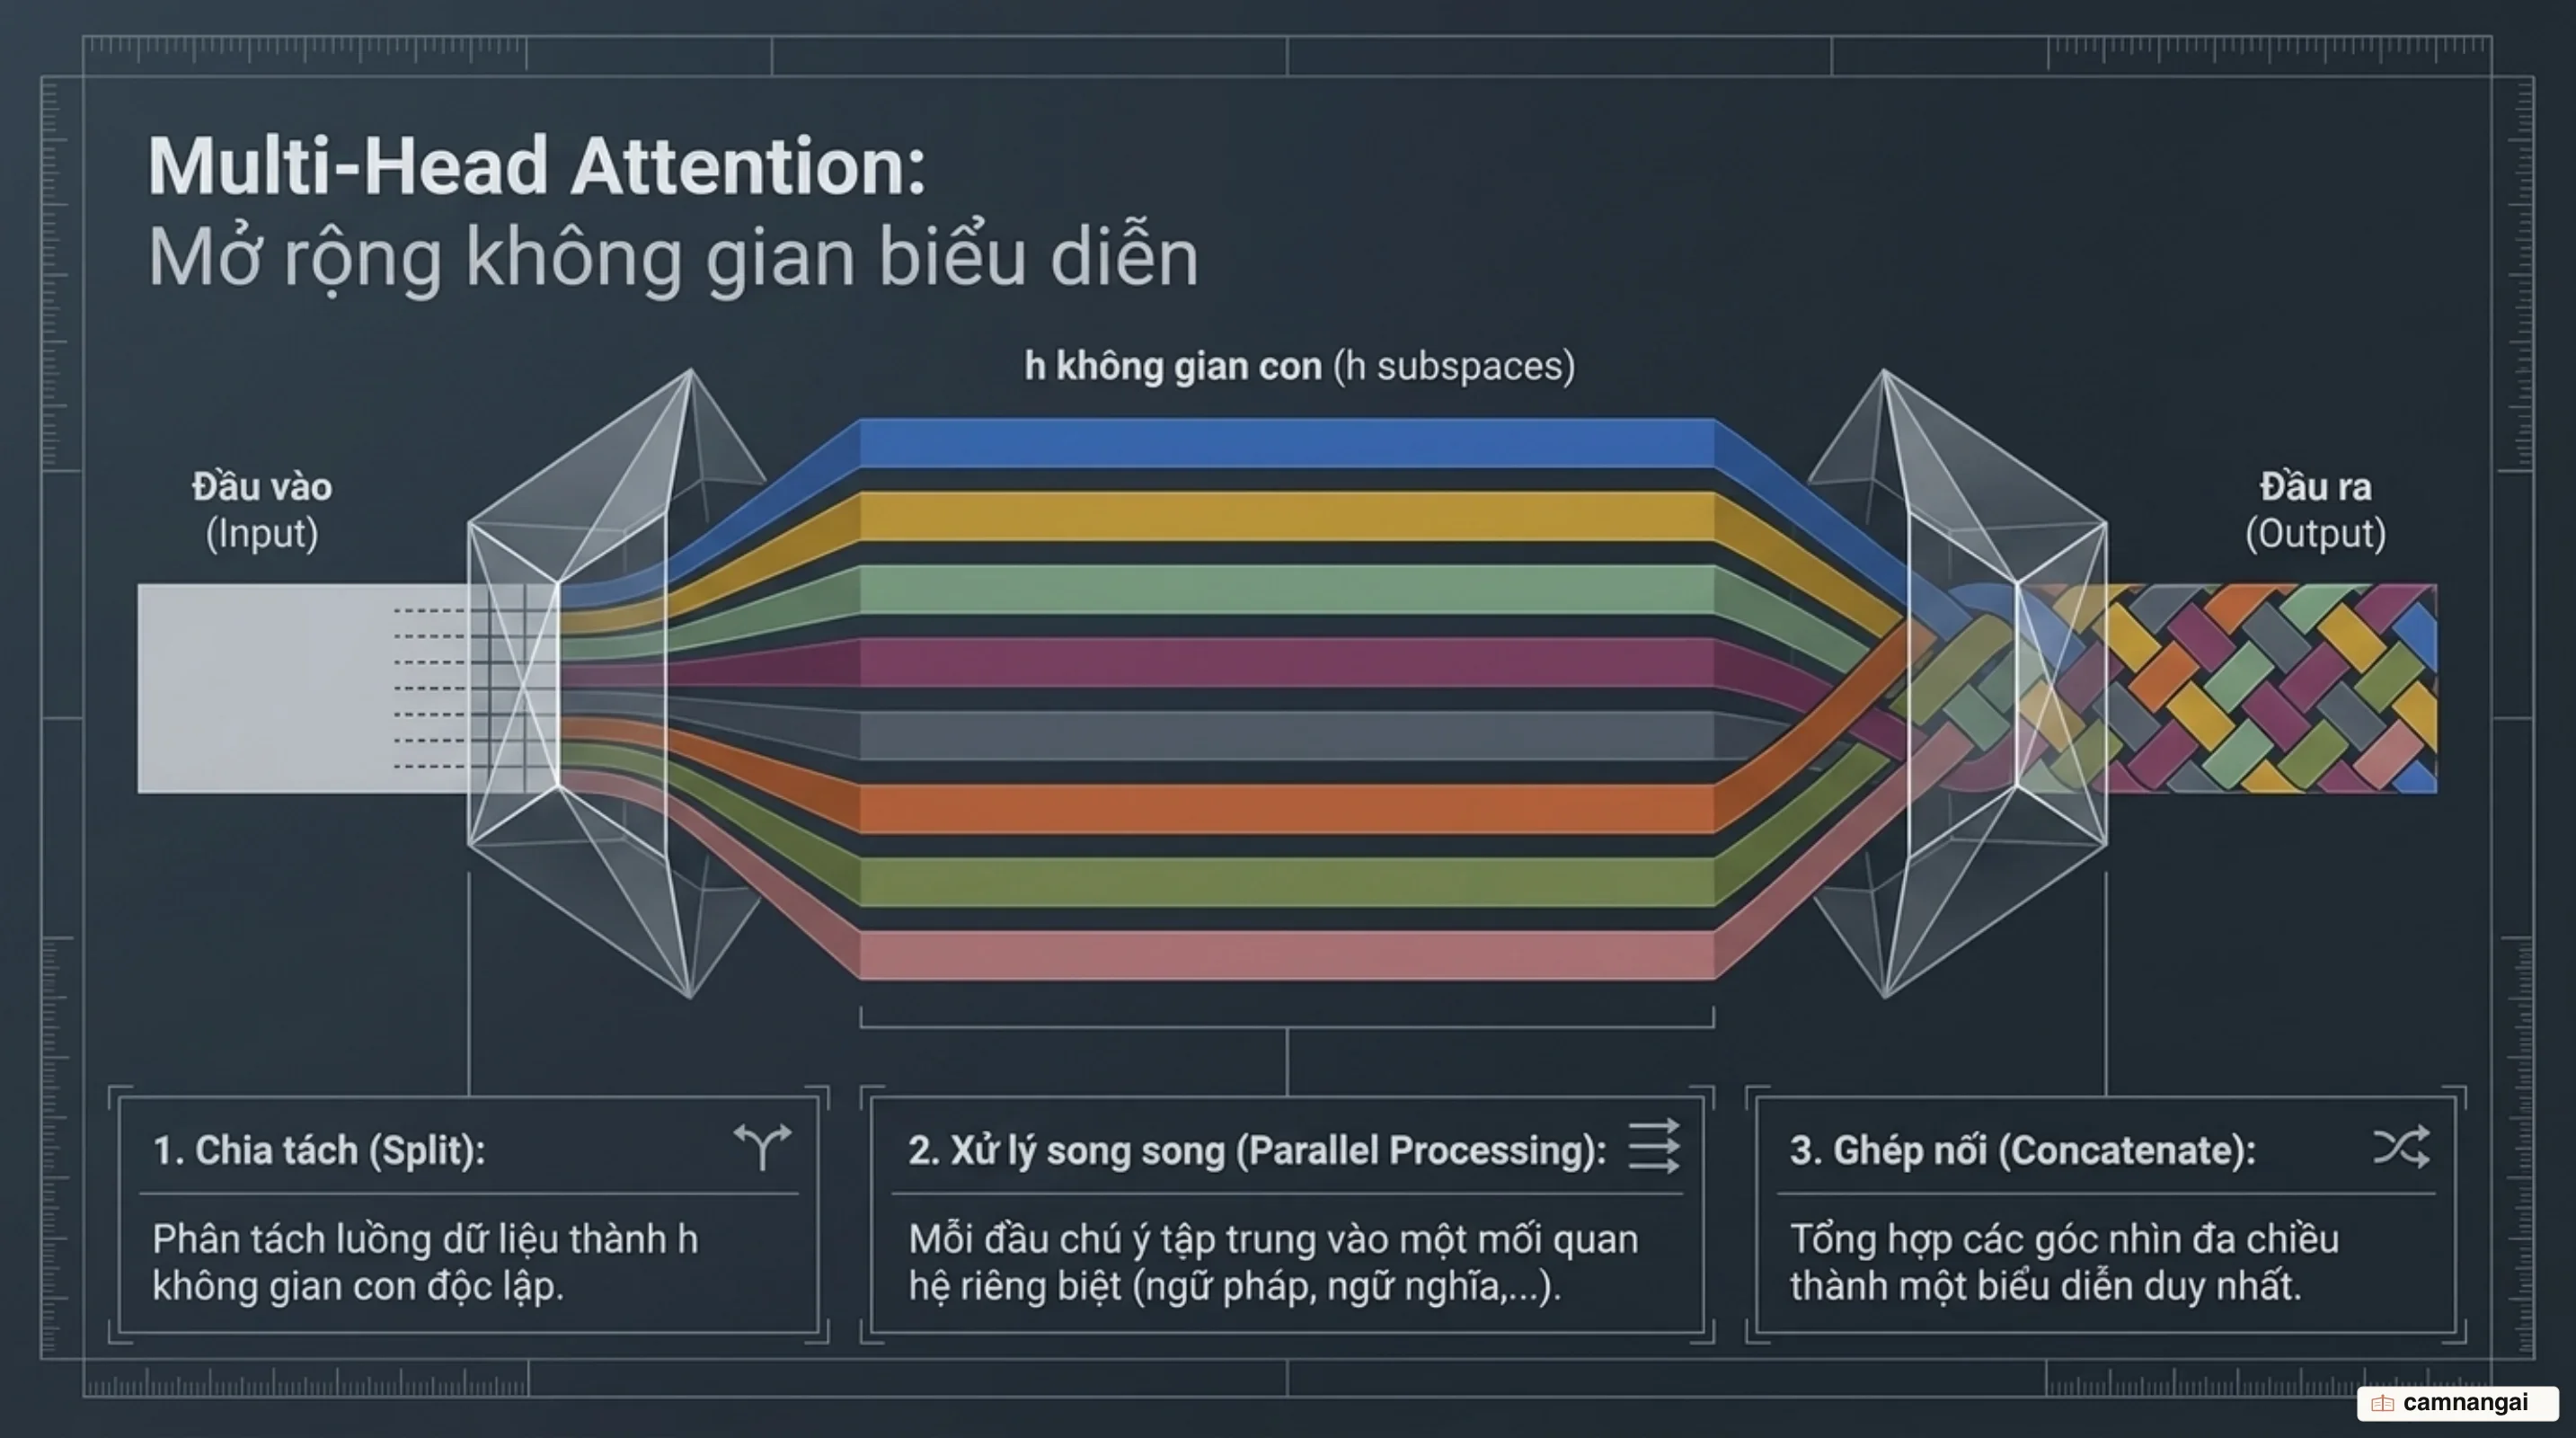
Trong cấu hình Transformer tiêu chuẩn, số lượng đầu chú ý được thiết lập là h = 8. Kích thước chiều không gian của mỗi đầu chú ý giảm xuống tương ứng: d_k = d_v = d_model / h = 512 / 8 = 64. Phép tính Multi-Head Attention được thực hiện theo công thức:
MultiHead(Q, K, V) = Concat(head_1, ..., head_h) · W^O
trong đó: head_i = Attention(Q · W_i^Q, K · W_i^K, V · W_i^V)
Các ma trận chiếu tham số bao gồm W_i^Q, W_i^K, W_i^V cho từng đầu chú ý thứ i, và ma trận tổng hợp đầu ra W^O.
                 +-----------------------+
                 |    Input (Q, K, V)    |
                 +-----------+-----------+
                             |
         +-------------------+-------------------+
         |                   |                   |
   Linear Proj (1)     Linear Proj (2)     Linear Proj (h)
         |                   |                   |
   Head 1 (d_k=64)     Head 2 (d_k=64)     Head h (d_k=64)
         |                   |                   |
         +-------------------+-------------------+
                             |
                      Concat (h * d_v)
                             |
                     Linear Projection (W^O)
                             |
                          Output
Việc phân chia thành h đầu chú ý cho phép mô hình đồng thời truy xuất ngữ cảnh ở các khía cạnh khác nhau. Ví dụ, một đầu chú ý có thể tập trung vào mối quan hệ cú pháp giữa động từ và tân ngữ phụ thuộc, trong khi một đầu chú ý khác đảm nhận việc giải quyết tham chiếu đồng sở (co-reference resolution) giữa đại từ và danh từ ở xa hơn trong câu.
Về mặt xử lý tensor trên phần cứng GPU, thao tác này không làm gia tăng chi phí tính toán so với chú ý đơn đầu đầy đủ chiều. Ma trận đầu vào được chiếu tuyến tính một lần tạo ra tensor kích thước [batch_size, seq_len, d_model], sau đó được thay đổi hình dạng (reshape) và tráo đổi chiều (permute) thành [batch_size, h, seq_len, d_k]. Phép nhân ma trận Q · K^T được thực thi song song trên toàn bộ h đầu chú ý. Cuối cùng, các tensor đầu ra được gộp lại (concatenate) và nhân với ma trận W^O để trả về kích thước không gian gốc d_model.
Mã hóa vị trí (Positional Encoding): Giải bài toán thứ tự từ
Do các phép toán Self-Attention thực thi song song trên tập hợp tensor mà không có mạng hồi quy hay tích chập, cơ chế này mang tính chất bất biến với các phép hoán vị (permutation-invariant). Nếu không có cơ chế mã hóa vị trí, kiến trúc Transformer sẽ tính toán ra ma trận chú ý giống hệt nhau cho hai chuỗi văn bản có cùng từ ngữ nhưng ngược thứ tự. Do đó, thông tin biểu diễn vị trí tuyệt đối và tương đối của các token phải được bổ sung trực tiếp vào vectơ đầu vào.
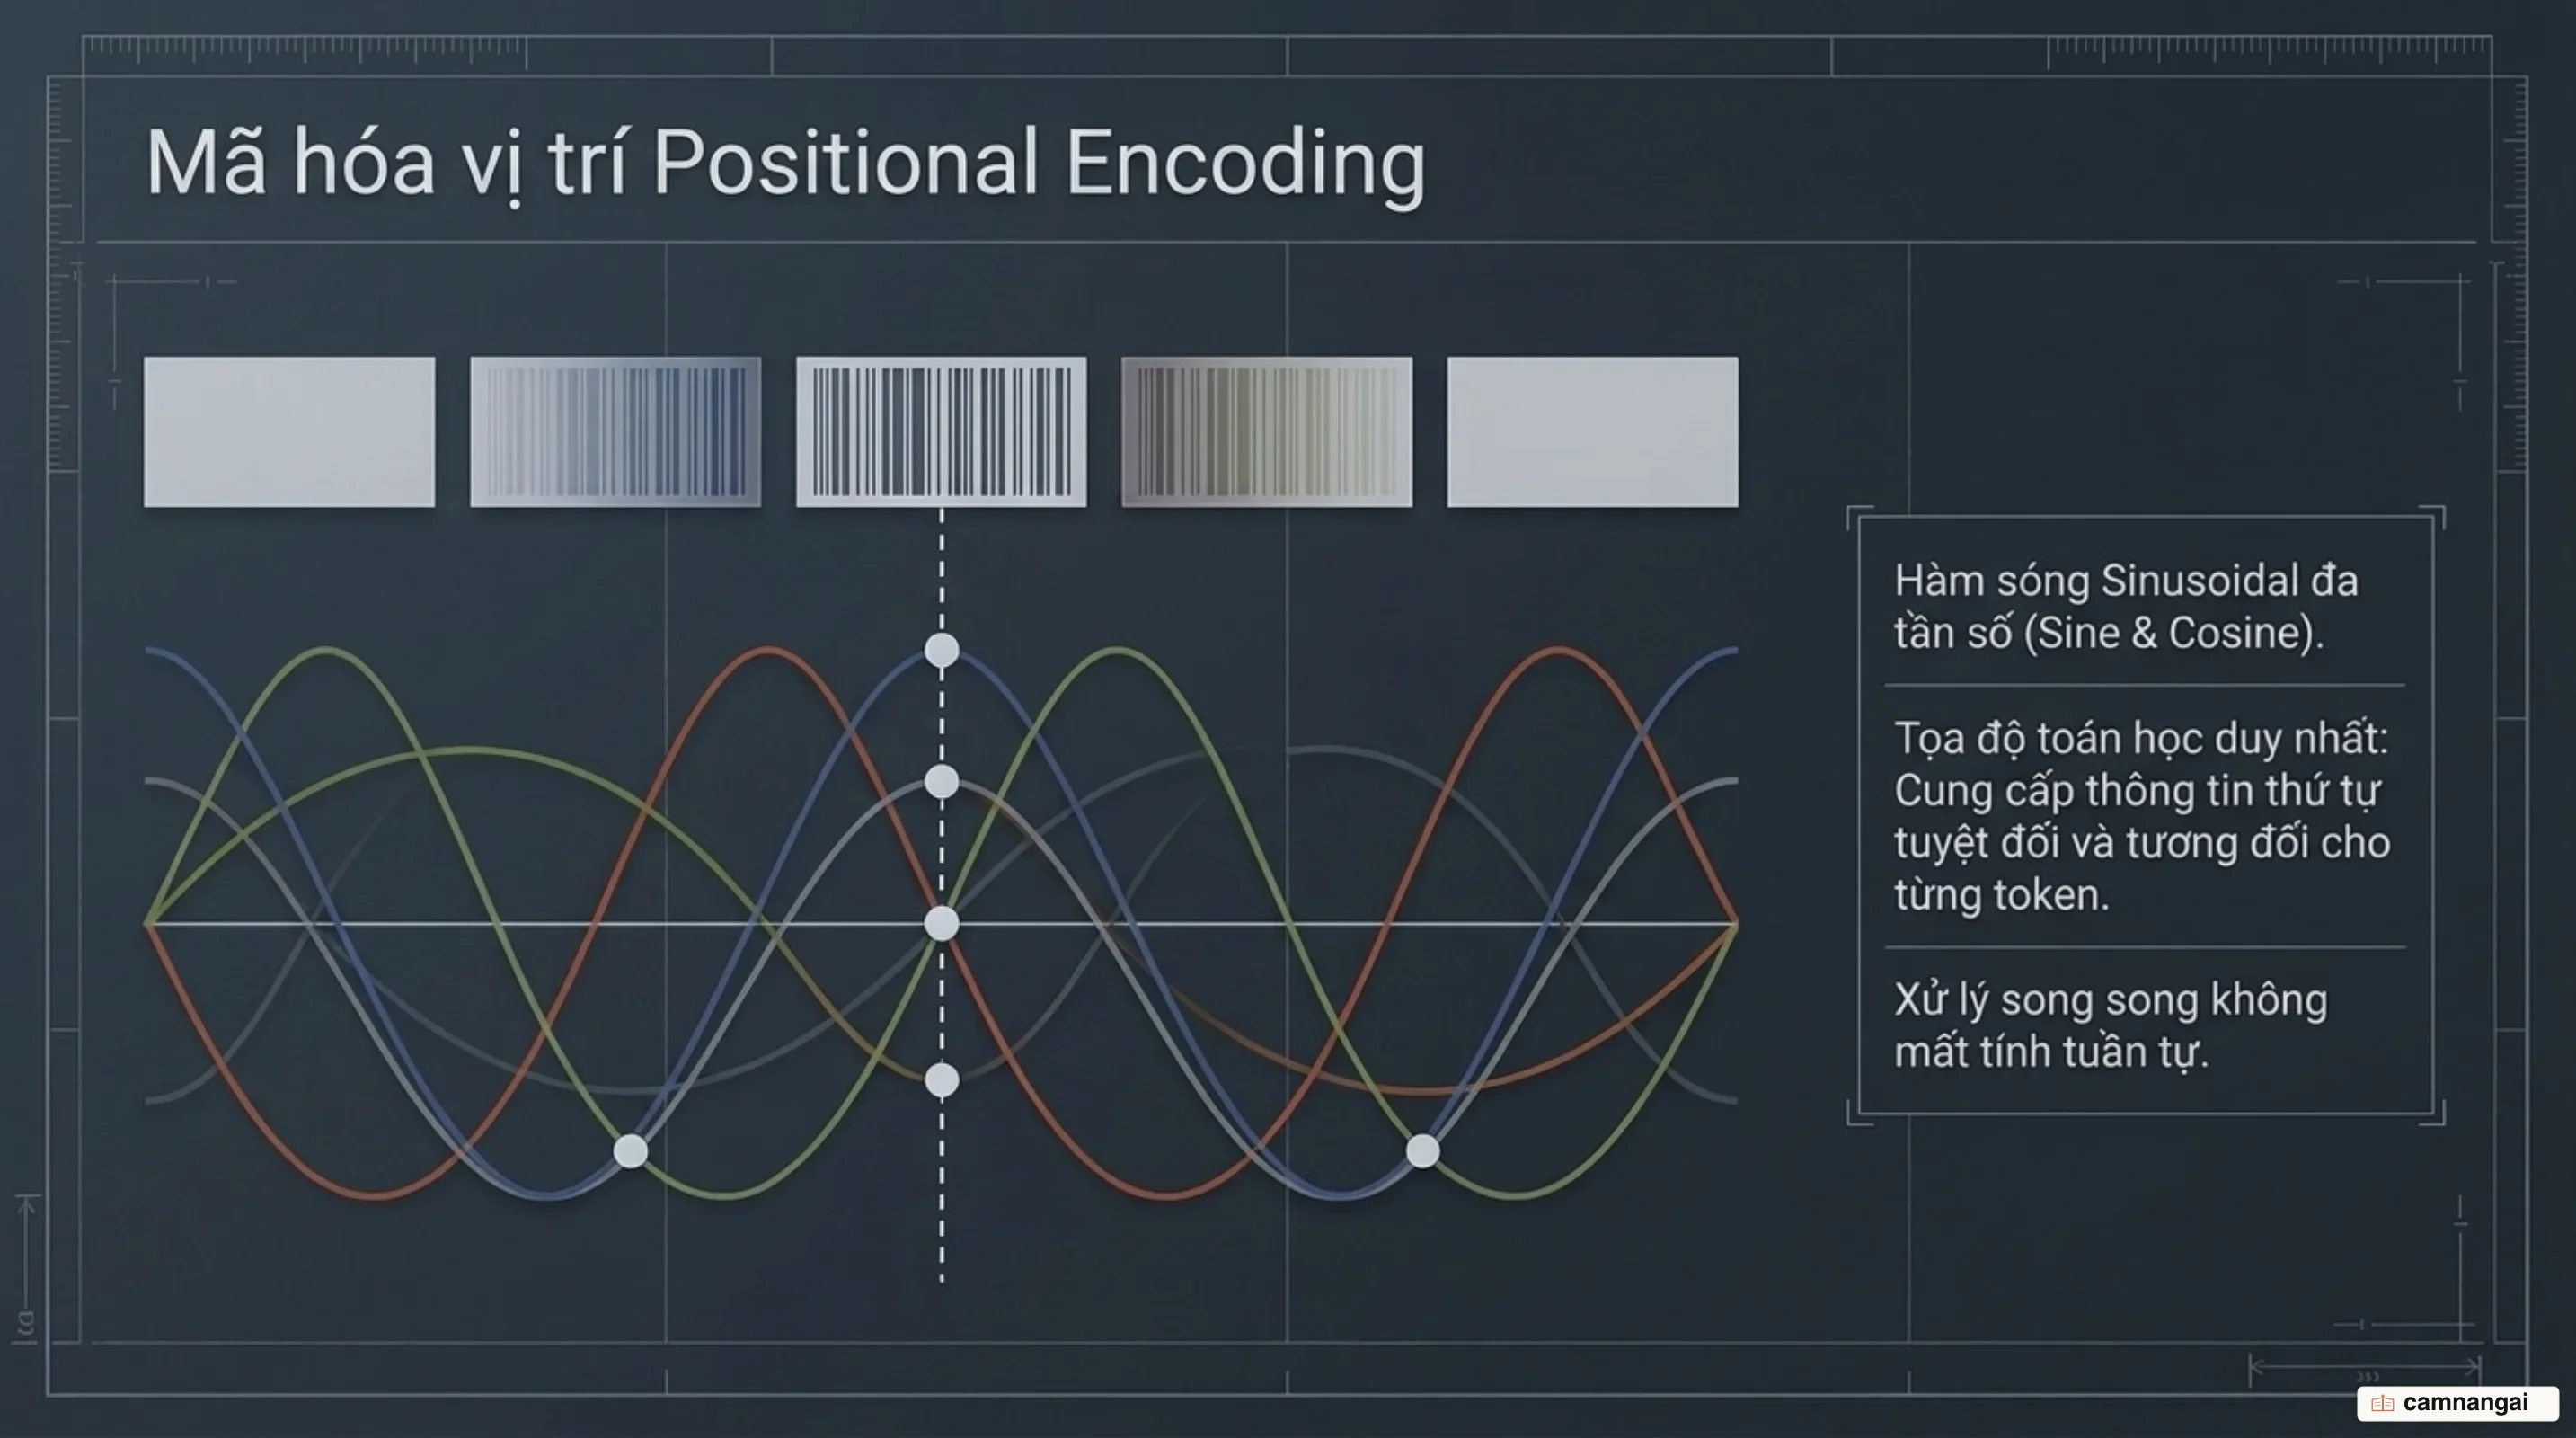
Mô hình gốc sử dụng các chuỗi hàm lượng giác sin và cosin với tần số khác nhau để xây dựng ma trận Positional Encoding (PE):
PE(pos, 2i)   = sin(pos / (10000^(2i / d_model)))
PE(pos, 2i+1) = cos(pos / (10000^(2i / d_model)))
Trong đó pos là vị trí của token trong chuỗi (pos chạy từ 0 đến L-1), và i là chỉ số chiều không gian (i chạy từ 0 đến d_model / 2 - 1). Tần số của các hàm lượng giác tạo thành một cấp số nhân biến đổi bước sóng từ 2π đến 10000 · 2π. Vectơ vị trí này có cùng chiều d_model với vectơ nhúng token và được cộng trực tiếp vào ma trận Input Embedding: E_final = E_token + PE.
Lựa chọn hàm lượng giác Sinusoidal mang lại thuộc tính đại số tuyến tính quan trọng: đối với bất kỳ khoảng dịch chuyển cố định k nào, PE_{pos+k} có thể biểu diễn dưới dạng một biến đổi tuyến tính của PE_{pos}. Thuộc tính này cho phép các tầng chú ý dễ dàng học cách tham chiếu vị trí tương đối giữa các token, vì tích vô hướng giữa hai vectơ vị trí chỉ phụ thuộc vào khoảng cách tương đối k = |pos_1 - pos_2|.
Thực nghiệm trong nghiên cứu gốc cũng so sánh phương pháp Sinusoidal với phương pháp mã hóa vị trí học được (Learned Positional Embeddings), nơi mỗi vị trí gán một vectơ tham số hóa được tối ưu qua lan truyền ngược. Kết quả cho thấy hai phương pháp đạt hiệu năng tương đương trên bài toán dịch máy. Tuy nhiên, dạng hàm Sinusoidal được lựa chọn do có khả năng suy luận mở rộng (extrapolate) cho các chuỗi văn bản có độ dài vượt quá độ dài tối đa xuất hiện trong tập dữ liệu huấn luyện.
Các khối bổ trợ: Residual Connections, Layer Normalization và Feed-Forward Network
Để duy trì tính ổn định tính toán và khả năng lan truyền đạo hàm qua các mô hình sâu, kiến trúc Transformer kết hợp các khối bổ trợ xung quanh mỗi tầng con. Với mỗi tầng con Sublayer(x), mô hình thiết lập một kết nối tắt residual nối tiếp với tầng chuẩn hóa:
Output = LayerNorm(x + Sublayer(x))Kết nối residual giúp tín hiệu đạo hàm lan truyền trực tiếp qua các tầng mạng mà không bị suy giảm, giải quyết hiện tượng tiêu biến đạo hàm khi xếp chồng nhiều tầng (N ≥ 6).
Tầng chuẩn hóa Layer Normalization (LayerNorm) đóng vai trò ổn định phân phối giá trị kích hoạt giữa các tầng. Khác với Batch Normalization (tính toán trung bình μ và phương sai σ^2 trên toàn bộ batch dữ liệu cho từng kênh), LayerNorm tính toán thống kê μ và σ^2 độc lập trên chiều đặc trưng hidden (d_model) cho duy nhất một vectơ token tại một bước thời gian:
LayerNorm(x) = ((x - μ) / √(σ^2 + ε)) · γ + βvới γ và β là các tham số học được, và ε = 10^-6 là hằng số chống chia cho 0. Chuẩn hóa theo chiều đặc trưng cho từng token riêng biệt giúp mô hình hoạt động ổn định bất chấp kích thước batch size thay đổi.
Mạng truyền tiến theo từng vị trí (Position-wise Feed-Forward Network - FFN) biến đổi độc lập và riêng biệt trên từng vị trí token. Mạng gồm hai phép biến đổi tuyến tính xen giữa bởi hàm kích hoạt ReLU:
FFN(x) = max(0, x · W_1 + b_1) · W_2 + b_2với W_1 có kích thước [d_model, d_ff], và W_2 có kích thước [d_ff, d_model]. Chiều ẩn của mạng FFN được mở rộng lên d_ff = 2048 (gấp 4 lần d_model = 512). Phép toán này tương đương với việc áp dụng hai phép tích chập có kích thước nhân k = 1. Chiều ẩn d_ff lớn cung cấp dung lượng lưu trữ tri thức phi tuyến tính cho mô hình sau khi thu nhận các thông tin chú ý.
Mô hình áp dụng hai kỹ thuật điều tiết (regularization) trong quá trình huấn luyện:
Residual Dropoutáp dụng tỷ lệP_drop = 0.1vào đầu ra của mỗi tầng con trước khi thực hiện phép cộng residual và LayerNorm, đồng thời áp dụng cho tổng ma trận nhúng token và ma trận vị trí.Label Smoothingthiết lập giá trịε_ls = 0.1để ngăn mô hình đưa ra các dự đoán quá tự tin (over-confident), cải thiện điểm số BLEU và khả năng tổng quát hóa trên dữ liệu kiểm thử.
Sự dịch chuyển sang Decoder-Only: Nền móng của các LLM hiện đại
Dù Transformer gốc sử dụng cấu trúc Encoder-Decoder cho nhiệm vụ dịch máy, sự phát triển của các mô hình ngôn ngữ lớn (LLM) thế hệ mới (như GPT, Llama, Claude) đánh dấu sự dịch chuyển sang kiến trúc Transformer chỉ chứa Decoder (Decoder-Only). Việc loại bỏ bộ Encoder giúp tối ưu hóa bài toán huấn luyện tự giám sát (self-supervised pre-training) trên các tập dữ liệu văn bản phi cấu trúc lớn thông qua mục tiêu dự đoán token tiếp theo (Causal Language Modeling).
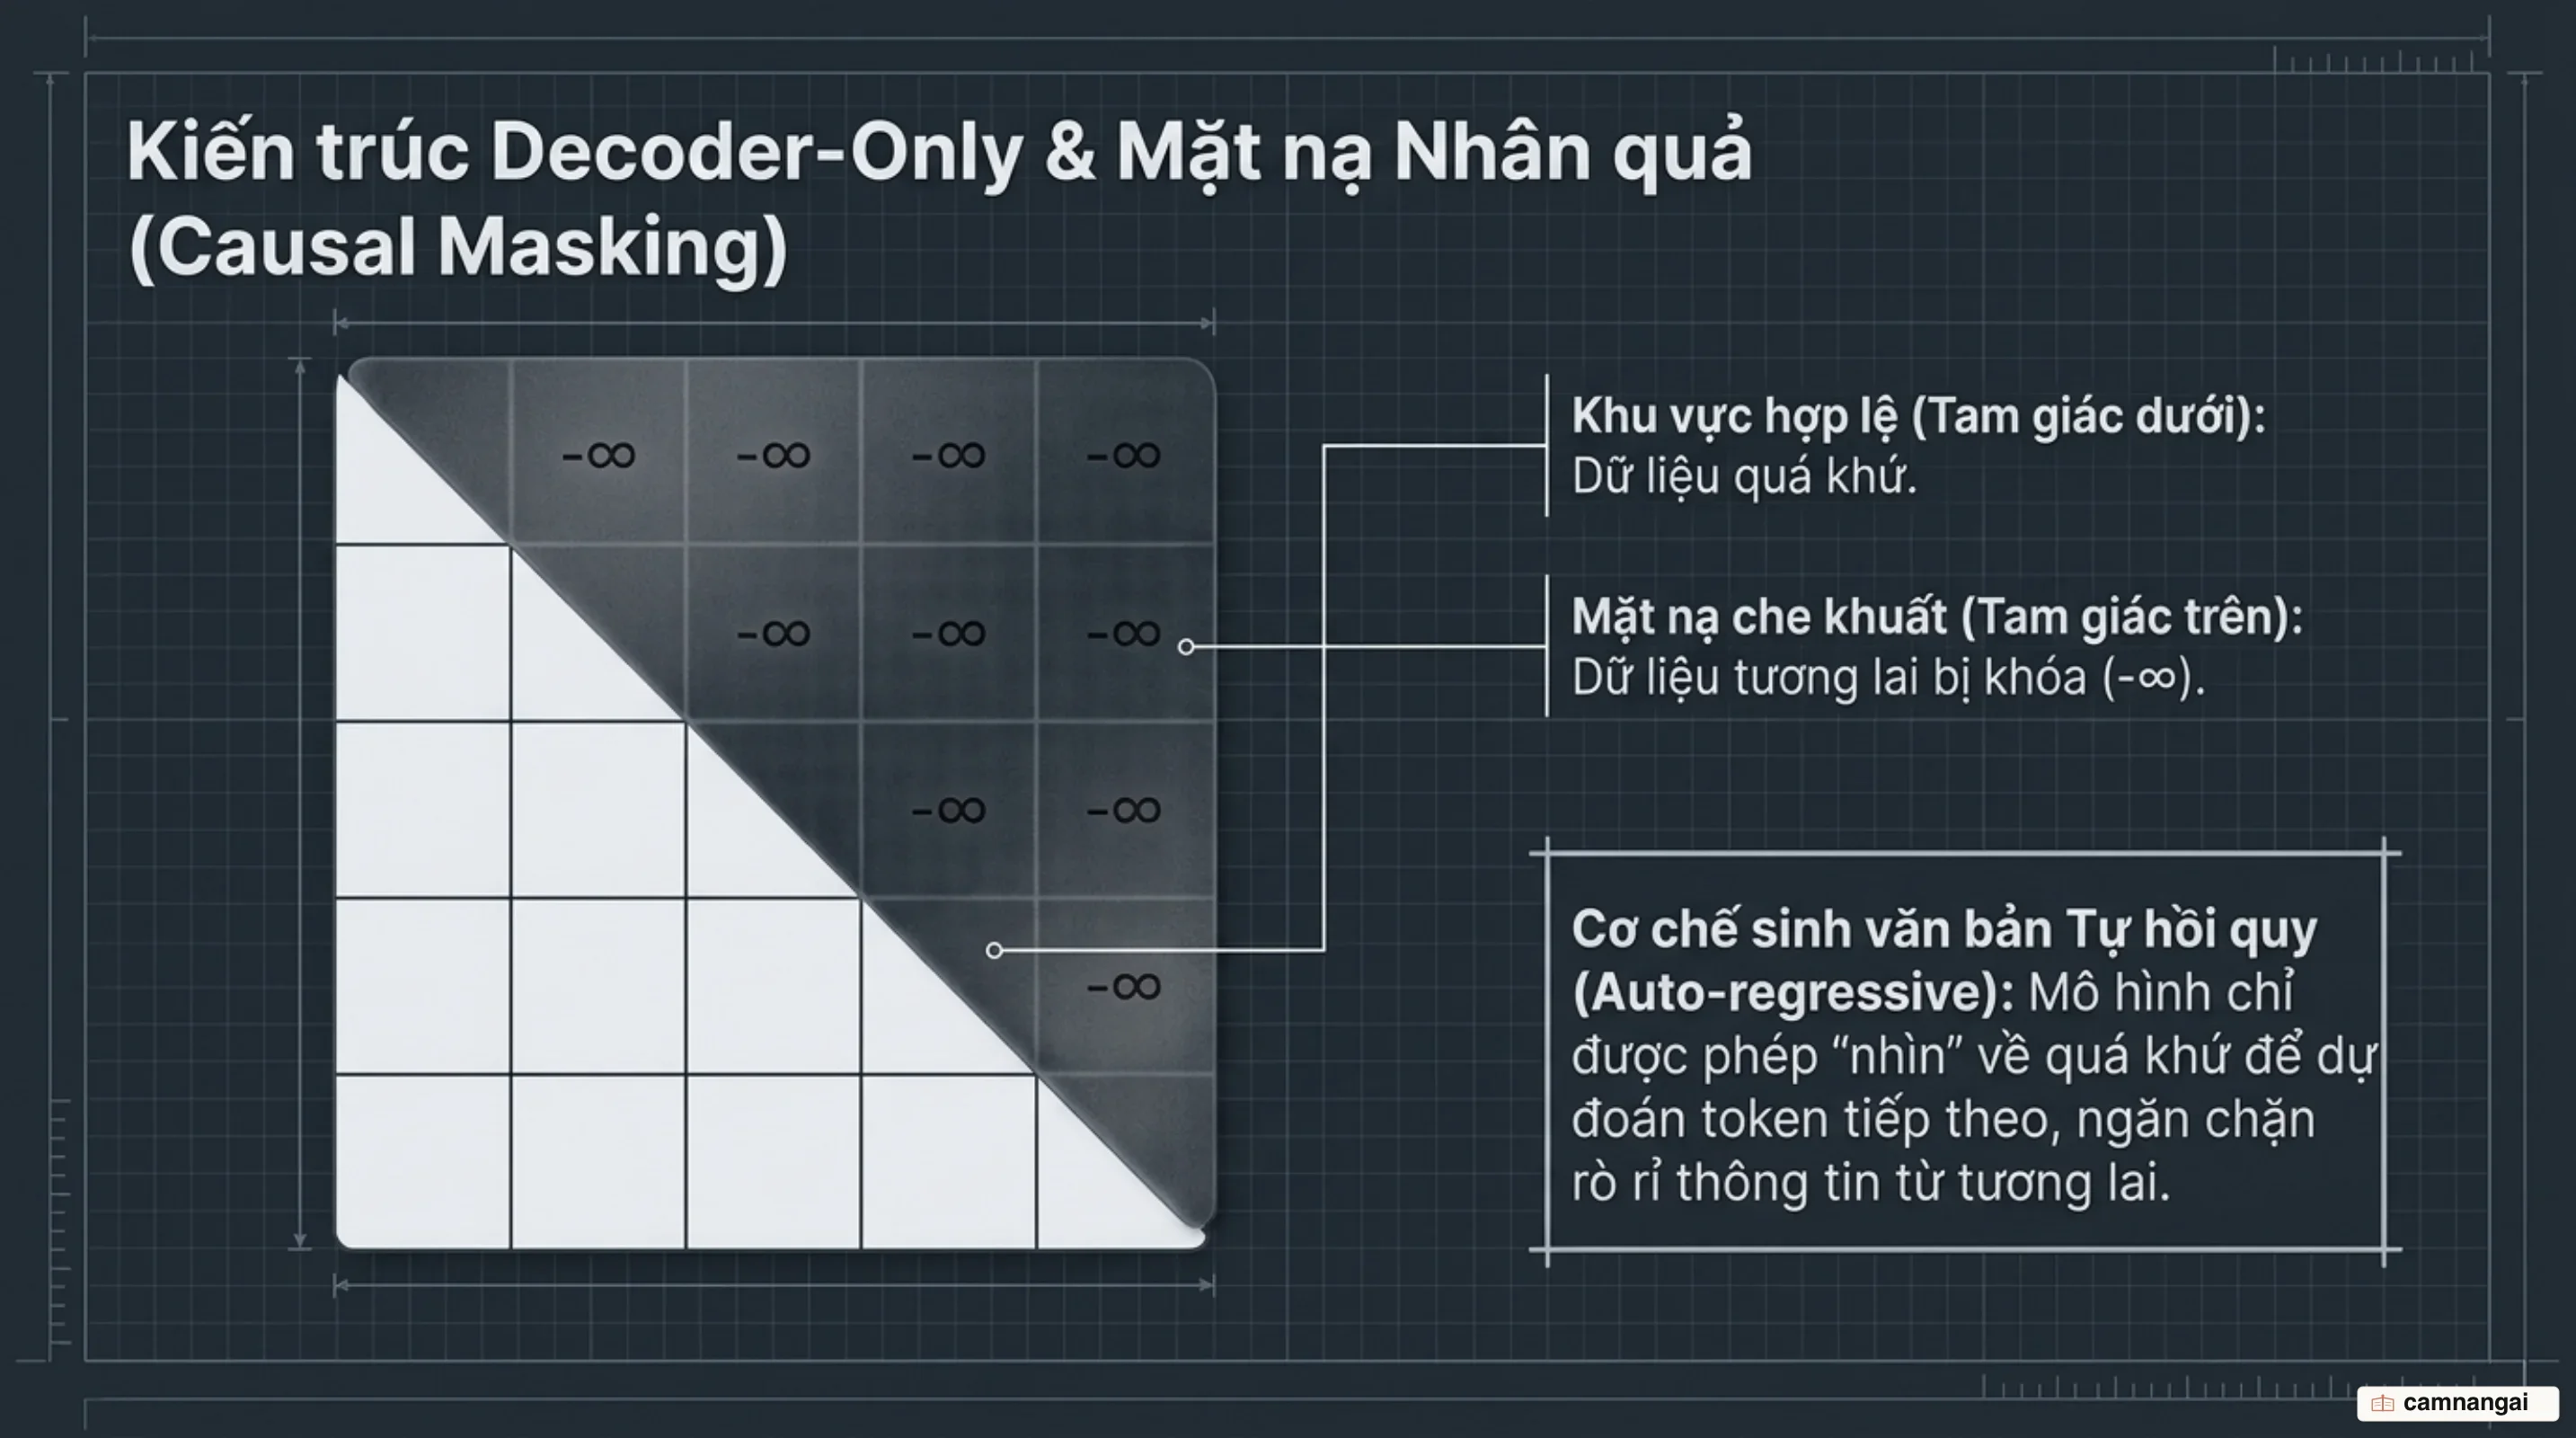
Trong kiến trúc Decoder-Only, cơ chế tự chú ý nhân quả (Causal Masked Self-Attention) giữ vai trò đảm bảo tính toàn vẹn của mô hình ngôn ngữ. Để ngăn thông tin từ tương lai rò rỉ vào các vị trí hiện tại, ma trận điểm số chú ý Q · K^T được cộng với một ma trận mặt nạ tam giác trên trước khi đưa vào hàm Softmax. Các vị trí có chỉ số cột j > i bị gán giá trị -1e9 (hoặc -∞). Khi đi qua hàm Softmax, giá trị exp(-1e9) xấp xỉ 0, triệt tiêu hoàn toàn ảnh hứng của các token tương lai lên biểu diễn của token hiện tại.
Vòng lặp suy luận (inference) diễn ra theo cơ chế sinh tự hồi quy từng bước:
- Chuỗi token đầu vào (prompt) được xử lý qua toàn bộ các tầng để tính phân phối xác suất dự đoán cho token kế tiếp thông qua tầng Linear Projection và Softmax.
- Token mới được lấy mẫu (sampling) từ phân phối xác suất này.
- Token mới được nối (append) vào cuối chuỗi dữ liệu đầu vào.
- Toàn bộ chuỗi dữ liệu mới được đưa lại vào mô hình để tiếp tục dự đoán token tiếp theo.
  Bước 1: Input ["Life", "is"] -------------> [Decoder Stack] ---> Output: "short"
                                                     |
  Bước 2: Input ["Life", "is", "short"] -----> [Decoder Stack] ---> Output: ","
Trong quá trình suy luận từng token, việc tính toán lại các vectơ Q, K, V cho toàn bộ các token quá khứ tại mỗi bước sinh tạo ra độ phức tạp tính toán dư thừa O(n^2). Kỹ thuật KV Caching được áp dụng để tối ưu hóa hiệu năng bằng cách lưu trữ ma trận Key và Value của tất cả các token lịch sử vào bộ nhớ VRAM của GPU. Tensor KV Cache được duy trì dưới dạng cấu trúc bộ nhớ [batch_size, num_heads, seq_len, head_dim]. Tại bước tính toán hiện tại t, mô hình chỉ tính toán vectơ Query, Key, Value cho duy nhất một token mới, sau đó nối Key và Value mới vào ma trận KV Cache có sẵn. Kỹ thuật này giảm độ phức tạp tính toán cho mỗi bước sinh token từ O(n^2) xuống O(n).
Các cải tiến kiến trúc trên các dòng LLM hiện đại
Khi các LLM mở rộng quy mô lên hàng chục và hàng trăm tỷ tham số, kiến trúc Transformer nguyên bản đã trải qua nhiều cải tiến về cấu trúc để duy trì độ ổn định huấn luyện và tối ưu hóa tốc độ suy luận. Một cải tiến quan trọng là việc thay thế mã hóa vị trí tuyệt đối bằng Rotary Position Embedding (RoPE). RoPE mã hóa vị trí tương đối bằng cách nhân vectơ Query và Key tại từng tầng chú ý với một ma trận quay số phức. Phương pháp này duy trì tính chất suy luận vị trí tương đối chính xác ngay cả khi suy luận trên các cửa sổ ngữ cảnh (context window) vượt quá hàng trăm nghìn token.
Để giảm mức tiêu thụ dung lượng RAM trên GPU của KV Cache khi phục vụ các LLM lớn, cơ chế Grouped-Query Attention (GQA) được phát triển nhằm thay thế cho Multi-Head Attention (MHA). Trong khi MHA duy trì số lượng đầu Key/Value bằng với số lượng đầu Query (h_Q = h_KV), GQA chia các đầu Query thành nhiều nhóm và cho các đầu Query trong cùng một nhóm chia sẻ chung một đầu Key/Value (h_KV < h_Q). Cấu trúc này giảm dung lượng KV Cache từ 4 đến 8 lần, nâng cao tốc độ suy luận (throughput) và cho phép mở rộng kích thước batch size trên phần cứng GPU. Kết hợp với các giải pháp tối ưu hóa thao tác bộ nhớ như FlashAttention, mô hình có thể xử lý ngữ cảnh dài với chi phí phần cứng tối ưu.
 Multi-Head Attention (MHA)        Grouped-Query Attention (GQA)

 Queries   Keys/Values            Queries           Keys/Values
   Q1 -------- K1/V1                Q1 \
   Q2 -------- K2/V2                Q2  +---------- K1/V1
   Q3 -------- K3/V3                Q3 /
   Q4 -------- K4/V4                Q4 \
                                    Q5  +---------- K2/V2
                                    Q6 /
 (1 Query - 1 Key/Value)          (N Queries - 1 Key/Value)
Về cấu trúc tầng, vị trí áp dụng Layer Normalization được thay đổi từ Post-LN (chuẩn hóa sau khi qua sub-layer và phép cộng residual) sang Pre-LN (chuẩn hóa trước khi đưa vào sub-layer). Cấu trúc Post-LN dễ gây mất ổn định đạo hàm ở các mô hình có độ sâu lớn. Pre-LN duy trì đường truyền residual chính không bị nhiễu, giúp quá trình lan truyền ngược ổn định khi huấn luyện các mô hình hàng trăm tầng. Hầu hết các LLM hiện đại biến tấu Pre-LN bằng cách sử dụng RMSNorm (Root Mean Square Normalization), kỹ thuật loại bỏ hoàn toàn phép tính trung bình μ trong LayerNorm để giảm chi phí tính toán mà vẫn đảm bảo tính ổn định của các giá trị kích hoạt.
Song song đó, những phát triển về kỹ thuật chắt lọc tri thức (Knowledge Distillation) và định luật quy mô (scaling laws) đã thúc đẩy sự ra đời của các dòng mô hình ngôn ngữ kích thước nhỏ nhưng hiệu năng cao (như SmolLM2 từ 135M đến 1.7B tham số hay Gemma 2 từ 2B đến 27B tham số). Các mô hình này áp dụng sự kết hợp tối ưu giữa các biến thể kiến trúc (RoPE, GQA, RMSNorm, Pre-LN) và mật độ dữ liệu huấn luyện lớn, chứng minh rằng cấu trúc Transformer tối ưu có thể đạt được kết quả ấn tượng trên các bài toán thực tế ở kích thước tham số gọn nhẹ.
Lời kết: Vì sao Transformer vẫn là xương sống không thể thay thế của AI
Kiến trúc Transformer đã thiết lập một tiêu chuẩn kỹ thuật mới cho lĩnh vực học sâu nhờ khả năng loại bỏ hoàn toàn tính toán tuần tự, tối ưu hóa khả năng xử lý song song trên phần cứng gia tốc quy mô lớn. Sự kết hợp giữa cơ chế tự chú ý chấm có tỷ lệ, khả năng biểu diễn đa không gian của Multi-Head Attention và các kết nối bổ trợ đã cung cấp cho hệ thống khả năng trích xuất tri thức linh hoạt từ dữ liệu chuỗi.
Chính tính chất đại số tuyến tính song song kết hợp với khả năng mở rộng (scalability) dự đoán được theo định luật quy mô đã đưa kiến trúc Transformer trở thành hạ tầng kỹ thuật chung cho cả xử lý ngôn ngữ tự nhiên lẫn các hệ thống học sâu đa phương thức hiện đại. Các cải tiến về tối ưu hóa bộ nhớ và ổn định đạo hàm tiếp tục củng cố vị thế của cơ chế chú ý như một nền tảng không thể thay thế của trí tuệ nhân tạo.