Khi xây dựng các hệ thống AI hiện đại, câu hỏi không còn là "LLM có thể làm được gì?" mà là "Làm thế nào để hệ thống hoạt động tin cậy ở quy mô lớn?". Thực tế, bạn nên chuyển sang kiến trúc multi-agent ngay khi một tác vụ đơn lẻ vượt quá giới hạn về cửa sổ ngữ cảnh (context window) (kể cả khi đã áp dụng kỹ thuật nén dữ liệu), yêu cầu tính song song hóa cao để giảm độ trễ (latency), hoặc đòi hỏi các quyền truy cập và công cụ chuyên biệt mà một agent đơn lẻ không thể gánh vác hiệu quả.
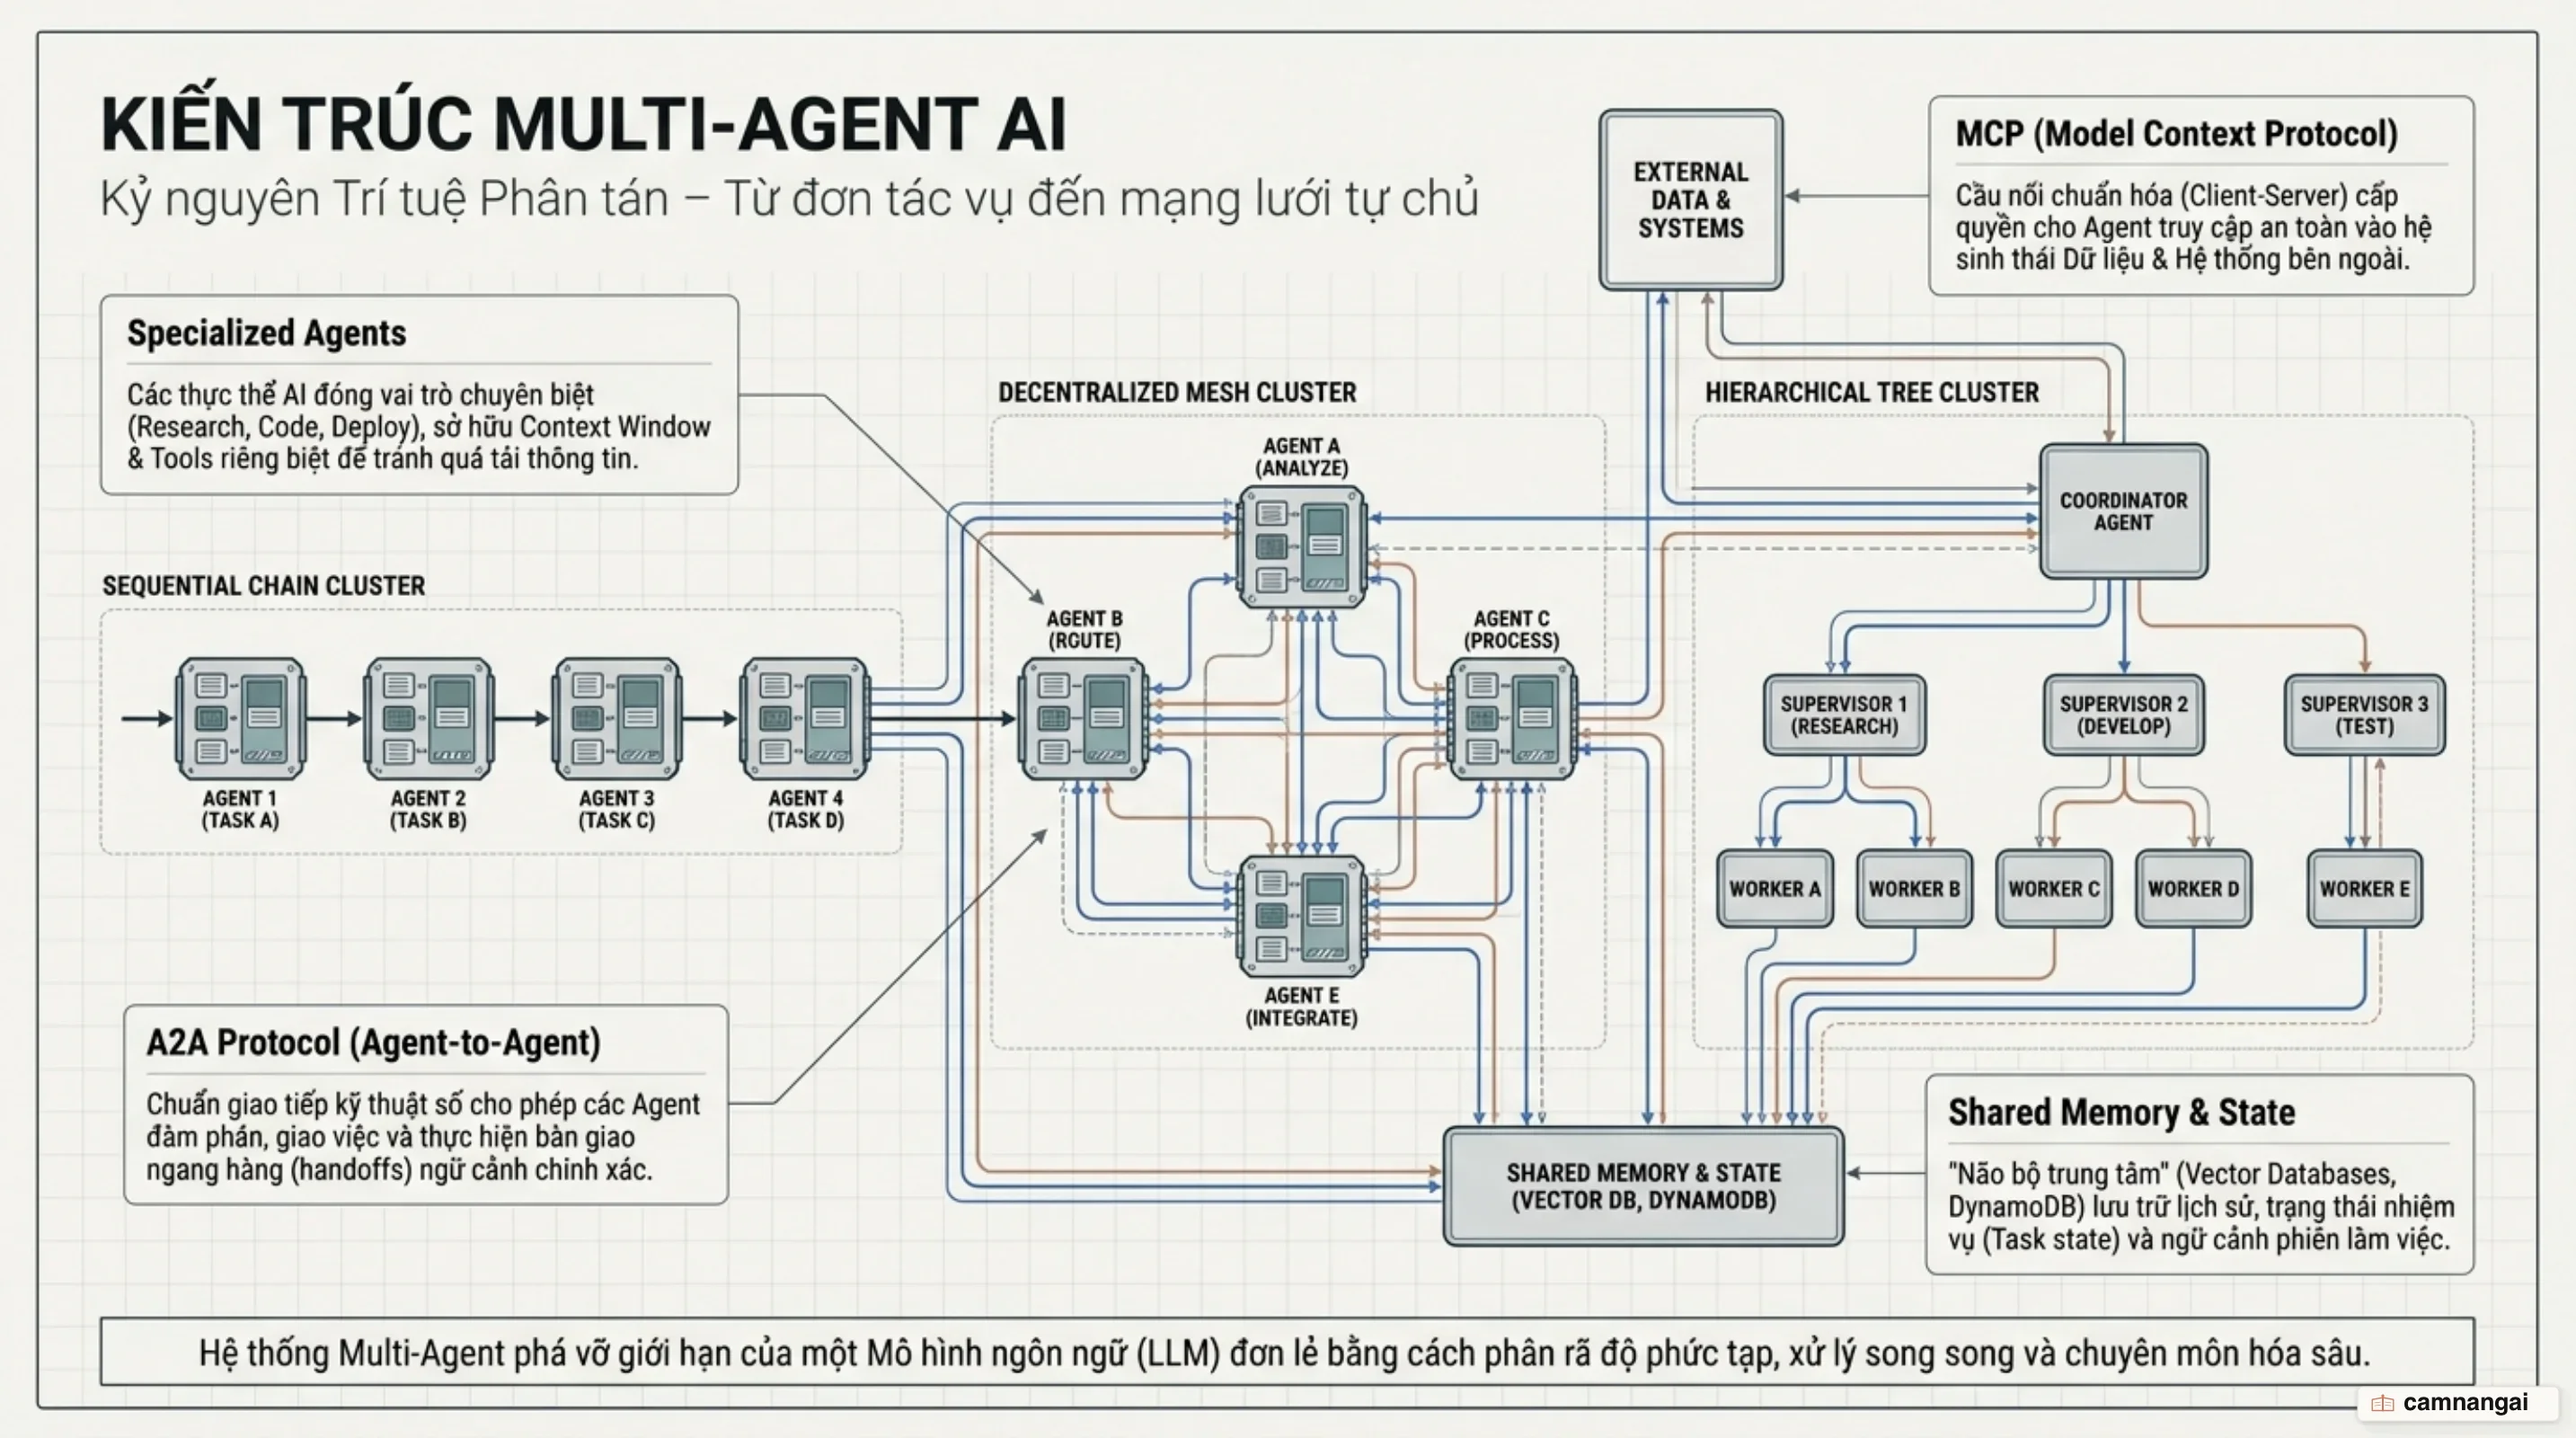
Kiến trúc multi-agent là mô hình phân rã các bài toán phức tạp thành nhiều tác vụ nhỏ được xử lý bởi các thực thể AI chuyên biệt hoạt động cộng tác.
Điểm khác biệt bạn cần phân biệt rõ là giữa Workflow và Agent. Workflow là hệ thống được điều phối qua các luồng mã cố định (predefined code paths), mang tính dự báo cao. Ngược lại, Agent là hệ thống mà mô hình ngôn ngữ lớn (LLM) tự quyết định quy trình và cách sử dụng công cụ linh hoạt dựa trên phản hồi môi trường.
Lựa chọn đúng kiến trúc multi-agent vừa là câu chuyện tối ưu hiệu năng, vừa là bài toán kiểm soát sai số tích tụ (compounding errors) trong toàn bộ luồng xử lý.
Vì sao agent đơn lẻ thất bại và khi nào cần multi-agent?
Một agent đơn lẻ thường chạm trần tại ba rào cản kỹ thuật sau:
- Tràn ngữ cảnh (Context Overflow): Khi kích thước dữ liệu đầu vào vượt quá khả năng xử lý hiệu quả của prompt, các thông tin quan trọng ở giữa hoặc đầu văn bản có thể bị bỏ quên. Ngay cả với các mô hình hỗ trợ context window hàng triệu token, việc nhồi nhét quá nhiều instruction và dữ liệu vẫn làm suy giảm năng lực suy luận logic và độ chính xác của agent.
- Thiếu khả năng song song hóa (Parallelism Constraints): Các tác vụ độc lập (chẳng hạn nghiên cứu độc lập 10 khía cạnh khác nhau của một ngành) nếu bị ép xử lý tuần tự sẽ tạo ra nút thắt cổ chai về độ trễ. Việc phân rã tác vụ cho các agent chạy song song có thể giảm tới 90% thời gian phản hồi tổng thể của hệ thống.
- Yêu cầu phân tách quyền hạn và chuyên môn hóa (Specialization & Permissions): Một agent không bao giờ nên vừa nắm quyền truy cập môi trường sandbox để thực thi mã nguồn tùy ý, lại vừa có quyền đọc cơ sở dữ liệu khách hàng nhạy cảm. Việc chia tách thành nhiều agent chuyên biệt giúp áp dụng nguyên tắc đặc quyền tối thiểu (least privilege), ngăn chặn nguy cơ leo thang đặc quyền (privilege creep) và cho phép tối ưu chi phí bằng cách gán model nhỏ, rẻ cho các tác vụ phụ trợ.
Mô hình 1: Orchestrator-Workers (Điều phối viên - Công nhân)
Trong mô hình Orchestrator-Workers, một agent trung tâm (Orchestrator) chịu trách nhiệm tiếp nhận mục tiêu tổng quát, phân tích bài toán, phân rã thành các phần việc độc lập và giao việc cho các Worker Agent. Các worker hoạt động hoàn toàn độc lập, không trực tiếp giao tiếp với nhau, và chỉ gửi kết quả về cho Orchestrator tổng hợp.
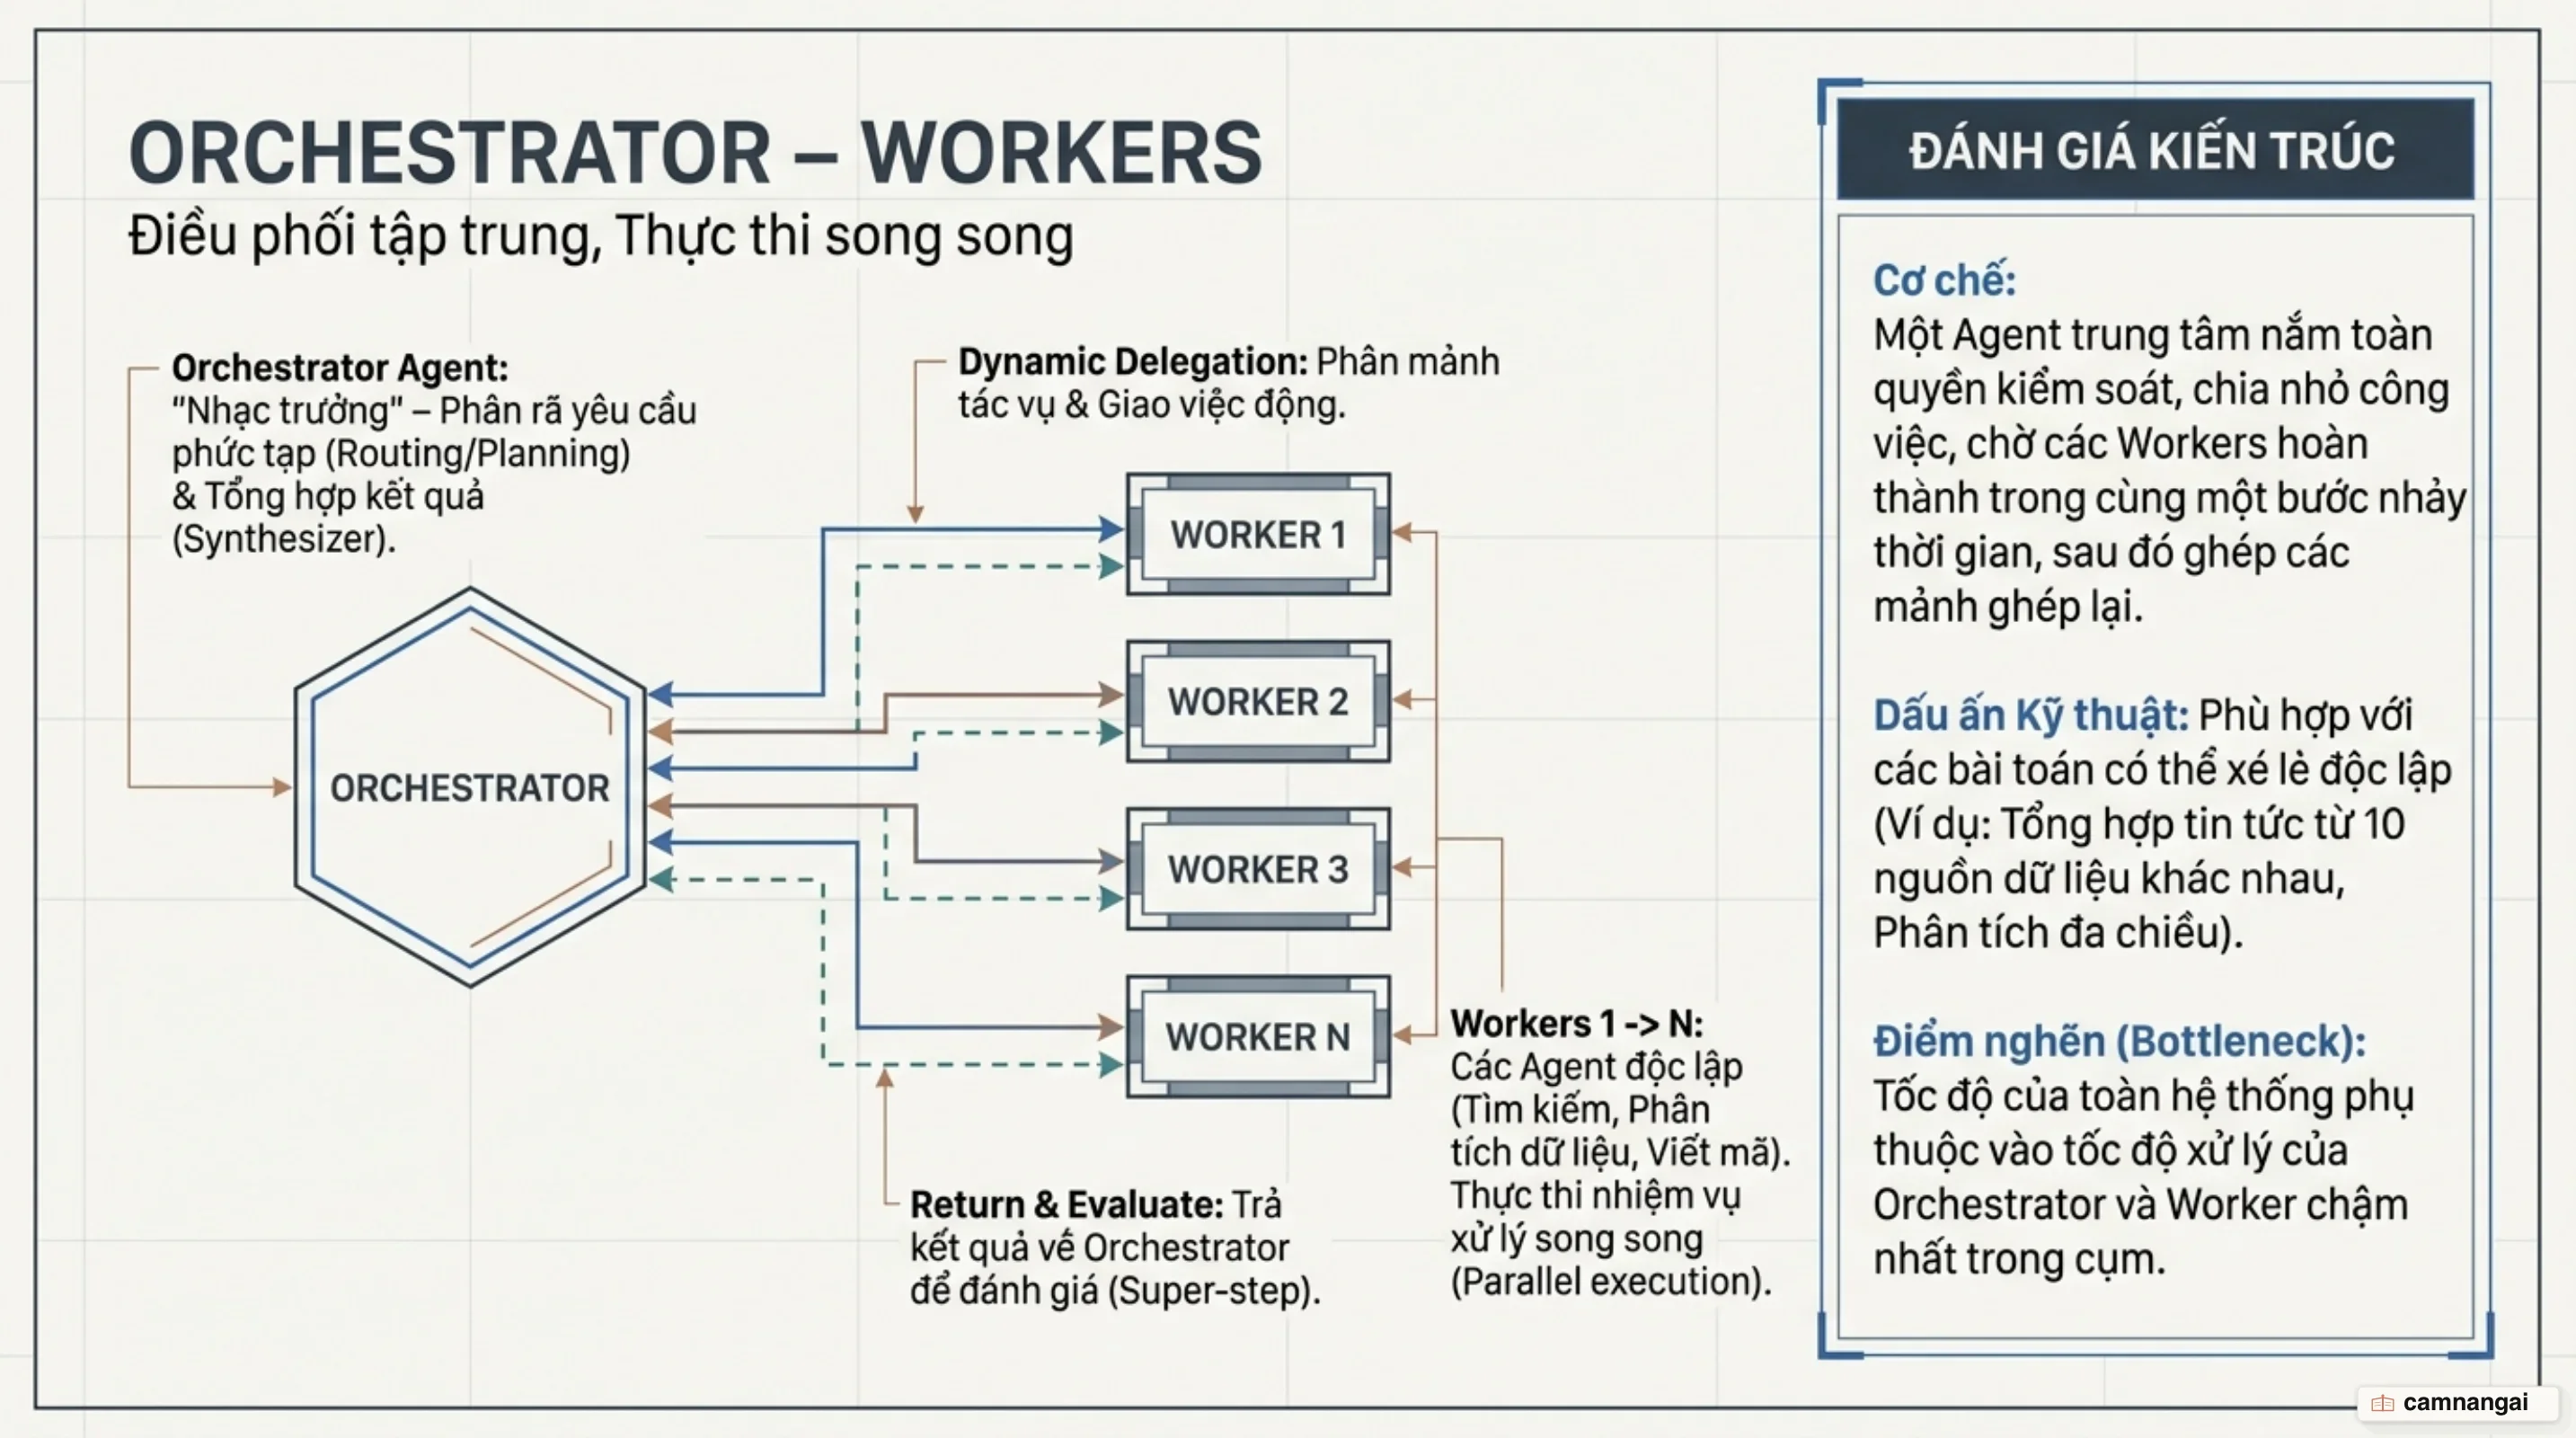
Khả năng mở rộng xử lý song song trong mô hình này thường triển khai theo hai kỹ thuật:
- Sectioning (Phân mảnh độc lập): Chia nhỏ một bài toán lớn thành các phần việc riêng biệt để nhiều worker xử lý đồng thời (ví dụ: mỗi worker quét một tài liệu hoặc nguồn dữ liệu khác nhau).
- Voting (Bỏ phiếu / Đồng thuận): Giao cùng một nhiệm vụ cho nhiều worker độc lập với các góc nhìn khác nhau để so sánh, bỏ phiếu kết quả nhằm giảm thiểu rủi ro ảo giác (hallucination).
Trong thực tế, mô hình nghiên cứu của Anthropic sử dụng một model đầu não (chẳng hạn Claude Opus) làm Orchestrator điều phối từ 2 đến 10 worker (dùng Claude Sonnet) chạy song song. Các worker tập trung truy xuất bằng chứng từ nhiều nguồn, sau đó Orchestrator tổng hợp báo cáo. Cấu hình này giúp cải thiện 90,2% chất lượng nghiên cứu so với một agent đơn lẻ.
Tuy nhiên, Orchestrator chính là điểm nghẽn hiệu năng (bottleneck). Toàn bộ thông lượng hệ thống bị trần bởi tốc độ xử lý của agent đầu não. Thêm vào đó, nếu Orchestrator giao việc với prompt mơ hồ, các worker rất dễ thực hiện trùng lặp công việc, gây lãng phí ngân sách token và tăng chi phí vận hành.
Mô hình 2: Sequential Pipeline (Chuỗi xử lý tuần tự)
Mô hình Sequential Pipeline tổ chức các agent theo dạng đồ thị có hướng không chu trình (DAG - Directed Acyclic Graph), hoạt động tương tự như một dây chuyền lắp ráp công nghiệp. Đầu ra của agent chặng trước trở thành đầu vào trực tiếp cho agent chặng tiếp theo.
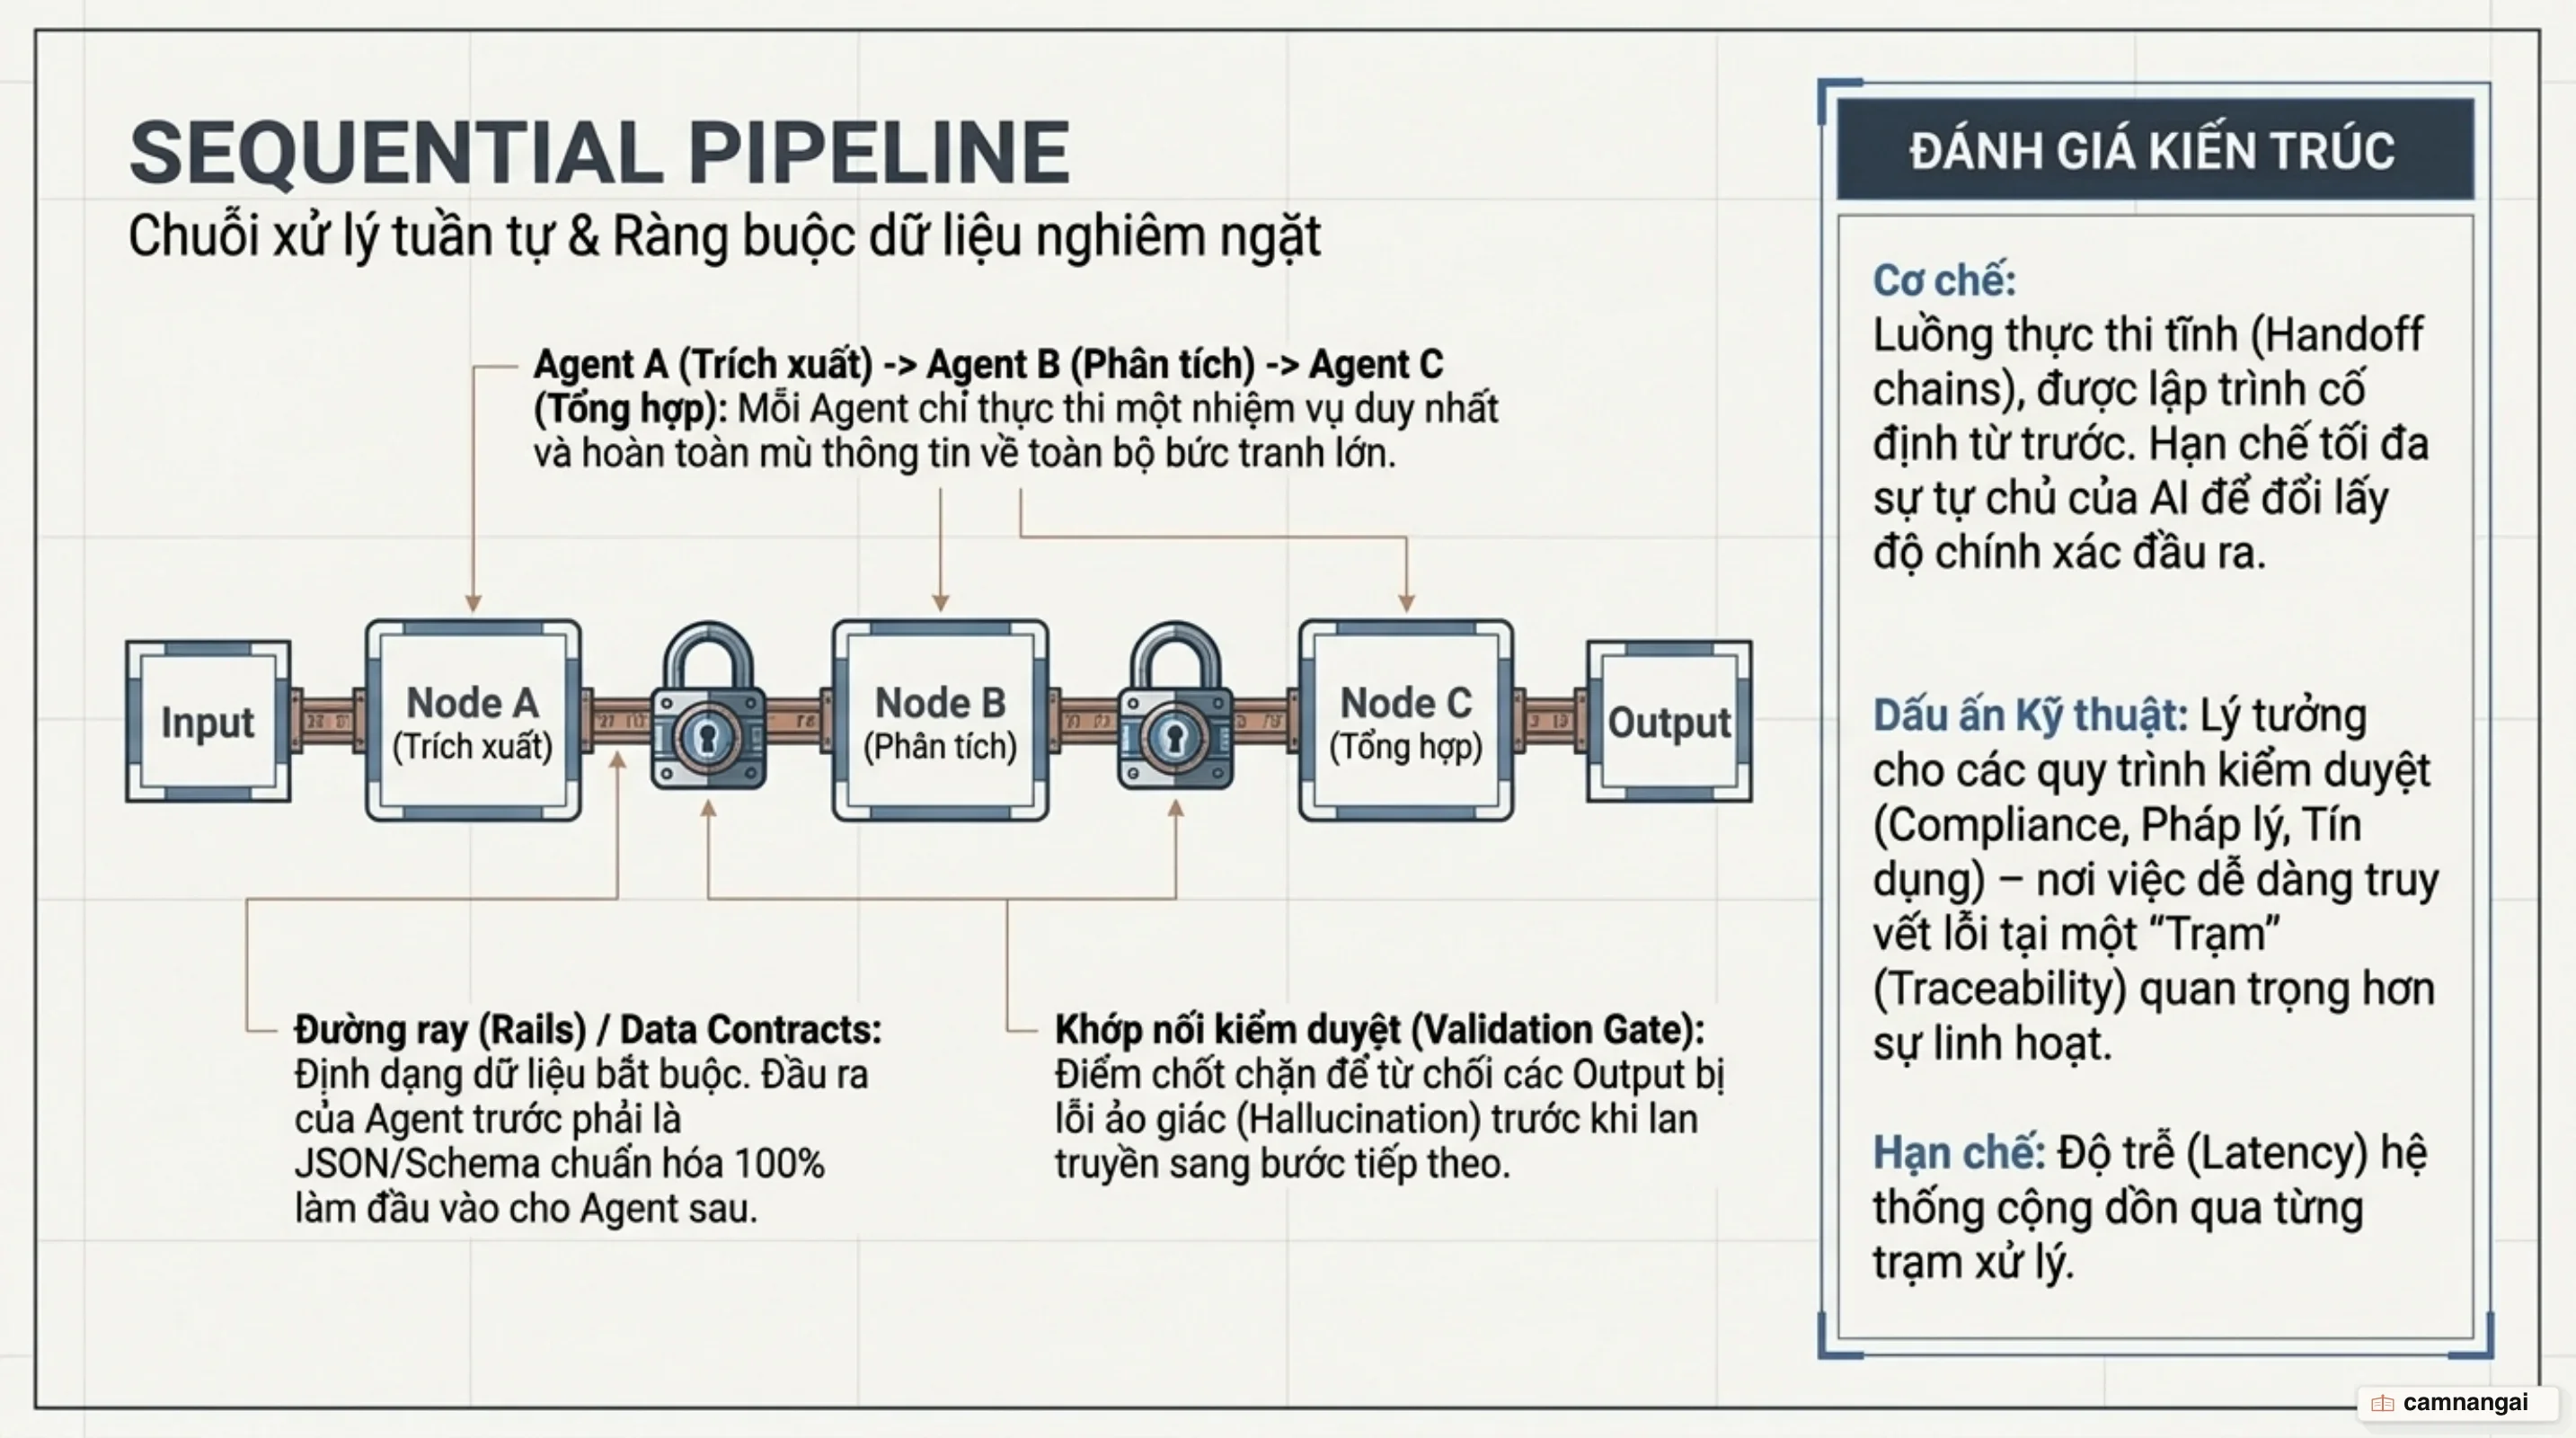
Mô hình này ưu tiên tính nhất quán, tính lặp lại và sự minh bạch tuyệt đối, đặc biệt phù hợp cho các quy trình nghiệp vụ yêu cầu kiểm toán khắt khe. Mấu chốt giúp pipeline thành công trong thực tế là việc thiết lập các "rails" (hợp đồng dữ liệu nghiêm ngặt): mỗi chặng chỉ nhận đúng schema dữ liệu đã định nghĩa và chỉ trả ra cấu trúc chuẩn tắc, ngăn chặn tình trạng agent đi lạc khỏi nhiệm vụ. Stripe đã áp dụng mô hình này vào quy trình thẩm định doanh nghiệp (từ kiểm tra pháp lý, đối soát hồ sơ đến đánh giá rủi ro), giúp giảm 26% thời gian xử lý so với quy trình thủ công.
Đánh đổi kỹ thuật lớn nhất của pipeline là độ trễ cộng dồn (latency stack). Tổng thời gian xử lý của hệ thống bằng tổng thời gian của từng bước gọi LLM nối tiếp nhau. Nếu bạn bổ sung thêm một agent đánh giá (evaluator) hoặc tinh chỉnh (refiner) vào cuối chuỗi, hệ thống sẽ tăng thêm chất lượng nhưng đánh đổi bằng việc người dùng phải chờ thêm vài giây.
Bù lại, pipeline mang lại kỷ luật ngữ cảnh (context discipline) vượt trội. Bằng cách ngắt context giữa các chặng, agent viết báo cáo ở cuối luồng sẽ không bị làm phiền bởi hàng trăm dòng dữ liệu thô chưa lọc của agent thu thập ở đầu luồng, giúp việc debug và tối ưu hóa từng prompt trở nên dễ dàng và cô lập.
Mô hình 3: Hierarchical Supervisor (Phân tầng đa cấp)
Mô hình Hierarchical Supervisor cấu trúc hệ thống thành một cây phả hệ nhiều tầng. Một Supervisor tối cao nắm giữ mục tiêu chiến lược và các bản tóm tắt cấp cao, sau đó định tuyến nhiệm vụ xuống các Supervisor cấp trung quản lý từng miền nghiệp vụ (domain). Các Supervisor cấp trung này tiếp tục chỉ đạo các worker chuyên biệt cấp dưới.
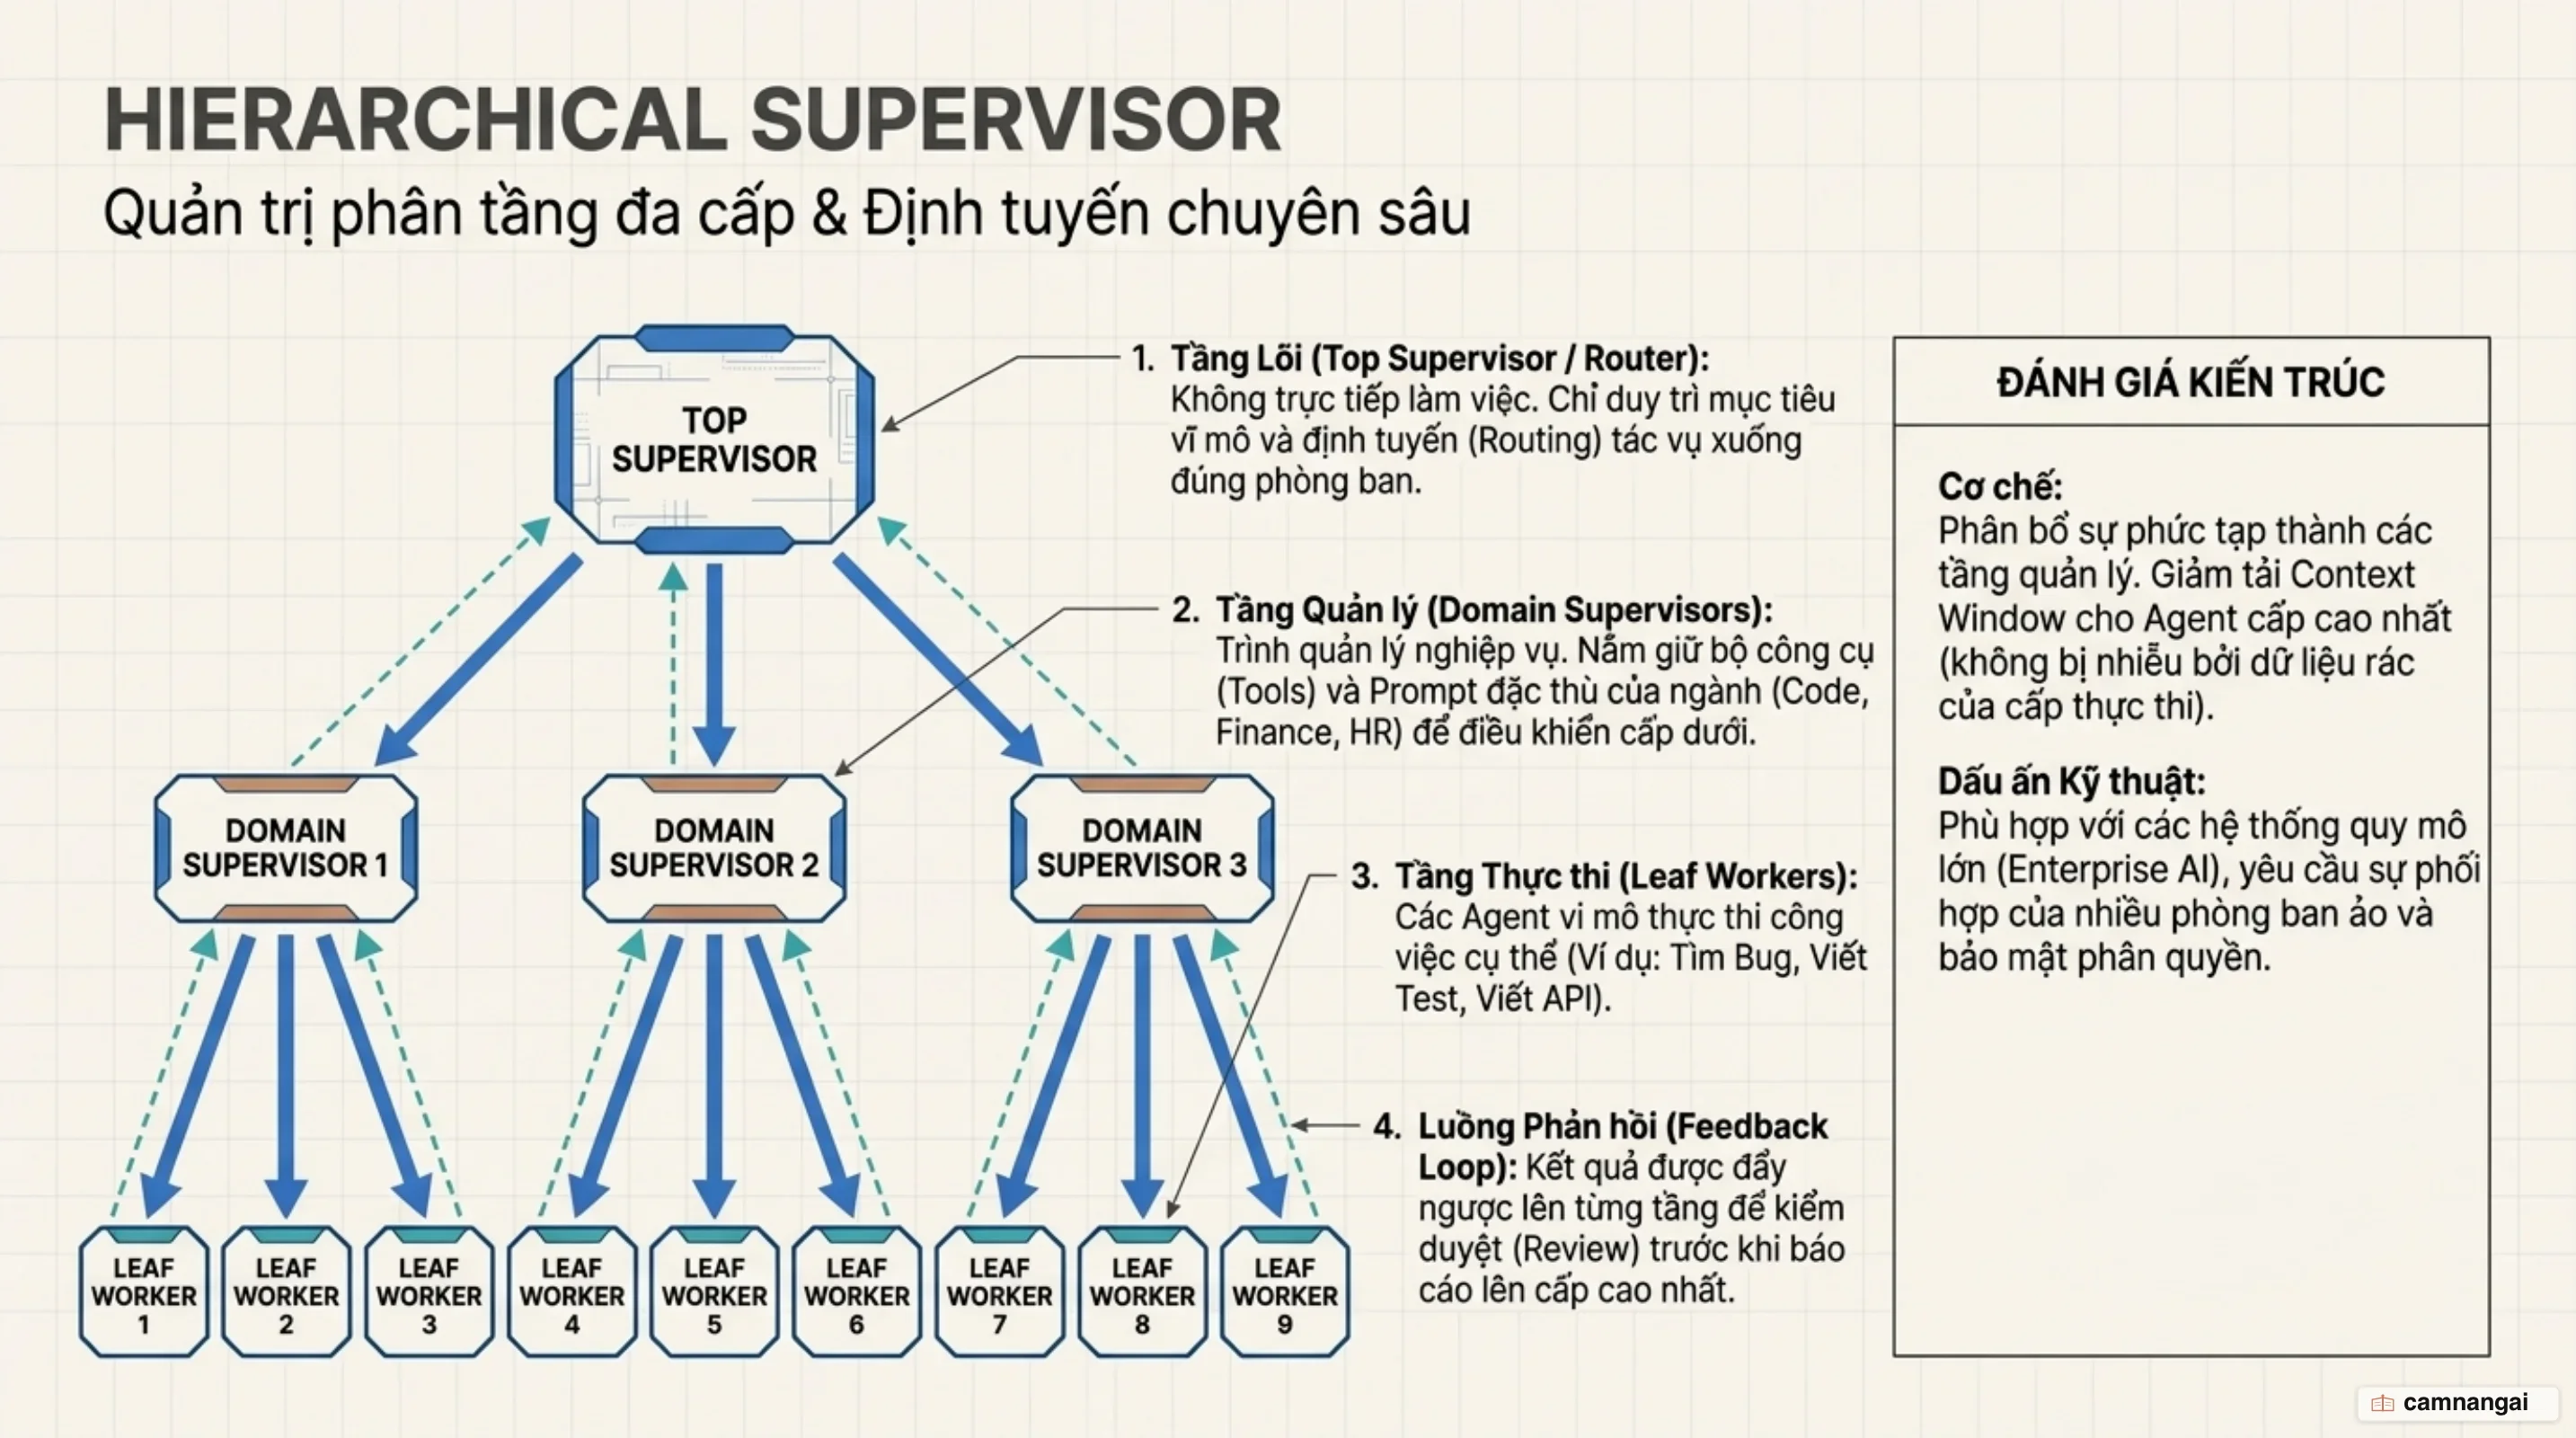
Đây là kiến trúc tối ưu nhất để giải quyết bài toán context window cho các hệ thống quy mô lớn, bởi không có bất kỳ agent nào phải ôm trọn vẹn toàn bộ ngữ cảnh khổng lồ của doanh nghiệp. Điển hình như IBM watsonx Orchestrate phân cấp điều phối hơn 80 agent chuyên trách cho các mảng nhân sự (HR), kinh doanh và mua sắm.
Trong hệ thống PRINCE (hợp tác giữa Thoughtworks và Bayer trong ngành dược phẩm), kiến trúc phân tầng chứng minh sức mạnh qua cơ chế phản tư quy trình (Process Reflection) và phản tư dữ liệu (Data Reflection):
- Phản tư quy trình (Think & Plan): Supervisor đánh giá xem kế hoạch hành động hiện tại có thực sự khả thi không, cho phép chuyển hướng truy vấn (ví dụ từ tìm kiếm vector sang truy vấn SQL) mà không phải làm lại từ đầu.
- Fail-fast ngay từ bước làm rõ ý định: Nếu câu hỏi của người dùng mơ hồ, Supervisor lập tức dừng luồng để yêu cầu làm rõ, tránh việc kích hoạt hàng loạt agent nghiên cứu đắt đỏ ở tầng dưới.
- Phản tư dữ liệu: Một agent độc lập đánh giá tính đầy đủ của thông tin trước khi cho phép tầng viết tổng hợp câu trả lời, đảm bảo tính chính xác khoa học.
Rủi ro lớn nhất của mô hình phân tầng là hiện tượng thất thoát thông tin (loss of detail). Khi dữ liệu bị tóm tắt và trừu tượng hóa qua quá nhiều tầng quản lý, các chi tiết kỹ thuật sắc bén ở tầng worker có thể bị lược bỏ trước khi chạm tới quyết định cuối cùng.
Mô hình 4: Collaborative Network và Swarm (Mạng lưới cộng tác ngang hàng)
Kiến trúc Collaborative Network (Swarm) là hệ thống phi tập trung, trong đó các agent hoạt động bình đẳng mà không có một bộ điều phối trung tâm nào nắm quyền sinh sát. Việc phối hợp giữa các agent diễn ra thông qua hai cơ chế chính: Handoffs (bàn giao quyền điều khiển linh hoạt giữa các agent) hoặc thông qua một Shared Blackboard (bảng đen chia sẻ trạng thái chung, thường lưu trữ trên Redis hoặc Vector Database).
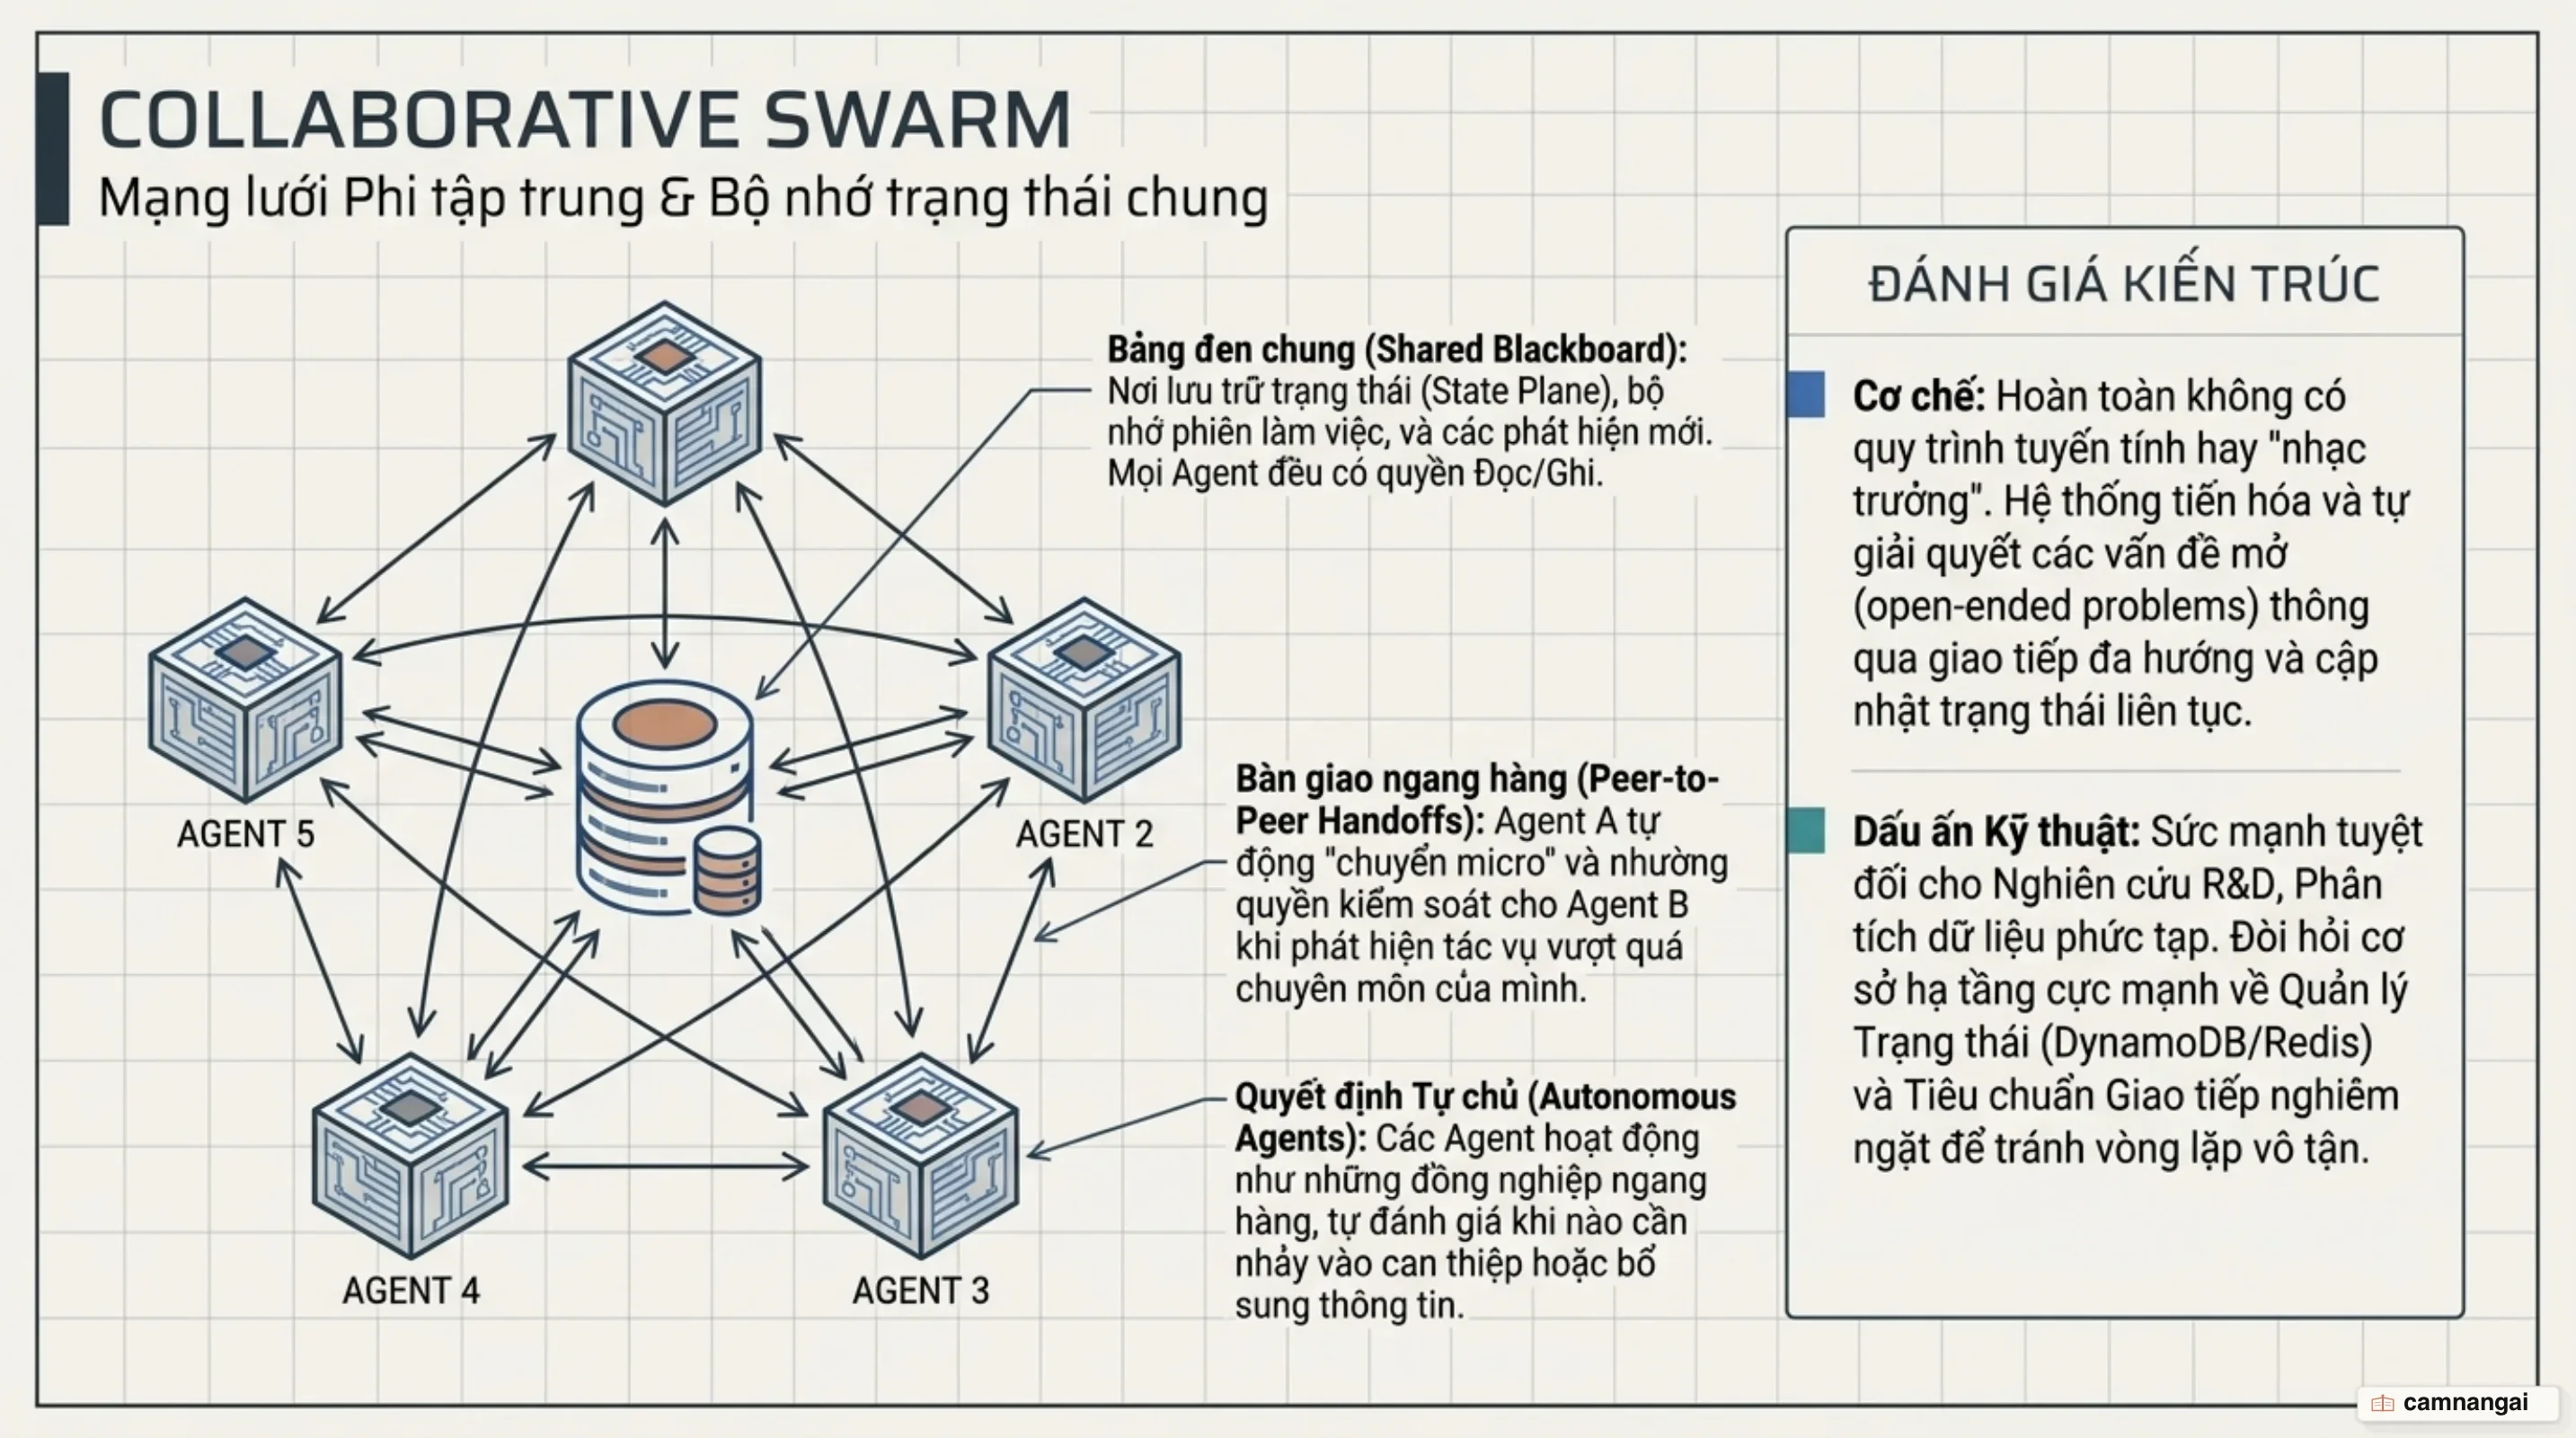
Ưu điểm nổi bật nhất của mạng lưới ngang hàng là khả năng chống chịu lỗi (resilience). Việc một agent gặp sự cố hoặc timeout không làm sập toàn bộ hệ thống; các agent khác trong mạng lưới vẫn có thể đọc trạng thái từ blackboard và tiếp tục hoàn thành nhiệm vụ. Điều này khiến swarm trở thành lựa chọn phù hợp cho các bài toán phân tích mở, nơi lộ trình giải quyết không thể vạch sẵn từ đầu và cần sự tương tác đa chiều.
Tuy nhiên, trong môi trường doanh nghiệp, Swarm là một thách thức lớn về khả năng kiểm soát và quan sát (observability). Do không có tháp điều khiển trung tâm, việc truy vết chính xác chuỗi nguyên nhân - kết quả dẫn đến một quyết định sai lệch trở nên cực kỳ phức tạp. Hệ thống cũng rất dễ rơi vào các vòng lặp bế tắc (ambiguity loops) khi các agent liên tục chuyền việc cho nhau mà không agent nào chịu trách nhiệm đưa ra kết luận cuối cùng.
Cơ chế giao tiếp và quản lý State giữa các agent
Một hệ thống multi-agent vững chắc đòi hỏi kiến trúc quản lý trạng thái (state) chuẩn hóa và cơ chế điều phối rõ ràng. Hiện nay, phương pháp tiếp cận theo từng siêu bước (super-steps) — bắt nguồn từ mô hình Pregel của Google và được phổ biến qua LangGraph — đang trở thành tiêu chuẩn công nghiệp:
- Quản lý State và Reducers: Trạng thái hệ thống được quản lý qua một schema chặt chẽ. Khi một node agent hoàn thành việc, thay vì ghi đè thô bạo lên dữ liệu cũ, hệ thống sử dụng các hàm Reducers (chẳng hạn cơ chế append message) để bảo toàn lịch sử tương tác và hỗ trợ phục hồi khi gặp lỗi.
- Định tuyến ngữ cảnh có chọn lọc (Selective Context Routing): Thay vì ném toàn bộ lịch sử trò chuyện cho mọi agent, các kiến trúc hàng đầu chỉ trích xuất đúng lát cắt dữ liệu cần thiết cho agent đó. Điều này giảm thiểu tối đa hiện tượng nhiễu ngữ cảnh (context contamination).
- Chuẩn hóa giao diện bằng giao thức: Giao thức Model Context Protocol (MCP) chuẩn hóa giao diện giữa agent và tài nguyên công cụ bên ngoài, đóng vai trò như một chuẩn Agent-Computer Interface (ACI). Trong khi đó, giao thức Agent-to-Agent (A2A) định hình cách thức các agent giao tiếp, chia sẻ ngữ cảnh và bàn giao tác vụ xuyên ranh giới hệ thống.
from typing import Annotated, TypedDict
from langgraph.graph.message import add_messages
from langgraph.managed import RemainingSteps

class SystemState(TypedDict):
    # Reducer đảm bảo tin nhắn mới được nối tiếp vào lịch sử
    messages: Annotated[list, add_messages]
    # Kiểm soát số bước còn lại trước khi chạm ngưỡng đệ quy
    remaining_steps: RemainingSteps
    current_phase: str
    active_worker: str
Khả năng phục hồi, xử lý lỗi và cái giá của sự phức tạp
Trong các hệ thống phân tán của AI, rủi ro kỹ thuật nguy hiểm nhất là sai số tích tụ (Compounding Errors): một suy luận sai lệch nhỏ ở agent đầu tiên có thể bị phóng đại thành một thảm họa dữ liệu ở agent cuối cùng.
Để bảo vệ hệ thống trong môi trường production, bạn cần xây dựng ba lớp phòng thủ:
- Lưu vết trạng thái (State Persistence & Checkpoints): Luôn ghi nhận snapshot trạng thái vào cơ sở dữ liệu (Postgres, DynamoDB) sau mỗi siêu bước. Khi một agent gặp lỗi mạng hoặc crash, hệ thống có thể phục hồi (resume) từ checkpoint gần nhất thay vì chạy lại từ đầu, tiết kiệm một lượng lớn chi phí token.
- Chiến lược xử lý lỗi chủ động: Kết hợp exponential backoff khi gọi API với cơ chế LLM Fallbacks (tự động chuyển hướng từ nhà cung cấp chính sang nhà cung cấp dự phòng nếu gặp mã lỗi 5xx hoặc chạm hạn mức rate-limit).
- Kỹ thuật khung bọc (Harness Engineering): Toàn bộ độ tin cậy của hệ thống đến từ bộ khung bao quanh model: hệ thống log truy vết (tracing) từng bước nhảy giữa các agent, rào chắn bảo vệ (guardrails) ngăn rò rỉ dữ liệu và bộ tiêu chí đánh giá tự động (Evals) liên tục đo lường tính trung thực của câu trả lời.
Khi nào bạn thực sự nên dùng multi-agent?
Lời khuyên kiến trúc quan trọng nhất: Đừng bắt đầu bằng multi-agent.
Multi-agent không phải là giải pháp vá lỗi cho một prompt tồi, cũng không phải là thứ để phô diễn sự phức tạp của hệ thống. Mỗi agent bổ sung vào kiến trúc đều phải trả giá bằng độ trễ tăng thêm, hóa đơn token nhân cấp số nhân và độ phức tạp vận hành tăng vọt.
Hãy bắt đầu bằng một prompt đơn lẻ được thiết kế chặt chẽ. Khi gặp giới hạn, hãy thử chuyển sang một quy trình workflow với logic code cố định. Bạn chỉ nên chuyển sang kiến trúc multi-agent khi bài toán thực sự vượt quá năng lực của một cửa sổ ngữ cảnh duy nhất, khi bạn cần khai thác triệt để năng lực xử lý song song, hoặc khi các ranh giới về bảo mật đòi hỏi sự cách ly nghiêm ngặt giữa các công cụ. Hãy để giá trị nghiệp vụ dẫn dắt kiến trúc, thay vì chạy theo sự hào nhoáng của công nghệ.
Tài liệu tham khảo
- Multi-Agent Architectures, Clearly Explained — System Design One
- Building Effective AI Agents — Anthropic
- Multi-Agent Systems — LangGraph Concepts
- Multi-agent AI system architecture — Google Cloud
- Multi-Agent Architectures — AWS Architecture
- Building Reliable Agentic AI Systems — Martin Fowler
- Agent and Multi-Agent Applications — AutoGen