Jev là mô hình System One đầu tiên được phát triển bởi TypeSafe AI, được thiết kế chuyên biệt để đưa ra các phán đoán có định kiểu (typed judgments) thay vì sinh văn bản (text generation).
Khác với các mô hình ngôn ngữ lớn (LLM) thông thường, Jev hoạt động như một thành phần hạ tầng (infrastructure component) tích hợp sâu vào hệ thống backend. Thay vì trả về chuỗi văn bản cần phân tách phức tạp, Jev trả về xác suất, lựa chọn định kiểu và chỉ số tin cậy.
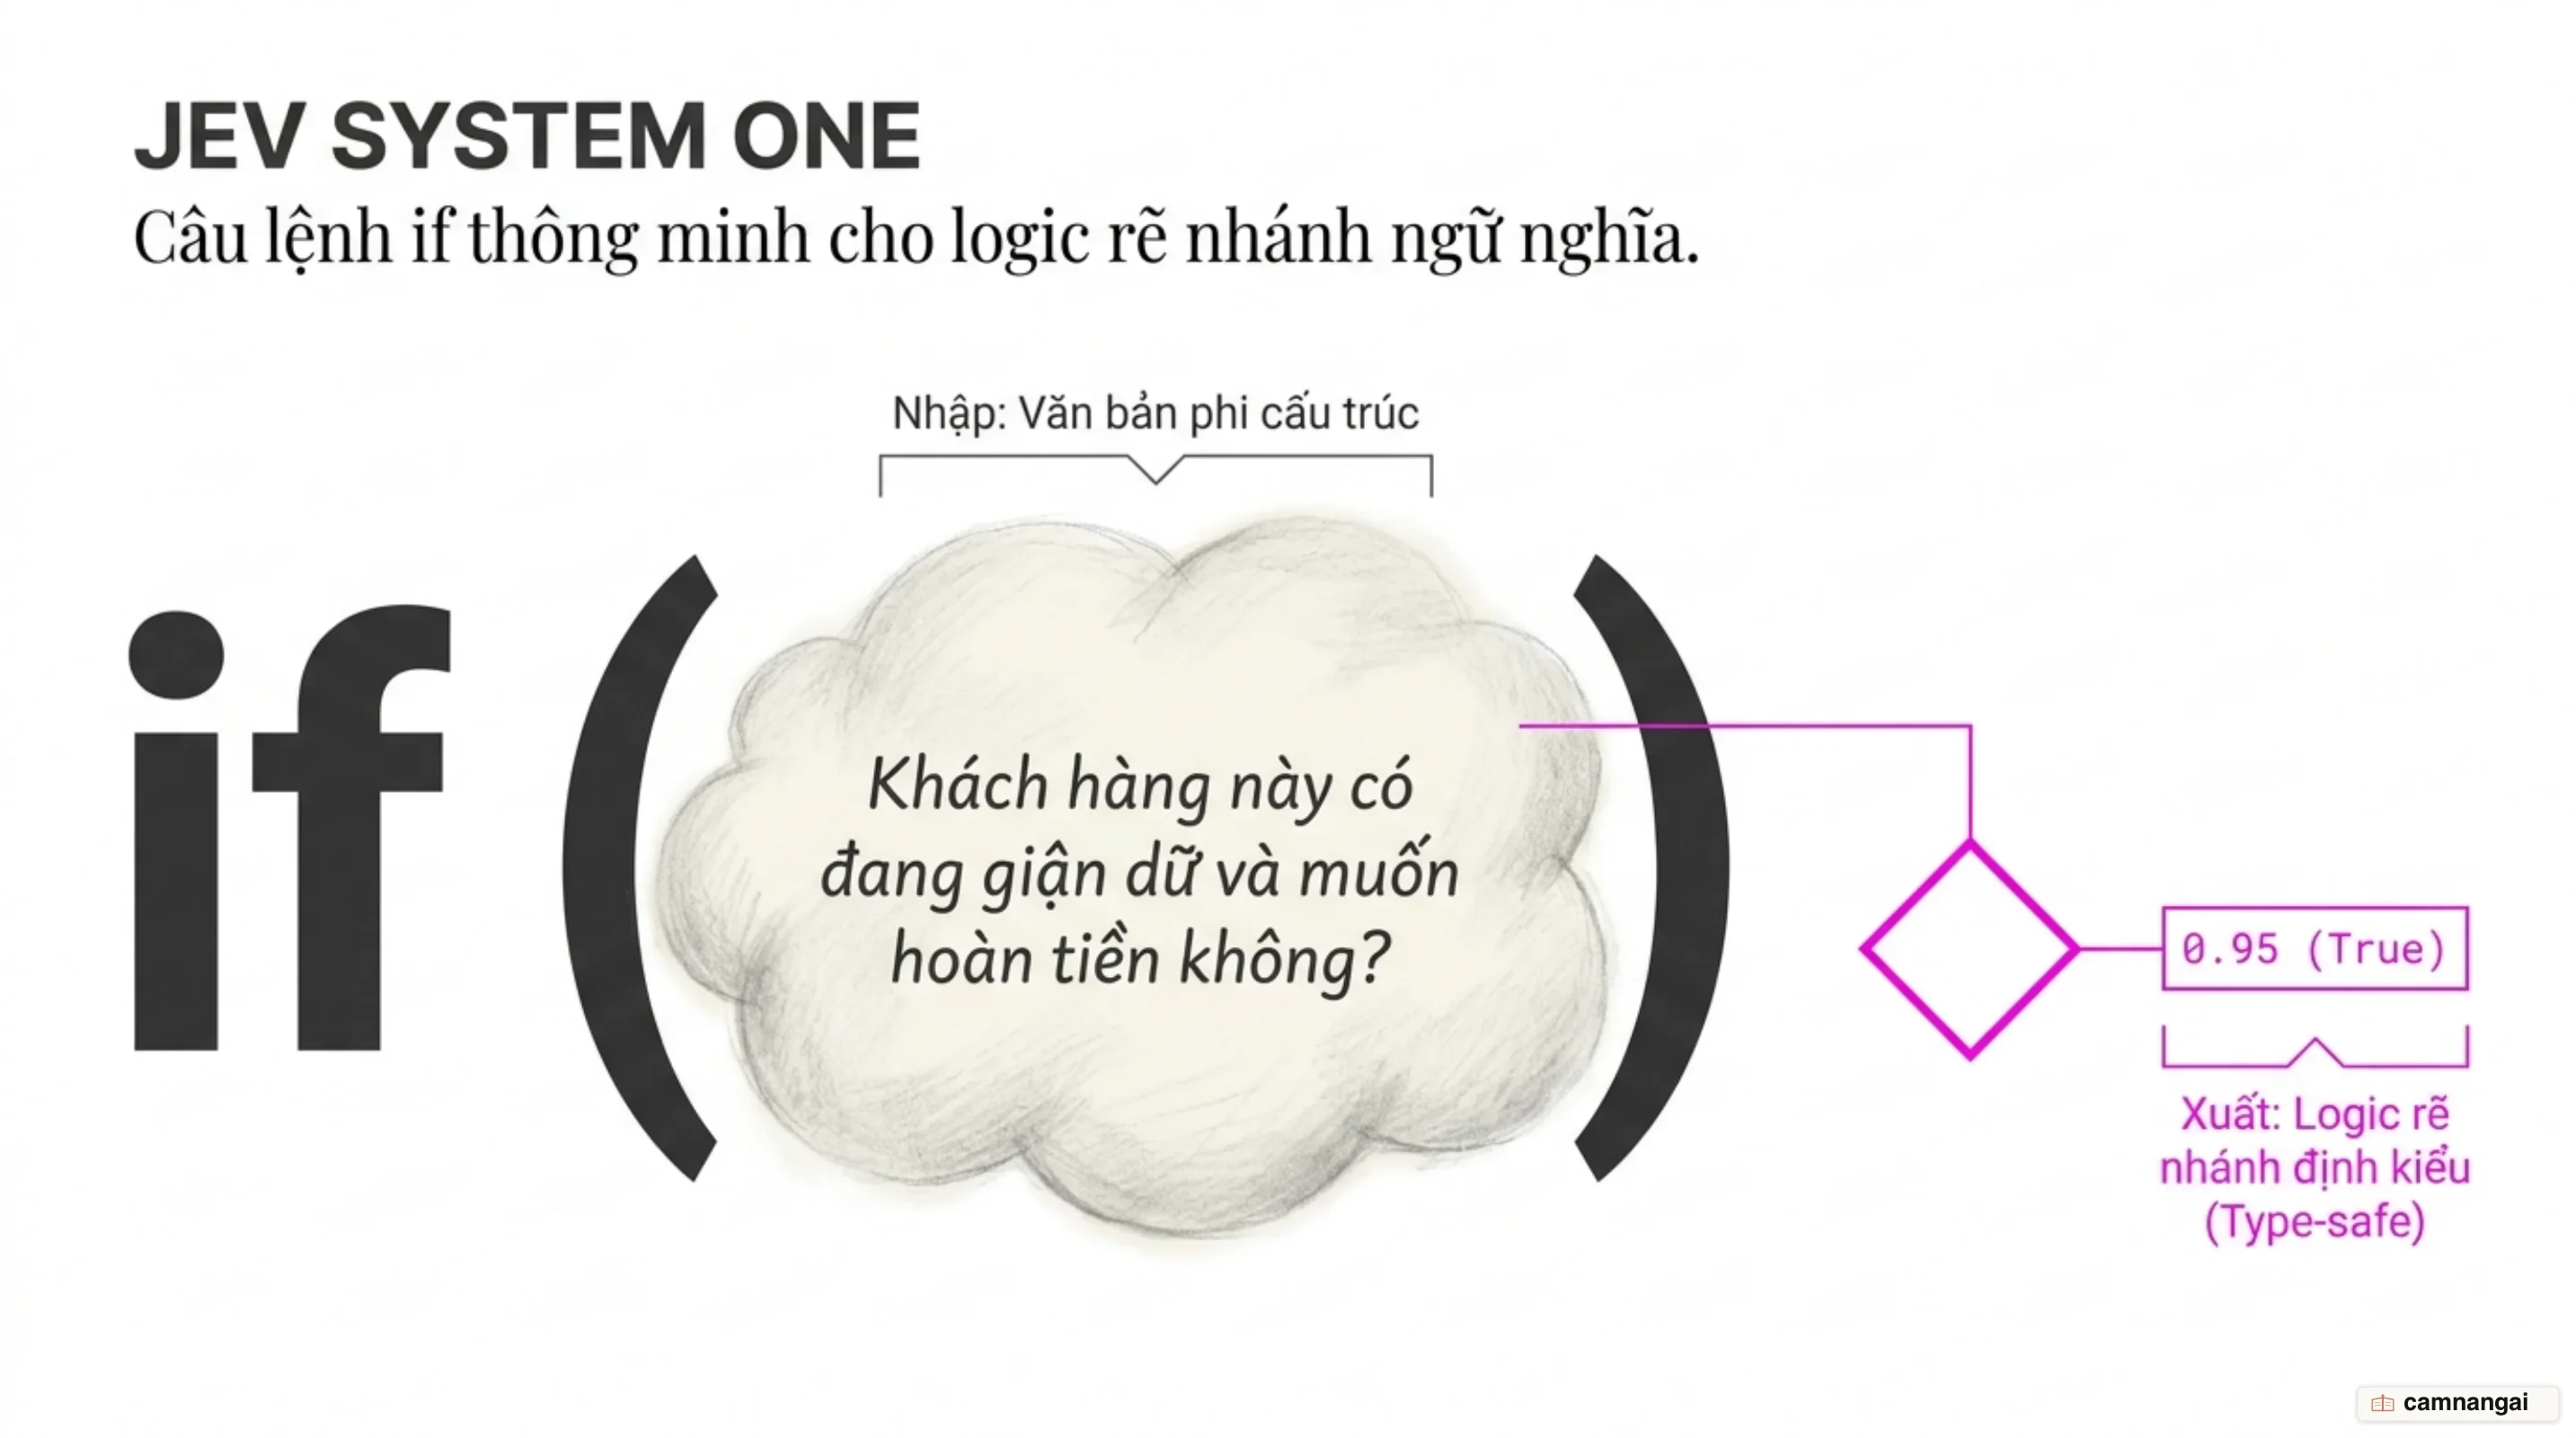
Trong kiến trúc phần mềm, Jev hoạt động như một câu lệnh if thông minh cho các phán đoán ngữ nghĩa. Mã nguồn truyền thống rẽ nhánh dựa trên giá trị tính toán xác định (if (user.balance > 100)), nhưng gặp bế tắc khi xử lý logic mờ, chẳng hạn như phân loại ý định người dùng hay kiểm tra độ an toàn của một lệnh shell. Jev lấp đầy khoảng trống này bằng cách cho phép lập trình viên định nghĩa trước các lựa chọn, nhận về phân phối xác suất và điều hướng luồng xử lý với độ trễ chỉ khoảng 100ms.
Hệ thống sử dụng bộ lấy mẫu song song có nhận thức phần cứng (hardware-aware parallel sampler) kết hợp phương pháp huấn luyện RLCD (Reinforcement Learning for Calibrated Decisions: học tăng cường cho các phán đoán hiệu chuẩn), giúp loại bỏ rủi ro sai định dạng dữ liệu và tối ưu chi phí ở quy mô hàng triệu lượt gọi mỗi ngày.
Vì sao Jev và mô hình System One ra đời
Kiến trúc của TypeSafe AI dựa trên lý thuyết của Daniel Kahneman về hai hệ thống tư duy: Hệ thống 1 (System 1) là tư duy nhanh, trực giác và Hệ thống 2 (System 2) là tư duy chậm, suy luận logic. Jev được xây dựng để đóng vai trò "Hệ thống 1" cho phần mềm, chuyên xử lý các phán đoán nhanh chóng mà không cần đến khả năng suy luận cồng kềnh, đắt đỏ của các mô hình Hệ thống 2 như GPT-4 hay Claude.
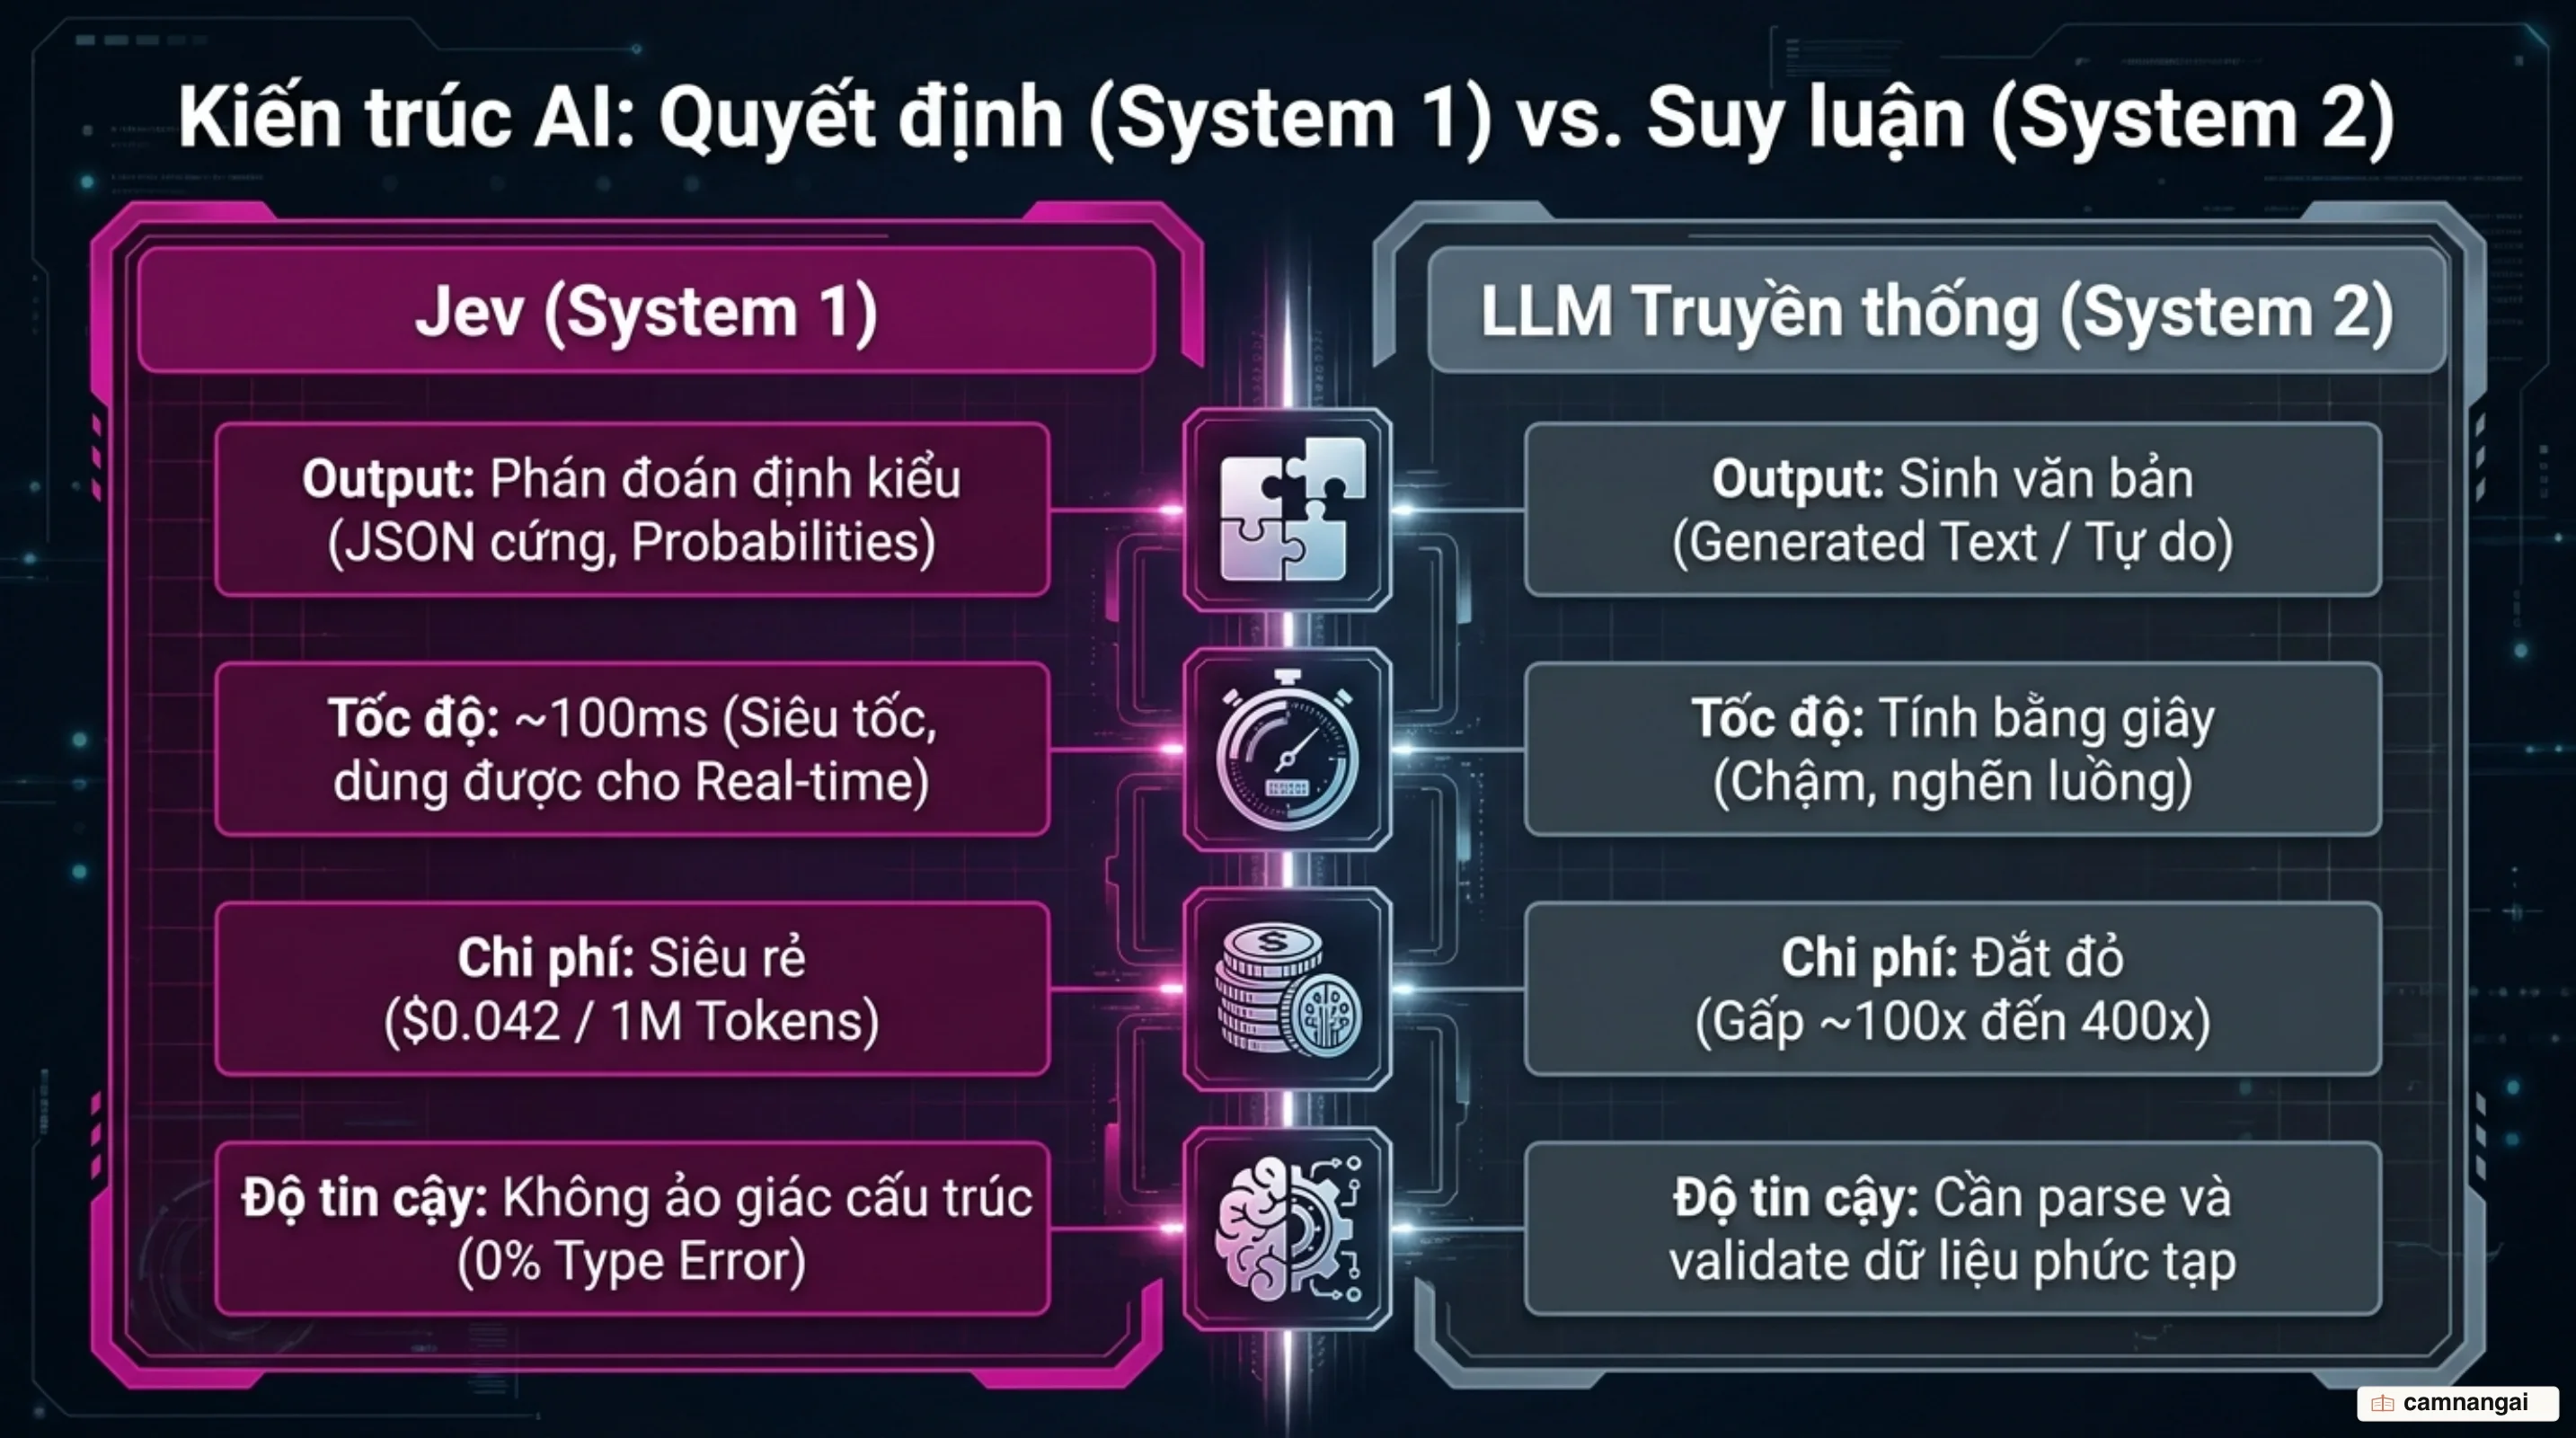
Mô hình ngôn ngữ lớn (LLM) truyền thống khi tích hợp vào logic phần mềm thường bộc lộ bốn hạn chế chí mạng: độ trễ tính bằng giây, chi phí vận hành cao, rủi ro ảo giác (hallucination) và kết quả đầu ra không có định kiểu (untyped strings). Jev giải quyết các bài toán này bằng cách tối ưu hóa cho các tác vụ phân loại, đánh giá và định tuyến với chi phí đầu vào cực thấp: $0,042/triệu token và miễn phí hoàn toàn đầu ra (output).
Tên gọi Jev bắt nguồn từ nghịch lý Jevons: khi hiệu suất sử dụng tài nguyên tăng và chi phí giảm, nhu cầu sẽ tăng vọt. TypeSafe AI tin rằng khi chi phí trí tuệ giảm sâu, phần mềm sẽ không dừng lại ở vài lượt gọi AI mỗi phiên, mà sẽ thực hiện hàng tỷ quyết định ngầm trong nền (background decisions) — những vị trí mà trước đây lập trình viên không bao giờ lãng phí một cuộc gọi LLM đắt đỏ.
Ba primitive cốt lõi: Choice, Score và Noul
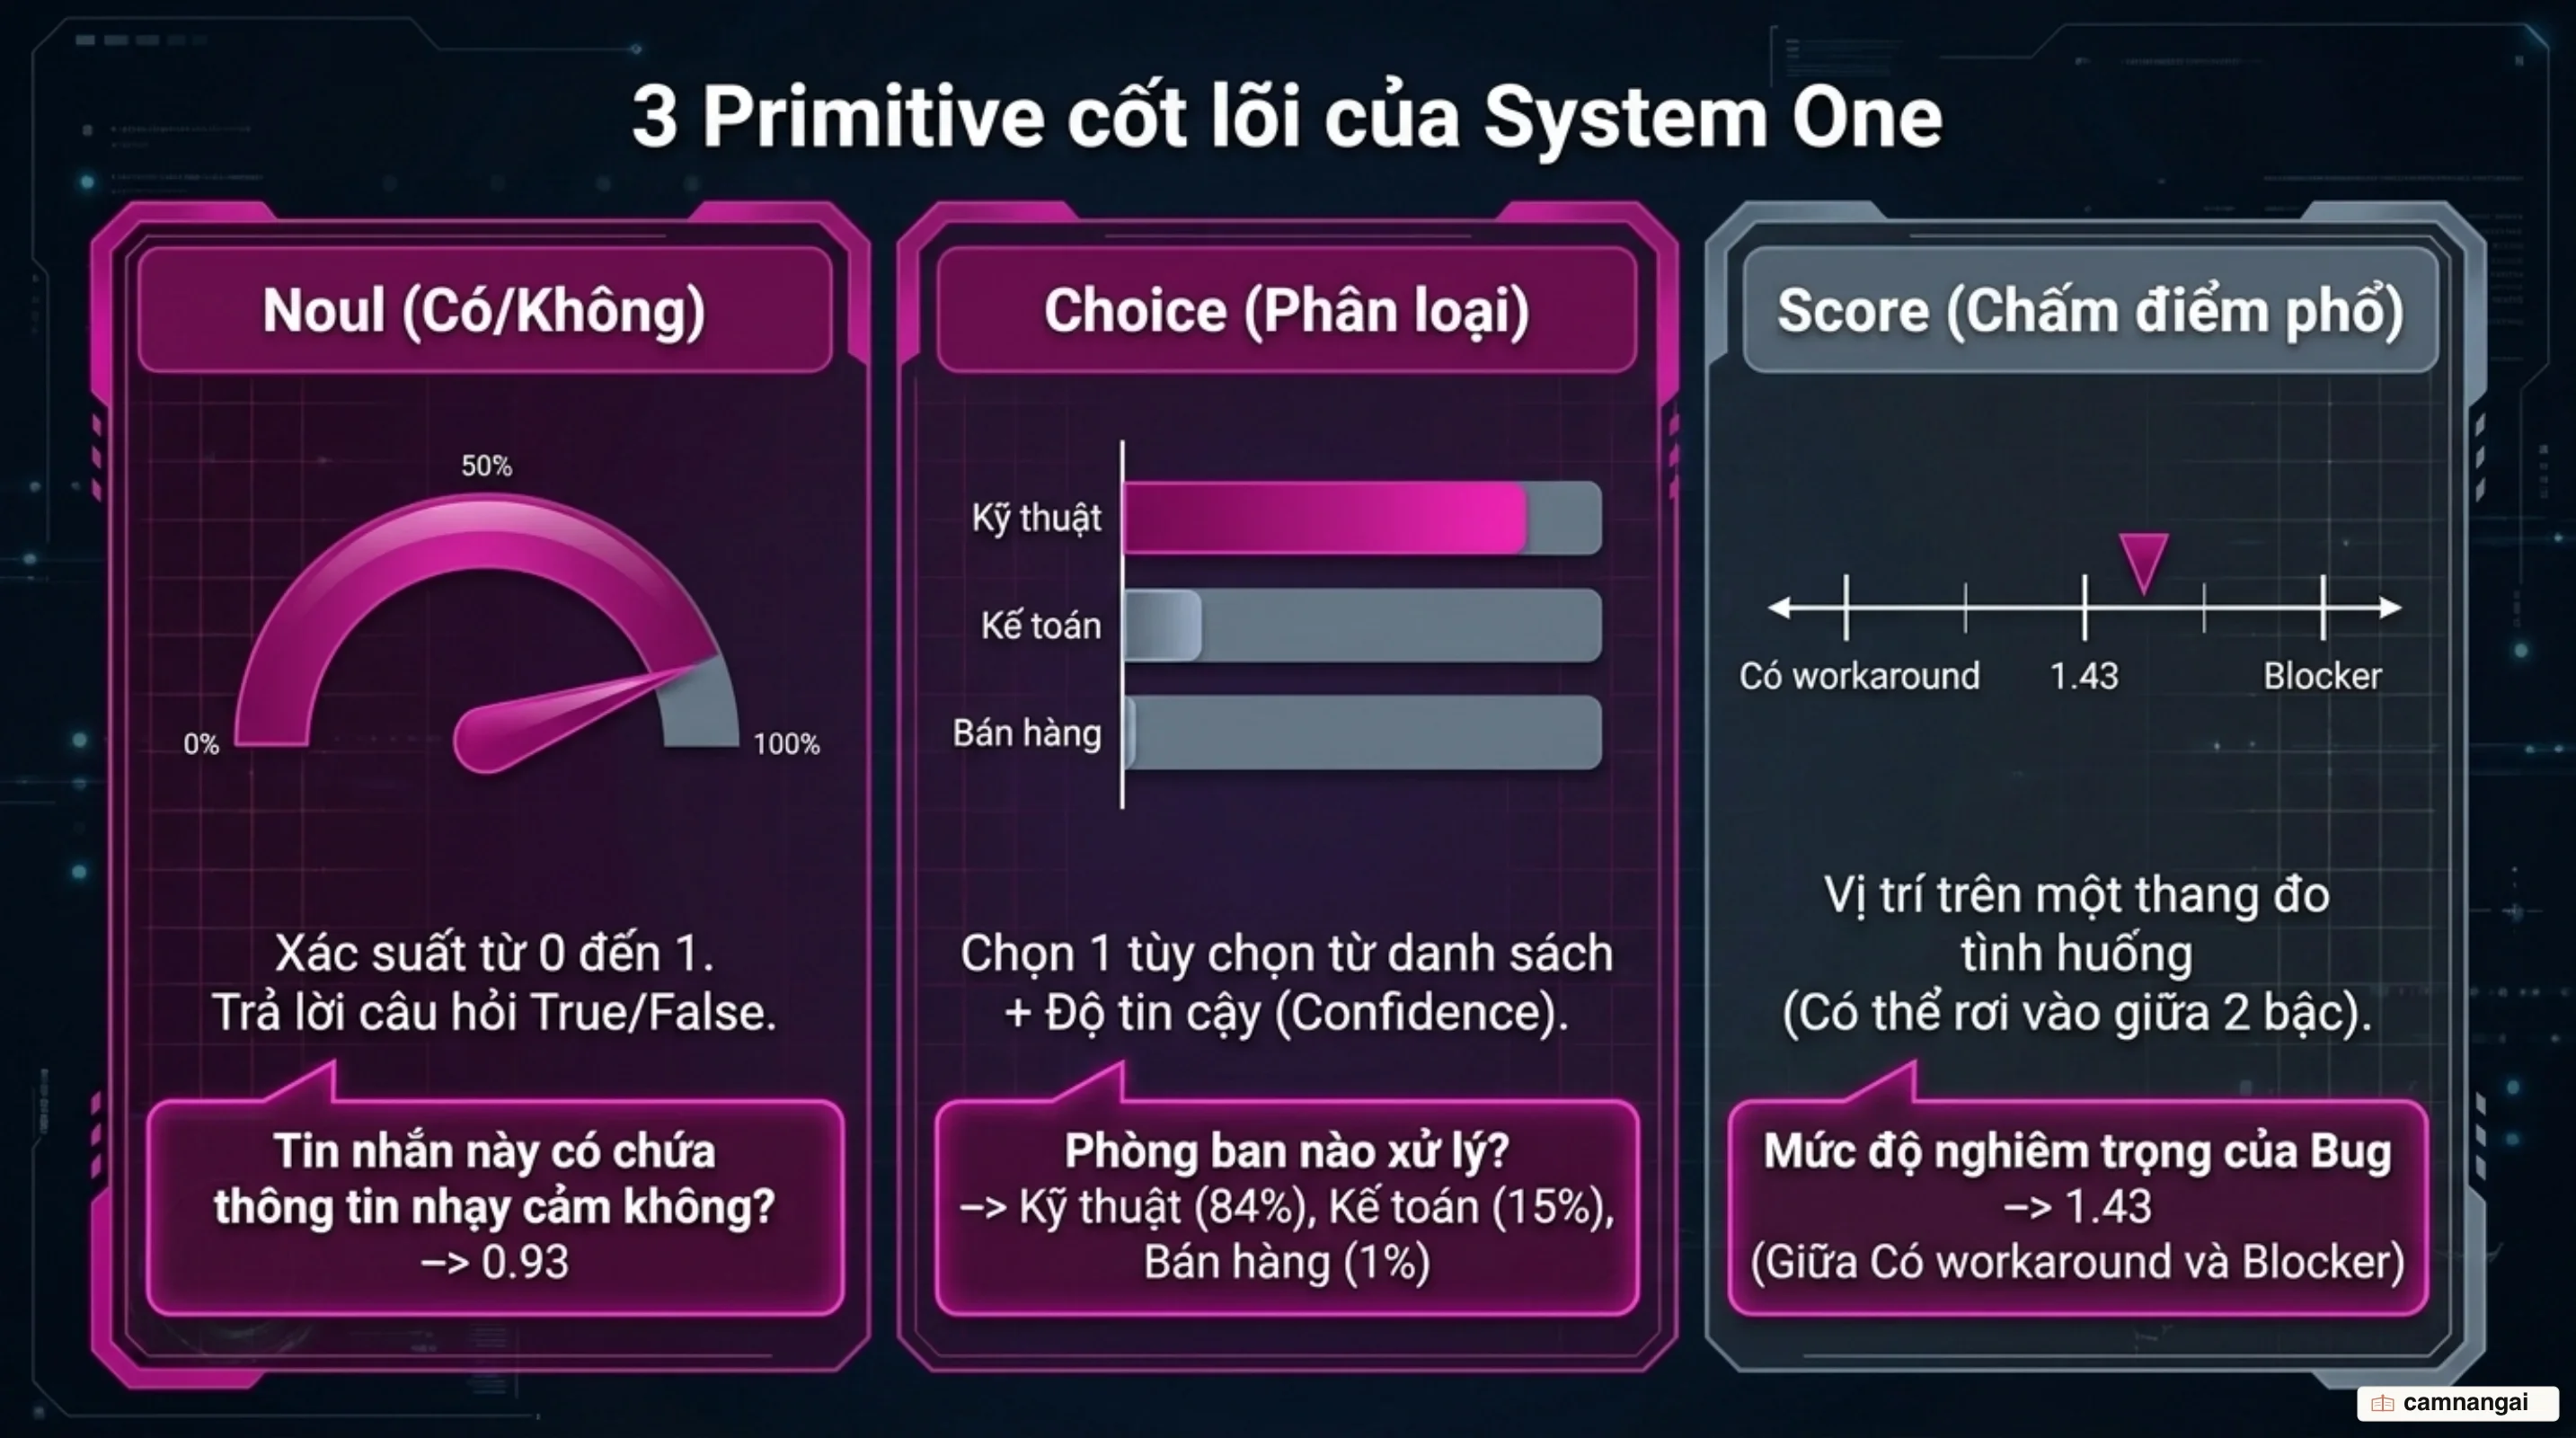
Jev hỗ trợ ba loại câu hỏi nguyên tử (primitives) với cấu trúc dữ liệu chặt chẽ:
- Noul (Phán đoán Có/Không): Trả về xác suất từ 0 đến 1. Giá trị 0.5 thể hiện sự không chắc chắn cao nhất, trong khi các giá trị tiệm cận 0 hoặc 1 thể hiện phán đoán dứt khoát. Noul không có trường
confidenceriêng vì chính xác suất là tín hiệu về độ bất định. - Choice (Lựa chọn): Chọn một phương án duy nhất từ danh sách cố định (hỗ trợ tối đa 255 tùy chọn). Đây là kiểu dữ liệu không có thứ tự, lý tưởng cho việc định tuyến tác vụ hoặc phân loại danh mục.
- Score (Đánh giá): Đánh giá trên một phổ giá trị từ 2 đến 10 mức độ. Kết quả trả về là một con số (ví dụ: 1.9) đại diện cho điểm trung bình có trọng số xác suất.
Quy tắc khi dùng Score: Phải mô tả tình huống cụ thể (situations), không mô tả mức độ (degrees). Thay vì dùng "Mức độ trung bình", hãy dùng "Tính năng bị hỏng, nhưng có phương án thay thế". Cách tiếp cận này giúp mô hình đối chiếu ngữ nghĩa chính xác thay vì ước lượng cảm tính.
Lưu ý kỹ thuật: ID câu hỏi chỉ dùng cho mã nguồn điều hướng, mô hình không đọc ID này. Mọi logic điều hướng phải nằm trong phần hướng dẫn (instructions) chi tiết.
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

questions = {
    "is_sponsor_inquiry": Noul(
        instructions="Nội dung có phải là yêu cầu tài trợ bản tin không?"
    ),
    "product_category": Choice(
        instructions="Sản phẩm thuộc danh mục nào?",
        criteria={
            "dev_tool": "Công cụ lập trình, hosting, API",
            "course": "Khóa học, sách hoặc đào tạo",
            "unrelated": "Nội dung không liên quan"
        }
    ),
    "message_quality": Score(
        instructions="Mức độ cụ thể của yêu cầu?",
        criteria=[
            "Email mẫu chung chung, không nhắc tên trang web",
            "Có nhắc tên trang web nhưng chưa có yêu cầu cụ thể",
            "Yêu cầu cụ thể kèm khung thời gian và sản phẩm rõ ràng"
        ]
    )
}
Kỹ thuật Speculative fan-out và xử lý song song
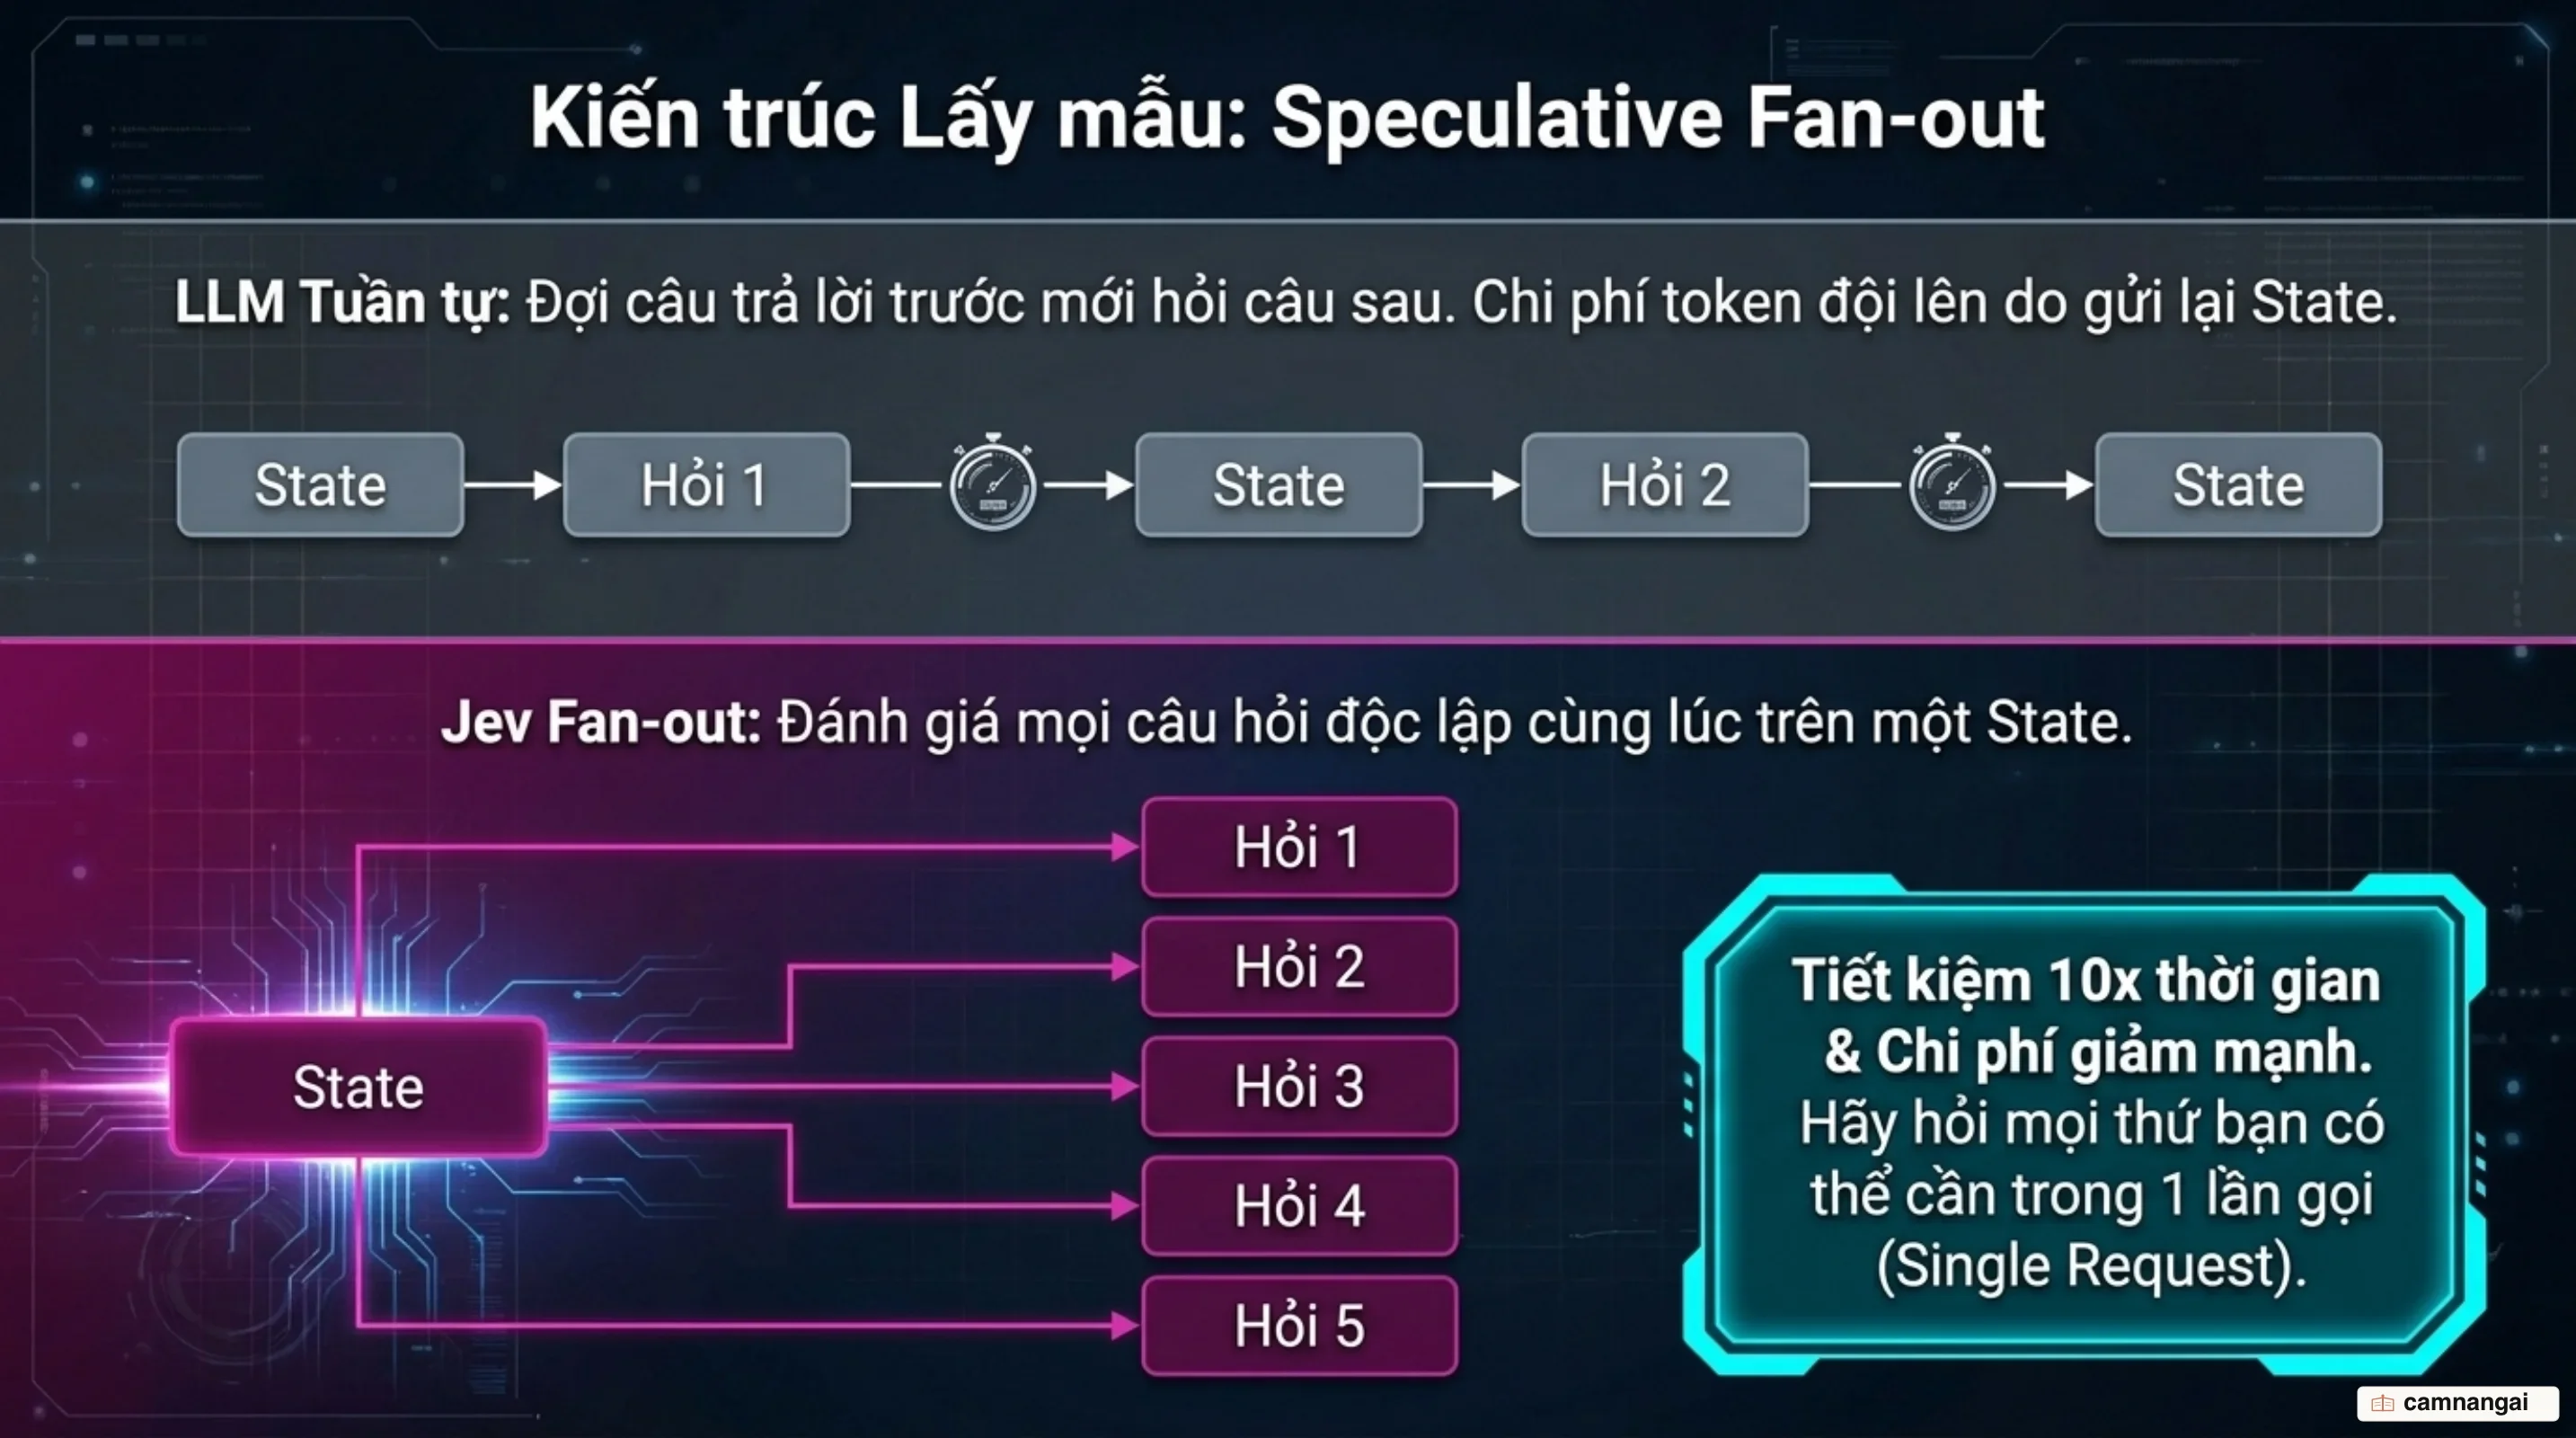
Khác với cơ chế sinh mã báo hiệu tuần tự (autoregressive) của mô hình ngôn ngữ lớn (LLM), Jev sử dụng một bộ lấy mẫu song song có nhận thức phần cứng (hardware-aware parallel sampler). Cơ chế này cho phép Jev đánh giá tất cả các câu hỏi độc lập trong cùng một lần thực thi duy nhất.
Kỹ thuật "Speculative fan-out" khuyến khích lập trình viên đưa mọi câu hỏi có khả năng cần thiết vào một yêu cầu. Việc gửi 13 câu hỏi song song rẻ hơn 12,2 lần và nhanh hơn 10 lần so với gọi tuần tự. Độ trễ trung bình của Jev chỉ khoảng 100ms (dao động 70–500ms), đủ nhanh để tích hợp trực tiếp vào các luồng xử lý thời gian thực hoặc giao diện người dùng.
Vì các câu hỏi được đánh giá độc lập, kết quả của câu hỏi này không làm sai lệch câu hỏi khác. Điều này ngăn chặn hiện tượng "nhiễm ngữ cảnh" (context contamination) thường thấy khi gom nhiều câu hỏi vào cùng một prompt trong LLM.
Chỉ số confidence và mô hình điều hướng 3 ngưỡng
Trong Jev, xác suất (probability) và độ tin cậy (confidence) là hai khái niệm riêng biệt. Xác suất cho biết khả năng một lựa chọn là đúng, trong khi độ tin cậy mô tả mức độ tập trung (peakiness) của phân phối xác suất đó. Jev được huấn luyện bằng phương pháp RLCD (Reinforcement Learning for Calibrated Decisions) để đạt được sự trung thực về mặt nhận thức (epistemic honesty): khi mô hình báo độ tin cậy 90%, nó phải chính xác trong khoảng 90% trường hợp thực tế.
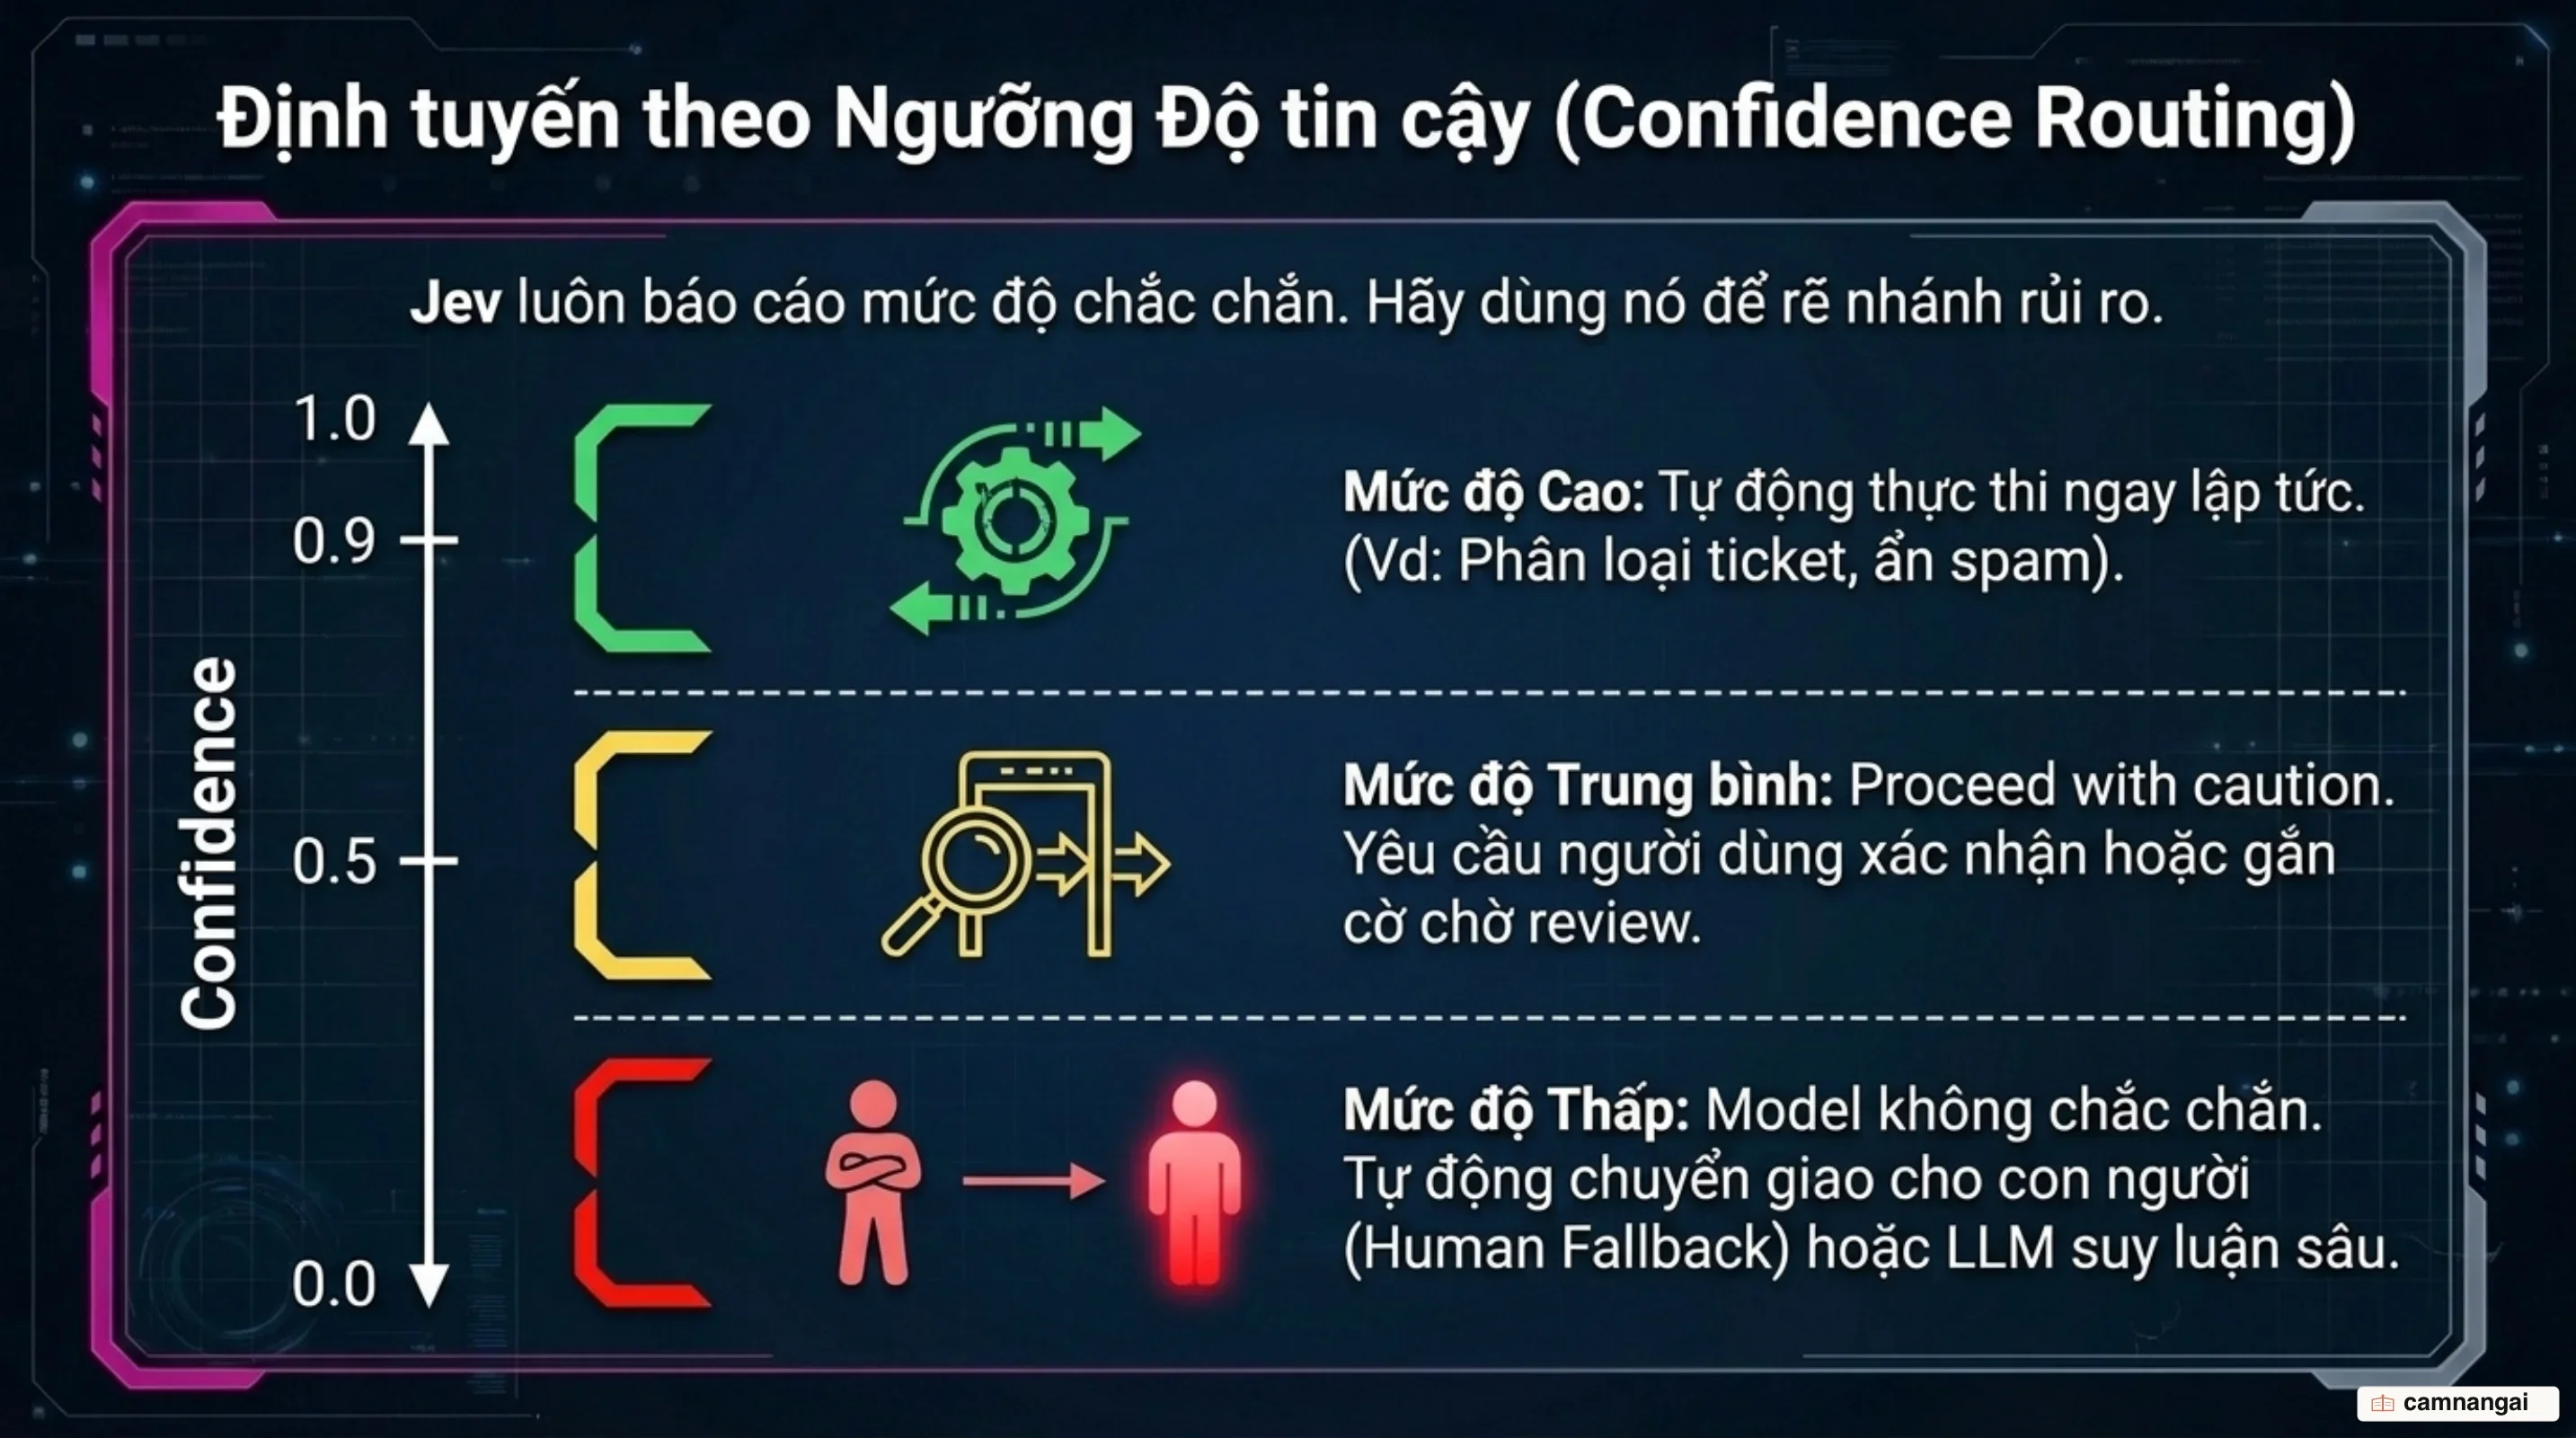
Kiến trúc Jev nhấn mạnh rằng rủi ro sai số phải được quản lý trong mã nguồn (code), không phải trong câu lệnh (prompt). Lập trình viên nên triển khai logic điều hướng 3 ngưỡng:
- Cao (> 0.9): Tự động thực thi hành động mà không cần con người can thiệp.
- Trung bình (0.5 - 0.9): Yêu cầu người dùng xác nhận hoặc gắn cờ kiểm duyệt.
- Thấp (< 0.5): Chuyển cho con người xử lý hoặc chuyển giao sang một mô hình Hệ thống 2.
action = response.answers["approve_transfer"]

# Ngưỡng rủi ro nằm trong code, không nằm trong prompt
if action.confidence < 0.5:
    route_to_human(user_message)
elif action.choice == "approve_transfer":
    if action.confidence > 0.9:
        confirm_then_execute(account_id)
    else:
        ask_user_to_confirm(account_id)
Câu lệnh if thông minh: Kiến trúc ứng dụng với Jev
Jev không thay thế quyền kiểm soát luồng (control flow) của mã nguồn. Nó đóng vai trò là các mắt xích phán đoán ngữ nghĩa trong một hệ thống do code điều khiển.
Các mẫu thiết kế chủ đạo bao gồm:
- Composite scoring: Kết hợp nhiều câu hỏi Score/Noul với trọng số (weight) để đưa ra điểm số tổng hợp. Ví dụ:
Priority = (0.6 * do_nghiem_trong) + (0.3 * su_gian_du) + (0.1 * chat_luong_bao_cao). Khi cần cân chỉnh hệ thống, bạn chỉ thay đổi hệ số trong code thay vì phải viết lại prompt. - Intent routing: Jev làm bộ định tuyến phía trước để quyết định luồng đi: nếu là câu hỏi tra cứu -> gọi cơ sở dữ liệu; nếu cần viết văn bản -> gọi LLM; nếu khiếu nại phức tạp -> chuyển nhân viên hỗ trợ.
- Shadow mode: Chạy Jev song song với logic cũ để ghi log phân phối xác suất và độ tin cậy, giúp tinh chỉnh ngưỡng an toàn trước khi kích hoạt luồng tự động hoá hoàn toàn.
Giới hạn và các góc cạnh khuyết của Jev
Phiên bản jev-1.13 có những "góc cạnh khuyết" (jaggedness) kỹ thuật cần lưu ý:
- Toán học và đếm: Jev không phải máy tính bỏ túi. Mô hình này không thể đếm số lượng mục trong một danh sách đủ tin cậy. Nếu cần đếm, hãy duyệt danh sách bằng code và đặt một câu hỏi Noul cho từng mục ("Mục này có phải trái cây không?"), sau đó tính tổng bằng code.
- Đọc hiểu sát nghĩa (Literal reading): Mô hình bám sát mặt chữ, không suy diễn ý định ngầm nếu hướng dẫn thiếu tường minh.
- Dữ liệu đặc thù: Jev khó phân biệt các mã màu Hex (ví dụ:
#FF4B0A), nhưng hiểu rất tốt các tên màu thông dụng (ví dụ: "vibrant orange"). Hãy chuyển đổi dữ liệu thô sang các nhóm ngữ nghĩa trước khi gọi mô hình. - So sánh thời gian: Các phép tính gián tiếp hoặc so sánh ngày tháng thường không chính xác. Hãy dùng Choice để trích xuất ngày/tháng/năm rồi dùng đối tượng Date trong code để so sánh.
- Context rot: Độ chính xác giảm khi trạng thái (state) chứa quá nhiều chi tiết không liên quan. Giữ state gọn gàng và nằm trong giới hạn 64.000 token của mô hình.
Khi nào nên dùng Jev thay vì LLM truyền thống
Việc lựa chọn giữa Jev và các mô hình sinh (như Claude hay GPT) phụ thuộc vào bản chất tác vụ là sáng tạo nội dung hay ra quyết định rẽ nhánh.
| Tiêu chí | Mô hình ngôn ngữ lớn (LLM) | Jev (System One) |
|---|---|---|
| Mục tiêu tối ưu | RLHF (Sự hài lòng của con người) | RLCD (Độ chính xác phán đoán) |
| Đầu ra (Output) | Chuỗi văn bản (String) | Giá trị định kiểu (Typed) |
| Tốc độ phản hồi | 3 - 300+ giây | 0.07 - 0.5 giây |
| Chi phí ($/1M input) | $0.20 - $10.00 | $0,042 |
| Độ an toàn kiểu | Rủi ro sai định dạng JSON | Đảm bảo 100% đúng schema |
Tác động kinh tế và vận hành
Xét một hệ thống chi trả $10.000 mỗi tháng cho các tác vụ tự động hóa dùng LLM. Tôi thấy không ít kỹ sư tốn phần lớn ngân sách này cho những lệnh gọi thực chất chỉ để phân loại và kiểm tra điều kiện (tác vụ System One). Khi chuyển hướng khoảng 60% tác vụ đó sang Jev, doanh nghiệp có thể cắt giảm hơn 50% tổng chi phí vận hành hàng tháng.
Báo cáo sản xuất thực tế từ các doanh nghiệp cho thấy tốc độ tìm kiếm ứng viên chuyển từ vài phút xuống vài giây (nhanh hơn 10 lần) với cùng độ chính xác khi thay thế logic LLM bằng Jev.
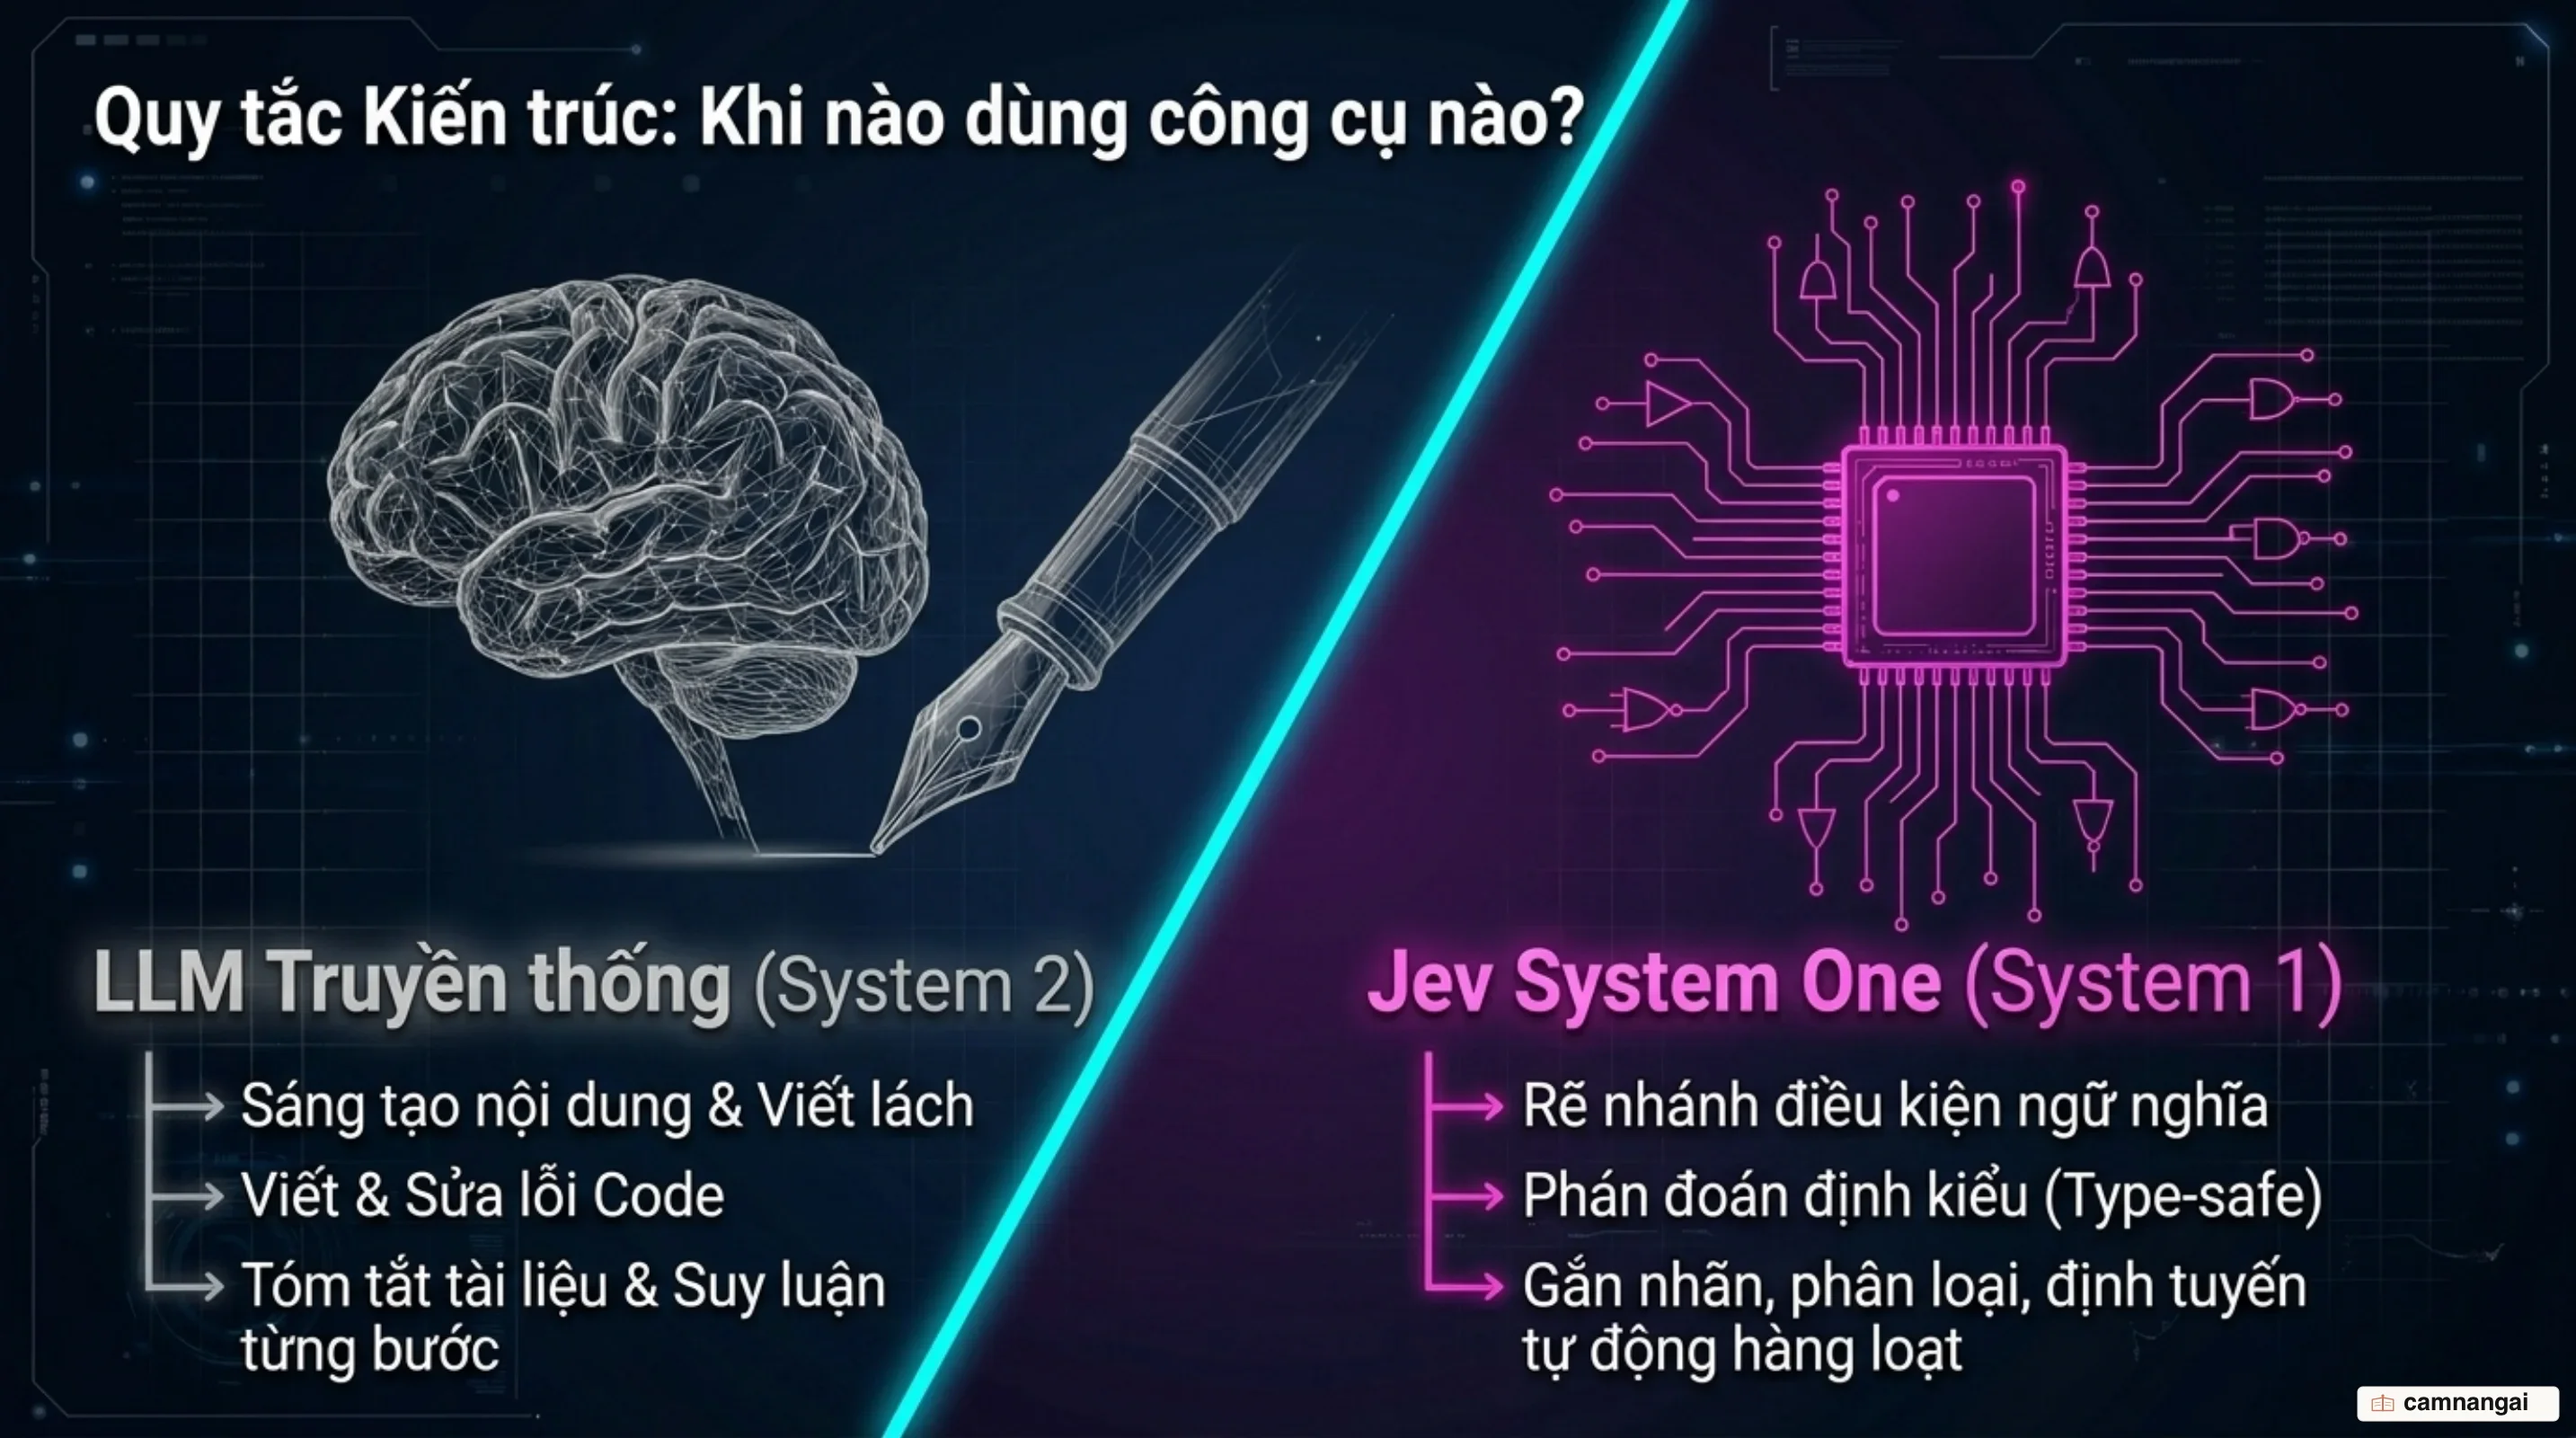
Nguyên tắc kiến trúc: Nếu hệ thống cần sinh văn bản, tóm tắt bài viết hoặc viết mã nguồn, hãy dùng LLM truyền thống. Nếu hệ thống chỉ cần "rút một lá bài từ bộ bài" (phân loại, chấm điểm, kiểm định hoặc rẽ nhánh điều kiện), hãy dùng Jev.