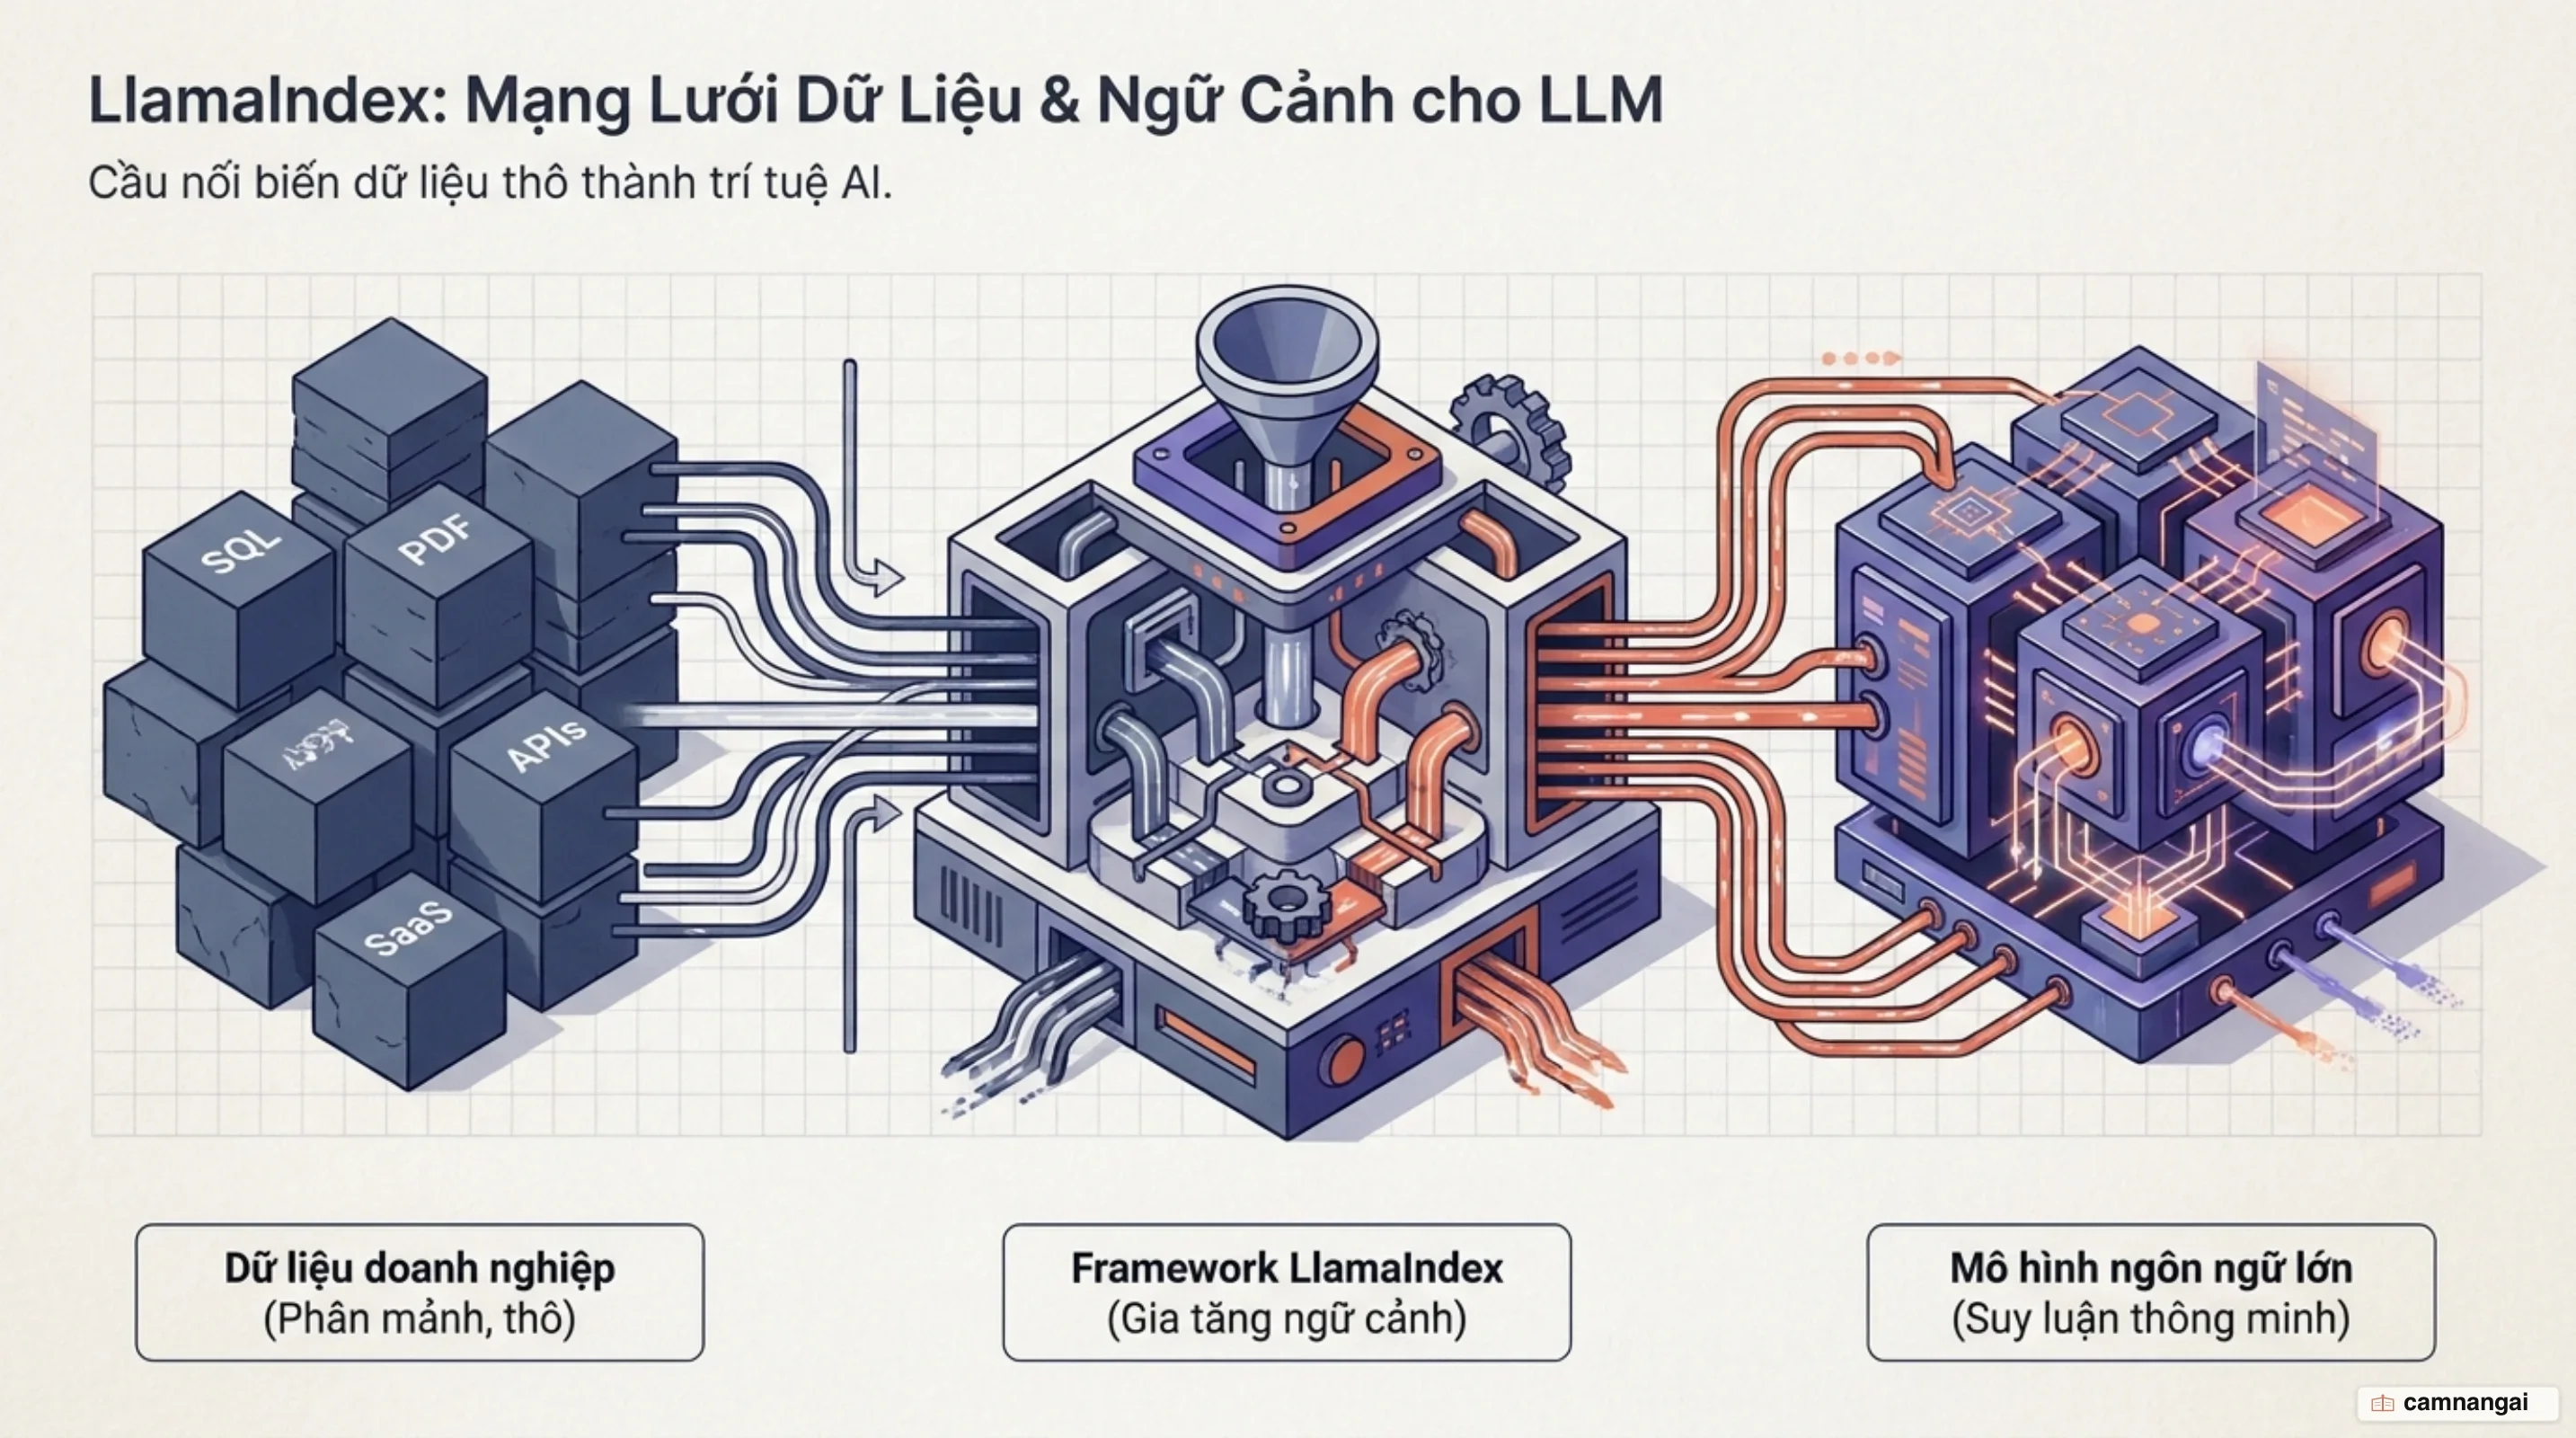
LlamaIndex là framework mã nguồn mở và nền tảng xử lý tài liệu (document processing platform) giúp kết nối các mô hình ngôn ngữ lớn (LLM) với dữ liệu riêng tư hoặc dữ liệu doanh nghiệp thông qua kỹ thuật gia tăng ngữ cảnh (Context Augmentation) và RAG (Retrieval-Augmented Generation).
Framework này cung cấp giải pháp toàn diện từ bóc tách tài liệu, trích xuất cấu trúc, đánh chỉ mục đến truy xuất ngữ cảnh cho mô hình ở thời điểm suy luận (inference time).
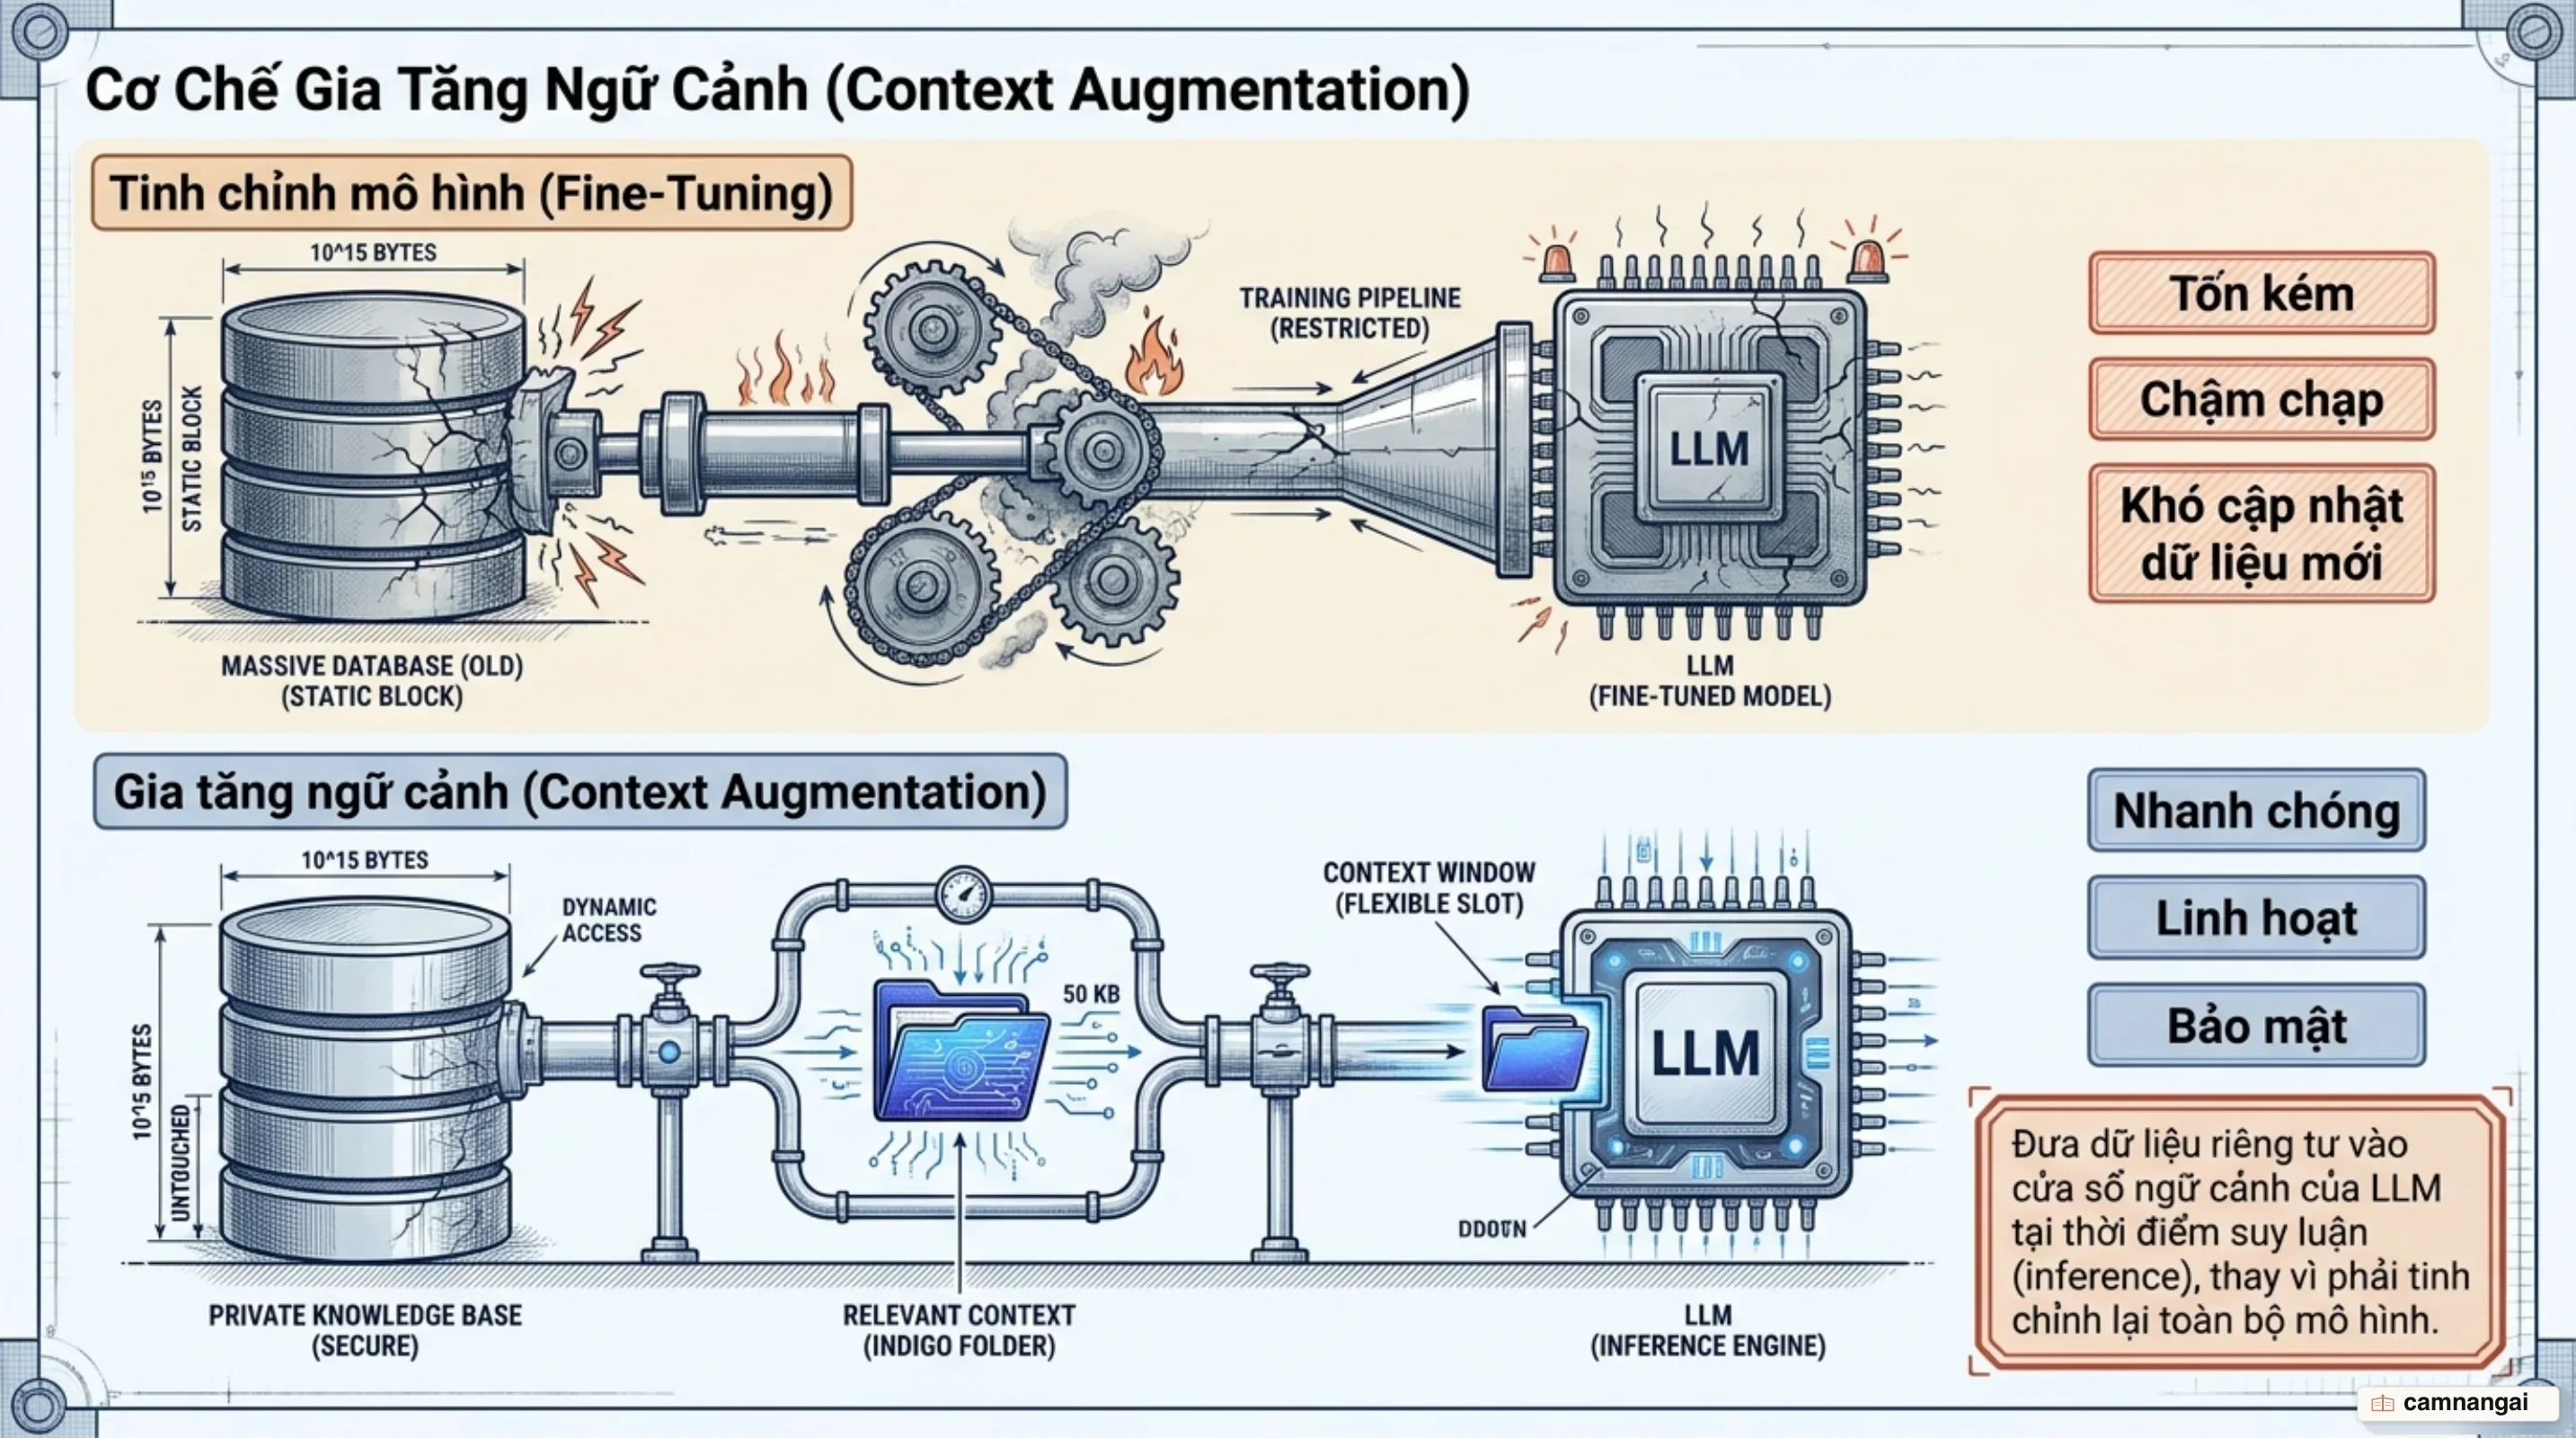
Khi triển khai các mô hình ngôn ngữ lớn vào thực tế, thách thức lớn nhất là trọng số mô hình chỉ đóng băng ở thời điểm tiền huấn luyện và không thể truy cập kho dữ liệu nội bộ. Thay vì tinh chỉnh lại toàn bộ mô hình, LlamaIndex hoạt động như một lớp hạ tầng dữ liệu, chọn lọc và cung cấp đúng ngữ cảnh cần thiết vào câu lệnh trước khi suy luận.
Hiện tại, mã nguồn mở LlamaIndex đạt hơn 52.700 stars trên GitHub, ghi nhận hơn 25 triệu lượt tải package mỗi tháng và hỗ trợ hơn 300 tích hợp dữ liệu trên LlamaHub. LlamaIndex đã phát triển từ một thư viện RAG đơn thuần thành nền tảng xử lý tài liệu, trích xuất cấu trúc và điều phối agentic workflows toàn diện.
LlamaIndex giải quyết bài toán gì khi xây dựng ứng dụng LLM?
Mặc dù các mô hình ngôn ngữ lớn (LLM) sở hữu khả năng suy luận và tổng hợp tri thức rất tốt, chúng bị giới hạn nghiêm trọng bởi dữ liệu huấn luyện tiền kỳ. Trọng số cố định của mô hình không thể phản ánh tài liệu nghiệp vụ nội bộ, hồ sơ khách hàng hay biến động dữ liệu theo thời gian thực. Việc huấn luyện lại (retraining) hay tinh chỉnh (fine-tuning) mô hình mỗi khi có dữ liệu mới tiêu tốn lượng chi phí tính toán khổng lồ và hoàn toàn bất khả thi trong vận hành hàng ngày. Ngoài ra, việc tinh chỉnh cũng không hỗ trợ phân quyền truy cập dữ liệu hay truy vết nguồn gốc câu trả lời.
LlamaIndex giải quyết triệt để rào cản này bằng cơ chế gia tăng ngữ cảnh (Context Augmentation). Framework cung cấp các đầu nối chuẩn hóa để nạp dữ liệu thô từ nhiều nguồn phân tán (từ tệp PDF, cơ sở dữ liệu SQL, REST API cho đến các kho tài liệu Markdown), sau đó chuyển đổi và chỉ chọn lọc những đoạn thông tin liên quan nhất để đưa vào ngữ cảnh suy luận mà không cần can thiệp vào trọng số mô hình.
Bằng cách chỉ truyền ngữ cảnh đã qua tinh lọc vào prompt, bạn vừa tối ưu chi phí token (token cost), vừa tránh vượt ngưỡng cửa sổ ngữ cảnh (context window), đồng thời giảm thiểu hiện tượng ảo giác (hallucination) nhờ neo câu trả lời vào dữ liệu thực tế.
Kiến trúc 5 giai đoạn: Từ dữ liệu thô đến câu trả lời hoàn chỉnh
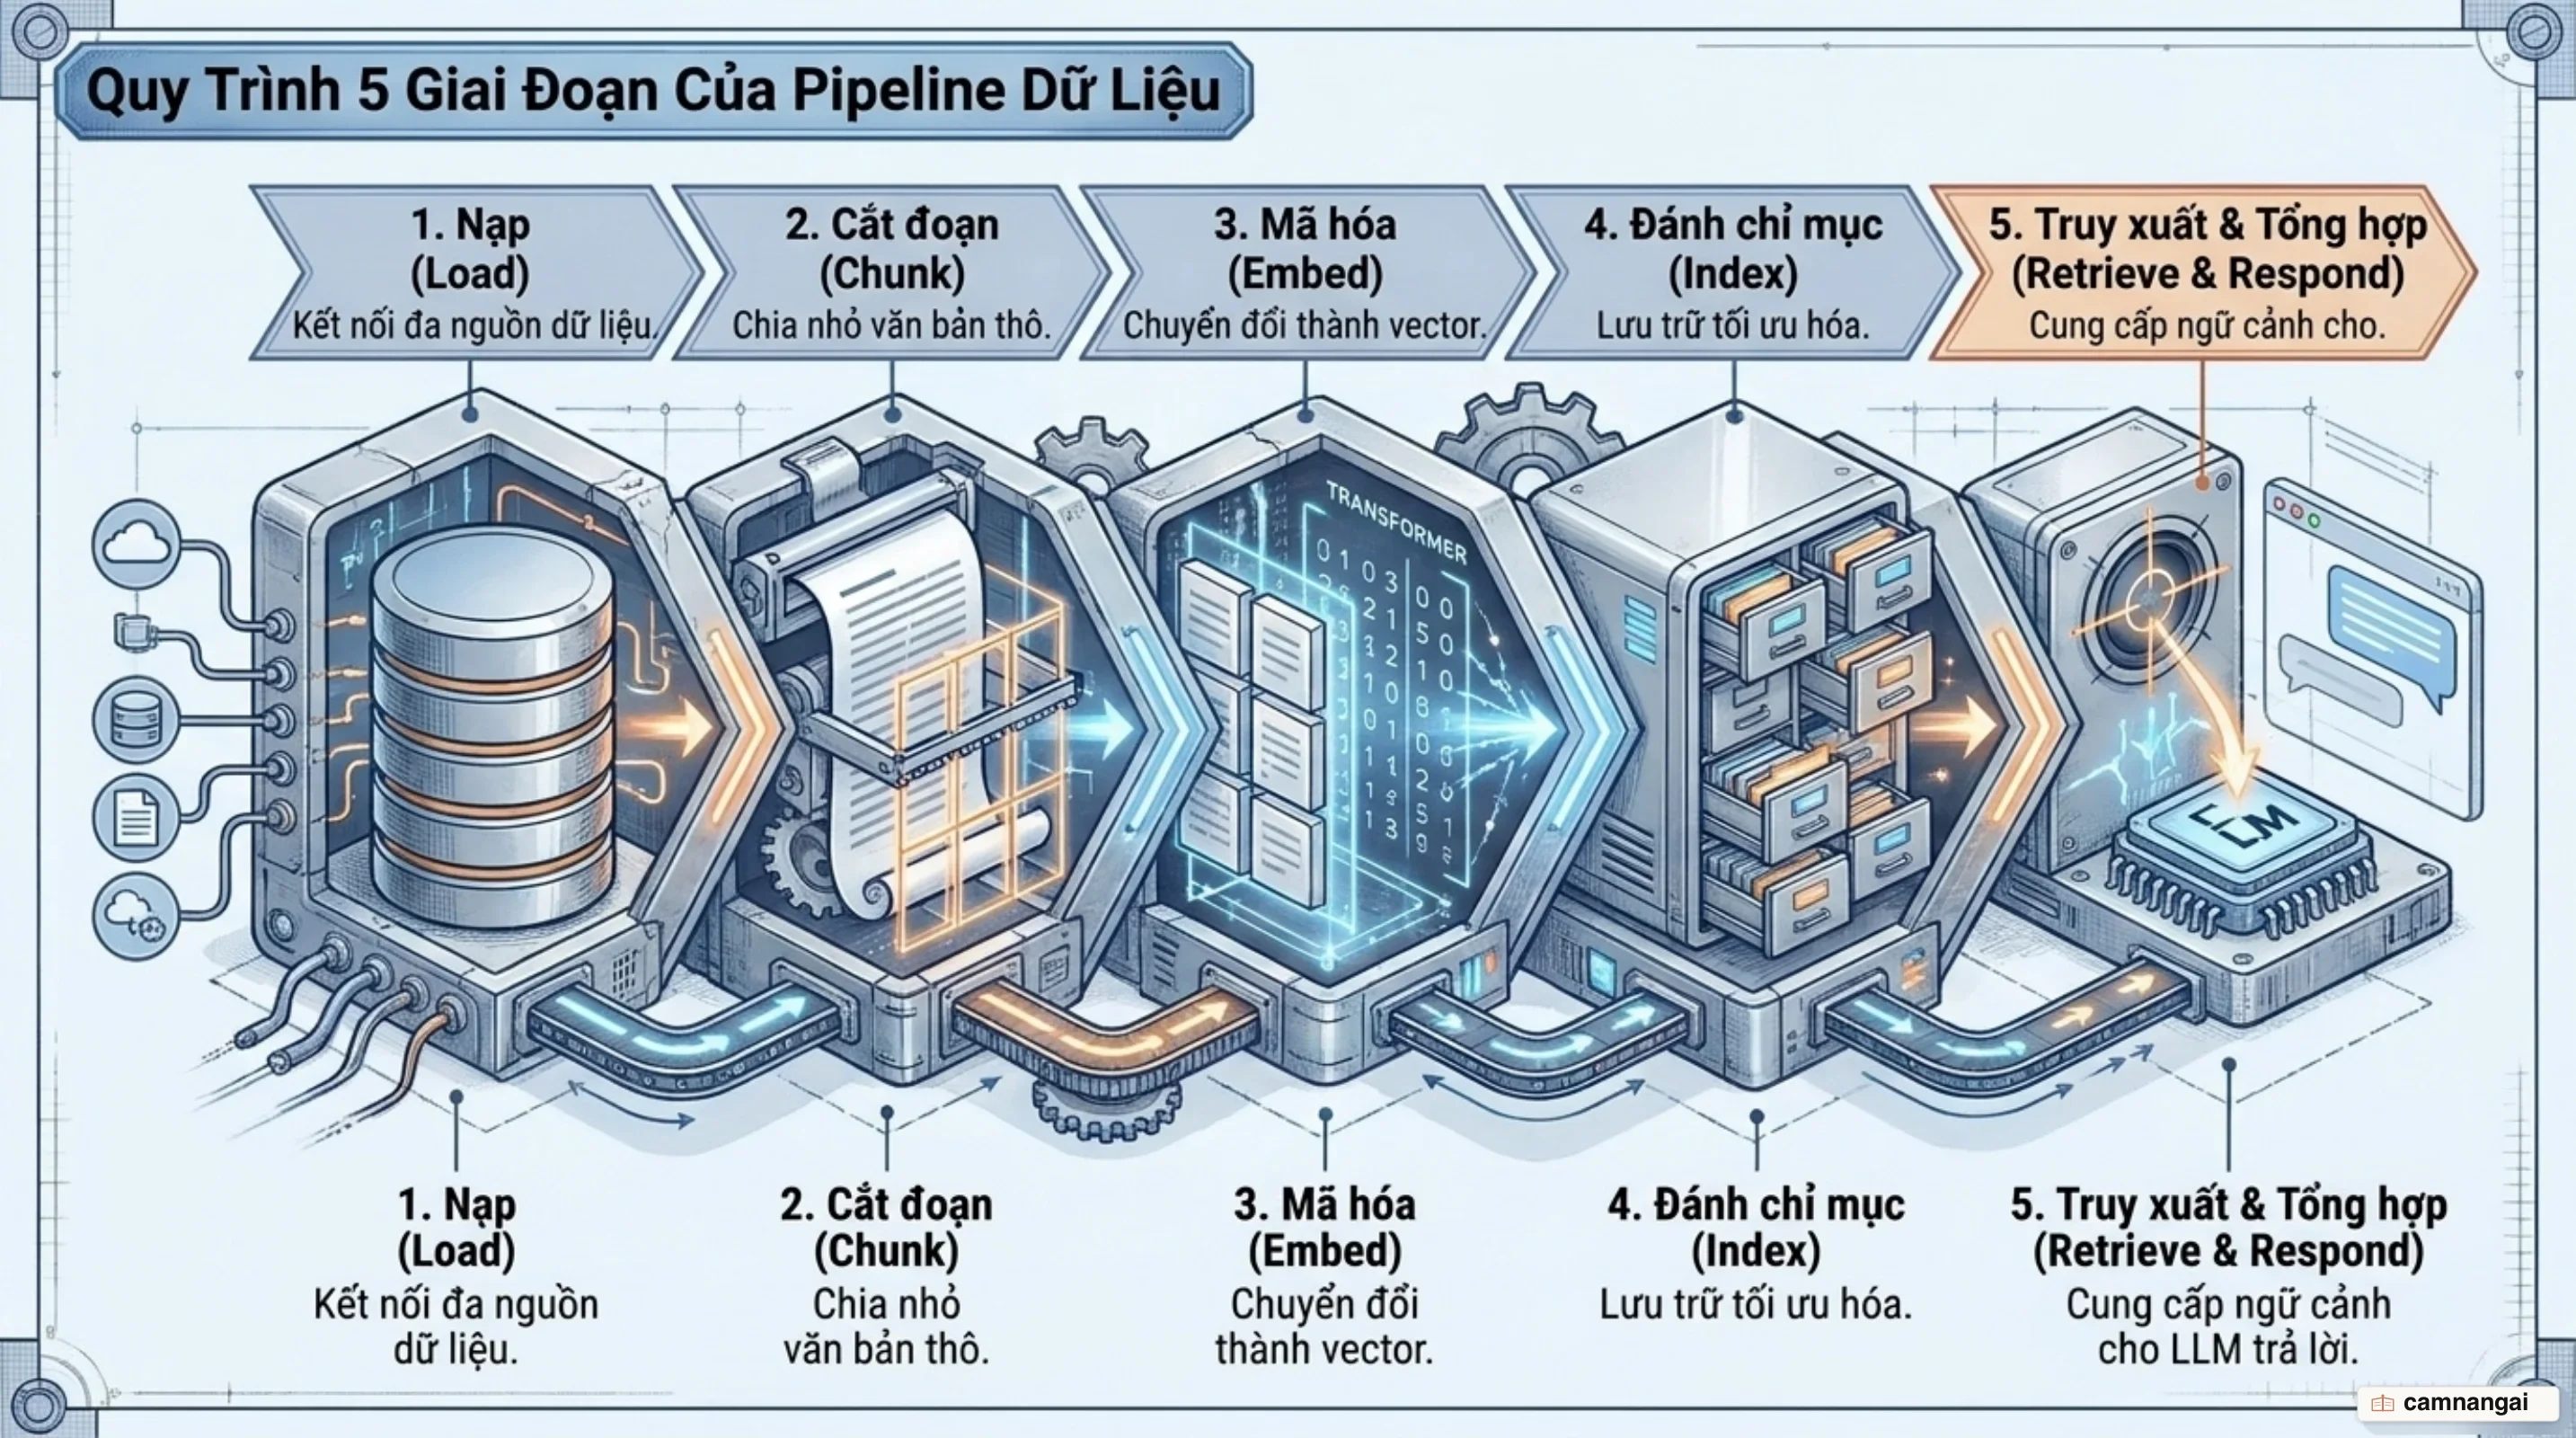
Vòng đời dữ liệu khi di chuyển qua pipeline của LlamaIndex được chia thành 5 giai đoạn tuần tự. Mỗi giai đoạn chịu trách nhiệm xử lý và biến đổi dữ liệu thông qua các thành phần chuyên biệt trong SDK:
1. Bóc tách và Nạp dữ liệu (Parse / Load)
Dữ liệu thô từ các định dạng khác nhau (PDF, Word, bảng tính, API, SQL) được nạp vào hệ thống thông qua các Data Connector và parser để chuyển đổi thành các đối tượng Document chuẩn hóa kèm metadata.
2. Cắt đoạn (Chunk)
Văn bản trong các đối tượng Document được chia nhỏ thành các đoạn ngắn gọi là Node. Quá trình này sử dụng các module như SentenceSplitter với các tham số cấu hình như chunk_size (kích thước đoạn) và chunk_overlap (độ chồng lấp ngữ cảnh) nhằm giữ ngữ nghĩa không bị ngắt quãng giữa các ranh giới cắt.
3. Mã hóa vector (Embed)
Mỗi Node được mô hình nhúng (embedding model) chuyển đổi thành một vector số biểu diễn ngữ nghĩa trong không gian nhiều chiều. Bạn có thể sử dụng các lớp nhúng đa dạng như OpenAIEmbedding, OllamaEmbedding cho mô hình cục bộ hoặc HuggingFaceEmbedding.
4. Đánh chỉ mục (Index)
Các Node cùng vector biểu diễn tương ứng được nạp vào các cấu trúc chỉ mục như VectorStoreIndex. Quản lý lưu trữ được đảm nhiệm bởi StorageContext, hỗ trợ lưu tạm trong bộ nhớ, kết nối đến vector database chuyên dụng hoặc lưu trữ bền vững ra đĩa thông qua persist_dir="./storage".
5. Truy xuất và Tổng hợp (Retrieve & Respond)
Khi nhận truy vấn từ người dùng, thành phần truy xuất thực hiện tìm kiếm ngữ nghĩa và lọc ra các Node có độ tương đồng cao nhất dựa trên tham số similarity_top_k. Tập hợp các đoạn ngữ cảnh này được đưa vào prompt để mô hình ngôn ngữ lớn tổng hợp thành câu trả lời hoàn chỉnh kèm trích dẫn nguồn.
Các thành phần nền tảng: Document, Node, Index và Retriever
Trong kiến trúc SDK của LlamaIndex, Document đóng vai trò là vùng chứa chung cho dữ liệu thô được nạp từ bất kỳ nguồn nào. Khi đi vào pipeline, Document được phân rã thành các Node, tức từng đoạn văn bản cụ thể đi kèm metadata quan trọng như tiêu đề tệp, số trang hay liên kết ngữ cảnh. Việc gắn kèm metadata cho phép hệ thống thực hiện lọc metadata (metadata filtering) trước hoặc sau khi tìm kiếm vector.
Index là cấu trúc dữ liệu cốt lõi giúp tổ chức các Node để phục vụ tìm kiếm hiệu quả. Phổ biến nhất là VectorStoreIndex phục vụ tìm kiếm ngữ nghĩa, bên cạnh SummaryIndex cho tóm tắt toàn văn và PropertyGraphIndex cho đồ thị tri thức. Khi thực thi truy vấn, thành phần Retriever tách biệt logic tìm kiếm khỏi việc sinh câu trả lời, trả về các Node phù hợp nhất cho QueryEngine hoặc ChatEngine tổng hợp.
Ví dụ dưới đây minh họa cách khởi tạo một VectorStoreIndex từ thư mục tài liệu và thực hiện truy vấn bằng query_engine:
from llama_index.core import SimpleDirectoryReader, VectorStoreIndex

# Nạp tài liệu từ thư mục và khởi tạo VectorStoreIndex
documents = SimpleDirectoryReader("data").load_data()
index = VectorStoreIndex.from_documents(documents)

# Tạo query engine và thực thi truy vấn
query_engine = index.as_query_engine()
response = query_engine.query("LlamaIndex có vai trò chính là gì?")
print(response)
LlamaParse: Bóc tách tài liệu phi cấu trúc và bảng biểu phức tạp
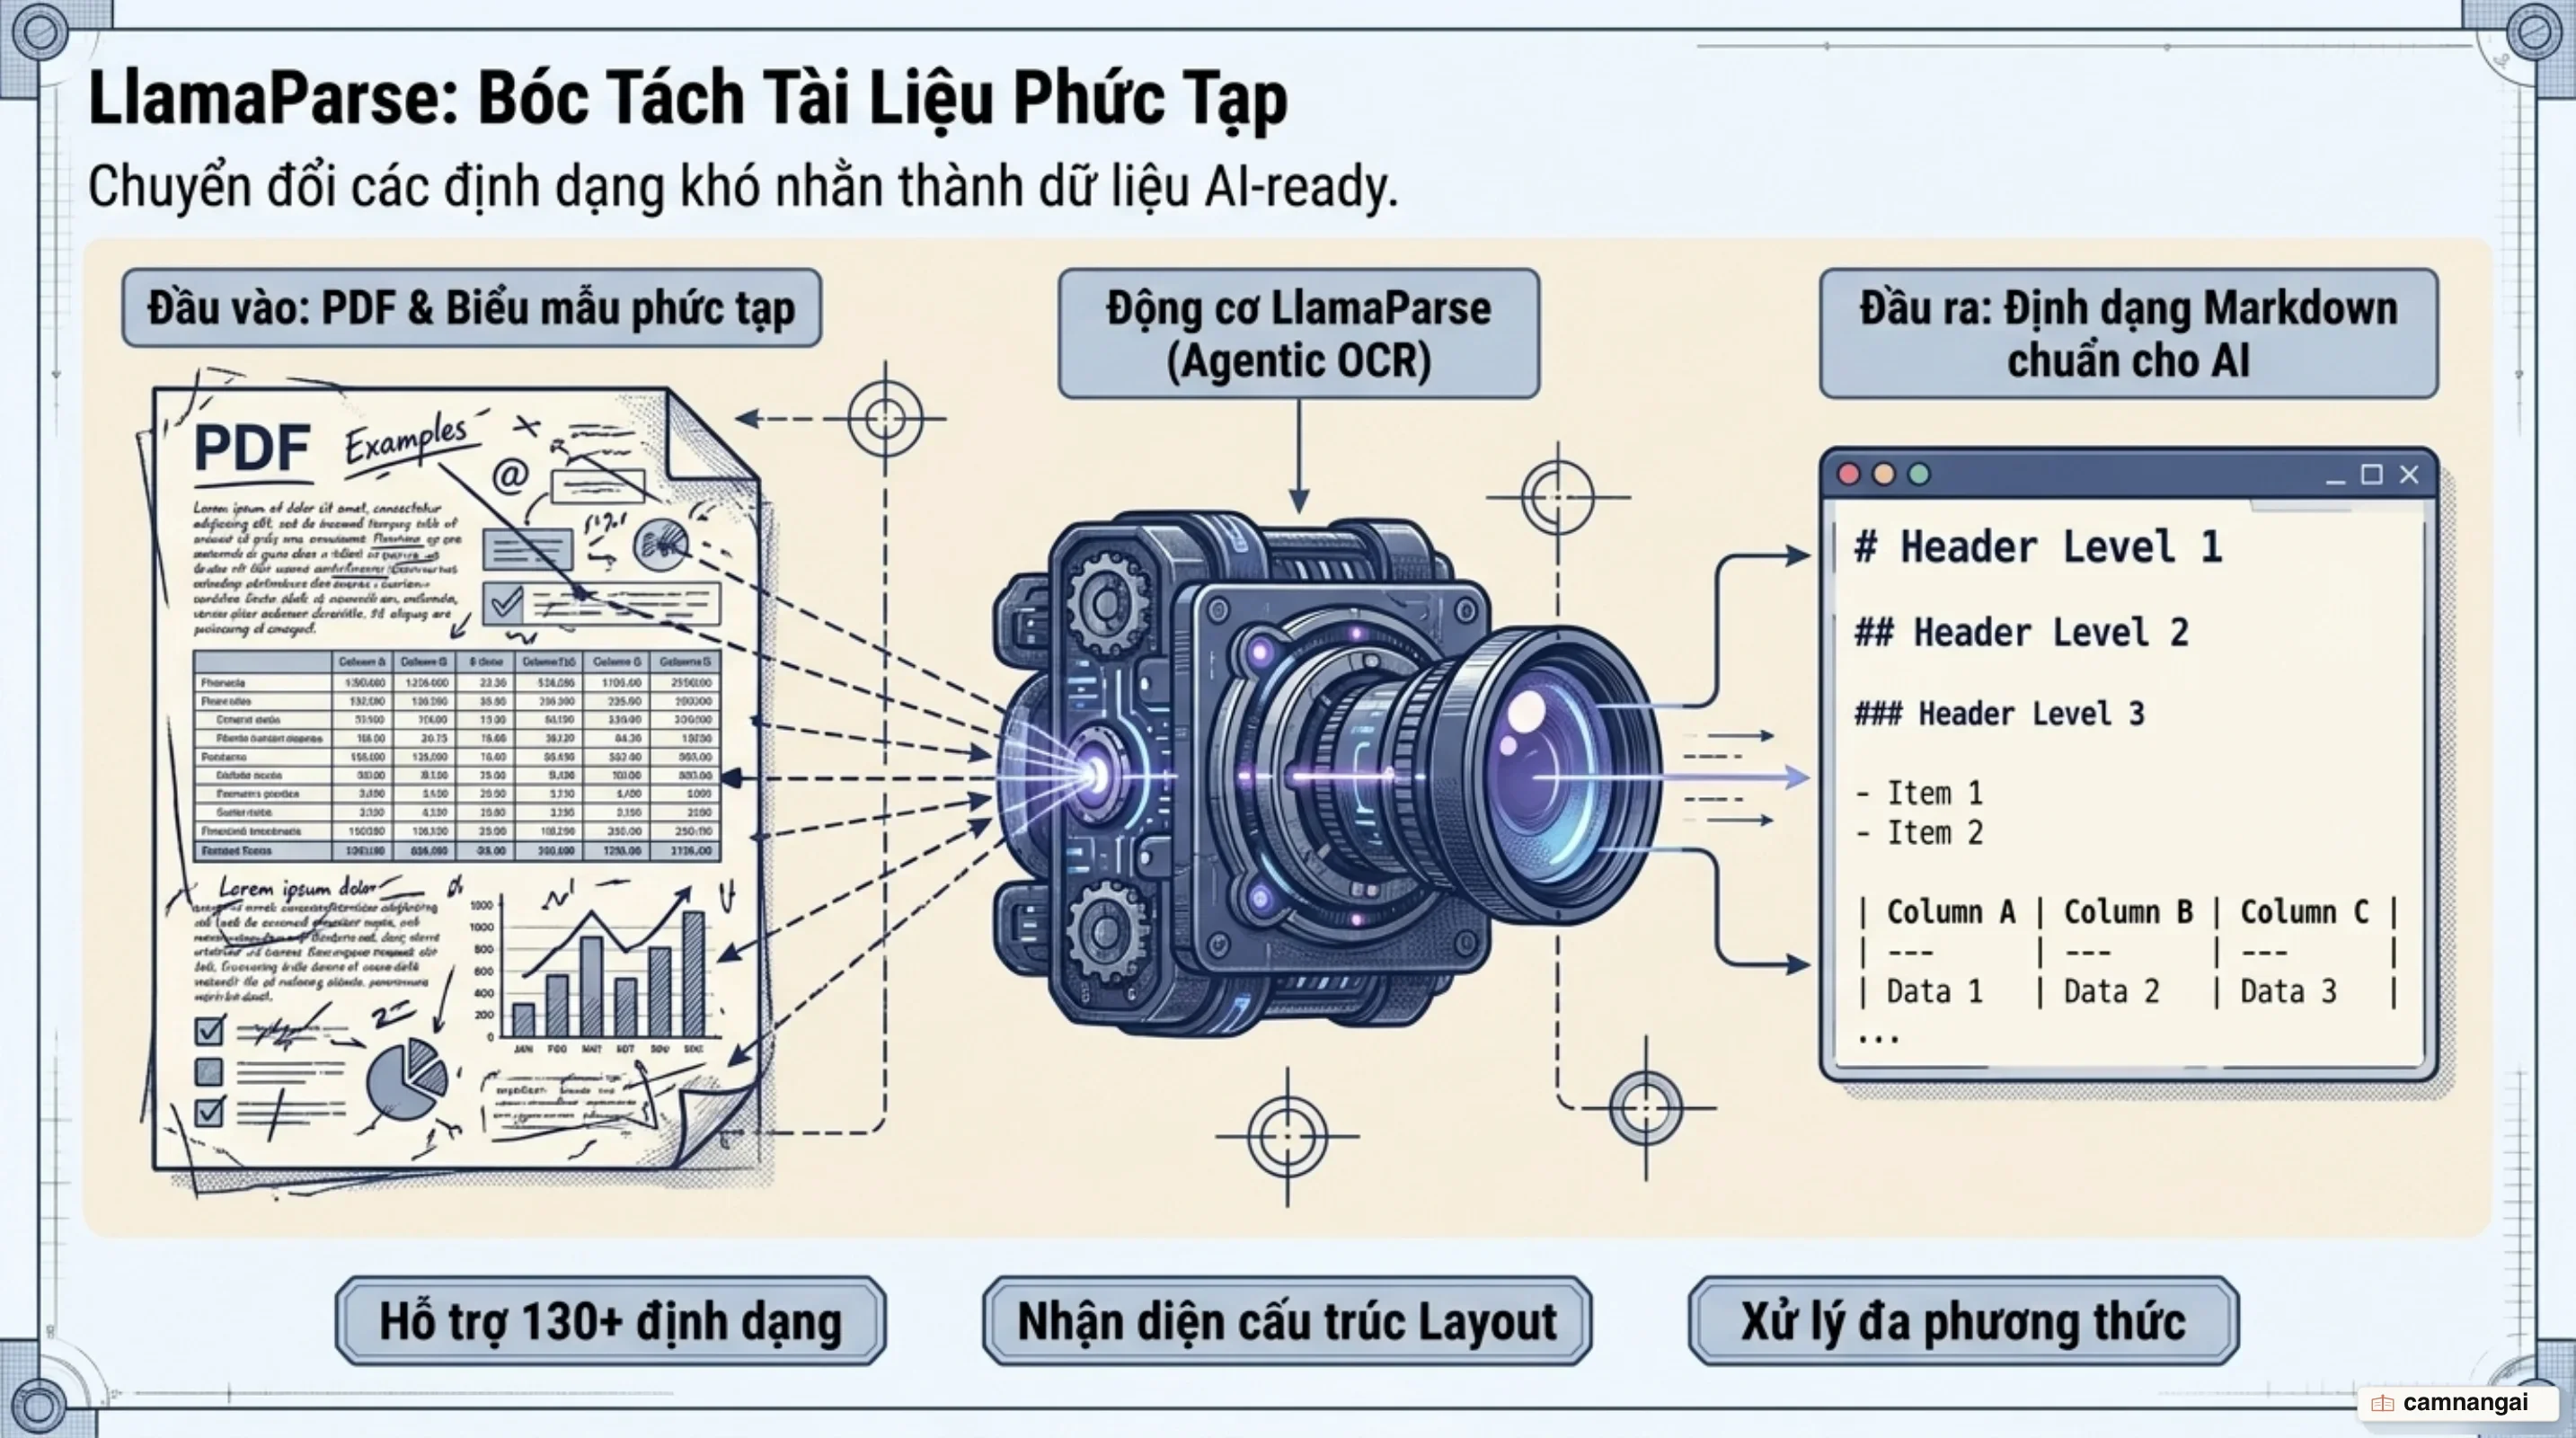
Bóc tách tài liệu (document parsing) là khâu quyết định trực tiếp đến chất lượng của toàn bộ hệ thống RAG. LlamaIndex giải quyết bài toán này thông qua hai công cụ bổ trợ lẫn nhau: LlamaParse và LiteParse.
LlamaParse là dịch vụ đám mây doanh nghiệp tích hợp Agentic OCR, chuyên xử lý các tài liệu phức tạp trên hơn 130 định dạng tệp. Công cụ này nhận diện chính xác các cấu trúc khó như bảng biểu nhiều trang, sơ đồ, biểu mẫu, chữ viết tay và tệp PDF quét để chuyển đổi sang định dạng Markdown chuẩn. Với hơn 1 tỷ trang tài liệu được xử lý cho hơn 300.000 người dùng, LlamaParse bảo toàn toàn vẹn bố cục không gian và cấu trúc dữ liệu bảng cho các mô hình AI hạ nguồn.
Ở phía thực thi cục bộ, LiteParse là thư viện mã nguồn mở viết bằng Rust (giấy phép Apache 2.0), cho phép bóc tách tài liệu tốc độ cao ngay trên máy chủ mà không cần gọi API đám mây. LiteParse hỗ trợ bóc tách văn bản dựa trên tọa độ không gian (PDFium bounding box), tích hợp sẵn Tesseract OCR và hỗ trợ chụp ảnh trang tài liệu cho các mô hình đa phương thức (Multimodal LLM).
Đặc biệt, LiteParse tích hợp cơ chế phát hiện độ phức tạp (complexity detection) để tạo luồng định tuyến thông minh: các tệp đơn giản sẽ được xử lý cục bộ miễn phí với tốc độ tối đa; chỉ những tệp vượt ngưỡng phức tạp (PDF quét mờ, bảng biểu quá dày) mới được tự động chuyển tiếp lên LlamaParse Cloud API. Ngoài ra, LiteParse hỗ trợ cơ chế Worker Pool Mode với tiến trình độc lập và timeout riêng biệt, ngăn chặn hoàn toàn nguy cơ tệp PDF hỏng làm treo hệ thống production.
LlamaIndex Workflows: Chuyển dịch sang kiến trúc hướng sự kiện cho AI agent
Để khắc phục sự gò bó của mô hình đồ thị có hướng không chu trình (DAGs), vốn gặp khó khăn khi triển khai các vòng lặp phản hồi (reflection) hoặc nhánh điều kiện động, LlamaIndex đã giới thiệu module Workflows. Được xây dựng trên nền tảng async Python, Workflows chuyển dịch hoàn toàn sang kiến trúc hướng sự kiện (event-driven), mang lại khả năng điều phối linh hoạt cho các AI agent.
Cơ chế của Workflows xoay quanh hai khái niệm: bước xử lý (step) và sự kiện (event). Mỗi step là một hàm bất đồng bộ được gắn decorator @step, đóng vai trò lắng nghe và phát ra sự kiện có định kiểu rõ ràng (Pydantic types). Framework cung cấp StartEvent để tiếp nhận tham số đầu vào và StopEvent để kết thúc quy trình và trả về kết quả. Nhờ cơ chế kiểm tra kiểu dữ liệu tự động, Workflows tự định tuyến sự kiện đến đúng step xử lý mà không cần định nghĩa cứng các cạnh nối.
Ở cấp độ kiến trúc hệ thống, Workflows hỗ trợ quản lý trạng thái chia sẻ an toàn qua đối tượng Context, cho phép các step giao tiếp bất đồng bộ qua ctx.send_event() hoặc gom các sự kiện song song với ctx.collect_events(). Ngoài ra, tính năng workflow.validate() cho phép kiểm tra tĩnh toàn bộ đồ thị trước khi chạy, phát hiện sớm các bước bị cô lập hoặc thiếu sự kiện kết thúc.
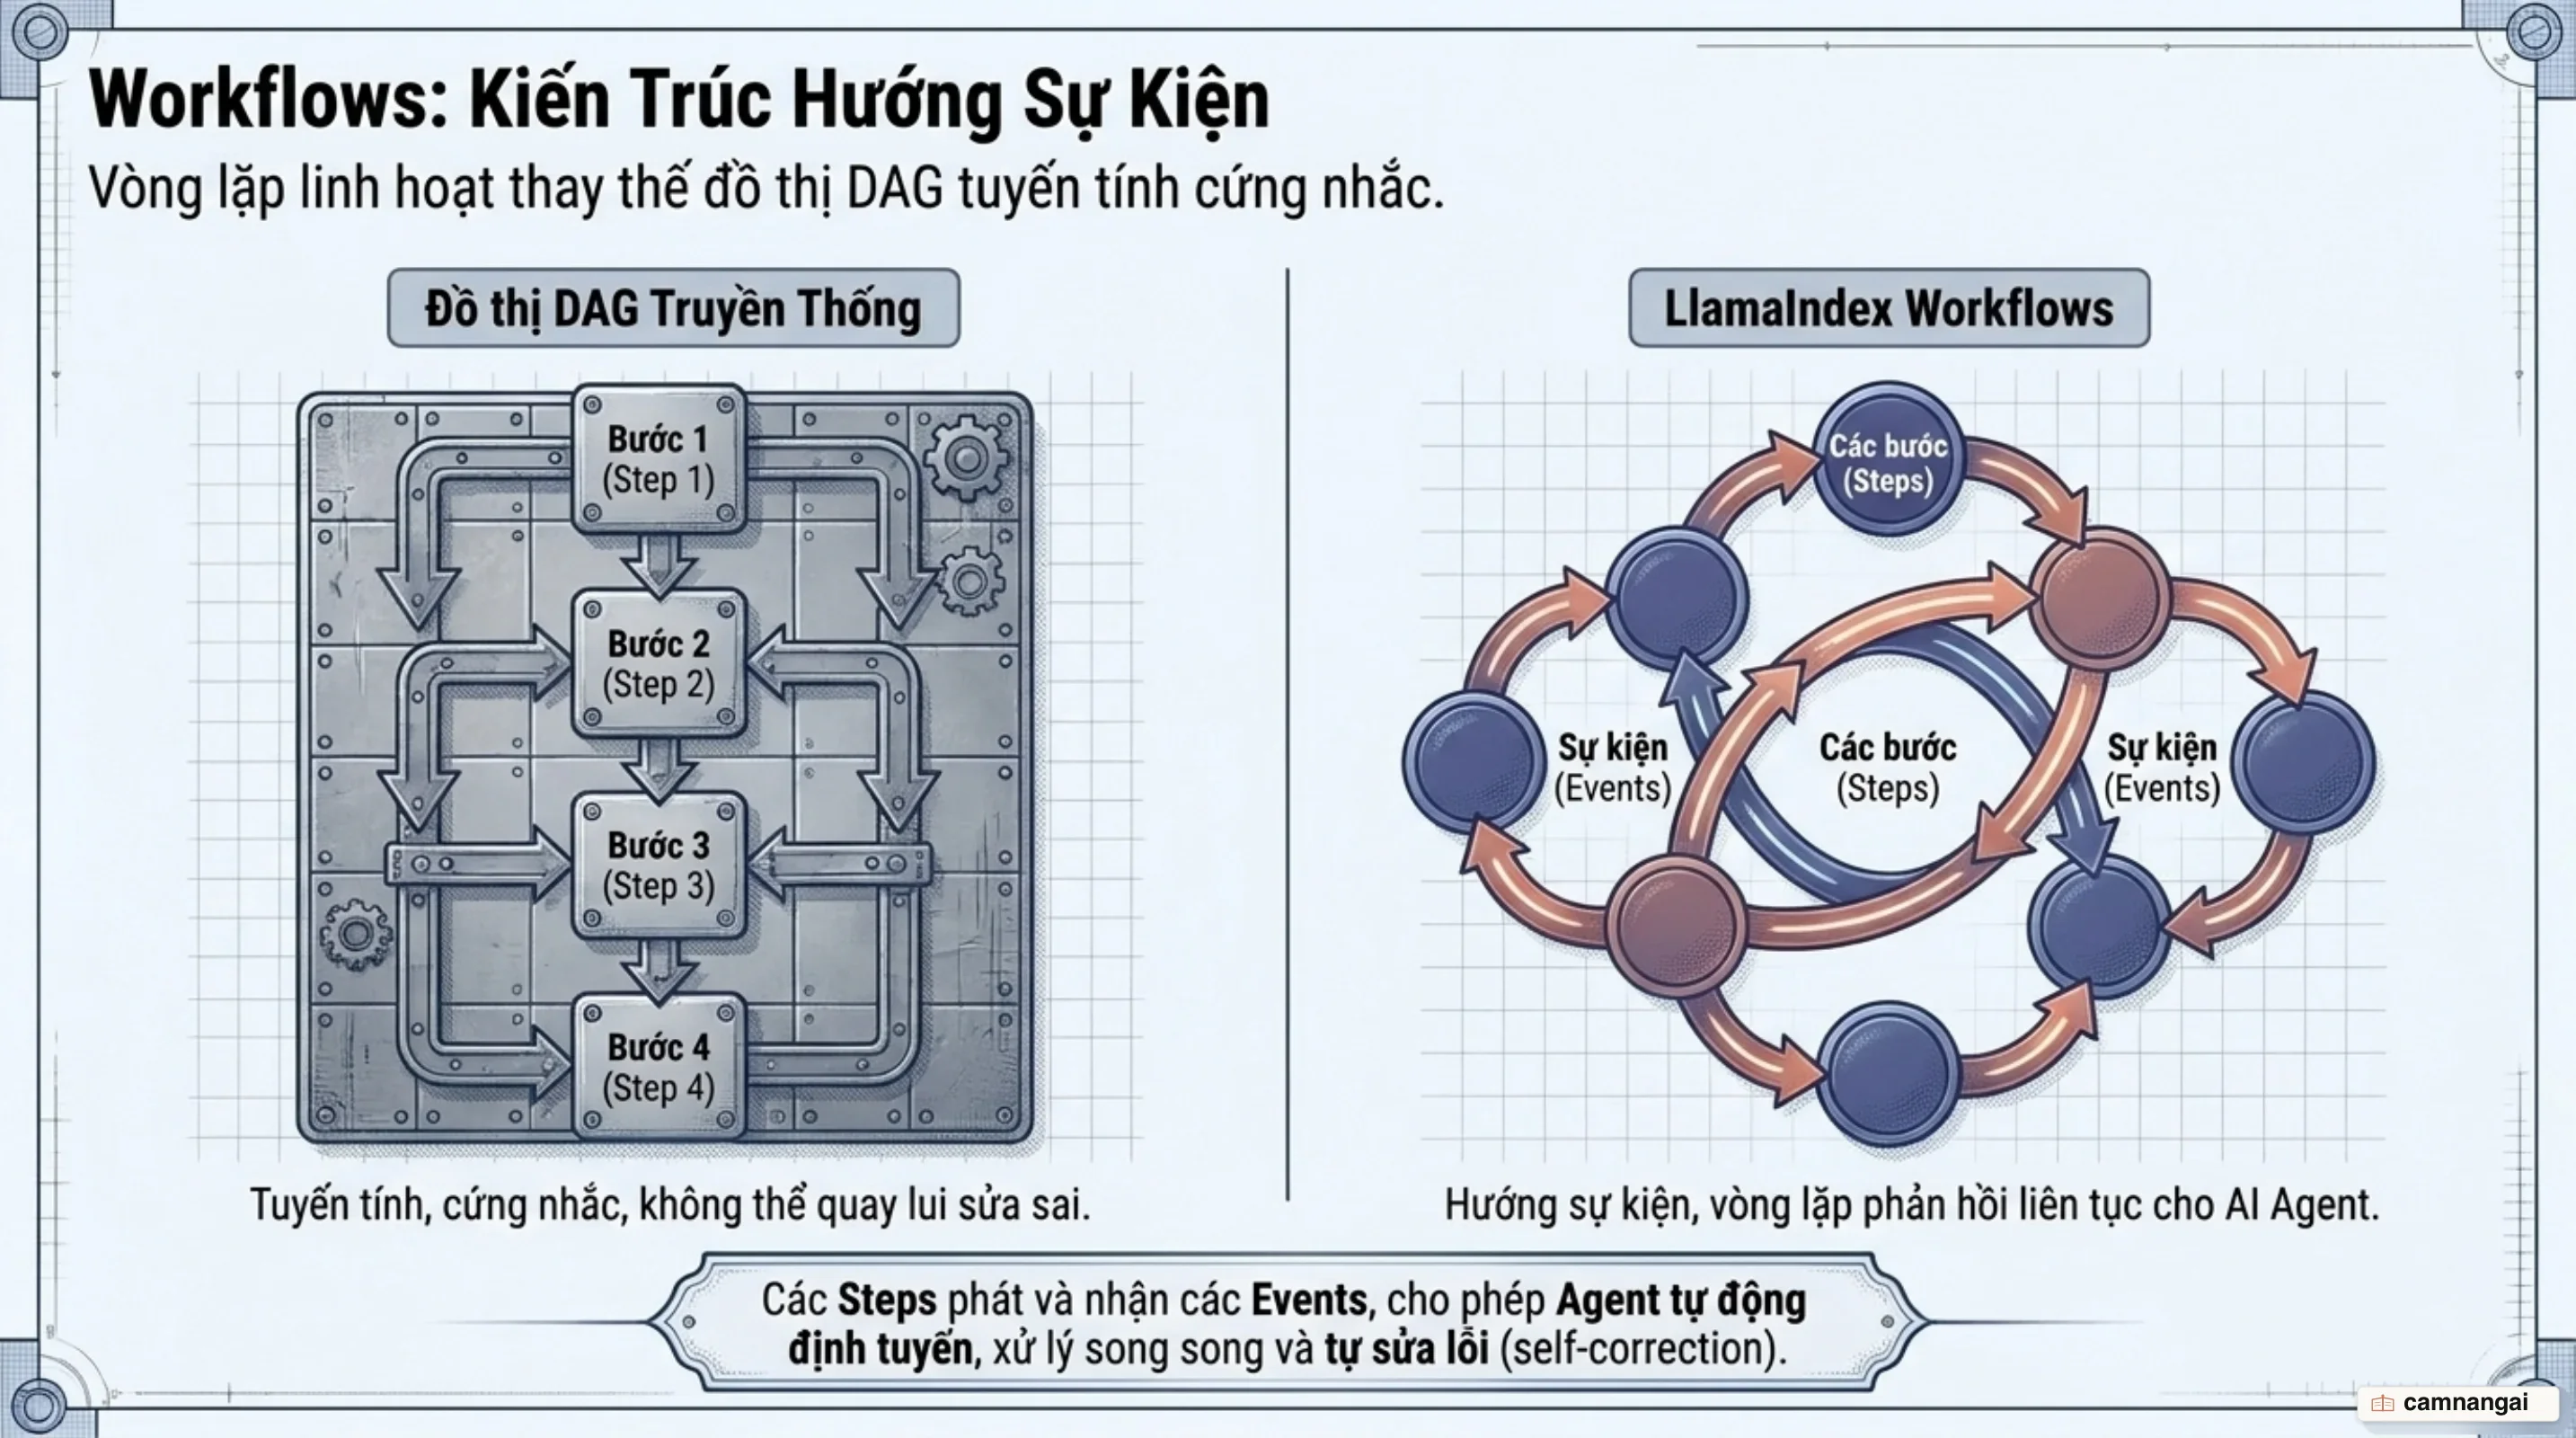
Ví dụ dưới đây minh họa một Workflow hướng sự kiện cơ bản:
import asyncio
from llama_index.core.workflow import Event, StartEvent, StopEvent, Workflow, step
from llama_index.llms.openai import OpenAI


class ProcessingEvent(Event):
    payload: str


class SimpleAgentWorkflow(Workflow):
    llm = OpenAI(model="gpt-4o-mini")

    @step
    async def process_input(self, ev: StartEvent) -> ProcessingEvent:
        query = ev.get("query")
        response = await self.llm.acomplete(f"Phân tích yêu cầu sau: {query}")
        return ProcessingEvent(payload=str(response))

    @step
    async def finalize_output(self, ev: ProcessingEvent) -> StopEvent:
        return StopEvent(result=f"Kết quả xử lý: {ev.payload}")


async def main():
    workflow = SimpleAgentWorkflow(timeout=60)
    result = await workflow.run(query="Phân tích yêu cầu thông lượng hệ thống.")
    print(result)


if __name__ == "__main__":
    asyncio.run(main())
LlamaIndex vs LangChain: Khác biệt cốt lõi và cách phối hợp trong thực tế
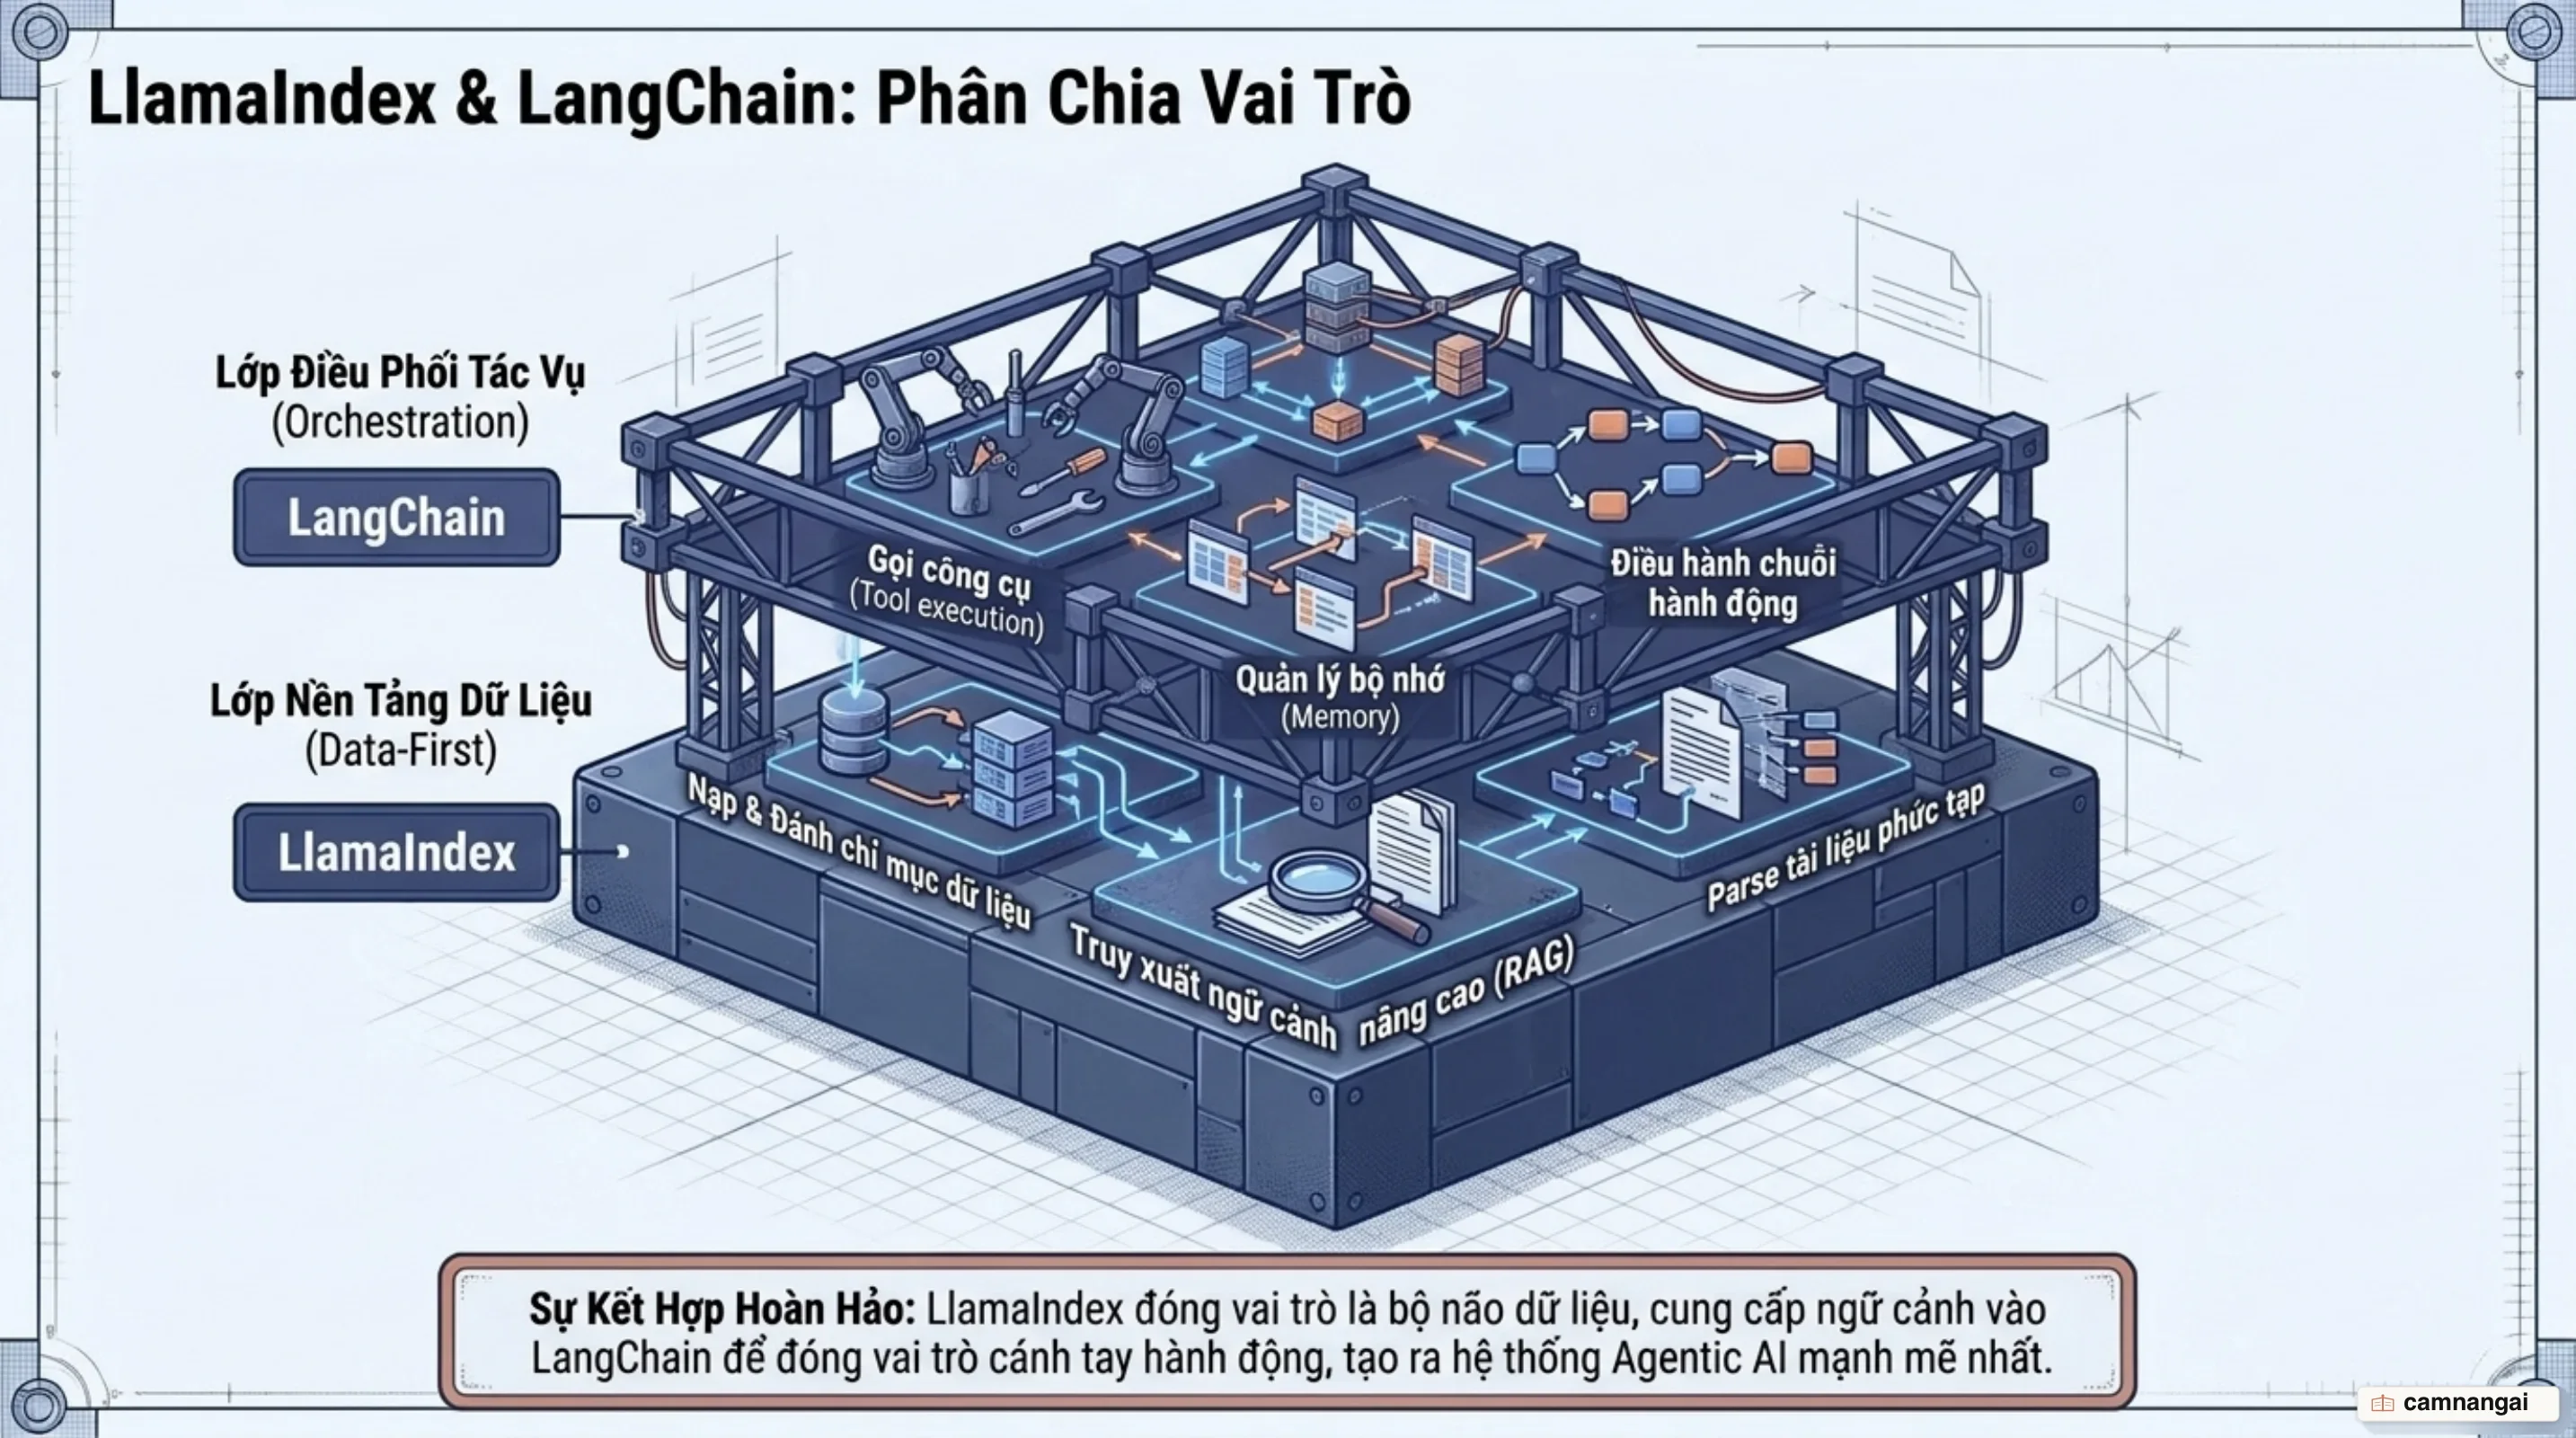
Dưới góc độ kiến trúc phần mềm, LlamaIndex và LangChain theo đuổi hai định hướng thiết kế khác nhau:
- LlamaIndex tuân theo triết lý tập trung vào dữ liệu ("data-first"), chuyên sâu vào các công đoạn nạp, bóc tách cấu trúc, đánh chỉ mục và truy xuất ngữ cảnh nâng cao. Với hơn 300 đầu kết nối dữ liệu trên LlamaHub cùng các cấu trúc chỉ mục chuyên biệt, LlamaIndex tối ưu hóa khả năng hiểu và trích xuất dữ liệu doanh nghiệp.
- LangChain (và LangGraph) được thiết kế như một framework tổng quát phục vụ điều phối tác vụ (orchestration). LangChain cung cấp hệ sinh thái phong phú để xâu chuỗi lời gọi mô hình, quản lý hội thoại và điều phối các agent thực thi công cụ bên ngoài qua API.
Trong kiến trúc production thực tế, hai framework này thường được kết hợp theo mô hình phân lớp. Bạn có thể sử dụng LlamaIndex làm lớp hạ tầng dữ liệu và truy xuất (thông qua QueryEngineTool), sau đó đóng gói công cụ này thành một Tool để nạp vào agent của LangChain hoặc LangGraph nhằm điều phối quy trình nghiệp vụ phức tạp.
Khi nào kỹ sư nên chọn LlamaIndex cho dự án của mình?
Bạn nên lựa chọn LlamaIndex khi dự án phần mềm đặt trọng tâm vào việc xây dựng hệ thống hỏi đáp tài liệu, ứng dụng RAG nâng cao hoặc trích xuất dữ liệu có cấu trúc từ các định dạng phức tạp như báo cáo tài chính, biểu bảng PDF và tài liệu kỹ thuật nội bộ. Khả năng bảo toàn cấu trúc dữ liệu và lọc ngữ cảnh chính xác của framework giúp giảm thiểu tối đa hiện tượng ảo giác trong suy luận của mô hình.
Đối với các đội ngũ kỹ thuật, lộ trình triển khai tối ưu là bắt đầu thử nghiệm với các module mã nguồn mở cốt lõi của LlamaIndex và LiteParse để xử lý tài liệu cục bộ với chi phí thấp. Khi hệ thống mở rộng quy mô sản xuất với các tài liệu quét phức tạp hoặc khối lượng xử lý lớn, bạn có thể dễ dàng tích hợp LlamaParse và kiến trúc Workflows hướng sự kiện mà không phải đập đi xây lại cấu trúc dữ liệu nền tảng.
Tài liệu tham khảo
- LlamaIndex Core Concepts — Developer Documentation
- LlamaIndex Starter Tutorial (Using OpenAI) — Developer Documentation
- LlamaIndex Workflows Guide — Developer Documentation
- AI Parsing Tool for AI-Ready Document Data — LlamaIndex
- What is LlamaIndex? — IBM
- LlamaIndex Repository — GitHub
- LlamaIndex vs LangChain: Which Framework Is Best for Agentic AI Workflows? — ZenML
- RAG with LlamaIndex, Elasticsearch and Mistral — Elasticsearch Labs