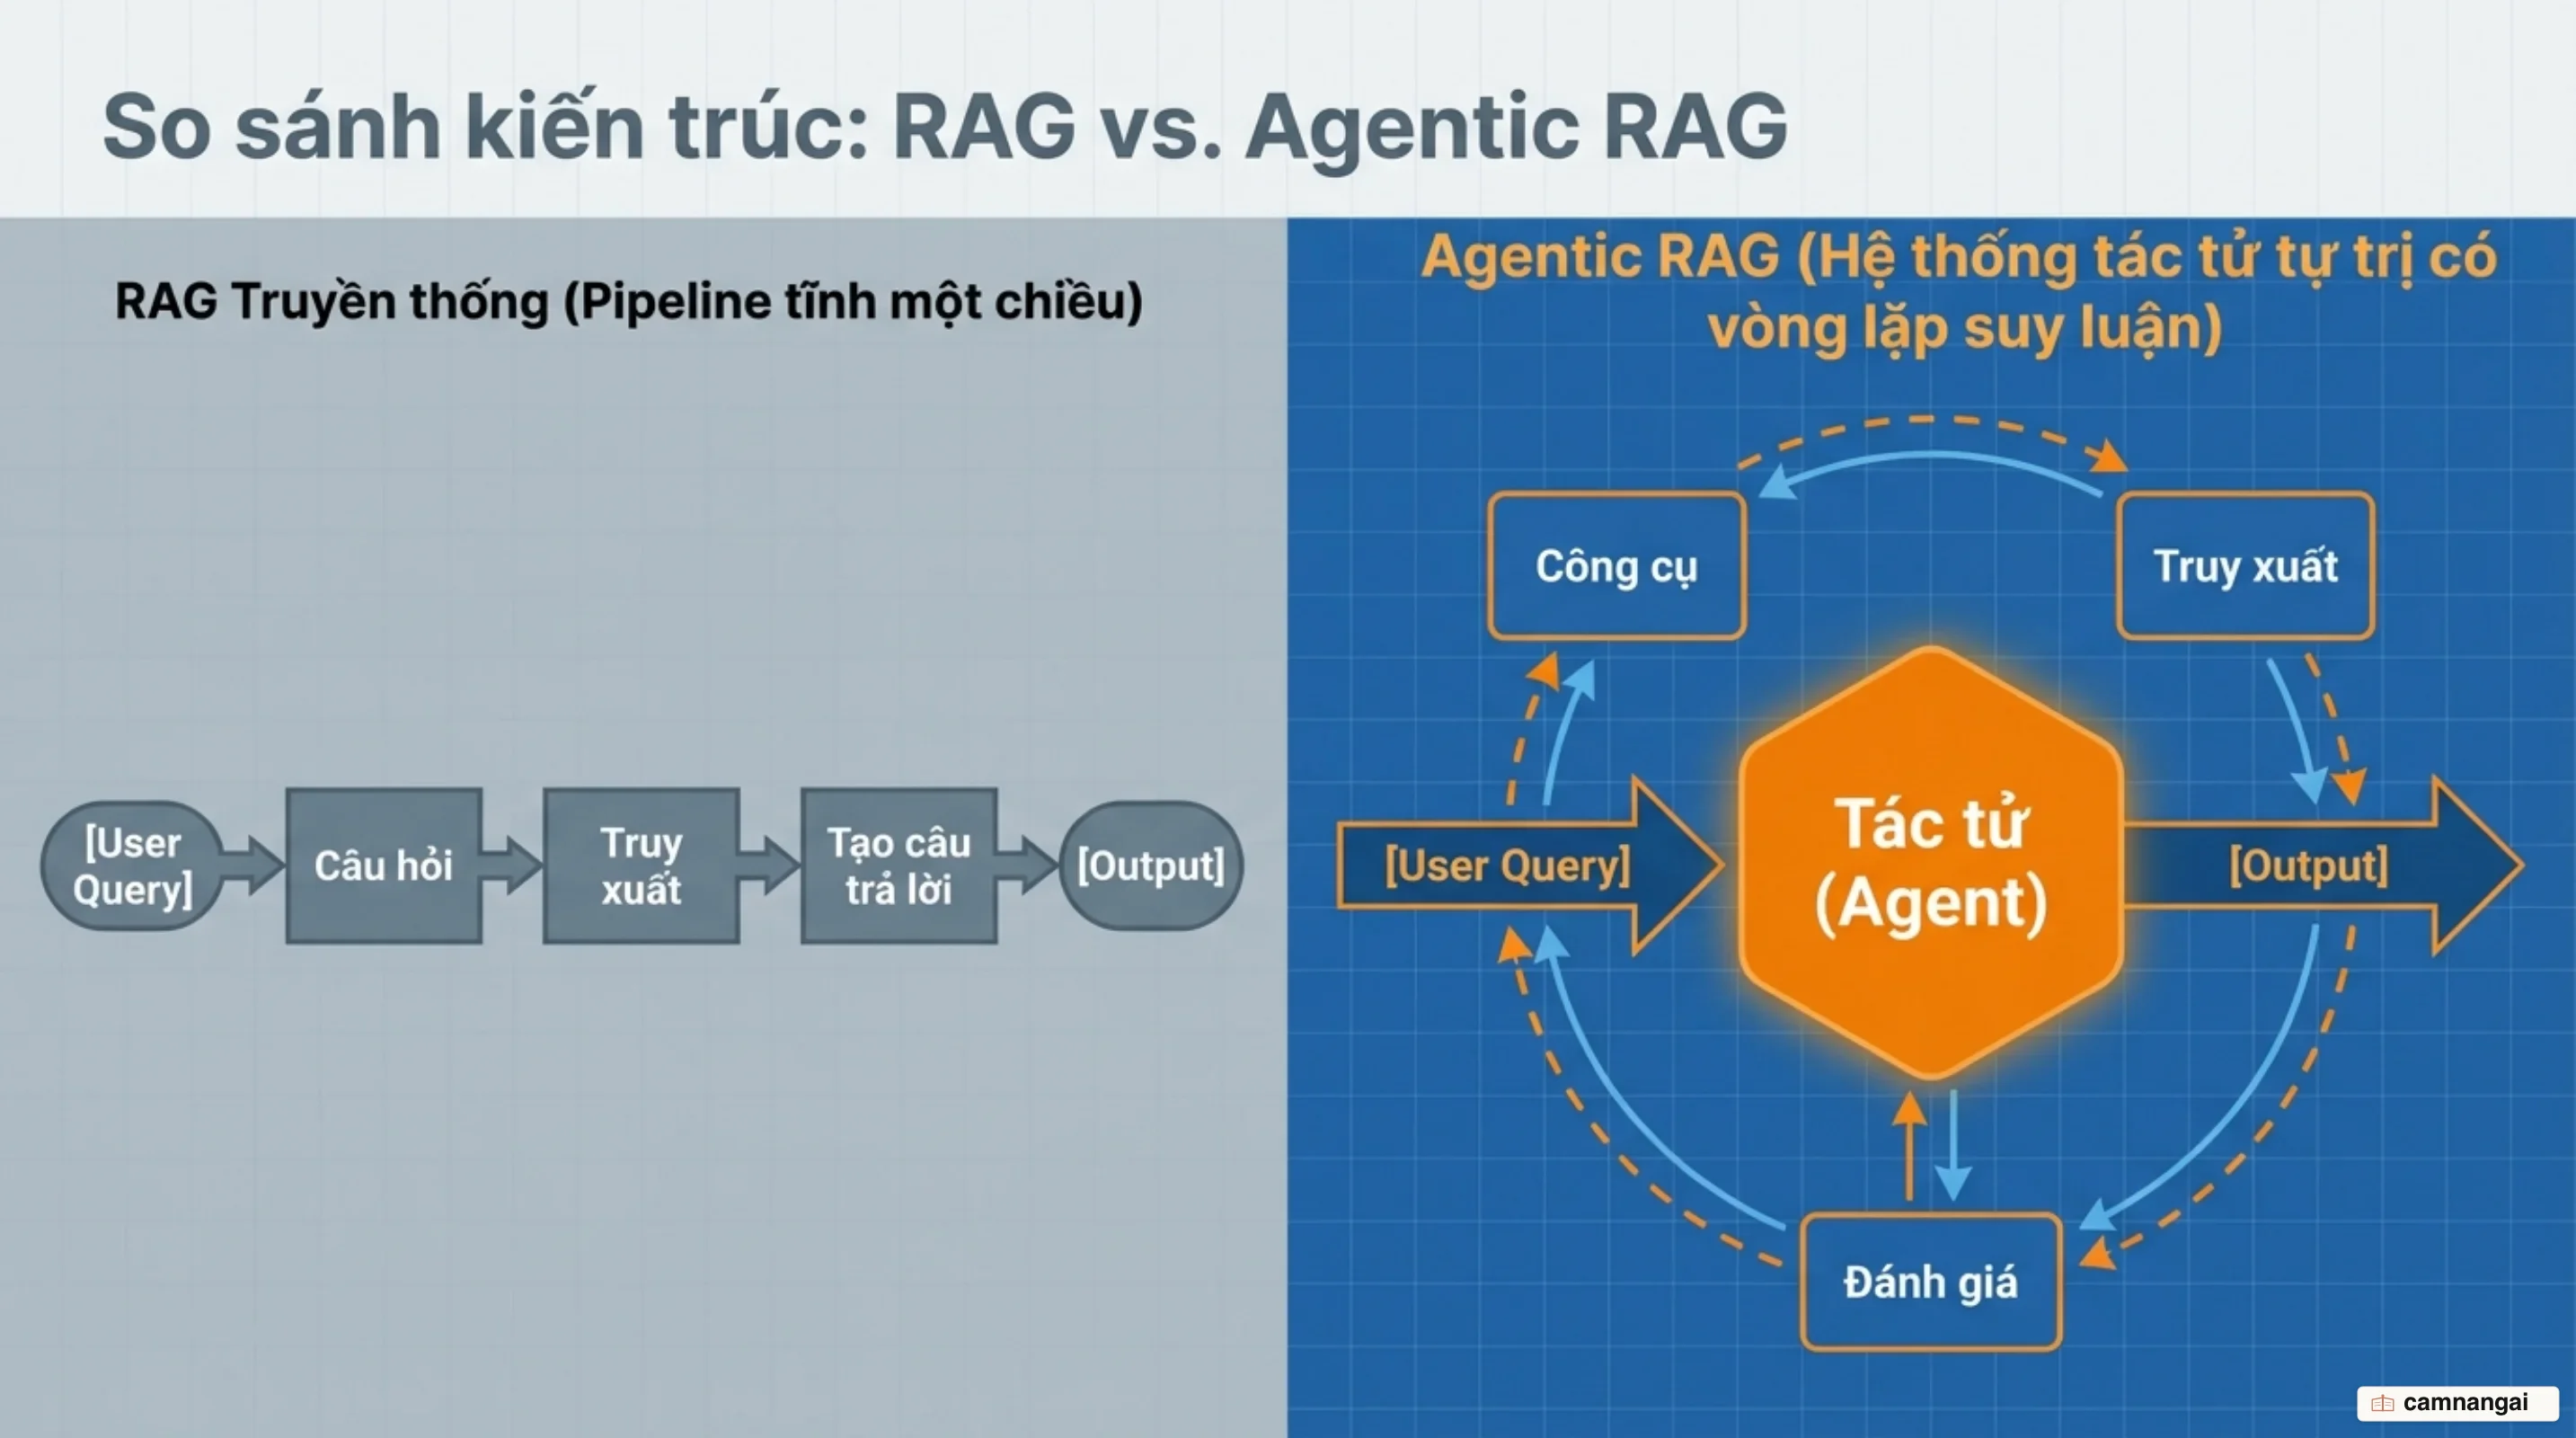
RAG truyền thống vận hành như một quy trình một chiều cố định: nhận truy vấn, tìm kiếm trong cơ sở dữ liệu vector và ép mô hình ngôn ngữ lớn tổng hợp câu trả lời trong một lần xử lý duy nhất. Ngược lại, sự khác biệt cốt lõi giữa RAG vs Agentic RAG nằm ở tính tự trị: Agentic RAG biến quy trình truy hồi thụ động thành một hệ thống tác tử có khả năng suy luận, tự chọn công cụ, đánh giá thông tin và lặp lại tìm kiếm cho đến khi đủ dữ liệu tin cậy.
Khi người dùng đặt những câu hỏi phức tạp đòi hỏi tổng hợp từ nhiều nguồn hoặc bóc tách đa chặng, pipeline tĩnh lập tức bộc lộ điểm yếu: nếu tài liệu lấy về ở bước đầu tiên bị thiếu hoặc sai lệch, toàn bộ câu trả lời phía sau sẽ rơi vào ảo giác mà hệ thống không có cách nào tự cứu vãn.
Hiểu đơn giản: RAG truyền thống dựa hoàn toàn vào may rủi của lần truy hồi đầu tiên, còn Agentic RAG trao quyền cho mô hình tự kiểm tra và sửa sai trước khi phát ngôn.
Vì sao RAG truyền thống chạm trần khi gặp bài toán phức tạp?
Cơ chế vận hành của Vanilla RAG (Naive RAG) hoàn toàn tuân theo chu trình tuyến tính 1-shot: Query → Vector Search → Prompt Augmentation → LLM Generation. Khi nhận câu hỏi từ người dùng, hệ thống chuyển câu hỏi thành embedding, thực hiện truy vấn độ tương đồng trong cơ sở dữ liệu vector, nhồi context thu được vào prompt và yêu cầu LLM sinh câu trả lời. Kiến trúc này khiến chất lượng đầu ra phụ thuộc hoàn toàn vào độ chính xác của cơ chế gán nhãn và nhúng (embedding/indexing) ban đầu. Nếu bước truy xuất duy nhất này lấy về dữ liệu sai hoặc thiếu, pipeline không thể tự quay lại để sửa chữa.
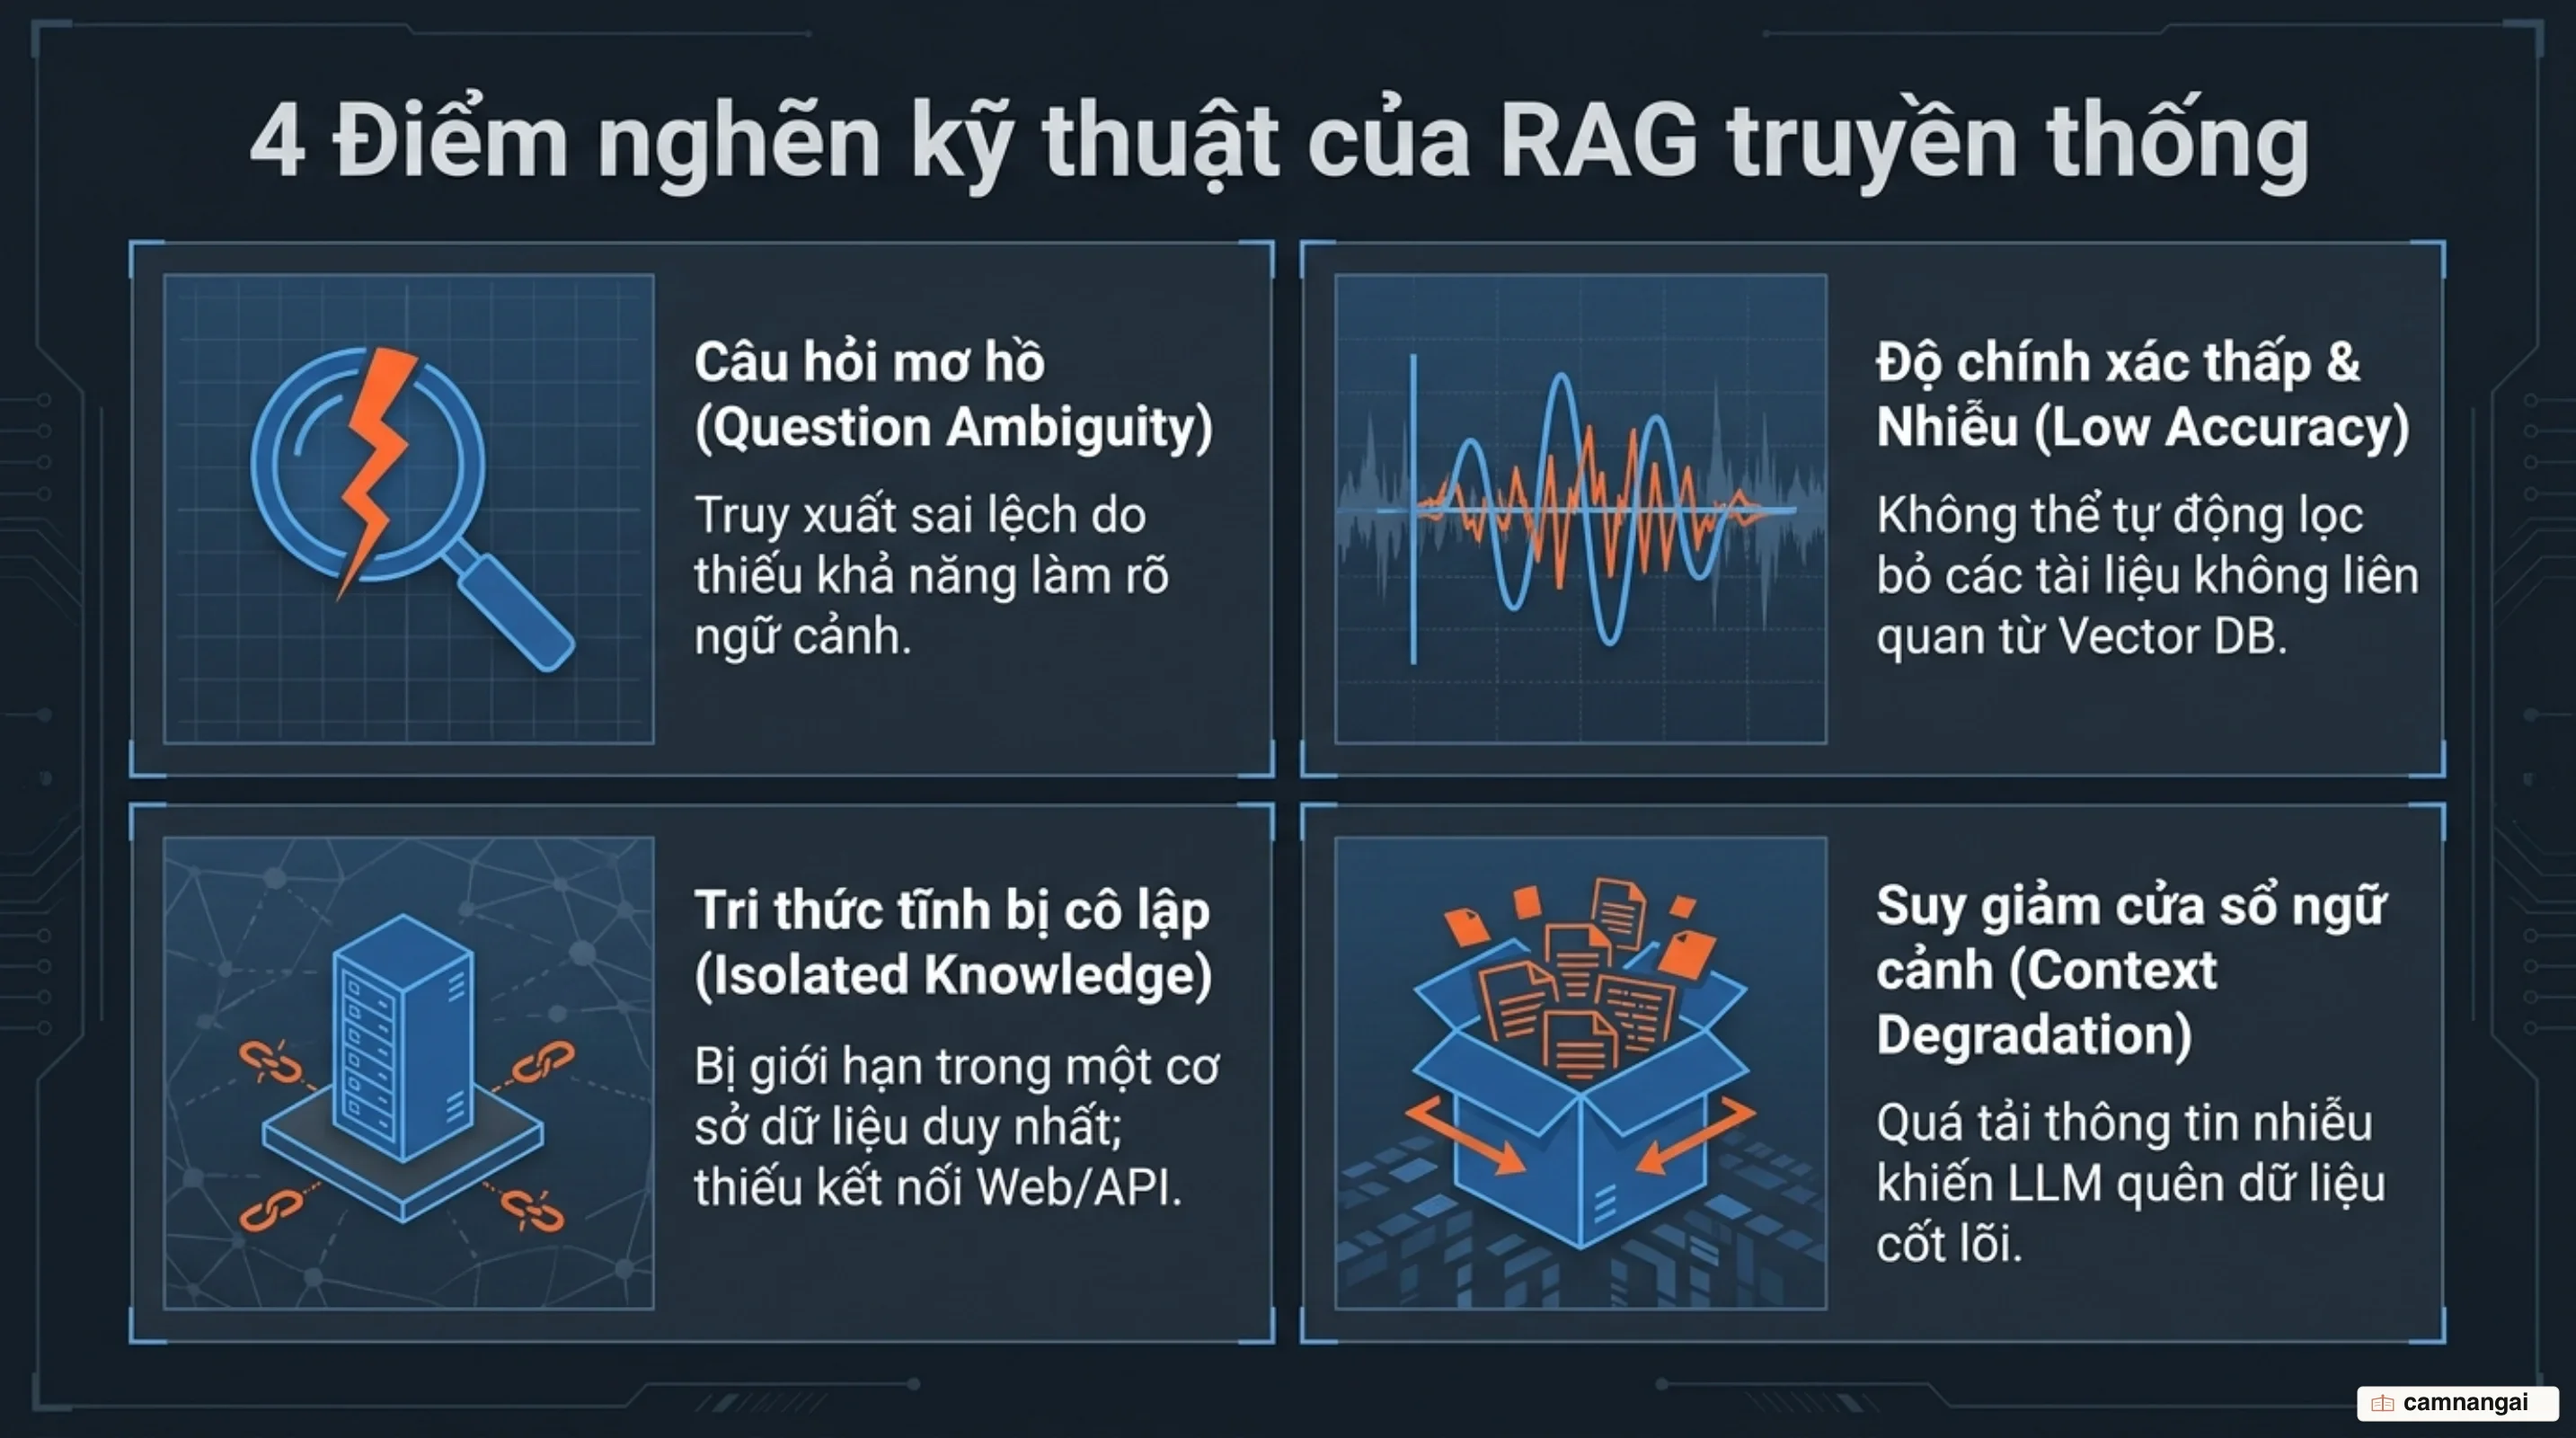
Khi đưa RAG truyền thống vào các môi trường sản xuất khắt khe, bạn sẽ nhanh chóng vấp phải 4 rào cản kỹ thuật chính khiến hệ thống chạm trần hiệu năng:
- Question ambiguity (Câu hỏi mơ hồ): Người dùng thường nhập các truy vấn không rõ ràng hoặc thiếu ngữ cảnh, dẫn đến việc tìm kiếm vector trả về các đoạn văn bản hoàn toàn lệch hướng.
- Low retrieval accuracy (Độ chính xác truy xuất thấp): Các tài liệu lấy ra không đồng đều về độ liên quan, chứa nhiều thông tin nhiễu hoặc không trực tiếp giải quyết ý định của câu hỏi.
- Limited knowledge (Tri thức bị giới hạn): Hệ thống chỉ truy vấn trên một kho dữ liệu tĩnh cố định, hoàn toàn bị cô lập và không có khả năng truy cập thông tin thời gian thực qua web hay các API bên ngoài.
- Context window performance limitations (Giới hạn cửa sổ ngữ cảnh): Cố gắng "truy xuất vượt mức" (over-retrieve) để bù đắp thiếu sót sẽ gây quá tải bộ nhớ ngữ cảnh, làm suy giảm khả năng chú ý của mô hình và tăng thời gian phản hồi lên mức không thể chấp nhận.
Thiếu sót nghiêm trọng nhất của RAG truyền thống là sự vắng bóng của cơ chế đánh giá (validation) và lập luận (reasoning). Kiến trúc chain tuyến tính mặc định coi kết quả truy xuất đầu tiên là "sự thật khách quan" (ground truth) và ép LLM sinh câu trả lời dựa trên đó. Khi ngữ cảnh truy xuất chứa thông tin sai lệch hoặc nhiễu, LLM bị buộc phải tổng hợp dữ liệu lỗi, dẫn đến hiện tượng lan truyền sai lệch (hallucination propagation) nghiêm trọng mà hệ thống không hề có khả năng tự phát hiện hay chặn lại.
Agentic RAG là gì? Ba năng lực thay đổi cuộc chơi
Agentic RAG là mô hình triển khai RAG dựa trên các AI Agent tự trị. Agentic RAG tái cấu trúc quy trình truy xuất thụ động thành một vòng lặp lặp đi lặp lại (iterative loop). Trong kiến trúc này, Agent giữ quyền điều phối chính: nó có thể truy xuất, tự đánh giá chất lượng tài liệu, truy xuất bổ sung nếu thiếu thông tin, và xác thực tính chính xác của phản hồi trước khi đưa ra câu trả lời cuối cùng.
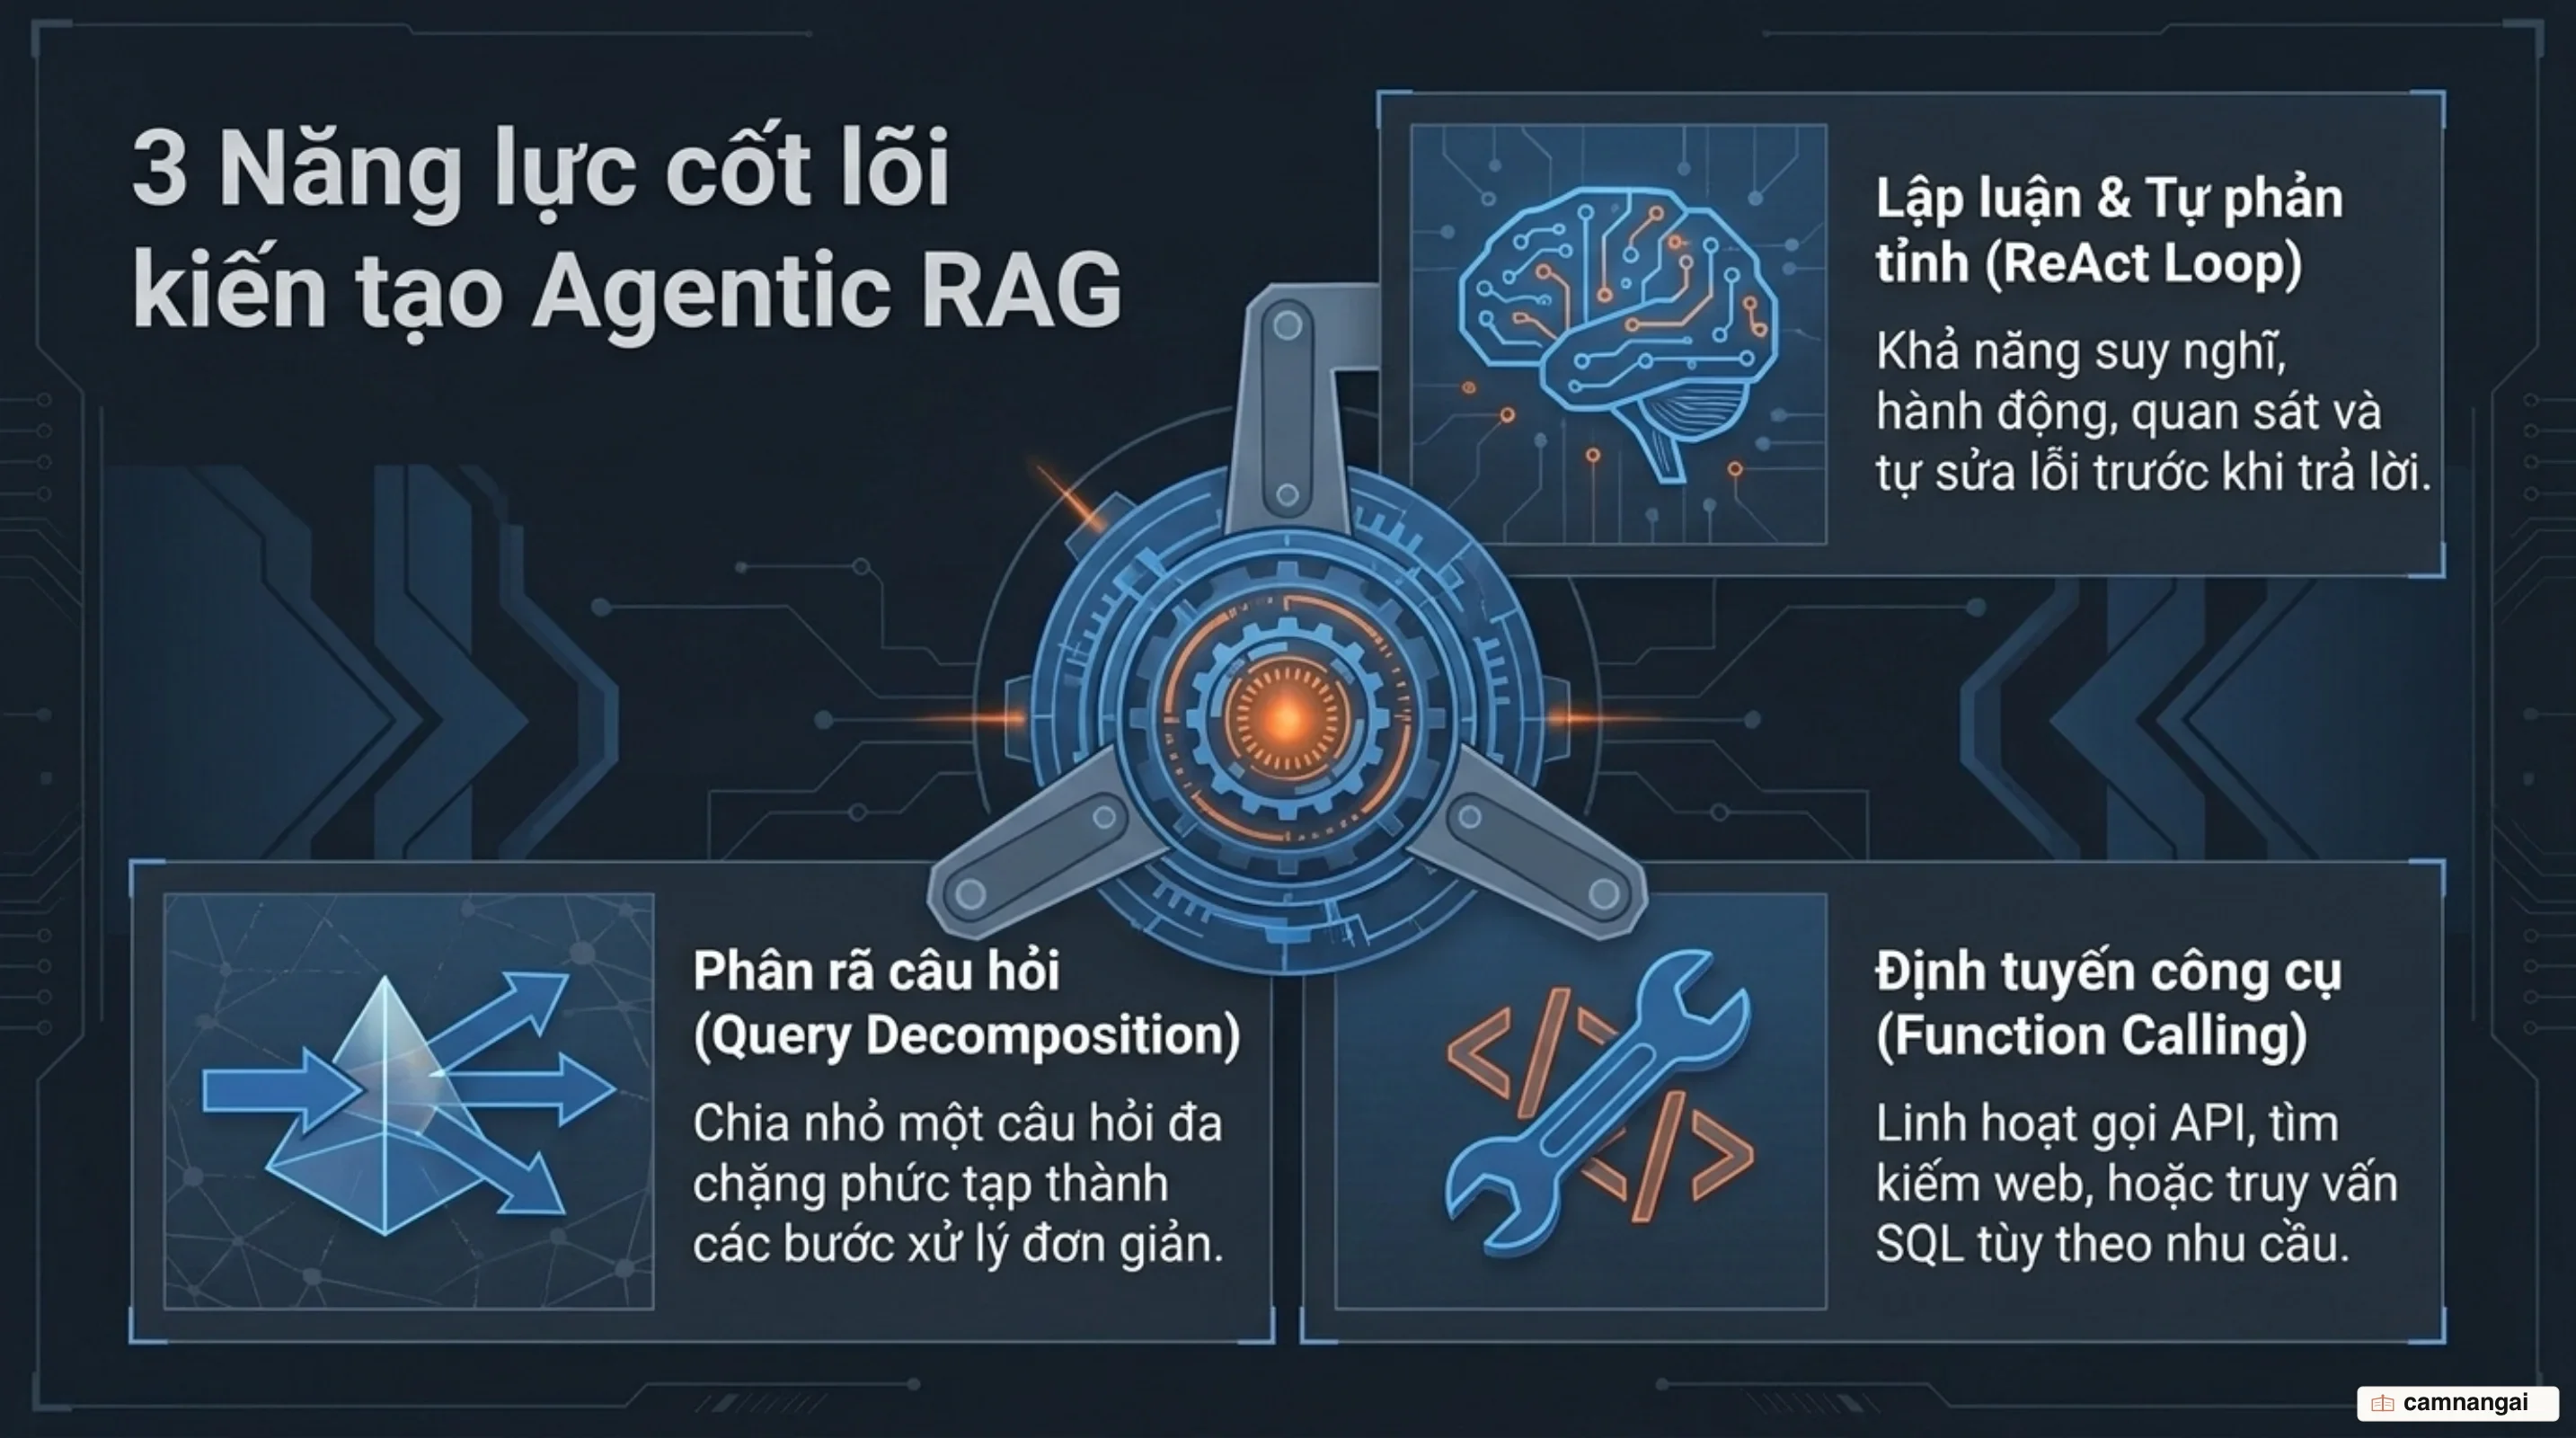
Năng lực cốt lõi đầu tiên của Agentic RAG là Lập luận & Tự phản tỉnh (Planning & Reflection). Bằng cách áp dụng các chu trình lập luận như ReAct (Thought → Action → Observation), Agent có thể phân rã câu hỏi phức tạp thành chuỗi tác vụ đơn lẻ. Khác với việc chỉ dùng prompt chỉ định LLM đóng vai trò giám khảo ở cấp độ ứng dụng, Agentic RAG nâng cao có thể khai thác các token phản tỉnh đặc trưng ở cấp độ mô hình (model-native reflection tokens như [Retrieval], [IsRel], [IsSup], [IsUse] trong Self-RAG). Các token này được huấn luyện đặc biệt để định hướng trực tiếp luồng giải mã (decoding pathways) trong quá trình suy luận, cho phép mô hình tự quyết định khi nào cần truy xuất và tự chấm điểm độ trung thực của văn bản sinh ra.
Năng lực thứ hai là Định tuyến & Sử dụng công cụ (Routing & Tool Use). Thông qua cơ chế Function Calling (gọi hàm), Agent vượt qua ranh giới của một Vector Database đơn lẻ. Khi nhận thấy dữ liệu nội bộ không đủ để đáp ứng truy vấn, Agent tự động chọn và kích hoạt các công cụ bên ngoài bao gồm công cụ tìm kiếm Web (như Tavily hay DuckDuckGo), kết nối API trực tiếp đến các hệ thống như GitHub, TechCrunch, Arxiv, hoặc gọi các trình tính toán chuyên dụng.
Năng lực thứ ba là Quản lý Trạng thái & Bộ nhớ (State Management & Memory). Để thực hiện các quy trình đa bước mà không làm mất dấu vết suy luận, Agent duy trì cấu trúc trạng thái liên tục. Hệ thống phân biệt rõ ràng giữa bộ nhớ dài hạn (Vector Store) và bộ nhớ ngắn hạn (luồng hội thoại / MessagesState). Bằng cách sử dụng các hàm gom tụ tin nhắn dạng cộng dồn (append-only message reducers như Annotated[list, add_messages]), LangGraph giúp Agent bảo toàn toàn bộ lịch sử gọi tool và các bước lập luận qua từng vòng lặp.
4 mô hình kiến trúc phổ biến của Agentic RAG
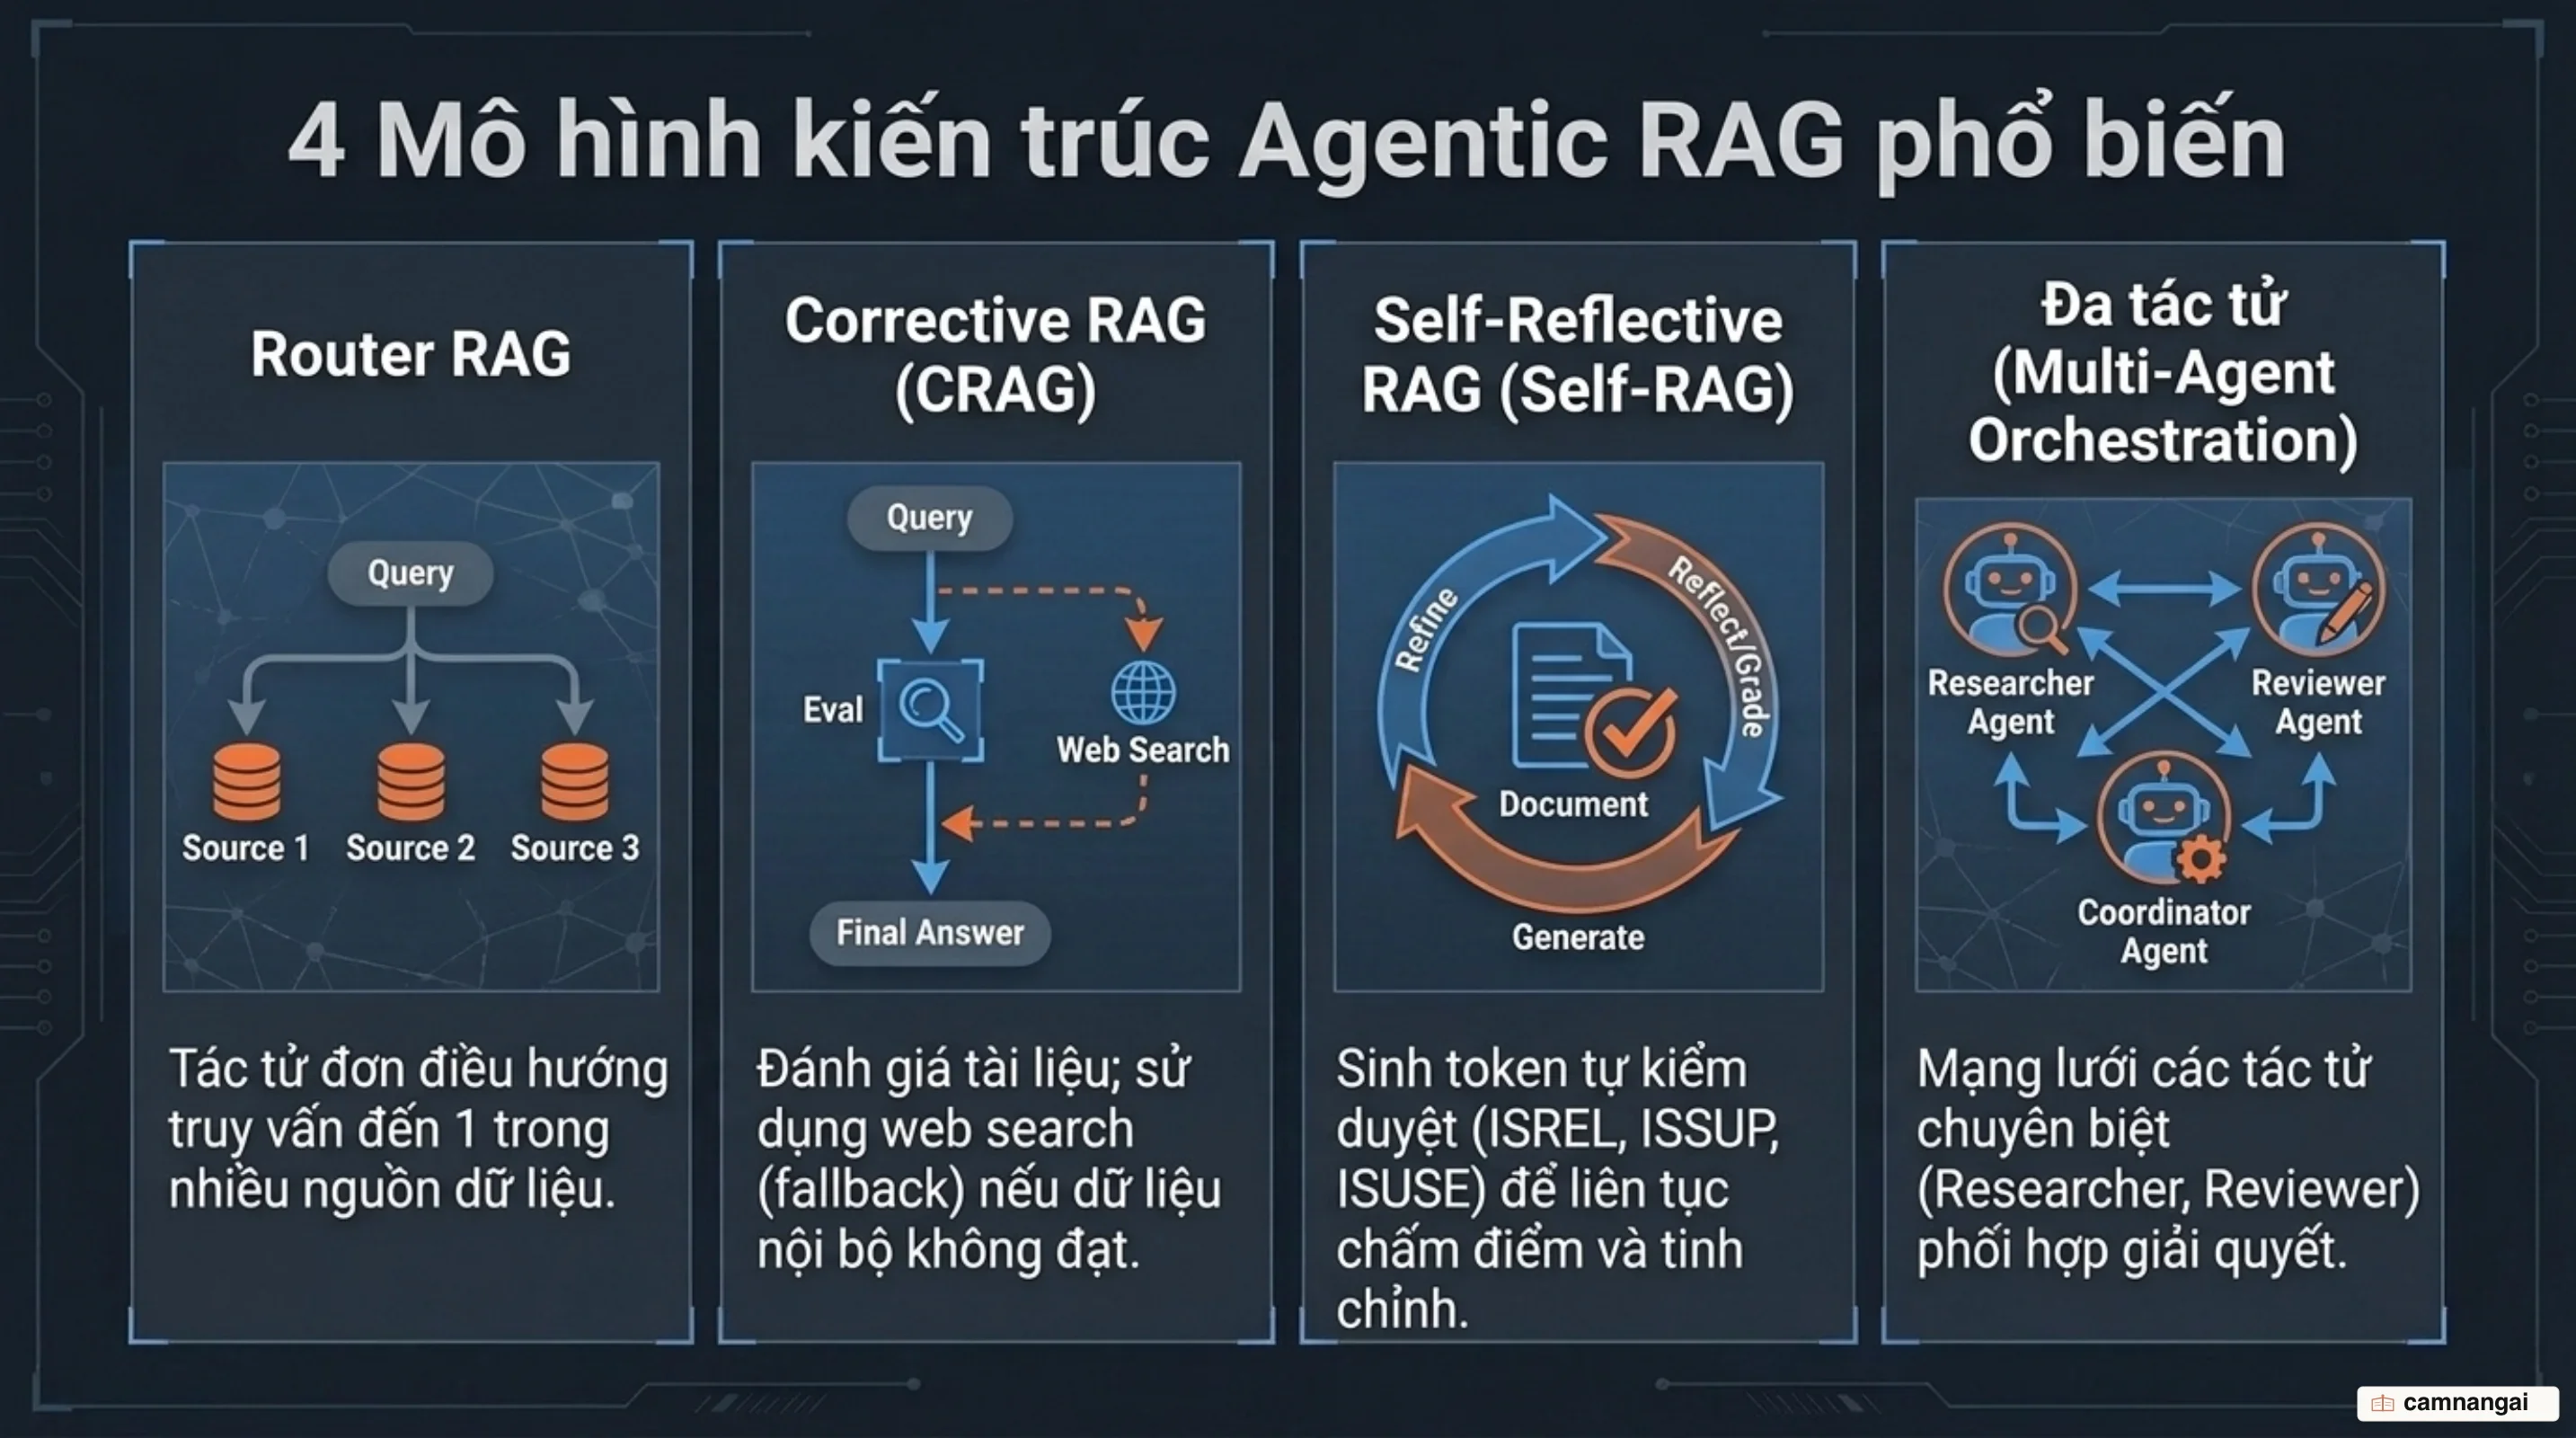
Trong thực tế triển khai, Agentic RAG được phát triển thành nhiều mẫu kiến trúc nâng cao tùy thuộc vào yêu cầu của bài toán:
- Router RAG (Single-Agent Router): Đây là dạng kiến trúc cơ bản nhất. LLM trực tiếp làm bộ định tuyến (router) ở ngay đầu vào, phân tích ý định của truy vấn để quyết định chuyển câu hỏi đến kho kiến thức vector phù hợp, kích hoạt tìm kiếm web hay chọn một công cụ truy vấn chuyên biệt.
- Corrective RAG (CRAG): Kiến trúc này bổ sung một bộ đánh giá (Retrieval Evaluator) để kiểm tra chất lượng tài liệu thu được từ Vector DB. Nếu phát hiện dữ liệu thiếu hoặc sai lệch, hệ thống tự động kích hoạt công cụ tìm kiếm Web (Tavily) để bổ sung tri thức. Đặc biệt, CRAG thực hiện tinh lọc tri thức (Knowledge Refinement) bằng cách chia nhỏ tài liệu retrieved thành các "dải tri thức" (knowledge strips) góc độ chi tiết, đánh giá riêng từng dải và loại bỏ triệt để các dải chứa thông tin nhiễu trước khi đưa vào sinh phản hồi.
- Self-Reflective RAG (Self-RAG): Mô hình này nhúng các bước kiểm định song song nghiêm ngặt vào luồng suy luận thông qua các chỉ số: đánh giá độ tương quan giữa truy vấn và tài liệu (
ISREL), đánh giá liệu phản hồi sinh ra có được hỗ trợ hoàn toàn bởi ngữ cảnh hay không (ISSUP— đóng vai trò cổng kiểm soát chống hallucination), và chấm điểm độ hữu ích của câu trả lời (ISUSE). - Multi-Agent RAG Orchestration: Đối với các hệ thống doanh nghiệp quy mô lớn, kiến trúc đa agent được áp dụng (như mô hình
AgentRunnerphối hợp vớiAgentWorkertrên LlamaIndex hoặc Amazon Bedrock). Mô hình bao gồm một Master Agent chịu trách nhiệm điều phối chung, giao việc cho các Sub-Agent chuyên trách từng nguồn dữ liệu riêng biệt (như Sub-Agent quản lý tài liệu kỹ thuật nội bộ, Sub-Agent quản lý dữ liệu API, Sub-Agent tìm kiếm web).
| Tiêu chí so sánh | Vanilla LLM RAG | Agentic RAG |
|---|---|---|
| Khả năng truy cập Tool bên ngoài | Không (Chỉ truy xuất từ 1 Vector DB cố định) | Có (Gọi linh hoạt Web Search, API, Calculator...) |
| Tiền xử lý Query | Không (Dùng nguyên bản câu hỏi người dùng) | Có (Viết lại, phân rã câu hỏi, tạo đa truy vấn) |
| Truy xuất đa bước (Multi-step) | Không (1-shot retrieval duy nhất) | Có (Lặp lại: Truy xuất → Đánh giá → Truy xuất lại) |
| Đánh giá / Xác thực dữ liệu | Không (Mặc định coi ngữ cảnh truy xuất là đúng) | Có (Đánh giá độ liên quan, cổng ISSUP chặn hallucination) |
State Machine và vòng lặp tự sửa sai: Trái tim của Agentic RAG
Các chuỗi tuyến tính tĩnh (Chain như LangChain cơ bản) hoàn toàn thất bại khi xây dựng Agentic RAG vì chúng không hỗ trợ khả năng rẽ nhánh động và vòng lặp (loops). Để xây dựng hệ thống tự trị, bạn phải sử dụng kiến trúc máy trạng thái (State Machine) như LangGraph. State Machine cho phép định nghĩa hệ thống dưới dạng đồ thị gồm: Nodes (các hàm thực thi hành động như truy xuất, sinh câu trả lời), Edges (luồng chuyển tiếp cố định) và Conditional Edges (các điểm rẽ nhánh dựa trên điều kiện thực tế của trạng thái).
 +-------------------------------------------------------+
 | |
 v |
[generate_query_or_respond] |
 | |
 +---> (Có Tool Calls?) --Yes--> [retrieve] |
 | | |
 No v |
 | [grade_documents] |
 v | |
 [END] +--- (Relevant?) |
 | | |
 Yes No |
 | | |
 v v |
 [generate_answer] [rewrite_question]-+
 |
 v
 [END]
Luồng tự sửa sai (Self-Correction Loop) trên LangGraph vận hành linh hoạt qua các bước:
generate_query_or_respond: LLM phân tích câu hỏi và quyết định trả lời ngay hoặc phát ra lệnh gọiretriever_tool.retrieve: Thực thi truy xuất ngữ cảnh từ cơ sở dữ liệu vector.grade_documents: Evaluator đánh giá độ liên quan của ngữ cảnh thu được. Nếu kết quả là "No" (không liên quan), luồng được chuyển sang noderewrite_questionđể tối ưu lại câu hỏi và quay ngược lại bướcgenerate_query_or_respondđể truy xuất lại. Nếu "Yes", luồng chuyển sanggenerate_answerđể tổng hợp phản hồi.
Toàn bộ quá trình tự sửa sai này được duy trì nhất quán nhờ việc quản lý Trạng thái (MessagesState) kết hợp với cơ chế ghi dồn tin nhắn (append-only reducers). Mọi vết suy luận, câu hỏi ban đầu, danh sách tài liệu truy xuất và kết quả chấm điểm đều được lưu lại. Nhờ đó, LLM duy trì được toàn bộ ngữ cảnh qua các vòng lặp, giúp quá trình viết lại câu hỏi không bị lệch khỏi ý định ban đầu của người dùng.
Đoạn mã Python dưới đây minh họa việc dựng một Graph API cho Agentic RAG sử dụng LangGraph với cấu hình map đường đi rõ ràng:
from typing import Literal
from typing_extensions import TypedDict
from langgraph.graph import StateGraph, MessagesState, END

# Định nghĩa StateGraph dựa trên MessagesState
workflow = StateGraph(MessagesState)

# Khai báo các nodes thực thi
workflow.add_node("generate_query_or_respond", generate_query_or_respond)
workflow.add_node("retrieve", retrieve)
workflow.add_node("grade_documents", grade_documents)
workflow.add_node("rewrite_question", rewrite_question)
workflow.add_node("generate_answer", generate_answer)

workflow.set_entry_point("generate_query_or_respond")

def route_on_tool_calls(state: MessagesState) -> Literal["retrieve", "__end__"]:
    last_message = state["messages"][-1]
    if getattr(last_message, "tool_calls", None):
        return "retrieve"
    return END

workflow.add_conditional_edges(
    "generate_query_or_respond",
    route_on_tool_calls,
    {"retrieve": "retrieve", END: END}
)

# Chuyển hướng từ điểm truy xuất sang bước đánh giá dữ liệu với path map rõ ràng
workflow.add_conditional_edges(
    "retrieve",
    grade_documents,
    {
        "generate_answer": "generate_answer",
        "rewrite_question": "rewrite_question",
    }
)

workflow.add_edge("rewrite_question", "generate_query_or_respond")
workflow.add_edge("generate_answer", END)

# Biên dịch đồ thị thành hệ thống hoàn chỉnh
graph = workflow.compile()
Cái giá của tự trị: Độ trễ, chi phí token và rủi ro vòng lặp vô tận
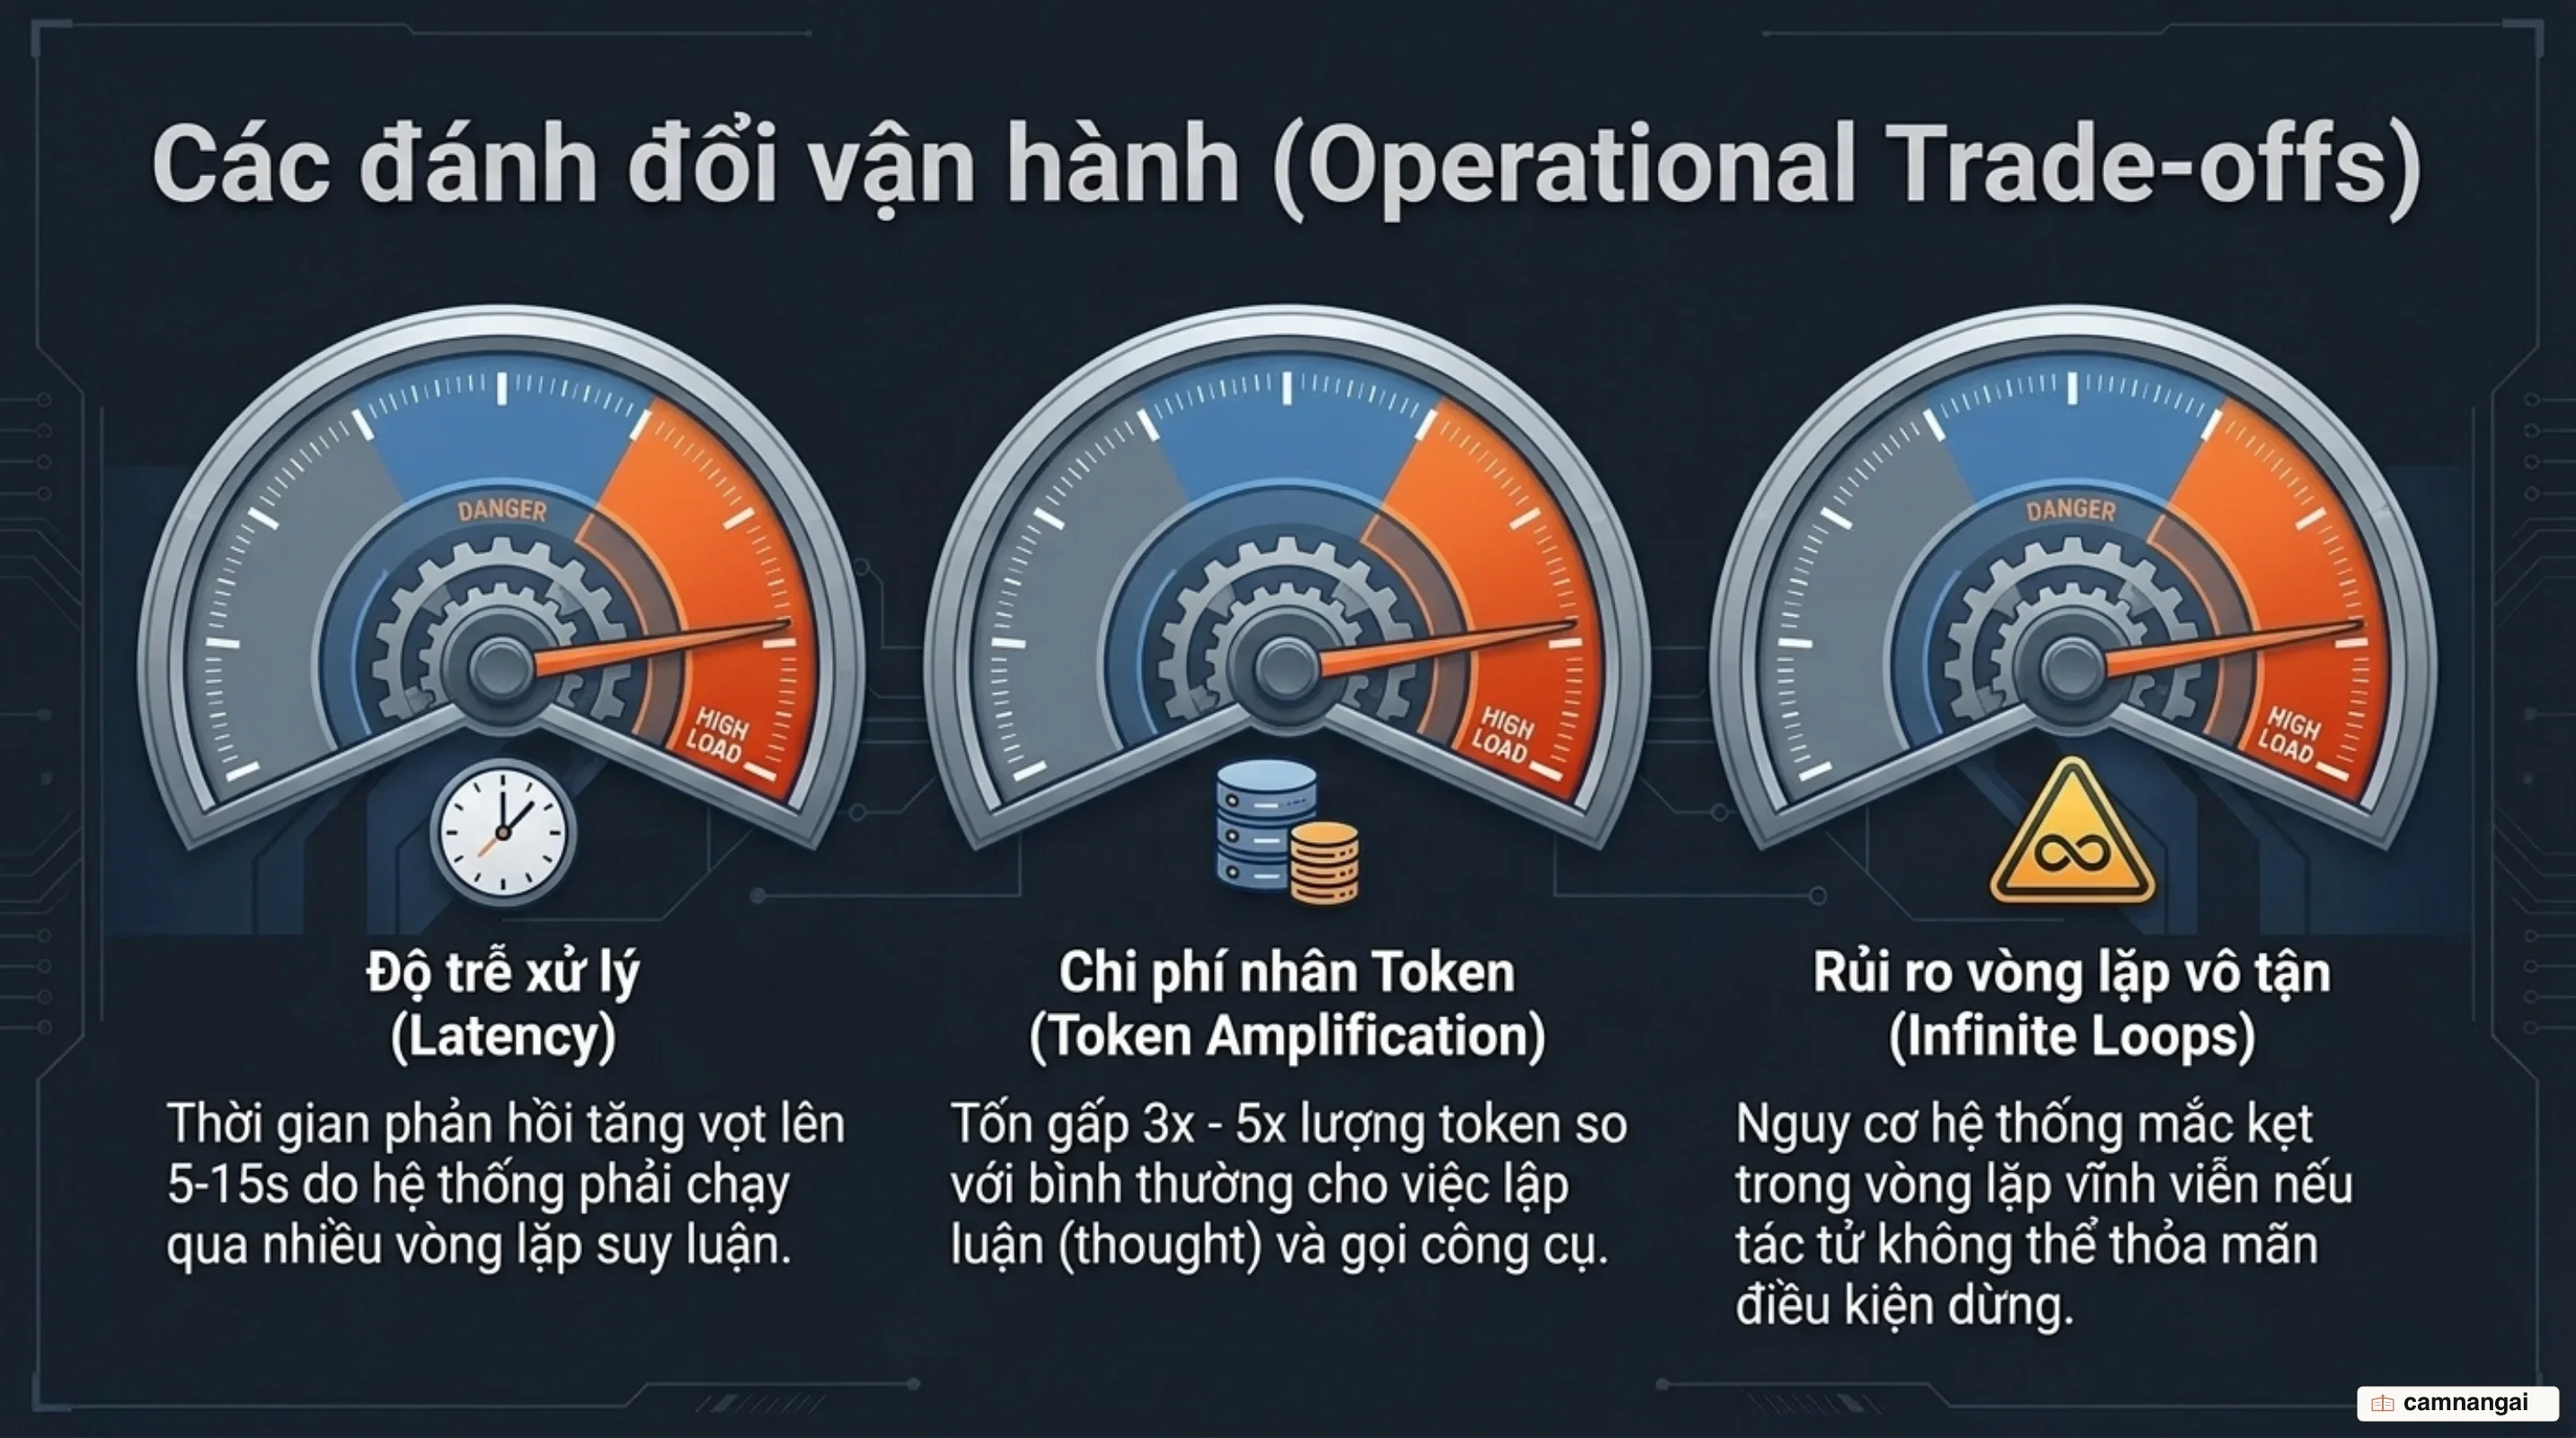
Mặc dù mang lại hiệu năng suy luận vượt trội, việc nâng cấp lên Agentic RAG đòi hỏi bạn phải đánh đổi bằng những chi phí hạ tầng không nhỏ. Thách thức lớn nhất là Độ trễ (Latency). Việc chuyển đổi từ 1 lệnh gọi LLM duy nhất sang một chuỗi nhiều lượt gọi LLM đồng bộ nối tiếp nhau (sequential LLM calls: truy xuất → chấm điểm → viết lại câu hỏi → truy xuất lại → sinh phản hồi) làm tăng đáng kể cả chỉ số Time to First Token (TTFT) lẫn Total End-to-End Latency, ảnh hưởng trực tiếp đến trải nghiệm người dùng thời gian thực.
Thách thức thứ hai nằm ở Chi phí Token (Token Cost Overhead). Trong kiến trúc tự trị, mỗi bước tự phản tỉnh (critique), sinh đa truy vấn để mở rộng ngữ cảnh (RAG Fusion), hay thực thi node Evaluator độc lập đều tiêu tốn thêm lượng lớn token đầu vào và đầu ra. Chi phí vận hành có thể bị khuếch đại (token amplification factor) lên gấp 3x đến 5x lần so với một pipeline Vanilla RAG đơn giản cho cùng một yêu cầu.
Thách thức thứ ba là Rủi ro Vòng lặp Vô tận (Infinite Loops) và Độ phức tạp khi Debug. Nếu các điều kiện rẽ nhánh (conditional_edges) hoặc ngưỡng điểm của Evaluator được thiết lập không chuẩn, Agent có thể rơi vào bẫy lặp lại liên tục: truy xuất sai → viết lại câu hỏi → truy xuất vẫn sai → tiếp tục viết lại mà không có điểm dừng. Hơn nữa, việc trace và debug luồng suy luận của agent qua nhiều nhánh đòi hỏi bạn phải triển khai các hệ thống giám sát chuyên dụng như LangSmith để theo dõi chi tiết từng chuyển trạng thái.
Khi nào nên giữ RAG đơn giản, khi nào cần chuyển sang Agentic RAG?
Bạn nên giữ kiến trúc Vanilla RAG đơn giản khi bài toán chỉ yêu cầu truy vấn trên kho dữ liệu nội bộ tĩnh, cấu trúc rõ ràng, ưu tiên tối ưu chỉ số TTFT và độ trễ tổng thể, ngân sách token hạn chế và các câu hỏi của người dùng nằm trong phạm vi hẹp, xác định.
Ngược lại, bạn bắt buộc phải nâng cấp lên Agentic RAG khi hệ thống cần tổng hợp tri thức từ nhiều nguồn không đồng nhất (Vector DB, Web Search, API bên ngoài), giải quyết các câu hỏi phức tạp đòi hỏi phân rã đa bước, hoặc ứng dụng trong các lĩnh vực yêu cầu kiểm soát triệt để hiện tượng ảo giác (hallucination) bằng các vòng lặp xác thực khắt khe.
Tài liệu tham khảo
- EP230: RAG vs Agentic RAG — ByteByteGo
- What Is Agentic RAG? From LLM RAG to AI Agents — Weaviate
- Self-Reflective RAG with LangGraph — LangChain
- Build a Custom RAG Agent with LangGraph — LangChain Docs
- Agentic Strategies Guide — LlamaIndex Documentation
- Create an Agentic RAG Application with LlamaIndex and Mistral on Amazon Bedrock — AWS Machine Learning Blog
- Advanced RAG Techniques — Pinecone Learning Center
- Corrective Retrieval Augmented Generation (CRAG) — arXiv:2401.15884