LLM Chaining là kỹ thuật kiến trúc chia nhỏ một tác vụ xử lý ngôn ngữ phức tạp thành nhiều tác vụ phụ (subtasks) được thực thi nối tiếp hoặc song song, trong đó dữ liệu đầu ra của mắt xích trước được biến đổi và đóng vai trò làm đầu vào cho mắt xích tiếp theo.
Khi thiết kế hệ thống trí tuệ nhân tạo (AI) trong môi trường sản xuất (production), nguyên tắc hạ tầng tiên quyết là luôn bắt đầu với giải pháp tối giản nhất: một prompt đơn lẻ (monolithic prompt) được tối ưu hóa kết hợp cùng kỹ thuật RAG (Retrieval-Augmented Generation) hoặc vài ví dụ mẫu ngay trong ngữ cảnh (in-context few-shot learning).
Bạn chỉ nên quyết định chuyển đổi sang kiến trúc LLM Chaining khi có số liệu đo lường thực nghiệm (eval metrics) chứng minh prompt đơn lẻ đã chạm trần hiệu năng hệ thống. Các dấu hiệu kỹ thuật cảnh báo bao gồm việc mô hình thường xuyên bỏ sót chỉ dẫn (task dropping), tạo ảo giác (hallucinations) khi xử lý ngữ cảnh dài, hoặc khi giao diện dữ liệu đầu ra đòi hỏi tính cấu trúc nghiêm ngặt cùng cơ chế kiểm duyệt an toàn độc lập trước khi đẩy sang các dịch vụ downstream.
Lựa chọn LLM Chaining đồng nghĩa với việc bạn chấp nhận một bài toán đánh đổi (trade-off) kỹ thuật trực tiếp: đánh đổi độ chính xác và khả năng kiểm soát tác vụ lấy độ trễ tích lũy (cumulative latency), chi phí gọi API tăng vọt và độ phức tạp trong vận hành hệ thống phân tán. Nếu thiếu một khung đánh giá diện rộng, việc lạm dụng tách chuỗi sẽ biến hạ tầng AI thành một hệ thống cồng cềnh, phát sinh điểm nghẽn P99 latency và cực kỳ khó truy vết sự cố.
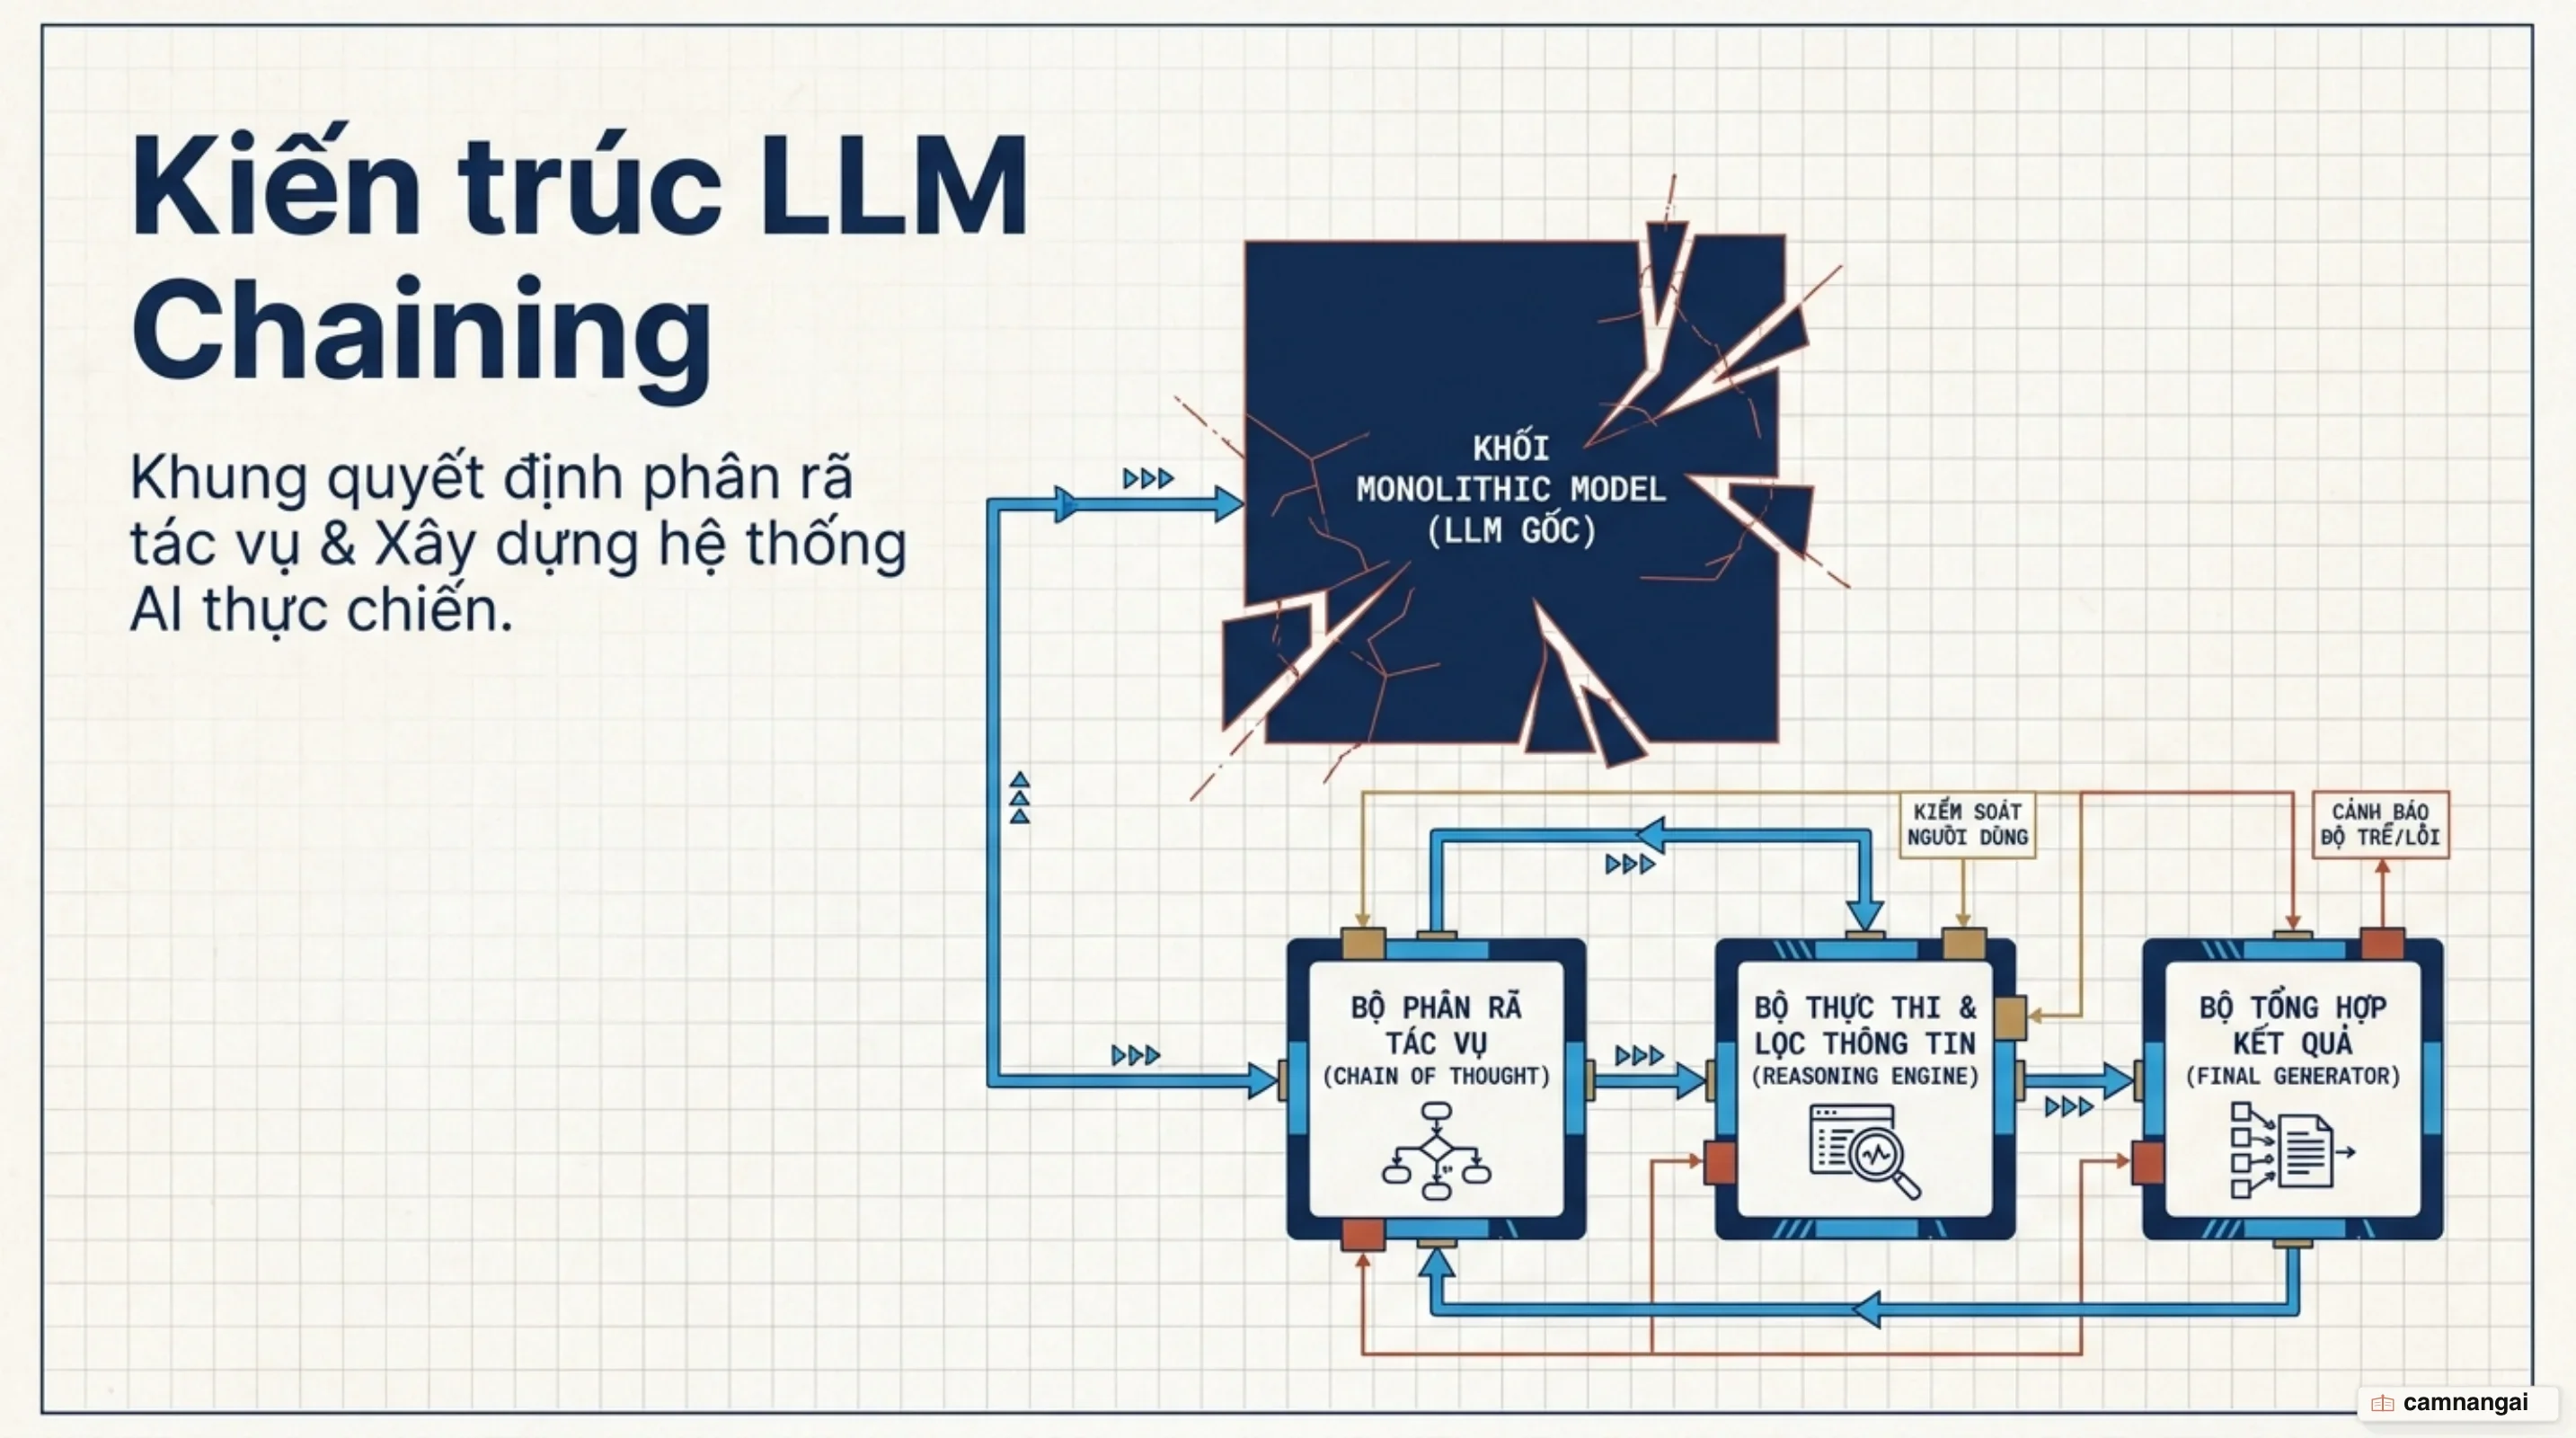
Tình thế tiến thoái lưỡng nan: Một prompt đơn lẻ hay một chuỗi LLM?
Khi bạn dồn toàn bộ quy trình nghiệp vụ vào một monolithic prompt (yêu cầu mô hình vừa đọc hiểu ngữ cảnh rộng, vừa lọc thông tin nhạy cảm PII, vừa phân tích suy luận logic, đồng thời phải trả về chính xác định dạng JSON Schema), bạn đang đặt cơ chế chú ý (attention mechanism) của mô hình ngôn ngữ lớn (LLM) dưới một áp lực tải nhận thức cực hạn. Trong kiến trúc Transformer, khi độ dài context window và số lượng chỉ dẫn ràng buộc tăng lên, mật độ phân bổ trọng số attention cho từng chỉ dẫn riêng biệt sẽ bị suy giảm đáng kể.
Hệ quả trực tiếp trong vận hành là hiện tượng bỏ sót chỉ dẫn (task dropping) và gia tăng tỷ lệ sai lệch stochastic output. Mô hình có thể hoàn thành xuất sắc phần trích xuất tri thức nhưng lại bỏ quên yêu cầu format trường dữ liệu, hoặc tuân thủ đúng định dạng JSON nhưng lại bỏ qua bước kiểm duyệt an toàn nội dung. Khi hệ thống phải phục vụ lượng truy cập lớn với các cam kết SLA (Service Level Agreement) khắt khe, tính thiếu ổn định này của monolithic prompt sẽ trực tiếp làm gián đoạn luồng xử lý của toàn bộ dịch vụ.
Ngoài ra, việc duy trì và thử nghiệm một monolithic prompt trong quy trình CI/CD là một bài toán hóc chuẩn mực. Khi bạn tinh chỉnh một vài câu từ trong prompt để khắc phục lỗi ảo giác ở bước phân tích logic, thay đổi này có thể vô tình phá vỡ khả năng ép cấu trúc JSON ở đầu ra. Nếu không có một bộ tự động hóa evals đồ sộ với hàng nghìn mẫu thử, việc cập nhật một prompt khổng lồ luôn ẩn chứa rủi ro gây sụp đổ dây chuyền hệ thống mà bạn không thể lường trước.
LLM Chaining giải quyết triệt để tình thế tiến thoái lưỡng nan này bằng tư duy kiến trúc "chia để trị" (divide and conquer). Hệ thống tách tác vụ tổng thể thành một mạng lưới các mắt xích độc lập, trong đó mỗi lần gọi LLM chỉ gánh vác một nhiệm vụ đơn hẹp. Trạng thái hệ thống (system state) và dữ liệu trung gian được chuyển giao giữa các mắt xích thông qua các bộ chuyển đổi mã nguồn (programmatic transformers).
Xét trên khía cạnh phân loại kiến trúc hệ thống AI, bạn cần phân biệt ranh giới rõ ràng giữa Workflows và Agents dựa trên mức độ kiểm soát luồng thực thi:
- Workflows (Quy trình cố định): Là hệ thống trong đó đường đi của dữ liệu, thứ tự gọi LLM và các công cụ bổ trợ được định nghĩa cứng bằng mã nguồn (predefined code paths). Luồng thực thi mang tính xác định (deterministic), dự đoán được và cực kỳ ổn định.
- Agents (Tác tử tự do): Là hệ thống trong đó LLM đóng vai trò bộ não điều phối tự động, tự lập kế hoạch và quyết định vòng lặp gọi công cụ (tool calling) dựa trên phản hồi động từ môi trường thực thi.
LLM Chaining chính là cốt lõi của nhóm Workflows. Kiến trúc này hy sinh tính linh hoạt tự do để đổi lấy độ tin cậy, khả năng kiểm toán dữ liệu và tính nhất quán tuyệt đối, những yếu tố sống còn khi vận hành hệ thống AI cấp công nghiệp.
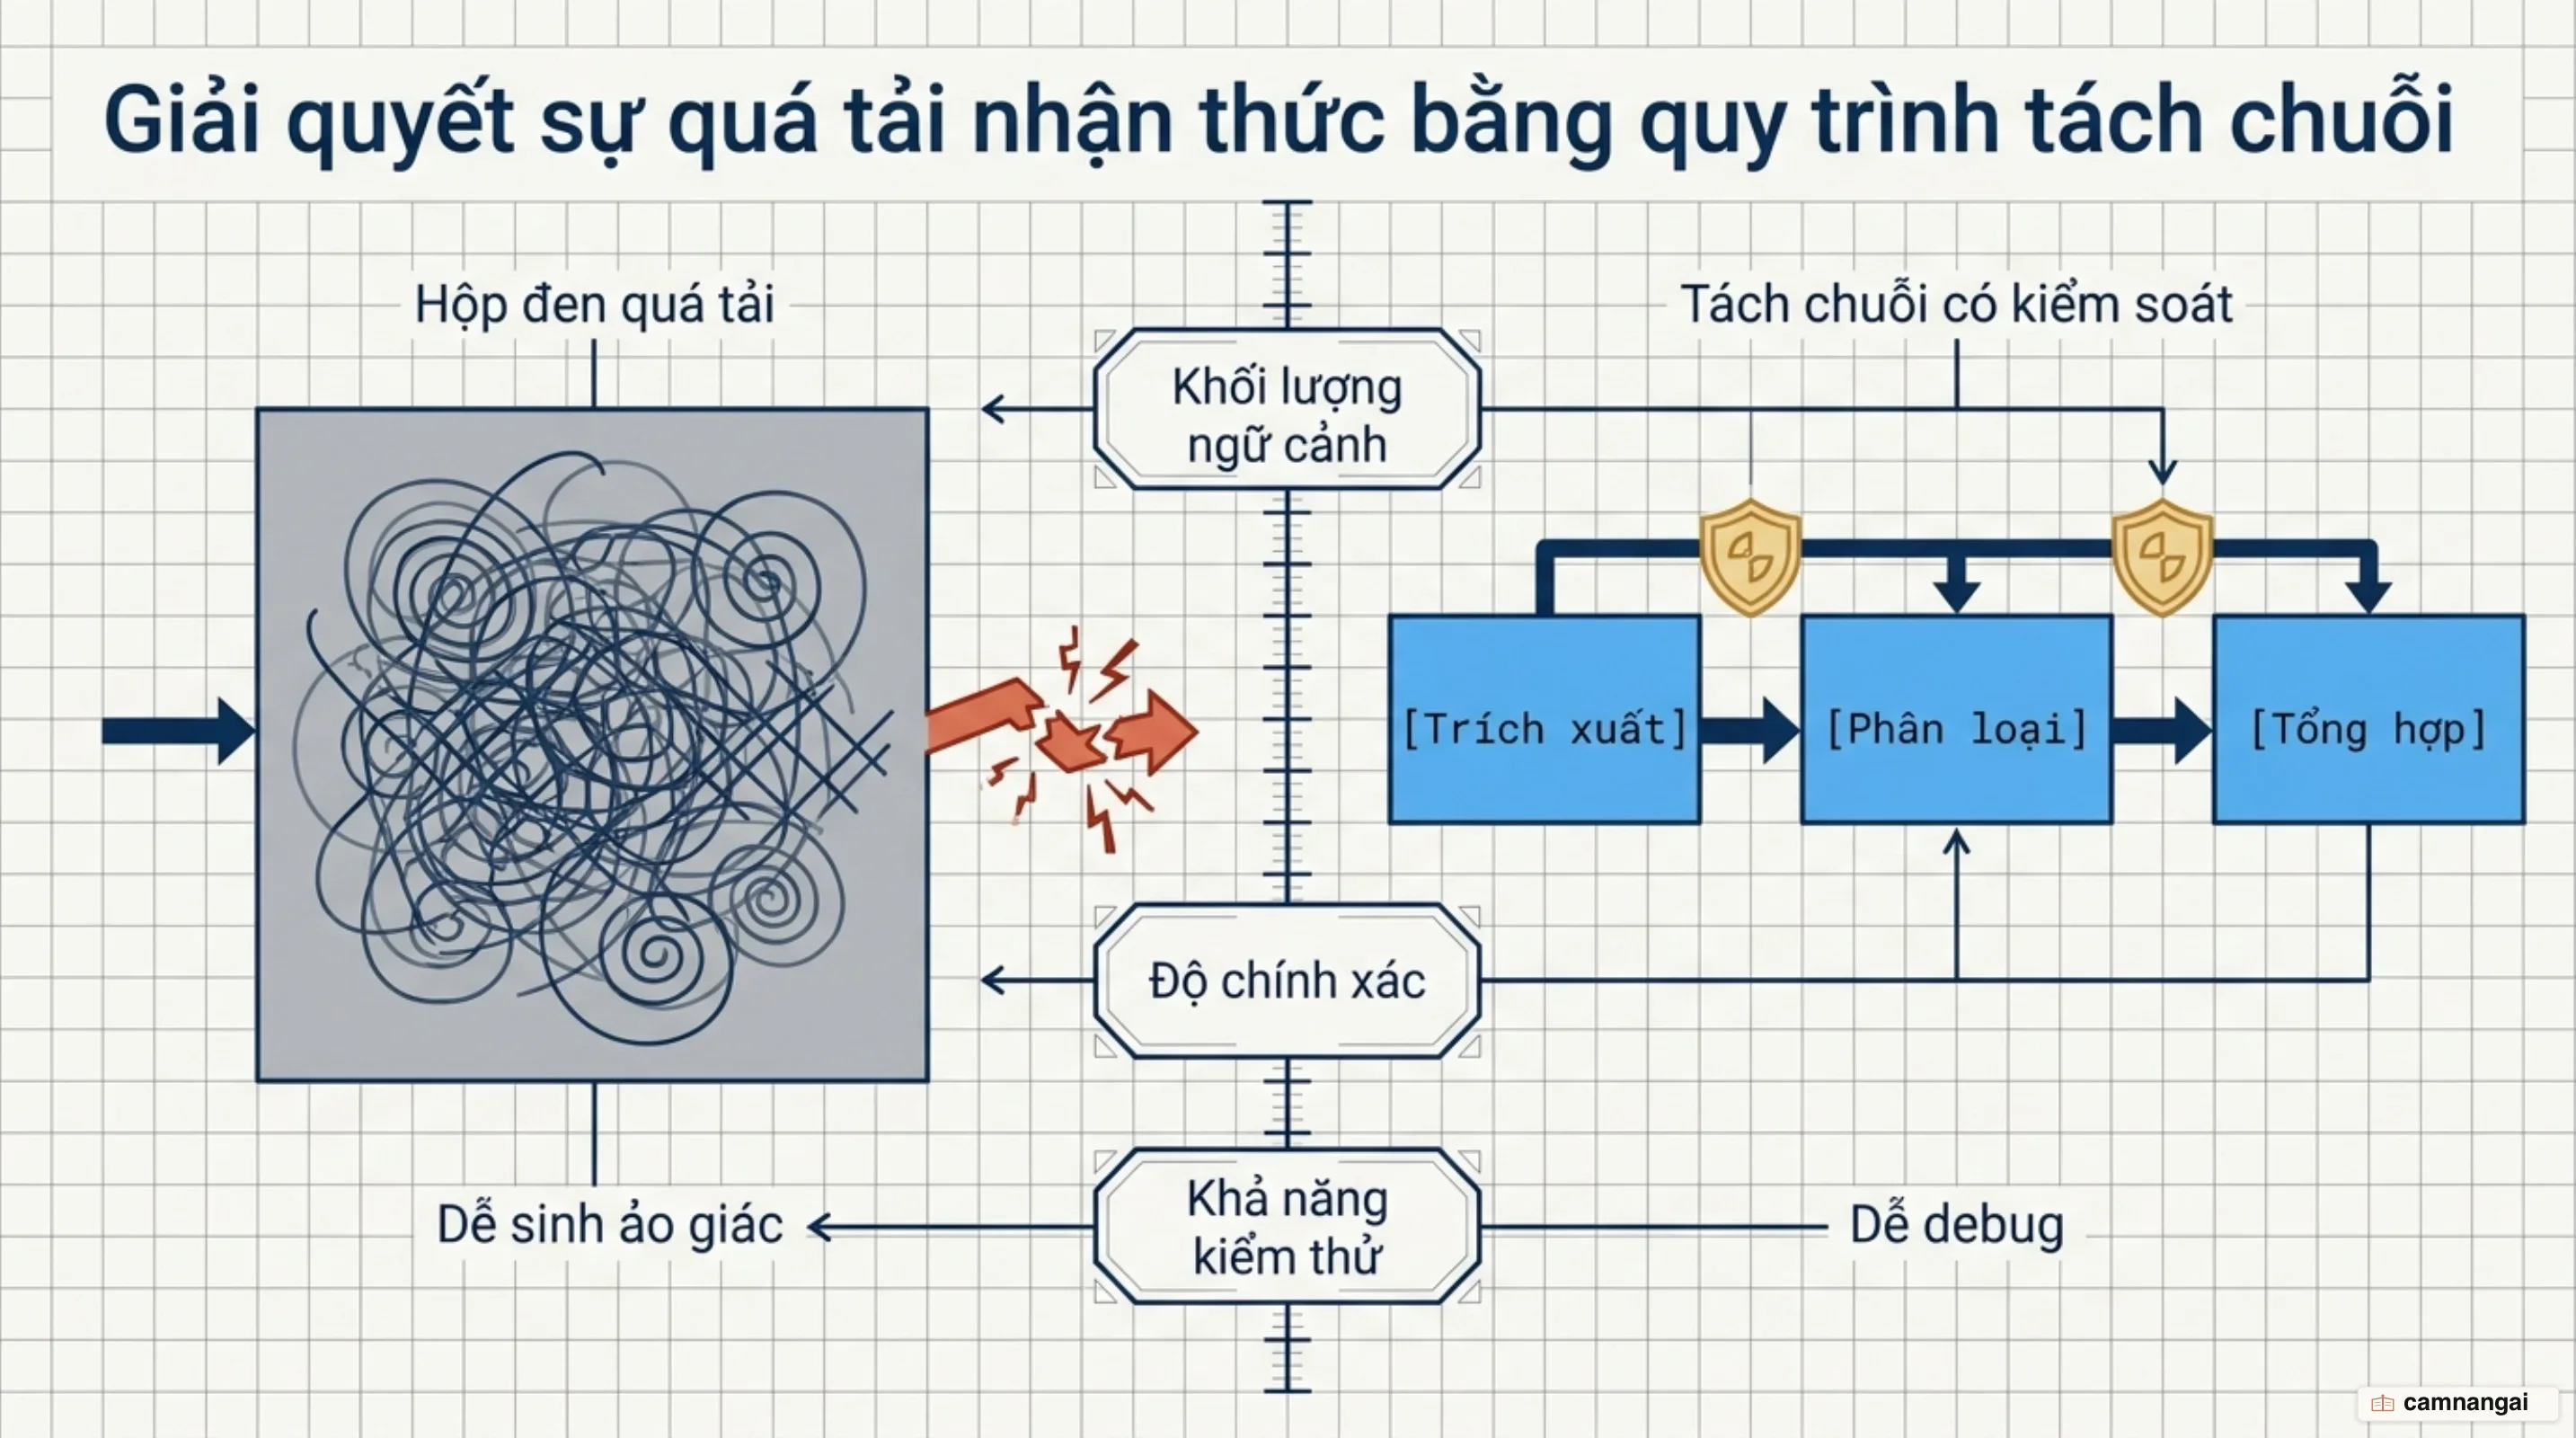
Để tối ưu hóa độ chính xác và loại bỏ ảo giác trong bài toán Hỏi-Đáp trên tài liệu doanh nghiệp dài, bạn có thể triển khai chuỗi xử lý 2 bước kết hợp cùng một cổng kiểm duyệt logic (programmatic gate):
[Đầu vào: Tài liệu gốc + Câu hỏi người dùng]
                       │
                       ▼
┌────────────────────────────────────────────────────────┐
│ Bước 1: Trích xuất trích dẫn (Quote Extraction)         │
│ - Target Model: LLM kích thước nhỏ (ví dụ: Haiku)       │
│ - Nhiệm vụ: Lọc chính xác văn bản chứa thông tin đúng   │
│ - Đầu ra: Khối văn bản chứa thẻ <quotes>...</quotes>   │
└────────────────────────────────────────────────────────┘
                       │
                       ▼
┌────────────────────────────────────────────────────────┐
│ Programmatic Gate (Cổng kiểm duyệt mã nguồn)           │
│ - Validate: Sử dụng Regex/Parser kiểm tra thẻ <quotes>  │
│ - Logic: Nếu rỗng -> Trả về "Không tìm thấy dữ liệu"   │
│ - Token Trim: Loại bỏ token thừa trước khi gửi tiếp    │
└────────────────────────────────────────────────────────┘
                       │ (Nếu <quotes> hợp lệ)
                       ▼
┌────────────────────────────────────────────────────────┐
│ Bước 2: Tổng hợp câu trả lời (Answer Composition)      │
│ - Target Model: LLM lý luận cao cấp (ví dụ: Sonnet/GPT) │
│ - Đầu vào: Khối <quotes> đã lọc + Câu hỏi ban đầu       │
│ - Nhiệm vụ: Tổng hợp câu trả lời tự nhiên và chính xác │
└────────────────────────────────────────────────────────┘
                       │
                       ▼
[Đầu ra chuẩn hóa gửi tới Người dùng / Downstream Service]
Vì sao nên dùng Chaining: Chuyên môn hóa, giảm tải nhận thức và kiểm soát
Bằng cách cô lập phạm vi xử lý cho từng mắt xích, bạn có thể thiết kế các prompt cực kỳ ngắn gọn, tập trung vào một nhiệm vụ chuyên biệt. Giới hạn ngữ cảnh hẹp không chỉ giúp triệt tiêu nguy cơ suy luận lan man mà còn gia tăng đáng kể độ ổn định của kết quả trả về. Khi mô hình không phải phân tán trọng số chú ý cho nhiều yêu cầu chồng chéo, tỷ lệ ảo giác (hallucination rate) của hệ thống sẽ giảm xuống mức tối thiểu.
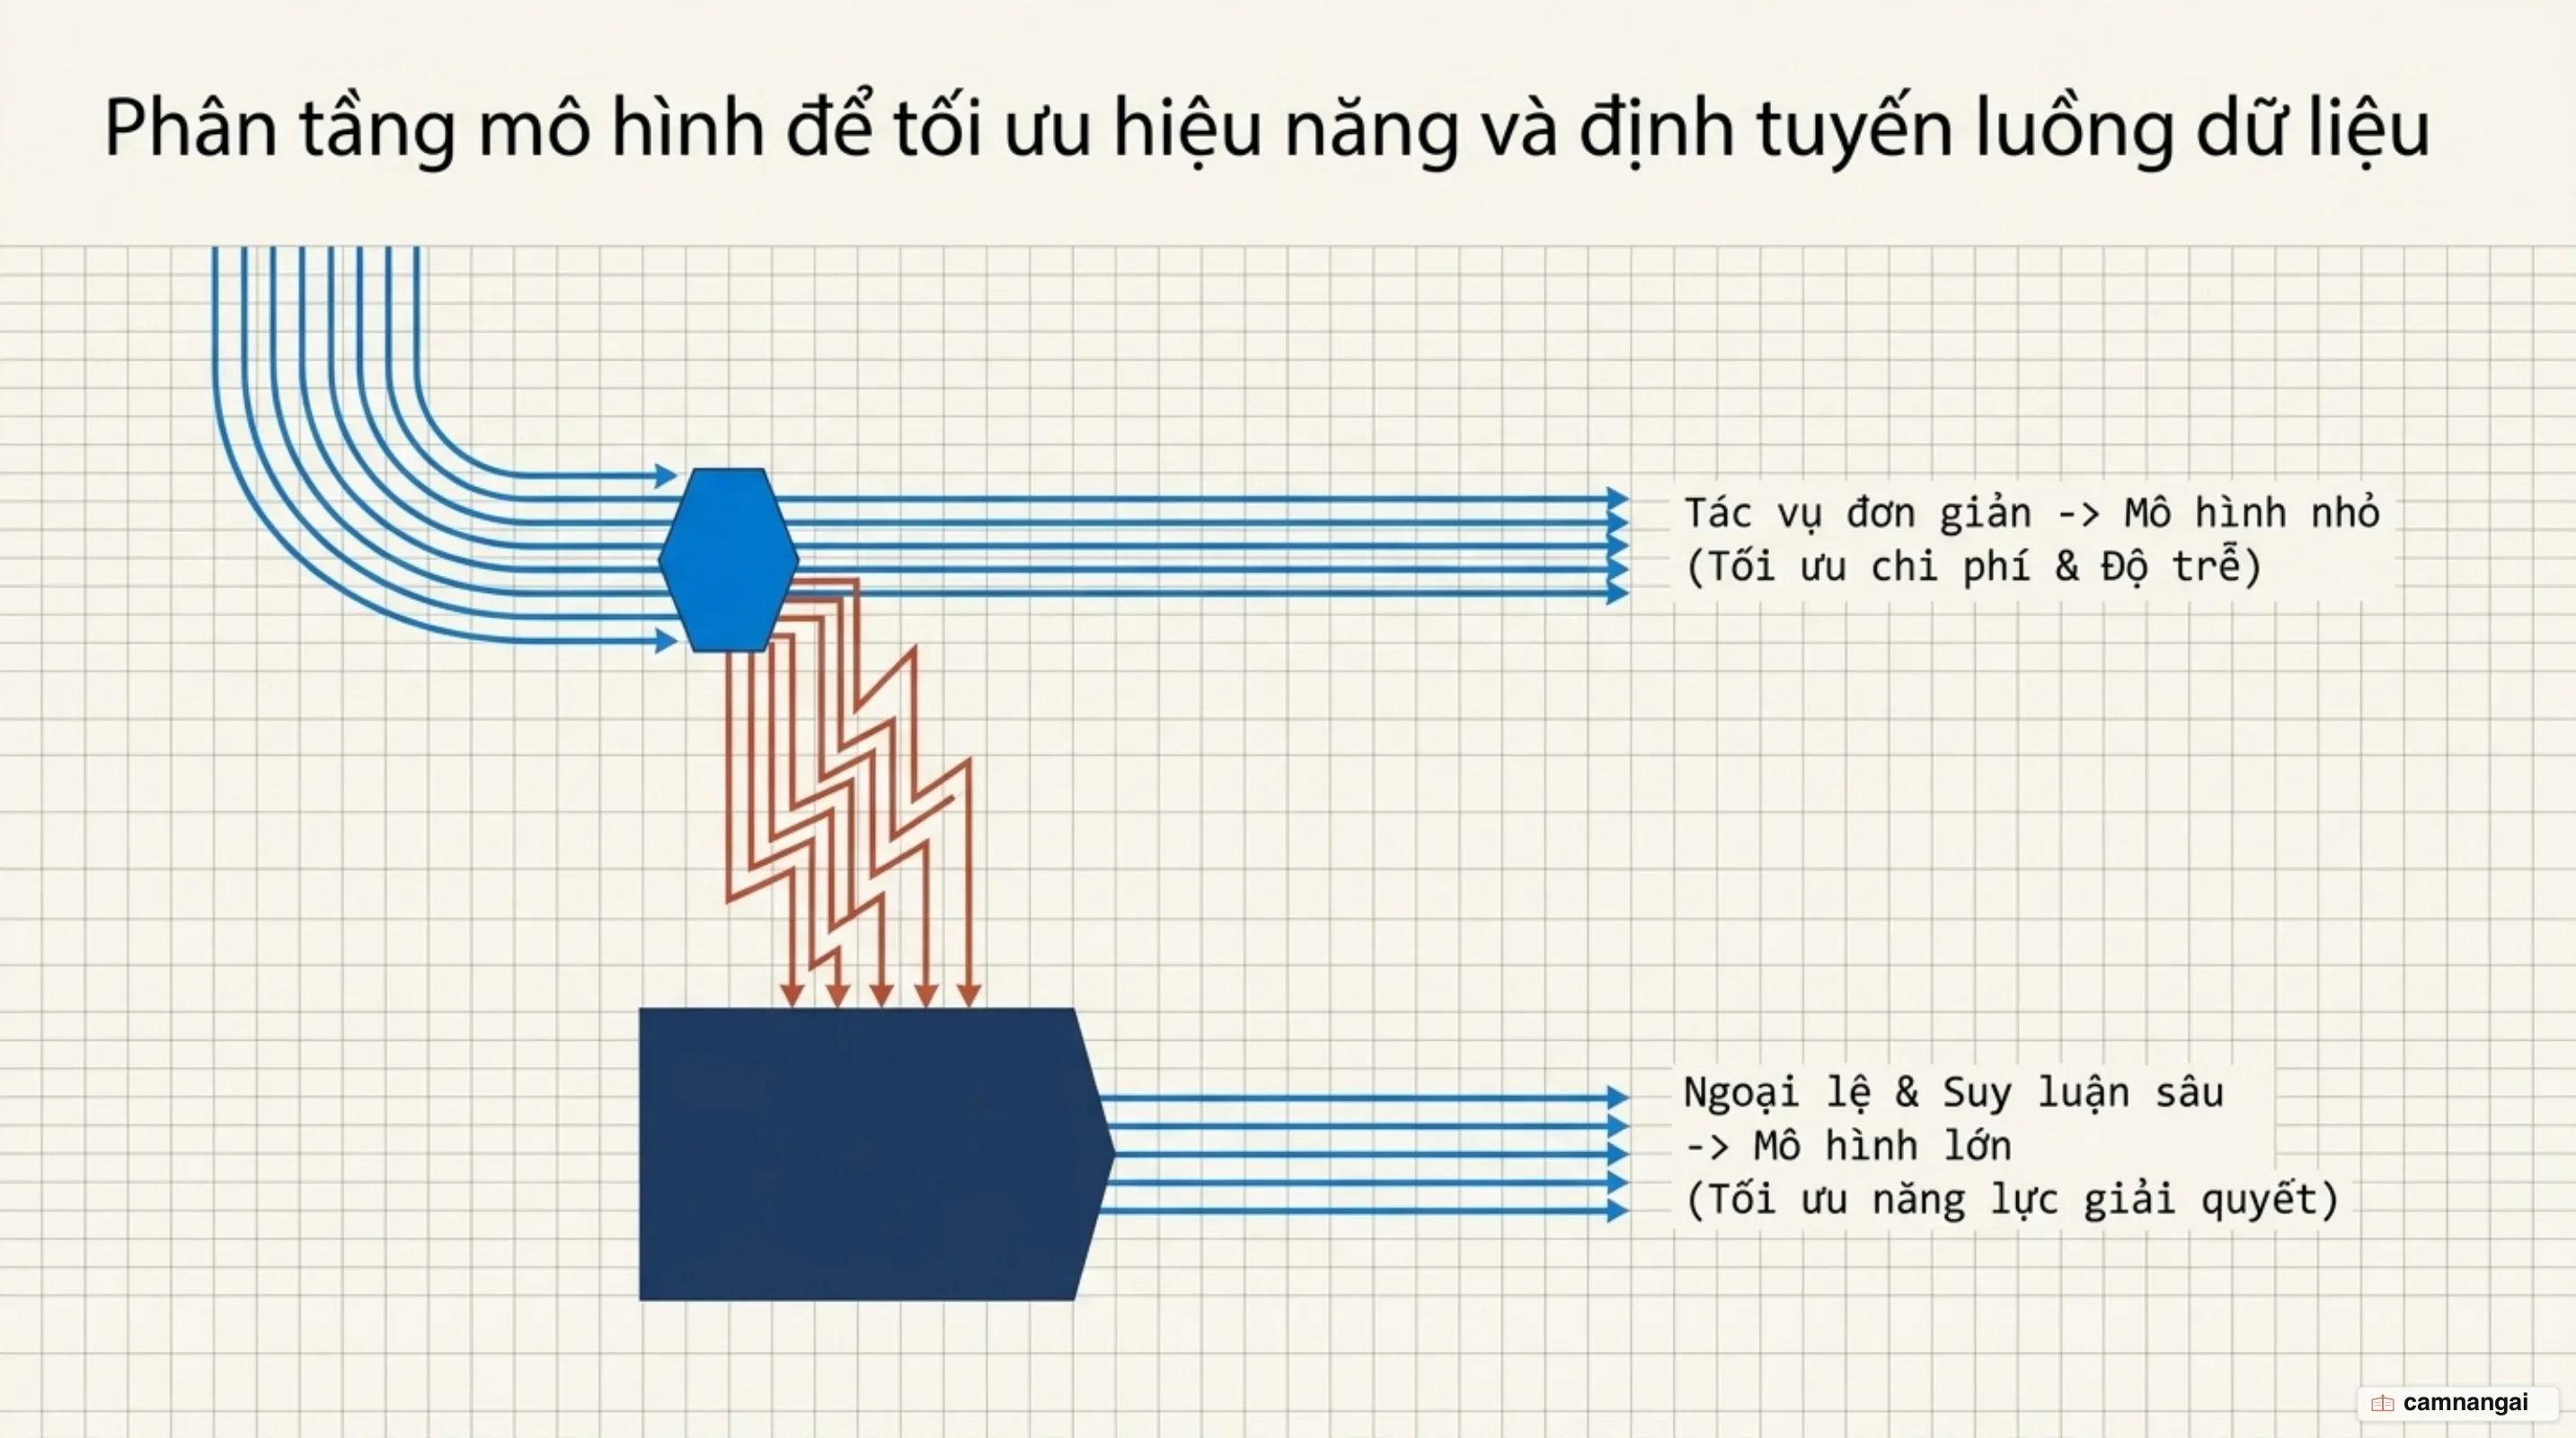
Quan trọng hơn từ góc độ hạ tầng, LLM Chaining cho phép bạn triển khai chiến lược mô hình phân tầng (Model Tiering) để tối ưu hóa bài toán chi phí và SLA hệ thống:
- Tầng mô hình tác vụ nhẹ (Ví dụ: Claude Haiku, GPT-4o-mini): Được phân công xử lý các mắt xích đầu vào có tần suất gọi cao nhưng độ phức tạp thấp như phân loại ý định (intent classification), trích xuất thực thể, hoặc định dạng lại văn bản. Tầng này giúp giảm 70-90% chi phí token và đảm bảo độ trễ trả về ở mức millisecond.
- Tầng mô hình lý luận chuyên sâu (Ví dụ: Claude Sonnet, GPT-4o): Chỉ được kích hoạt ở các mắt xích thực sự yêu cầu khả năng suy luận logic phức tạp, tổng hợp dữ liệu đa nguồn hoặc sáng tạo văn phong cao cấp.
Sự kết hợp này đảm bảo hệ thống không lãng phí tài nguyên tính toán đắt đỏ cho các tác vụ định dạng thô, giúp tối ưu tổng chi phí vận hành trên mỗi lượt request (Cost per Request) trong khi vẫn giữ vững cam kết về mặt chất lượng.
Mọi mô hình ngôn ngữ lớn (LLM) đều bị giới hạn bởi khả năng duy trì sự tập trung khi phải đồng thời cân bằng giữa nội dung suy luận và định dạng hiển thị. Khi bạn yêu cầu một LLM vừa thực hiện suy luận chuỗi logic phức tạp (Chain-of-Thought) vừa phải tuân thủ nghiêm ngặt một JSON Schema phức tạp với hàng chục trường dữ liệu, tỷ lệ vi phạm định dạng hoặc sai sót logic sẽ tăng lên theo định luật lũy thừa.
Chaining giải phóng hoàn toàn áp lực này bằng cách tách biệt hai giai đoạn "Suy luận logic" và "Đóng gói định dạng". Mắt xích đầu tiên được tự do phát sinh chuỗi suy luận bằng văn bản tự nhiên (unstructured text) để đạt độ chính xác tư duy cao nhất. Mắt xích thứ hai nhận toàn bộ kết quả suy luận đã hoàn tịnh đó và chỉ làm nhiệm vụ đọc, trích xuất, và ánh xạ dữ liệu vào JSON Schema theo đúng hợp đồng giao diện kỹ thuật.
Lợi ích cốt lõi của LLM Chaining nằm ở khả năng biến một tiến trình "hộp đen" bất định thành các khối chức năng mô-đun hóa có thể can thiệp bằng mã nguồn lập trình truyền thống. Kỹ sư hạ tầng có thể dễ dàng cài đặt các chốt chặn an toàn tại các điểm giao thoa:
- Cổng kiểm soát (Programmatic Gates): Đánh giá tính hợp lệ của dữ liệu trung gian trước khi quyết định gọi mắt xích tiếp theo. Nếu Bước N không trích xuất được thông tin cần thiết, hệ thống sẽ ngắt chuỗi ngay lập tức thay vì tiếp tục gọi API đắt đỏ ở Bước N+1.
- Lọc dữ liệu nhạy cảm (PII Redaction): Cài đặt các công cụ mã nguồn thô hoặc mô hình chuyên biệt để quét và che giấu thông tin định danh cá nhân trước khi đẩy ngữ cảnh sang các mô hình thương mại bên ngoài.
- Can thiệp bất đồng bộ của con người (Human-in-the-loop): Tạm dừng tiến trình xử lý tại các mắt xích nhạy cảm (như duyệt khoản thanh toán, phát hành tài liệu pháp lý) để chờ xác nhận từ vận hành viên trước khi tiếp tục.
Dưới góc độ kiểm thử (evals) và giám sát hạ tầng, cấu trúc chia nhỏ này cho phép bạn xây dựng bộ dữ liệu đánh giá đơn vị (unit evals) riêng biệt cho từng mắt xích. Khi hệ thống gặp sự cố trong production, bạn có thể nhanh chóng khoanh vùng chính xác mắt xích phát sinh sai số thay vì phải phỏng đoán nguyên nhân trong một câu lệnh prompt dài hàng nghìn token.
Chi phí hệ thống tiềm ẩn: Độ trễ tích lũy, lỗi dây chuyền và trôi dạt interface
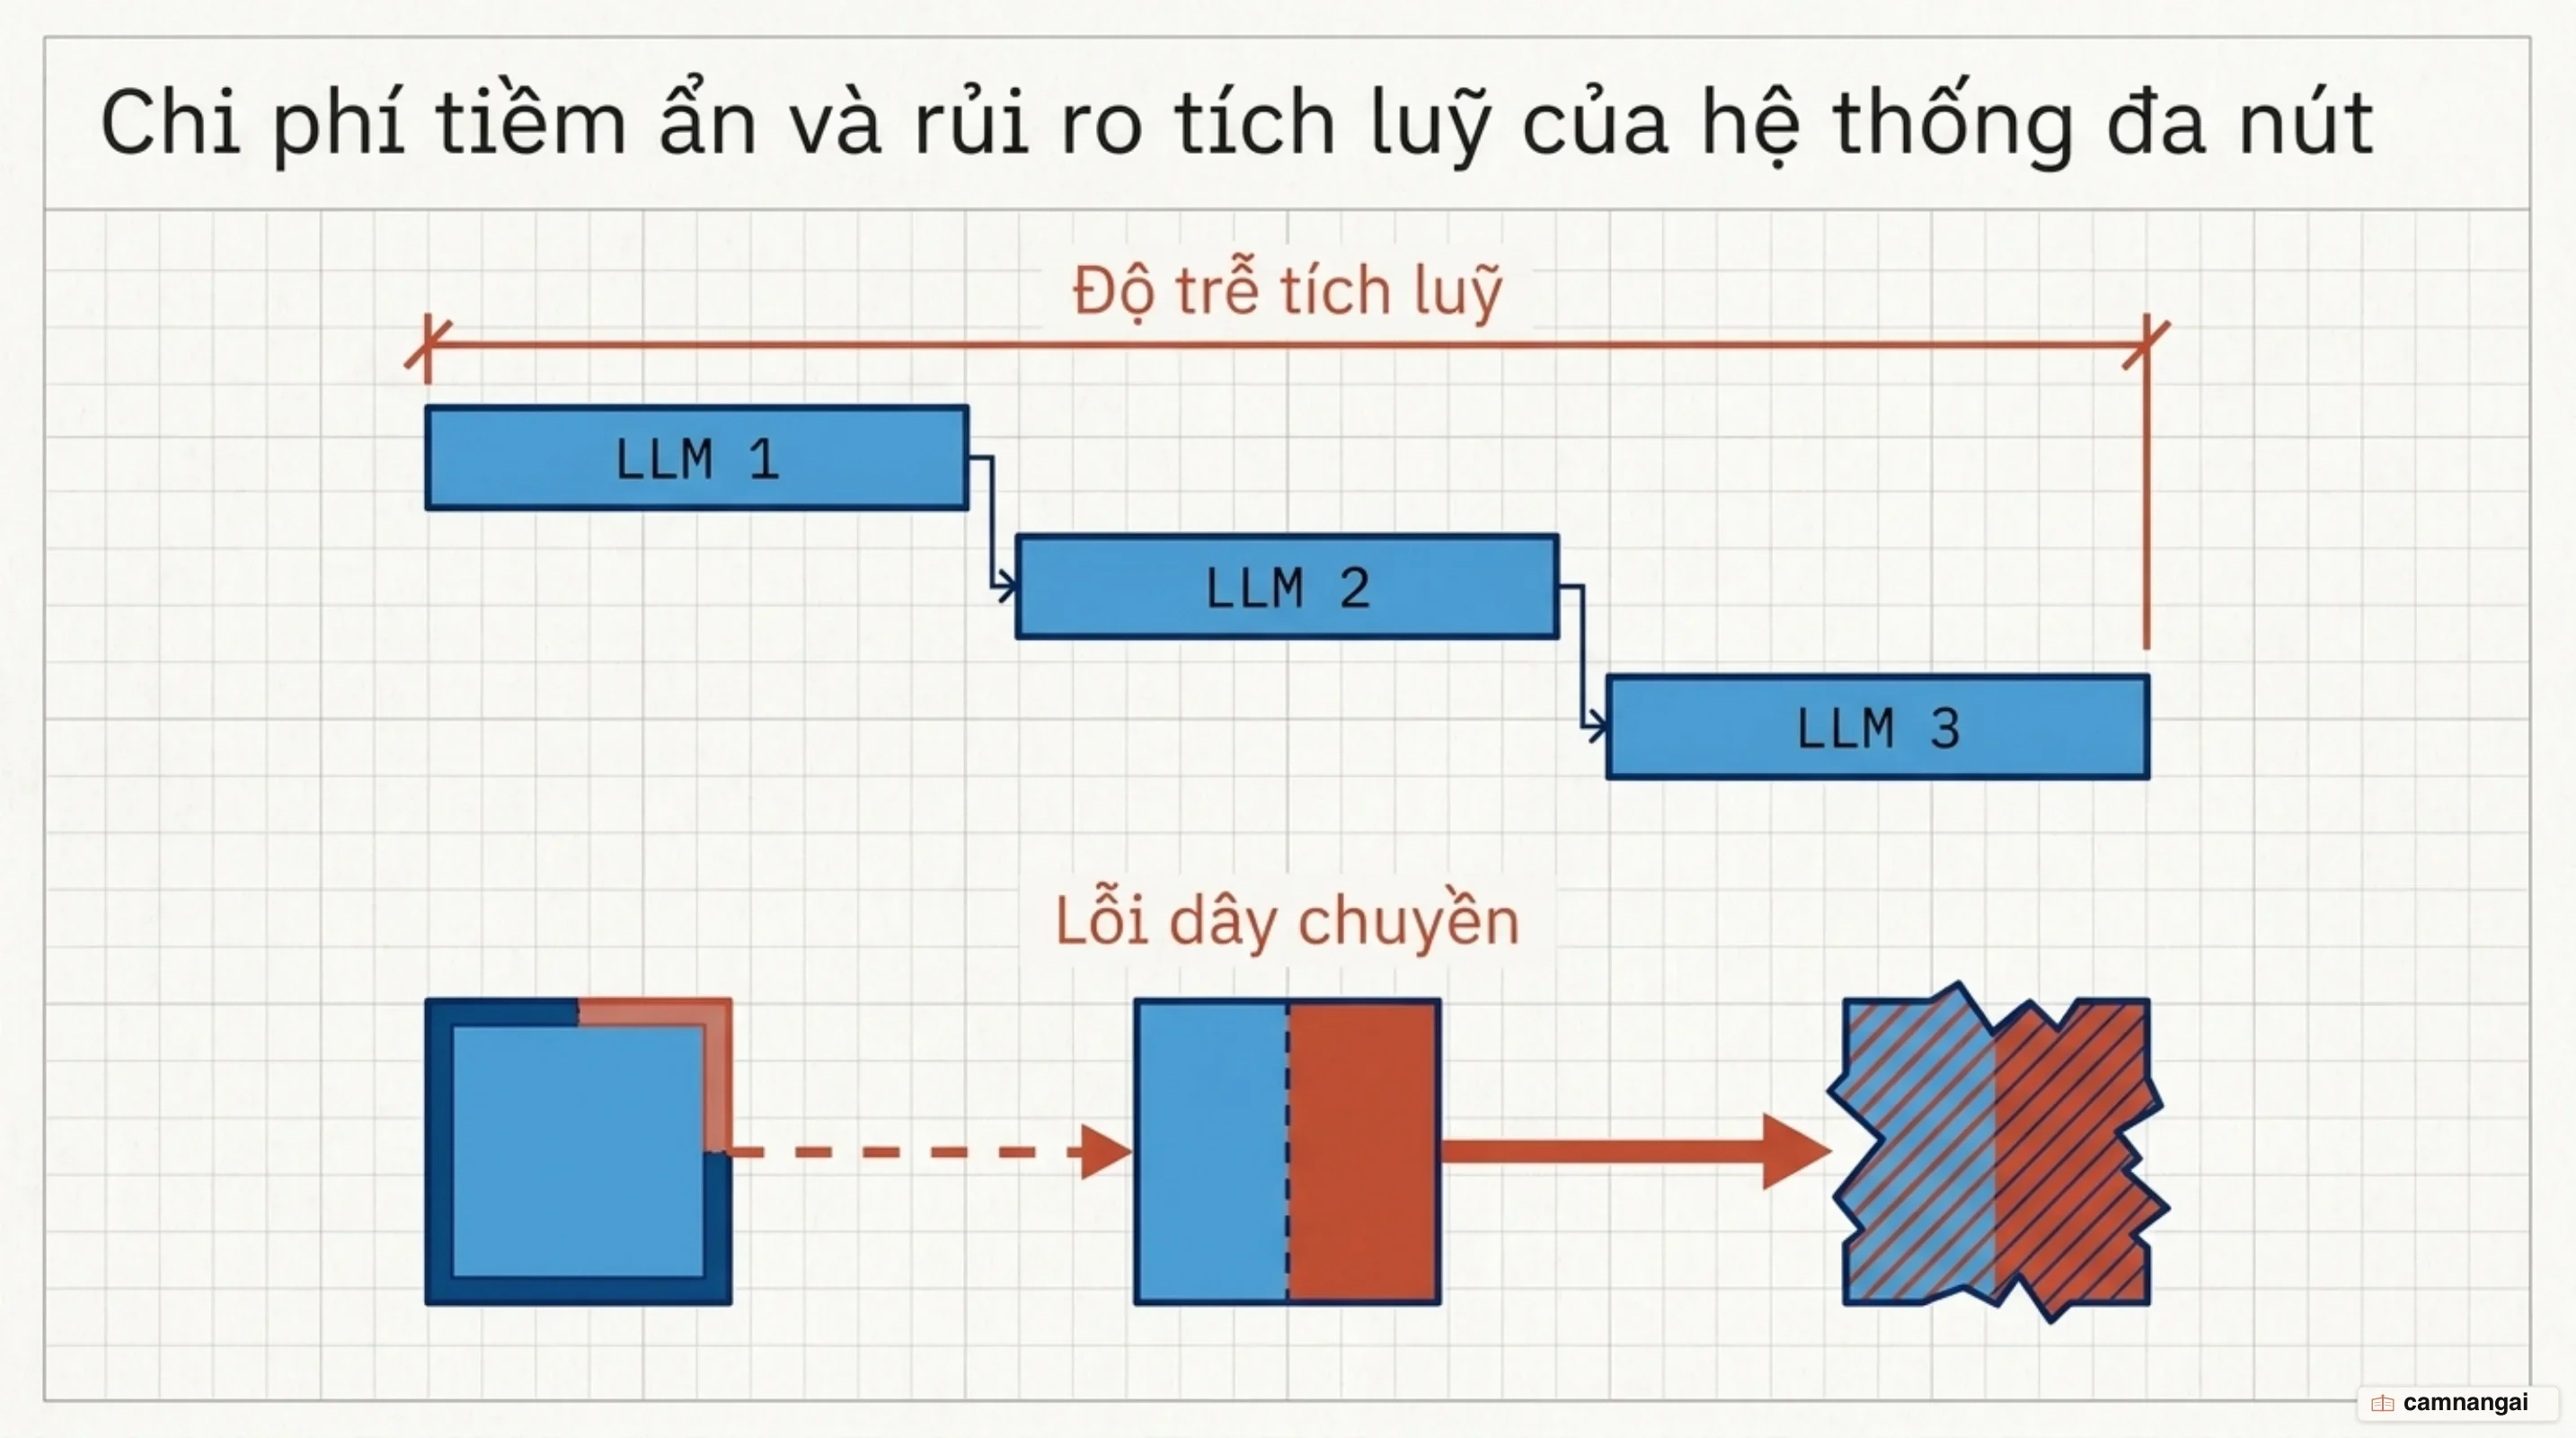
Cái giá lớn nhất mà kỹ sư AI phải trả khi chuyển sang kiến trúc LLM Chaining là sự gia tăng đột biến của độ trễ hệ thống (End-to-End Latency) và chi phí tài nguyên API. Một chuỗi xử lý gồm N mắt xích nối tiếp đồng nghĩa với việc bạn thực hiện N lượt gọi API qua môi trường mạng. Tổng độ trễ hệ thống được tính theo công thức:
Latency_total = ∑ (Network_Hop_Latency_i + Inference_Time_i)Trong môi trường production, độ trễ P99 của hệ thống sẽ bị ảnh hưởng nghiêm trọng bởi hiện tượng cộng dồn này. Chỉ cần một mắt xích gặp tình trạng nghẽn mạng hoặc suy giảm tốc độ suy luận (inference degradation), toàn bộ quy trình phía sau sẽ bị trì hoãn, đẩy tổng thời gian phản hồi lên mức hàng chục giây.
Đặc biệt, Chaining gây ra một điểm nghẽn hạ tầng cực kỳ nghiêm trọng đối với trải nghiệm người dùng: sự sụp đổ của khả năng truyền tải dữ liệu dạng dòng (Streaming Blocking / Loss of Time-to-First-Token - TTFT). Trong các ứng dụng tương tác trực tiếp như Chatbot hay Voice Agent, việc phản hồi từng token ngay lập tức (Streaming TTFT) là yếu tố quyết định UX. Tuy nhiên, khi áp dụng chuỗi tuần tự LLM_1 → LLM_2, mắt xích LLM_2 bắt buộc phải chờ LLM_1 hoàn tất 100% câu trả lời, tiến hành parse JSON/XML thành công thì mới có thể bắt đầu phiên suy luận của mình. Điều này hoàn toàn triệt tiêu khả năng Stream dữ liệu thời gian thực tới người dùng cuối ở các giai đoạn trung gian, khiến người dùng phải đối mặt với khoảng thời gian "màn hình đóng băng" kéo dài.
Trong một hệ thống chuỗi nối tiếp, sai số ở mắt xích N-1 sẽ đóng vai trò là dữ liệu đầu vào nhiễu cho mắt xích N. Hiện tượng này dẫn đến sự khuếch đại lỗi theo cấp số nhân (Cascading Failures). Một hành vi lệch chuẩn nhỏ trong bước phân loại dữ liệu đầu tiên (ví dụ: nhận diện nhầm loại tài liệu) sẽ khiến toàn bộ các bước trích xuất, phân tích và tổng hợp phía sau suy luận hoàn toàn sai hướng:
[Dữ liệu đầu vào] ──► (LLM 1: Lỗi phân loại nhầm)
                            │ (Chuyển giao thông tin sai)
                            ▼
                      (LLM 2: Trích xuất sai dữ liệu)
                            │ (Khuếch đại suy luận rác)
                            ▼
                      (LLM 3: Tạo báo cáo hoàn toàn vô giá trị)
Sự cố dây chuyền này gây ra khó khăn cực lớn cho công tác truy vết nguyên nhân gốc (root cause analysis). Nếu không có hạ tầng lưu trữ toàn bộ lịch sử trạng thái trung gian (payload state tracking), kỹ sư vận hành sẽ không thể xác định được sự cố xuất phát từ bản thân mô hình LLM_3 yếu kém hay do mô hình LLM_1 đã truyền dữ liệu đầu vào bị nhiễm độc.
Bản chất của các mô hình ngôn ngữ lớn là tính bất định (stochastic nature). Dù bạn có thiết lập tham số temperature = 0, mô hình vẫn có xác suất trả về cấu trúc dữ liệu bị trôi dạt (Interface Drift), ví dụ như tự ý bổ sung các ký tự xuống dòng rỗng, bao bọc chuỗi JSON trong thẻ markdown codeblock (```json ... ```), hoặc thay đổi kiểu dữ liệu của một key từ List[str] sang str.
Nếu giao diện trung gian giữa LLM_1 và LLM_2 không được bảo vệ bằng các lớp ràng buộc dữ liệu (Data Contracts) nghiêm ngặt, bất kỳ sự trôi dạt định dạng nào từ LLM_1 cũng sẽ lập tức làm vỡ bộ parse dữ liệu của hệ thống, gây ra ngoại lệ mã nguồn (Runtime Exception) và làm sụp đổ tiến trình xử lý ngay tại trận.
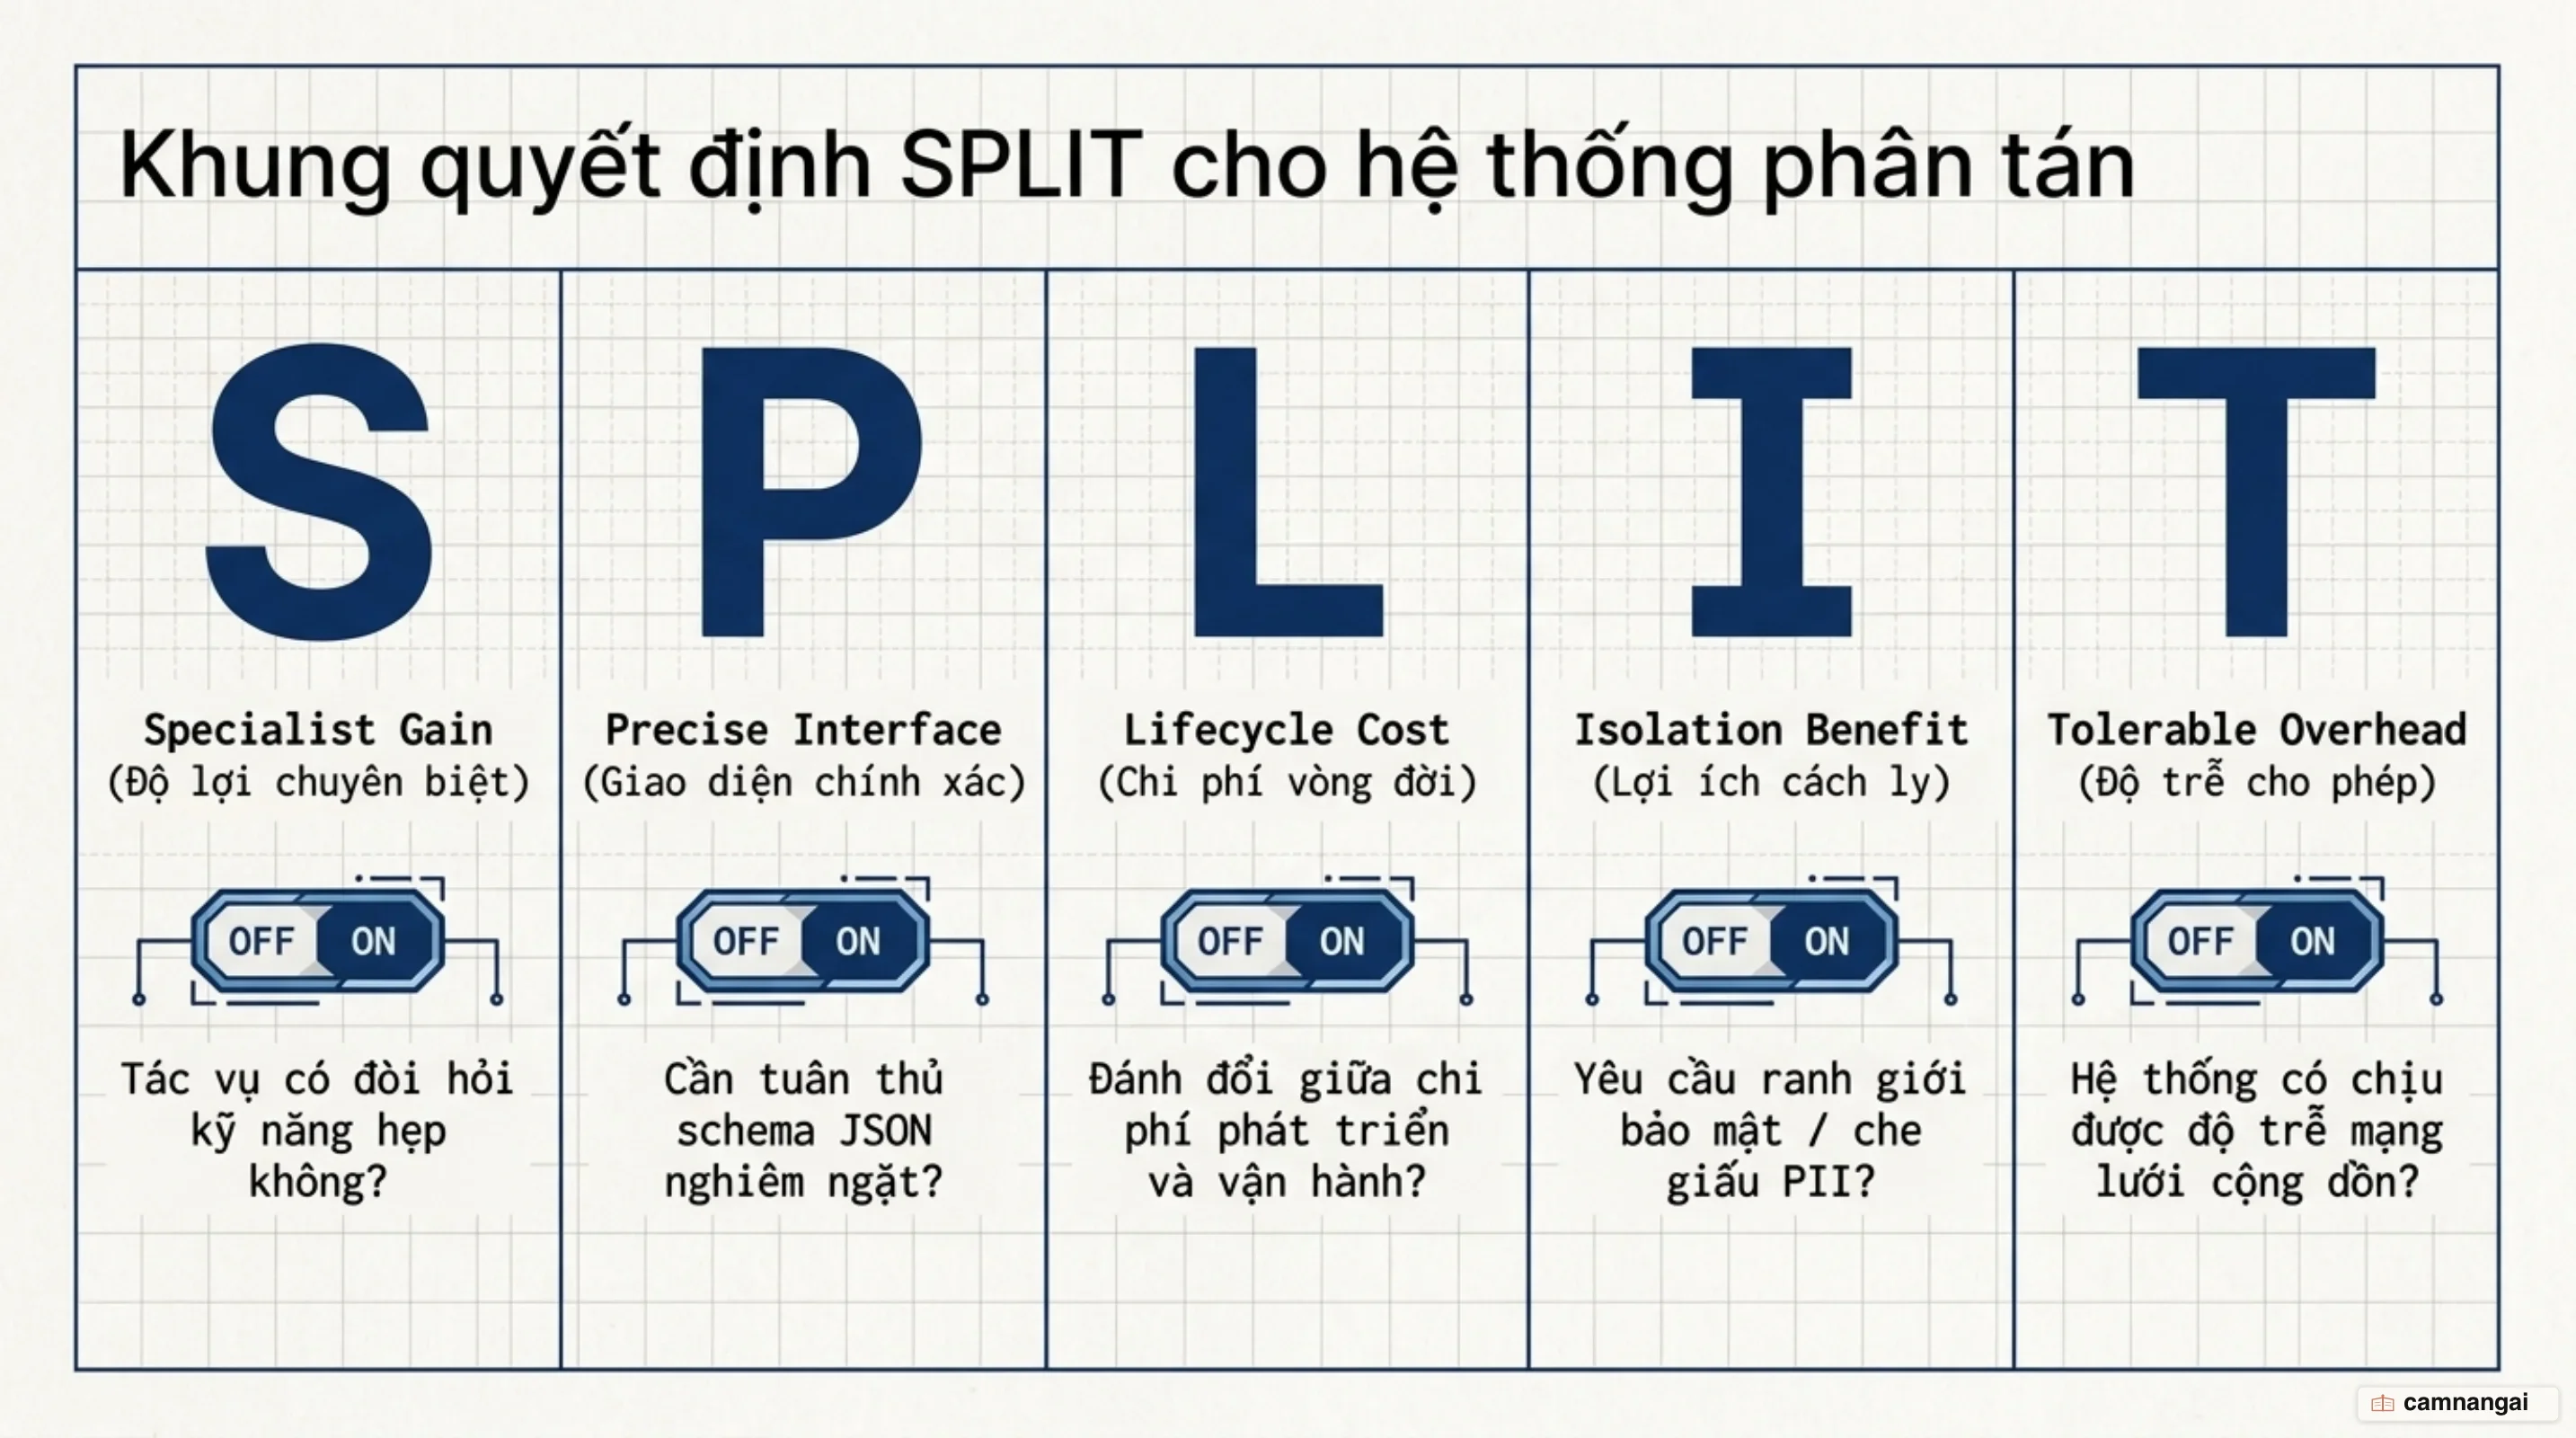
Khung quyết định SPLIT: 5 tiêu chí xác định thời điểm nên tách chuỗi
Để ngăn chặn bẫy phức tạp hóa hệ thống không cần thiết (over-engineering), bạn bắt buộc phải tiến hành phân tích hạ tầng qua Khung quyết định SPLIT trước khi quyết định bẻ đôi một prompt đơn lẻ:
- S - Specialist Gain (Lợi ích chuyên môn hóa): Bạn phải đo lường chính xác mức độ cải thiện hiệu năng (độ chính xác, F1-score, hay tỷ lệ ảo giác) khi chuyển một tác vụ phụ sang cho một mô hình hoặc prompt chuyên biệt. Lợi ích này có đủ lớn để bù đắp cho độ trễ bổ sung và chi phí tính toán phát sinh hay không? Nếu việc tách chuỗi chỉ mang lại mức tăng trưởng hiệu năng 1-2% trên tập evals, giải pháp tối ưu hạ tầng là giữ nguyên prompt đơn lẻ.
- P - Precise Interface (Giao diện chính xác): Mắt xích này có đòi hỏi khắt khe về tính cấu trúc của dữ liệu đầu ra để tích hợp vào các hệ thống phần mềm truyền thống bên dưới (như cơ sở dữ liệu SQL, gRPC service, API bên thứ ba) hay không? Nếu một monolithic prompt thường xuyên làm vỡ cấu trúc JSON Schema hoặc trả về sai kiểu dữ liệu khi gánh vác đồng thời nhiệm vụ suy luận, việc tách riêng bước này thành một mắt xích đóng gói định dạng chuyên biệt là quyết định hạ tầng bắt buộc.
- L - Lifecycle Cost (Chi phí vòng đời hệ thống): Tính toán đầy đủ tổng chi phí vận hành trong suốt vòng đời ứng dụng, bao gồm: chi phí gọi API token, độ trễ cộng dồn ảnh hưởng tới SLA, thời gian phát triển mã nguồn orchestration, và công sức bảo trì hệ thống CI/CD khi tinh chỉnh prompt. Một kiến trúc tách chuỗi chỉ đạt tiêu chuẩn vận hành khi nó giảm được tổng chi phí tài nguyên (nhờ Model Tiering) hoặc giảm thiểu đáng kể thời gian debug trong production.
- I - Isolation Benefit (Lợi ích cô lập): Đánh giá mức độ cần thiết của việc tách biệt không gian xử lý nhằm phục vụ các yêu cầu về an toàn, bảo mật và tuân thủ pháp lý. Việc cô lập bước lọc dữ liệu nhạy cảm (PII Redaction), bước chặn tấn công Prompt Injection, hay bước kiểm duyệt nội dung độc hại (Guardrails) thành các mắt xích độc lập giúp bảo vệ mô hình lõi khỏi các nguy cơ an ninh mạng và đơn giản hóa quy trình kiểm toán tuân thủ.
- T - Tolerable Overhead (Mức độ overhead chấp nhận được): Hệ thống và trải nghiệm người dùng (UX) có chịu đựng được các chi phí phát sinh từ kiến trúc phân tán hay không? Hãy phân tích khắt khe xem liệu ứng dụng của bạn có bị phá vỡ cam kết độ trễ khi mất đi khả năng Stream token trực tiếp tới màn hình người dùng hay không. Các hệ thống thời gian thực (Real-time Chatbots) có mức chịu đựng overhead rất thấp, trong khi các hệ thống xử lý bất đồng bộ theo lô (Batch Processing) lại dễ dàng chấp nhận overhead này.
Bảng dưới đây tóm tắt các trường hợp nên và không nên áp dụng kỹ thuật tách chuỗi:
| Tiêu chí SPLIT | Trường hợp NÊN giữ Prompt Đơn | Trường hợp NÊN Tách Chuỗi (Chaining) |
|---|---|---|
| Specialist Gain | Một mô hình generalist xử lý đạt 90%+ chất lượng yêu cầu trên toàn bộ tác vụ. | Mô hình đơn bị giảm độ chính xác rõ rệt; cần kết hợp mô hình chuyên biệt (như Vision + Text). |
| Precise Interface | Đầu ra là văn bản tự do (unstructured text) như bài viết, email, bản tóm tắt. | Đầu ra yêu cầu JSON/Pydantic Schema chuẩn xác tuyệt đối để truyền vào hệ thống lập trình. |
| Lifecycle Cost | Yêu cầu thời gian phản hồi cực nhanh (dưới 1-2 giây) và ngân sách token hạn chế. | Chấp nhận tổng thời gian xử lý lâu hơn để đổi lấy độ tin cậy và khả năng kiểm toán quy trình. |
| Isolation Benefit | Không có yêu cầu khắt khe về kiểm duyệt an toàn hoặc lọc dữ liệu nhạy cảm theo tầng. | Cần cô lập bước lọc PII, kiểm duyệt độc hại (guardrails) hoặc bước can thiệp của con người. |
| Tolerable Overhead | Ứng dụng thời gian thực (Real-time Chatbot, Voice Agent) nhạy cảm với độ trễ. | Ứng dụng xử lý bất đồng bộ (Batch processing, phân tích tài liệu, lập báo cáo background). |
Các mẫu kiến trúc phổ biến: Sequential, Cascade, Router và Vòng lặp tự sửa lỗi
Sequential Pipeline (Chuỗi tuần tự) là mẫu kiến trúc nhập môn nhưng được ứng dụng rộng rãi nhất, trong đó dữ liệu chảy tuyến tính qua các mắt xích cố định: LLM_1 → LLM_2 → LLM_3. Mỗi mắt xích gánh vác một giai đoạn biến đổi dữ liệu rõ ràng. Kiến trúc này triệt tiêu áp lực nhận thức bằng cách chia quy trình thành chuỗi tác vụ đơn giản:
[Input Data] ──► (LLM 1: Trích xuất Context) ──► (LLM 2: Suy luận Logic) ──► (LLM 3: Format JSON) ──► [Output]Ví dụ thực chiến: Trong quy trình xử lý tài liệu hợp đồng, LLM_1 đọc tài liệu thô để trích xuất các điều khoản chính → LLM_2 phân tích rủi ro pháp lý từ các điều khoản đó → LLM_3 ánh xạ danh sách rủi ro vào định dạng bảng báo cáo JSON cho ban quản trị.
Cascade / Filter & Escalate (Phân tầng / Lọc và leo thang) là mẫu kiến trúc cốt lõi để tối ưu hóa chi phí vận hành và độ trễ P50. Hệ thống luôn ưu tiên đẩy request vào các mô hình kích thước nhỏ, tốc độ cao và chi phí thấp trước. Một bộ đánh giá độ tin cậy (Confidence Score Check) hoặc quy tắc lập trình sẽ kiểm tra đầu ra. Nếu mô hình nhỏ giải quyết được tác vụ với độ tin cậy vượt ngưỡng, kết quả sẽ được trả về ngay lập tức. Nếu gặp tác vụ khó hoặc điểm tin cậy thấp, hệ thống mới "leo thang" đẩy request sang mô hình lớn đắt đỏ hơn:
                                    ┌─► [Đủ độ tin cậy (Success)] ──► [Trả kết quả ngay]
[User Input] ──► (LLM Nhỏ: Haiku) ──┤
                                    └─► [Thất bại / Điểm thấp] ────► (LLM Lớn: Sonnet/GPT) ──► [Trả kết quả]
Router / Dispatcher (Định tuyến) áp dụng tư duy phân hóa xử lý. Một LLM đóng vai trò Bộ định tuyến (Router) sẽ đọc phân tích yêu cầu đầu vào của người dùng, phân loại nó vào một danh mục cụ thể, sau đó điều hướng request tới các chuỗi xử lý hoặc mô hình chuyên biệt tương ứng. Kiến trúc này giúp ngăn ngừa hiện tượng "một prompt gánh toàn bộ nghiệp vụ" bằng cách tạo ra các luồng xử lý riêng biệt cho từng ngữ cảnh:
                                ┌─► [Nhánh Kỹ thuật] ──► (Prompt + Tool Fix Bug)
[User Query] ──► (LLM Router) ──┼─► [Nhánh Thanh toán] ──► (Tool Tra cứu DB + LLM)
                                └─► [Nhánh Hủy Dịch vụ] ─► (LLM Chăm sóc KH)
Self-Correction / Evaluator-Optimizer (Vòng lặp tự sửa lỗi) là mẫu kiến trúc vòng lặp khép kín (feedback loop) nhằm nâng cao chất lượng đầu ra mà không cần con người can thiệp. Mắt xích Generator (Mô hình sinh) tạo ra kết quả ban đầu, mắt xích Evaluator (Mô hình đánh giá hoặc công cụ kiểm thử mã nguồn) sẽ kiểm tra kết quả dựa trên danh sách tiêu chí định sẵn. Nếu phát hiện lỗi, Evaluator sẽ tạo ra một đoạn phản hồi chi tiết (critique) để Generator tự tinh chỉnh lại sản phẩm. Vòng lặp dừng lại khi kết quả vượt qua bài kiểm tra hoặc đạt số lần thử tối đa (Max Retries):
            ┌──────────────────────────────────────────────────────────┐
            ▼                                                          │
┌─────────────────────────┐     ┌──────────────────────────┐           │ (Phản hồi sửa lỗi / Critique)
│ LLM Generator (Sinh mã) │────►│ LLM/Tool Evaluator       │───────────┤
│                         │     │ (Lập trình / Chạy Evals) │           │
└─────────────────────────┘     └──────────────────────────┘           │
                                              │                        │
                                     [Đạt tiêu chuẩn?]                 │
                                              │                        │
                                             YES                       NO
                                              ▼                        │
                                  [Đẩy vào Production] ────────────────┘
Hạ tầng bắt buộc cho production: Hợp đồng schema, Observability và Fallback
Khi bạn đưa kiến trúc LLM Chaining vào môi trường sản xuất, bạn đang thực sự vận hành một hệ thống vi dịch vụ (microservices) phân tán. Để đảm bảo tính ổn định và khả năng phục hồi của hệ thống trước các biến động ngẫu nhiên của LLM, ba thành phần hạ tầng sau đây là bắt buộc.
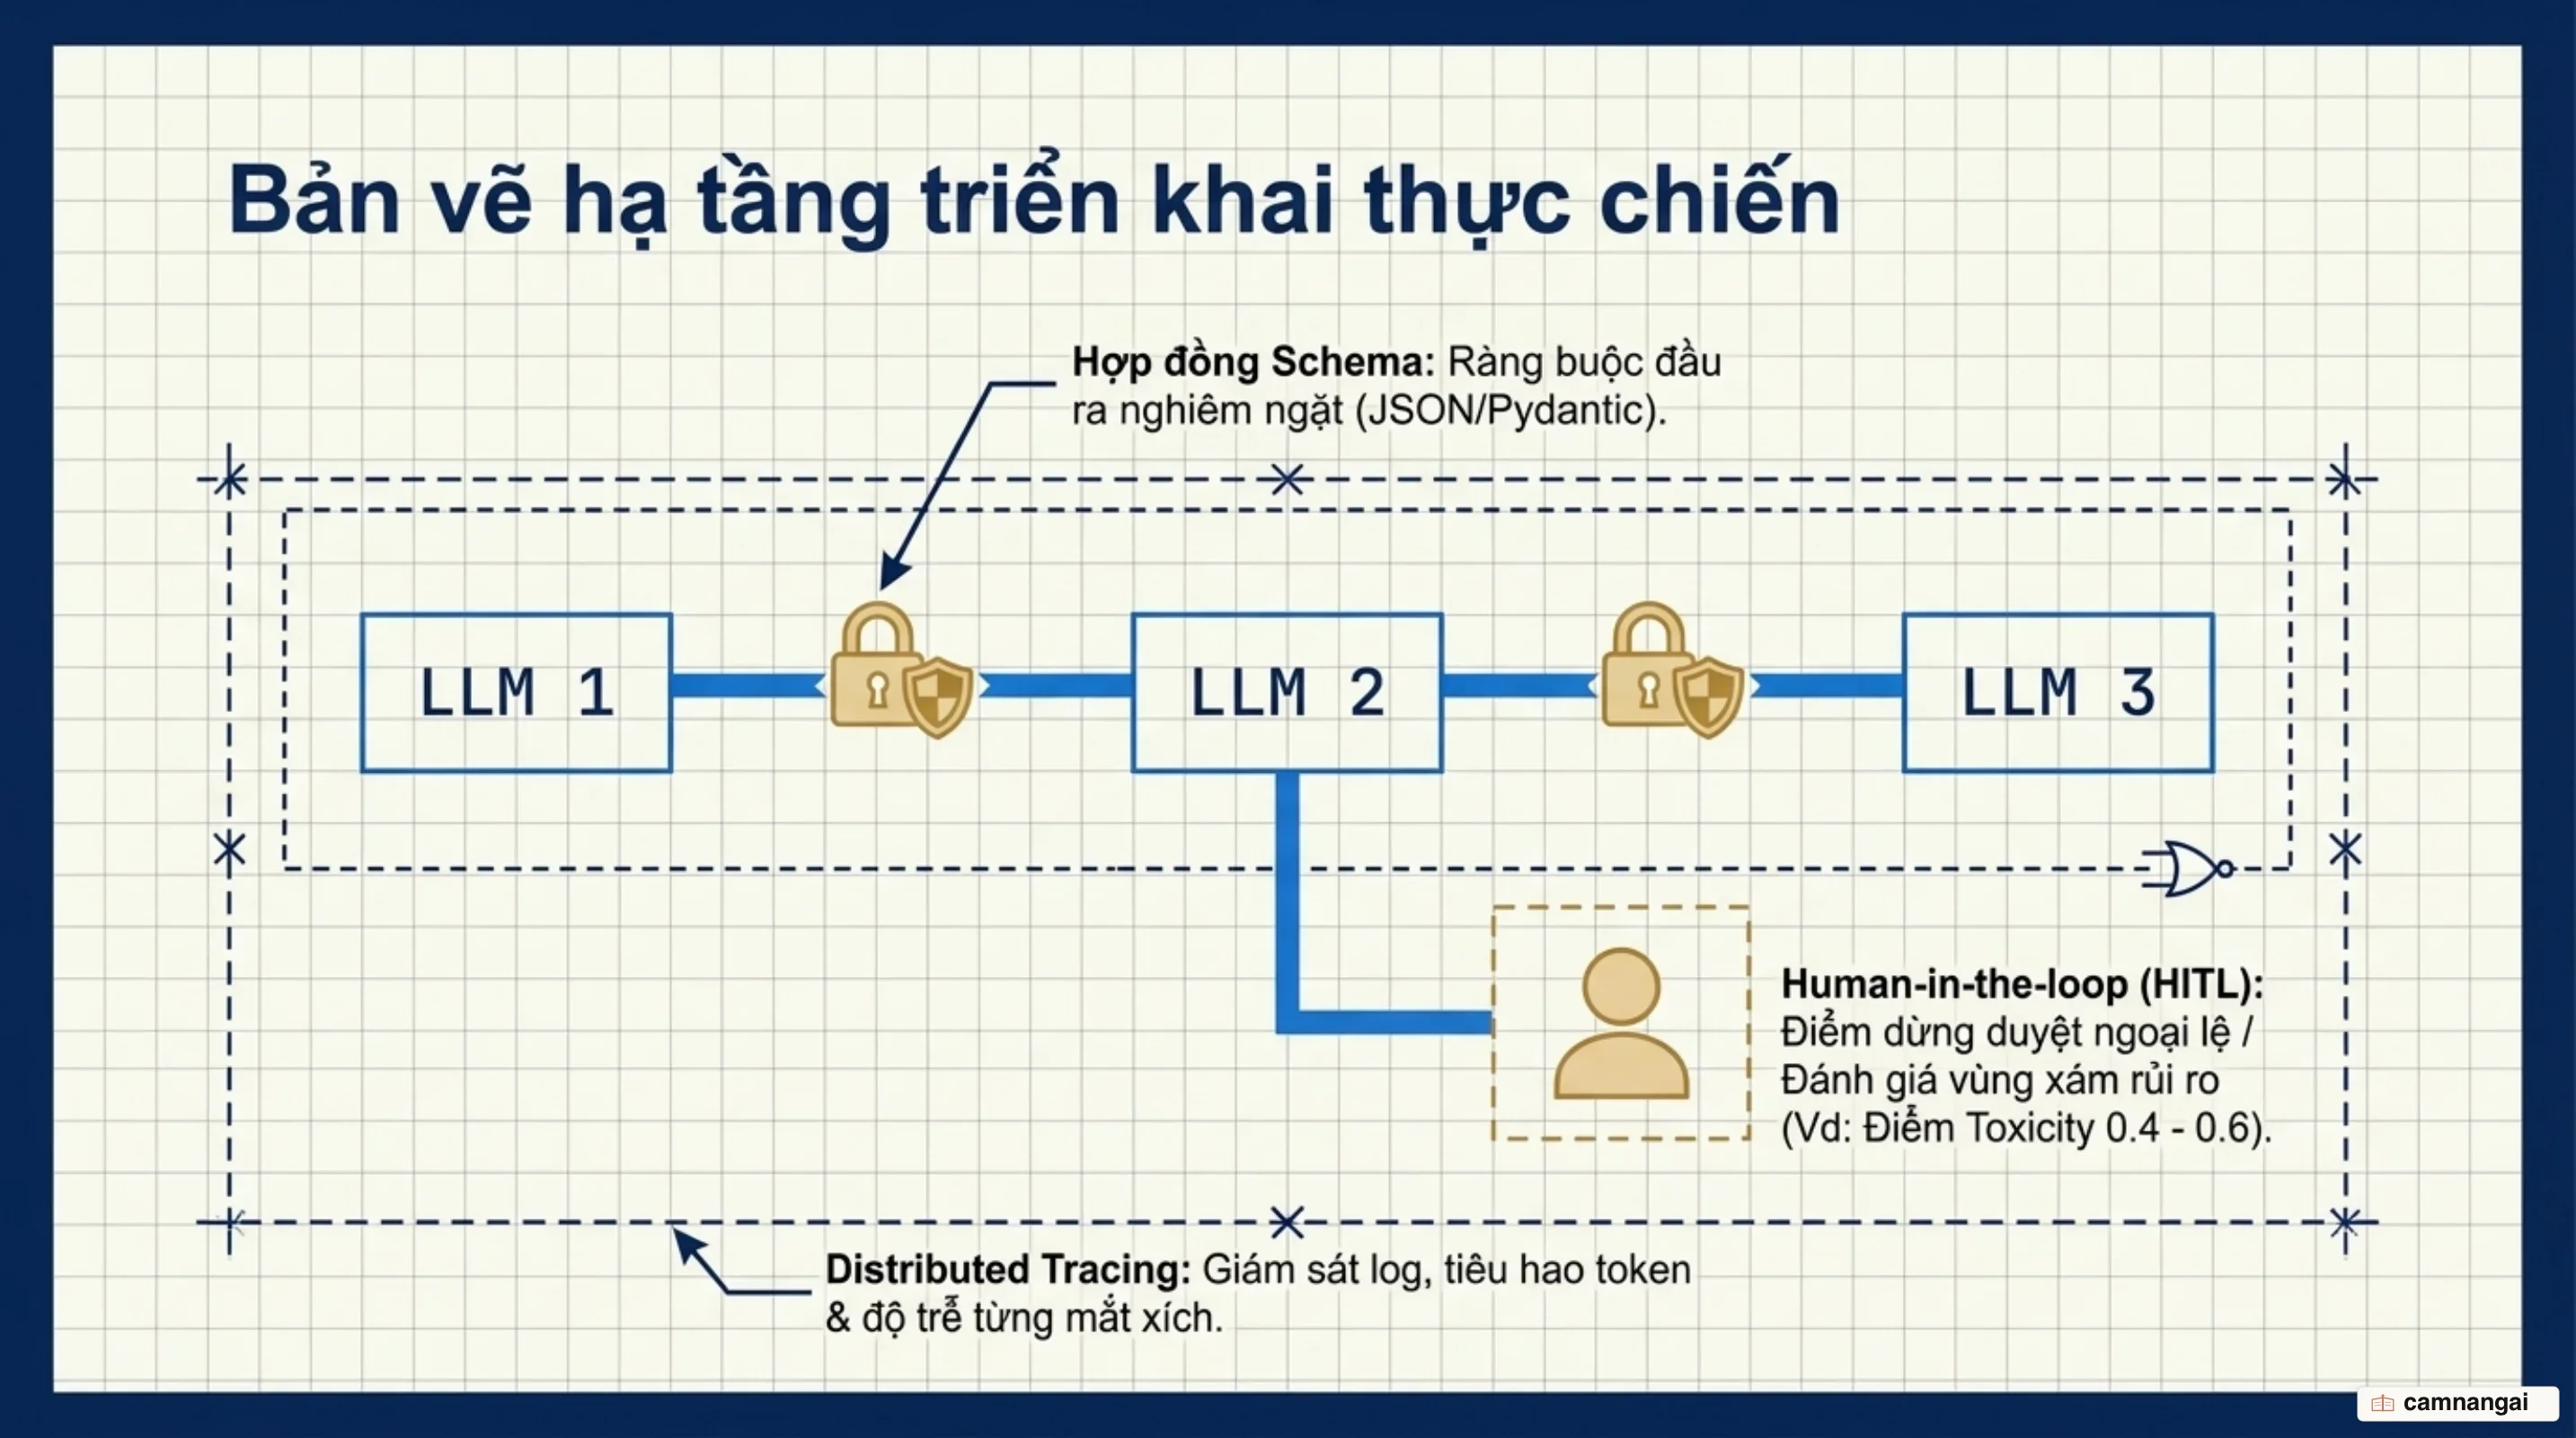
Tại các điểm giao thoa dữ liệu giữa các mắt xích LLM, tuyệt đối không bao giờ truyền nhận văn bản thô thiếu kiểm soát. Bạn bắt buộc phải áp dụng tính năng Đầu ra cấu trúc (Structured Outputs) kết hợp với thư viện Pydantic để thực thi cơ chế Phòng thủ dữ liệu (Defensive Parsing). Mã nguồn tại các mắt xích phải chủ động làm sạch các ký tự markdown rỗng và xử lý ngoại lệ cấu trúc an toàn.
Đoạn mã Python thực chiến dưới đây minh họa hạ tầng kiểm soát hợp đồng dữ liệu giữa Bước 1 và Bước 2, tích hợp cơ chế làm sạch mã nguồn phòng thủ và tự động chuyển đổi sang phương án dự phòng (Fallback) khi vỡ Schema:
import json
import re
from typing import List, Optional
from pydantic import BaseModel, Field, ValidationError

class ExtractedQuote(BaseModel):
    quote_id: int
    content: str = Field(description="Nội dung trích dẫn chính xác từ tài liệu gốc")
    relevance_score: float = Field(ge=0.0, le=1.0)

class StepOneOutput(BaseModel):
    quotes: List[ExtractedQuote]
    has_sufficient_context: bool

def defensive_parse_step_one(raw_llm_response: str) -> StepOneOutput:
    """
    Defensive Parsing Engine: Làm sạch chuỗi phản hồi từ LLM và validate qua Pydantic.
    Chủ động xử lý rủi ro Markdown Wrapper và Interface Drift từ LLM.
    """
    cleaned_response = raw_llm_response.strip()

    # 1. Bỏ gói markdown codeblock (```json ... ```) nếu LLM tự ý chèn vào
    json_match = re.search(r"```(?:json)?\s*([\s\S]*?)\s*```", cleaned_response)
    if json_match:
        cleaned_response = json_match.group(1).strip()

    # 2. Parse JSON và Validate Hợp đồng Schema
    try:
        validated_data = StepOneOutput.model_validate_json(cleaned_response)
        return validated_data
    except ValidationError as val_err:
        print(f"[INTERFACE DRIFT DETECTED]: {val_err.json()}")
        return StepOneOutput(quotes=[], has_sufficient_context=False)
    except json.JSONDecodeError as json_err:
        print(f"[MALFORMED PAYLOAD]: Không thể parse JSON từ LLM output. Lỗi: {json_err}")
        return StepOneOutput(quotes=[], has_sufficient_context=False)
Do bản chất đa mắt xích của Chaining, việc giám sát hệ thống đòi hỏi kỹ thuật Distributed Tracing (Truy vết phân tán) tương tự như trên hạ tầng microservices. Bạn cần truyền các thông số ngữ cảnh tiêu chuẩn như Trace ID và Span ID (thông qua W3C traceparent headers) xuyên suốt tất cả các bước gọi LLM và các hàm chuyển đổi mã nguồn trung gian.
Hạ tầng Tracing phải xây dựng được cây thực thi (Execution Tree) chi tiết cho từng request, lưu trữ các số liệu kỹ thuật tại mỗi mắt xích:
- Prompt Version, System Instructions, và các tham số mô hình (
temperature,top_p). - Toàn bộ Raw Payload đầu vào và đầu ra (kèm HTTP status codes).
- Độ trễ suy luận (Inference Latency) và Độ trễ mạng (Network Hop Latency).
- Thống kê chính xác số lượng Token tiêu tốn (Prompt Tokens, Completion Tokens) để hạch toán chi phí tài nguyên.
Một hệ thống Chaining vững chắc phải được thiết kế dựa trên tư duy "mọi mắt xích đều có thể sụp đổ". Hạ tầng của bạn bắt buộc phải tích hợp sẵn các kịch bản dự phòng tự động:
- Cơ chế Retry với Exponential Backoff & Jitter: Áp dụng khi mắt xích gặp các lỗi ngắt kết nối mạng tạm thời hoặc khi chạm ngưỡng giới hạn tần suất gọi API (Rate Limit / HTTP 429).
- Chuyển đổi Mô hình Dự phòng (Cross-Provider Fallback): Nếu nhà cung cấp chính gặp sự cố hạ tầng, hệ thống tự động điều hướng request ở mắt xích đó sang mô hình tương đương của nhà cung cấp khác.
- Tích hợp con người bất đồng bộ (Async Human-in-the-loop): Trong các chuỗi quy trình dài nghiệp vụ (Long-running Workflows), sử dụng cơ chế Callback với Task Token (như tính năng
waitForTaskTokentrên AWS Step Functions). Hệ thống sẽ tạm dừng quy trình, lưu trữ trạng thái vào database và phát đi tin nhắn chờ. Khi người vận hành phê duyệt thao tác trên giao diện quản trị, APISendTaskSuccesssẽ gửi Task Token tương ứng để nối lại chuỗi xử lý trơn tru:
[AWS Step Functions Workflow] ──► (Task: Khởi tạo Task Token & Gửi Email) ──► [Tạm dừng Trạng thái]
                                                                                   │
[Nhà quản lý duyệt yêu cầu trên giao diện Admin] ─────────────────────────────────┘
                                │
                                ▼
            (Gọi API: SendTaskSuccess + Task Token)
                                │
                                ▼
            [Step Functions Resume ──► Chạy mắt xích tiếp theo]
Bắt đầu từ sự đơn giản: Lộ trình áp dụng Chaining tránh bẫy over-engineering
Lời khuyên thực chiến hàng đầu dành cho mọi kỹ sư AI là không bao giờ xây dựng một chuỗi LLM Chaining phức tạp chỉ vì nó đem lại cảm giác nâng cao tính kỹ thuật cho hệ thống. Độ phức tạp là món nợ kỹ thuật (technical debt) tích lũy lãi suất rất nhanh trong môi trường production.
Hãy tuân thủ nghiêm ngặt lộ trình triển khai 4 bước tiêu chuẩn:
- Monolithic Prompt First: Bắt đầu xây dựng sản phẩm bằng một prompt đơn lẻ. Tối ưu hóa tối đa hiệu năng của nó bằng kỹ thuật Prompt Engineering chuẩn mực, bổ sung vài ví dụ mẫu (few-shot) và tích hợp RAG nếu cần thêm tri thức ngoại vi.
- Establish Evals: Xây dựng bộ tự động hóa đo lường chất lượng (Evals Harness) dựa trên các dữ liệu mẫu thực tế của người dùng.
- SPLIT Framework Execution: Chỉ khi số liệu Evals cho thấy monolithic prompt đã chạm trần hiệu năng và khung phán quyết SPLIT xác nhận lợi ích chuyên môn hóa lớn hơn chi phí vận hành, bạn mới tiến hành bẻ đôi prompt thành một chuỗi LLM Chaining.
- Continuous Pruning: Liên tục giám sát số liệu độ trễ P99 và chi phí tài nguyên trong production. Khi các foundation model thế hệ mới ra mắt với khả năng tư duy và tuân thủ chỉ dẫn tốt hơn, hãy sẵn sàng tái cấu trúc (refactor), tinh giản hoặc gộp các mắt xích nhỏ lại thành một prompt đơn lẻ để giữ cho hệ thống luôn luôn tối giản và tinh gọn.
Tài liệu tham khảo
- LLM Chaining: A Pragmatic Decision Framework — Vikash Rungta (Chain Of Thought)
- Building Effective Agents — Anthropic
- Prompt Chaining — DAIR.AI Prompt Engineering Guide
- Prompt Engineering: Decompose Complex Tasks into Simpler Subtasks — OpenAI
- Patterns for Building LLM-based Systems & Products — Eugene Yan
- Building Generative AI Prompt Chaining Workflows with Human in the Loop — AWS Machine Learning Blog