Vector (Baseline RAG) dựa trên việc chia nhỏ văn bản () và tìm kiếm tương đồng vector bằng không gian nhúng (embeddings). Tuy nhiên, khi hệ thống phải xử lý các tập dữ liệu phi cấu trúc phức tạp, phương pháp này bộc lộ những hạn chế lớn về mặt kỹ thuật. GraphRAG là kỹ thuật kết hợp Đồ thị tri thức (Knowledge Graph) với các mô hình ngôn ngữ lớn (LLM) nhằm xử lý các điểm nghẽn về đứt gãy ngữ cảnh và suy luận kém của Vector RAG truyền thống.
Bằng cách chuyển đổi dữ liệu thô thành mạng lưới các thực thể, mối quan hệ và các cụm tri thức được tóm tắt sẵn, GraphRAG giúp truy xuất ngữ cảnh chính xác, xử lý các câu hỏi suy luận đa chặng (multi-hop reasoning) và thấu hiểu toàn cảnh tập dữ liệu mà tìm kiếm tương đồng vector đơn thuần gặp giới hạn nghiêm trọng.
Giới hạn của Vector RAG: Vì sao tìm kiếm tương đồng vector là chưa đủ?
Cơ chế vận hành của Vector RAG truyền thống (Baseline RAG) dựa trên việc chia cắt tài liệu thành các đoạn văn bản nhỏ (chunks), chuyển đổi chúng thành các vector nhúng (embeddings) và thực hiện tìm kiếm tương đồng vector (như cosine similarity) dựa trên truy vấn của người dùng. Kỹ thuật này hoạt động hiệu quả đối với các truy vấn tra cứu thông tin cục bộ đơn giản. Tuy nhiên, khi đối mặt với dữ liệu phức tạp dạng tự sự hoặc tài liệu doanh nghiệp phi cấu trúc, Vector RAG vướng phải hai điểm nghẽn kỹ thuật nghiêm trọng.
Thứ nhất là điểm nghẽn "kết nối các điểm thông tin" (connecting the dots). Khi câu hỏi yêu cầu liên kết nhiều mảng thông tin phân tán nằm ở các đoạn văn bản khác nhau thông qua các thuộc tính chung, Vector RAG gặp khó khăn. Do các đoạn văn bản trả về không chứa từ khóa trực tiếp hoặc nằm rải rác, tìm kiếm vector chỉ lấy ra các đoạn khớp về mặt ngữ nghĩa bề mặt mà không thể duyệt qua các mối quan hệ ẩn kết nối giữa chúng. Thực nghiệm trên tập dữ liệu VIINA của Microsoft Research cho thấy Vector RAG không trả lời được câu hỏi dạng "Novorossiya đã làm gì?" do các đoạn văn bản chứa hành vi không trực tiếp khớp vector với từ khóa truy vấn trong không gian nhúng.
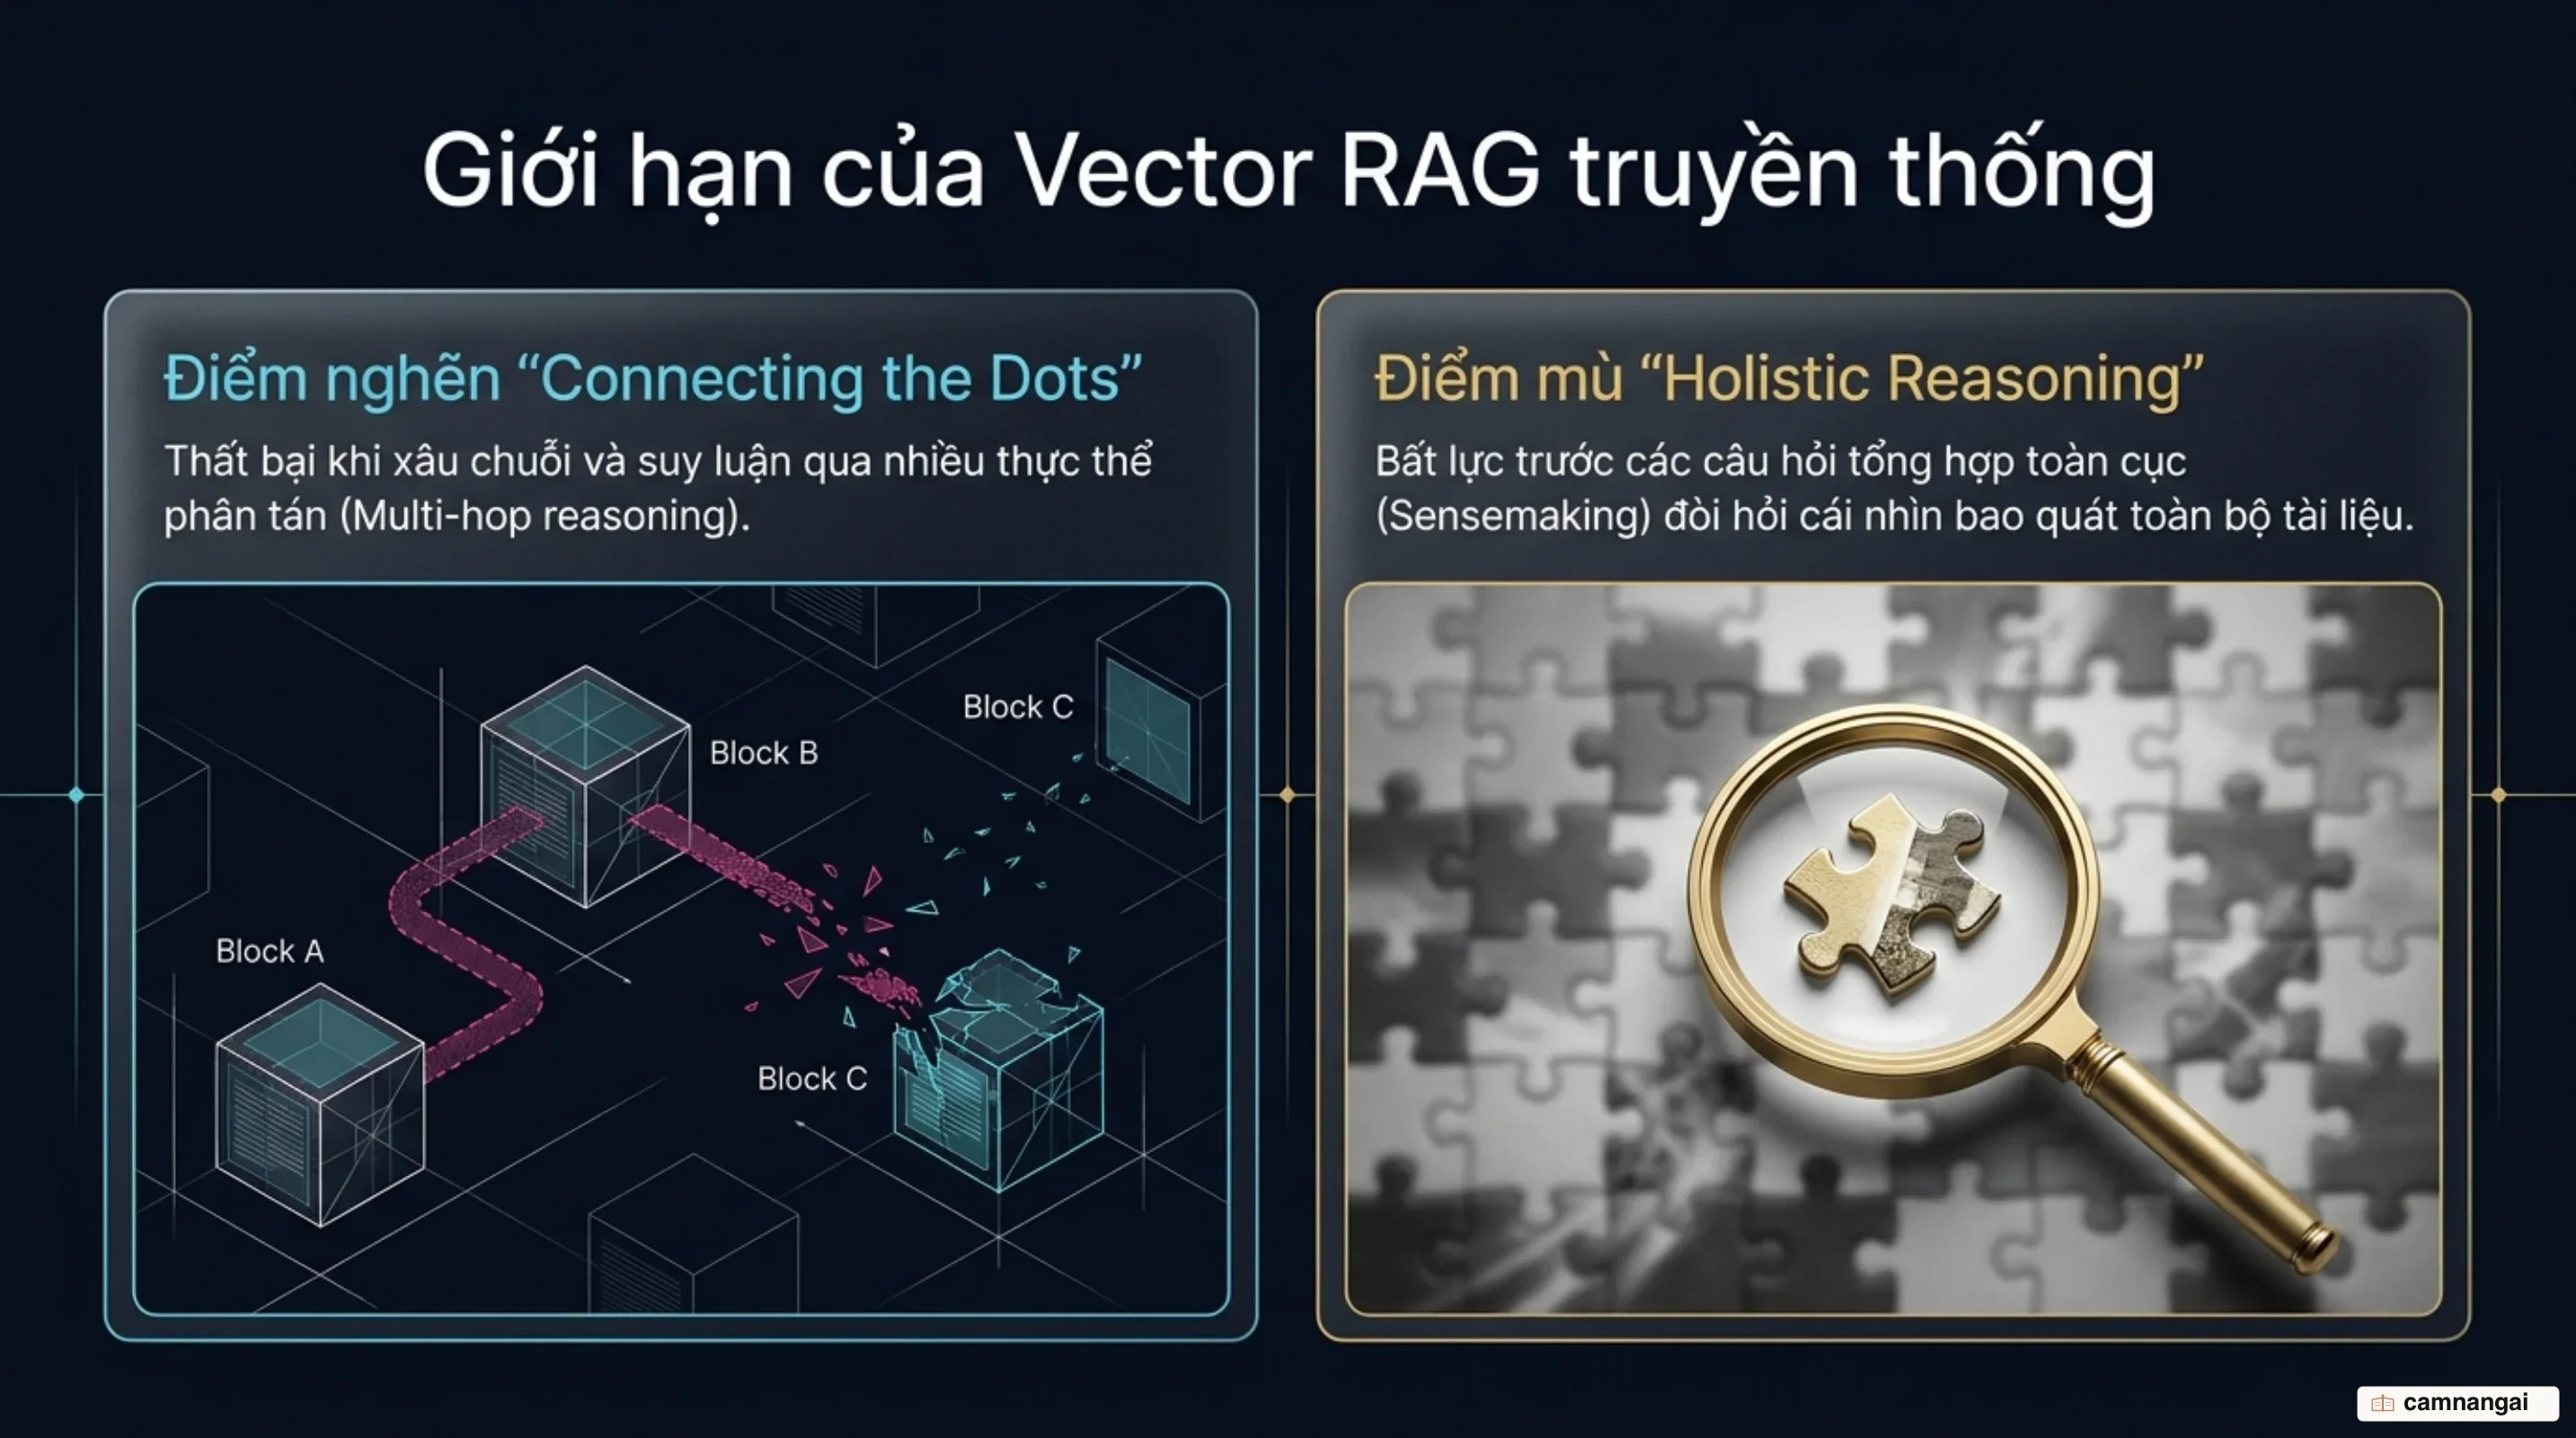
Thứ hai là điểm nghẽn "thấu hiểu toàn cục" (holistic / whole-dataset reasoning). Vector RAG không có khả năng trả lời các câu hỏi tổng hợp mang tính chủ đề trên toàn bộ tập dữ liệu (ví dụ: "5 chủ đề chính trong dữ liệu này là gì?"). Thuật toán tìm kiếm vector chỉ lấy ra danh sách $k$ đoạn văn bản gần nhất với câu lệnh. LLM sau đó chỉ nhận được ngữ cảnh hẹp hòi này, dẫn đến câu trả lời bị lệch hướng hoặc đưa ra các chủ đề ngẫu nhiên (như tin tức phát triển đô thị hay cuộc họp ngoại giao) chỉ vì từ khóa "chủ đề" vô tình xuất hiện trong các chunk đó.
Ngoài ra, tính chất "hộp đen" của không gian nhúng vector làm giảm khả năng kiểm chứng nguồn gốc (provenance/faithfulness). Người vận hành hệ thống rất khó truy vết chính xác vì sao một đoạn văn bản lại được truy hồi, cũng như không thể trích dẫn chính xác đường dẫn mối quan hệ logic cấu thành nên câu trả lời của LLM.
Knowledge Graph: Cấu trúc hóa tri thức phi cấu trúc thành các thực thể và mối quan hệ
Để xử lý sự đứt gãy ngữ cảnh của các chunk văn bản rời rạc, Đồ thị tri thức (Knowledge Graph / Property Graph) biểu diễn dữ liệu dưới dạng một mạng lưới cấu trúc gồm ba thành phần chính:
- Nút (Nodes/Entities): Đại diện cho các thực thể hoặc khái niệm (như con người, tổ chức, địa điểm, sự kiện).
- Cạnh (Edges/Relations): Thể hiện mối quan hệ định kiểu giữa các nút (như
THUỘC_VỀ,TÁC_ĐỘNG,SỞ_HỮU). - Thuộc tính (Properties/Metadata): Lưu trữ các cặp khóa-giá trị đính kèm vào nút hoặc cạnh để bổ sung ngữ cảnh (như thời gian, mã định danh, nguồn trích dẫn).
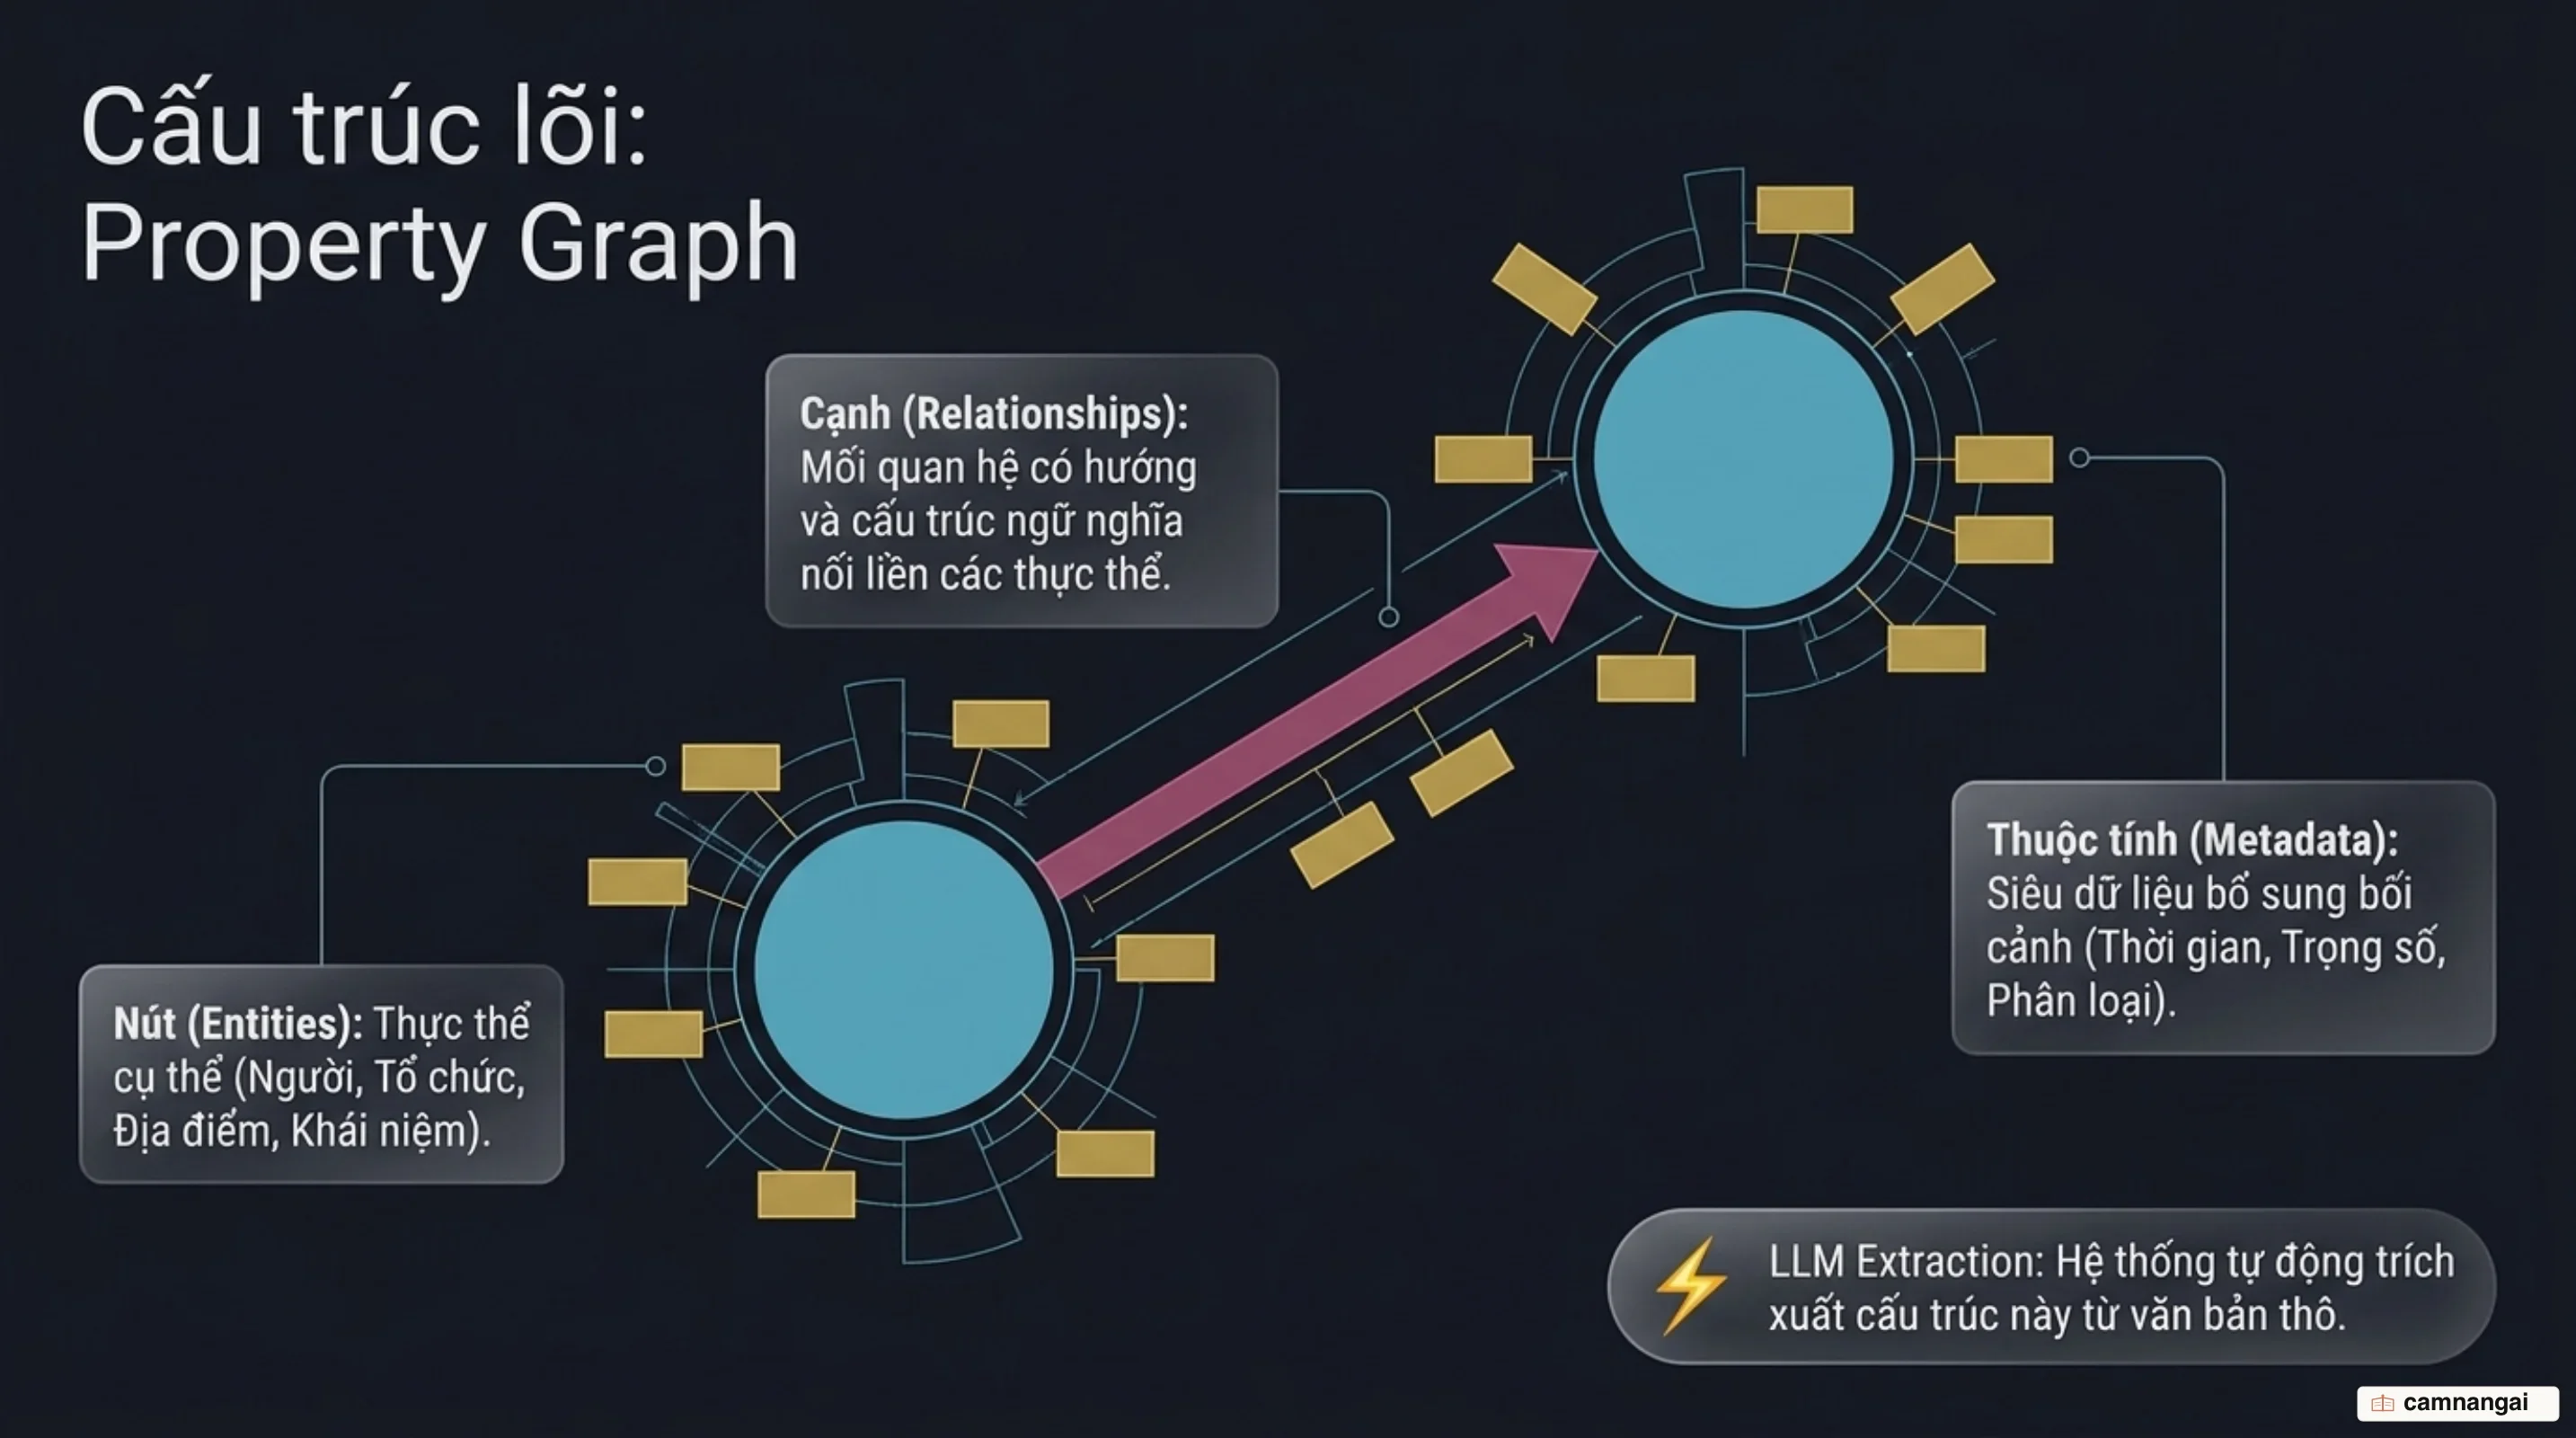
Quy trình trích xuất tri thức từ văn bản phi cấu trúc sang dạng đồ thị được thực hiện thông qua nhiều cơ chế trích xuất (kg_extractors) với các đánh đổi rõ ràng về chi phí và độ chính xác:
SimpleLLMPathExtractor: Phân tích văn bản tự do bằng LLM để trích xuất các bộ ba tri thức dạng(Entity1, Relation, Entity2)không giới hạn schema.SchemaLLMPathExtractor: Áp dụng kiểm duyệt nghiêm ngặt qua Pydantic schema, bắt buộc các thực thể và mối quan hệ phải tuân theo đúng tập Ontology định sẵn, giúp chuẩn hóa dữ liệu tuyệt đối nhưng tốn chi phí gọi LLM hơn.ImplicitPathExtractor: Trích xuất mối quan hệ trực tiếp từ thuộc tính metadata (node.relationships) có sẵn trên cấu trúc tài liệu mà không tốn chi phí gọi LLM hay model.DynamicLLMPathExtractor: Cho phép LLM linh hoạt trích xuất dựa trên danh sách các thực thể/mối quan hệ gợi ý nhưng không bắt buộc đóng khung cứng nhắc như Schema-enforced.
Đoạn code Python dưới đây minh họa cách khởi tạo chỉ mục đồ thị thuộc tính (PropertyGraphIndex) trong LlamaIndex, kết hợp trích xuất tri thức và truy hồi ngữ cảnh vector trên đồ thị:
from llama_index.core import PropertyGraphIndex
from llama_index.core.indices.property_graph import SimpleLLMPathExtractor, VectorContextRetriever

# Giả định llm và embed_model đã được khởi tạo trước đó
# llm = OpenAI(model="gpt-4o-mini")
# embed_model = OpenAIEmbedding(model="text-embedding-3-large")

# 1. Khởi tạo extractor sử dụng LLM để trích xuất bộ ba tri thức (Entity1, Relation, Entity2)
kg_extractor = SimpleLLMPathExtractor(
    llm=llm,
    max_paths_per_chunk=10
)

# 2. Xây dựng PropertyGraphIndex từ danh sách tài liệu văn bản (documents)
index = PropertyGraphIndex.from_documents(
    documents,
    kg_extractors=[kg_extractor],
    embed_model=embed_model
)

# 3. Khởi tạo sub-retriever kết hợp tìm kiếm vector nút và duyệt đường dẫn đồ thị (graph traversal)
sub_retrievers = [
    VectorContextRetriever(
        index.property_graph_store,
        embed_model=embed_model,
        similarity_top_k=5,
        path_depth=2  # Độ sâu duyệt các thực thể lân cận (N-hops)
    )
]

retriever = index.as_retriever(sub_retrievers=sub_retrievers)
Kiến trúc Microsoft GraphRAG: Pipeline chỉ mục từ trích xuất đến phân cụm Leiden
Pipeline xây dựng chỉ mục (Indexing Pipeline) của Microsoft GraphRAG không dừng lại ở việc tạo bộ ba tri thức đơn thuần, mà áp dụng kỹ thuật trên đồ thị (Graph Machine Learning) qua 3 bước xử lý tuần tự:
- Phân đoạn & Trích xuất (Chunking & Extraction): Tập tài liệu đầu vào được chia nhỏ thành các đơn vị phân tích cơ sở gọi là
TextUnit. LLM duyệt qua từngTextUnitđể trích xuất toàn bộ các thực thể (Entities), mối quan hệ (Relationships) và các luận điểm chính (Claims), đồng thời lưu lại liên kết nguồn gốc từ ngữ cảnh ban đầu. - Phân cụm phân cấp (Hierarchical Clustering): Hệ thống xây dựng đồ thị tổng thể từ các thực thể và mối quan hệ, sau đó áp dụng thuật toán phân cụm Leiden (Leiden algorithm). Thuật toán Leiden hoạt động trên nhiều cấp độ quy mô (multiscale) từ dưới lên (bottom-up): tạo ra các cụm nhỏ chi tiết ở Cấp 0 (Level 0 fine-grained communities), sau đó nhóm dần thành các cụm khái niệm lớn hơn ở Cấp 1, Cấp 2 hoặc Cấp 3 (high-level clusters). Cấu trúc phân cấp này tạo điều kiện cho việc truy hồi ngữ cảnh ở các độ trừu tượng khác nhau tùy thuộc vào câu hỏi.
- Tóm tắt cụm (Community Summarization): Ở từng cấp độ phân cụm Leiden, LLM được sử dụng để tạo ra các bản tóm tắt tiền xử lý (pre-summarized reports) cho từng cộng đồng thực thể. Các bản tóm tắt này cô đọng toàn bộ chủ đề, thực thể chính và mối quan hệ nội bộ của cụm, làm tài nguyên đầu vào trực tiếp cho các truy vấn toàn cục ở bước truy hồi.
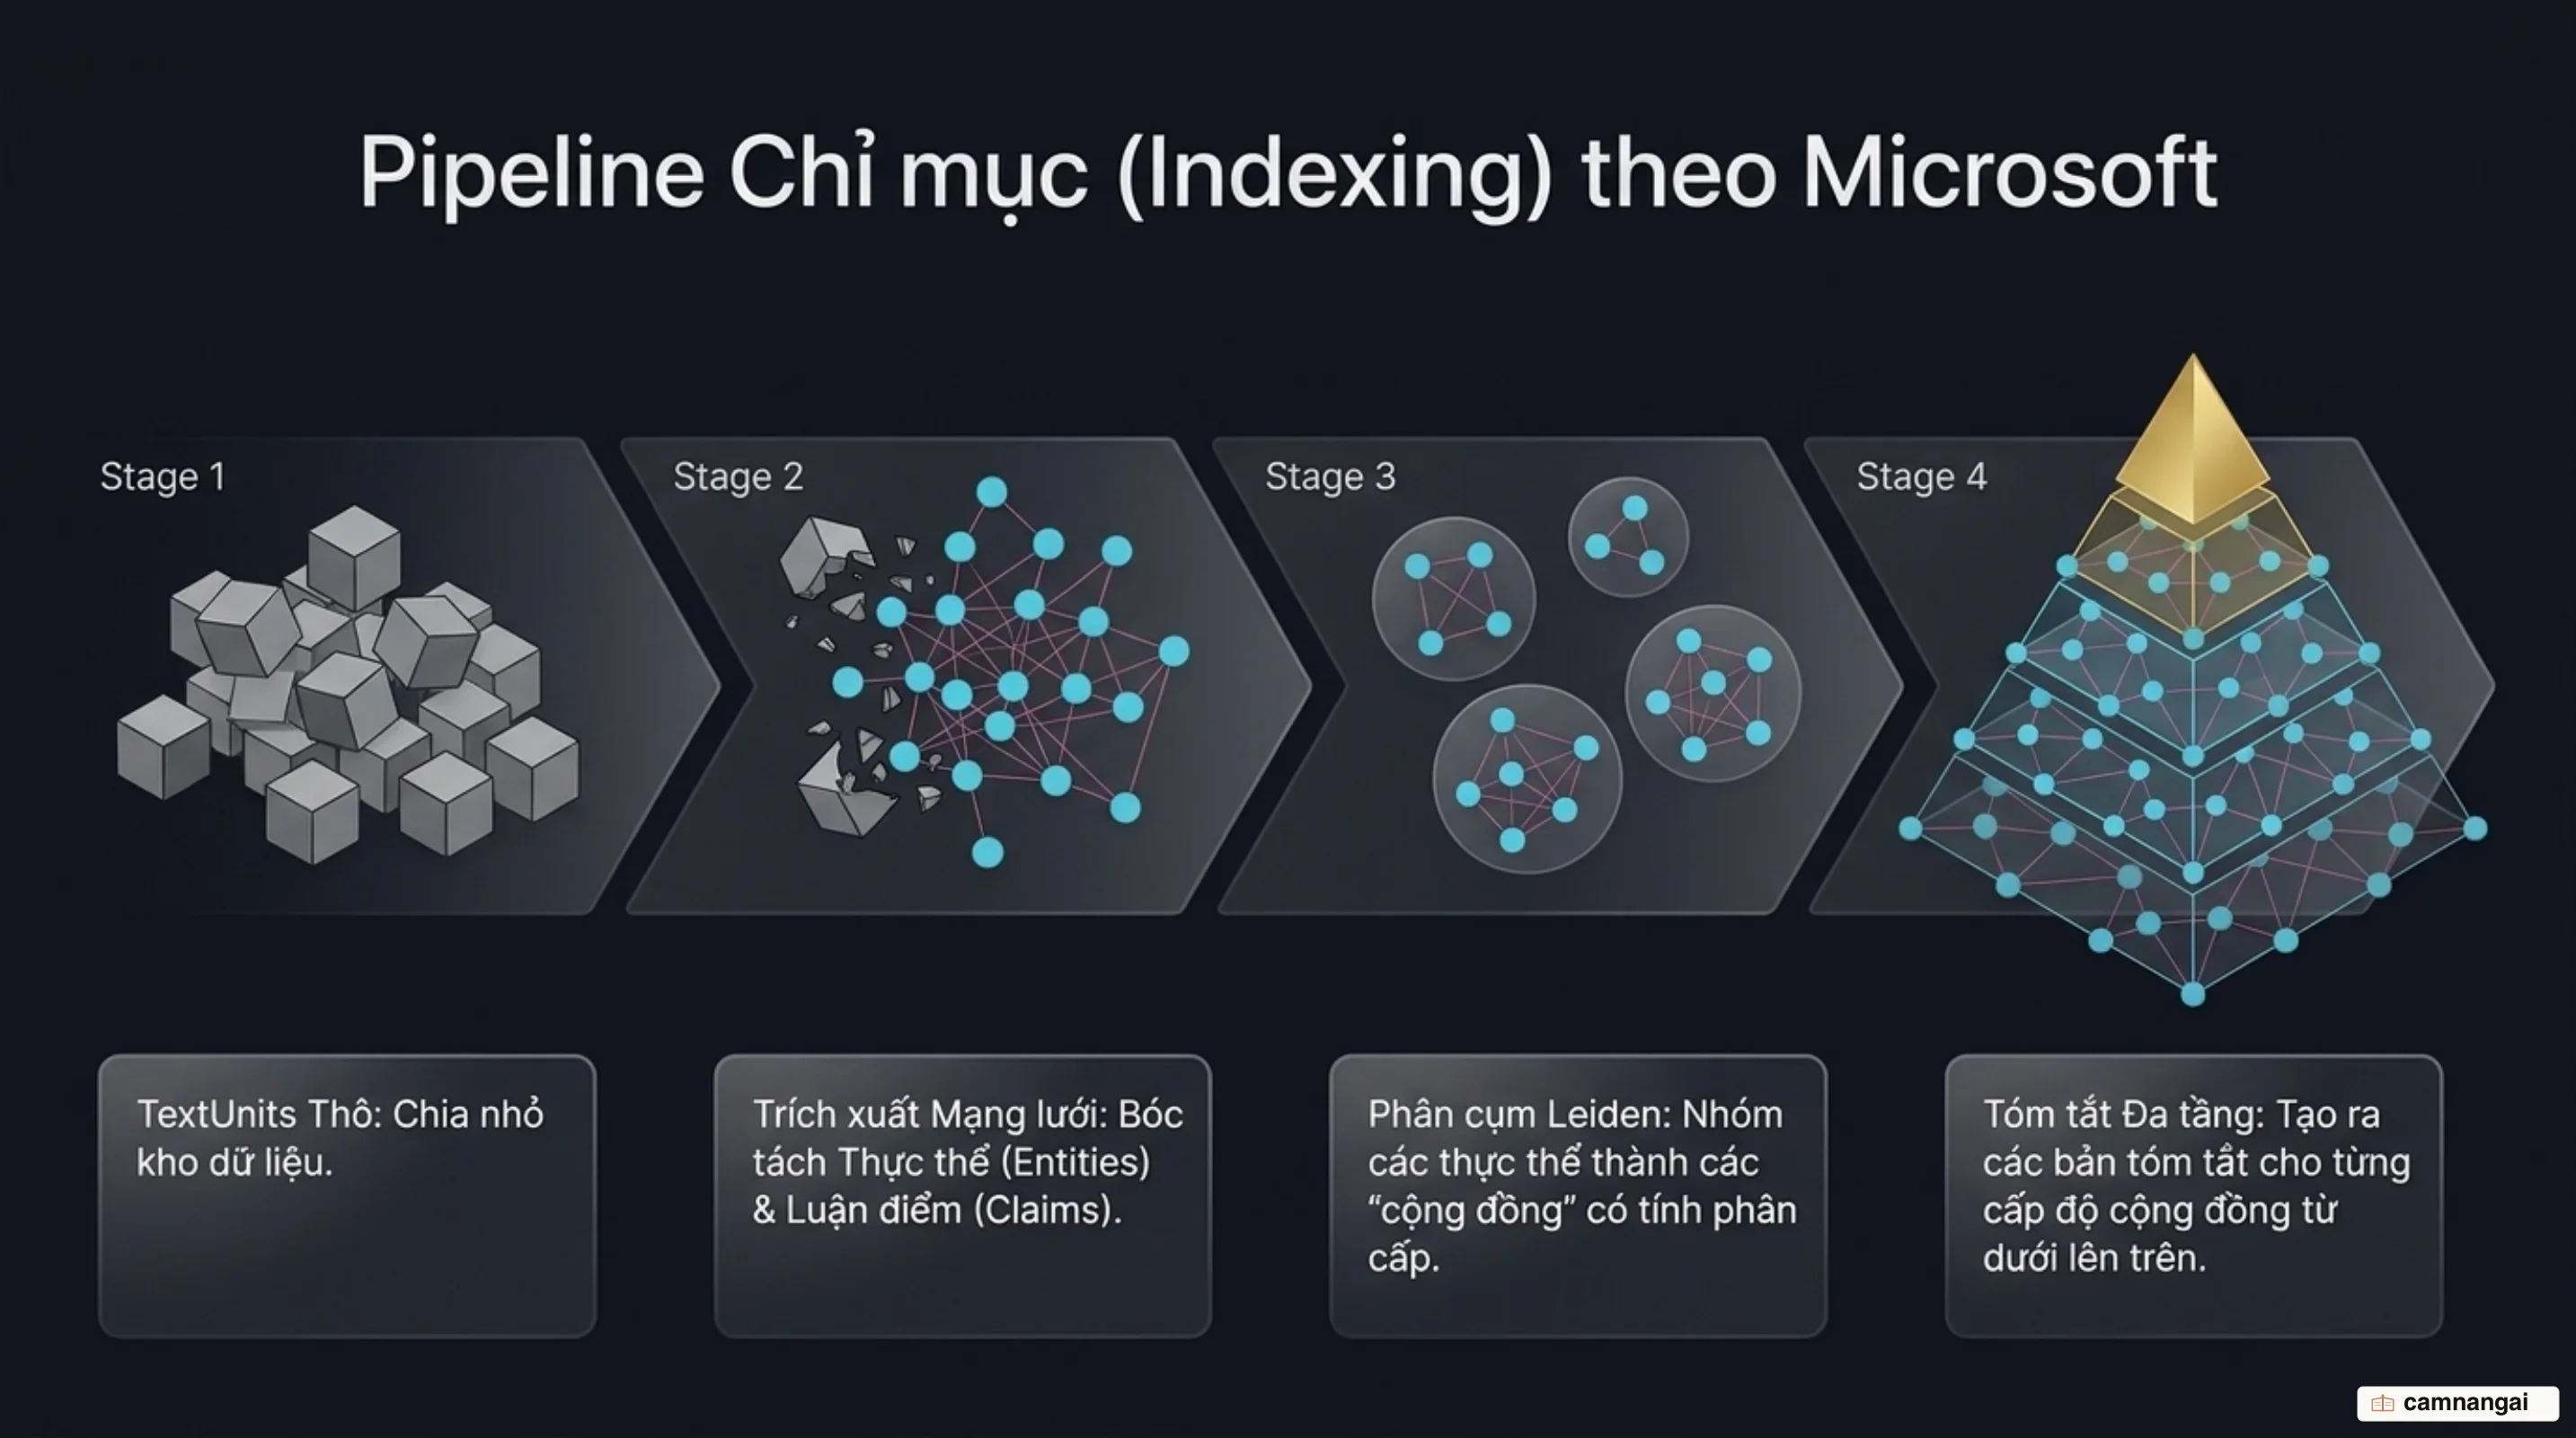
Chi tiết dòng luồng xử lý chỉ mục và định tuyến truy vấn được thể hiện trong sơ đồ kiến trúc bên dưới:
==== PIPELINE CHỈ MỤC (INDEXING PIPELINE) ====
[Corpus / Tài liệu] ──► [TextUnits] ──(Trích xuất LLM)──► [Entities / Relations / Claims]
                                                                  │
                                                                  ▼
[Community Summaries] ◄──(LLM Summarization)── [Phân cụm Leiden (Level 0 ➔ Level N)]

==== LUỒNG TRUY VẤN (QUERY ROUTING PIPELINE) ====
                  ┌─► [Local Search]  ──► Nhận diện Thực thể ─► Fan-out N-hops ─► LLM Context
[User Query] ─────┤
                  └─► [Global Search] ─► Map (Parallel Summaries) ─► Reduce ──► LLM Context
Cơ chế truy hồi: Phân biệt Local Search và Global Search
Khi truy vấn hệ thống GraphRAG, tùy thuộc vào bản chất của câu hỏi, hai chế độ truy hồi chính được kích hoạt:
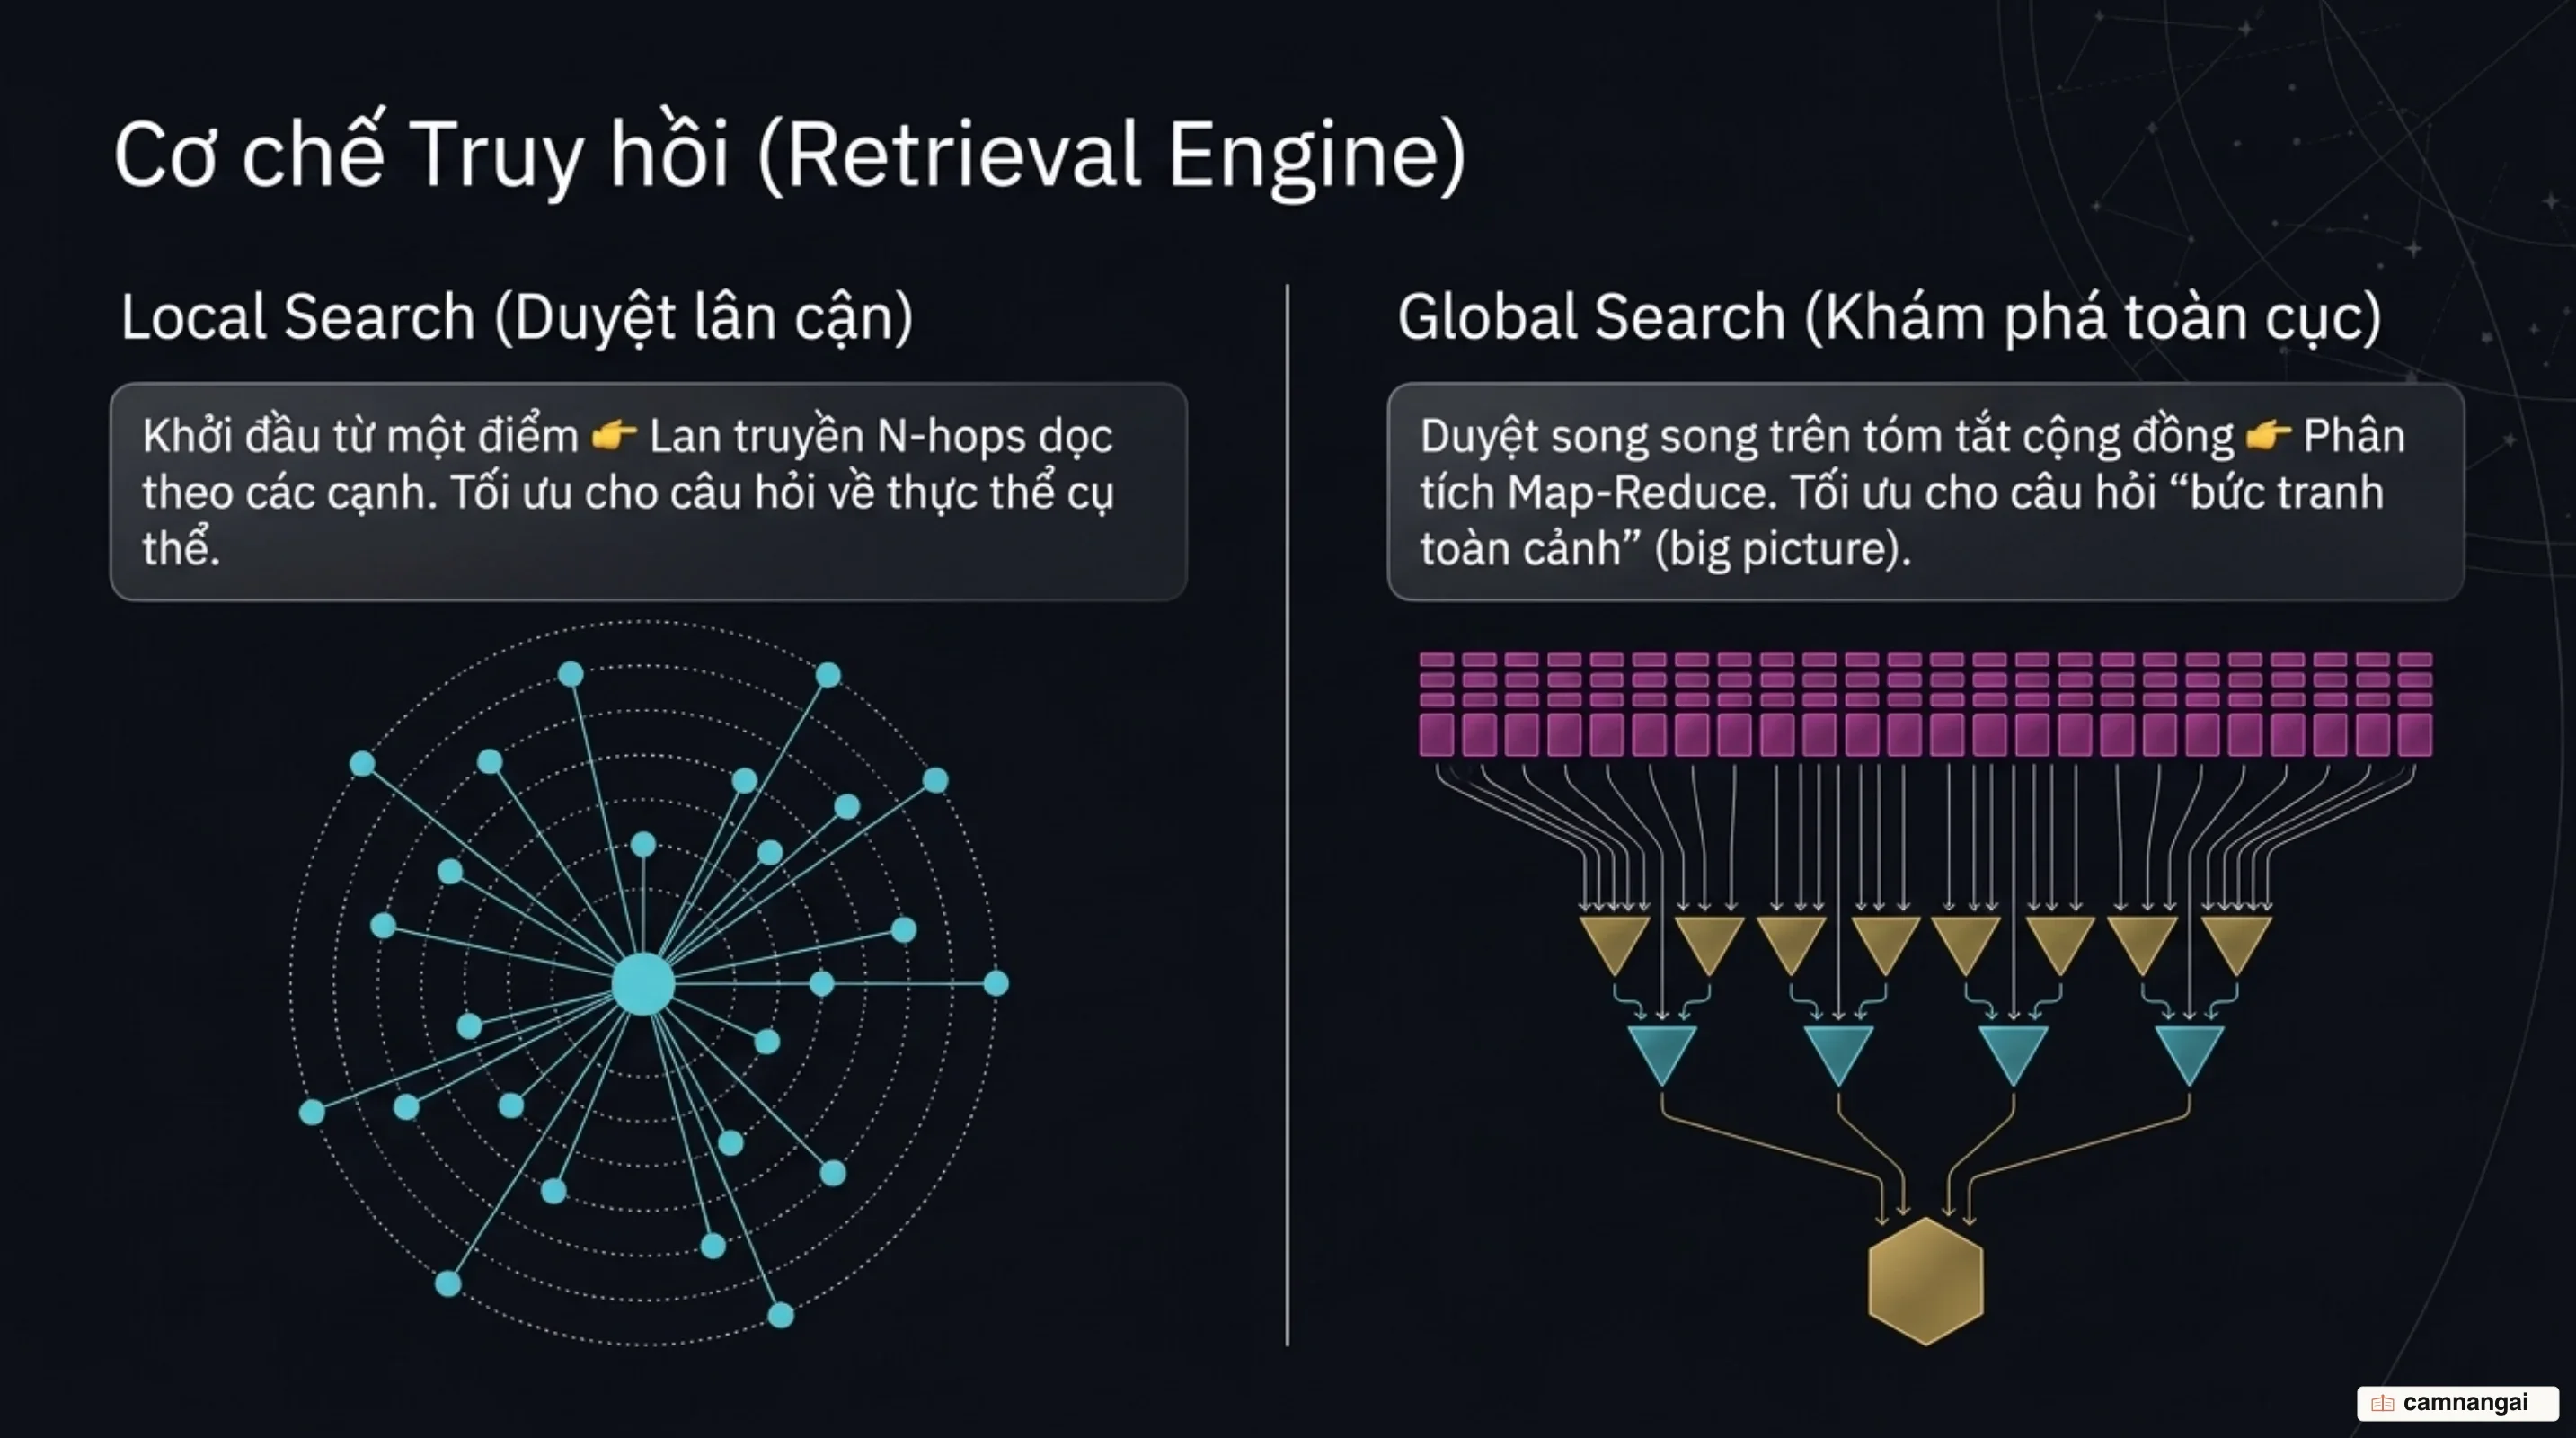
Local Search (Tìm kiếm cục bộ)
- Cơ chế: Khi nhận câu hỏi, hệ thống trích xuất các thực thể trọng tâm trong câu lệnh, chiếu vào đồ thị tri thức và mở rộng (fan-out) sang các thực thể lân cận (neighbors) cùng các khái niệm liên kết trong phạm vi $N$-hops. Ngữ cảnh đưa vào LLM bao gồm thông tin chi tiết của các nút, các cạnh quan hệ, các luận điểm (claims) và đoạn văn bản gốc (
TextUnit) liên quan. - Trường hợp sử dụng: Thích hợp cho các câu hỏi đi sâu vào chi tiết của một thực thể cụ thể. Ví dụ: "Novorossiya đã làm gì?" hoặc tra cứu hồ sơ 360 độ của một khách hàng trong hệ thống ngân hàng hoặc bán lẻ.
Global Search (Tìm kiếm toàn cục)
- Cơ chế: Thay vì tìm kiếm vector trên từng chunk văn bản thô, Global Search vận hành theo mô hình Map-Reduce trên danh sách các bản tóm tắt cụm (community summaries) được tạo ra từ thuật toán Leiden:
- Giai đoạn Map: Hệ thống chia nhỏ các bản tóm tắt cụm ở cấp độ phân cấp phù hợp, gửi song song đến LLM để tạo ra các câu trả lời trung gian (intermediate responses) kèm điểm số tin cậy.
- Giai đoạn Reduce: Hệ thống gom tất cả các câu trả lời trung gian, lọc bỏ thông tin nhiễu, tổ chức lại và tổng hợp thành một câu trả lời toàn cục thống nhất cho người dùng.
- Trường hợp sử dụng: Thích hợp cho các câu hỏi tổng quát yêu cầu thấu hiểu toàn bộ tập dữ liệu, chẳng hạn như "5 chủ đề lớn nhất được thảo luận trong tập tài liệu này là gì?" hoặc phân tích xu hướng vĩ mô.
Thực nghiệm từ Microsoft Research ghi nhận GraphRAG vượt trội hơn Baseline RAG trên 3 chỉ số đánh giá định tính cốt lõi:
- Độ toàn diện (Comprehensiveness): Mức độ chi tiết và bao quát của bối cảnh trả lời.
- Tính đa dạng (Diversity): Khả năng cung cấp nhiều góc nhìn và hướng phân tích khác nhau đối với câu hỏi.
- Khả năng trao quyền cho con người (Human Enfranchisement): Cung cấp đầy đủ bối cảnh hỗ trợ và các liên kết nguồn gốc (provenance links), giúp chuyên gia con người dễ dàng đối chiếu, kiểm chứng thông tin trực tiếp với văn bản gốc.
Song song đó, hệ thống sử dụng SelfCheckGPT để đo lường độ trung thực (faithfulness), đảm bảo câu trả lời thu được đạt độ chính xác thực tế tương đương hoặc vượt trội so với Baseline RAG mà không bị ảo giác.
So sánh Vector RAG và GraphRAG: Đánh đổi chi phí, độ trễ và độ phức tạp
Chuyển đổi từ Vector RAG sang GraphRAG đòi hỏi AI Engineer phải cân nhắc bài toán đánh đổi về chi phí tính toán và hạ tầng kỹ thuật.
| Tiêu chí | Vector RAG (Baseline RAG) | GraphRAG |
|---|---|---|
| Chi phí chỉ mục (Indexing Cost) | Thấp: Chỉ tốn chi phí gọi API Embedding model để tạo vector cho các chunk văn bản. | Rất cao: Tốn lượng lớn token LLM cho việc trích xuất thực thể, mối quan hệ, luận điểm và tóm tắt phân cụm Leiden. |
| Chi phí truy vấn & Độ trễ (Query Cost & Latency) | Thấp / Nhanh: Truy vấn K-NN trên cơ sở dữ liệu vector có độ trễ mili-giây và chi phí token thấp. | Cao hơn: Cần thời gian duyệt đồ thị (Local Search) hoặc chạy luồng Map-Reduce qua nhiều bản tóm tắt cụm (Global Search). |
| Suy luận đa chặng (Multi-hop Reasoning) | Hạn chế: Gặp khó khăn khi thông tin nằm phân tán rải rác ở nhiều chunk không chứa từ khóa trực tiếp. | Xuất sắc: Duyệt qua các đường dẫn liên kết giữa các thực thể trên đồ thị để nối liền ngữ cảnh bị đứt gãy. |
| Tổng hợp toàn cục (Holistic Summarization) | Không hiệu quả: Chỉ lấy được các đoạn văn cục bộ ngẫu nhiên gần nhất với vector truy vấn. | Xuất sắc: Khai thác các bản tóm tắt cộng đồng (community reports) ở nhiều cấp độ trừu tượng qua Map-Reduce. |
| Tính minh bạch & Kiểm chứng (Traceability / Provenance) | Khó: Không gian nhúng vector là hộp đen, khó giải thích lý do chính xác vì sao chunk được chọn. | Rõ ràng: Trích dẫn đường dẫn cụ thể (provenance links) từ nút/cạnh đồ thị về chính xác đoạn TextUnit gốc. |
Khi nào AI Engineer nên đầu tư vào GraphRAG?
AI Engineer nên đầu tư triển khai GraphRAG khi hệ thống làm việc với dữ liệu riêng tư dạng tự sự hoặc văn bản phi cấu trúc phức tạp (narrative private datasets) — nơi chứa nhiều thực thể đan xen và thông tin ẩn cần suy luận đa chặng, hoặc khi nghiệp vụ bắt buộc phải trả lời các câu hỏi tổng quát toàn cục với yêu cầu khắt khe về độ chính xác và khả năng trích dẫn nguồn gốc cho chuyên gia kiểm chứng.
Ngược lại, nếu ứng dụng chỉ dừng lại ở tra cứu ngữ cảnh ngắn, xử lý dữ liệu ít tính liên kết hoặc truy vấn tra cứu sự thật đơn giản (fact-retrieval) với ngân sách hạn chế, Vector RAG vẫn là lựa chọn tối ưu về mặt chi phí và tốc độ phản hồi. Việc kết hợp kiến trúc hybrid (dùng Vector Search cho tra cứu nhanh và GraphRAG cho suy luận sâu) là hướng đi hợp lý cho các hệ thống quy mô lớn.
Tài liệu tham khảo
- From Local to Global: A Graph RAG Approach to Query-Focused Summarization — arXiv
- Graph RAG integration - Docs by LangChain
- GraphRAG: Unlocking LLM discovery on narrative private data - Microsoft Research
- Using a Property Graph Index | Developer Documentation
- Using knowledge graphs to build GraphRAG applications with Amazon Bedrock and Amazon Neptune | AWS Database Blog
- Welcome - GraphRAG
- What is GraphRAG?