Việc gia tăng tài nguyên điện toán tại thời điểm suy luận (test-time compute scaling) cho phép các mô hình thế hệ mới như OpenAI o1, DeepSeek-R1 hay Claude 3.7 Sonnet sinh ra các suy nghĩ (reasoning tokens) nhằm xử lý những bài toán phức tạp. Tuy nhiên, tiêu tốn nhiều tài nguyên hơn không phải lúc nào cũng cải thiện độ chính xác. Hiện tượng overthinking trong LLM mô tả tình trạng mô hình tiêu tốn quá mức tính toán cho các yêu cầu đơn giản, dẫn đến lãng phí tài nguyên, phản hồi chậm và thậm chí làm sai lệch kết quả từ đúng thành sai.
Trong cơ chế sinh tự hồi quy (autoregressive generation), mô hình ghi lại các bước trung gian lên một vùng nháp nội bộ (scratchpad) trước khi đưa ra câu trả lời cuối cùng. Khi chuỗi lý luận kéo dài quá mức cần thiết, các sai số nhỏ ở những token ban đầu sẽ tích tụ theo cơ chế tự hồi quy, khiến mô hình tự bác bỏ một đáp án chính xác đã tìm ra trước đó.
Sự lãng phí tài nguyên và suy giảm độ chính xác này đặt ra bài toán tối ưu cho việc thiết kế và triển khai ứng dụng (AI). Việc hiểu rõ cơ chế vận hành, nguyên nhân kỹ thuật và điểm bão hòa tính toán của mô hình lý luận giúp bạn quản lý chi phí API và duy trì độ tin cậy của hệ thống.
Bước nhảy vọt của Reasoning Models: Khi AI bắt đầu "suy nghĩ"
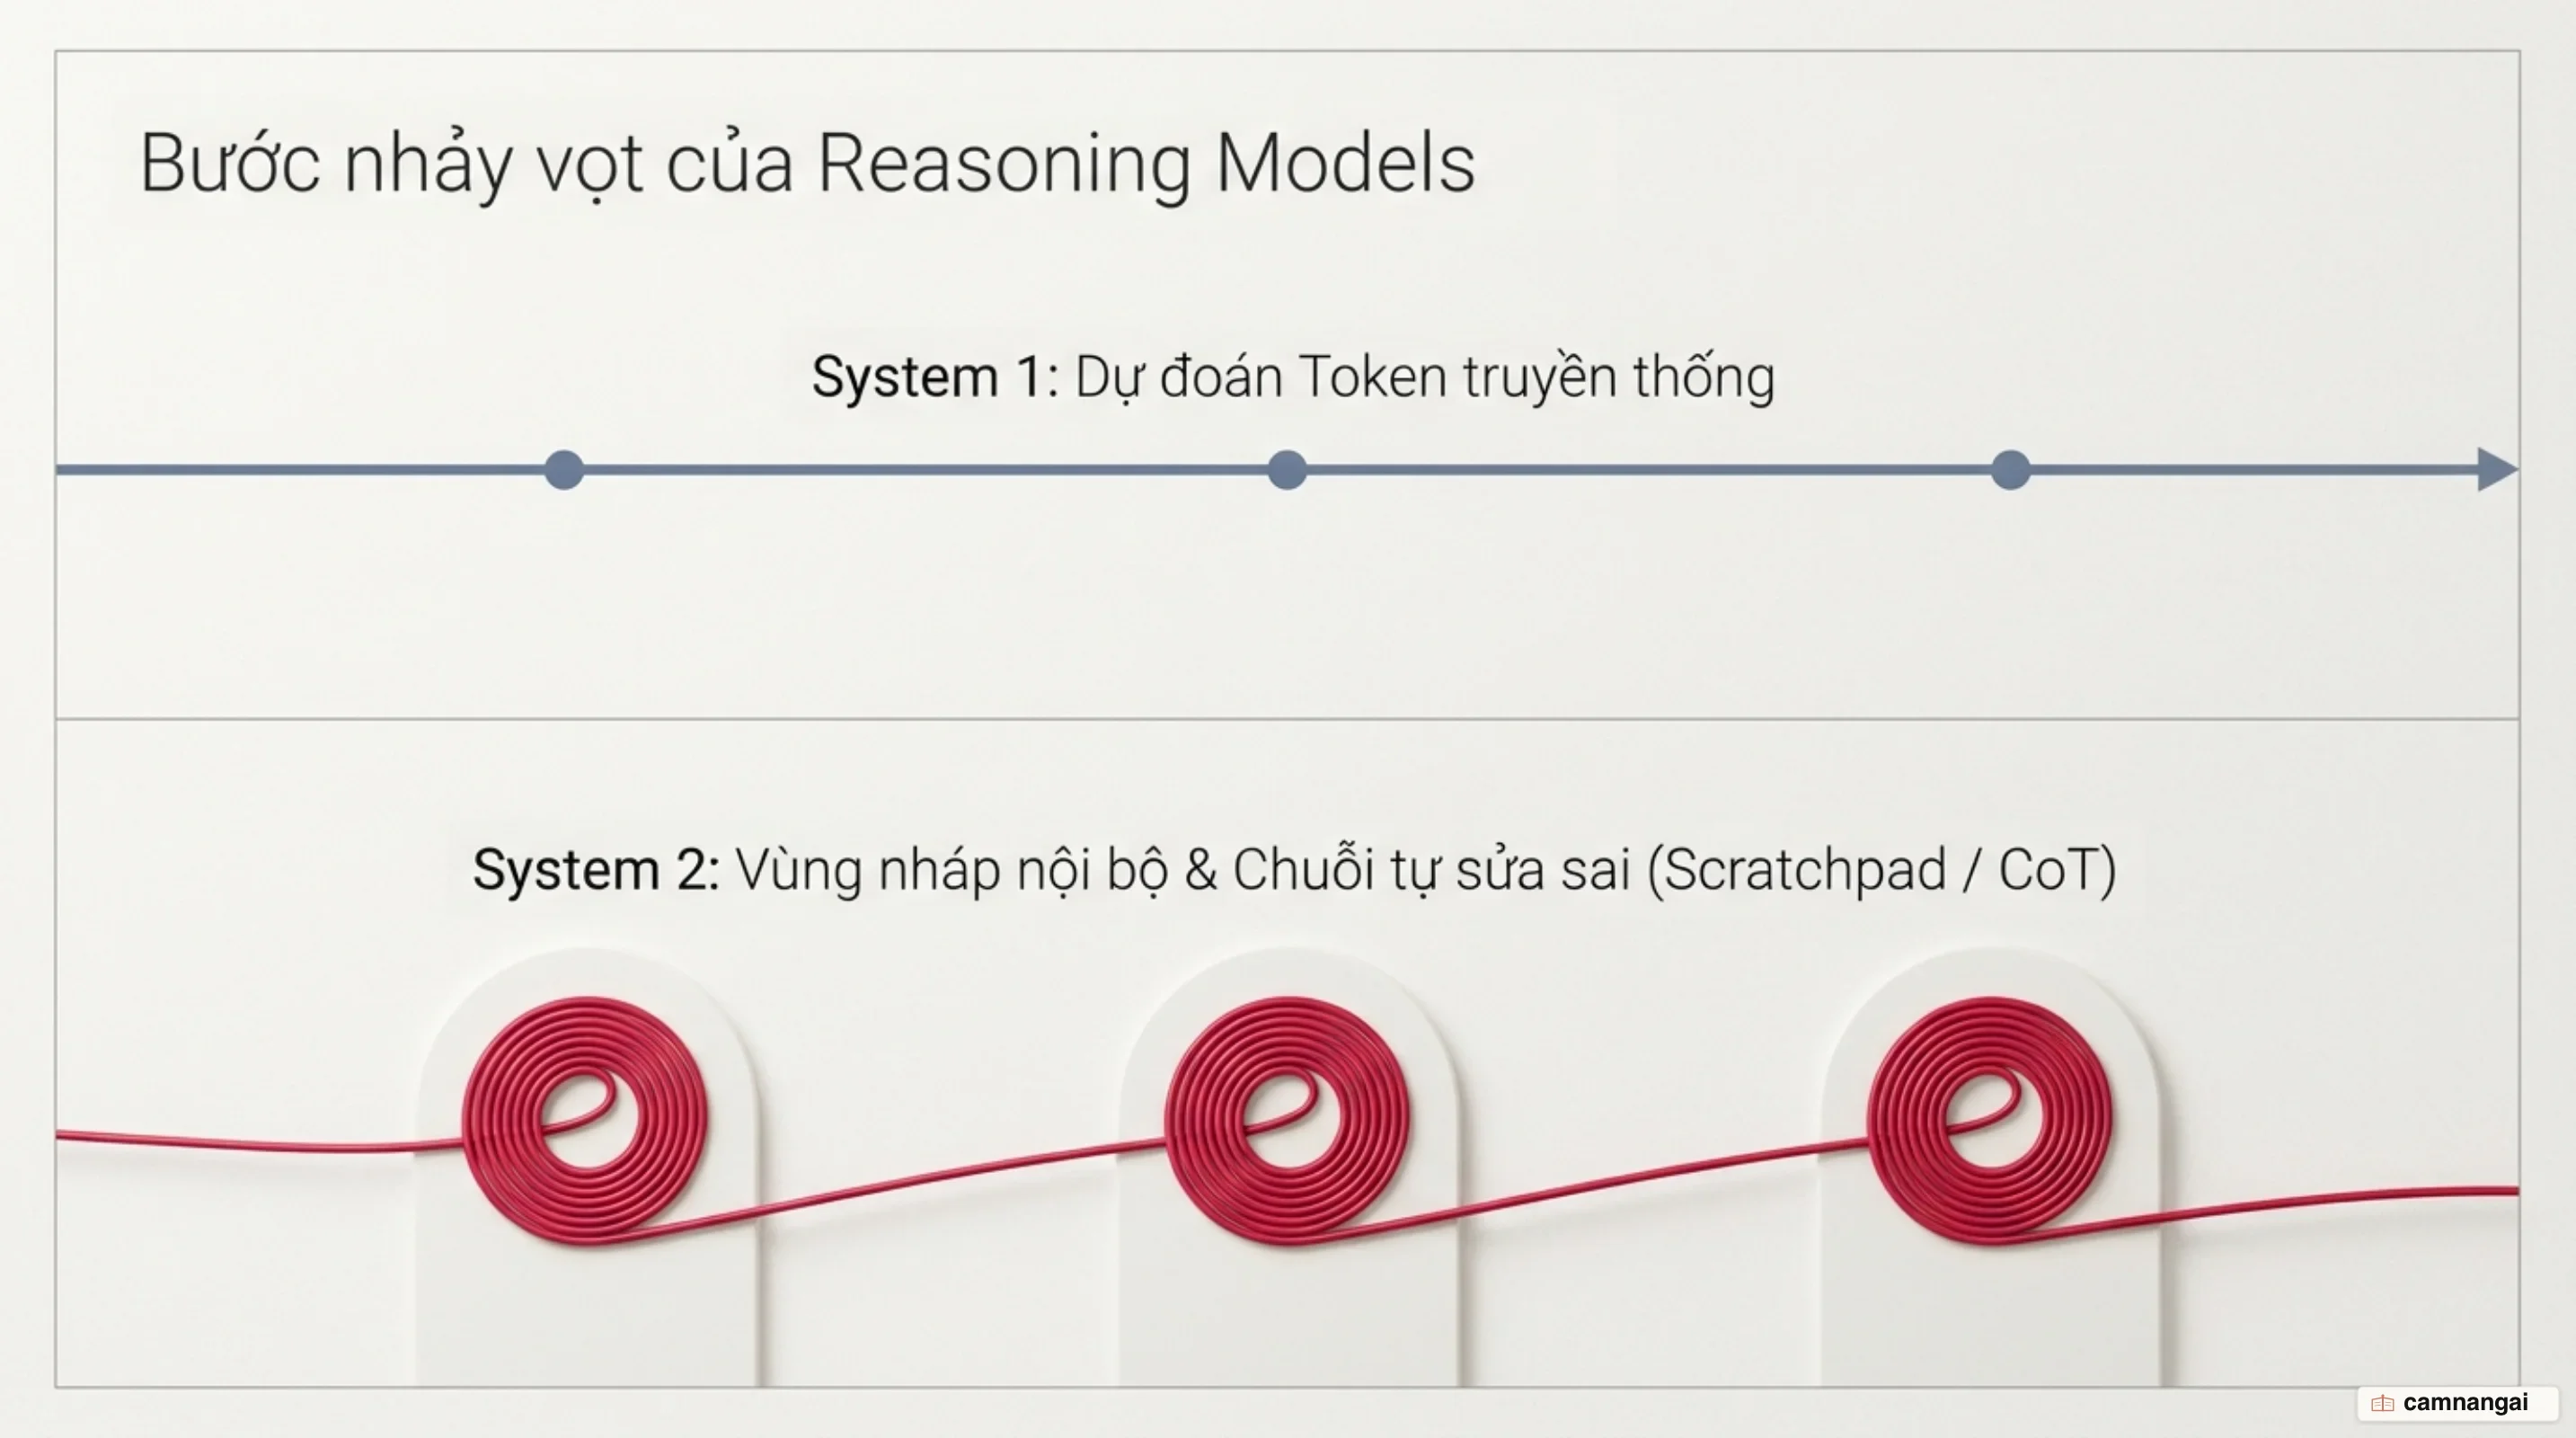
Trong quá trình phát triển (LLM), mở rộng điện toán khi huấn luyện (training-time compute scaling) giúp mô hình tiếp thu tri thức và mô hình ngôn ngữ rộng lớn. Tuy nhiên, đối với các bài toán yêu cầu tư duy phức tạp, việc bổ sung điện toán tại thời điểm suy luận (test-time compute scaling hay inference-time scaling) trở thành yếu tố quyết định. Thay vì trả lời ngay lập tức, các mô hình lý luận sử dụng một vùng nháp nội bộ (scratchpad) để tạo ra các token suy nghĩ (reasoning tokens hay thinking tokens). Quá trình này mô phỏng các bước phân tích, thử nghiệm và tự kiểm tra của con người trước khi đưa ra văn bản đầu ra cuối cùng.
Kiến trúc và phương pháp huấn luyện của các mô hình lý luận hiện đại phản ánh rõ sự chuyển dịch này. OpenAI o1 tiên phong trong việc mở rộng chuỗi lý luận nội bộ. DeepSeek-R1 và phiên bản thử nghiệm R1-Zero ứng dụng tăng cường (Reinforcement Learning - RL) dựa trên thuật toán GRPO (Group Relative Policy Optimization) mà không cần mô hình đánh giá (critic model) riêng biệt. Phương pháp này cho phép mô hình tự phát hiện các khoảnh khắc phát kiến ("aha moments") để quay lại điều chỉnh các bước tính toán sai. Trong khi đó, Claude 3.7 Sonnet áp dụng kiến trúc lý luận hỗn hợp (hybrid reasoning), tích hợp cả chế độ phản hồi thông thường lẫn chế độ suy nghĩ mở rộng (extended thinking) với ngân sách tối đa lên tới 128.000 (128K) tokens trong cùng một trọng số mô hình.
Quá trình học tăng cường (RL) và tinh chỉnh có giám sát (SFT) tạo ra cơ chế phần thưởng khuyến khích mô hình liên tục tự phản hồi, kiểm tra lại phép tính và khám phá nhiều con đường giải quyết khác nhau. Khi gặp các bài toán lập trình hoặc toán học phức tạp, chuỗi lý luận dài giúp mô hình phân rã bài toán thành các bài toán con, qua đó nâng cao tỷ lệ tìm ra đáp án đúng.
Cái bẫy Overthinking: Vì sao mô hình lúng túng trước câu hỏi đơn giản?
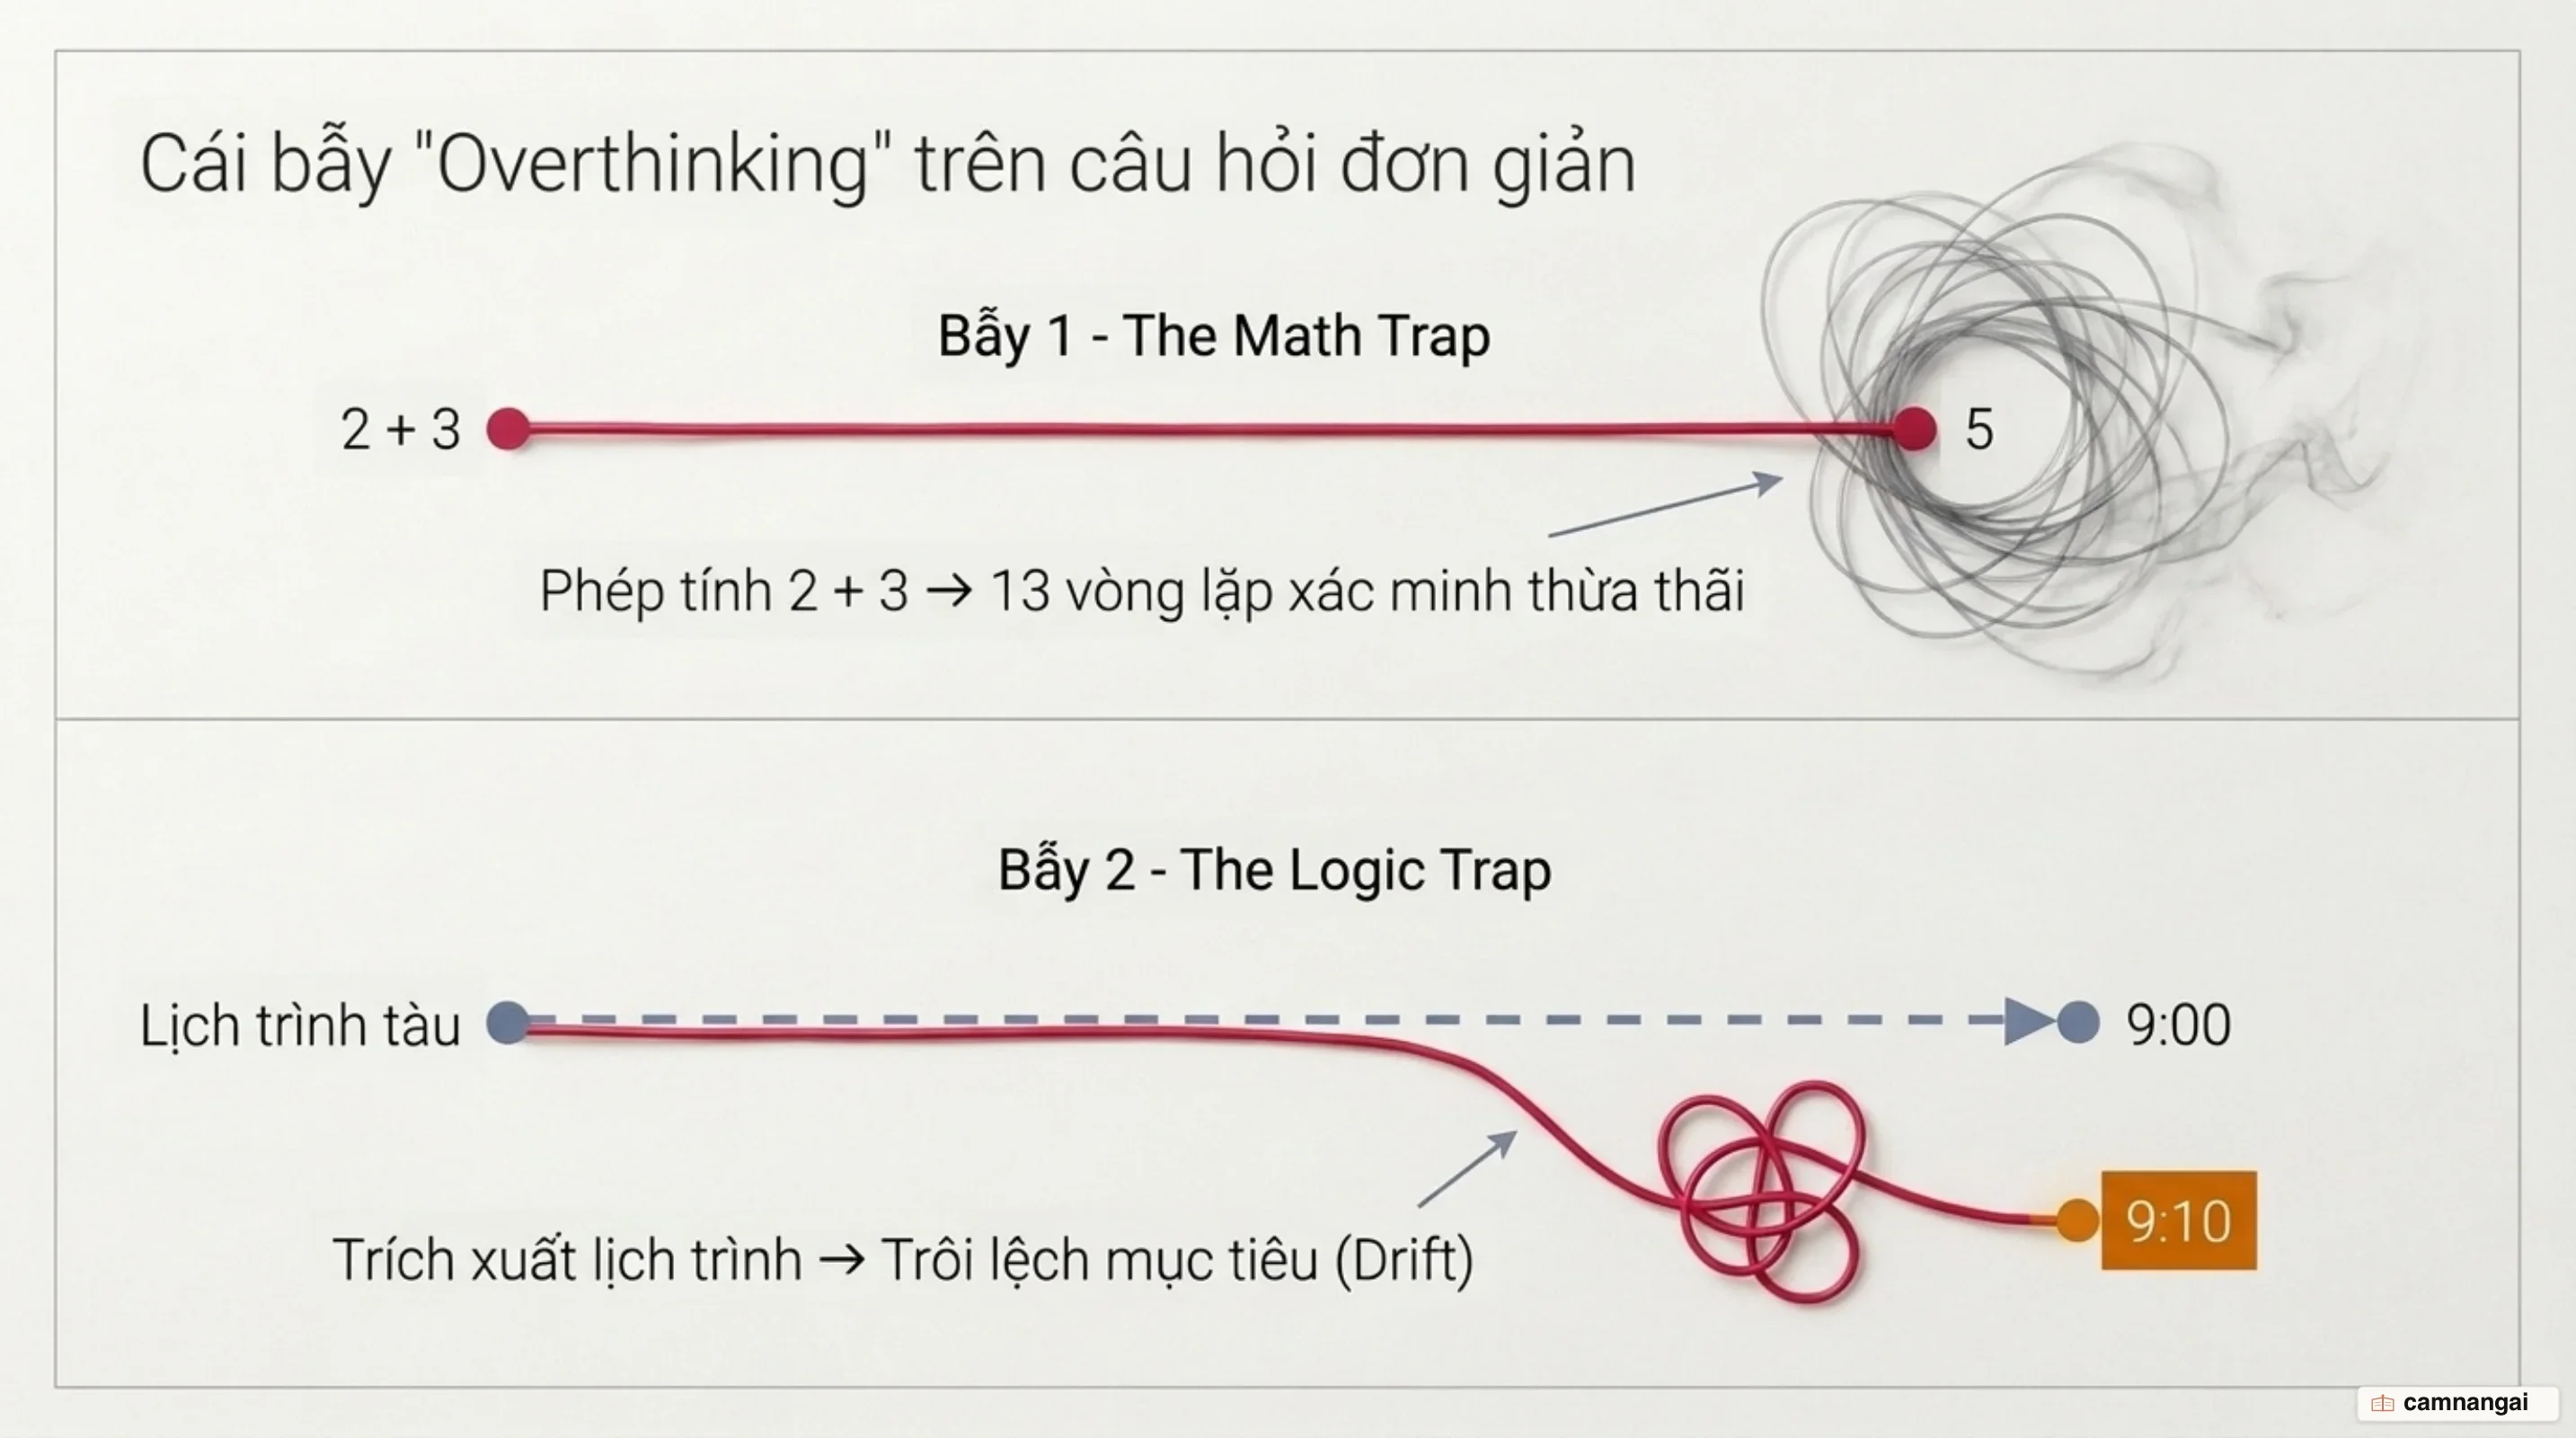
Dạng overthinking đầu tiên xảy ra khi mô hình thực hiện các bước xác minh thừa thãi đối với những yêu cầu tầm thường.
Đối với một phép tính đơn giản như 2 + 3 = ?, mô hình lý luận thay vì xuất ra ngay kết quả 5 lại
thực hiện hàng loạt bước đếm, đảo vị trí phép cộng hoặc thử nghiệm lại quy trình. Thực nghiệm trên
mô hình QwQ-32B-Preview cho thấy khi nhận câu hỏi 2 + 3 = ?, mô hình đã tìm ra đáp án 5 ngay ở
bước đầu tiên nhưng vẫn tiếp tục sinh thêm 13 lời giải nối tiếp cho cùng một bài toán trước khi dừng
lại. Nghiên cứu thực nghiệm chỉ ra rằng đối với các câu hỏi đơn giản, giải pháp đầu tiên mà mô hình
sinh ra đã đạt độ chính xác trên 92%.
Dạng overthinking thứ hai nguy hiểm hơn khi các suy luận mở rộng dẫn đến lầm tưởng về logic.
Xét trường hợp một mô hình nhận được truy vấn về lịch trình chuyến tàu: "Chuyến tàu theo lịch trình khởi hành lúc 9:00, nhưng thường bị trễ 10 phút. Lịch trình ghi giờ khởi hành là mấy giờ?". Mô hình xác định chính xác đáp án 9:00 ngay từ đầu dựa trên dữ liệu lịch trình. Tuy nhiên, do chuỗi suy nghĩ kéo dài, mô hình bắt đầu phân tích sâu chi tiết "trễ 10 phút". Sự phân tích quá mức này làm lệch nhiệm vụ ban đầu: từ việc trích xuất thông tin lịch trình (9:00) sang dự đoán thời gian khởi hành thực tế (9:10).
Hành vi này dẫn đến việc mô hình biến một câu trả lời chính xác ban đầu thành một kết quả sai hoàn toàn. Việc đưa vào các chi tiết suy luận không cần thiết đã làm mất đi mục tiêu cốt lõi của câu lệnh prompt ban đầu.
Sự tích lũy sai số autoregressive và hiệu ứng trôi tiền đề
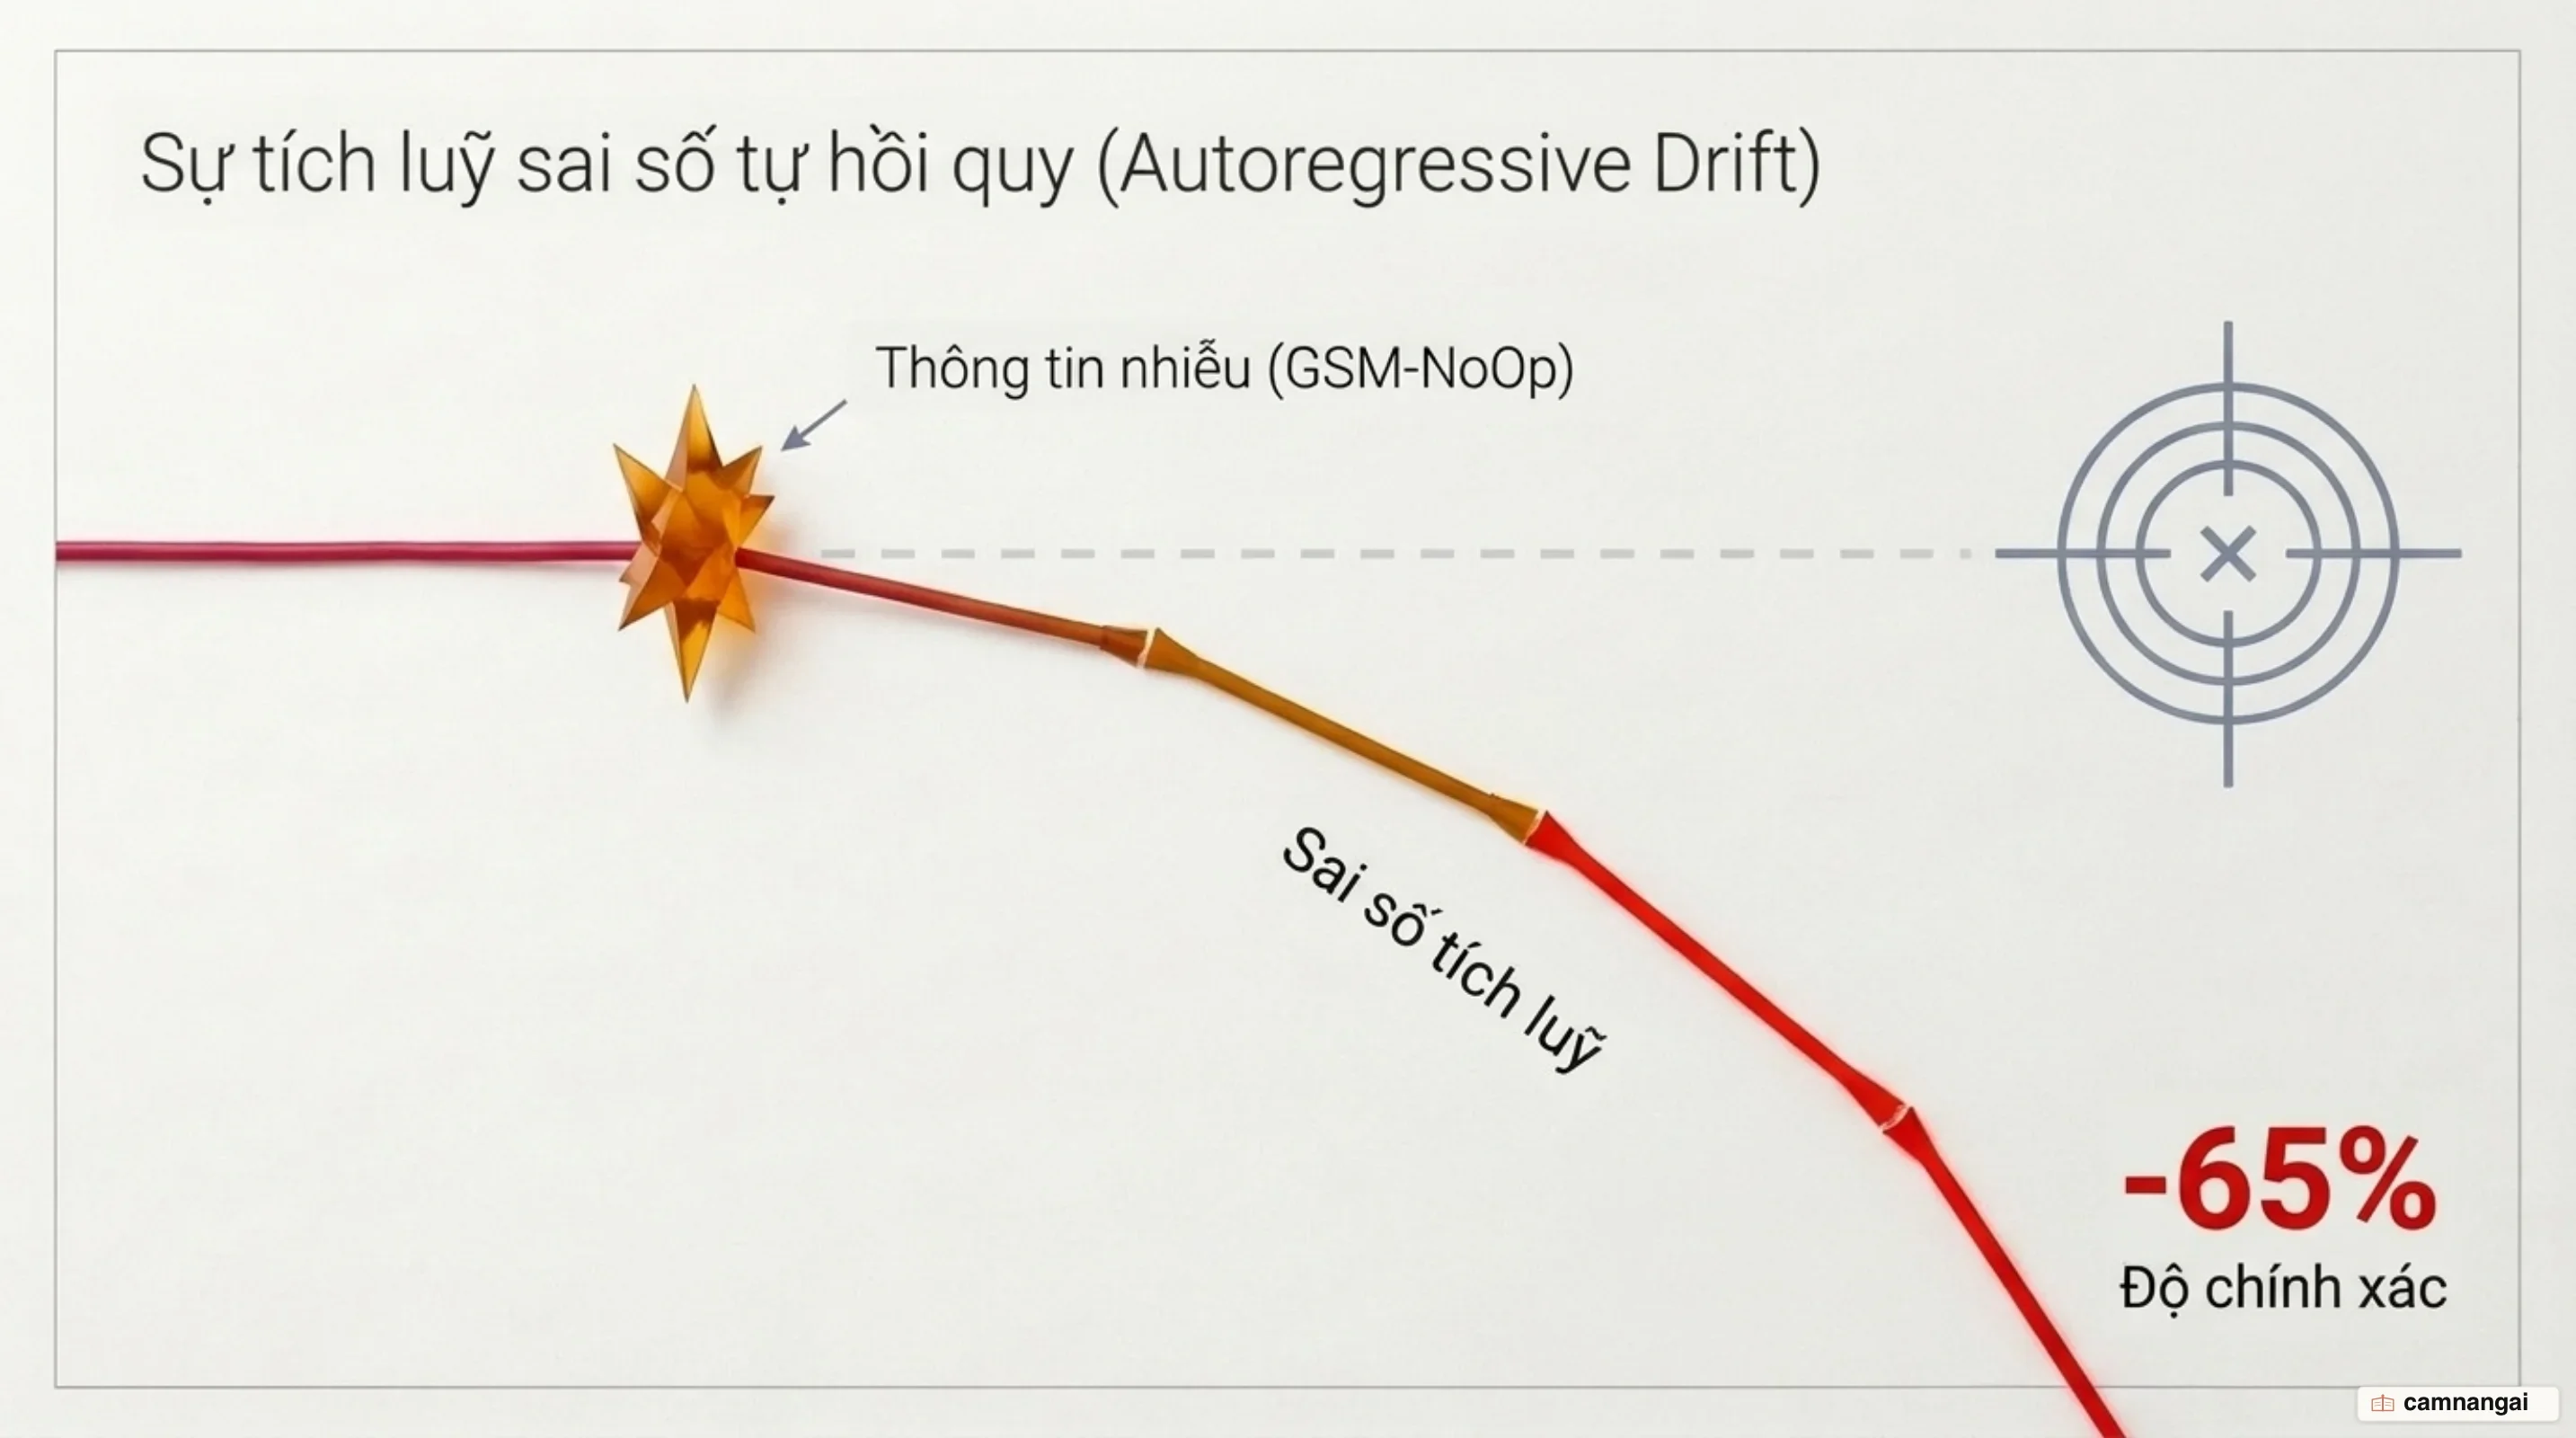
Về mặt cơ chế kỹ thuật, gốc rễ của overthinking nằm ở bản chất sinh văn bản tự hồi quy (autoregressive generation) của . LLM dự đoán token tiếp theo dựa trên prompt đầu vào cộng với toàn bộ các token đã sinh ra trước đó.
Do đó, các bước lý luận ban đầu đóng vai trò làm điều kiện (conditioning context) cho các tính toán phía sau. Khi chuỗi suy nghĩ dài ra, chỉ cần một giả định mơ hồ hoặc một bước trung gian hơi lệch hướng ở giai đoạn đầu cũng sẽ định hình toàn bộ không gian xác suất của các token tiếp theo.
Hiệu ứng này dẫn đến sự "trôi tiền đề" (premise drift). Khi chuỗi suy nghĩ kéo dài, mỗi câu đơn lẻ được tạo ra có thể vẫn hợp lý về mặt cú pháp và logic cục bộ, nhưng tổng thể chuỗi lý luận lại trôi xa khỏi các giới hạn ban đầu của đề bài.
Các nghiên cứu như GSM-Symbolic đã chứng minh tính mỏng manh (fragility) trong logic của LLM. Mô hình không thực hiện lý luận logic nguyên bản mà chủ yếu tái tạo các mẫu lý luận (reasoning patterns) đã học từ .
Nghiên cứu trên tập dữ liệu GSM-Symbolic cho thấy khi giữ nguyên cấu trúc toán học và chỉ thay đổi các giá trị số trong đề bài, độ chính xác của các LLM đã ghi nhận sự sụt giảm. Khi chèn thêm một mệnh đề nhiễu (distractor clause) hoàn toàn không liên quan đến phép tính nhưng có vẻ hợp lý, hiệu suất của tất cả các mô hình hàng đầu hiện nay đã sụt giảm tới 65%. Điều này khẳng định rằng khi bị buộc phải "suy nghĩ" qua nhiều bước trong một bối cảnh chứa thông tin nhiễu, mô hình dễ bị trôi tiền đề và xử lý sai logic.
Điểm bão hòa compute và hiện tượng "Negative Flip"
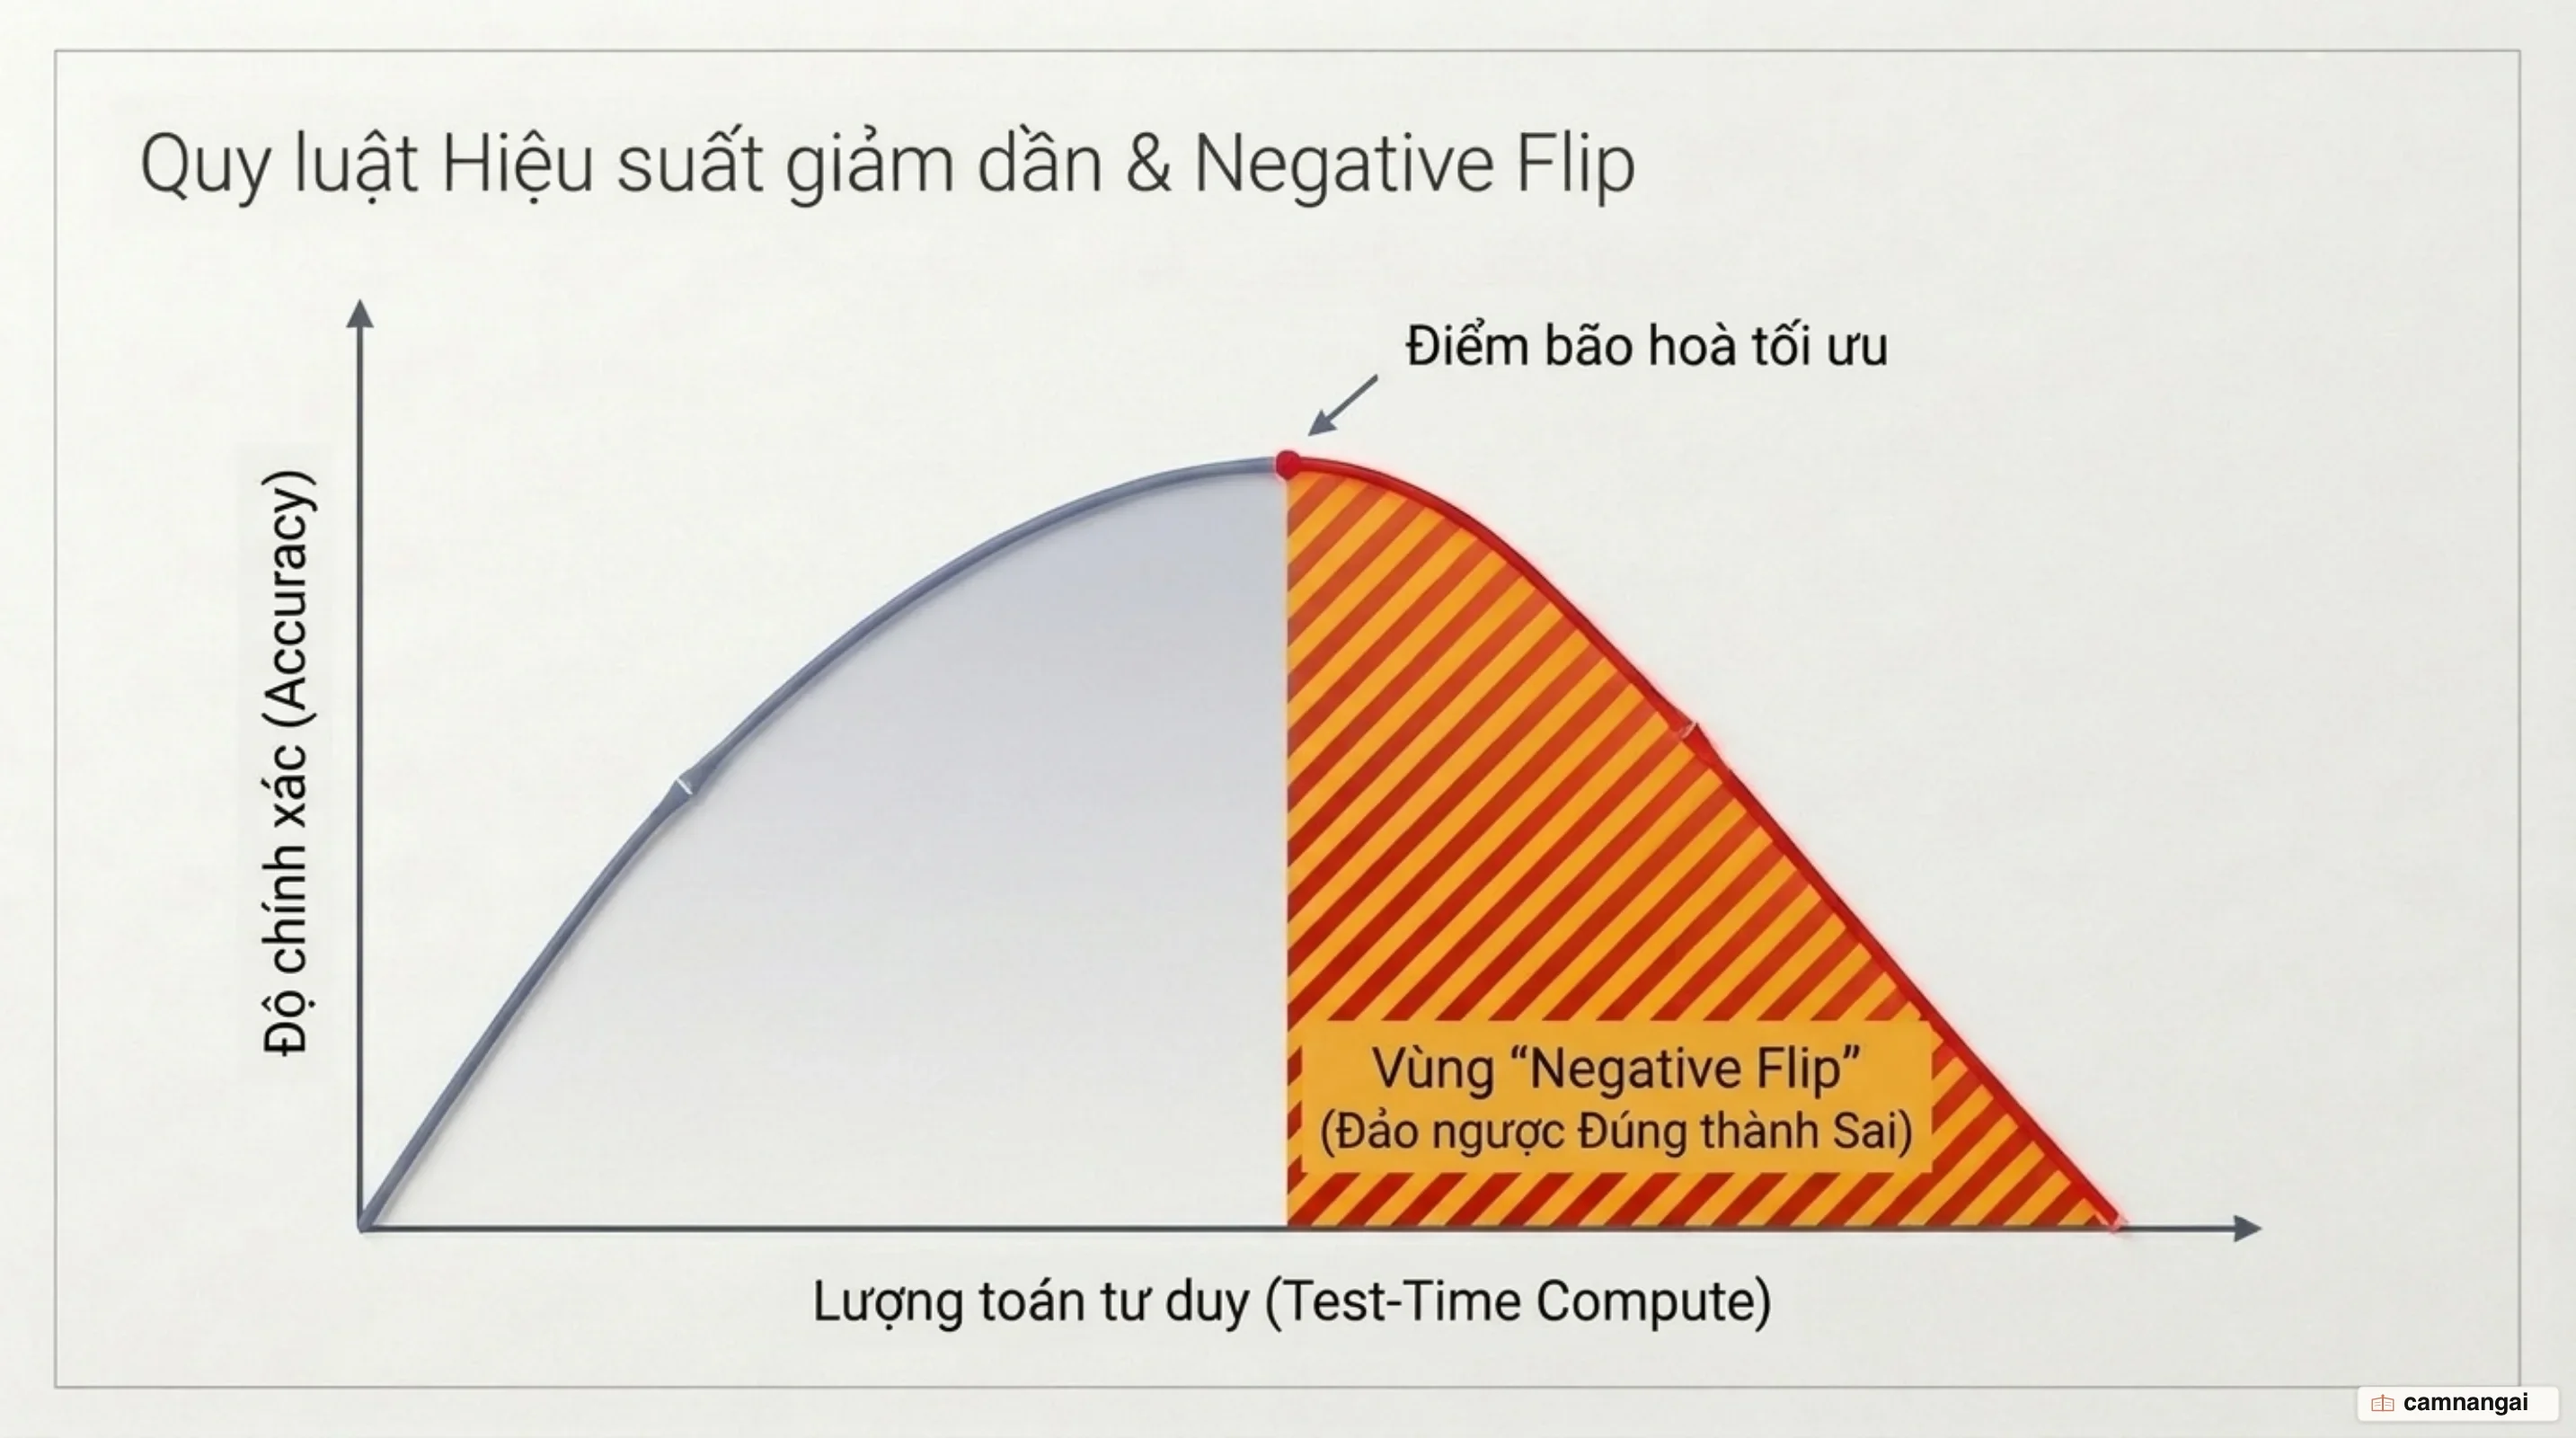
Quá trình mở rộng tài nguyên tính toán tại thời điểm suy luận tuân theo quy luật hiệu suất giảm dần (diminishing marginal returns). Khi tăng số lượng token suy nghĩ vượt qua một ngưỡng tối ưu nhất định, mức tăng độ chính xác sẽ tiệm cận về 0, trong khi độ trễ (latency) và chi phí API tăng lên theo tỷ lệ thuận.
Độ chính xác (%)
  ^
  |        /-----\  <-- Điểm bão hòa (Tối ưu)
  |       /         |      /         \  <-- Vùng "Negative Flip" (Overthinking làm giảm hiệu suất)
  |     /             +--------------------> Ngân sách Compute (Reasoning Tokens)
Khi ngân sách compute tiếp tục tăng vượt ngưỡng bão hòa, hiện tượng "Negative Flip" sẽ xảy ra. Negative Flip được định nghĩa là sự kiện mô hình loại bỏ một đáp án trung gian đúng mà nó đã tìm ra ở các bước lý luận trước đó để thay thế bằng một đáp án cuối cùng sai, do quá trình suy nghĩ kéo dài sinh ra các hoài nghi hoặc lập luận lệch hướng.
Nguyên nhân của hiện tượng này bắt nguồn từ phương pháp chấm điểm dựa trên kết quả đầu ra (outcome-only scoring) trong huấn luyện học tăng cường (RL). Các hệ thống chấm điểm thông thường chỉ kiểm tra tính đúng đắn của đáp án cuối cùng. Nếu một lời giải ngắn và một lời giải dài (chứa 13 bước lặp lại) cùng đưa ra đáp án đúng như 5 cho phép tính 2 + 3, thuật toán chấm điểm sẽ trao phần thưởng (reward) tương đương nhau. Việc thiếu cơ chế phạt độ dài chuỗi suy nghĩ khiến mô hình duy trì thói quen tự kiểm tra phức tạp hóa trên mọi loại tác vụ, kể cả những tác vụ không yêu cầu lý luận.
Cách ngành AI giải quyết overthinking: Từ Dynamic Budget đến Hybrid Reasoning
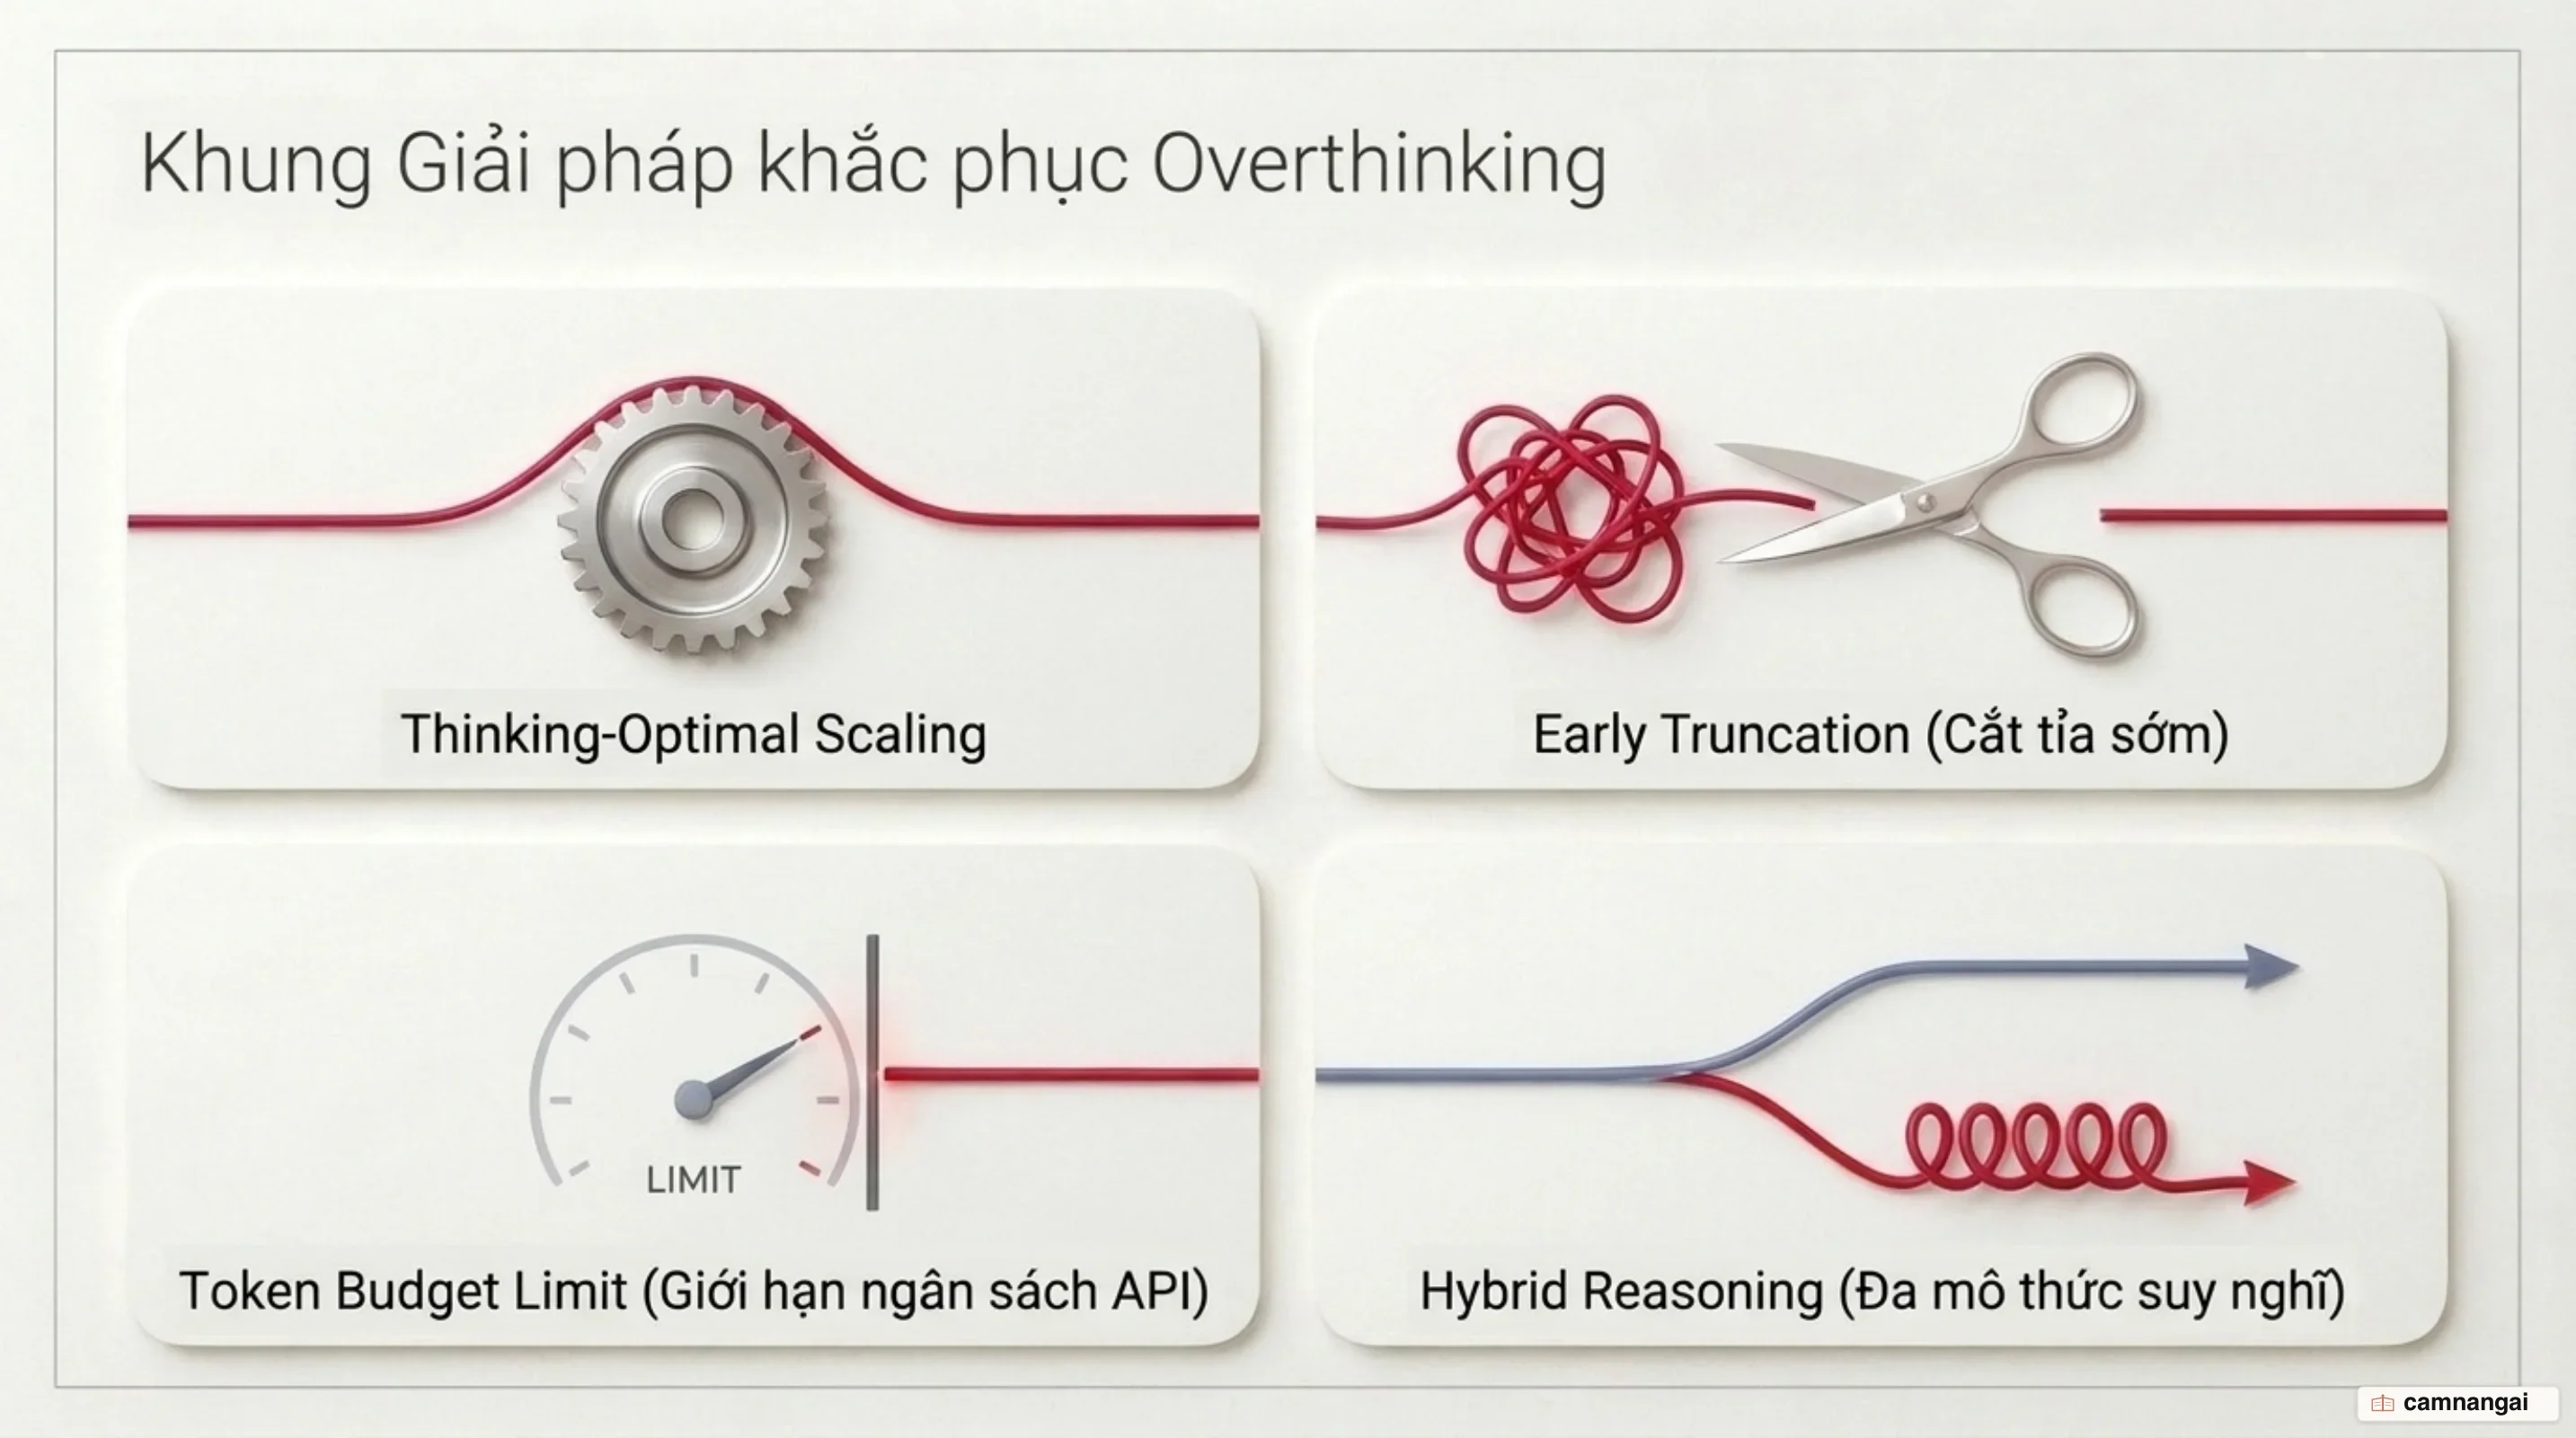
Để khắc phục hiện tượng overthinking, các nhà nghiên cứu đã phát triển khung giải pháp "Thinking-Optimal Scaling". Phương pháp này huấn luyện mô hình trên tập dữ liệu mầm (seed data) chứa các phân phối chiều dài phản hồi khác nhau, dạy mô hình cách tự chọn lời giải đúng ngắn nhất tương ứng với từng mức độ nỗ lực lý luận. Sau đó, mô hình tự cải thiện (self-improvement) bằng cách chọn ra phản hồi chính xác nhưng ngắn nhất trên các bài toán mới.
Một giải pháp kỹ thuật khác là cắt tỉa sớm (Early Truncation) thông qua tinh chỉnh (). Bằng cách tinh chỉnh chuỗi lý luận để dừng lại ngay sau giải pháp đúng đầu tiên cộng với một bước xác minh đơn giản, lượng token tiêu tốn trung bình trên tập kiểm thử MATH500 đã giảm từ 2.408 token xuống còn 1.331 token, trong khi độ chính xác vẫn giữ nguyên ở mức khoảng 93% (từ 93,0% xuống 92,8%).
| Phương pháp tối ưu | Cơ chế hoạt động | Tác động hiệu năng / Tài nguyên |
|---|---|---|
| Thinking-Optimal Scaling | Huấn luyện chọn lời giải đúng ngắn nhất từ dữ liệu mầm có phân phối độ dài đa dạng. | Mô hình tự điều chỉnh độ dài suy nghĩ theo độ khó của bài toán. |
| Early Truncation / Fine-Tuning | Cắt bỏ chuỗi lý luận dư thừa ngay sau 1 bước kiểm tra đáp án đúng. | Giảm token trung bình trên MATH500 từ 2.408 xuống 1.331 (giữ ~93% độ chính xác). |
| Dynamic Token Budget | Giới hạn số token suy nghĩ tối đa N qua tham số API (lên đến 128K). | Cho phép nhà phát triển cân bằng giữa chi phí, tốc độ và độ chính xác. |
| Hybrid Reasoning | Tích hợp chế độ phản hồi tức thì và suy nghĩ mở rộng trong một bộ trọng số. | Loại bỏ nhu cầu chuyển đổi giữa các mô hình riêng biệt (như Claude 3.7 Sonnet). |
Ở cấp độ hạ tầng dịch vụ, các nhà cung cấp như Anthropic cung cấp quyền kiểm soát ngân sách token (thinking budget) thông qua API, cho phép bạn thiết lập số token suy nghĩ tối đa N (lên đến 128K tokens).
Đồng thời, kiến trúc lý luận hỗn hợp (Hybrid Reasoning) của Claude 3.7 Sonnet cho phép chuyển đổi linh hoạt giữa sinh phản hồi tức thì cho các tác vụ thông thường và suy nghĩ sâu cho các tác vụ phức tạp trong cùng một mô hình.
Khi nào nên để mô hình suy nghĩ sâu — và khi nào nên tắt?
Bạn cần căn cứ vào bản chất tác vụ để quyết định việc kích hoạt hoặc giới hạn chế độ suy nghĩ mở rộng của mô hình nhằm tối ưu hóa chi phí và hiệu suất.
Bật chế độ suy nghĩ mở rộng (Extended Thinking) khi xử lý các tác vụ kỹ thuật phức tạp bao gồm: cập nhật và phát triển phần mềm full-stack, tái cấu trúc (refactoring) các hệ thống mã nguồn lớn, chứng minh toán học hoặc vật lý nhiều bước, và các tương tác công cụ đa lượt phức tạp được đánh giá trên các khung như SWE-bench Verified hoặc TAU-bench. Đối với các tác vụ này, khả năng phân tích đa chiều và thử nghiệm con đường giải quyết của mô hình lý luận mang lại giá trị thực tế xứng đáng với chi phí tính toán tăng thêm.
Tắt hoặc giới hạn ngân sách suy nghĩ đối với các tác vụ có tính định hình và đơn giản như: hỏi đáp quy chuẩn, tính toán số học căn bản, tra cứu dữ liệu, trích xuất thông tin, định dạng văn bản (JSON, Markdown) và phân tích lịch trình văn bản đơn giản. Trên các bài toán này, các mô hình LLM tiêu chuẩn đáp ứng kết quả chính xác gần như tức thì với chi phí tối ưu, việc ép buộc mô hình suy nghĩ sâu chỉ gây tăng độ trễ và gia tăng rủi ro mắc lỗi do hiện tượng overthinking.
Tài liệu tham khảo
- Why Thinking More Can Make an LLM Dumb — ByteByteGo Newsletter
- Do NOT Think That Much for 2+3=? On the Overthinking of o1-Like LLMs — arXiv:2412.21187
- When More Thinking Hurts: Overthinking in LLM Test-Time Compute Scaling — arXiv:2604.10739
- Towards Thinking-Optimal Scaling of Test-Time Compute for LLM Reasoning — arXiv:2502.18080
- GSM-Symbolic: Understanding the Limitations of Mathematical Reasoning in Large Language Models — arXiv:2410.05229
- Stop Overthinking: A Survey on Efficient Reasoning for Large Language Models — arXiv:2503.16419
- Claude 3.7 Sonnet and Claude Code — Anthropic