Quy trình chuyển đổi hàng trăm terabyte dữ liệu văn bản thô từ internet thành một (LLM) có khả năng tương tác tự nhiên là một chuỗi xử lý kỹ thuật phức tạp. Để huấn luyện LLM đạt hiệu năng tối ưu, bạn cần đưa hệ thống qua hàng loạt bước tinh chỉnh toán học và xử lý dữ liệu quy mô lớn trên cụm hạ tầng tính toán song song. Quá trình này không tạo ra một thực thể có trí tuệ tự nhận thức, mà xây dựng một hệ thống nhận dạng mẫu thống kê chính xác dựa trên xác suất xuất hiện của chuỗi ký tự.
Quy trình huấn luyện tiêu chuẩn hiện nay gồm 4 giai đoạn nối tiếp: Tiền huấn luyện (Pre-training), Tinh chỉnh có giám sát (Supervised Fine-Tuning - SFT), Mô hình hóa phần thưởng (Reward Modeling - RM), và Học tăng cường từ phản hồi con người (Reinforcement Learning from Human Feedback - ). Mỗi giai đoạn đảm nhận một cơ chế kỹ thuật riêng biệt, từ việc trích xuất tri thức diện rộng cho đến việc định hình hành vi phản hồi an toàn và chính xác cho hệ thống.
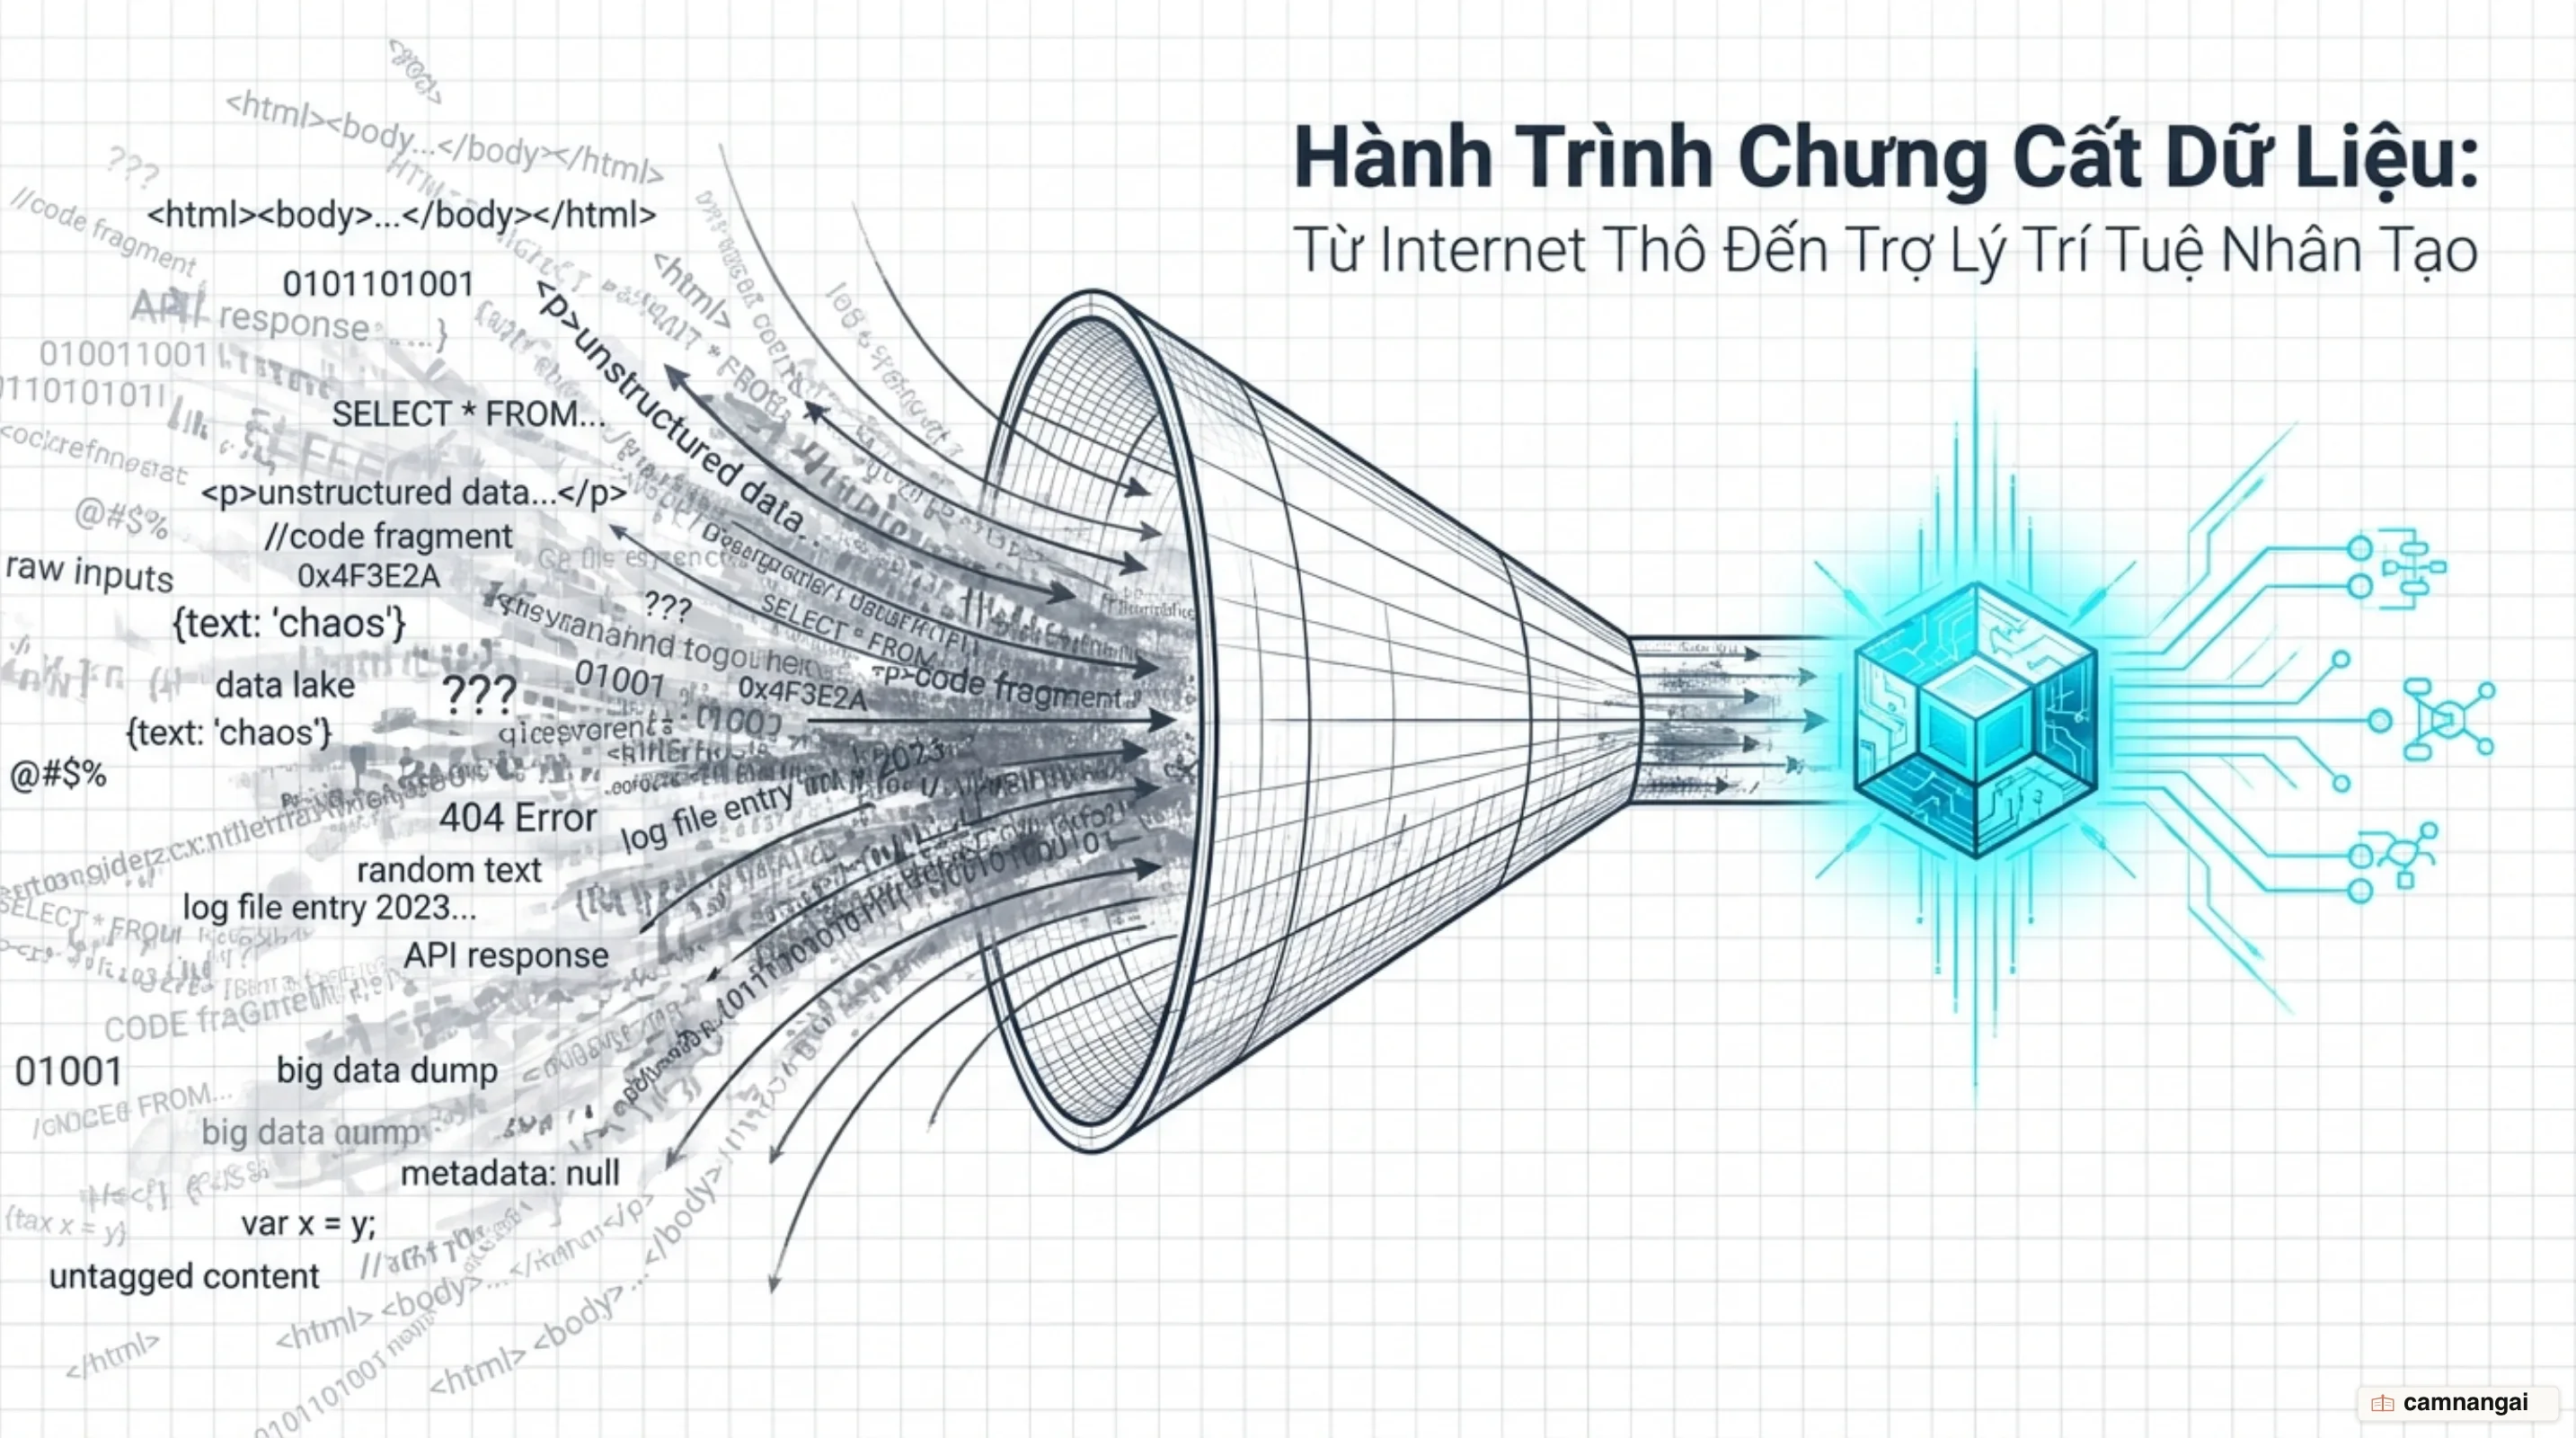
1. Dữ liệu tiền huấn luyện: Internet được sàng lọc và đóng gói ra sao?
Nguồn dữ liệu thô phổ biến nhất cho giai đoạn tiền huấn luyện là Common Crawl, kho lưu trữ web công cộng thu thập dữ liệu định kỳ.
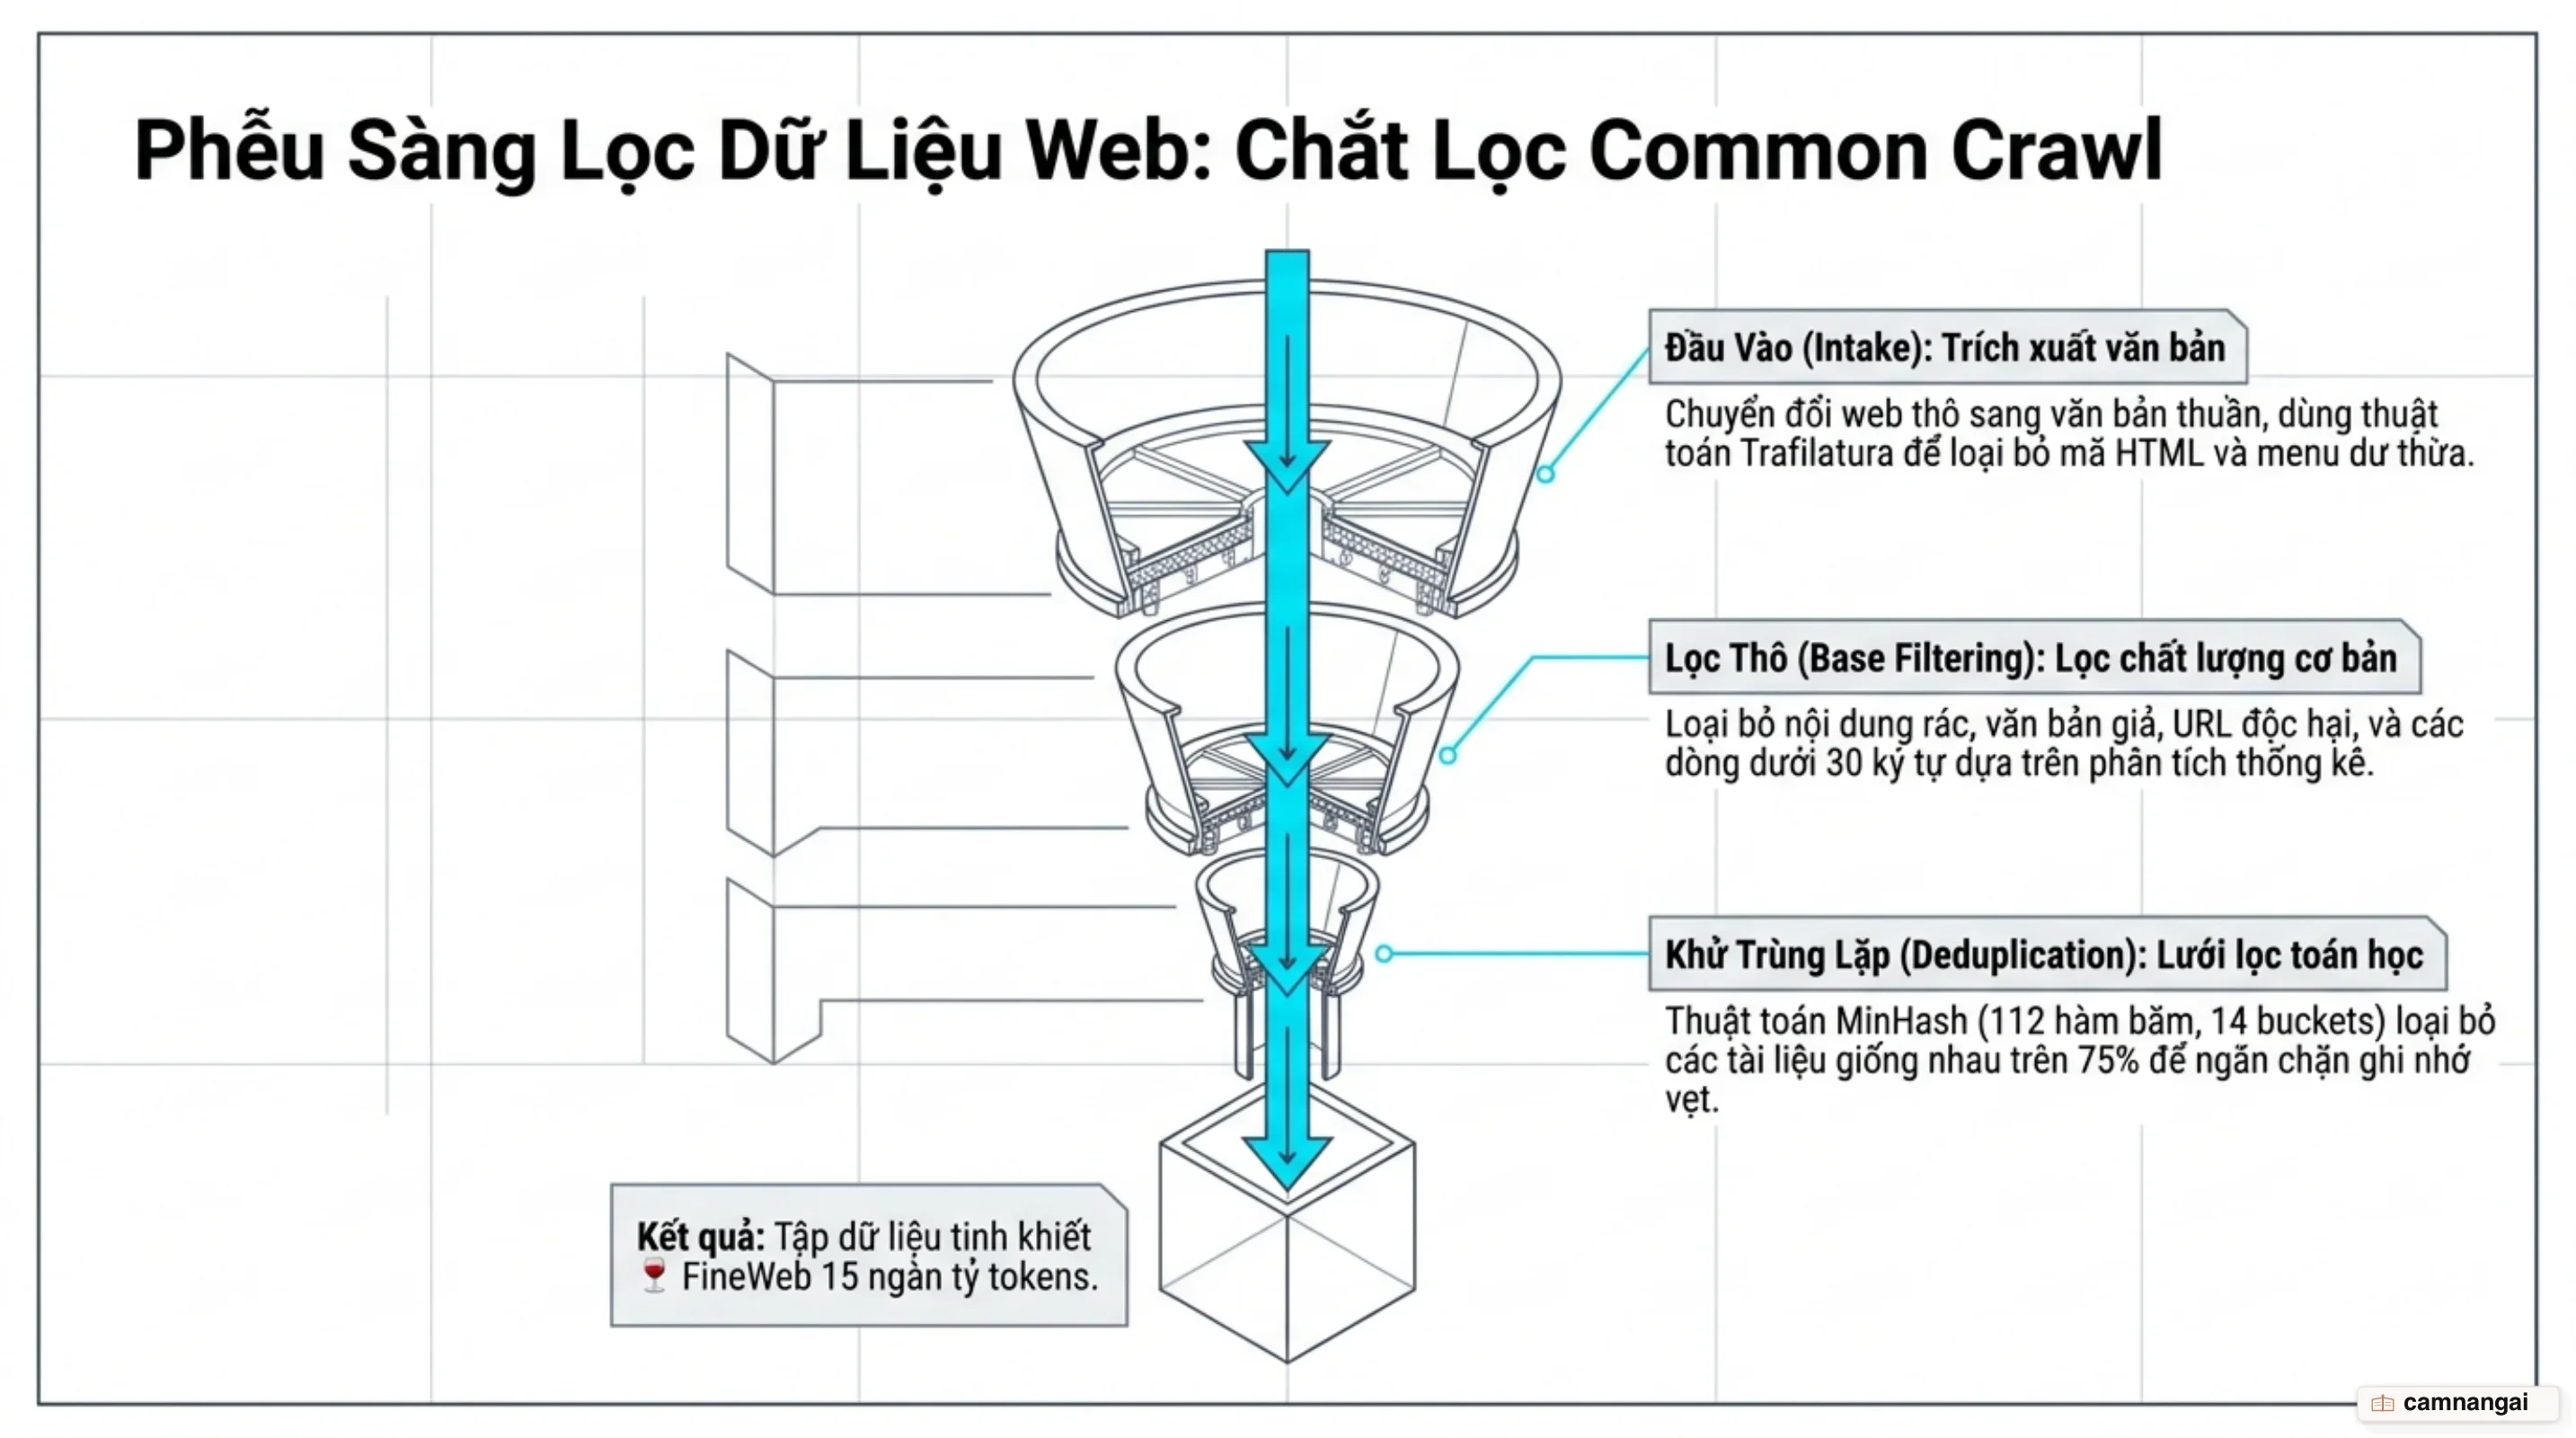
Mỗi bản snapshot (crawl) của Common Crawl chứa khoảng 200 đến 400 TiB dữ liệu HTML thô. Dữ liệu này được cung cấp ở hai định dạng chính: WARC (Web ARChive - chứa toàn bộ mã HTML thô và metadata) và WET (WARC Encapsulated Text - chỉ chứa văn bản đã trích xuất mặc định). Việc sử dụng trực tiếp các tập WET mang lại chất lượng thấp do thuật toán mặc định giữ lại quá nhiều thành phần rác như thanh điều hướng, menu và chân trang. Để đạt chất lượng tối ưu, quá trình xử lý tiên tiến trích xuất văn bản trực tiếp từ WARC bằng thư viện Trafilatura. Dù tốn chi phí tính toán hơn nhiều so với việc dùng sẵn WET, Trafilatura loại bỏ nội dung rác hiệu quả hơn và nâng cao độ chính xác của văn bản thu được.
Sau khi trích xuất, dữ liệu trải qua bước lọc cơ sở và đánh giá chất lượng. Quy trình này bắt đầu bằng việc lọc URL qua danh sách đen (blocklist) để loại bỏ nội dung người lớn, tiếp theo là phân loại ngôn ngữ bằng công cụ fastText nhằm giữ lại các văn bản tiếng Anh có điểm số tin cậy ≥ 0.65. Tiếp đó, các bộ lọc quy tắc từ MassiveText và C4 được áp dụng để loại bỏ các tài liệu rác: loại bỏ các dòng không kết thúc bằng dấu chấm câu (terminal punctuation), loại bỏ tài liệu chứa các ký tự đặc biệt của mã lập trình như dấu ngoặc nhọn { hay }, hoặc xóa văn bản chứa từ khóa rác (như thông báo cookie, câu lệnh JavaScript).
Khử trùng lặp (Deduplication) là bước tiếp theo nhằm tránh việc mô hình ghi nhớ máy móc thay vì học quy luật.
Thuật toán MinHash được sử dụng phổ biến với cấu hình chọn các chuỗi 5-gram từ từ vựng, tính toán 112 hàm hash chia thành 14 bucket (mỗi bucket 8 hash) để phát hiện các tài liệu có độ tương đồng từ 75% trở lên. Một phát hiện kỹ thuật quan trọng trong xử lý dữ liệu web là: nếu thực hiện khử trùng lặp toàn bộ trên tất cả các crawl (global dedup), hệ thống sẽ loại bỏ tới 94% dữ liệu của các crawl cũ, làm suy giảm nghiêm trọng hiệu năng mô hình do vô tình giữ lại các dữ liệu rác không bị trùng lặp. Ngược lại, thực hiện khử trùng lặp độc lập trên từng crawl (independent dedup per dump) giữ lại khoảng 20 nghìn tỷ và mang lại hiệu năng tối ưu nhất trên các bài kiểm tra đánh giá (benchmarks).
Cuối cùng, dữ liệu văn bản thuần được chuyển đổi sang dạng số thông qua thuật toán mã hóa Token (Tokenization), điển hình là Byte Pair Encoding (BPE). Thuật toán này tách văn bản thành các đơn vị token (từ hoặc mảnh từ, ví dụ từ "unhappiness" được tách thành hai mảnh "un" và "happiness") và ánh xạ mỗi token thành một số nguyên duy nhất dựa trên từ điển cố định từ 50.000 đến 100.000 token.
2. Tiền huấn luyện: Học quy luật ngôn ngữ qua việc đoán token tiếp theo
Giai đoạn tiền huấn luyện tiêu tốn hơn 98% toàn bộ ngân sách tính toán trong vòng đời của một LLM. Ở giai đoạn này, mô hình được khởi tạo với các ma trận tham số mang giá trị thống kê ngẫu nhiên. Nhiệm vụ cốt lõi mà mô hình phải thực hiện trong suốt quá trình tiền huấn luyện là dự đoán token tiếp theo (next-token prediction).
Mô hình nhận một chuỗi đầu vào gồm vài nghìn token, sau đó tính toán phân phối xác suất trên toàn bộ
bộ từ vựng V để chọn ra token có khả năng xuất hiện tiếp theo cao nhất. Kết quả dự đoán này được
so sánh trực tiếp với token thực tế tiếp theo trong tập để tính toán hàm tổn thất
entropy chéo (cross-entropy loss):
Loss_CE = -sum(y_i * log(y_hat_i))Trong đó y_i là phân phối thực tế (one-hot vector) và y_hat_i là xác suất dự đoán của mô hình. Điểm số tổn thất càng cao đồng nghĩa với việc dự đoán của mô hình càng sai lệch so với thực tế.
Để giảm điểm số tổn thất, thuật toán lan truyền ngược (backpropagation) được kích hoạt để tính toán đạo hàm, xác định chính xác hướng và mức độ ảnh hưởng của từng tham số đối với lỗi sai chung. Sau đó, thuật toán tối ưu hóa (Gradient Descent) sẽ cập nhật trọng số của tất cả các tham số theo hướng giảm thiểu tổn thất bằng những lượng cực nhỏ (ví dụ 0.00001). Quá trình này được phân bổ trên hạ tầng máy tính song song quy mô lớn, tính toán trên các global batch size lên đến hàng triệu token thông qua kỹ thuật song song dữ liệu (data parallelism) và song song mô hình (model parallelism) trên hàng nghìn GPU/TPU, tiêu thụ hàng megawatt điện năng với chi phí hàng triệu USD.
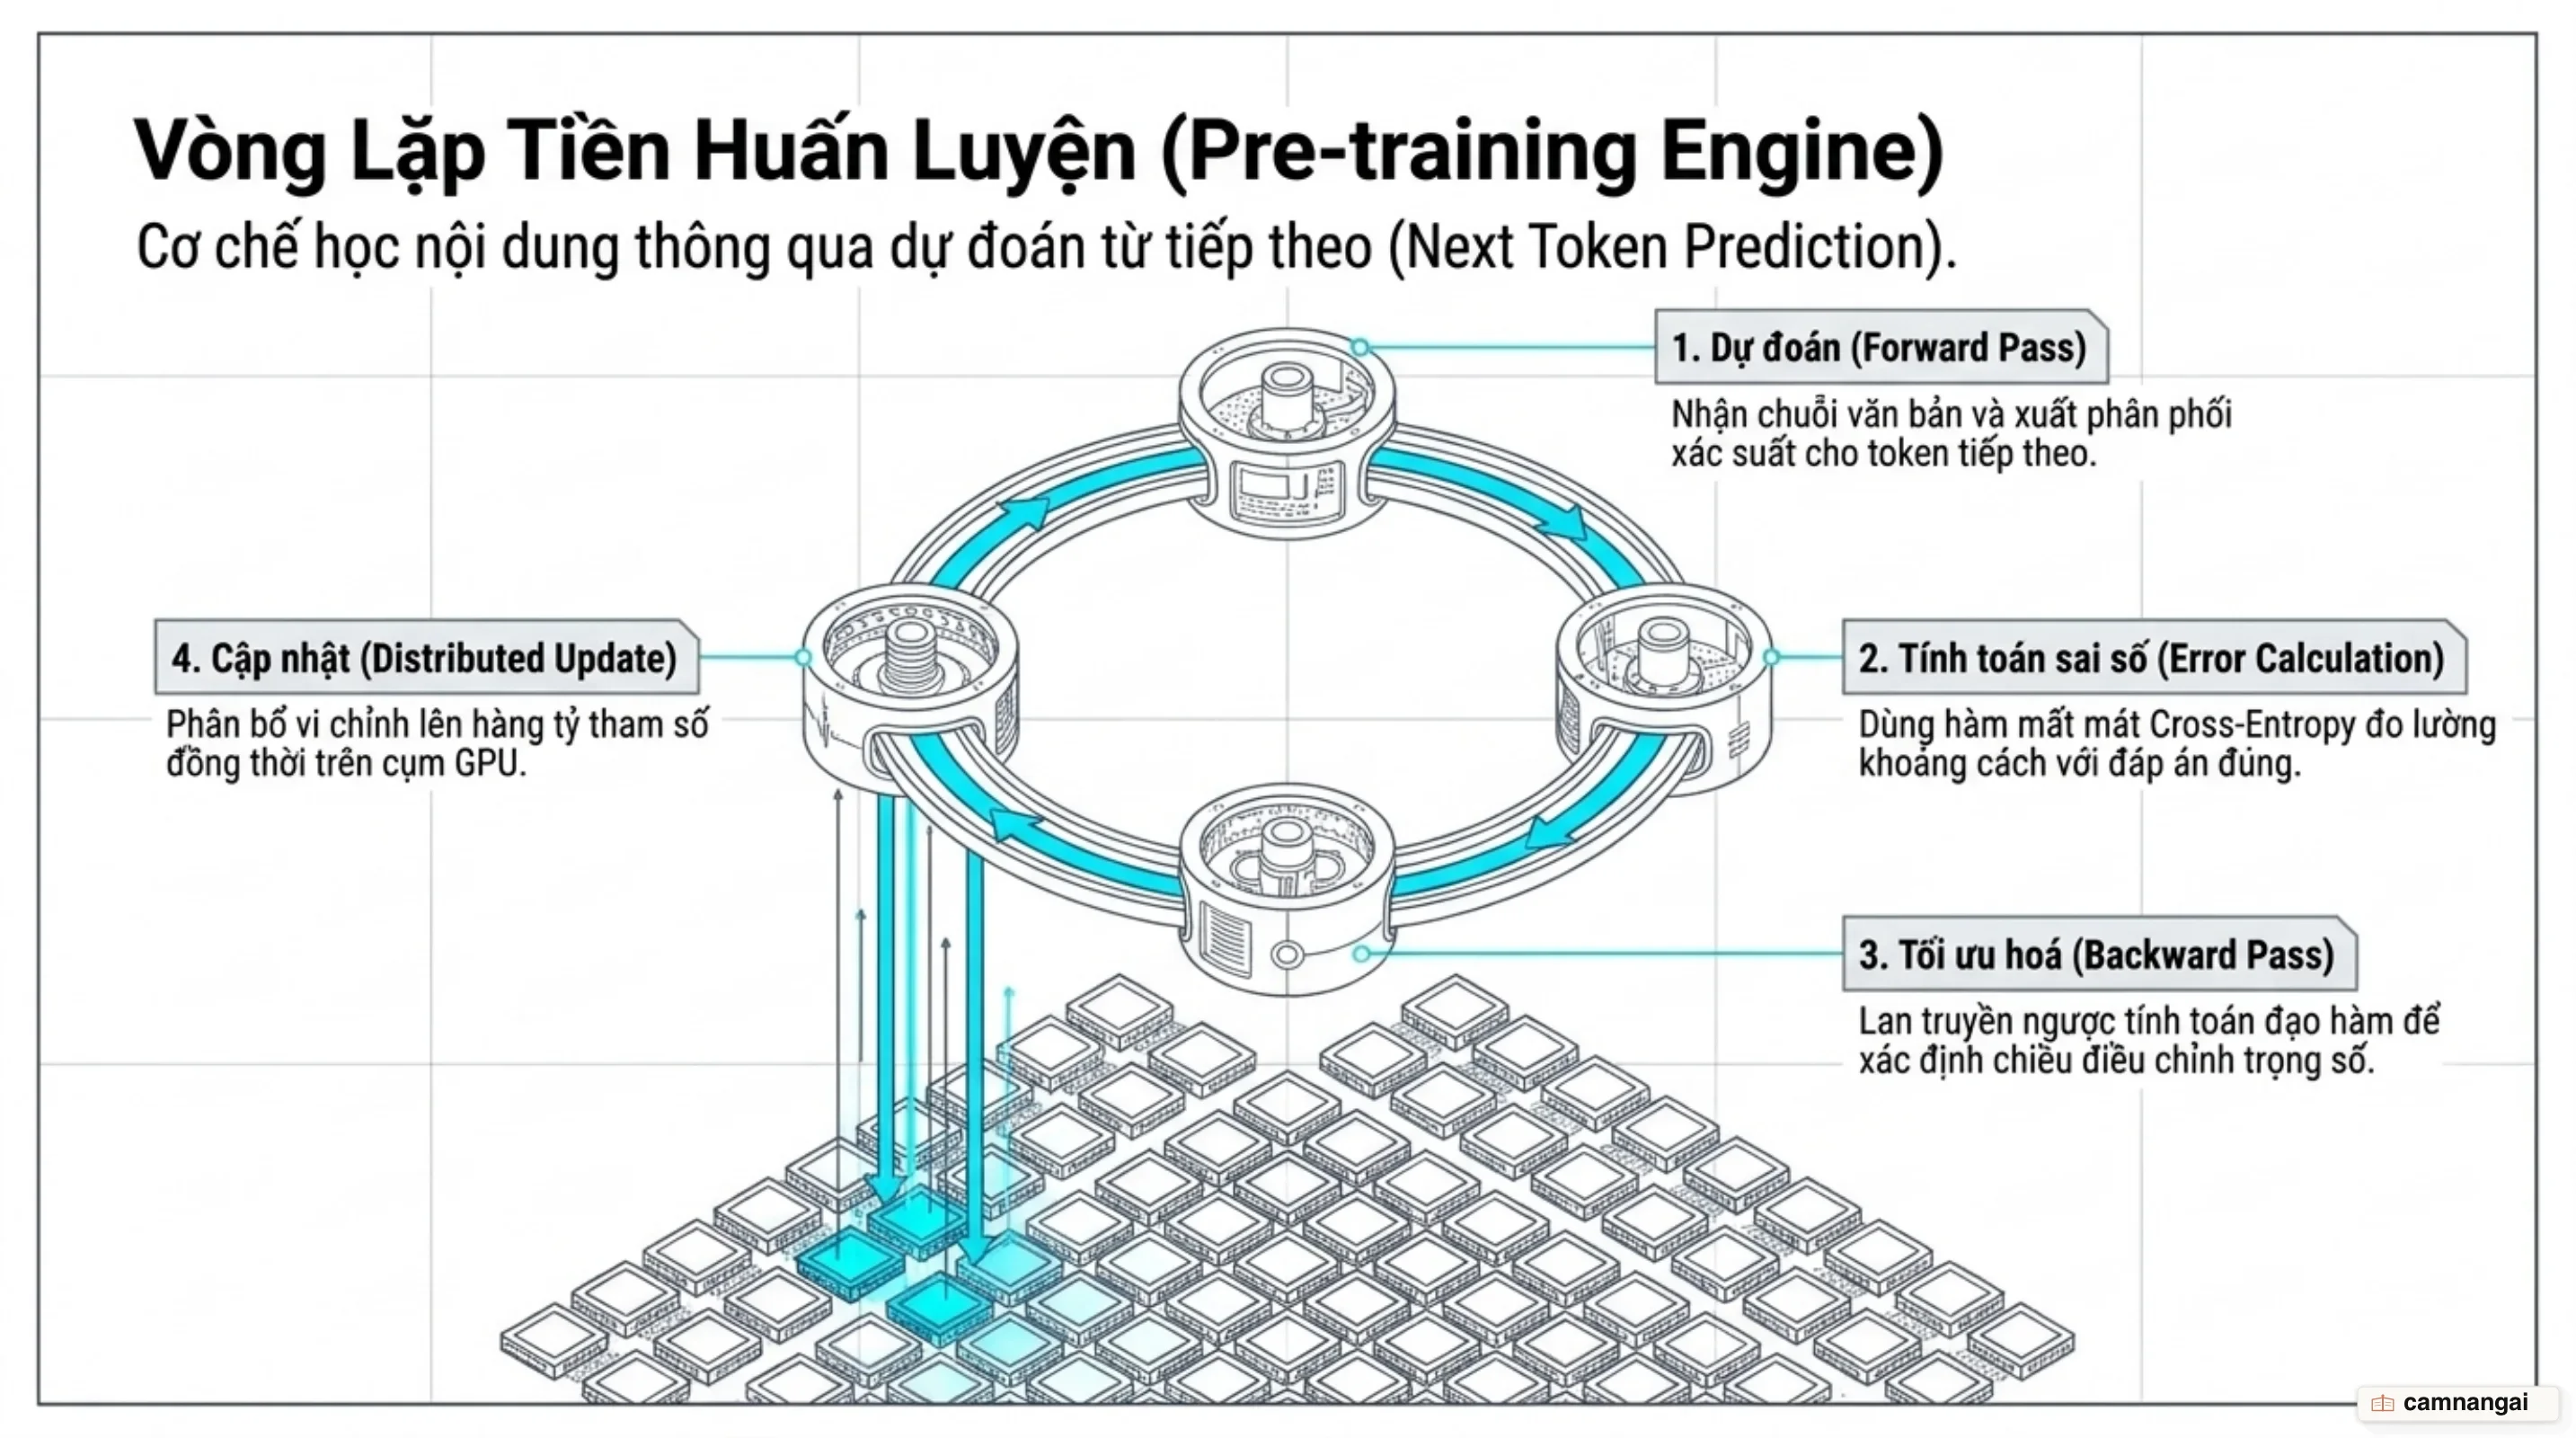
Qua hàng nghìn tỷ lượt lặp dự đoán, tính toán tổn thất và cập nhật trọng số, mô hình tự hình thành các năng lực ngôn ngữ phức tạp. Các cấu trúc cú pháp, tri thức thực tế và khả năng suy luận logic xuất hiện một cách tự nhiên như một thuộc tính mới nổi (emergent capabilities) từ nhiệm vụ đoán từ tiếp theo, mà không cần bất kỳ dòng mã lập trình thủ công nào về quy tắc ngôn ngữ.
3. Kiến trúc Transformer: Vì sao cơ chế Attention xử lý được dữ liệu quy mô web?
Trước khi kiến trúc ra đời vào năm 2017, các tuần tự (RNN) xử lý văn bản bằng cách đọc từng từ một từ trái sang phải. Phương pháp này tạo ra hai điểm nghẽn kỹ thuật lớn: mô hình dễ bị "quên" ngữ cảnh khi khoảng cách giữa các từ quá xa, và quá trình tính toán không thể phân tách để thực hiện song song trên nhiều bộ xử lý.
Kiến trúc Transformer giải quyết triệt để vấn đề này nhờ cơ chế Tự chú ý (Self-Attention). Cơ chế này cho phép tất cả các token trong một chuỗi tương tác và tính toán mối liên hệ trực tiếp với nhau ngay lập tức, bất kể khoảng cách vị trí giữa chúng. Ví dụ, trong câu "Con vật không đi qua đường vì nó quá mệt", cơ chế Attention sẽ tính toán điểm đại số để kết nối token "nó" với "con vật" thay vì "con đường", giúp mô hình giải mã chính xác đại từ dựa trên toàn bộ ngữ cảnh xung quanh.
Về cấu trúc phần cứng và luồng dữ liệu, Transformer được xây dựng từ hàng chục tầng (layers) xếp chồng lên nhau. Dữ liệu đầu vào dưới dạng các vector token sẽ đi qua từng tầng để liên tục nâng cấp độ biểu diễn:
- Các tầng đầu tiên trích xuất cú pháp cơ bản và mối quan hệ từ vựng ngắn.
- Các tầng giữa học các quan hệ ngữ nghĩa phức tạp và ngữ cảnh đoạn văn.
- Các tầng sâu nhất mã hóa các khái niệm trừu tượng, khả năng suy luận và ngữ cảnh diện rộng.
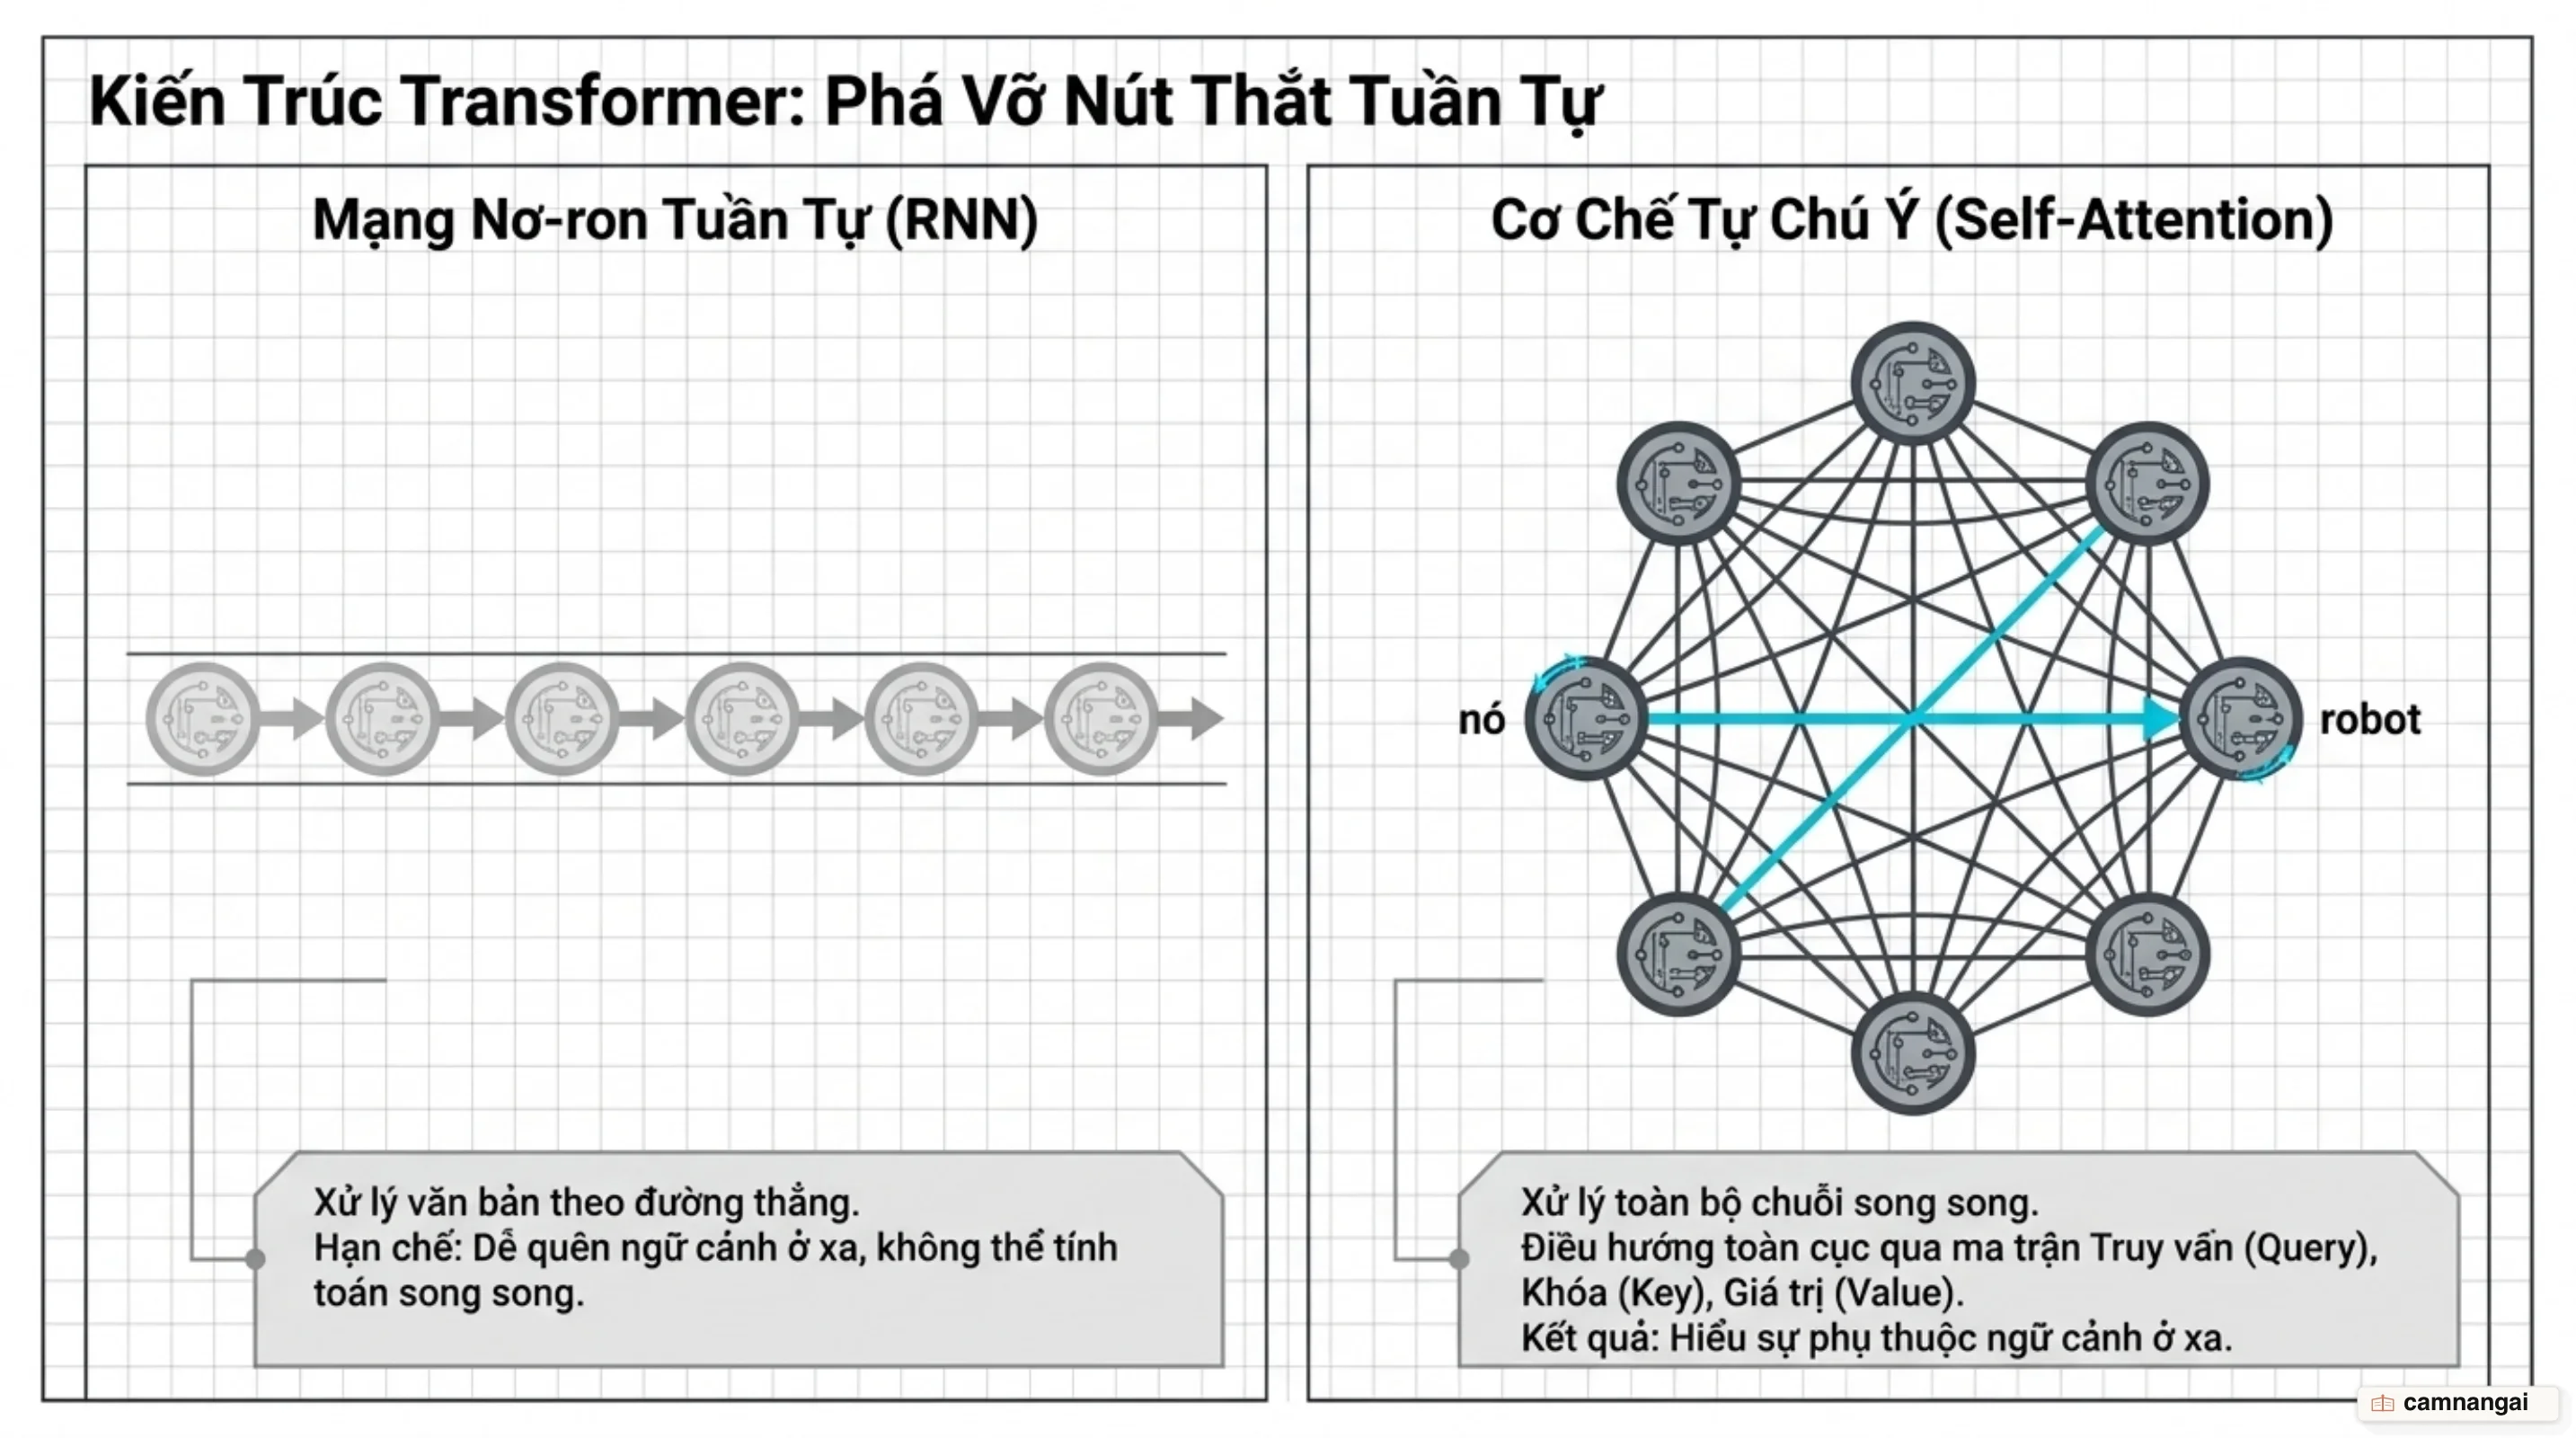
Nhờ tính chất loại bỏ sự phụ thuộc tuần tự của cơ chế Attention, Transformer cho phép phân chia dữ liệu để huấn luyện đồng thời trên các cụm máy tính khổng lồ. Kiến trúc này cũng giúp mở rộng cửa sổ ngữ cảnh () của mô hình từ vài trăm token lên đến hàng chục nghìn token mà vẫn duy trì được độ chính xác khi truy xuất thông tin.
4. Mô hình gốc chưa phải là chatbot: Khoảng cách giữa mô phỏng văn bản và trợ lý
Mô hình hoàn tất giai đoạn tiền huấn luyện được gọi là mô hình gốc (Base Model). Dù sở hữu tri thức sâu rộng về ngôn ngữ và thông tin, mô hình gốc vẫn chưa thể hoạt động như một trợ lý AI hay một chatbot hội thoại.
Về bản chất, mô hình gốc hoạt động như một công cụ mô phỏng tài liệu internet. Khi bạn đặt một câu hỏi như: "Làm thế nào để tạo file trong Python?", mô hình gốc không hiểu rằng bạn đang nhờ nó hướng dẫn. Thay vào đó, nó đối xử câu hỏi của bạn như phần mở đầu của một trang diễn đàn hoặc một bài tập trực tuyến, và có xu hướng viết tiếp: "Bài tập 2: Làm thế nào để xóa file trong Python? Hãy viết câu trả lời dưới đây".
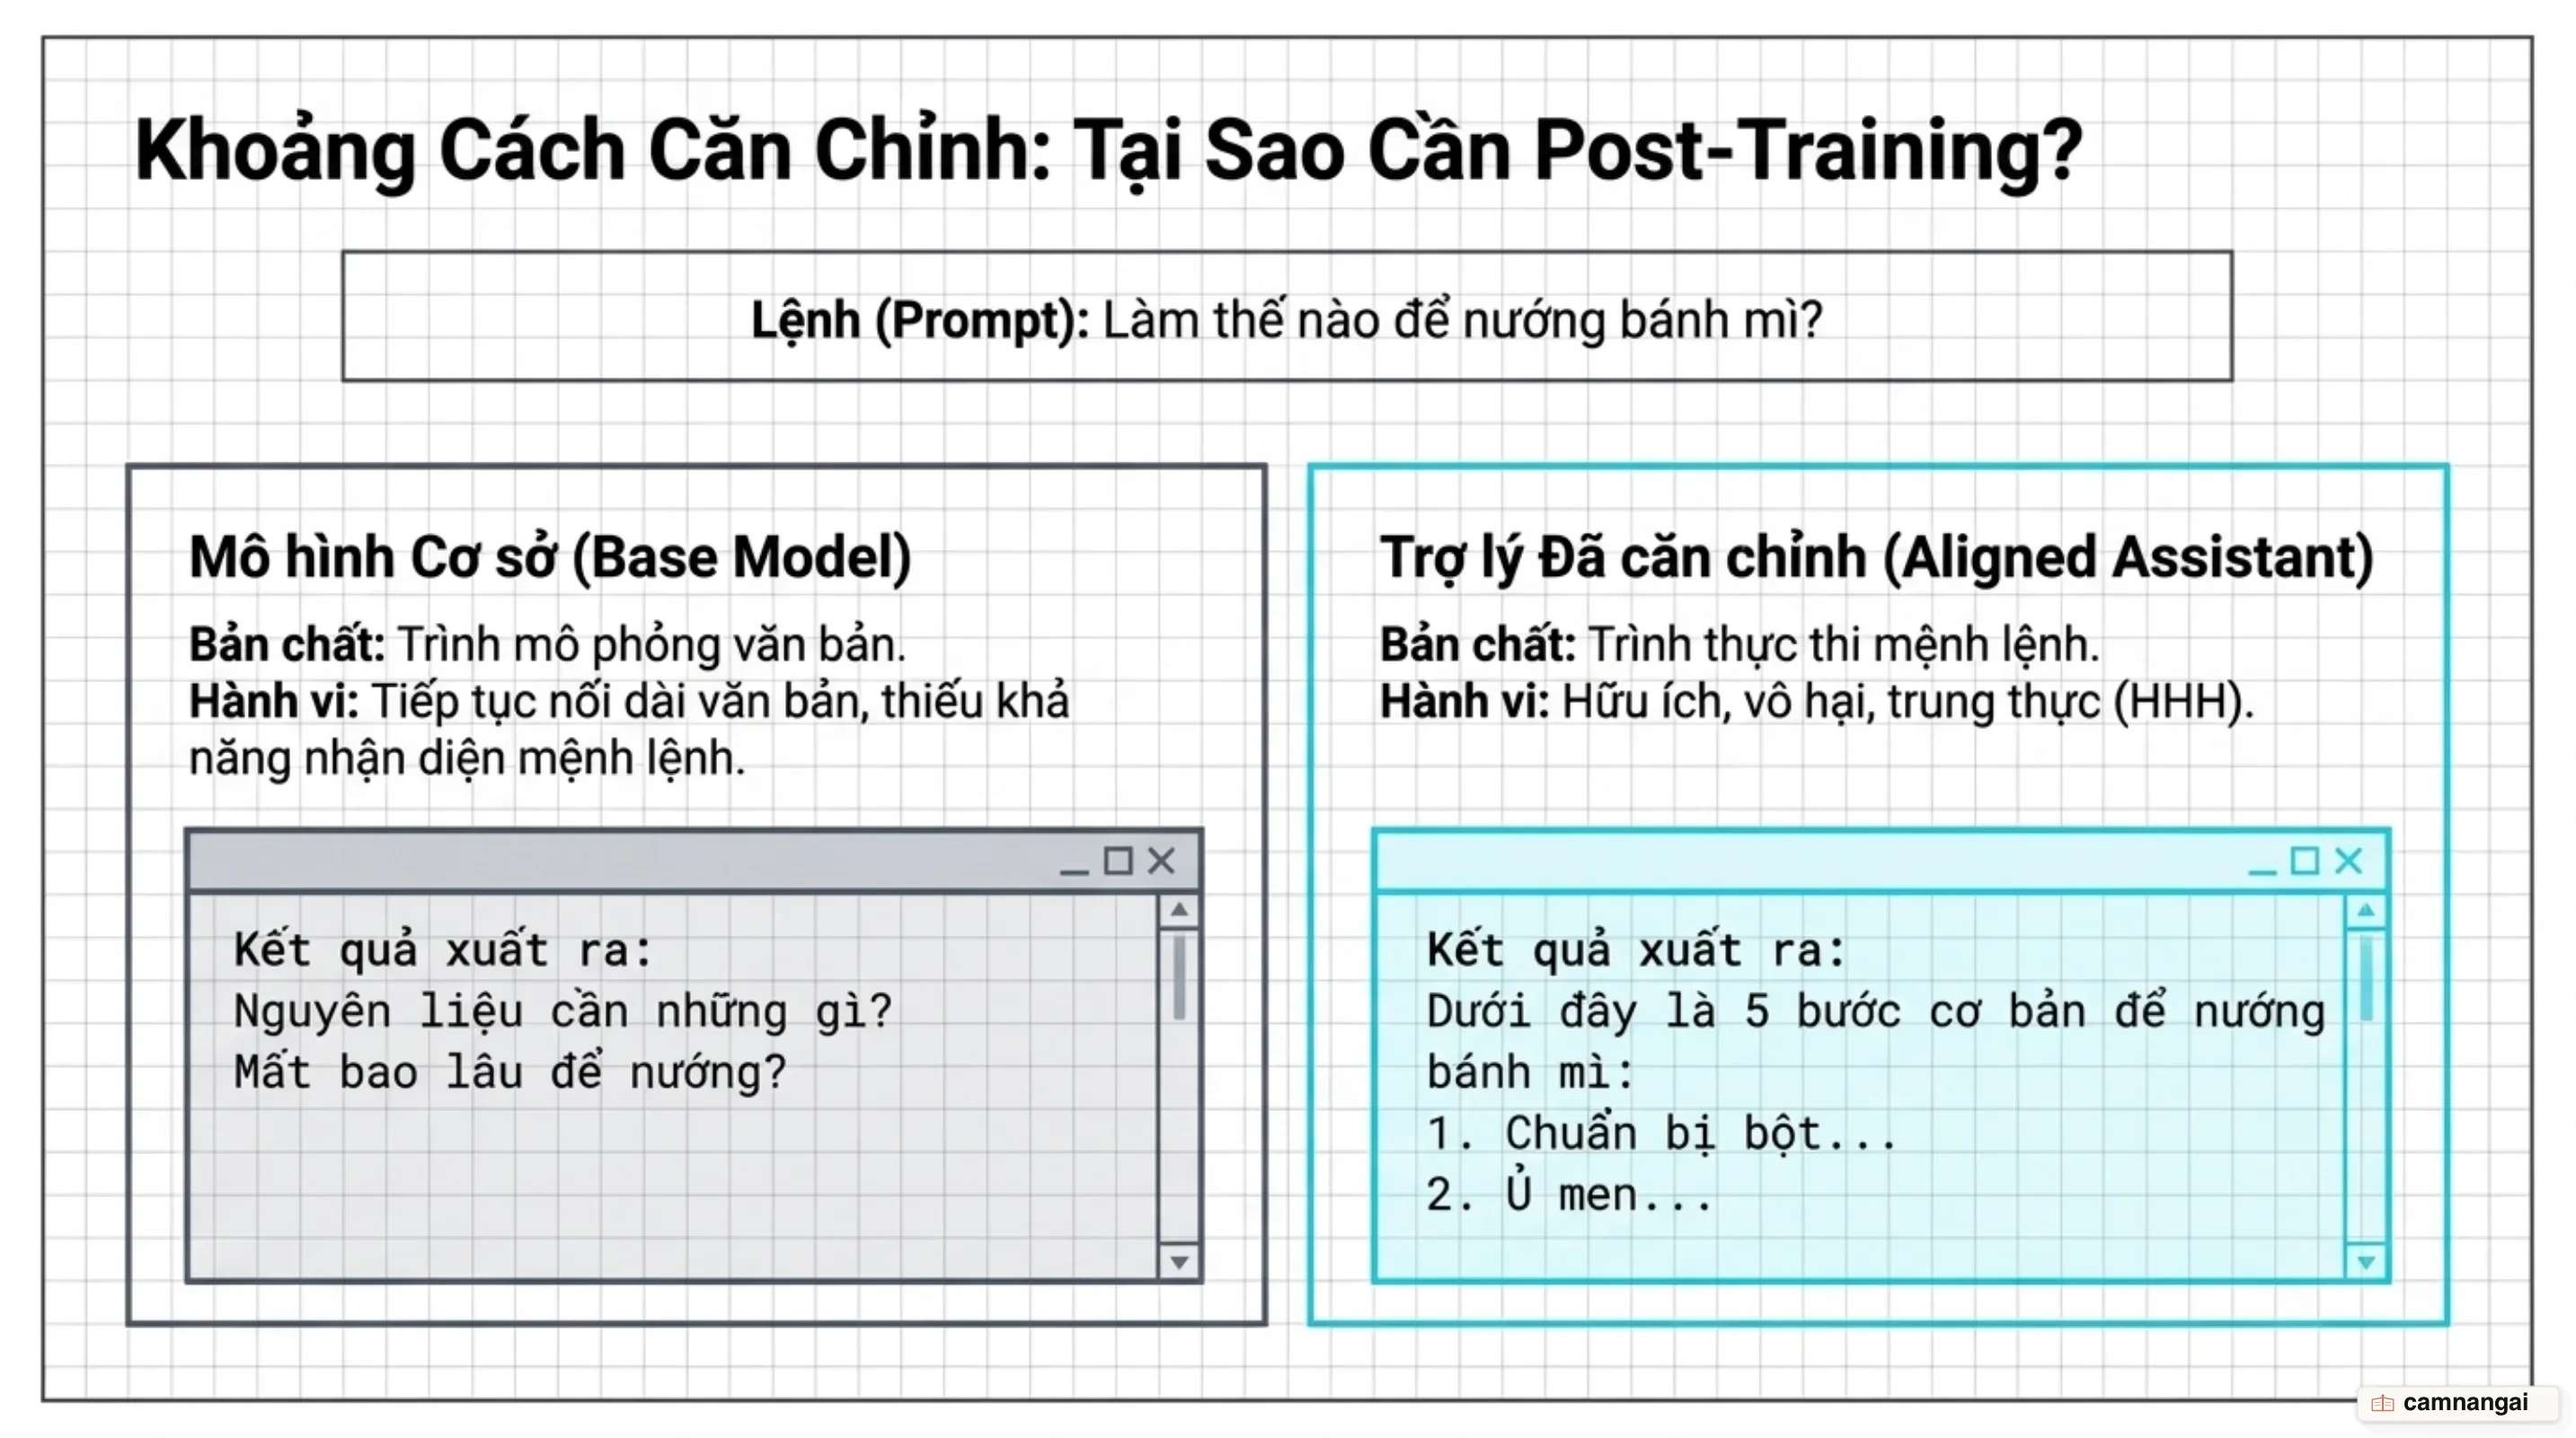
Bên cạnh việc không hiểu ý định người dùng (intent), mô hình gốc còn kế thừa toàn bộ các mặt tiêu cực của dữ liệu internet thô, bao gồm định kiến xã hội, ngôn từ độc hại và các nội dung nguy hiểm. Để biến một cỗ máy mô phỏng văn bản thô thành một trợ lý hữu ích và an toàn, bạn bắt buộc phải đưa mô hình qua chuỗi quy trình hậu huấn luyện (post-training).
5. Hậu huấn luyện và căn chỉnh: Tinh chỉnh chỉ dẫn (SFT) và RLHF
Quy trình hậu huấn luyện bắt đầu bằng bước Tinh chỉnh có giám sát (Supervised Fine-Tuning - SFT). Ở bước này, bạn huấn luyện tiếp mô hình gốc trên một tập dữ liệu chọn lọc gồm các cặp câu lệnh và phản hồi mẫu chất lượng cao (prompt-response demonstrations), thường từ hàng nghìn đến hàng trăm nghìn mẫu do con người biên soạn.
Mục tiêu toán học ở SFT vẫn là dự đoán token tiếp theo, nhưng chỉ tính toán hàm tổn thất trên các token thuộc phần câu trả lời của trợ lý (assistant tokens), bỏ qua phần prompt đầu vào. Qua SFT, mô hình học được phong cách hội thoại, cách giải thích rành mạch và định dạng của một trợ lý AI.
Sau SFT, mô hình bước vào giai đoạn Căn chỉnh (Alignment) để điều hướng hành vi sâu hơn. Bước thứ hai là xây dựng Mô hình phần thưởng (Reward Model - RM). Con người rất khó viết công thức toán học tường minh cho khái niệm "một câu trả lời hay", nhưng lại rất dễ dàng so sánh hai câu trả lời xem câu nào tốt hơn. Do đó, hệ thống thu thập tập dữ liệu so sánh cặp (pairwise comparisons): cho một prompt đầu vào, mô hình SFT sinh ra nhiều câu trả lời khác nhau, sau đó con người sắp xếp thứ tự từ tốt nhất đến tệ nhất. Một mô hình RM riêng biệt được huấn luyện trên dữ liệu này để chấm điểm số thưởng cho bất kỳ câu trả lời nào.
Bước thứ ba là Học tăng cường từ phản hồi con người (RLHF) sử dụng thuật toán Proximal Policy Optimization (PPO). Mô hình ngôn ngữ nhận đầu vào là các prompt ngẫu nhiên, tự sinh ra câu trả lời và nhận điểm số thưởng từ Mô hình phần thưởng (RM).
Để ngăn mô hình thay đổi quá xa so với bản SFT ban đầu hoặc sinh ra các văn bản vô nghĩa nhưng vẫn "hắc" (fool) được điểm số của RM, một hình phạt độ lệch Kullback–Leibler (KL Divergence) được bổ sung vào hàm thưởng:
r = r_theta(x, y) - beta * D_KL(pi_phi(y|x) || pi_SFT(y|x))Đồng thời, để tránh việc mô hình suy giảm hiệu năng trên các bài kiểm tra ngôn ngữ tiêu chuẩn sau quá trình tối ưu RL (hiện tượng RLHF performance regression), thành phần trộn độ dốc tiền huấn luyện (PPO-ptx) được thêm vào mục tiêu tối ưu hóa tổng thể:
Objective(phi) = E_(x,y)[ r_theta(x,y) - beta * D_KL(pi_phi(y|x) || pi_SFT(y|x)) ] + gamma * E_x[ log(pi_phi(x)) ]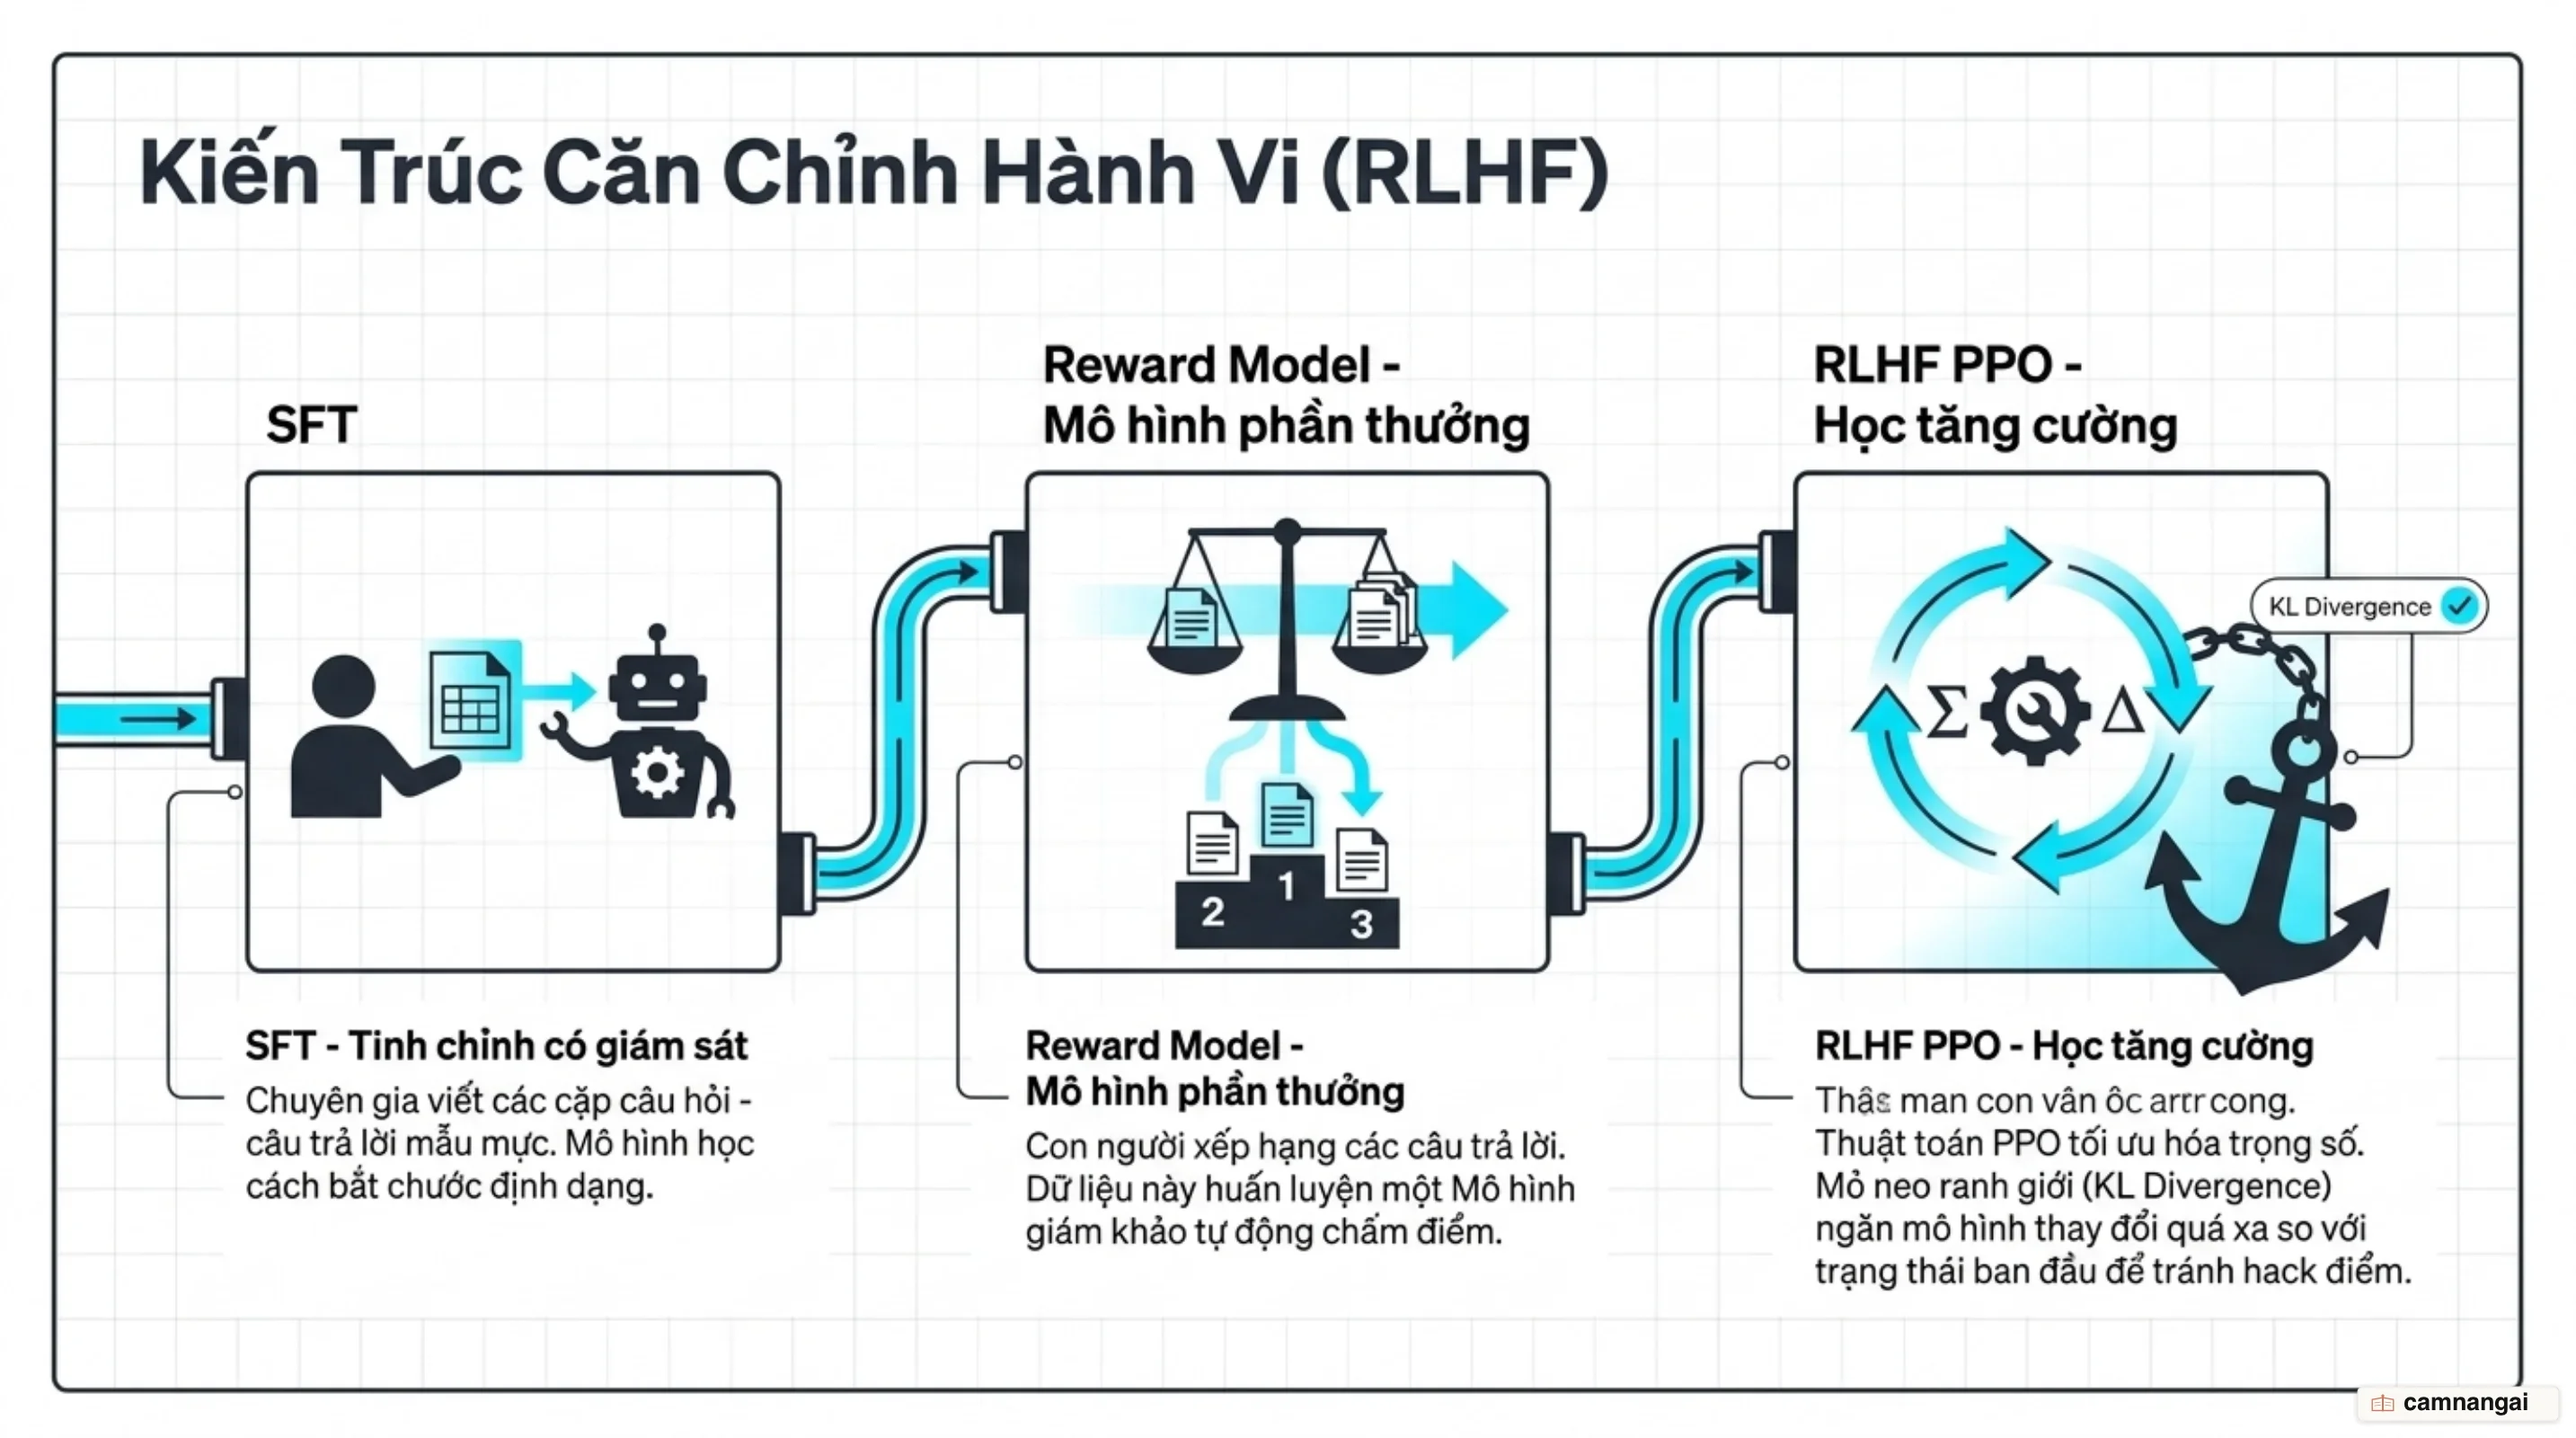
Trong suốt quá trình PPO, các trọng số của Mô hình SFT Gốc (Reference Model) hoàn toàn bị đóng băng (frozen weights) và chỉ có các trọng số của mô hình RL Policy được cập nhật. Việc triển khai RLHF hiện nay được hỗ trợ bởi các thư viện mã nguồn mở như TRL, TRLX hoặc RL4LMs. Thách thức lớn nhất của quy trình này nằm ở sự biến động của dữ liệu đầu vào: độ tương đồng ý kiến giữa những người gán nhãn con người chỉ đạt khoảng 73%, tạo ra nhiễu thống kê đòi hỏi các thuật toán tối ưu phải có biên độ an toàn cao.
6. Bức tường dữ liệu: Điều gì xảy ra khi AI "đọc hết" internet?
Nguồn dữ liệu văn bản tự nhiên do con người tạo ra trên internet đang tiến tới giới hạn cạn kiệt khi các mô hình ngôn ngữ thế hệ mới tiêu thụ đến hàng chục nghìn tỷ token cho mỗi lượt huấn luyện. Bên cạnh đó, từ năm 2023 trở đi, sự bùng nổ của các LLM đã khiến internet bị tràn ngập bởi dữ liệu nhân tạo (synthetic data) chứa các cụm từ đại diện cho văn bản do AI sinh ra như "delve", "rich tapestry", "it's important to note", "as a large language model", "intertwined", "certainly!", và "dive into", gây nguy cơ suy giảm chất lượng nếu thu thập vô hoán đổi cho các đợt huấn luyện sau.
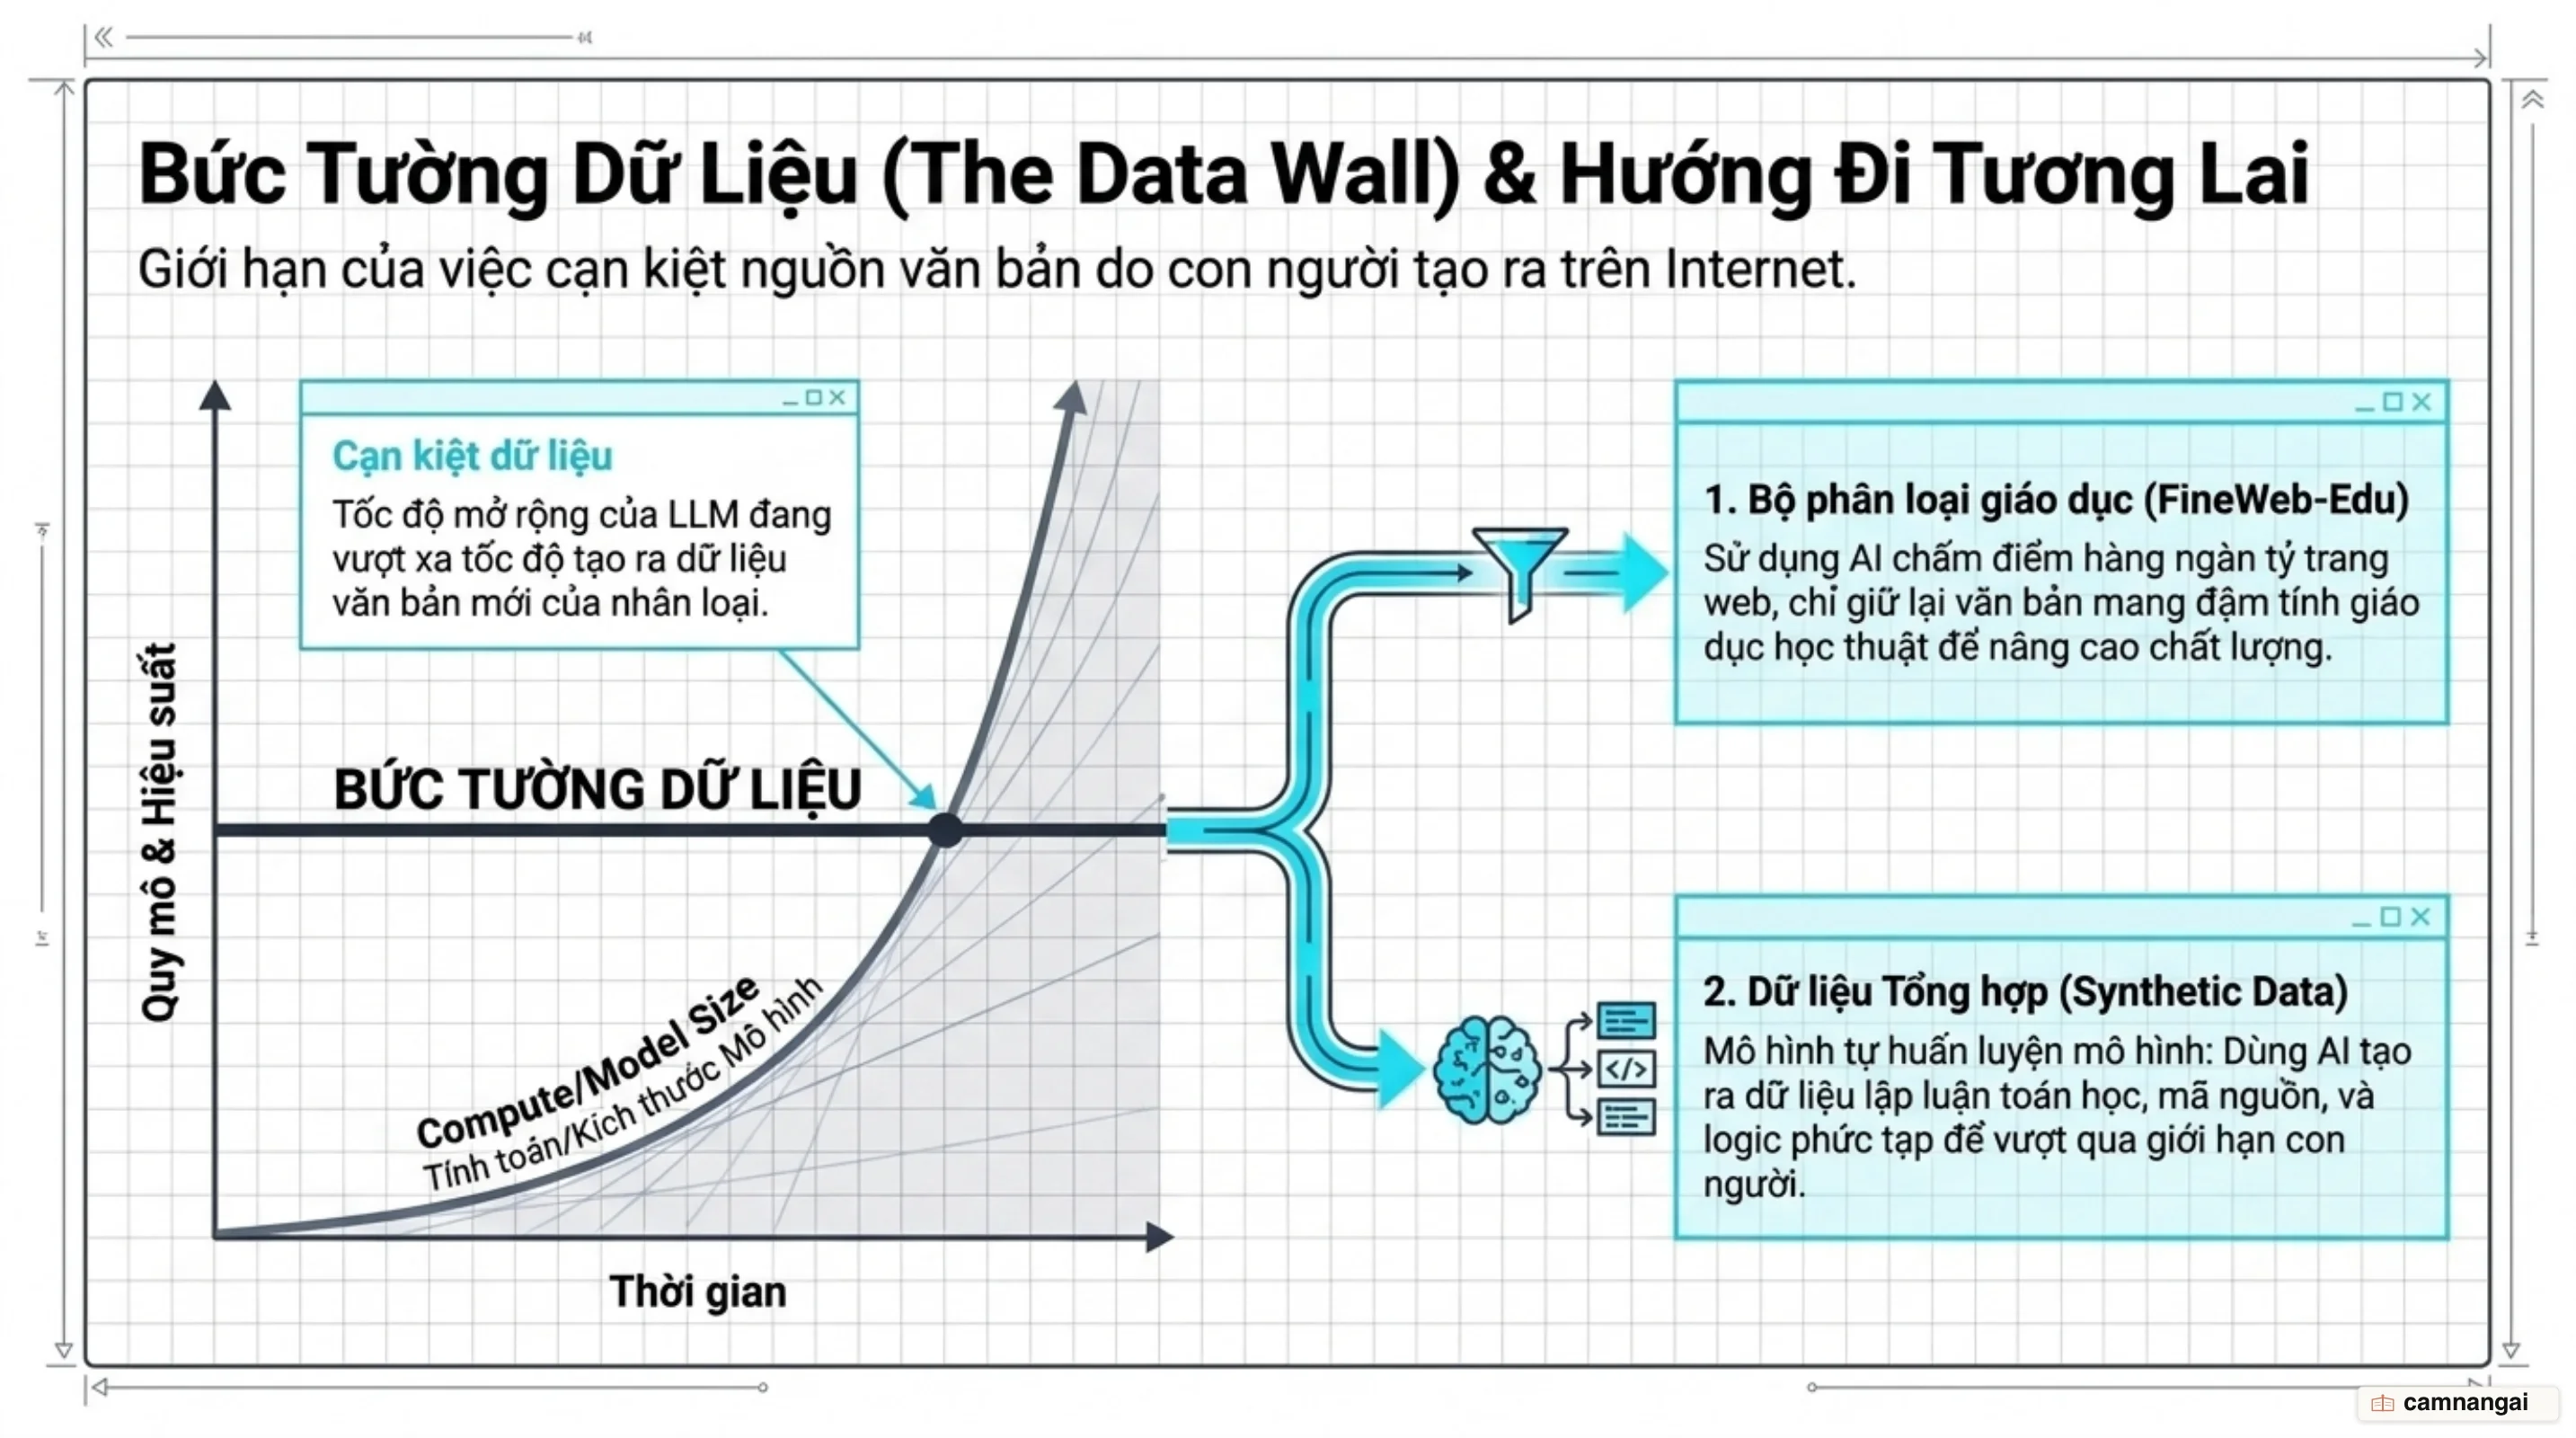
Thực tế kỹ thuật cho thấy việc nâng cao hiệu năng LLM trong tương lai không còn dựa vào chiến lược cào dữ liệu thô quy mô lớn một cách thụ động. Thay vào đó, ngành công nghiệp chuyển hướng sang sử dụng các bộ phân loại chất lượng dựa trên mô hình ngôn ngữ. Tiêu biểu như tập dữ liệu FineWeb-Edu: hệ thống dùng Llama-3-70B-Instruct gán nhãn 500,000 mẫu theo thang điểm giáo dục từ 0 đến 5, sau đó huấn luyện một mô hình hồi quy dựa trên kiến trúc Snowflake-arctic-embed với ngưỡng phân loại nhị phân ≥ 3 (đạt điểm F1 82% trên tập kiểm chứng). Bộ lọc này đã loại bỏ 92% dữ liệu web rác và giữ lại 1.3 nghìn tỷ token giáo dục chất lượng cao. Việc kết hợp các bộ lọc phân loại này cùng với việc khai thác sâu các tập dữ liệu chuyên biệt có bản quyền đang trở thành hướng đi bắt buộc để vượt qua bức tường dữ liệu hiện tại.
Tài liệu tham khảo
- How LLMs Learn from the Internet: The Training Process — ByteByteGo
- FineWeb: Decanting the Web for the Finest Text Data at Scale — Hugging Face
- State of GPT — Andrej Karpathy (Microsoft Build 2023)
- The Illustrated GPT-2 (Visualizing Transformer Language Models) — Jay Alammar
- Illustrating Reinforcement Learning from Human Feedback (RLHF) — Hugging Face
- RLHF: Reinforcement Learning from Human Feedback — Chip Huyen
- Will We Run Out of Data to Train Large Language Models? — Epoch AI