Việc tối ưu hóa kiến trúc quy trình vận hành mang lại hiệu quả thực tế rõ rệt so với việc thụ động chờ đợi các mô hình nền tảng thế hệ tiếp theo. Khi xây dựng ứng dụng trí tuệ nhân tạo, lộ trình chuyển dịch từ loop engineering đến graph engineering định hình cách mô hình suy luận, kiểm thử và quản lý bộ nhớ. Đặt một mô hình ngôn ngữ lớn (LLM) vào một quy trình lặp có cấu trúc cho phép hệ thống tự sửa lỗi, thu thập dữ liệu và phân rã bài toán phức tạp mà một câu lệnh zero-shot không thể xử lý.
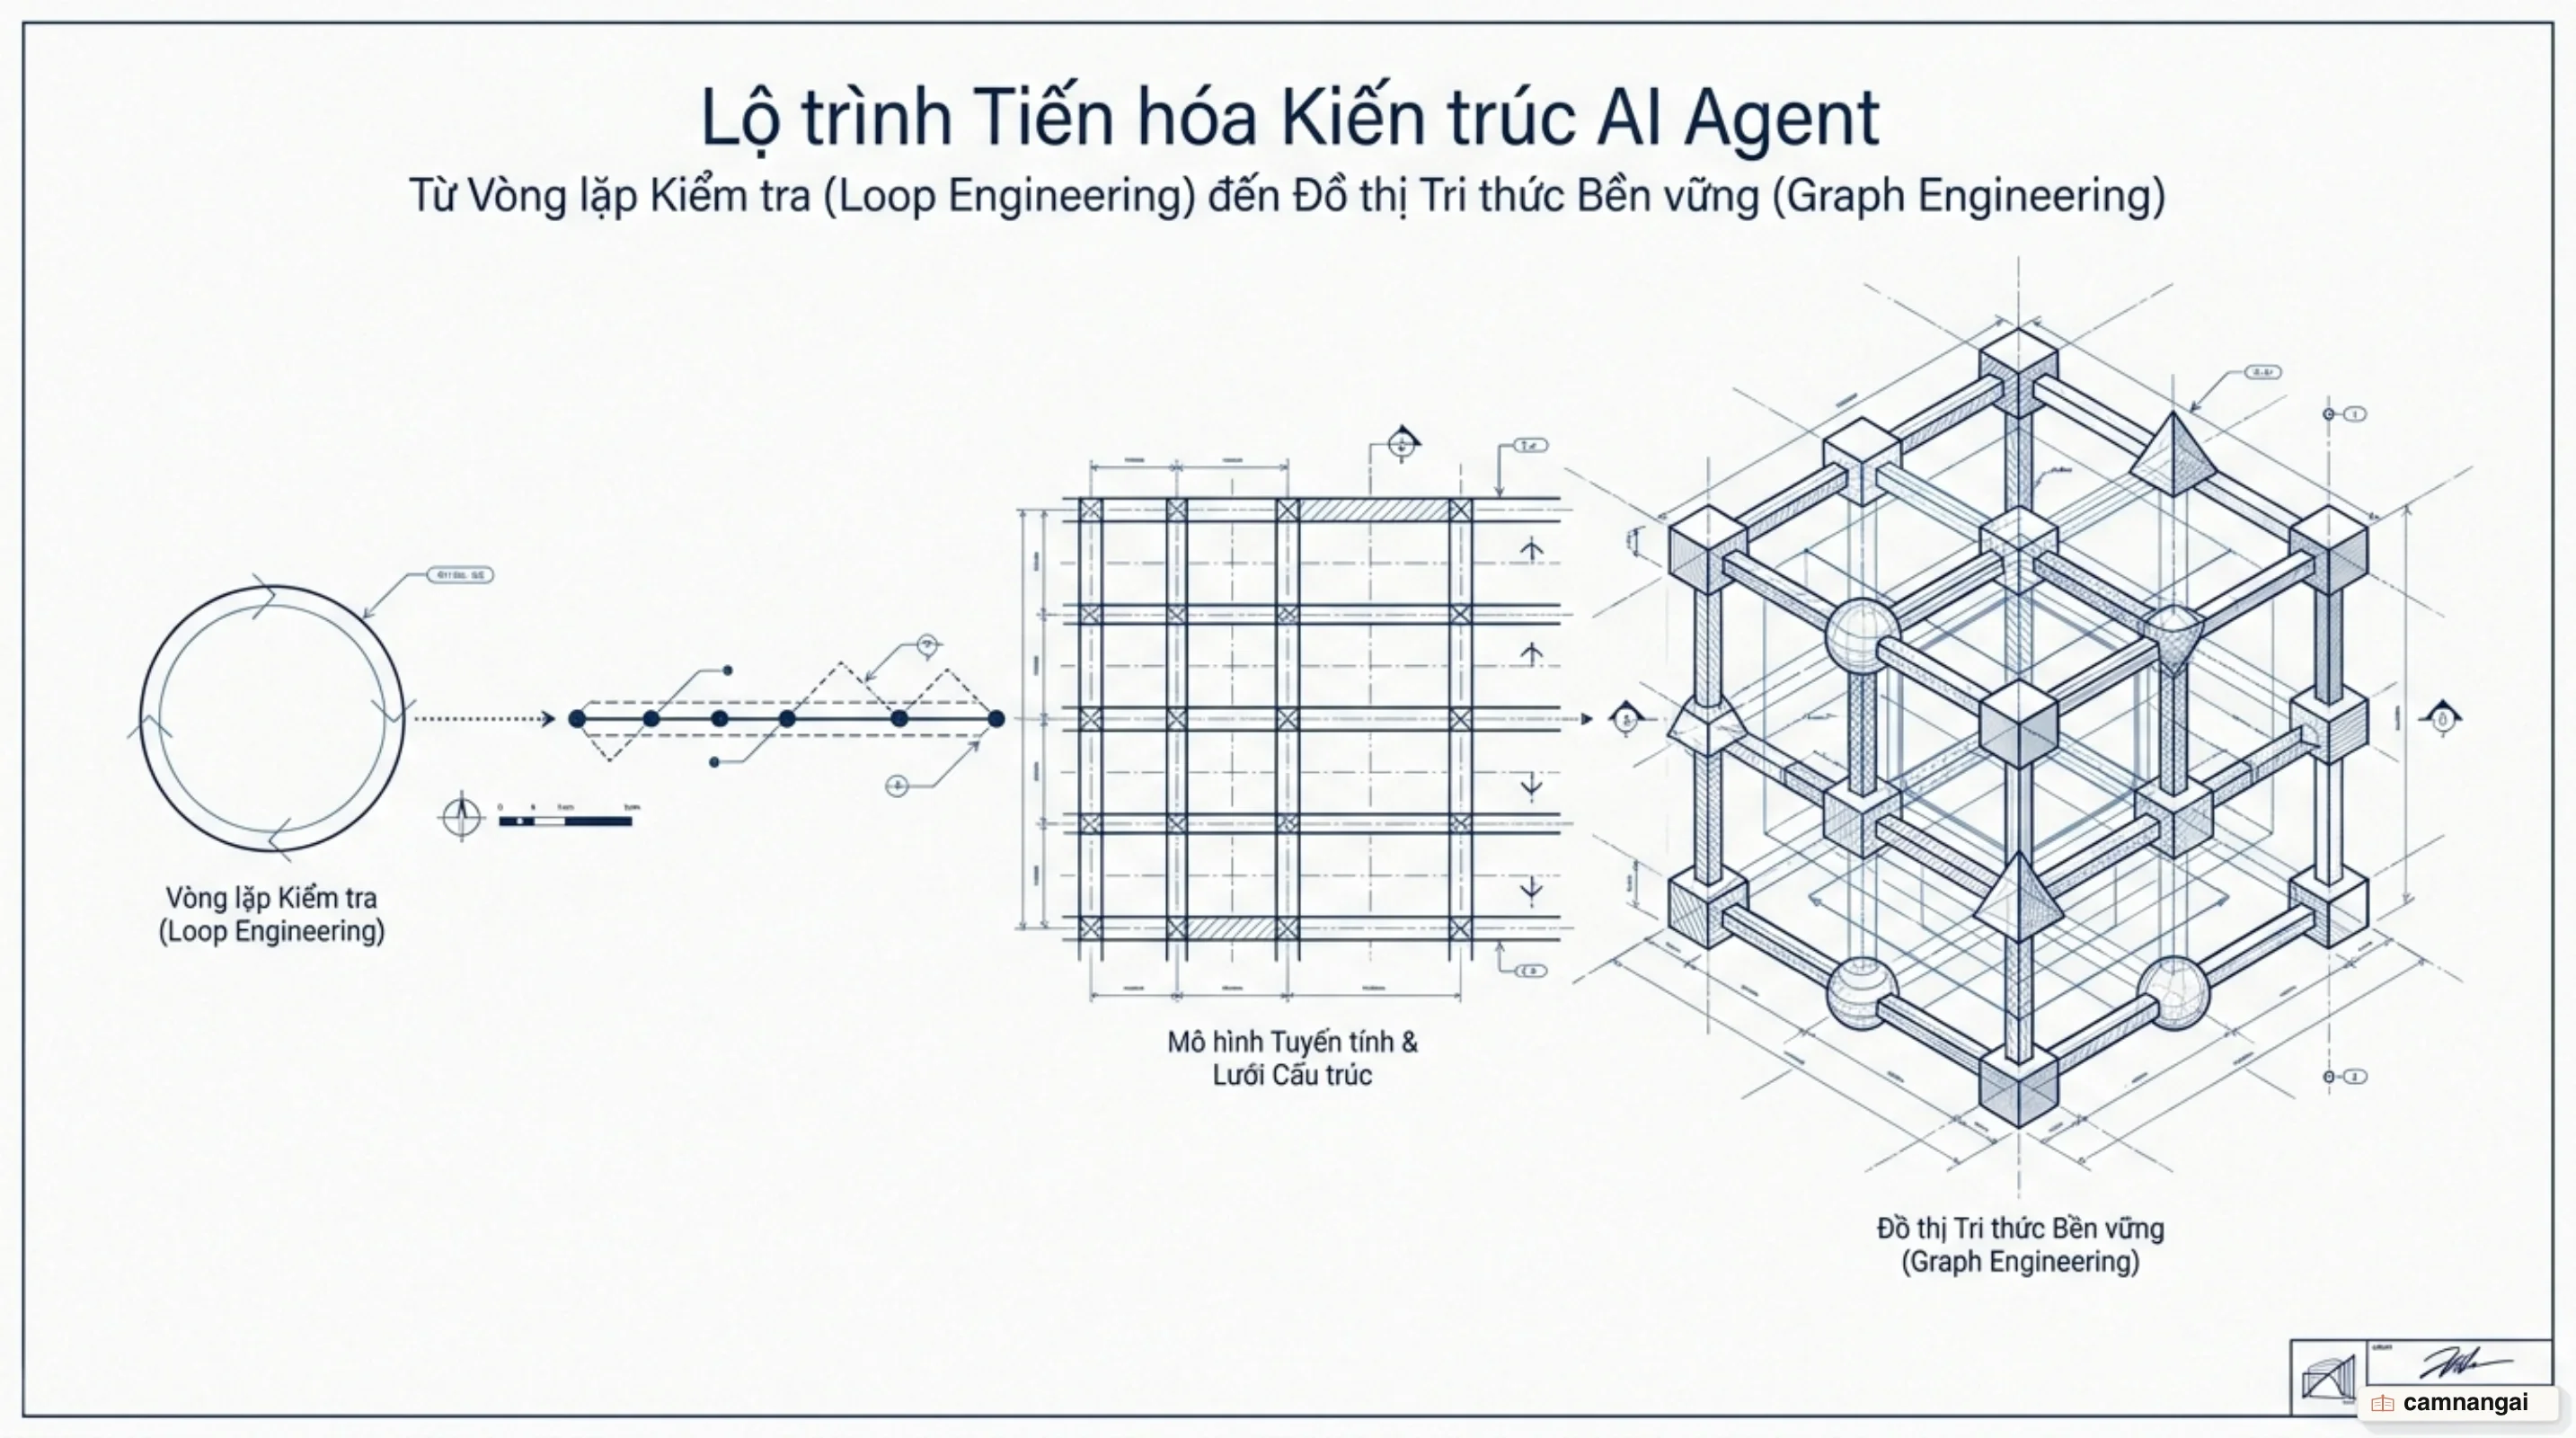
Từ Loop Engineering đến Graph Engineering là lộ trình tiến hóa kiến trúc AI Agent từ các vòng lặp kiểm tra đơn lẻ (loop), qua chuỗi xử lý (chain) và mạng lưới phân vai (network), đến đồ thị tri thức (graph) có bộ nhớ trạng thái bền vững.
Dữ liệu thực nghiệm cho thấy một mô hình có năng lực thấp hơn nếu được vận hành trong một vòng lặp phản hồi hợp lý sẽ đạt hiệu suất vượt xa mô hình mạnh hơn chạy ở chế độ đơn vị (zero-shot). Tiến trình phát triển này đi từ các vòng lặp kiểm tra đơn giản (Loop Engineering), qua các chuỗi tác vụ tuyến tính (chain), mở rộng thành mạng lưới phân công chuyên biệt (network), và cuối cùng đạt đến kiến trúc đồ thị có trạng thái bền vững (graph). Sự dịch chuyển này giải quyết triệt để bài toán kiểm soát chất lượng đầu ra, quản lý chi phí token và độ trễ của hệ thống.
Kiến trúc quy trình quyết định giới hạn năng lực của AI Agent, không phải kích thước của mô hình nền tảng.
Vì sao kiến trúc agent quan trọng hơn model?
Yêu cầu một mô hình ngôn ngữ lớn tạo ra kết quả hoàn hảo ngay trong một lượt chạy (zero-shot) tương tự như việc bắt một chuyên gia viết một bài luận phức tạp mà không cho phép nháp, xóa, tra cứu tài liệu hay rà soát lỗi. Mô hình zero-shot bị tước đi mọi cơ hội tự sửa sai và kiểm chứng thông tin. Do đó, điểm hạn chế của hệ thống thường không nằm ở khả năng hiểu ngôn ngữ của mô hình, mà nằm ở thiết kế quy trình thiếu các vòng lặp kiểm soát chất lượng.
Dữ liệu thực nghiệm trên benchmark lập trình HumanEval được trích dẫn bởi Andrew Ng đã chứng minh tầm quan trọng của kiến trúc quy trình. Khi chạy ở chế độ zero-shot, mô hình GPT-3.5 đạt điểm số 48.1%, trong khi mô hình GPT-4 đạt 67.0%. Tuy nhiên, khi đưa GPT-3.5 vào một quy trình agentic có tính lặp và kiểm thử, điểm số trên HumanEval tăng vọt lên 95.1%.
| Cấu hình hệ thống | Điểm số HumanEval (%) |
|---|---|
| GPT-3.5 (Zero-shot) | 48.1% |
| GPT-4 (Zero-shot) | 67.0% |
| GPT-3.5 + Agentic Workflow | 95.1% |
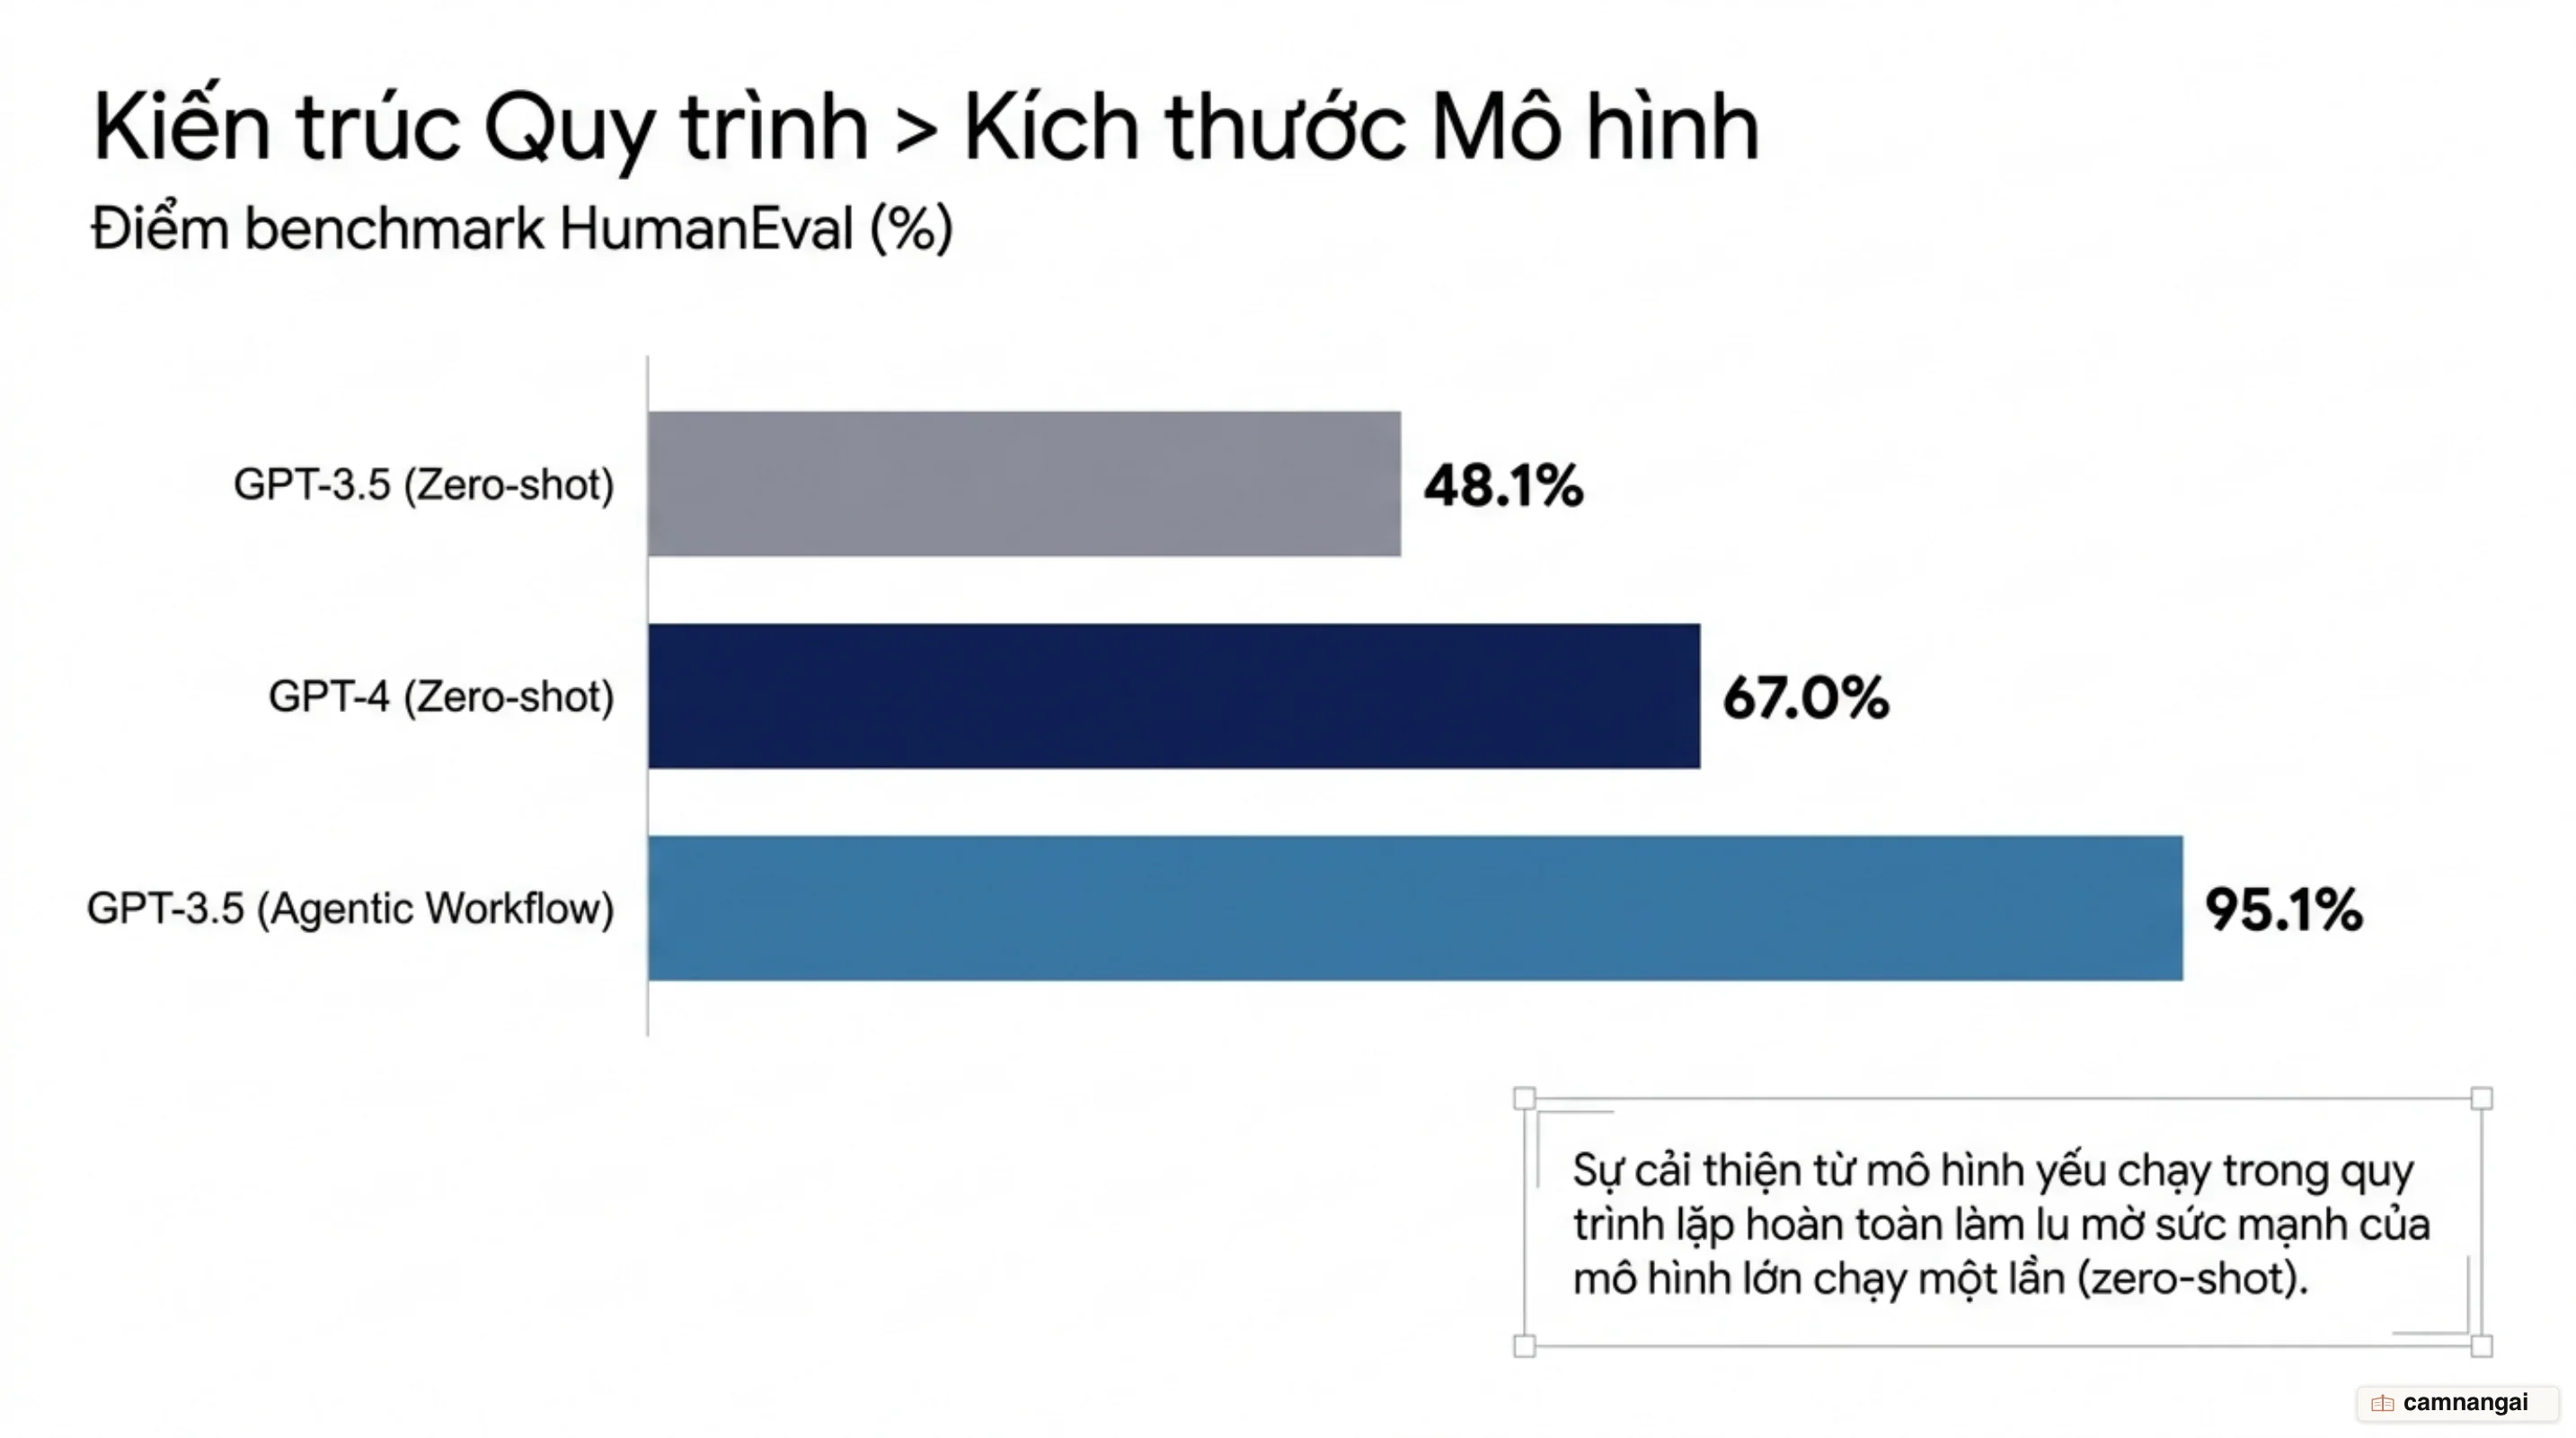
Mức tăng điểm khi tích hợp quy trình agentic cho GPT-3.5 (+47.0%) áp đảo hoàn toàn mức tăng điểm khi nâng cấp mô hình nền tảng từ GPT-3.5 lên GPT-4 ở dạng zero-shot (+18.9%). Kết quả này cho thấy việc đầu tư vào kiến trúc quy trình mang lại mức cải thiện hiệu năng rõ rệt. Tuy nhiên, cần lưu ý rằng HumanEval là một benchmark chuyên biệt về lập trình. Dù con số 95.1% minh chứng rõ ràng cho sức mạnh của quy trình lặp, các đội ngũ kỹ sư khi triển khai thực tế vẫn bắt buộc phải xây dựng bộ dữ liệu đánh giá riêng (evaluation set) theo đúng miền nghiệp vụ để đo lường chính xác mức độ tăng trưởng chất lượng.
Một yếu tố kỹ thuật then chốt khác nằm ở bản chất của tốc độ suy luận (inference speed) và cách tiêu thụ token. Trong các quy trình agentic, phần lớn lượng token sinh ra không phải để con người đọc trực tiếp, mà được tiêu thụ bởi chính các nhân tố LLM khác trong hệ thống. Do đó, khả năng sinh token nhanh từ các mô hình nhỏ hoặc mô hình đã qua tối ưu hóa (quantized serving) đóng vai trò như một bộ nhân hiệu năng hệ thống. Việc xử lý token với tốc độ cao cho phép agent thực hiện nhiều vòng lặp suy luận, tra cứu và kiểm thử trong cùng một khoảng thời gian chấp nhận được, cho ra kết quả tốt hơn nhiều so với việc chờ đợi một lượt phát sinh token chậm chạp từ các mô hình lớn.
4 mẫu thiết kế của Andrew Ng kết hợp 5 workflow của Anthropic
Để xây dựng hệ thống agent hiệu quả, bạn cần nắm vững 4 mẫu thiết kế cốt lõi do Andrew Ng tổng hợp bao gồm: Reflection (Phản chiếu), Tool Use (Sử dụng công cụ), Planning (Lập kế hoạch), và Multi-Agent Collaboration (Phối hợp đa agent). Mức độ trưởng thành của các mẫu này không đồng đều trong môi trường sản xuất. Reflection và Tool Use là các kỹ thuật đã vững chắc (robust), có thể áp dụng ngay với độ tin cậy cao. Trong khi đó, Planning và Multi-Agent Collaboration vẫn đang ở giai đoạn phát triển (emerging), mang lại kết quả ấn tượng nhưng đòi hỏi cơ chế kiểm soát chặt chẽ để tránh hành vi không dự đoán được.
| Mẫu thiết kế (Ng) | Mức độ trưởng thành | Đánh giá thực tế |
|---|---|---|
| Reflection | Robust (Vững chắc) | Gần như luôn hoạt động hiệu quả |
| Tool Use | Robust (Vững chắc) | Triển khai rộng rãi, dễ hiểu |
| Planning | Emerging (Đang phát triển) | Ít trưởng thành hơn, khó dự đoán |
| Multi-Agent | Emerging (Đang phát triển) | Hoạt động tốt hơn mong đợi nhưng phức tạp |
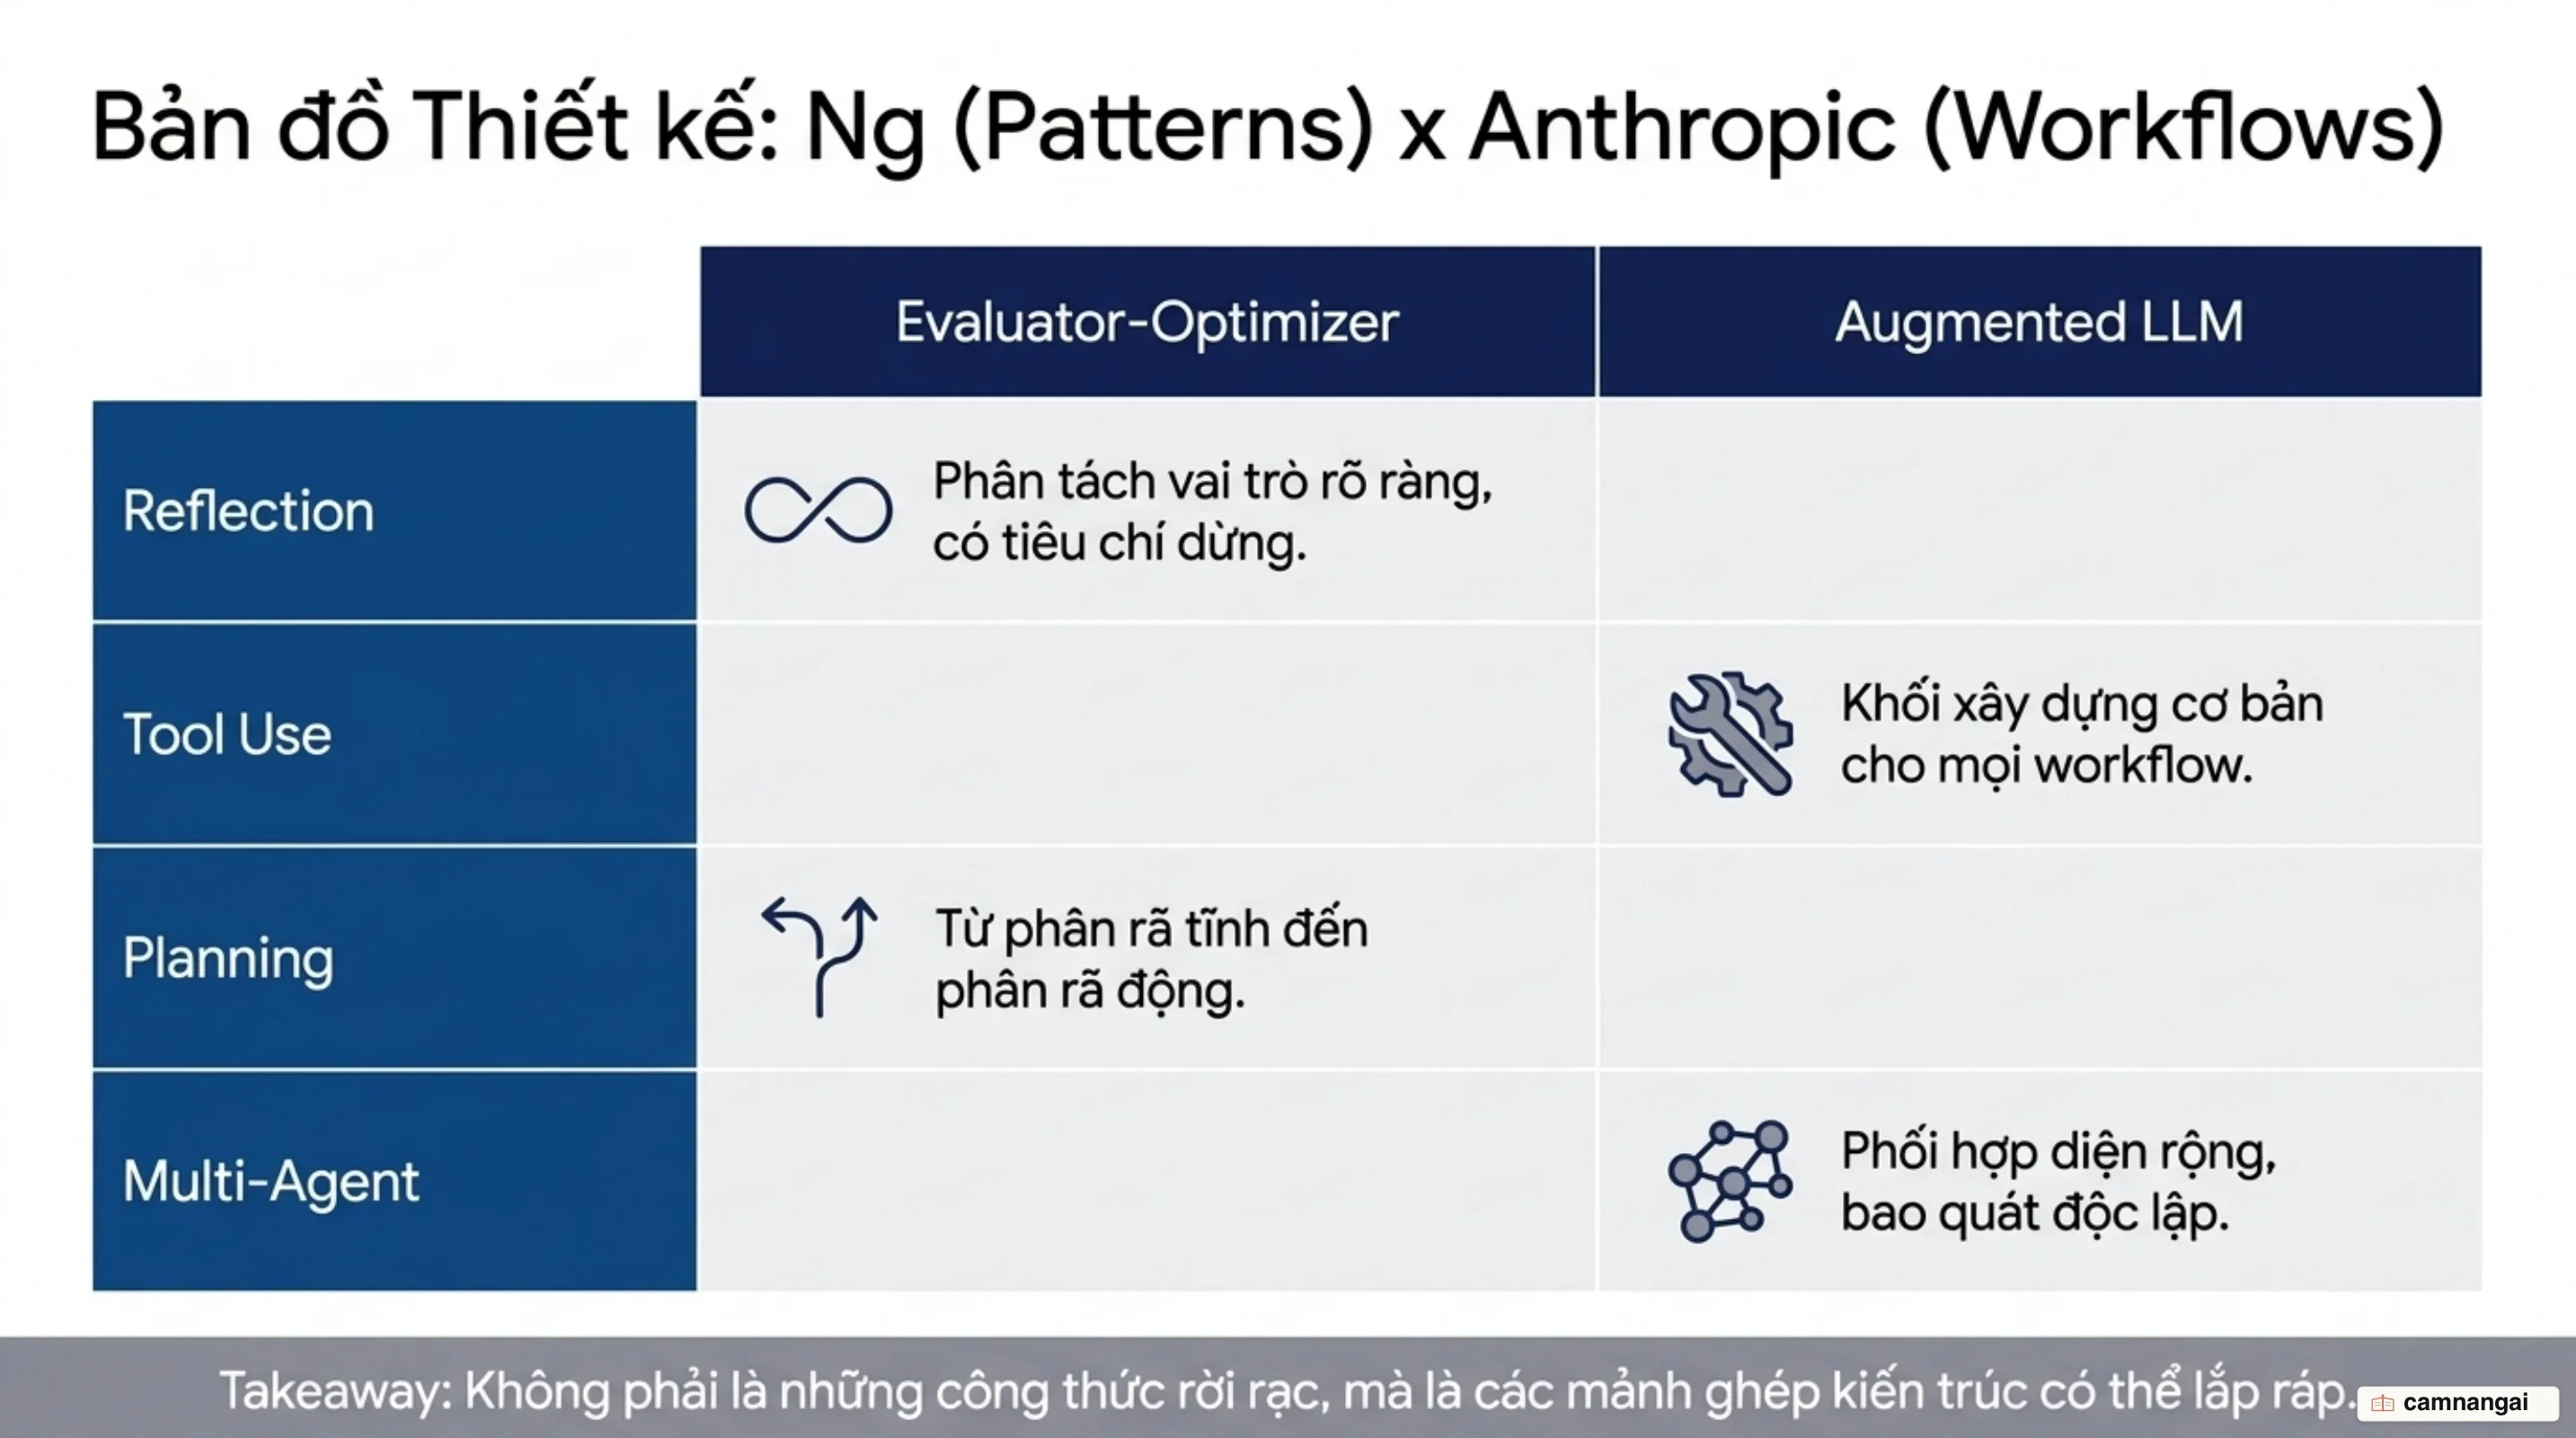
Song song với đó, Anthropic định hình 5 dạng workflow thực chiến giúp chuẩn hóa các đường đi của dữ liệu: Prompt Chaining, Routing, Parallelization, Orchestrator-Workers, và Evaluator-Optimizer. Việc ánh xạ các mẫu thiết kế của Ng vào các workflow của Anthropic giúp biến các ý tưởng lý thuyết thành cấu trúc mã nguồn cụ thể.
| Mẫu thiết kế (Ng) | Workflow tương đương (Anthropic) | Thành phần bổ sung cốt lõi |
|---|---|---|
| Reflection | Evaluator-Optimizer | Phân tách vai trò và tiêu chí dừng rõ ràng |
| Tool Use | Augmented LLM | Khối xây dựng cơ bản cho mọi quy trình |
| Planning | Orchestrator-Workers + Chaining | Phân rã công việc động so với tĩnh |
| Multi-Agent | Parallelization + Orchestrator-Workers | Điều phối sản xuất thực tế |
Nguyên tắc kỹ thuật quan trọng nhất khi kết hợp các mô hình này là ưu tiên xây dựng các quy trình mang tính xác định (deterministic workflows) như Prompt Chaining hay Routing trước khi đưa vào các agent tự quyết động (dynamic autonomous agents) như Planning hay Orchestrator-Workers. Các quy trình cố định giúp đảm bảo luồng thực thi rõ ràng, dễ dự đoán và tối ưu chi phí.
Việc bổ sung các lớp điều phối động (dynamic orchestration) quá sớm sẽ đưa tính bất định (nondeterminism) vào hệ thống, làm tăng chi phí token và tạo ra các điểm nghẽn ngữ cảnh không cần thiết cho các tác vụ vốn có thể giải quyết bằng chuỗi bước cố định. Phức tạp hóa kiến trúc chỉ nên diễn ra khi các lỗi thực tế trong vận hành đòi hỏi sự linh hoạt đó.
Bước 1 & 2: Từ Loop đơn lẻ đến Chain có cấu trúc
Ở giai đoạn đầu tiên, hệ thống khởi đầu với dạng vòng lặp phản hồi đơn giản (Reflection Loop) tương ứng với mô hình Evaluator-Optimizer. Cơ chế này đòi hỏi ít nhất 4 thành phần dữ liệu (artifacts): Nhiệm vụ (Task), Bản thảo đầu ra (Draft), Phản hồi đánh giá (Critique), và Quyết định sửa đổi (Revision Decision). Vòng lặp yêu cầu một nhân tố tạo nội dung và một nhân tố đánh giá dựa trên tiêu chí (rubric) hoặc bài kiểm tra xác định.
Dưới đây là đoạn mã giả minh họa cơ chế vòng lặp Reflection tối thiểu:
@dataclass
class Critique:
    satisfactory: bool
    issues: list[str]
    revision_instructions: list[str]

def reflect(task: str, llm, max_iterations=3):
    draft = llm.generate(task)
    for _ in range(max_iterations):
        feedback = llm.evaluate(task=task, draft=draft)
        if feedback.satisfactory:
            return draft
        draft = llm.revise(task, draft, feedback)
    return draft
Mặc dù Reflection cải thiện chất lượng rõ rệt, nó tồn tại các dạng thất bại (failure modes) đặc thù như tự xác nhận sai (self-confirmation), lệch tiêu chí (rubric drift) và sửa đổi không đơn điệu (non-monotonic revision). Để khắc phục, bạn cần tuân thủ hai quy tắc vận hành bắt buộc. Thứ nhất, tách biệt tuyệt đối bước đánh giá (critique) và bước sửa đổi (revision). Thay vì gửi một câu lệnh chung chung "hãy cải thiện văn bản này", hệ thống phải bắt buộc mô hình đánh giá trả về một danh sách lỗi có cấu trúc (typed issues list), sau đó mới truyền danh sách này vào prompt sửa đổi riêng biệt. Thứ hai, tích hợp các bước kiểm tra mang tính xác định (deterministic checks) như unit test, linter, hoặc schema validator chạy trước khi gọi mô hình đánh giá định tính nhằm ngăn chặn tình trạng trôi tiêu chí.
Để giải quyết các hạn chế của vòng lặp đơn lẻ, hệ thống cần tiến lên bước 2: Chuỗi có cấu trúc (Prompt Chaining & Routing). Tại đây, quy trình được chia nhỏ thành các giai đoạn cố định. Thay vì để một vòng lặp tự do điều chỉnh toàn bộ văn bản, dữ liệu đầu ra của bước trước trở thành đầu vào của bước sau qua các điểm kiểm định lập trình (programmatic checks). Ưu điểm của kiến trúc chuỗi là tính dự đoán cao và dễ kiểm thử từng công đoạn độc lập, dù nó giảm tính linh hoạt khi gặp các dữ liệu đầu vào ngoài kịch bản dự kiến.
Bước 3: Network — Điều phối đa worker và bẫy phình to ngữ cảnh
Khi bài toán mở rộng đòi hỏi nhiều chuyên môn khác nhau, kiến trúc chuyển sang dạng Mạng lưới (Network), áp dụng các mô hình như Orchestrator-Workers và kiến trúc multi-agent (ví dụ: mô hình lập trình đa vai trò ChatDev hoặc cơ chế tranh luận đa agent). Mô hình điều phối trung tâm (Orchestrator) sẽ phân rã bài toán, giao việc cho các nhân tố chuyên biệt (Workers) như kỹ sư phần mềm, chuyên gia kiểm thử, hay biên tập viên, sau đó tổng hợp kết quả.
Tuy nhiên, các hệ thống dạng mạng lưới thường gặp phải "Bẫy phình to ngữ cảnh" (Context Bottleneck Trap). Khi các worker gửi toàn bộ lịch sử hội thoại hoặc văn bản thô về cho Orchestrator, hoặc khi các worker trò chuyện qua lại trực tiếp không kiểm soát, cửa sổ ngữ cảnh (context window) của mô hình trung tâm bị lấp đầy bởi thông tin nhiễu. Điều này làm giảm nghiêm trọng khả năng suy luận logic, làm tăng độ trễ và khiến chi phí token tăng theo hàm mũ.
Giải pháp kỹ thuật bắt buộc cho kiến trúc Network là thiết lập "Hợp đồng sản phẩm" (Artifact Contract) cho mọi điểm giao dịch (handoff) giữa các agent. Các worker không bao giờ được gửi lại toàn bộ lịch sử chat hời hợt. Thay vào đó, chúng chỉ trả về các đối tượng dữ liệu có cấu trúc (typed artifacts) chứa kết quả chính, bằng chứng chứng minh và chỉ số độ tin cậy. Orchestrator chỉ tiếp nhận các đối tượng dữ liệu này để đưa ra quyết định tiếp theo, giúp giữ cho ngữ cảnh luôn sạch và tập trung.
Bước 4: Graph Engineering — Ngoại hóa bộ nhớ và trạng thái bền vững
Khi mạng lưới agent trở nên phức tạp, việc nhồi nhét dữ liệu vào context window sẽ chạm trần vật lý. Đây là lúc hệ thống bắt buộc phải chuyển sang Graph Engineering (Bước 4): ngoại hóa toàn bộ trạng thái, thực thể và các mối quan hệ ra một cơ sở hạ tầng đồ thị độc lập (như Knowledge Graph). Thay vì sao chép toàn bộ ngữ cảnh, các agent sẽ truy vấn các đồ thị con (subgraphs) liên quan và cập nhật kết quả ngược lại đồ thị dùng chung.
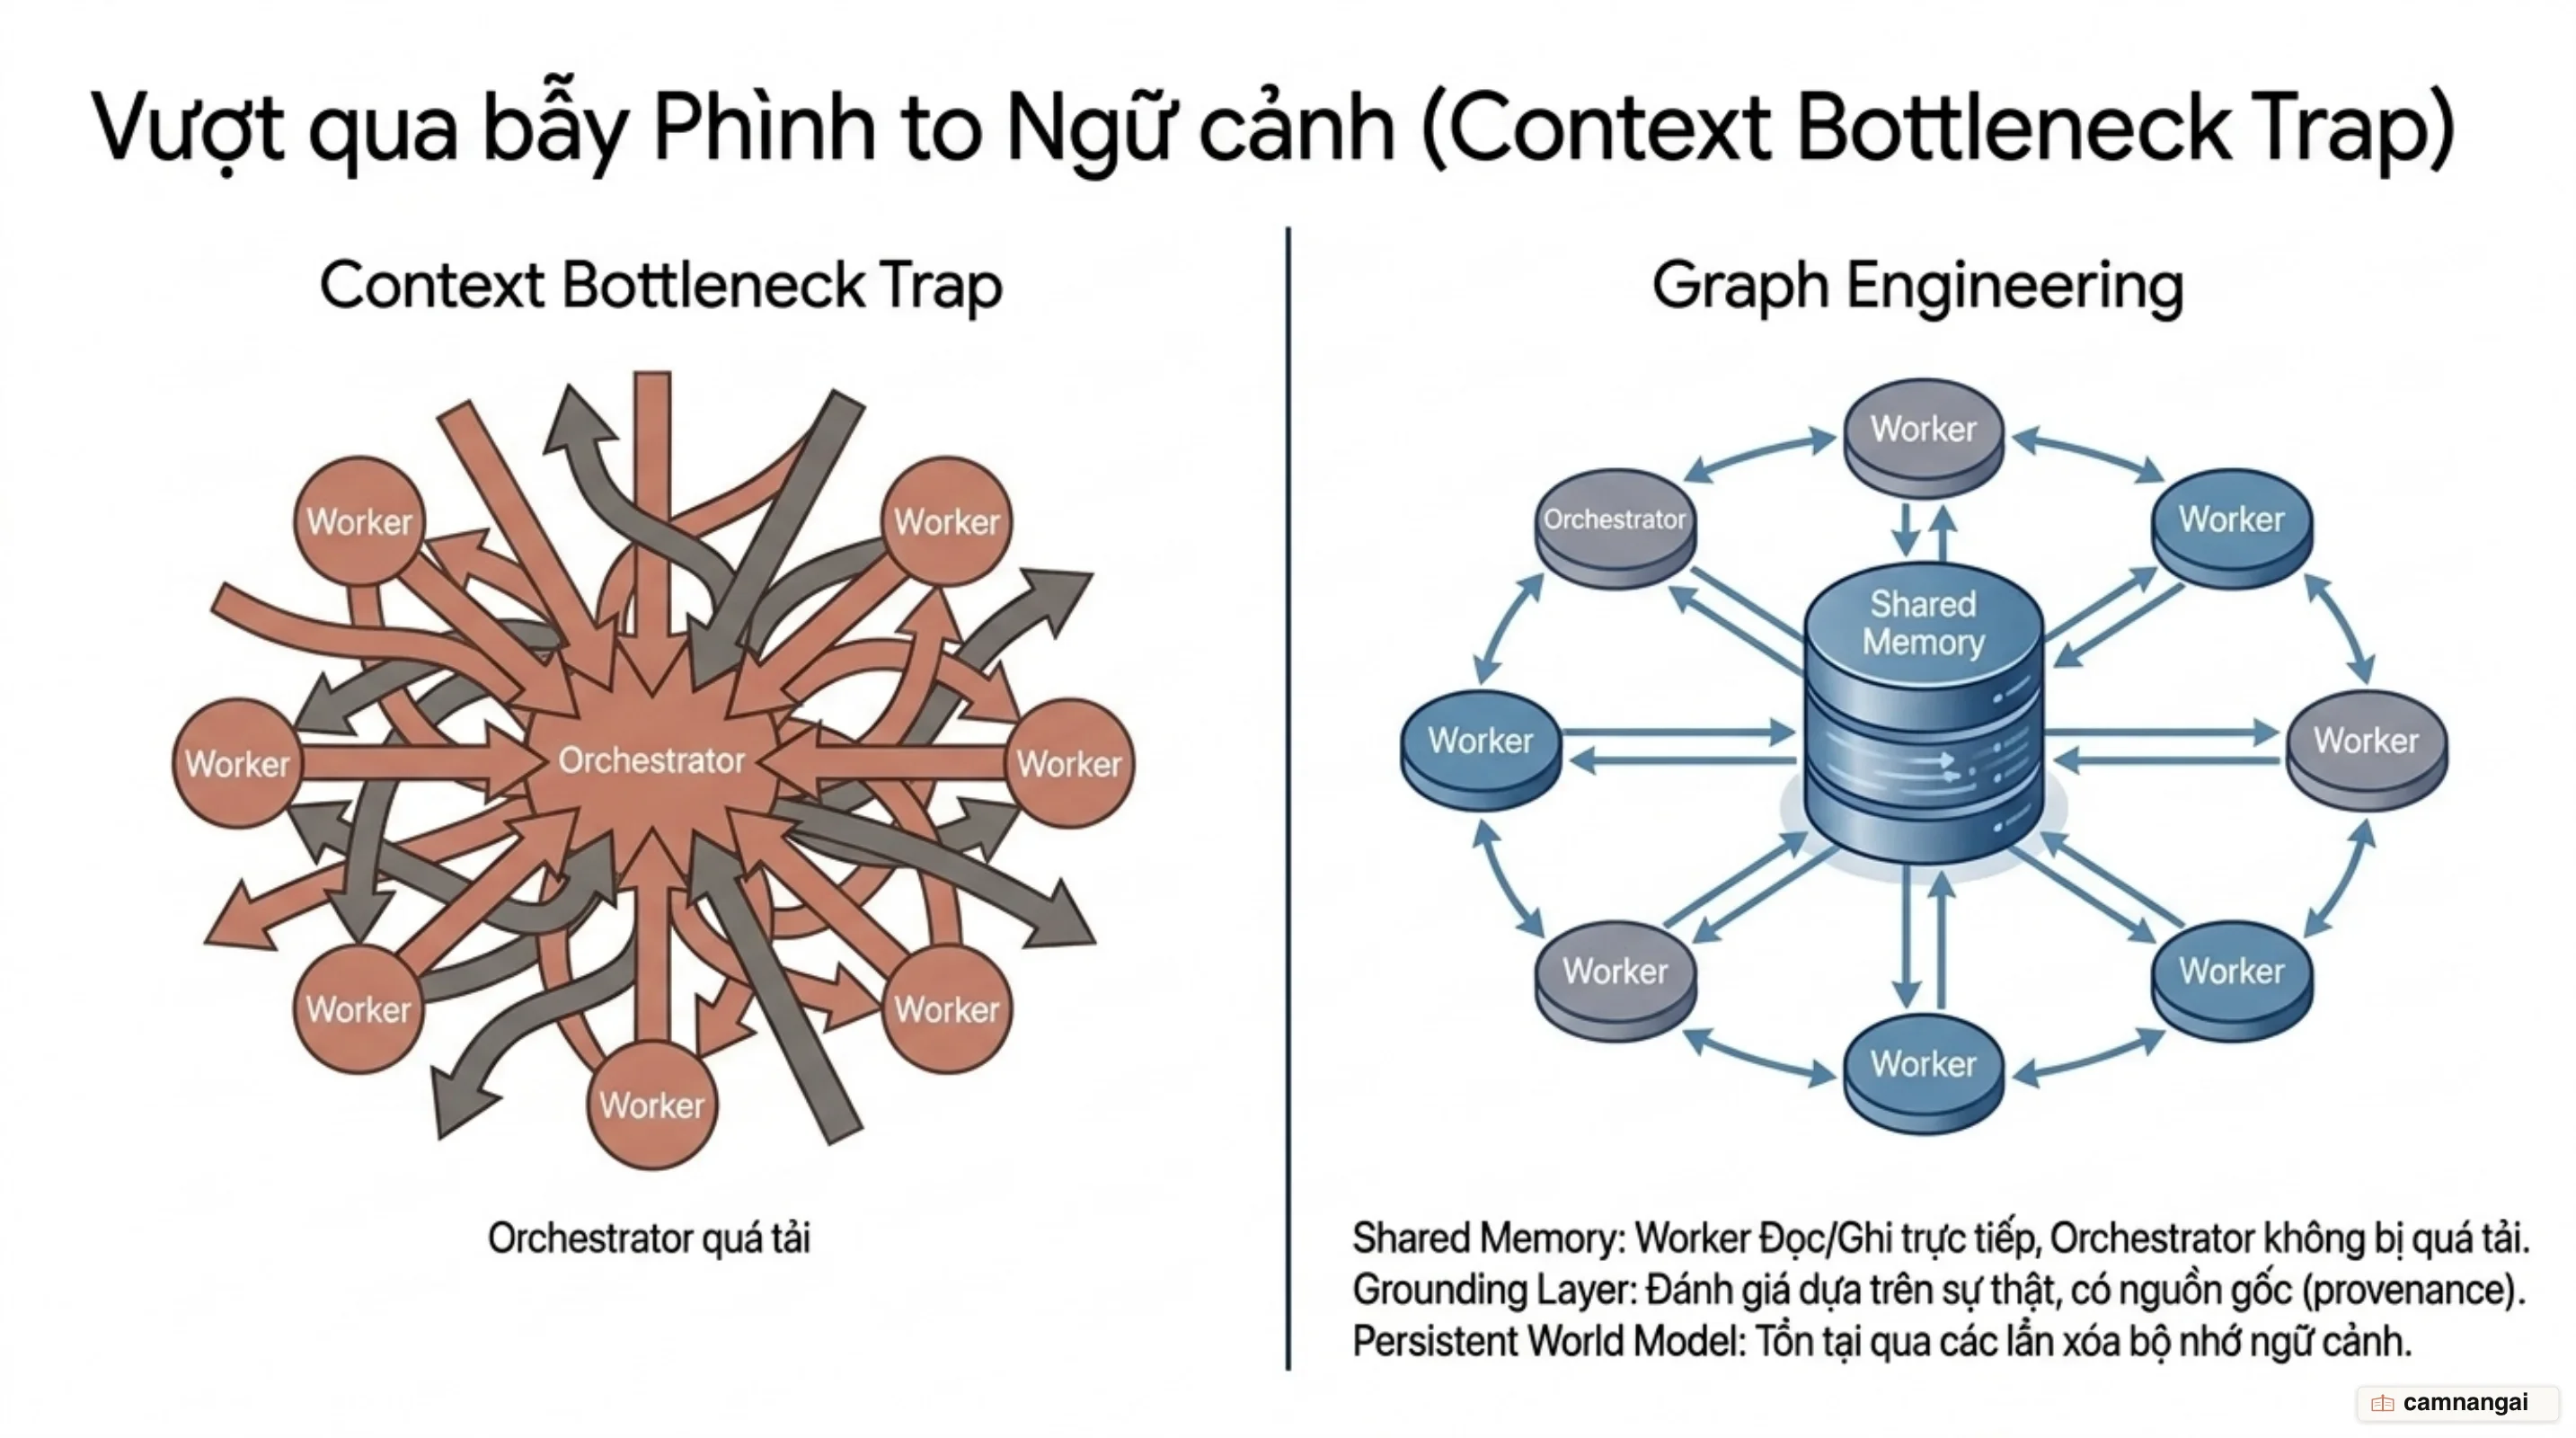
Đồ thị Tri thức giữ 3 vai trò kỹ thuật cốt lõi trong hệ thống AI Agent:
- Shared Memory (Bộ nhớ dùng chung): Cho phép các Worker trong mô hình Orchestrator-Workers đọc và ghi dữ liệu trực tiếp vào đồ thị mà không cần chuyền qua context window của Orchestrator.
- Grounding Layer (Lớp căn cứ đánh giá): Cung cấp các sự thật khách quan có trích dẫn nguồn gốc (provenance) để mô hình Evaluator kiểm tra luận điểm. Sự tồn tại của đồ thị giúp biến một phản hồi đánh giá cảm tính dạng "câu này nghe không ổn" thành một phép kiểm tra dữ liệu xác thực dựa trên các cạnh đồ thị, ví dụ: "tam giác thực thể (X, works_at, Y) không tồn tại trong đồ thị tri thức".
- Persistent World Model (Mô hình thế giới bền vững): Đảm bảo trạng thái của hệ thống tồn tại xuyên suốt ngay cả khi ngữ cảnh của LLM bị xóa hoàn toàn sau mỗi phiên chạy.
Cấu trúc Schema đồ thị tối thiểu cho một hệ thống agent bao gồm 5 loại Node cơ bản: Entity (Thực thể), Claim (Tuyên bố/Luận điểm), Source (Nguồn dữ liệu/Kết quả test), Artifact (Sản phẩm đầu ra như mã nguồn, báo cáo), và Run (Lịch sử phiên chạy). Các Edge (cạnh) quan trọng kết nối chúng bao gồm mentions, supports, contradicts, derived_from, và supersedes.
Nguyên tắc thao tác dữ liệu trên đồ thị là chỉ ghi bổ sung (Additive Write Operations). Hệ thống không bao giờ ghi đè lên các dữ liệu cũ. Khi một thông tin hoặc bản thảo mã nguồn được sửa đổi, hệ thống tạo một Node mới và nối với Node cũ thông qua quan hệ supersedes. Cơ chế này giữ nguyên toàn bộ lịch sử biến đổi, giúp hệ thống có khả năng tự kiểm toán (auditable) và phục hồi trạng thái khi xảy ra sự cố suy luận.
Khung quyết định: Khi nào nên chuyển từ Loop sang Graph?
Việc lựa chọn kiến trúc đòi hỏi sự phân tích đánh đổi khắt khe giữa Độ trễ (Latency) và Chất lượng (Quality). Khi đưa các mô hình vào vòng lặp agentic, hệ thống chấp nhận đánh đổi thời gian xử lý (thậm chí từ vài phút đến hàng giờ cho một tác vụ) để đổi lấy đầu ra có độ chính xác cao. Sự chấp nhận độ trễ này tương tự như việc quản lý một nhân sự: giao việc và cho phép họ nghiên cứu, phác thảo, kiểm tra lỗi thay vì đòi hỏi câu trả lời ngay lập tức.
Mặt khác, bài toán Chi phí Token vs Độ tin cậy đòi hỏi việc tính toán điểm hòa vốn vận hành. Việc chạy nhiều vòng lặp suy luận trên các mô hình nhỏ, tốc độ cao với chi phí thấp thường mang lại độ tin cậy cao hơn nhiều so với việc tiêu tốn ngân sách cho một lượt chạy đơn lẻ trên các mô hình đắt đỏ. Tuy nhiên, nếu không có tiêu chí dừng rõ ràng, các vòng lặp sẽ lãng phí tài nguyên mà không làm tăng chất lượng đầu ra.
| Tình huống bài toán | Bắt đầu với mẫu | Lý do kỹ thuật |
|---|---|---|
| Cần nâng chất lượng đầu ra đơn lẻ | Reflection | Phương án cải thiện rẻ và tin cậy nhất |
| Cần dữ liệu thực tế, chính xác | Tool Use | Neo câu trả lời vào dữ liệu thực |
| Tác vụ phức tạp, nhiều bước linh hoạt | Planning | Phân rã bài toán thành các bước nhỏ |
| Cần nhiều góc nhìn/chuyên môn | Multi-Agent | Phân vai để phát hiện lỗi chéo |
| Trạng thái cần tồn tại qua nhiều phiên | Graph Architecture | Vượt qua giới hạn bộ nhớ ngữ cảnh |
| Câu hỏi QA đơn giản | Zero-shot | Tránh tối ưu hóa quá mức (Over-engineering) |
Không phải bài toán nào cũng cần đến kiến trúc Đồ thị. Bạn nên áp dụng nguyên tắc tối giản: chỉ tăng thêm độ phức tạp khi đã xác định rõ failure mode của kiến trúc hiện tại và chứng minh được kiến trúc mới giải quyết được vấn đề đó. Lộ trình triển khai thực tế cho các đội ngũ phát triển nên đi theo từng giai đoạn đo lường cụ thể:
- Ngày 1: Triển khai Reflection. Tăng ngay 10-30% chất lượng đầu ra cho các tác vụ có tiêu chí kiểm thử rõ ràng.
- Ngày 2: Tích hợp Tool Use. Cung cấp công cụ tra cứu hoặc thực thi mã nguồn để xác thực dữ liệu.
- Tuần 1: Xây dựng Planning Agent. Áp dụng cho các tác vụ chuỗi phức tạp cần phân rã công việc động dưới dạng JSON.
- Tuần 2: Mở rộng Multi-Agent. Phân tách vai trò người tạo và người kiểm duyệt với quy ước giao tiếp bằng hợp đồng dữ liệu rõ ràng.
- Tháng 1: Tích hợp Graph Architecture. Thiết lập cơ sở dữ liệu đồ thị khi hệ thống bắt đầu xử lý các tác vụ dài hạn, đòi hỏi bộ nhớ bền vững đa phiên.
Bắt đầu từ vòng lặp nhỏ nhất trước khi dựng đồ thị
Hãy đo lường hiệu năng của bài toán hiện tại với các câu lệnh đơn lẻ, xác định chính xác điểm thất bại của mô hình, và chỉ bổ sung thêm các vòng lặp, công cụ hay đồ thị khi điểm thất bại đó yêu cầu sự kiểm soát phức tạp hơn.
Kiến trúc agent tối ưu không phải là kiến trúc sử dụng nhiều mô hình hay nhiều luồng điều phối nhất, mà là kiến trúc đơn giản nhất đủ để giải quyết bài toán với độ tin cậy cao và chi phí tối ưu.