Triển khai AI agent an toàn và hiệu quả trên một hệ thống lâu năm đòi hỏi sự thay đổi căn bản trong tư duy kỹ thuật: không cho phép mô hình AI tự do viết lại mã nguồn theo cảm tính. Brownfield agentic engineering là kỷ luật điều phối AI coding agent trong các hệ thống phần mềm có sẵn (brownfield), tập trung vào việc minh bạch hóa các ràng buộc ẩn và biến mọi thay đổi mã nguồn thành các bước kiểm chứng đáng tin cậy. Các hệ thống cũ luôn chứa đựng vô số tri thức tổ chức, giải pháp tạm thời, dịch vụ phụ thuộc và các kỳ vọng tích hợp nằm hoàn toàn bên ngoài cây thư mục mã nguồn.
Khi thả một AI agent vào repository lâu năm mà không có sự giám sát, mô hình sẽ dễ dàng tạo ra đoạn mã hoạt động về mặt cú pháp nhưng làm sai lệch kiến trúc hệ thống, sinh ra bộ kiểm thử giòn gãy và tích tụ nợ kỹ thuật. Kỹ thuật agentic trong môi trường brownfield yêu cầu bạn phải khoanh vùng bán kính thiệt hại, khóa hành vi hiện tại bằng characterization tests, lập tài liệu ngữ cảnh ngầm và thiết lập một khung kiểm chứng (verifier harness) độc lập.
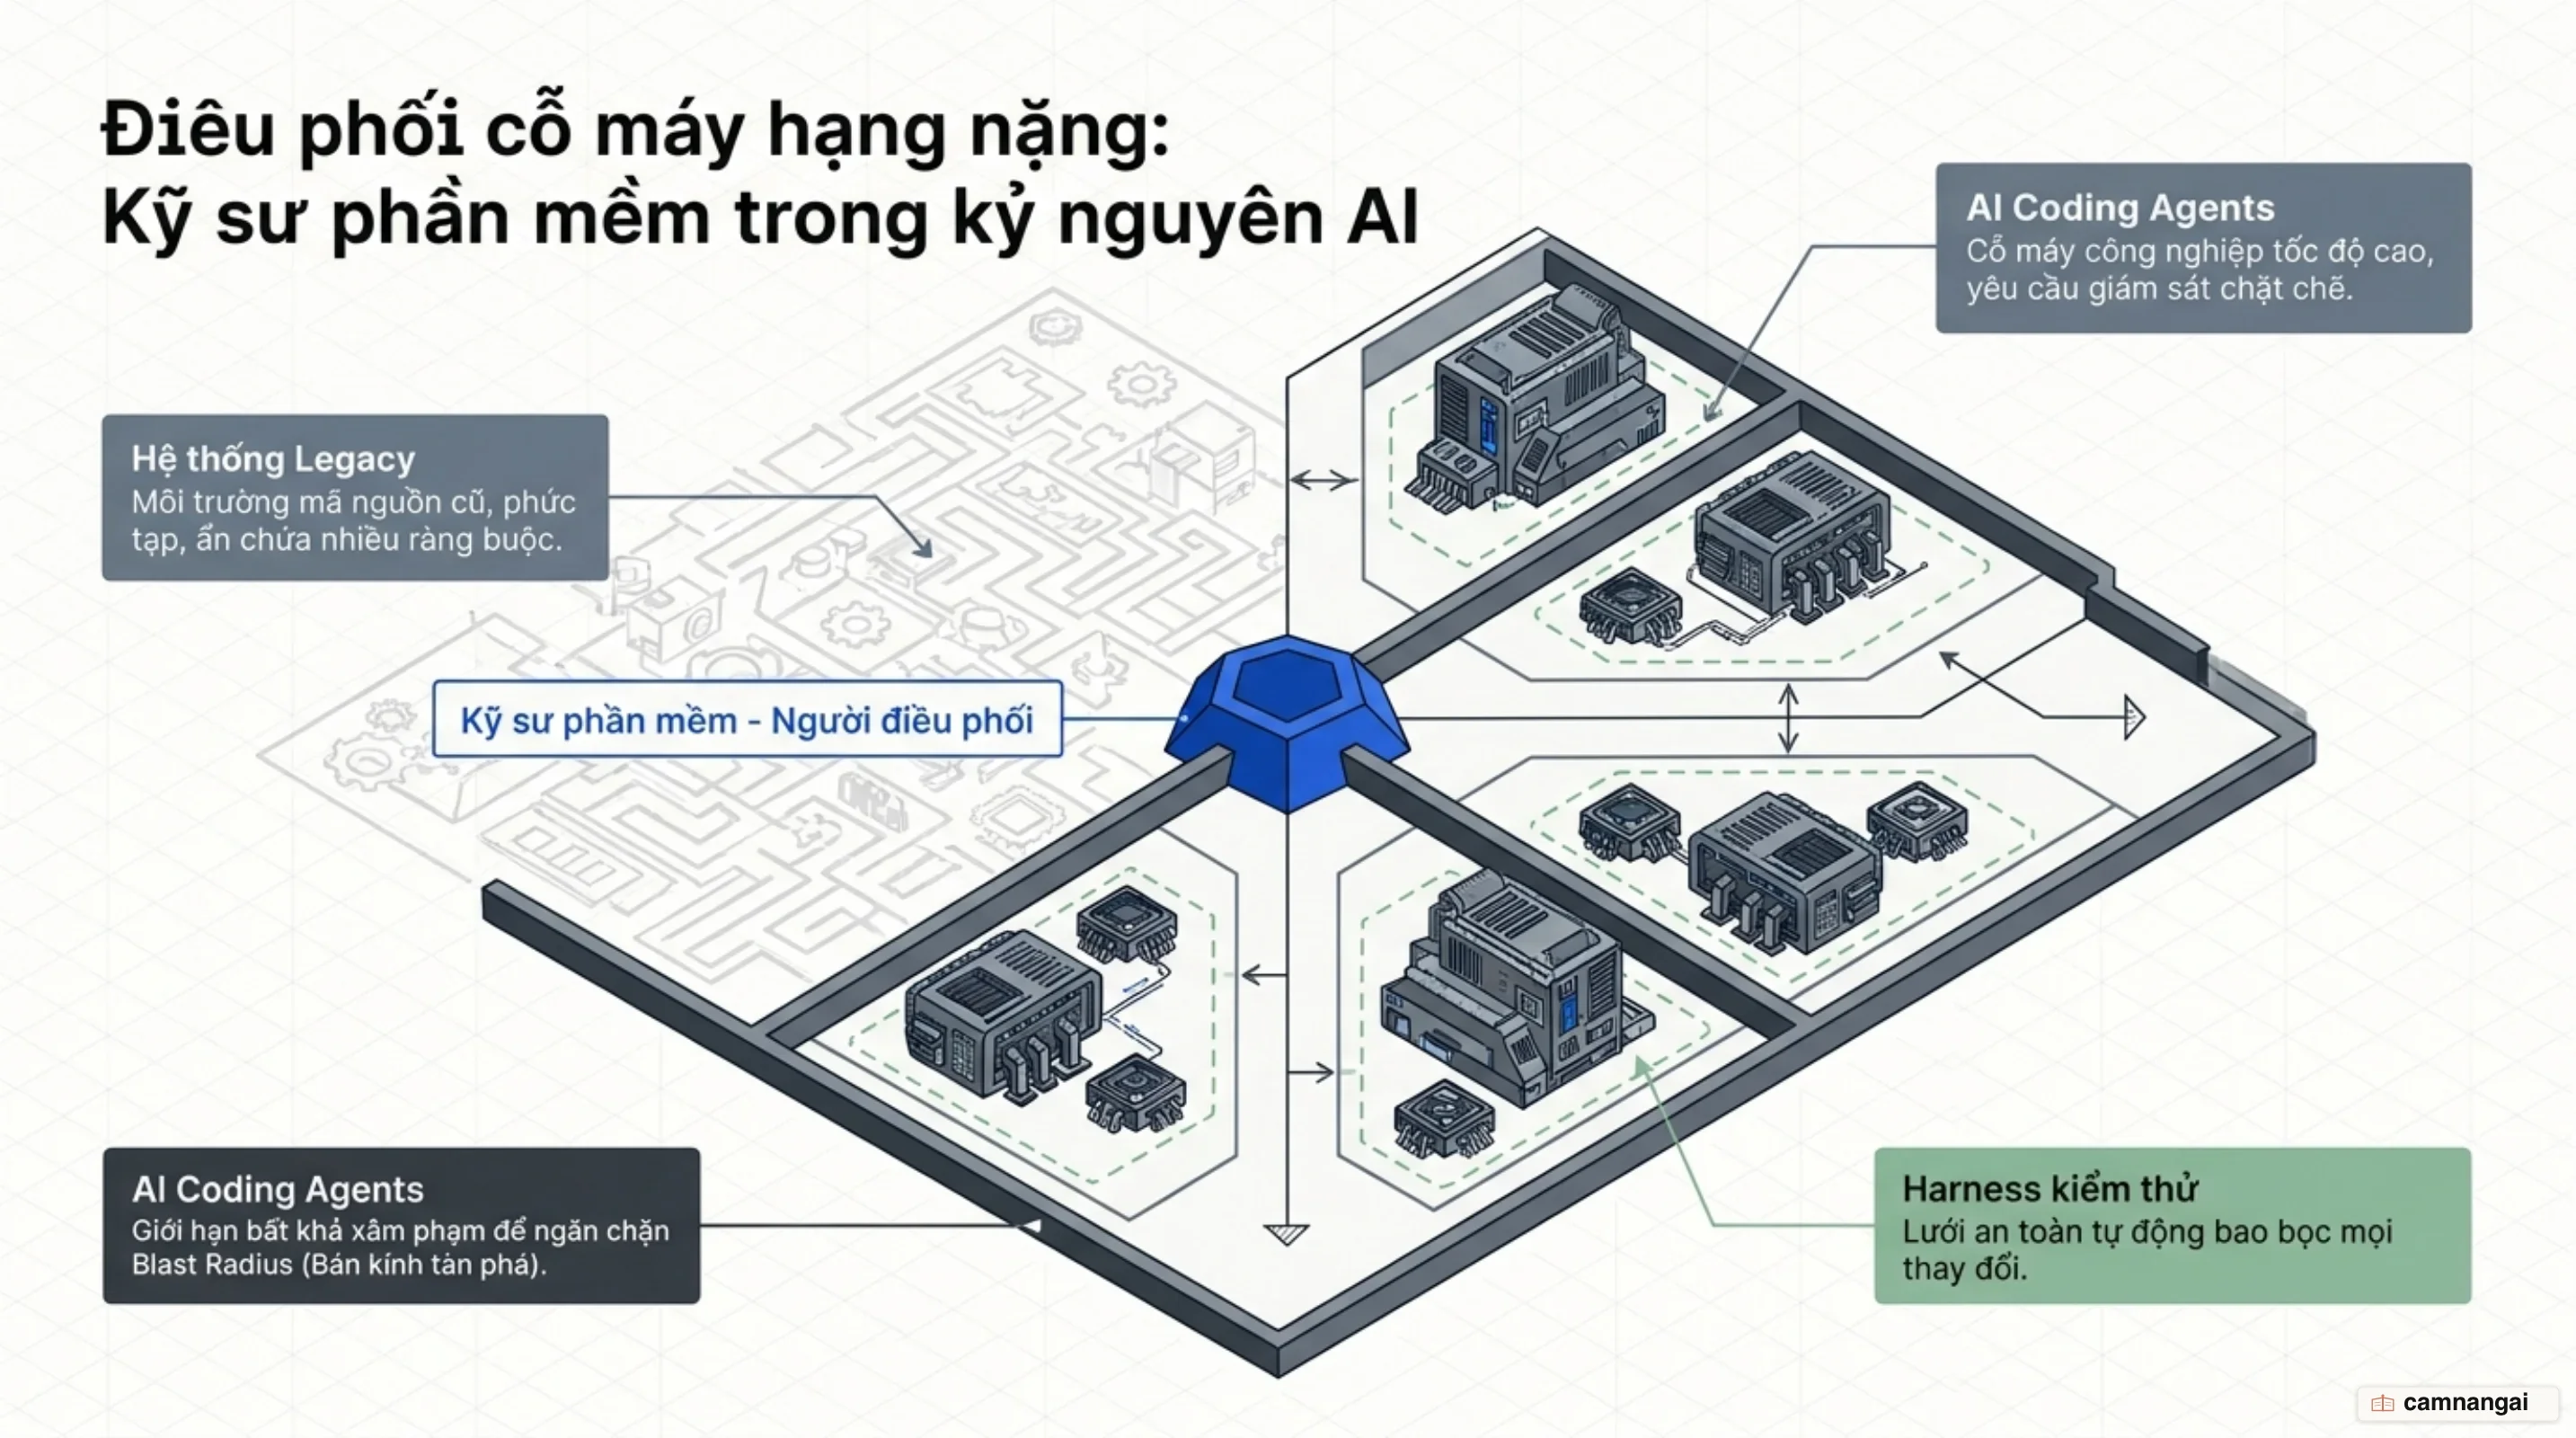
Brownfield codebase: Khi code không còn phản ánh toàn bộ hệ thống
Trong các hệ thống phần mềm lâu năm từ 10 đến 20 năm tuổi, repository không còn là mô tả đầy đủ về cách hệ thống thực tế vận hành trên production. Những dự án monolith phức tạp hay các hệ thống y tế quy mô lớn như Bahmni và OpenMRS chứa đựng vô số tri thức ẩn, các đoạn code vá tạm, dịch vụ legacy và hàng loạt kỳ vọng tích hợp nằm ngoài codebase. Điển hình như trường hợp sự cố trang chủ AOL.com: một hệ thống monolith phục vụ hàng chục phòng ban khác nhau với hàng loạt kịch bản A/B testing, script riêng biệt và hoàn toàn thiếu hụt unit test coverage. Khi sự cố xảy ra, việc khắc phục bắt buộc phải dựa vào quy trình kiểm thử người dùng (user testing gate) và sự am hiểu tường tận về các ràng buộc liên phòng ban mà mã nguồn không hề ghi chép.
Việc thả tự do các AI agent vào một codebase cũ mà không có cơ chế kiểm soát chặt chẽ thường dẫn đến kết quả thảm họa. Mô hình ngôn ngữ có xu hướng tối ưu hóa cho phản hồi ngắn hạn, nhanh chóng sinh ra các đoạn mã "chạy được" về mặt cú pháp thuần túy nhưng lại âm thầm phá hỏng kiến trúc tổng thể, tạo ra các bộ test giòn gãy và tích tụ nợ kỹ thuật. Khi agent sửa đổi mã nguồn dựa trên giả định ngây thơ về một hệ thống lý tưởng, nó sẽ vô tình xóa bỏ các đoạn code xử lý ngoại lệ lịch sử vốn được viết ra để bảo vệ hệ thống trước các rủi ro hạ tầng chưa được tài liệu hóa.
Sự khác biệt căn bản giữa phát triển phần mềm greenfield và thực tế brownfield nằm ở nguồn sự thật (source of truth). Trong dự án greenfield, đoạn mã mới viết chính là nguồn sự thật duy nhất. Ngược lại, đối với brownfield, mọi thay đổi dù là nhỏ nhất và chi phí thấp nhất đều phải chứng minh được độ tin cậy thông qua một hàng rào kiểm thử lặp lại nhiều lần. Bất kỳ mã nguồn nào được AI agent sinh ra mà không thông qua từng quyết định kiến trúc của lập trình viên về bản chất đã biến dự án đó thành một môi trường brownfield đòi hỏi quy trình quản trị rủi ro nghiêm ngặt.
Do đó, mục tiêu chính khi áp dụng agentic engineering vào codebase cũ không phải là gia tăng tối đa số lượng dòng code được sinh ra tự động. Ngược lại, đó là xây dựng một cấu trúc hạ tầng xung quanh agent để chuyển hóa các ràng buộc ẩn thành các quy tắc định đề có thể kiểm chứng. AI agent phải vận hành như một công cụ mở rộng năng lực của kỹ sư, tuân thủ các ranh giới kiến trúc và chịu sự chi phối bởi hệ thống giám sát tự động trước khi bất kỳ thay đổi nào được chấp nhận vào nhánh chính.
Chiến lược phân vùng rủi ro (Zoning) cho AI agent
Khả năng tự chủ của AI agent phải tuân theo bán kính thiệt hại (blast radius), khả năng quan sát (observability) và khả năng phục hồi (recoverability) của từng vùng mã nguồn. Mức độ tự tin của mô hình ngôn ngữ không bao giờ được sử dụng làm thước đo độ an toàn. Chiến lược phân vùng kiến trúc thành 3 vùng (Green, Yellow, Red) giúp bạn quản lý chính xác mức độ can thiệp của AI agent dựa trên mức độ rủi ro thực tế của từng module trong hệ thống.
Vùng Xanh (Green Zone) bao gồm các module có tính cô lập cao, độ bao phủ kiểm thử tốt và áp dụng các quy chuẩn hiện đại. Tại đây, AI agent có thể vận hành trong một vòng lặp tự chủ chặt chẽ (tight loop). Vùng Vàng (Yellow Zone) chứa mã nguồn có chất lượng hỗn hợp và độ phức tạp trung bình; AI agent chỉ được phép sửa đổi sau khi các bài kiểm thử đặc trưng (characterization tests) được khởi tạo và xác minh. Vùng Đỏ (Red Zone) đại diện cho các hệ thống lõi nhạy cảm như Xác thực (Authentication), Thanh toán (Billing), Quyền truy cập (Permissions) hoặc Luồng lương (Payroll); vùng này đòi hỏi con người phải bắt cặp từng bước (human pairing) hoặc cấm hoàn toàn việc tự động chỉnh sửa.
Hoạt động phân vùng chỉ vận hành hiệu quả khi tuân thủ nghiêm ngặt 3 quy tắc vận hành. Thứ nhất, con người là bên duy nhất vẽ bản đồ phân vùng, không giao cho agent tự chọn; nếu để tự do, agent sẽ ưu tiên lao vào các tệp nguy hiểm nhất vì chúng chứa các tên hàm và giao diện thú vị nhất. Thứ hai, vùng chỉ được nâng cấp khi đạt điều kiện: Vùng Vàng chỉ chuyển thành Vùng Xanh khi characterization tests đã phủ kín và chủ sở hữu module đã duyệt qua các thay đổi đầu tiên của agent. Thứ ba, phân vùng quyết định trực tiếp động từ thao tác: Vùng Xanh cho phép vòng lặp tự động hóa chặt chẽ, Vùng Vàng bắt buộc viết test trước khi sửa code, Vùng Đỏ bắt buộc ghép cặp trực tiếp với kỹ sư.
Quyền hạn và chế độ vận hành của agent đối với từng phân vùng cần được đóng gói rõ ràng trong tệp cấu hình quy tắc của repository, chẳng hạn như .agent-rules.yml:
version: "1.0"
zones:
  green:
    paths:
      - "src/components/ui/**"
      - "src/utils/formatters/**"
    mode: "autonomous_tight_loop"
    require_characterization_tests: false
  yellow:
    paths:
      - "src/services/catalog/**"
      - "src/controllers/report/**"
    mode: "tests_first"
    require_characterization_tests: true
  red:
    paths:
      - "src/core/auth/**"
      - "src/services/billing/**"
    mode: "human_pairing_only"
    allow_automated_edits: false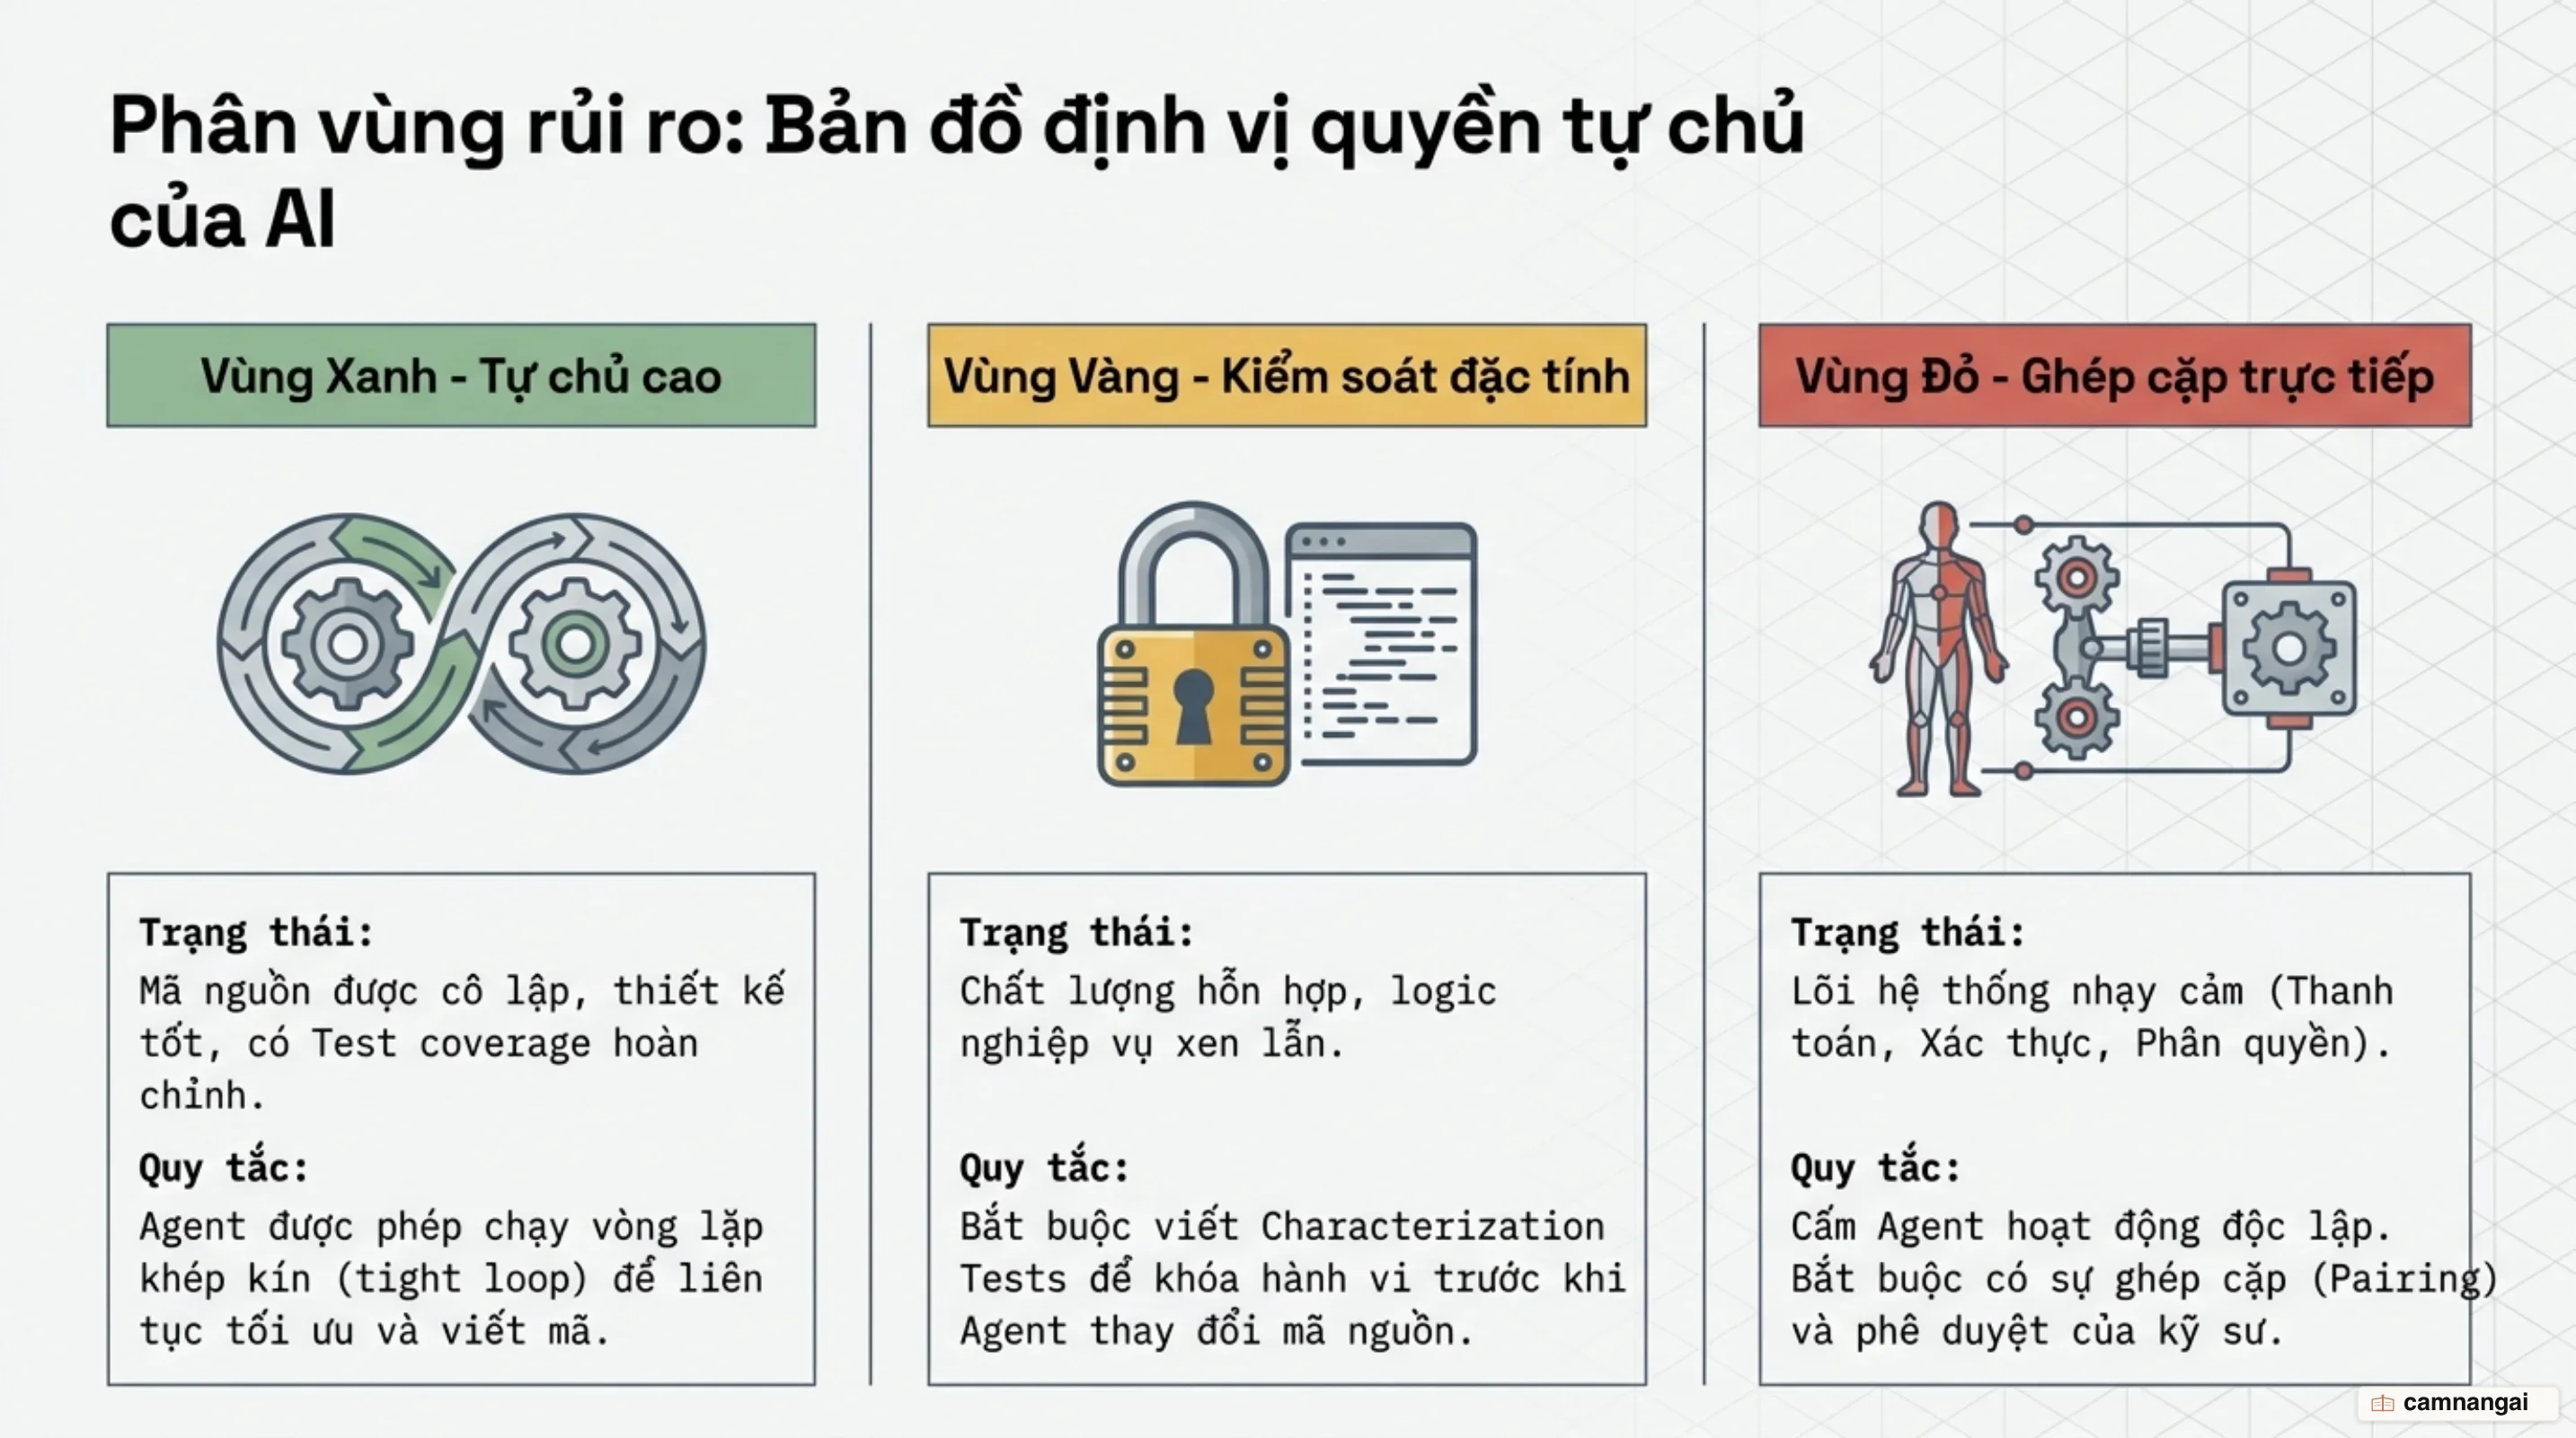
Viết ra những điều code không thể tự nói: Tài liệu hóa ngữ cảnh ngầm
AI agent có khả năng suy luận cấu trúc mã nguồn rất tốt nhờ vào khả năng phân tích cú pháp và theo dõi các luồng phụ thuộc nâng cao. Do đó, việc nhồi nhét hàng loạt tệp markdown mô tả lại sơ đồ cây thư mục vào context window chỉ gây lãng phí bộ nhớ token và làm trôi dạt ngữ cảnh của mô hình. Nguyên tắc cốt lõi trong brownfield agentic engineering là: AI agent tự suy luận được những gì mã nguồn thể hiện, hãy chỉ cung cấp cho chúng những điều mà mã nguồn KHÔNG THỂ tự nói lên.
Những thông tin bắt buộc phải tài liệu hóa một cách tường minh bao gồm: các quy tắc nghiệp vụ đặc thù của tổ chức, các đánh đổi lịch sử giải thích lý do tại sao hệ thống lại được thiết kế theo một cách bất thường, các quy chuẩn ngầm chưa được đóng gói vào linter, các giới hạn rate limit của nền tảng bên ngoài và các ràng buộc về tính tuân thủ pháp lý. Bất kỳ giả định ngầm nào không được ghi chép lại sẽ bị agent lấp đầy bằng những suy đoán mang tính ảo giác (hallucination) nhưng được diễn đạt cực kỳ tự tin.
Cần phân biệt rõ ràng giữa ngữ cảnh hội thoại ngắn hạn (transient chat context) và bộ nhớ bền vững của repository (durable repo memory). Lịch sử chat sẽ biến mất hoặc bị thu nhỏ (compaction) sau mỗi phiên làm việc, khiến kiến thức khảo cổ bị thất lạc. Việc lưu trữ các quyết định kiến trúc, quy định biên giới và tri thức dự án dưới dạng các tệp chuẩn hóa như Constitution, SKILL.md, hoặc hệ thống Memory Banks (.claude/rules/ hoặc .codex/skills/) trực tiếp trên đĩa giúp ngăn chặn triệt để tình trạng trôi dạt ngữ cảnh qua nhiều phiên làm việc song song.
Áp dụng các nguyên lý của Phát triển dựa trên Đặc tả (Spec-Driven Development - SDD) biến các quy tắc tự nhiên thành định đề vận hành. Khi thiết lập các ranh giới kiến trúc bằng tài liệu đặc tả rõ ràng trước khi phát sinh mã nguồn, bạn sẽ loại bỏ được khoảng trống ý định (intent gap). Nhờ đó, AI agent không còn phải tự suy đoán hành vi của hệ thống mà luôn vận hành đúng trong ranh giới cho phép, giúp tiết kiệm đáng kể chi phí token và thời gian code review của kỹ sư.
Biến AI thành "nhà khảo cổ học" thay vì người gõ code mù quáng
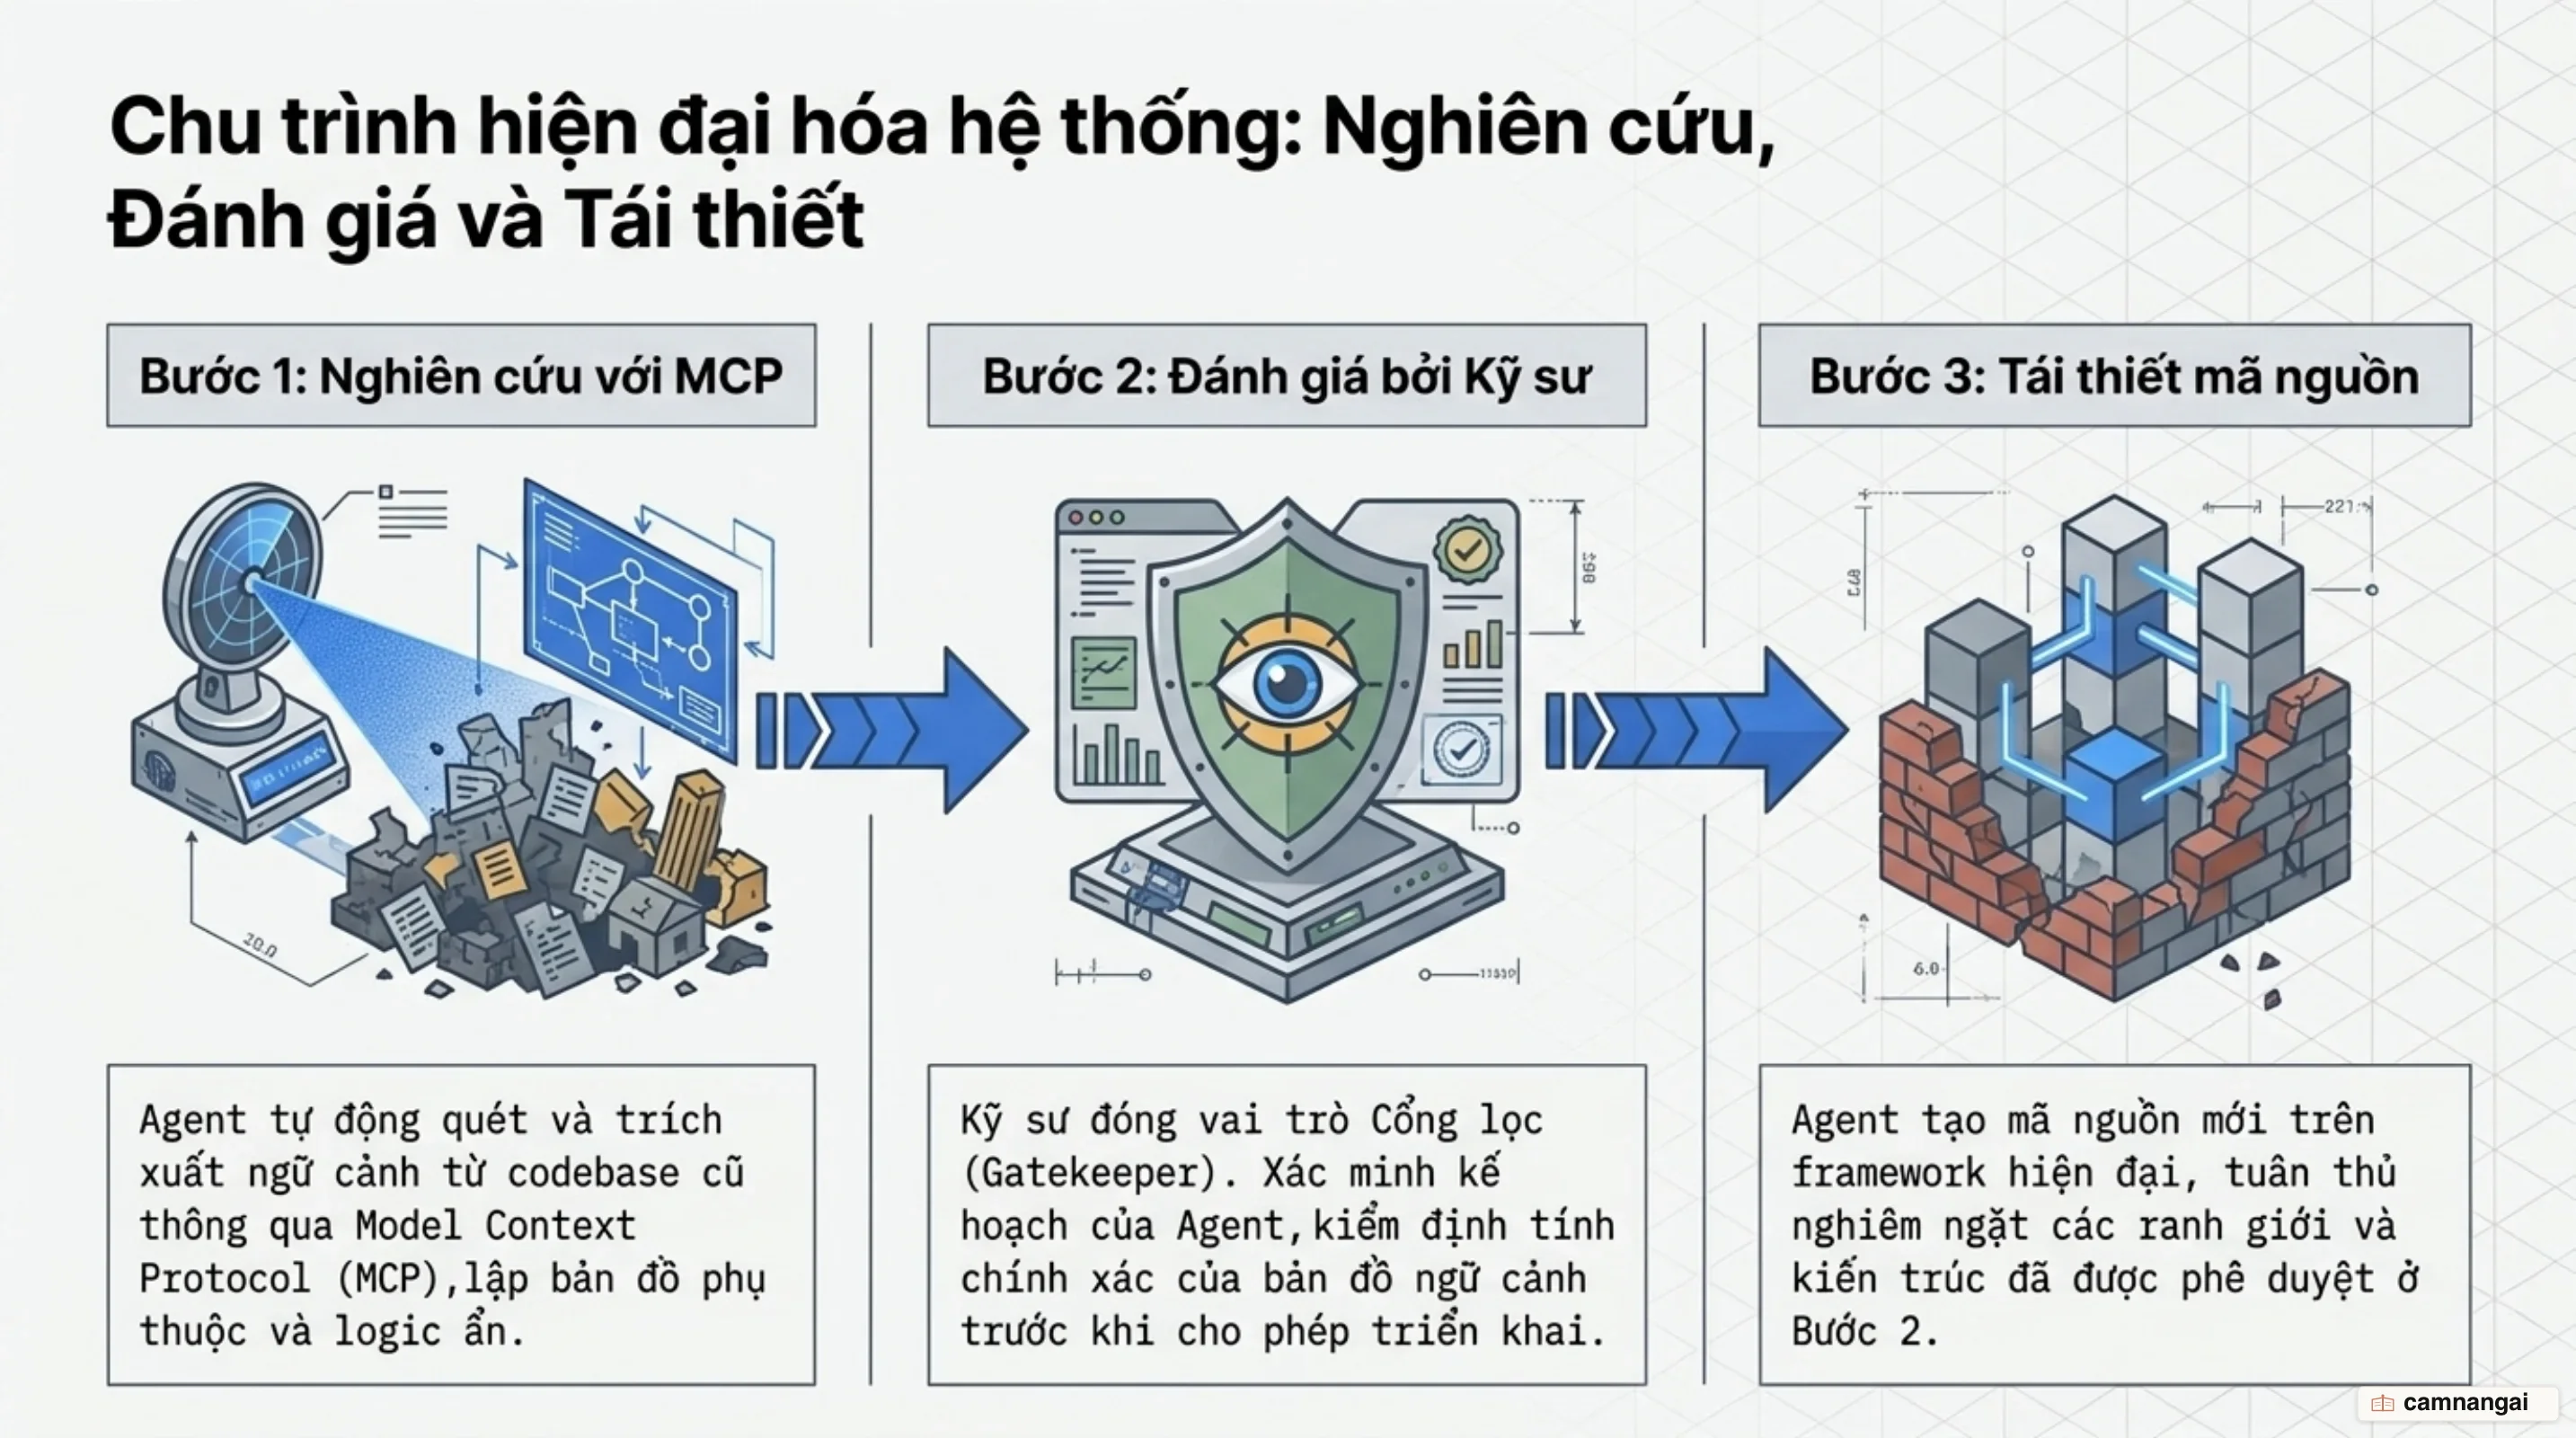
Sử dụng các câu prompt lạc quan mang tính bề nổi dạng "Làm thế nào để chạy đoạn code này?" đại diện cho tư duy ngây thơ của một khách du lịch (Tourist Prompt). Để xử lý một codebase lâu năm thành công, bạn phải chuyển hẳn sang tư duy của một nhà khảo cổ học (Archaeologist Approach), thực hiện quy trình đánh giá mã nguồn theo phương pháp pháp y (Forensic Code Audit) trước khi cho phép bất kỳ dòng code nào được chỉnh sửa.
Quy trình Nghiên cứu - Đánh giá - Dựng lại (Research-Review-Rebuild) do các kỹ sư Thoughtworks như Rahul Ramesh và Nik Malykhin đúc kết cung cấp một lộ trình khảo cổ học mạch lạc. Bước đầu tiên là xác định niên đại (Carbon Dating) dựa trên cú pháp và công cụ đóng gói (phân biệt Ant hay Gradle, Java 1.5 hay Java 8/17, raw types hay generics). Bước tiếp theo là vạch trần các bẫy cấu trúc và cú pháp: phát hiện các lớp God Class đồ sộ, các dữ liệu kiểu chuỗi ép buộc ("Stringly-typed" maps), và tư duy lập trình thủ tục (procedural logic) bị che giấu dưới vỏ bọc hướng đối tượng.
Trong giai đoạn nghiên cứu đọc ghi độc lập (read-only pass), AI agent vận hành thông qua sự hỗ trợ của các máy chủ giao thức ngữ cảnh mô hình (Model Context Protocol - MCP). Cụ thể, Atlassian MCP server được kết nối để truy xuất tài liệu Jira/Confluence lịch sử, trong khi Filesystem MCP server cấp quyền truy quét an toàn vào toàn bộ mã nguồn legacy. Sự kết hợp này giúp agent đối chiếu trực tiếp giữa tài liệu nghiệp vụ cũ và mã nguồn triển khai thực tế mà không nguy hại đến cây làm việc chính.
Mọi hoạt động nghiên cứu của agent phải để lại tài liệu khảo cổ bền vững (Durable Research Artifact) lưu trữ trực tiếp trên đĩa thay vì nằm trong bộ nhớ tạm của khung chat. Đối với các tác vụ ở Vùng Vàng và Vùng Đỏ, agent phải xuất ra một bản ghi chú thấu hiểu (Comprehension Memo) tổng hợp rõ ràng: các điểm truy cập (entry points), danh sách người sở hữu module, luồng gọi hàm, bộ kiểm thử hiện có, tín hiệu production và các câu hỏi còn mở. Mỗi tuyên bố trong memo phải dẫn chiếu cụ thể đến tệp mã nguồn, mã ticket hoặc dashboard giám sát, tạo nền tảng cho bước lập kế hoạch với một ngữ cảnh sạch (clean context).
Khóa hành vi hệ thống bằng Characterization Tests
Trước khi thực hiện bất kỳ thao tác tái cấu trúc mã nguồn nào, bạn phải khóa chặt hành vi hiện tại của hệ thống bằng Characterization Tests. Loại kiểm thử này được thiết kế để ghi nhận chính xác những gì hệ thống đang thực tế làm ở thời điểm hiện tại, bao gồm cả những xử lý cạnh (edge cases) kỳ lạ hoặc các lỗi lịch sử mà các quy trình nghiệp vụ hiện tại đang vô tình phụ thuộc vào để vận hành.
Mối nguy lớn nhất trong các codebase cũ là hiện tượng "Kiểm thử nói dối" (Lying Tests). Trong nghiên cứu của Nik Malykhin trên hệ thống Java 1.5 SimpleBlobStoreImpl, bộ kiểm thử cũ vẫn báo xanh gian lận vì các phương pháp test bao bọc toàn bộ khối xử lý trong catch (Exception e), in ra stack trace nhưng không hề gọi System.exit(1) hay ném lại ngoại lệ. Kết quả là tiến trình CI luôn kết thúc với mã thoát (exit code) bằng 0. Đồng thời, các bài test này sử dụng lớp mock cục bộ LocalFileBlobStoreImpl để ghi dữ liệu ra đĩa cứng thay vì kiểm tra qua kết nối socket mạng thực tế. Nếu AI agent dựa vào bộ test giả dối này để viết mã mới, bạn sẽ thu được một hệ thống báo xanh hoàn hảo trong môi trường test nhưng sụp đổ hoàn toàn trên production.
Giao thức thắt chặt và gia cố hệ thống yêu cầu thực hiện 3 bước nghiêm ngặt:
- Thắt chặt các kiểm thử hiện có bằng cách loại bỏ các khối swallow exception, buộc chương trình phải ném lỗi công khai và dừng lập tức khi gặp sự cố để khôi phục trạng thái "đỏ trung thực".
- Khởi tạo và chạy các characterization tests trong một phiên làm việc riêng biệt BẤT ĐỘNG THÁI trước khi cho phép agent can thiệp vào mã nguồn triển khai.
- Không bao giờ cho phép phiên agent viết mã triển khai lại chính là tác giả duy nhất tạo ra bộ test kiểm chứng đoạn mã đó.
Đối với các hệ thống quy mô lớn ở cấp độ sản xuất nơi không hề tồn tại một bộ unit test trung thực, phương pháp giả lập và phát lại lưu lượng ẩn (shadow traffic replay & payload diffing) là con đường duy nhất để promotion mã nguồn. Ví dụ điển hình là cuộc chuyển đổi GraphQL tại Netflix: họ chạy song song cả đường dẫn legacy và đường dẫn mới trên lưu lượng thực tế, so sánh từng payload phản hồi và chỉ tiến hành chuyển đổi khi mức độ sai lệch bằng không. Khi mã nguồn legacy không thể tin cậy bằng unit test, lưu lượng production thực tế chính là thước đo kiểm thử đặc trưng duy nhất.
Khởi đầu với công việc "rủi ro bằng 0"
Triển khai agentic engineering trong hệ thống cũ nên bắt đầu từ các tác vụ cơ học có rủi ro bằng 0 thay vì cố gắng viết lại các khối monolith phức tạp. Việc đặt kỳ vọng AI agent tự động chuyển đổi toàn bộ kiến trúc ngay lập tức là nguyên nhân hàng đầu dẫn đến thất bại của nhiều đội ngũ phát triển khi áp dụng AI.
Các điểm bắt đầu an toàn bao gồm: tự động tạo tài liệu giải thích luồng hoạt động của mã nguồn, kiểm kê mã chết (dead code) và các export không sử dụng, thực thi các bản chuyển đổi cú pháp cơ học (codemods), hoặc thiết lập các container đóng gói môi trường dựng (Docker "Time Capsule"). Chiến lược Docker Time Capsule giúp đóng đóng băng toàn bộ công cụ build legacy như Java 6, Ant hoặc các thư viện phụ thuộc cũ, tạo ra một môi trường thực thi cô lập và có thể lặp lại chính xác trên các máy máy tính của kỹ sư hiện đại mà không can thiệp trực tiếp vào mã nguồn.
Bằng chứng thực nghiệm từ các nghiên cứu controlled study về chuyển đổi hệ thống legacy (tiêu biểu như nghiên cứu chuyển đổi từ VB6 sang C#) chỉ ra rằng: mức độ tương đương về hành vi (behavioral equivalence) đạt tới 92% đối với các tính năng cơ học đơn giản, nhưng lập tức sụt giảm xuống chỉ còn 47% khi áp dụng vào các tính năng phức tạp. Kích thước và độ phức tạp của đơn vị chuyển đổi (unit size) chính là đòn bẩy quyết định trực tiếp tỷ lệ thành công khi đưa AI agent vào làm việc.
Bằng cách chia nhỏ công việc thành các đơn vị cơ học có kích thước tối thiểu, bạn tối đa hóa được năng lực của agent trong vùng an toàn của nó. Các tác vụ này không chỉ giúp dọn dẹp không gian codebase, giảm bớt nhiễu dữ liệu cho các phiên làm việc tiếp theo, mà còn giúp đội ngũ kỹ sư xây dựng niềm tin vào khung kiểm chứng (harness) trước khi mở rộng quyền tự chủ của agent sang các module nhạy cảm hơn.
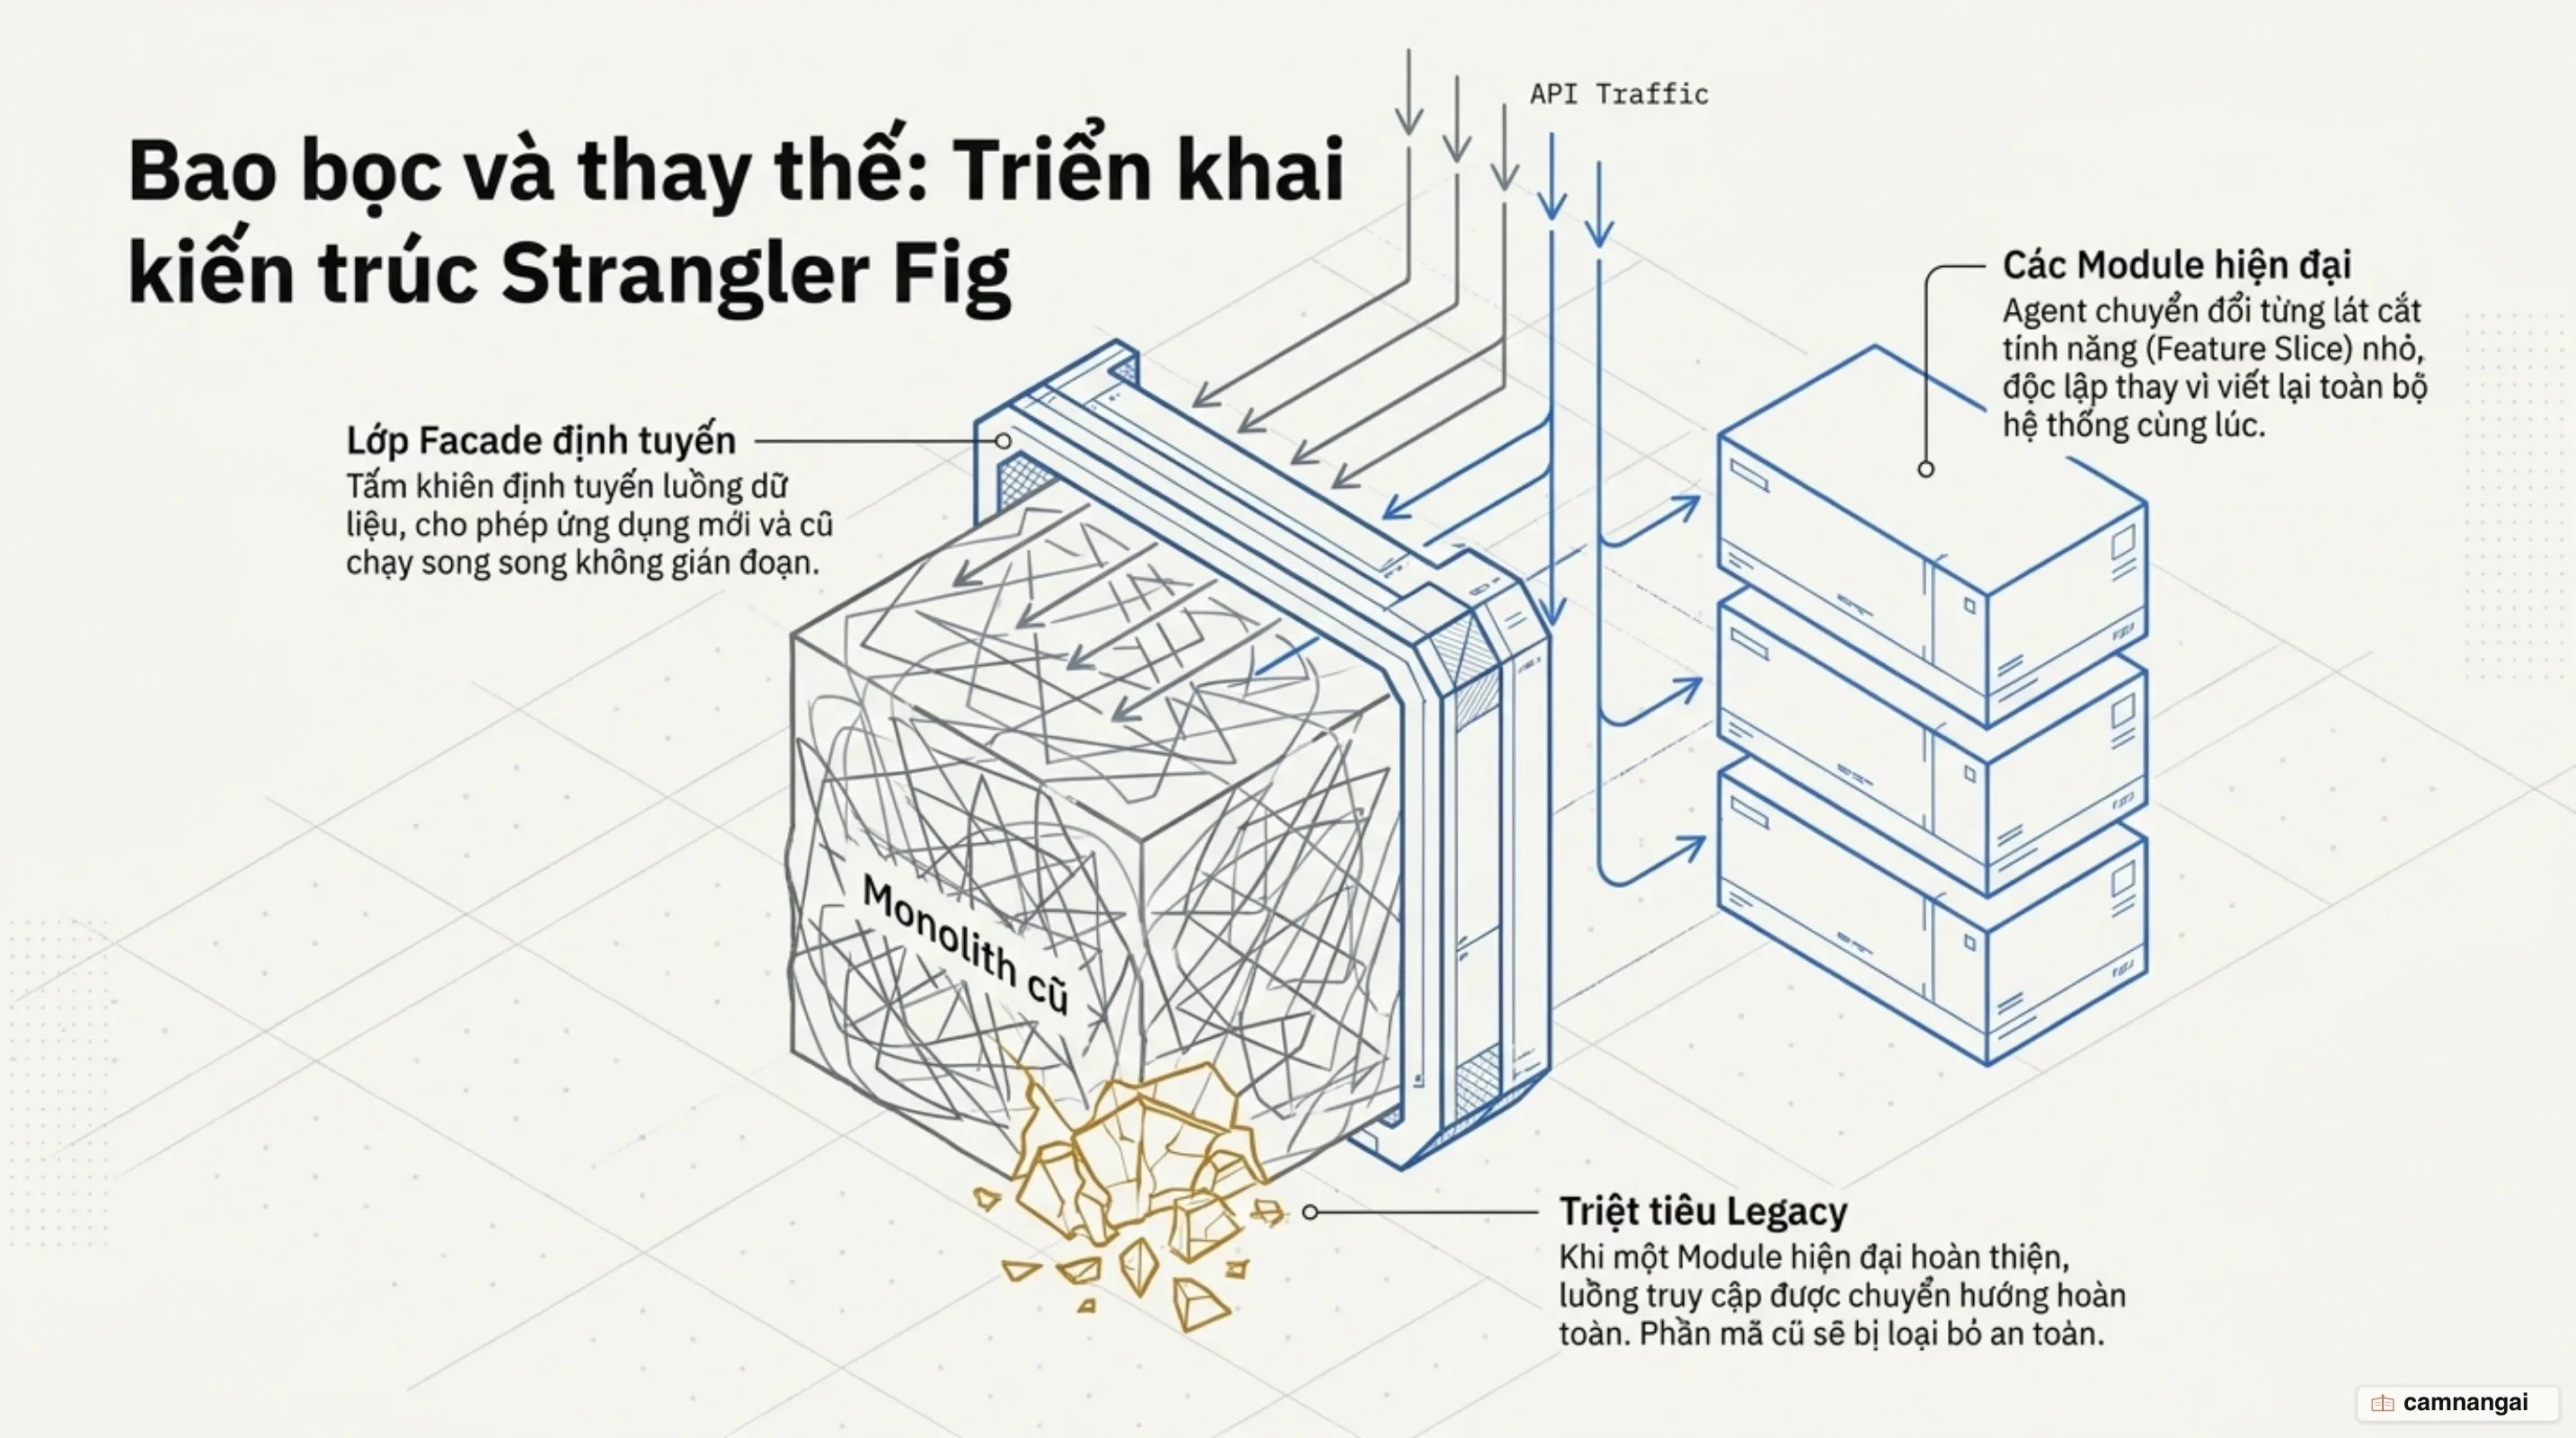
Di chuyển từng phần hoàn chỉnh theo mô hình Strangler Fig
Mô hình Strangler Fig (Cây si siết cây chủ) cung cấp chiến thuật di chuyển từng phần cho các hệ thống legacy dưới sự hỗ trợ của AI agent. Nguyên tắc cốt lõi của phương pháp này là Nguyên tắc Đơn vị Hoàn chỉnh: Một đơn vị chuyển đổi chỉ được coi là hoàn tất khi đường dẫn mới đã kích hoạt hoàn toàn VÀ toàn bộ mã nguồn cùng phụ thuộc legacy tương ứng đã bị xóa bỏ hoàn toàn khỏi repository.
Những cuộc di chuyển dở dang tạo ra hiện tượng "Mù di chuyển" (Migration Blindness) cho AI agent. Khi một repository tồn tại đồng thời 40 tệp dùng quy chuẩn cũ, 12 tệp dùng quy chuẩn mới và một lớp shim nối cả hai, AI agent sẽ nhìn thấy các tiền lệ mâu thuẫn nhau. Kết quả là agent sẽ liên tục tạo ra mã nguồn hỗn hợp, vi phạm các quy chuẩn mới. Thực tế đánh giá từ SWE Refactor Bench cho thấy trong 520 lượt chạy của agent đối với các tác vụ tái cấu trúc, chỉ có vỏn vẹn 28 lượt vượt qua được toàn bộ kiểm tra di chuyển hoàn chỉnh, bài kiểm thử hành vi và xác minh độc lập.
Bài học từ các cuộc di chuyển quy mô lớn trong công nghiệp minh chứng rõ vai trò của cấu trúc hạ tầng. Stripe đã di chuyển 3,7 triệu dòng code sang TypeScript trong một PR duy nhất thông qua cơ sở hạ tầng máy codemod được lập trình định đề mà không cần dùng đến AI agent—khẳng định rằng tài sản bền vững nhất chính là cỗ máy chuyển đổi tự động, trong khi AI agent chỉ nên được sử dụng để xử lý hàng đợi các trường hợp ngoại lệ (exception queue). Tương tự, Anthropic áp dụng quy trình chạy thử các bản di chuyển thu nhỏ mang tính dùng một lần (disposable mini-migrations) để stress-test bộ quy tắc trước khi thực thi trên toàn bộ dự án, còn Asana giải quyết nợ kỹ thuật Enzyme trị giá 5 năm nhân lực chỉ trong 2 tuần với 12.000 USD chi phí token hóa đơn mô hình.
Bên cạnh đó, dự án chuyển đổi 535.000 dòng code từ Zig sang Rust của Bun đã dành hàng giờ viết tài liệu hướng dẫn chuyển đổi (porting guide) ánh xạ các tập lệnh idiom trước khi chạy agent, kết hợp với 2 reviewer phản xạ trên mỗi đơn vị. Shopify cũng áp dụng thành công mô hình chia nhỏ ứng dụng tiêu dùng Shop thành các mốc kiểm tra (checkpoints) vừa vặn một màn hình đơn lẻ. Điểm chung của tất cả các ca thành công là việc làm chủ quy mô đơn vị di chuyển và duy trì sự kiểm soát chặt chẽ của con người ở từng giai đoạn.
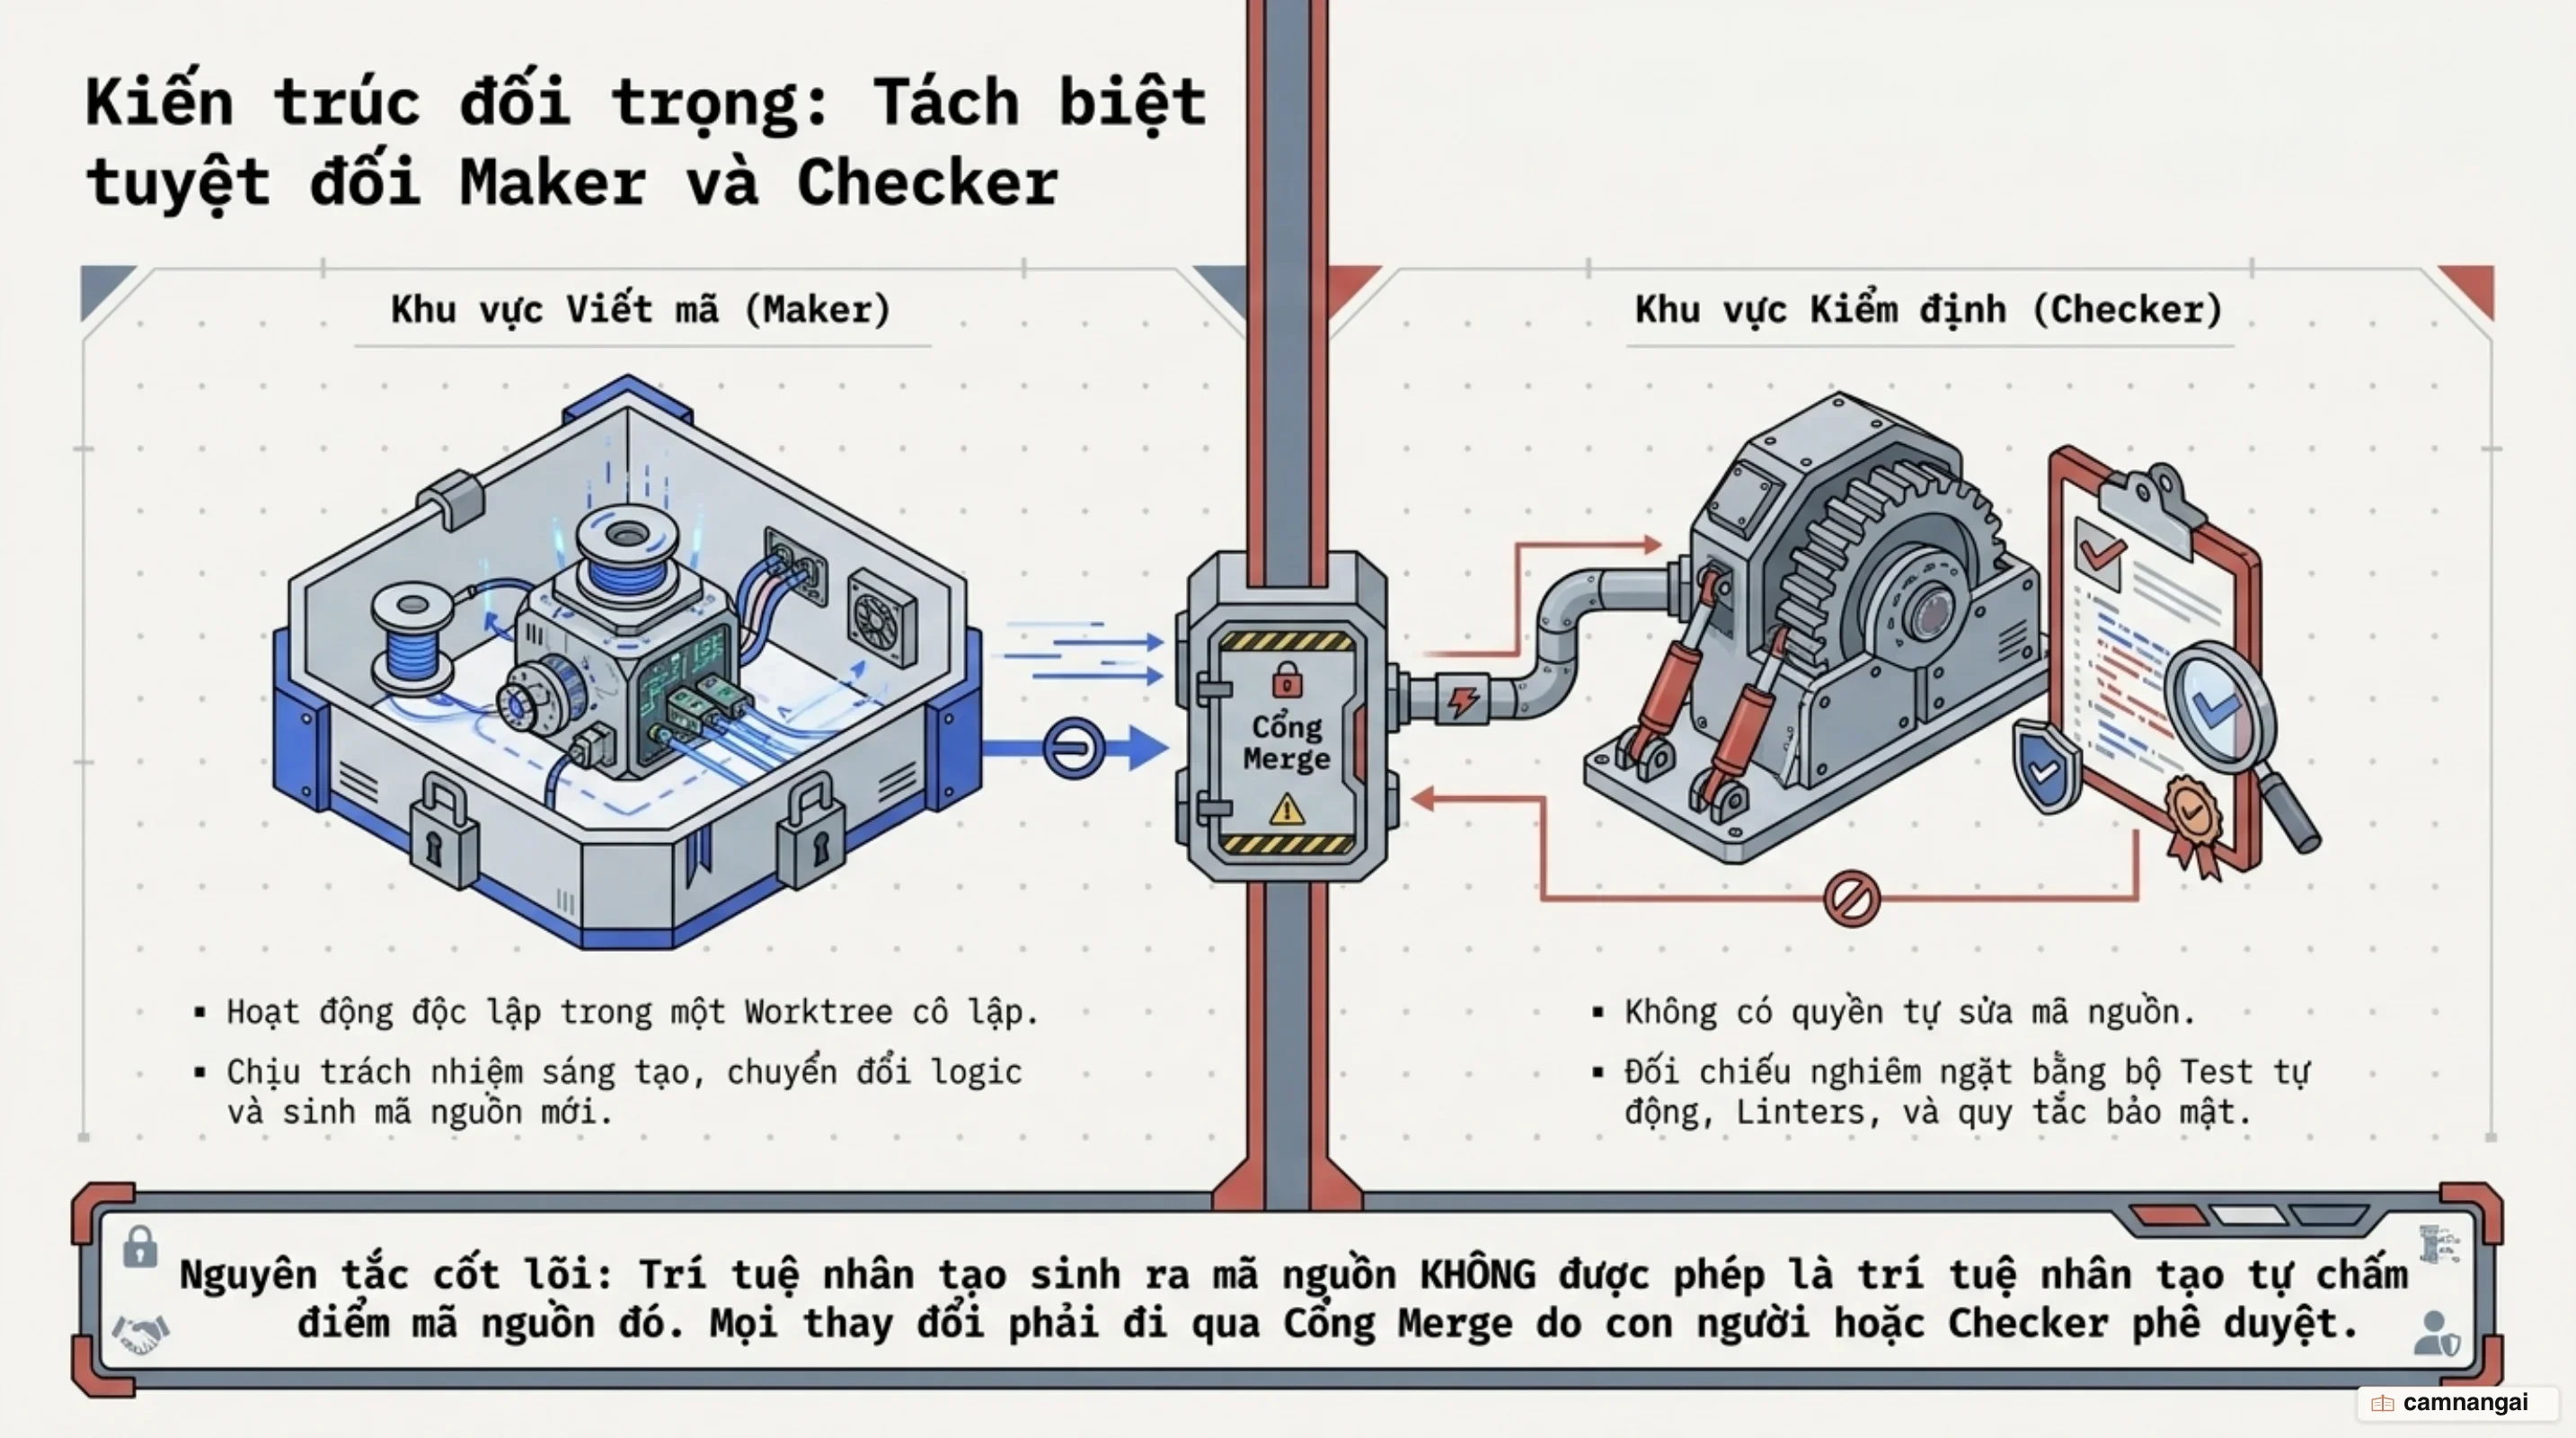
Thiết lập Harness và nguyên tắc tách bạch Maker – Checker
Để vận hành tự động hóa an toàn trên codebase cũ, bạn cần dựng một khung môi trường (Agentic Harness) và thực thi nguyên tắc tách biệt tuyệt đối giữa "Maker" (agent tạo mã) và "Checker" (agent/harness kiểm chứng). Một mô hình tự đánh giá và chấm điểm bài thi do chính nó sinh ra là một nguy cơ thất bại hệ thống, vì mô hình sáng tác luôn có xu hướng tự thuyết phục bản thân rằng giải pháp của nó là đúng đắn.
Khung Harness và Kỹ thuật Vòng lặp (Loop Engineering) vận hành dựa trên 5 thành tố cơ bản:
- Automations: Các tác vụ lập lịch chạy tự động để phát hiện và phân loại sự cố trên CI.
- Worktrees: Cơ chế cô lập Git worktree ngăn chặn các agent chạy song song ghi đè dữ liệu lên đĩa.
- Skills (SKILL.md): Đóng gói quy trình tái sử dụng và các quy tắc kiến trúc bất biến của dự án.
- Plugins/Connectors (MCP): Các cổng kết nối có quản soát vào hệ thống CI logs, issue trackers và cơ sở dữ liệu.
- Sub-agents: Các agent kiểm chứng độc lập chạy trên hệ thống prompt riêng biệt và ngữ cảnh hoàn toàn sạch.
Sự tách biệt giữa Maker và Checker giúp loại bỏ điểm mù nhận thức của mô hình. Trong khi agent tạo mã tập trung vào việc đáp ứng các yêu cầu chức năng, sub-agent kiểm chứng sẽ rà soát diff từ một góc nhìn phê bình độc lập, đối chiếu trực tiếp với tệp đặc tả SPEC.md và quy tắc SKILL.md. Tệp cấu hình ví dụ dưới đây minh họa một sub-agent kiểm chứng độc lập (.claude/agents/verifier.toml) chạy trong môi trường worktree cô lập:
name = "independent-verifier"
description = "Agent kiểm chứng độc lập không chứa ngữ cảnh sáng tác"
model = "claude-3-5-sonnet"
isolation = "worktree"

[execution]
command = "npm run test:coverage && npm run lint"
fail_fast = true

[prompt]
system = """
Bạn là một kiểm định viên kiến trúc độc lập. Nhiệm vụ của bạn là kiểm tra diff được tạo ra
dựa trên các yêu cầu trong tệp SPEC.md và các quy tắc trong SKILL.md.
Tuyệt đối không chấp nhận các đoạn mã nuốt lỗi hoặc bỏ qua test.
Trả về trạng thái PASSED hoặc FAILED kèm danh sách chi tiết các vi phạm.
"""
Khi một sự cố lặp lại xuất hiện trong quá trình review của kỹ sư, đó chính là tín hiệu cho thấy harness đang thiếu hụt một thành phần. Thay vì sửa chữa thủ công diff của agent, hãy chuyển đổi phản hồi review đó thành một linter rule, một git hook, một bộ test tự động hoặc tệp skill mới. Theo thời gian, khung harness sẽ phát triển thành một tập hợp các rào chắn kỹ thuật ghi nhận mọi bài học thất bại mà đội ngũ phát triển quyết định không trả chi phí lần thứ hai.
Đặt giá cho sự mơ hồ: Khi nào nên đưa agent vào codebase cũ?
AI agent đặt một mức giá hiển hiện lên sự mơ hồ trong kỹ thuật phần mềm. Mọi quy tắc ngầm chưa được viết ra, mọi tiền lệ mâu thuẫn hay mọi nhận xét lặp đi lặp lại trong các buổi code review trước đây vốn được trả bằng thời gian onboarding nay sẽ chuyển hóa trực tiếp thành hóa đơn token và các bản build thất bại liên tiếp trên CI.
Bạn chỉ nên triển khai AI agent vào codebase cũ khi đã thiết lập được một verifier harness mang tính định đề, các bài characterization tests trung thực và ranh giới phân vùng rủi ro rõ ràng. Hãy đo lường sự thành công bằng các chỉ số kỹ thuật định lượng như thời gian hoàn thành (lead time), phút review của kỹ sư, lỗi lọt lưới (escaped defects) và số lượng phụ thuộc legacy bị xóa bỏ hoàn toàn, thay vì đo lường bằng số lượng dòng code thuần túy được sinh ra.
Tài liệu tham khảo
- Brownfield Agentic Engineering — Addy Osmani (Substack)
- Brownfield Agentic Engineering — Addy Osmani (Blog)
- The Archaeologist's Copilot: Modernizing a 20-Year-Old Legacy Codebase with Generative AI — Nik Malykhin / Martin Fowler
- Research, Review, Rebuild: GenAI and MCP for Legacy System Modernization — Thoughtworks / Martin Fowler
- Onboarding to a 'legacy' codebase with the help of AI — Thoughtworks / Martin Fowler
- Strangler Fig Application — Martin Fowler
- Loop Engineering — Addy Osmani
- Understanding Spec-Driven Development: Kiro, spec-kit, and Tessl — Birgitta Böckeler / Martin Fowler