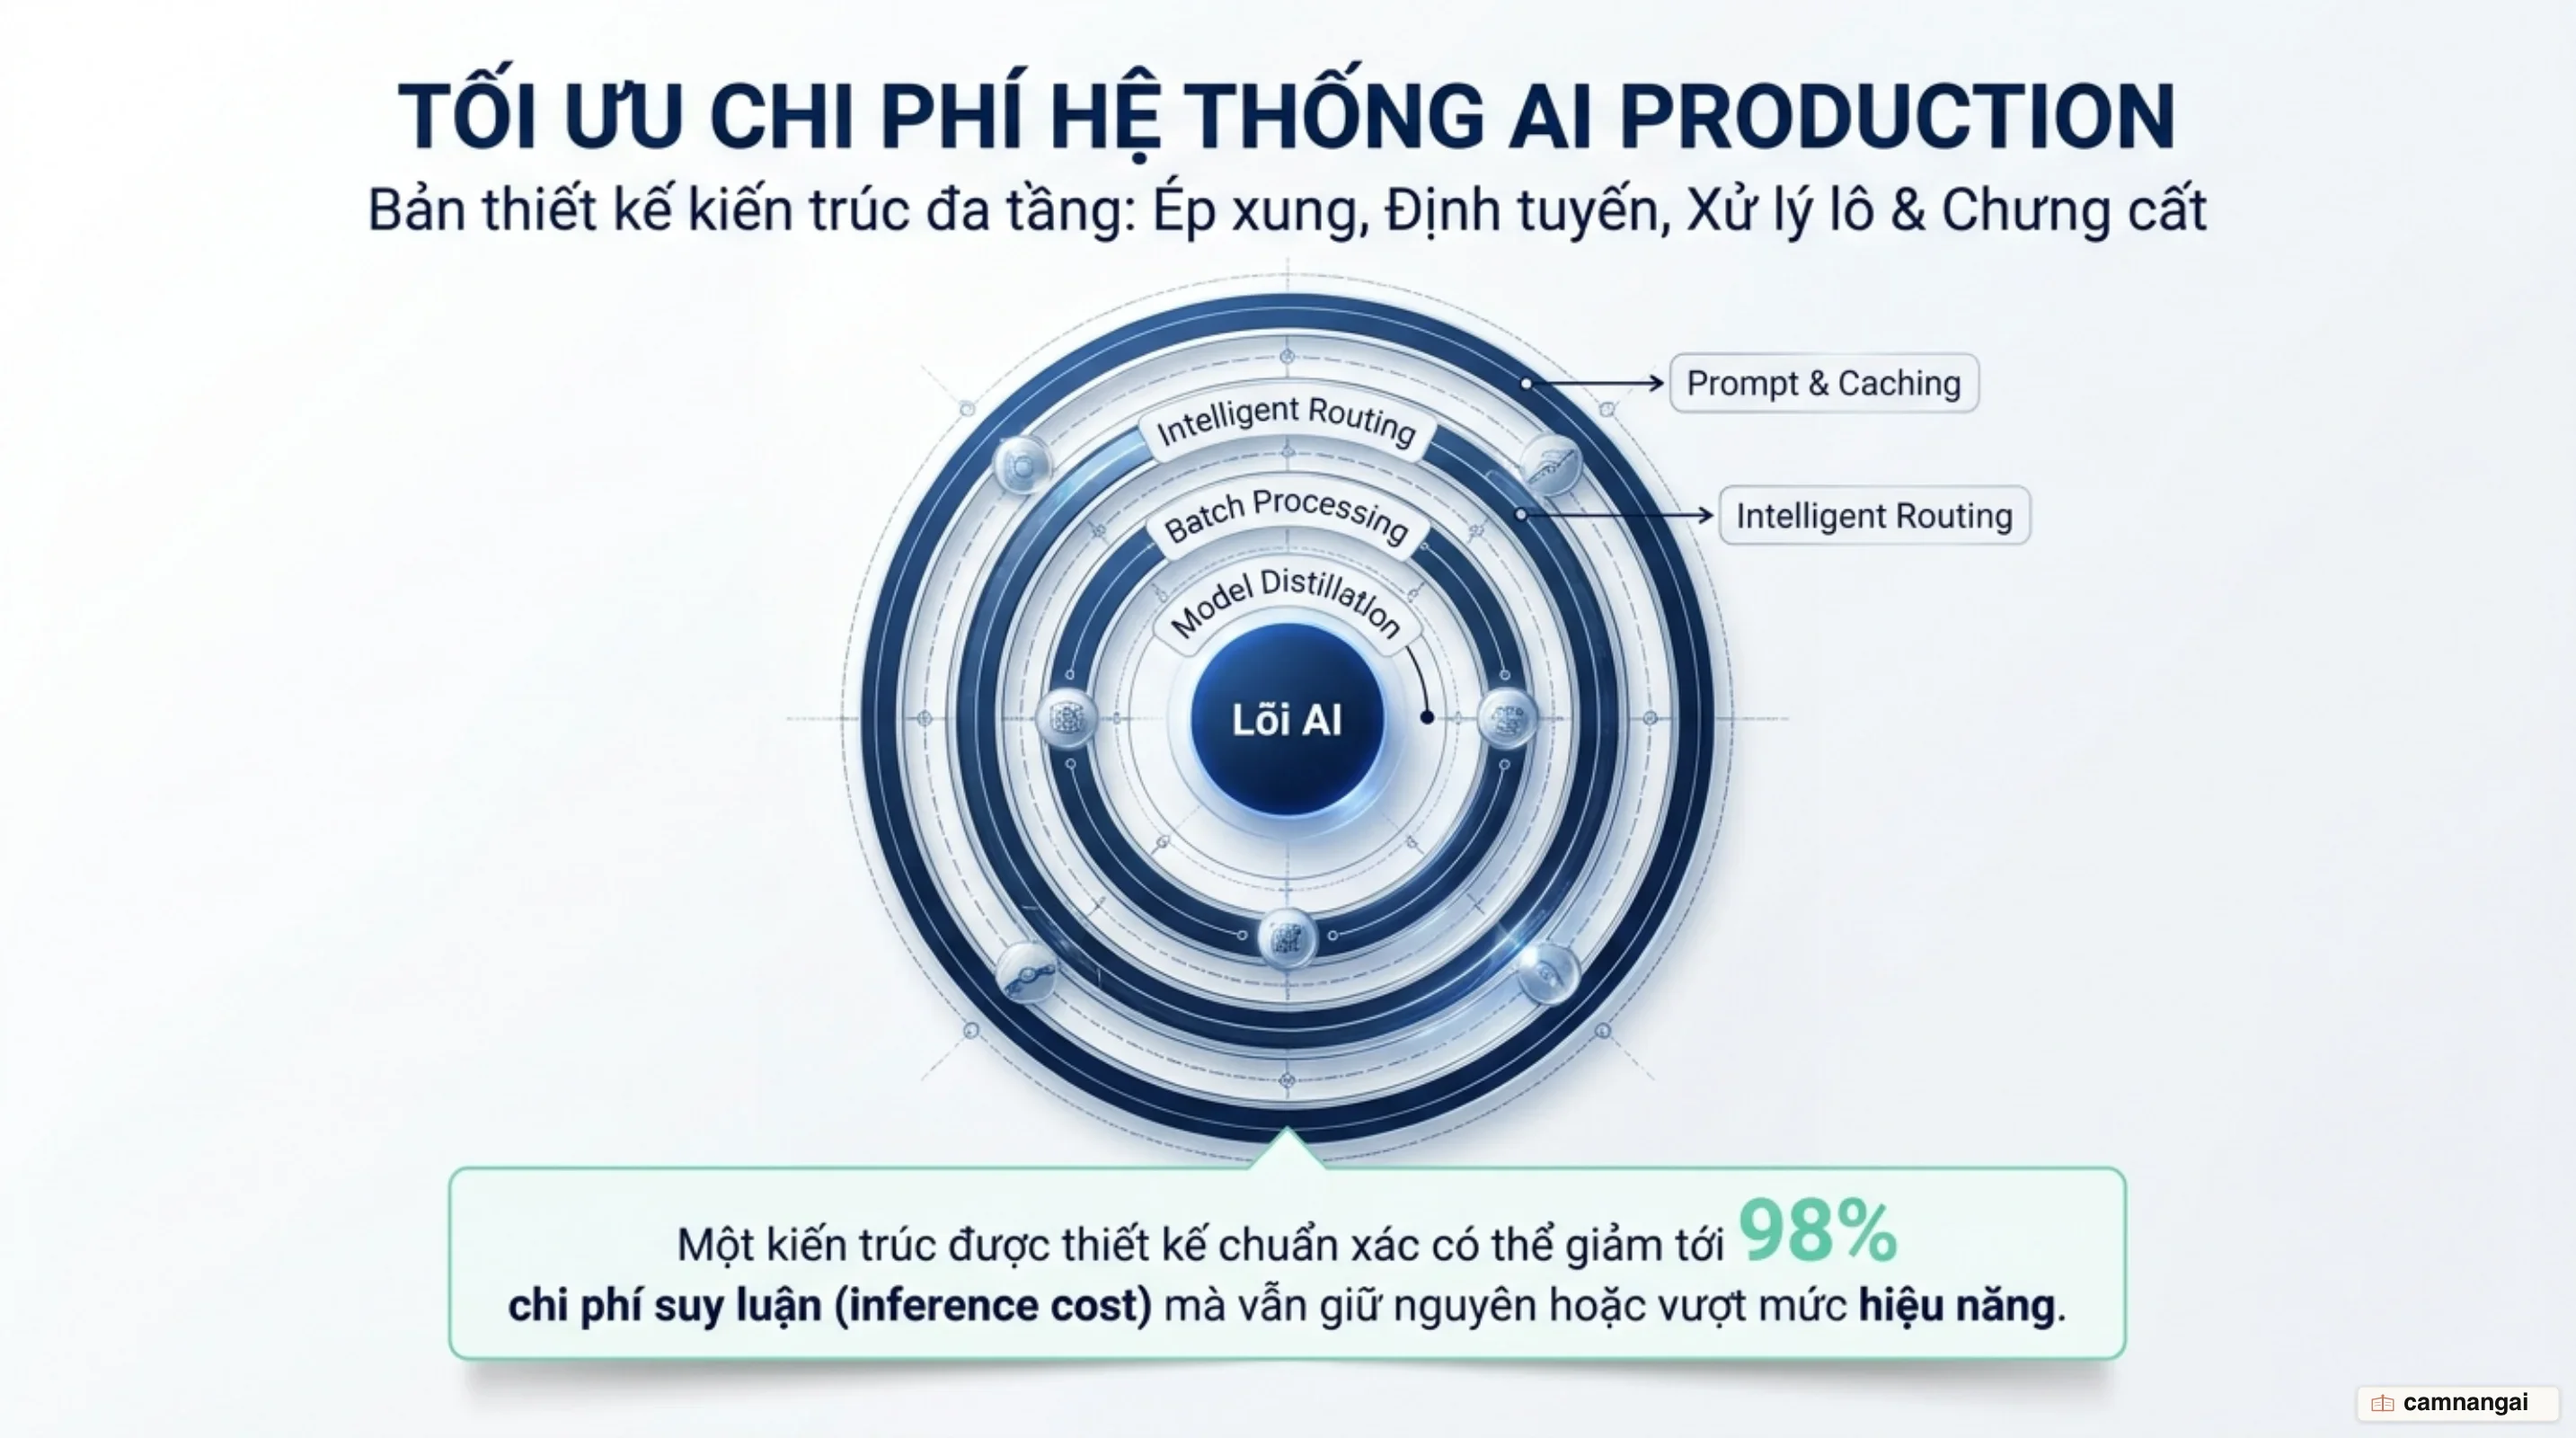
Để tối ưu chi phí hệ thống AI và cắt giảm từ 50% đến 98% chi phí vận hành mô hình ngôn ngữ lớn (LLM) mà không đánh đổi độ chính xác, bạn cần loại bỏ kiến trúc gọi API đơn lẻ truyền thống. Giải pháp kỹ thuật nằm ở việc triển khai hạ tầng đa tầng: nén prompt (prompt adaptation), bộ nhớ đệm ngữ nghĩa (), xử lý bất đồng bộ (Batch API), định tuyến mô hình linh hoạt ( Cascades) và chưng cất tri thức sang các mô hình ngôn ngữ nhỏ (SLM).
Chi phí suy luận (inference cost) của các mô hình biên như GPT-4 hay Claude Opus đang chiếm tỷ trọng lớn trong P&L của doanh nghiệp SaaS. Việc vận hành một hệ thống chatbot chăm sóc khách hàng quy mô 360.000 truy vấn/tháng có thể tiêu tốn hơn 21.000 USD/tháng, trong khi chi phí vận hành ChatGPT ước tính vượt 700.000 USD/ngày.
Sự bùng nổ chi phí này xuất phát từ việc đơn giá giữa các dòng mô hình chênh lệch tới 2 cấp độ quy mô (2 orders of magnitude) — từ 0,2 USD đến 30 USD cho 10 triệu đầu vào. Kiểm soát dòng tiền ở cấp độ kiến trúc hệ thống là điều kiện bắt buộc để đảm bảo chỉ số tài chính khi quy mô truy vấn tăng trưởng theo cấp số nhân.
Cơ cấu chi phí của hệ thống AI: Tiền thực sự biến mất ở đâu?
Để tối ưu hóa chi phí hạ tầng, bạn cần phân tích bản chất công thức tính giá API của các nhà cung cấp LLM. Chi phí cho một truy vấn p tới mô hình i được xác định theo mô hình toán học:
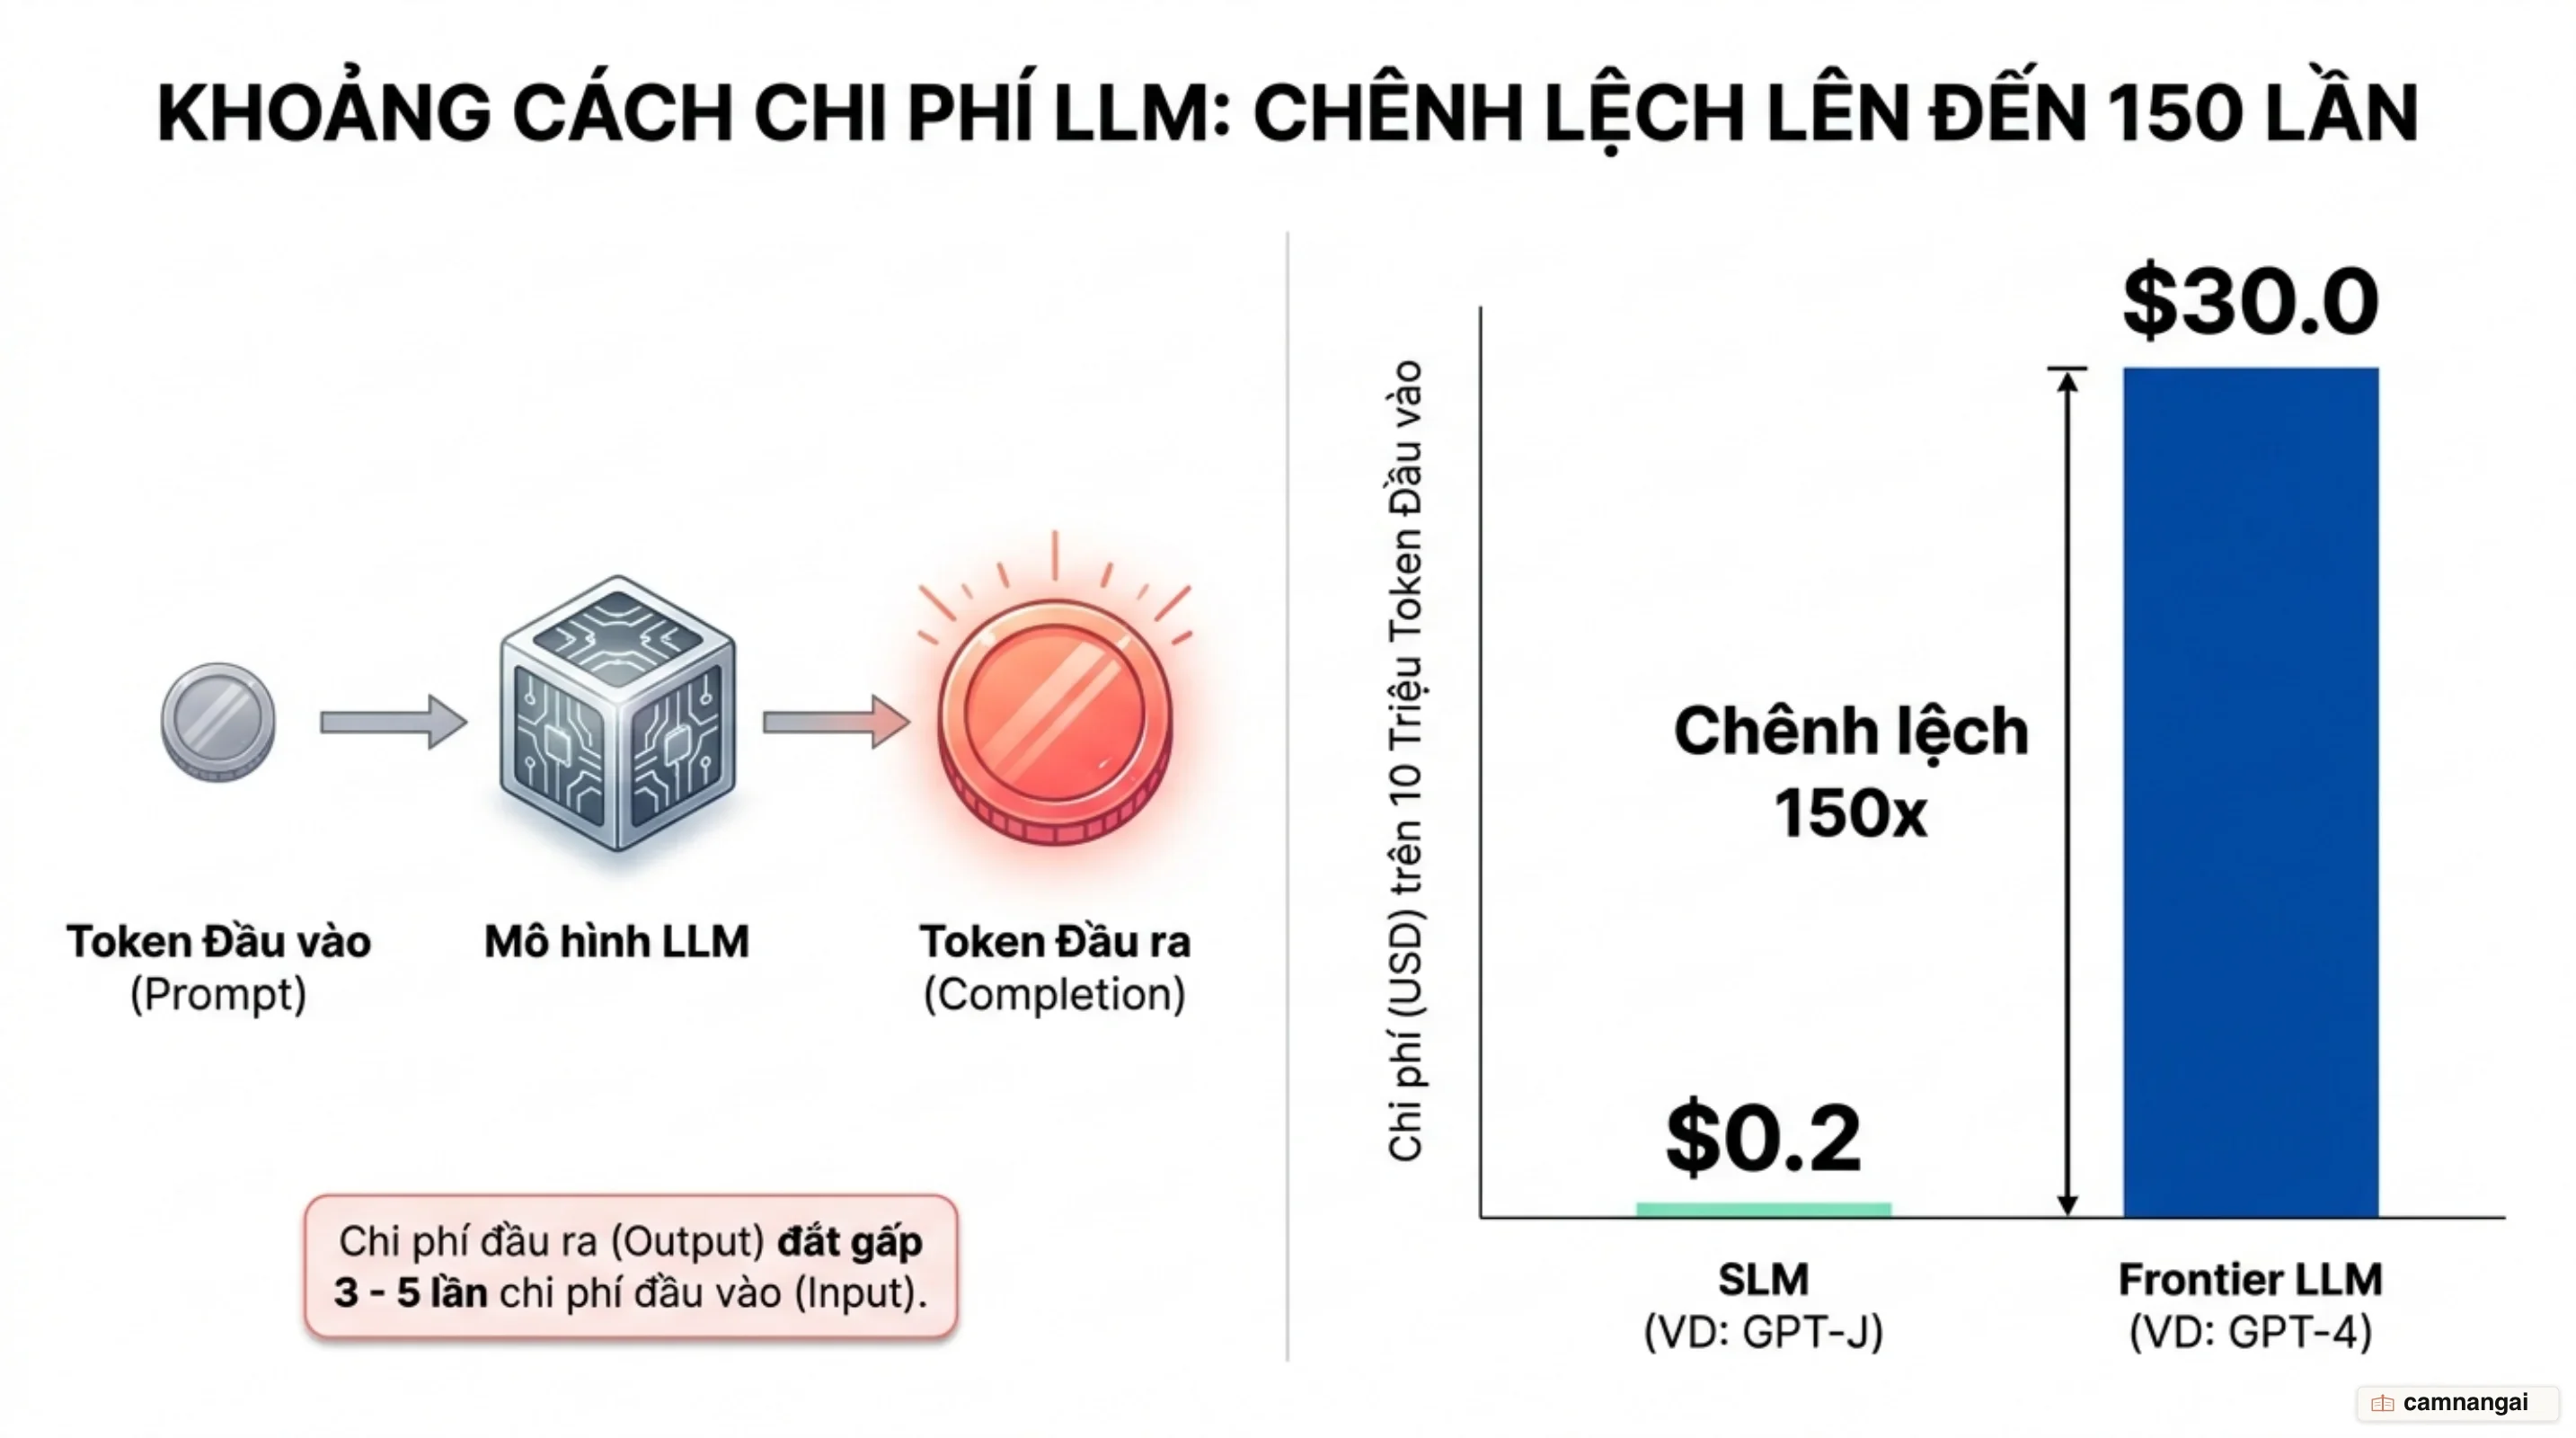
c_i(p) = c_{i,2} * |f_i(p)| + c_{i,1} * |p| + c_{i,0}Trong đó |p| là độ dài prompt đầu vào, |f_i(p)| là độ dài chuỗi kết quả sinh ra, c_{i,1} và c_{i,2} lần lượt là đơn giá trên từng token đầu vào và đầu ra, còn c_{i,0} đại diện cho chi phí cố định trên mỗi request. Đơn giá token đầu ra (c_{i,2}) luôn đắt gấp 2 đến 3 lần token đầu vào (c_{i,1}). Ví dụ, OpenAI áp giá GPT-4 ở mức 0,03 USD/1k token input nhưng tính tới 0,06 USD/1k token output.
Sự gãy đổ tài chính xảy ra khi hệ thống phân bổ tài nguyên không hợp lý: sử dụng các mô hình biên cực lớn (GPT-4, Claude Opus) cho các tác vụ mang tính định hình cơ bản như phân loại email, trích xuất thực thể hoặc đọc hiểu đoạn văn ngắn. Xét trên mặt bằng giá thị trường, 10 triệu token input của GPT-J (trên Textsynth) chỉ tốn 0,2 USD, nhưng con số này vọt lên 30 USD nếu gửi đến GPT-4 của OpenAI — gấp 150 lần cho cùng một lượng đầu vào.
Theo phân tích hạ tầng từ PostHog, khi năng lực xử lý giữa các mô hình dần tiệm cận ở các tác vụ thông thường, việc chi trả chi phí LLM tăng theo cấp số nhân sẽ làm thủng biên lợi nhuận của sản phẩm SaaS. Nếu thiếu hạ tầng quan sát AI (AI Observability) để định lượng chi phí chi tiết trên từng phiên làm việc và từng người dùng, doanh nghiệp sẽ mất kiểm soát dòng tiền khi hệ thống mở rộng.
Ngoài ra, thói quen lạm dụng kỹ thuật few-shot prompting tĩnh gây lãng phí ngân sách lớn. Việc đính kèm cố định hàng chục ví dụ mẫu (in-context examples) vào mọi request khiến hệ thống liên tục lặp lại các thao tác xử lý dữ liệu đầu vào không cần thiết, nhân bản chi phí xử lý prompt lên hàng triệu lần trên môi trường production.
Cắt giảm token thừa: Context dieting và kiểm soát output
Chi phí xử lý tỷ lệ thuận với độ dài prompt. Kỹ thuật đầu tiên bạn cần triển khai là chọn lọc ví dụ vài-shot dựa trên độ tương đồng ngữ nghĩa (Semantic Selection) thay vì gửi toàn bộ tập dữ liệu mẫu. Một prompt đính kèm 20 ví dụ cố định tiêu tốn khoảng 623 token/request (tương đương 0,1 cent/request trên gpt-3.5-turbo).
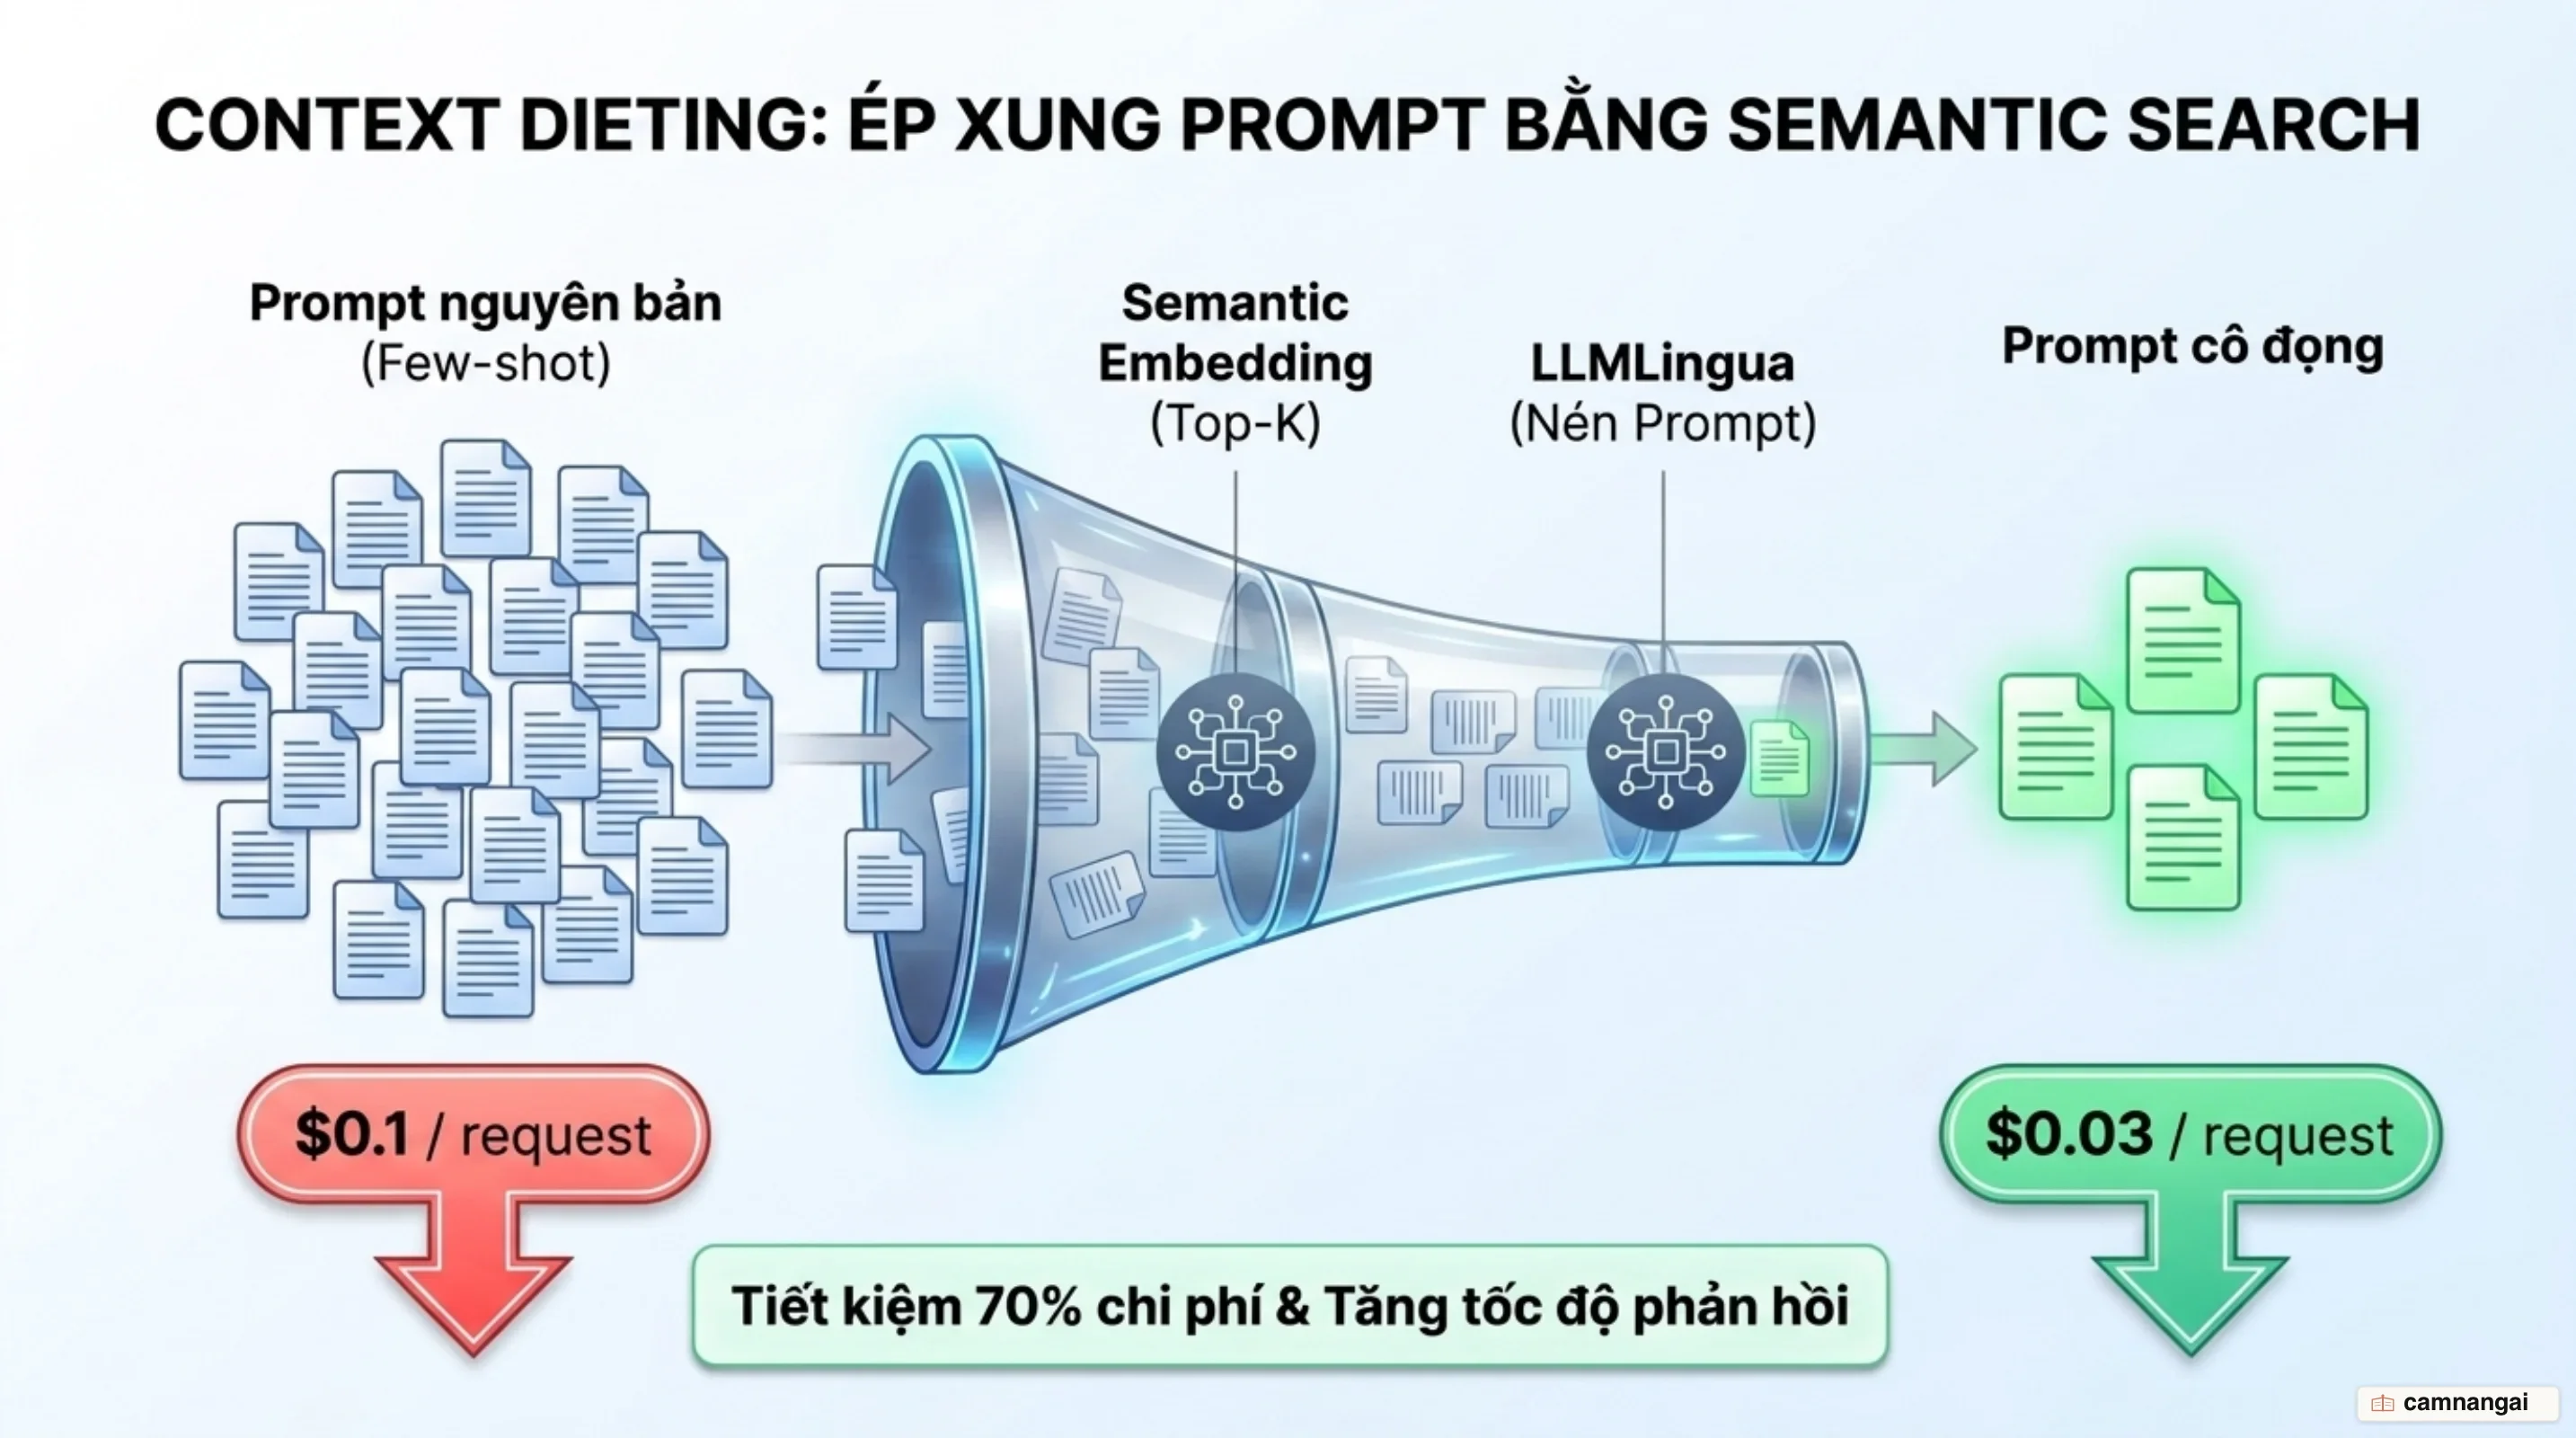
Bằng cách sử dụng một mô hình kích thước nhỏ (như all-MiniLM-L6-v2), bạn có thể tính toán độ tương đồng cosine giữa truy vấn đầu vào và cơ sở dữ liệu ví dụ mẫu. Hệ thống chỉ trích xuất Top-K (ví dụ k=5) ví dụ có ngữ cảnh gần nhất để đưa vào prompt. Kỹ thuật này giúp cắt giảm 70% lượng token đầu vào, đưa chi phí prompt xuống còn 0,03 cent/request mà vẫn giữ nguyên độ chính xác.
import numpy as np
from sklearn.metrics.pairwise import cosine_similarity
from transformers import AutoTokenizer, AutoModel
import torch

tokenizer = AutoTokenizer.from_pretrained('sentence-transformers/all-MiniLM-L6-v2')
model = AutoModel.from_pretrained('sentence-transformers/all-MiniLM-L6-v2')

def get_embeddings(texts):
    encoded_input = tokenizer(texts, padding=True, truncation=True, return_tensors='pt')
    with torch.no_grad():
        model_output = model(**encoded_input)
    return model_output.last_hidden_state[:, 0, :].numpy()

# Lưu ý hạ tầng: Trong môi trường production, tập `example_embeddings` của cơ sở dữ liệu ví dụ
# bắt buộc phải được tính toán trước (pre-computed) offline và lưu ở vector store hoặc RAM
# để tránh phát sinh độ trễ mã hóa O(N) khi xử lý request thời gian thực.
def select_best_examples(query, examples, example_embeddings, k=5):
    query_emb = get_embeddings([query])[0]
    similarities = cosine_similarity([query_emb], example_embeddings)[0]
    top_k_indices = np.argsort(similarities)[-k:]
    return [examples[i] for i in top_k_indices]
Kỹ thuật thứ hai là Gom cụm truy vấn (Query Concatenation). Thay vì phát nhiều request đơn lẻ chứa cùng một đoạn văn bản hướng dẫn (instruction), bạn cấu hình prompt để LLM xử lý đồng thời 2 đến 3 truy vấn trong một lần gọi API. Phương pháp gom nhóm này loại bỏ phần prompt tĩnh bị lặp lại, giảm 50% chi phí xử lý trung bình trên từng request.
Song song đó, bạn nên áp dụng công nghệ nén prompt không phụ thuộc tác vụ với LLMLingua. LLMLingua sử dụng mô hình nhỏ (như LLaMA-7B) để đánh giá thông lượng thông tin (entropy) của từng token trong prompt, sau đó tự động loại bỏ các token có entropy thấp. Trên các tập dữ liệu như MeetingBank hay GSM8K, LLMLingua đạt tỷ lệ nén từ 2,5x đến 5x mà không làm suy giảm chất lượng câu trả lời của mô hình mục tiêu.
Cuối cùng, hãy kiểm soát chặt chẽ độ dài output. Do đơn giá sinh token đầu ra luôn cao gấp đôi token đầu vào, bạn phải thiết lập tham số max_tokens chính xác và ràng buộc cấu trúc phản hồi ở dạng JSON tối giản hoặc từ khóa ngắn gọn, triệt tiêu hoàn toàn các câu từ dư thừa do LLM tự sinh.
Tận dụng bộ nhớ đệm: Prompt caching và Semantic caching
Triển khai bộ nhớ đệm là phương án nhanh nhất để cắt giảm chi phí và độ trễ. Cơ chế đơn giản nhất là Exact Match Cache dựa trên mã hash của prompt. Dữ liệu thực tế từ Portkey ghi nhận Exact Match Cache đạt tỷ lệ trúng đệm (cache hit rate) trung bình 8%, giúp giảm 99% chi phí và 95% độ trễ cho các truy vấn trùng lập hoàn toàn.
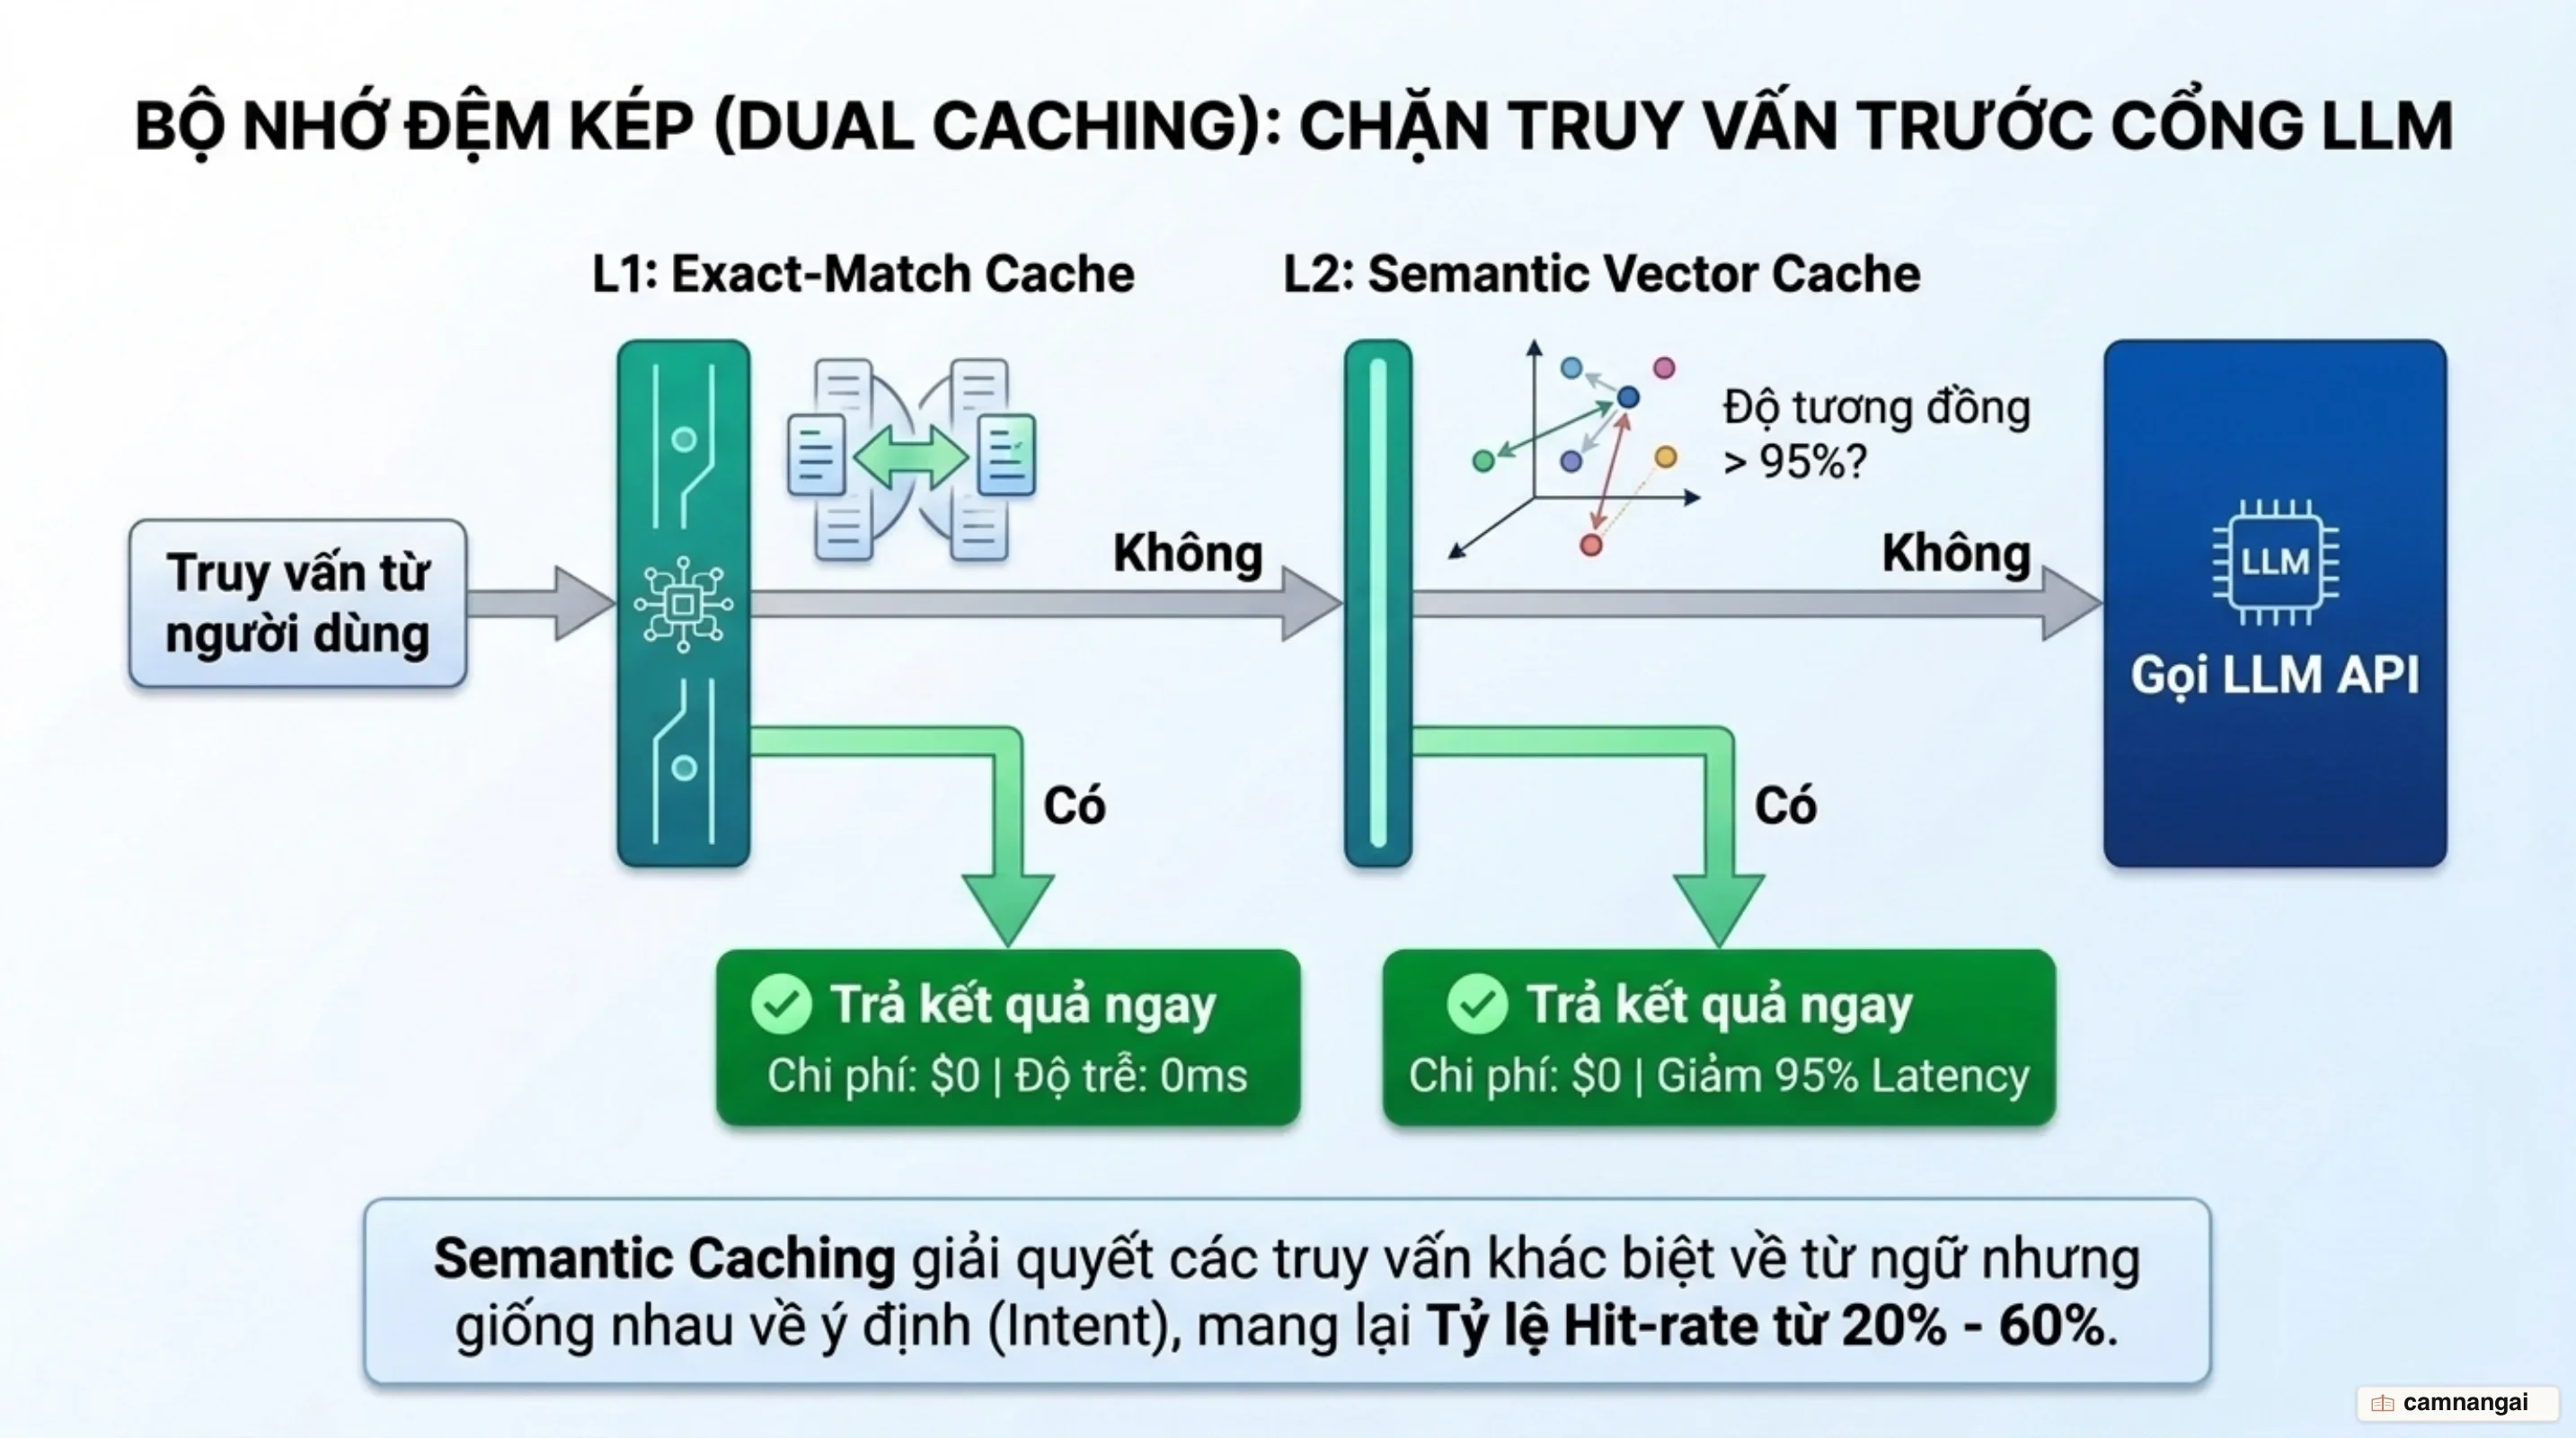
Để tối ưu hơn, bạn cần nâng cấp lên Bộ nhớ đệm ngữ nghĩa (Semantic Caching). Thay vì so khớp chuỗi ký tự, Semantic Cache chuyển đổi prompt mới thành vector embedding và tìm kiếm trong cơ sở dữ liệu vector các prompt đã lưu có độ tương đồng vượt ngưỡng thiết lập (ví dụ 0,95). Tỷ lệ trúng đệm của Semantic Cache đạt trung bình 21%, và trong nhiều hệ thống sản xuất có thể đạt tới 60%, đem lại mức cắt giảm 95% chi phí và độ trễ trên các request trùng ngữ nghĩa.
{
  "cache": {
    "mode": "semantic",
    "max-age": 3600,
    "force-refresh": false
  }
}
Tuy nhiên, việc vận hành Semantic Cache trong môi trường production đòi hỏi bạn xử lý 3 cạm bẫy kỹ thuật:
- Rò rỉ dữ liệu (Data Leakage): Người dùng có thể cố tình nhập prompt giống người khác để truy xuất câu trả lời lưu trong đệm có chứa thông tin nhạy cảm. Giải pháp: Phân vùng bộ nhớ đệm (partitioning) bằng cách đính kèm mã định danh
metadata(User ID, Org ID, Session ID) vào khóa cache. - Ngưỡng tương đồng sai lệch: Đặt ngưỡng similarity quá thấp sẽ trả về kết quả sai ngữ cảnh. Bạn bắt buộc phải chạy backtest trên tối thiểu 5.000 request thực tế để tìm ra ngưỡng tối ưu đảm bảo độ chính xác >99%.
- Lưu trữ kết quả lỗi (Poisoned Cache): LLM có thể trả về câu trả lời sai ngẫu nhiên và bị Semantic Cache lưu lại. Giải pháp: Xây dựng luồng nhận phản hồi tiêu cực từ người dùng (thumbs down) để gửi lệnh
force-refreshxóa bộ nhớ đệm hỏng ngay lập tức.
Ngoài ra, bạn nên tận dụng tính năng từ các nhà cung cấp API như Anthropic hay OpenAI. Với cơ chế ephemeral cache (thời gian sống 5 phút hoặc 1 giờ), bạn có thể chồng nếp giảm giá (stacking discount) khi kết hợp Prompt Caching của nhà cung cấp với các kỹ thuật tối ưu hóa khác.
Định tuyến thông minh: Mô hình phân tầng (LLM Cascades) theo FrugalGPT
Kiến trúc FrugalGPT Cascade do nhóm nghiên cứu Stanford (Lingjiao Chen, Matei Zaharia, James Zou) đề xuất là chiến lược định tuyến truy vấn qua một chuỗi các mô hình có chi phí và năng lực tăng dần (ví dụ: GPT-J -> J1-Large -> GPT-4). Nếu mô hình rẻ hơn ở đầu chuỗi đưa ra phản hồi đạt độ tin cậy, hệ thống sẽ ngắt chuỗi và trả về kết quả ngay lập tức, tránh việc gọi đến mô hình đắt tiền phía sau.
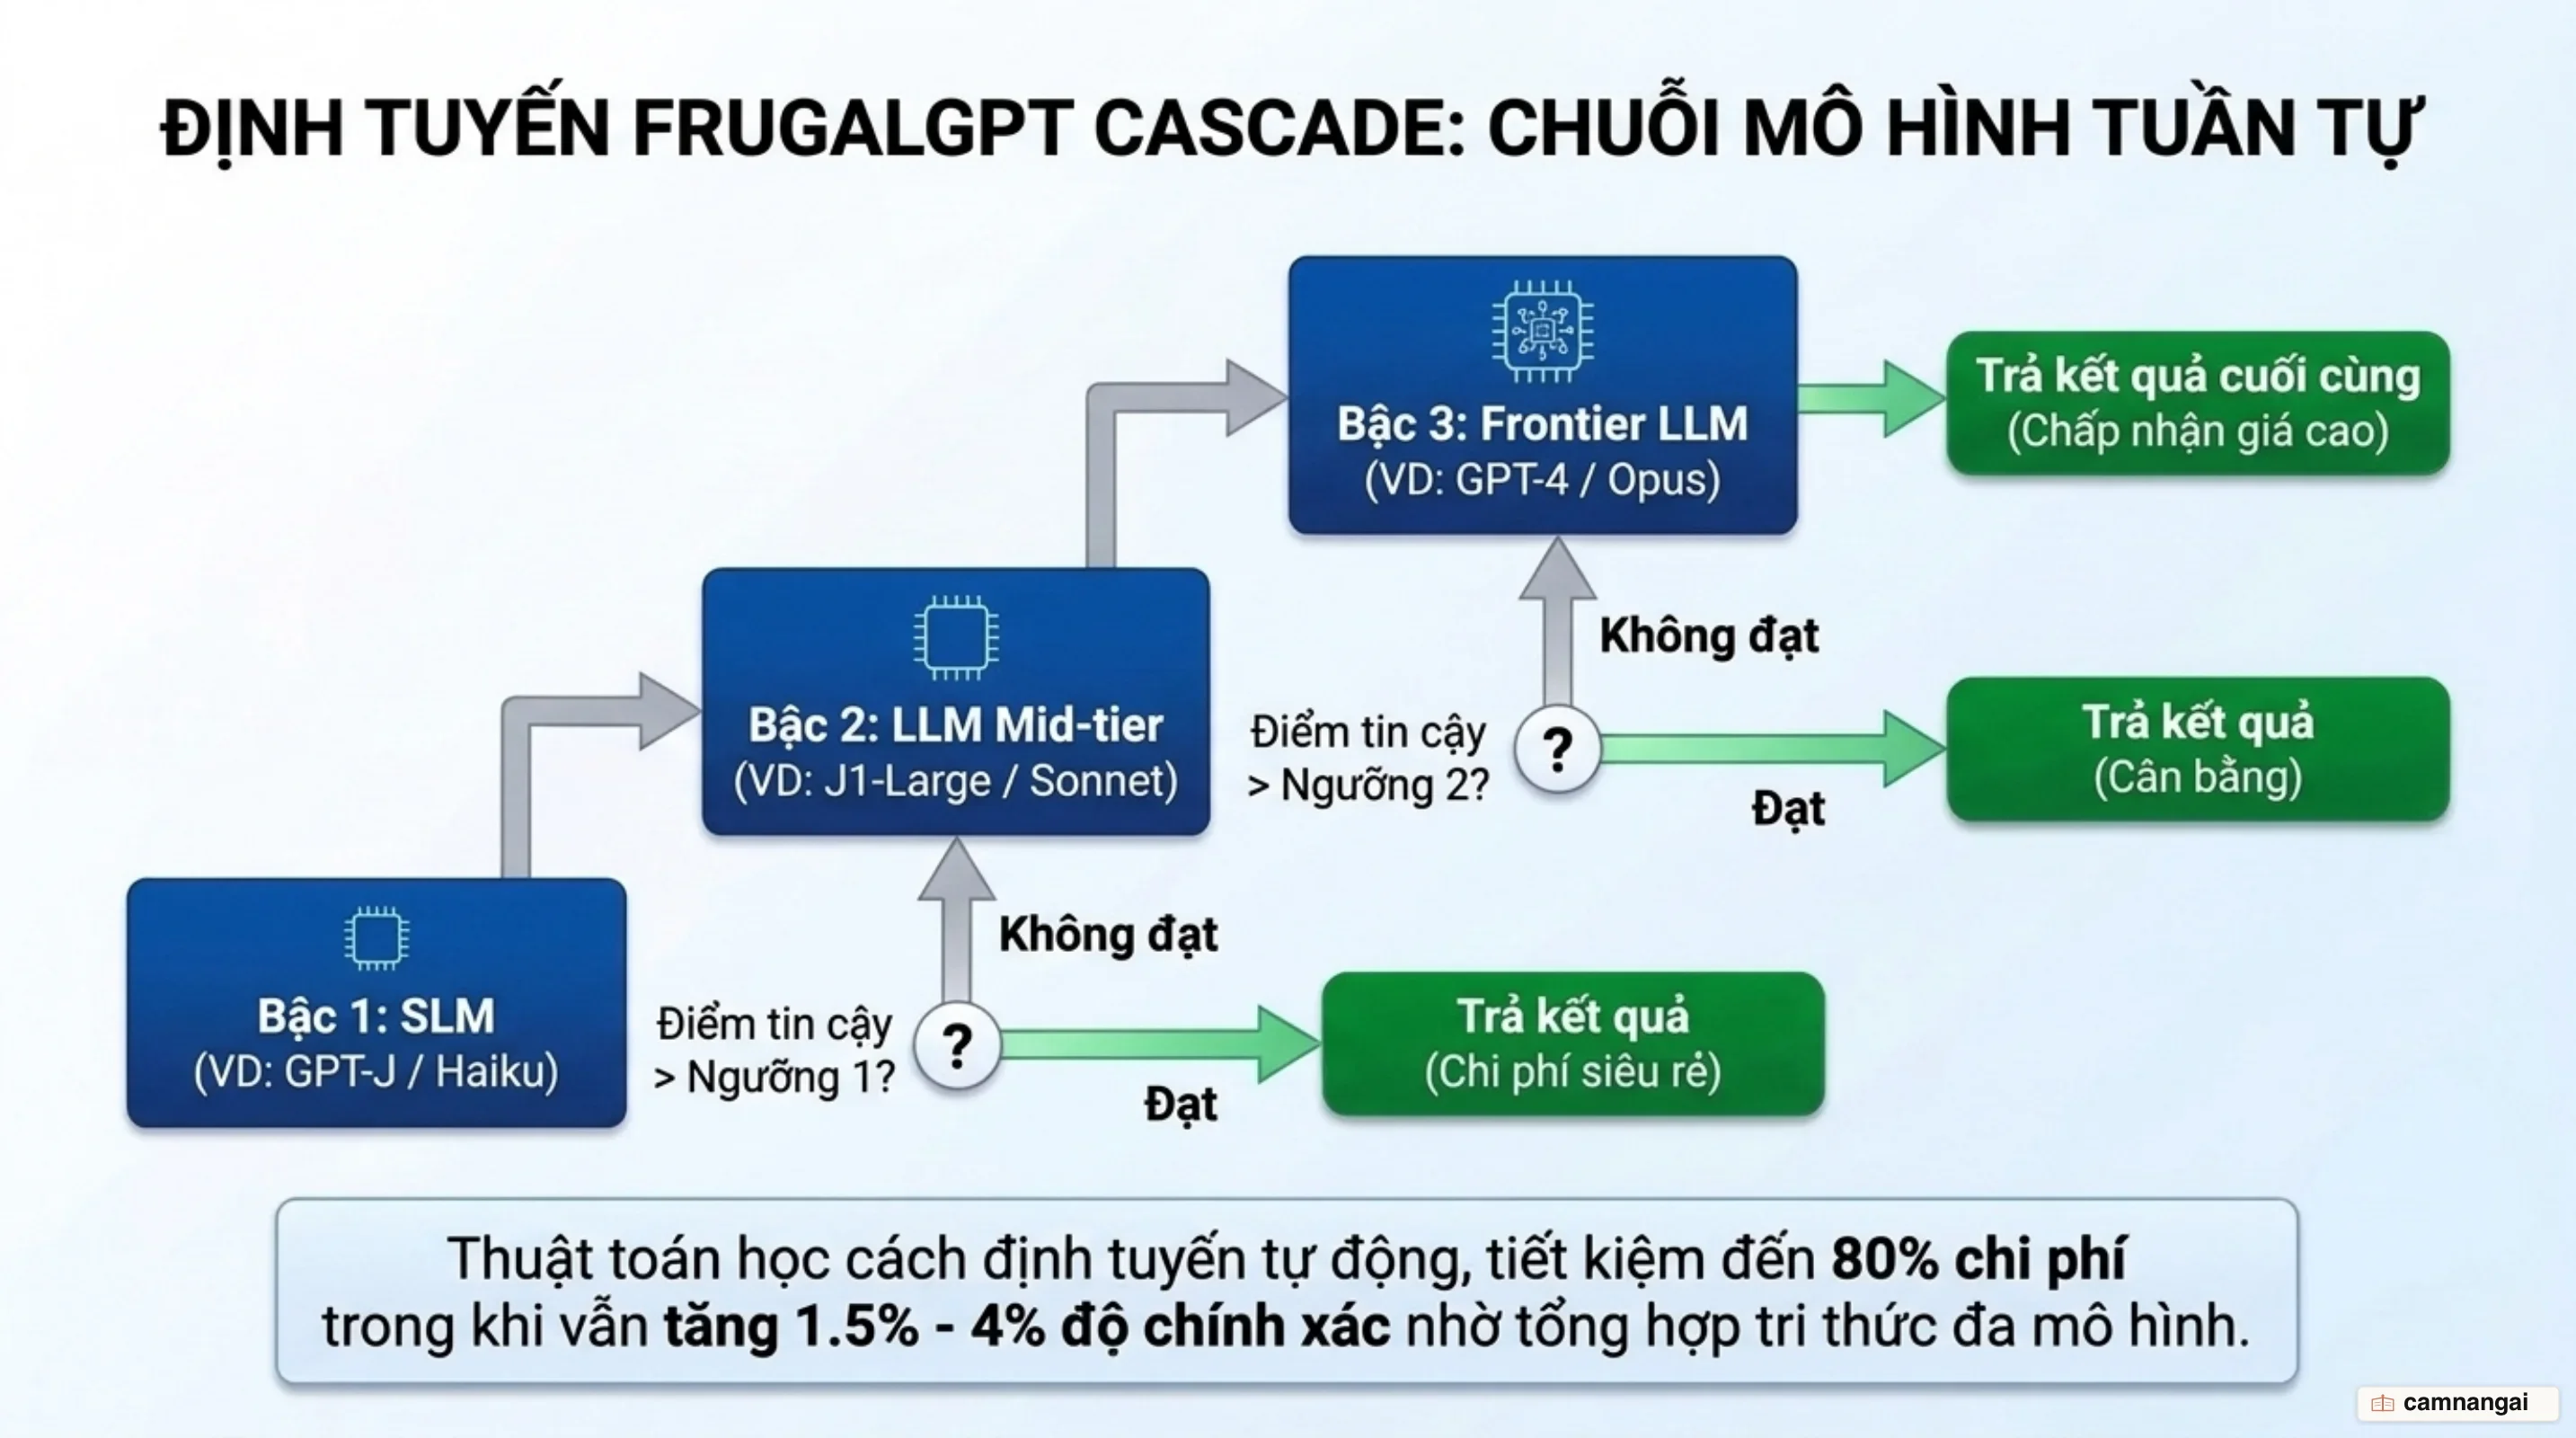
Kiến trúc FrugalGPT dựa trên 2 thành phần chính:
- Hàm đánh giá điểm (Generation Scoring Function
g(q, a)): Sử dụng một mô hình phân loại nhỏ (như DistilBERT fine-tuned) để chấm điểm độ tin cậy của câu trả lờiacho truy vấnq, trả về giá trị điểm số trong khoảng[0, 1]. - Bộ định tuyến LLM (LLM Router): Xác định danh sách gồm
mAPI được chọnL = [L_1, L_2, ..., L_m]và các ngưỡng tin cậy tương ứngtau = [tau_1, tau_2, ..., tau_m]thông qua bài toán tối ưu hóa có ràng buộc ngân sáchb:
max_{L, tau} E[r(a, f_{L_z}(q))]   s.t.   E[sum_{i=1}^z c_{L_i}(q)] <= b
với: z = argmin_i (g(q, f_{L_i}(q)) >= tau_i)
Trong công thức trên, véc-tơ L đại diện cho thứ tự ưu tiên của danh sách m mô hình được chọn từ tập K API khả dụng, véc-tơ tau_i thiết lập ngưỡng tin cậy bắt buộc tại tầng thứ i trong chuỗi, và chỉ số z xác định mô hình đầu tiên dừng lại khi tạo ra câu trả lời có điểm g(q, f_{L_i}(q)) vượt qua ngưỡng tau_i.
Kết quả thực nghiệm từ báo cáo của Đại học Stanford chứng minh FrugalGPT giúp giảm tới 98,3% chi phí trên tập dữ liệu HEADLINES (giảm từ 33,1 USD xuống 0,6 USD mà vẫn giữ nguyên độ chính xác của GPT-4), giảm 73,3% chi phí trên tập OVERRULING và 59,2% trên tập COQA. Đặc biệt, trên một số tác vụ, FrugalGPT còn làm tăng từ 1% đến 4% độ chính xác so với việc chỉ dùng duy nhất GPT-4 nhờ tận dụng sự đa dạng trong phản hồi của các mô hình (Maximum Performance Improvement - MPI).
from transformers import pipeline

scorer = pipeline("text-classification", model="distilbert-base-uncased-finetuned-sst-2-english")

def generation_score(query, generated_text):
    input_text = f"Query: {query} \nGenerated:\n {generated_text}"
    return scorer(input_text)[0]['score']

def execute_cascade(query, llm_sequence, thresholds):
    for llm_fn, threshold in zip(llm_sequence, thresholds):
        response = llm_fn(query)
        score = generation_score(query, response)
        if score >= threshold:
            return response
    return response
Xử lý bất đồng bộ: Giảm 50% hóa đơn với Batch API
Đối với các công việc không yêu cầu phản hồi thời gian thực (real-time), chuyển sang cơ chế Batch API là phương án cắt giảm chi phí trực tiếp nhất. Bằng cách gom nhóm các request vào tập tin dạng .jsonl và gửi xử lý bất đồng bộ trong cửa sổ hoàn thành 24 giờ, cả OpenAI và Anthropic đều áp dụng mức giảm giá trực tiếp 50% cho toàn bộ chi phí token (Input, Output và Cache) trên tất cả các dòng mô hình (từ GPT-4o, GPT-6 đến Claude Opus, Sonnet, Haiku).
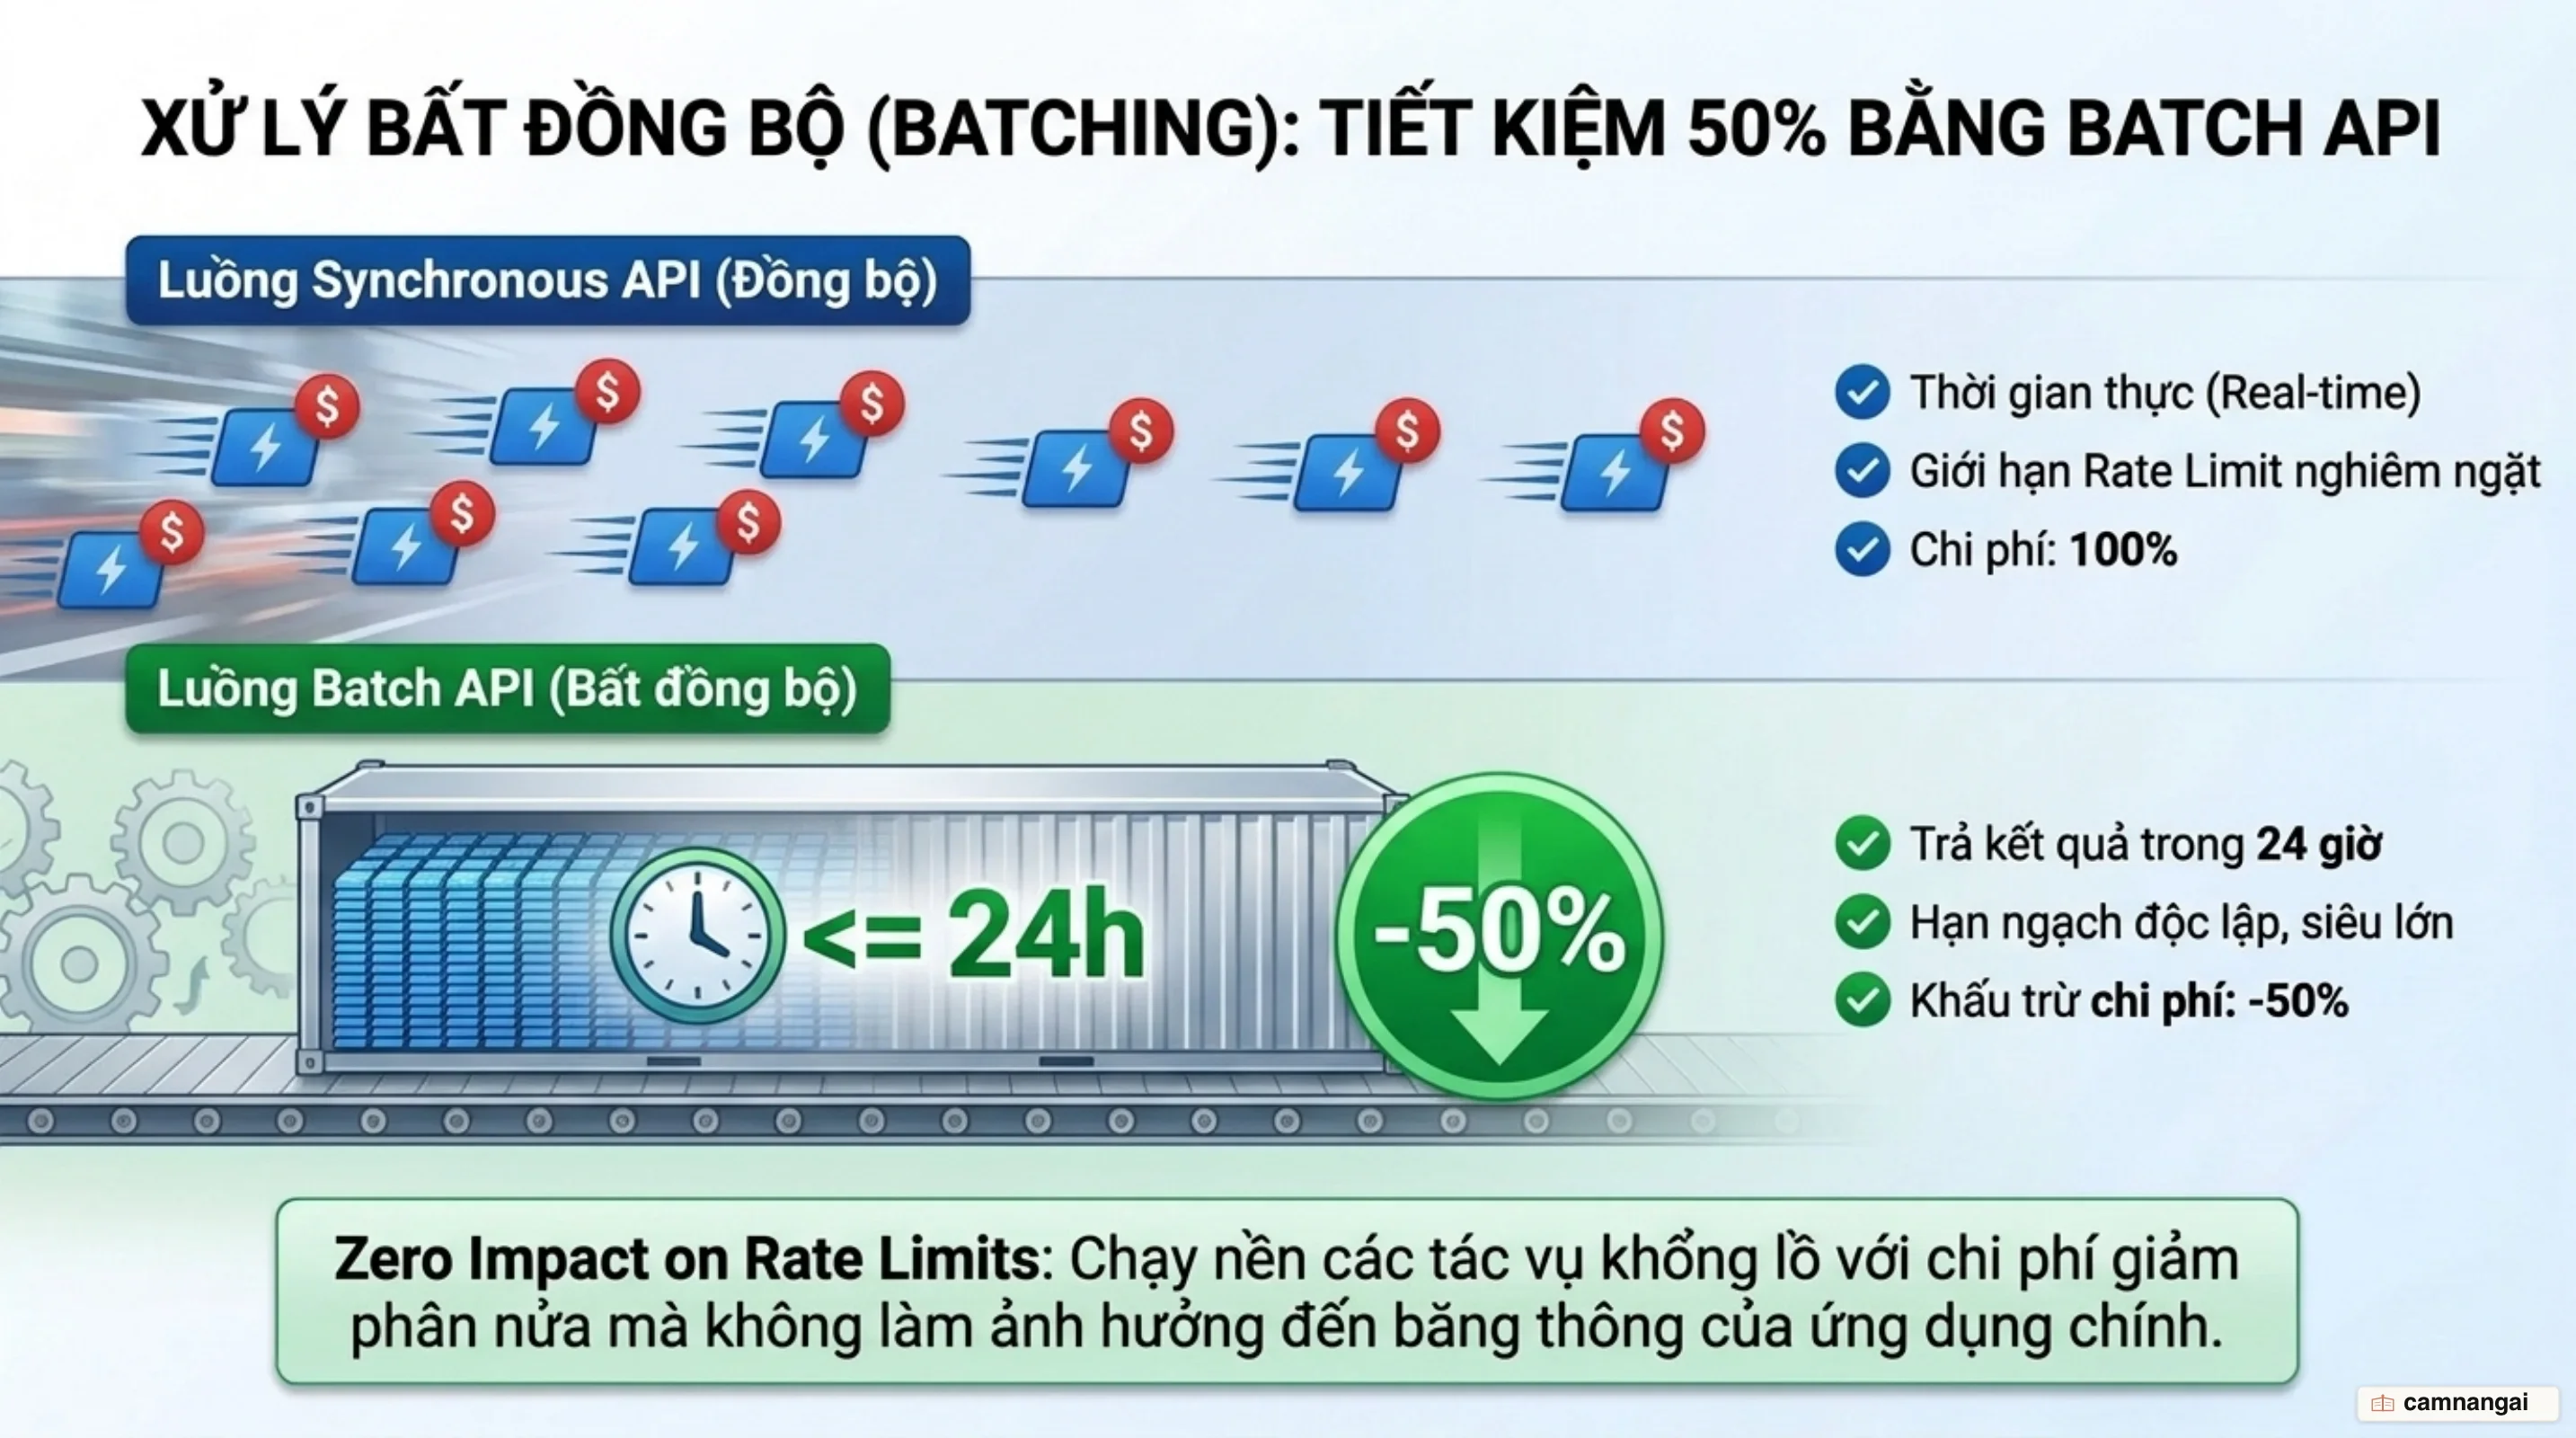
Batch API cung cấp một hạn ngạch Rate Limit hoàn toàn riêng biệt. Việc đẩy dữ liệu khối lượng lớn qua Batch API sẽ không làm tiêu tốn tài nguyên hạn ngạch API thời gian thực của hệ thống.
Về mặt thông số kỹ thuật:
- OpenAI Batch API: Cho phép tối đa 50.000 request hoặc 200 MB cho mỗi file tải lên cổng
/v1/files(vớipurpose="batch"). Hỗ trợ các endpoint bao gồm/v1/responses,/v1/chat/completions,/v1/embeddings, và/v1/moderations. - Anthropic Message Batches API: Hỗ trợ tối đa 100.000 request hoặc 256 MB cho mỗi batch qua endpoint
/v1/messages/batches. Kết quả được lưu trữ để tải về trong 29 ngày. Tích hợp đầy đủ các tính năng như Server Tools, Extended Output hỗ trợ sinh tới 300.000 token output (beta).
from anthropic import Anthropic
from anthropic.types.message_create_params import MessageCreateParamsNonStreaming
from anthropic.types.messages.batch_create_params import Request

client = Anthropic()

batch = client.messages.batches.create(
    requests=[
        Request(
            custom_id="req_idx_001",
            params=MessageCreateParamsNonStreaming(
                model="claude-sonnet-5-5",
                max_tokens=1024,
                messages=[{"role": "user", "content": "Analyze document segment A"}]
            )
        )
    ]
)
print(f"Batch Enqueued ID: {batch.id}")
Đặc biệt, bạn có thể áp dụng chiến lược Chiết khấu chồng nếp (Stacked Discounting) bằng cách tích hợp tham số cache_control (Prompt Caching) vào trong các request của tệp Batch API (đặc biệt trên dòng mô hình Claude của Anthropic). Việc kết hợp 2 mức giảm giá giúp hạ chi phí xuống mức cực thấp khi xử lý dữ liệu lịch sử, chạy kiểm thử mô hình (Evals) hoặc phân loại dữ liệu quy mô lớn.
Chưng cất và tinh chỉnh: Thay thế mô hình khổng lồ bằng SLM chuyên biệt
Thay vì liên tục chi trả tiền thuê API cho các mô hình thương mại đắt đỏ, chiến lược lâu dài của hệ thống AI hiệu năng cao là thực hiện Chưng cất tri thức (Knowledge Distillation) để chuyển sang các mô hình ngôn ngữ nhỏ (SLM).
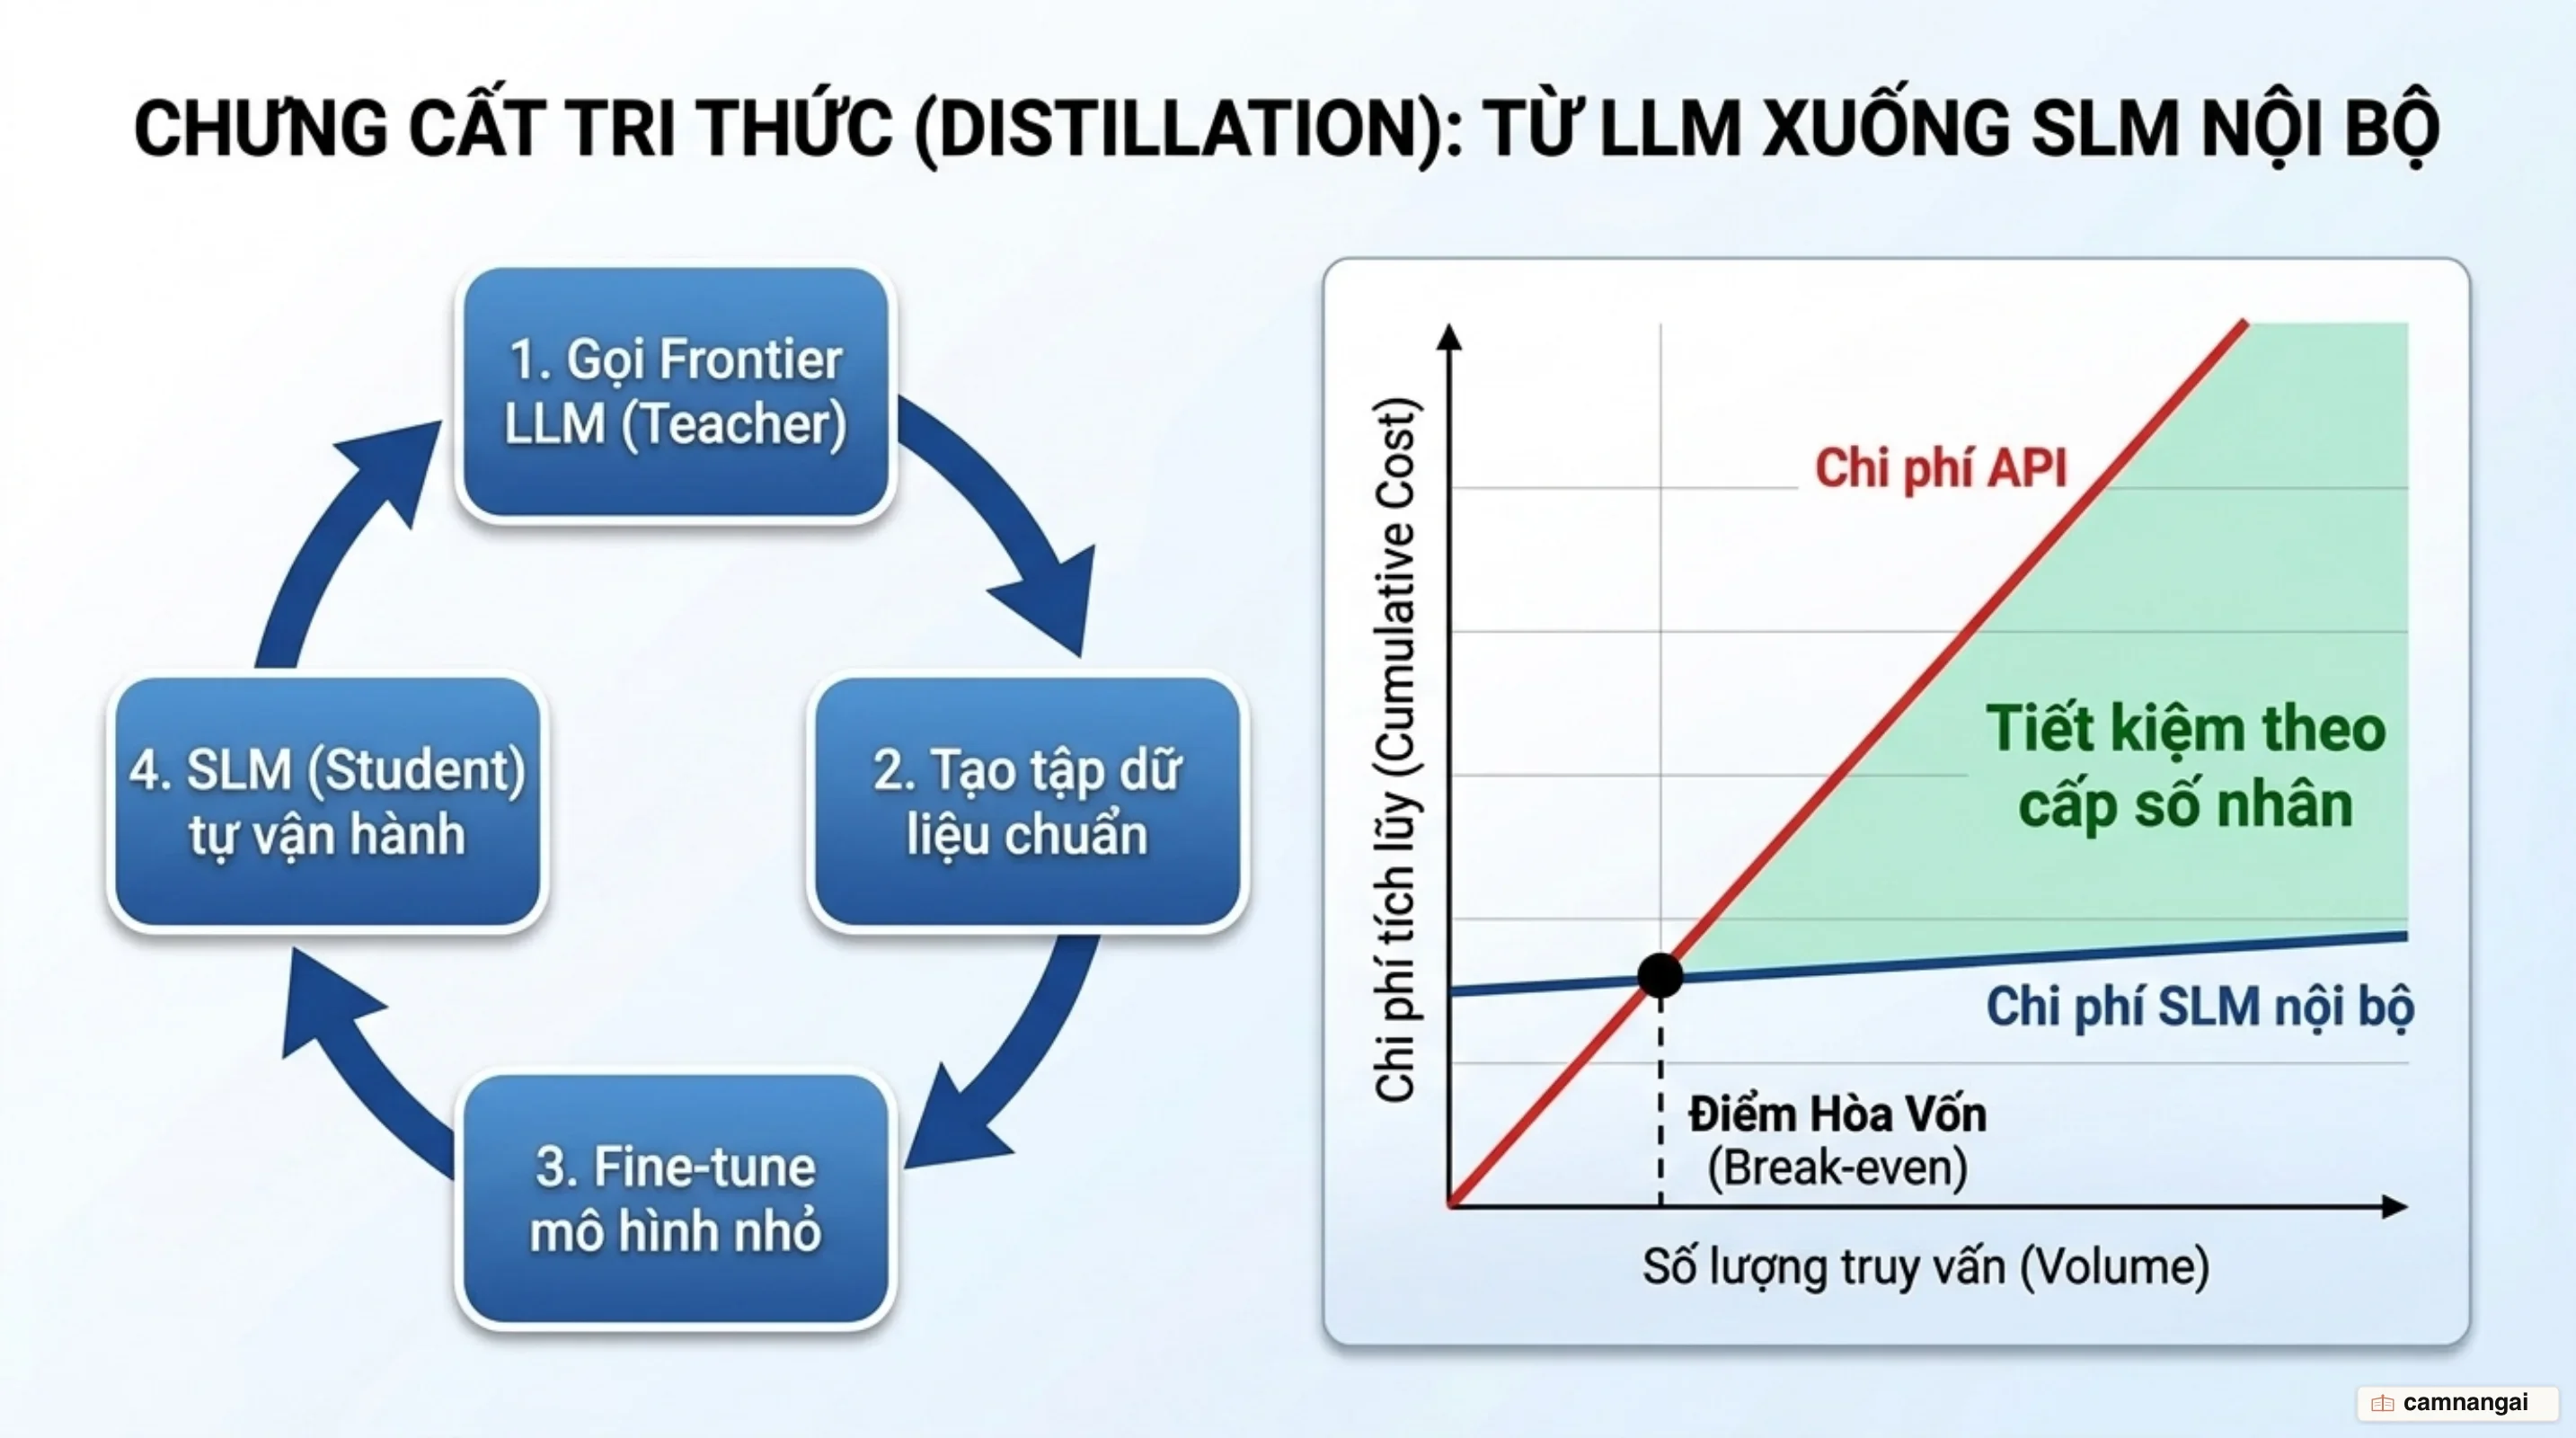
Quy trình bắt đầu bằng việc dùng các mô hình lớn (GPT-4, Claude Opus) xử lý các tác vụ thực tế ban đầu. Bạn tiến hành ghi log toàn bộ các phản hồi chất lượng cao để làm tập (training set).
Thực nghiệm từ Predibase và Portkey cho thấy: Khi tinh chỉnh () một mô hình nhỏ chuyên biệt (như LLaMA-3-8B, Mistral-7B, hoặc GPT-3.5-Turbo fine-tuned) cho duy nhất một tác vụ hẹp, mô hình nhỏ có thể đạt độ chính xác tương đương hoặc vượt trội GPT-4, nhưng giúp giảm tới 94% chi phí suy luận và cắt giảm mạnh độ trễ xử lý.
Để tối ưu hóa quy trình này, bạn nên thiết lập Vòng lặp tinh chỉnh tự động (Autonomous Fine-tuning):
- Tự động lọc log truy vấn: Chỉ chọn các request có mã phản hồi thành công (Status 200) và nhận được phản hồi tích cực từ người dùng (Weighted Feedback > 0).
- Định kỳ đưa dữ liệu chuẩn vào tập huấn luyện và khởi tạo các checkpoint mới cho mô hình SLM mà không cần thao tác thủ công.
Bên cạnh đó, áp dụng phương pháp chuyển đổi Prompt Zero-shot sang Few-shot cho SLM (theo nghiên cứu của Matt Shumer) đem lại hiệu quả chi phí vượt trội: Sử dụng mô hình lớn (Claude Opus) để phân tích và mở rộng một prompt zero-shot ngắn (281 token, tốn 3,2 cent trên Opus) thành một prompt few-shot chứa hướng dẫn chi tiết (1.600 token). Khi thực thi prompt few-shot này trên mô hình nhỏ (Claude Haiku), chi phí xử lý chỉ còn 0,05 cent/request — giảm 98,5% chi phí và tăng 78% tốc độ phản hồi.
Quản trị FinOps và Gateway: Giám sát đơn giá trên mỗi tác vụ thành công
Tối ưu chi phí hạ tầng đòi hỏi một lớp kiểm soát tập trung đứng trước các kết nối API. Triển khai AI Gateway (như Portkey hoặc PRISMA AIRS AI Gateway) giúp bạn thiết lập điểm quản trị dòng tiền thời gian thực trên toàn bộ hệ thống.
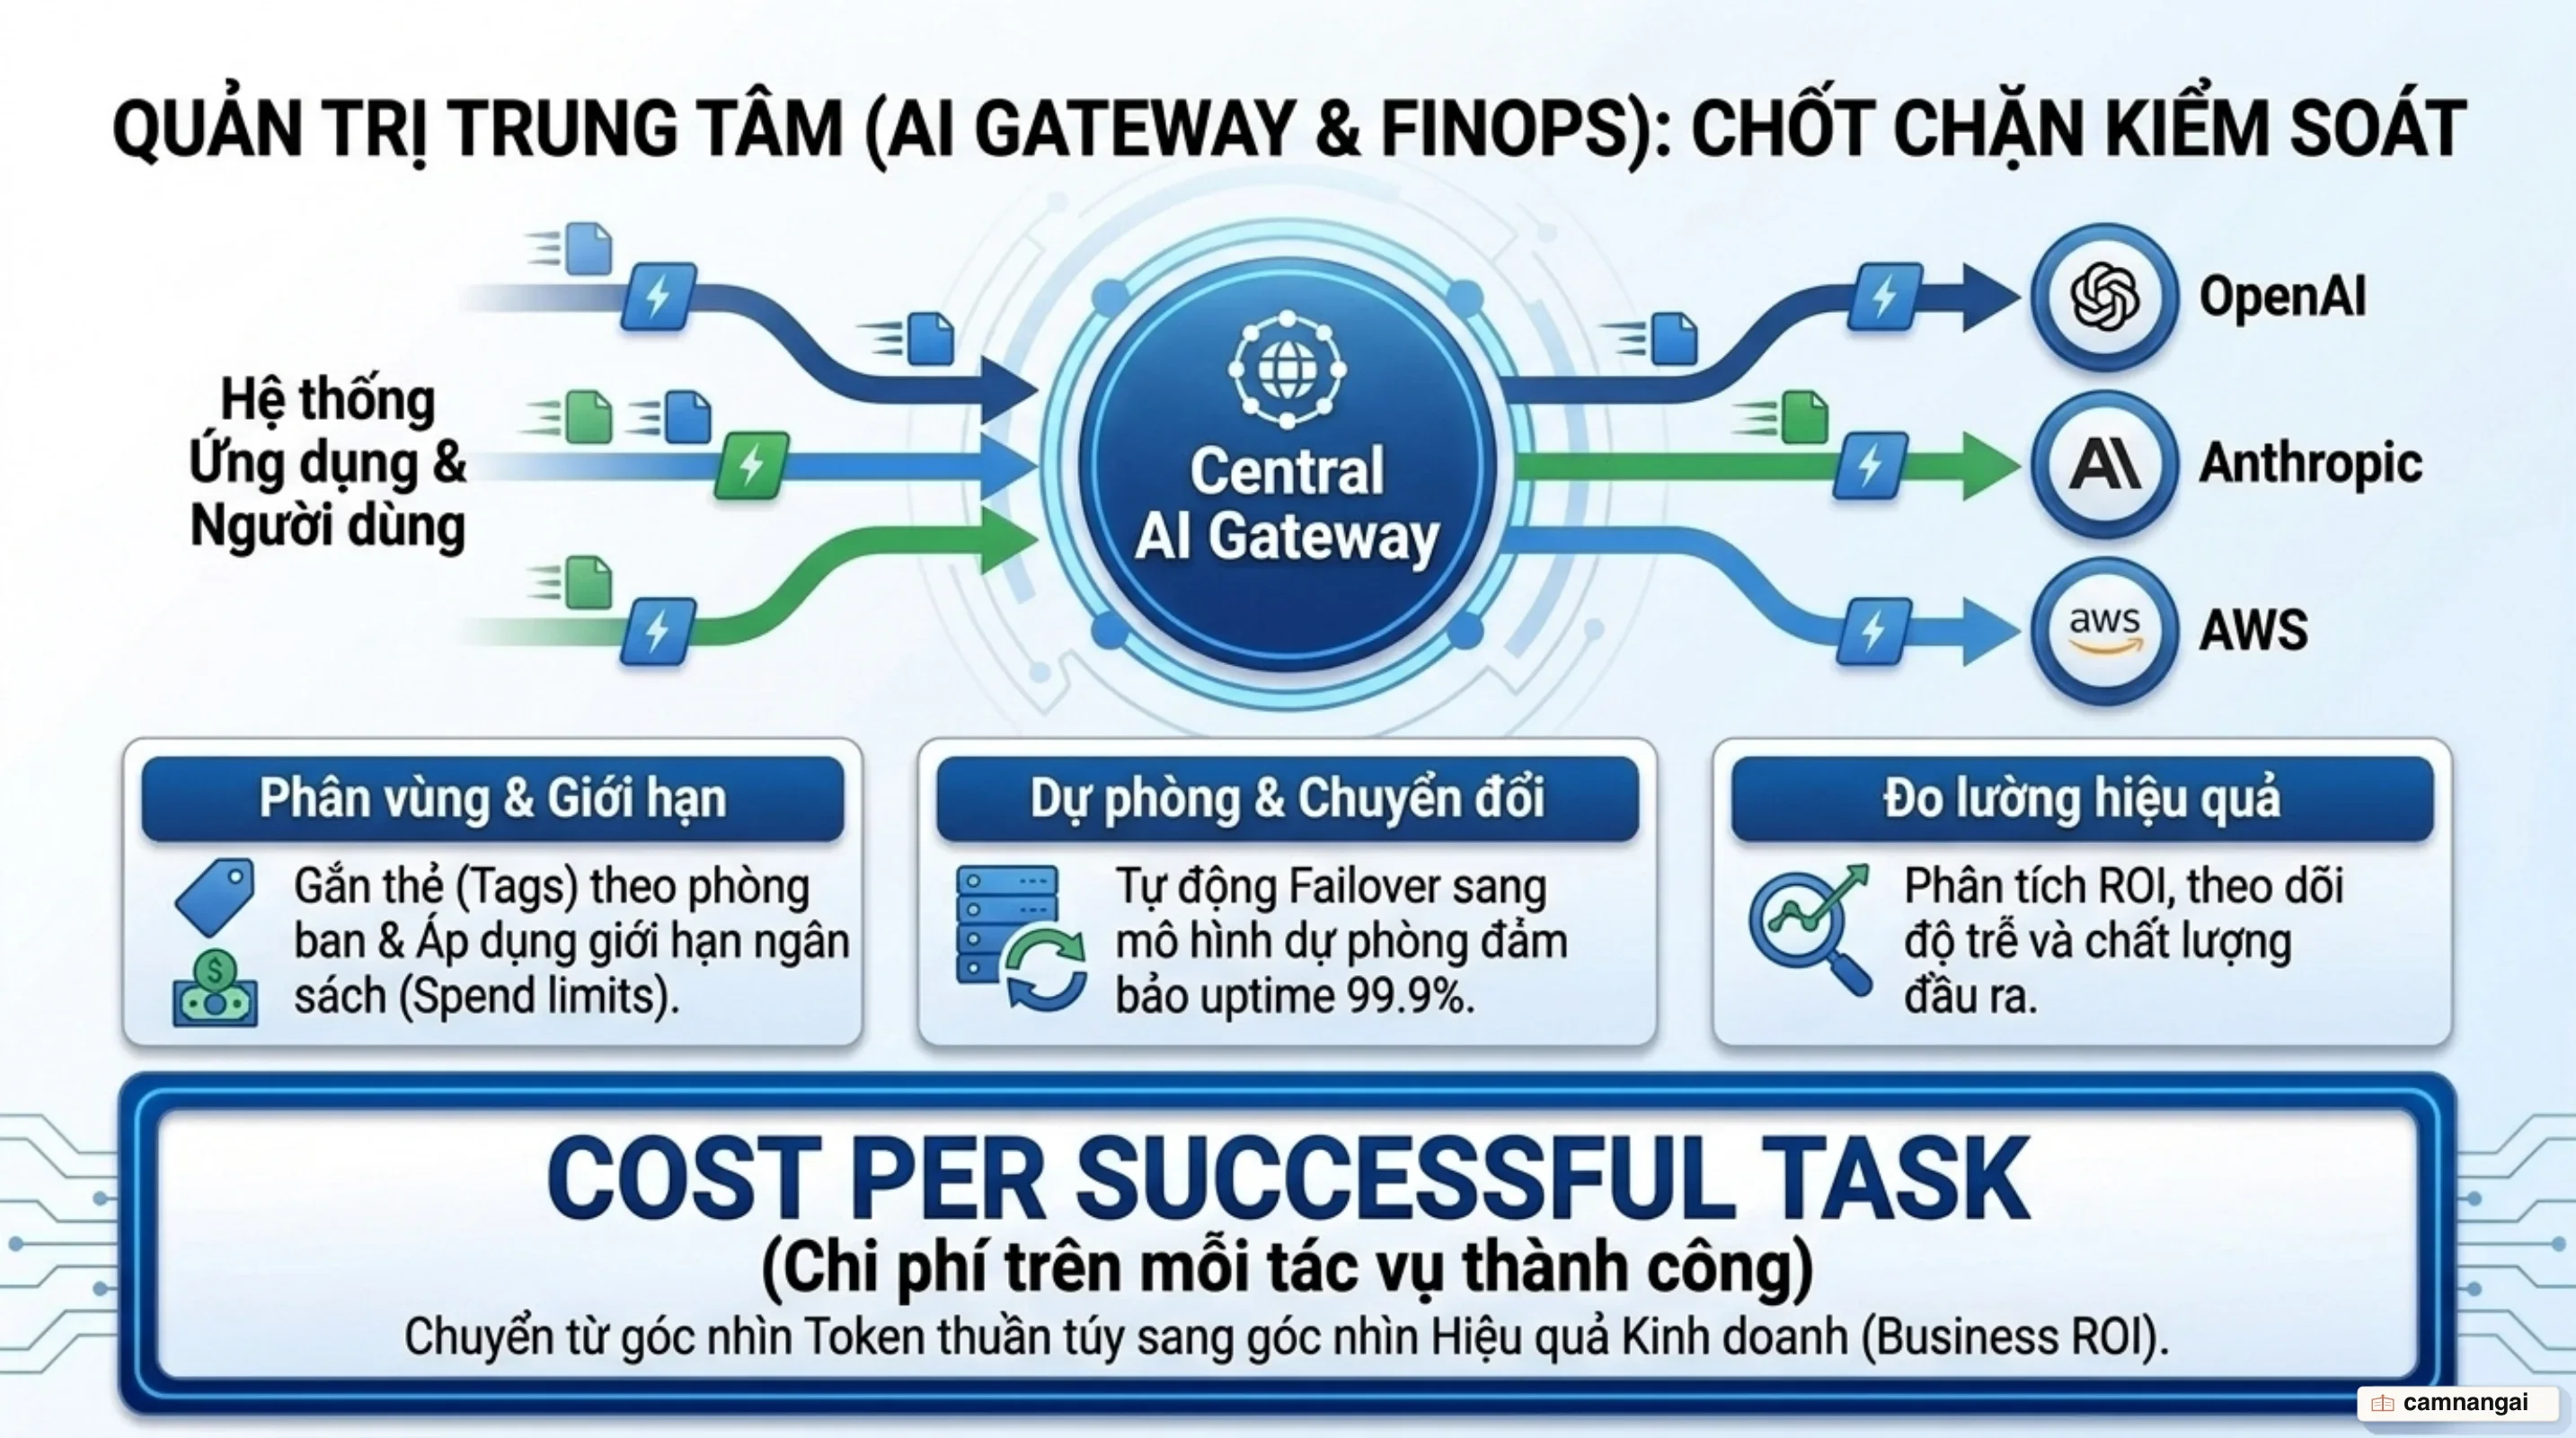
AI Gateway cho phép cấu hình chính sách hạn ngạch (rate limit), tự động chuyển vùng khi gặp lỗi (failover), và gom nhóm chi phí theo từng dự án, phòng ban hoặc khách hàng (multi-tenant).
Về mặt đo lường FinOps, bạn cần thay đổi chỉ số theo dõi: Chuyển từ việc giám sát tổng lượng token tiêu thụ sang chỉ số tài chính cốt lõi: Cost per Successful Task (Chi phí trên mỗi tác vụ thành công). Dữ liệu từ PostHog cho thấy các doanh nghiệp không phân rã chi phí LLM theo từng user/session sẽ rất dễ bị bùng nổ ngân sách trên báo cáo P&L khi hệ thống gặp lỗi lặp vô hạn (infinite loop) hoặc bị người dùng lạm dụng.
Hệ thống AI Gateway cần thực thi chính sách hạn ngạch tài chính cứng (Hard Spend Limits) ở cấp độ Workspace, phân quyền truy cập API key (RBAC), kết hợp tách biệt bộ nhớ đệm cache theo metadata để loại bỏ nguy cơ rò rỉ dữ liệu giữa các người dùng. Ngoài ra, tính năng Dynamic Load Balancing trên Gateway sẽ tự động định tuyến lại truy vấn sang các nhà cung cấp dự phòng có mức giá rẻ hơn khi nhà cung cấp chính quá tải hoặc vượt ngưỡng chi phí cho phép.
Bản đồ ưu tiên triển khai: Bắt đầu từ đâu mà không làm giảm chất lượng?
Để tối ưu hóa chi phí hệ thống AI hiệu quả mà không gây gián đoạn vận hành, bạn cần thực thi theo lộ trình 3 giai đoạn:
- Giai đoạn 1 (Tối ưu hóa ngay trong 24h - Không thay đổi kiến trúc): Triển khai Prompt Caching cho các phần dữ liệu đầu vào cố định. Chuyển toàn bộ các tác vụ xử lý ngầm, đánh giá mô hình () và phân loại dữ liệu lịch sử sang Batch API để giảm ngay 50% hóa đơn tài khoản.
- Giai đoạn 2 (Tối ưu hạ tầng Gateway & Prompt - 1 đến 2 tuần): Triển khai AI Gateway để thiết lập Bộ nhớ đệm ngữ nghĩa (Semantic Cache). Áp dụng kỹ thuật Prompt Dieting (lọc ví dụ vài-shot bằng embedding tương đồng) và cài đặt bộ giám sát chi phí trên từng người dùng/phiên làm việc (Cost per Successful Task).
- Giai đoạn 3 (Tối ưu hóa nâng cao - 1 tháng): Xây dựng hệ thống định tuyến phân tầng FrugalGPT Cascade để tự động phân tải truy vấn theo độ khó. Đồng thời thu thập log dữ liệu chuẩn để fine-tune các mô hình SLM nhỏ (LLaMA-3-8B, Mistral-7B), từng bước thay thế các mô hình biên đắt đỏ trên sản xuất.
Tài liệu tham khảo
- FrugalGPT: How to Use Large Language Models While Reducing Cost and Improving Performance
- Prompt caching - Claude Platform Docs
- Batch processing - Claude Platform Docs
- Prompt caching | OpenAI API
- Batch API | OpenAI API
- LLM cost optimization - Handbook - PostHog
- Implementing FrugalGPT: Reducing LLM Costs & Improving Performance - Portkey Blog
- Semantic Cache for Large Language Models - Portkey Blog
- Track, allocate, and manage your generative AI cost and usage with Amazon Bedrock - AWS Blog