Prompt Caching vs Semantic Caching là hai cơ chế caching cốt lõi nhằm giải quyết bài toán chi phí vận hành API và độ trễ phản hồi trong các hệ thống mô hình ngôn ngữ lớn (LLM): tái sử dụng trạng thái tính toán tiền tố tại inference engine so với tìm kiếm vector câu trả lời ở application gateway.
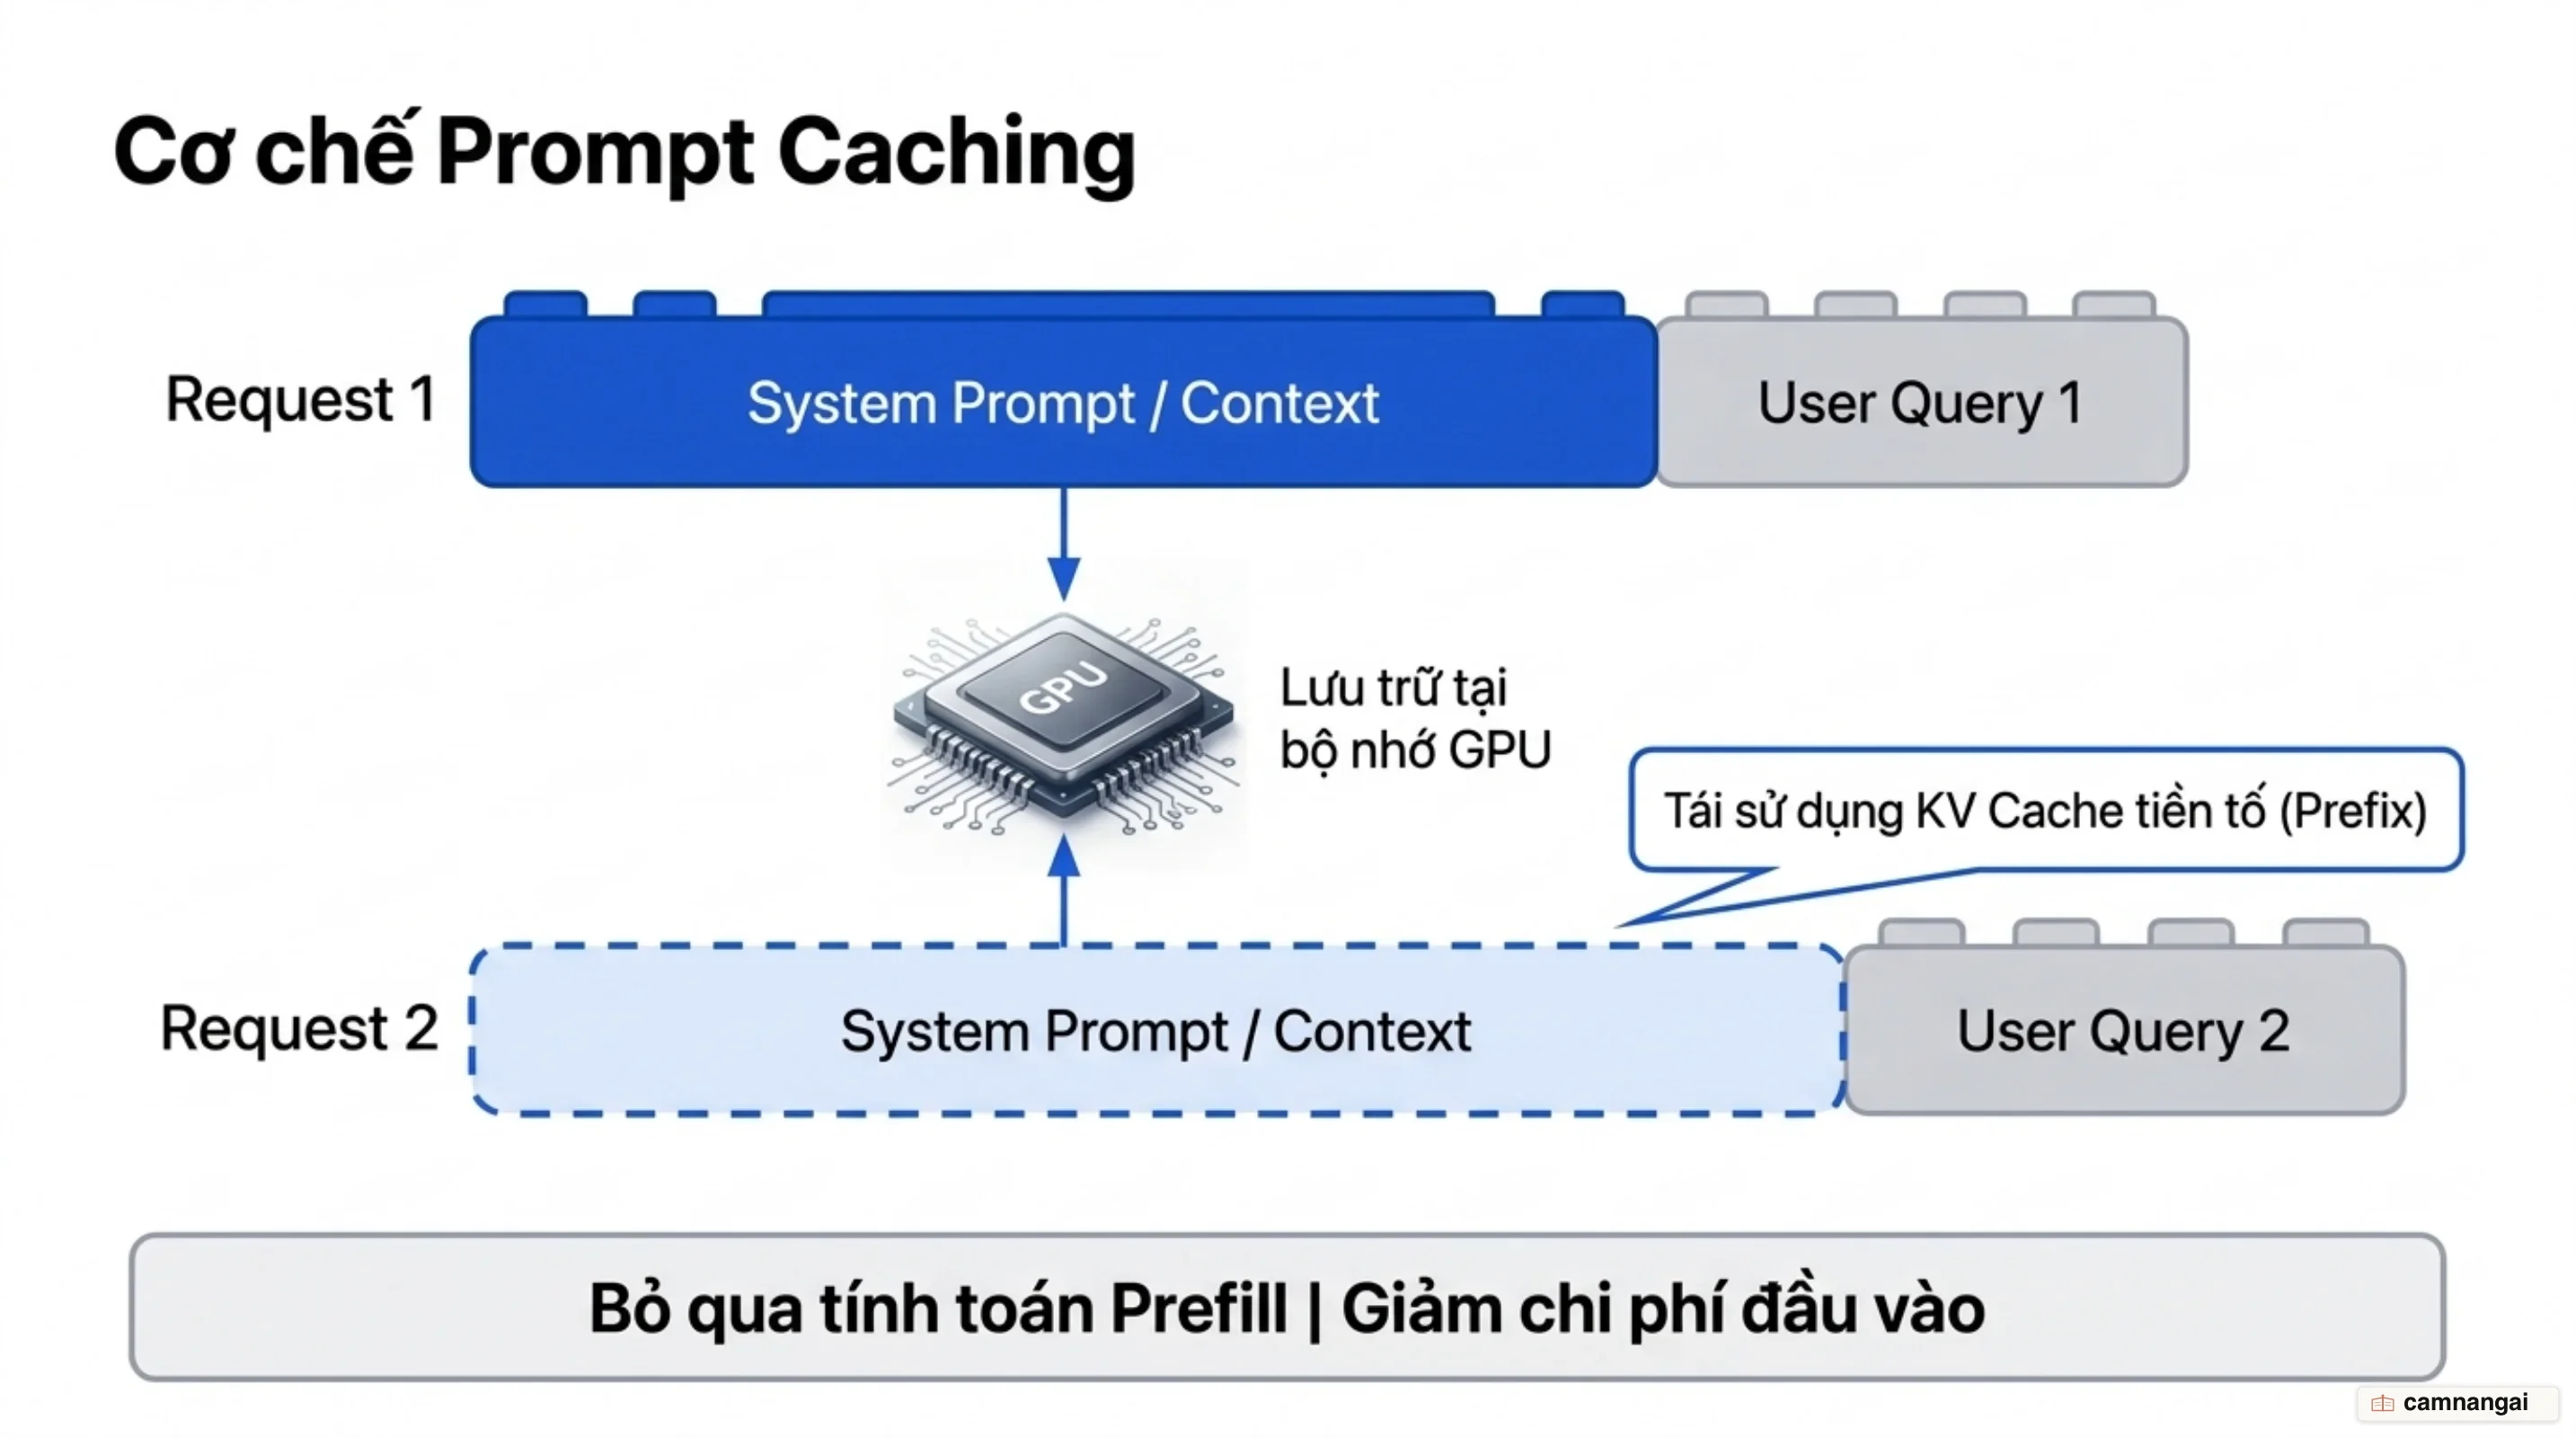
Prompt Caching hoạt động ở tầng sâu bên dưới—ngay tại LLM Inference Engine hoặc Model Provider. Cơ chế này lưu trữ và tái sử dụng các trạng thái ẩn Key-Value (KV Cache) của đoạn văn bản tiền tố (prefix) cố định trong giai đoạn Prefill của mô hình Transformer. Nhờ đó, mô hình bỏ qua việc tính toán lại các đoạn context dài như system instructions hay tài liệu RAG, giúp rút ngắn thời gian sinh ra token đầu tiên (Time-to-First-Token - TTFT) và được hưởng mức giá giảm sâu cho các input token đã cached.
Ngược lại, Semantic Caching hoạt động ở tầng ứng dụng hoặc middleware (nằm ngoài LLM). Hệ thống sử dụng một Embedding Model để chuyển đổi câu hỏi của người dùng thành Vector Embedding và thực hiện tìm kiếm tương đồng (Vector Similarity Search) trên Vector Database. Nếu phát hiện một câu hỏi đã tồn tại trong cache có cùng ý định ngữ nghĩa vượt qua ngưỡng xác định, hệ thống lập tức trả về câu trả lời đã lưu trữ trong vài miligiây, bỏ qua hoàn toàn lượt gọi đến LLM.
Hiểu rõ ranh giới kiến trúc giữa Prompt Caching và Semantic Caching giúp bạn xây dựng hạ tầng AI vừa tối ưu chi phí vừa đảm bảo tính chính xác cho dữ liệu sản xuất.
Vì sao các ứng dụng LLM bắt buộc phải có chiến lược caching?
Cấu trúc giá của các nhà cung cấp API LLM hiện nay phụ thuộc vào hai thành phần chính: số lượng input tokens (chi phí đọc và xử lý ngữ cảnh) và số lượng output tokens (chi phí sinh chuỗi ký tự mới). Trong thực tế vận hành, giá của output token thường cao hơn input token, nhưng khối lượng input token lại chiếm tỷ trọng áp đảo trong tổng lưu lượng xử lý.
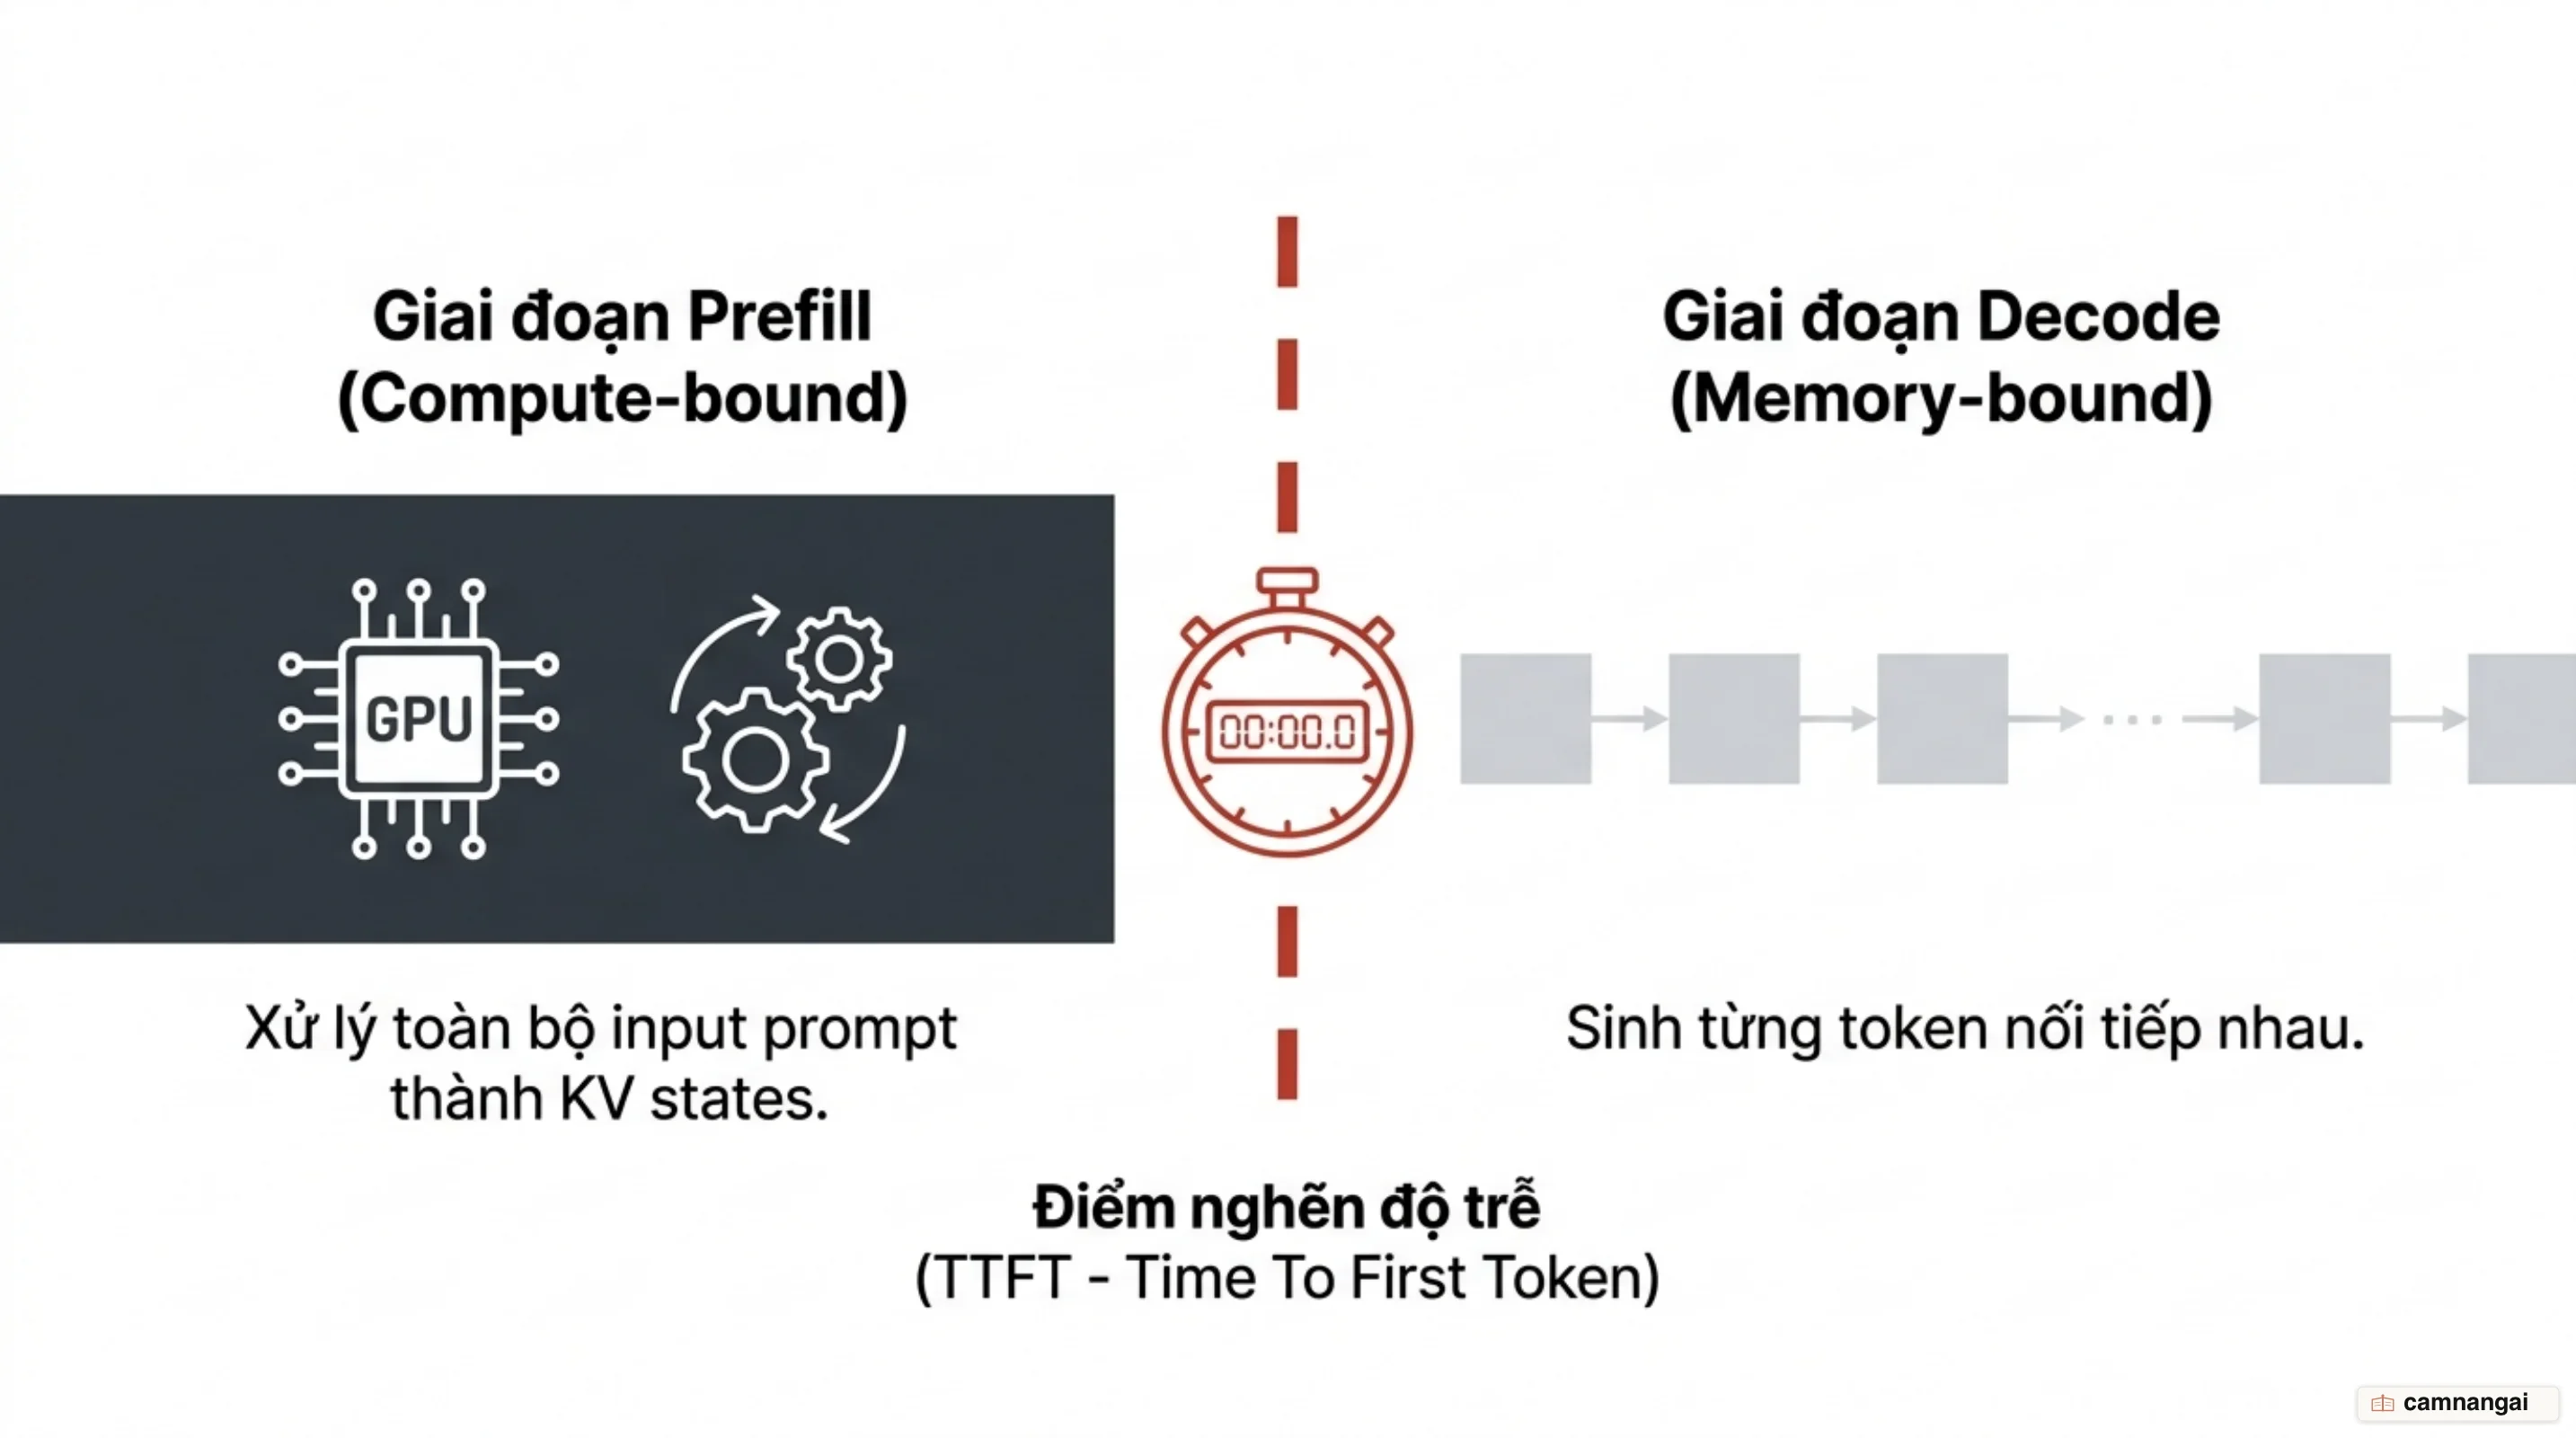
Các ứng dụng enterprise như RAG (Retrieval-Augmented Generation), Chatbot chăm sóc khách hàng hay Agentic Workflows luôn gửi kèm một lượng lớn dữ liệu lặp đi lặp lại trong mỗi request: hướng dẫn hệ thống (system instructions), định nghĩa công cụ (tool definitions), tài liệu sản phẩm dài hoặc lịch sử hội thoại qua nhiều vòng. Bên cạnh vấn đề chi phí, việc LLM phải xử lý (prefill) hàng ngàn token ngữ cảnh cho mỗi truy vấn tạo ra độ trễ khởi tạo lớn, trực tiếp ảnh hưởng đến chỉ số Time-to-First-Token (TTFT).
Nhằm giải quyết triệt để điểm nghẽn về độ trễ và chi phí tính toán lặp lại, hạ tầng ứng dụng LLM bắt buộc phải khai thác hai cơ hội tối ưu hóa chính:
- Tái sử dụng ngữ cảnh đầu vào đã xử lý (Prompt Caching): Giảm thiểu chi phí tính toán lại giai đoạn Prefill cho các đoạn dữ liệu đầu vào cố định được dùng chung giữa nhiều lượt gọi API.
- Tái sử dụng câu trả lời đã sinh cho các câu hỏi tương đồng (Semantic Caching): Bỏ qua hoàn toàn quá trình suy luận của LLM khi gặp các câu hỏi có cùng ý định ngữ nghĩa với các truy vấn đã được xử lý thành công trước đó.
Prompt Caching: Bản chất kỹ thuật, cơ chế KV Cache và tái sử dụng tiền tố (Prefix)
Một mô hình Transformer sinh tự do (Causal Language Model) xử lý truy vấn qua hai giai đoạn với đặc tính phần cứng hoàn toàn khác biệt: Prefill và Decode. Giai đoạn Prefill là quá trình compute-bound (bị giới hạn bởi khả năng tính toán của GPU), trong đó mô hình thực hiện hàng loạt phép nhân ma trận song song để chuyển đổi toàn bộ input tokens thành các trạng thái ẩn Key-Value tensors (KV Cache). Giai đoạn Decode sau đó là quá trình memory-bandwidth bound (bị giới hạn bởi băng thông bộ nhớ), sinh từng token mới một cách tuần tự dựa trên các KV tensors đã tính. Việc tính toán lại KV Cache cho các ngữ cảnh dài ở giai đoạn Prefill tiêu tốn lượng FLOPs khổng lồ của GPU.
Do tính chất duy kề (causal) của kiến trúc Self-Attention, các token đứng trước không bị ảnh hưởng bởi các token đứng sau. Nếu hai request độc lập chia sẻ cùng một chuỗi văn bản khởi đầu (Shared Prefix), tập hợp các KV tensors của đoạn tiền tố này hoàn toàn giống hệt nhau. Prompt Caching triệt tiêu phần tính toán nặng nhất ở giai đoạn Prefill bằng cách lưu trữ các KV tensors của tiền tố vào bộ nhớ GPU hoặc RAM của hệ thống phục vụ. Khi một request mới gửi đến có đoạn tiền tố trùng khớp chính xác từng token (Exact Prefix Match), mô hình nạp ngay trạng thái KV Cache đã lưu và chuyển tiếp sang giai đoạn sinh token, giúp giảm tối đa thời gian chờ TTFT.
Để Prompt Caching hoạt động hiệu quả, bạn bắt buộc phải tuân thủ quy tắc vị trí tiền tố cố định:
- Toàn bộ nội dung tĩnh (system instructions, tài liệu tham khảo, định nghĩa tools) phải được đẩy lên đầu prompt.
- Bất kỳ sự thay đổi nhỏ nào ở đầu prompt—chẳng hạn như chèn timestamp, Request ID, hoặc thay đổi thứ tự tài liệu—sẽ làm thay đổi toàn bộ chuỗi hash của prefix, dẫn đến hiện tượng Cache Miss hoàn toàn.
Các nhà cung cấp và Inference Engine hiện tại triển khai Prompt Caching theo nhiều cơ chế:
- Anthropic Claude: Hỗ trợ cơ chế đặt
cache_control={"type": "ephemeral"}. Mặc định cache có thời gian sống (TTL) 5 phút, trong đó lượt ghi cache đầu tiên tính phí 1.25x so với giá input cơ bản và các lượt cache hit tiếp theo được gia hạn TTL miễn phí. Bạn cũng có thể chọn gia hạn TTL lên 1 giờ với chi phí ghi cache là 2x base input rate (ephemeral_1h_input_tokens). Phí đọc token đã cached giảm mạnh, chỉ còn 0.1x so với uncached input (giảm tới 0.05x cho Claude Opus 5.5 / Sonnet 5.5 và 0.025x cho Claude Fable 5.1). Hệ thống cho phép thiết lập tự động (automatic caching) hoặc đặt thủ công tối đa 4 điểm ngắt (cache breakpoints) với cửa sổ nhìn lại (lookback window) 20 blocks. Về mặt an ninh, cache được cách ly ở tầng Workspace trên Claude API, AWS Platform và Microsoft Foundry; còn trên Amazon Bedrock và Google Cloud được cách ly ở tầng Organization. - OpenAI: Tự động áp dụng KV Caching cho các đoạn tiền tố có độ dài từ 1,024 tokens trở lên (đối với các dòng mô hình GPT-5.6+), hỗ trợ giảm 50%–95% chi phí input token (giá đọc cache là 0.1x base input). Đối với các mô hình trước GPT-5.6, ngưỡng token tối thiểu thay đổi tùy thuộc vào cấu hình request (tools, images, output schema). Dữ liệu cache được cách ly an toàn theo Organization/Workspace.
- vLLM (Automatic Prefix Caching - APC): Tự động quản lý KV Cache trên GPU bộ nhớ tĩnh. Với các mô hình Transformer tiêu chuẩn, bạn kích hoạt bằng cách thiết lập
enable_prefix_caching=Truetrong Python Engine hoặc dùng cờ--enable-prefix-cachingkhi khởi chạy CLI. Đối với các mô hình Hybrid Mamba, vLLM cung cấp các tham số như--enable-mamba-shared-prefix-checkpointvà--prefix-match-unitnhằm lưu trữ checkpoint tại đúng ranh giới khối (block boundary) của kiến trúc Mamba, giúp các request có cùng tiền tố nhưng bị cắt ngang ở giữa khối vẫn có thể tái sử dụng dữ liệu tính toán.
# Minh họa cấu hình Prompt Caching với Anthropic Messages API
import anthropic

client = anthropic.Anthropic()

# Khởi tạo request với cấu hình Prompt Caching dạng ephemeral
response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=1024,
    cache_control={"type": "ephemeral"}, # Đặt top-level automatic breakpoint cho tiền tố
    system=[
        {
            "type": "text",
            "text": "Bạn là chuyên gia phân tích hệ thống AI Hạ tầng...",
            "cache_control": {"type": "ephemeral"} # Đặt explicit breakpoint cố định cho System Prompt
        }
    ],
    messages=[
        {"role": "user", "content": "Phân tích tài liệu kỹ thuật đi kèm."}
    ]
)

# Kiểm tra hiệu quả cache qua dữ liệu usage
print(f"Cache Read Tokens: {response.usage.cache_read_input_tokens}")
print(f"Cache Creation Tokens: {response.usage.cache_creation_input_tokens}")
Semantic Caching: Tìm kiếm tương đồng ngữ nghĩa bằng Vector Embeddings
Khác với Prompt Caching phụ thuộc vào cấu trúc chuỗi token chính xác, Semantic Caching vận hành hoàn toàn ở tầng Middleware của ứng dụng. Cơ chế này loại bỏ tư duy khớp chuỗi ký tự truyền thống (Exact String Match) để chuyển sang so sánh ý định ngữ nghĩa của người dùng.
Quy trình xử lý của một Semantic Cache trải qua 4 bước tiêu chuẩn:
- Tiếp nhận truy vấn: Hệ thống bắt lại câu hỏi đầu vào từ người dùng ở tầng API Gateway / Middleware.
- Vector hóa (Embedding): Truy vấn được đưa qua một Embedding Model để chuyển thành một Vector Embedding cao chiều (thường là 768 hoặc 1,536 chiều tùy mô hình).
- Tìm kiếm tương đồng (Similarity Search): Hệ thống thực hiện phép đo khoảng cách Cosine (Cosine Similarity) giữa vector mới và tập hợp các vector câu hỏi đã từng lưu trong Vector Database (như Redis, FAISS, Milvus).
- Đánh giá ngưỡng (Threshold Evaluation): Giá trị tương đồng thu được sẽ so sánh với một ngưỡng (Similarity Threshold) được cấu hình trước (thường nằm trong khoảng 0.85 – 0.95).
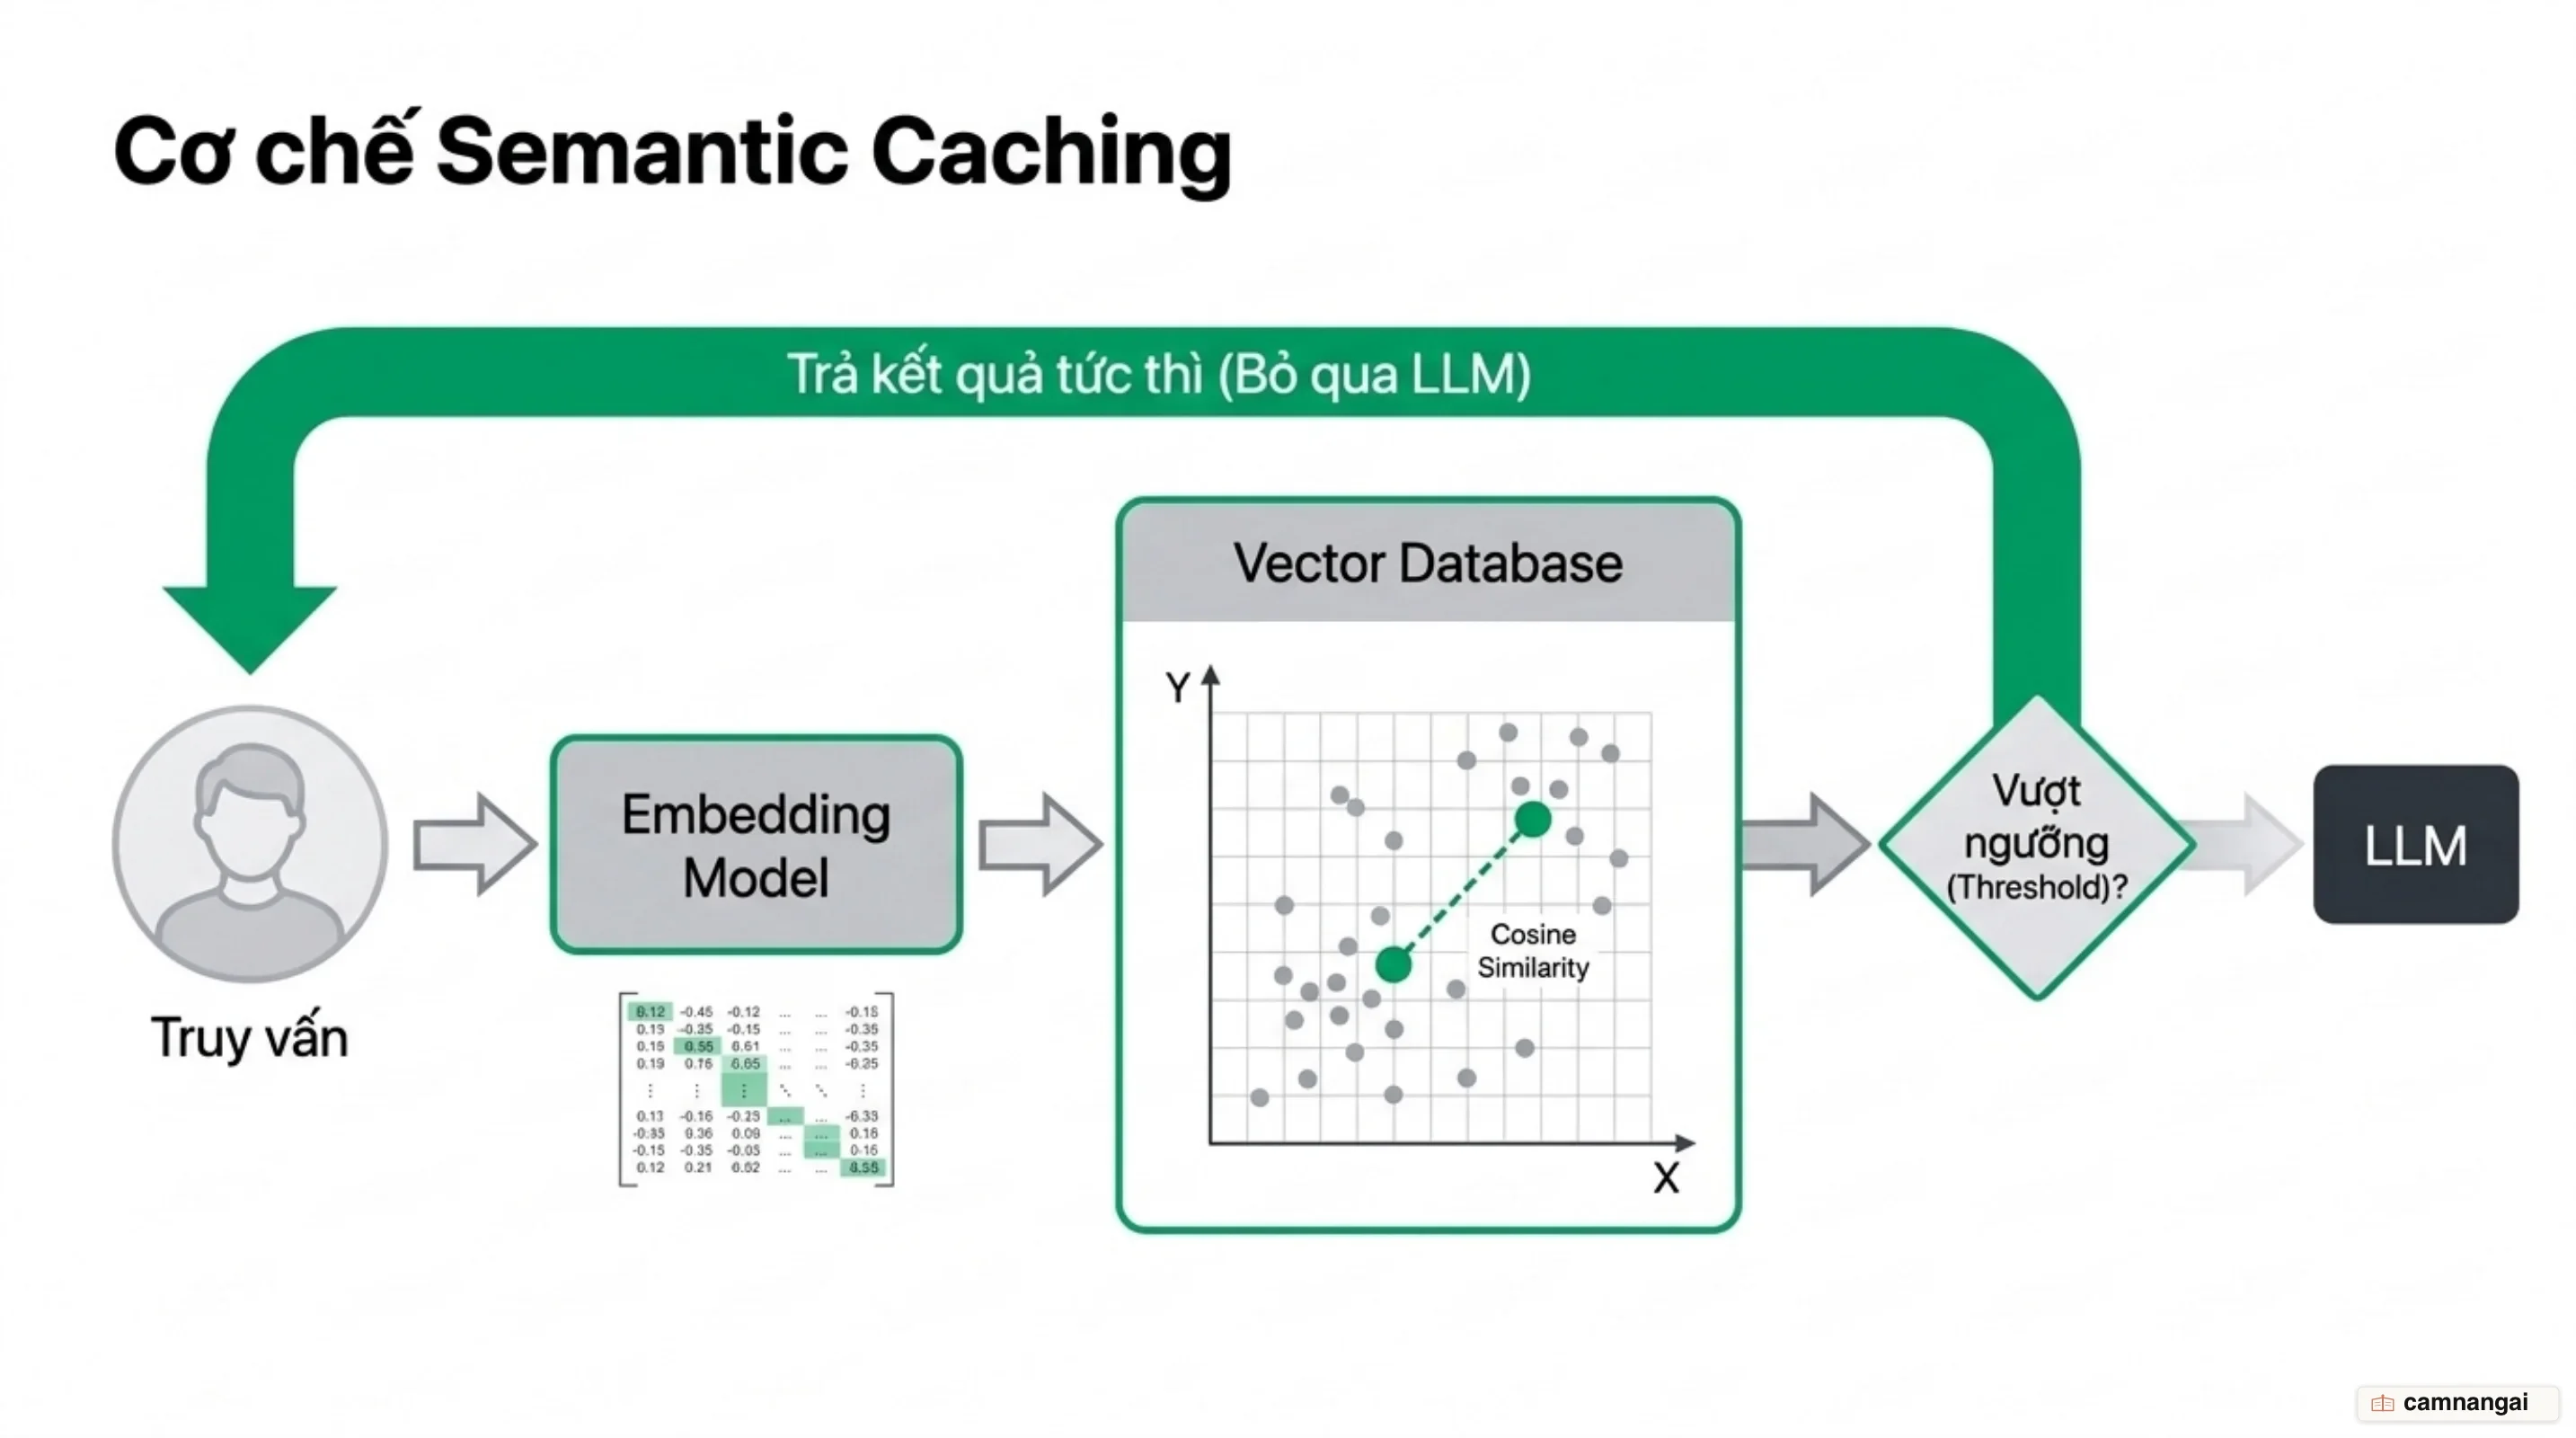
Về mặt hiệu năng, việc thực hiện tìm kiếm tương đồng vector chỉ tiêu tốn khoảng 5–20 ms chi phí xử lý (overhead). Khi xảy ra Cache Hit (điểm số vượt qua ngưỡng), hệ thống trả về ngay lập tức câu trả lời dạng text đã lưu trữ, cắt giảm 1–5 giây thời gian chờ suy luận từ LLM. Nhờ đó, ứng dụng đạt tốc độ xử lý nhanh hơn từ 2x–4x trong điều kiện thông thường và lên tới 50x–100x trong các kịch bản tối ưu.
Trường hợp điểm số thấp hơn ngưỡng (Cache Miss), truy vấn được chuyển tiếp đến LLM để thực hiện suy luận đầy đủ. Sau khi LLM hoàn tất sinh dữ liệu, cả Vector Embedding của câu hỏi mới lẫn câu trả lời thu được sẽ được ghi ngược vào Vector DB để phục vụ cho các truy vấn tương lai.
Các thư viện và nền tảng đại diện cho hướng tiếp cận này bao gồm GPTCache và Redis LangCache. Điểm mạnh lớn nhất của Semantic Caching là khả năng xử lý mượt mà các dạng diễn đạt khác nhau (Paraphrase). Ví dụ: hai câu hỏi "Làm sao để đổi mật khẩu tài khoản?" và "Tôi quên thông tin đăng nhập, cần khôi phục thế nào?" sở hữu tập từ vựng khác biệt nhưng có Vector Embedding gần kề nhau, cho phép hệ thống tái sử dụng chung một kết quả giải đáp.
So sánh trực diện: Prompt Caching vs Semantic Caching
| Tiêu chí kỹ thuật | Prompt Caching | Semantic Caching |
|---|---|---|
| Tầng kiến trúc (Pipeline Stage) | LLM Engine / Model Provider (Tầng dưới) | Application Middleware / Vector DB (Tầng trên) |
| Cơ chế khớp (Matching) | Khớp chính xác từng token tiền tố (Exact Prefix Match) | Khớp tương đồng ngữ nghĩa Vector (Cosine Similarity) |
| Dữ liệu lưu trữ (Payload) | Key-Value Tensors (KV Cache trạng thái ẩn) | Vector Embedding + Text Response hoàn chỉnh |
| Lượng tính toán giảm thiểu | Triệt tiêu việc tính toán lại KV Tensors cho phần tiền tố trùng khớp trong giai đoạn Prefill (Compute-bound), giữ nguyên giai đoạn Decode | Bỏ qua hoàn toàn lượt gọi LLM (Prefill + Decode) |
| Mức độ giảm chi phí | Giảm 50%–90% giá Token đầu vào (Input Discount) | Tiết kiệm 100% Token (Input + Output) khi Hit |
| Độ trễ cải thiện | Giảm TTFT (Time-to-First-Token) | Giảm toàn bộ độ trễ xuống vài miligiây (Sub-second) |
| Tính định hướng/Chính xác | Chính xác 100% (Không rủi ro sai lệch ngữ nghĩa) | Có rủi ro False Positive nếu đặt ngưỡng sai |
Sự đánh đổi (trade-off) cốt lõi giữa hai giải pháp nằm ở mối quan hệ giữa tính chính xác tuyệt đối và khả năng tối ưu chi phí tối đa:
Prompt Caching duy trì tính toàn vẹn 100% của mô hình ngôn ngữ. Vì mô hình vẫn thực hiện giai đoạn Decode để sinh ra các token mới dựa trên KV Cache có sẵn, câu trả lời trả về vẫn đảm bảo tính linh hoạt, động và chính xác theo đúng ngữ cảnh riêng của request đó. Tuy nhiên, bạn vẫn phải trả phí cho các token đầu ra và chịu độ trễ của quá trình sinh chuỗi.
Ngược lại, Semantic Caching cắt giảm triệt để chi phí API và độ trễ xuống mức tối thiểu bằng cách triệt tiêu lượt gọi LLM. Đổi lại, giải pháp này chấp nhận rủi ro trả về câu trả lời cố định cho các câu hỏi có ngữ nghĩa tiệm cận nhau. Việc thiết lập ngưỡng tương đồng không chính xác có thể dẫn đến hiện tượng trả sai thông tin đối với các câu hỏi đòi hỏi dữ liệu cá nhân hóa hoặc có sự khác biệt tinh tế trong ngữ cảnh.
Rủi ro và thách thức triển khai: Độ trôi ngữ cảnh, phân quyền (RBAC) và vô hiệu hóa cache
Triển khai caching trên môi trường Production thực tế đòi hỏi kỹ sư phải giải quyết các bài toán phức tạp về tính nhất quán và bảo mật dữ liệu.
1. Thách thức vô hiệu hóa Cache (Cache Invalidation)
- Semantic Caching: Khi dữ liệu gốc thay đổi (ví dụ: chính sách đổi trả hàng giảm từ 30 ngày xuống 14 ngày), các câu trả lời cũ đã lưu trong Semantic Cache sẽ trở thành thông tin sai lệch. Bạn bắt buộc phải áp dụng thời gian sống TTL (5–15 phút cho dữ liệu biến động cao như giá/kho hàng, hoặc 24 giờ cho tài liệu hướng dẫn tĩnh). Một giải pháp triệt để hơn là vô hiệu hóa dựa trên sự kiện (Event-driven invalidation) hoặc quản lý phiên bản (Versioning): khi tài liệu nguồn cập nhật (
policy_version=13), ứng dụng chủ động xóa hoặc bỏ qua các cache entries mang phiên bản cũ (policy_version=12). - Prompt Caching: Cache tự động mất hiệu lực nếu ứng dụng thay đổi dù chỉ một ký tự trong đoạn prefix. Nếu ứng dụng truyền đúng bản cập nhật mới nhất vào prompt, LLM sẽ nhận diện prefix mới và khởi tạo cache entry mới.
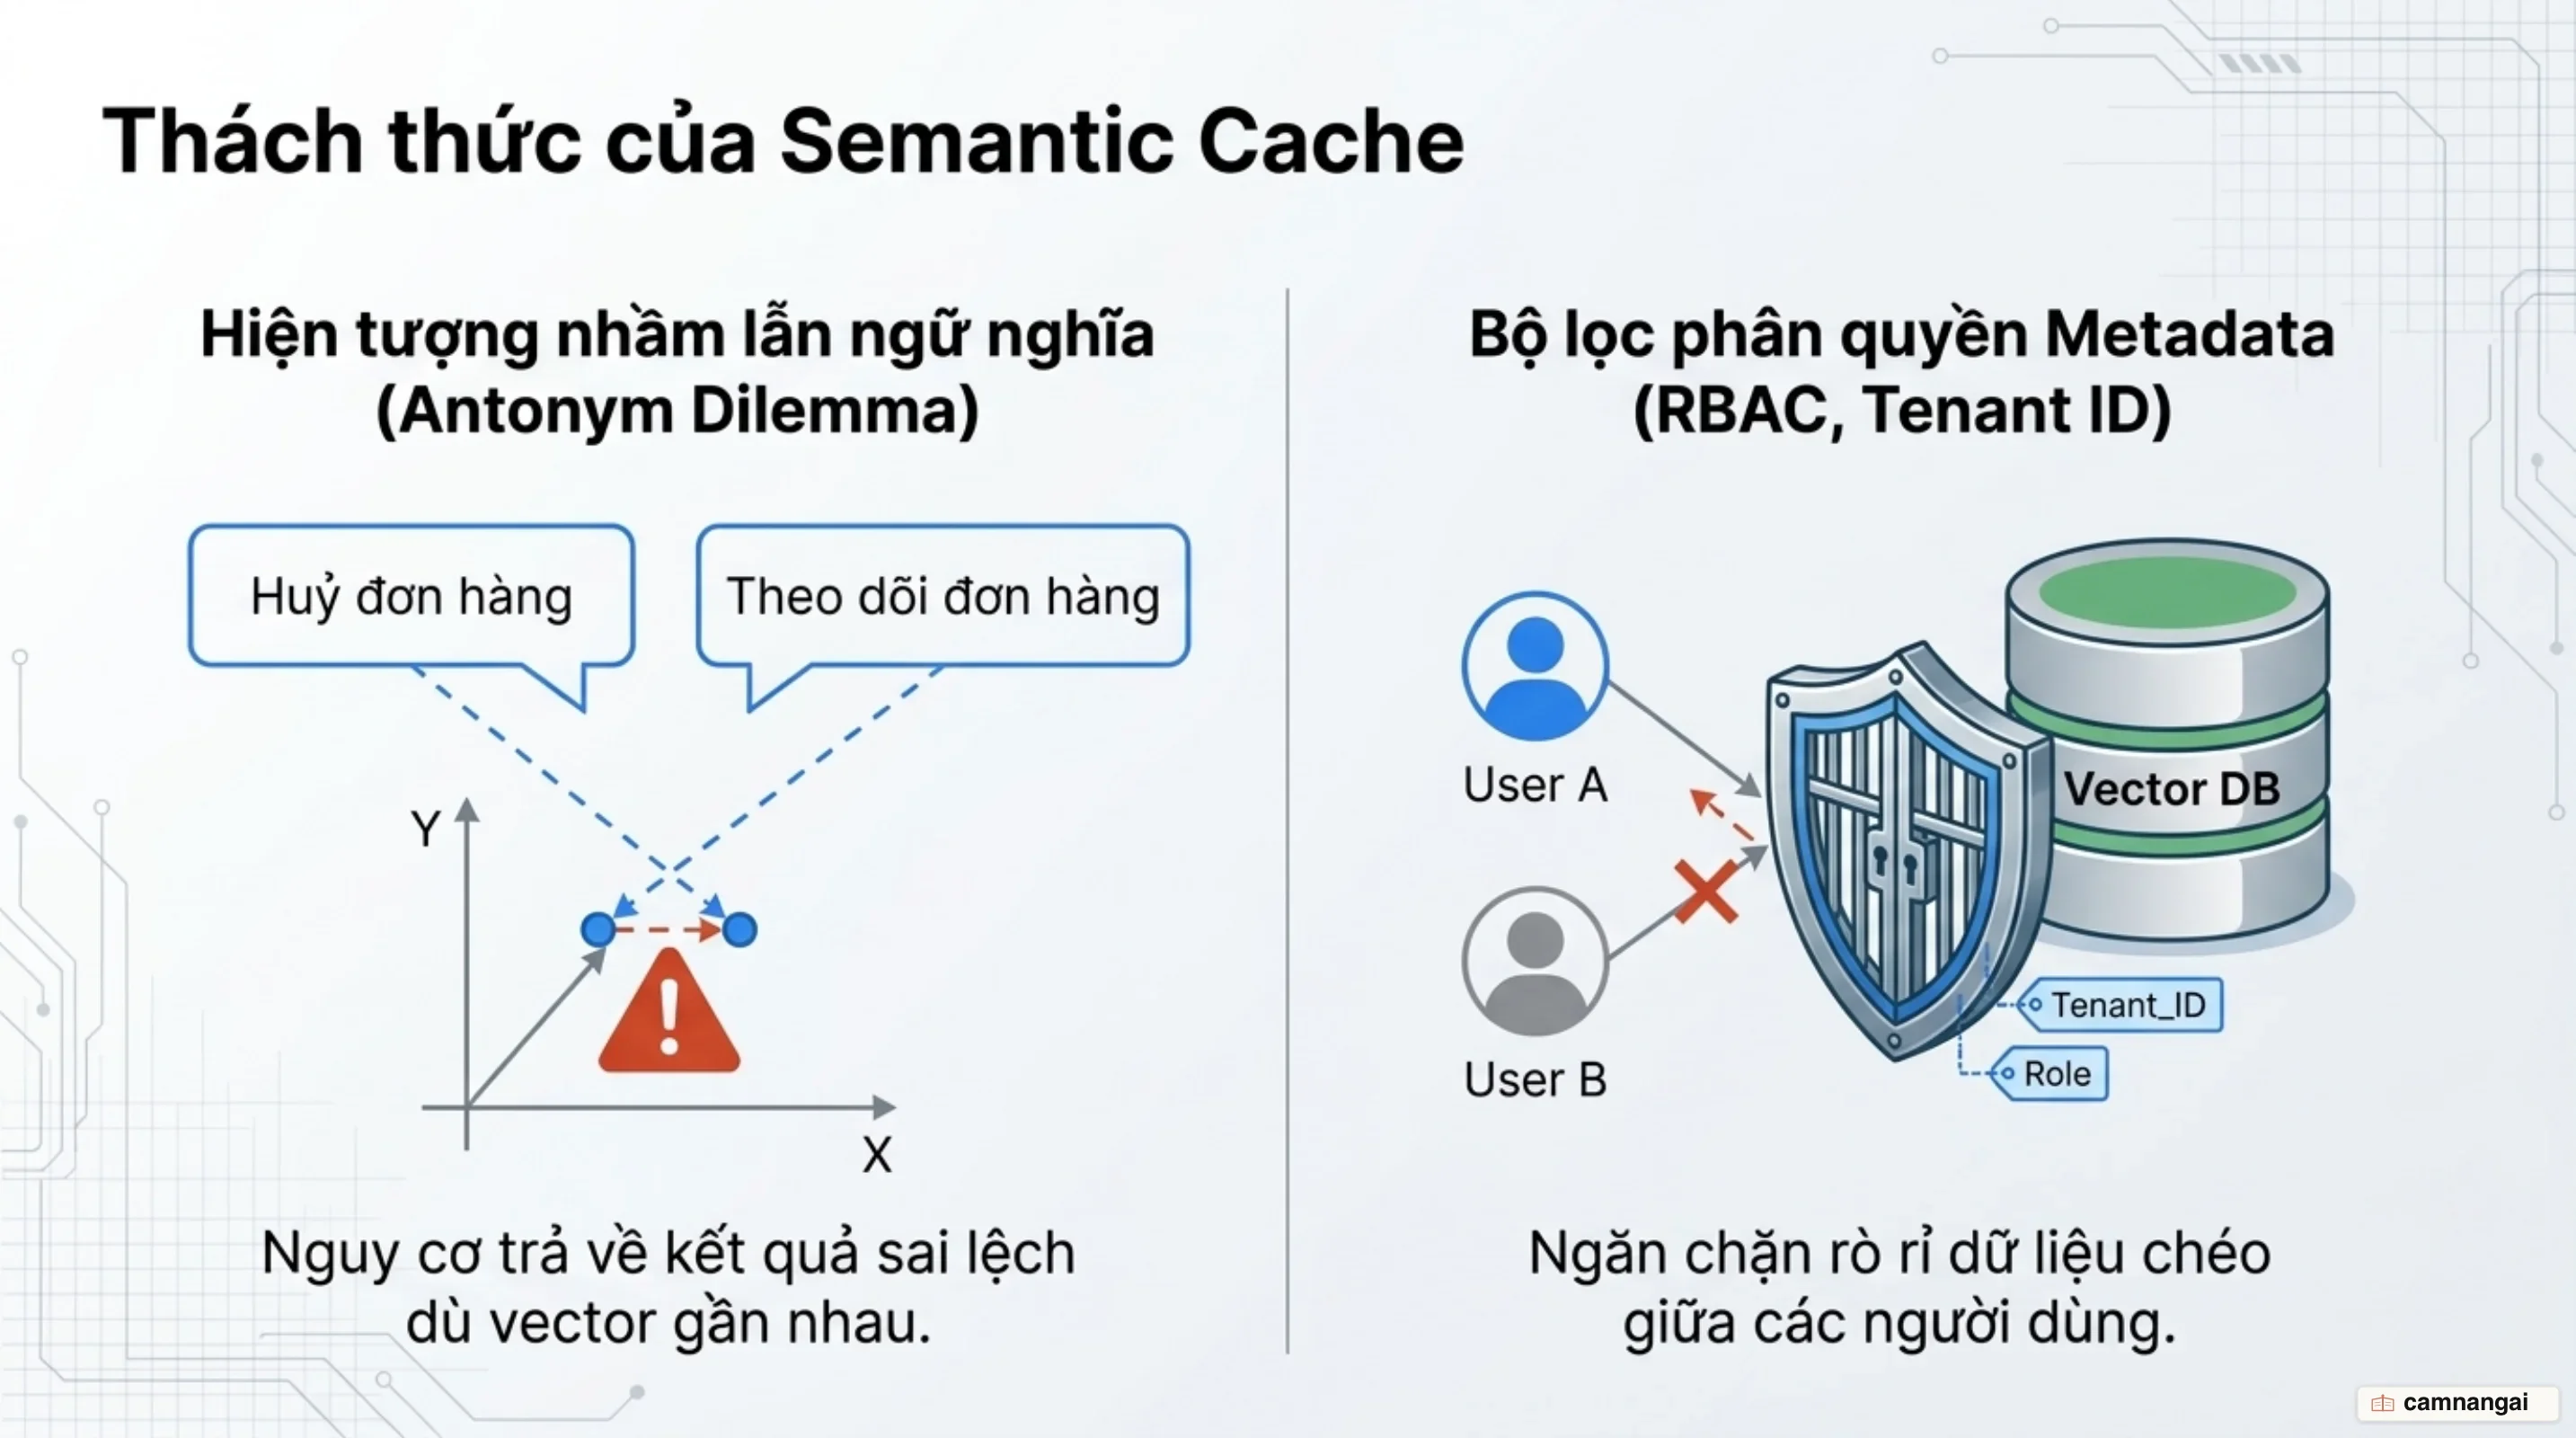
2. Nhầm lẫn ngữ nghĩa (False Positives & Antonym Dilemma)
Các phép đo khoảng cách vector đơn thuần rất khó phân biệt các câu hỏi chứa từ phủ định hoặc có sự khác biệt về tham số dịch vụ nhưng chung tập từ vựng. Ví dụ:
- "Làm thế nào để hủy đơn hàng trước khi giao?" vs "Làm thế nào để hủy đơn hàng sau khi giao?"
- "Gói Basic có hỗ trợ sao lưu không?" vs "Gói Pro có hỗ trợ sao lưu không?"
Do chứa phần lớn từ vựng giống nhau, Vector Embedding của các cặp câu trên có điểm Cosine Similarity rất cao. Nếu đặt Similarity Threshold thấp (< 0.88), hệ thống sẽ trả về sai phản hồi nghiêm trọng. Để khắc phục, bạn cần siết chặt ngưỡng tương đồng lên mức 0.90 – 0.95 và duy trì một bộ dữ liệu kiểm thử (eval suite) chứa các cặp câu gần giống nhau nhưng đối lập ý định (near-matches / antonyms) để liên tục đánh giá độ chính xác của Semantic Cache.
3. Bảo mật và Phân quyền (RBAC / Isolation)
- Semantic Caching: Việc dùng chung bộ nhớ vector giữa nhiều người dùng hoặc các tổ chức (tenants) dễ dẫn đến rò rỉ dữ liệu cá nhân (ví dụ: câu hỏi chứa thông tin tài chính của User A bị trả về cho User B). Do đó, quy trình tìm kiếm Vector Similarity BẮT BUỘC phải tích hợp bộ lọc Metadata (Metadata Filtering) chứa các thuộc tính phân quyền như
customer_id,org_id, hoặcuser_role. - Prompt Caching: Các nhà cung cấp API như Anthropic và OpenAI triển khai hạ tầng cách ly cache ở tầng Workspace hoặc Organization. Trạng thái KV Cache của một tổ chức hoàn toàn không thể bị truy vấn hay chia sẻ sang tổ chức khác, giải quyết triệt để bài toán rò rỉ dữ liệu đa người dùng.
Kiến trúc kết hợp: Phối hợp cả hai tầng caching trên môi trường Production
Nhằm giải quyết triệt để các hạn chế riêng lẻ của tầng Semantic Caching (nguy cơ False Positive, dữ liệu tĩnh) và tầng Prompt Caching (vẫn tốn chi phí Decode, phụ thuộc Prefix trùng khớp), kiến trúc caching đa tầng (Multi-tier Caching) được thiết kế như một cơ chế giảm thiểu rủi ro toàn diện cho các hệ thống enterprise.
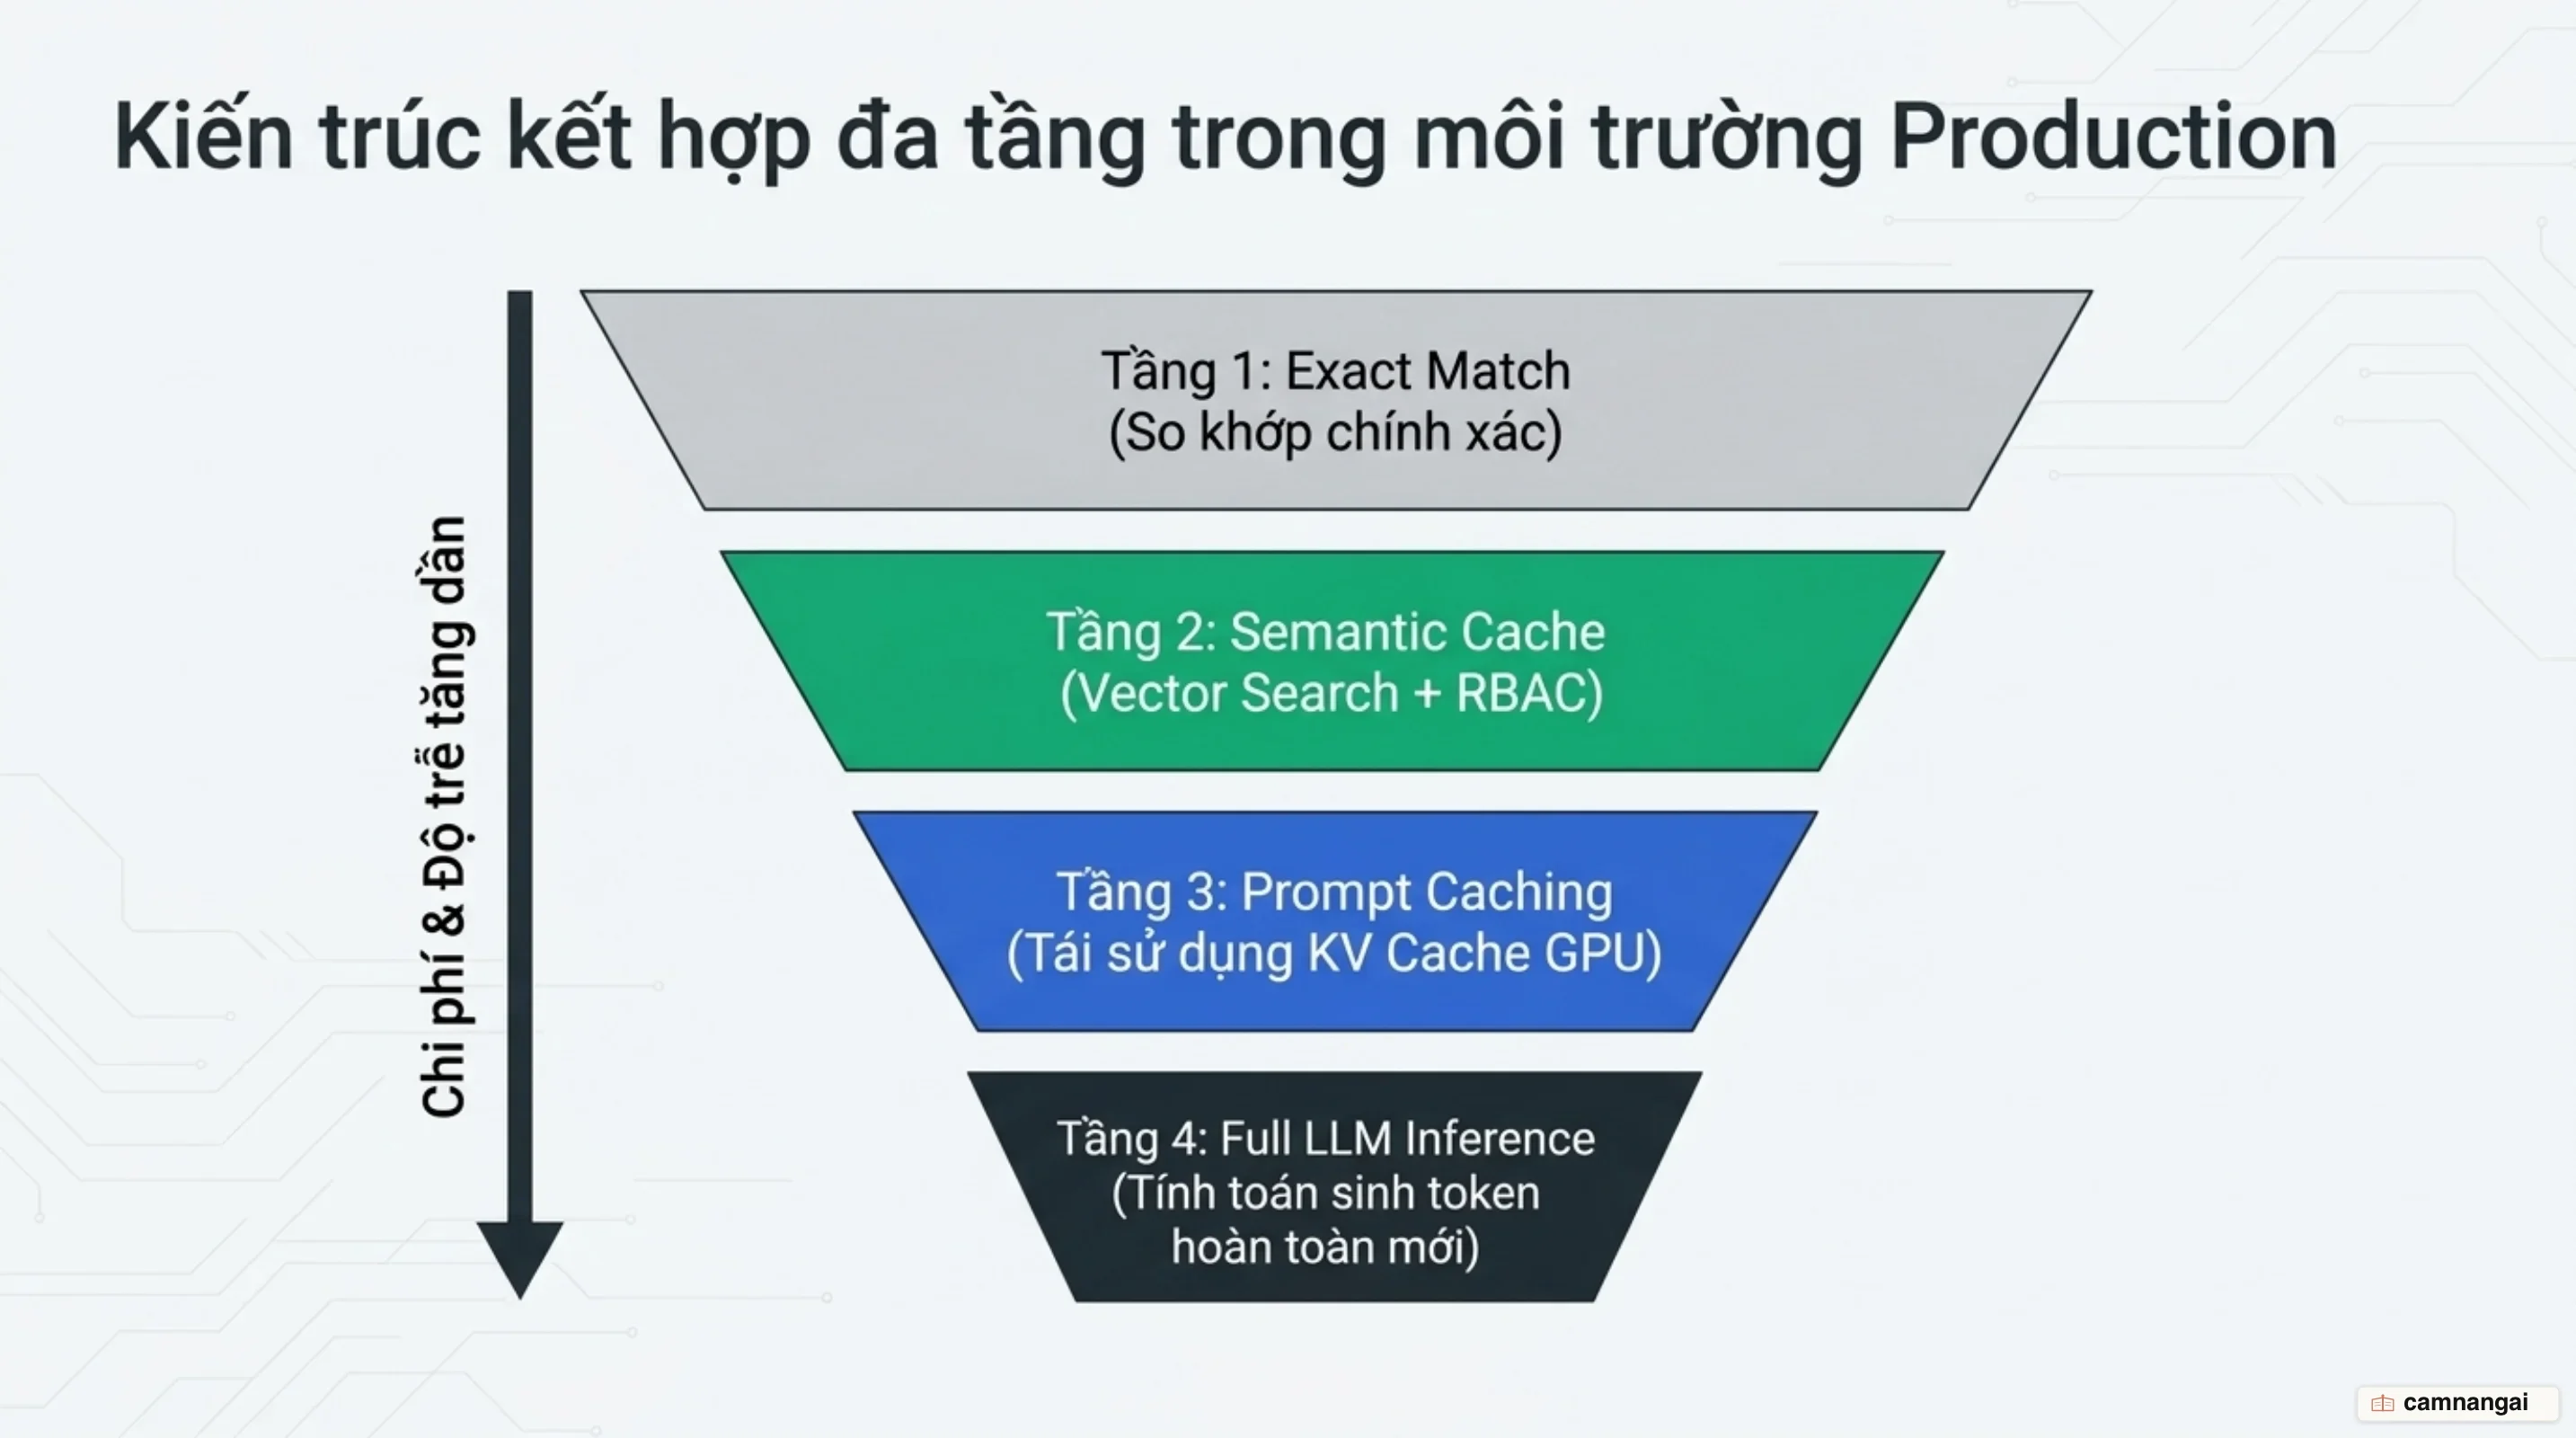
Luồng xử lý dữ liệu qua 4 tầng được thực hiện tuần tự như sau:
- Tầng 1 (Exact Match Cache): Middleware kiểm tra chuỗi câu hỏi bằng phép so sánh chuỗi chính xác (dựa trên Hash/Key-Value trong Redis). Nếu câu hỏi lặp lại nguyên văn, hệ thống trả về kết quả ngay lập tức với chi phí tiệm cận 0.
- Tầng 2 (Semantic Cache Layer): Nếu Tầng 1 Miss, ứng dụng tạo Vector Embedding cho câu hỏi và truy vấn Vector DB kèm theo Metadata Filtering (RBAC). Nếu phát hiện câu hỏi có điểm tương đồng lớn hơn hoặc bằng ngưỡng quy định (ví dụ: 0.92), hệ thống trả về câu trả lời đã lưu trữ.
- Tầng 3 (Prompt Caching Layer): Nếu Tầng 2 Miss, request bắt buộc phải chuyển tới LLM. Lúc này, ứng dụng đóng gói prompt theo một cấu trúc chuẩn hóa: đặt toàn bộ System Prompt, định nghĩa Tools và Tài liệu RAG cố định ở phần đầu (Prefix) và gắn nhãn
cache_control. Truy vấn được gửi tới LLM Provider. Tại đây, LLM Engine nhận diện tiền tố đã tồn tại trong bộ nhớ KV Cache, cho phép xử lý giai đoạn Prefill với tốc độ cao hơn và chi phí giảm 50%–90%. - Tầng 4 (Full Inference & Cache Update): LLM thực hiện sinh các token mới (Decode). Kết quả hoàn chỉnh sau khi trả về cho người dùng sẽ được ghi ngược lại vào Tầng 2 (Semantic Cache) và Tầng 1 (Exact Match Cache) để tối ưu cho các lượt truy vấn tiếp theo.
Lời kết: Khung quyết định lựa chọn giải pháp caching cho bài toán của bạn
Lựa chọn chiến lược caching phù hợp đòi hỏi việc đánh giá bản chất truy vấn và yêu cầu đầu ra của ứng dụng:
Bạn nên ưu tiên triển khai Prompt Caching khi ứng dụng bắt buộc phải sinh ra các câu trả lời mới, mang tính linh hoạt và cá nhân hóa cao cho từng người dùng, nhưng quá trình suy luận lại dựa trên một tập ngữ cảnh chung rất lớn. Các bài toán điển hình bao gồm: trợ lý phân tích tài liệu RAG độ dài lớn, các Agentic Workflows sở hữu danh sách hàng chục định nghĩa công cụ (tool definitions), hoặc các công cụ hỗ trợ lập trình (Coding Assistants) cần giữ toàn bộ codebase trong context window.
Bạn nên lựa chọn Semantic Caching khi ứng dụng phải xử lý lưu lượng truy vấn lớn có tính chất lặp đi lặp lại về mặt ý định, và tập câu trả lời mẫu có tính chất cố định, ít biến động theo thời gian. Các bài toán phù hợp nhất là Chatbot tự động trả lời FAQ chăm sóc khách hàng, hệ thống tra cứu chính sách nội bộ doanh nghiệp, hoặc công cụ tìm kiếm sản phẩm trên các sàn thương mại điện tử.
Việc kết hợp cả hai tầng caching trên cùng một đường ống xử lý (Pipeline) sẽ giúp ứng dụng đạt được hiệu năng tối đa: Semantic Caching chịu trách nhiệm đánh chặn các câu hỏi trùng lặp ở tầng ngoài để cắt giảm tối đa chi phí, trong khi Prompt Caching đóng vai trò tuyến phòng thủ phía sau giúp giảm thiểu độ trễ TTFT và giá token khi request bắt buộc phải thực hiện suy luận trên LLM.
Tài liệu tham khảo
- LLM Prompt Caching Versus Semantic Caching — ByteByteGo
- Prompt Caching — Anthropic Claude Platform Docs
- Prompt Caching in API — OpenAI Documentation
- Automatic Prefix Caching (APC) — vLLM Documentation
- What is semantic caching? Guide to faster, smarter LLM apps — Redis
- GPTCache: A Library for Creating Semantic Cache for LLM Queries — Zilliz