Trong kiến trúc RAG (Retrieval-Augmented Generation), retrieval (truy hồi) là giai đoạn hệ thống truy vấn thông tin từ cơ sở dữ liệu ngoại vi để cung cấp ngữ cảnh chính xác cho mô hình ngôn ngữ lớn (LLM).
Giai đoạn này đóng vai trò "cầu nối" kỹ thuật, trực tiếp giải quyết vấn đề ảo giác (hallucination) và tri thức lỗi thời bằng cách chuyển đổi truy vấn người dùng thành các vector hoặc từ khóa để tìm kiếm các đoạn văn bản (chunks) liên quan nhất.
Nếu không có tầng retrieval tối ưu, LLM chỉ là một bộ não mạnh mẽ nhưng thiếu dữ liệu thực tế để suy luận.
Quy trình retrieval vận hành như thế nào trong RAG?
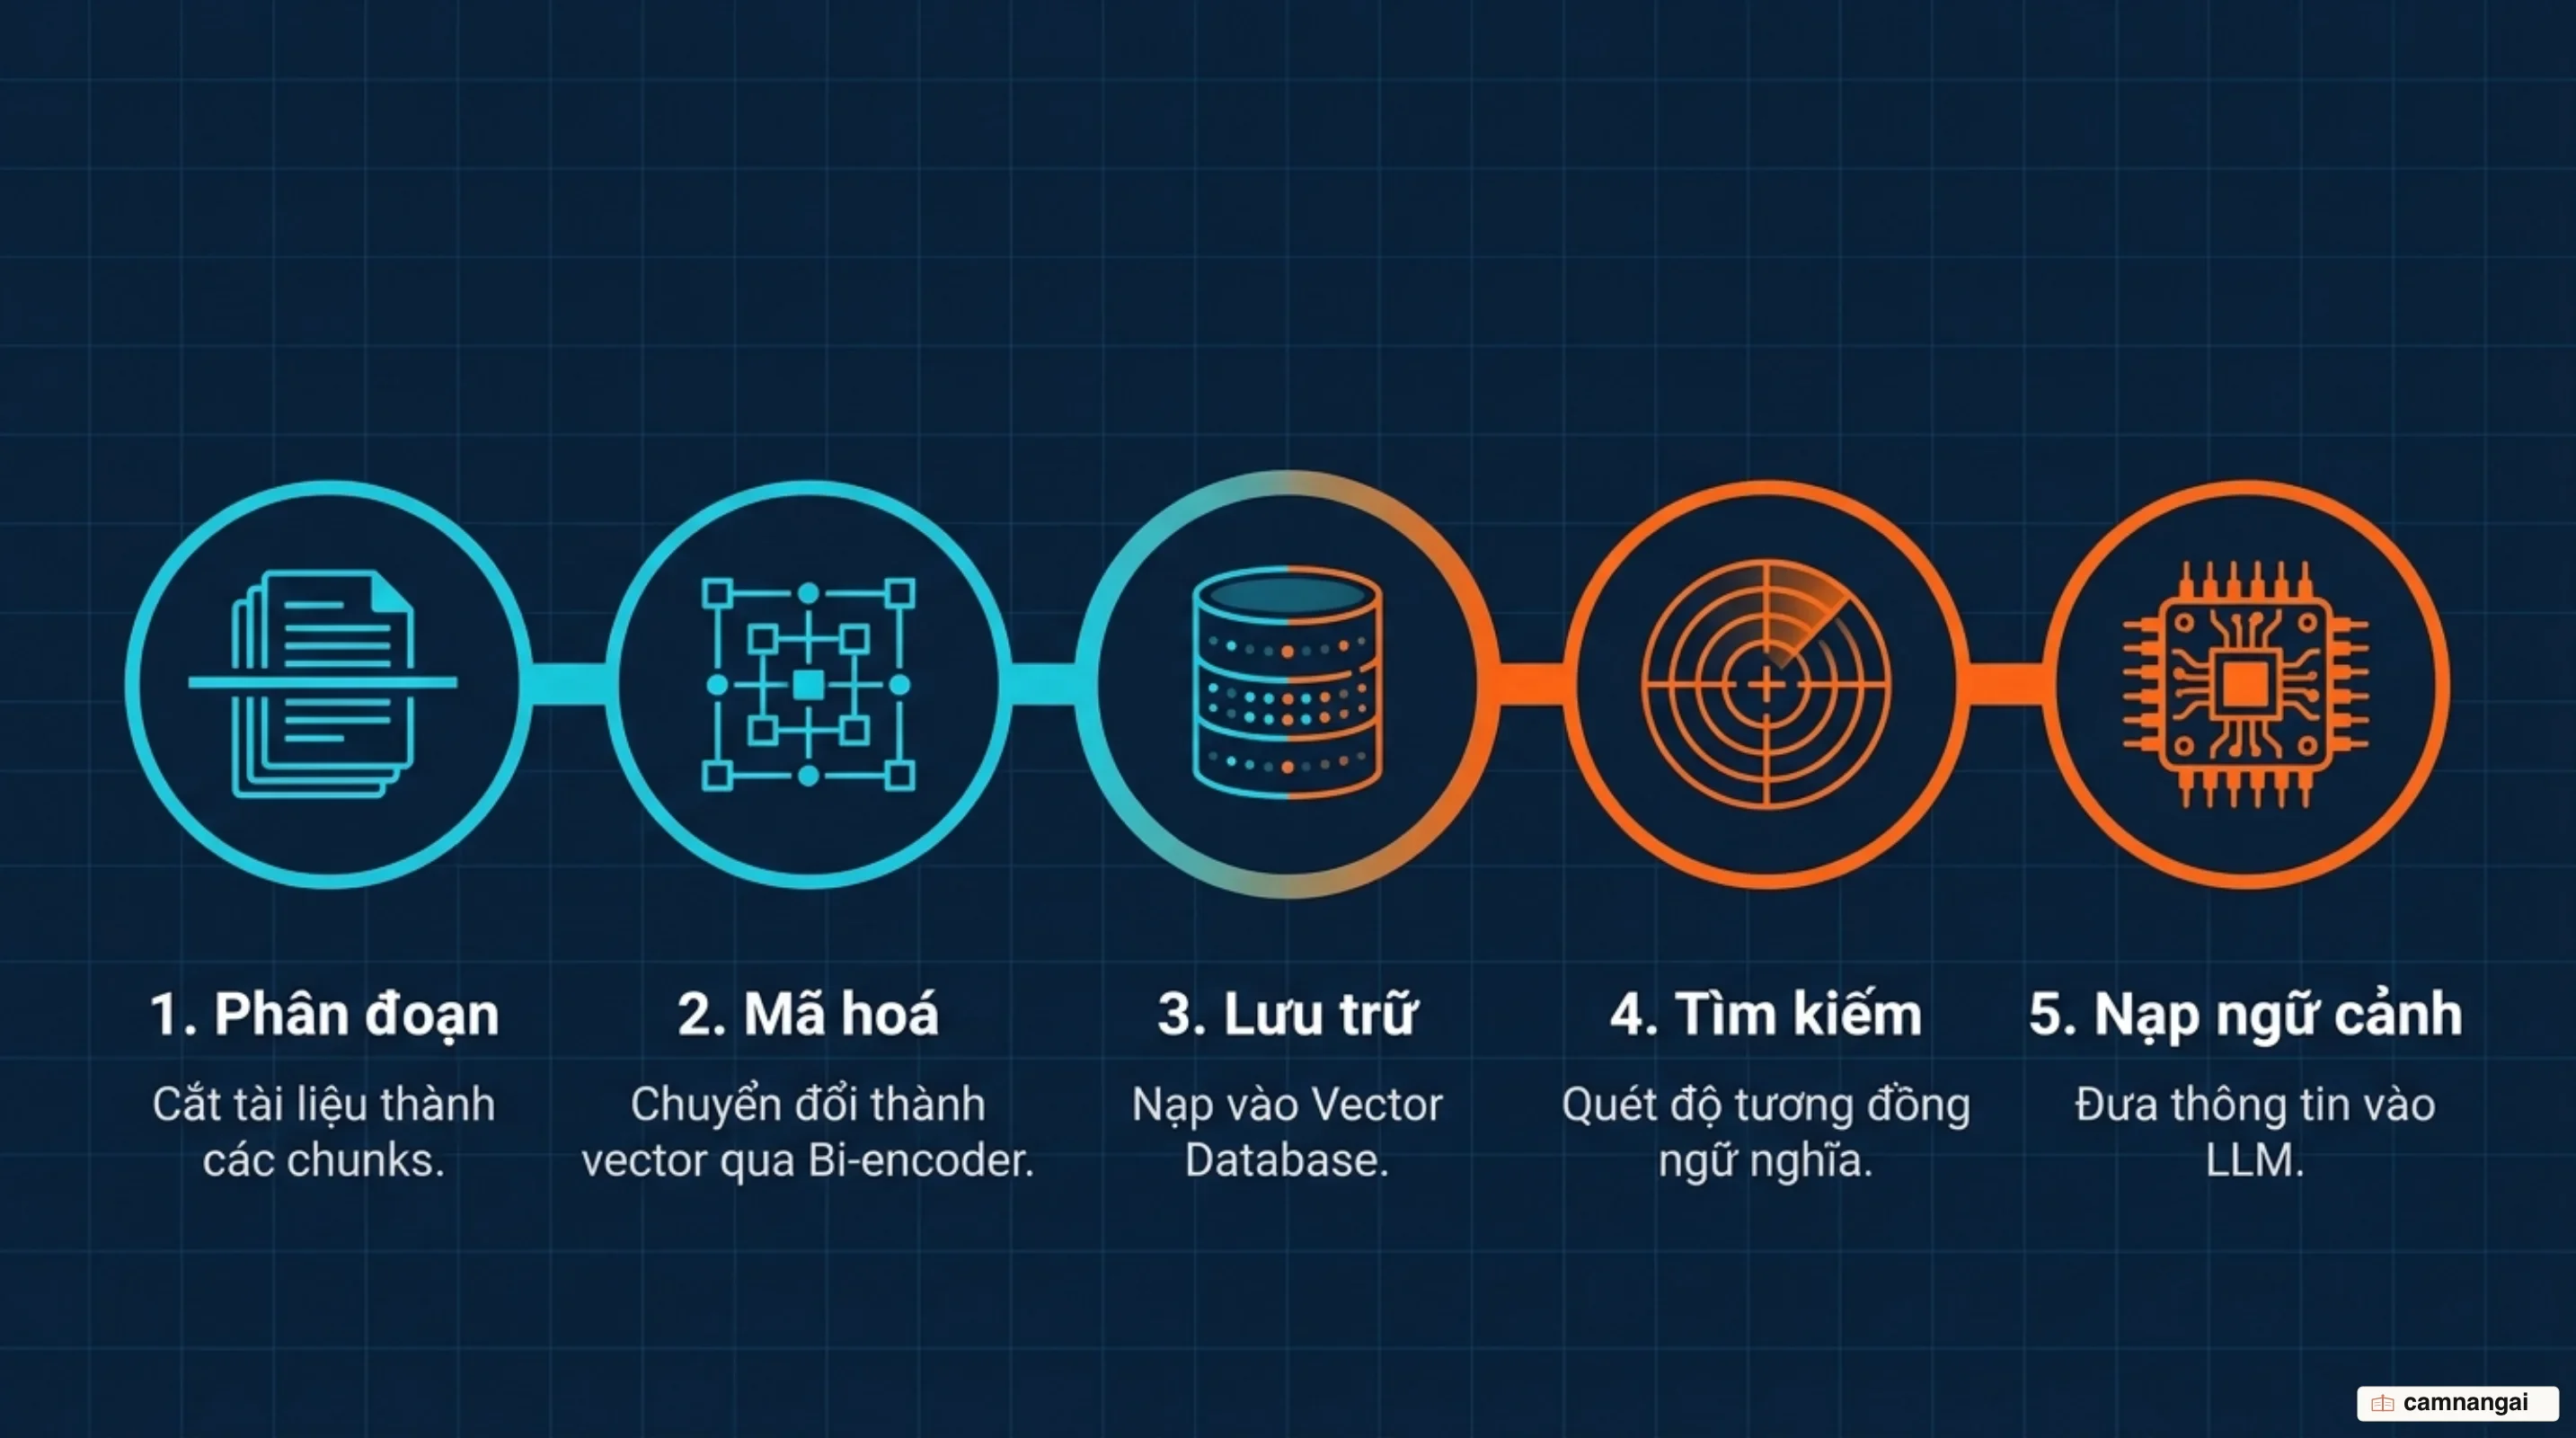
Một hệ thống retrieval trong RAG chuẩn hóa vận hành qua hai giai đoạn then chốt:
- Giai đoạn Tiền xử lý (Offline): Tài liệu thô được chia nhỏ (chunking), sau đó được chuyển đổi thành các vector số học thông qua embedding model và lưu trữ vào cơ sở dữ liệu vector.
- Giai đoạn Vận hành (Runtime): Hệ thống nhận query từ người dùng, chuyển đổi query đó thành vector và thực hiện tìm kiếm láng giềng gần nhất (nearest neighbor search) để trích xuất dữ liệu.
Thách thức "mất ngữ cảnh" (Context Conundrum):
Khi chia nhỏ tài liệu, các đoạn văn bản thường mất đi thông tin toàn cục (ví dụ: một đoạn văn đề cập đến "doanh thu tăng 3%" nhưng không rõ thuộc về năm tài chính nào hay công ty nào). Để khắc phục, chúng ta áp dụng kỹ thuật tách biệt (decoupling) giữa chunk dùng để truy hồi và chunk dùng để tổng hợp (synthesis) thông qua hai chiến lược:
- Document Summary Indexing: Tạo embedding cho bản tóm tắt tài liệu và liên kết nó với các chunks chi tiết bên dưới.
- Sentence-Window Retrieval: Thực hiện truy hồi dựa trên một câu đơn lẻ (để đạt độ chính xác cao) nhưng khi đưa vào LLM sẽ lấy thêm một "cửa sổ" ngữ cảnh xung quanh câu đó.
Dense, Sparse và Hybrid Search: Khi nào vector không đủ?
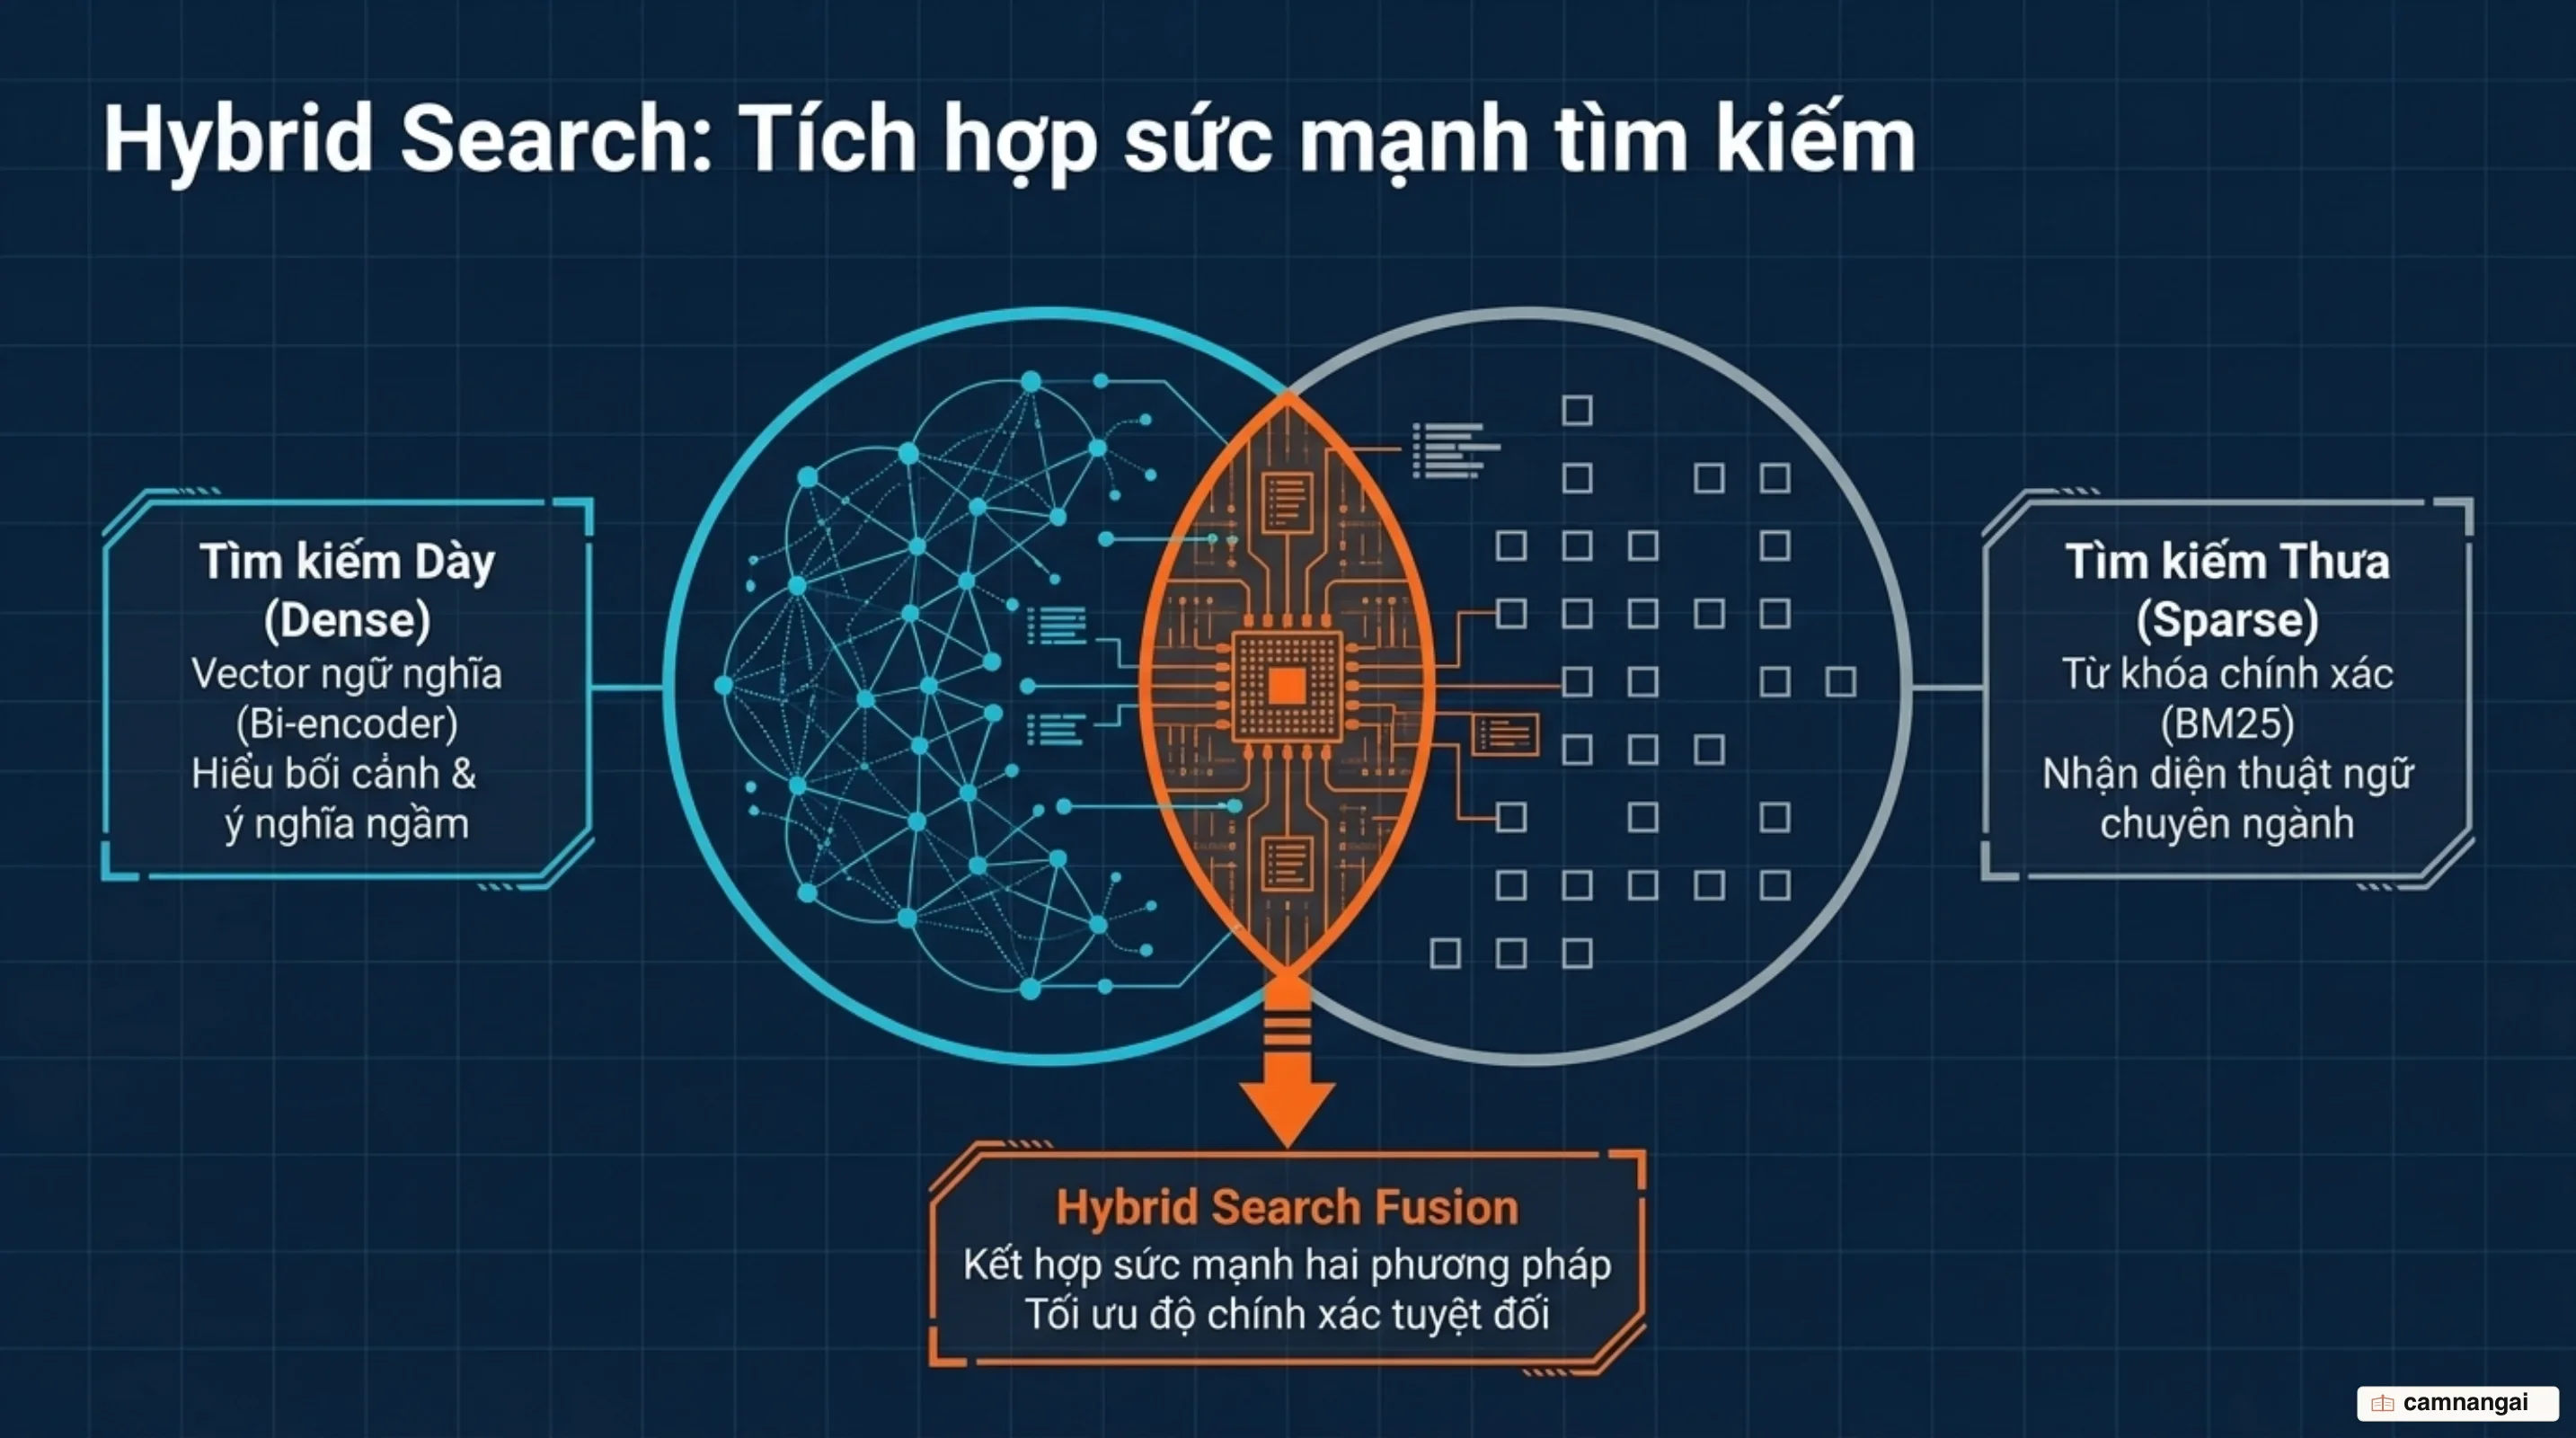
Trong môi trường production, chỉ sử dụng Dense Vector (nhúng ngữ nghĩa) là chưa đủ. Các thuật ngữ chuyên ngành hoặc mã lỗi đặc định (như "TS-999") thường bị trôi đi trong không gian vector dày đặc.
| Tiêu chí | Dense Search (Vector) | Sparse Search (Keyword/BM25) |
|---|---|---|
| Khả năng hiểu ngữ nghĩa | Rất cao (hiểu từ đồng nghĩa/ngữ cảnh) | Thấp (chỉ khớp từ khóa chính xác) |
| Độ chính xác thuật ngữ | Trung bình (dễ nhầm mã lỗi tương tự) | Rất cao (khớp chính xác mã TS-999) |
| Chi phí tính toán | Cao (yêu cầu GPU cho embedding) | Thấp (chạy tốt trên CPU) |
Cơ chế Hybrid Search:
Đây là sự kết hợp giữa Dense và Sparse search. Để gộp kết quả, hệ thống sử dụng thuật toán relativeScoreFusion (lựa chọn chuẩn trong các vector database hiện đại). Khác với rankedFusion vốn chỉ giữ lại thứ tự vị trí, relativeScoreFusion sử dụng min-max normalization để giữ nguyên "khoảng cách chiến thắng" giữa các kết quả, giúp bảo toàn độ tin cậy của điểm số ban đầu. Tham số alpha (từ 0 đến 1) được dùng để điều chỉnh: alpha = 1 là thuần vector, alpha = 0 là thuần BM25.
Tìm kiếm láng giềng gần đúng (ANN) và cấu trúc đồ thị HNSW
Với tập dữ liệu hàng triệu đến hàng tỷ vector, việc quét tuyến tính (linear scan) là bất khả thi. HNSW (Hierarchical Navigable Small Worlds) là cấu trúc đồ thị đa tầng giúp tối ưu tốc độ tìm kiếm láng giềng gần đúng (Approximate Nearest Neighbor - ANN):
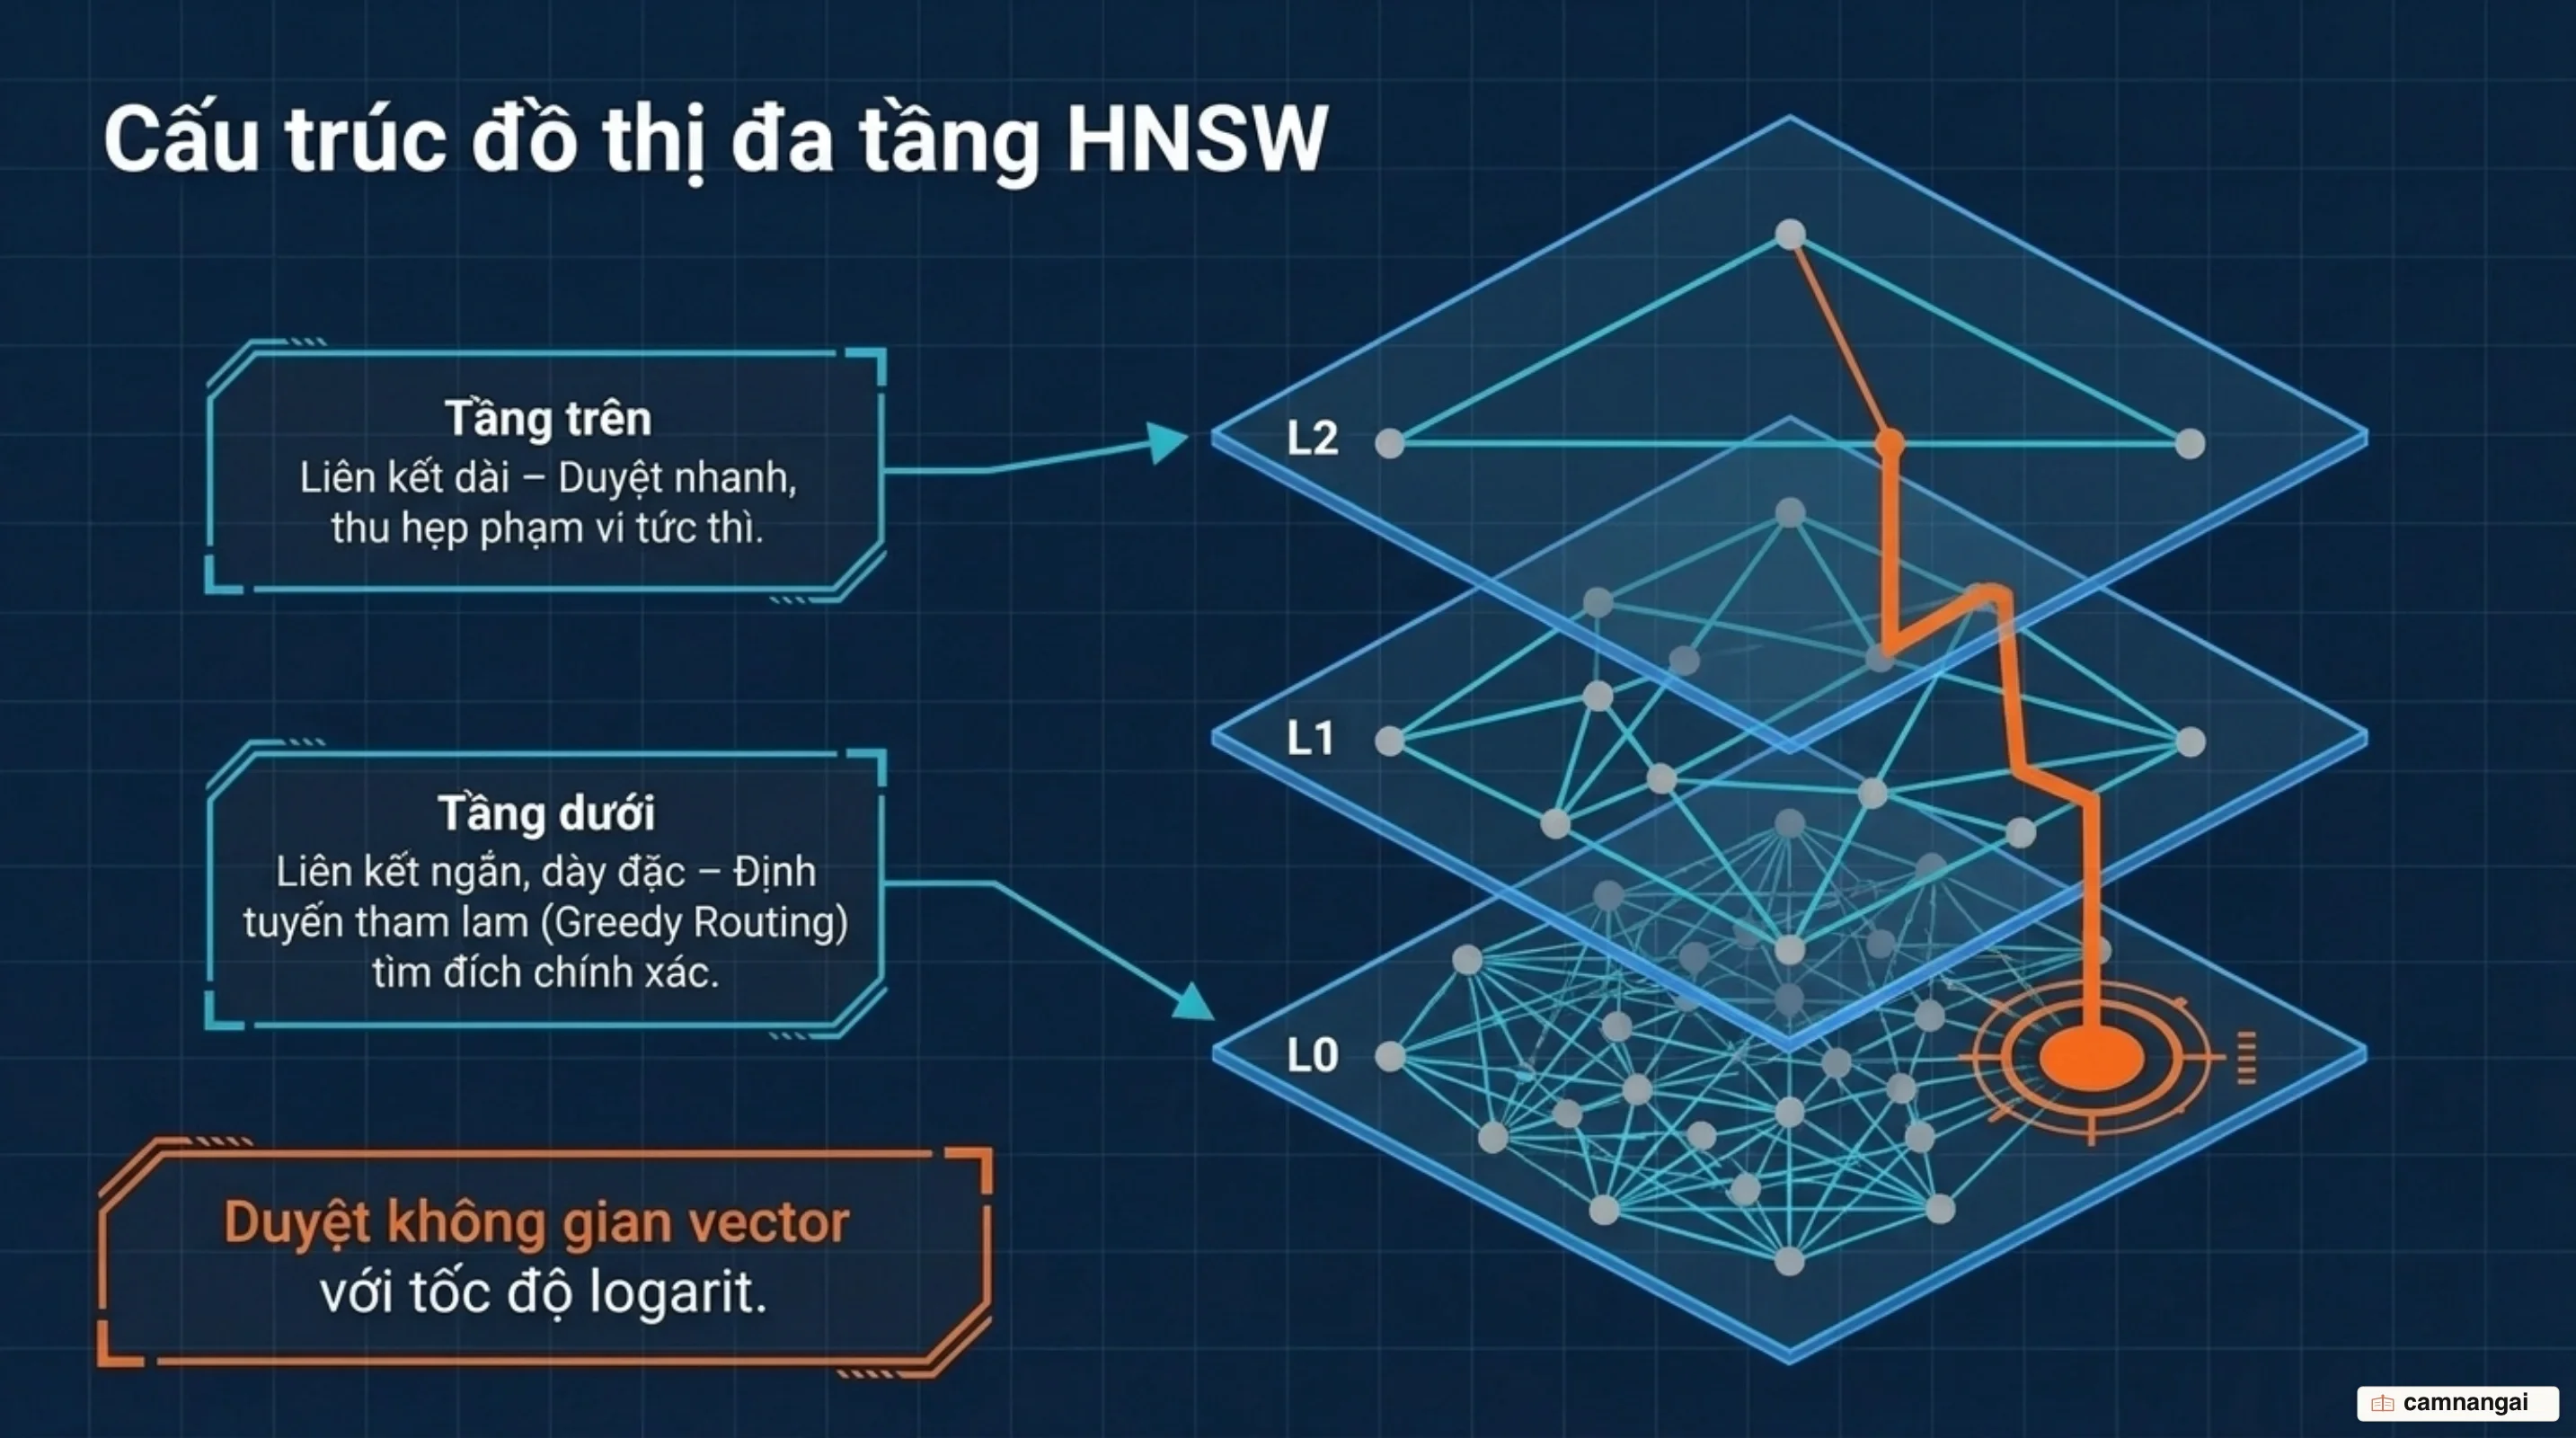
- Cấu trúc: Kết hợp giữa Probability Skip List và Navigable Small World graphs. Tầng cao nhất chứa các liên kết dài (zoom-out) để nhảy nhanh qua các vùng dữ liệu, tầng thấp nhất chứa liên kết ngắn và dày đặc (zoom-in) để tìm điểm chính xác.
- Tham số kiến trúc:
M: Số lượng láng giềng tối đa trên mỗi node. Mức sử dụng bộ nhớ (RAM) tỷ lệ thuận với $M$. Ví dụ với tập Sift1M, $M=2$ tốn khoảng 0.5GB nhưng $M=512$ có thể lên tới 5GB.m_L: Hệ số nhân cấp độ (level multiplier), quy định phân phối các node giữa các tầng. Quy tắc tối ưu là $m_L = 1/\ln(M)$.efConstruction&efSearch: Điều chỉnh sự cân bằng giữa độ phủ (recall) và độ trễ (latency).
Tối ưu hai đầu: Contextual Retrieval và Reranking
Kiến trúc retrieval trong RAG hiện đại yêu cầu tối ưu hóa ở cả hai đầu của quy trình truy hồi:
1. Tiền truy hồi (Pre-retrieval): Contextual Retrieval
Việc bổ sung ngữ cảnh toàn cục ngắn gọn vào từng chunk trước khi embed giúp giảm tỷ lệ truy hồi lỗi đến 49%:
- Ví dụ: Chunk gốc là "Doanh thu tăng 3%" sẽ được chuyển thành "Trong báo cáo tài chính Q2/2023 của ACME Corp, doanh thu tăng 3%".
- Chi phí: Nhờ tính năng Prompt Caching, chi phí tạo contextualized chunks chỉ khoảng 1.02 USD trên mỗi 1 triệu tokens tài liệu.
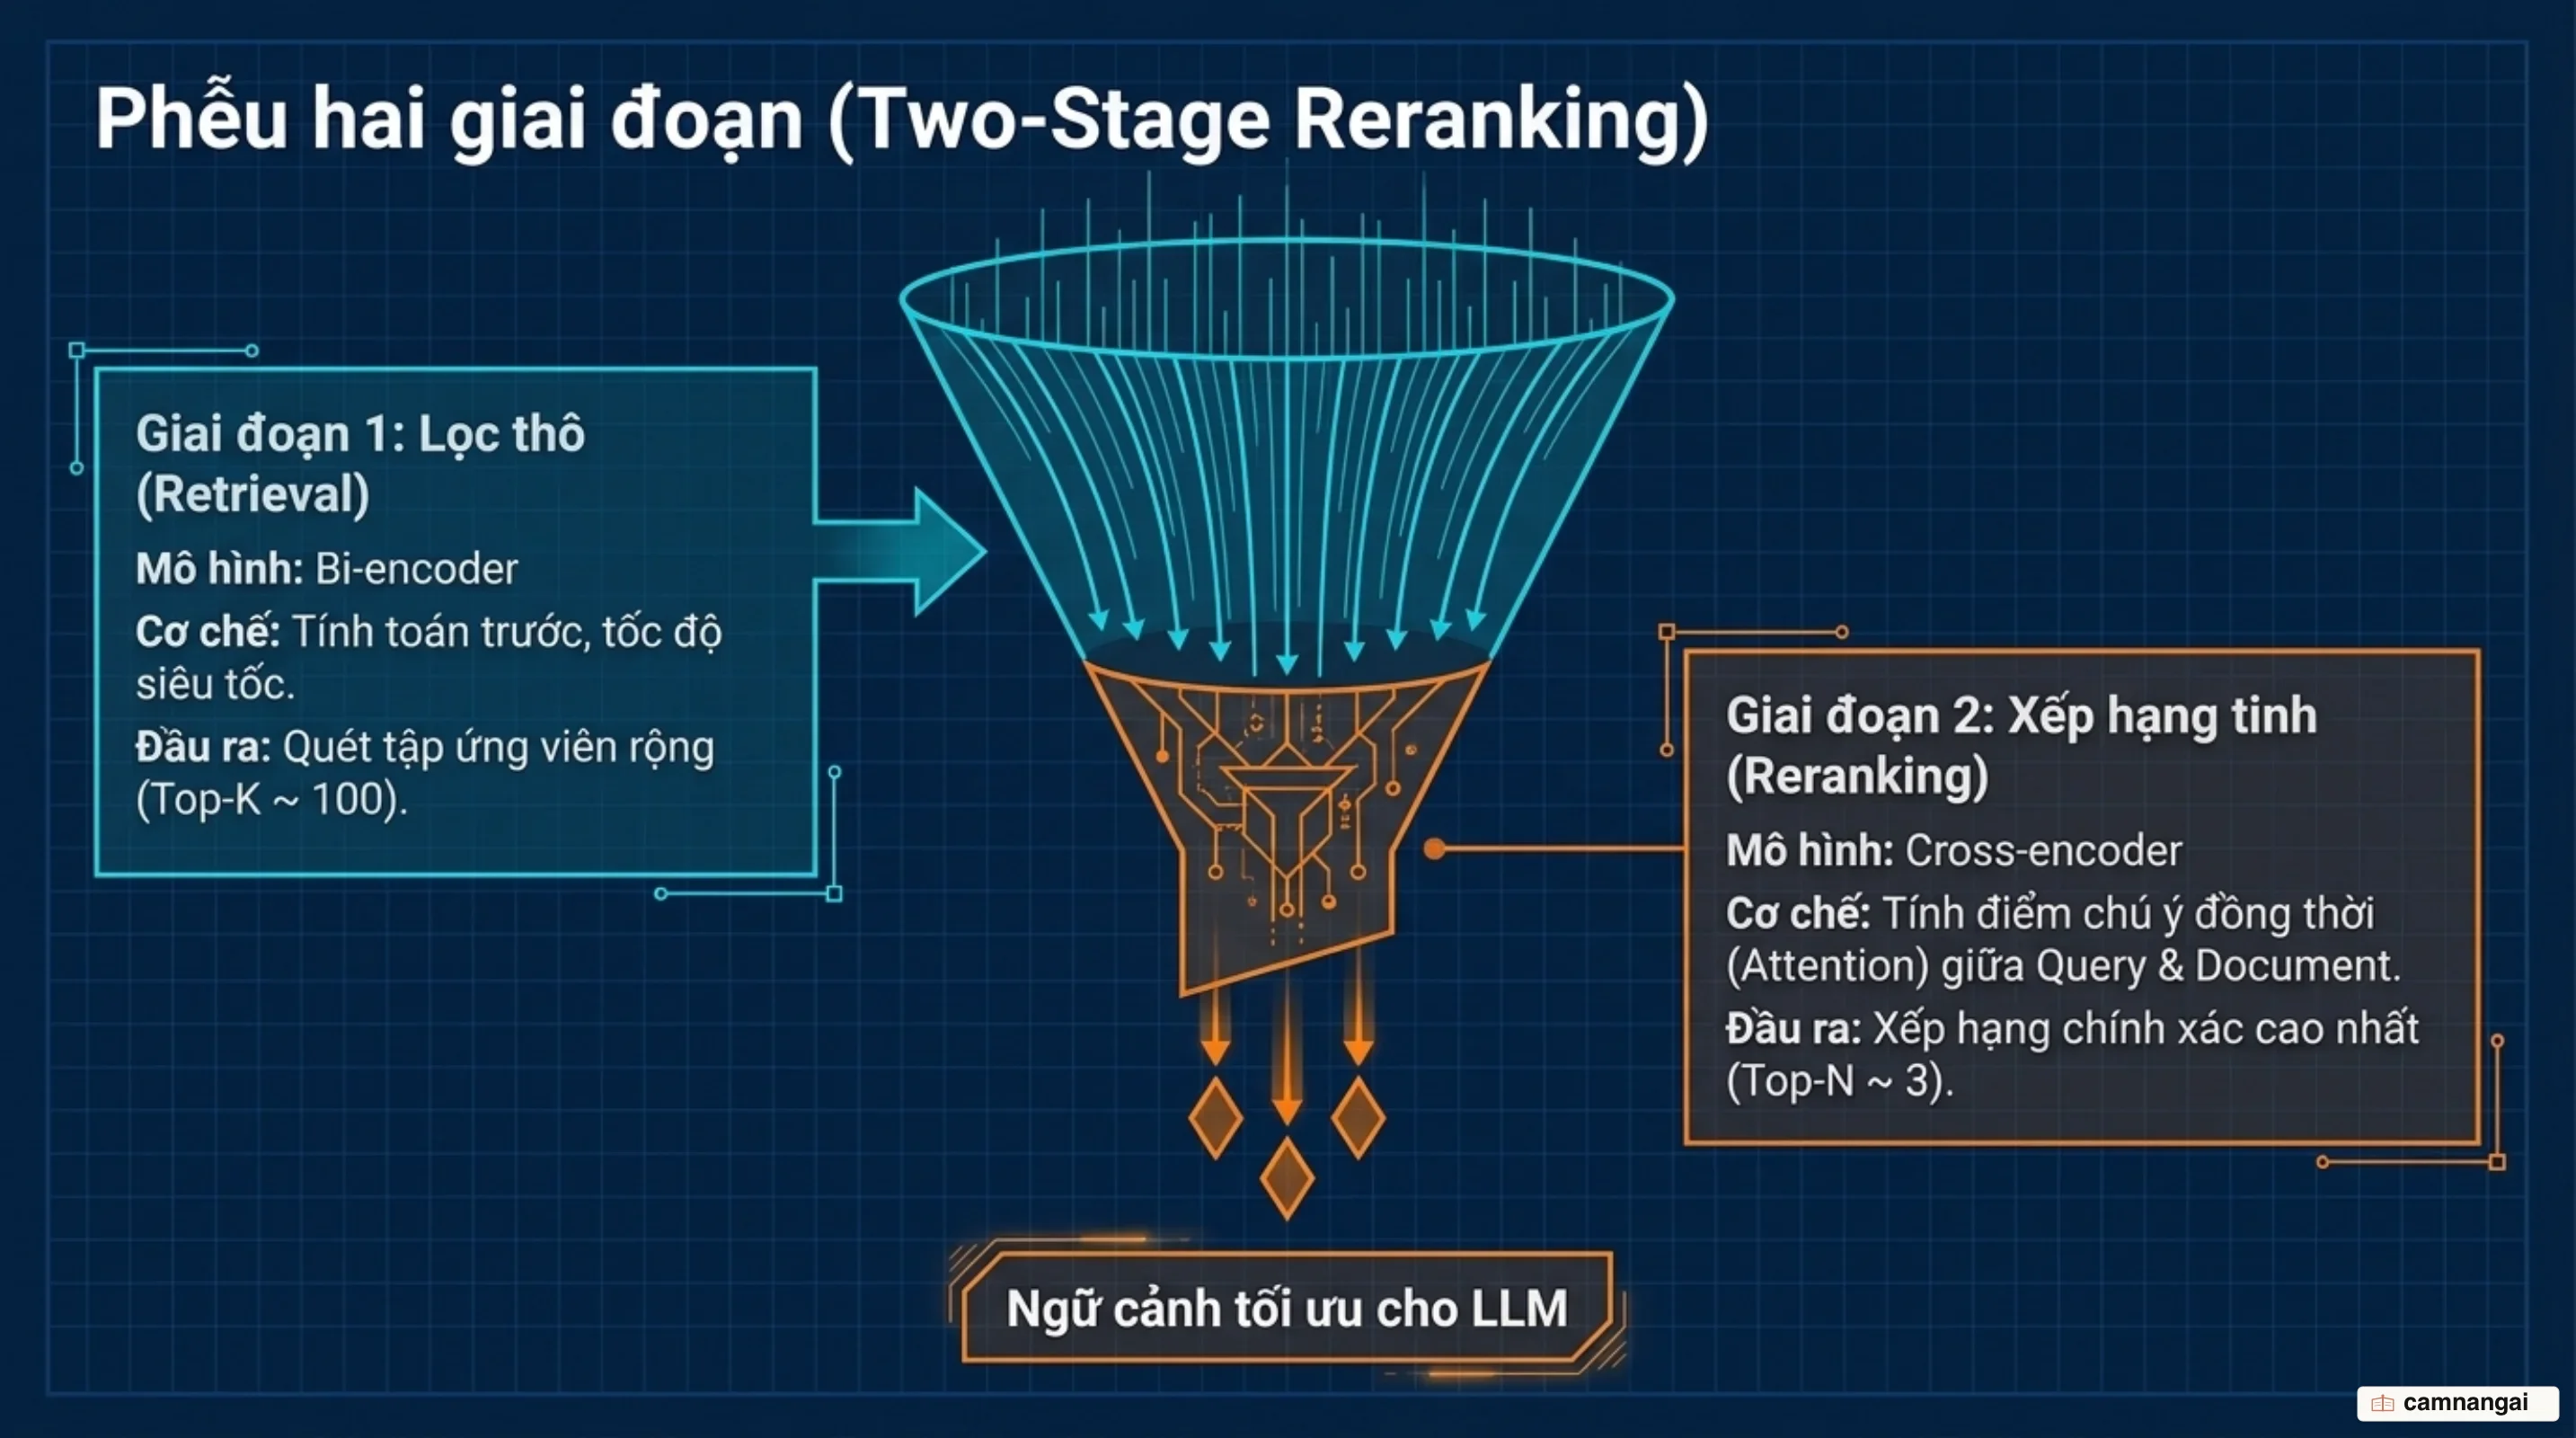
2. Hậu truy hồi (Post-retrieval): Reranking
Retriever ban đầu tập trung vào Recall@K (tìm nhiều ứng viên nhanh chóng). Sau đó, một Reranker (Cross-encoder) sẽ sắp xếp lại danh sách Top-K này để đạt Precision tối đa. Kết hợp Contextual Retrieval và Reranking có thể giảm tỷ lệ lỗi truy hồi lên đến 67%.
from llama_index.core.postprocessor import SentenceTransformerRerank

# Sử dụng cross-encoder/ms-marco-MiniLM-L6-v2 để cân bằng giữa tốc độ và chất lượng
rerank = SentenceTransformerRerank(
    model="cross-encoder/ms-marco-MiniLM-L6-v2", top_n=3
)
Đánh giá hiệu năng truy hồi: Recall, Precision và MRR
Đánh giá hệ thống truy hồi cần các chỉ số định lượng thay vì cảm tính:
- Recall@K: Tỷ lệ tài liệu liên quan được tìm thấy trong K kết quả đầu tiên.
- Context Precision: Tỷ lệ chính xác của các đoạn văn bản được đưa vào prompt, đảm bảo thông tin liên quan nằm ở nhóm đầu và hạn chế nhiễu cho mô hình.
- Mean Reciprocal Rank (MRR): Đánh giá vị trí xuất hiện của kết quả đúng đầu tiên. MRR sử dụng logic nghịch đảo: nếu kết quả đúng ở vị trí 1, điểm là 1; vị trí 2 là 0.5 (1/2); vị trí 3 là 0.33 (1/3). Chỉ số này ưu tiên các hệ thống xếp hạng tài liệu phù hợp nhất ngay đỉnh danh sách.
Khi nào hệ thống của bạn thực sự cần nâng cấp tầng retrieval?
Việc triển khai Hybrid Search hay Reranking làm tăng độ trễ và chi phí hạ tầng. Hãy cân nhắc nâng cấp khi:
- Dữ liệu vượt ngưỡng: Nếu dữ liệu dưới 200.000 tokens (~500 trang), hãy tận dụng Prompt Caching để đưa toàn bộ vào ngữ cảnh thay vì xây dựng pipeline RAG phức tạp.
- Lỗi "Lost in the middle": LLM bắt đầu bỏ sót thông tin quan trọng nằm ở giữa các văn bản dài.
- Lỗi ngữ cảnh: Mô hình trả lời đúng dựa trên văn bản nhận được, nhưng nội dung đó không trả lời đúng câu hỏi của người dùng do retriever trích xuất nhầm chunk.
Nguyên tắc ra quyết định: Luôn bắt đầu với Naive RAG (Top-K vector search đơn giản). Chỉ nâng cấp lên Hybrid Search khi gặp vấn đề với mã hiệu và thuật ngữ chuyên ngành, và bổ sung Cross-Encoder Reranking khi cần độ chính xác cao nhất cho môi trường production.
Tài liệu tham khảo
- Building Performant RAG Applications for Production — LlamaIndex
- Contextual Retrieval in AI Systems — Anthropic
- Hierarchical Navigable Small Worlds (HNSW) — Pinecone
- Hybrid Search Explained — Weaviate
- Introducing the hybrid index — Pinecone
- Rerankers and Two-Stage Retrieval — Pinecone
- Retrieval-Augmented Generation for LLMs: A Survey — ArXiv