Generation trong RAG là giai đoạn cuối cùng trong pipeline RAG, nơi mô hình ngôn ngữ lớn (LLM) tổng hợp các phân đoạn dữ liệu được truy xuất để tạo ra phản hồi.
Về mặt kiến trúc hệ thống, tham số mô hình (weights) đóng vai trò là trí nhớ dài hạn (đã học), trong khi dữ liệu đầu vào (prompt) là trí nhớ ngắn hạn. Cơ chế này thiết lập khả năng truy cập thông tin thực tế tại thời điểm inference (inference-time access) mà không cần retraining, đảm bảo tính nhất quán dữ liệu với độ trễ thấp hơn đáng kể so với fine-tuning.
Sử dụng Generation trong RAG giúp hệ thống đạt độ chính xác thực tế cao hơn fine-tuning. Nếu fine-tuning tương đương việc học thuộc lòng cho một kỳ thi thì Generation giống như một kỳ thi mở với các ghi chú có sẵn. LLM hoạt động như một cỗ máy xử lý thông tin dựa trên bằng chứng thay vì tự suy đoán từ trọng số tĩnh sau huấn luyện.
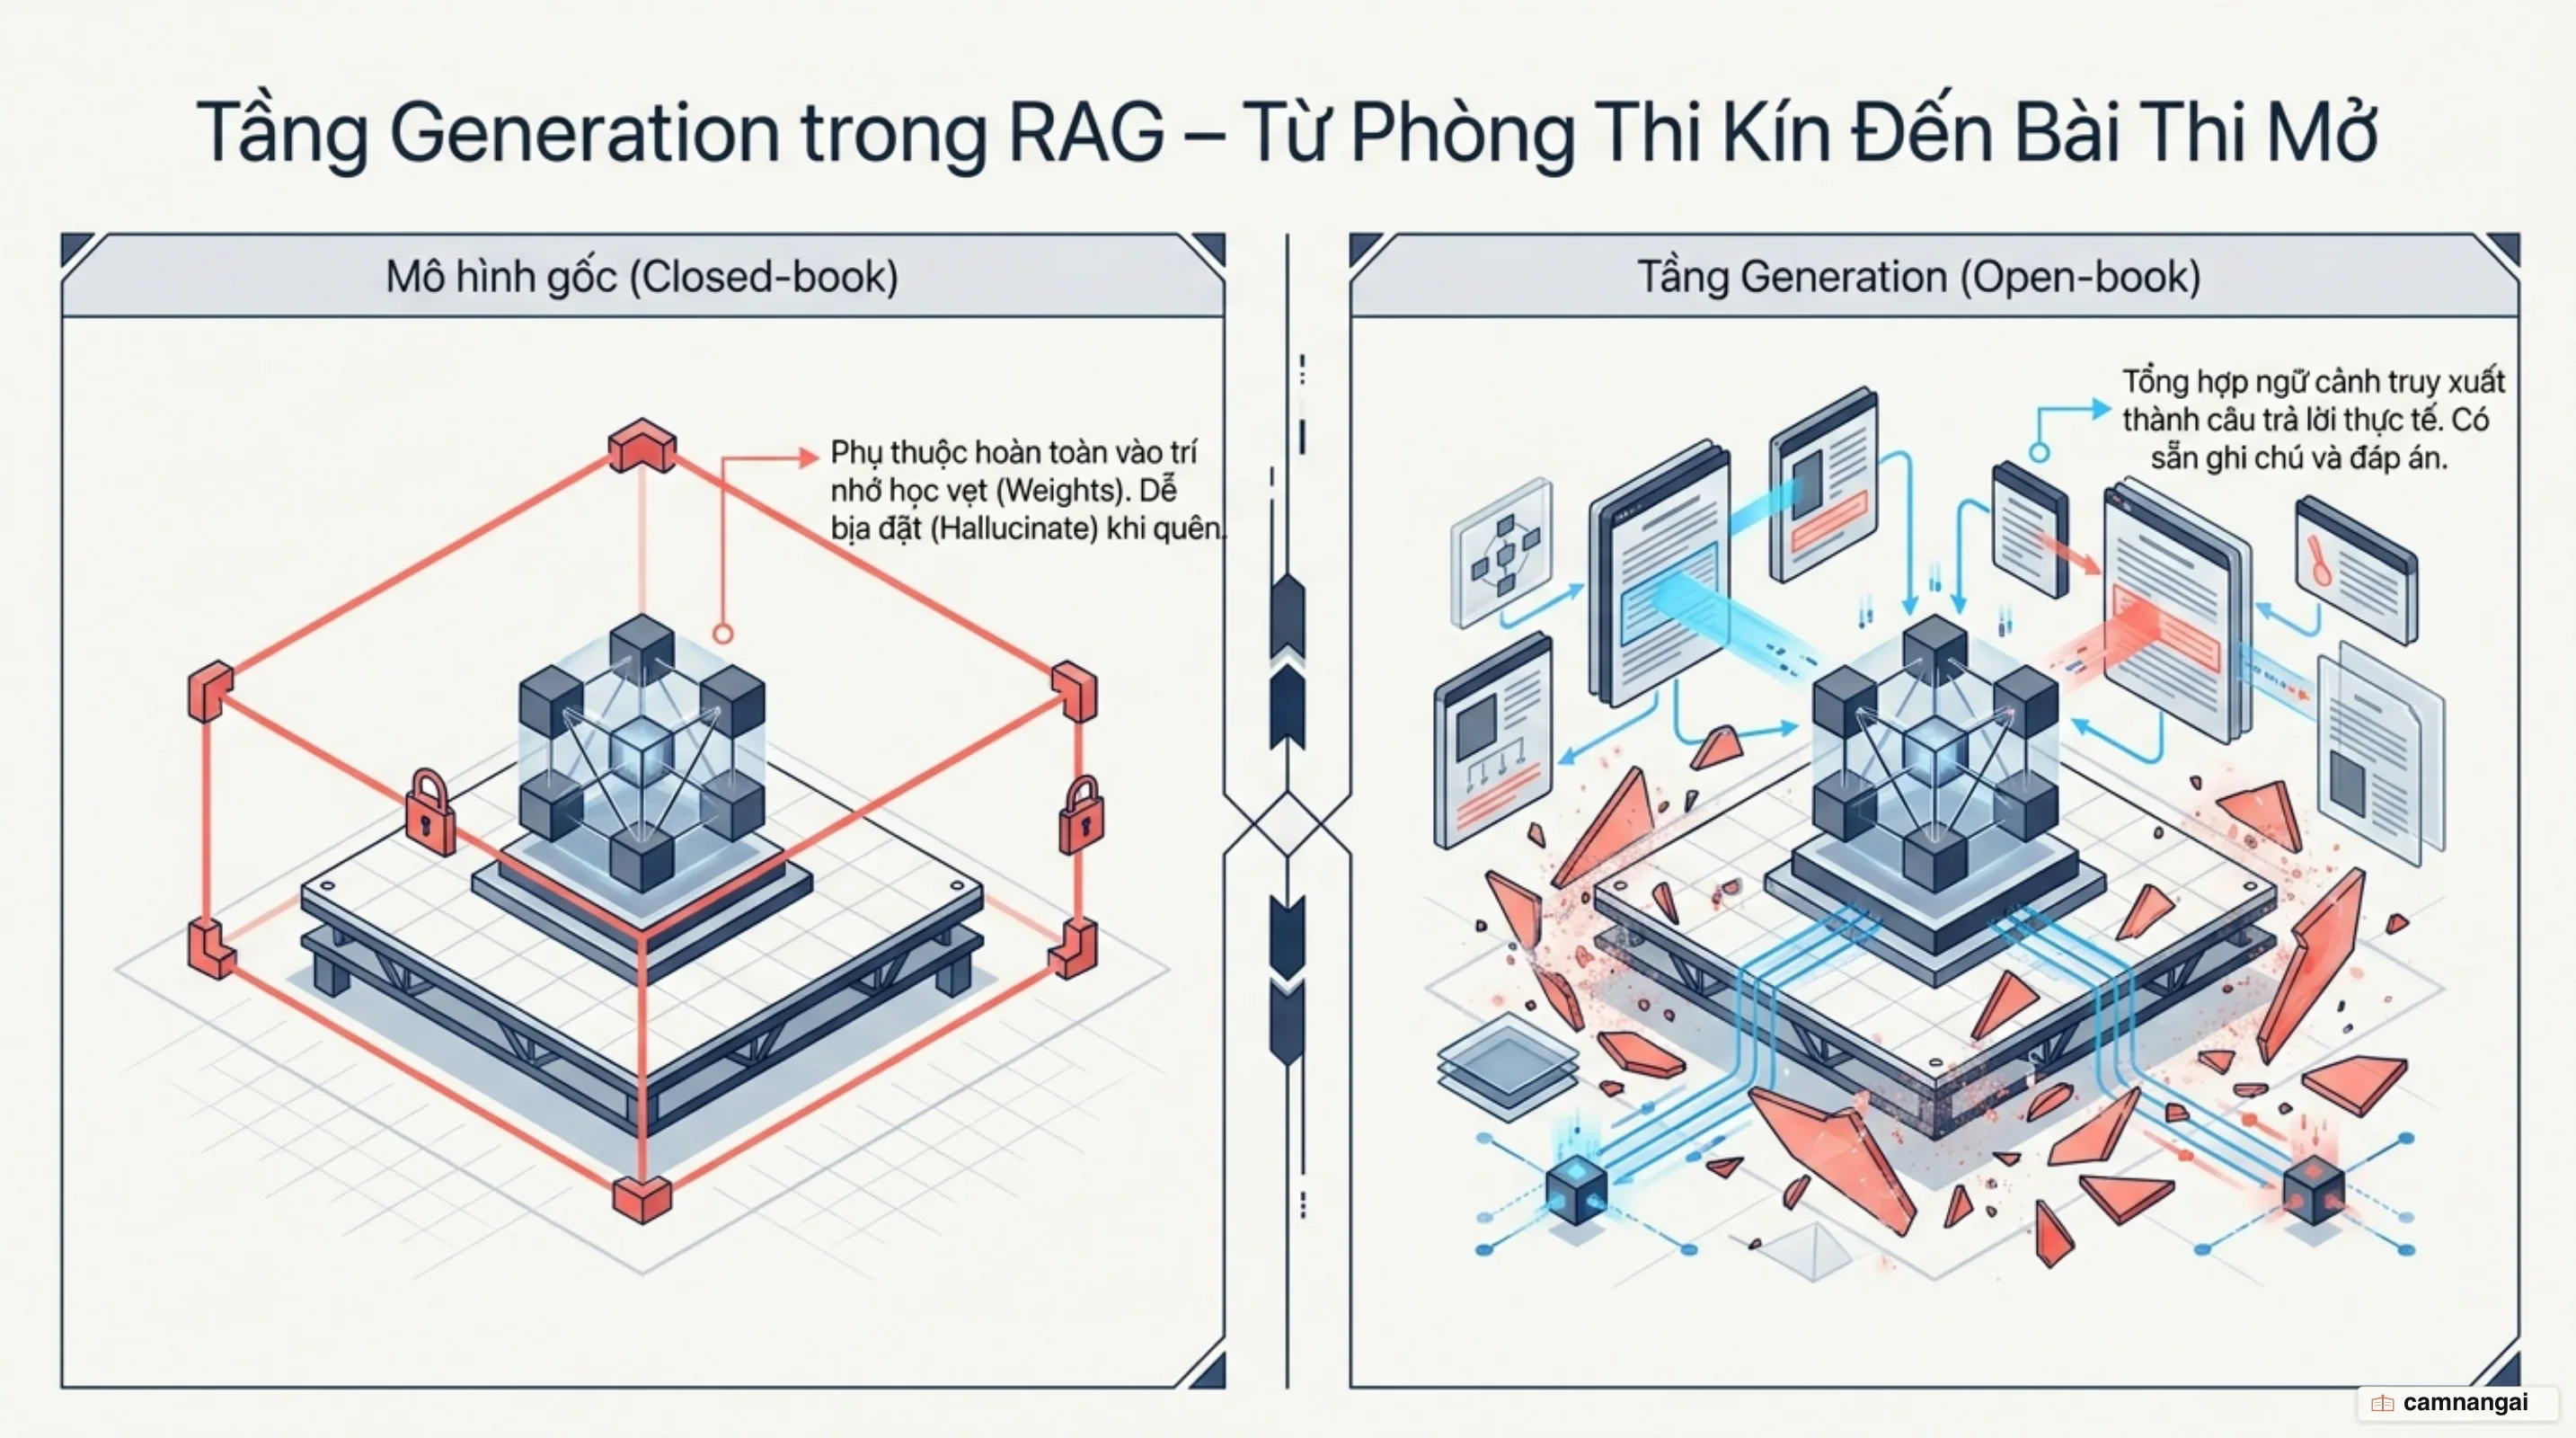
Generation là gì và vai trò của tầng sinh trong pipeline RAG?
Tầng Generation là bộ phận xử lý logic cuối cùng, chuyển đổi các chunk văn bản thô thành câu trả lời có cấu trúc. Khác biệt cốt lõi nằm ở nguồn tri thức: thay vì dựa vào các trọng số tĩnh được đóng băng từ quá trình huấn luyện, Generator sử dụng ngữ cảnh động (dynamic context) được truyền trực tiếp vào input prompt.
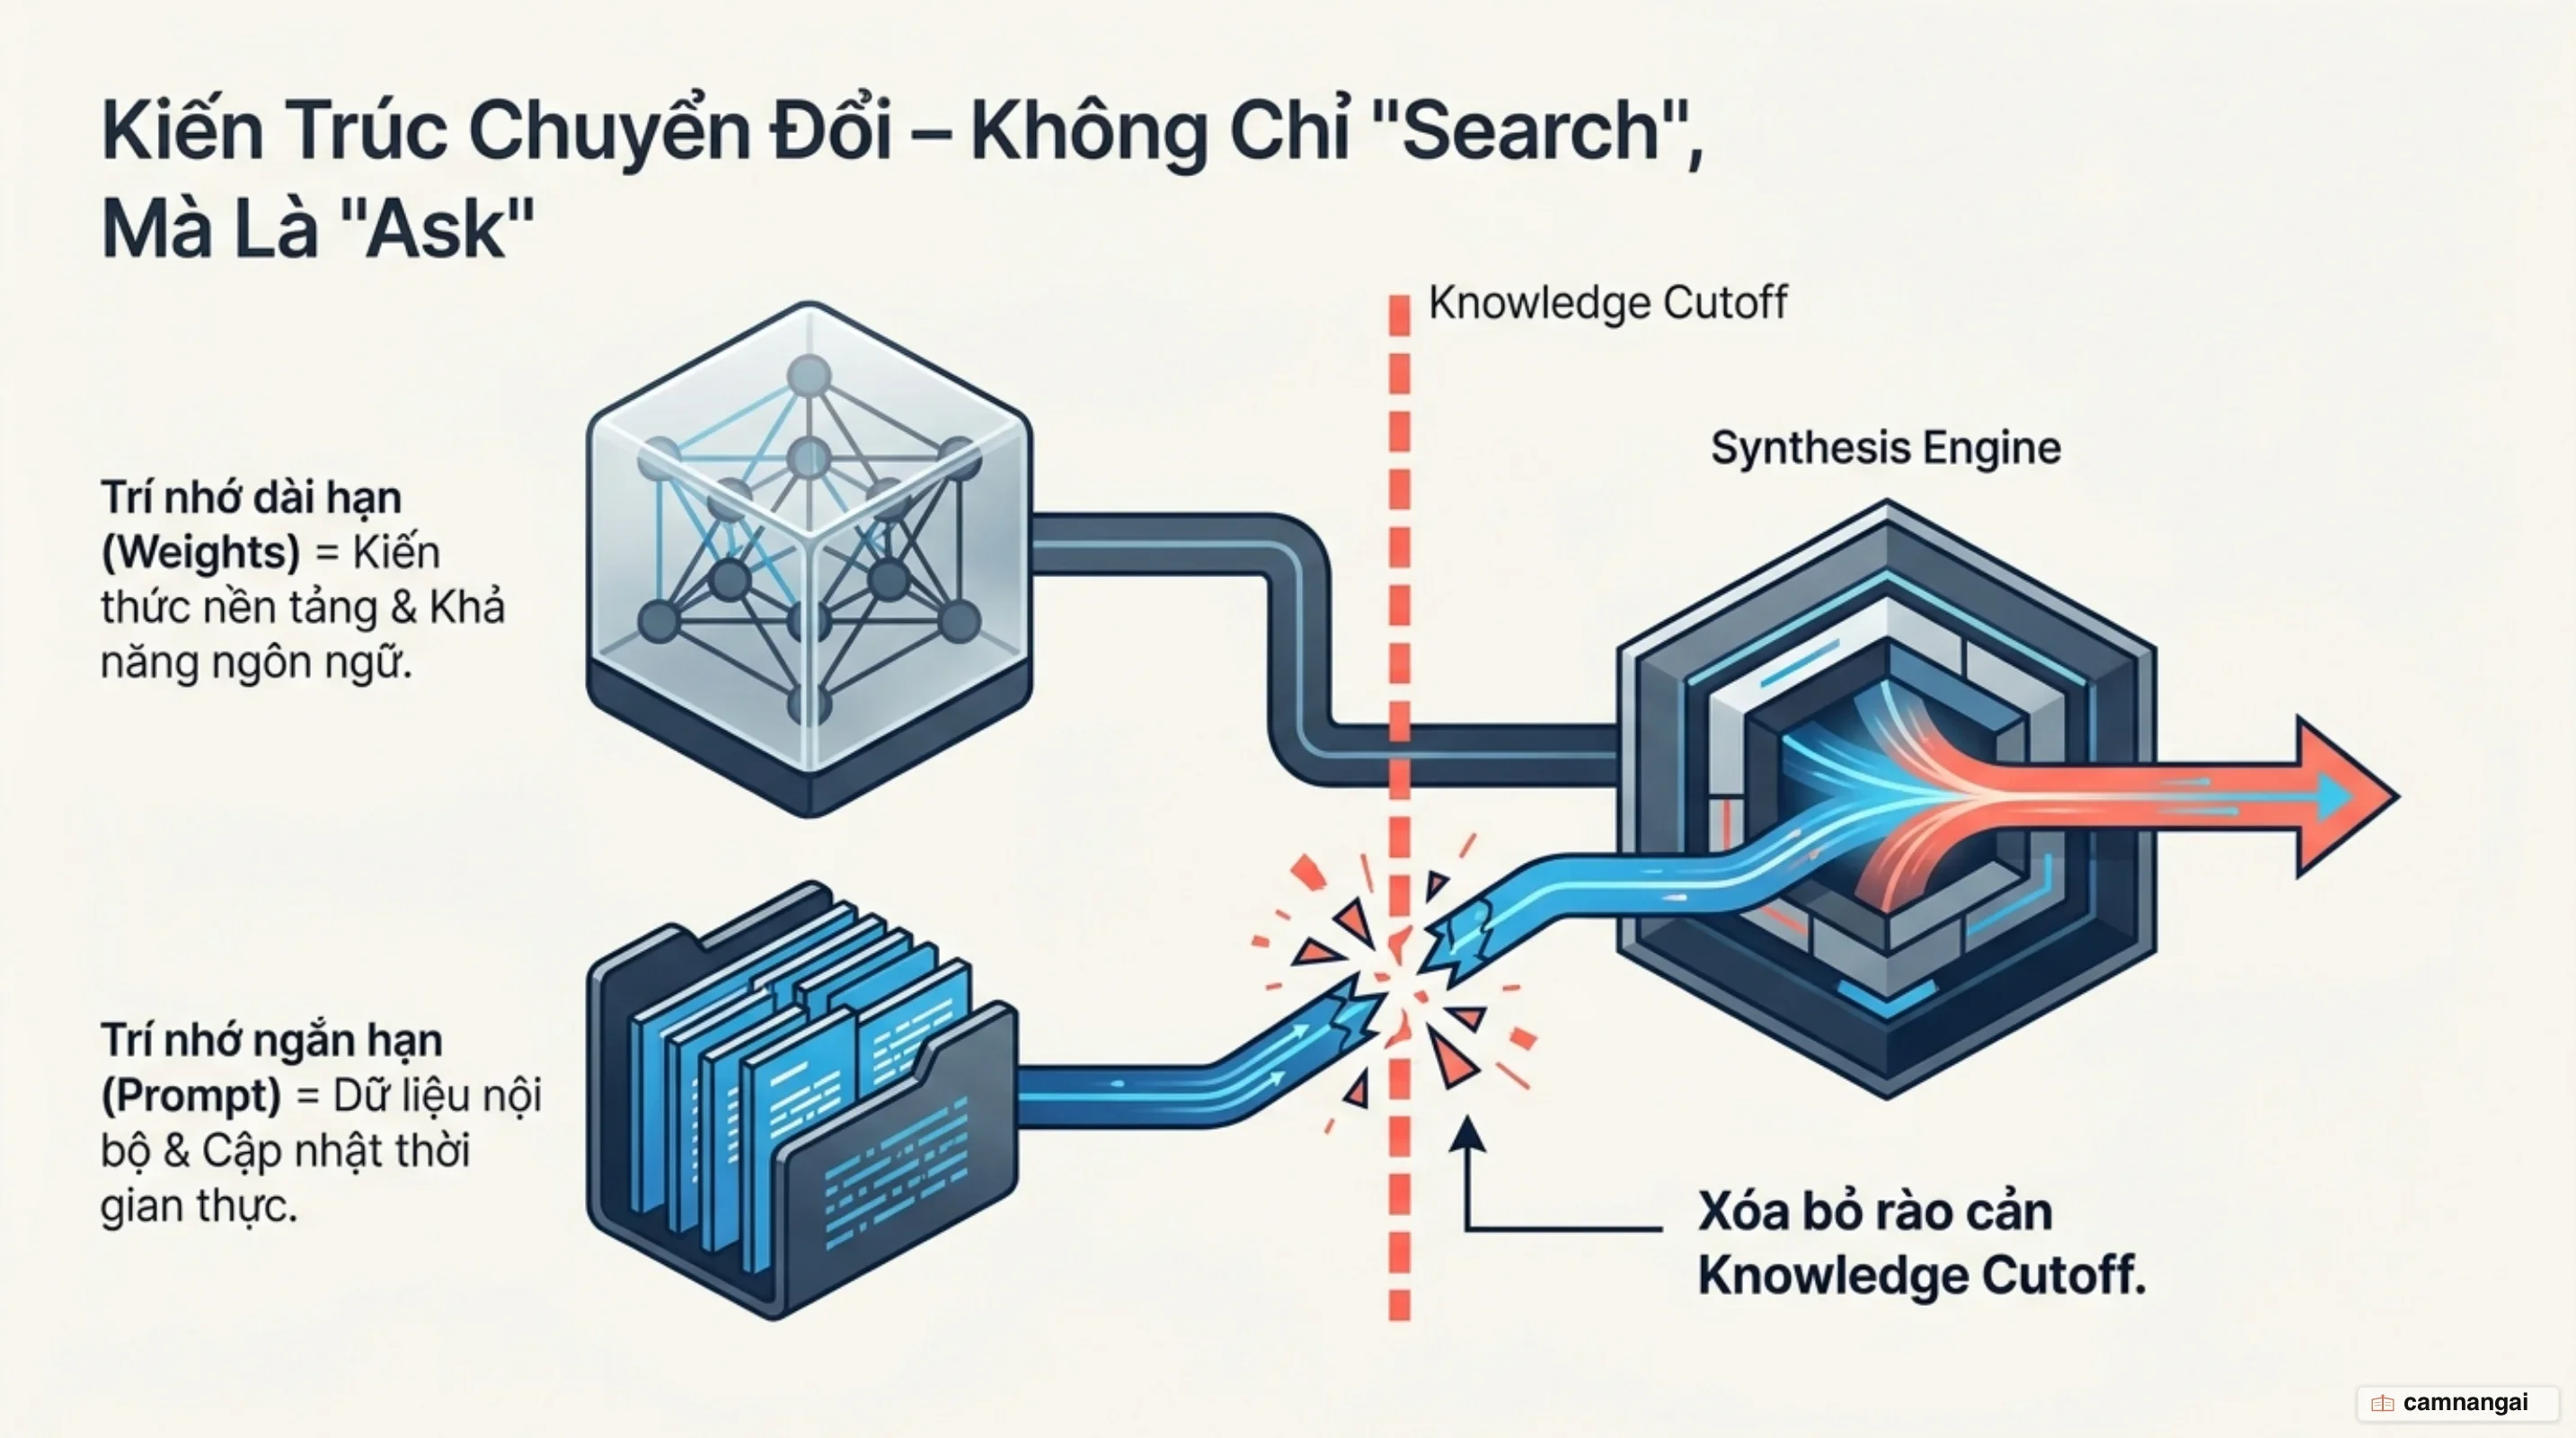
Vai trò chính của tầng này là triệt tiêu vấn đề Knowledge Cutoff (ngắt quãng tri thức). Ví dụ, các mô hình như GPT-4o-mini có kiến thức bị ngắt quãng tại mốc thời gian huấn luyện cố định. Nếu không có RAG, mô hình không thể phản hồi chính xác về các sự kiện hay tài liệu phát sinh sau đó. Bằng cách cung cấp dữ liệu mới nhất dưới dạng context vào cửa sổ ngữ cảnh, Generator có thể vượt qua giới hạn thời gian huấn luyện. Đây là phương pháp tối ưu để duy trì tính chính xác thực tế mà không tốn chi phí tài nguyên cho việc tái huấn luyện liên tục.
Hơn nữa, tầng sinh đóng vai trò tổng hợp đa nguồn (multi-source synthesis). Khi hệ thống truy xuất được nhiều đoạn tài liệu từ các báo cáo khác nhau, Generator không đơn thuần ghép nối các đoạn văn bản cơ học. Mô hình đọc hiểu, đối chiếu sự mâu thuẫn giữa các đoạn trích, và diễn đạt lại thành một câu trả lời mạch lạc theo đúng ý định của người dùng.
Cơ chế Prompt Augmentation: Ghép nối truy vấn và ngữ cảnh truy xuất
Prompt Augmentation là quá trình kỹ thuật tích hợp Top-K chunks (thường là Top-20) vào cửa sổ ngữ cảnh của mô hình ngôn ngữ lớn (LLM). Tuy nhiên, việc chia nhỏ tài liệu (chunking) thường dẫn đến hiện tượng Context Conundrum (mất mát ngữ cảnh biên). Một chunk riêng lẻ chứa thông tin "doanh thu tăng 3%" sẽ trở nên vô nghĩa nếu Generator không biết đó là tài liệu của doanh nghiệp nào hay trong quý tài chính nào.
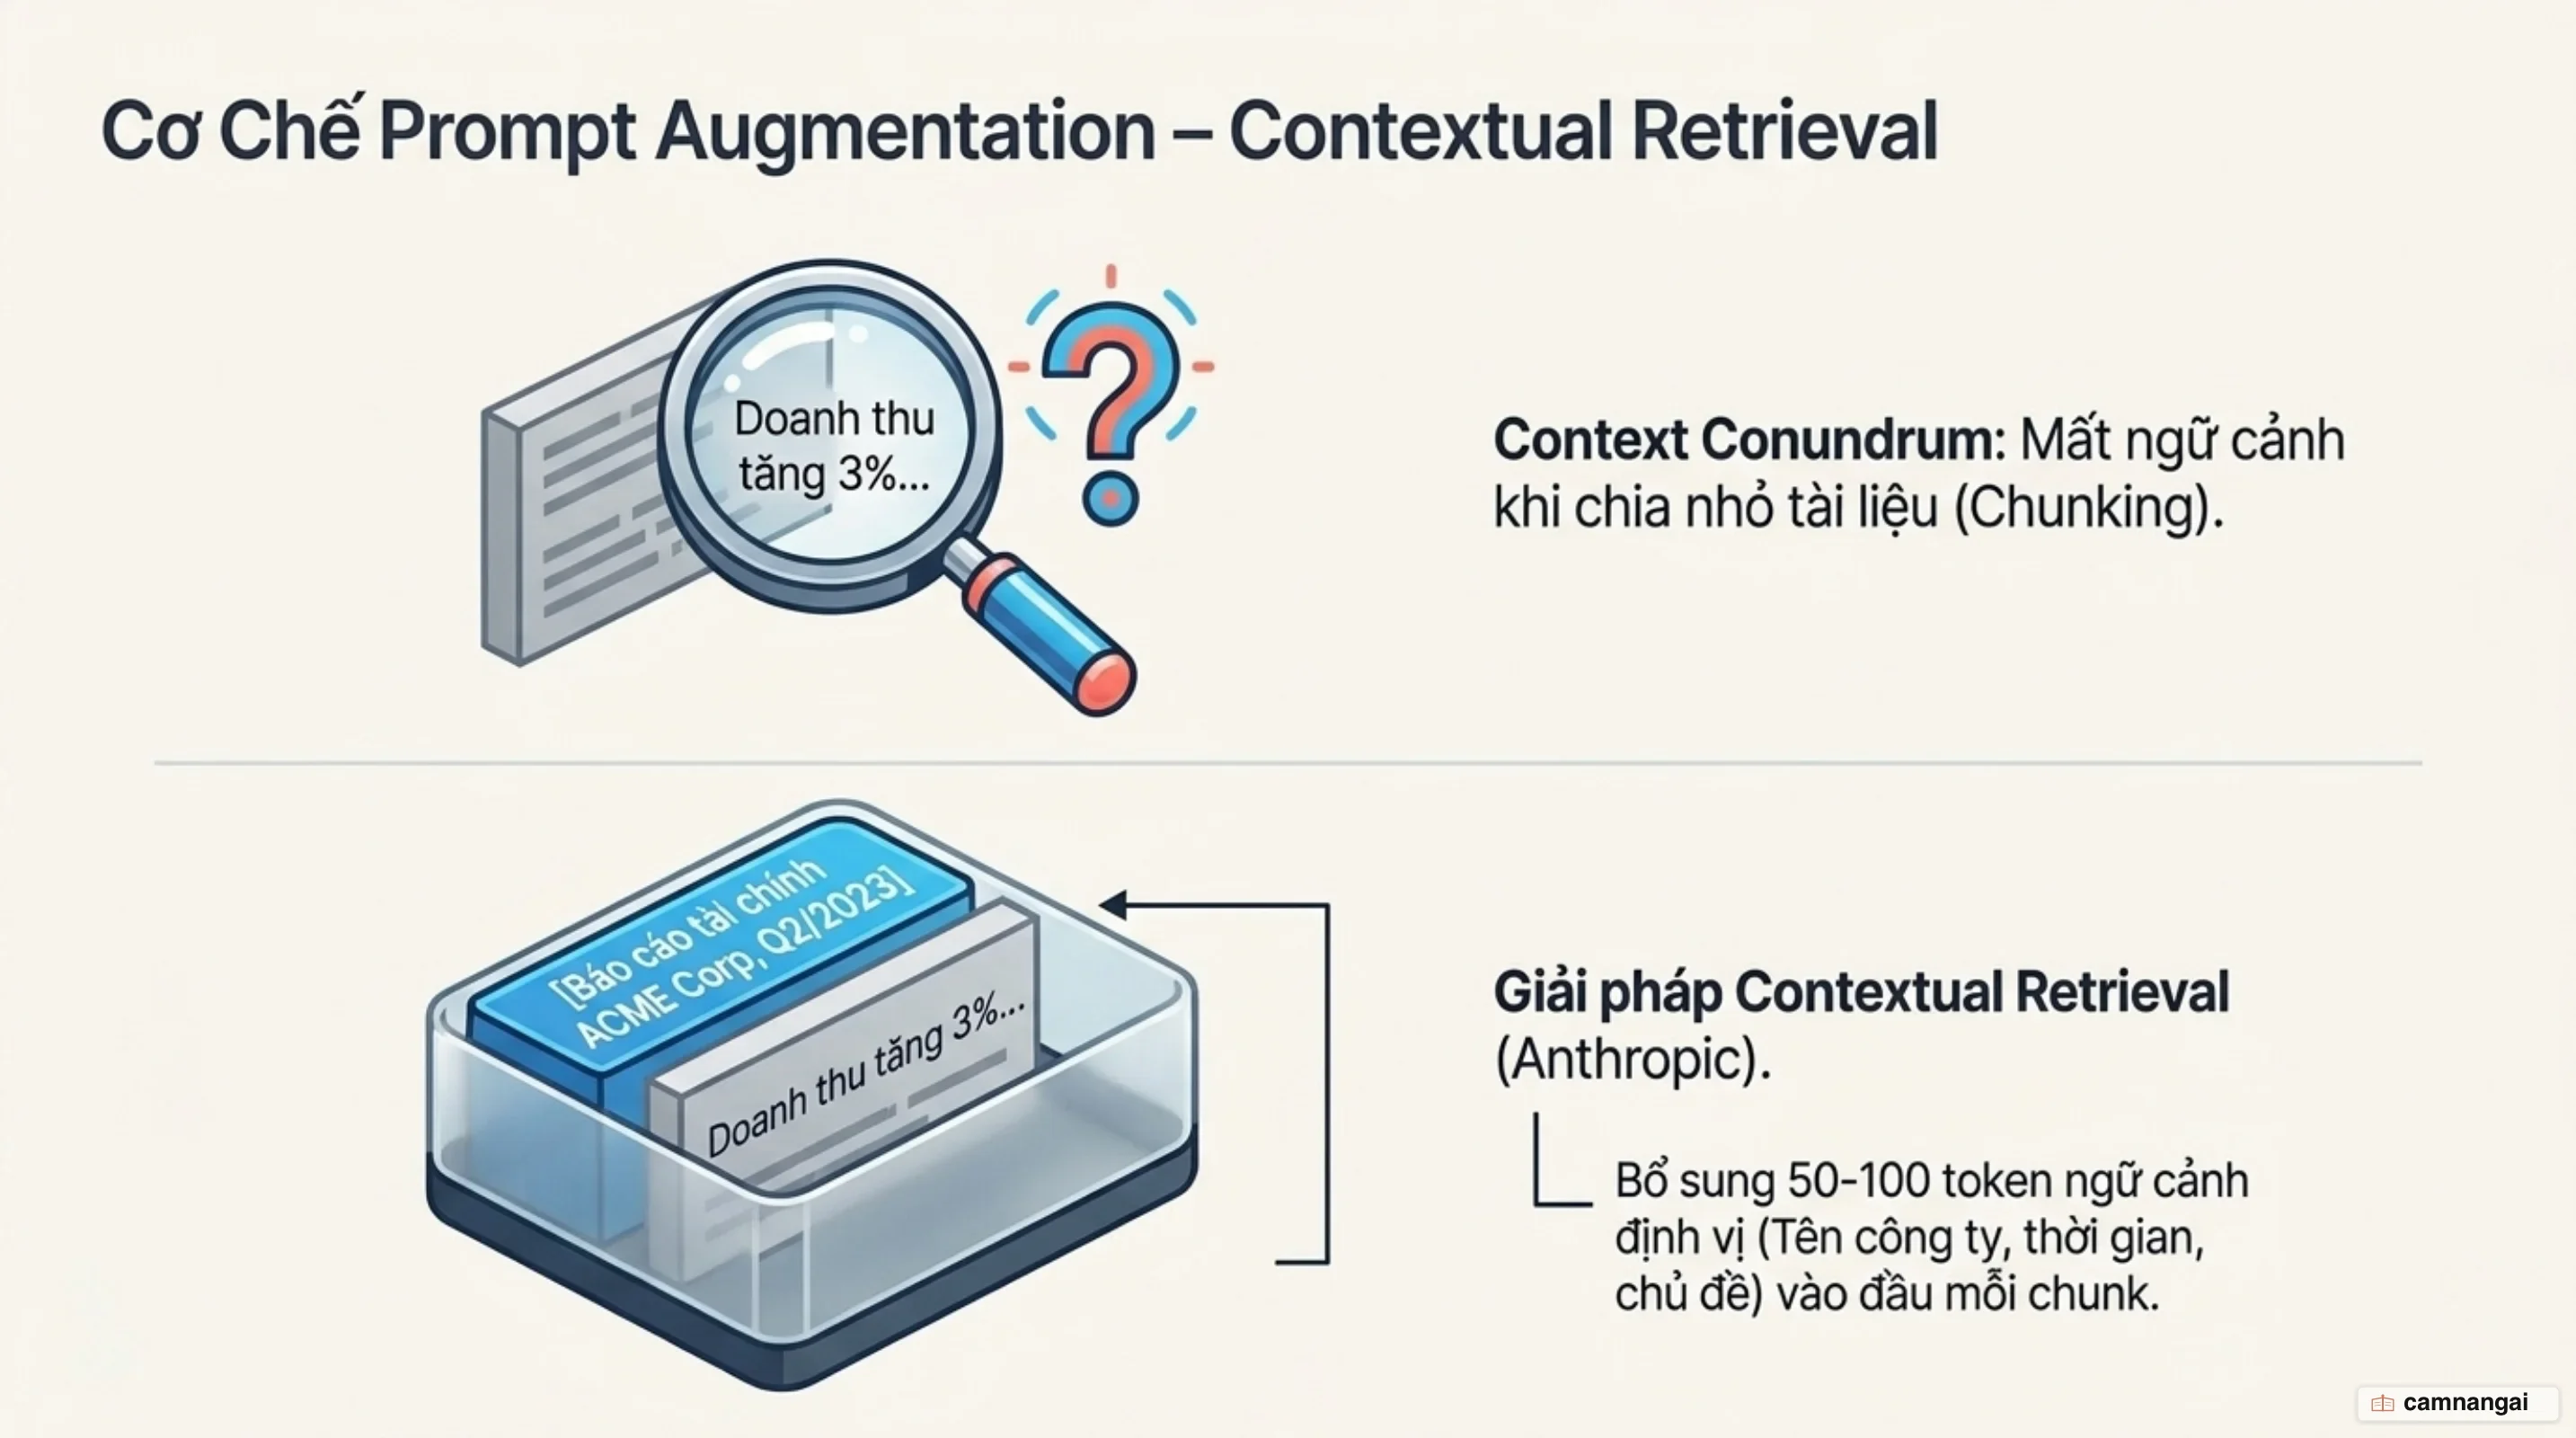
Kỹ thuật Contextual Retrieval giải quyết vấn đề này bằng cách thêm thông tin định vị (situating context) dài khoảng 50–100 tokens vào từng chunk trước khi embedding. Thực tế triển khai cho thấy phương pháp này giảm tỷ lệ truy xuất lỗi tới 49% (và lên tới 67% nếu kết hợp reranking). Kỹ sư cần chú ý đến tham số chunk overlap để duy trì tính liên kết ngữ nghĩa giữa các đoạn văn bản bị cắt rời.
Cấu trúc prompt template điển hình để định vị ngữ cảnh:
<document>
{{WHOLE_DOCUMENT}}
</document>
Here is the chunk we want to situate within the whole document
<chunk>
{{CHUNK_CONTENT}}
</chunk>
Please give a short succinct context to situate this chunk within the overall document for the purposes of improving search retrieval of the chunk.
Các chiến lược tổng hợp câu trả lời (Response Synthesis)
Tùy vào yêu cầu về độ trễ và độ chi tiết, kỹ sư có thể lựa chọn các chiến lược tổng hợp câu trả lời (Response Synthesis):
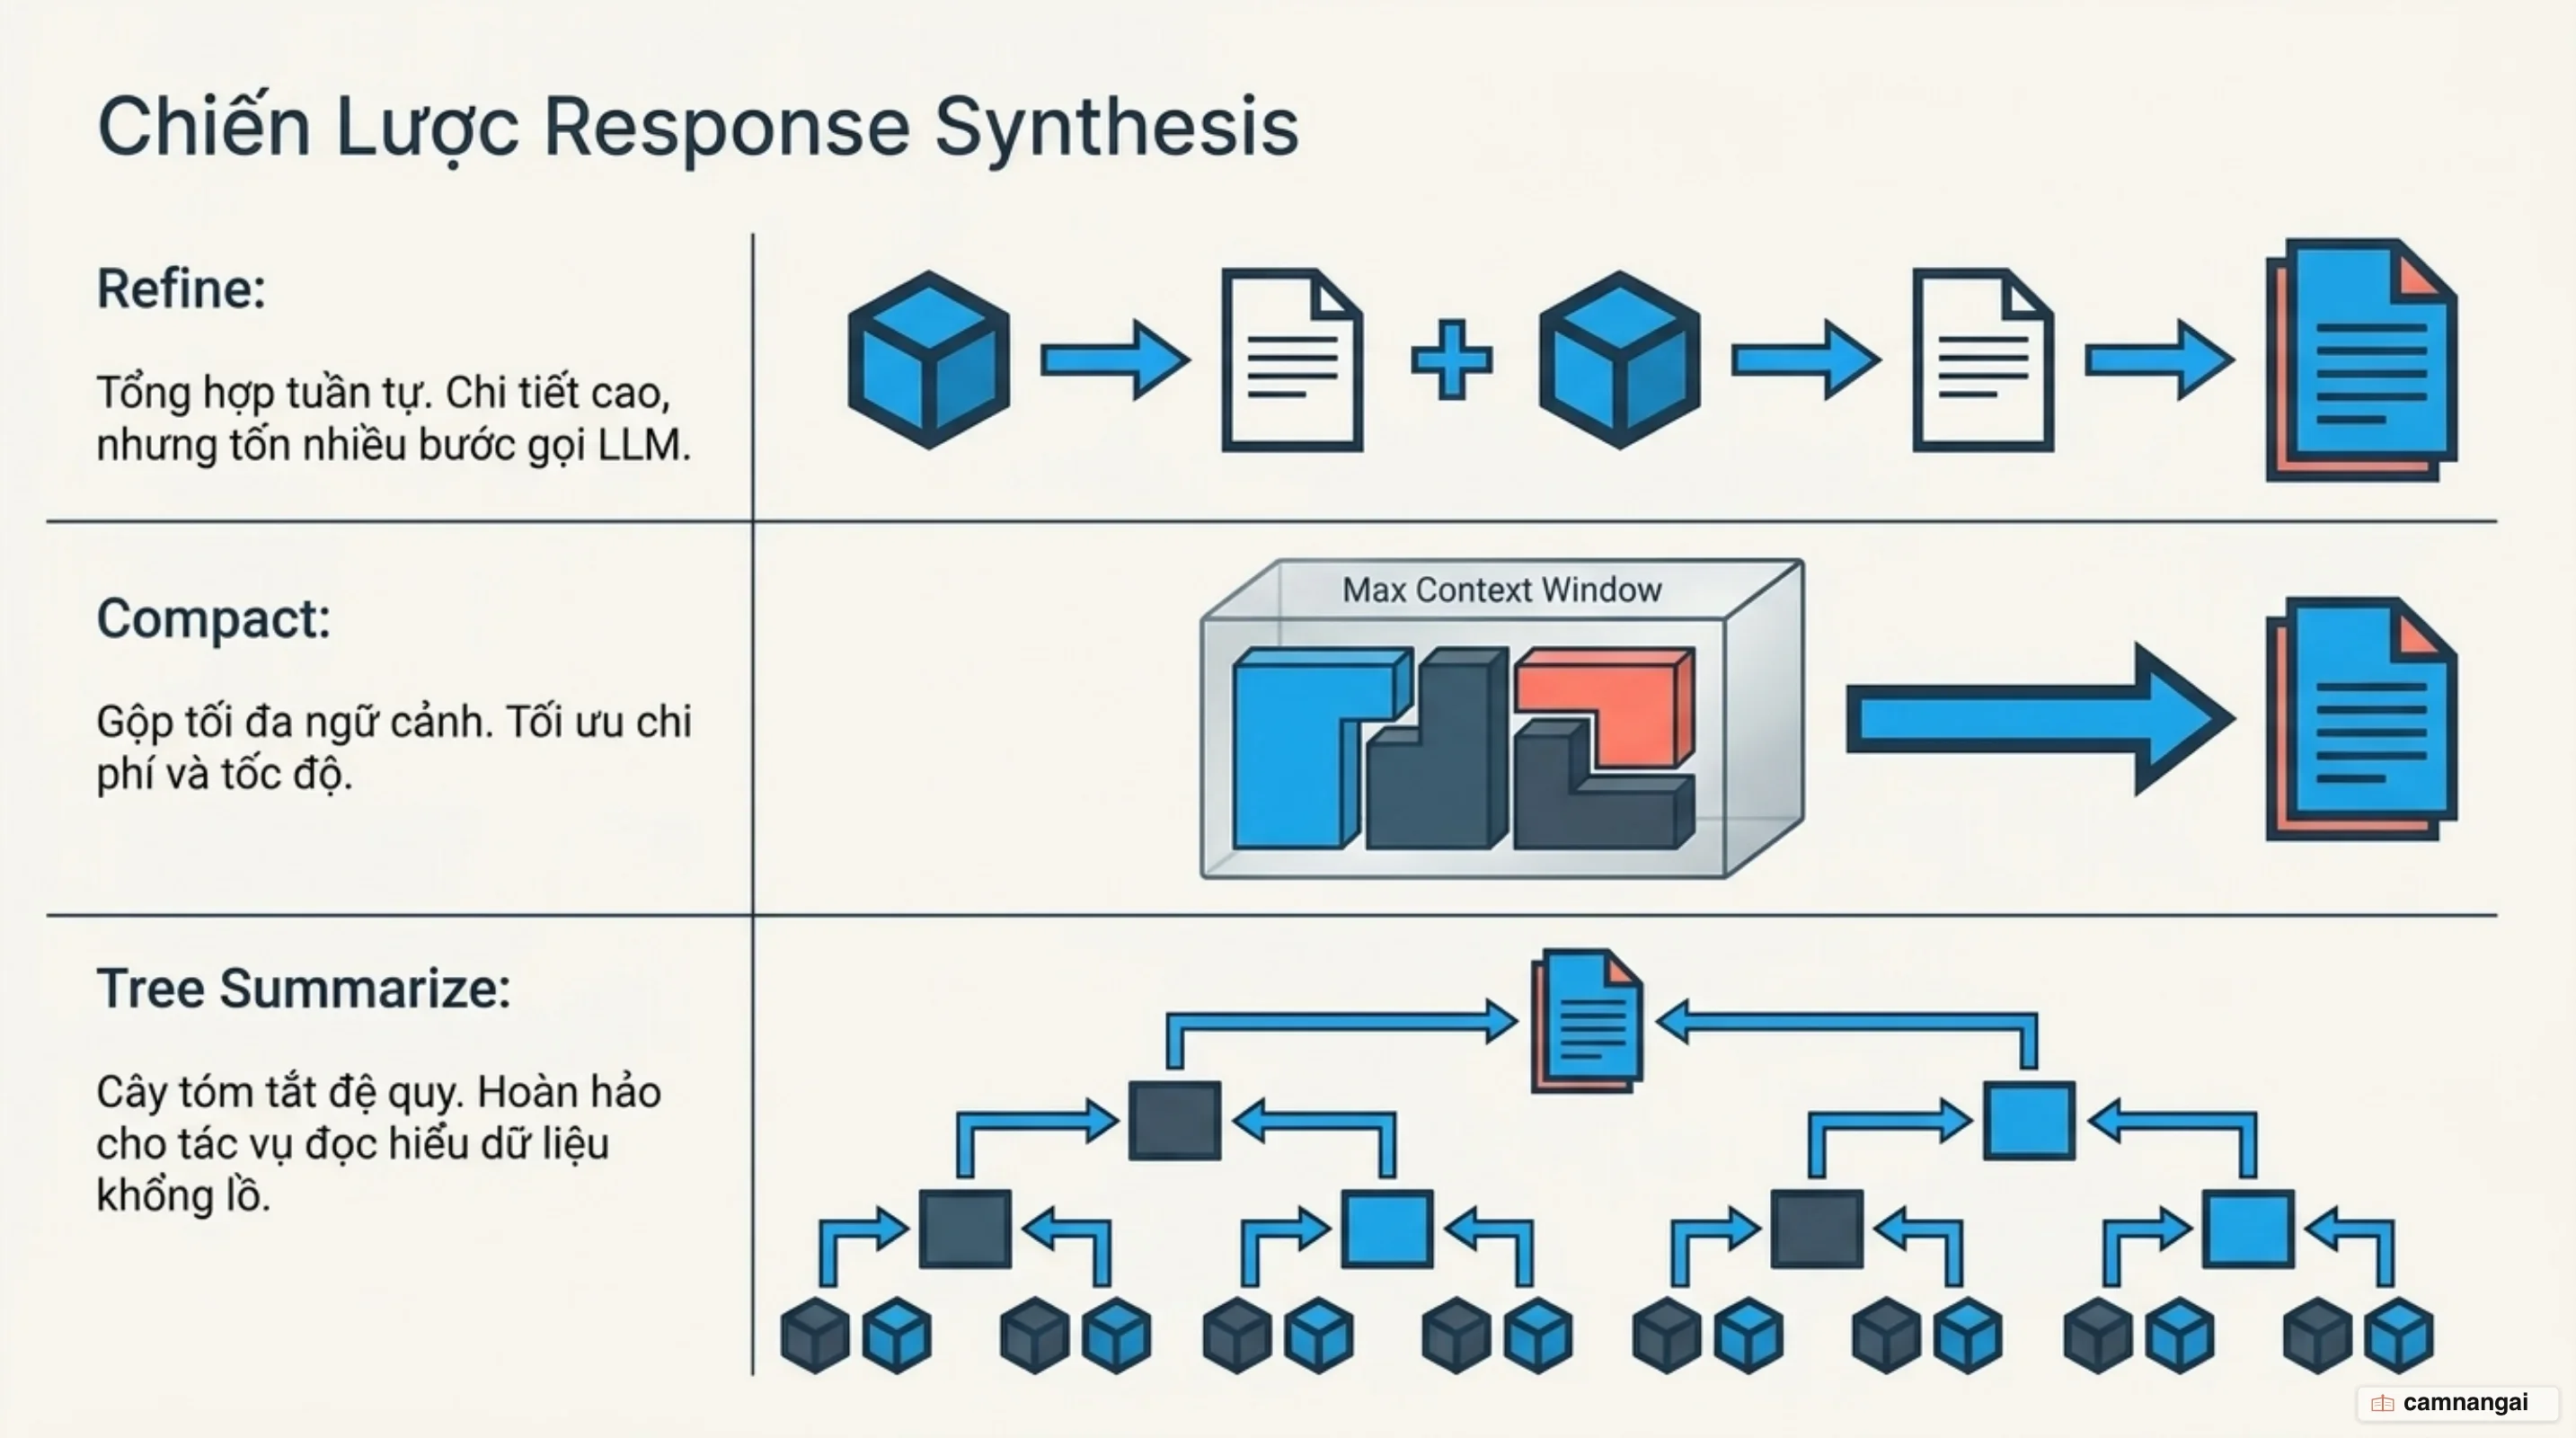
- Refine: Sinh câu trả lời sơ thảo từ chunk đầu tiên, sau đó cập nhật tuần tự với các chunk kế tiếp. Phù hợp cho yêu cầu độ chính xác cao nhưng độ trễ tăng theo số lượng chunk.
- Compact: Gộp tối đa các chunk vào một cửa sổ ngữ cảnh để giảm số lượng lượt gọi API (Round Trip Time), tối ưu chi phí và độ trễ.
- Tree_Summarize: Xây dựng cấu trúc cây tóm tắt từ các chunk theo độ phức tạp O(log N) về chiều sâu, cực kỳ hiệu quả cho việc tóm tắt toàn bộ tài liệu lớn.
- Simple_Summarize: Cắt cụt các chunk để ép vào một prompt duy nhất. Nhanh nhưng mang rủi ro mất mát thông tin quan trọng.
- Accumulate: Chạy truy vấn độc lập trên từng chunk và gộp kết quả lại thành một danh sách phản hồi tổng thể.
Lựa chọn đúng chế độ tổng hợp quyết định trực tiếp đến trải nghiệm người dùng và chi phí token hàng tháng của hệ thống.
Kiểm soát hallucination và trích dẫn nguồn (Grounding & Citations)
Grounding (neo dữ liệu thực tế) là yêu cầu tiên quyết để hệ thống đạt chuẩn production. Các kỹ thuật kiểm soát bao gồm:
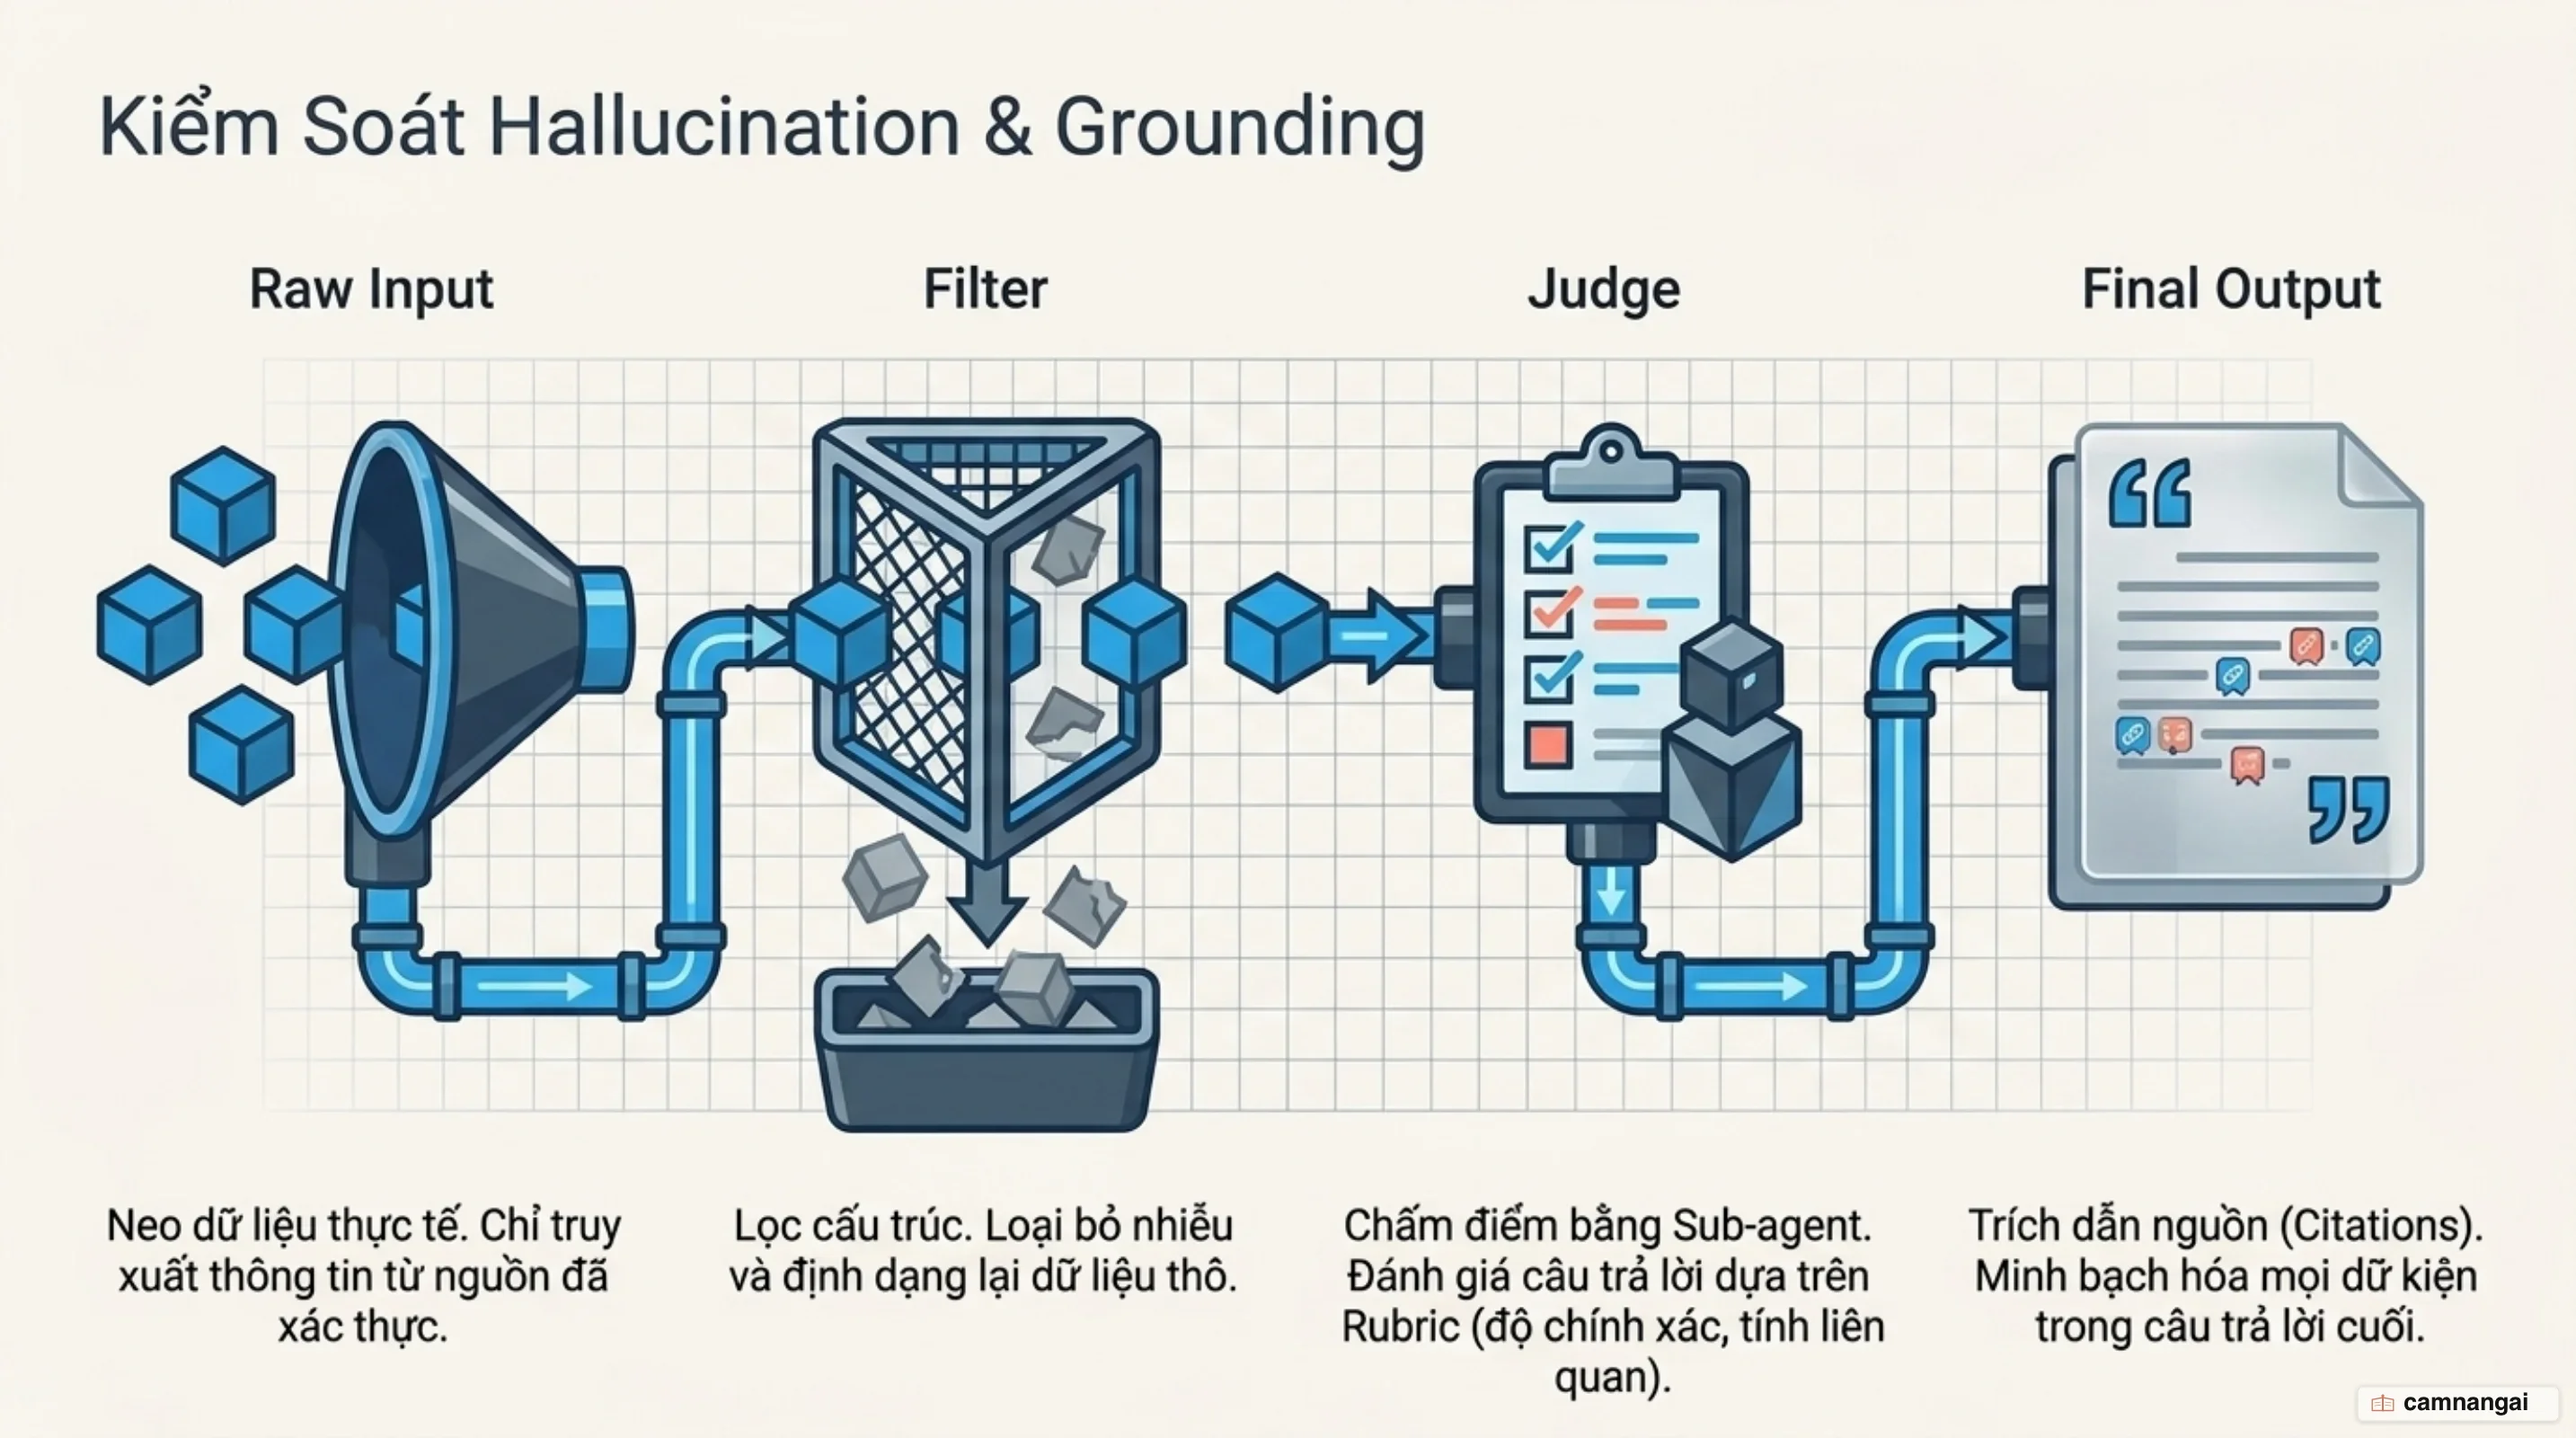
- Structured Answer Filtering: Sử dụng Function Calling hoặc Structured Outputs để ép mô hình lọc bỏ các input node không liên quan trước khi sinh văn bản, giúp tập trung vào dữ liệu thực tế.
- Rubric-checked grounding: Triển khai đánh giá với một sub-agent chấm điểm câu trả lời dựa trên bộ tiêu chí (rubric) định sẵn, đảm bảo mọi khẳng định đều có bằng chứng trực tiếp từ ngữ cảnh.
- Prompt Constraints: Thiết lập ràng buộc phủ định rõ ràng, yêu cầu mô hình trả lời "Tôi không tìm thấy thông tin" nếu ngữ cảnh không đủ bằng chứng, ngăn chặn việc mô hình tự ý suy diễn từ tri thức tiềm ẩn.
Việc tích hợp số chỉ mục trích dẫn nguồn (citations) trong câu trả lời giúp người dùng dễ dàng đối chiếu, xây dựng niềm tin vào hệ thống AI của doanh nghiệp.
Đánh đổi độ trễ và chi phí: Streaming, caching và chọn mô hình Generator
Bài toán kinh tế trong production đòi hỏi sự cân bằng giữa chất lượng suy luận và ngân sách vận hành:
- Định mức chi phí: Sử dụng GPT-4o-mini (
$0.00015/query) cho các tác vụ hỏi đáp thông thường thay vì GPT-4o ($0.0025/query) giúp tối ưu ngân sách đáng kể mà vẫn đảm bảo độ chính xác. - Prompt Caching: Kỹ thuật này giúp giảm độ trễ hơn 2 lần và giảm tới 90% chi phí đối với các prompt dài chứa nhiều ngữ cảnh cố định không thay đổi qua các lượt truy vấn.
- Streaming & Subagents: Tận dụng Streaming để giảm thời gian phản hồi đầu tiên (Time To First Token), cải thiện trải nghiệm người dùng cuối. Các sub-agent có thể xử lý song song các tài liệu khác nhau để tăng throughput cho toàn bộ hệ thống.
Các cạm bẫy kỹ thuật thường gặp khi đưa tầng Generation lên production
Trong thực tế, hệ thống thường gặp hiện tượng vỡ vụn ngữ cảnh (Context Fragmentation) do việc chia ranh giới chunk dựa trên số lượng token cố định mà thiếu đi metadata bổ trợ. Ngoài ra, việc nhồi nhét quá nhiều Top-K chunks không liên quan sẽ gây nhiễu, khiến mô hình rơi vào hiện tượng "lost-in-the-middle" và suy giảm khả năng suy luận.
Cần triển khai hệ thống Evals định kỳ để phân tách rõ nguồn gốc lỗi: nếu lỗi do tìm sai dữ liệu, hãy tối ưu tầng Retrieval; nếu dữ liệu truy xuất đã chính xác nhưng mô hình trả lời sai, hãy tinh chỉnh prompt augmentation hoặc nâng cấp mô hình Generator để đảm bảo khả năng bám sát tài liệu nguồn.
Tài liệu tham khảo
- Retrieval-Augmented Generation (RAG) Architecture — Pinecone
- What is Retrieval-Augmented Generation (RAG)? — AWS
- Retrieval-Augmented Generation (RAG) Architecture — IBM Think
- What is Retrieval-Augmented Generation (RAG)? — Databricks
- Contextual Retrieval in AI Systems — Anthropic
- Retrieval-Augmented Generation (RAG) Tutorial — LangChain
- Response Synthesizer Module Guide — LlamaIndex
- Question Answering Using Embeddings — OpenAI Cookbook