Việc kiểm soát lưu lượng cho Large Language Model (LLM) thông qua một API Gateway LLM khác biệt hoàn toàn so với API truyền thống do tính chất bất định về chi phí và tài nguyên tính toán của từng request. Đối với hệ thống REST API thông thường, mỗi request đòi hỏi mức độ tiêu tốn tài nguyên tương đối đồng đều. Tuy nhiên, các mô hình ngôn ngữ lớn xử lý dữ liệu theo số lượng token đầu vào và đầu ra, khiến tải tính toán của hai request HTTP cùng kích thước có thể chênh lệch nhau hàng nghìn lần.
Lớp đệm API Gateway LLM đóng vai trò proxy trung gian đứng giữa các ứng dụng phía client và các nhà cung cấp mô hình (như OpenAI, Anthropic, Azure OpenAI).
Lớp hạ tầng này chịu trách nhiệm trực tiếp đếm số token thực tế, quản trị hạn mức ngân sách tài chính, thực thi các thuật toán rate limit nâng cao và tự động điều hướng luồng dữ liệu (fallback) khi nhà cung cấp phát tín hiệu lỗi HTTP 429 (Too Many Requests) hoặc nghẽn hạ tầng.
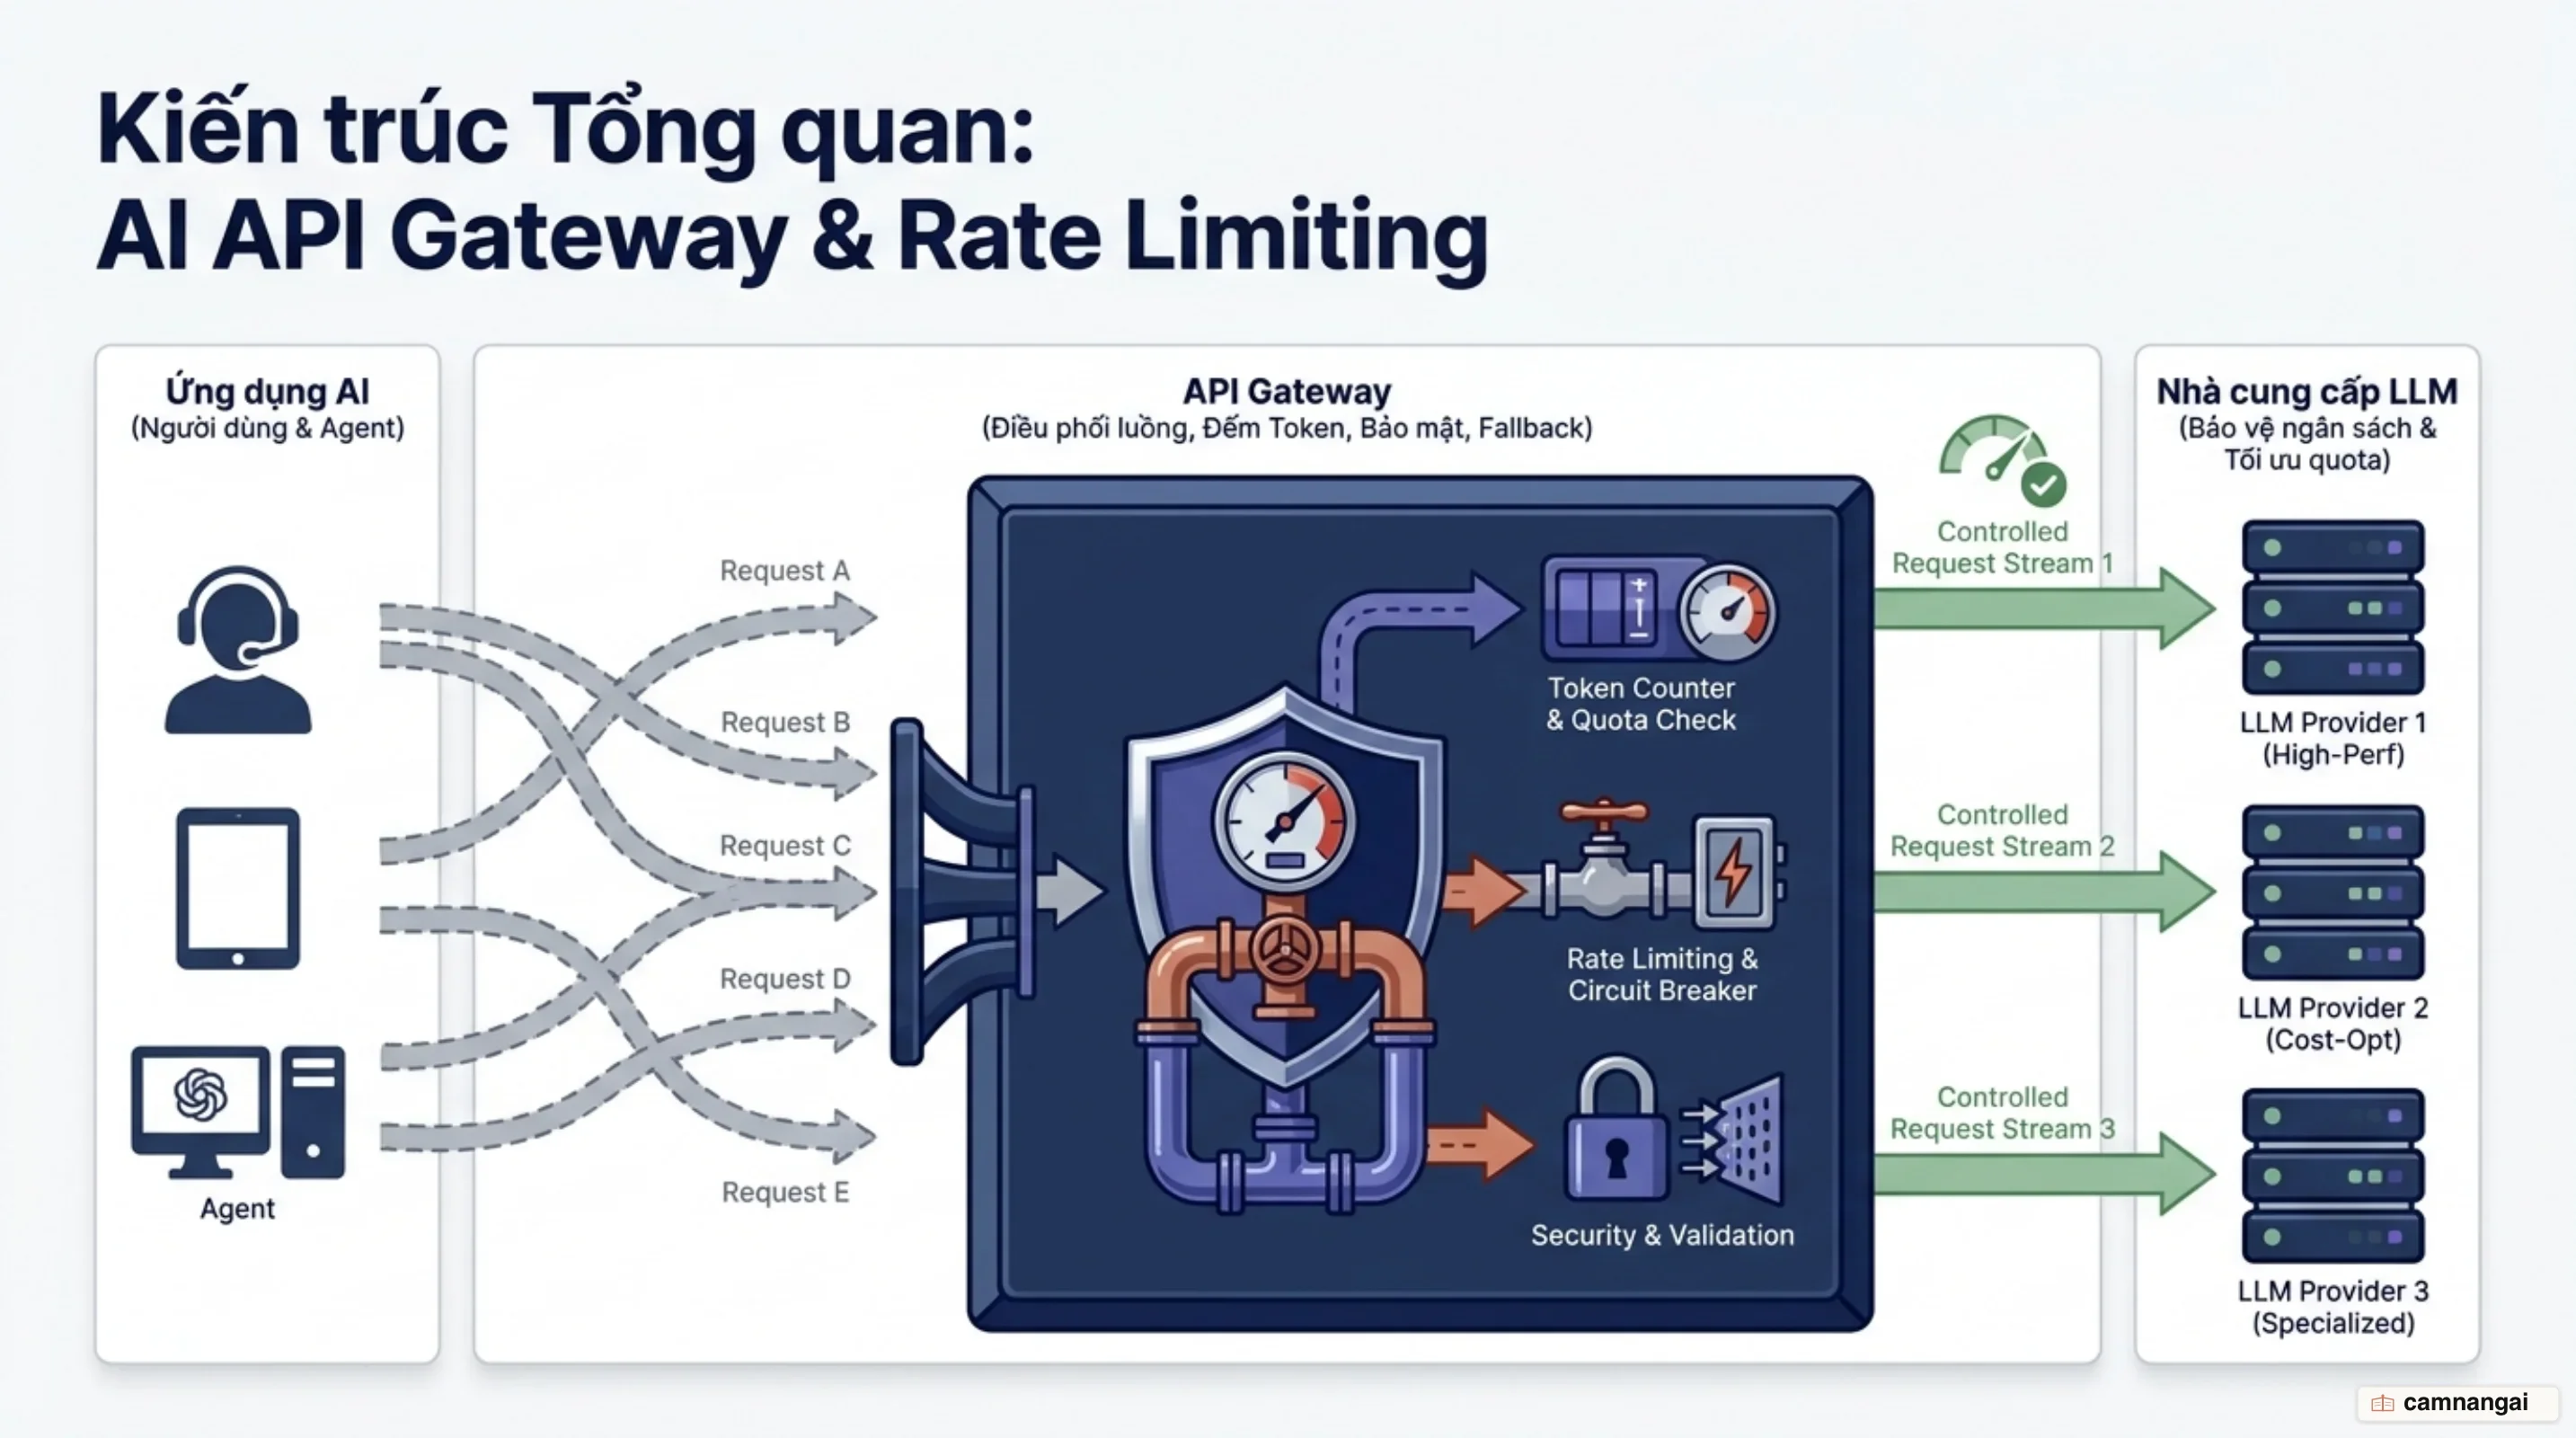
Vì sao rate limiting cho LLM phức tạp hơn API truyền thống?
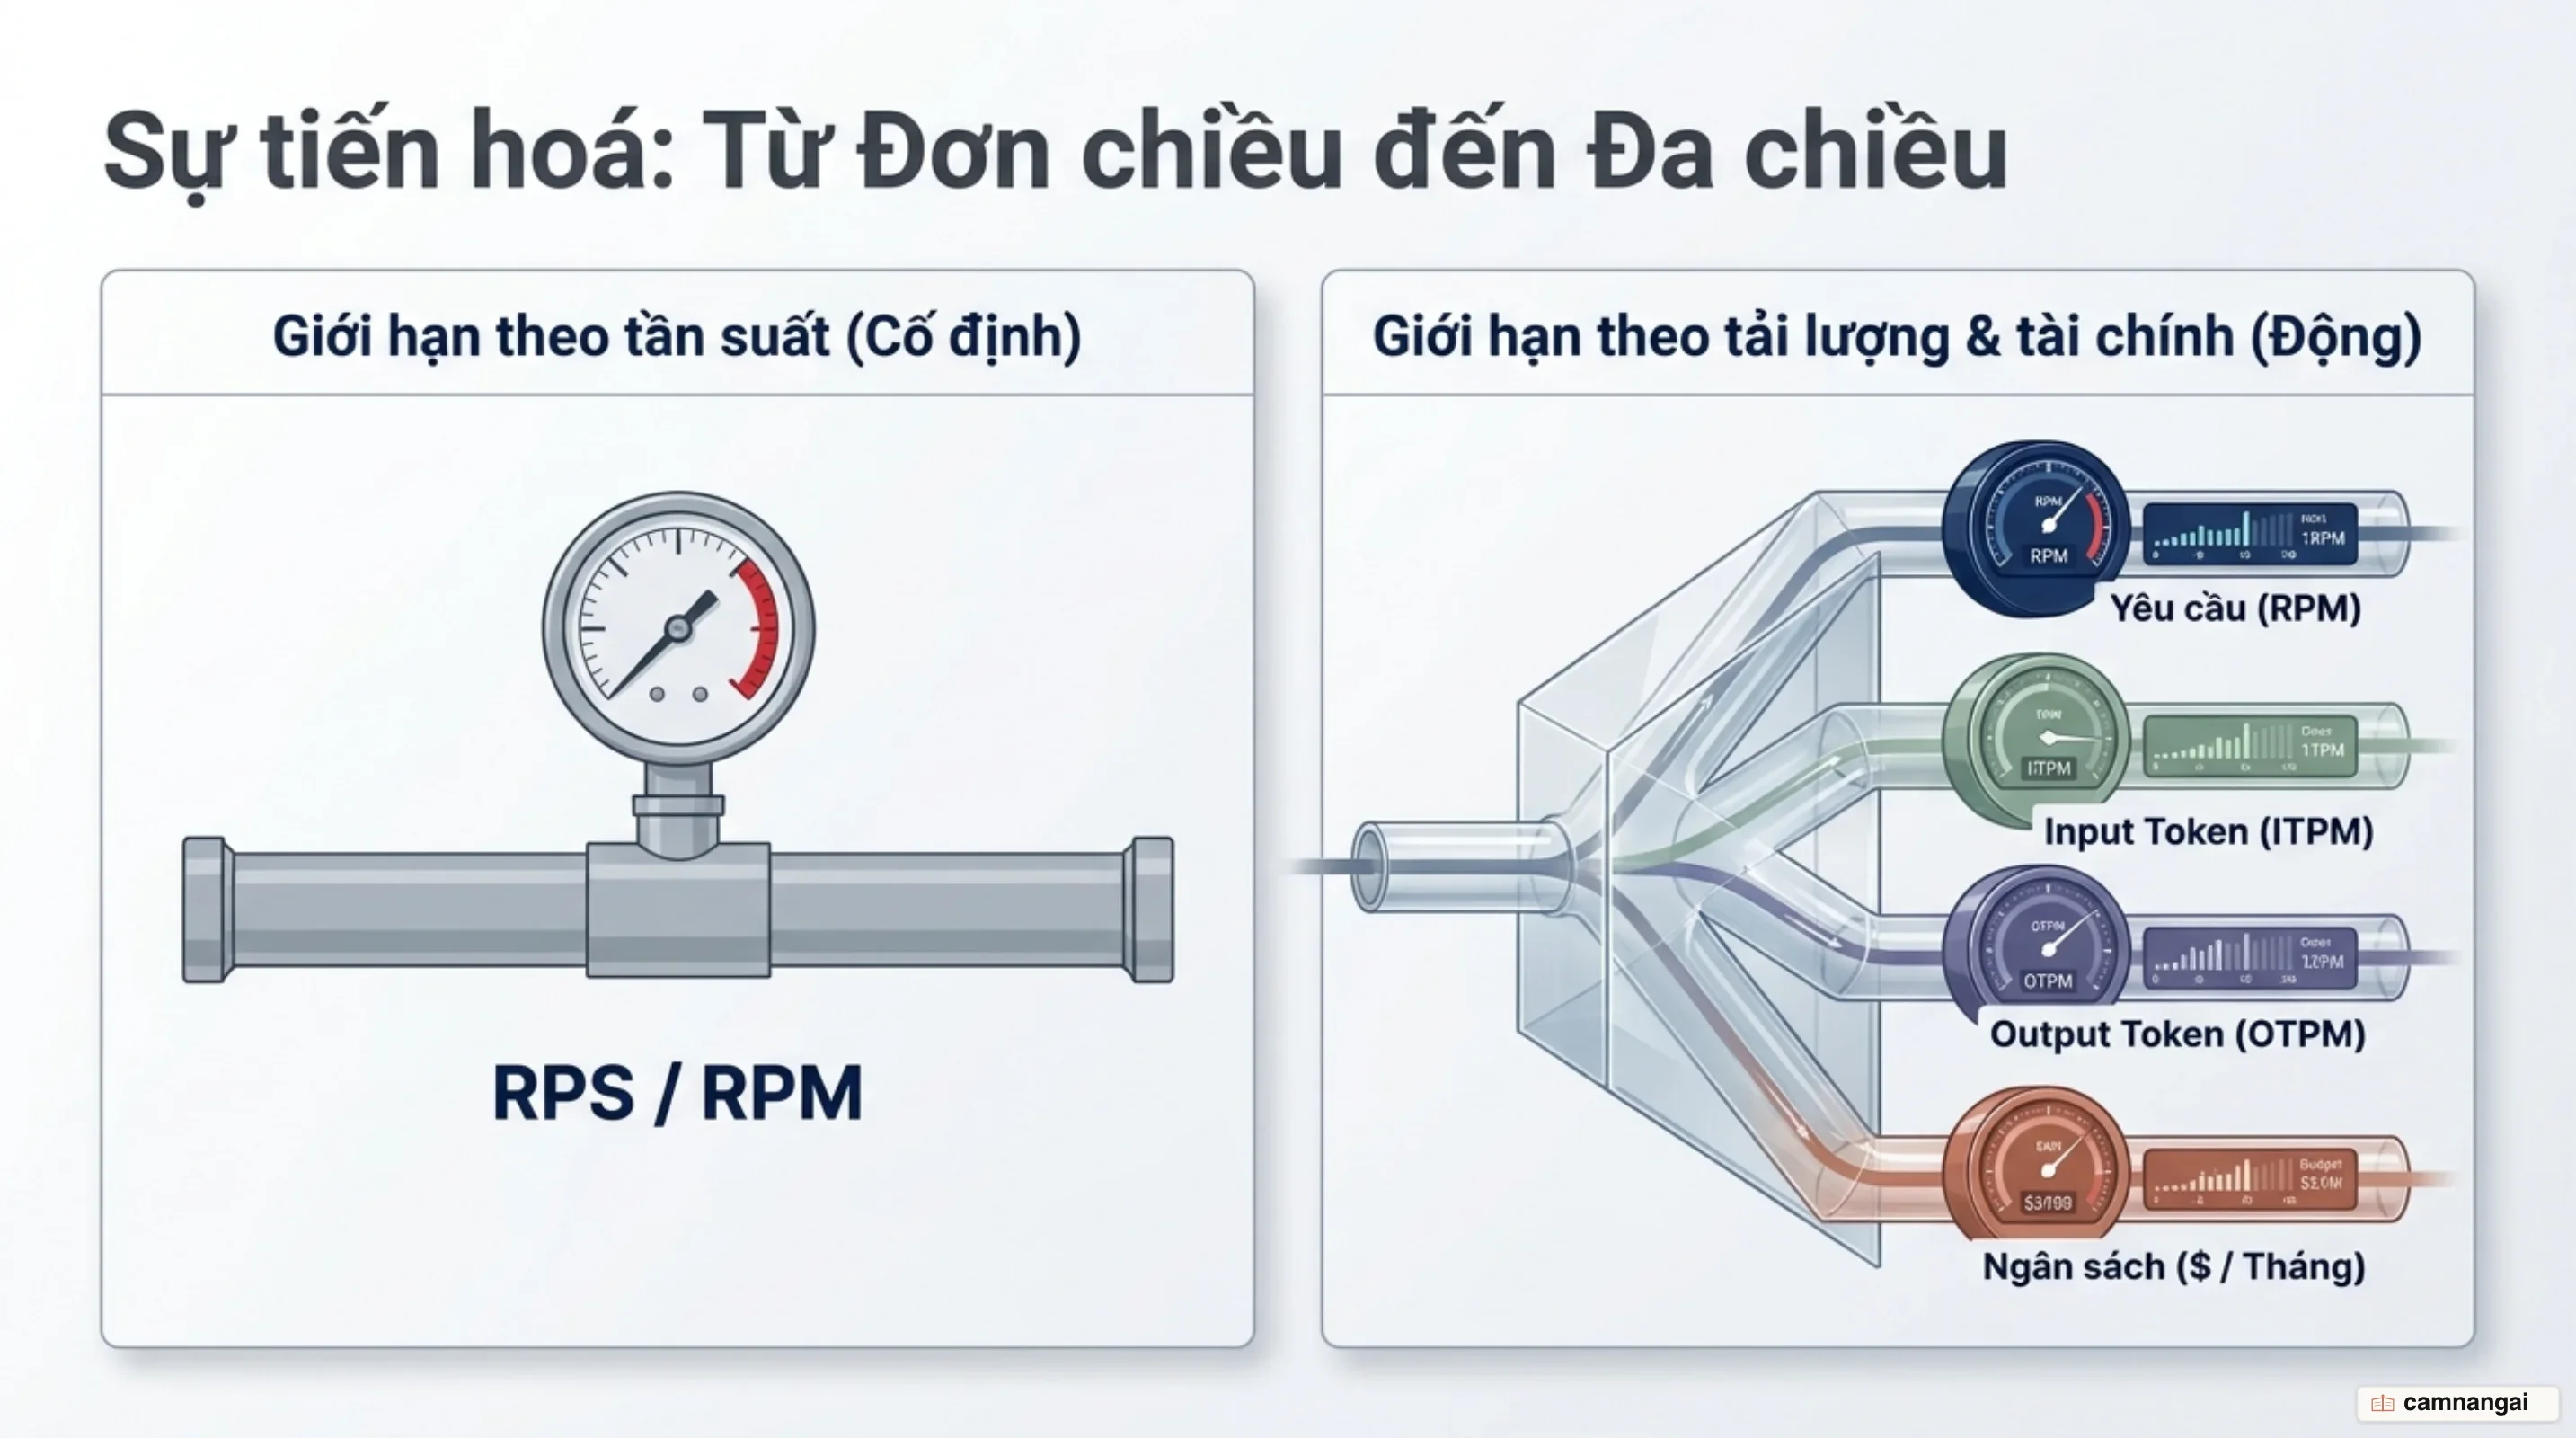
Đối với các hệ thống Web API truyền thống, cơ chế rate limiting chủ yếu dựa trên số lượng lượt gọi HTTP trong một đơn vị thời gian (Requests Per Second - RPS hoặc Requests Per Minute - RPM). Mô hình này giả định rằng chi phí xử lý trên server cho mỗi request là tương đương nhau. Ngược lại, trong ứng dụng LLM, một request xử lý câu hỏi ngắn chỉ tốn 10 token, nhưng request tiếp theo xử lý tài liệu tài chính có thể ngốn tới 128,000 token. Nếu bạn chỉ áp dụng quy tắc chặn theo RPS/RPM, một vài request dung lượng token cực lớn sẽ nhanh chóng làm cạn kiệt băng thông tính toán (throughput) của hệ thống và gây sập dịch vụ upstream.
Sự phức tạp tăng lên do sự chênh lệch chi phí giữa token đầu vào (prompt tokens) và token đầu ra (completion tokens). Xử lý prompt đòi hỏi quá trình đọc và mã hóa song song, trong khi sinh completion đòi hỏi quá trình tự hồi quy (autoregressive) tốn nhiều tài nguyên GPU hơn. Plugin Kong AI Gateway Enterprise giải quyết bài toán này bằng cách đưa ra công thức quy đổi chi phí tài chính hoặc chi phí tính toán thực tế dựa trên đơn vị 1 triệu token:
cost = ((prompt_tokens * input_cost) + (completion_tokens * output_cost)) / 1_000_000
Độ trễ và cơ chế phản hồi theo dạng dòng chảy (Server-Sent Events - SSE / Streaming response) đặt ra thách thức kỹ thuật lớn cho các AI Gateway. Với các thuật toán sinh tự hồi quy, độ dài văn bản đầu ra hoàn toàn không định tính (non-deterministic). Do đó, Gateway không thể thực thi việc chặn cứng ngay ở thời điểm bắt đầu nhận request streaming vì chưa có thông tin chính xác về dung lượng đầu ra. Giải pháp duy nhất là Gateway phải ghi nhận lượng tiêu thụ thực tế sau khi luồng SSE đóng lại và áp dụng cơ chế dư nợ tiêu dùng (usage debt/penalty): khoản cước token của request hiện tại sẽ được bù trừ vào bộ đếm hạn mức của các request kế tiếp (reflected on next request).
Để kiểm soát lưu lượng linh hoạt, các AI Gateway như Kong hỗ trợ 4 chiến lược đếm token cốt lõi: total_tokens (tổng số token prompt và completion), prompt_tokens (chỉ đếm token đầu vào), completion_tokens (chỉ đếm token sinh ra), và cost (tính theo trọng số tài chính quy đổi). Dưới đây là ví dụ cấu hình chiến lược cost trên Kong Gateway:
plugins:
  - name: ai-rate-limiting-advanced
    config:
      tokens_count_strategy: cost
      # Lưu ý: 'llm_providers' là cú pháp legacy. Từ Kong Gateway 3.14+, khuyến nghị chuyển sang cấu hình dạng 'policies'.
      llm_providers:
        - name: openai
          model:
            options:
              input_cost: 2.5 # USD trên 1M prompt tokens
              output_cost: 10.0 # USD trên 1M completion tokens
Cơ chế giới hạn của các nhà cung cấp: OpenAI và Anthropic
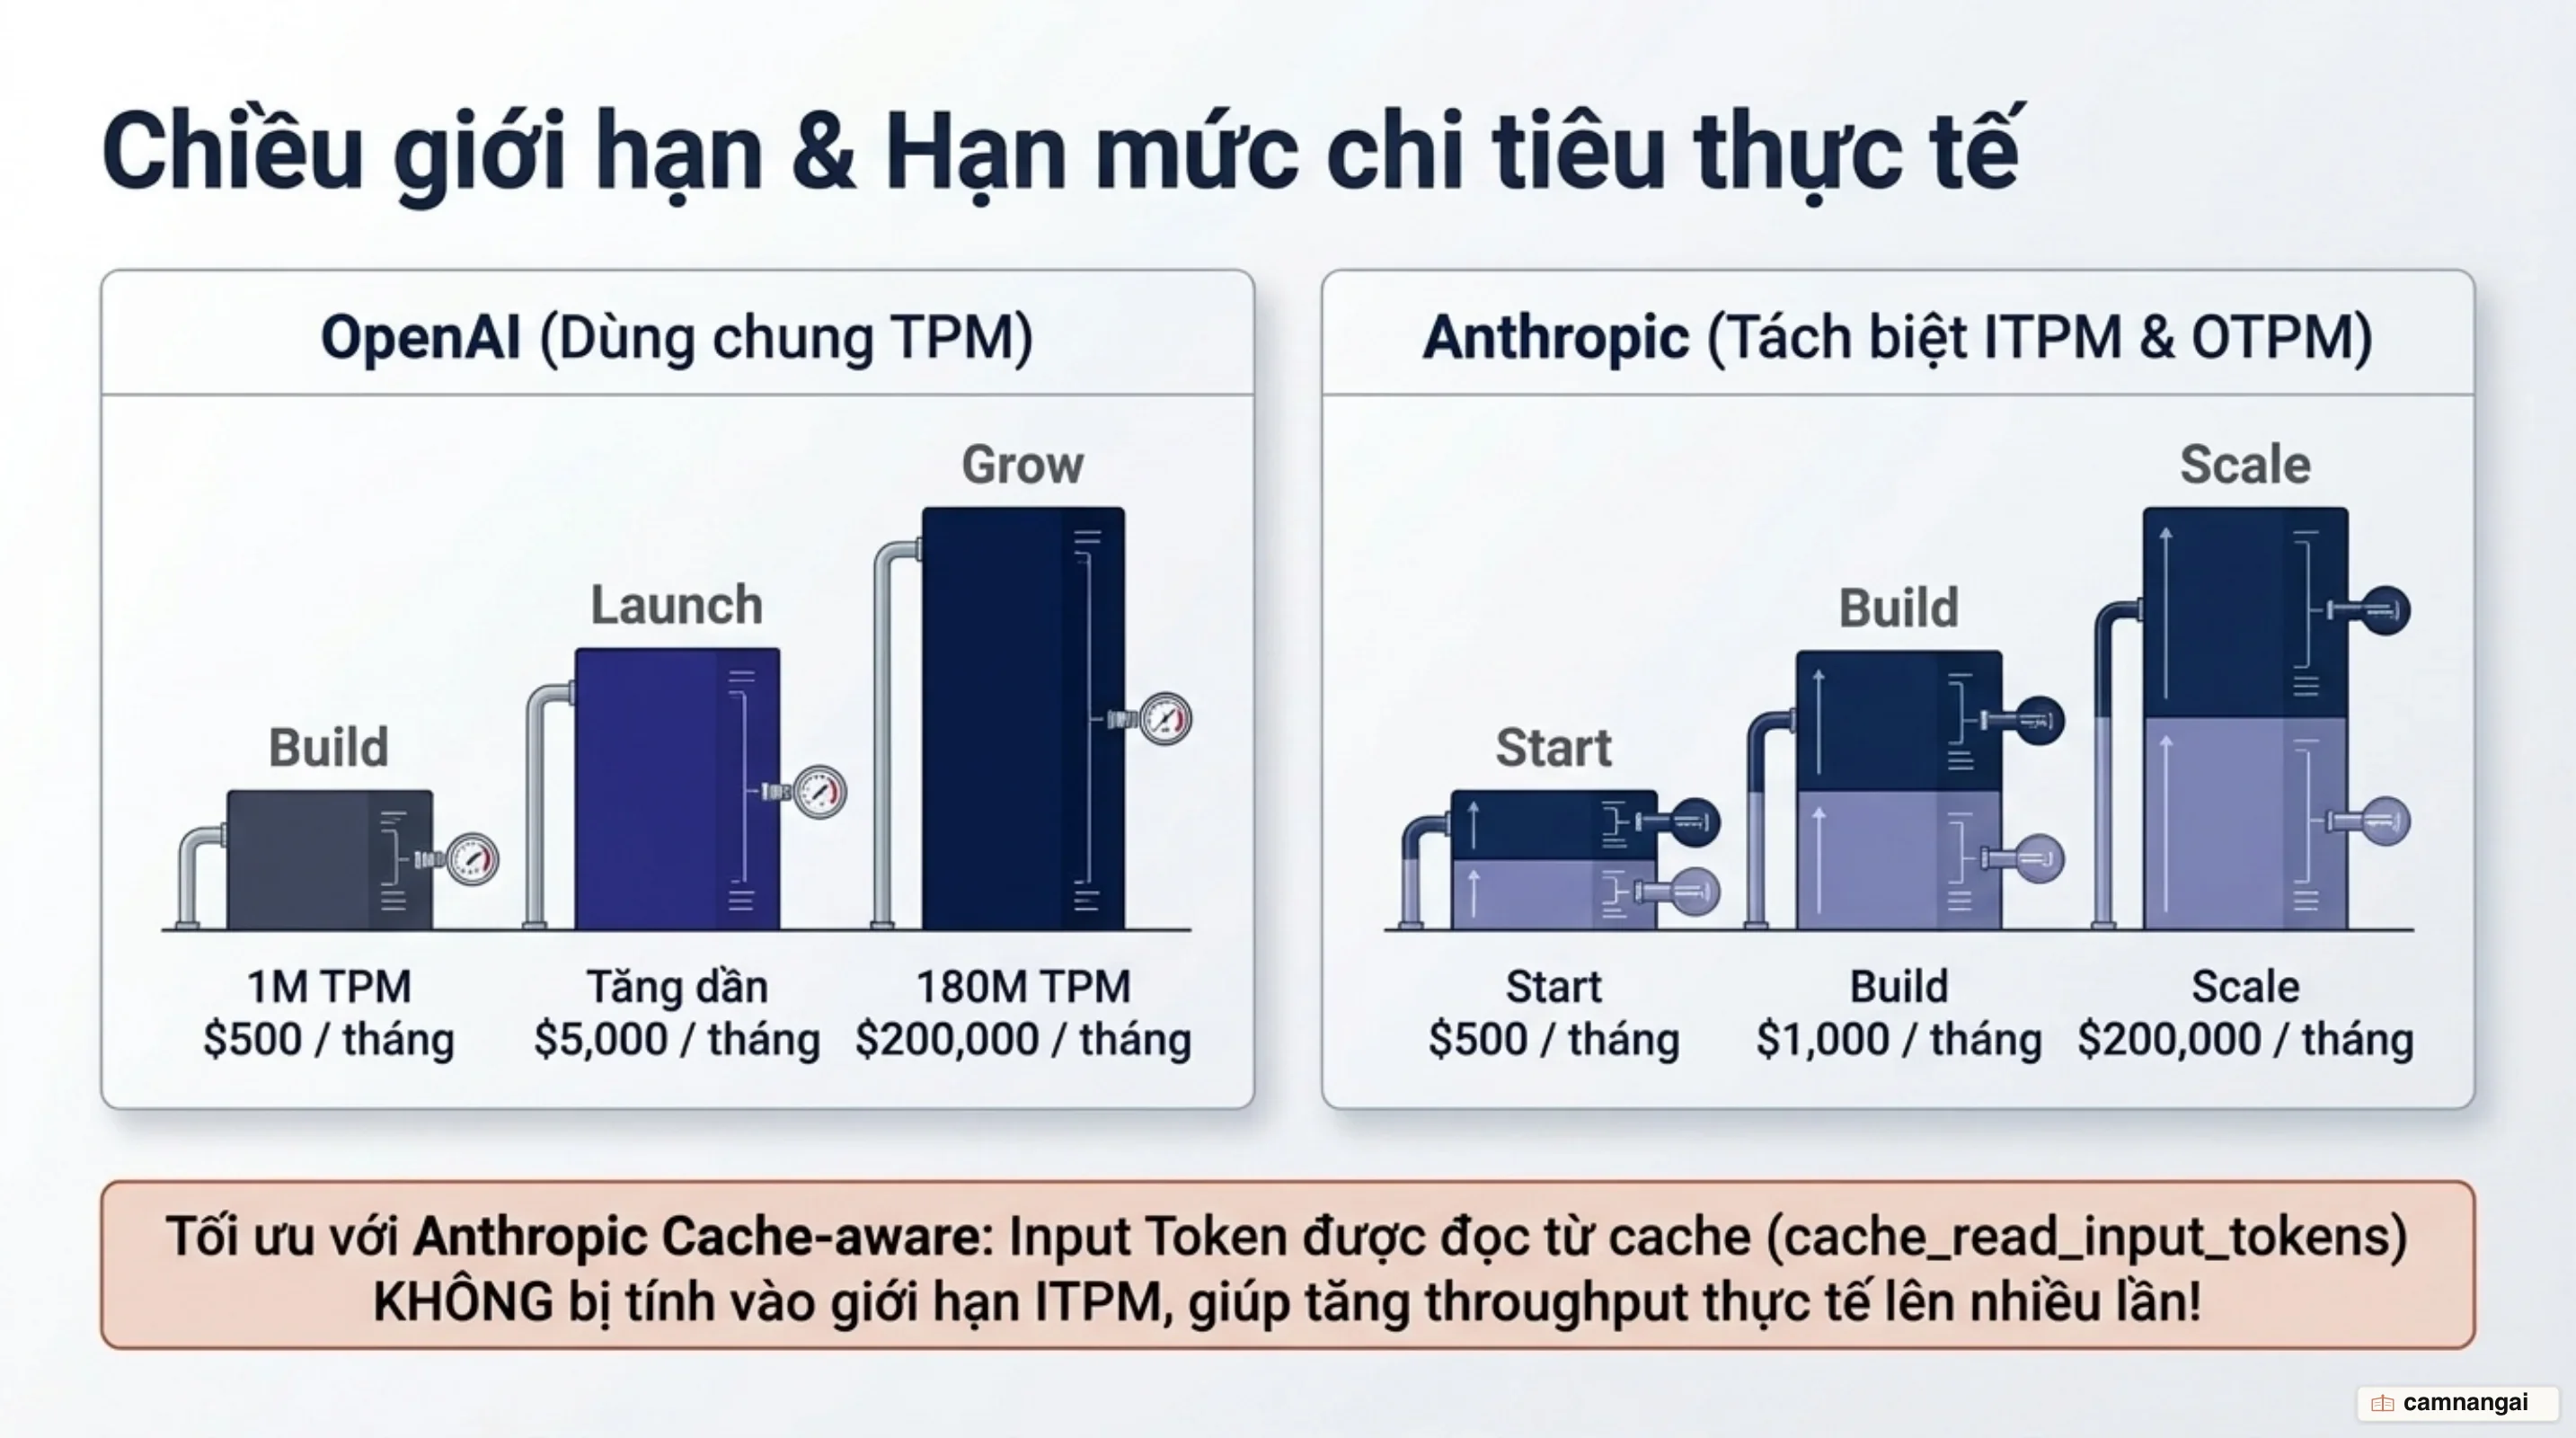
Các nhà cung cấp LLM lớn áp dụng cơ chế giới hạn lưu lượng đa chiều (Multi-dimensional Rate Limits) hoạt động song song. Người vận hành hệ thống phải đối mặt đồng thời với các ngưỡng: Requests Per Minute (RPM), Input Tokens Per Minute (ITPM), Output Tokens Per Minute (OTPM) và Total Tokens Per Minute (TPM). Một request sẽ bị từ chối ngay lập tức nếu vi phạm bất kỳ một trong các chỉ số này, bất kể các chỉ số còn lại vẫn nằm trong khoảng an toàn.
Bên cạnh hạn mức kỹ thuật theo phút, Anthropic và các nhà cung cấp còn thiết lập cơ chế chặn cứng theo tháng (Monthly Spend Cap) phân cấp theo hạng tài khoản (Usage Tier). Ở hạng Start Tier, ngưỡng chi phí tối đa là $500/tháng; Build Tier nâng lên $1,000/tháng; và Scale Tier mở rộng tới $200,000/tháng. Khi tổ chức đụng trần chi phí này, hệ thống dừng toàn bộ truy cập và trả về lỗi HTTP 429 đi kèm JSON payload đặc thù chứa chi tiết enforced_spend_limit_reached. Đáng chú ý, phản hồi lỗi do trần chi phí sẽ không chứa header retry-after, nghĩa là mọi nỗ lực tự động thử lại (retry) từ phía client đều thất bại cho đến khi hạn mức tháng được khôi phục hoặc nâng cấp hạng.
{
  "type": "error",
  "error": {
    "type": "rate_limit_error",
    "message": "You have reached your API usage limits...",
    "details": { "error_code": "enforced_spend_limit_reached" }
  }
}
Cơ chế đếm token thông minh dựa trên Prompt Caching của Anthropic Claude mang lại lợi thế lớn cho việc tối ưu ITPM. Khi gửi request, chỉ có input_tokens (các token đứng sau cột mốc cache cuối cùng) và cache_creation_input_tokens (các token đang được ghi vào cache) mới bị tính vào hạn mức ITPM. Ngược lại, cache_read_input_tokens (các token đọc trực tiếp từ cache) hoàn toàn không bị tính vào hạn mức ITPM đối với đa số mô hình Claude. Cần lưu ý ngoại lệ kỹ thuật quan trọng: mô hình Claude Haiku 3.5 vẫn tính cả cache_read_input_tokens vào hạn mức ITPM. Với các dòng mô hình áp dụng miễn trừ (Sonnet, Opus), số liệu thực tế chứng minh: nếu hệ thống đạt tỷ lệ cache hit 80% trên ngưỡng giới hạn 2,000,000 ITPM, throughput thực tế mà bạn xử lý được có thể lên tới 10,000,000 input tokens/phút.
Khi ứng dụng chạm ngưỡng giới hạn, Provider trả về HTTP Status Code 429 Too Many Requests. Để ứng dụng client điều tiết traffic chính xác, API Gateway cần giải mã và truyền tiếp các HTTP Header phản hồi tiêu chuẩn như: retry-after (số giây cần chờ trước khi gửi lại), X-AI-RateLimit-Reset (thời điểm hạn mức được làm mới), và X-AI-RateLimit-Remaining (số lượt request hoặc token còn lại trong cửa sổ hiện tại).
Các thuật toán rate limiting cốt lõi: Token Bucket và Sliding Window
Thuật toán Token Bucket (Xô chứa Token) là nền tảng kiểm soát lưu lượng cho các hệ thống AI. Nguyên lý hoạt động dựa trên một xô có dung tích cố định $B$, được nạp liên tục các token theo tốc độ $r$ token/giây. Khi một request đến, nó phải lấy đi một số lượng token tương ứng với dung lượng tài nguyên. Token Bucket cho phép hệ thống xử lý các đợt bùng nổ traffic đột ngột (burst capacity) miễn là tổng lượng token tiêu thụ không vượt quá dung tích $B$. Anthropic áp dụng thuật toán Token Bucket để liên tục phục hồi capacity theo thời gian thực thay vì reset toàn bộ hạn mức về 0 ở các mốc thời gian cố định.
Sự khác biệt giữa thuật toán Cửa sổ Cố định (Fixed Window) và Cửa sổ Trượt (Sliding Window) được thể hiện rõ qua ví dụ quản lý truy cập trên Cloudflare AI Gateway. Giả sử bạn thiết lập giới hạn 10 requests / 10 phút, bắt đầu từ 12:00 (các cửa sổ cố định là 12:00–12:10, 12:10–12:20). Nếu client phát 10 requests vào lúc 12:09 và phát tiếp 10 requests vào lúc 12:11:
- Fixed Window: Cả 20 requests đều thành công vì 10 request đầu nằm trong khung 12:00–12:10 và 10 request sau thuộc khung 12:10–12:20. Tuy nhiên, hệ thống phải gánh 20 requests chỉ trong 2 phút.
- Sliding Window: 10 requests phát lúc 12:11 sẽ bị chặn hoàn toàn (HTTP 429), vì thuật toán liên tục tính tổng số request trong 10 phút gần nhất (từ 12:01 đến 12:11) đã vượt quá ngưỡng cho phép (đạt 20 requests).
Trong kiến trúc hạ tầng phân tán gồm nhiều node (như Kong Gateway cluster), việc duy trì bộ đếm counter đặt ra bài toán về độ lệch dữ liệu. Có 3 chiến lược lưu trữ bộ đếm được áp dụng:
local: Counter lưu hoàn toàn trong bộ nhớ RAM của từng node. Hiệu năng cao nhất, không tốn latency mạng nhưng gây ra lệch dữ liệu (diverge) khi cluster mở rộng scale-out, ngoại trừ khi dùng Consistent-Hashing Load Balancer đứng trước Gateway.cluster: Counter lưu tập trung tại cơ sở dữ liệu của Kong Gateway. Độ chính xác tuyệt đối nhưng mỗi request bắt buộc phải thực hiện 1 đợt Read và Write vào DB, gây ra trễ rất nặng (không khuyến nghị khi cấu hìnhsync_ratethấp/tần suất cao).redis: Counter lưu tập trung trên cụm Redis độc lập. Đạt cân bằng tối ưu giữa độ chính xác và hiệu năng. Hỗ trợ cơ chế tự động hạ cấp (fallback) vềlocalkhi kết nối Redis bị gián đoạn.
Khi triển khai chiến lược bất đồng bộ trên cụm node phân tán, hiện tượng vượt ngưỡng tối đa (Cluster Overage Lag) có thể xảy ra do độ lệch giữa các khoảng thời gian đồng bộ (sync_rate). Công thức và bảng tính toán trường hợp xấu nhất (Worst-case potential overage) từ dữ liệu kỹ thuật của Kong Gateway như sau:
| Thuộc tính | Công thức / Vị trí cấu hình | Giá trị minh họa |
|---|---|---|
| Window size (giây) | config.window_size | 5 |
| Limit (trong window) | config.limit | 1000 |
| Sync rate (giây) | config.sync_rate | 0.5 |
| Số lượng nodes (>1) | Cụm Data Plane | 10 |
| RPS ước tính trên mỗi node | Limit / Window size / Số nodes | $1000 / 5 / 10 = 20$ |
| Trễ tối đa trên một node | RPS trên node * Sync rate | $20 \times 0.5 = 10$ |
| Vượt ngưỡng tối đa toàn cụm/giây | Trễ tối đa trên node * Số nodes | $10 \times 10 = 100$ |
| Tỷ lệ vượt ngưỡng tối đa toàn cụm | Vượt ngưỡng toàn cụm / Limit | $100 / 1000 = 10%$ |
Kiến trúc LLM Gateway: Tự host hay giải pháp tại Edge?
Mô hình tự triển khai (Self-Hosted LLM Gateway) như LiteLLM Proxy chạy trên Kubernetes/Docker hoặc Kong Gateway on-premise đem lại khả năng kiểm soát tuyệt đối. Các doanh nghiệp áp dụng mô hình này nhằm giữ trọn vẹn dữ liệu nhạy cảm (PII), không làm rò rỉ API Key ra hạ tầng bên ngoài và tuân thủ các quy định bảo mật nội bộ khắt khe. Mặc dù vậy, chi phí vận hành hạ tầng không nhỏ: đội ngũ DevOps phải tự gánh gánh nặng duy trì cụm Redis tính toán high-availability, xử lý bài toán đồng bộ trạng thái và quản trị bảo mật credential.
Khi tự host với bộ nhớ Redis, bạn có thể loại bỏ hoàn toàn rủi ro lọt mật khẩu tĩnh (Static Passwords) bằng cách tích hợp các cơ chế xác thực đám mây tĩnh/động theo chuẩn Kong Gateway:
- AWS ElastiCache: Tích hợp xác thực IAM policy qua action
elasticache:Connect. - Azure Managed Redis: Xác thực thông qua Entra ID (Service Principal / Principal ID).
- Google Cloud Memorystore: Gán vai trò IAM
roles/redis.dbConnectionUsercho Memorystore for Redis Cluster hoặcroles/memorystore.dbConnectionUsercho Valkey. - OAuth 2.0 Token Endpoint: Tự động lấy và xoay vòng Bearer Token thông qua grant type
client_credentialshoặcpassword.
Mô hình Managed at Edge (như Cloudflare AI Gateway, Portkey / Prisma AIRS) tận dụng mạng lưới phân tán toàn cầu (300+ điểm Edge) để xử lý request ngay gần vị trí người dùng. Ưu điểm vượt trội là khả năng triển khai tức thì, tích hợp sẵn các tính năng Data Loss Prevention (DLP), Guardrails chặn prompt injection, và Caching tại Edge giúp giảm đáng kể latency mạng. Tuy nhiên, nhược điểm nằm ở việc phụ thuộc nhà cung cấp (vendor lock-in) và phát sinh thêm chi phí dịch vụ trên mỗi lượt request bên cạnh cước phí trả cho LLM Provider.
Nhằm tối ưu hóa chi phí và độ trễ trước khi proxy chuyển tiếp request lên upstream provider, LLM Gateway cần thực hiện hai lớp lọc nâng cao ngay tại Edge: Lọc theo vị trí địa lý (Inference Geo / Region filtering) để đảm bảo tuân thủ quyền riêng tư dữ liệu (ví dụ: chỉ điều hướng trong vùng EU), và Lọc khả năng xử lý (Vision capability filtering - tự động loại bỏ các model chỉ hỗ trợ text khỏi danh sách khả dĩ khi request có chứa dữ liệu hình ảnh image_url).
Chiến lược xử lý khi chạm trần: Retry, Fallback và Circuit Breaker
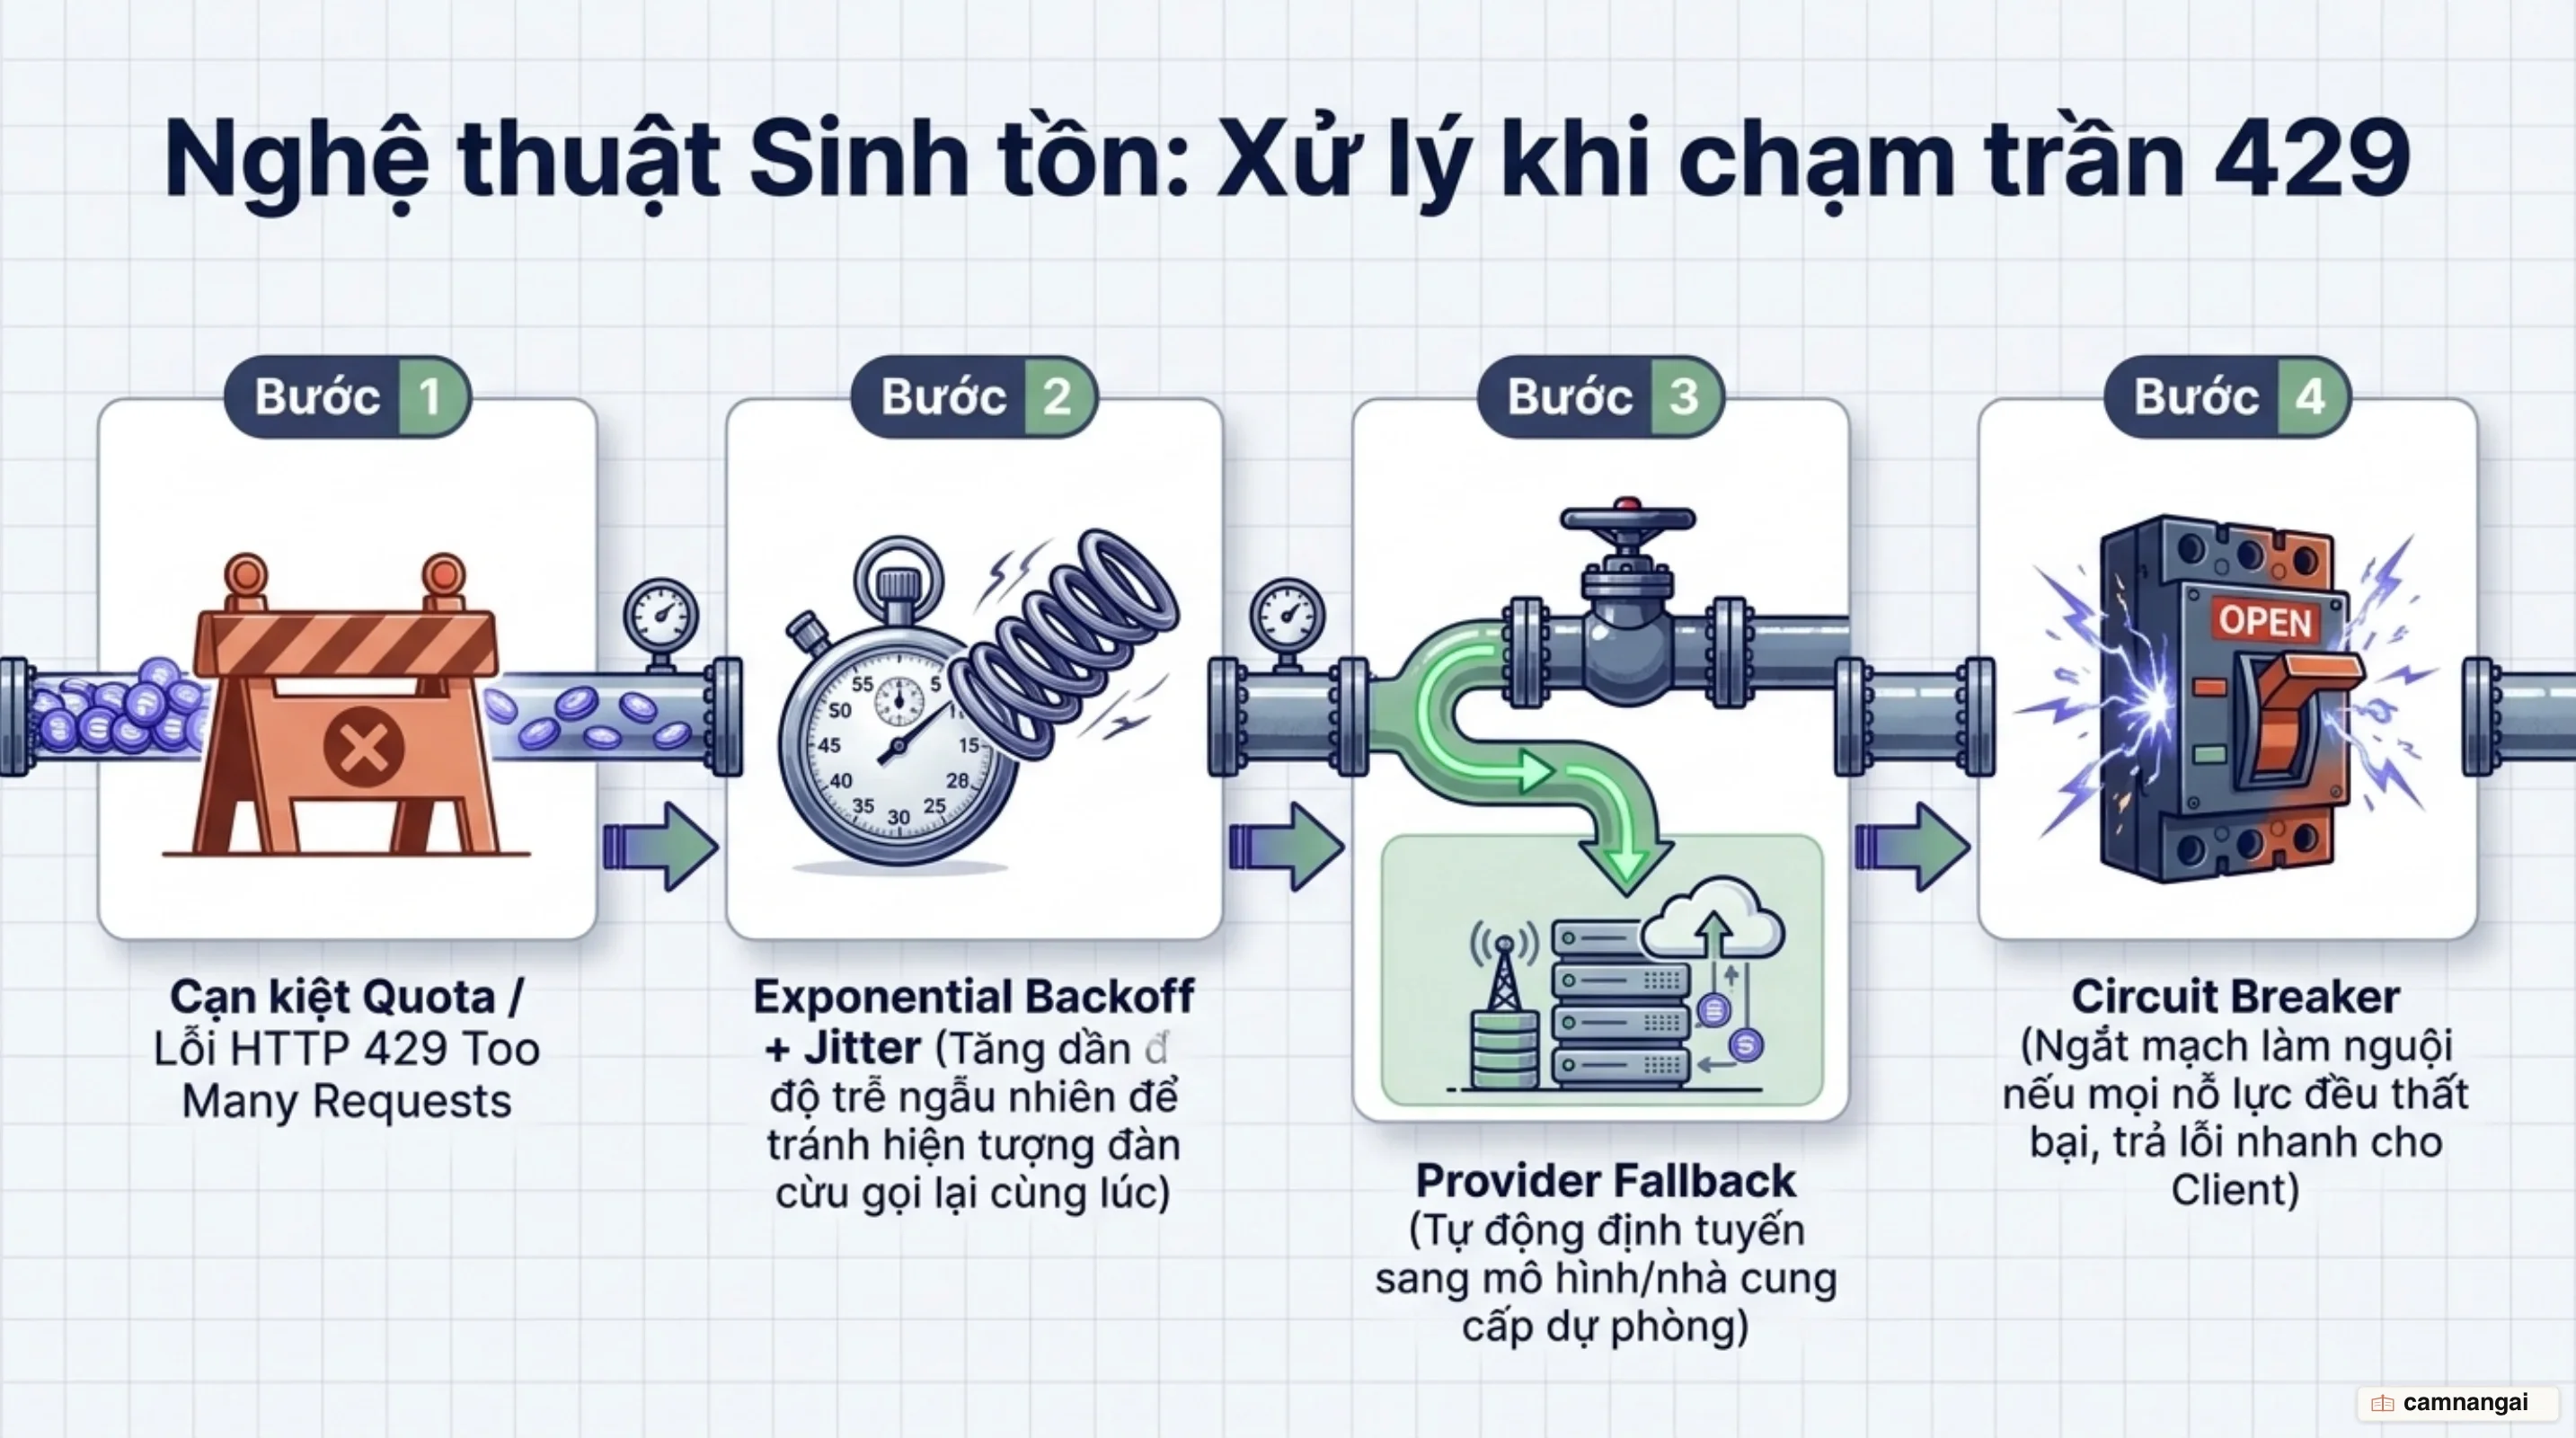
Để đảm bảo tính sẵn sàng cao (High Availability), LLM Gateway cần cấu hình cơ chế tự động thử lại (Automatic Retries) kết hợp thuật toán lùi thời gian lũy thừa (Exponential Backoff). Bạn phải xác định rõ ngưỡng giới hạn số lần thử lại (num_retries) và thời gian tối đa cho một truy vấn (request_timeout). Nếu thiết lập tham số retry quá cao mà không có timeout chặt chẽ, các kết nối HTTP sẽ bị treo, dẫn đến tình trạng cạn kiệt thread pool (thread starvation) toàn bộ hệ thống Gateway.
Các giải pháp AI Gateway hiện đại như LiteLLM Proxy và Portkey triển khai cơ chế Chuyển hướng dự phòng phân cấp (Multi-tier Failover) linh hoạt tùy theo loại lỗi phát sinh:
fallbacks: Kích hoạt chuỗi backup khi gặp lỗi hạ tầng như HTTP Status 429 (Rate Limit), 500, 503 hoặc khi đã vượt quánum_retries.content_policy_fallbacks: Kích hoạt riêng biệt khi nhận lỗi vi phạm chính sách kiểm duyệt nội dung (ContentPolicyViolationError). Cho phép hệ thống chuyển hướng request từ mô hình kiểm duyệt khắt khe (như Azure OpenAI) sang mô hình linh hoạt hơn (như Anthropic) để không gián đoạn trải nghiệm người dùng.context_window_fallbacks: Yêu cầu bật cơ chế kiểm tra trước (enable_pre_call_checks: true). Nếu độ dài prompt vượt quá cửa sổ ngữ cảnh (max_input_tokens) của mô hình hiện tại, Gateway tự động đẩy request sang mô hình có cửa sổ ngữ cảnh lớn hơn mà không cần gọi thử tới provider chính.
Một vấn đề kỹ thuật đặc thù của LLM khi tiến hành failover giữa các provider khác nhau là xử lý dữ liệu suy luận (Reasoning/Thinking data). Khi một chặng gọi chính thất bại ở các lượt hội thoại sau, dữ liệu suy luận đã được mã hóa (reasoning.encrypted_content hoặc các khối thinking) từ provider ban đầu sẽ không thể giải mã bởi provider mục tiêu. LLM Gateway xử lý bằng cách tự động loại bỏ (strip) phần dữ liệu mã hóa không thể đọc này, chỉ giữ lại phần tóm tắt văn bản đọc được (summary). Nhờ đó, model backup có thể suy luận lại từ đầu một cách hợp lệ mà không ném ra lỗi invalid_encrypted_content.
Đoạn cấu hình YAML chuẩn hóa chiến lược Fallbacks + Retries + Cooldowns trên LiteLLM Proxy:
# Ví dụ cấu hình Fallback & Reliability trên LiteLLM Proxy
model_list:
  - model_name: gpt-primary
    litellm_params:
      model: azure/gpt-4o-prod
      api_base: https://primary-eastus.openai.azure.com/
      api_key: os.environ/AZURE_API_KEY_1
  - model_name: gpt-backup
    litellm_params:
      model: anthropic/claude-3-5-sonnet-20241022
      api_key: os.environ/ANTHROPIC_API_KEY

litellm_settings:
  num_retries: 3
  request_timeout: 15
  fallbacks: [{ "gpt-primary": ["gpt-backup"] }]

router_settings:
  allowed_fails: 3
  cooldown_time: 30
Quản trị multi-tenant: Virtual keys, hạn mức và kiểm soát chi phí
Trong môi trường dùng chung (Multi-tenant), AI Gateway quản lý truy cập thông qua các Virtual Key được cấp phát riêng cho từng Consumer hoặc Consumer Group. Với cú pháp chuẩn hóa dạng policies từ Kong Gateway 3.14+ (thay thế cho llm_providers cũ), quy tắc khớp đa chiều trong plugin ai-rate-limiting-advanced cho phép thiết lập chính sách rate limit chi tiết kết hợp đồng thời các tham số: consumer, consumer_group, ip, header, path, model, và provider.
Lưu ý kỹ thuật quan trọng: khi cấu hình quy tắc khớp theo các tham số biến đổi tự do (wildcard/dynamic matching) như model hay consumer, bạn bắt buộc phải đặt partition_by: true. Nếu thiếu thuộc tính này, Gateway sẽ vô tình cộng dồn tất cả các truy vấn của mọi model hoặc tenant vào một bộ đếm dùng chung thay vì phân tách riêng biệt cho từng đối tượng.
plugins:
  - name: ai-rate-limiting-advanced
    config:
      policies:
        - match:
            - type: consumer
              key: id
              values: ["DEV_TEAM_01"]
            - type: model
              partition_by: true
              values: ["gpt-4o"]
          limits:
            - limit: 100
              window_size: 60
Khi luồng Fallback được kích hoạt, AI Gateway thực thi các rào cản bảo mật chặt chẽ đối với Virtual Key:
- Kiểm tra quyền truy cập (
access_groups): Virtual Key của tenant phải được cấp phép gọi model mục tiêu trong chuỗi fallback. Nếu key không có quyền, Gateway lập tức chặn fallback và trả về lỗi nguyên bản của model chính. - Kiểm tra ngân sách (
max_budget): Nếu Virtual Key đã tiêu thụ hết ngân sách chi tiêu, Gateway không cho phép chuyển hướng sang model backup có tính phí. Tùy chọn này đảm bảo trách nhiệm tài chính, tránh tình trạng các request gọi model miễn phí tự động tràn sang các model trả phí đắt đỏ khi gặp sự cố.
Để đảm bảo tính minh bạch, Gateway chủ động trả về các HTTP Header phản hồi cho client để thông báo trạng thái tiêu thụ:
X-AI-RateLimit-Limit-*-policy: Ngưỡng giới hạn được áp dụng theo policy.X-AI-RateLimit-Remaining-*-policy: Hạn mức còn lại trong cửa sổ thời gian.X-AI-RateLimit-Reset: Thời gian (tính bằng giây) cho đến khi quota khôi phục.X-AI-RateLimit-Query-Cost: Chi phí tính toán/token của request vừa thực hiện.
Trường hợp vi phạm hạn mức, Gateway trả về lỗi HTTP 429 kèm JSON payload thông báo rõ provider hoặc policy bị vượt giới hạn: {"message": "API rate limit exceeded for provider azure, cohere"}.
Đối với công tác kiểm toán chi phí (Spend Tracking), hệ thống ghi log ngân sách (Spend Logs) bắt buộc phải lưu trữ đầy đủ các trường metadata phục vụ truy vết sau thất bại: attempted_fallbacks (số lần thử fallback đã thực hiện) và original_model_group (nhóm model gốc được ứng dụng gọi ban đầu).
Khi nào bạn thực sự cần một LLM Gateway chuyên dụng?
Bạn chưa cần triển khai một LLM Gateway chuyên dụng nếu kiến trúc ứng dụng hiện tại đơn giản: chỉ tích hợp duy nhất 1 LLM provider, lưu lượng truy cập thấp nằm hoàn toàn dưới ngưỡng RPM/TPM cơ bản của Start Tier, và hệ thống vận hành theo mô hình đơn tenant (single-tenant).
Bạn bắt buộc phải triển khai một LLM Gateway chuyên dụng khi hạ tầng đạt tới các cột mốc kỹ thuật sau:
- Hệ thống kết nối đa provider (OpenAI, Anthropic, Bedrock, Azure OpenAI) đòi hỏi cơ chế tự động failover/fallback tức thì để đảm bảo SLA dịch vụ mà không được sửa đổi code ứng dụng.
- Cần phân chia Virtual Keys nhằm kiểm soát hạn mức (Rate limit) và ép trần ngân sách (Monthly Budget Cap) chi tiết tới từng phân nhóm người dùng, phòng ban hoặc khách hàng trong môi trường multi-tenant.
- Cần tập trung hóa quản trị API Key, chuẩn hóa định dạng log chi phí (spend logs), đồng thời thực thi đồng loạt các chính sách bảo mật (Guardrails, DLP, Prompt Caching) ngay tại lớp đệm proxy trước khi traffic thoát ra ngoài internet.