Đánh giá AI (AI Evals) là hệ thống đo lường chất lượng toàn diện nhằm xác định chính xác liệu một ứng dụng AI có đáp ứng đúng nhu cầu người dùng và mục tiêu kinh doanh hay không.
Thay vì dựa vào những kiểm thử cảm tính chủ quan ("vibe checks"), đánh giá AI chuyển hóa các tiêu chuẩn chất lượng thành các chỉ số kỹ thuật có thể đo lường tự động.
Quy trình này kiểm tra toàn bộ các thành phần cấu thành sản phẩm, bao gồm (LLM), câu lệnh (prompt), hệ thống truy xuất dữ liệu (retrieval), công cụ tích hợp (tools) và mã nguồn ứng dụng (application code).
Khi đưa sản phẩm AI vào vận hành thực tế, sự biến thiên trong đầu ra của mô hình đòi hỏi bạn phải áp dụng phương pháp luận khoa học nhằm phát hiện sớm các sai sót hệ thống. Lỗi phát hiện qua đánh giá không dừng lại ở việc vá lỗi tức thời: chúng là nguồn dữ liệu quý giá để liên tục tối ưu hóa hệ thống. Việc xây dựng quy trình kiểm thử đáng tin cậy giúp bạn loại bỏ sự phỏng đoán, đảm bảo tính ổn định và ngăn ngừa hiện tượng thoái hóa hiệu năng khi nâng cấp mô hình hay cập nhật kiến trúc.
AI Evals là gì và vì sao "vibe check" khiến sản phẩm thất bại?
Để xây dựng một hệ thống đánh giá hiệu quả, bạn cần phân biệt rõ ràng giữa hai khái niệm: Model Benchmarks và Product Evals. Model Benchmarks là các bộ kiểm thử học thuật do nhà cung cấp mô hình công bố, ví dụ như GPQA Diamond cho năng lực lý luận khoa học, Terminal-Bench cho tác vụ dòng lệnh, hoặc MMLU cho kiến thức tổng quát. Những điểm số này cung cấp điểm tựa ban đầu để bạn lựa chọn . Tuy nhiên, một mô hình đạt điểm cao trên MMLU không đảm bảo ứng dụng thực tế của bạn (ví dụ một tác nhân xử lý hủy đơn hàng) sẽ hoạt động chính xác. Product Evals đo lường trực tiếp hành vi của ứng dụng trên miền dữ liệu, quy trình nghiệp vụ và logic công cụ cụ thể mà bạn triển khai.
Việc phụ thuộc vào kiểm thử thủ công chủ quan ("vibe check") là nguyên nhân hàng đầu khiến các sản phẩm AI thất bại khi mở rộng quy mô. Khi ứng dụng phát triển, việc bạn chỉnh sửa một câu lệnh () hoặc thay đổi logic truy xuất nhằm sửa một lỗi cụ thể thường vô tình gây ra lỗi thoái hóa (regression) ở các kịch bản khác. Nếu không có bộ kiểm thử tự động, đội ngũ kỹ thuật của bạn sẽ rơi vào trạng thái "bay mù" (flying blind), chỉ phát hiện ra sự sụt giảm chất lượng khi người dùng cuối phản ánh.
Ngoài ra, cố gắng tối ưu để đạt tỷ lệ vượt qua 100% trên bộ kiểm thử thường là một cái bẫy. Một bộ test suite khắt khe với tỷ lệ vượt qua 70% mang lại tín hiệu chẩn đoán có giá trị hơn nhiều so với một bộ kiểm thử dễ dãi luôn đạt điểm tối đa.
Xây dựng hệ thống đánh giá sản phẩm bản chất là việc bạn áp dụng phương pháp luận khoa học vào quy trình kỹ nghệ AI. Chu trình này bắt đầu bằng bước Quan sát (Observation) thông qua việc đọc log và trace hệ thống. Tiếp theo, bạn tiến hành Gán nhãn (Annotation) các mẫu thành công và thất bại. Từ dữ liệu này, bạn đưa ra Giả thuyết (Hypothesis) về nguyên nhân gây lỗi (do truy xuất sai dữ liệu, prompt thiếu dữ kiện hay công cụ trả về lỗi). Sau đó, bạn Thiết kế thực nghiệm (Experimentation) bằng cách điều chỉnh prompt, thay đổi tham số truy xuất hoặc nâng cấp mô hình, và cuối cùng là Đo lường kết quả (Outcome measurement) bằng các chỉ số định lượng thay vì cảm nhận cá nhân.
Một quy trình đánh giá AI hệ thống tạo ra bánh đà dữ liệu (data flywheel) cải tiến liên tục cho sản phẩm của bạn. Khi mỗi lỗi phát sinh trên thực tế được chuyển hóa thành một bài kiểm thử tự động, tỷ lệ khuyết tật của hệ thống sẽ giảm dần theo thời gian. Quy trình này định hình kỷ luật kỹ thuật cho đội ngũ phát triển, đưa việc tối ưu hóa prompt và kiến trúc thoát khỏi trạng thái thử-sai ngẫu nhiên, từ đó xây dựng niềm tin lâu dài từ phía người dùng.
Ba cấp độ đánh giá từ cơ bản đến nâng cao
Một kiến trúc đánh giá sản phẩm toàn diện được phân thành ba cấp độ từ thấp đến cao, kết hợp giữa kiểm tra định lượng chính xác và năng lực đánh giá định tính.
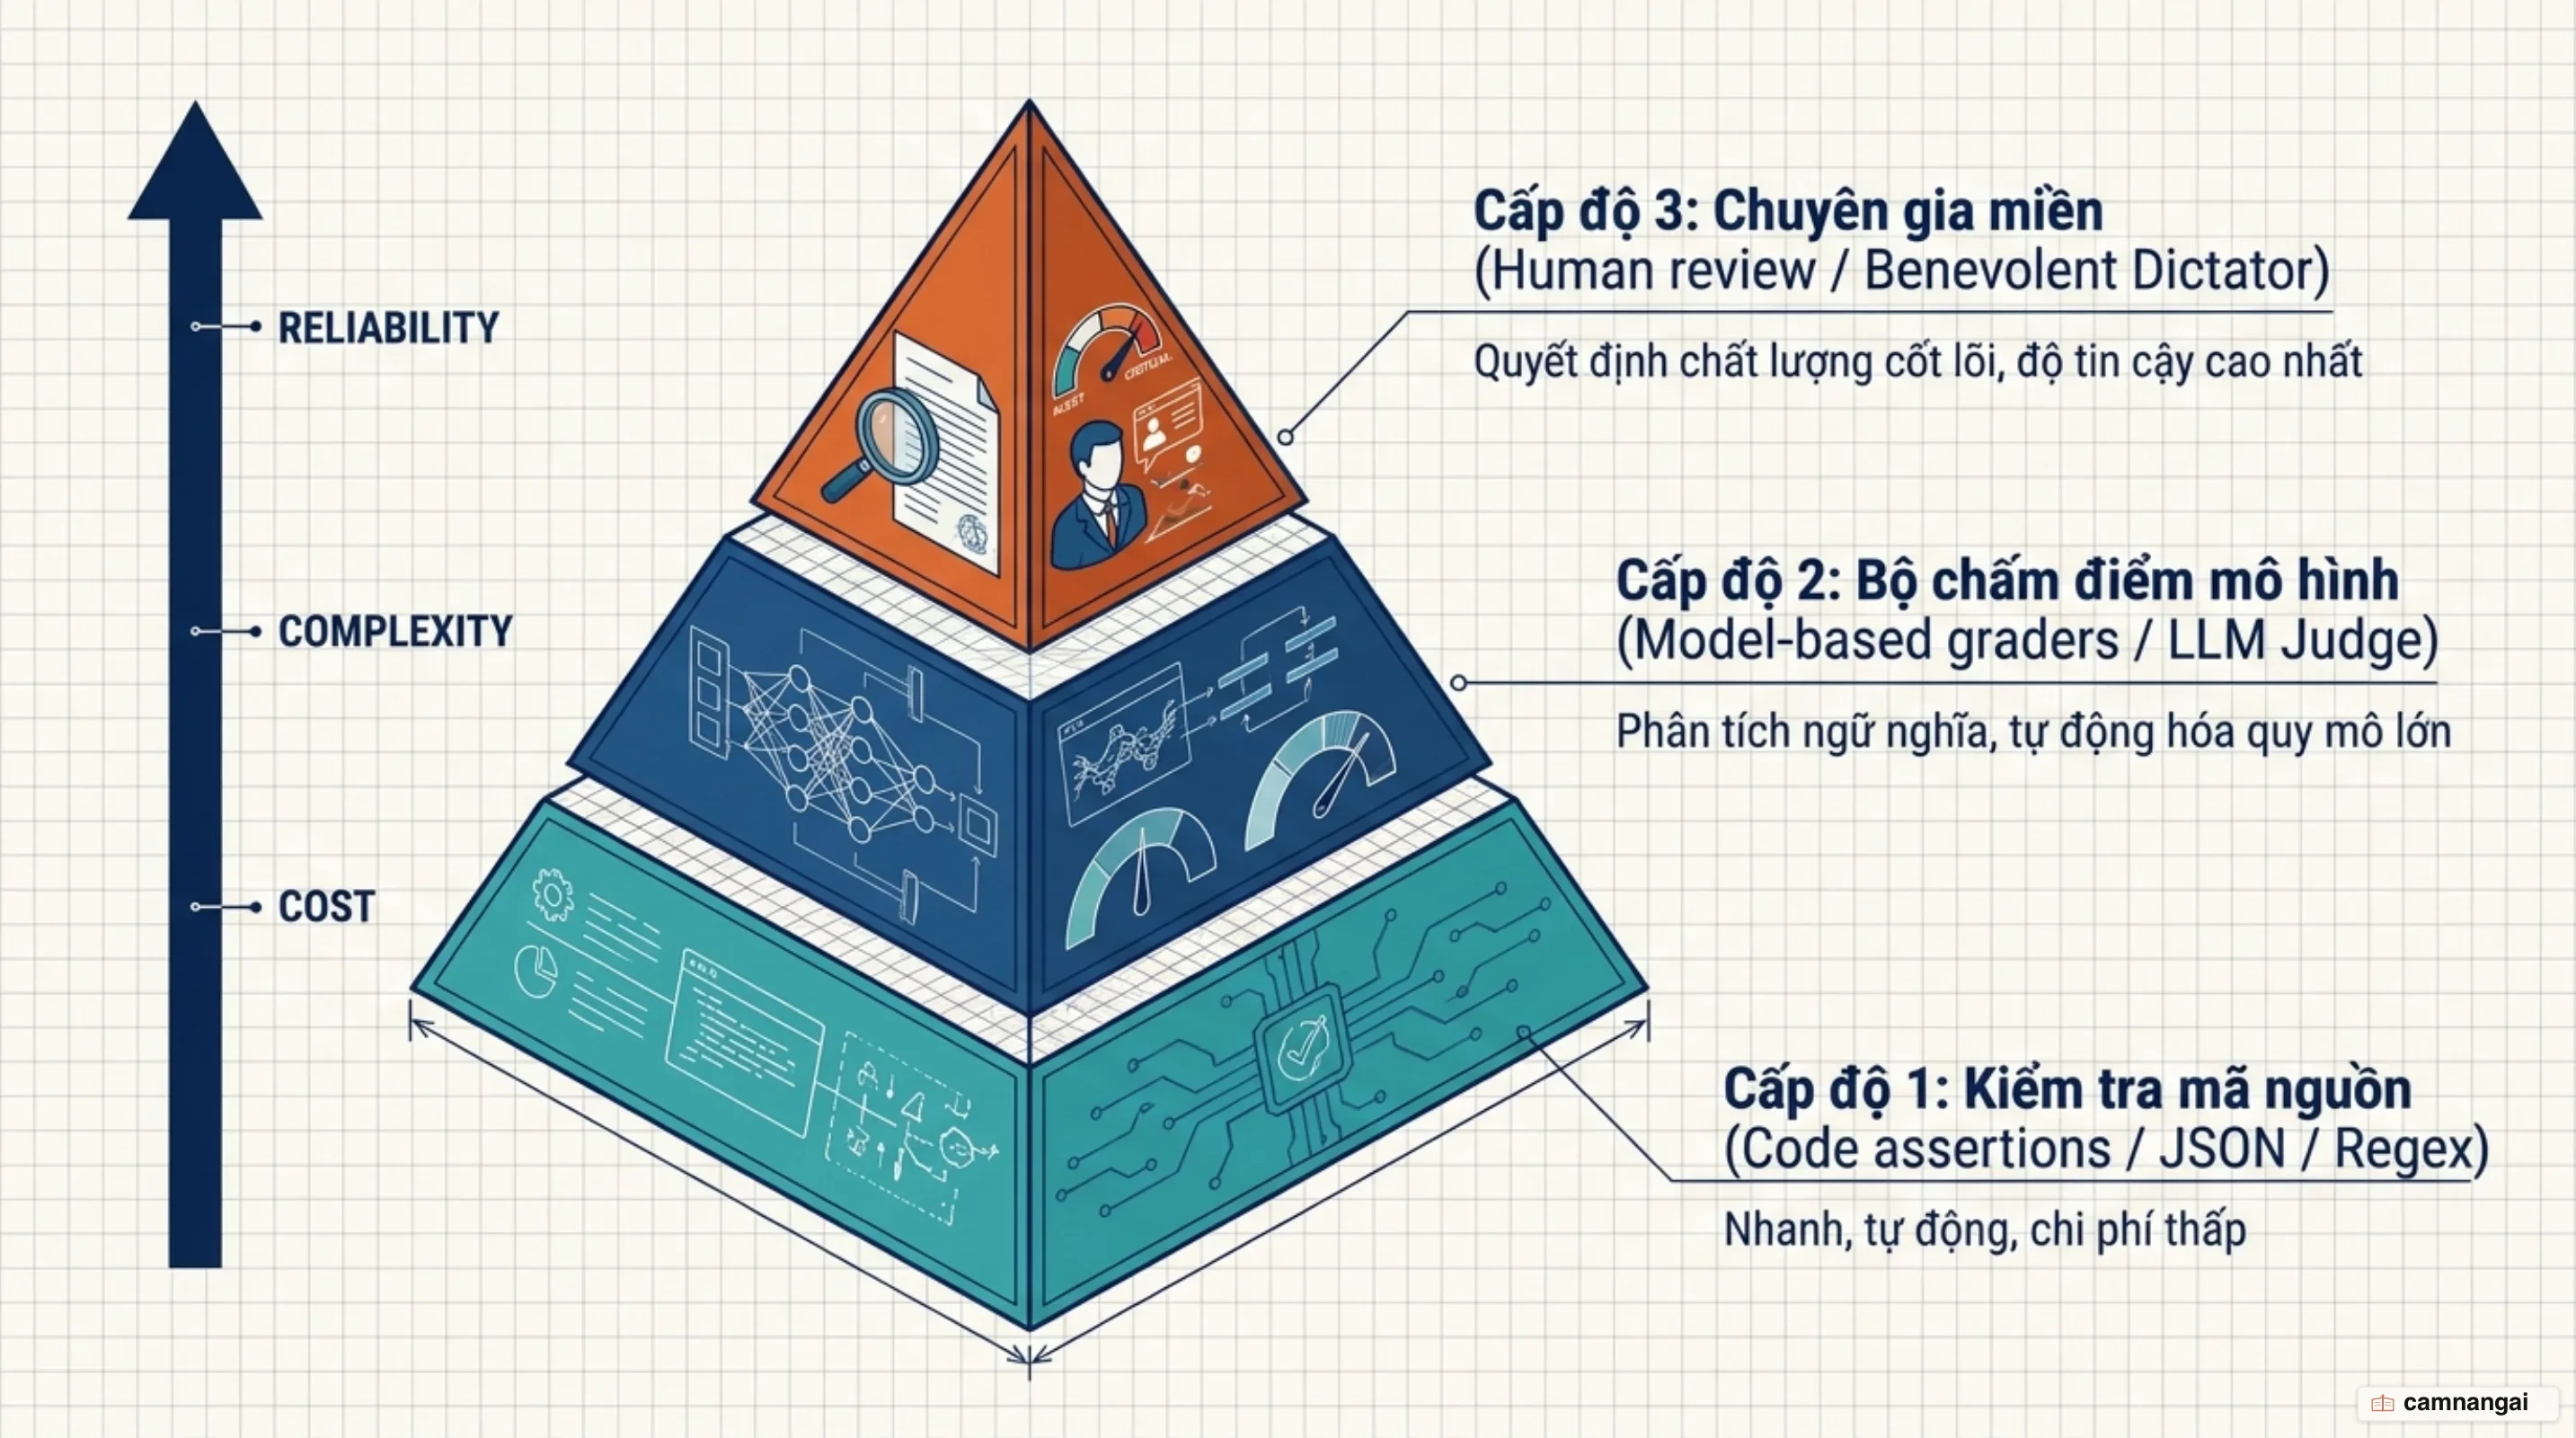
Khi triển khai ở Cấp độ 1 (Code-based assertions), bạn sử dụng các kiểm thử dựa trên mã nguồn thuần túy. Đây là lớp phòng thủ đầu tiên, có tốc độ thực thi cực nhanh, chi phí thấp và tính định lượng tuyệt đối.
Bạn có thể sử dụng mã nguồn để kiểm tra tính hợp lệ của cấu trúc JSON đầu ra, đối sánh chuỗi bằng biểu thức chính quy (Regex), kiểm tra cú pháp mã sinh ra, hoặc truy vấn trực tiếp cơ sở dữ liệu để xác nhận trạng thái hệ thống. Ví dụ, sau khi tác nhân tuyên bố đã lưu thông tin khách hàng, một câu lệnh SQL assertion sẽ kiểm tra xem bản ghi tương ứng có xuất hiện trong cơ sở dữ liệu hay không.
Ở Cấp độ 2 (Model-based graders / LLM-as-a-Judge & Classifiers), bạn áp dụng các mô hình làm trình đánh giá để xử lý các tiêu chí định tính mà mã nguồn không thể kiểm tra trực tiếp, như văn phong, độ hoàn thiện hoặc khả năng tuân thủ chính sách bảo mật.
Bạn có thể triển khai các LLM thương mại lớn hoặc các mô hình phân loại nhẹ như Jev, BERT, hoặc Logistic Regression tùy thuộc vào ngân sách độ trễ và chi phí. Điểm mấu chốt là bạn phải thiết kế các mô hình đánh giá này thành các bộ phân loại đơn mục tiêu, tập trung kiểm tra một loại lỗi cụ thể thay vì bắt mô hình chấm điểm mở trên nhiều tiêu chí phức tạp.
Cấp độ 3 là đánh giá từ chuyên gia miền (Human Review / Domain Expert). Trong dự án của bạn, việc chỉ định một chuyên gia miền xuất sắc làm người quyết định chất lượng tối cao ("benevolent dictator", ví dụ bác sĩ đối với ứng dụng y tế hoặc luật sư đối với ứng dụng pháp lý) sẽ mang lại hiệu quả cao nhất.
Chuyên gia này xác lập tiêu chuẩn chất lượng, loại bỏ các tranh cãi kéo dài giữa nhiều người gán nhãn, và cung cấp tập nhãn chuẩn (gold standard). Nhãn từ con người phục vụ việc hiệu chuẩn (calibrate) các bộ đánh giá tự động ở Cấp độ 2 và làm rõ các quy tắc nghiệp vụ ranh giới.
Khi thiết kế tiêu chí đánh giá, bạn nên ưu tiên tuyệt đối nhãn nhị phân (Pass/Fail) thay vì thang đo Likert 1–5.
Thang đo 1–5 tạo ra nhiễu chủ quan, làm tăng độ lệch giữa những người gán nhãn, yêu cầu kích thước mẫu lớn hơn để đạt ý nghĩa thống kê, và khiến người đánh giá có xu hướng chọn các giá trị an toàn ở giữa (3 hoặc 4). Trái lại, đánh giá nhị phân ép buộc tiêu chuẩn vận hành rõ ràng, giúp thao tác gán nhãn diễn ra nhanh chóng. Nếu bạn muốn đo lường sự tiến bộ trên các nhiệm vụ phức tạp, hãy chia nhỏ nhiệm vụ đó thành nhiều phép kiểm tra nhị phân độc lập.
Bắt đầu bằng Error Analysis: Đọc log trước khi viết code kiểm thử
Phân tích lỗi (Error Analysis) là hoạt động nền tảng quan trọng nhất trong toàn bộ quy trình đánh giá AI. Bạn nên dành 60–80% thời gian phát triển để đọc log và phân tích các trace thất bại thay vì vội vã xây dựng cơ sở hạ tầng kiểm thử tự động phức tạp.
Việc trực tiếp quan sát dữ liệu thực tế giúp bạn phát hiện đúng các chế độ lỗi (failure modes) của ứng dụng, tránh lãng phí nguồn lực vào việc viết mã kiểm thử cho những giả định sai lầm.
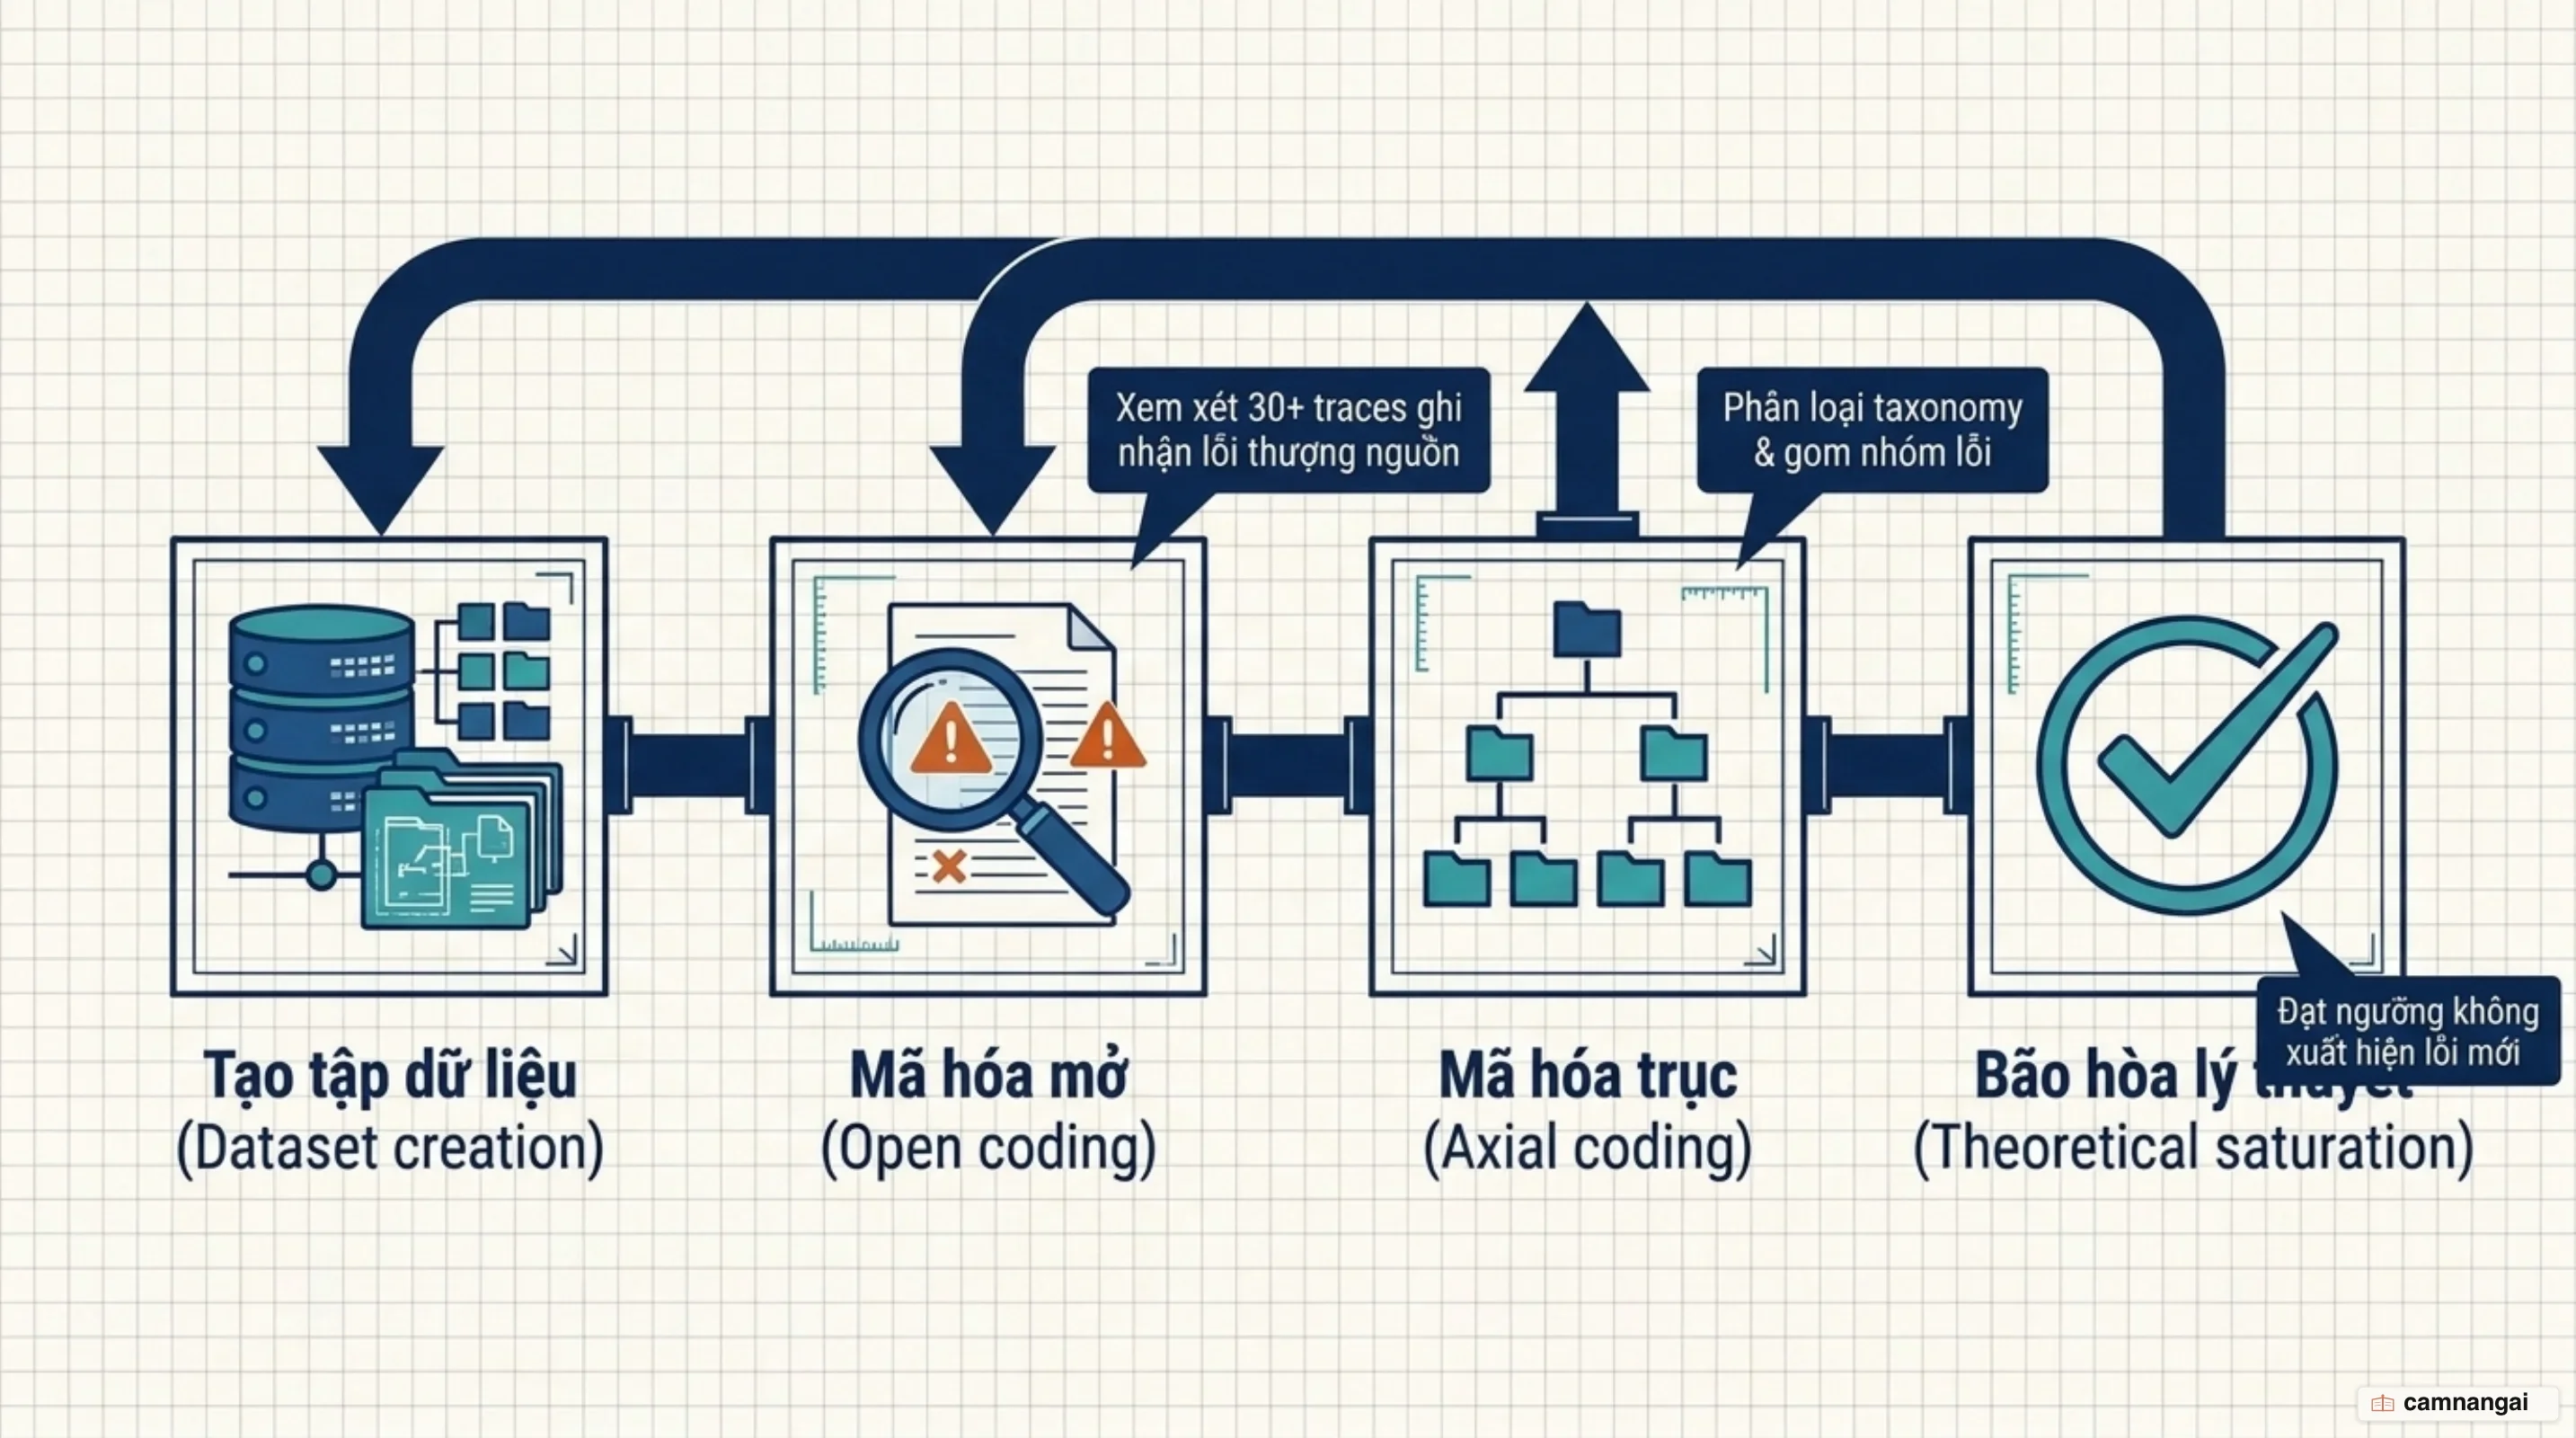
Quy trình phân tích lỗi được thực hiện theo chuỗi bước bài bản. Đầu tiên, bạn khởi tạo tập dữ liệu (Dataset Creation) bằng cách thu thập các trace đại diện cho tương tác người dùng. Tiếp theo, bạn tiến hành mã hóa mở (Open Coding): tự mình đọc và viết ghi chú định tính tự do cho ít nhất 30 trace đầu tiên, chỉ tập trung ghi nhận lỗi thượng nguồn (upstream failure) đầu tiên xuất hiện để tránh bị nhiễu bởi các lỗi hệ quả hạ nguồn. Sau đó, bạn thực hiện mã hóa trục (Axial Coding) bằng cách gom nhóm các ghi chú tự do thành một danh mục phân loại lỗi (failure taxonomy) có cấu trúc và tính toán tần suất của từng loại. Cuối cùng, bạn sử dụng các hoặc thuật toán phân cụm để quét các trace còn lại cho đến khi đạt trạng thái bão hòa lý thuyết (theoretical saturation), tức thời điểm việc đọc thêm trace mới không còn phát hiện thêm loại lỗi mới hay làm thay đổi danh mục lỗi hiện tại.
Bạn tuyệt đối không nên giao khoán (outsource) quy trình phân tích lỗi hoặc mã hóa mở ban đầu cho bên thứ ba hoặc các LLM tổng quát. Việc giao khoán sẽ phá vỡ vòng phản hồi trực tiếp giữa việc phát hiện sai sót và năng lực cải tiến kiến trúc của bạn, đồng thời làm thất thoát tri thức ẩn (tacit knowledge) của chuyên gia miền, tức những hiểu biết sâu sắc không thể thể hiện trọn vẹn qua một bản mô tả quy tắc đơn giản.
Dữ liệu ghi nhận từ quy trình phân tích lỗi (bao gồm các trace đã gán nhãn và danh mục phân loại lỗi) chính là nguồn dữ liệu đầu vào (seed data) và tiêu chí bộ quy tắc (rubric) để bạn xây dựng và hiệu chuẩn các bộ phân loại hoặc LLM judge ở Cấp độ 2. Đối với các hệ thống chứa thông tin định danh cá nhân (PII) hoặc dữ liệu nhạy cảm, bạn có thể xử lý bằng cách loại bỏ PII (redaction) trước khi lưu log, phối hợp với các chuyên gia nội bộ được ủy quyền, hoặc sinh dữ liệu tổng hợp (synthetic data) có cấu trúc như một giải pháp thay thế cuối cùng khi rào cản pháp lý không cho phép tiếp cận dữ liệu thực.
Quy trình ba bước xây dựng Product Evals chuẩn kỹ nghệ
Khi xây dựng bộ kiểm thử sản phẩm, bước đầu tiên của bạn là thu thập và gán nhãn dữ liệu (Data Collection & Labeling). Bạn cần lắp ráp một tập dữ liệu đánh giá cân bằng, lý tưởng nhất là tỷ lệ 50:50 giữa kịch bản đạt (Pass) và thất bại (Fail) trên toàn bộ dải phân bố đầu vào. Về quy mô, bạn cần khoảng 20–50 trace cho giai đoạn thiết lập ban đầu và phát hiện lỗi. Tuy nhiên, để hiệu chuẩn các bộ đánh giá tự động (LLM judge), bạn cần chuẩn bị từ 100–200 ví dụ đã gán nhãn cho mỗi chế độ lỗi cụ thể nhằm đảm bảo tính đại diện thống kê.
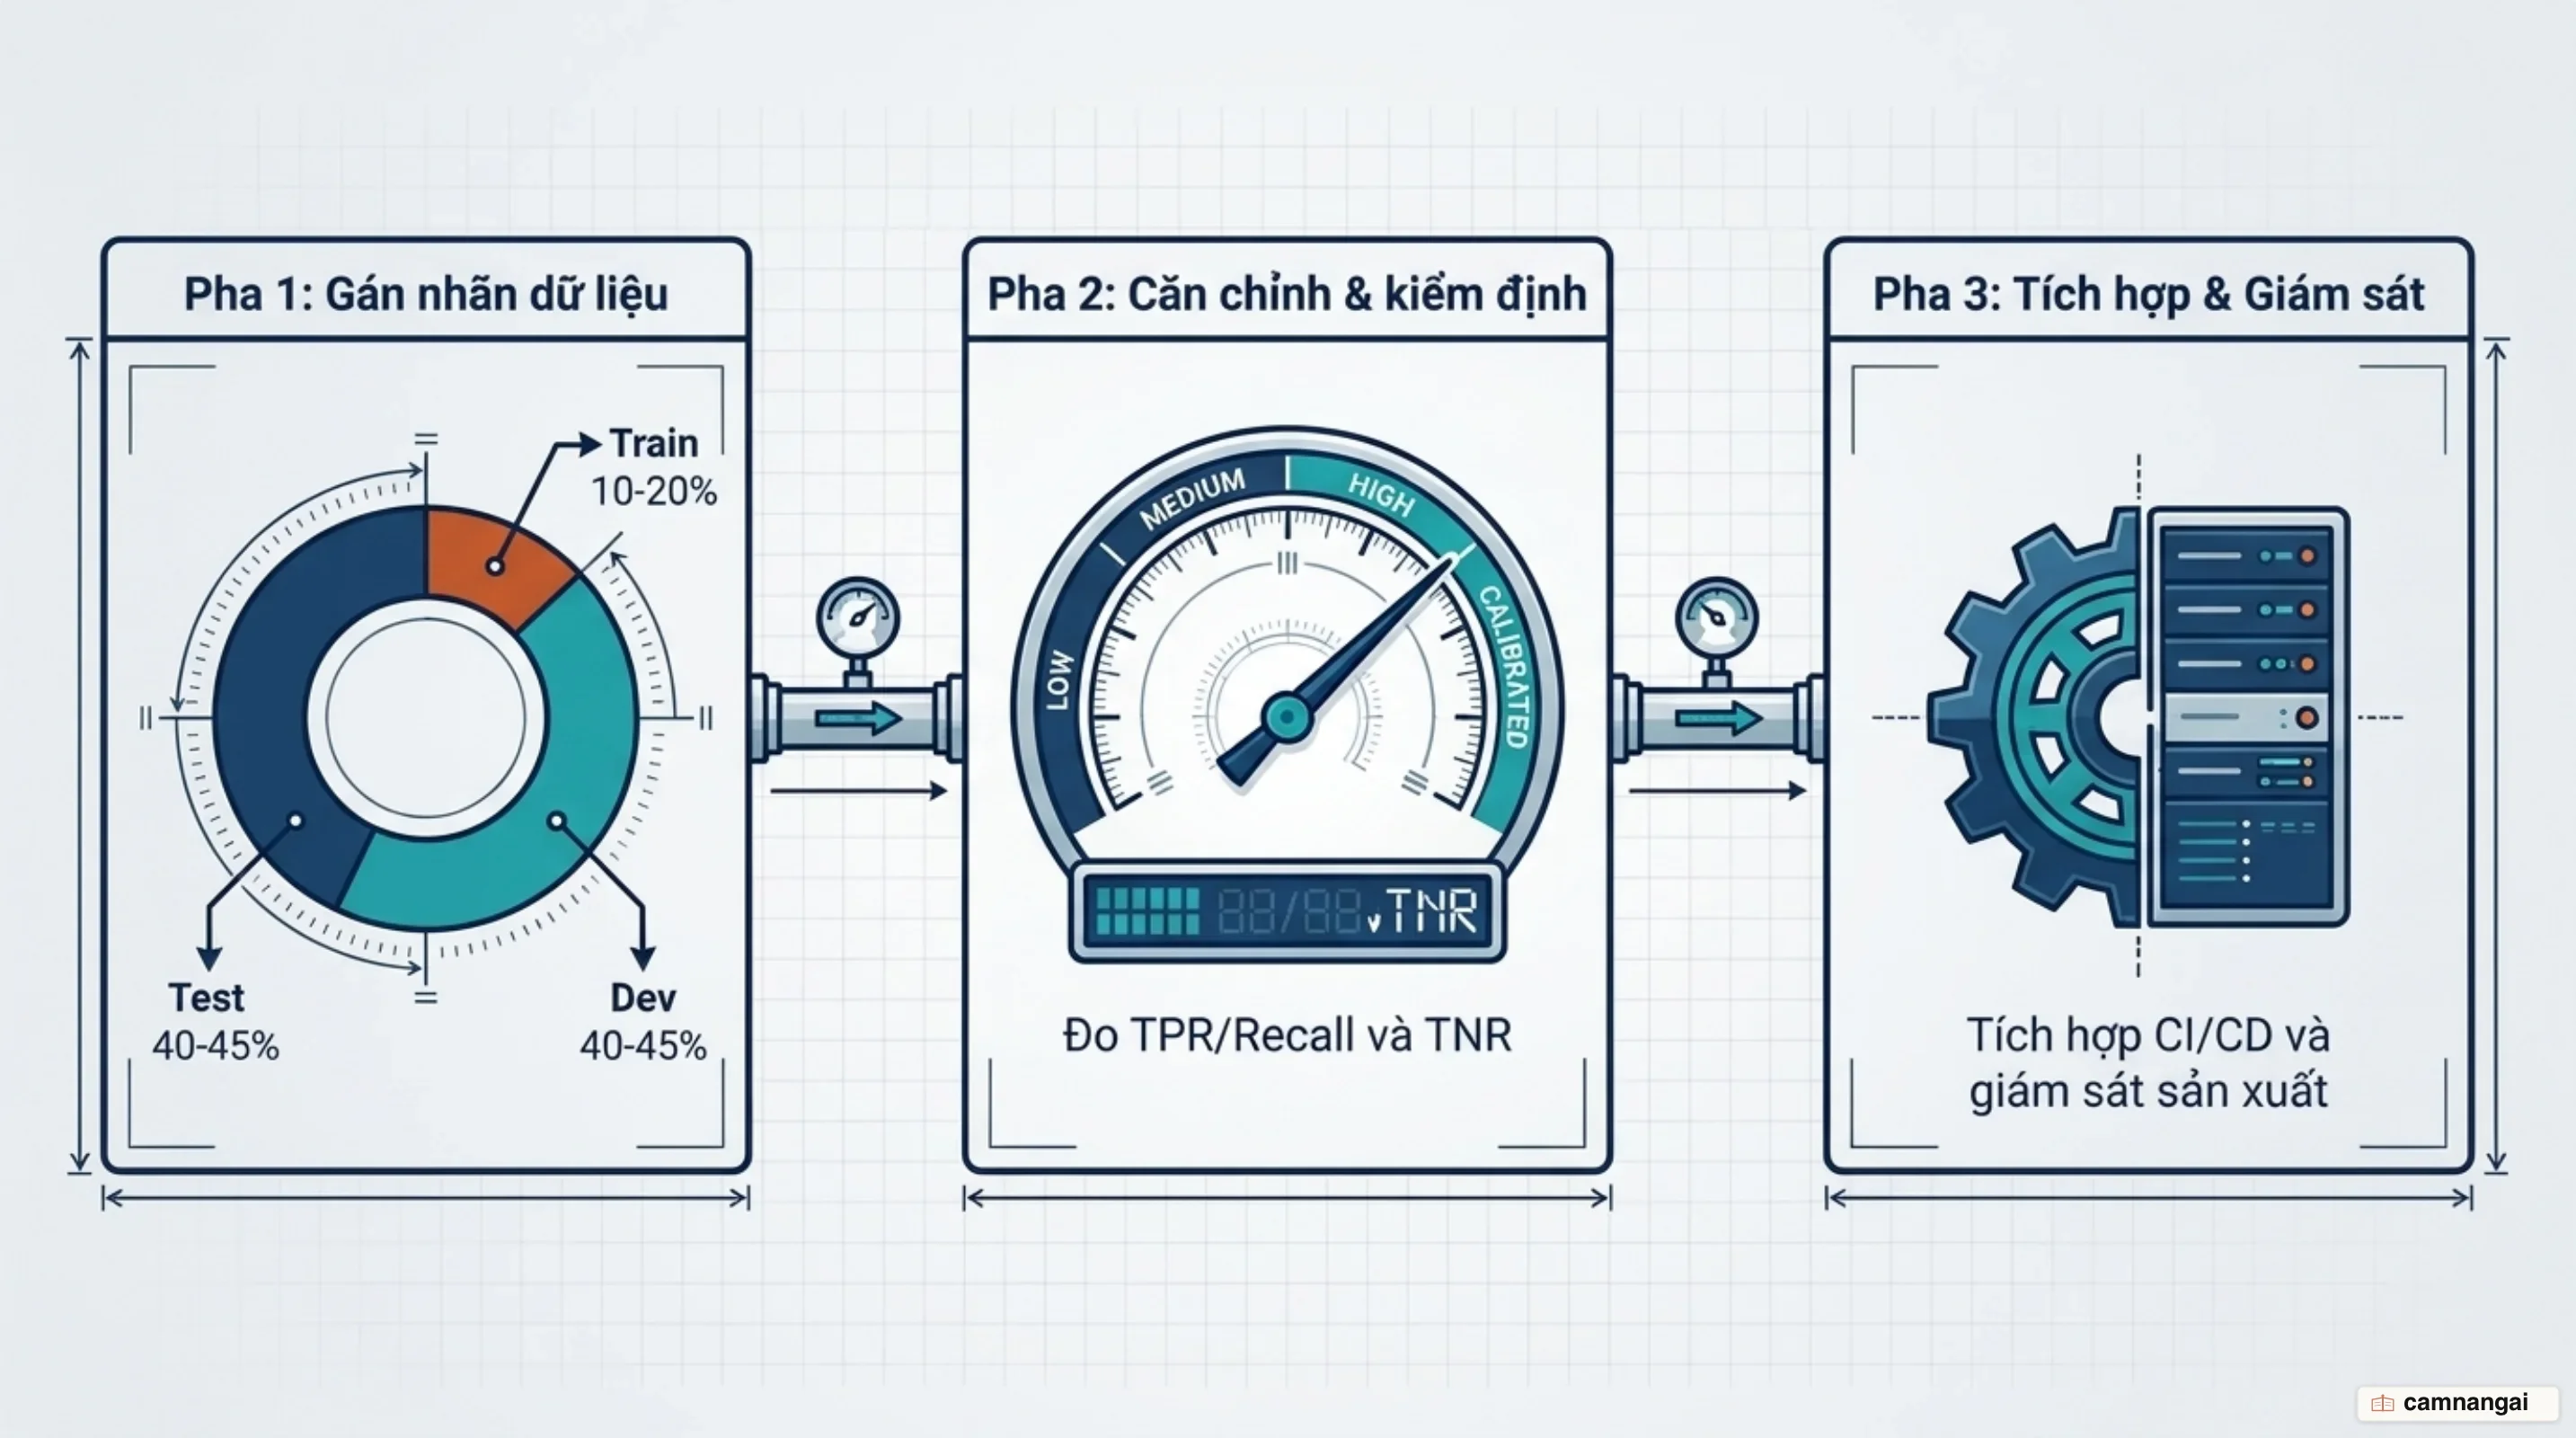
Bước thứ hai là căn chỉnh và kiểm định bộ đánh giá (Evaluator Alignment & Validation). Bạn chia tách tập dữ liệu đã gán nhãn thành ba tập riêng biệt: Tập Huấn luyện (Train set: 10–20%), Tập Phát triển (Dev set: 40–45%), và Tập Kiểm thử độc lập (Test set: 40–45%). Việc chia tách này là bắt buộc để ngăn ngừa hiện tượng quá khớp (overfitting) của bộ đánh giá trong quá trình tinh chỉnh prompt tự động. Bạn sử dụng tập Dev để điều chỉnh prompt đánh giá và đo lường hai chỉ số: Tỷ lệ Dương tính Thật (TPR / Recall - khả năng phát hiện đúng lỗi) và Tỷ lệ Âm tính Thật (TNR - khả năng xác nhận đúng đầu ra đạt). Tập Test được giữ nguyên vẹn cho lần kiểm tra cuối cùng để đánh giá chính xác năng lực tổng quát hóa của bộ đánh giá trên dữ liệu chưa từng gặp.
Bước thứ ba là tích hợp vào đường ống CI/CD và giám sát sản xuất. Trong đường ống CI/CD, bạn vận hành bộ dữ liệu rút gọn (khoảng 100+ mẫu đại diện cho tính năng cốt lõi và lỗi quá khứ), ưu tiên các phép kiểm nhanh bằng code assertions để chặn lỗi thoái hóa trước khi triển khai. Trái lại, hệ thống giám sát sản xuất chạy bất đồng bộ trên luồng dữ liệu thực tế, sử dụng các LLM judge không cần tham chiếu (reference-free evaluators) kết hợp với khoảng tin cậy thống kê (confidence intervals) để phát hiện sự lệch phân bố dữ liệu.
Các bài kiểm thử trong đường ống CI/CD được cấu hình dưới dạng các file mã nguồn định dạng chuẩn hóa, kết hợp đồng thời nhiều cấp độ kiểm tra trên một nhiệm vụ:
# Ví dụ cấu hình file Task Evaluation cho hệ thống AI
task_id: "verify_order_cancellation_001"
description: "Kiểm tra agent hủy đơn hàng và cập nhật database"
inputs:
  user_query: "Hủy đơn hàng #92841 giúp tôi"
graders:
  - type: "code_assertion"
    check: "json_response_valid"
  - type: "state_check"
    db_query: "SELECT status FROM orders WHERE id=92841"
    expected: "CANCELLED"
  - type: "llm_rubric"
    rubric_prompt: "prompts/cancellation_politeness_rubric.md"
    expected_result: "PASS"
metrics_tracked:
  - "latency_seconds"
  - "total_tokens_used"
Cấu hình trên thể hiện rõ mô hình kiểm thử đa tầng cho một tác vụ: code_assertion kiểm tra nhanh cấu trúc JSON đầu ra ở Cấp độ 1; state_check truy vấn cơ sở dữ liệu để xác nhận trạng thái đơn hàng đã chuyển thành CANCELLED; và llm_rubric gọi một mô hình ở Cấp độ 2 để đánh giá thái độ lịch sự của câu trả lời.
Kiến trúc đánh giá cho hệ thống RAG: 3 biến và 6 phép kiểm
Đánh giá hệ thống RAG (Retrieval-Augmented Generation) đòi hỏi bạn tách biệt hoàn toàn hai thành phần: Khâu truy xuất (Retrieval) và Khâu sinh văn bản (Generation).
Khâu truy xuất bản chất là một bài toán tìm kiếm thông tin (Information Retrieval - IR) truyền thống, cần được đo lường độc lập bằng các chỉ số IR kinh điển như Recall@k (tỷ lệ tài liệu liên quan thu được trong top k), Precision@k (tỷ lệ tài liệu chuẩn trong top k), và Mean Reciprocal Rank (MRR
- vị trí thứ hạng của tài liệu liên quan đầu tiên). Bạn cũng có thể áp dụng các phương pháp đo chất lượng ngữ cảnh chuyên sâu để cô lập lỗi ngay từ tầng dữ liệu.
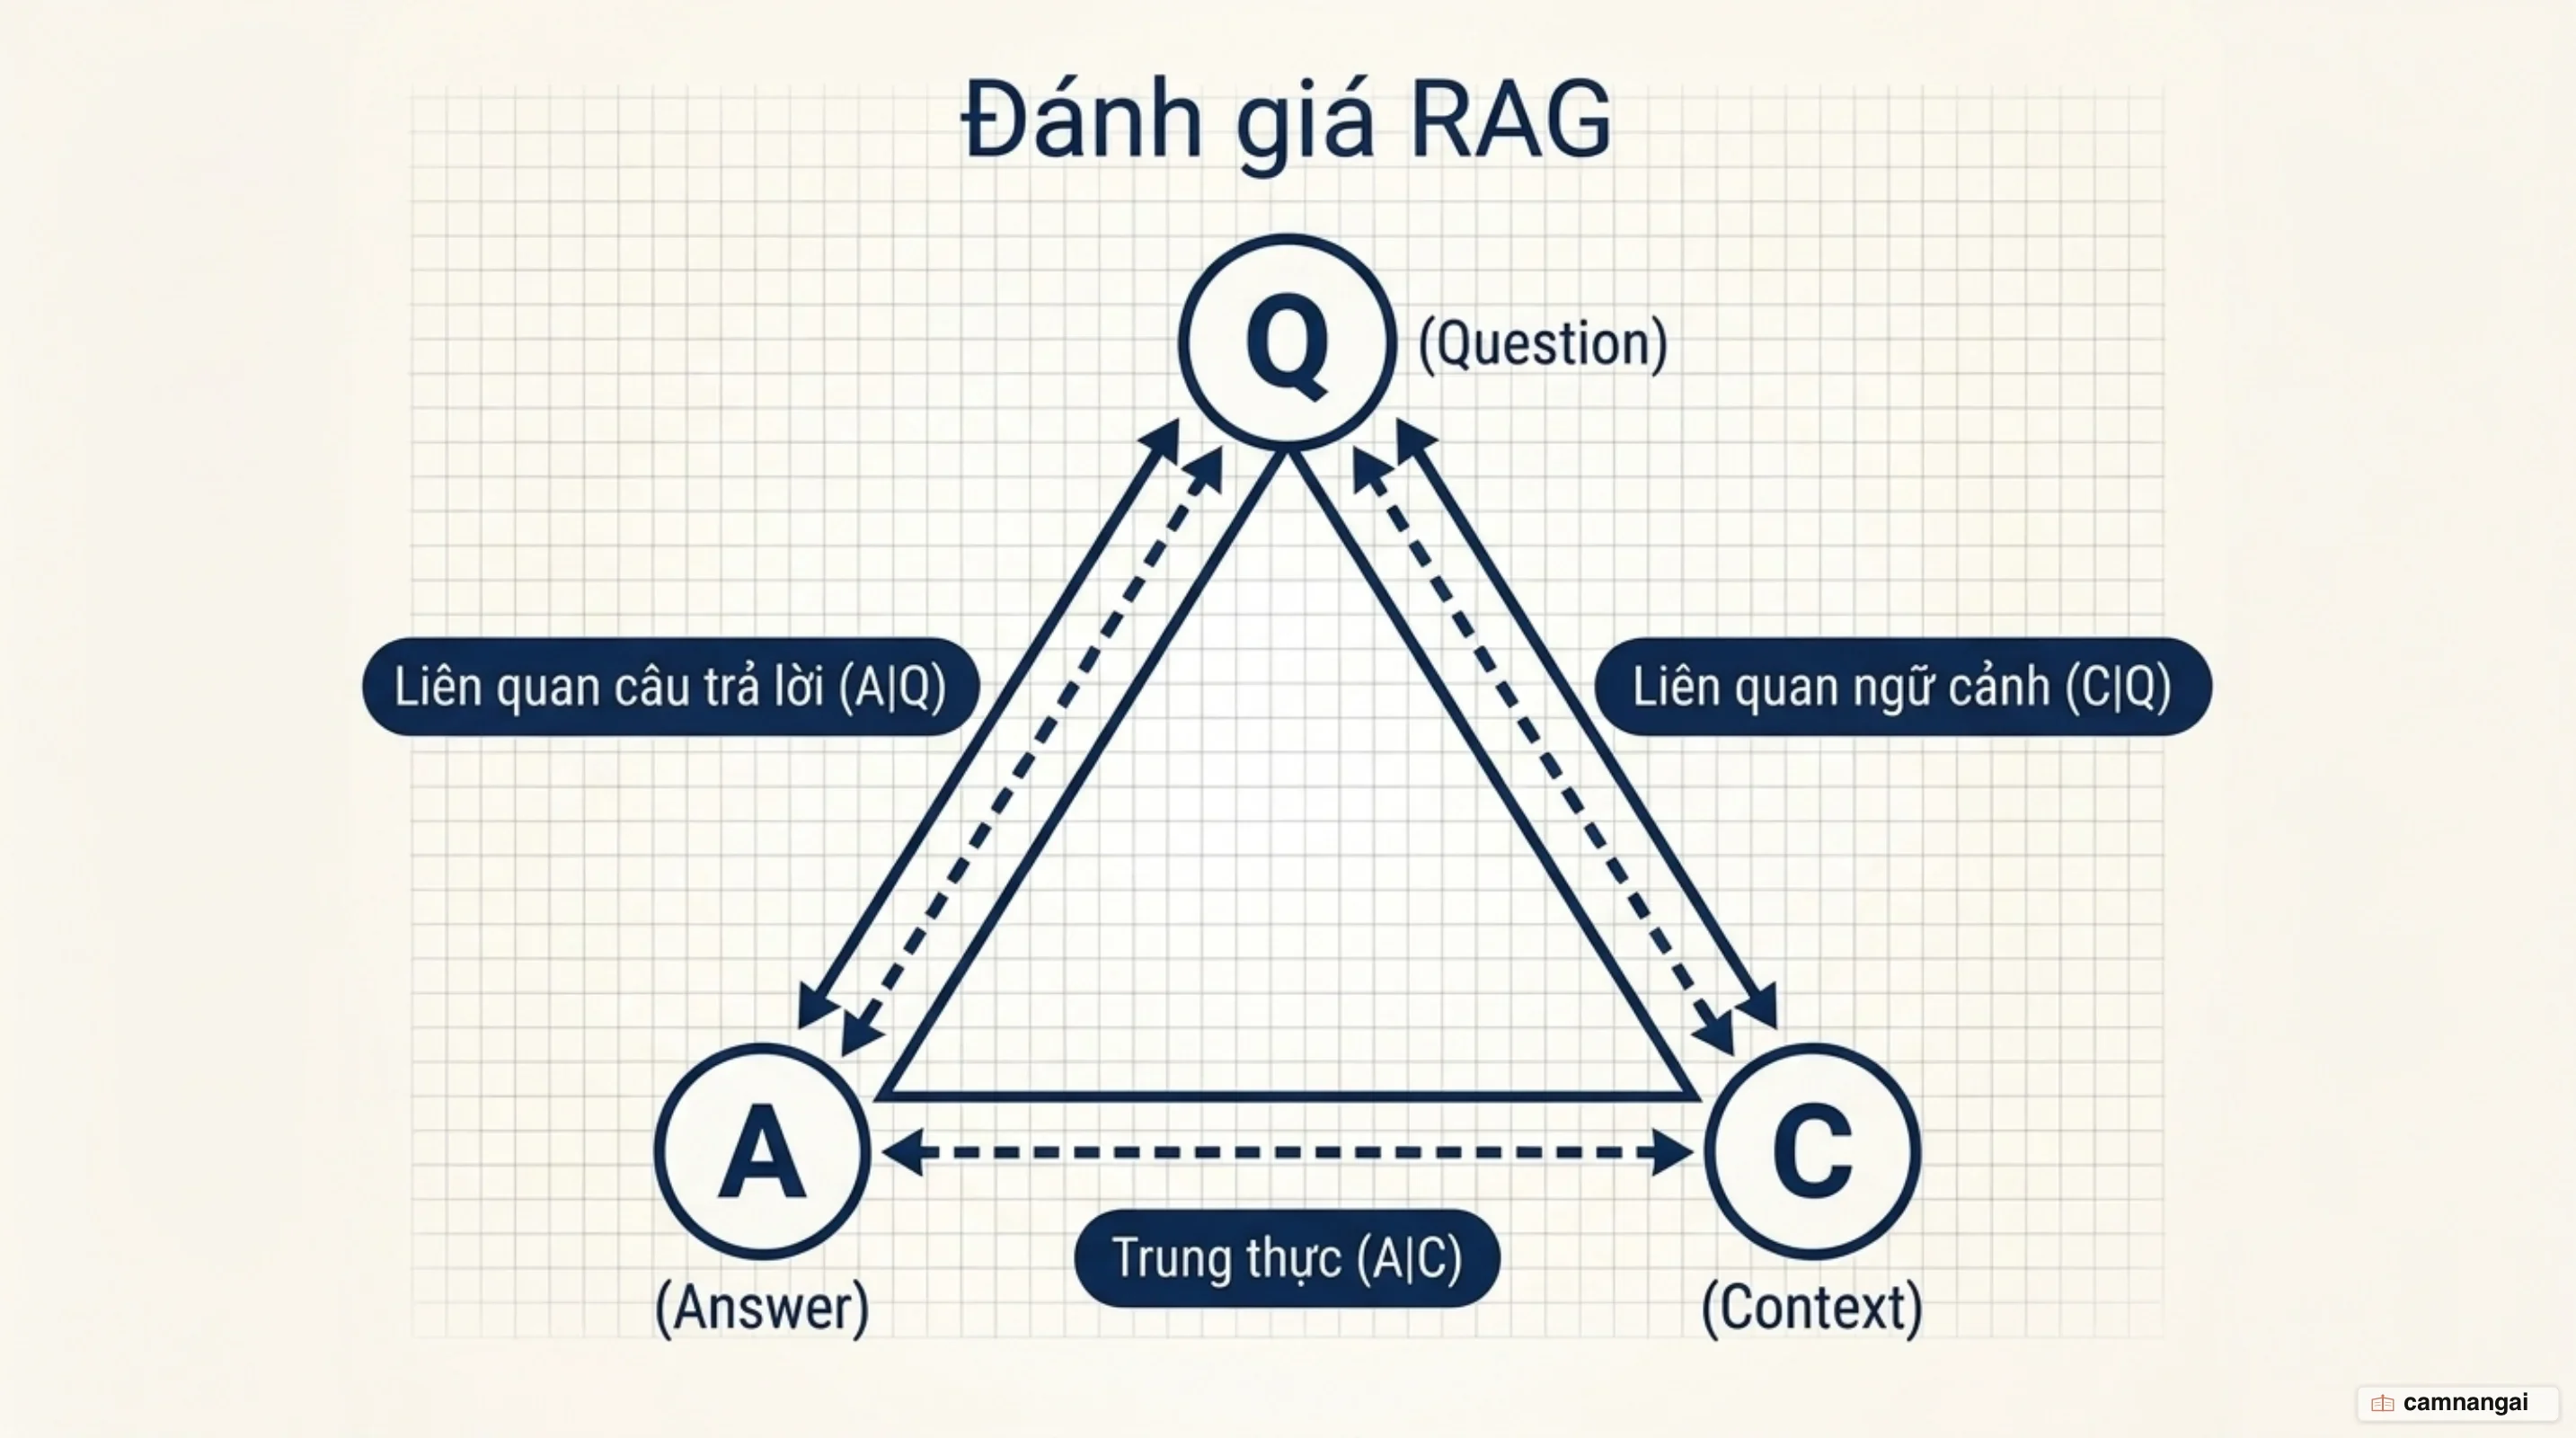
Đối với khâu sinh và tổng thể RAG, bạn quản lý quy trình đánh giá dựa trên mối quan hệ giữa 3 Biến số: Câu hỏi (Q - Question), Ngữ cảnh truy xuất (C - Context), và Câu trả lời sinh ra (A - Answer). Từ 3 biến số này, bạn xây dựng bộ 3 phép kiểm cốt lõi:
- Độ liên quan của ngữ cảnh ($C|Q$): Ngữ cảnh thu được có chứa thông tin giải quyết câu hỏi không?
- Độ trung thực của câu trả lời ($A|C$): Câu trả lời có căn cứ hoàn toàn vào ngữ cảnh hay bịa đặt ()?
- Độ liên quan của câu trả lời ($A|Q$): Câu trả lời có đáp ứng đúng trọng tâm câu hỏi người dùng không?
Ba phép kiểm phụ trợ bổ sung bao gồm: Phép kiểm căn chỉnh Câu hỏi - Ngữ cảnh (Query/Context alignment), Phép kiểm xác minh cặp Q-C tổng hợp, và Phép kiểm quy tắc nghiệp vụ đặc thù miền.
Tối ưu hóa kích thước đoạn văn bản (Chunk Size Optimization) là một tham số kỹ thuật ảnh hưởng trực tiếp đến tải trọng nhận thức (cognitive load) và khả năng xử lý của mô hình. Khi bạn truyền một chunk quá lớn, tải trọng nhận thức tăng cao sẽ kích hoạt điểm nghẽn chú ý (hiện tượng "lost in the middle"), khiến mô hình bỏ sót các chi tiết nằm ở giữa văn bản.
Do đó, bạn cần lựa chọn kích thước chunk dựa trên đặc thù tác vụ.
Đối với các nhiệm vụ đầu ra cố định (Fixed-Output Tasks, như trích xuất một con số hoặc câu trả lời đơn lẻ), bạn nên sử dụng các chunk lớn để bảo toàn ngữ cảnh toàn cục và tránh phân mảnh dữ liệu. Ngược lại, đối với các nhiệm vụ đầu ra mở rộng (Expansive-Output Tasks, như tóm tắt toàn bộ tài liệu hay trích xuất danh sách diện rộng), bạn phải sử dụng các chunk nhỏ hơn để giới hạn sự tập trung cục bộ của mô hình, sau đó tổng hợp kết quả thông qua các mô hình Map-Reduce.
Đánh giá AI Agent: Vượt qua giới hạn của kiểm thử đơn bước
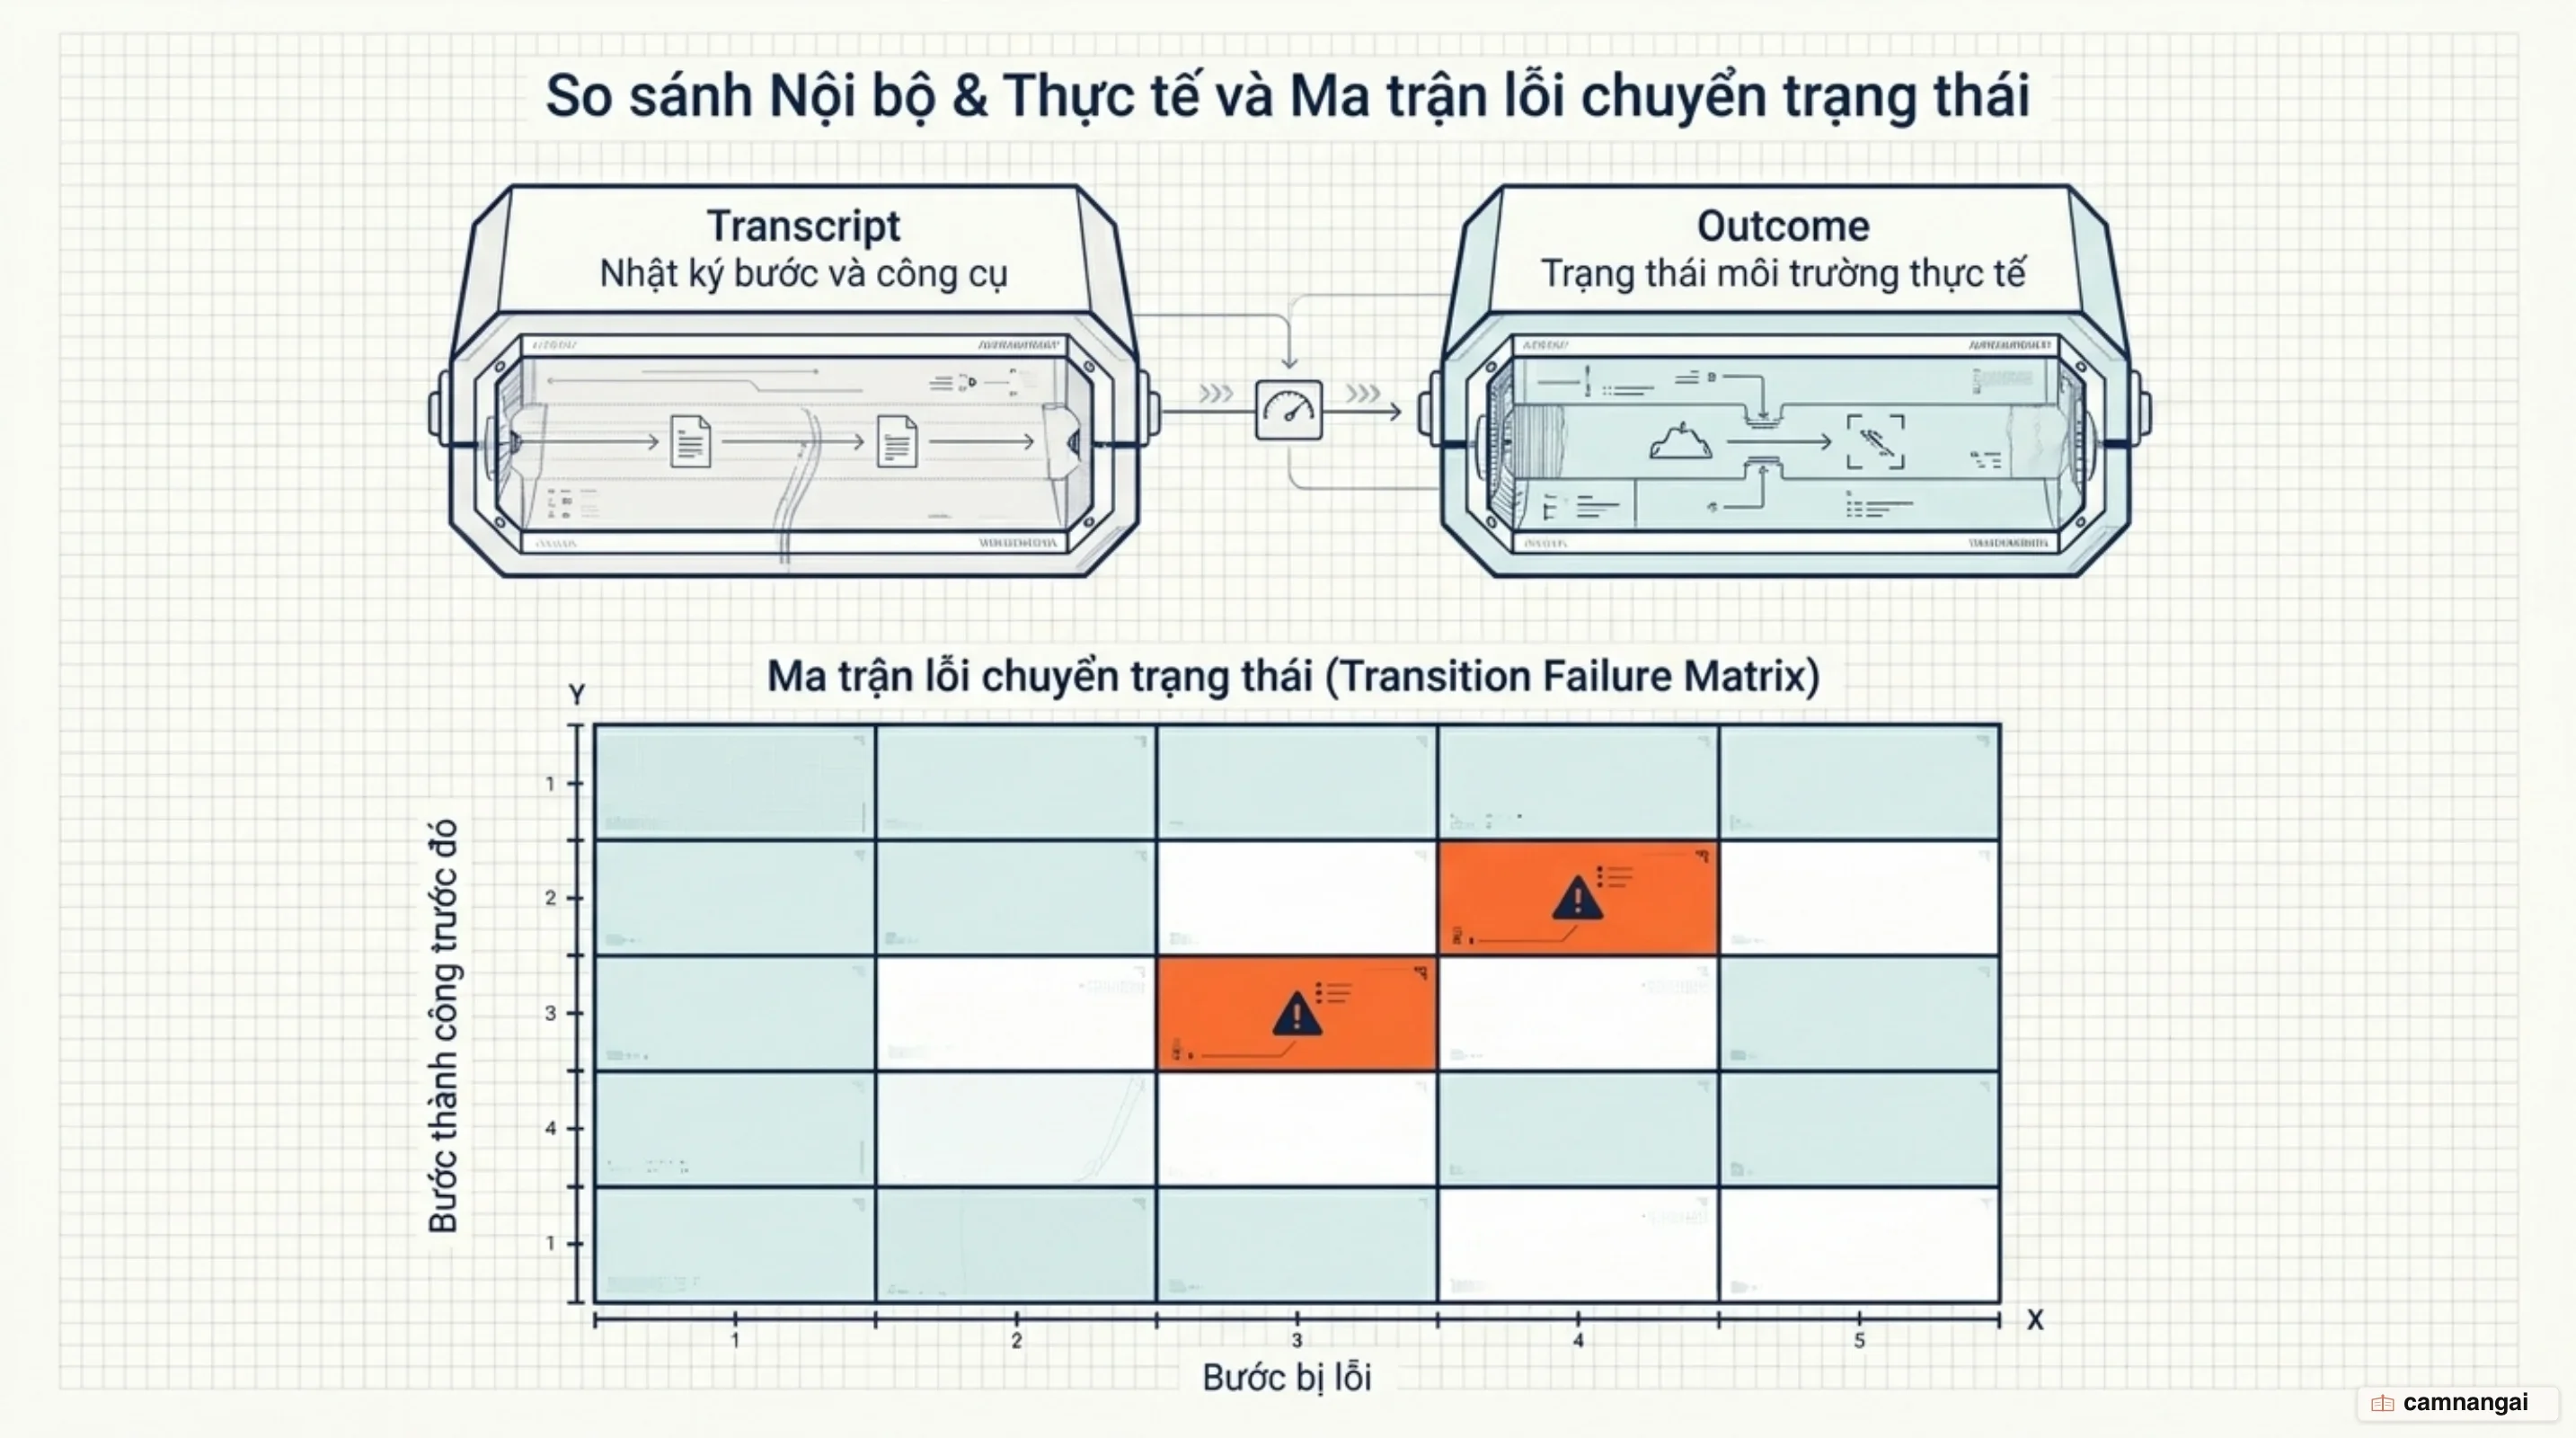
Đánh giá các tác nhân AI (AI agents) phức tạp hơn nhiều so với các hệ thống đơn bước do tương tác diễn ra qua nhiều lượt (multi-turn), trong đó sai lệch ở bước trước sẽ tích tụ và gây ra thất bại nghiêm trọng ở các bước sau. Khi đánh giá agent, bạn phải phân biệt giữa Nhật ký (Transcript) và Kết quả (Outcome). Transcript ghi lại chuỗi hội thoại, lý luận trung gian và các lượt gọi công cụ (tool calls). Outcome phản ánh sự thay đổi trạng thái thực tế của môi trường hệ thống (như bản ghi SQL đã được cập nhật hay email đã được gửi thành công). Một agent có thể tạo ra transcript hợp lệ nhưng vẫn thất bại nếu môi trường không đạt trạng thái mục tiêu.
Về mặt thống kê, bạn cần phân biệt và áp dụng chính xác hai chỉ số $pass@k$ và $pass^k$:
- $pass@k$: Xác suất tác nhân đạt được ít nhất 1 lời giải đúng trong $k$ lần thử. Chỉ số này đo lường năng lực giải quyết bài toán tối đa (hill-climbing potential) khi hệ thống được cấp thêm tài nguyên thử lại.
- $pass^k$: Xác suất tất cả $k$ lần thử đều thành công. Chỉ số này đo lường độ tin cậy và tính ổn định vận hành tuyệt đối, yếu tố quyết định đối với các tác nhân triển khai trực tiếp cho khách hàng.
Để chẩn đoán các hệ thống đa bước, bạn nên sử dụng Ma trận Lỗi Chuyển trạng thái (Transition Failure Matrix). Bạn xây dựng một ma trận biểu diễn trạng thái thành công cuối cùng ở các hàng và trạng thái xuất hiện lỗi đầu tiên ở các cột (ví dụ: chuyển từ bước tạo câu lệnh GenSQL sang thực thi ExecSQL). Việc thống kê tần suất lỗi trên ma trận này sẽ lập tức làm nổi bật các "điểm nóng" (hotspots) kỹ thuật đang làm sụp đổ luồng xử lý của agent.
Ở Cấp độ chẩn đoán chi tiết từng bước (step-level diagnostics), bạn cần kiểm tra tính chính xác của việc chọn công cụ, tham số trích xuất, khả năng xử lý ngoại lệ API, và các điều kiện tiên quyết/quyền hạn. Khi một chuỗi tương tác đa lượt gặp lỗi, bạn nên áp dụng phương pháp kiểm thử N-1 (N-1 testing): cung cấp chính xác N-1 lượt thoại lịch sử từ một trace thất bại thực tế và chỉ kiểm tra phản ứng của agent ở lượt thứ N. Phương pháp này giúp bạn cô lập hoàn toàn nguyên nhân gốc rễ là do logic xử lý của bản thân lượt thứ N hay do sự tích tụ nhiễu ngữ cảnh từ các lượt trước đó.
Phân định ranh giới giữa Evals và Guardrails
Ranh giới giữa Evals và Guardrails thường bị nhầm lẫn trong quá trình thiết kế kiến trúc AI. Guardrails là các cơ chế kiểm soát an toàn đồng bộ (synchronous inline checks) nằm trực tiếp trên đường truyền của luồng yêu cầu/phản hồi. Nhiệm vụ của Guardrail là can thiệp tức thì trước khi dữ liệu đến tay người dùng hoặc mô hình. Do nằm trên luồng xử lý thời gian thực, phải tuân thủ ngân sách độ trễ cực kỳ khắt khe (tính bằng miligiây) và sử dụng các quy tắc định lượng tuyệt đối (như Regex, bộ kiểm tra schema, hoặc bộ phân loại siêu nhẹ) để chặn các thất bại nghiêm trọng: rò rỉ PII, SQL injection, hoặc đầu ra hỏng định dạng JSON.
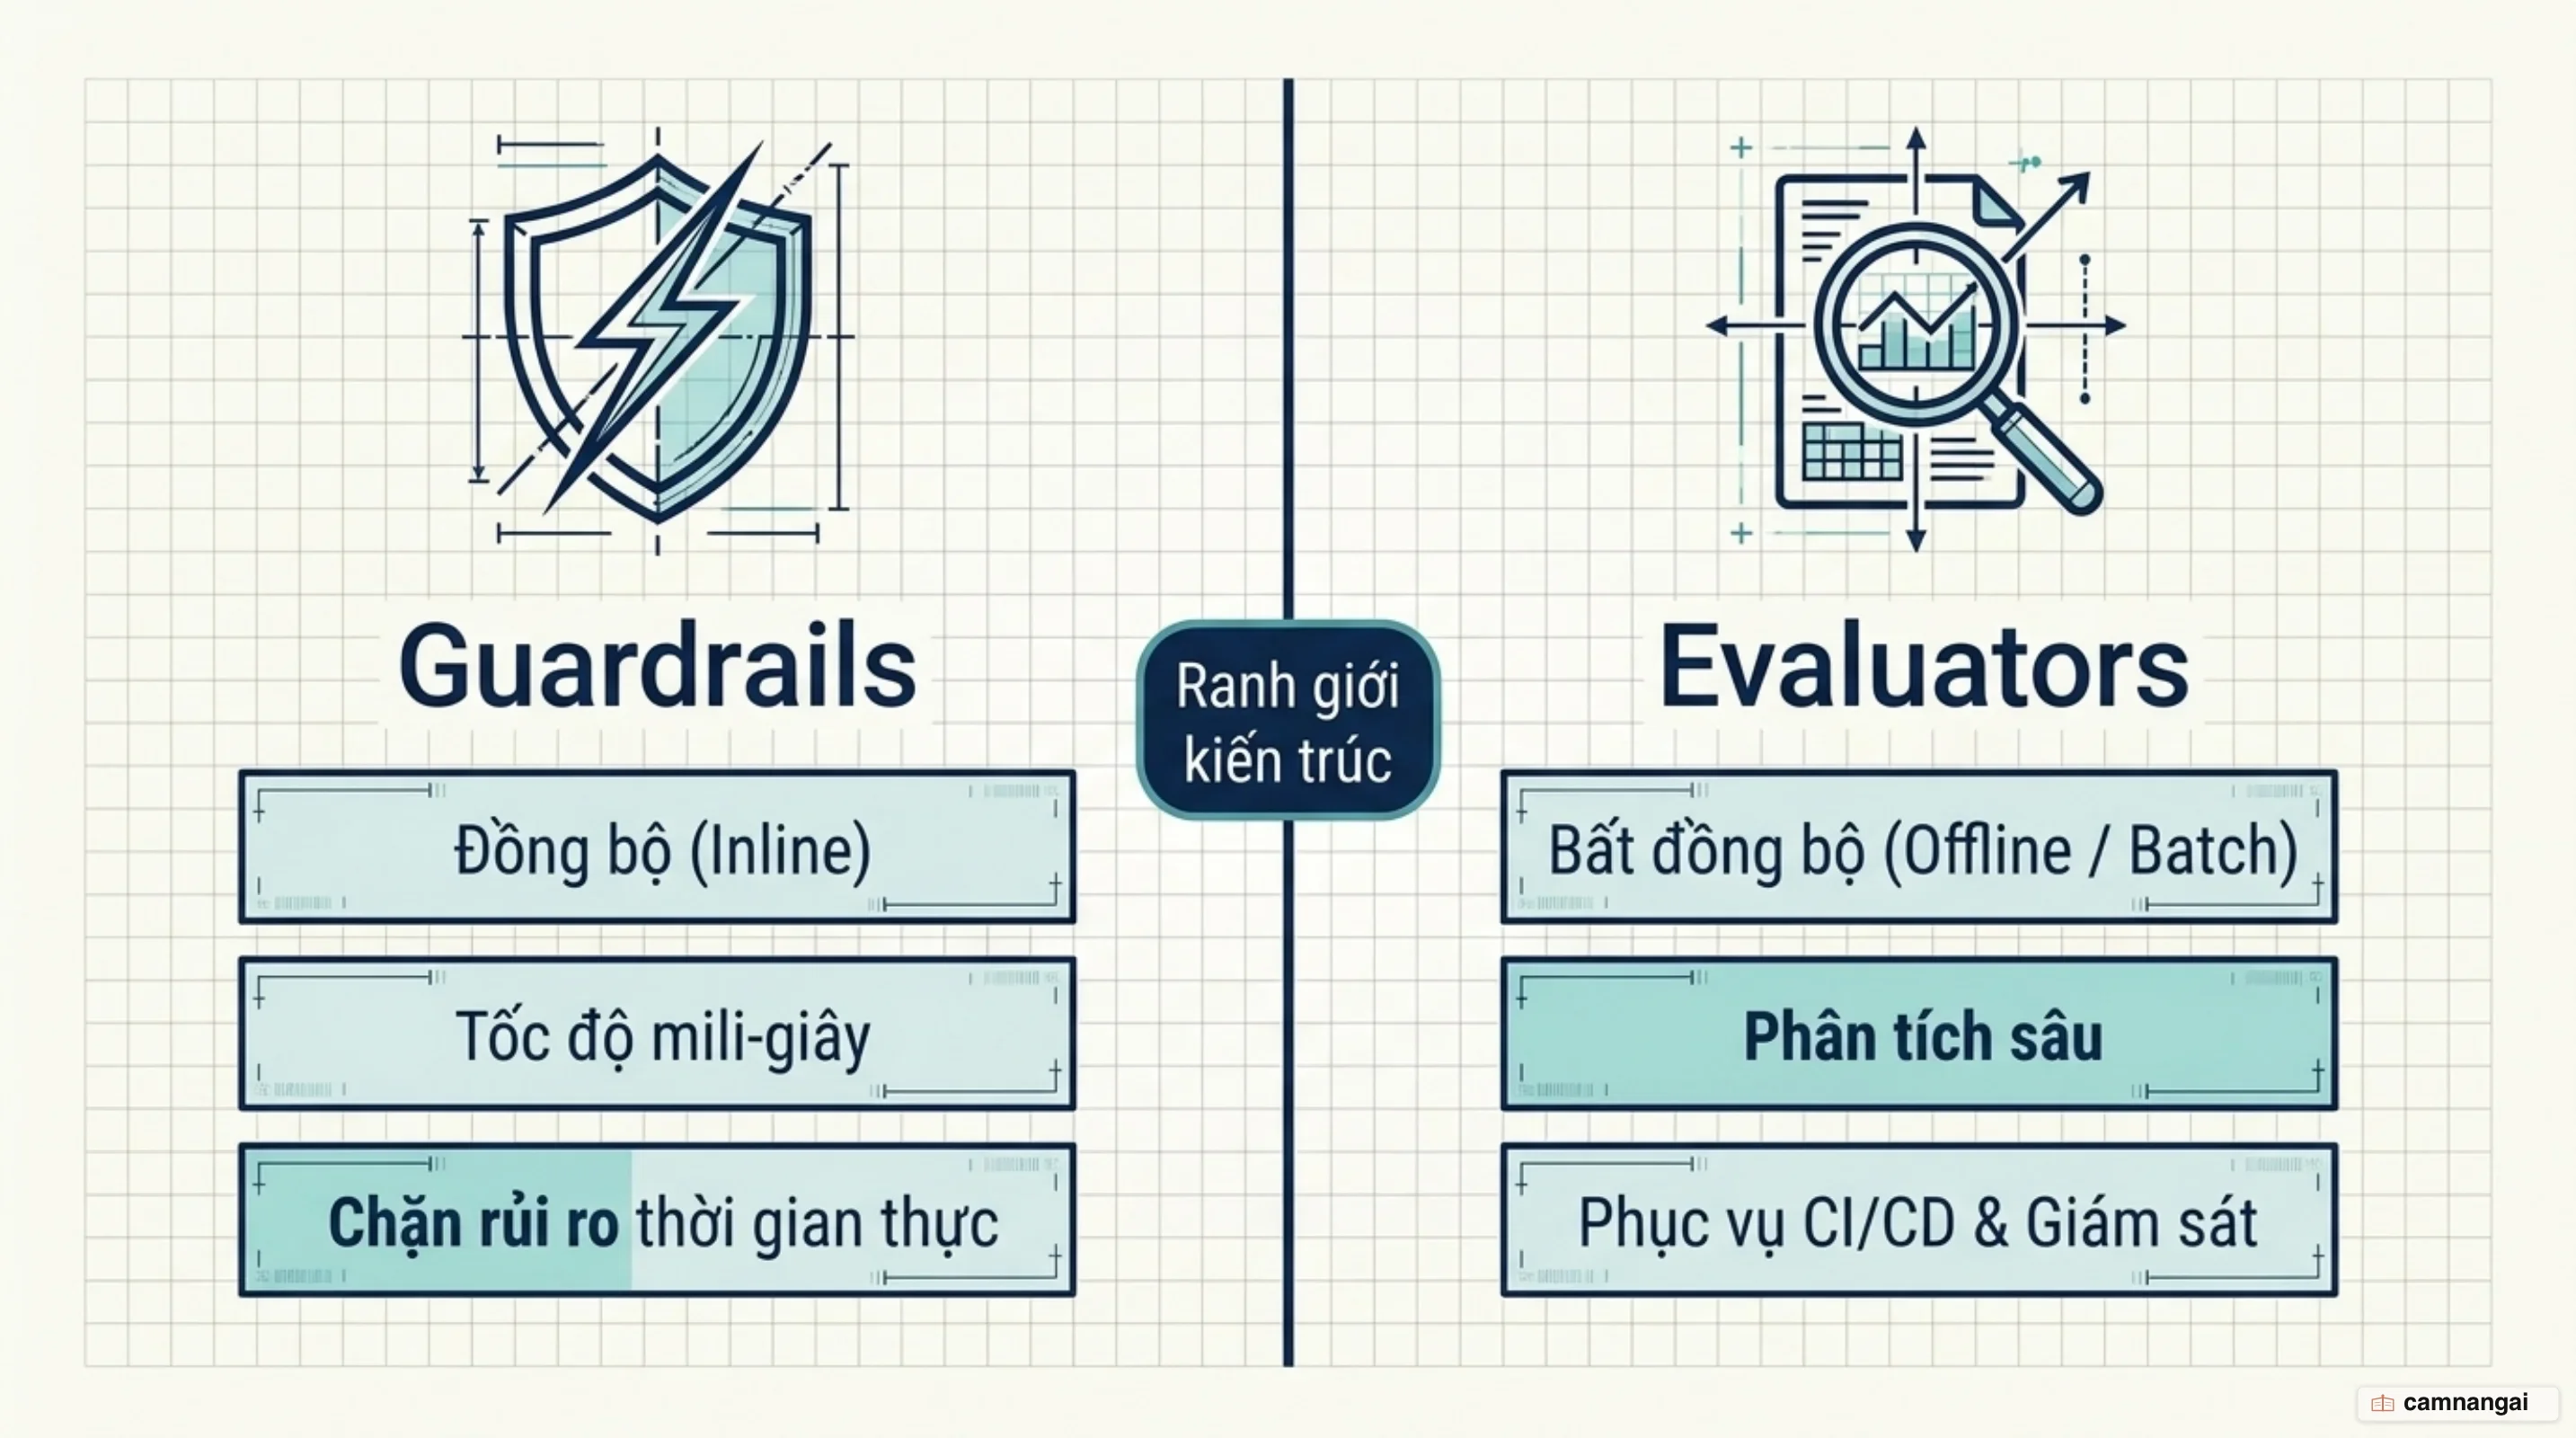
Trái lại, Evaluators là hệ thống đánh giá bất đồng bộ (asynchronous/batch systems) chạy sau khi phản hồi đã được tạo ra hoặc trong môi trường offline. Evaluators phân tích các tiêu chí định tính phức tạp hơn như độ chính xác thực tế, mức độ hoàn thiện câu trả lời và văn phong. Do không chặn luồng phản hồi trực tiếp của người dùng, Evaluators có thể sử dụng các phép tính toán tốn kém như LLM-as-a-Judge. Kết quả từ Evaluators phục vụ việc cập nhật bảng điều khiển (dashboard), chạy đường ống CI/CD, và cung cấp tín hiệu để bạn tinh chỉnh mô hình.
Việc thiết lập hai hệ thống này đòi hỏi bạn phải quản lý sự cân bằng giữa Âm tính Giả (False Negatives - bỏ sót lỗi) và Dương tính Giả (False Positives - chặn nhầm dữ liệu hợp lệ). Vì Guardrails can thiệp trực tiếp vào trải nghiệm người dùng, một Guardrail có tỷ lệ dương tính giả cao sẽ liên tục chặn các yêu cầu hợp lệ, gây ức chế cho người dùng cuối.
Do đó, bạn không nên sử dụng các LLM judge có độ trễ cao và tính ngẫu nhiên làm Guardrail đồng bộ trên luồng xử lý thực tế, ngoại trừ các kịch bản rủi ro đặc biệt nghiêm trọng mà ngân sách độ trễ cho phép. Hãy áp dụng Guardrails cho các mục tiêu bảo vệ tức thì và sử dụng Evaluators cho việc giám sát, cải tiến chất lượng hệ thống lâu dài.
Biến hệ thống đánh giá thành lợi thế cạnh tranh dài hạn
Hệ thống đánh giá AI không phải là một công cụ mua sẵn hay bài kiểm thử dùng một lần, mà là một kỷ luật kỹ thuật phần mềm dài hạn dựa trên phương pháp luận khoa học.
Một hệ thống đánh giá đáng tin cậy giúp đội ngũ kỹ thuật của bạn tự tin tái cấu trúc mã nguồn, tối ưu hóa câu lệnh, cải tiến kiến trúc RAG và lập tức nâng cấp lên các thế hệ mô hình nền tảng mới mà không lo ngại nguy cơ thoái hóa hệ thống.
Để bắt đầu, bạn nên xây dựng một quy trình gọn nhẹ: thu thập 20–50 trace lỗi thực tế, thực hiện phân tích lỗi thủ công để thấu hiểu sâu sắc hành vi hệ thống, và viết các kiểm thử bằng mã nguồn trước khi đầu tư vào các LLM judge đắt đỏ. Chính năng lực quan sát dữ liệu và quy trình cải tiến liên tục, chứ không phải việc sở hữu các công cụ đánh giá phức tạp, mới là yếu tố cốt lõi tạo nên lợi thế cạnh tranh bền vững cho sản phẩm AI của bạn.
Tài liệu tham khảo
- AI Evals: Everything You Need to Know — Hamel Husain
- Your AI Product Needs Evals — Hamel Husain
- Task-Specific LLM Evals that Do & Don't Work — Eugene Yan
- Demystifying Evals for AI Agents — Anthropic
- An LLM-as-Judge Won't Save The Product—Fixing Your Process Will — Eugene Yan
- There Are Only 6 RAG Evals — Jason Liu
- Evaluation Best Practices — OpenAI