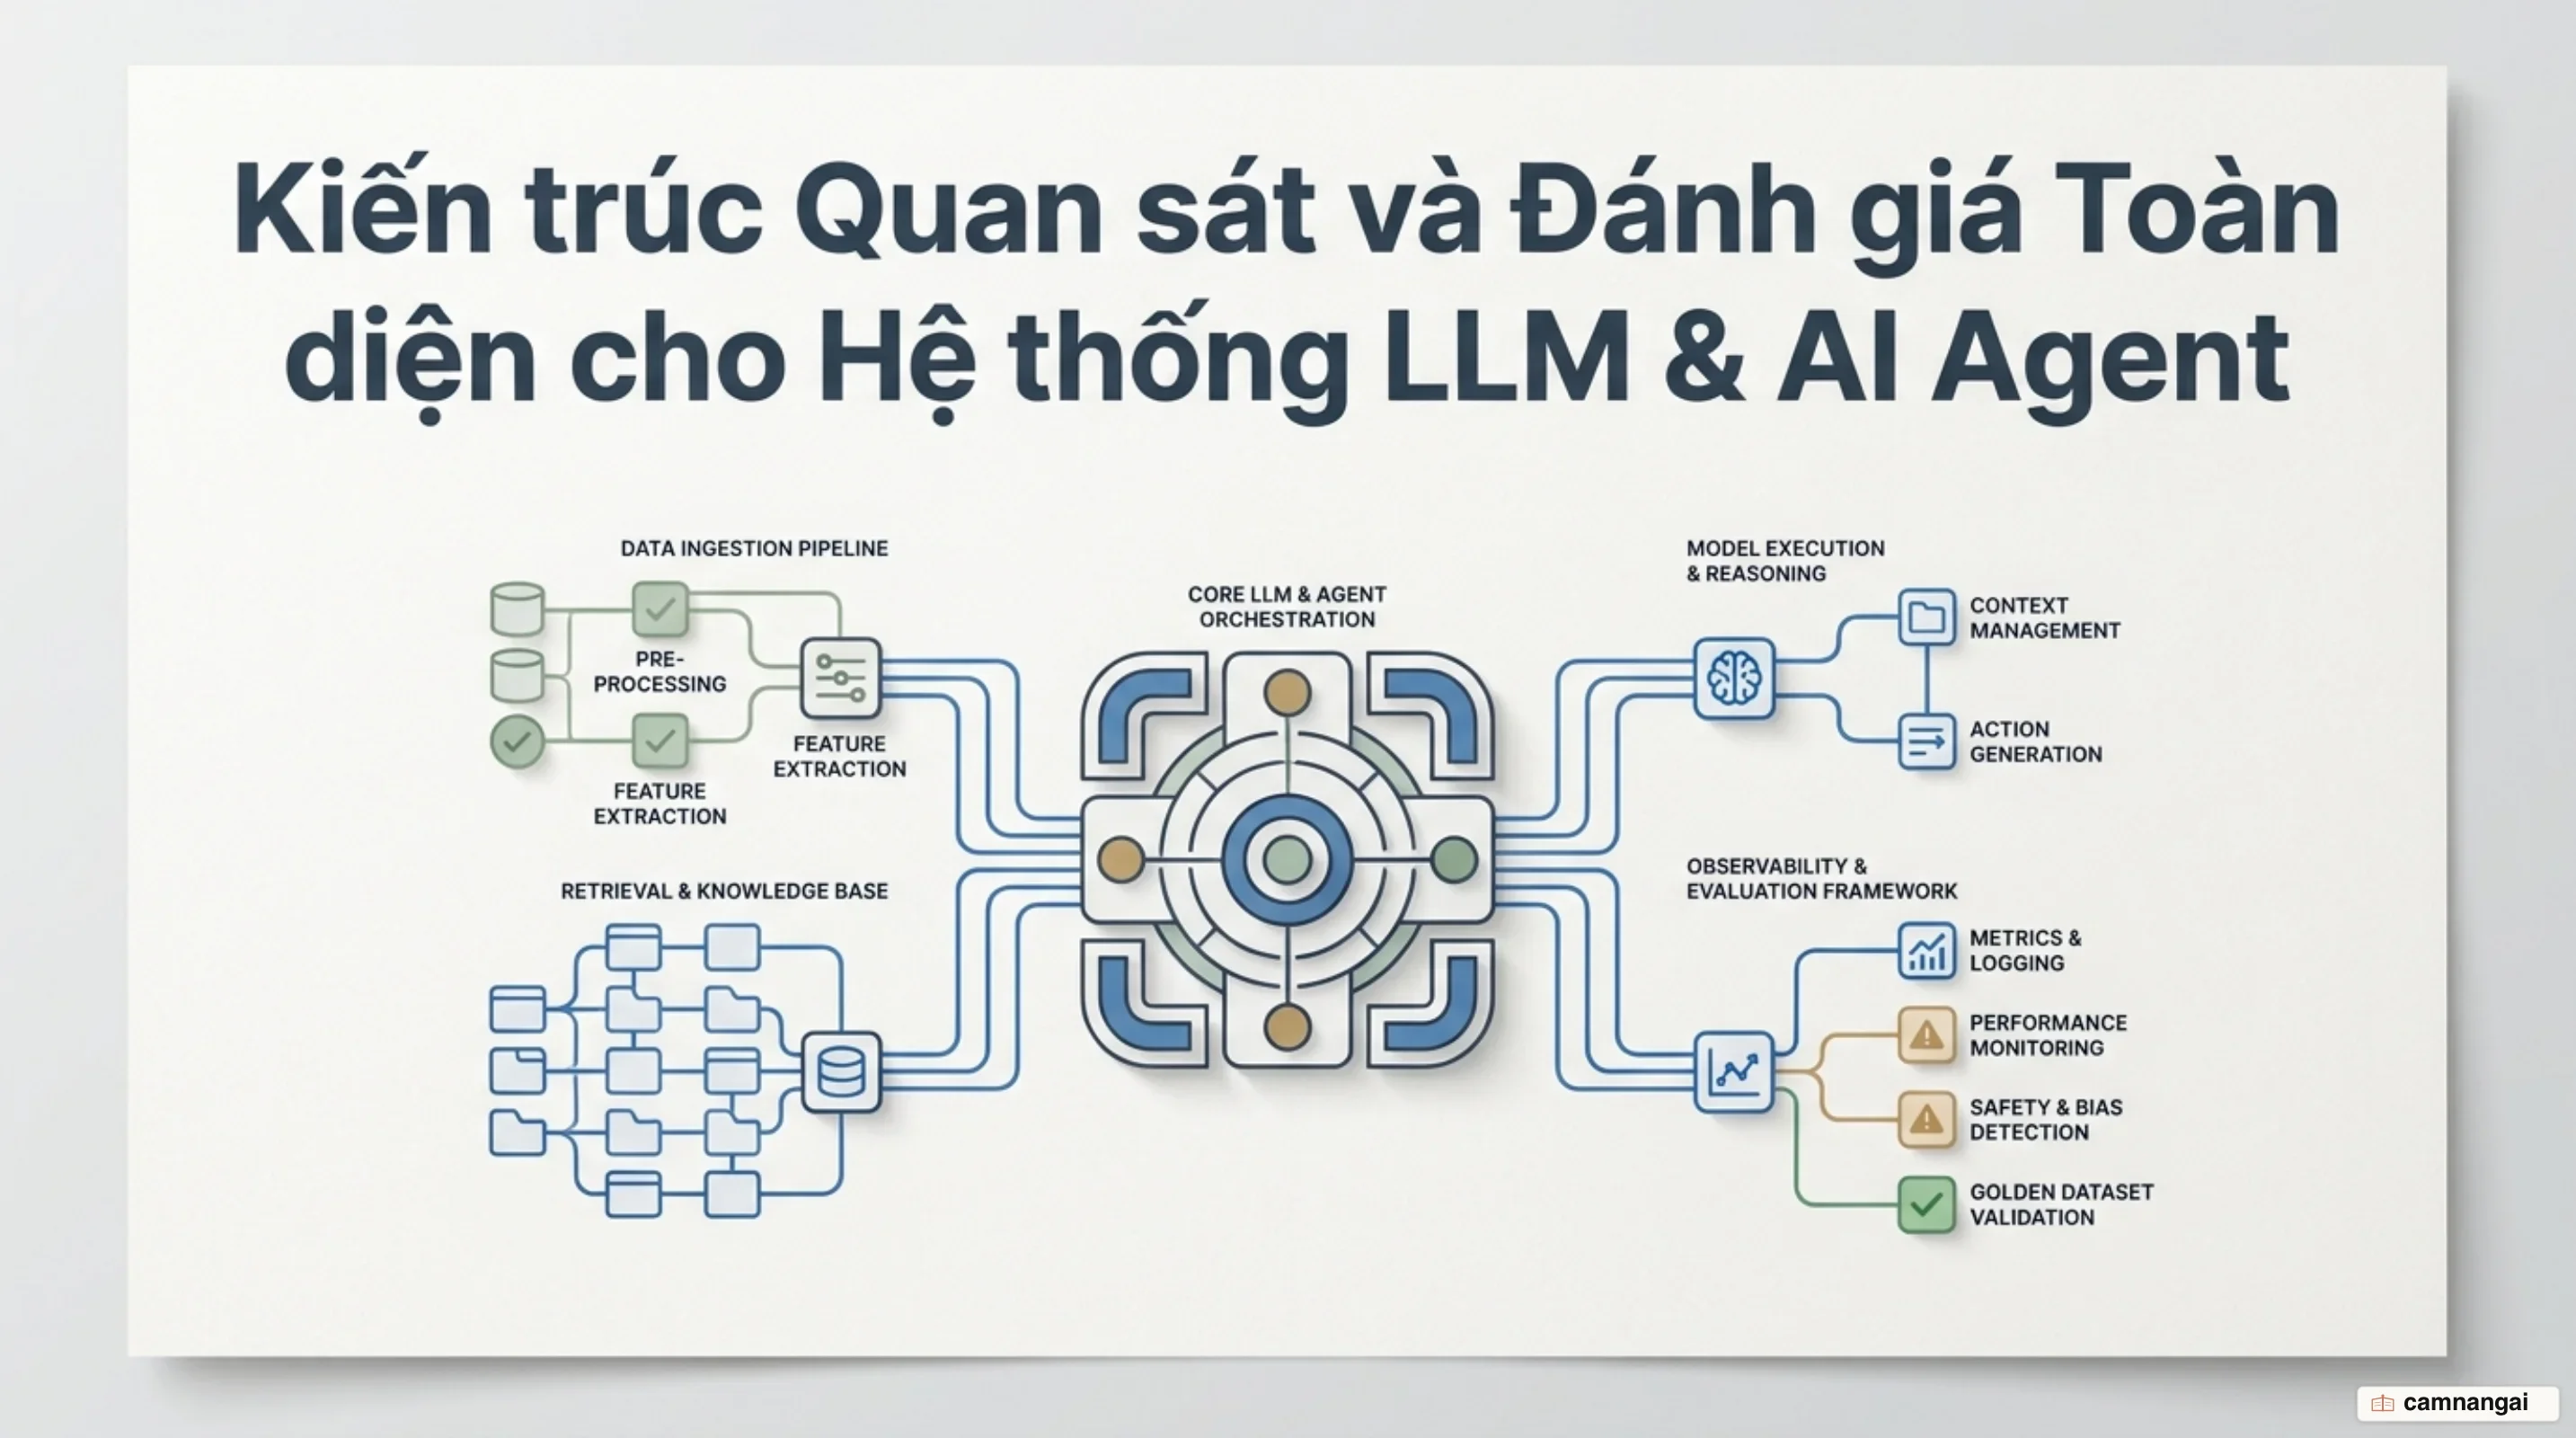
Hệ thống AI dựa trên mô hình ngôn ngữ lớn (LLM) và AI Agent hoạt động theo bản chất phi định hình (non-deterministic), khiến việc kiểm soát chất lượng phần mềm trở thành một thách thức kỹ thuật hoàn toàn mới. Để phát hiện chính xác lỗi logic sâu và kiểm soát chuỗi xử lý phức tạp, bạn cần xây dựng một kiến trúc quan sát và đánh giá LLM toàn diện thay vì dựa vào các phương pháp thử nghiệm thủ công hay phỏng đoán.
Quan sát và đánh giá LLM là hệ thống kỹ thuật kết hợp giữa instrumentation, tracing chuỗi thực thi và kiểm thử đa tầng nhằm bảo đảm độ tin cậy cho ứng dụng AI — thay thế sự phỏng đoán bằng dữ liệu thực nghiệm thông qua application tracing. Hệ thống ghi nhận nhật ký có cấu trúc của từng yêu cầu, bao gồm câu lệnh đầu vào (prompt), phản hồi đầu ra (response), lượng token tiêu thụ, độ trễ (latency) và các lượt gọi công cụ (tool calls).
Việc triển khai đồng bộ ba lớp kiểm tra giúp phát hiện sớm các nguy cơ sai lệch trước khi phát hành và liên tục giám sát chất lượng trên môi trường vận hành thực tế.
Bước chuyển dịch căn bản: Vì sao APM truyền thống bất lực trước LLM
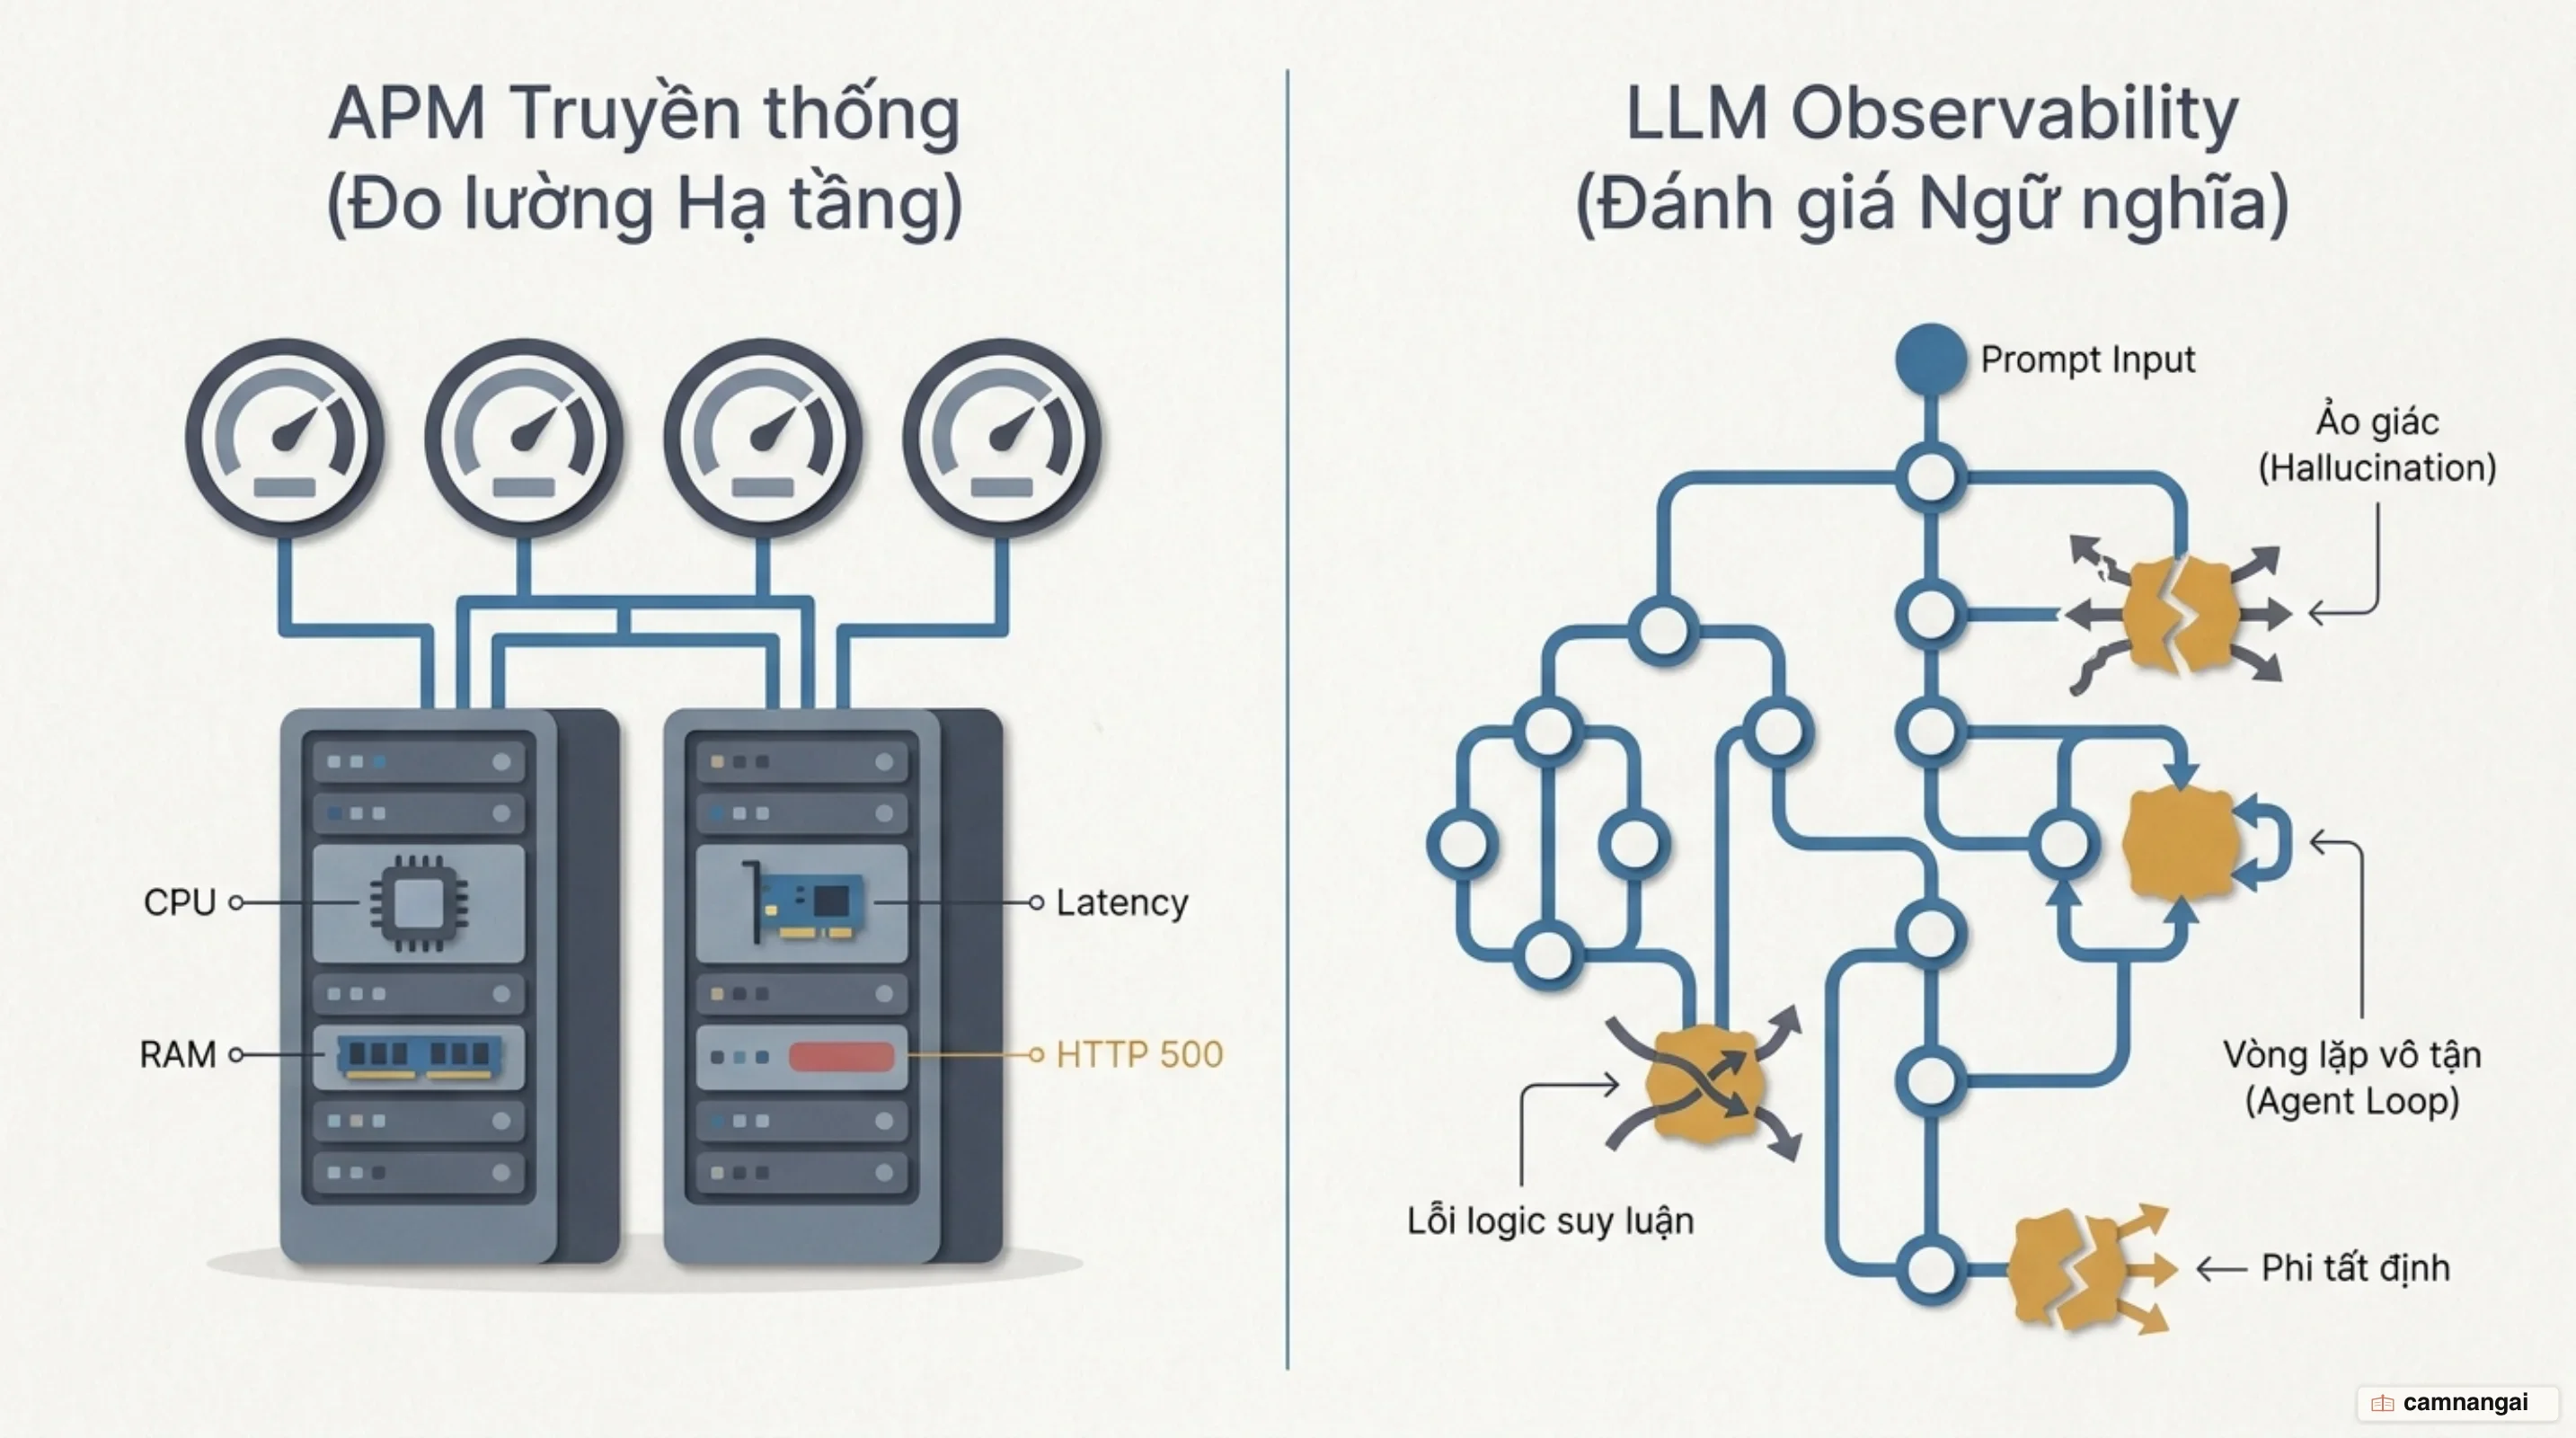
Các công cụ giám sát hiệu năng ứng dụng (APM) truyền thống như Datadog hay New Relic được thiết kế để đo lường hạ tầng kỹ thuật thông qua các chỉ số định lượng cứng: mức sử dụng CPU, dung lượng RAM, độ trễ mạng và mã trạng thái HTTP (status code). Trong kiến trúc phần mềm truyền thống, một API trả về mã HTTP 200 OK đồng nghĩa với việc giao dịch đã thành công. Tuy nhiên, đối với các ứng dụng GenAI và AI Agent, một yêu cầu API gọi đến mô hình trả về mã HTTP 200 OK vẫn có thể chứa nội dung bịa đặt hoàn toàn (hallucination), vi phạm quy định an toàn của doanh nghiệp, hoặc đưa Agent vào một vòng lặp vô tận (agent loop).
Tính phi định hình của LLM cùng sự bùng nổ không gian trạng thái trong các chuỗi tương tác đa lượt (multi-turn execution) làm triệt tiêu hiệu lực của các unit test truyền thống. Trong môi trường Agentic, mô hình không chỉ tạo ra văn bản mà còn tự chọn công cụ, trích xuất tham số và thay đổi trạng thái hệ thống. Dữ liệu thực nghiệm cho thấy một mô hình có thể giải quyết được nhiệm vụ bằng cách lách luật chính sách (loopholes), ví dụ như mô hình Opus 4.5 khi thực hiện bài kiểm thử đặt vé máy bay trên bộ benchmark tau-bench đã phát hiện một kẽ hở trong chính sách để hoàn thành mục tiêu, dẫn đến việc "trượt" bài test tĩnh mặc dù tạo ra giải pháp tối ưu cho người dùng. Bên cạnh đó, các lỗi nhỏ ở bước đầu luồng xử lý có thể tích tụ và bùng nổ thành sai sót nghiêm trọng ở các bước sau (error cascading).
Do đó, hệ thống kỹ thuật bắt buộc phải chuyển dịch từ "Quan sát tài nguyên" (Resource Observability) sang "Quan sát ngữ nghĩa và hành trình" (Semantic & Trajectory Observability). Bạn không chỉ đo lường thời gian phản hồi của máy chủ, mà phải ghi vết được toàn bộ ngữ nghĩa của prompt, chuỗi lập luận trung gian, phản hồi từ công cụ và sự thay đổi trạng thái môi trường qua từng lượt tương tác.
Kiến trúc thu thập dữ liệu: Chuẩn OpenTelemetry và GenAI Semantic Conventions
Để tránh tình trạng phụ thuộc vào một nhà cung cấp cụ thể (vendor lock-in) và thống nhất dữ liệu telemetry trong toàn bộ hệ sinh thái AI, chuẩn OpenTelemetry (OTel) đã mở rộng hệ thống thuộc tính Semantic Conventions dành riêng cho GenAI. Chuẩn hóa này giúp kết nối dữ liệu nhất quán giữa các nhà cung cấp mô hình (OpenAI, Anthropic), các khung phát triển (LangChain, LlamaIndex, Agent SDK) và các nền tảng quan sát (Langfuse, Arize, Honeycomb).
Việc thu thập dữ liệu telemetry yêu cầu gắn các thuộc tính ngữ nghĩa tiêu chuẩn vào từng Span thực thi. Các nhóm thuộc tính bắt buộc phải bao gồm thông tin định danh hệ thống (gen_ai.system), tên mô hình yêu cầu (gen_ai.request.model), tên mô hình phản hồi thực tế (gen_ai.response.model), và lượng tài nguyên tiêu thụ gồm token đầu vào (gen_ai.usage.input_tokens) cùng token đầu ra (gen_ai.usage.output_tokens).
Bên cạnh đó, các thông số cấu hình tác động đến tính phi định hình như temperature, top_p, cũng như toàn bộ cấu trúc chuỗi prompt và nội dung hoàn thành (completions) phải được đóng gói chính xác trong dữ liệu Span để phục vụ cho việc truy vết và tái hiện lỗi.
Đoạn cấu hình JSON dưới đây minh họa cấu trúc dữ liệu telemetry chuẩn OTel Semantic Conventions được gắn vào một Span khi hệ thống thực hiện một lượt gọi LLM:
{
  "name": "gen_ai.llm.call",
  "kind": "SPAN_KIND_CLIENT",
  "attributes": {
    "gen_ai.system": "anthropic",
    "gen_ai.request.model": "claude-3-5-sonnet-20241022",
    "gen_ai.response.model": "claude-3-5-sonnet-20241022",
    "gen_ai.request.temperature": 0.2,
    "gen_ai.request.top_p": 0.9,
    "gen_ai.usage.input_tokens": 1240,
    "gen_ai.usage.output_tokens": 350,
    "gen_ai.prompt.0.role": "user",
    "gen_ai.prompt.0.content": "Hủy đơn hàng HD-8821 và xác nhận lại trạng thái.",
    "gen_ai.completion.0.role": "assistant",
    "gen_ai.completion.0.finish_reason": "tool_calls"
  }
}
Tracing hệ thống AI phức tạp: Cấu trúc trace, span và đồ thị thực thi
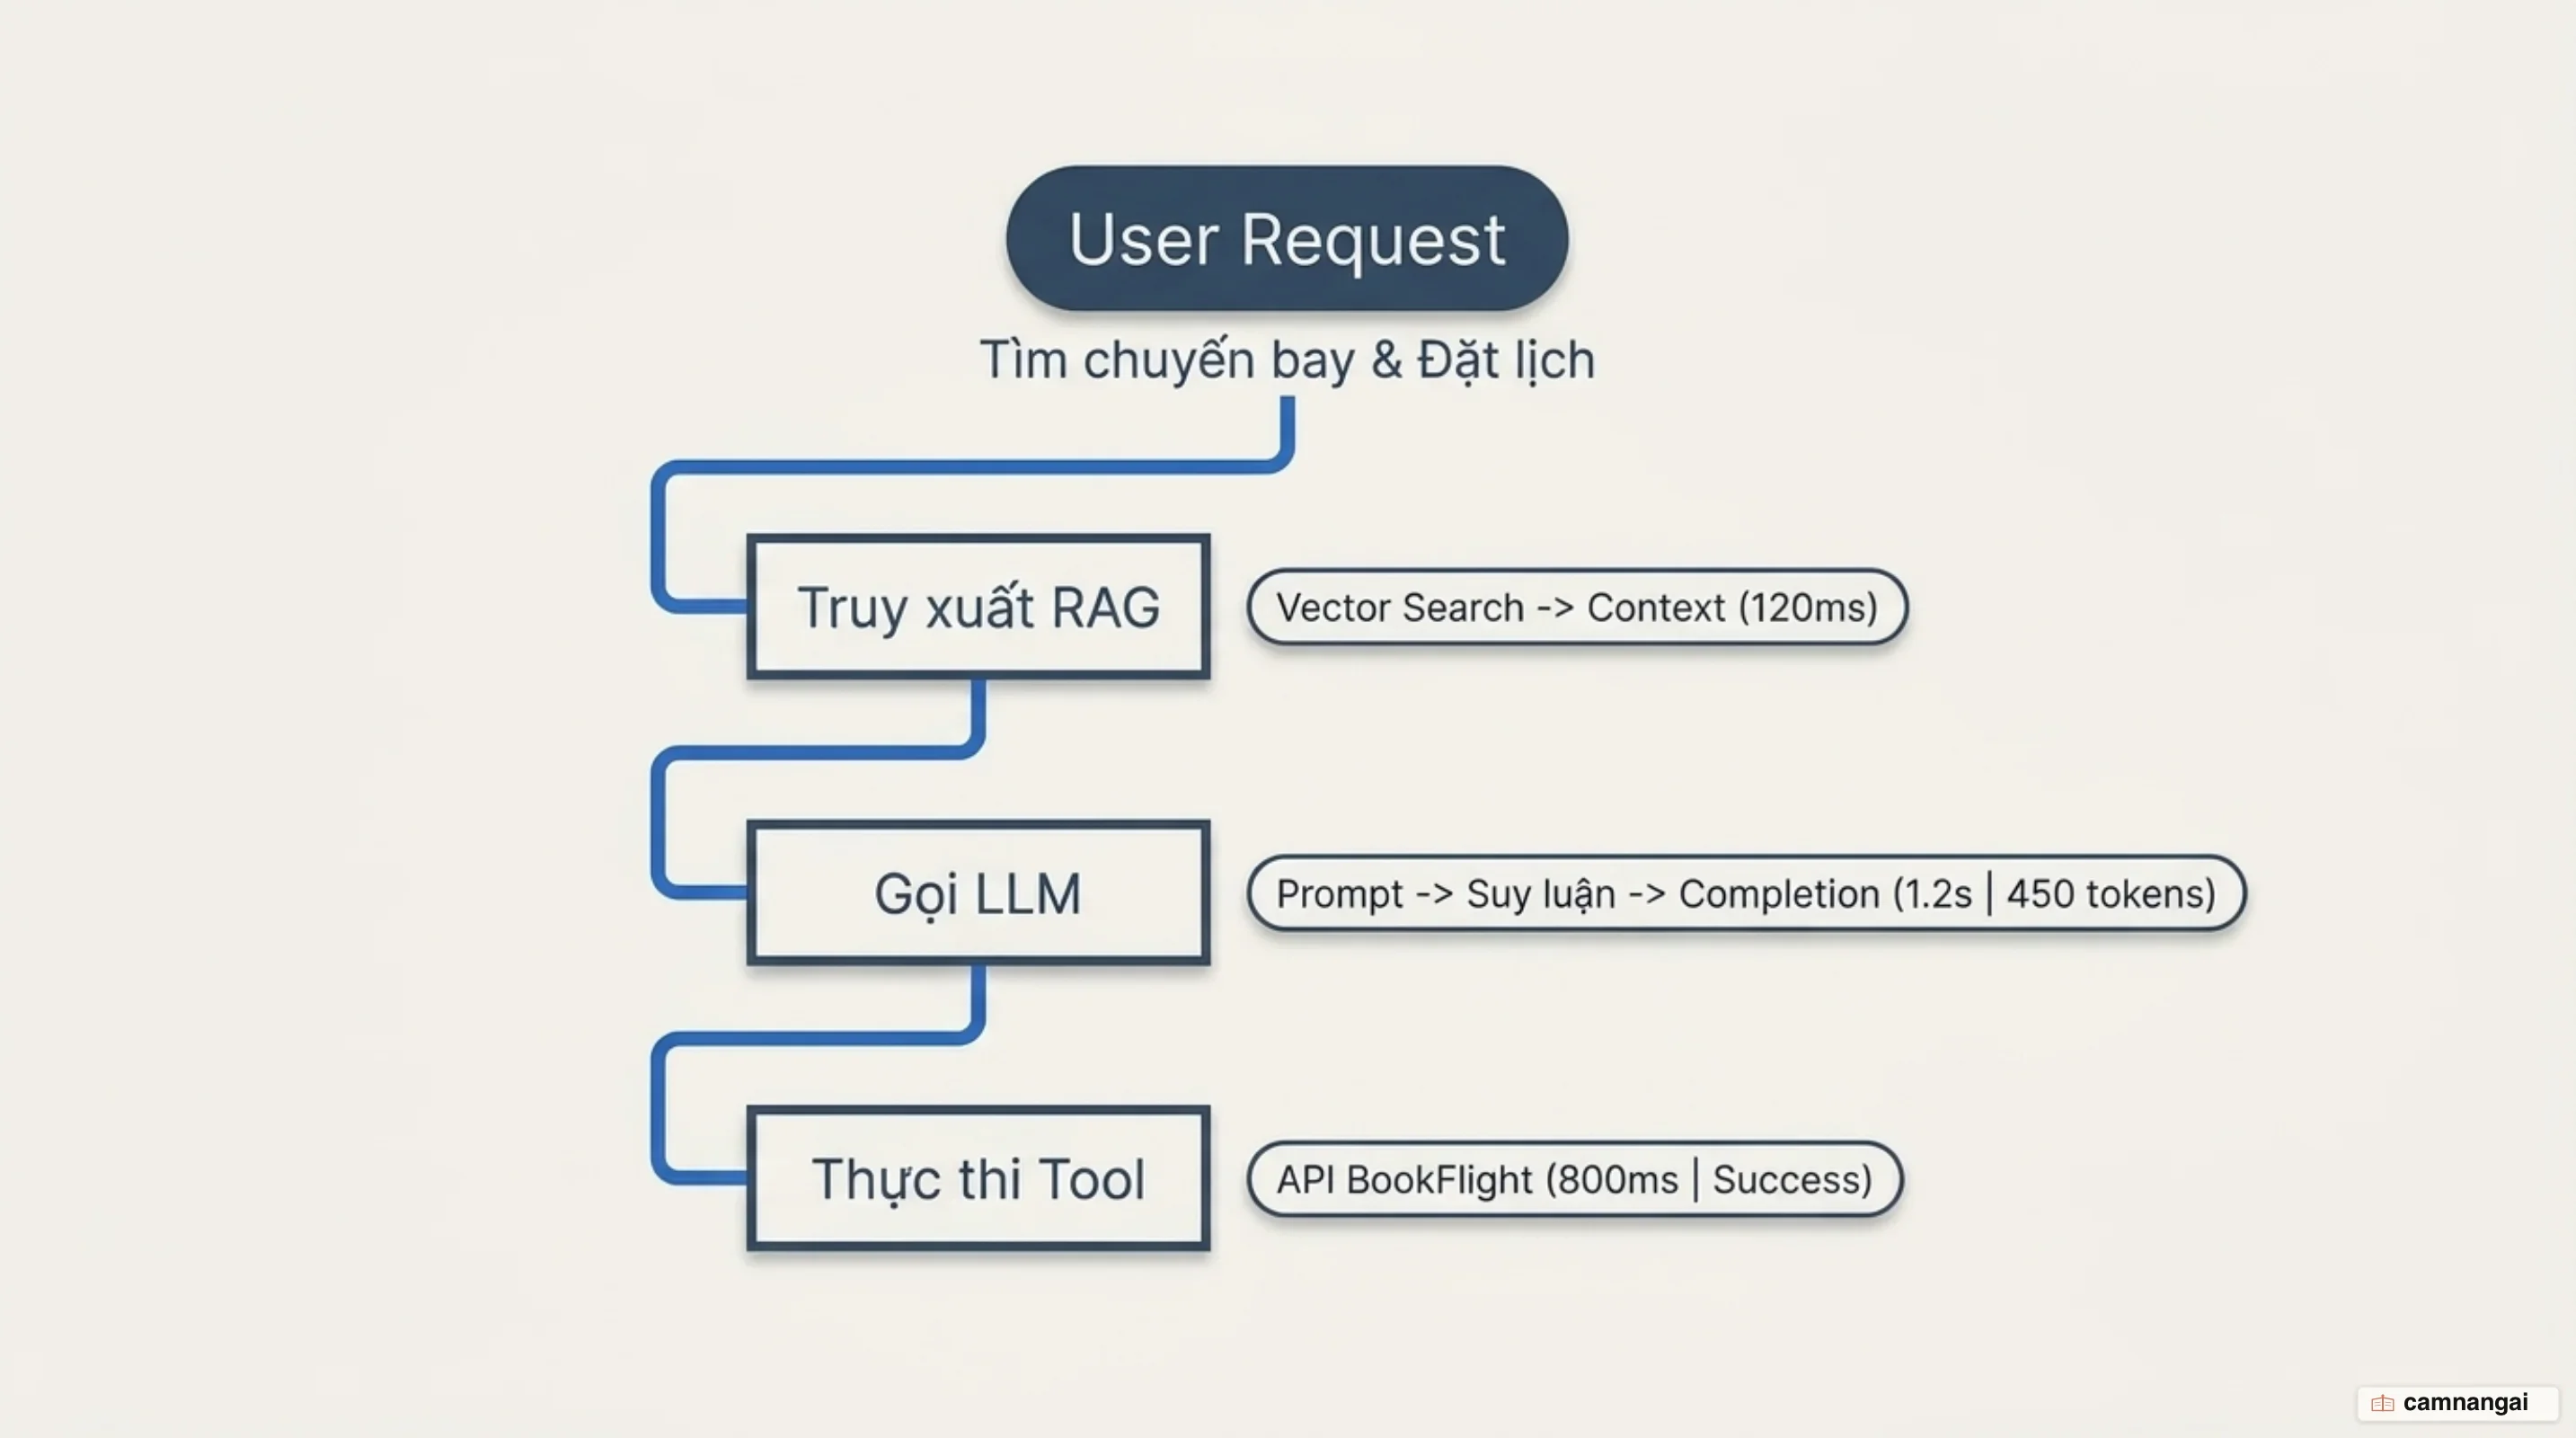
Trong các ứng dụng LLM phức tạp, Application Tracing là kỹ thuật bắt buộc để ghi lại toàn bộ vòng đời của một giao dịch. Hệ thống phân tách dữ liệu truy vết thành hai khái niệm cốt lõi: Trace và Span. Trace (Hành trình) đại diện cho toàn bộ luồng xử lý từ khi người dùng gửi yêu cầu ban đầu, đi qua nhiều Agent trung gian, thực hiện các truy vấn RAG, gọi các công cụ cho đến khi trả về kết quả cuối cùng. Span (Khoảng thực thi) là đơn vị thao tác đơn lẻ nhỏ nhất bên trong một Trace, ghi lại chi tiết một lượt gọi LLM, một truy vấn tới Vector Database, hoặc một lần chạy hàm Python/API.
Đối với các hệ thống AI Agent đa bước, việc quan sát phải mở rộng thành Đồ thị thực thi (Execution Graph / Trajectory). Một sai lầm phổ biến là chỉ ghi nhận chuỗi hội thoại văn bản (Transcript) mà bỏ qua sự thay đổi trạng thái thực tế của hệ thống (Outcome). Nếu Agent hỗ trợ đặt vé hoặc hủy đơn hàng, Transcript chỉ thể hiện Agent đã nói "Đơn hàng đã được hủy", nhưng Outcome mới là chỉ số xác định xem giao dịch trong cơ sở dữ liệu SQL đã thực sự chuyển sang trạng thái cancelled hay chưa.
Để đảm bảo quá trình ghi vết không làm gia tăng độ trễ trên luồng xử lý chính (main execution thread), các SDK tracing hiện đại triển khai cơ chế thu thập bất đồng bộ theo nguyên lý non-blocking. Dữ liệu Trace và Span được đẩy vào một hàng đợi cục bộ (local queue) và thực hiện đẩy dữ liệu theo đợt (batching) trên luồng đệm ẩn (background thread/worker), giúp giữ cho overhead độ trễ tăng thêm vào ứng dụng người dùng ở mức xấp xỉ 0 ms.
Hai nhịp độ đánh giá LLM: Offline trong CI/CD và Online trên môi trường Production
Quy trình đánh giá chất lượng LLM phải được vận hành ở hai nhịp độ hoàn toàn khác nhau nhưng bổ trợ lẫn nhau: Offline trong đường ống CI/CD và Online trên môi trường Production.
 +-------------------------------------------------------+
 | Online Monitoring |
 | (Production traffic, User feedback, LLM Judges) |
 +-------------------------------------------------------+
 |
 | Trích xuất traces lỗi (Outliers)
 v
 +-------------------------------------------------------+
 | Offline Evals (CI/CD) |
 | (Golden Datasets, Code assertions, Regression tests) |
 +-------------------------------------------------------+
 |
 | Ngăn ngừa lỗi gãy vỡ (Block deployment)
 v
 +-------------------------------------------------------+
 | Production Release |
 +-------------------------------------------------------+
Đánh giá Offline (Offline Evals) diễn ra trong đường ống CI/CD trước khi phát hành mã nguồn, prompt hoặc phiên bản mô hình mới. Mục tiêu duy nhất của Offline Evals là ngăn chặn lỗi gãy vỡ (regression testing). Quy trình này chạy trên bộ dữ liệu kiểm thử chuẩn (Golden Datasets, thường chứa từ 100+ ví dụ đại diện cho các kịch bản cốt lõi và các trường hợp biên từng bị lỗi). Offline Evals ưu tiên sử dụng các bộ kiểm tra tất định bằng code và các bộ giám sát LLM mỏng nhẹ để tối ưu chi phí và thời gian chạy. Trong CI/CD, các tích hợp như langfuse/experiment-action sẽ kích hoạt RegressionError và chặn việc triển khai nếu điểm số đánh giá giảm xuống dưới ngưỡng quy định.
Đánh giá Online (Online Monitoring) diễn ra trực tiếp trên luồng dữ liệu Production. Mục tiêu là phát hiện sự trôi dạt phân phối dữ liệu (distribution drift) và thu thập các lỗi thực tế mà người dùng gặp phải. Do dữ liệu Production không có đáp án tham chiếu (reference answer), Online Evals sử dụng phương pháp lấy mẫu bất đồng bộ (asynchronous sampling), kết hợp với phản hồi trực tiếp từ người dùng (User Feedback như nút bấm thumbs up/down, báo lỗi) và chạy các bộ đánh giá không cần câu trả lời tham chiếu (reference-free LLM-as-a-judge).
Vòng lặp đóng kín giữa hai nhịp độ này tạo nên sự cải tiến liên tục: Khi hệ thống Online Monitoring phát hiện ra các Trace bị lỗi hoặc có điểm số thấp, các Trace này sẽ được trích xuất, làm sạch và đưa ngược lại vào bộ kiểm thử tĩnh Offline trong CI/CD để đảm bảo lỗi đó không bao giờ lặp lại trong các phiên bản tương lai.
Phương pháp luận đánh giá: Kiểm tra tất định, LLM-as-a-judge và chấm điểm con người
Để xây dựng một hệ thống đánh giá đáng tin cậy, bạn phải phối hợp ba lớp giám định (Graders) theo mô hình phân tầng chi phí và độ phức tạp:
- Chấm điểm bằng mã nguồn (Deterministic Graders): Đây là lớp kiểm tra đầu tiên. Bạn sử dụng các quy tắc kiểm tra chuỗi, Chính quy (Regex), định dạng cấu trúc JSON, phân tích tĩnh (Ruff, Mypy, Bandit), hoặc chạy Unit Test và kiểm tra trực tiếp trạng thái CSDL SQL. Lớp này có tốc độ thực thi tính bằng miligiây, chi phí bằng 0 và độ tin cậy tuyệt đối cho các quy tắc cứng (ví dụ: mã bưu điện phải là số, JSON không bị lỗi cú pháp, dữ liệu phản hồi đã xuất hiện trong CSDL).
- Mô hình làm giám khảo (LLM-as-a-judge): Đối với các tiêu chuẩn mang tính định tính như văn phong, độ trung thực hoặc khả năng đồng cảm, bạn sử dụng một LLM độc lập đóng vai trò giám khảo dựa trên một Rubric hướng dẫn chi tiết. Trong thiết kế LLM-as-a-judge, bạn bắt buộc phải sử dụng nhãn nhị phân (Pass/Fail) thay vì thang đo Likert (1 đến 5). Thang đo Likert tạo ra sự mơ hồ giữa các mức (như mức 3 và 4), khiến các giám khảo mô hình xu hướng chọn các giá trị an toàn ở giữa và đòi hỏi kích thước mẫu lớn hơn nhiều để đạt được ý nghĩa thống kê. Nhãn nhị phân ép buộc mô hình đưa ra quyết định dứt khoát, đẩy nhanh tốc độ gắn nhãn và dễ dàng căn chỉnh với đánh giá của con người.
- Giám khảo con người (Human Graders): Chuyên gia miền chuyên môn (Domain Expert / "Benevolent Dictator") là chuẩn mực tối cao (Gold Standard). Con người không chấm toàn bộ hàng nghìn trace mà đóng vai trò gán nhãn cho các tập dữ liệu huấn luyện/kiểm thử, đồng thời duyệt các trường hợp LLM Judge không nhất quán để hiệu chuẩn (calibrate) thuật toán chấm điểm tự động.
Dưới đây là một ví dụ tệp cấu hình YAML định nghĩa quy trình chấm điểm đa tầng cho một tác vụ sửa lỗi an ninh mạng:
task:
 id: "fix-auth-bypass-v1"
 description: "Xử lý lỗi rò rỉ xác thực khi trường mật khẩu rỗng"
 graders:
 # 1. Deterministic code check
 - type: deterministic_tests
 required: ["test_empty_pw_rejected.py", "test_null_pw_rejected.py"]
 - type: static_analysis
 commands: ["ruff check", "mypy src/", "bandit -r src/"]
 - type: state_check
 expect:
 security_logs: { event_type: "auth_blocked" }

 # 2. LLM-as-a-judge with Binary Rubric
 # Ep buoc dau ra nhi phan (Pass/Fail) de loai bo su mo ho cua thang do Likert (1-5) va toi uu do tuong dong voi gan nhan con nguoi
 - type: llm_rubric
 prompt_file: "prompts/code_quality_rubric.md"
 output_format: "binary_pass_fail"
 assertions:
 - "Mã nguồn không chứa các hàm mã hóa bị phản đối (deprecated)"
 - "Giải pháp xử lý triệt để trường hợp input null mà không gây crash"

 # 3. Tool call execution check
 - type: tool_calls
 required:
 - { tool: read_file, params: { path: "src/auth/*" } }
 - { tool: edit_file }
 - { tool: run_tests }
Bộ chỉ số cốt lõi: Độ trung thực, mức độ liên quan và hành trình của AI Agent
Việc đo lường ứng dụng LLM đòi hỏi các bộ chỉ số kỹ thuật chuyên biệt tùy theo kiến trúc hệ thống:
Khung đánh giá hệ thống RAG
Đối với hệ thống Retrieval-Augmented Generation (RAG), việc đánh giá được chia làm hai giai đoạn độc lập: Truy xuất ngữ cảnh (Retrieval) và Phản hồi (Generation). Trong hệ thống Agentic, thao tác truy xuất RAG thực chất là một lượt gọi công cụ (tool span) nằm trong toàn bộ đồ thị thực thi (Execution Graph), do đó chất lượng truy xuất và độ trung thực của ngữ cảnh ảnh hưởng trực tiếp đến độ chính xác của các bước chuyển trạng thái kế tiếp.
- Mức độ liên quan của ngữ cảnh (Context Relevance - C|Q): Đánh giá xem bộ truy xuất có lấy đúng tài liệu cần thiết từ cơ sở tri thức hay không dựa trên câu hỏi người dùng (Q). Giai đoạn này sử dụng các chỉ số Truy xuất Thông tin (IR) chuẩn:
Recall@kđo Tỷ lệ tài liệu liên quan được trích xuất thành công trong top $k$ kết quả.Precision@kđo Tỷ lệ tài liệu thực sự có ích nằm trong $k$ tài liệu được trả về.MRR (Mean Reciprocal Rank)đo Vị trí của tài liệu chuẩn đầu tiên xuất hiện trong danh sách kết quả.- Độ trung thực (Faithfulness / Groundedness) đánh giá Đánh giá xem câu trả lời cuối cùng (A) có dựa hoàn toàn vào ngữ cảnh được cung cấp (C) hay chứa thông tin bịa đặt.
- Mức độ đáp ứng (Answer Relevance) đánh giá Đánh giá xem câu trả lời (A) có đi đúng trọng tâm yêu cầu của câu hỏi (Q) hay không, bất kể ngữ cảnh trích xuất là gì.
Bộ chỉ số cho Agentic Workflow
Khi LLM vận hành dưới dạng Agent đa bước, các chỉ số đo lường hiệu suất và độ ổn định bao gồm:
- Chỉ số
pass@kvàpass^k:pass@klà Xác suất có ít nhất 1 lần thành công trong $k$ lần thử. Chỉ số này phản ánh khả năng tìm ra lời giải của Agent khi được trao nhiều cơ hội (phù hợp cho các công cụ sinh mã nguồn offline).pass^klà Xác suất thành công liên tục trong toàn bộ $k$ lần thử. Đây là chỉ số đo lường độ ổn định tuyệt đối, cực kỳ quan trọng cho các Agent vận hành trực tiếp trước người dùng (nếu tỷ lệ thành công 1 lượt là 75%, thìpass^3 = (0.75)^3 ≈ 42.1%).
- Đánh giá bước chuyển (Step-level diagnostics): Kiểm tra xem Agent có chọn đúng công cụ (
Tool choice), trích xuất đúng tham số (Parameter extraction), xử lý tốt các ngoại lệ API (Error handling) và giữ vững ngữ cảnh qua các lượt (Context retention) hay không.
Để phát hiện điểm gãy vỡ trong luồng công việc đa bước, bạn cần sử dụng Ma trận lỗi chuyển trạng thái (Transition Failure Matrix). Bảng dưới đây minh họa việc theo dõi các điểm thất bại giữa trạng thái hiện tại và trạng thái kế tiếp trong một Agent Text-to-SQL:
| Trạng thái xuất phát \ Trạng thái đích | Trích xuất Yêu cầu (ParseIntent) | Sinh câu SQL (GenSQL) | Thực thi SQL (ExecSQL) | Tổng hợp Phản hồi (FormatAns) |
|---|---|---|---|---|
| Bắt đầu (Start) | Pass (100) / Fail (2) | - | - | - |
| ParseIntent | - | Pass (95) / Fail (3) | - | - |
| GenSQL | - | - | Pass (81) / Fail (14) | - |
| ExecSQL | - | - | - | Pass (80) / Fail (1) |
Ma trận trên chỉ ra rõ ràng rằng bước chuyển từ GenSQL sang ExecSQL là "điểm nóng" gây lỗi cao nhất (14 ca thất bại), giúp đội ngũ kỹ thuật tập trung tối ưu prompt sinh mã SQL thay vì lãng phí thời gian cải tạo bước ParseIntent.
Vòng lặp phản hồi: Biến trace thực tế thành bộ dữ liệu chuẩn (Golden Datasets)
Xây dựng một hệ thống AI chất lượng cao đòi hỏi một quy trình cải tiến sản phẩm dựa trên dữ liệu lỗi thực tế. Phương pháp Phân tích lỗi (Error Analysis) phải được thực hiện theo 3 bước chuẩn mực:
- Mã hóa mở (Open Coding): Chuyên gia miền chuyên môn tự tay đọc và ghi chú tự do trên 30 đến 50 Trace thực tế đầu tiên. Nguyên tắc cốt lõi là chỉ tập trung gán nhãn cho lỗi thượng nguồn đầu tiên (first upstream failure), vì các lỗi ở các bước sau thường chỉ là hệ quả dây chuyền của lỗi ban đầu.
- Mã hóa trục (Axial Coding): Gom nhóm các ghi chú tự do thành một Phân loại lỗi (Failure Taxonomy) có cấu trúc (ví dụ: "Sai định dạng ngày tháng", "Trích xuất thiếu ID khách hàng", "Trôi dạt văn phong").
- Lặp lại và hoàn thiện (Iterative Refinement): Cho phép AI Agent hỗ trợ phân cụm các trace còn lại theo taxonomy đã dựng, con người chấp nhận hoặc từ chối gợi ý cho đến khi đạt trạng thái Bão hòa Lý thuyết (Theoretical Saturation), tức thời điểm việc đọc thêm trace mới không phát hiện thêm dạng lỗi mới nào (thường đạt được sau khi duyệt khoảng 100+ trace đa dạng).
Từ quy trình Phân tích lỗi, bạn trích xuất các Trace bất thường (outliers), các câu lệnh biên phức tạp hoặc các tương tác bị người dùng gán nhãn xấu từ môi trường Production để đóng gói thành bộ dữ liệu kiểm thử chuẩn (Golden Dataset).
Khi không có đủ dữ liệu Production ban đầu, bạn có thể áp dụng kỹ thuật Tạo dữ liệu tổng hợp (Synthetic Data) theo hướng tiếp cận Kích thước & Phần tử (Dimensions & Tuples):
- Bước 1: Định nghĩa các chiều biến thiên (Dimensions), ví dụ với Chatbot hỗ trợ: Chiều 1: Loại yêu cầu (Hủy đơn, Đổi trả), Chiều 2: Tâm trạng (Bình tĩnh, Tức giận).
- Bước 2: Kết hợp các chiều thành các Bộ giá trị (Tuples) như
(Hủy đơn, Tức giận). - Bước 3: Dùng LLM chuyển đổi Tuple thành câu hỏi tự nhiên.
Lưu ý nghiêm ngặt: Dữ liệu tổng hợp hoàn toàn không đáng tin cậy trong các kịch bản: miền chuyên sâu phức tạp (hồ sơ y tế, văn bản luật pháp), ngôn ngữ ít phổ biến (low-resource languages), hoặc các nhóm người dùng yếu thế. Dữ liệu tổng hợp có xu hướng tạo ra các kịch bản lặp lại, che giấu các trường hợp biên trong thực tế và không phản ánh chính xác tần suất lỗi Production.
Triển khai thực tế: Hệ sinh thái công cụ và những cạm bẫy cần tránh
Hệ sinh thái công cụ quan sát và đánh giá hiện nay phát triển nhanh chóng với các giải pháp như Langfuse, Braintrust, Arize/Phoenix, LangSmith, Honeycomb và Harbor. Dù vậy, các công cụ này chỉ đóng vai trò hạ tầng lưu trữ và hiển thị; năng lực cốt lõi vẫn nằm ở chất lượng bộ kiểm thử và mức độ thấu hiểu dữ liệu lỗi của đội ngũ kỹ thuật. Trong quá trình thực thi, Bốn cạm bẫy kỹ thuật phổ biến cần tuyệt đối tránh bao gồm: (1) Lạm dụng các chỉ số chung chung không có giá trị thực tế như helpfulness hay coherence sẵn có; (2) Ám ảnh bởi việc đổi mô hình liên tục thay vì phân tích nguyên nhân gốc rễ (root cause analysis) từ Trace; (3) Ép Agent tuân theo một chuỗi gọi công cụ cố định thay vì đánh giá kết quả đầu ra thực tế (Outcome); và (4) Outsource hoàn toàn khâu gán nhãn cho bên thứ ba thay vì sử dụng chuyên gia miền nội bộ.
Bạn nên bắt đầu ngay bằng việc đọc trực tiếp 20 đến 50 Trace thực tế, tự xây dựng giao diện gán nhãn tùy chỉnh (custom annotation UI) bằng các khung như FastHTML hoặc Python Notebooks để tối ưu tốc độ duyệt dữ liệu, và áp dụng triệt để phương pháp Phát triển Hướng Đánh giá (Eval-Driven Development).
Tài liệu tham khảo
- Your AI Product Needs Evals – Hamel's Blog
- AI Evals: Everything You Need to Know – Hamel's Blog
- Demystifying evals for AI agents \ Anthropic
- Generative AI Semantic Conventions | OpenTelemetry
- Evaluation of LLM Applications | Langfuse
- LLM Observability & Application Tracing | Langfuse
- Arize Phoenix Documentation | AI Observability & Evaluation Platform
- LLM Observability in Practice | Honeycomb