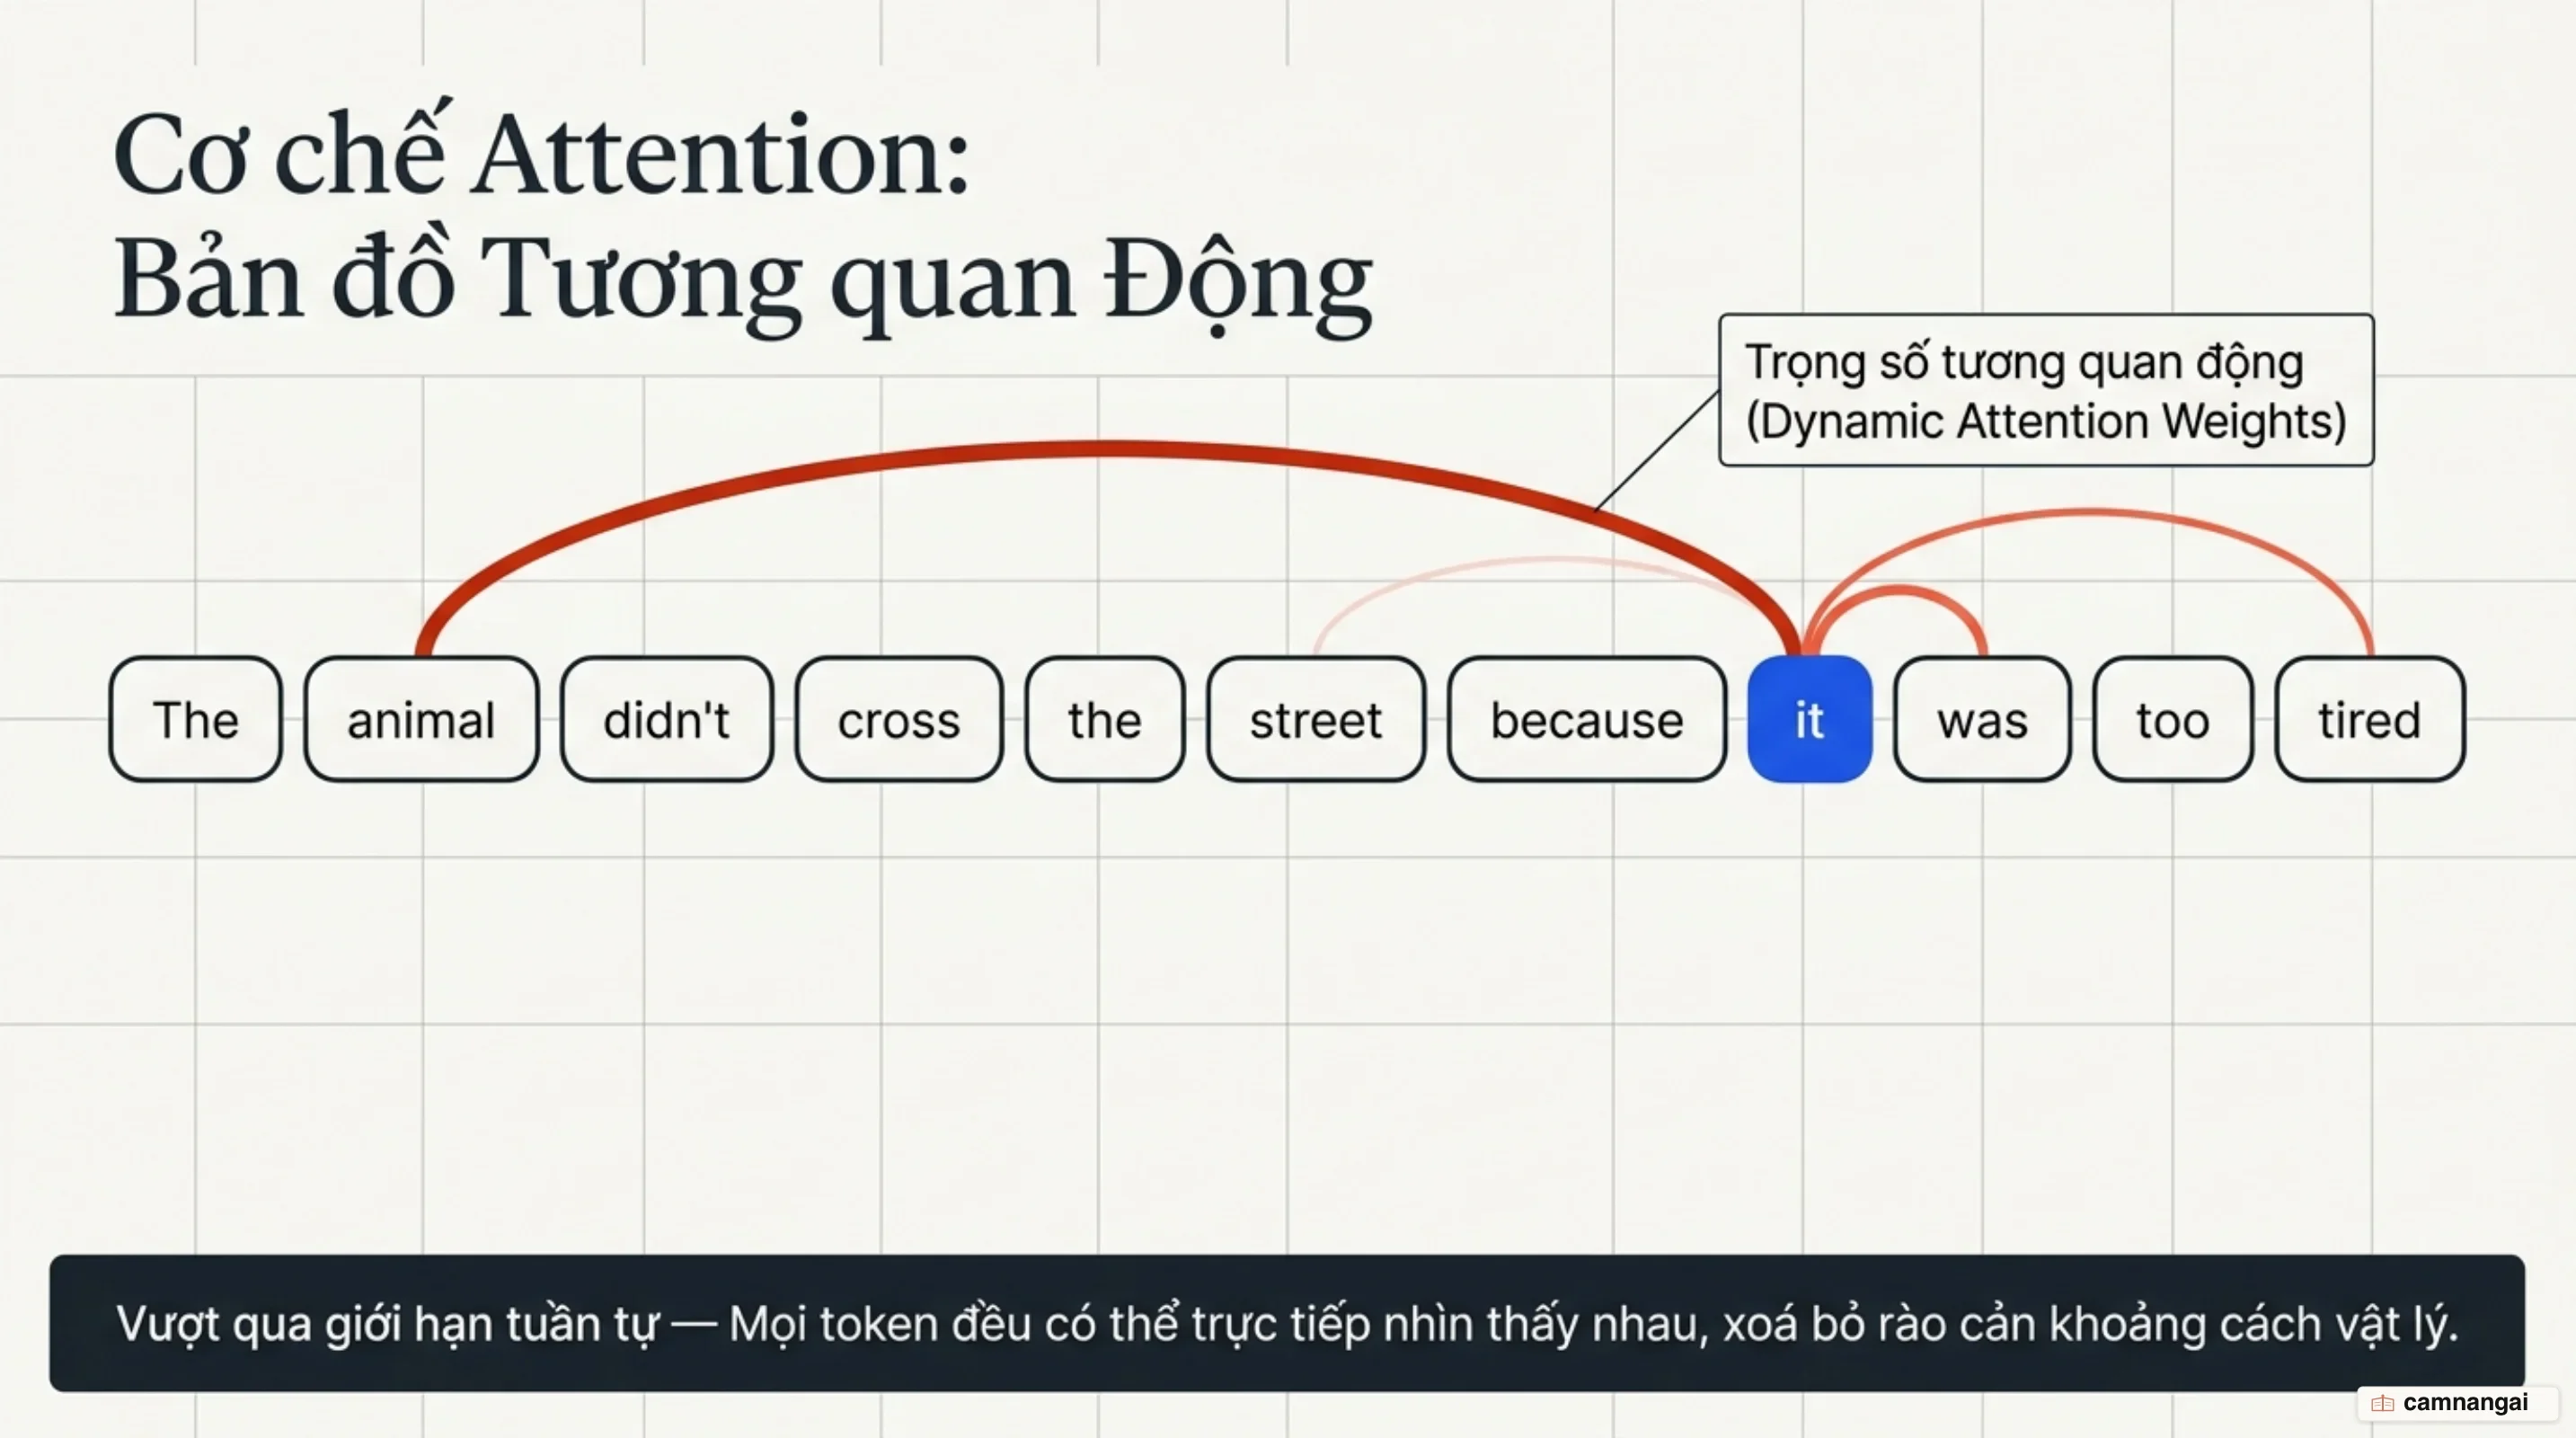
Về bản chất toán học, cơ chế attention (cơ chế chú ý) là một vectơ chứa các trọng số tầm quan trọng (importance weights), cho phép các mô hình xử lý chuỗi ước tính mức độ tương quan động giữa các phần tử và tính tổng có trọng số của các giá trị để xấp xỉ đối tượng mục tiêu.
Khi bạn thiết kế các mô hình học sâu cho xử lý chuỗi, thay vì nén toàn bộ thông tin của chuỗi đầu vào có độ dài tùy ý vào một vectơ ngữ cảnh (context vector) kích thước cố định như các kiến trúc mạng hồi quy truyền thống, cơ chế attention thiết lập các đường kết nối trực tiếp (shortcuts) giữa bộ giải mã và tất cả các trạng thái ẩn trung gian của bộ mã hóa.
Cấu trúc này cho phép mô hình gán điểm số ngữ cảnh linh hoạt trên toàn bộ các token đầu vào tại mỗi bước phát sinh dữ liệu, loại bỏ hoàn toàn điểm nghẽn biểu diễn cố định và khai mở khả năng xử lý các phụ thuộc xa trong chuỗi mà bạn thường gặp khi huấn luyện hệ thống.
Điểm nghẽn của RNN và lý do cơ chế Attention ra đời
Khi bạn triển khai các kiến trúc Mạng thần kinh Hồi quy (RNN) như LSTM hay GRU, tính toán bị tuần tự hóa theo từng bước thời gian: trạng thái ẩn h_t được tính toán dưới dạng hàm số h_t = f(h_{t-1}, x_t) phụ thuộc trực tiếp vào trạng thái h_{t-1} ngay trước đó và đầu vào x_t. Tính chất tuần tự nội tại này ngăn cản khả năng song song hóa quá trình tính toán trong cùng một mẫu huấn luyện, tạo ra điểm nghẽn nghiêm trọng về hiệu năng và hạn chế mức độ khai thác bộ nhớ GPU khi bạn mở rộng độ dài chuỗi.
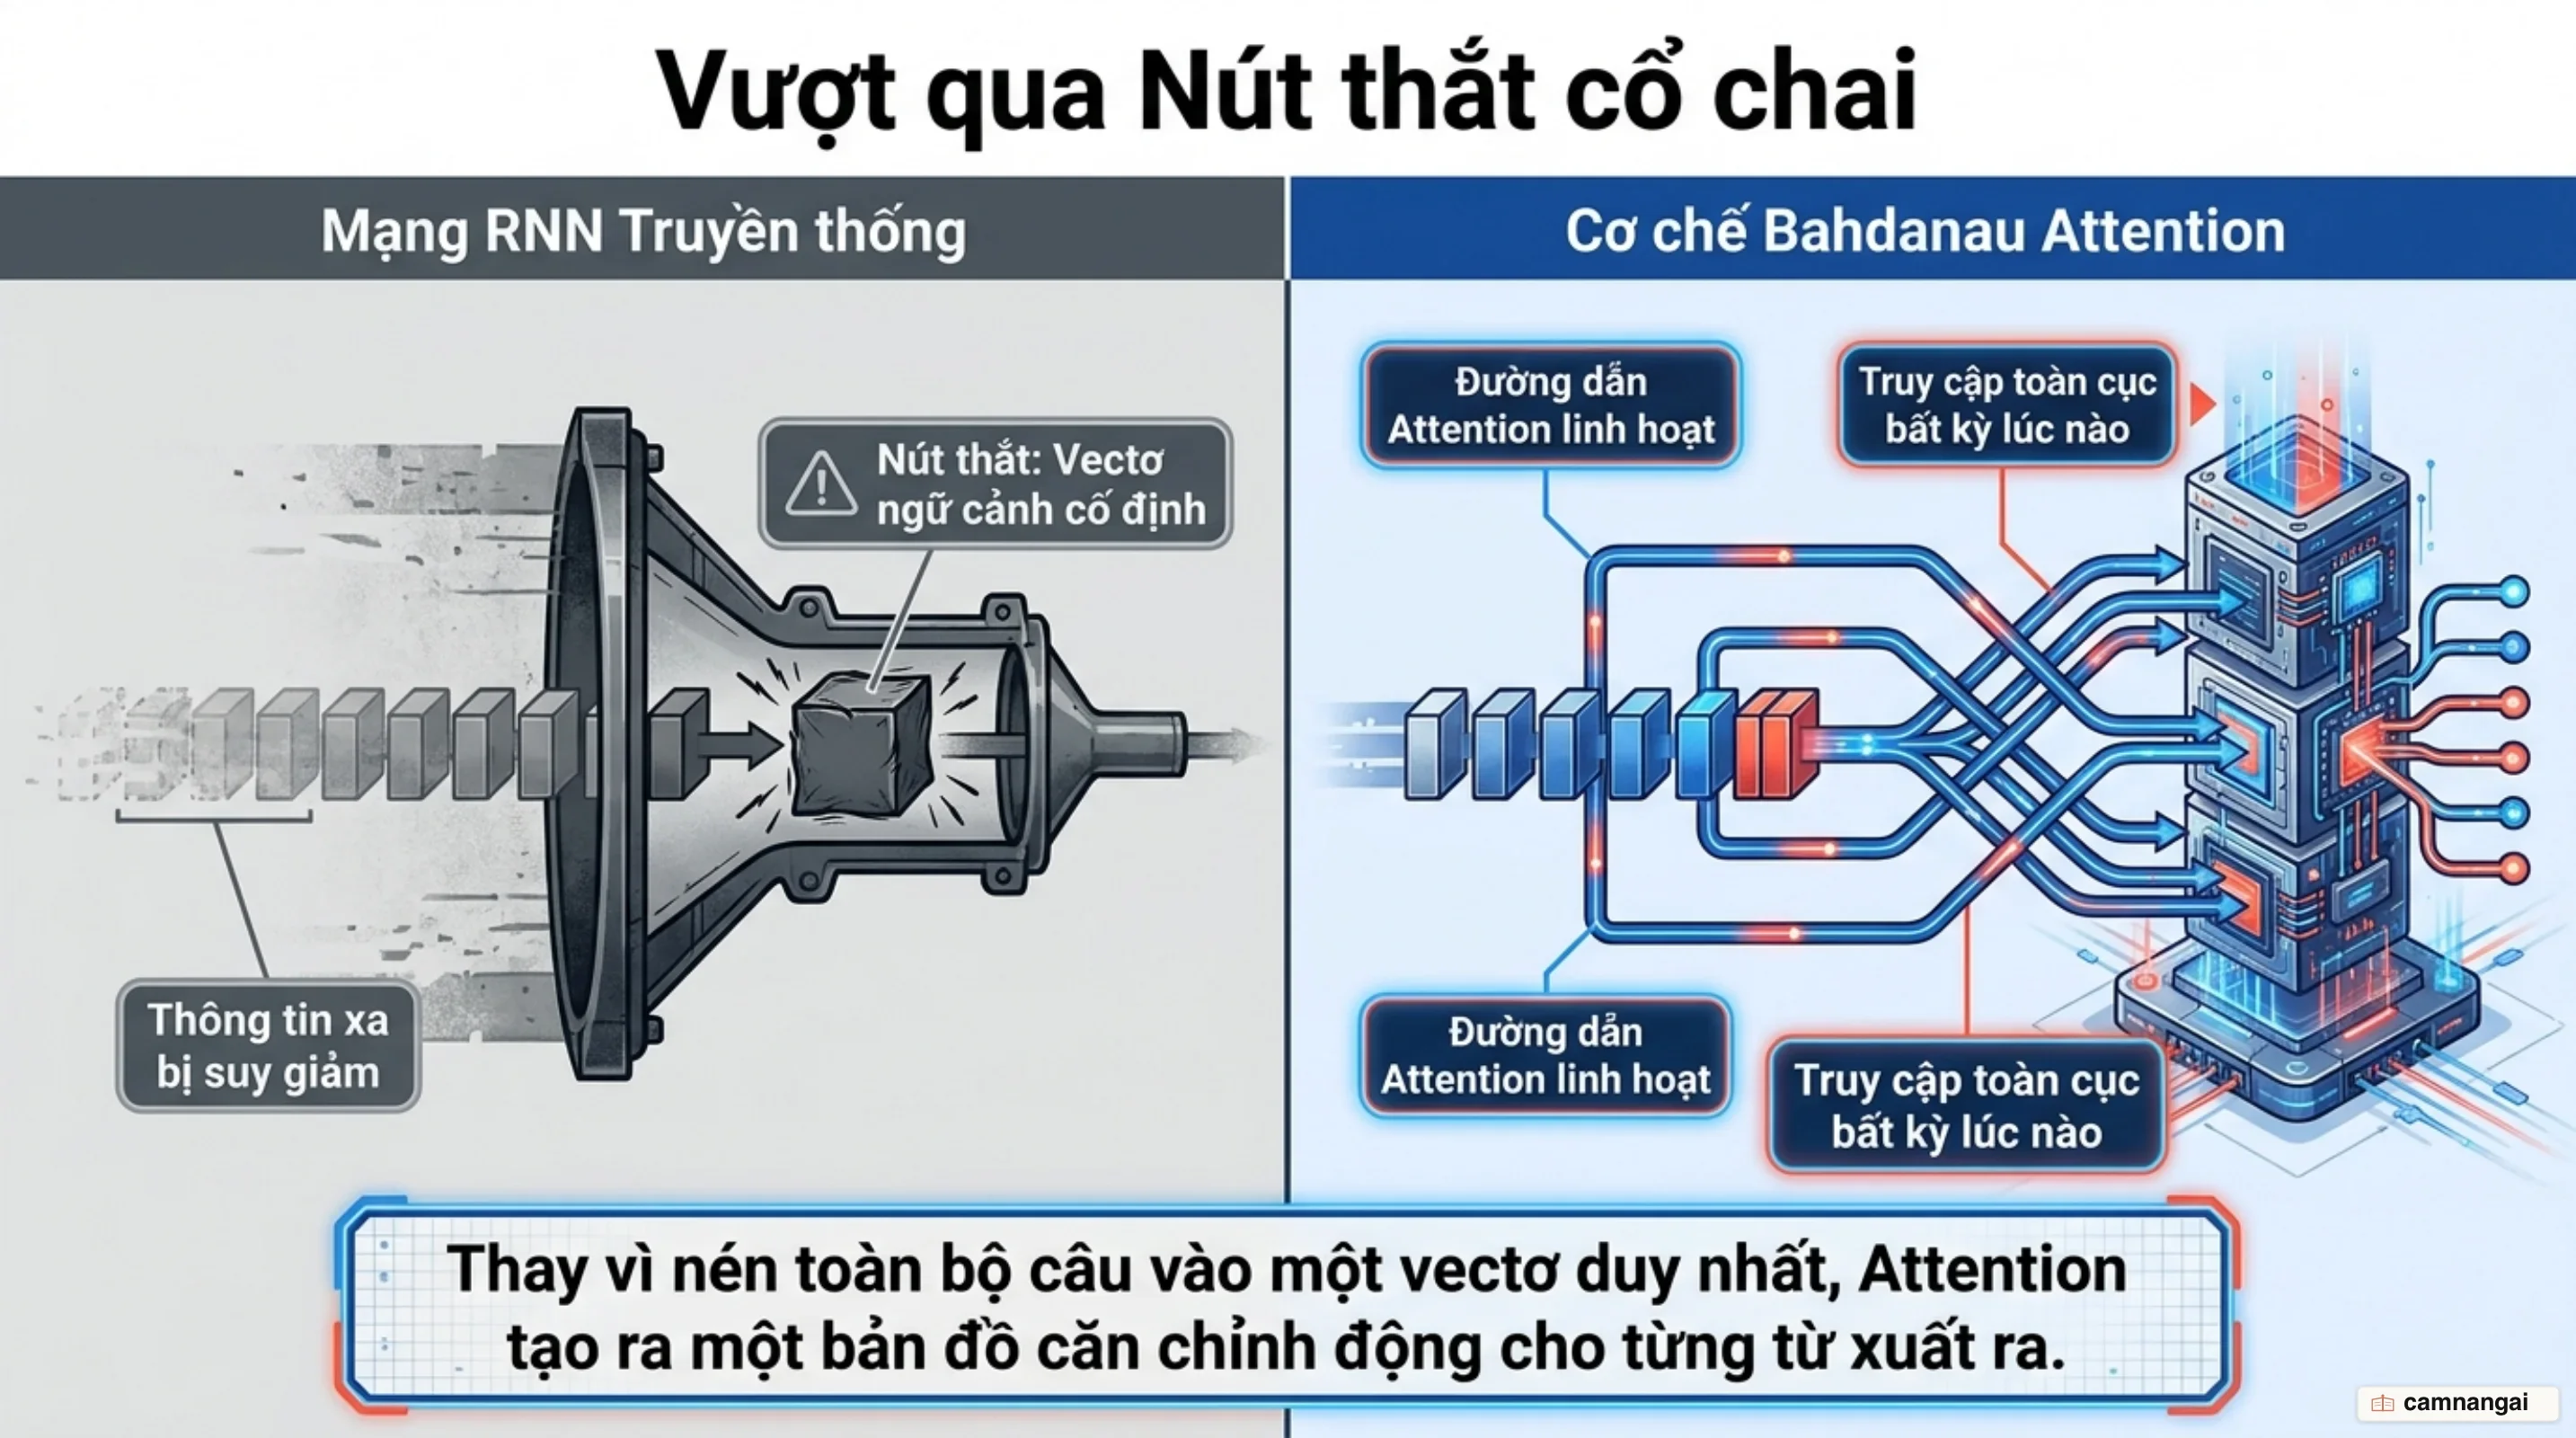
Bên cạnh hạn chế tính toán, RNN gặp phải điểm nghẽn lớn khi bạn muốn mô hình hóa các phụ thuộc khoảng cách xa (long-range dependencies). Tín hiệu lan truyền ngược giữa hai token cách xa nhau N vị trí phải trải qua O(N) phép toán tuần tự. Quá trình lan truyền qua chuỗi dài khiến đạo hàm dễ bị triệt tiêu hoặc bùng phát (vanishing or exploding gradients), làm cho mô hình mất khả năng duy trì mối liên kết giữa các phần tử ở đầu và cuối chuỗi.
Trong mô hình Sequence-to-Sequence (Seq2Seq) cổ điển của Sutskever và cộng sự, bộ mã hóa (encoder) nén toàn bộ chuỗi đầu vào có độ dài bất kỳ thành một vectơ ngữ cảnh (context vector) có kích thước cố định để khởi tạo cho bộ giải mã (decoder). Vectơ này tạo ra một điểm nghẽn thông tin (information bottleneck). Khi chuỗi đầu vào kéo dài, dung lượng cố định của vectơ không đủ chứa toàn bộ ngữ cảnh, dẫn đến mất mát thông tin nghiêm trọng trên các câu dài.
Để giải quyết triệt để vấn đề này, Bahdanau và cộng sự đã đề xuất cơ chế attention bằng cách thiết lập các đường kết nối tắt (shortcut connections) giữa bộ giải mã và toàn bộ trạng thái ẩn trung gian của bộ mã hóa. Tại mỗi bước phát sinh đầu ra t, mô hình cho phép bạn tính toán một tổng có trọng số linh hoạt c_t = Σ (α_{t,i} · h_i), gán điểm số gióng hàng động giữa nguồn và mục tiêu mà không bị giới hạn bởi độ dài chuỗi.
Bản chất toán học: Query, Key, Value và cơ chế chấm điểm
Khi bạn gửi một truy vấn Query (Q) vào hệ thống, cơ chế attention hoạt động như một thao tác truy xuất động (dynamic retrieval) từ một ngân hàng dữ liệu lưu trữ dưới dạng các cặp Key-Value (K, V). Mô hình so sánh Q với tất cả các K để xác định mức độ tương quan (compatibility score), từ đó tính ra một tập hợp các trọng số attention. Trọng số này sau đó được dùng để tính tổng có trọng số của các V, tạo ra đầu ra chứa ngữ cảnh tương ứng cho truy vấn của bạn:
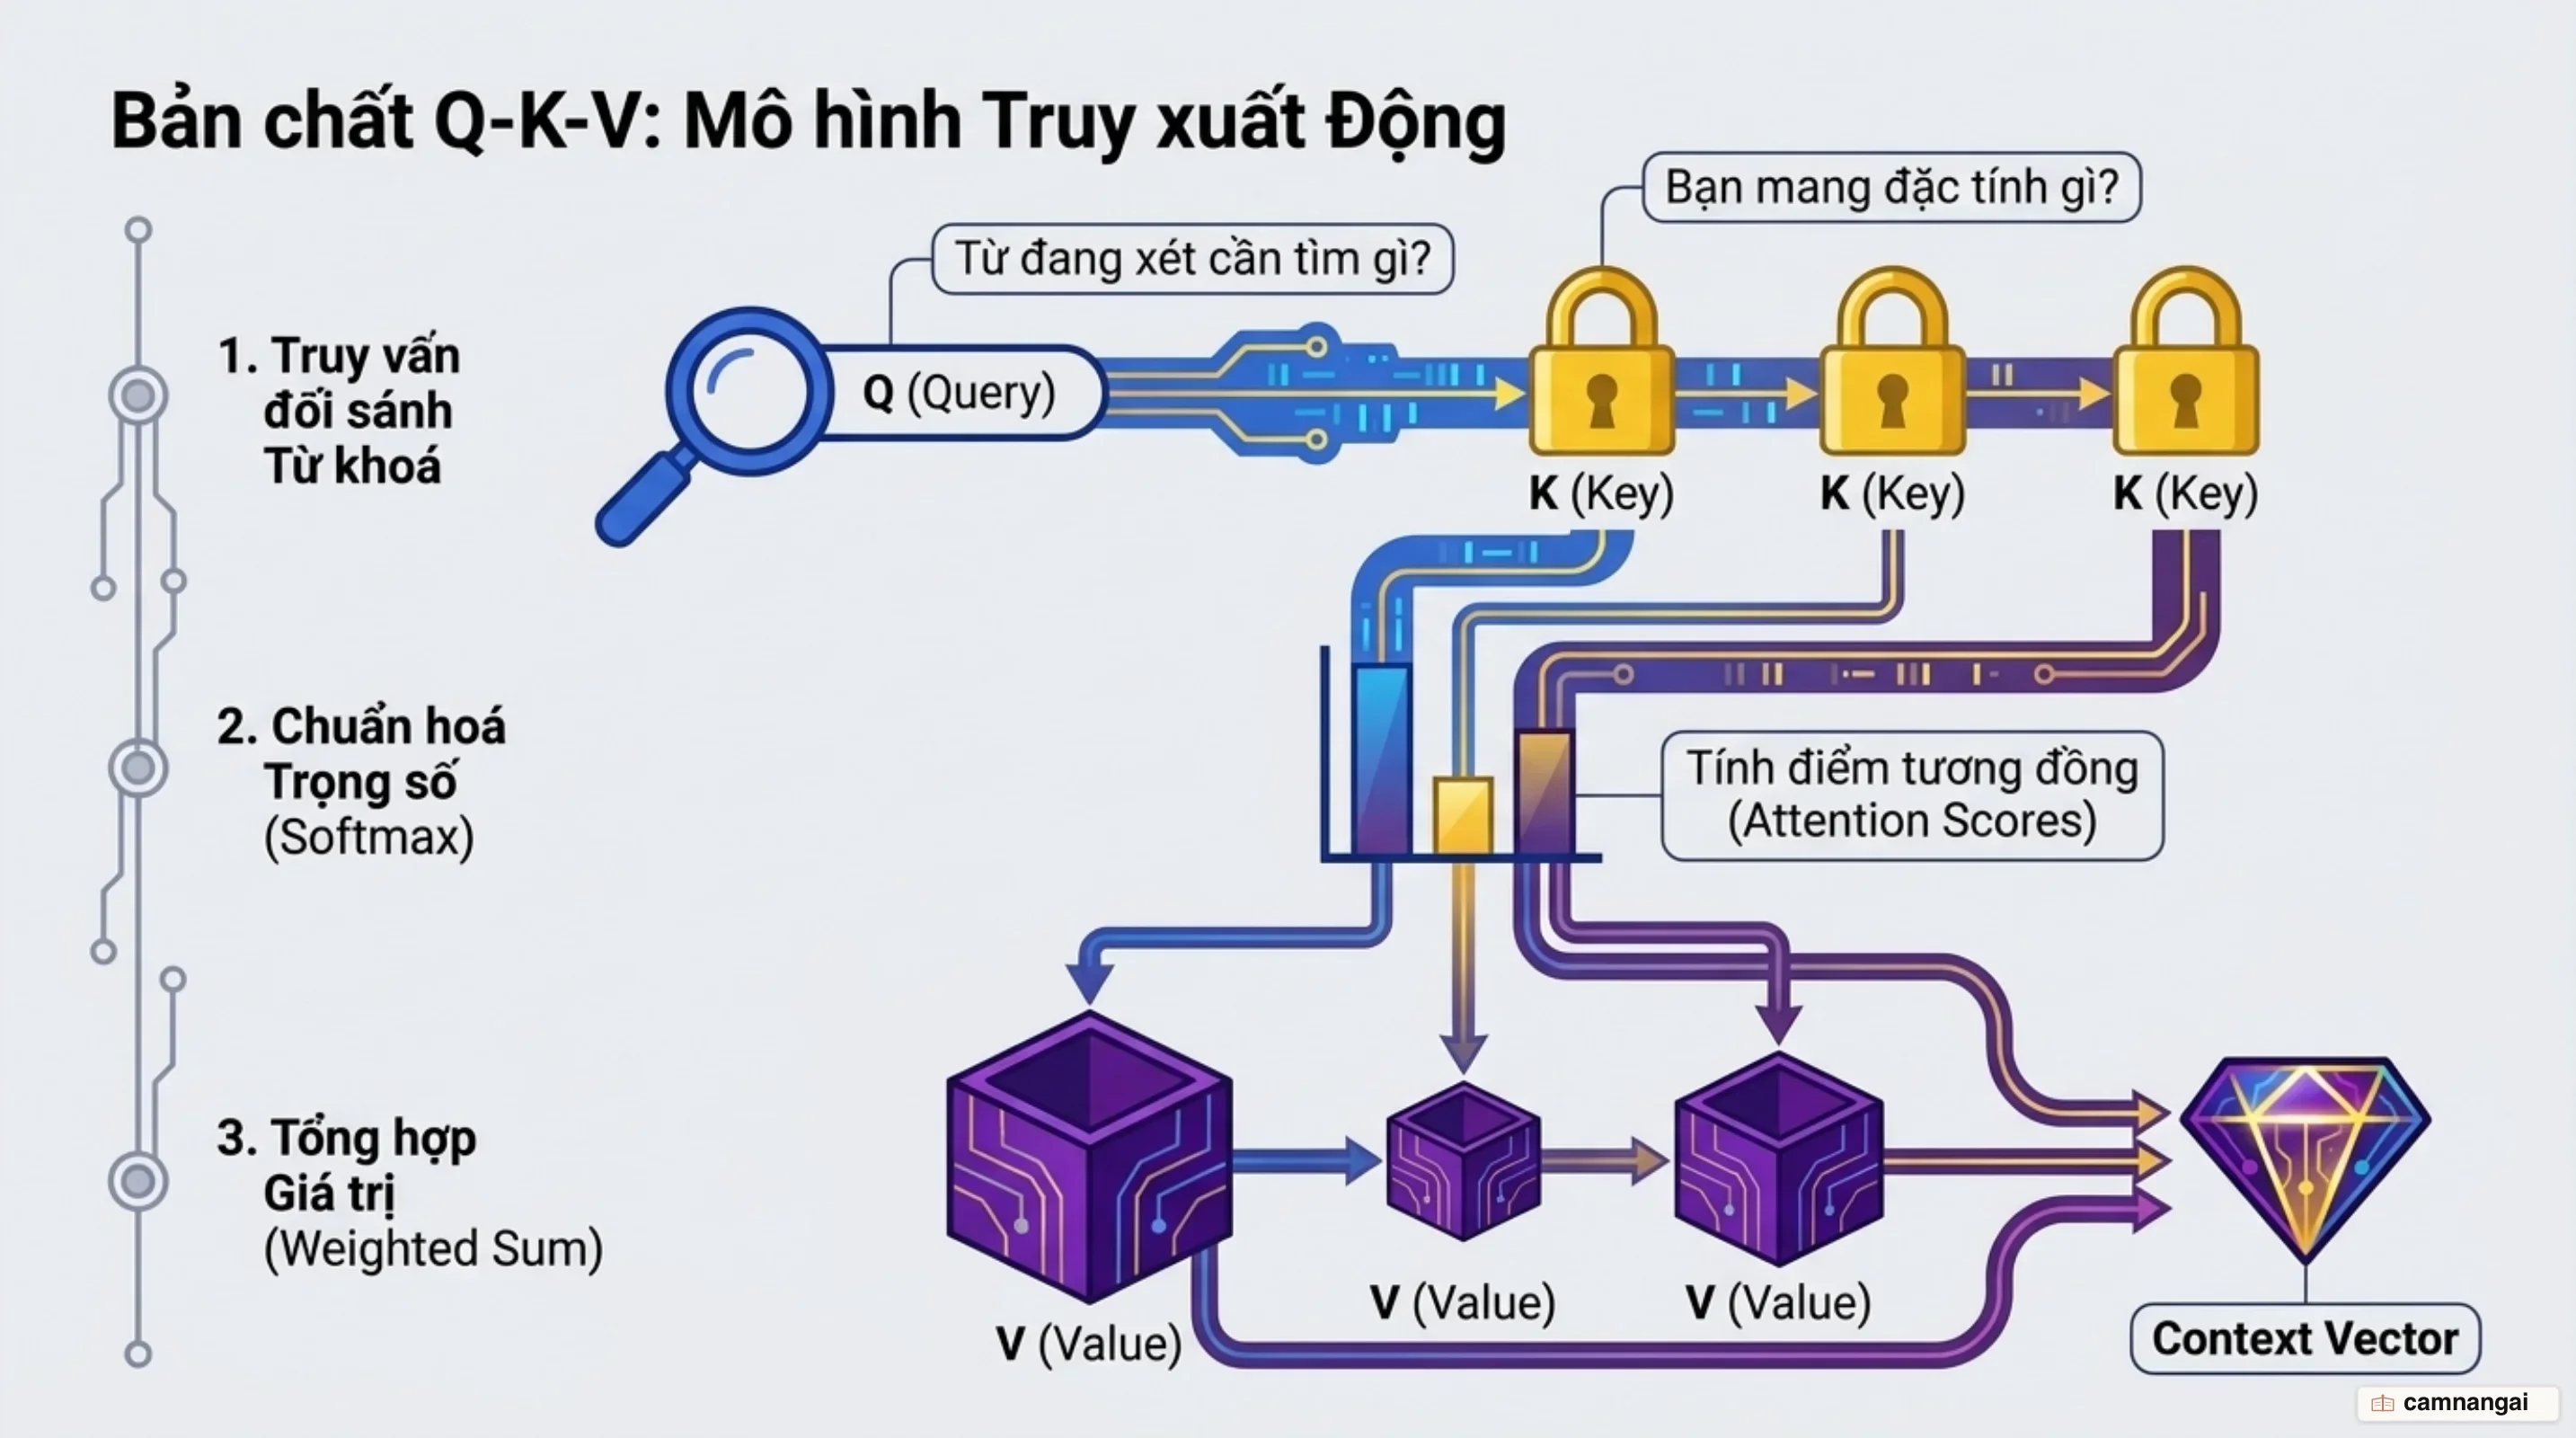
Output = Σ (α_i · v_i)Trong quá trình phát triển, hàm chấm điểm Additive Attention của Bahdanau và cộng sự tính toán mức độ tương thích giữa Query q và Key k thông qua một mạng Feed-Forward lớp ẩn đơn với hàm kích hoạt tanh:
score(q, k) = v_a^T · tanh(W_q · q + W_k · k)Trong công thức trên, các ma trận trọng số W_q, W_k và vectơ v_a là các tham số có thể học. Ưu điểm của Additive Attention là khả năng xử lý linh hoạt các truy vấn q và khóa k có kích thước chiều khác nhau nhờ hai ma trận chiếu độc lập W_q và W_k.
Khi bạn triển khai phép cộng W_q · q và W_k · k trong mã nguồn, cơ chế broadcasting của framework sẽ tự động mở rộng kích thước tensor. Chi tiết hơn, nếu W_q · q có kích thước (batch, no_queries, 1, num_hiddens) và W_k · k có kích thước (batch, 1, no_keys, num_hiddens), phép cộng số học sẽ tự động mở rộng cả hai thành kích thước chung (batch, no_queries, no_keys, num_hiddens) trước khi đưa qua hàm tanh, cho phép tính điểm tương thích cho mọi cặp (q, k) đồng thời.
Dạng chấm điểm thứ hai là Dot-Product Attention (tích vô hướng) do Luong và cộng sự đề xuất, trong đó điểm tương quan được xác định trực tiếp bằng tích vô hướng hoặc qua ma trận trung gian W_a:
score(q, k) = q^T · k hoặc score(q, k) = q^T · W_a · kMặc dù hai phương pháp có độ phức tạp lý thuyết tương đồng ở chiều không gian nhỏ, Dot-Product Attention áp đảo trong thực tế kỹ thuật. Tích vô hướng cho phép bạn chuyển đổi toàn bộ phép tính thành các phép nhân ma trận song song khối lượng lớn, khai thác triệt để các thư viện đại số tuyến tính (BLAS) được tối ưu ở cấp độ phần cứng trên GPU.
Scaled Dot-Product Attention: Động cơ cốt lõi của Transformer
Trong kiến trúc Transformer, Vaswani và cộng sự chuẩn hóa cơ chế Scaled Dot-Product Attention. Khi bạn truyền vào ma trận chứa n truy vấn Q, m khóa K và m giá trị V, biểu thức tính toán dạng ma trận được thiết lập như sau:
Attention(Q, K, V) = softmax((Q · K^T) / √d_k) · VPhép chia cho hệ số √d_k là một đòi hỏi bắt buộc về mặt toán học khi bạn làm việc với không gian biểu diễn có số chiều d_k lớn. Giả sử các thành phần của q và k là các biến ngẫu nhiên độc lập có trung bình bằng 0 và phương sai bằng 1. Tích vô hướng q · k = Σ (q_i · k_i) sẽ giữ trung bình bằng 0 nhưng phương sai bị đẩy lên mức d_k. Nếu phương sai lớn, các giá trị của tích vô hướng Q · K^T sẽ rất xa gốc 0, đẩy hàm Softmax vào vùng giá trị bão hòa cực biên nơi gradient tiệm cận về 0 và gây ra hiện tượng triệt tiêu đạo hàm khi lan truyền ngược. Phép chia cho √d_k kéo phương sai trở lại mức 1, giữ cho gradient ổn định trong quá trình huấn luyện.
Để vận hành toán tử này hiệu quả trên các hệ thống tính toán thực tế, hai kỹ thuật xử lý dữ liệu luôn đi kèm:
- Masked Softmax: Khi bạn xử lý các chuỗi có độ dài biến thiên hoặc áp dụng causal mask trong bộ giải mã, các vị trí không hợp lệ hoặc phần đệm (padding) được gán điểm số âm cực lớn (như
-1e6hoặc-inf) trước khi đưa qua Softmax, khiến trọng số attention tại các vị trí này triệt tiêu hoàn toàn về 0. - Batch Matrix Multiplication (BMM): Giúp bạn tính toán đồng thời các lô dữ liệu song song chứa ma trận
QvàK, trả về kết quả kích thước lô mà không cần dùng vòng lặp thủ công.
Dưới đây là đoạn mã triển khai Scaled Dot-Product Attention hoàn chỉnh trong PyTorch xử lý an toàn các chiều tensor mask:
import math
import torch
import torch.nn as nn

def masked_softmax(X: torch.Tensor, valid_lens: torch.Tensor) -> torch.Tensor:
    """Thực hiện softmax có che chắn (masking) trên trục cuối cùng."""
    if valid_lens is None:
        return nn.functional.softmax(X, dim=-1)
    shape = X.shape
    if valid_lens.dim() == 1:
        valid_lens = torch.repeat_interleave(valid_lens, shape[1])
    else:
        valid_lens = valid_lens.reshape(-1)
    flat_X = X.reshape(-1, shape[-1])
    maxlen = flat_X.size(1)
    mask = torch.arange(maxlen, dtype=torch.float32, device=X.device)[None, :] < valid_lens[:, None]
    flat_X[~mask] = -1e6
    return nn.functional.softmax(flat_X.reshape(shape), dim=-1)

class DotProductAttention(nn.Module):
    """Scaled Dot-Product Attention engine với masked softmax."""
    def __init__(self, dropout: float):
        super().__init__()
        self.dropout = nn.Dropout(dropout)

    def forward(
        self,
        queries: torch.Tensor,
        keys: torch.Tensor,
        values: torch.Tensor,
        valid_lens: torch.Tensor = None
    ) -> torch.Tensor:
        d_k = queries.shape[-1]
        scores = torch.bmm(queries, keys.transpose(1, 2)) / math.sqrt(d_k)
        attention_weights = masked_softmax(scores, valid_lens)
        return torch.bmm(self.dropout(attention_weights), values)
Self-Attention và Cross-Attention: Khi mô hình tự nhìn lại chính mình
Cơ chế Self-Attention (tự chú ý) cho phép các vị trí khác nhau trong cùng một chuỗi tương tác với nhau để xây dựng biểu diễn ngữ cảnh hoàn chỉnh cho chính chuỗi đó. Thay vì chỉ liên kết các trạng thái từ hai chuỗi khác biệt, Self-Attention đặt Q, K, V bắt nguồn từ cùng một nguồn dữ liệu ban đầu. Ví dụ, trong câu "Con vật không qua đường vì nó quá mệt", Self-Attention gán trọng số liên kết lớn giữa từ "nó" và "Con vật", giúp mạng nắm bắt chính xác quan hệ đồng quy chiếu ngữ nghĩa (co-reference resolution).
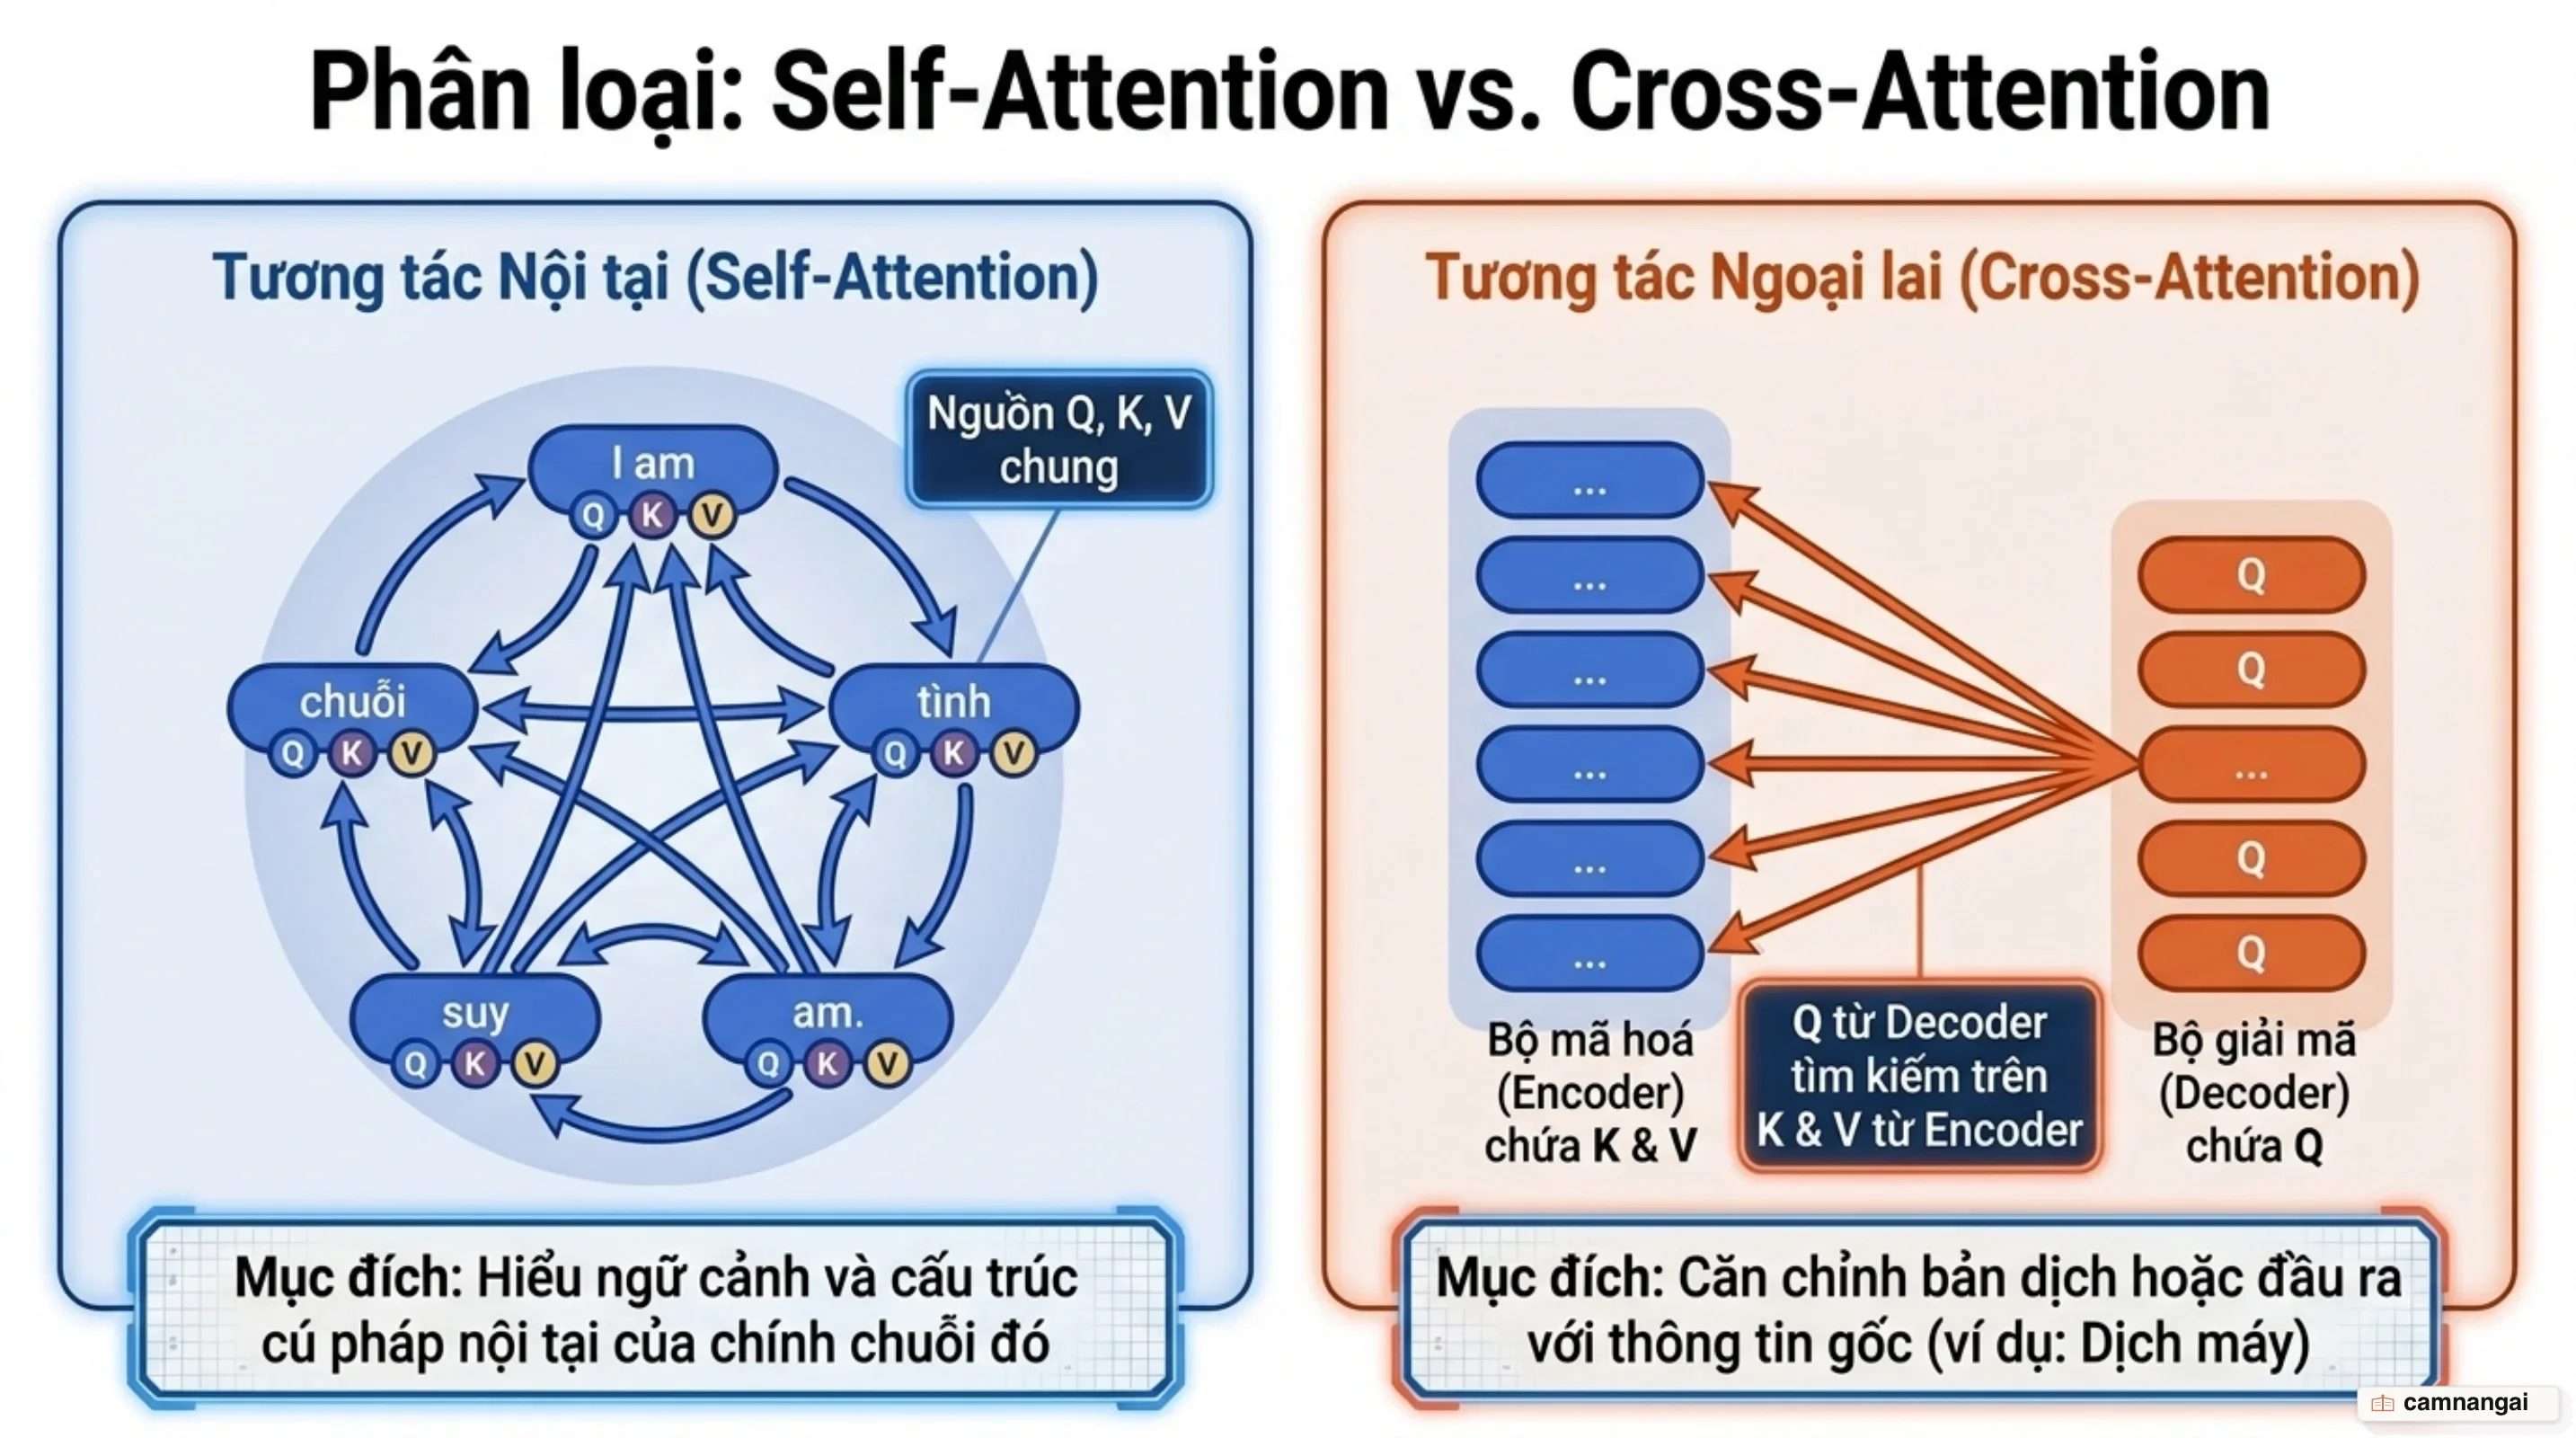
Trái ngược với Self-Attention, Cross-Attention (Encoder-Decoder Attention) lấy Q từ lớp giải mã (decoder) hiện tại, nhưng lấy K và V từ đầu ra cuối cùng của bộ mã hóa (encoder). Cơ chế này đóng vai trò như một cầu nối truy xuất dữ liệu, cho phép mỗi token đang được tạo ở decoder quan sát toàn bộ ngữ cảnh biểu diễn của chuỗi nguồn.
Đối với Self-Attention trong bộ giải mã, bạn phải áp dụng Causal Masking (Masking nhân quả) để chặn luồng thông tin chảy ngược từ các vị trí tương lai về quá khứ. Bằng cách gán điểm số -inf cho tất cả các vị trí tương lai trước hàm Softmax, mô hình đảm bảo việc dự đoán token ở vị trí hiện tại chỉ được phép phụ thuộc vào các token đã xuất hiện trước đó, bảo toàn tuyệt đối tính chất tự hồi quy (auto-regressive) khi bạn suy luận chuỗi.
Multi-Head Attention: Mở rộng không gian biểu diễn đa chiều
Việc chỉ sử dụng một đầu attention duy nhất (Single-Head Attention) tạo ra hạn chế về mặt biểu diễn: phép tính trung bình hóa các trọng số attention trên toàn bộ không gian khiến mô hình khó lòng tập trung đồng thời vào nhiều kiểu mối quan hệ khác nhau (như quan hệ cú pháp hay quan hệ tham chiếu ngữ nghĩa) giữa các vị trí.
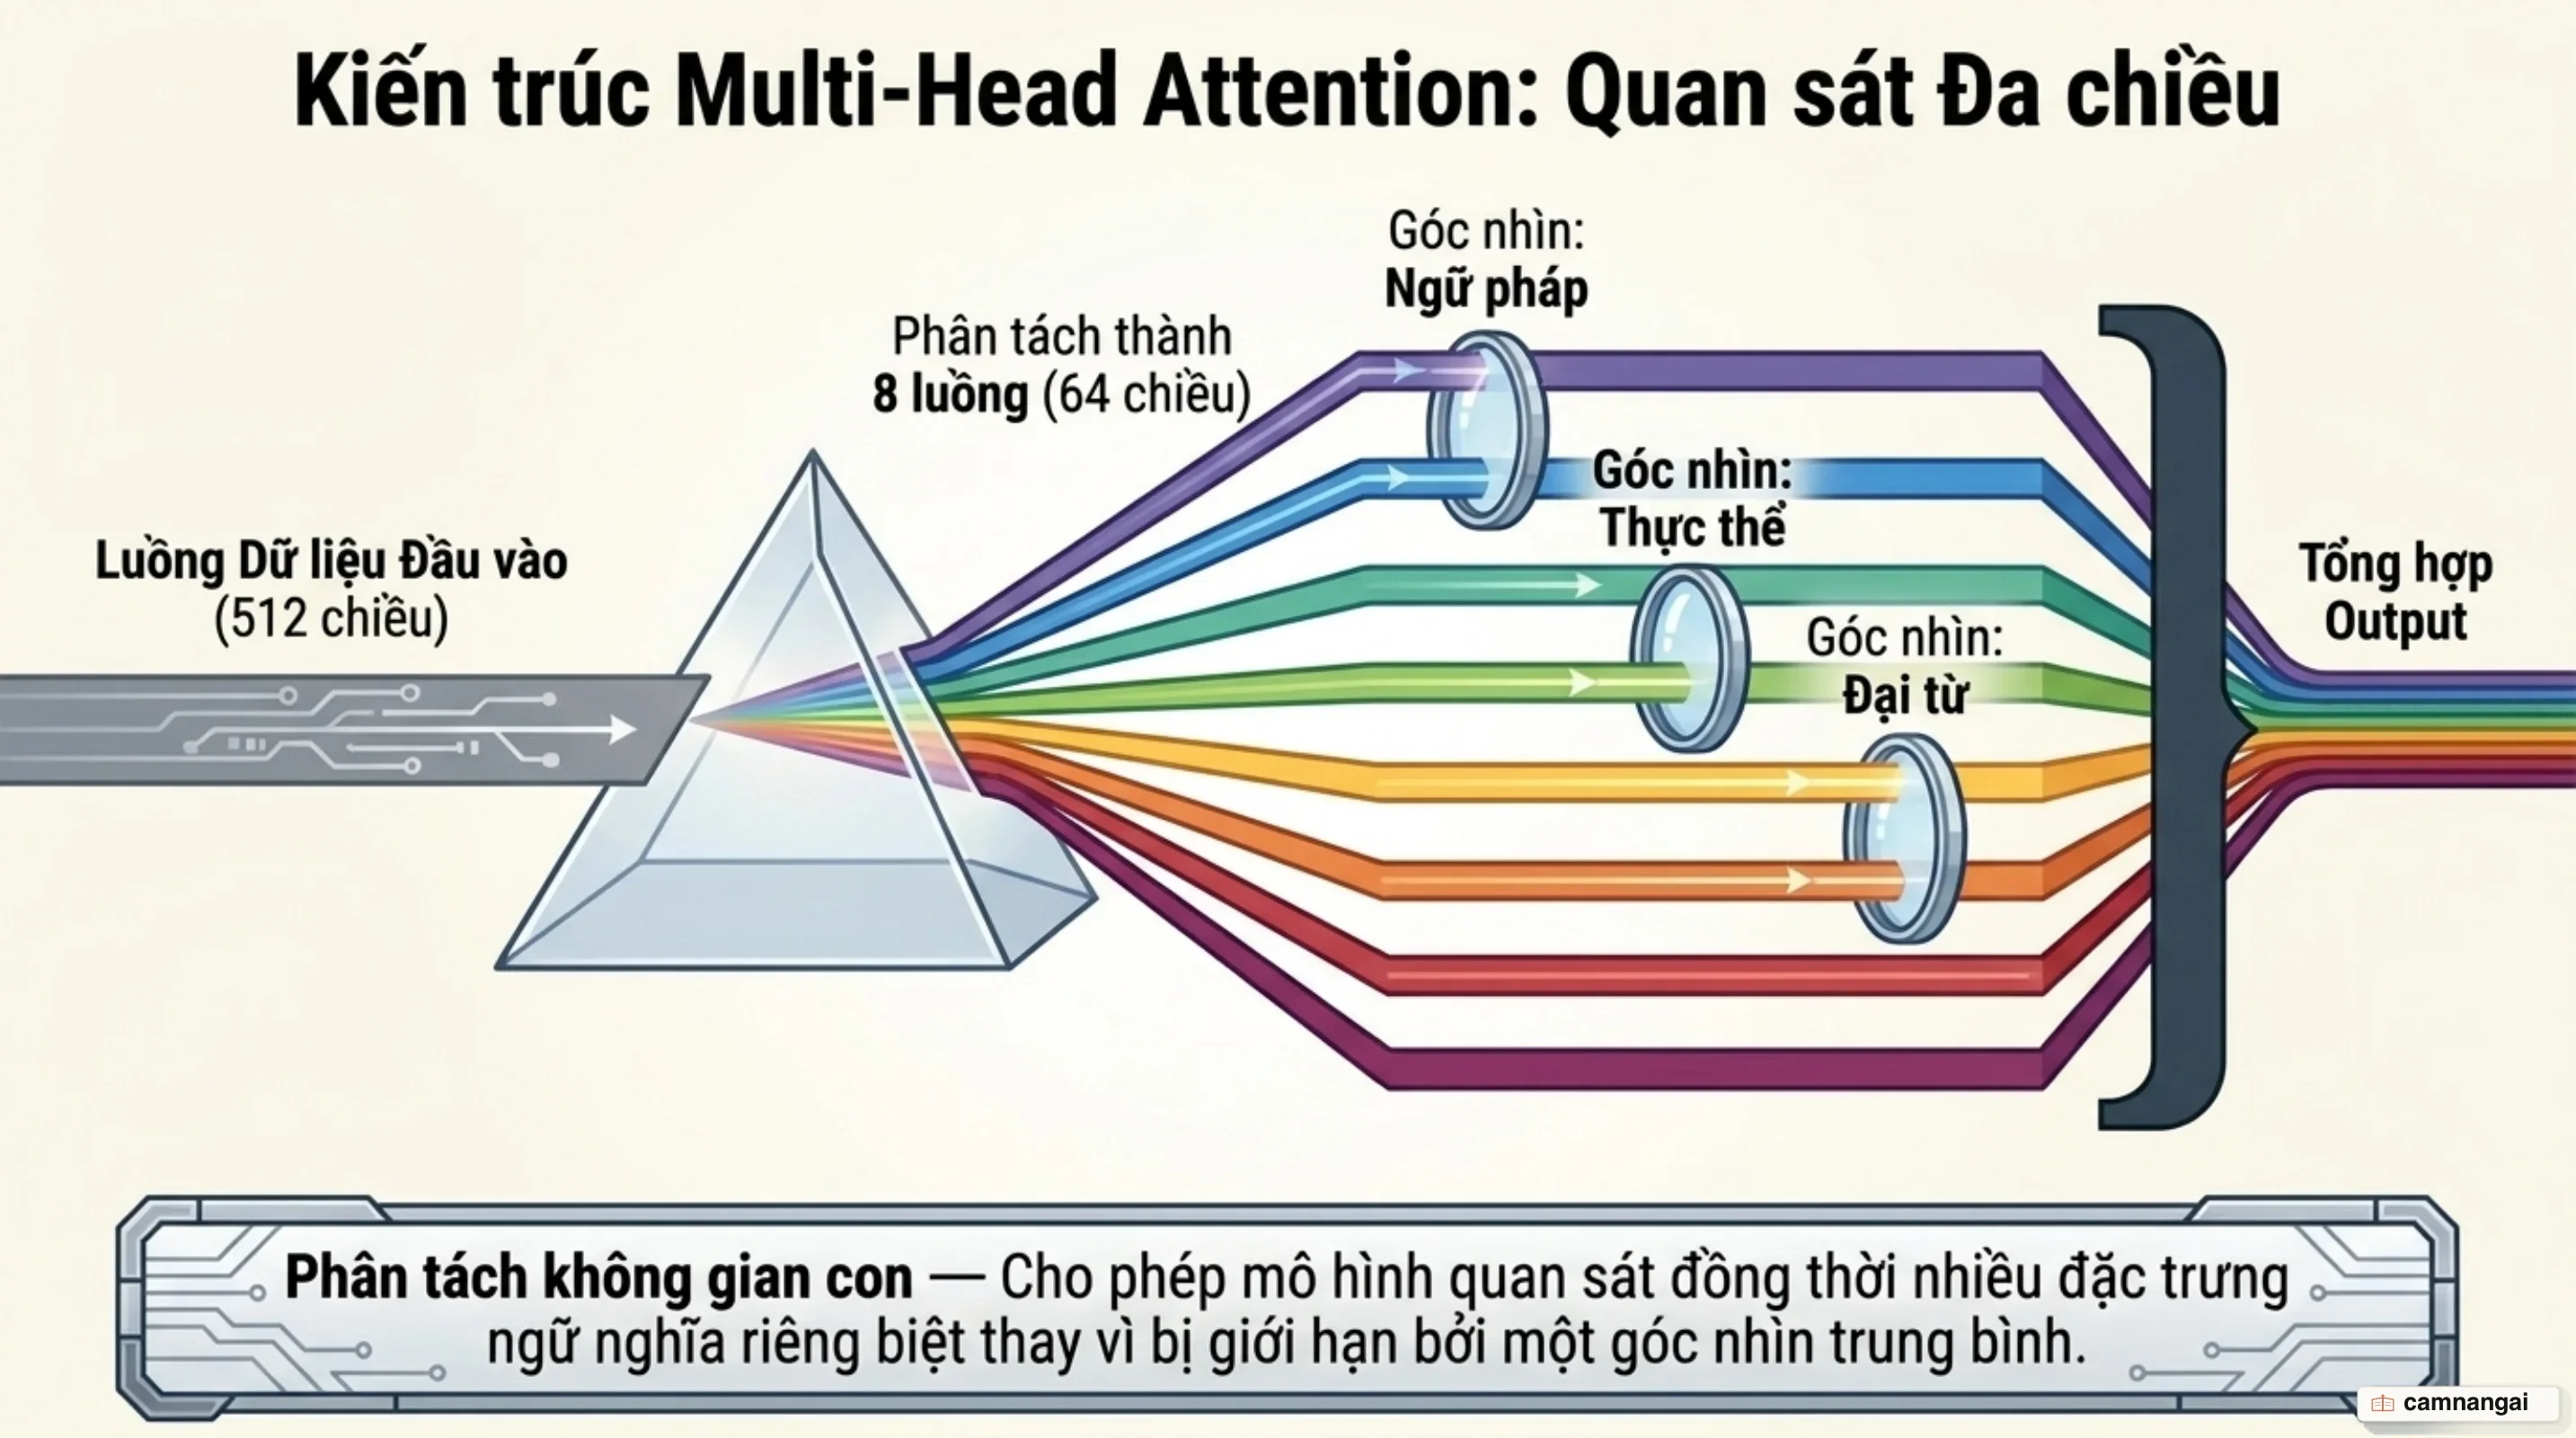
Để giải quyết hạn chế này, Multi-Head Attention (MHA) thực hiện chiếu các ma trận Q, K, V qua h phép biến đổi tuyến tính song song độc lập để đưa dữ liệu vào h không gian con (subspaces) có số chiều nhỏ hơn. Công thức toán học của Multi-Head Attention được viết như sau:
MultiHead(Q, K, V) = Concat(head_1, ..., head_h) · W^O
trong đó: head_i = Attention(Q · W_i^Q, K · W_i^K, V · W_i^V)
Kích thước của các ma trận trọng số chiếu được xác định chính xác theo tham số hệ thống:
W_i^Q: kích thước[d_model, d_k]W_i^K: kích thước[d_model, d_k]W_i^V: kích thước[d_model, d_v]W^O: kích thước[h · d_v, d_model]
Trong mô hình Transformer base, các thông số chuẩn được thiết lập ở mức h = 8 đầu attention, d_model = 512, và d_k = d_v = d_model / h = 64. Nhờ giảm số chiều ở mỗi đầu xuống 64, tổng chi phí tính toán FLOPs của Multi-Head Attention tương đương với chi phí của Single-Head Attention trên không gian đầy đủ d_model, nhưng mô hình của bạn thu được khả năng trích xuất thông tin phong phú hơn nhiều lần trên các không gian con riêng biệt.
Thách thức tính toán O(N²) và bước ngoặt FlashAttention
Mặc dù giải quyết triệt để điểm nghẽn tuần tự của RNN, cơ chế Self-Attention tiêu chuẩn vấp phải rào cản vật lý lớn khi bạn mở rộng chiều dài chuỗi: độ phức tạp bộ nhớ và tính toán tăng theo bình phương độ dài chuỗi O(N²). Khi độ dài chuỗi N tăng lên, hệ thống bắt buộc phải khởi tạo và lưu trữ ma trận điểm S = Q · K^T kích thước N x N cùng ma trận xác suất P = softmax(S / √d_k) trên bộ nhớ High Bandwidth Memory (HBM) của GPU.
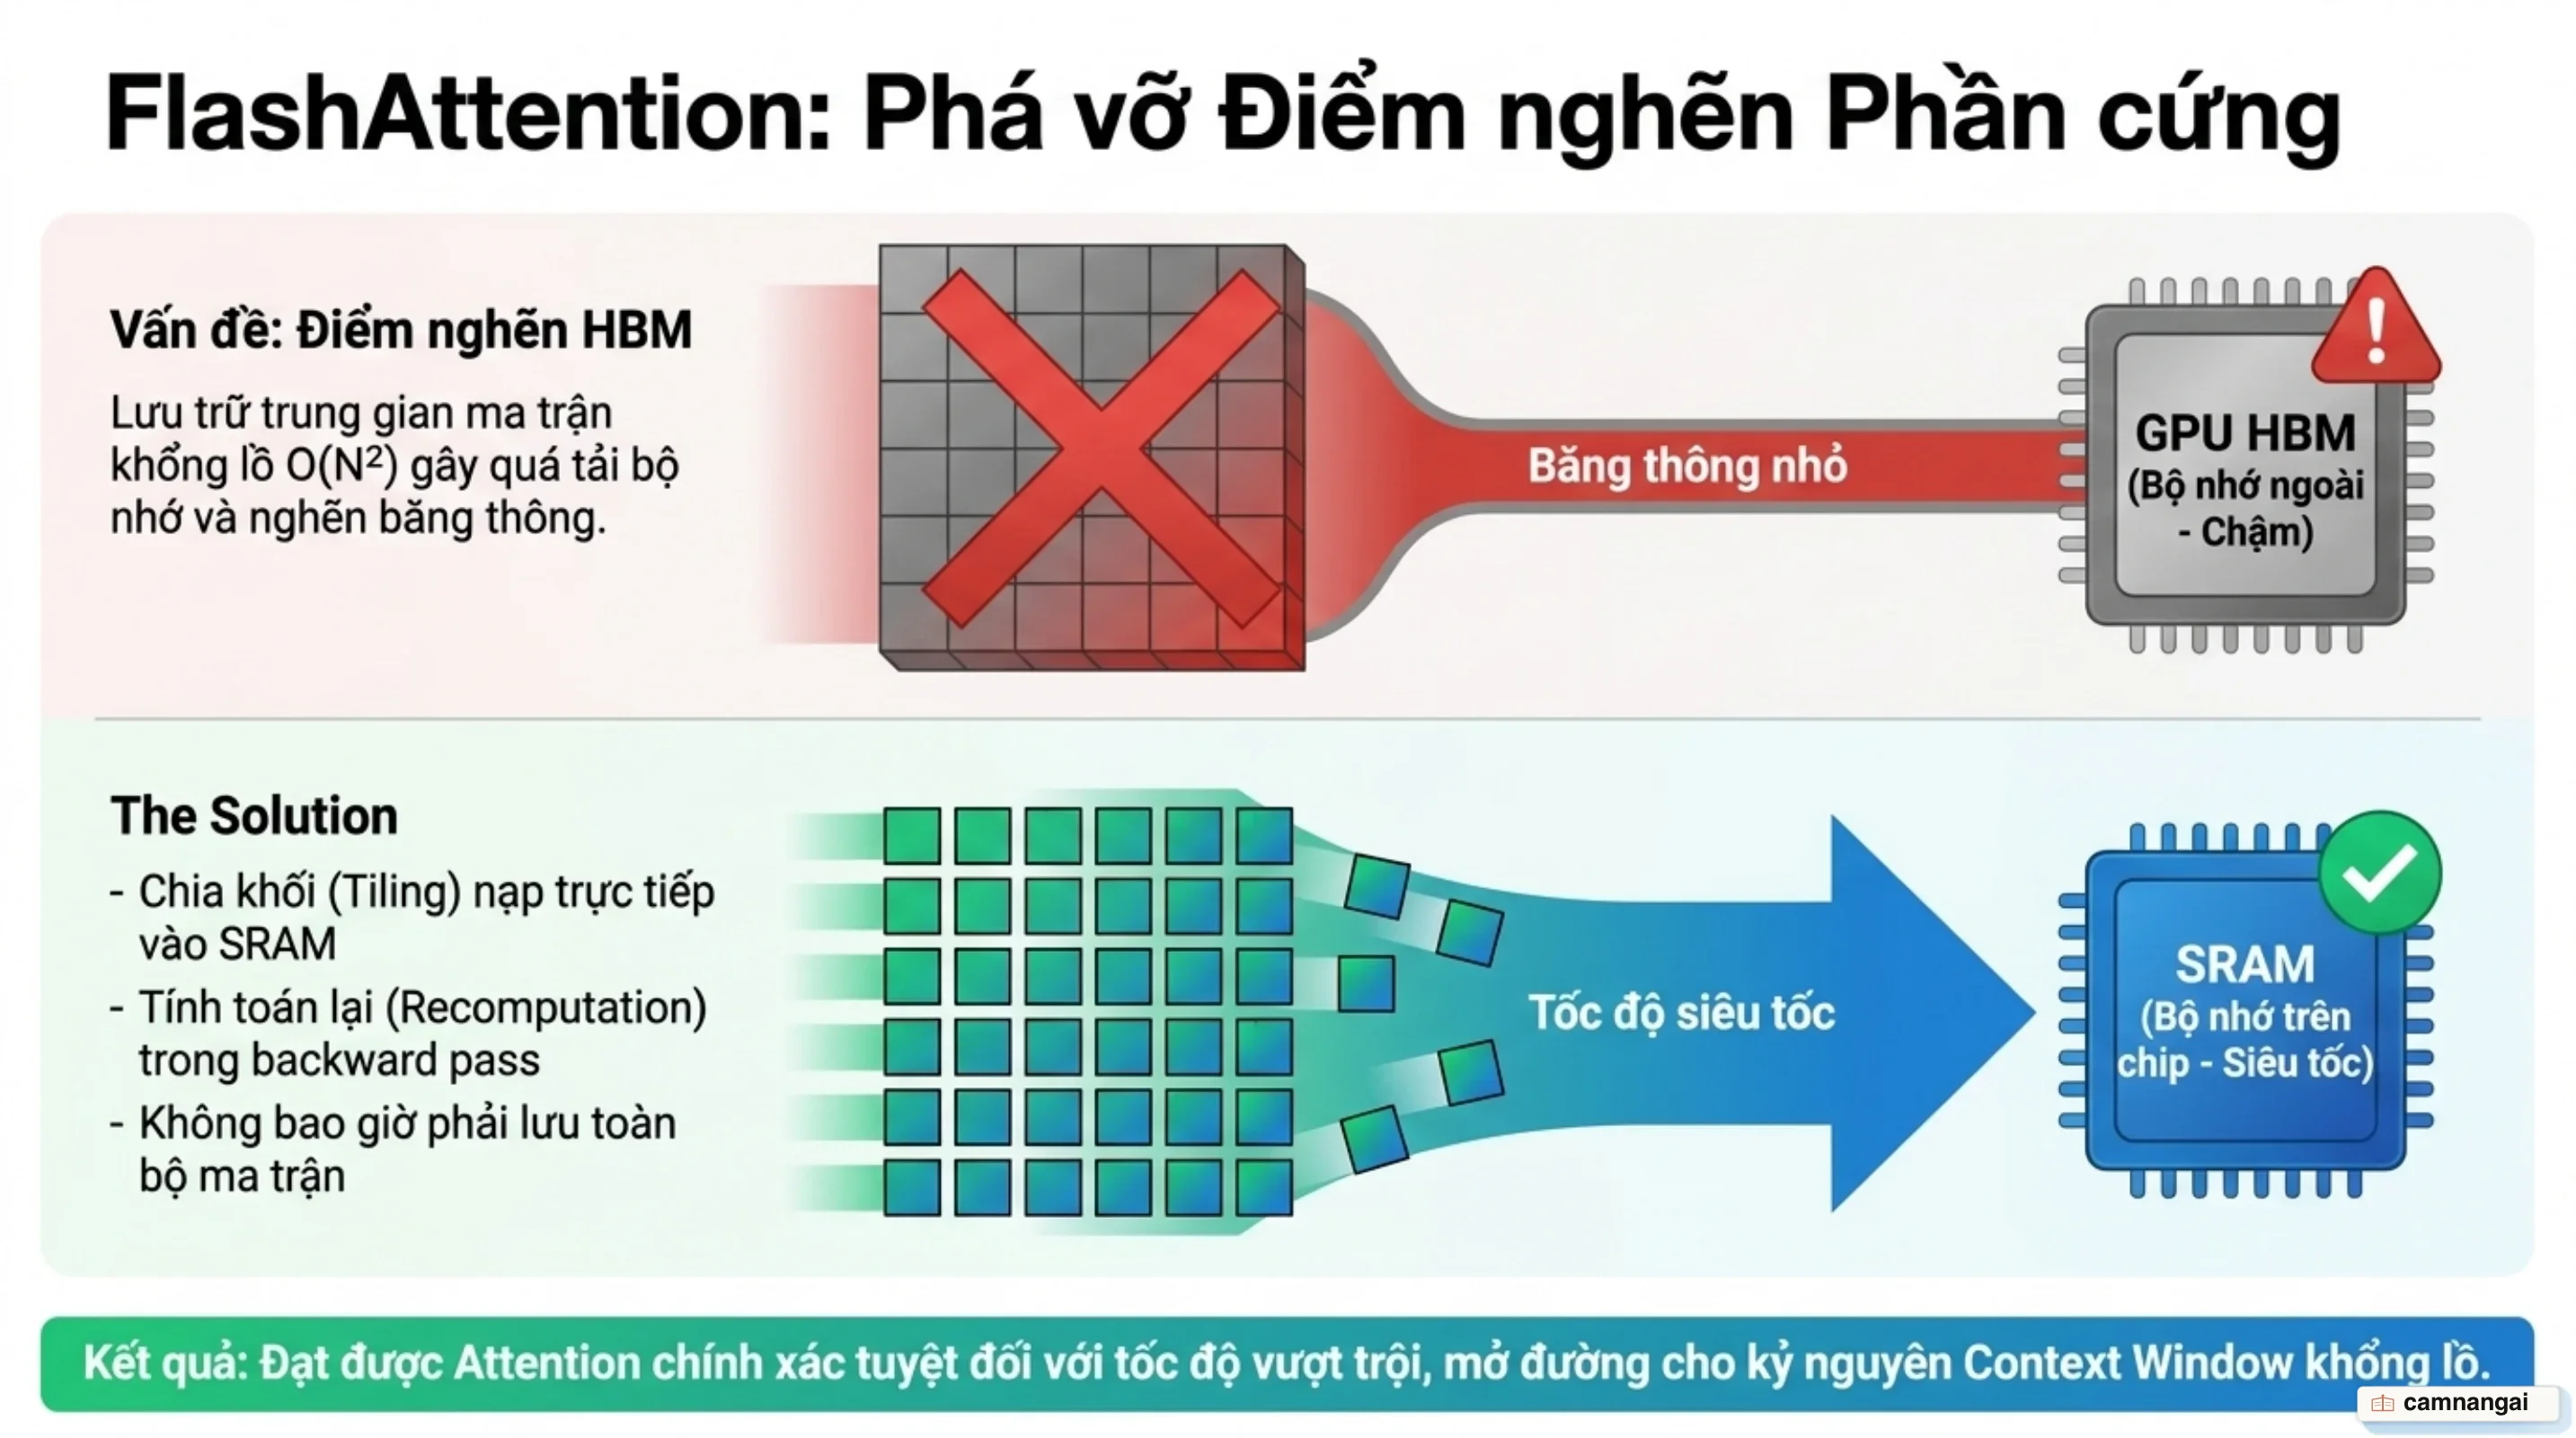
Phân tích hiệu năng ở cấp độ phần cứng cho thấy toán tử attention tiêu chuẩn bị giới hạn bởi băng thông bộ nhớ (memory-bandwidth bound) chứ không phải do thiếu hụt năng lực tính toán FLOPs. Việc liên tục đọc và ghi các ma trận trung gian kích thước N x N giữa HBM (tốc độ truy xuất chậm) và bộ nhớ SRAM tích hợp trong chip (dung lượng nhỏ 100 KB–192 KB mỗi Streaming Multiprocessor nhưng tốc độ cực cao) gây ra độ trễ truy xuất dữ liệu rất lớn.
Để giải quyết điểm nghẽn phần cứng này, Tri Dao và cộng sự đề xuất FlashAttention—một thuật toán attention chính xác (exact attention) nhận biết I/O phần cứng. Kỹ thuật cốt lõi của FlashAttention dựa trên hai cơ chế:
- Tiling (Phân khối): Chia ma trận
Q,K,Vthành các khối nhỏ vừa vặn với dung lượng SRAM. Bằng việc áp dụng kỹ thuật online softmax để theo dõi và cập nhật liên tục các giá trị chuẩn hóa trực tiếp trong SRAM, FlashAttention tính toán kết quả theo từng khối mà không bao giờ thực thể hóa (materialize) ma trậnN x Nđầy đủ ra HBM. - Recomputation (Tính toán lại): Trong lượt lan truyền ngược, thay vì đọc ma trận attention khổng lồ đã lưu ở HBM, FlashAttention chỉ lưu lại các hệ số chuẩn hóa cực nhỏ và tự tính toán lại các khối attention trung gian ngay trong SRAM.
Nhờ triệt tiêu các thao tác I/O thừa với bộ nhớ HBM, FlashAttention giảm độ phức tạp bộ nhớ phụ thuộc vào chiều dài chuỗi từ O(N²) xuống O(N). Kỹ thuật này mang lại tốc độ huấn luyện nhanh hơn từ 2 đến 4 lần trên thực tế mà không làm thay đổi hay xấp xỉ bất kỳ kết quả toán học nào của toán tử attention gốc, tạo tiền đề kỹ thuật quan trọng giúp bạn mở rộng cửa sổ ngữ cảnh cho các hệ thống LLM hiện đại.
Đánh giá: Cơ chế Attention thay đổi tư duy kiến trúc mô hình ra sao
Nhìn từ góc độ kỹ nghệ hệ thống, cơ chế attention đã tạo ra bước dịch chuyển căn bản: thay thế các mô hình chuyển trạng thái tuần tự (sequential state transition) bằng kết nối toàn cục động (dynamic global connectivity). Sự thay đổi này chuyển dịch trọng tâm thiết kế mạng thần kinh từ việc xử lý các chuỗi phụ thuộc theo thời gian sang thực hiện các phép toán đại số tuyến tính song song hóa trên tensor. Việc rút ngắn chiều dài đường truyền tín hiệu xuống O(1) cho phép bạn khai thác trọn vẹn sức mạnh tính toán song song của các cụm phần cứng GPU/TPU hiện đại.
Tuy nhiên, đánh đổi kỹ thuật đi kèm nằm ở chi phí bộ nhớ O(N²) của toán tử attention nguyên bản, buộc kỹ sư hệ thống phải kết hợp chặt chẽ giữa toán học lý thuyết và tối ưu hóa phần cứng (như giải pháp FlashAttention) khi mở rộng không gian ngữ cảnh. Cân bằng giữa khả năng biểu diễn ngữ cảnh toàn cục và hiệu năng truy xuất bộ nhớ phần cứng chính là yếu tố then chốt quyết định sự thành công khi bạn thiết kế và triển khai các kiến trúc mô hình ngôn ngữ lớn hiện nay.
Tài liệu tham khảo
- Visualizing A Neural Machine Translation Model (Mechanics of Seq2seq Models With Attention) — Jay Alammar
- The Illustrated Transformer — Jay Alammar
- Attention? Attention! | Lil'Log
- The Annotated Transformer — Harvard NLP
- 11.3. Attention Scoring Functions — Dive into Deep Learning
- Attention Is All You Need — Vaswani et al.
- Neural Machine Translation by Jointly Learning to Align and Translate — Bahdanau et al.
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness — Tri Dao et al.