Tokenmaxxing là hành vi cố tình tiêu thụ tối đa lượng token AI khi tương tác với các mô hình ngôn ngữ lớn (LLM)
— thông qua việc viết câu lệnh (prompt) dài, vận hành nhiều tác tử AI (agent) song song hoặc lặp ngữ cảnh liên tục — rồi xem tổng lượng token tiêu tốn như một chỉ số đo lường hiệu suất công việc và độ linh hoạt công nghệ của kỹ sư.
Xuất phát từ Thung lũng Silicon, trào lưu này biến việc tiêu tốn tài nguyên tính toán thành một trò chơi địa vị trong nội bộ các tập đoàn công nghệ. Nhiều kỹ sư và nhà quản lý lầm tưởng rằng việc đốt càng nhiều ngân sách giao diện lập trình ứng dụng (API) đồng nghĩa với việc doanh nghiệp đang ứng dụng AI càng sâu rộng.
Tuy nhiên, nhìn từ góc độ kiến trúc hệ thống, việc cố tình tăng lượng token tiêu thụ không phản ánh giá trị đầu ra thực tế. Đây là hành vi thao túng chỉ số năng suất, gây lãng phí ngân sách nghiêm trọng và trực tiếp suy giảm chất lượng mã nguồn.
Tokenmaxxing là gì và bắt nguồn từ đâu?
Thuật ngữ tokenmaxxing xuất hiện từ đầu năm 2026 tại Thung lũng Silicon, vay mượn hậu tố "-maxxing" từ văn hóa internet (vốn chỉ hành vi đẩy một chỉ số cá nhân lên mức tối đa) để áp dụng vào việc tiêu thụ tài nguyên AI. Ban đầu, trào lưu này bùng nổ từ các tuyên bố đẩy mạnh áp dụng AI của các lãnh đạo công nghệ hàng đầu. Jensen Huang, CEO của NVIDIA, gây tranh cãi khi đề xuất cấp cho mỗi kỹ sư có mức lương 500.000 USD một ngân sách token bằng một nửa tiền lương của họ (250.000 USD) và tuyên bố sẽ "rất báo động" nếu họ không tiêu hết. Nhà nghiên cứu Andrej Karpathy thừa nhận cảm thấy "lo lắng" mỗi khi dung lượng đăng ký AI hàng tháng còn thừa vì chưa tối ưu hóa hết công suất token.
Bên cạnh đó, các nhà lãnh đạo như Garry Tan (CEO Y Combinator) chia sẻ việc tạo ra 10.000 dòng lệnh mỗi ngày nhờ AI, Tobi Lütke (CEO Shopify) đặt ra yêu cầu mặc định phải dùng AI trước khi xin thêm nhân sự, cùng với những luận điểm ủng hộ quy mô từ Sam Altman (OpenAI - khẳng định chi phí AI giảm 10 lần mỗi 12 tháng) và Dario Amodei (Anthropic - tuyên bố "không có hồi kết cho cầu vồng" khi mở rộng quy mô tính toán). Các tuyên bố này đã biến việc tiêu thụ token từ một khoản chi phí hạ tầng thuần túy thành thước đo mức độ cam kết với AI của nhân viên.
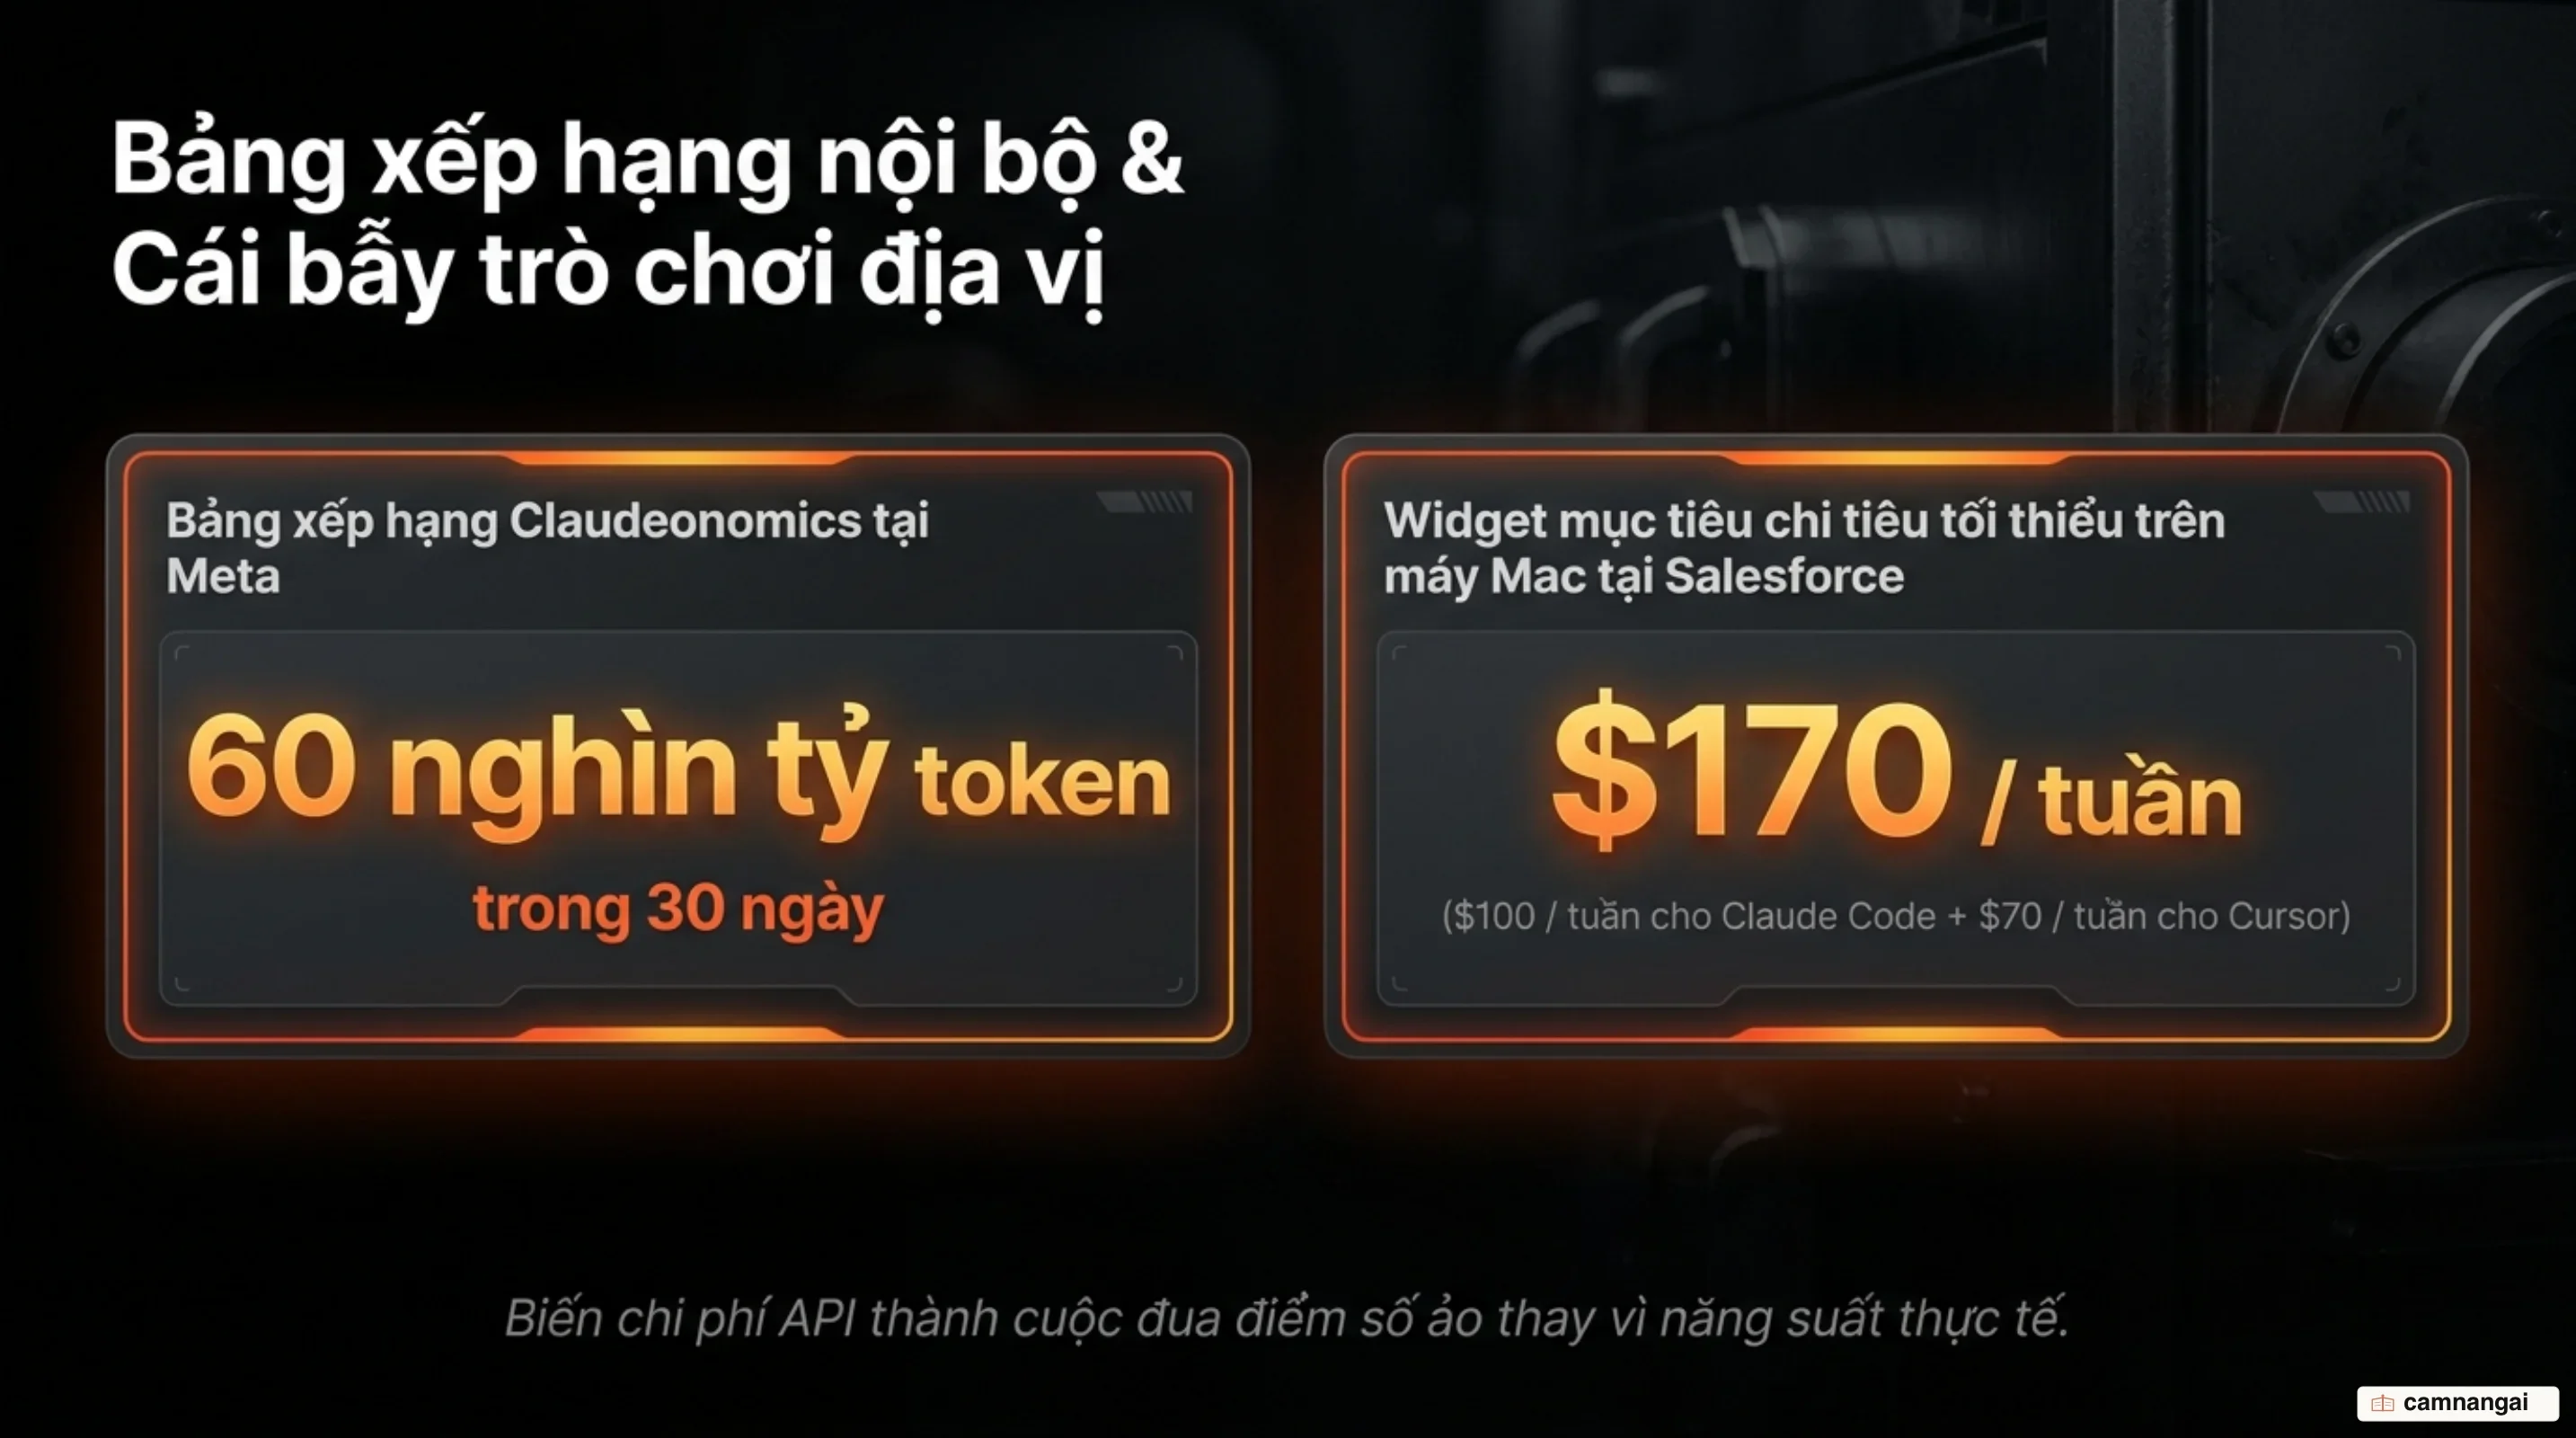
Sự biến tướng thể hiện rõ nhất qua các bảng xếp hạng (leaderboard) tiêu thụ token nội bộ. Tại Meta, một kỹ sư đã dựng bảng xếp hạng mang tên "Claudeonomics" trên mạng nội bộ để theo dõi hơn 85.000 nhân viên. Chỉ trong 30 ngày, nhân viên Meta đã tiêu tốn tới 60,2 nghìn tỷ token (tương đương hơn 100 triệu USD theo giá API công khai), trong đó người đứng đầu bảng xếp hạng tiêu tốn tới 281 tỷ token. Đáng chú ý, các kỹ sư kỳ cựu tại Meta tiết lộ một động cơ ngầm: ban lãnh đạo có thể đã cố tình khuyến khích việc đốt token để thu thập khối lượng lớn dữ liệu tương tác thực tế (traces), dùng làm dữ liệu huấn luyện cho các mô hình lập trình thế hệ mới của công ty.
Tại Microsoft, bảng xếp hạng ghi nhận các Phó Chủ tịch (VP) và kỹ sư cấp cao liên tục lọt top đầu tiêu thụ dù họ ít khi trực tiếp viết mã. Điều này tạo áp lực khiến các kỹ sư cấp dưới buộc phải "tokenmaxx" bằng cách hỏi AI những thông tin đã có sẵn trong tài liệu hoặc chạy thử các dự án bỏ đi để tránh bị đánh giá thiếu tích cực. Tại Salesforce, công ty cài đặt một tiện ích (widget) trên máy Mac hiển thị mục tiêu chi tiêu tối thiểu hàng tuần ($100/tuần cho Claude Code và $70/tuần cho Cursor) đồng thời công khai mức chi của đồng nghiệp, ép kỹ sư phải duy trì lượng tiêu thụ trên mức trung bình.
Vì sao tiêu thụ nhiều token lại trở thành "thước đo năng suất"?
Sự xuất hiện của trào lưu này đến từ tính chất dễ đo lường của token. Trong hệ sinh thái AI thương mại, token đầu vào (input token) và token đầu ra (output token) là đơn vị đo lường duy nhất được các nhà cung cấp định giá và đo đếm chính xác theo thời gian thực. Khác với các khái niệm mơ hồ như "giá trị kinh doanh" hay "chất lượng kiến trúc", số lượng token là một con số hiển thị tức thì trên bảng điều khiển quản trị.
Tâm lý quản lý và áp lực từ cấp trên đã thúc đẩy sự lệch chuẩn này. Ban lãnh đạo doanh nghiệp, dưới áp lực phải chứng minh công ty đang "tiên phong AI" (AI-forward) với cổ đông và nhà đầu tư, đã tìm kiếm một chỉ số tức thì để báo cáo. Mức độ tiêu thụ token trở thành câu trả lời nhanh nhất cho câu hỏi "doanh nghiệp đã triển khai AI đến đâu". Khi các nhà quản trị thiếu công cụ đánh giá kết quả thực tế, họ mặc định rằng chi phí API càng cao thì đội ngũ kỹ thuật làm việc càng hiệu quả.
Đây là sự nhầm lẫn giữa Hoạt động (Input) và Kết quả (Outcome). Việc dùng lượng token để đo năng suất kỹ sư hoàn toàn tương tự như sai lầm đo độ hiệu quả của lập trình viên bằng số lượng dòng lệnh (lines of code) trong quá khứ. Cả hai chỉ số này đều đo lường khối lượng tài nguyên tiêu tốn hoặc dung lượng văn bản sinh ra, chứ không phản ánh được liệu mã nguồn đó có giải quyết đúng bài toán kinh doanh, có tối ưu về mặt kiến trúc hay có vận hành ổn định trên môi trường thực tế (production) hay không.
Hậu quả: Khi định luật Goodhart làm biến dạng quy trình kỹ thuật
Khi một chỉ số tiêu thụ tài nguyên trở thành mục tiêu đánh giá, định luật Goodhart ngay lập tức phát huy tác dụng: các kỹ sư bắt đầu thao túng chỉ số (gaming metrics). Để leo top bảng xếp hạng hoặc đạt hạn ngạch tối thiểu, lập trình viên cố tình nạp ngữ cảnh không qua bộ lọc (unfiltered context loading) bằng cách đẩy toàn bộ kho mã nguồn (repository) vào agent; hỏi AI những câu đã có sẵn trong tài liệu nội bộ; thả cho các agent chạy vòng lặp vô tận (agent loops); hoặc tự tạo ra các dự án rác để tăng lượng tiêu thụ.
[Nạp ngữ cảnh không qua bộ lọc / Full Repo]
 │
 ▼
[Chạy Agent song song & Vòng lặp rác] ──► [Tiêu tốn Token cao] ──► [Báo cáo giả tạo "Năng suất AI"]
 │
 ▼
[Sinh mã nguồn ồ ạt không qua kiểm duyệt]
 │
 ▼
[Bugs +54% | Code Churn +861% | Review Time x5] ──► [Sự cố Hạ tầng, Rò rỉ Dữ liệu & Nợ kỹ thuật]
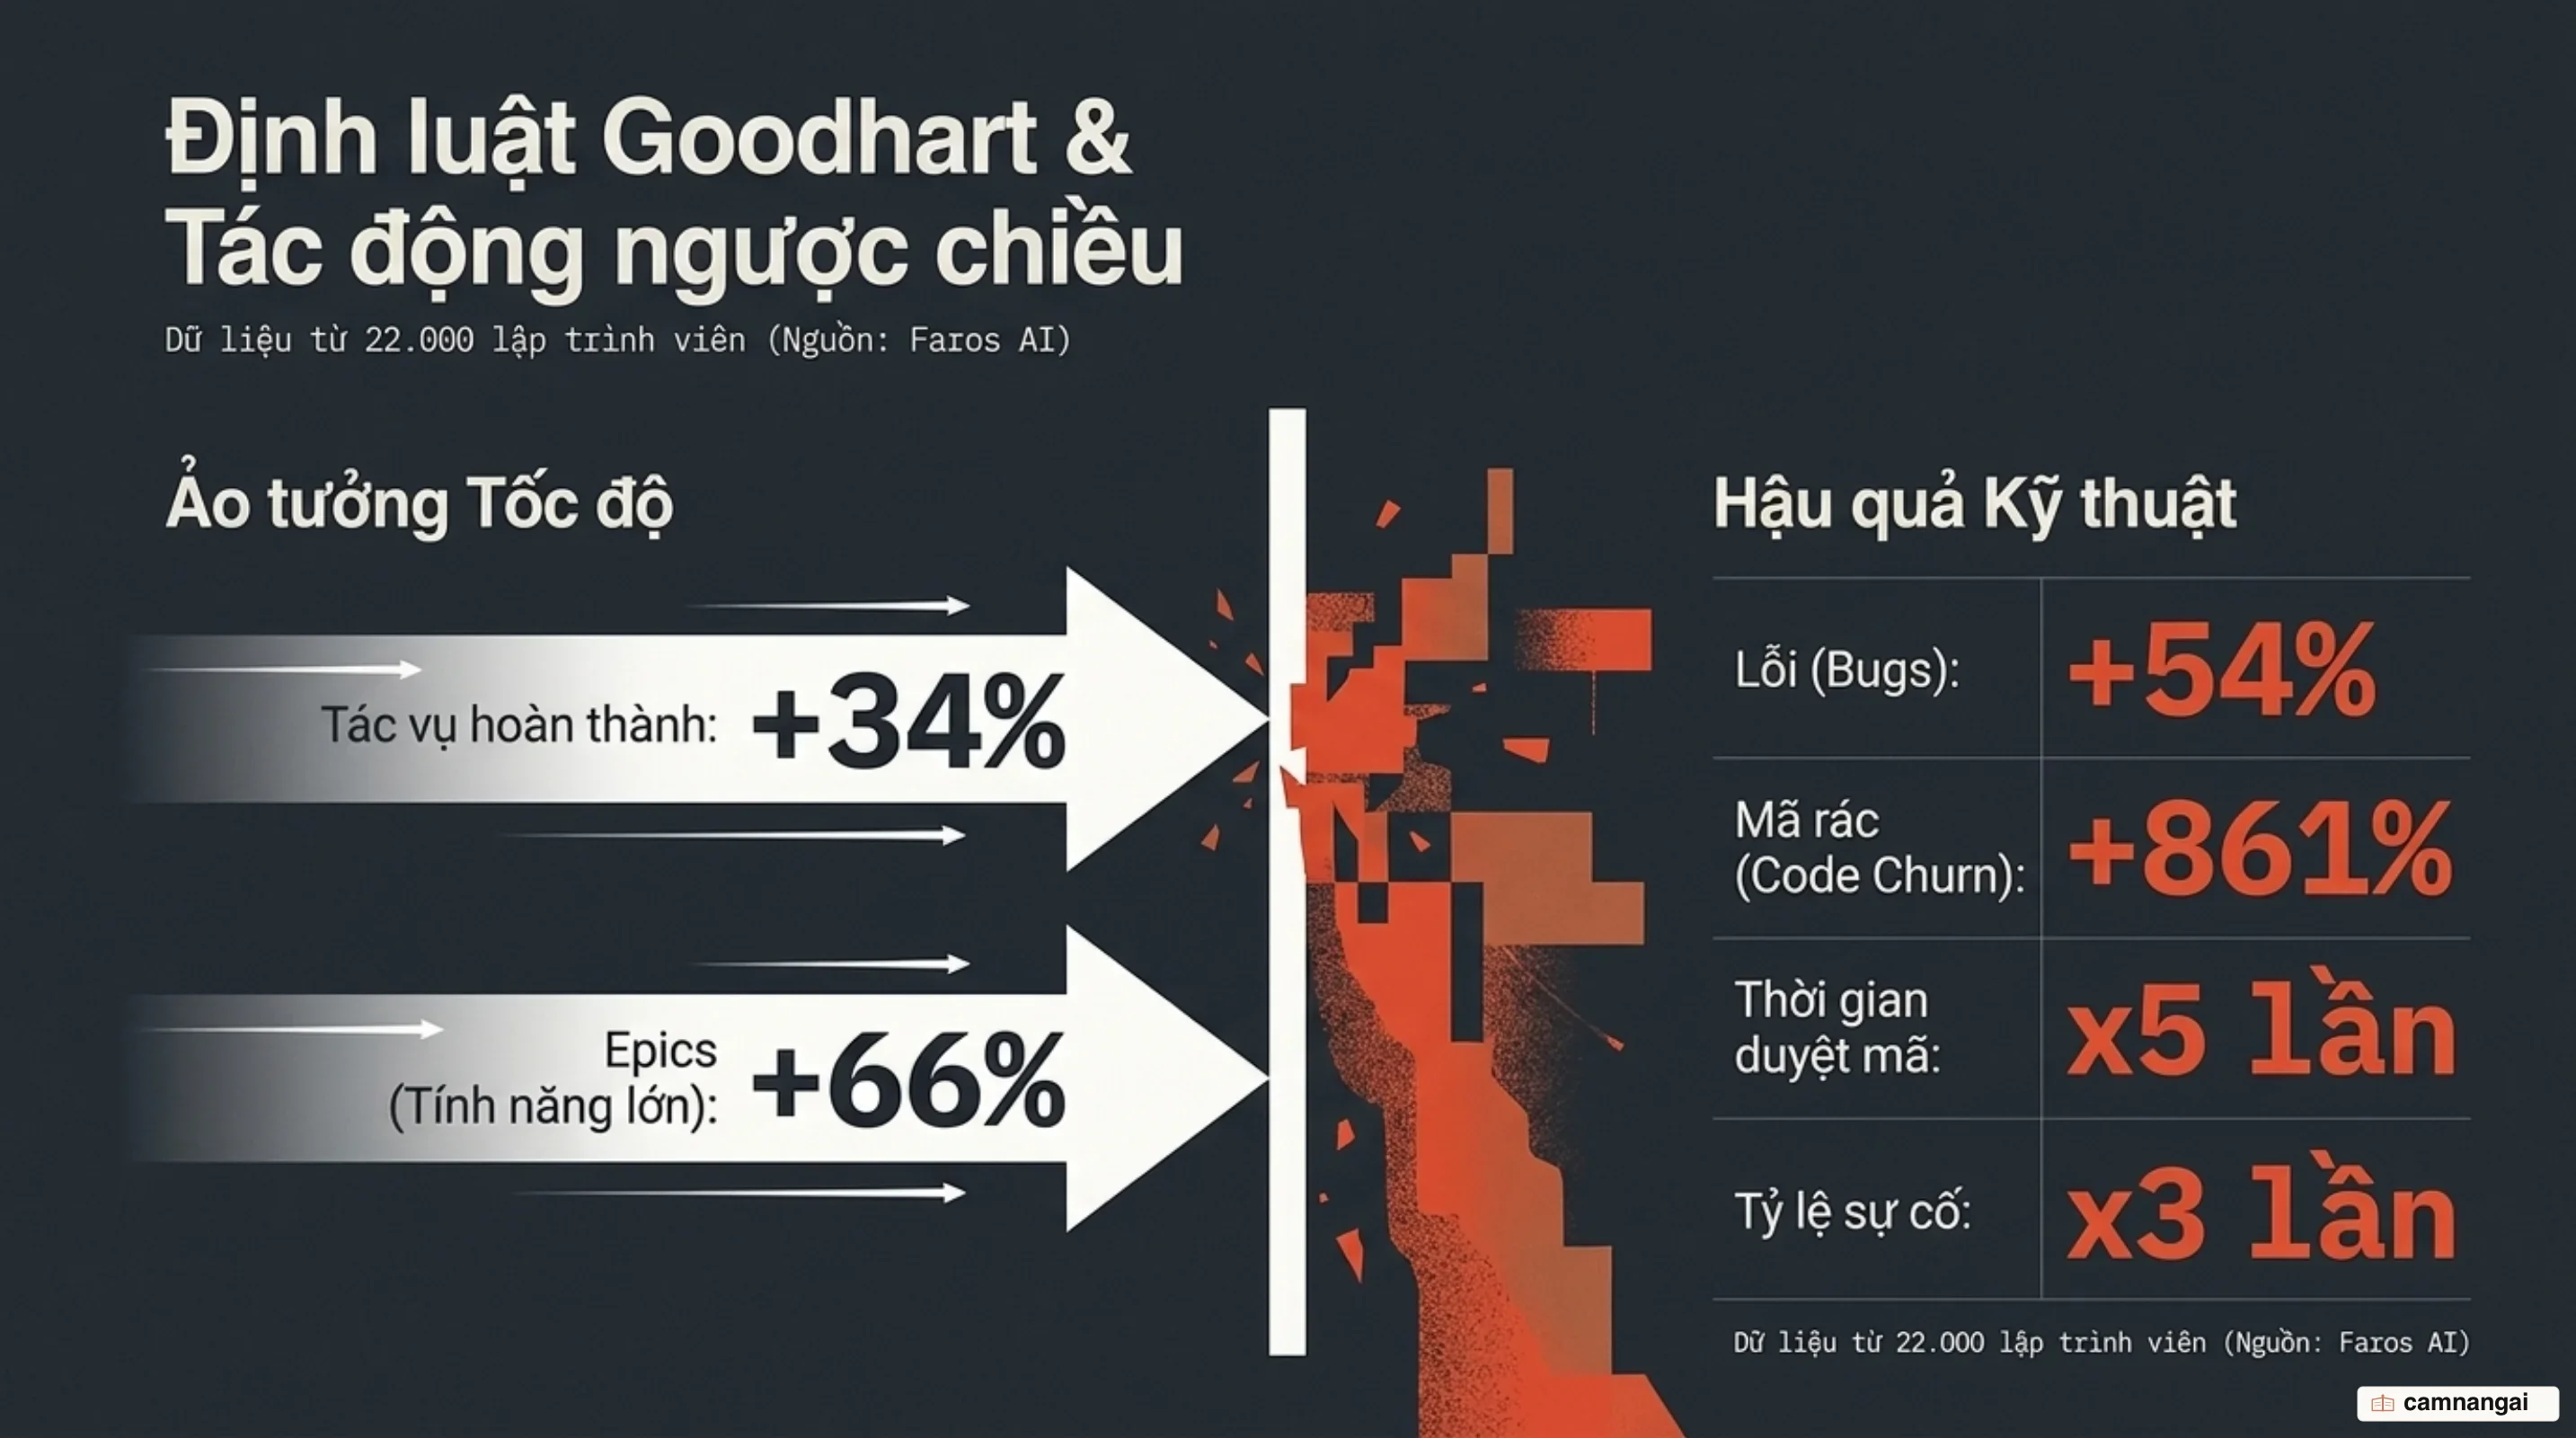
Dữ liệu thực tế chứng minh sự lệch lạc này. Nghiên cứu của Faros AI trên 22.000 lập trình viên thuộc 4.000 đội ngũ kỹ thuật chỉ ra rằng: dù tốc độ hoàn thành tác vụ tăng 34% và số lượng tác vụ lớn (epic) hoàn thành tăng 66%, các chỉ số chất lượng lại suy giảm nghiêm trọng. Tỷ lệ lỗi (bugs) trên mỗi lập trình viên tăng 54%, tỷ lệ sự cố trên mỗi Yêu cầu hợp nhất mã (PR - Pull Request) tăng hơn 3 lần, thời gian duyệt mã (review time) kéo dài gấp 5 lần, và tỷ lệ xáo trộn mã nguồn (code churn - tỷ lệ dòng mã bị xóa hoặc sửa lại sau khi viết) tăng vọt 861%. Đáng lo ngại hơn, tỷ lệ PR được hợp nhất mà không qua bất kỳ sự kiểm duyệt nào của con người tăng thêm 31% so với mức cơ sở.
Tình trạng này dẫn đến trạng thái quá tải khả năng hấp thụ của hệ thống (system absorption bottleneck). Mã nguồn do AI sinh ra quá nhanh khiến hạ tầng kỹ thuật không kịp tiêu hóa, tạo ra lượng nợ kỹ thuật (technical debt) khổng lồ.
Bên cạnh gánh nặng kỹ thuật, việc nhồi nhét ngữ cảnh vô tội vạ còn kéo theo rủi ro an ninh nghiêm trọng:
- Rò rỉ dữ liệu (Data Leakage): Việc nạp toàn bộ mã nguồn hoặc dữ liệu RAG chưa qua sàng lọc vào mô hình thương mại khiến thông tin định danh cá nhân (PII), dữ liệu nhạy cảm và chìa khóa xác thực (credentials) bị đẩy ra khỏi ranh giới bảo vệ của doanh nghiệp.
- Lỗ hổng kiểm toán (Audit Gaps): Thiếu cơ chế ghi nhật ký (logging) đối với câu lệnh và kết quả trả về từ agent khiến doanh nghiệp không thể truy xuất nguồn gốc mã nguồn khi xảy ra sự cố.
- Rủi ro tuân thủ pháp lý (Compliance Exposure): Việc nhiều agent dùng chung một token khởi tạo mã (master token) làm mất tính định danh cá nhân, vi phạm trực tiếp các quy định kiểm toán của Đạo luật AI Châu Âu (EU AI Act) và quyền chủ quyền dữ liệu theo GDPR.
Cơn ác mộng ngân sách và làn sóng phản đối từ các doanh nghiệp
Hậu quả tài chính của tokenmaxxing xuất hiện rất nhanh. Uber là ví dụ điển hình khi đốt sạch ngân sách AI dành cho năm 2026 (trích từ tổng ngân sách R&D trị giá 3,4 tỷ USD) chỉ trong vòng 4 tháng, phần lớn do việc sử dụng không kiểm soát công cụ Claude Code. Chi phí bùng nổ do token đầu ra của các mô hình cao cấp đắt gấp 2 đến 4 lần token đầu vào, khiến việc thả cho agent tự do sinh mã kéo theo hóa đơn tăng theo cấp số nhân.
Trước tình trạng lãng phí và nguy cơ mất an toàn, các tập đoàn buộc phải can thiệp. Meta đóng cửa bảng xếp hạng "Claudeonomics" sau khi bị truyền thông phanh phui việc nhân viên treo agent chạy không tải để lấy điểm. Tháng 5/2026, Amazon xóa bỏ bảng xếp hạng tiêu thụ token của lập trình viên kèm thông điệp: tuyệt đối không sử dụng AI chỉ để phô diễn con số.
Giới lãnh đạo công nghệ đã lên tiếng chỉnh đốn. Yamini Rangan, CEO của HubSpot, khẳng định: "Outcome maxxing >> token maxxing" (Tối ưu kết quả quan trọng hơn nhiều tối ưu token). Andrew Macdonald, Giám đốc Vận hành (COO) của Uber, thừa nhận trên truyền thông rằng mức chi tiêu token khổng lồ chưa tạo ra mối liên hệ rõ ràng với các sản phẩm mà khách hàng thực sự cần. Áp lực tài chính càng tăng khi GitHub Copilot chuyển sang mô hình tính phí theo lượng token tiêu thụ, biến mọi hành vi lãng phí thành gánh nặng ngân sách trực tiếp.
Trái ngược với thất bại của Meta, Shopify là điểm sáng về quản trị AI hiệu quả ngay từ sớm. Shopify chuyển đổi bảng xếp hạng thành "bảng điều khiển sử dụng" (usage dashboard) nhằm quan sát hành vi thay vì tạo cuộc đua. Họ chủ động kiểm tra các tài khoản tiêu tốn nhiều tài nguyên để tìm kiếm các kịch bản sử dụng thực sự có giá trị, đồng thời triển khai cơ chế ngắt mạch tự động (circuit breakers). Cơ chế này giúp Shopify phát hiện kịp thời các agent bị treo và ngăn chặn các sự cố hạ tầng trước khi chi phí bùng nổ.
Từ tokenmaxxing sang "valuemaxxing": Tối ưu giá trị thay vì đốt token
Sự thất bại của tokenmaxxing dẫn đến sự ra đời của khái niệm "valuemaxxing" (do Marc Boroditsky, CRO của Nebius khởi xướng và được IBM thúc đẩy). Valuemaxxing chuyển dịch tư duy quản trị: đo lường giá trị tạo ra trên mỗi đơn vị token (Value per Token) — thể hiện qua số tác vụ hoàn thành, số lỗ hổng bảo mật được khắc phục, thời gian rút ngắn quy trình và tỷ lệ mã nguồn được giữ lại sử dụng.
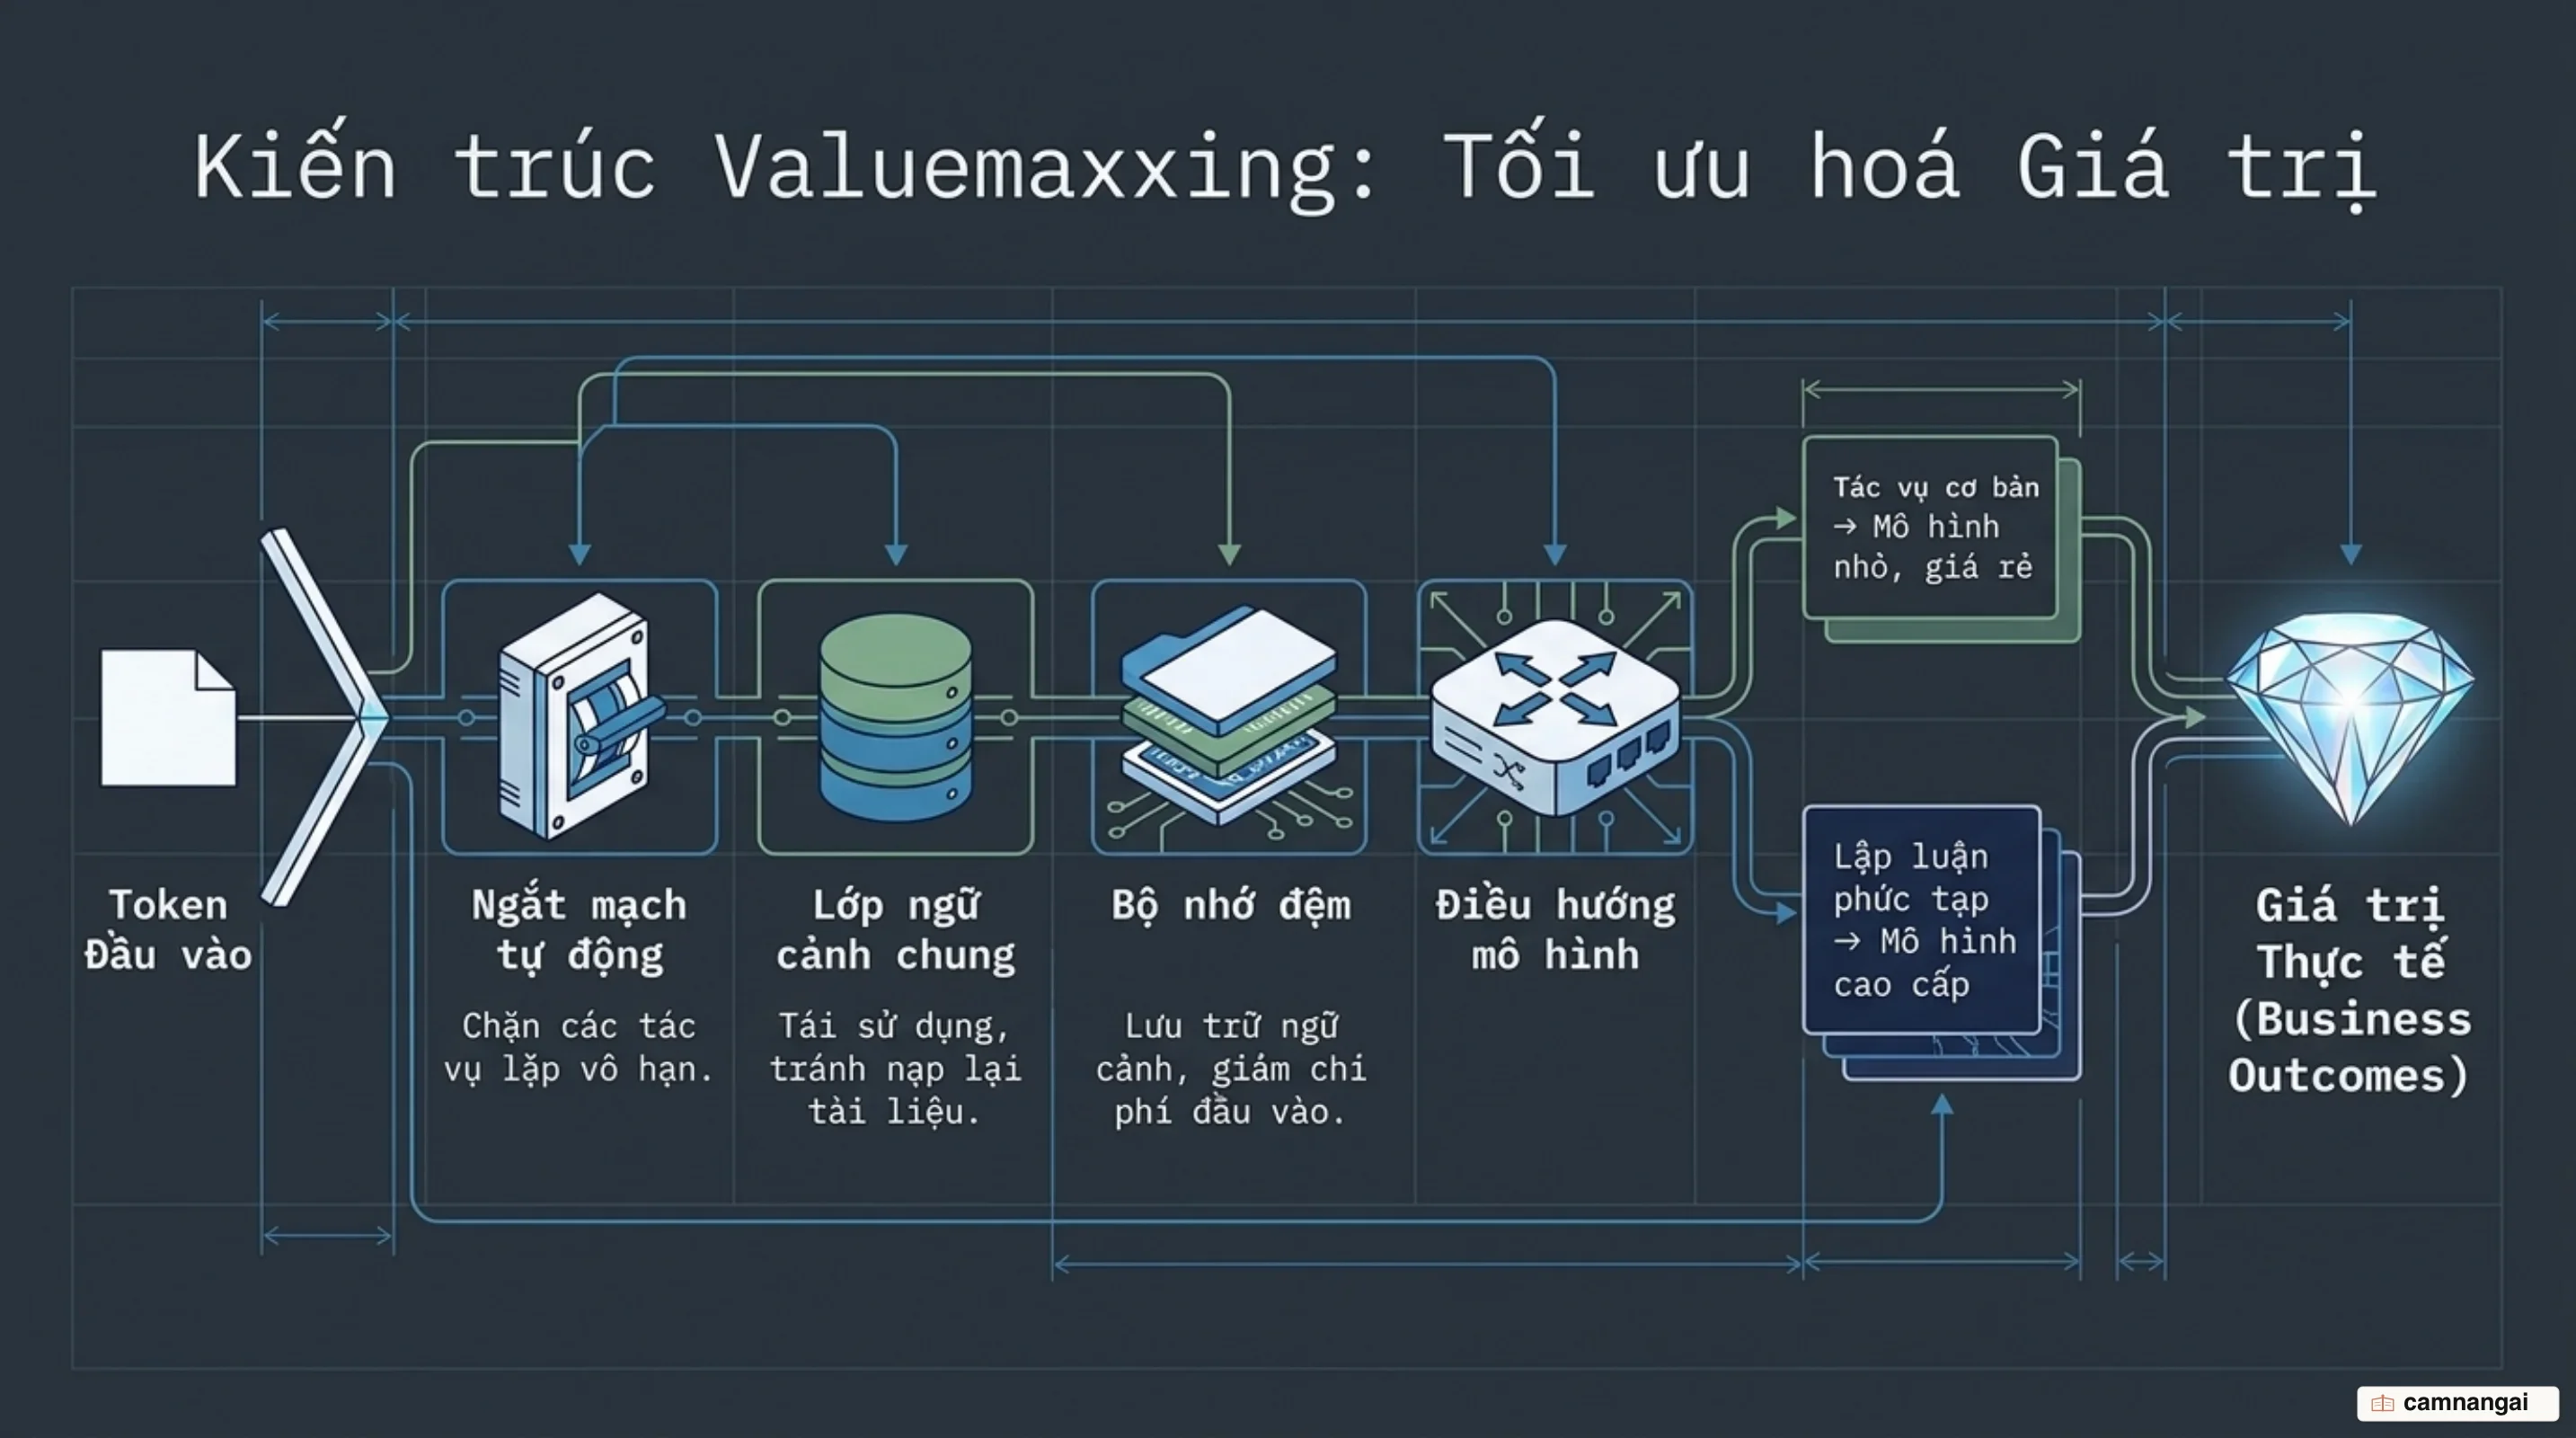
 ┌──► Tác vụ đơn giản (Phân loại, Tóm tắt) ──► Mô hình nhỏ / Giá rẻ (Claude Haiku, Open-source)
[Yêu cầu Công việc]
 └──► Lập luận phức tạp (Kiến trúc, Security) ──► Mô hình cao cấp (Claude Opus, Frontier LLM)
 │
 ▼
 [Lớp Ngữ cảnh Chung (Falconer)]
 │
 ▼
 [Tối ưu hóa: Caching + Circuit Breakers]
Để hiện thực hóa valuemaxxing, các kỹ sư hệ thống áp dụng các giải pháp kiến trúc chuyên sâu:
- Điều hướng mô hình (Model Routing): Dự báo từ IDC chỉ ra rằng đến năm 2028, 70% doanh nghiệp AI sẽ áp dụng cơ chế tự động phân loại tác vụ. Các tác vụ thông thường (phân loại, tóm tắt, định dạng) được điều hướng sang các mô hình nhỏ giá rẻ như Claude Haiku hoặc mô hình nguồn mở. Các mô hình lập luận đắt đỏ như Claude Opus chỉ được gọi cho các bài toán thiết kế kiến trúc hoặc kiểm toán bảo mật phức tạp.
- Lưu tạm câu lệnh (Prompt Caching): Tái sử dụng ngữ cảnh và hướng dẫn cố định thay vì nạp lại từ đầu ở mỗi lượt gọi, giảm đáng kể sự bão hòa cửa sổ ngữ cảnh (context window saturation).
- Tối ưu hóa RAG: Lọc, xếp hạng và chỉ truyền đúng đoạn tài liệu cần thiết, loại bỏ việc nạp nguyên kho mã nguồn vào prompt.
- Ngắt mạch tự động (Circuit Breakers): Thiết lập trần tiêu thụ và giới hạn độ sâu vòng lặp (loop depth) để tự động ngắt các agent rơi vào vòng lặp vô tận.
- Lớp ngữ cảnh chung (Shared Knowledge Layer): Triển khai các nền tảng như Falconer để hợp nhất tài liệu, mã nguồn và lịch sử hệ thống vào một lớp tri thức dùng chung. Lớp này giúp các agent không phải độc lập tìm kiếm và xử lý lại cùng một ngữ cảnh trùng lặp, giải quyết triệt để vấn đề truy xuất dư thừa.
- Quản trị tài chính AI (AI FinOps): Thiết lập hạn ngạch, theo dõi chi phí theo đơn vị công việc kinh doanh (agentic work unit) thay vì theo tài khoản cá nhân.
Khi nào nên dùng nhiều token và khi nào nên tiết kiệm?
Chấp nhận tiêu tốn lượng lớn token cho các tác vụ có tác động chiến lược: nghiên cứu thiết kế kiến trúc hệ thống phức tạp, tái cấu trúc các hệ thống mã nguồn cũ khổng lồ (legacy modernization), hoặc phân tích chuyên sâu các rủi ro bảo mật hạ tầng. Trong các kịch bản này, giá trị kỹ thuật và thời gian tiết kiệm được vượt xa chi phí API phát sinh.
Ngược lại, phải triệt để tiết kiệm đối với các tác vụ tra cứu thông thường, định dạng dữ liệu, viết mã lặp lại, hoặc khi agent bị kẹt trong vòng lặp thử - sai không rõ điều kiện dừng. Tiết kiệm token không phải là rào cản năng suất, mà là biểu hiện của kỷ luật tối ưu hóa kiến trúc trong kỹ thuật phần mềm hiện đại.
Tài liệu tham khảo
- Tokenmaxxing: Plain-English Definition, Origin & What It Means — Tokenmaxxing
- The Pulse: 'Tokenmaxxing' as a Weird New Trend — The Pragmatic Engineer
- Tokenmaxxing: Why AI Token Consumption Isn't Engineering Productivity — Faros AI
- Tokenmaxxing is Dead, Long Live Valuemaxxing — IBM
- Tokenmaxxing: The AI Token Status Game Taking Over Tech — Mr. Prompts
- Tokenmaxxing vs. Token Efficiency: What Changes When Agents Share a Knowledge Layer — Falconer Guides
- Tokenmaxxing: How CIOs Can Extract Maximum Value from AI Tokens — TechTarget