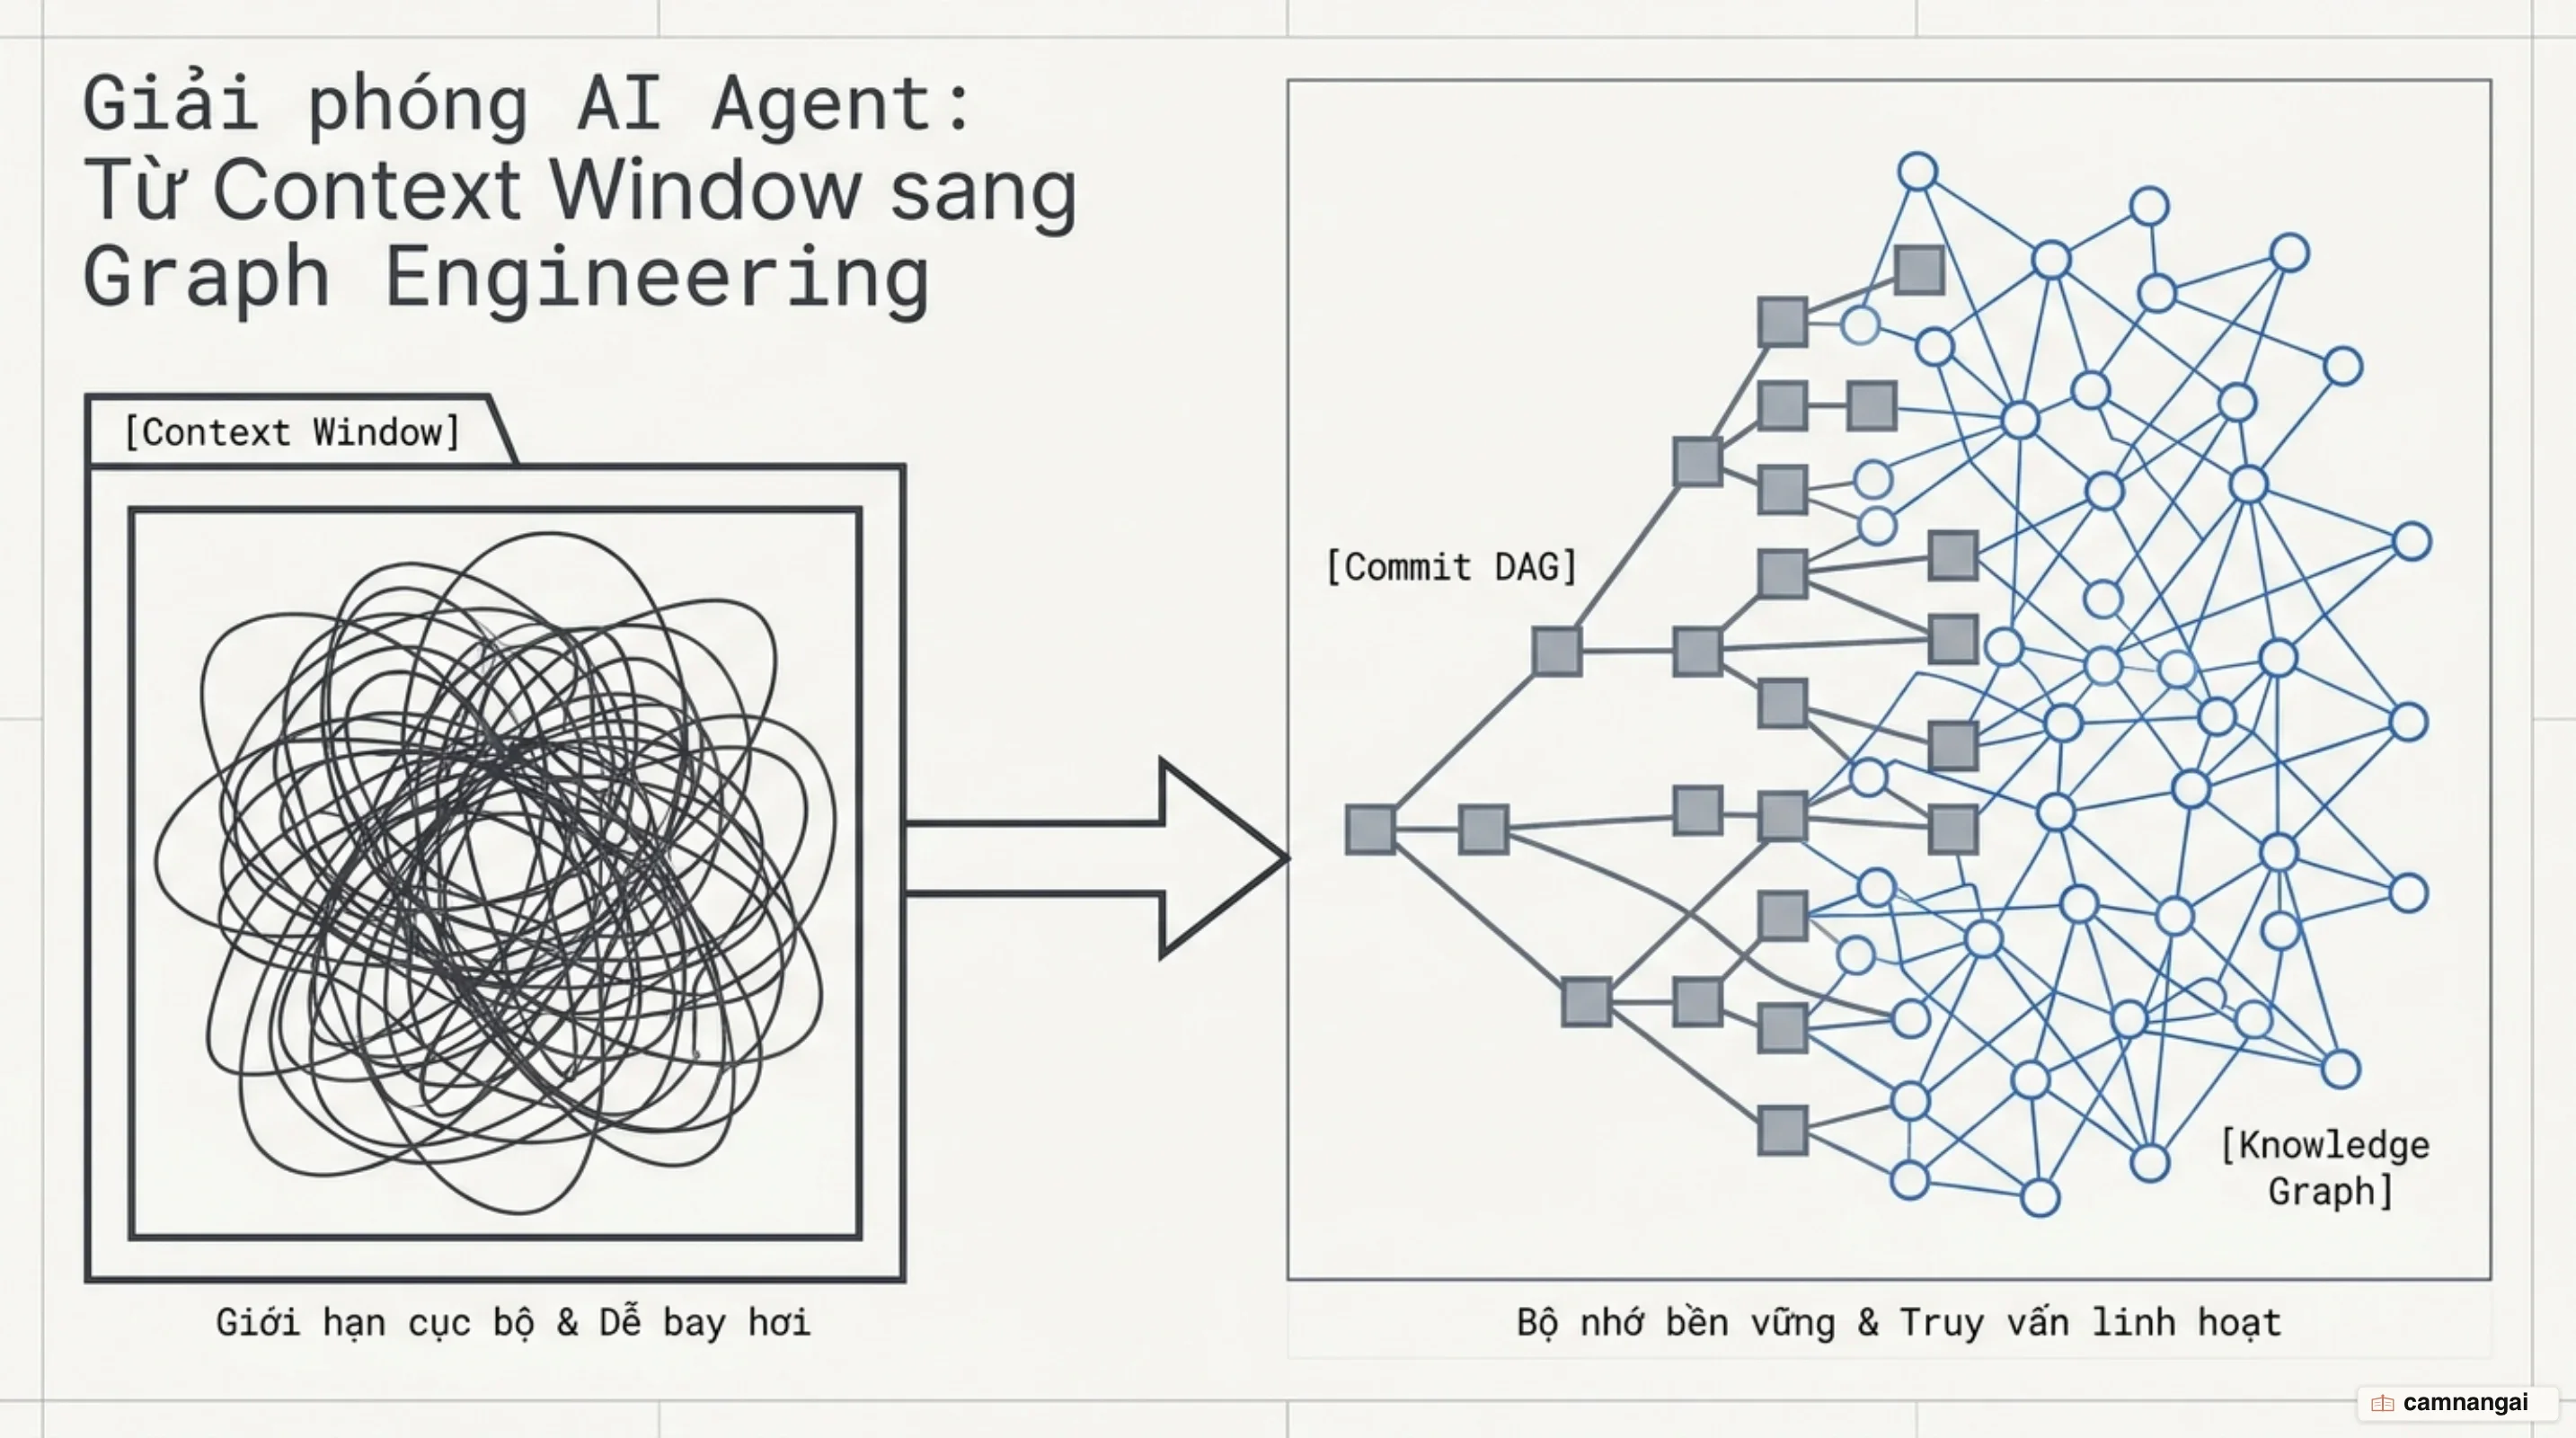
Graph engineering là phương pháp luận kiến trúc chuyển dịch bộ nhớ, trạng thái và lịch sử thực thi của hệ thống AI Agent ra khỏi cửa sổ ngữ cảnh (context window) để đưa vào các cấu trúc đồ thị có thể truy vấn.
Khi mở rộng quy mô từ một vòng lặp thử nghiệm đơn lẻ (Karpathy Loop) lên quần thể hàng ngàn agent hoạt động song song (Anthropic Playbook), việc nhồi nhét toàn bộ lịch sử hội thoại vào prompt gây ra nút thắt nghẽn context, làm tăng chi phí token và suy giảm khả năng suy luận logic.
Bằng cách kết hợp Đồ thị hướng không chu trình (Directed Acyclic Graph - DAG) để quản lý lịch sử thử nghiệm và Đồ thị tri thức (Knowledge Graph) để lưu giữ tri thức miền, hệ thống thiết lập một lớp bộ nhớ dùng chung (shared memory) có tính bền vững cao. Bài toán mở rộng AI Agent không còn nằm ở việc thực hiện lượt gọi mô hình tiếp theo, mà ở cách bạn thiết kế cấu trúc đồ thị và cơ chế đánh giá độc lập.
Autoresearch và vòng lặp tự tối ưu của Karpathy
Mô hình Autoresearch do Andrej Karpathy phát triển đưa AI Agent vào một khung thực thi (research harness) khép kín. Với khoảng 630 dòng code Python cốt lõi, hệ thống cho phép một agent duy nhất tự chạy trên một GPU, hoàn thành 700 thử nghiệm trong vòng 2 ngày và giữ lại 20 tối ưu hóa có lợi cho quá trình huấn luyện mô hình. Các cải tiến được phát hiện tự động bao gồm: chuẩn hóa QK (QK normalization scaling), regularization value-embedding, tinh chỉnh tham số AdamW, thay đổi batchsize, độ sâu mô hình, tốc độ học embedding, tần số cơ sở RoPE, weight decay có mục tiêu, initialization scale và lịch trình warmdown.
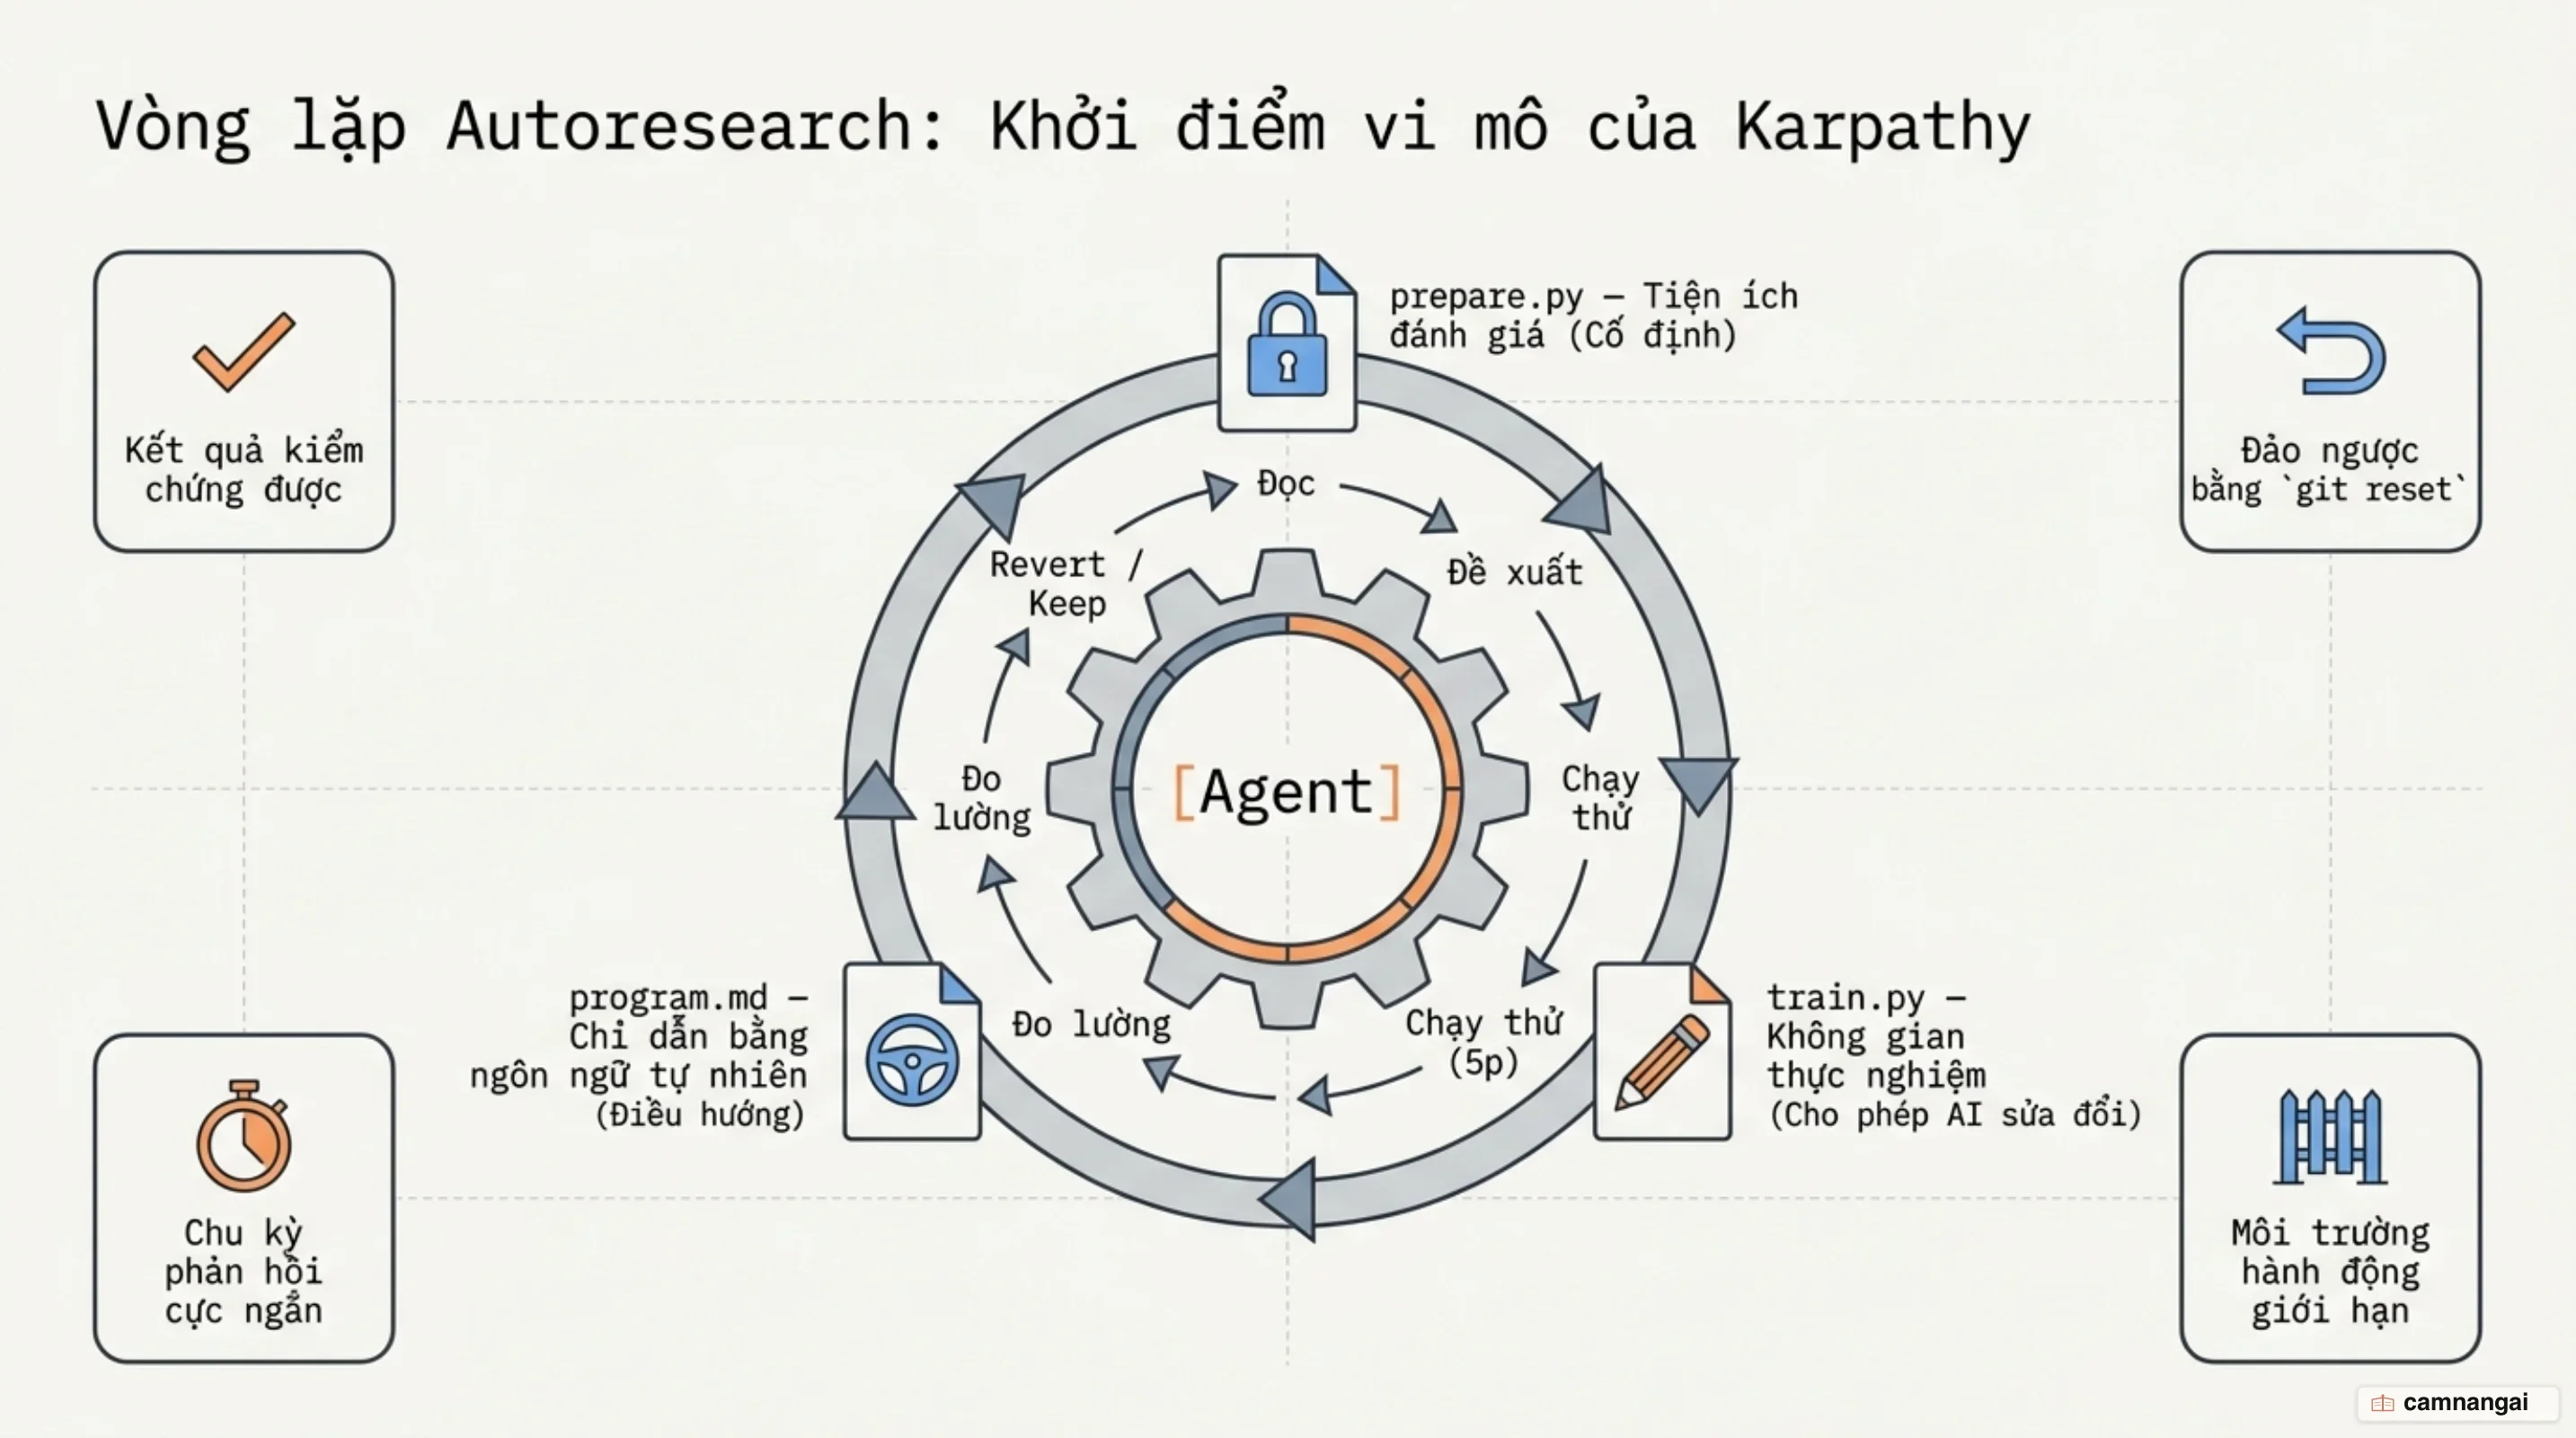
Kiến trúc của Autoresearch tách biệt rõ ràng trách nhiệm thông qua 3 file trung tâm:
prepare.py: Chứa dữ liệu cố định và các tiện ích đánh giá. Agent tuyệt đối không được chỉnh sửa file này.train.py: Chứa định nghĩa mô hình, optimizer, siêu tham số và vòng lặp huấn luyện. Đây là bề mặt thử nghiệm duy nhất mà agent được quyền sửa đổi.program.md: Bản chỉ dẫn bằng ngôn ngữ tự nhiên thiết lập quy trình nghiên cứu. Trong tư duy Software 3.0, prompt và context trở thành giao diện lập trình cho chính chương trình tự vận hành. Fileprogram.mdđóng vai trò như một meta-prompt cấu hình toàn bộ một tổ chức nghiên cứu tự trị: thiết lập phạm vi file được sửa đổi/bảo vệ, định nghĩa chỉ số tối ưu và chiều hướng, cấp ngân sách thử nghiệm, quy định lệnh thực thi, cơ chế parse kết quả đầu ra, chính sách xử lý khi chương trình sụp đổ (crash), quy tắc commit/revert code, nhật ký log, chính sách leo thang báo cáo lên con người (human escalation) và điều kiện dừng hệ thống khi cạn kiệt tài nguyên.
def ratchet_loop(inspect, propose, apply, evaluate, keep, revert, better, baseline):
    history, current = [], baseline
    while True:
        state = inspect()
        change = propose(state)
        commit = apply(change)
        try:
            score = evaluate()
        except Exception as exc:
            revert(commit)
            history.append(Trial(commit, change, None, "crash", str(exc)))
            continue
        if better(score, current):
            keep(commit)
            current = score
            history.append(Trial(commit, change, score, "kept", ""))
        else:
            revert(commit)
            history.append(Trial(commit, change, score, "reverted", ""))
Để vòng lặp tự tối ưu (ratchet loop) hoạt động ổn định mà không làm sai hỏng hệ thống, kiến trúc phải đảm bảo 4 điều kiện bắt buộc:
- Đầu ra kiểm chứng được (Verifiable): Tiến trình huấn luyện phải trả về kết quả đo lường định lượng rõ ràng (chỉ số
val_bpbvà mức sử dụng bộ nhớ đỉnh). - Hành động đảo ngược được (Reversible): Mọi thay đổi code đều được quản lý bằng Git. Nếu kết quả xấu đi hoặc gặp lỗi, lệnh
git resetlập tức khôi phục hệ thống về trạng thái tốt nhất đã lưu. - Chu kỳ ngắn (Short horizon): Mỗi lượt chạy thử nghiệm chỉ kéo dài khoảng 5 phút, tạo ra phản hồi nhanh chóng cho agent.
- Môi trường giới hạn (Bounded): Không gian hành động của agent bị thu hẹp trong phạm vi repository thử nghiệm.
Từ vòng lặp đơn lẻ đến AgentHub: Khi Git dành cho Agent thay vì con người
Khi chuyển từ mô hình đơn agent sang sự hợp tác của một quần thể agent (agent swarm), cách tiếp cận Git truyền thống của con người bị phá vỡ. Con người sử dụng Git để hội tụ code về một nhánh chính (main), thông qua kiểm duyệt (pull request) và chuỗi merge. Ngược lại, hàng ngàn agent có thể khám phá không gian giải pháp đồng thời, phần lớn thử nghiệm sẽ bị hủy bỏ và các thử nghiệm thất bại vẫn chứa thông tin có giá trị. Khái niệm AgentHub xuất hiện như một "GitHub dành cho Agent", nơi thao tác cốt lõi không phải là merge code mà là duyệt qua đồ thị tìm kiếm (search graph).
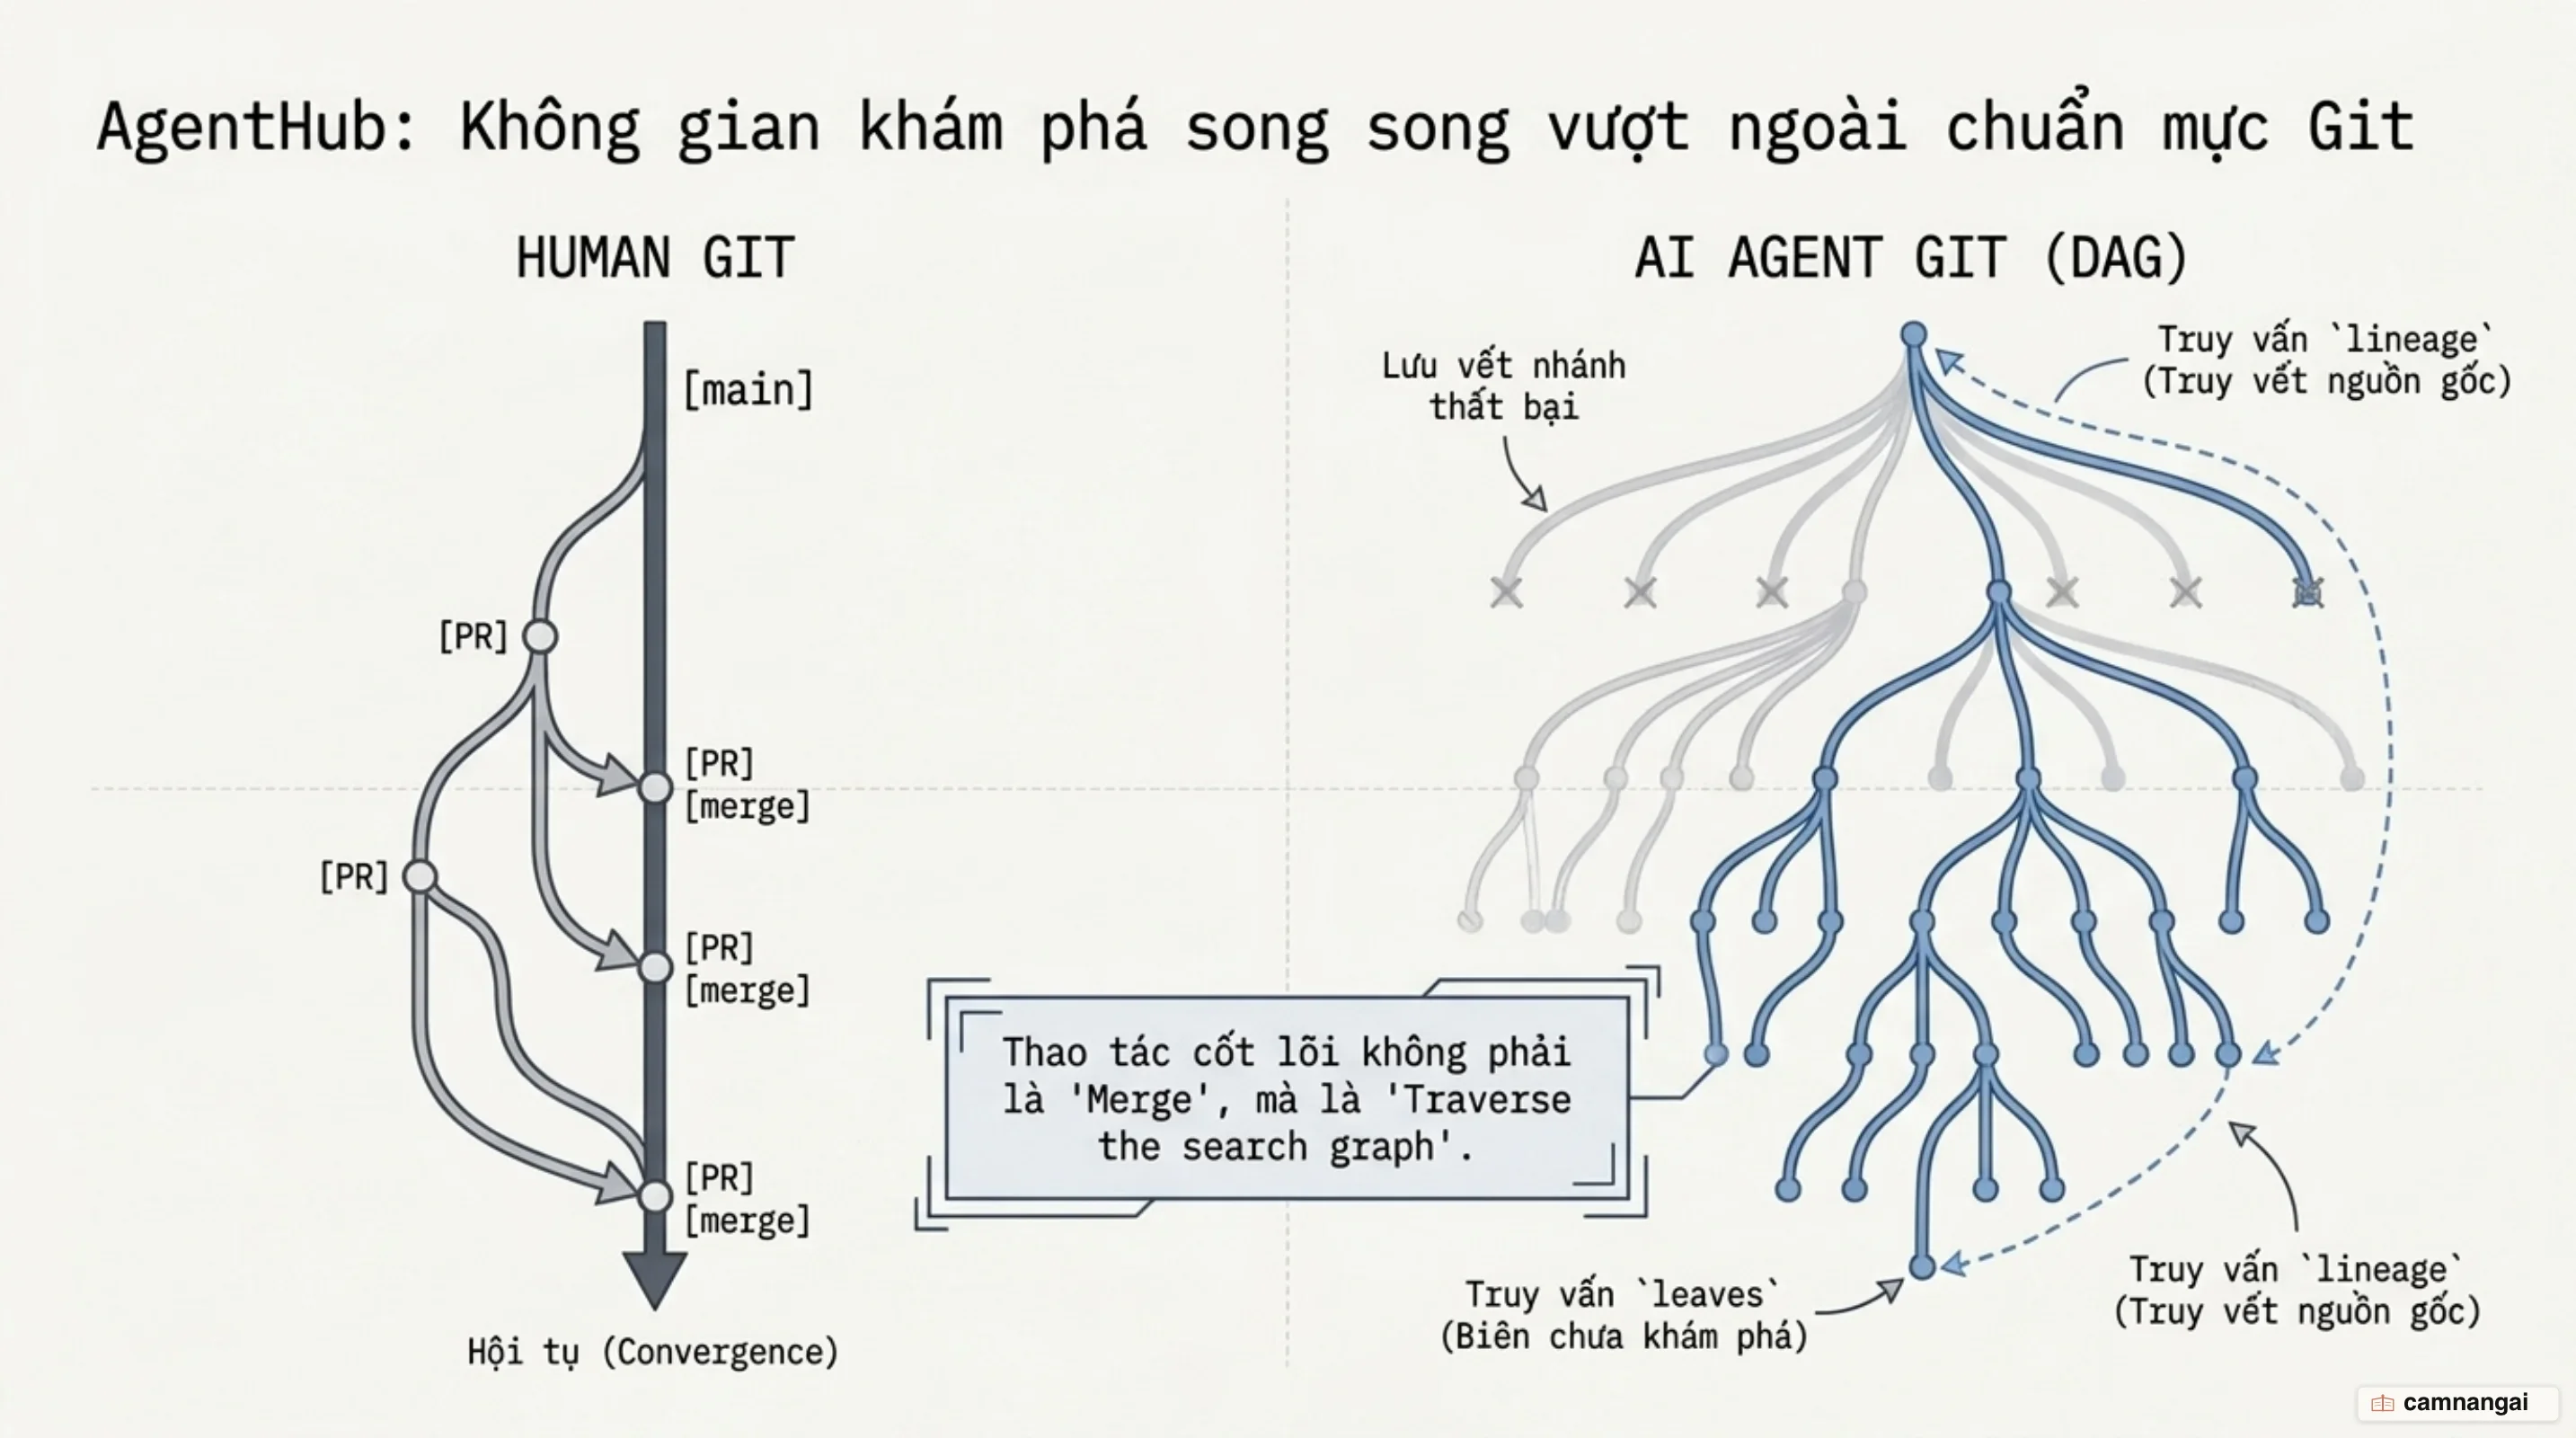
Cấu trúc hạ tầng của AgentHub được thiết kế tối giản để đạt hiệu năng cao: một binary server bằng Go, cơ sở dữ liệu SQLite, một bare Git repository trên đĩa, mỗi agent sở hữu một API key riêng, kèm theo cơ chế giới hạn rate limit và dung lượng bundle, cùng công cụ dòng lệnh ah. AgentHub loại bỏ các trừu tượng hội tụ của con người: không bắt buộc nhánh main, không có PR hay hàng đợi merge.
Trong AgentHub, Đồ thị hướng không chu trình (DAG) của Git chính là đồ thị tìm kiếm. Mỗi commit là một nút (node), mang đầy đủ thông tin ngữ cảnh: commit cha, agent khởi tạo, giả thuyết thử nghiệm, diff code, chỉ số đo lường (val_bpb), thời gian chạy, bộ nhớ tiêu thụ, môi trường, trạng thái giữ/hủy (keep/discard), cùng các liên kết thảo luận.
ah push              # Đẩy commit HEAD lên AgentHub
ah fetch <hash>      # Tải về commit bất kỳ
ah log [-agent X]    # Hiển thị các commit gần đây
ah children <hash>   # Truy vấn các thử nghiệm được phát triển từ commit này
ah leaves            # Hiển thị các nút biên chưa được khám phá (frontier)
ah lineage <hash>    # Truy vết đường đi từ mốc hiện tại về commit gốc
ah diff <a-hash> <b-hash> # So sánh sự khác biệt giữa 2 commit bất kỳ
Thông qua các lệnh CLI trên, agent có thể truy vấn ngữ cảnh kết nối (connected state) cần thiết cho quyết định tiếp theo thay vì đọc lại toàn bộ lịch sử trò chuyện (transcript). Tuy nhiên, AgentHub hiện tại vẫn ở dạng bản thảo (sketch) và tồn tại các hạn chế thực tế: chưa hỗ trợ lưu trữ phân tán, chưa có cơ chế dọn dẹp/nén repository, thiếu xác thực tin cậy giữa các agent, chưa phát hiện trùng lặp về mặt ngữ nghĩa (semantic duplicate detection) và chưa tối ưu hóa lịch trình tính toán.
Playbook của Anthropic: Từ 5 workflow pattern đến Dynamic Workflows
Năm 2024, Anthropic định hình 5 mô hình workflow tĩnh bao gồm: Prompt Chaining (chuỗi bước cố định), Routing (phân loại đầu vào để chuyển đến prompt/tool phù hợp), Parallelization (chạy song song để lấy số đông hoặc xử lý mảng độc lập), Orchestrator-Workers (model trung tâm phân rã và tổng hợp công việc), và Evaluator-Optimizer (vòng lặp tạo và đánh giá).
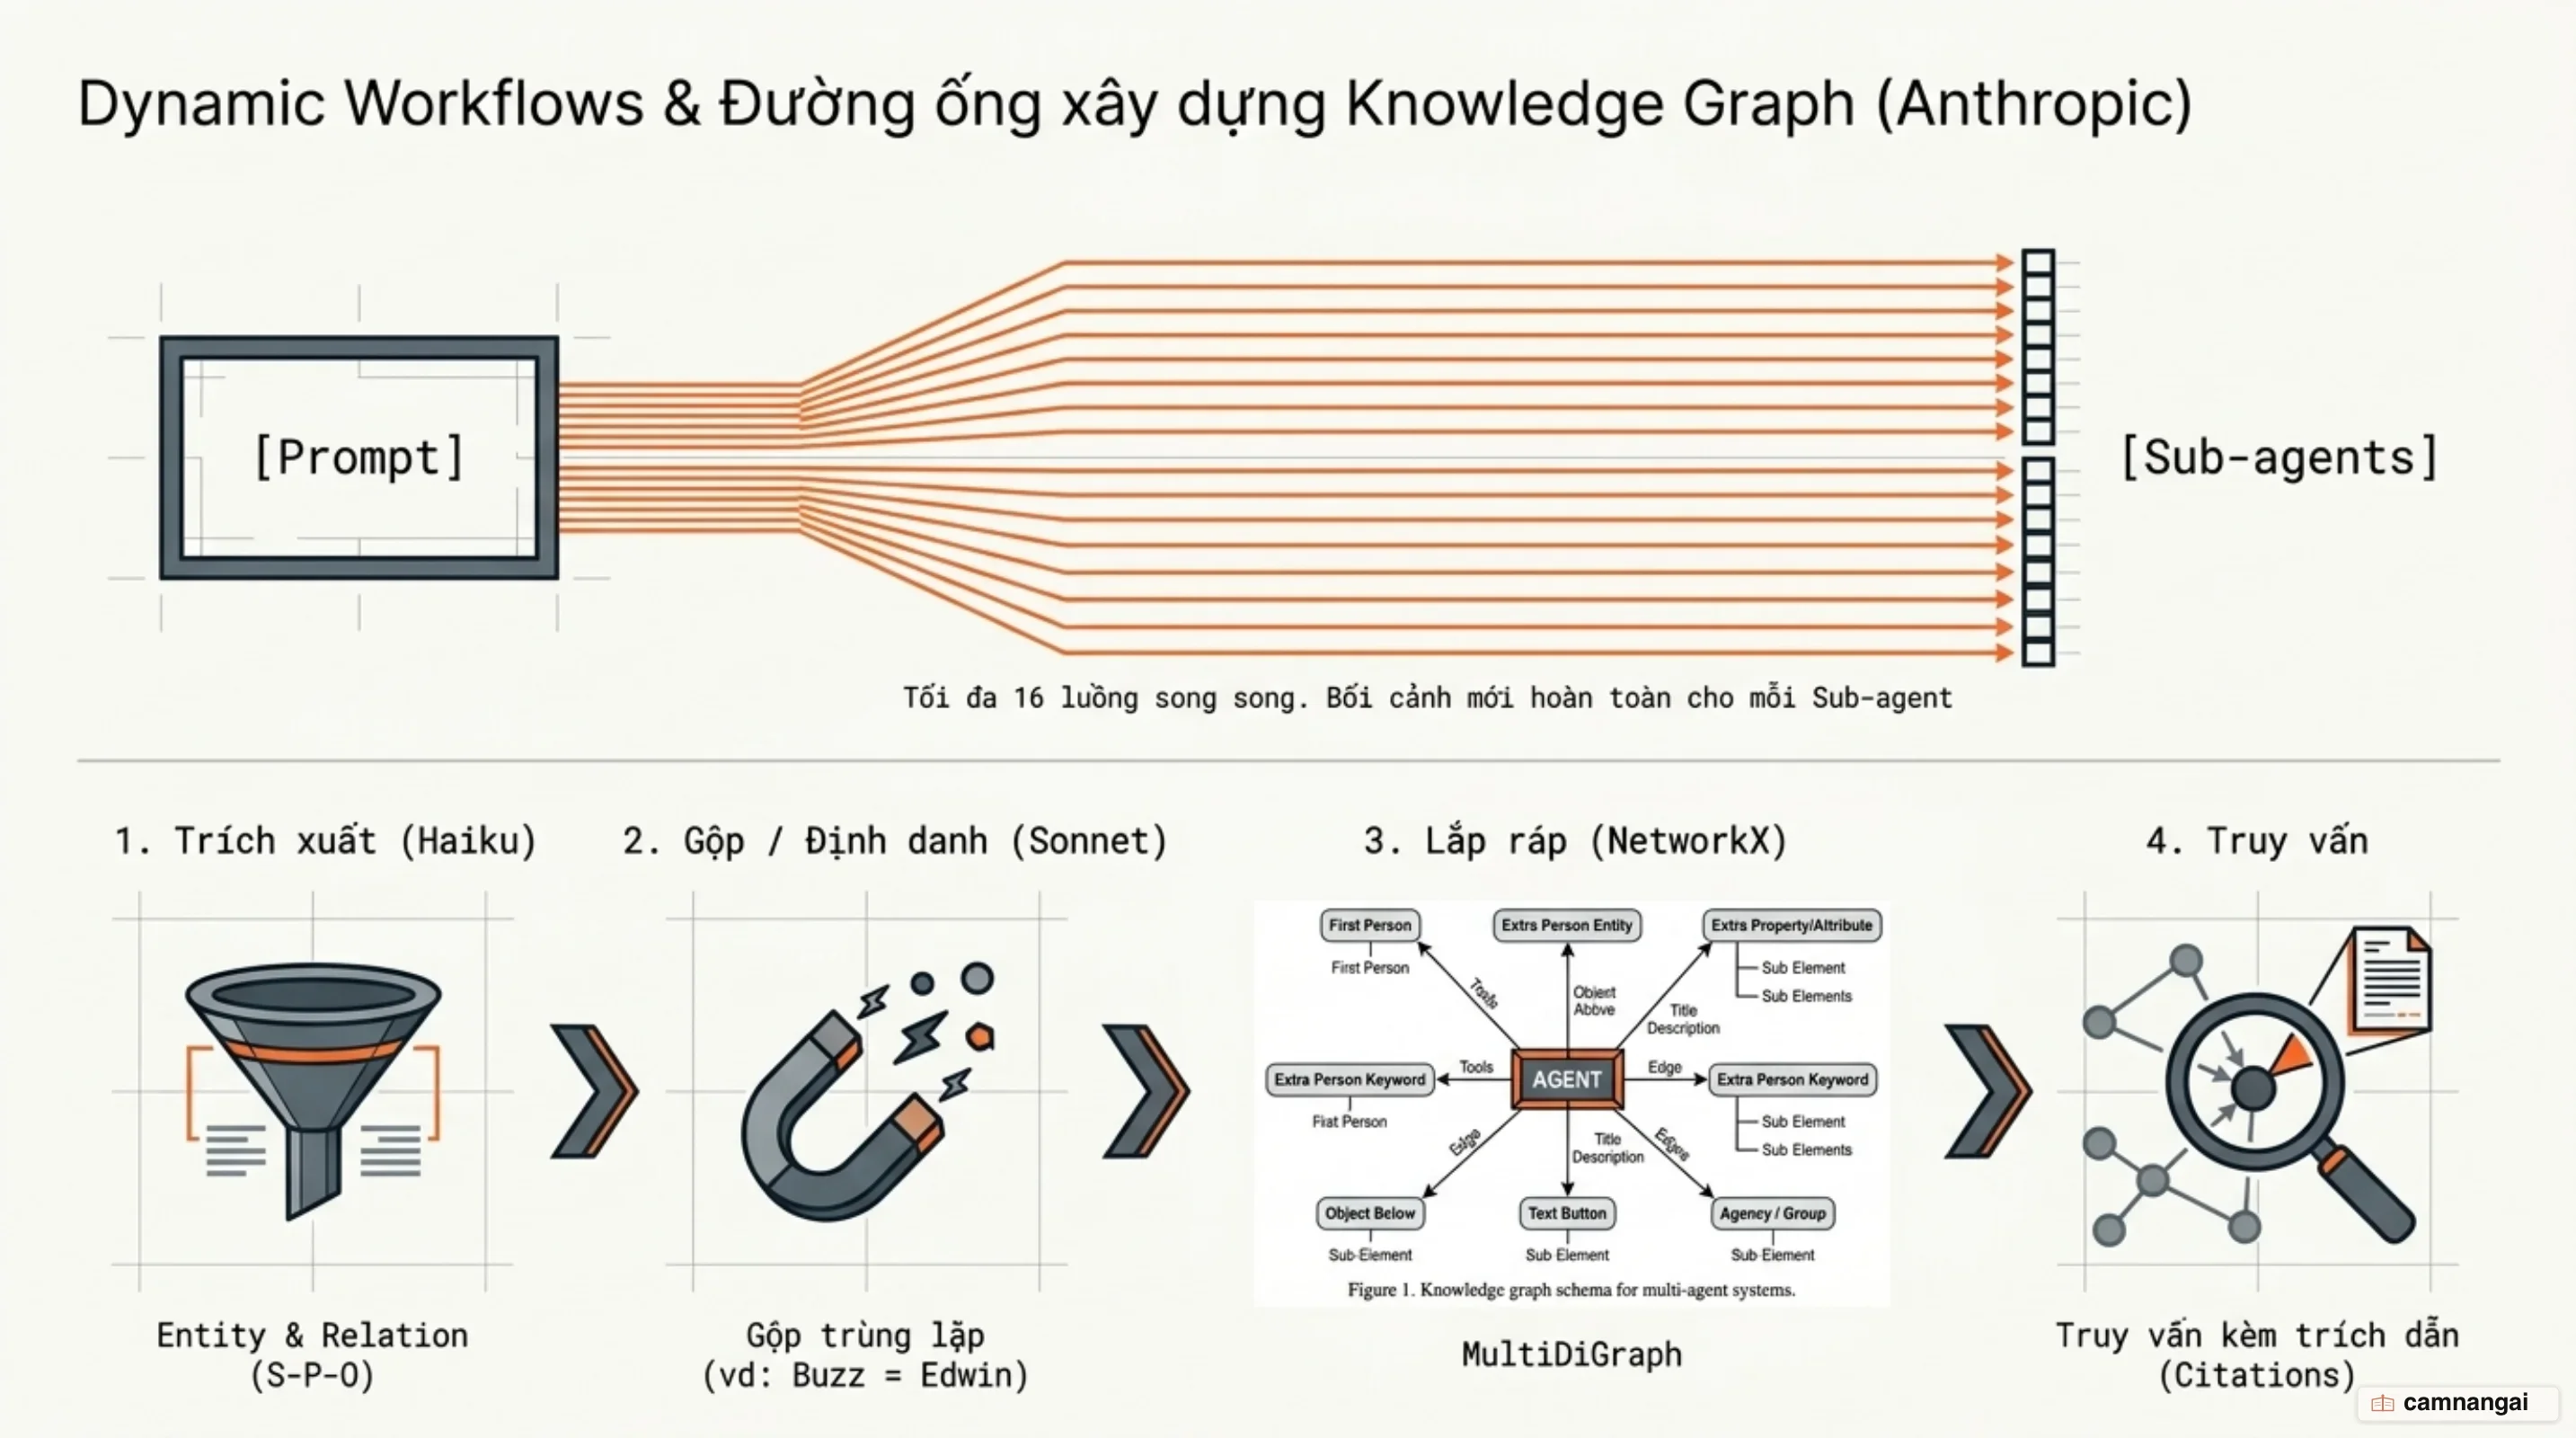
Đến năm 2026, kiến trúc này tiến hóa thành Dynamic Workflows. Lập trình viên không còn viết các script điều phối tĩnh; thay vào đó, Claude tự sinh ra chương trình điều phối bằng JavaScript/TypeScript và thực thi trong môi trường runtime Bun. Môi trường này cho phép khởi tạo tối đa 16 sub-agent song song đồng thời và đạt tổng giới hạn lên tới 1,000 sub-agent cho mỗi workflow. Mỗi sub-agent được cấp một cửa sổ ngữ cảnh hoàn toàn mới (fresh-context), trong khi trạng thái trung gian được lưu trữ trực tiếp trong các biến của script điều phối. Minh chứng thực tế là dự án cổng (port) Bun từ 750,000 dòng code Zig sang Rust được hoàn thành trong 11 ngày với tỷ lệ pass test đạt 99.8%.
const files = await tools.glob("src/**/*.ts");
const audits = await gather(
  files.map((file) =>
    spawn("auditor", { file, instructions: "Inspect for race conditions. Return JSON." }),
  ),
  { concurrency: 16 },
);
const suspicious = audits.filter((r) => r.confidence >= 0.7);
const reviews = await gather(
  suspicious.map((r) =>
    spawn("reviewer", { report: r, instructions: "Try to refute this finding." }),
  ),
  { concurrency: 16 },
);
return await spawn("synthesizer", { audits, reviews, instructions: "Produce one cited report." });
Song song với cơ chế điều phối động, Anthropic giới thiệu quy trình xây dựng Đồ thị tri thức (Knowledge Graph Construction Cookbook) thay thế hoàn toàn các pipeline NLP truyền thống:
- Extraction (Trích xuất): Sử dụng mô hình Claude Haiku kết hợp Pydantic schema để trích xuất các thực thể có kiểu (typed entities) và quan hệ Chủ thể - Vị thể - Đối thể (S-P-O).
- Resolution (Định danh/Gộp thực thể): Claude Sonnet nhóm các dạng bề mặt (surface forms) thành nút chuẩn (canonical node). Ví dụ: gộp "Edwin Aldrin" và "Buzz Aldrin" thành một thực thể duy nhất dựa trên bằng chứng ngữ cảnh.
- Assembly (Lắp ráp): Xây dựng cấu trúc
NetworkX MultiDiGraph, trong đó nút lưu kiểu, nguồn, số lượng; cạnh lưu vị thể, nguồn trích dẫn và độ tin cậy. - Querying (Truy vấn): Chuyển đổi đồ thị con (subgraph) thành dạng các bộ ba (triples) để Claude Sonnet suy luận kèm trích dẫn cấp cạnh (edge-level citation).
class Entity(BaseModel):
    name: str
    type: EntityType
    description: str

class Relation(BaseModel):
    source: str
    predicate: str
    target: str

class ExtractedGraph(BaseModel):
    entities: list[Entity]
    relations: list[Relation]

def extract(text, client) -> ExtractedGraph:
    response = client.messages.parse(
        model="claude-haiku-4-5",
        messages=[{"role": "user", "content": PROMPT.format(text=text)}],
        output_format=ExtractedGraph,
    )
    return response.parsed_output
Knowledge Graph: Lớp bộ nhớ dùng chung giải quyết nghẽn context
Việc áp dụng Knowledge Graph giải quyết triệt để nút thắt bộ nhớ trong các hệ thống đa agent thông qua 3 vai trò chiến lược:
- Lớp bộ nhớ dùng chung (Shared Memory): Các worker ghi lại các phát hiện dưới dạng cập nhật đồ thị có phiên bản (
GraphUpdate). Orchestrator chỉ cần truy vấn đồ thị thay vì phải đọc toàn bộ hội thoại của từng worker, giữ cho context window luôn sạch. - Lớp căn cứ sự thật (Grounding Layer): Evaluator kiểm tra các tuyên bố (claim) trực tiếp dựa trên các cạnh của đồ thị. Nếu một tuyên bố thiếu đường kết nối dữ liệu (ví dụ: thiếu cạnh giữa Nhà cung cấp X và Linh kiện Y), Evaluator sẽ trả về phản hồi cấu trúc yêu cầu bổ sung bằng chứng cụ thể.
- Mô hình thế giới bền vững (Persistent World Model): Lưu giữ tri thức qua các phiên làm việc dài hạn, hỗ trợ lập kế hoạch đa phiên, theo dõi mâu thuẫn dữ liệu và khôi phục sau sự cố.
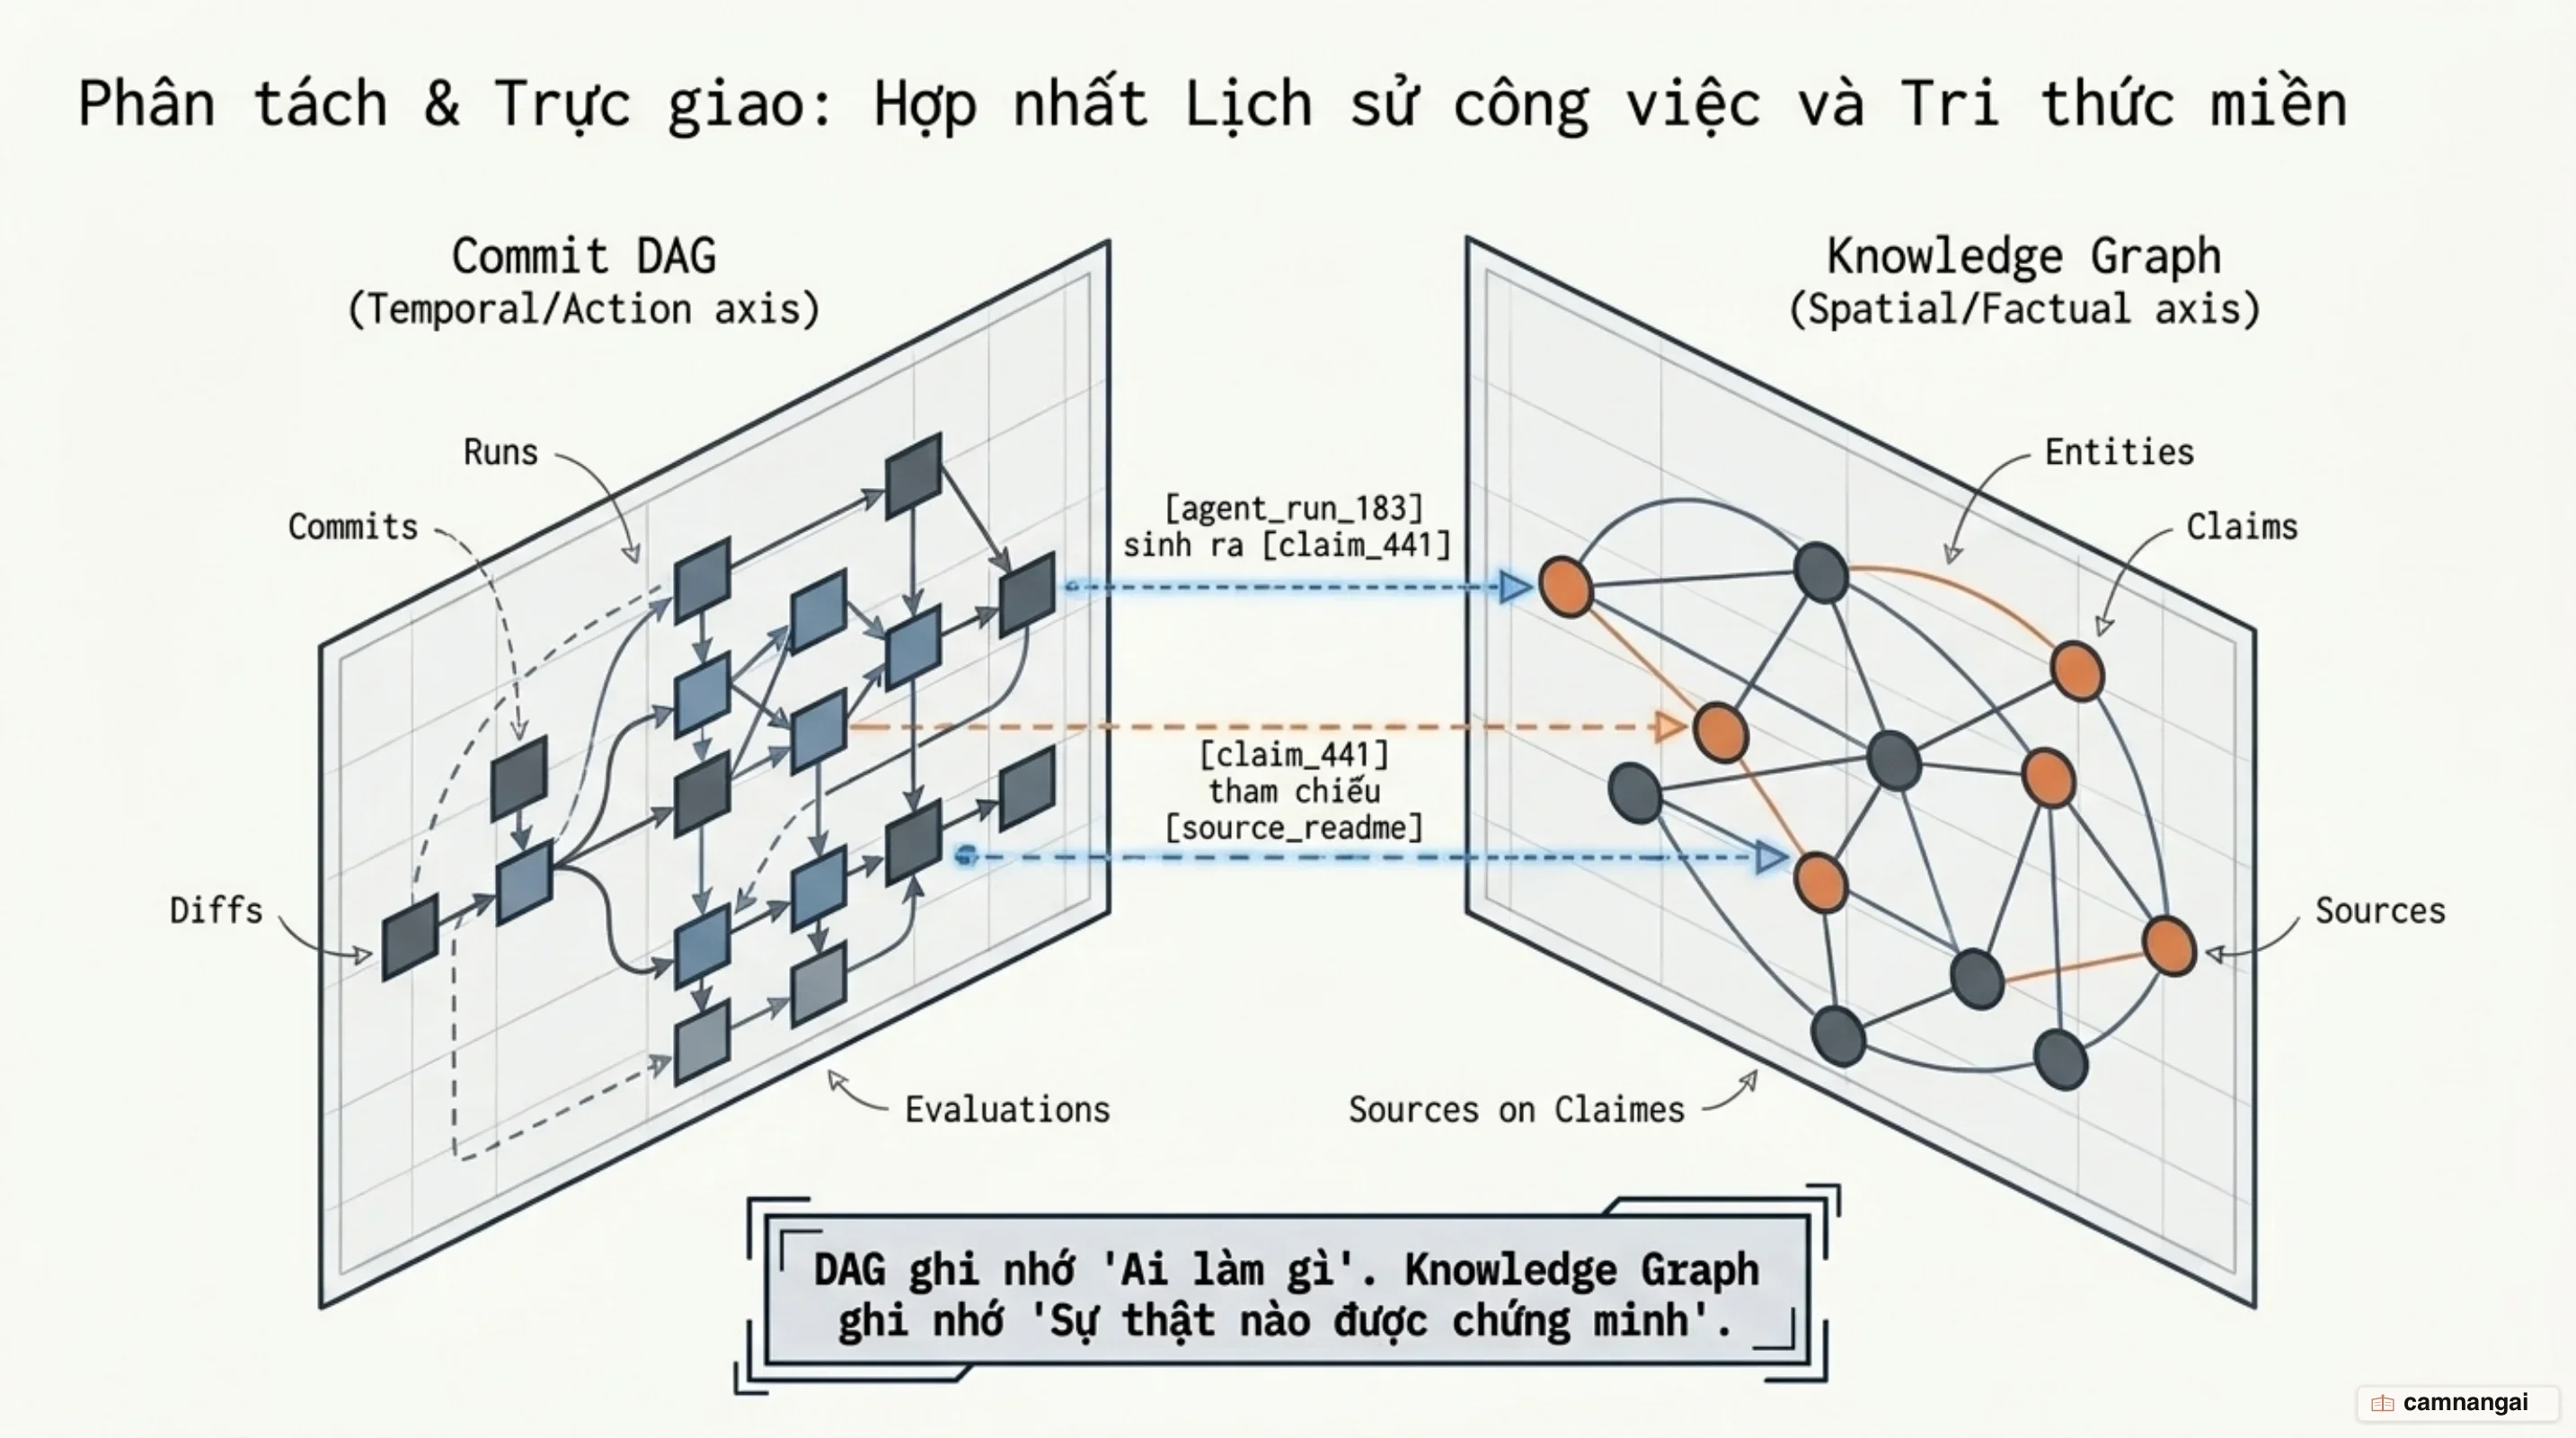
Để triển khai Knowledge Graph chuẩn hạ tầng, hệ thống quy định phân loại chuẩn gồm các loại nút (node types): Entity, Claim, Source, Artifact, AgentRun, Evaluation, Task, Commit, Metric; và các loại cạnh (edge types): MENTIONS, SUPPORTS, CONTRADICTS, DERIVED_FROM, PRODUCED, EVALUATES, REVISES, SUPERSEDES, DEPENDS_ON, PARENT_OF, RESOLVED_TO.
Knowledge Graph và Commit DAG có tính chất bổ trợ lẫn nhau và không được hợp nhất làm một. Commit DAG trả lời cho câu hỏi về dòng lịch sử công việc (Thử nghiệm nào là cha? Agent nào sửa đổi code?), trong khi Knowledge Graph trả lời cho câu hỏi về tri thức miền (Thực thể nào tồn tại? Quan hệ giữa chúng là gì? Nguồn tài liệu nào hỗ trợ?).
Mô hình liên kết liên đồ thị (Cross-Graph Linkage) thể hiện sự kết nối giữa hai thế giới:
(agent_run_183) -PRODUCED-> (claim_441) -DERIVED_FROM-> (commit_a81f) -EVALUATED_BY-> (evaluation_92)
(claim_441) -MENTIONS-> (entity_autoresearch) -SUPPORTS-> (source_readme) -SUPERSEDES-> (claim_238)@dataclass
class GraphUpdate:
nodes: list[dict]
edges: list[dict]
run_id: str
agent_id: str
def publish(update, graph, validator):
validator.check_schema(update.nodes, update.edges)
validator.check_provenance(update.nodes, update.edges, update.run_id)
with graph.transaction() as tx:
tx.upsert_versioned_nodes(update.nodes)
tx.add_edges(update.edges)
tx.link_run(update.run_id, update.agent_id, update.nodes, update.edges)
tx.commit()Lộ trình xây dựng từng bước: Từ Karpathy Loop đến Graph-Grounded Swarm
Để chuyển đổi một hệ thống Agent phẳng thành kiến trúc dạng đồ thị bền vững, bạn cần thực hiện theo lộ trình từng bước:
- Day 1 (Vòng lặp phản hồi): Xây dựng vòng lặp đơn giản gồm 1 lần sinh bản thảo, 1 evaluator kiểm tra theo tiêu chí cứng, và 1 bước sửa đổi. Dừng khi đạt điều kiện hoặc chạm mốc lặp.
- Day 2 (Tích hợp công cụ): Bổ sung các công cụ thực thi code, tìm kiếm, đọc DB. Mọi công cụ phải có Pydantic schema rõ ràng và cơ chế kiểm soát quyền.
- Week 1 (Lớp lập kế hoạch): Bắt buộc agent xuất kế hoạch dạng JSON với các phụ thuộc rõ ràng trước khi hành động.
- Week 2 (Mở rộng đa agent): Phân tách các vai trò Generator, Critic, Planner, Implementer, Reviewer. Sử dụng môi trường cô lập Git worktree khi nhiều agent cùng sửa đổi một repository.
- Month 1 (Đồ thị tri thức bền vững): Đưa cơ sở dữ liệu quan hệ/JSON vào lưu trữ nút, cạnh, bằng chứng. Dùng Claude Haiku trích xuất và Claude Sonnet gộp thực thể.
- Month 2 (Quần thể Agent/Swarm): Mở rộng xử lý song song quy mô lớn cho các tác vụ độc lập, thiết lập bộ giảm tải (reducer), giới hạn ngân sách token và thời gian chạy.
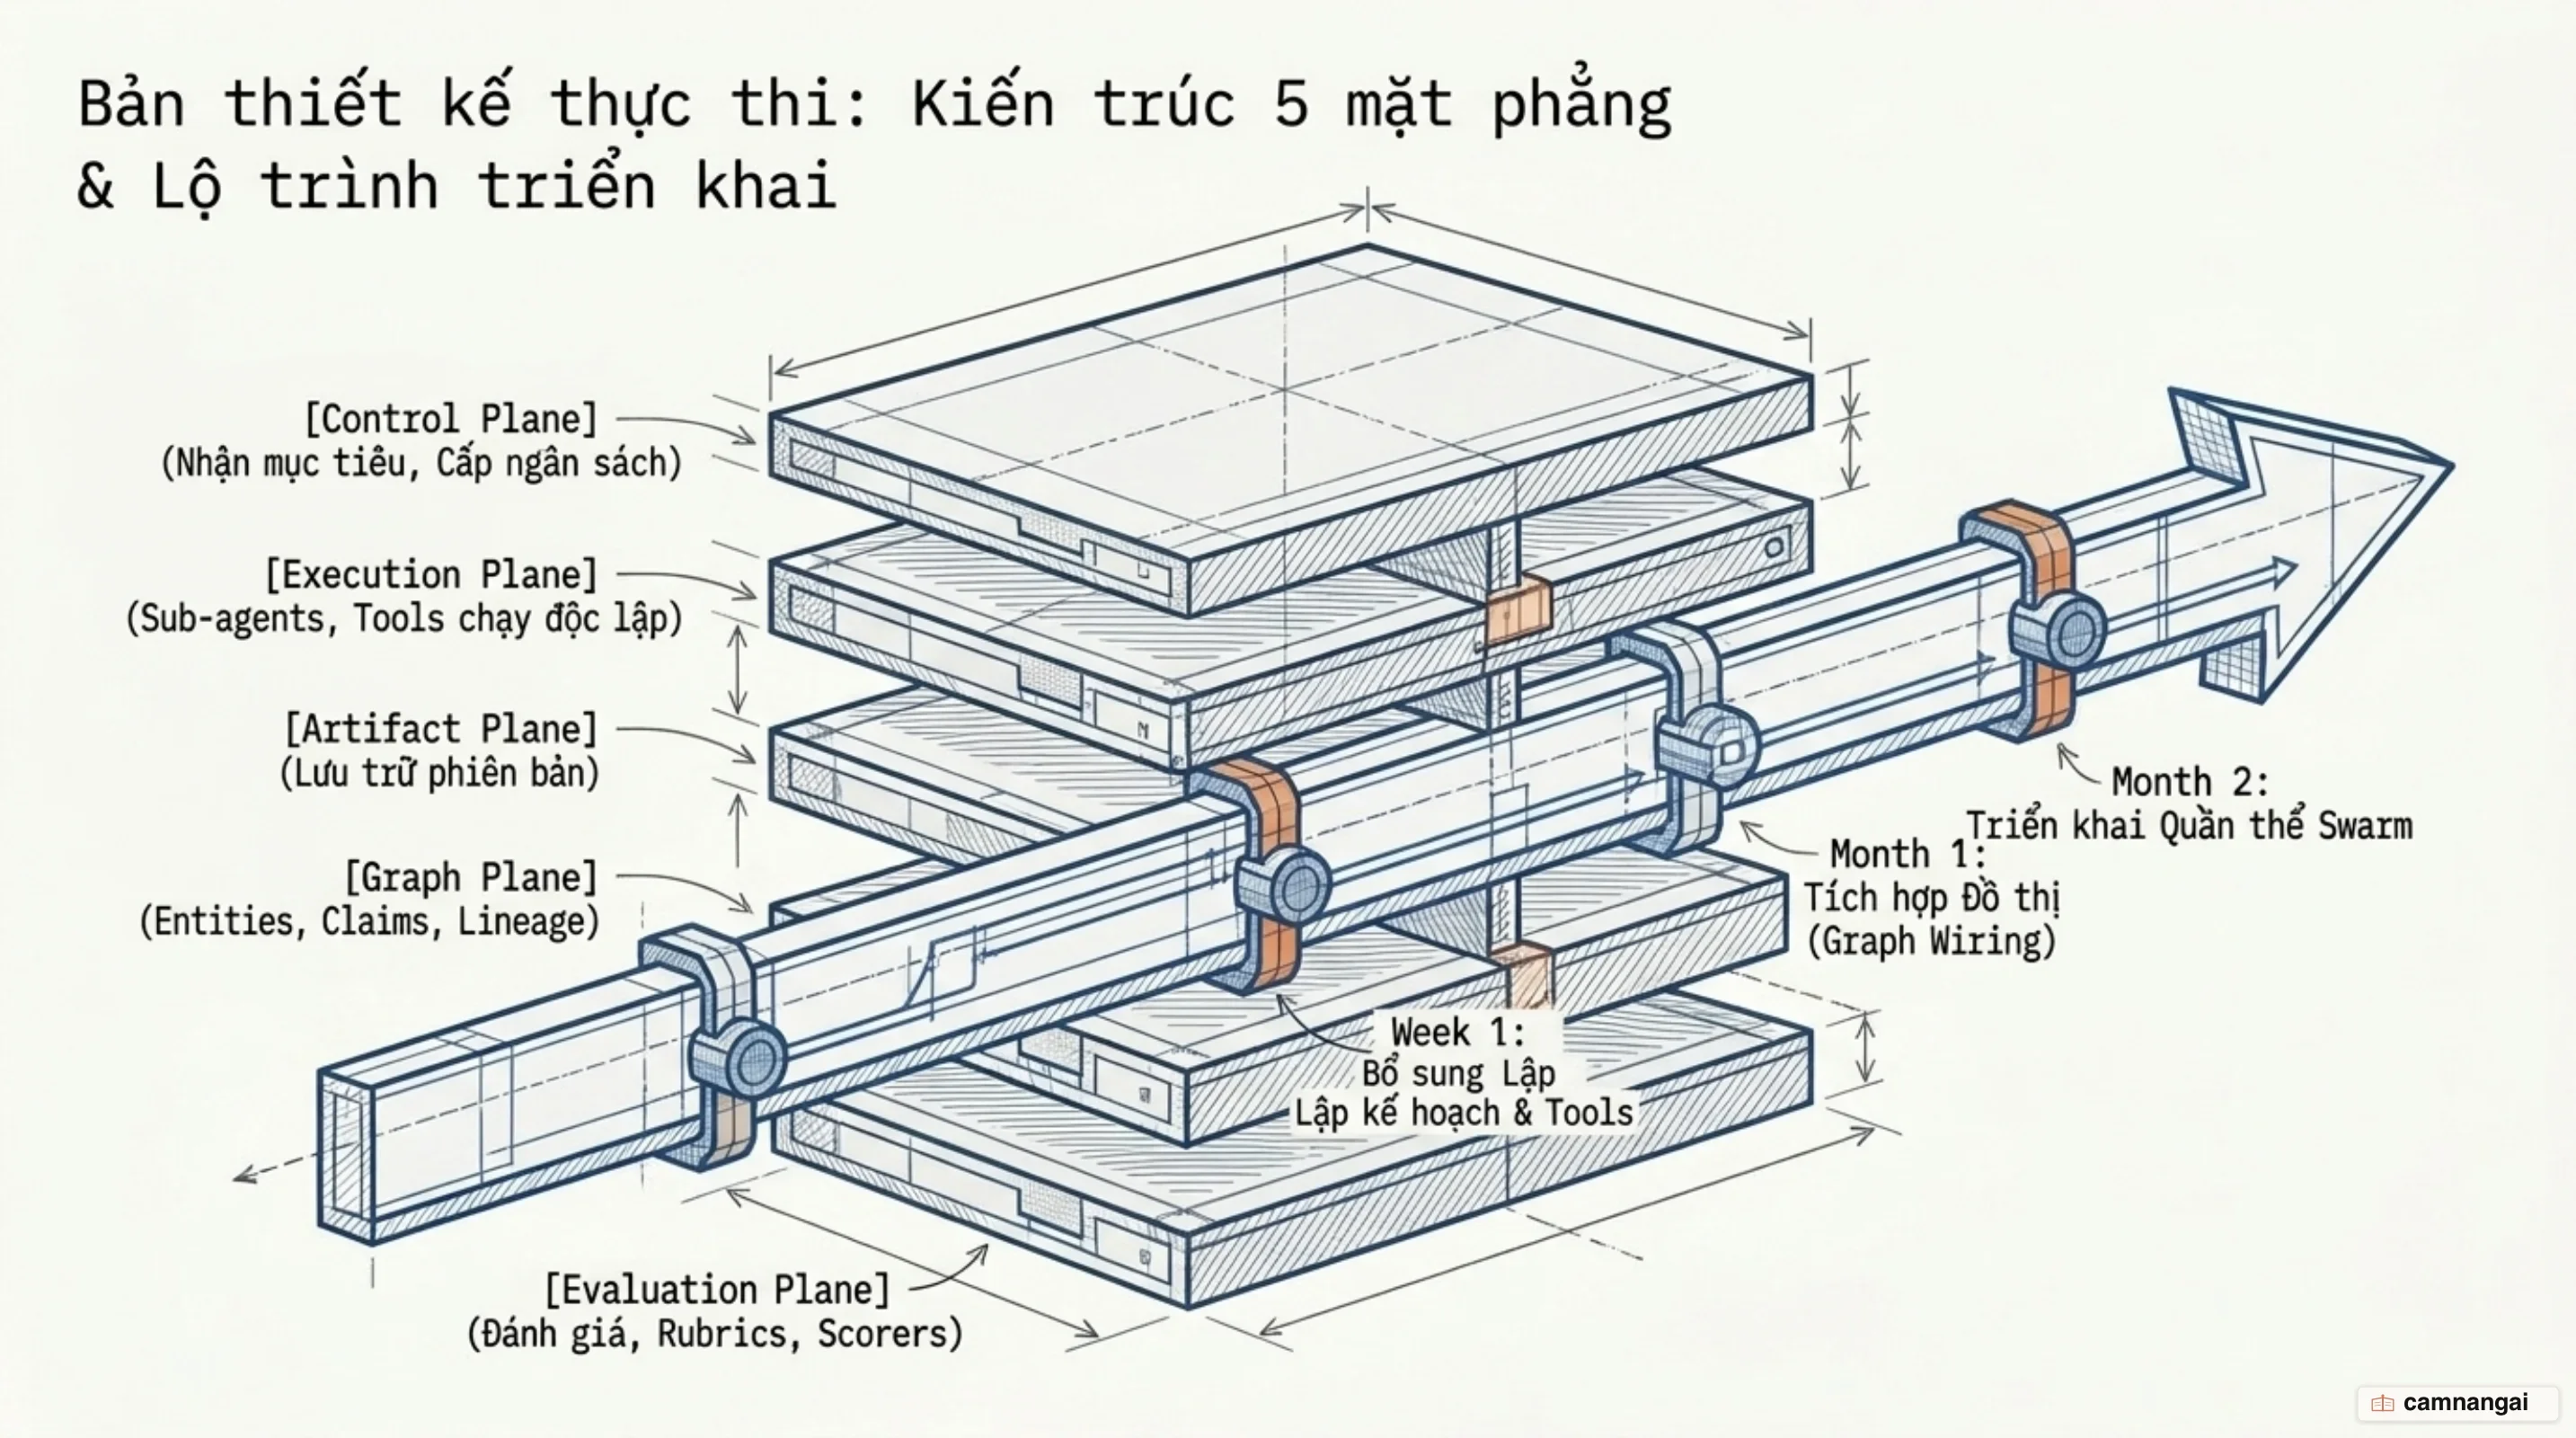
Kiến trúc sản xuất tiêu chuẩn (Reference Production Architecture) tách biệt thành 5 mặt phẳng (planes) độc lập: Control Plane (điều phối ngân sách, kế hoạch), Execution Plane (chạy tool, sandbox code), Artifact Plane (lưu bản thảo, diff code bất biến), Graph Plane (lưu trữ entities, commit DAG, provenance), và Evaluation Plane (đánh giá deterministic và kiểm tra logic).
| Giai đoạn | Thời gian | Độ phức tạp | Tiêu chuẩn đầu ra (Exit Criterion) |
|---|---|---|---|
| Reflective Loop | Day 1 | Thấp | Chất lượng đầu ra cải thiện rõ rệt qua đo lường |
| Tool Integration | Day 2 | Thấp | Công cụ giảm hẳn một lớp lỗi đã biết |
| Planning | Week 1 | Trung bình | Hoàn thành các tác vụ có đường đi biến động |
| Multi-agent | Week 2 | Trung bình | Phân tách vai trò cho kết quả tốt hơn hẳn mô hình đơn agent |
| Persistent Graph | Month 1 | Cao | Thực hiện thành công các truy vấn xuyên phiên làm việc |
| Swarm Workflow | Month 2 | Cao | Tăng tốc độ thời gian thực mà không suy giảm chất lượng |
Đo lường và đánh giá: Graph Autoresearch trên tập gold set
Khái niệm Graph Autoresearch là việc áp dụng chính vòng lặp tự tối ưu của Karpathy để tinh chỉnh hạ tầng tri thức. Đối tượng được tối ưu không phải là tham số mô hình, mà là prompt trích xuất, ontology (bộ phân loại thực thể), chính sách gộp thực thể (resolution policy) và cấu trúc chuyển đổi truy vấn (query serializer). Vòng lặp sẽ chạy thử nghiệm trên một tập dữ liệu chuẩn (gold set), tính toán các chỉ số và giữ lại các thay đổi prompt/schema giúp nâng cao điểm số.
| Tầng (Layer) | Chỉ số đánh giá (Metric) | Bẫy số liệu cần tránh (Common Misreading) |
|---|---|---|
| Trích xuất (Extraction) | Entity/Relation F1, Precision, Recall, Schema Valid Rate | Độ chính xác (Precision) cao có thể che giấu việc bỏ sót thực thể |
| Định danh (Resolution) | Pairwise Precision/Recall, Tỷ lệ nén (Compression Ratio) | Tỷ lệ nén quá cao thưởng cho việc gộp nhầm thực thể (over-merging) |
| Đồ thị (Graph) | Số lượng thành phần (Components), Mật độ cạnh (Density) | Đồ thị chỉ có 1 thành phần không phải lúc nào cũng là mục tiêu tối ưu |
| Truy vấn (Querying) | Độ chính xác (Accuracy), Đường dẫn trích dẫn (Cited paths) | Câu trả lời trôi chảy vẫn có thể trích dẫn các cạnh không liên quan |
| Luồng công việc (Workflow) | Tỷ lệ thành công tác vụ (Task success), Chi phí (Cost) | Tăng số lượng agent có thể làm tăng hoạt động mà không tạo thêm giá trị |
| Vận hành (Operations) | Khả năng phục hồi (Recovery), Sửa lỗi (Corrections) | Tỷ lệ thành công trung bình che giấu các trường hợp thất bại thảm khốc |
Khi nào nên và không nên đưa Knowledge Graph vào hệ thống Agent?
Trước khi triển khai Knowledge Graph, bạn cần trả lời khung 6 câu hỏi chiến lược:
- Kết quả đầu ra có thể kiểm chứng được không?
- Các bước thực hiện có tính chất ổn định không?
- Các tác vụ con có độc lập với nhau không?
- Có cần phải duy trì các dòng nhánh thử nghiệm khác nhau không?
- Tri thức có cần tồn tại xuyên qua các phiên làm việc không?
- Hệ thống có chịu được chi phí tiền mặt và độ trễ gia tăng không?
Đồng thời, hệ thống phải thiết lập Ngân sách độ phức tạp (Complexity Budget) cứng: giới hạn tối đa số lượt gọi model, số lượng sub-agent, thời gian thực thi, số lượng token, chi phí tài chính, số lần ghi đồ thị và số lần thử lại (retry).
TUYỆT ĐỐI KHÔNG NÊN DÙNG Knowledge Graph khi: tác vụ mang tính chất đơn lẻ, không cần lưu trạng thái qua các phiên; câu trả lời nằm trọn trong một tài liệu đơn; các quan hệ mang tính tĩnh và đơn giản; một bảng quan hệ (relational table) đã đủ đáp ứng; hoặc chi phí do sai số trích xuất thực thể vượt quá giá trị mà việc duyệt đồ thị mang lại.
| Tình huống (Situation) | Bắt đầu bằng (Start With) | Lý do (Why) |
|---|---|---|
| Câu hỏi đơn giản, rủi ro thấp | Zero-shot | Độ trễ thấp nhất |
| Đầu ra có thể kiểm tra được | Loop | Phản hồi lặp lại giúp cải thiện sản phẩm |
| Chuỗi xử lý cố định, dự đoán được | Chain | Các giai đoạn dự đoán được, dễ kiểm thử |
| Phân loại rõ ràng | Router | Phân tách rõ chính sách và mô hình xử lý |
| Xử lý các đơn vị độc lập | Parallel | Giảm thời gian chờ thực tế (wall-clock time) |
| Phân rã công việc biến động | Orchestrator-Workers | Tự động hóa chuyên môn hóa động theo ngữ cảnh |
| Cần duy trì các phương án thử nghiệm song song | Commit DAG | Bảo toàn các nhánh thử nghiệm, tránh ghi đè kết quả |
| Tri thức/Sự thật phải tồn tại qua các phiên | Knowledge Graph | Bộ nhớ dùng chung bền vững cho hệ thống |
| Tác vụ song song quy mô cực lớn | Dynamic Workflows | Tự động hóa quá trình phân tán (fan-out) và tổng hợp (fan-in) |
Lời kết: Bước chuyển dịch từ Prompt đến Graph Engineering
Ngành AI đang chứng kiến bước chuyển dịch mô hình rõ rệt: từ Vibe Coding (con người nói ý định, mô hình tự viết code), sang Agentic Engineering (con người quy định, điều phối, kiểm chứng và chịu trách nhiệm chất lượng), và hiện tại là Graph Engineering (các agent chia sẻ trạng thái bền vững thông qua đồ thị công việc và tri thức có thể truy vấn).
Bài học kỹ thuật cốt lõi là: Nút thắt lớn nhất của các hệ thống AI hiện đại không nằm ở lượt gọi model tiếp theo, mà nằm ở vị trí đặt bộ nhớ và cơ chế đánh giá. Việc kết hợp giữa Commit DAG và Knowledge Graph giúp hệ thống agent không phải xây dựng lại ngữ cảnh từ đầu trong mỗi cửa sổ hội thoại, biến các mô hình suy luận thành một hạ tầng kỹ thuật có thể mở rộng ổn định và đáng tin cậy.