Việc chọn model Claude phù hợp trong hệ sinh thái Anthropic đòi hỏi bạn phải căn cứ vào bản chất kỹ thuật của tác vụ, độ trễ phản hồi chấp nhận được và hạn mức ngân sách token.
Chi phí xử lý dữ liệu biến thiên đáng kể giữa các phân khúc, từ $0.10/triệu token input với Haiku 5.5 cho đến $10/triệu token input với Fable 5.1. Quyết định lựa chọn kiến trúc model vì vậy tác động trực tiếp đến hạn mức sử dụng (rate limits) và tổng chi phí vận hành hệ thống.
Khung quyết định hạ tầng được xác định cụ thể: sử dụng Haiku 5.5 cho các tác vụ trích xuất và xử lý dữ liệu tức thì đòi hỏi độ trễ tối thiểu; đặt Sonnet 5.5 làm model mặc định cho đa số công việc lập trình, phân tích và quy trình đa bước; áp dụng Opus 5.5 cho các bài toán nghiên cứu chuyên sâu yêu cầu khả năng suy luận phức tạp kéo dài; và triển khai Fable 5.1 cho các dự án agentic quy mô lớn đòi hỏi năng lực tự chủ cao, tự lập kế hoạch và tự kiểm tra kết quả.
Lựa chọn đúng model ngay từ đầu giúp tối ưu hóa hiệu năng thực thi và giữ hệ thống an toàn bên trong hạn mức tốc độ.
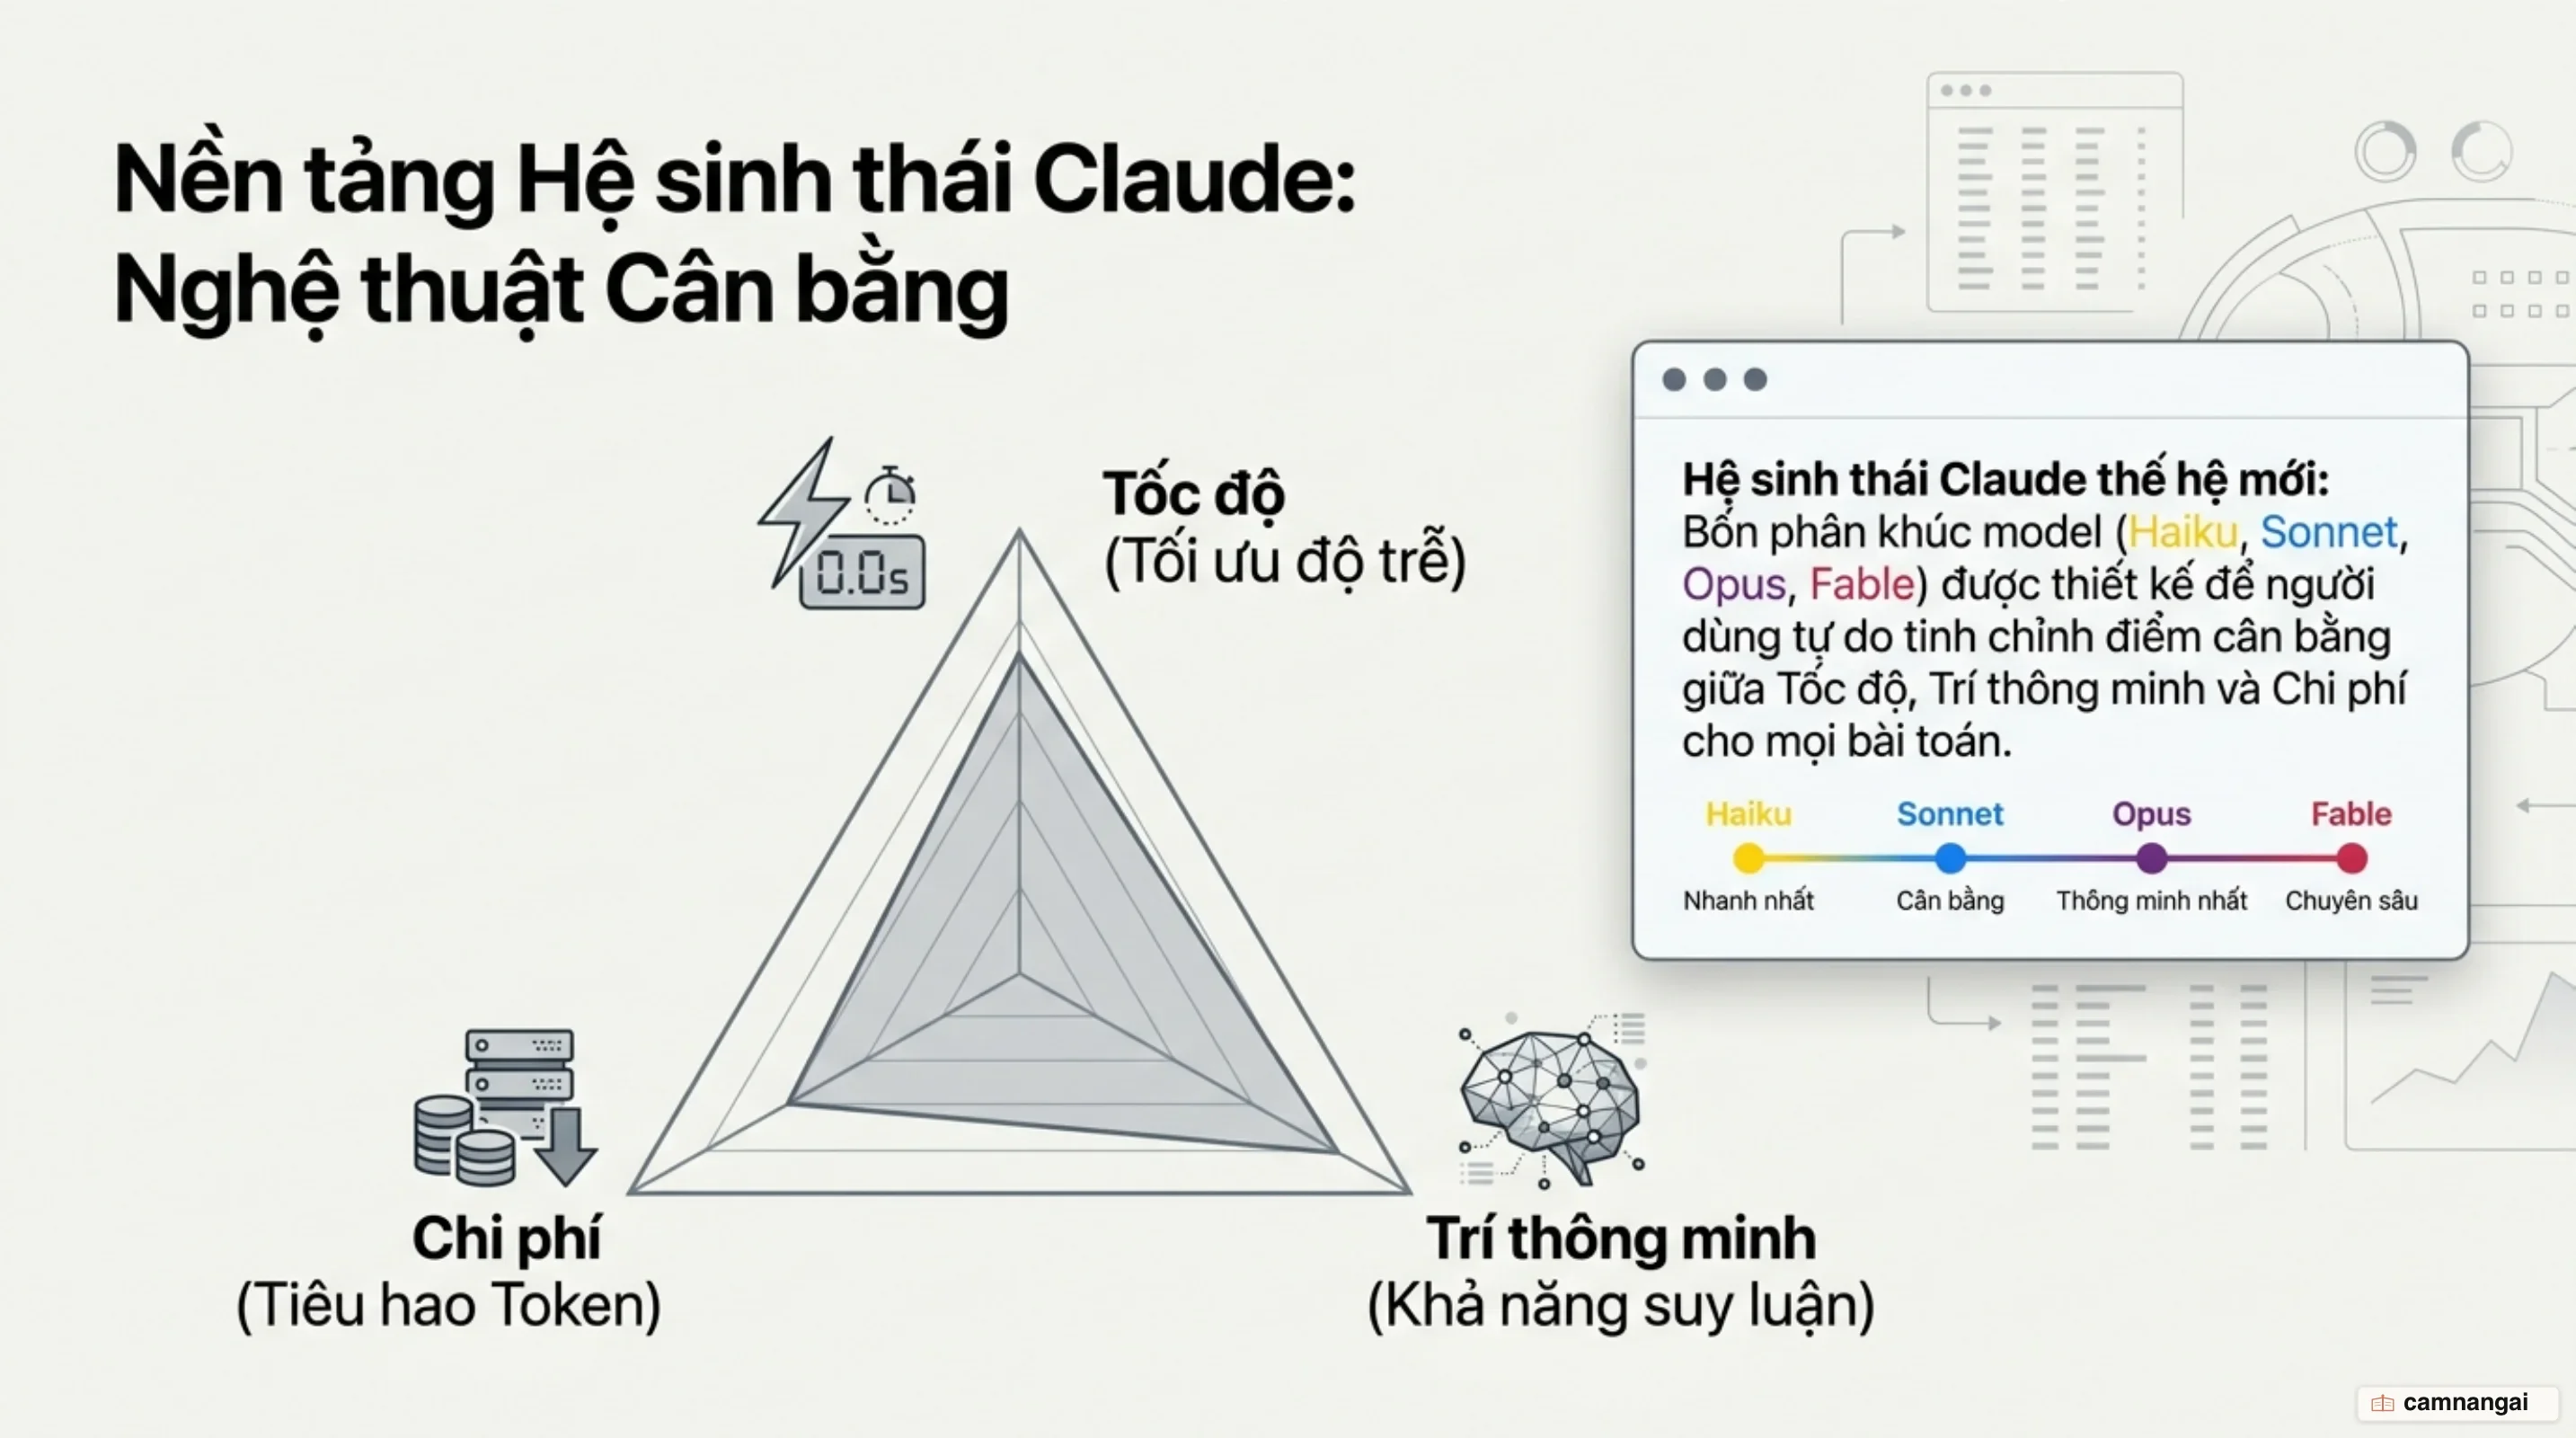
Bốn phân khúc model trong hệ sinh thái Claude
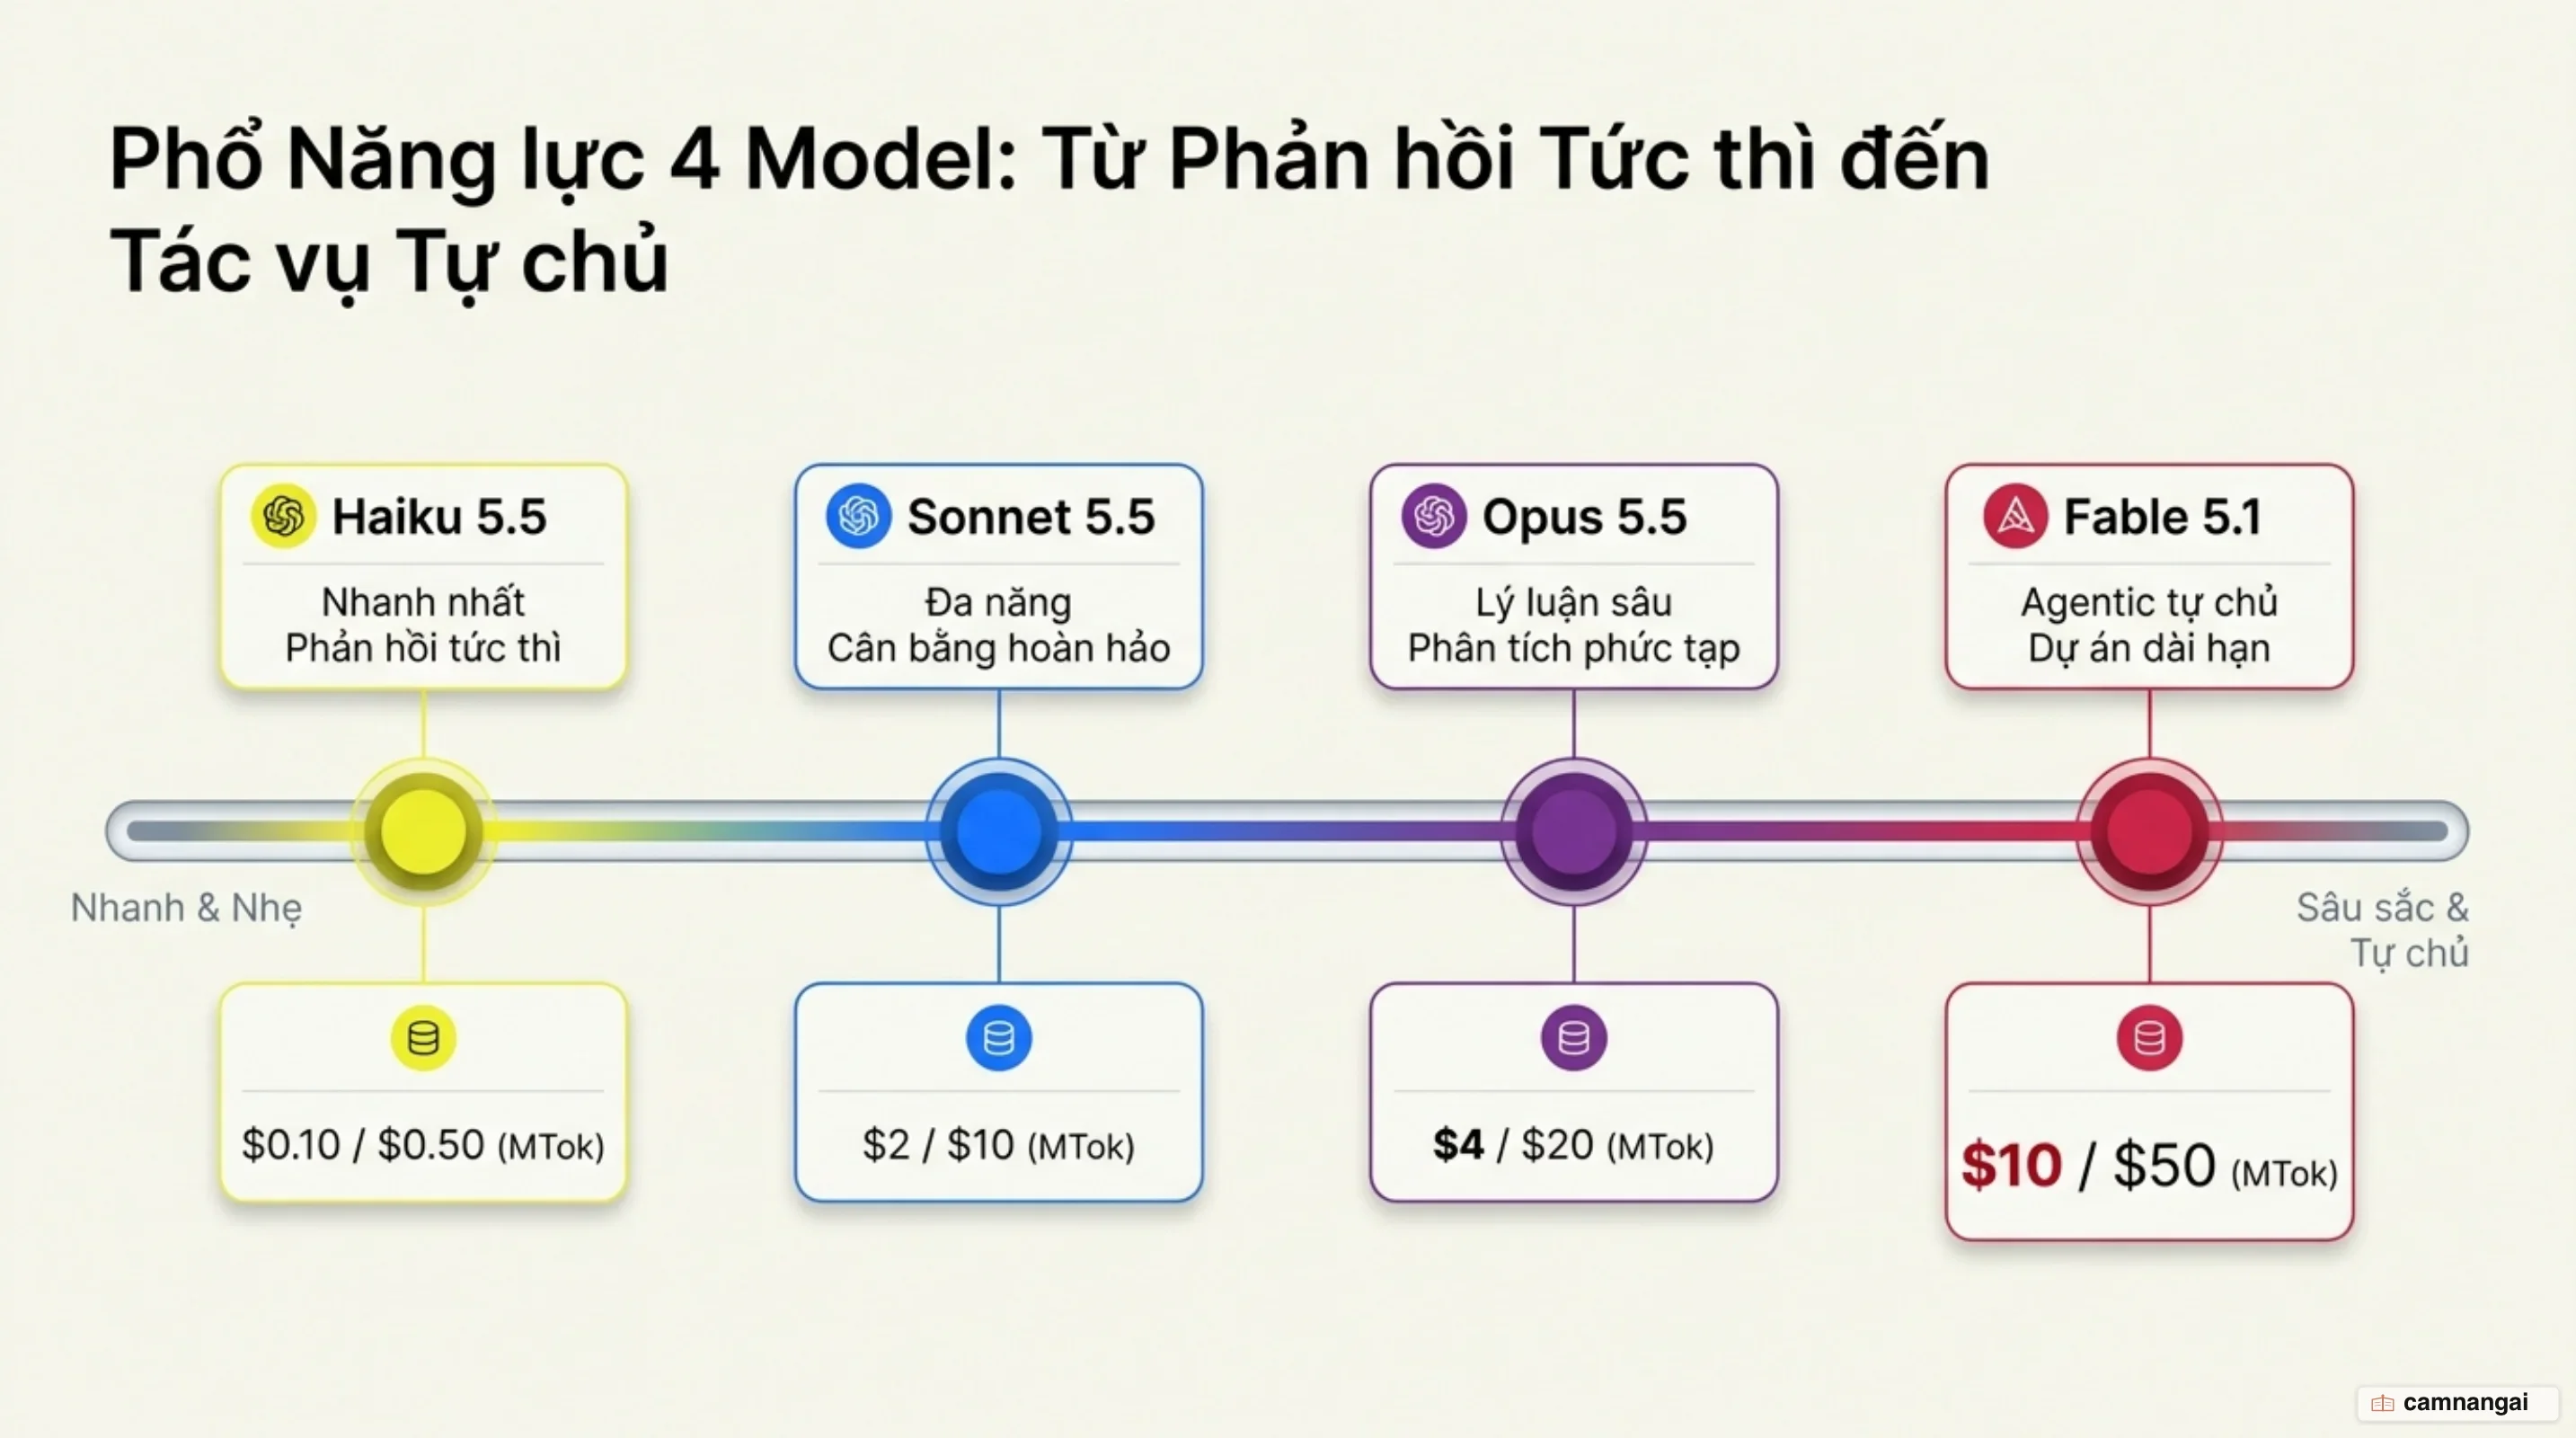
Hệ sinh thái Claude cung cấp 4 dòng model chính phục vụ các yêu cầu kỹ thuật và khối lượng tính toán khác nhau. Toàn bộ các model thế hệ hiện tại đều hỗ trợ cửa sổ ngữ cảnh (Context Window) lên tới 1 triệu token và dung lượng đầu ra tối đa (Max Output) đạt 128k token, với mốc dữ liệu huấn luyện (cutoff) tính đến tháng 6 năm 2026:
- Haiku 5.5 (
claude-haiku-5-5): Dòng model có tốc độ phản hồi nhanh nhất và tối ưu chi phí nhất ($0.10 input / $0.50 output per MTok). Model này được thiết kế chuyên biệt cho các tác vụ xử lý khối lượng lớn, nhạy cảm với độ trễ như phân loại, trích xuất dữ liệu, định tuyến yêu cầu và tóm tắt cơ bản. - Sonnet 5.5 (
claude-sonnet-5-5): Model mặc định đa năng ($2 input / $10 output per MTok). Sonnet 5.5 mang lại sự cân bằng tối ưu giữa tốc độ và trí thông minh, xử lý xuất sắc các tác vụ lập trình, sáng tác, phân tích, thao tác giao diện máy tính (computer use), thị giác máy tính (vision) cũng như khởi tạo tài liệu/bảng tính. - Opus 5.5 (
claude-opus-5-5): Chuyên gia lý luận quy mô lớn ($4 input / $20 output per MTok). Model được tối ưu hóa cho các bài toán chuyên sâu cần suy luận duy trì theo thời gian, phân tích tài liệu phức tạp và nghiên cứu khoa học. - Fable 5.1 (
claude-fable-5-1): Model cấp Mythos mạnh nhất ($10 input / $50 output per MTok). Fable 5.1 được thiết kế cho các tác vụ agentic dài hạn, có khả năng vận hành tự chủ cao: người dùng chỉ cần mô tả kết quả đầu ra mong muốn, model sẽ tự lập kế hoạch các bước và tự kiểm tra đánh giá lại kết quả trong suốt quá trình xử lý.
| Model | Chi phí (Input/Output per MTok) | Độ trễ (Latency) | Mức Effort mặc định | Ứng dụng tối ưu |
|---|---|---|---|---|
| Haiku 5.5 | $0.10 / $0.50 | Nhanh nhất | Medium | Trích xuất dữ liệu, phân loại, định tuyến, tóm tắt nhanh |
| Sonnet 5.5 | $2.00 / $10.00 | Nhanh | High | Lập trình, sáng tác, phân tích, quy trình đa bước |
| Opus 5.5 | $4.00 / $20.00 | Trung bình | Medium | Nghiên cứu sâu, lý luận phức tạp, phân tích tài liệu chuyên ngành |
| Fable 5.1 | $10.00 / $50.00 | Chậm hơn | High | Tác vụ agentic dài hạn, lập kế hoạch tự chủ quy mô lớn |
Tác động của từng model lên hạn mức sử dụng (rate limits)
Cơ chế rate limit áp đặt giới hạn số lượng token mà hệ thống của bạn có thể tiêu thụ trong một khoảng thời gian nhất định. Mức độ tiêu tốn tài nguyên phụ thuộc vào số lượng token lý luận (reasoning tokens) và độ sâu suy luận của mô hình. Thứ tự tiêu tốn hạn mức tăng dần theo cấp độ: Haiku (nhẹ nhất), tiếp đến Sonnet (trung bình), Opus (nặng), và Fable (nặng nhất). Việc lạm dụng Opus hoặc Fable cho các câu hỏi tra cứu đơn giản sẽ làm cạn kiệt hạn mức token rất nhanh mà không mang lại khác biệt về kết quả.
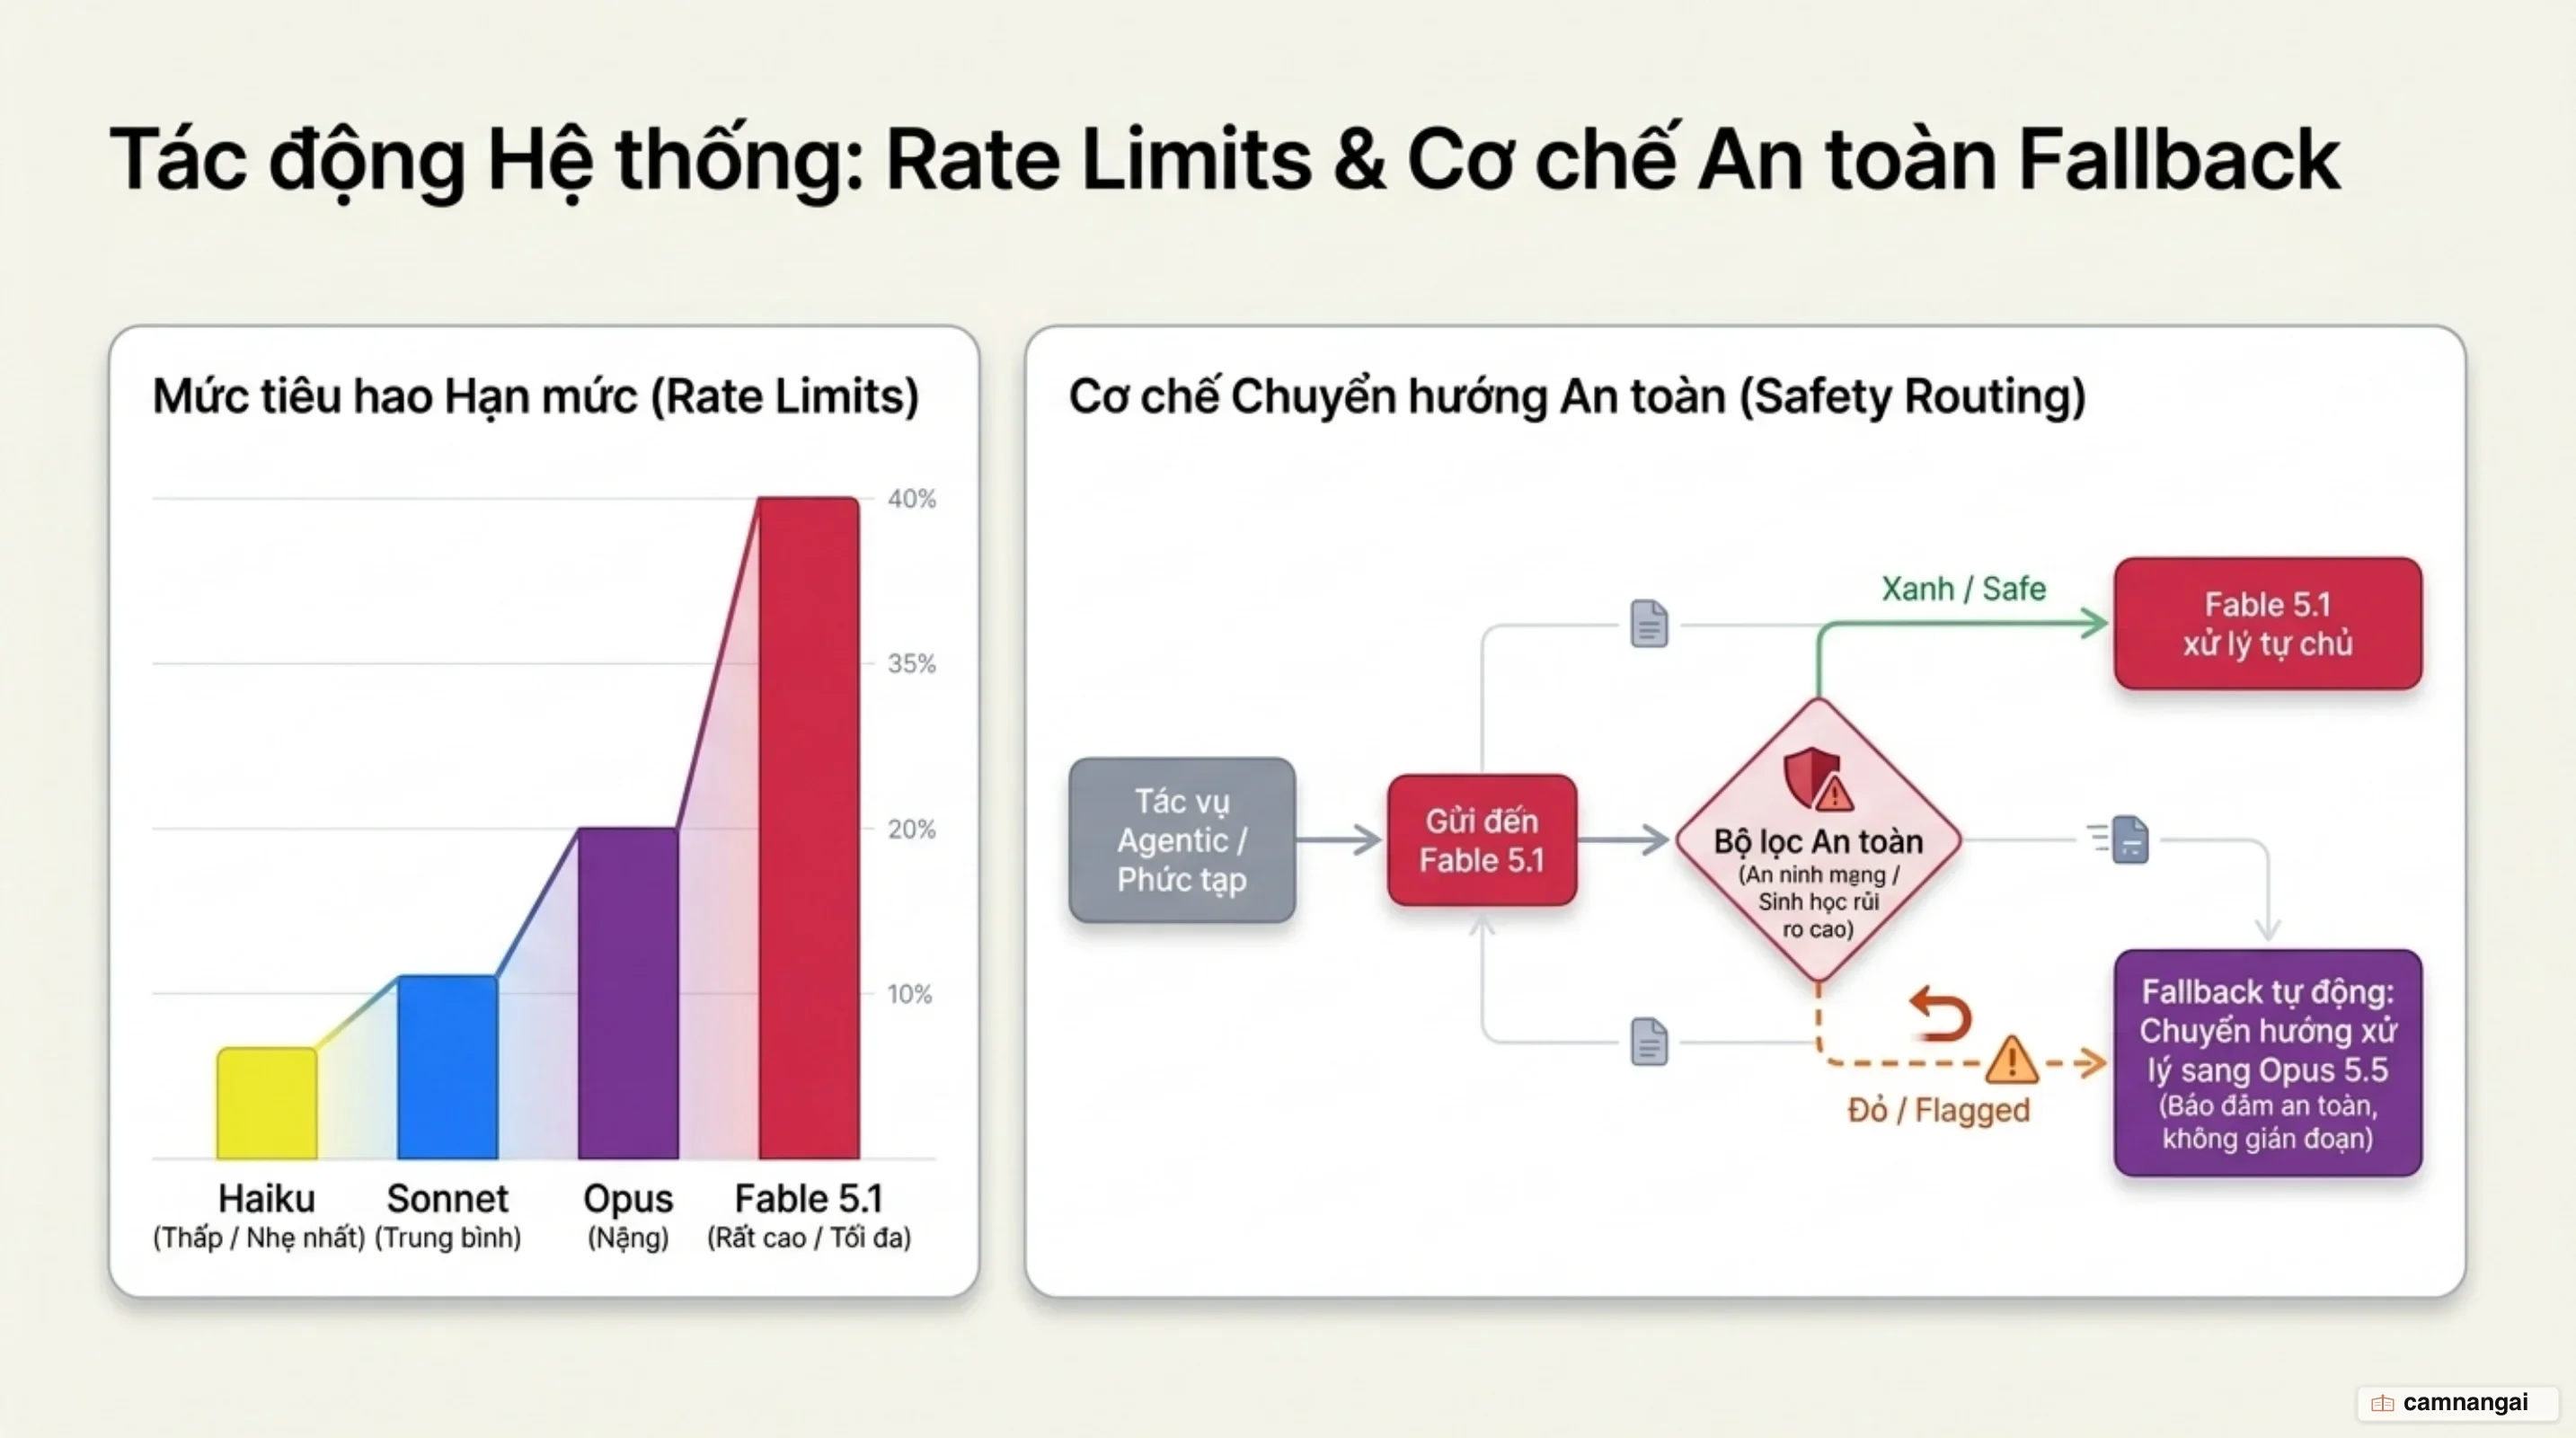
Đối với dòng Fable 5 và Fable 5.1, hệ thống tích hợp bộ phân loại an toàn (Safety Classifiers) tự động chạy trên mọi yêu cầu dịch vụ. Khi phát hiện các lệnh truy vấn rơi vào nhóm chủ đề có rủi ro cao (gồm kỹ thuật an ninh mạng tấn công, sinh học hay hóa học công dụng kép, tấn công chắt lọc mô hình hoặc các tác vụ phát triển hạ tầng LLM đặc thù), hệ thống sẽ tự động chuyển hướng yêu cầu sang dòng Opus (Opus 4.8 đối với an ninh mạng hoặc Opus 5 đối với sinh hóa) xử lý.
Cơ chế tính cước khi xảy ra fallback được quy định rõ:
- Các yêu cầu bị chặn trước khi model đưa ra phản hồi (blocked before output) do vi phạm an toàn biological, distillation hoặc hạ tầng LLM vẫn bị tính phí nhằm hạn chế các cuộc tấn công leo thang hệ thống.
- Các yêu cầu bị chặn midstream (khi đang phản hồi) sẽ tính phí trên số token input và output đã khởi tạo theo mức cước của model ban đầu.
- Phần phản hồi chuyển hướng sang Opus được tính phí riêng theo biểu giá của Opus, kèm theo khoản credit bù đắp chi phí trễ bộ nhớ đệm (cache miss).
Tiêu chí chọn model theo từng nhóm tác vụ lập trình
Trong thực tế kỹ thuật phần mềm, việc chọn model Claude được phân định dựa trên quy mô và độ phức tạp của codebase:
- Phân tích nhật ký, tra cứu code & trích xuất cú pháp: Sử dụng Haiku 5.5. Độ trễ cực thấp của Haiku 5.5 cho phép xử lý tức thì các công việc định tuyến thông tin, phân loại lỗi cú pháp hoặc kiểm tra log hệ thống mà không tốn nhiều hạn mức.
- Viết code hàng ngày, Debugging & Refactoring: Sử dụng Sonnet 5.5. Đây là công cụ chủ lực xử lý đa số các tác vụ lập trình thực tế. Sonnet 5.5 tích hợp tốt với các công cụ phát triển như Claude Code, xử lý hiệu quả các luồng làm việc đa agent (multi-agent workflows) và cung cấp phản hồi nhanh chóng trong quá trình tương tác trực tiếp.
- Phân tích kiến trúc phức tạp & Tối ưu thuật toán: Sử dụng Opus 5.5. Chuyển sang Opus 5.5 khi Sonnet 5.5 gặp rào cản đối với các bài toán yêu cầu lý luận cấu trúc toán học phức tạp, phân tích lỗ hổng sâu hoặc phân tích tài liệu kỹ thuật dài.
- Chuyển đổi codebase quy mô lớn & Tác vụ Agentic dài hạn: Sử dụng Fable 5.1. Thực tế triển khai tại Stripe cho thấy Fable 5 đã nén công việc kỹ thuật từ nhiều tháng xuống còn nhiều ngày: xử lý chuyển đổi toàn bộ codebase Ruby gồm 50 triệu dòng code trong đúng 1 ngày, thay vì một đội ngũ kỹ sư phải làm thủ công hơn 2 tháng. Báo cáo đánh giá trên benchmark FrontierCode của Cognition ghi nhận Fable đạt điểm số cao nhất nhờ năng lực tự lập kế hoạch, duy trì bộ nhớ dài hạn dạng tệp (persistent file-based memory) và các vòng lặp tự sửa lỗi (self-correction loops) ổn định qua hàng triệu token.
Thử nghiệm cùng một prompt trên hai model: Bài học thực tế
Phương pháp luận kiểm thử hiệu năng đòi hỏi việc thực thi thực nghiệm đối chứng trên cùng một câu lệnh đầu vào. Bạn có thể gửi cùng một prompt (ví dụ: tóm tắt báo cáo kỹ thuật hoặc phân tích một đoạn mã nguồn) qua Haiku 5.5 trước, sau đó mở một cửa sổ chat mới và chạy lại chính prompt đó trên Sonnet 5.5 hoặc Opus 5.5.
Tiêu chí đánh giá bài mẫu dựa trên độ sâu lý luận, độ chính xác và điểm mù (blind spots) của câu trả lời, tuyệt đối không so sánh dựa trên độ dài văn bản hay số lượng từ.
Nguyên tắc ra quyết định kỹ thuật: Nếu đầu ra từ Haiku 5.5 đã phản ánh đầy đủ các điểm then chốt và đáp ứng đúng tiêu chuẩn kiểm tra của bạn, tác vụ đó nên được cố định ở phân khúc Haiku. Bạn chỉ nên nâng cấp luồng xử lý lên Sonnet, Opus hoặc Fable khi thử nghiệm thực tế chứng minh mô hình cấp thấp hơn bỏ sót các chi tiết cốt lõi, làm ảnh hưởng đến quyết định kỹ thuật của hệ thống.
Khi nào nên tinh chỉnh effort thay vì đổi model?
Trước khi quyết định chuyển đổi giữa các dòng model, việc điều chỉnh thông số Effort (Mức độ nỗ lực) và Thinking (Suy luận mở rộng) là giải pháp tối ưu hóa chi phí cần cân nhắc. Thang đo Effort kiểm soát mức độ đào sâu suy luận của mô hình trước khi trả lời. Mức Effort cao hơn giúp câu trả lời kỹ lưỡng hơn nhưng sẽ tăng thời gian phản hồi và tiêu tốn nhiều token hơn.
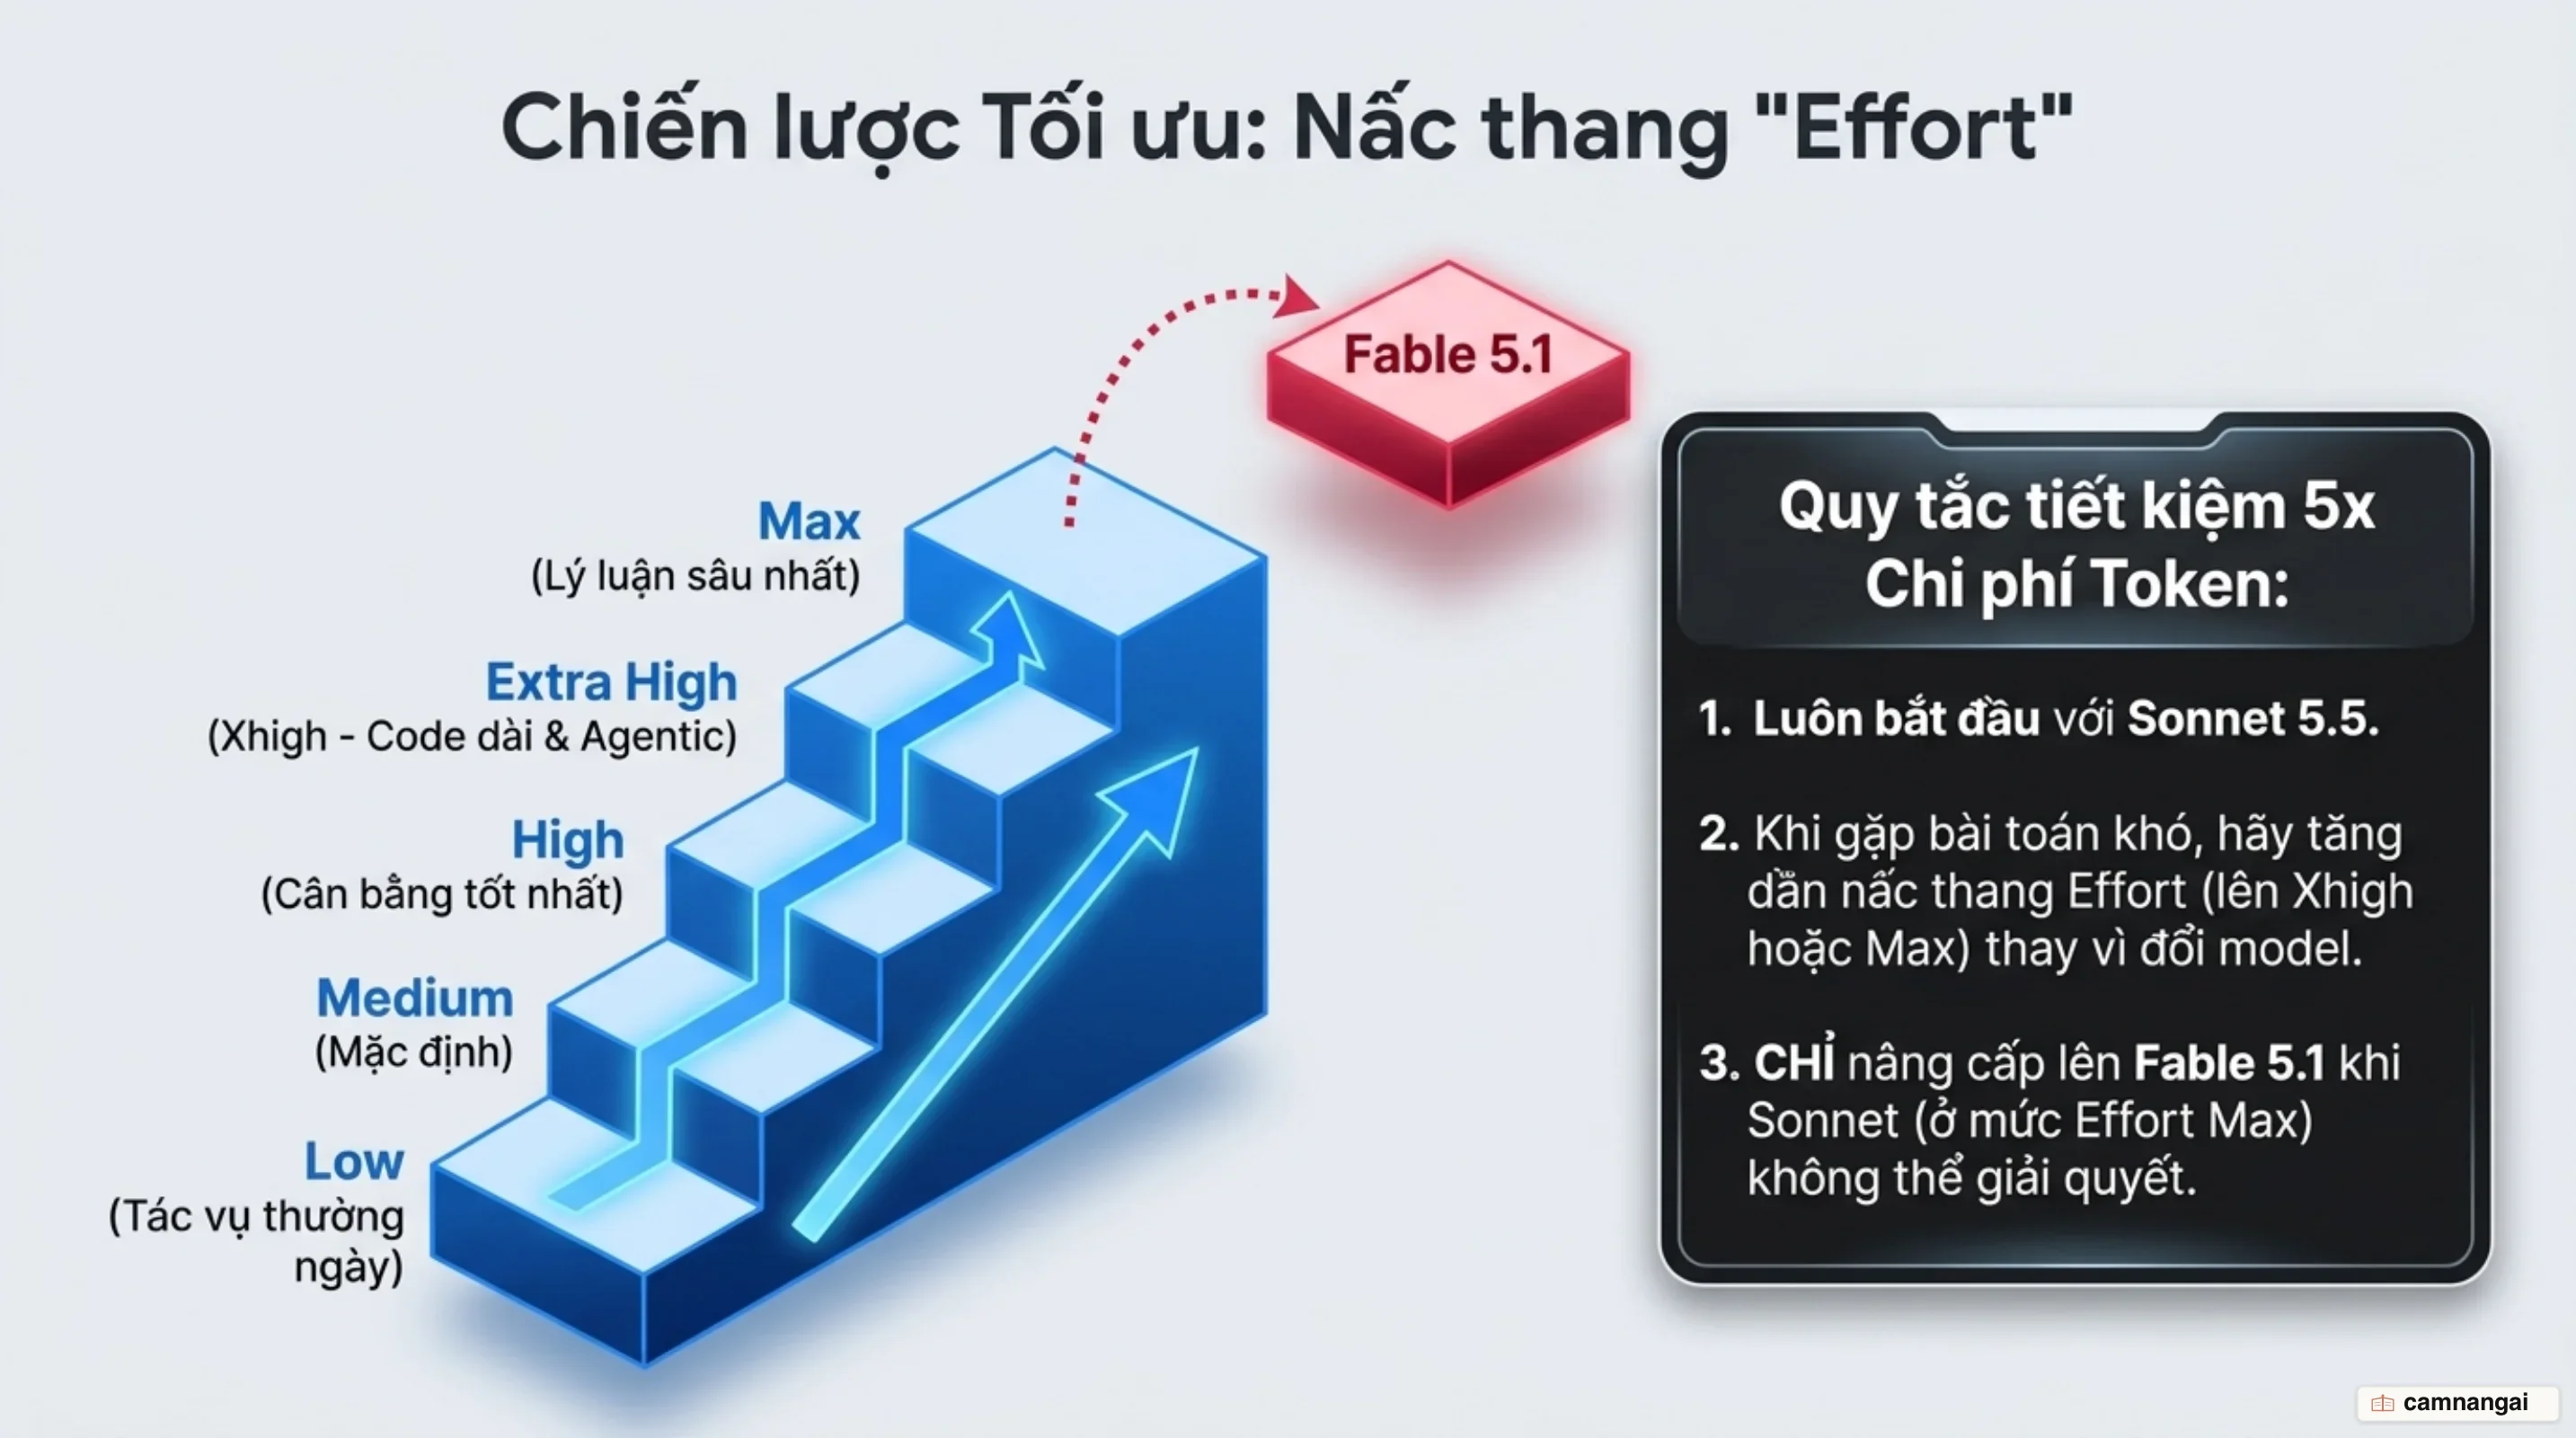
Các cấp độ Effort bao gồm:
- Low / Medium: Phù hợp cho các tác vụ thường nhật, giúp tiết kiệm tối đa hạn mức token.
- High: Mức mặc định mang lại sự cân bằng tốt nhất giữa chất lượng và tốc độ.
- Extra High (xhigh): Thiết kế cho các tác vụ lập trình dài hạn và quy trình agentic (khả dụng từ Opus 4.7 trở lên), cung cấp khả năng lý luận sâu mà không tốn chi phí token tối đa như Max.
- Max: Mức độ lý luận tối đa, dành riêng cho các bài toán tối quan trọng đòi hỏi độ chính xác tuyệt đối.
Về chế độ suy luận (Thinking): Trên Opus 5.5 và Fable 5.1, tính năng suy luận tự điều chỉnh (Adaptive thinking) luôn ở trạng thái bật bắt buộc ở mọi mức effort (kể cả trên Claude API). Đối với Sonnet 5.5 và Haiku 5.5, bạn có thể bật/tắt hoặc tinh chỉnh qua API. Cần lưu ý rằng nếu đặt cấu hình thinking thành disabled trực tiếp trên Claude API cho Sonnet 5.5 mà không điều chỉnh tham số công cụ, hệ thống sẽ trả về lỗi 400 Bad Request. Để tắt lượt suy luận ban đầu một cách an toàn mà không gây gián đoạn API, bạn phải sử dụng thiết lập between_tools—khi đó model chỉ thực hiện suy luận giữa các lượt gọi công cụ (tool calls), giúp giữ nguyên hoặc tối ưu tốc độ phản hồi.
Lời khuyên kiến trúc: Trước khi nâng cấp từ Sonnet 5.5 lên Fable 5.1 (làm tăng chi phí token lên 5 lần), bạn nên nâng thông số Effort của Sonnet 5.5 lên High hoặc Extra High, hoặc chuyển sang Opus 5.5 với Effort cao để đánh giá tương quan hiệu năng / chi phí.
Đưa ra quyết định: Bắt đầu từ đâu cho dự án của bạn?
Quy trình chuẩn hóa hạ tầng AI đòi hỏi việc thiết lập Sonnet 5.5 làm model mặc định cho toàn bộ luồng công việc phát triển, lập trình và xử lý dữ liệu ban đầu.
Việc dịch chuyển phân khúc phải dựa trên dữ liệu đo lường thực tế (evals): Hạ cấp luồng xử lý xuống Haiku 5.5 đối với các API endpoints yêu cầu độ trễ phản hồi tính bằng mili-giây và tối ưu chi phí vận hành. Ngược lại, chỉ tăng mức Effort hoặc chuyển đổi sang Opus 5.5 / Fable 5.1 khi dữ liệu kiểm thử thực tế xác nhận Sonnet 5.5 không đạt ngưỡng độ chính xác yêu cầu đối với các tác vụ agentic phức tạp hoặc quy trình xử lý dài hạn.
Tài liệu tham khảo
- Change the model, effort, and thinking settings — Claude Help Center
- Choosing the right Claude model: Haiku, Sonnet, Opus, or Fable — Claude Academy
- Claude Fable 5 and Claude Mythos 5 — Anthropic
- Models overview — Claude Platform Docs
- Why Claude switched models in your conversation with Fable 5 or Fable 5.1 — Claude Help Center