Gõ code ngẫu hứng () từng câu lệnh đơn lẻ đã chạm ngưỡng giới hạn năng suất. Kỹ thuật phần mềm hiện đại đang chuyển dịch toàn bộ sang mô hình nhà máy phần mềm (Software Factory)—hệ thống tự động hóa toàn bộ vòng đời phát triển phần mềm (SDLC) dựa trên các vòng lặp agent (agent loops) được đóng khung chặt chẽ. Nguyên lý vận hành cốt lõi ở đây rất gãy gọn: con người định hướng ("Humans steer") và agent chịu trách nhiệm thực thi ("Agents execute").
Là một kỹ sư kiến trúc hạ tầng, tôi khẳng định với bạn rằng viết code thủ công không còn là lợi thế cạnh tranh. Khi năng lực suy luận của model tiến hóa, công việc của chúng ta không phải là ngồi gõ từng hàm logic hay đi sửa từng lỗi lặt vặt. Chúng ta chuyển sang làm meta-engineering: thiết kế môi trường thực thi, đóng gói ngữ cảnh, thiết lập các ranh giới kiến trúc và bảo vệ các cổng kiểm duyệt chất lượng để agent tự do chạy song song ở quy mô lớn.
Từ vibe coding đến nhà máy phần mềm: Vì sao kỹ thuật phần mềm trở thành kỹ thuật nhà máy?
Sự chuyển dịch từ gõ code thủ công ngẫu hứng sang tư duy kỹ thuật nhà máy là một bước tiến tất yếu về mặt kiến trúc hạ tầng. Để vận hành mô hình này một cách tin cậy, hệ thống phải được phân tầng rõ ràng theo ba cấp độ: Vòng lặp (Loop) -> Khung điều hướng (Harness) -> Nhà máy (Factory).
Vòng lặp (Loop) là đơn vị cơ bản nhất. Đây là một agent thực hiện lặp đi lặp lại một tác vụ theo chu trình: thu thập ngữ cảnh -> hành động -> kiểm tra kết quả -> lặp lại cho đến khi đạt điều kiện hoàn thành. Khung điều hướng (Harness) là môi trường bao bọc lấy vòng lặp, cung cấp sandbox cách ly, công cụ truy cập, bộ nhớ lưu trữ giữa các phiên chạy và thiết lập các cổng kiểm duyệt (gate) để xác định tiêu chuẩn hoàn thành. Nhà máy phần mềm (Factory) là một sơ đồ tổ chức gồm nhiều vòng lặp đã được đóng khung, chạy song song hoặc nối tiếp, được cấp hàng chờ công việc và đổ kết quả về cổng duyệt (review gate) dưới sự giám sát toàn cục của con người.
Thực tế hạ tầng tại OpenAI chứng minh hiệu quả vượt trội của mô hình này: một đội ngũ chỉ gồm 3 đến 7 kỹ sư đã xây dựng một sản phẩm thử nghiệm đạt quy mô 1 triệu dòng code thông qua khoảng 1.500 Pull Request (PR) được hợp nhất trong 5 tháng. Đội ngũ này không viết tay một dòng code ứng dụng nào, đạt năng suất trung bình 3.5 PR/kỹ sư/ngày và tiếp tục gia tăng khi mở rộng quy mô. Để đạt được tốc độ này, harness của họ phải biến ứng dụng thành môi trường có khả năng quan sát cao (legibility) cho agent: mỗi tác vụ chạy trên một instance ứng dụng riêng biệt nhờ cách ly git worktree, tích hợp Chrome DevTools Protocol để agent tự chụp DOM snapshot, screenshot và dựng bộ quan sát ephemeral (PromQL/LogQL) cho phép agent tự truy vấn log để tối ưu latency hay sửa lỗi khởi động dịch vụ. Ngoài ra, họ còn duy trì các background agent tự động rà soát và dọn dẹp mã nguồn rác (AI slop) hàng tuần.
Gốc rễ của nhà máy phần mềm không mới, nó đã được Bob Bemer khởi xướng từ bài báo về kinh tế học sản xuất phần mềm năm 1968 và mô hình Software Works của Hitachi năm 1969. Tuy nhiên, ở thế kỷ trước, ý tưởng này sụp đổ vì việc tự động hóa các ý tưởng sáng tạo bằng công cụ cơ học là vô vọng. Chỉ đến khi và các hệ thống harness hiện đại ra đời, mô hình nhà máy phần mềm mới thực sự khả thi.
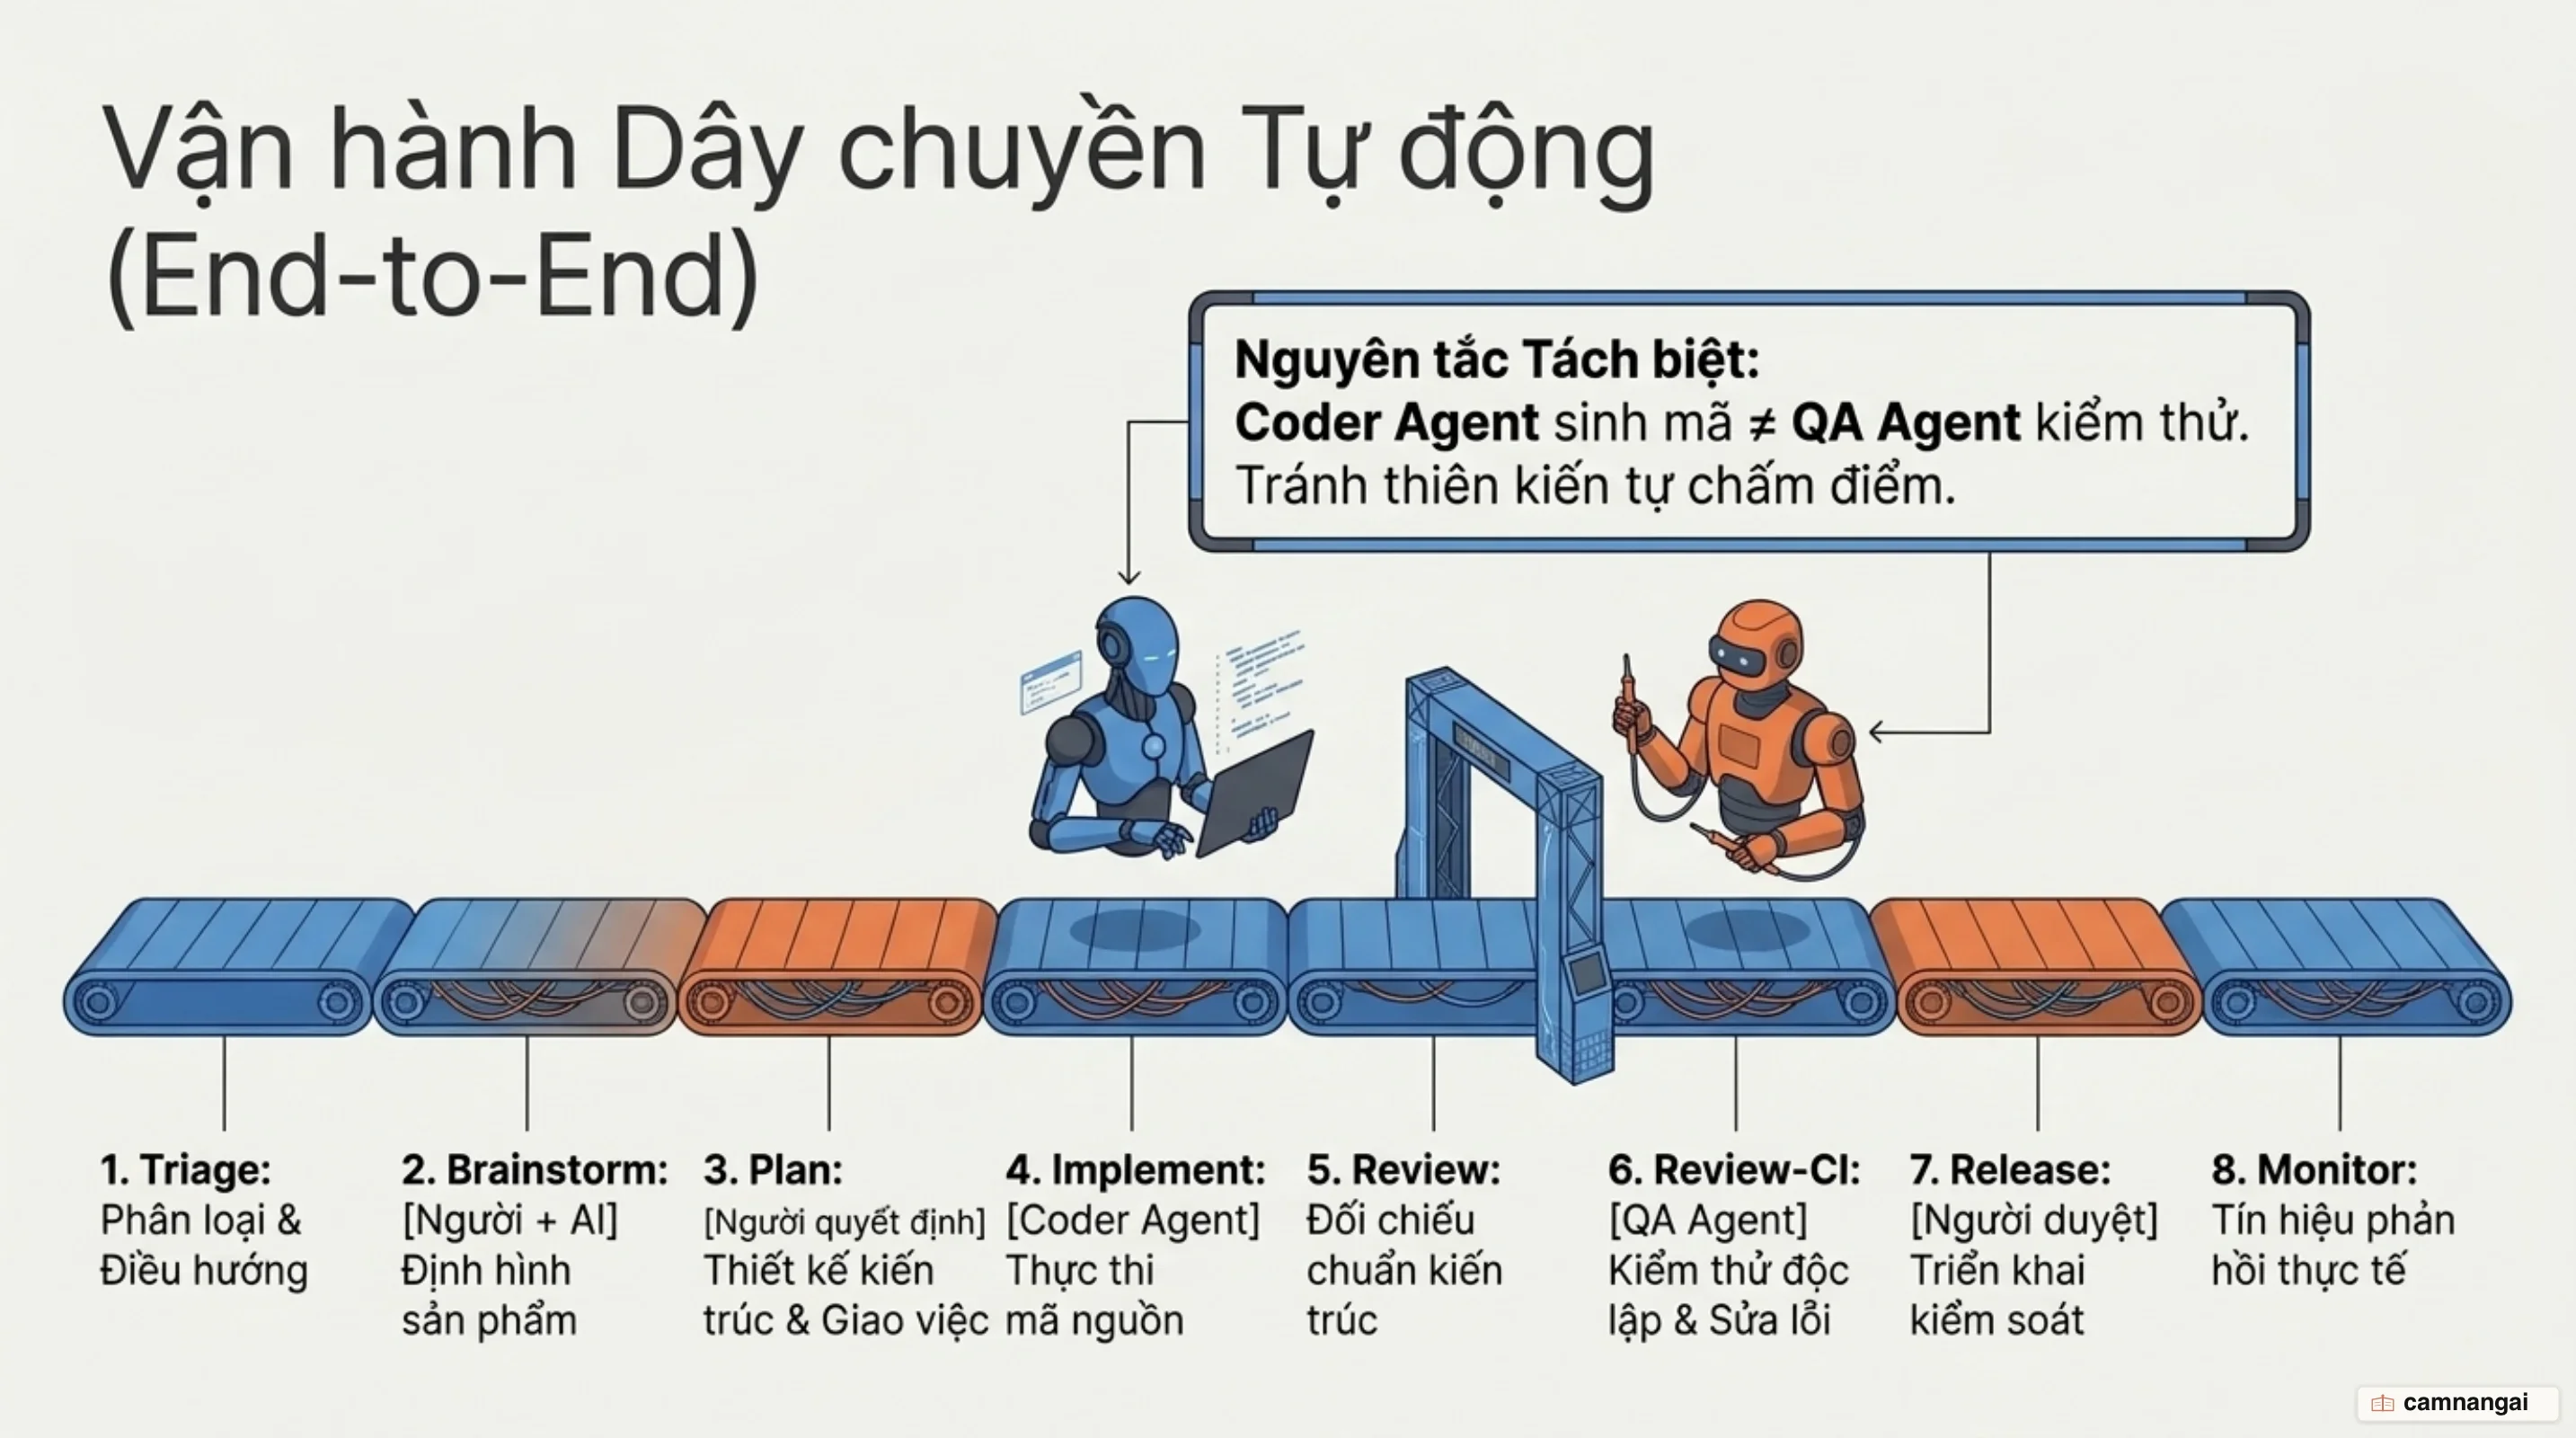
Dây chuyền 8 công đoạn: Từ tiếp nhận yêu cầu đến vòng lặp cải tiến liên tục
Một nhà máy phần mềm tiêu chuẩn vận hành dựa trên dây chuyền 8 công đoạn nối tiếp, chia thành 3 nhóm chức năng chính nhằm đảm bảo tính minh bạch và khả năng kiểm soát.
Nhóm thứ nhất: Xác định nội dung cần xây dựng (What to build)
- Triage/Intake: Phân loại, khử trùng lặp và định tuyến các báo cáo lỗi, yêu cầu tính năng hay sự cố hạ tầng từ người dùng và hệ thống monitoring.
- Brainstorming: Phân tích dữ liệu người dùng, đối thủ cạnh tranh và tài liệu kỹ thuật để tìm ra các tính năng có giá trị cao. Đây là nơi gu sản phẩm và phán đoán của con người giữ vai trò quyết định.
- Planning: Khâu quan trọng nhất trong toàn bộ dây chuyền. Agent làm việc ở chế độ chỉ đọc (read-only), truy vấn codebase và tầng ngữ cảnh, liên tục đặt câu hỏi ngược lại cho kỹ sư để làm rõ điểm mơ hồ. Kết quả của khâu này là bản nhật ký quyết định kiến trúc (ADR), danh mục thuật ngữ (glossary) và các ticket kỹ thuật được đóng gói chuẩn hóa.
Nhóm thứ hai: Xây dựng và kiểm tra (Actual building & checking)
- Implementing: Vòng lặp giữa agent lập trình và agent QA. Tôi bắt buộc phải tách biệt agent QA ra khỏi agent lập trình, bởi vì model tạo ra code luôn quá vị tha và thiên vị khi tự chấm điểm bài làm của chính mình. Agent QA được cấp lệnh kích hoạt toàn bộ môi trường để test như một người dùng thực tế.
- Review: Kiểm tra PR diff so với yêu cầu sản phẩm, tiêu chuẩn kiến trúc ADR và quét sạch "AI slop" (các đoạn comment rác hoặc tên hàm rườm rà).
- Review-CI: Chạy bộ test suite tự động. Nếu xuất hiện lỗi, một agent sửa lỗi (fixing agent) sẽ lập tức được kích hoạt để khắc phục.
- Release: Triển khai tự động lên môi trường staging hoặc production dưới sự kiểm duyệt phát hành của con người.
Nhóm thứ ba: Tự cải tiến (Self-improving)
- Monitor/Incident response: Thu thập tín hiệu thực tế từ môi trường vận hành (alert, log, sự cố) để đẩy ngược dữ liệu vào khâu Triage, đóng kín vòng lặp sản xuất.
Ranh giới kiểm soát được phân định rất rõ: con người hiện diện đậm nét nhất ở khâu Brainstorming và Planning nhằm định hình kiến trúc, cùng cổng duyệt PR cuối cùng. Các agent sẽ làm chủ toàn bộ các bước thực thi ở giữa.
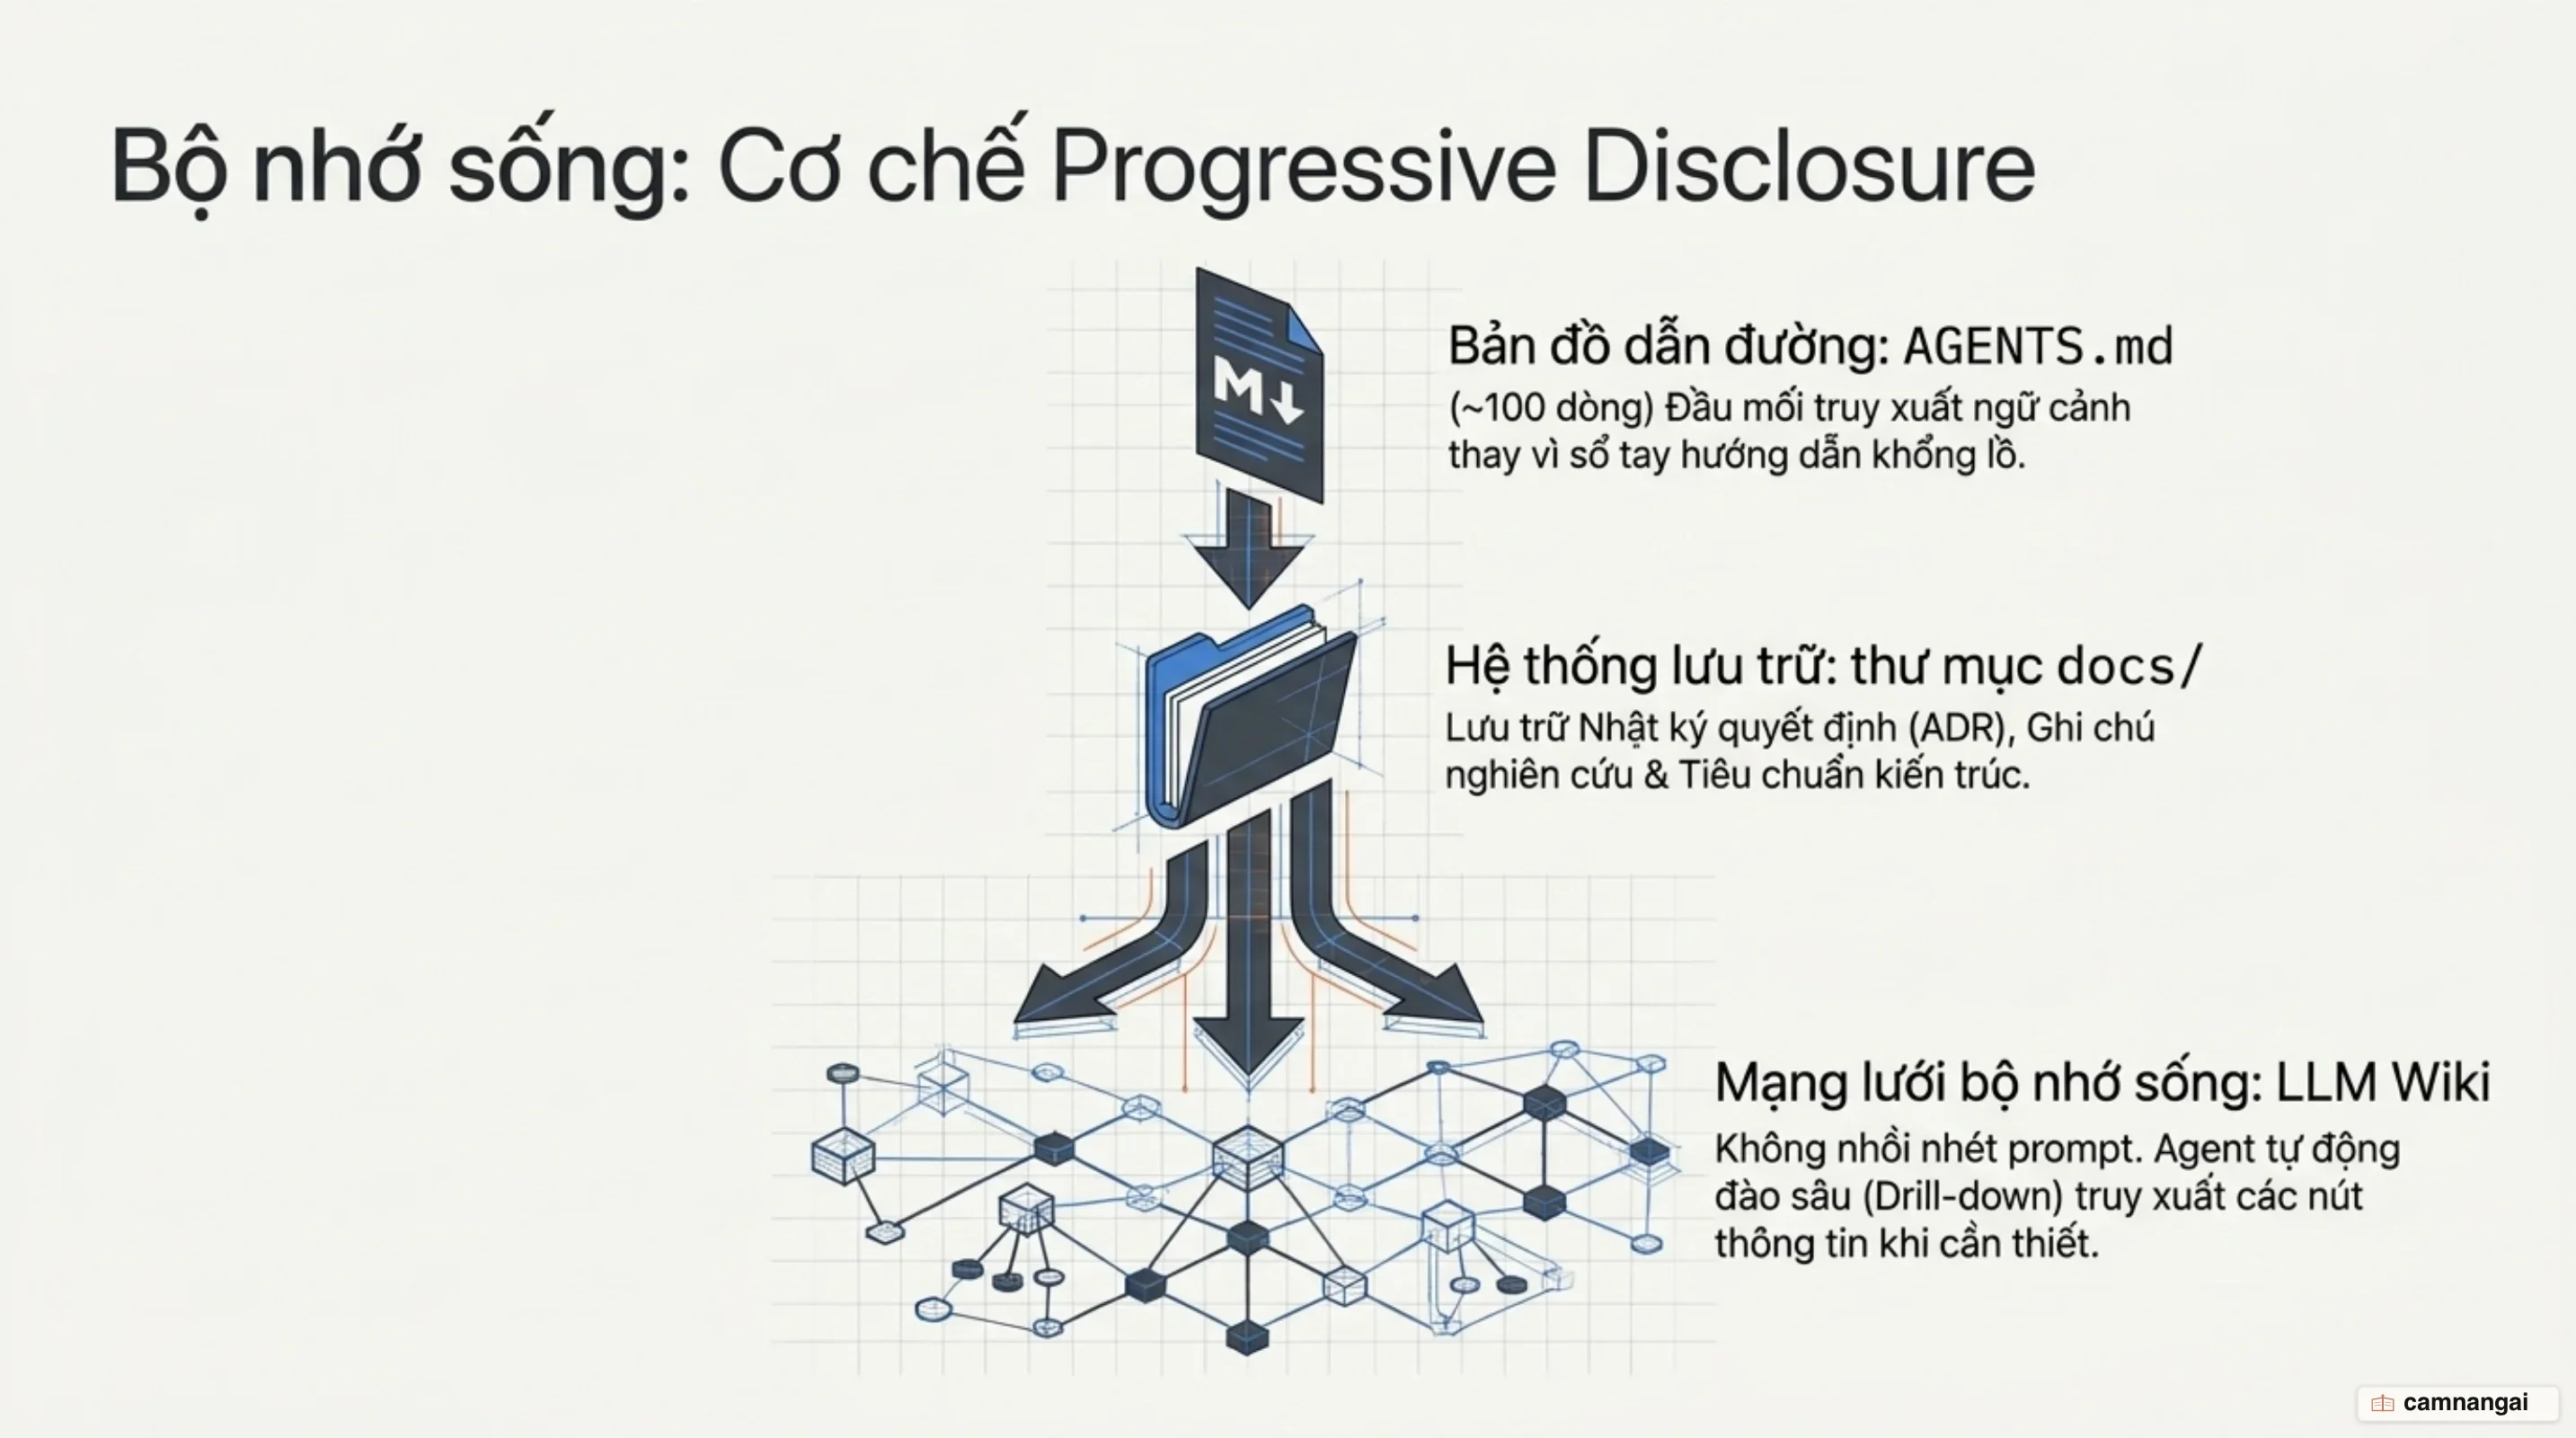
Tầng ngữ cảnh (Context Layer): Bộ nhớ sống nuôi dưỡng toàn bộ dây chuyền bằng LLM Wiki
Tầng ngữ cảnh (Context Layer) là mạch máu nuôi dưỡng toàn bộ dây chuyền tự động hóa. Tôi đã thấy nhiều đội ngũ thất bại khi cố gắng nhồi nhét tất cả quy định vào một file AGENTS.md khổng lồ. File quá lớn sẽ làm lãng phí của model, gây nhiễu thông tin khiến agent bỏ qua các quy chuẩn quan trọng, nhanh chóng bị lỗi thời và cực kỳ khó kiểm tra tự động.
Giải pháp kiến trúc chuẩn xác là cấu trúc hóa tri thức theo nguyên lý phân tầng:
- Sử dụng file
AGENTS.mdngắn gọn (~100 dòng) đóng vai trò làm "Mục lục / Bản đồ" chỉ đường. - Đặt toàn bộ tri thức chuyên sâu vào thư mục
docs/được cấu trúc hóa (chứadesign-docs,exec-plans,product-specs,references) làm nguồn sự thật (system of record).
Áp dụng mô hình LLM Wiki (theo chuẩn Open Knowledge Format), dữ liệu thô được chuyển đổi thành bộ tri thức dạng Markdown phẳng kết hợp với YAML frontmatter và hệ thống liên kết liên trang. Cơ chế này cho phép thực thi truy xuất ngữ cảnh phân tầng (Progressive Disclosure): agent bắt đầu bằng việc đọc file index.yaml để nắm bản đồ tổng quan, truy cập trang nguồn Wiki khi cần thêm chi tiết, đọc các bản tạo (entities, concepts, comparisons), và chỉ mở các file code hoặc tài liệu thô khi thực sự bắt buộc. Điều này giúp giữ context window luôn tinh gọn và tiết kiệm .
Đối với bộ nhớ cá nhân hoặc ghi chú của kỹ sư (như Obsidian vận hành theo phương pháp PARA), nguyên tắc kiến trúc bắt buộc là giữ ở dạng bất biến (read-only). Hệ thống chỉ chiết xuất ngữ cảnh cần thiết sang môi trường dự án thông qua các lượt deep research, tuyệt đối không cho phép agent tự ý ghi đè hay sửa đổi các ghi chú gốc của con người.
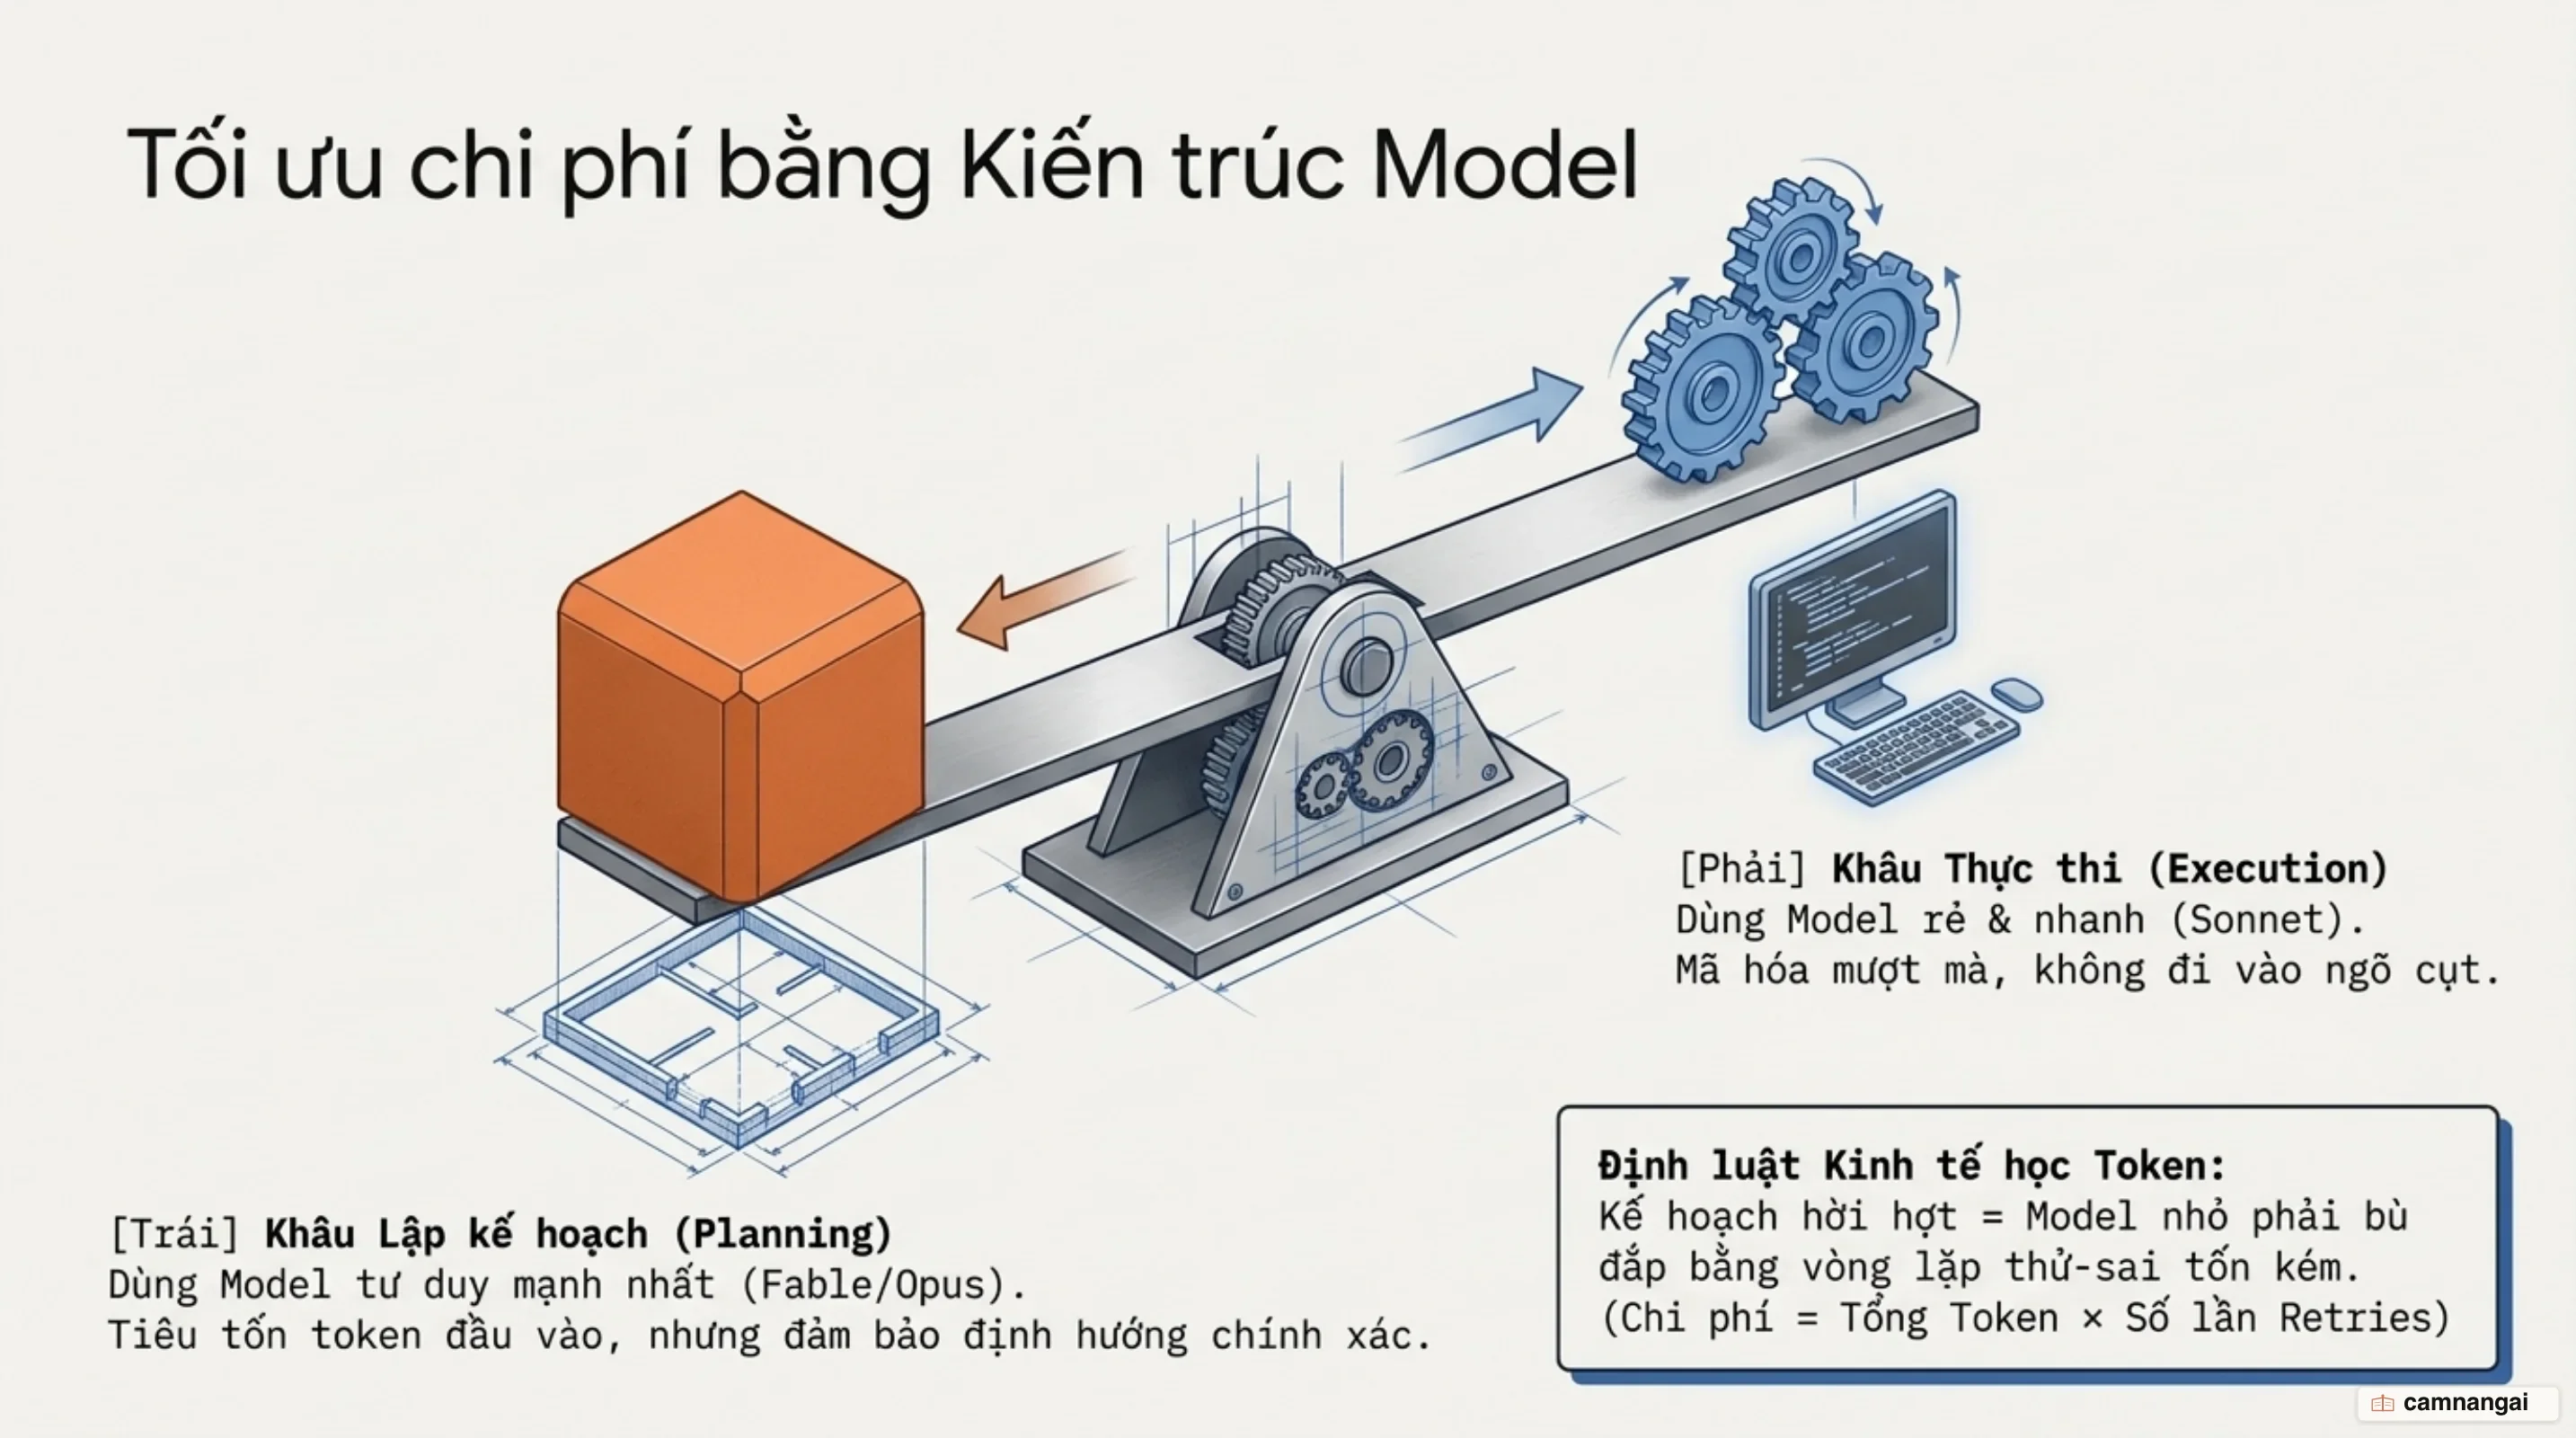
Kinh tế học phân tầng model: Vì sao dồn token vào khâu lập kế hoạch lại giúp tiết kiệm chi phí?
Vận hành nhà máy phần mềm đòi hỏi sự tính toán chính xác về mặt kinh tế học. Trong đó xuất hiện một nghịch lý chi phí: việc sử dụng các model mạnh nhất và đắt nhất (như Fable, Opus hay GPT-5) cho khâu Brainstorming và Planning tưởng chừng tốn kém, nhưng lại giúp tổng chi phí vận hành rẻ hơn nhiều so với việc dùng model rẻ (như Sonnet) ngay từ đầu với một bản kế hoạch kém chất lượng.
Bản chất toán học của chi phí được tính theo công thức:
Tổng chi phí = Số lượng token × Giá mỗi tokenMột bản kế hoạch mơ hồ sẽ bắt model rẻ phải suy luận nhiều vòng, liên tục thử sai, gặp lỗi và sinh ra hàng loạt token lặp lại. Tổng số token phát sinh từ các vòng lặp thất bại này sẽ nhanh chóng vượt xa chi phí dùng model cao cấp ngay từ đầu. Một bản kế hoạch chuẩn xác giúp các model thực thi rẻ tiền chạy một mạch đến mục tiêu mà không bị sa vào các ngõ cụt.
Để tối ưu hóa chi phí hơn nữa, tôi áp dụng chiến lược "Hệ thống quy tắc nghiêm ngặt bên ngoài" (Invariants & Linters). Bằng cách sử dụng linter tĩnh và các bài test cấu trúc, tôi ép agent phải tuân thủ ranh giới kiến trúc cố định (ví dụ luồng dữ liệu một chiều: Types -> Config -> Repo -> Service -> Runtime -> UI). Khi agent vi phạm quy tắc, linter tĩnh sẽ chặn lại và bơm trực tiếp hướng dẫn khắc phục (remediation instructions) vào context window của agent. Việc xử lý lỗi ngay ở tầng linter giúp loại bỏ hoàn toàn các vòng lặp suy luận (reasoning loops) đắt đỏ với chi phí token bằng 0.
Bài học chống ôm đồm từ dự án Squid: Đừng biến nhà máy thành cỗ máy nguyên khối mất kiểm soát
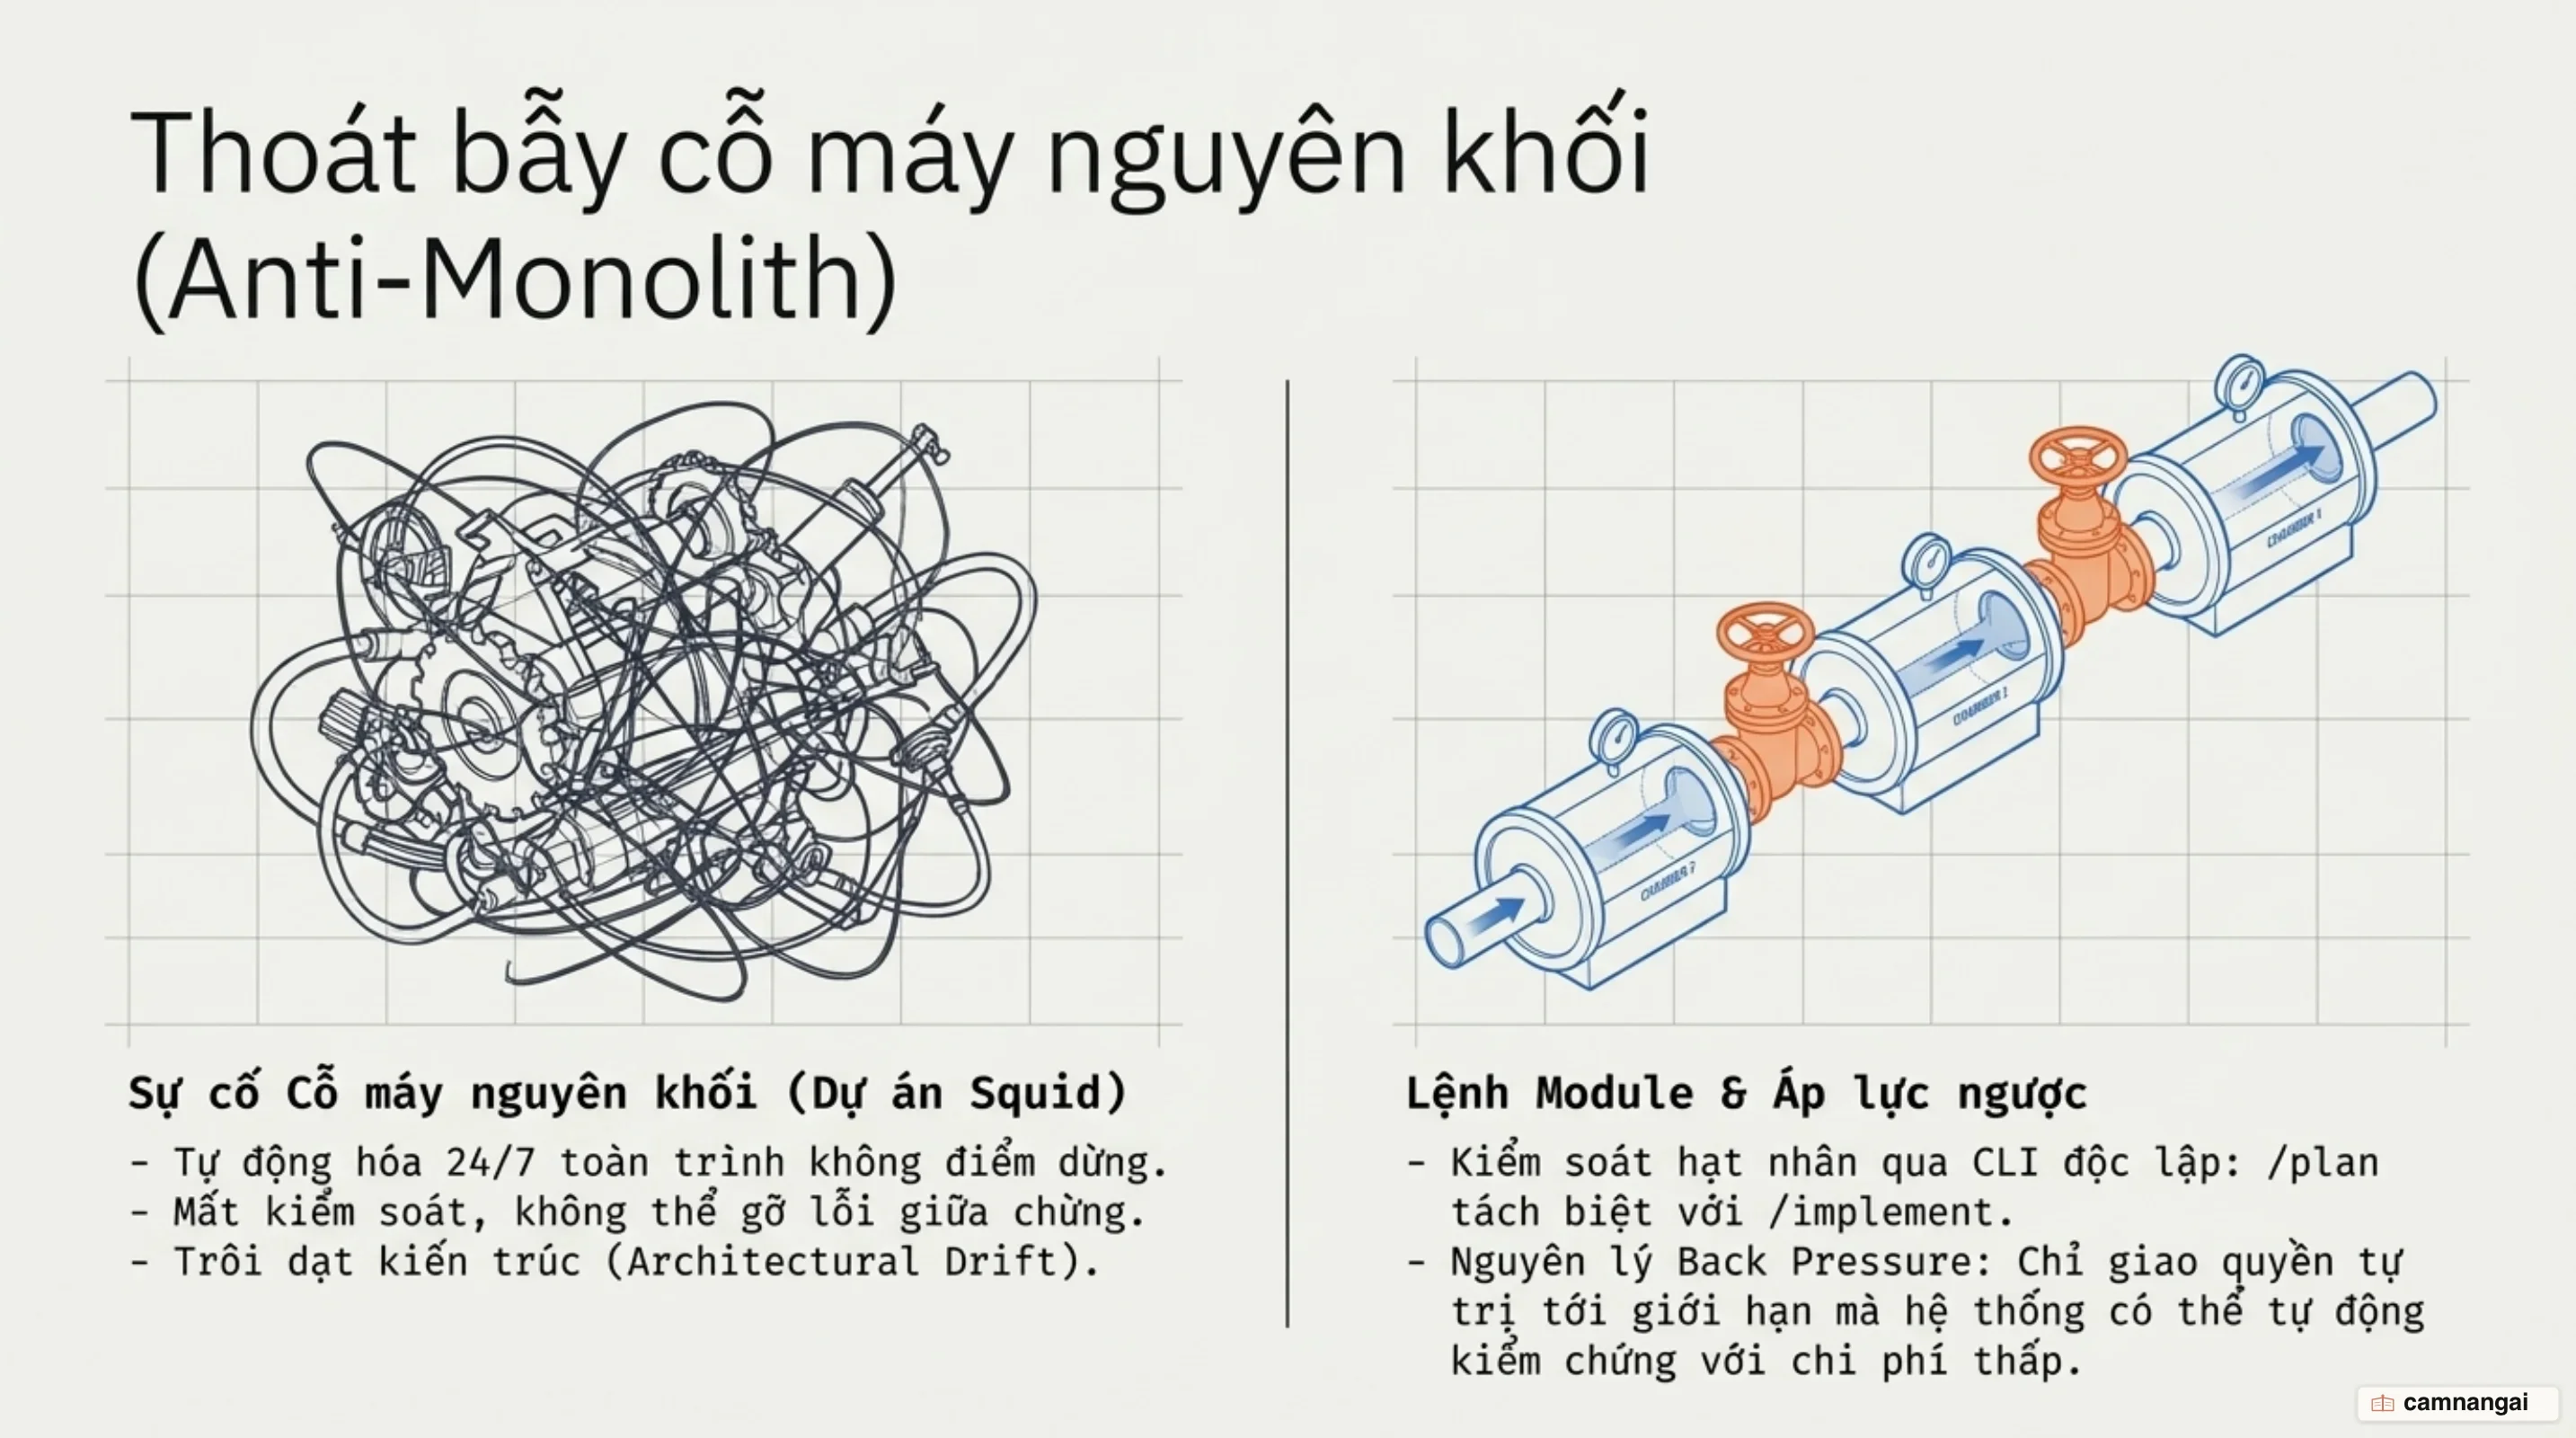
Bài học thực tế từ dự án Squid của Paul Iusztin chỉ ra cạm bẫy lớn khi kỹ sư mang "tham vọng tự động hóa 100%". Việc cố gắng dựng một đường ống remote 24/7 nguyên khối (monolith) chạy tự động từ đầu đến cuối thường dẫn đến thất bại. Khi agent đi chệch hướng, hệ thống nguyên khối trở nên không thể debug, không thể tạm dừng hay điều hướng nếu không hủy bỏ toàn bộ phiên chạy.
Kiến trúc nhà máy phần mềm hiệu quả cần phân chia linh hoạt thành 2 chế độ điều khiển:
- Các lệnh đơn lẻ, độ phân giải cao (
/plan,/implement,/reviewcho từng tác vụ cụ thể) để con người can thiệp khi cần. - Lệnh đóng gói đồ thị (tách riêng
/planvà/implement-review-all) khi muốn kích hoạt chế độ tự chạy hoàn toàn trong background.
Sự khác biệt giữa Nhà máy tối (Dark Factory) và Nhà máy sáng (Lit Factory) là một lời cảnh báo quan trọng về mặt hạ tầng:
- Dark Factory: Hệ thống chạy tự động hoàn toàn, code được ship đi mà không ai đọc diff. Điều này tích tụ "Nợ hiểu biết" (Comprehension Debt)—khoảng cách ngày càng rộng giữa lượng code sinh ra và khả năng hiểu codebase của con người. Hệ thống vẫn chạy ổn định cho đến khi gặp sự cố phức tạp trên hệ thống cũ (brownfield) và sụp đổ âm thầm.
- Lit Factory: Giữ ánh sáng ở những nơi cần sự phán đoán của con người (bật đèn ở cổng kiến trúc, thiết kế ban đầu và các review gate quan trọng).
Chiến lược này tuân theo nguyên tắc Áp lực ngược (Back Pressure): Bạn chỉ có thể giao cho agent mức độ tự chủ tương ứng với khả năng kiểm tra (verify) chi phí thấp và tin cậy của bạn. Nút thắt cổ chai của nhà máy phần mềm chưa bao giờ nằm ở khâu sinh code (generation) mà nằm ở khâu kiểm tra và xác minh code (verification).
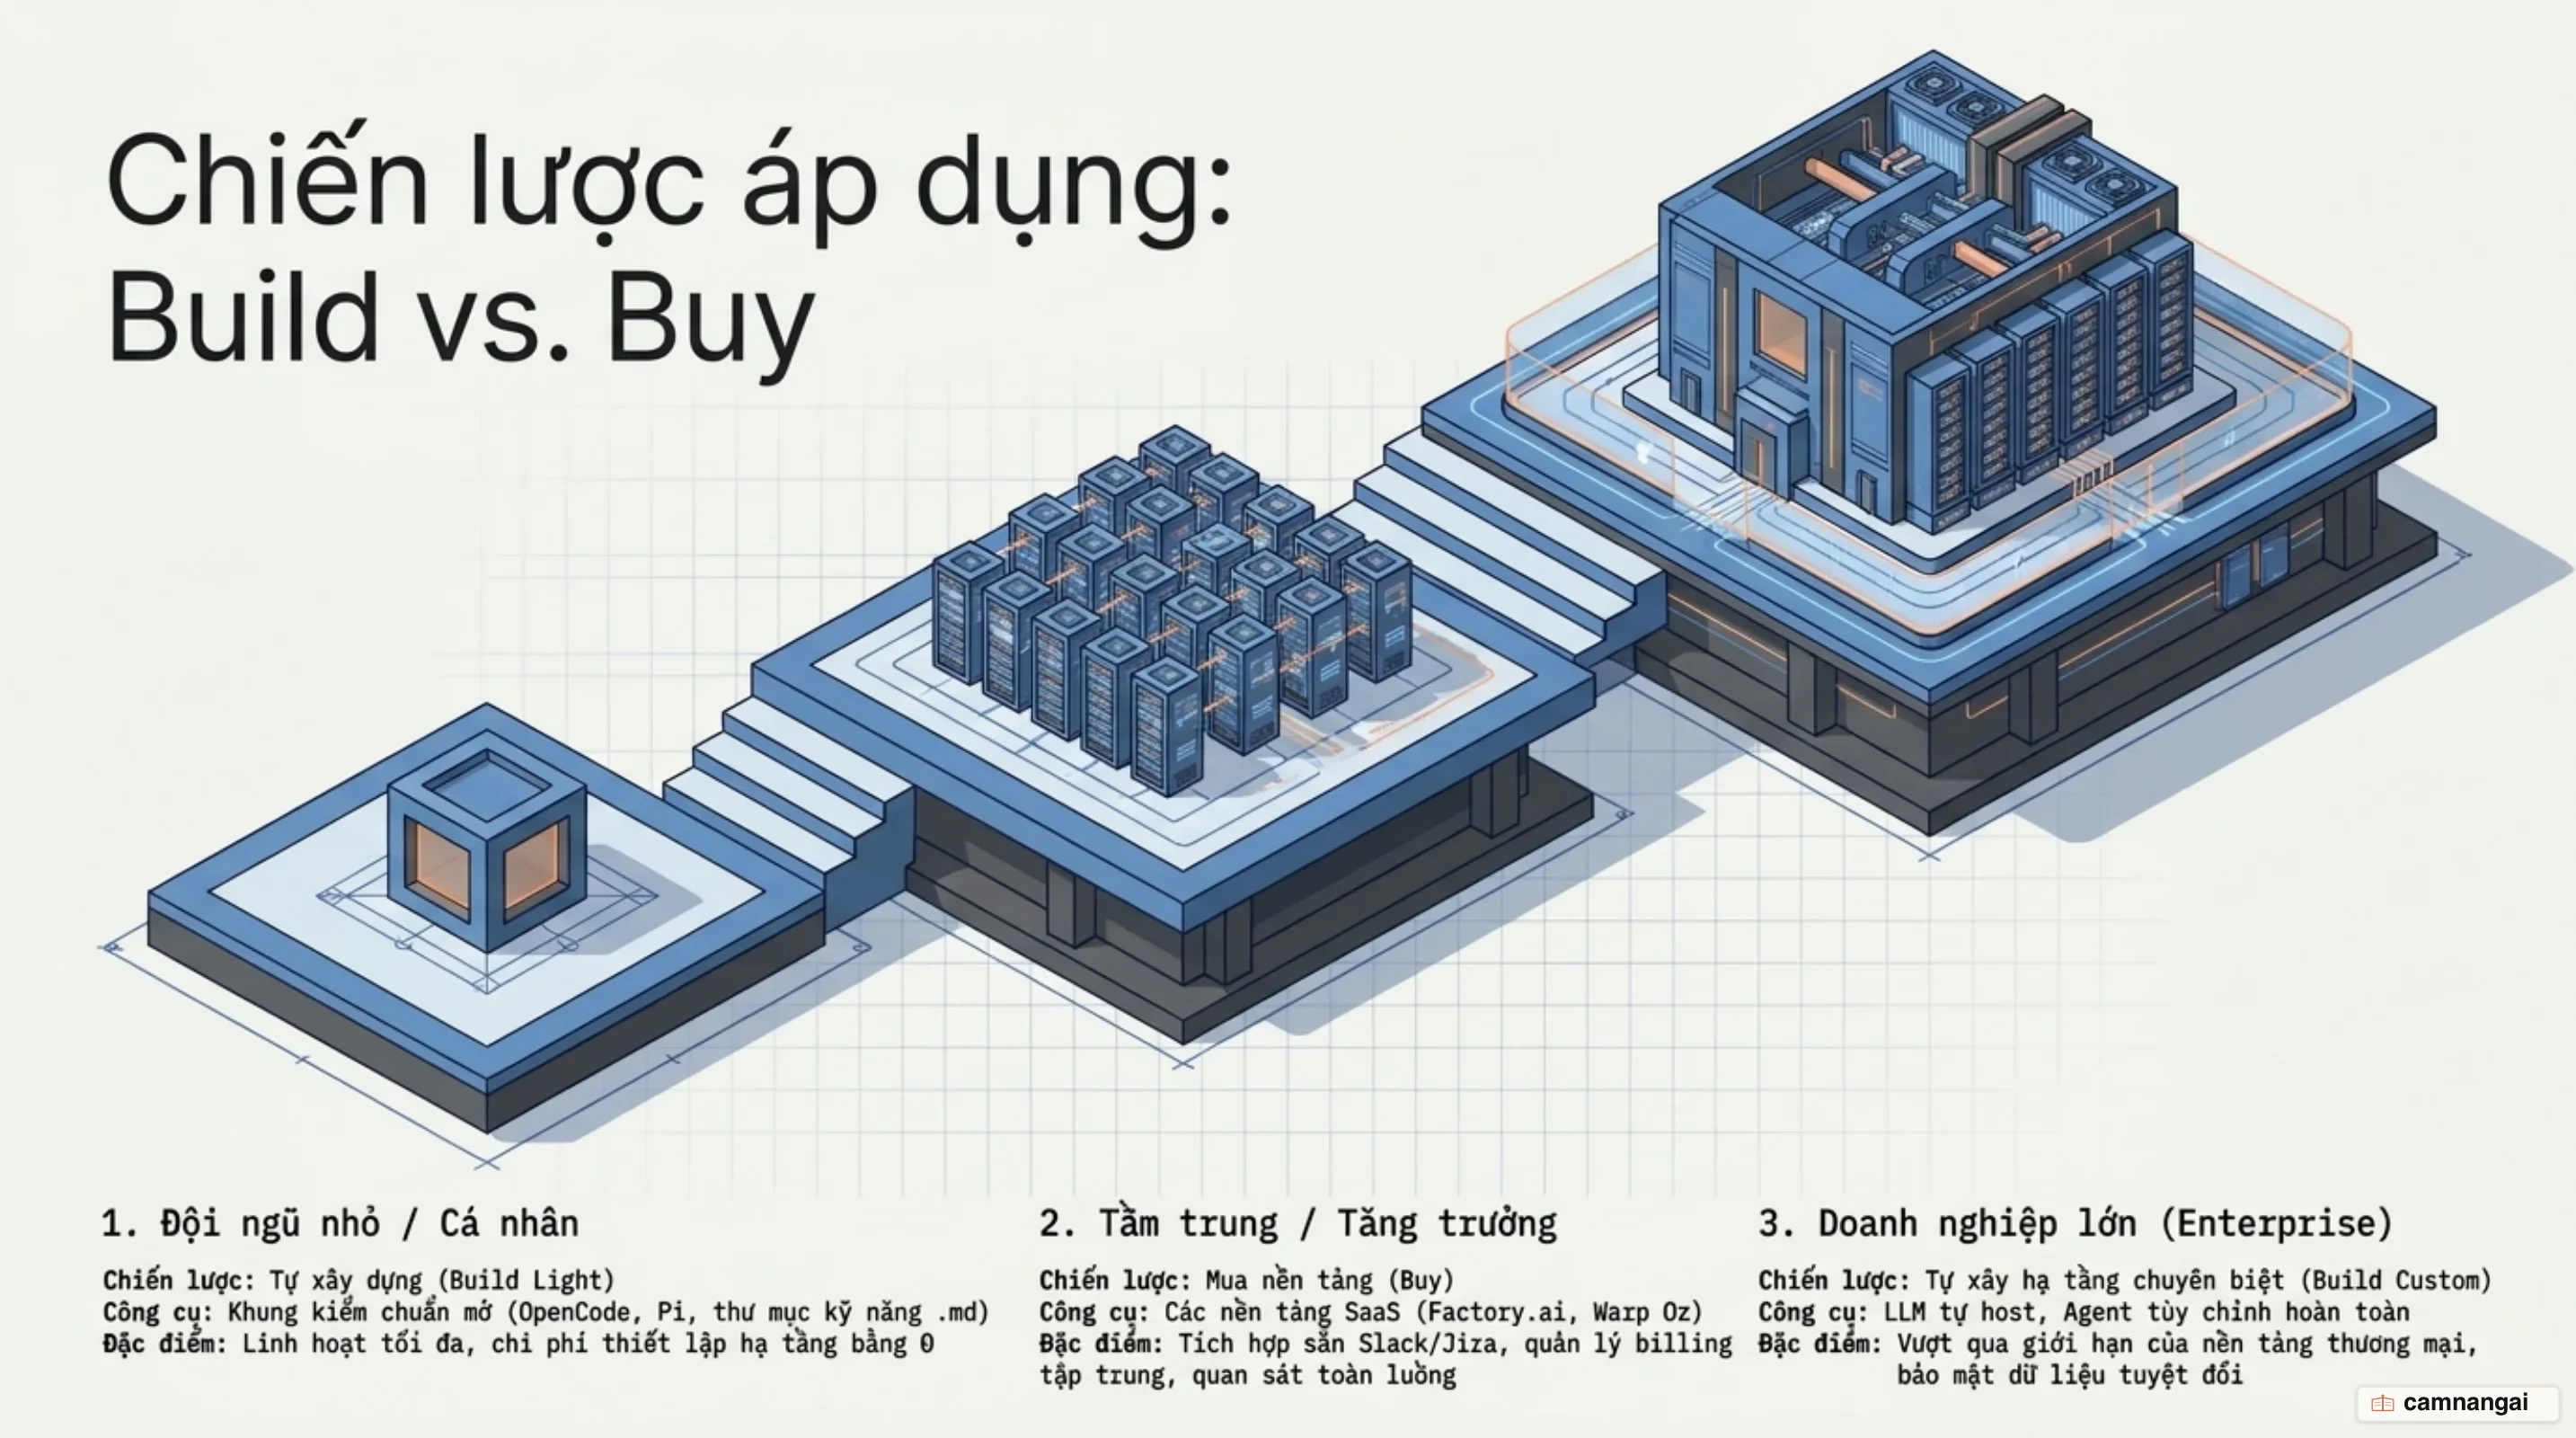
Tự xây hay mua sẵn (Build vs. Buy): Định cỡ nhà máy phần mềm theo quy mô đội ngũ
Quyết định tự phát triển hay mua giải pháp nhà máy phần mềm phụ thuộc trực tiếp vào quy mô đội ngũ và tính chất của dự án:
       [ Quy mô đội ngũ & Nhu cầu ]
                    │
    ┌───────────────┼───────────────┐
    ▼               ▼               ▼
 Lập trình cá nhân /   Đội ngũ tăng trưởng   Tổ chức lớn /
   Đội ngũ nhỏ          (Tầm trung)          Doanh nghiệp
    │               │               │
    ▼               ▼               ▼
[ Build đơn giản ]  [ Buy thương mại ]  [ Build chuyên biệt ]
 - Harness mở        - Factory.ai        - Internal Harness
 - Rule Markdown     - Warp Oz           - Tùy biến sâu
 - Worktree local    - Quản lý token     - Tối ưu quy mô
- Đội ngũ nhỏ / Lập trình viên cá nhân (Build đơn giản): Bạn chỉ cần tận dụng một khung agent có sẵn (Claude Code, Codex CLI, OpenCode, Pi) kết hợp với các file quy tắc Markdown quy định agent/skill (như Squid, BMad, Matt Pocock skills). Chạy các agent cục bộ cách ly thông qua
git worktree. - Đội ngũ tầm trung / Đang tăng trưởng (Buy giải pháp thương mại): Xuất hiện nhu cầu quản lý agent giữa nhiều kỹ sư không trực tiếp giám sát nhau. Hệ thống bắt buộc phải có tính năng quan sát (observability), truy vết (tracing), quản lý chi phí theo token, và tích hợp sâu vào Slack, Linear, CI. Lúc này, lựa chọn tối ưu là các nền tảng thương mại đóng gói sẵn như Factory.ai (với Droid agent) hoặc Warp Oz.
- Tổ chức / Doanh nghiệp lớn (Build hệ thống chuyên biệt): Khi ranh giới và chi phí của các nền tảng thương mại vượt quá chi phí tự phát triển, doanh nghiệp cần tự xây dựng hệ thống harness nội bộ chuyên biệt (như cách OpenAI tự xây dựng hệ thống trên Codex để quản lý 1 triệu dòng code).
Bắt đầu từ nút thắt khó chịu nhất: Lời khuyên thực chiến cho kỹ sư phần mềm
Đừng cố gắng xây dựng một nhà máy phần mềm đồ sộ ngay trong ngày đầu tiên. Tôi khuyên bạn hãy chọn đúng một công đoạn gây khó chịu nhất trong công việc hàng ngày (như tự động sửa lỗi lint, tự động chạy test và tạo PR sửa lỗi nhỏ) và xây dựng một vòng lặp ngắn nhất (smallest loop) để xử lý dứt điểm công đoạn đó.
Kỹ năng của kỹ sư phần mềm không mất đi mà đang chuyển dịch mạnh mẽ sang kỹ thuật meta-engineering. Năng lực cốt lõi hiện nay là thiết kế môi trường làm việc, thiết lập các quy chuẩn kiến trúc và bảo vệ các cổng kiểm duyệt chất lượng để định hướng cho các hệ thống agent thực thi.
Tài liệu tham khảo
- Inside a Software Factory: Go from vibe coding to generating clean, maintainable code — Paul Iusztin
- Software Factories, Light and Dark — Addy Osmani
- Why Software Factories Are the Next Phase of Coding — Zach Lloyd & Latent Space
- Inside the Software Factory, and What It Takes to Build One — Factory.ai
- Harness Engineering: Leveraging Codex in an Agent-First World — OpenAI
- LLM Wikis as Living Memory for AI Agents — Paul Iusztin & Louis-François Bouchard
- AIEWF Daily Dispatch: Loops, Software Factories & Forward Deployed Engineers — Latent Space