vLLM là thư viện và engine mã nguồn mở hiệu năng cao dùng để phục vụ và suy luận các mô hình ngôn ngữ lớn (LLM), ban đầu phát triển tại Sky Computing Lab thuộc Đại học California, Berkeley (UC Berkeley). Thư viện này được thiết kế để tối ưu hóa tốc độ xử lý và khả năng quản lý bộ nhớ GPU khi triển khai các mô hình Transformer trên quy mô lớn.
Trong hạ tầng phục vụ LLM, nghẽn bộ nhớ VRAM do dữ liệu Key-Value (KV) cache gây ra là nguyên nhân chính làm giảm hiệu suất hệ thống. vLLM giải quyết bài toán này bằng cách giới thiệu thuật toán PagedAttention và cơ chế Continuous Batching, giúp loại bỏ hiện tượng phân mảnh bộ nhớ và tối ưu hóa băng thông của phần cứng.
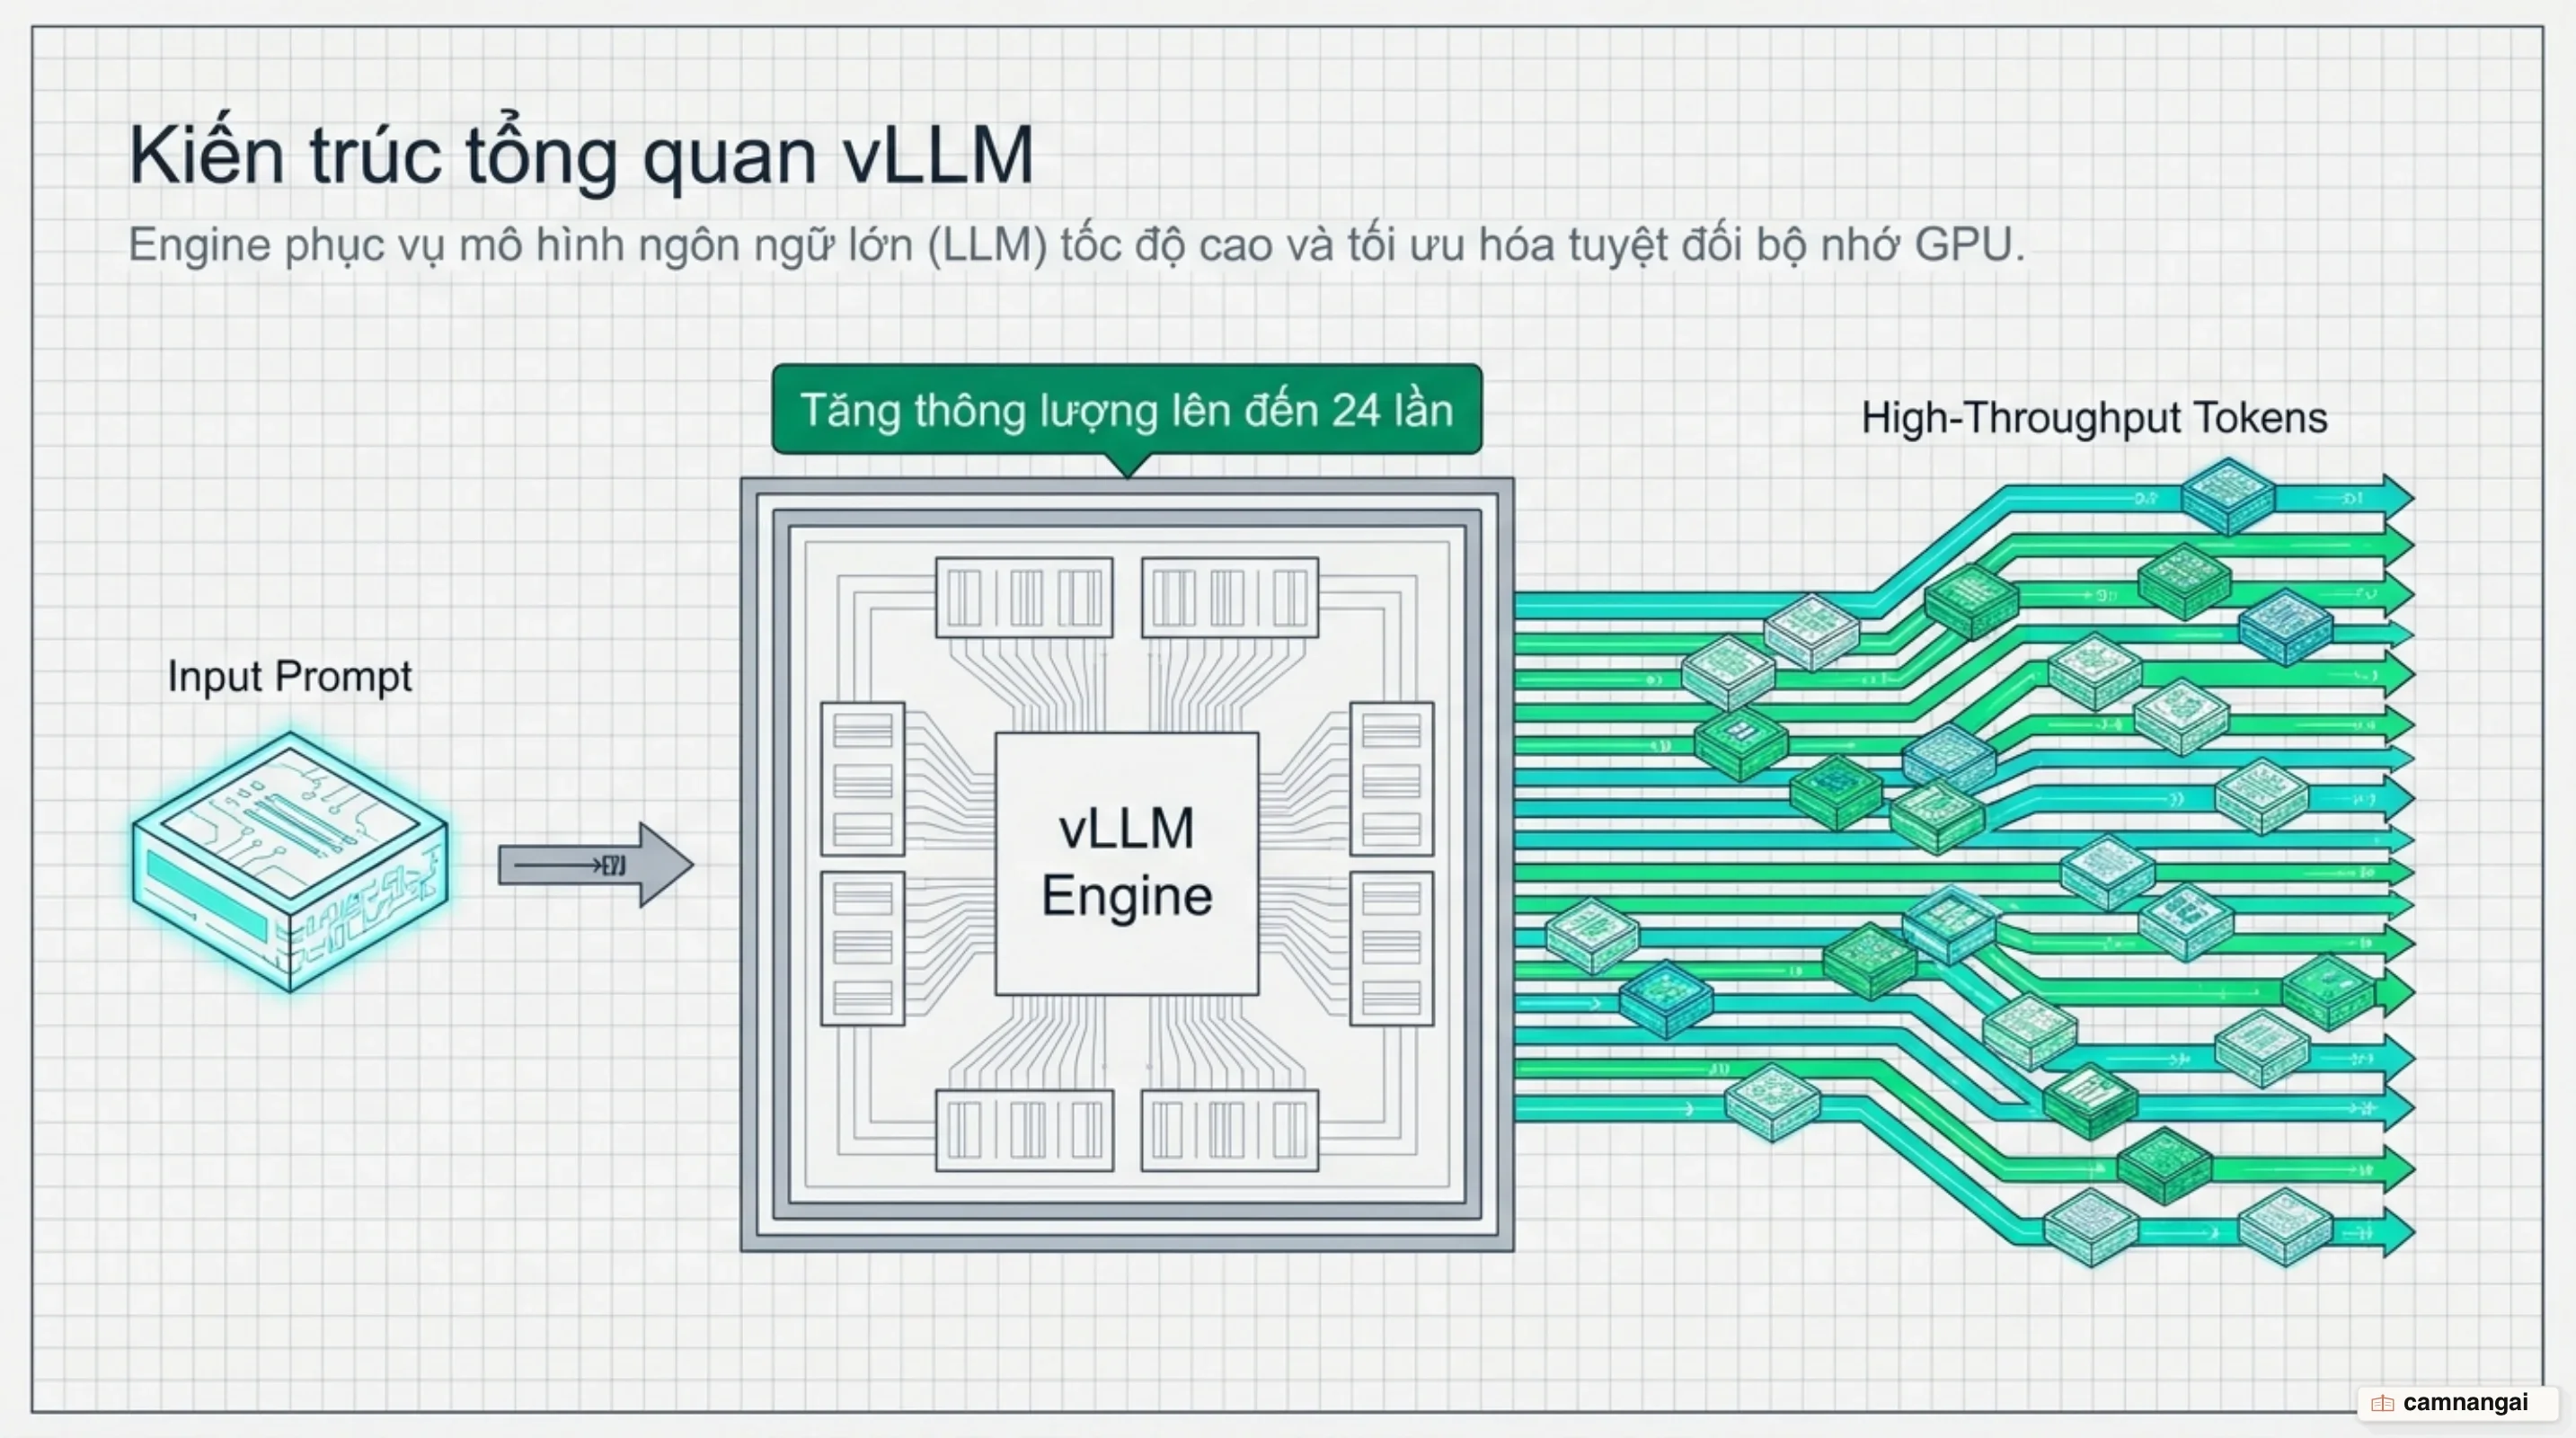
vLLM giải quyết bài toán gì trong LLM serving?
Khi phục vụ các mô hình ngôn ngữ lớn, bộ nhớ Key-Value (KV) cache tạo ra trong quá trình tính toán cơ chế Attention chiếm phần lớn dung lượng VRAM của GPU. Kích thước của KV cache không cố định mà tăng trưởng động theo độ dài ngữ cảnh (context length) và kích thước lô (batch size). Điều này khiến việc quản lý bộ nhớ trở nên phức tạp khi hệ thống phải xử lý đồng thời nhiều yêu cầu có độ dài văn bản khác nhau.
Các hệ thống phục vụ truyền thống như FasterTransformer hay Orca phiên bản cũ thường áp dụng cơ chế cấp phát bộ nhớ liên tục (contiguous allocation). Do không thể dự đoán chính xác độ dài đầu ra của mô hình, các hệ thống này phải dự phòng trước các khối VRAM liền kề dựa trên độ dài chuỗi tối đa (maximum sequence length). Cách làm này gây ra hiện tượng phân mảnh bộ nhớ trầm trọng (memory fragmentation), lãng phí từ 60% đến 80% dung lượng VRAM thực tế do bộ nhớ dự phòng không được sử dụng hết hoặc bị bỏ trống giữa các yêu cầu.
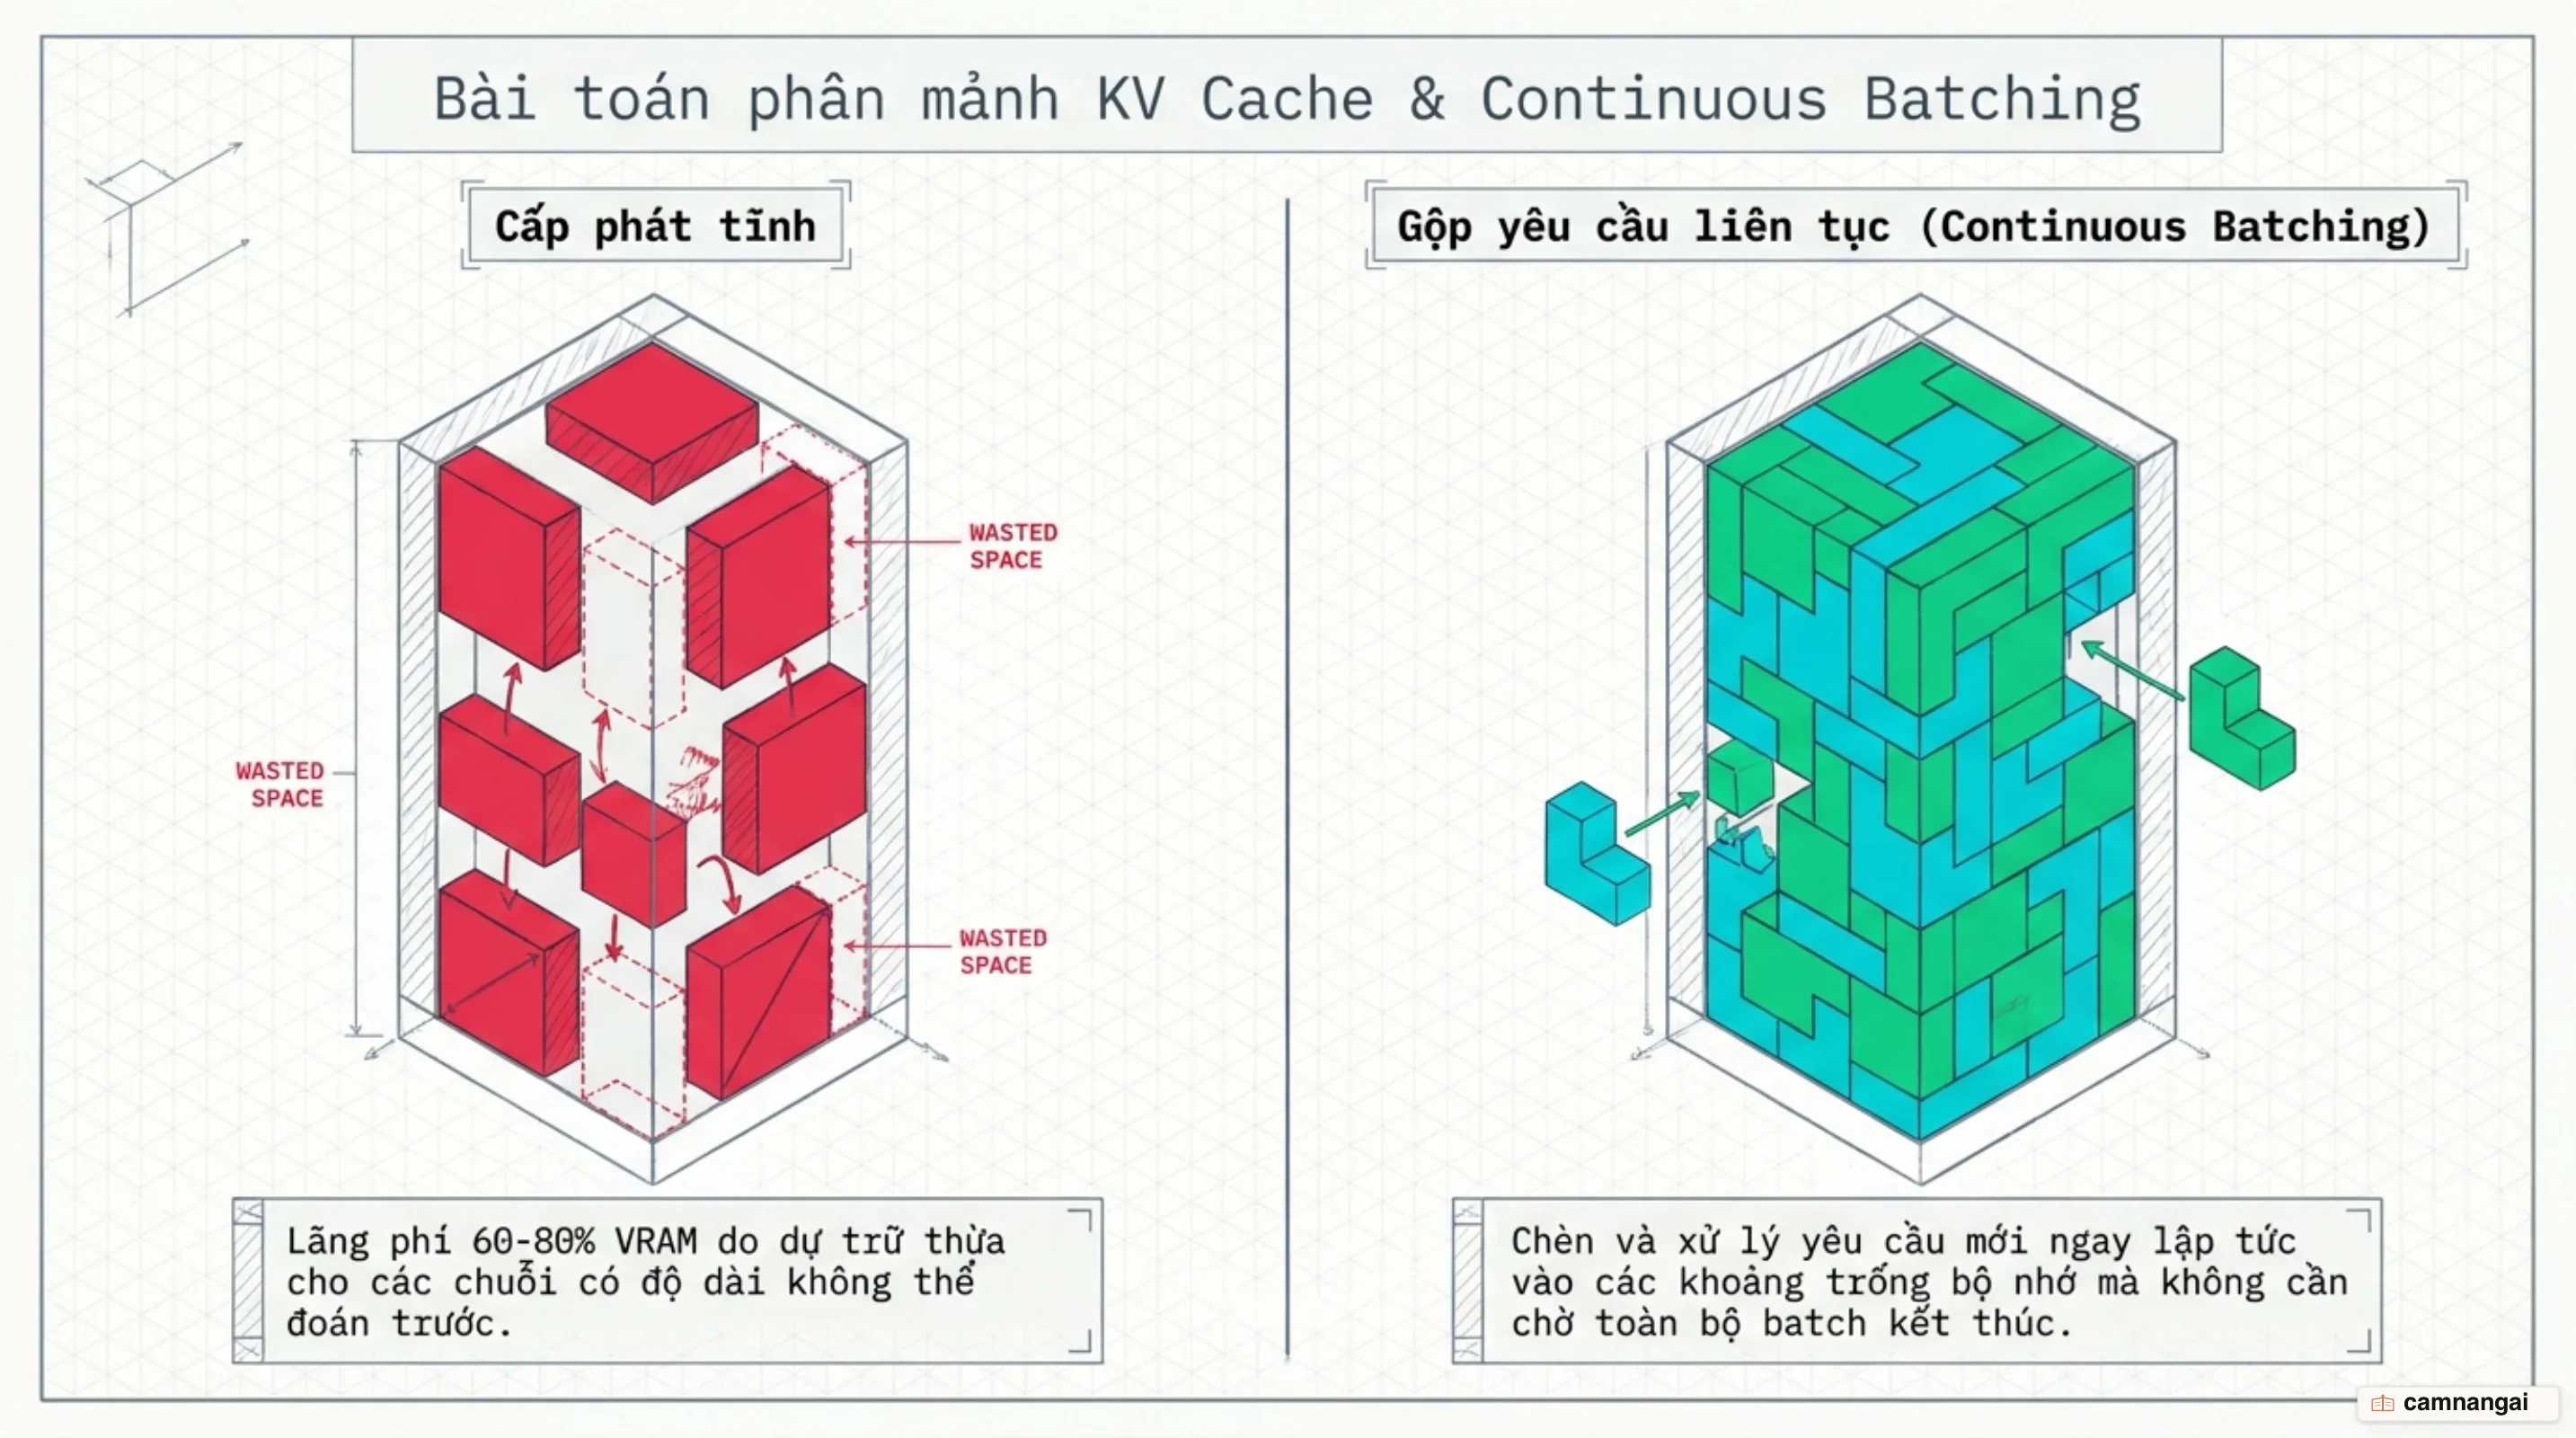
Để khắc phục điểm nghẽn trên, vLLM kết hợp kỹ thuật Continuous Batching (hay iteration-level batching). Thay vì chờ toàn bộ một batch hoàn thành giai đoạn sinh token (decode) mới nhận yêu cầu mới như static batching, vLLM liên tục gộp các yêu cầu mới ở giai đoạn xử lý prompt (prefill) vào cùng các bước tính toán decode hiện tại. Cơ chế này loại bỏ hoàn toàn thời gian chờ idle của GPU, nâng cao hiệu suất sử dụng phần cứng.
Trái tim của vLLM: Cơ chế PagedAttention hoạt động như thế nào?
PagedAttention là thuật toán quản lý bộ nhớ cốt lõi của vLLM, lấy cảm hứng từ cơ chế bộ nhớ ảo (virtual memory) và phân trang (paging) trong các hệ điều hành kinh điển. Thay vì bắt buộc lưu trữ dữ liệu KV cache của một yêu cầu trên các dải VRAM liền kề, PagedAttention chia KV cache thành các khối (blocks) có kích thước cố định, mặc định chứa 16 tokens mỗi block.
Hệ thống quản lý KV-cache manager duy trì một hàng chờ chứa các khối tự do (free_block_queue) và sử dụng bảng ánh xạ (Block Tables). Bảng này lưu trữ liên kết giữa địa chỉ logic của các token trong ngữ cảnh với các khối vật lý được cấp phát rải rác trên VRAM của GPU. Khi một token mới được tạo ra, hệ thống tự động ghi dữ liệu KV vào block vật lý hiện tại hoặc cấp phát thêm một block mới từ free_block_queue nếu block cũ đã đầy.
Địa chỉ Logic (Tokens)  --->  [Block Table]  --->  Địa chỉ Vật lý (GPU VRAM)
[Token 0  - 15 ]              Block 0             Block #37 (Không liền kề)
[Token 16 - 31 ]              Block 1             Block #12 (Không liền kề)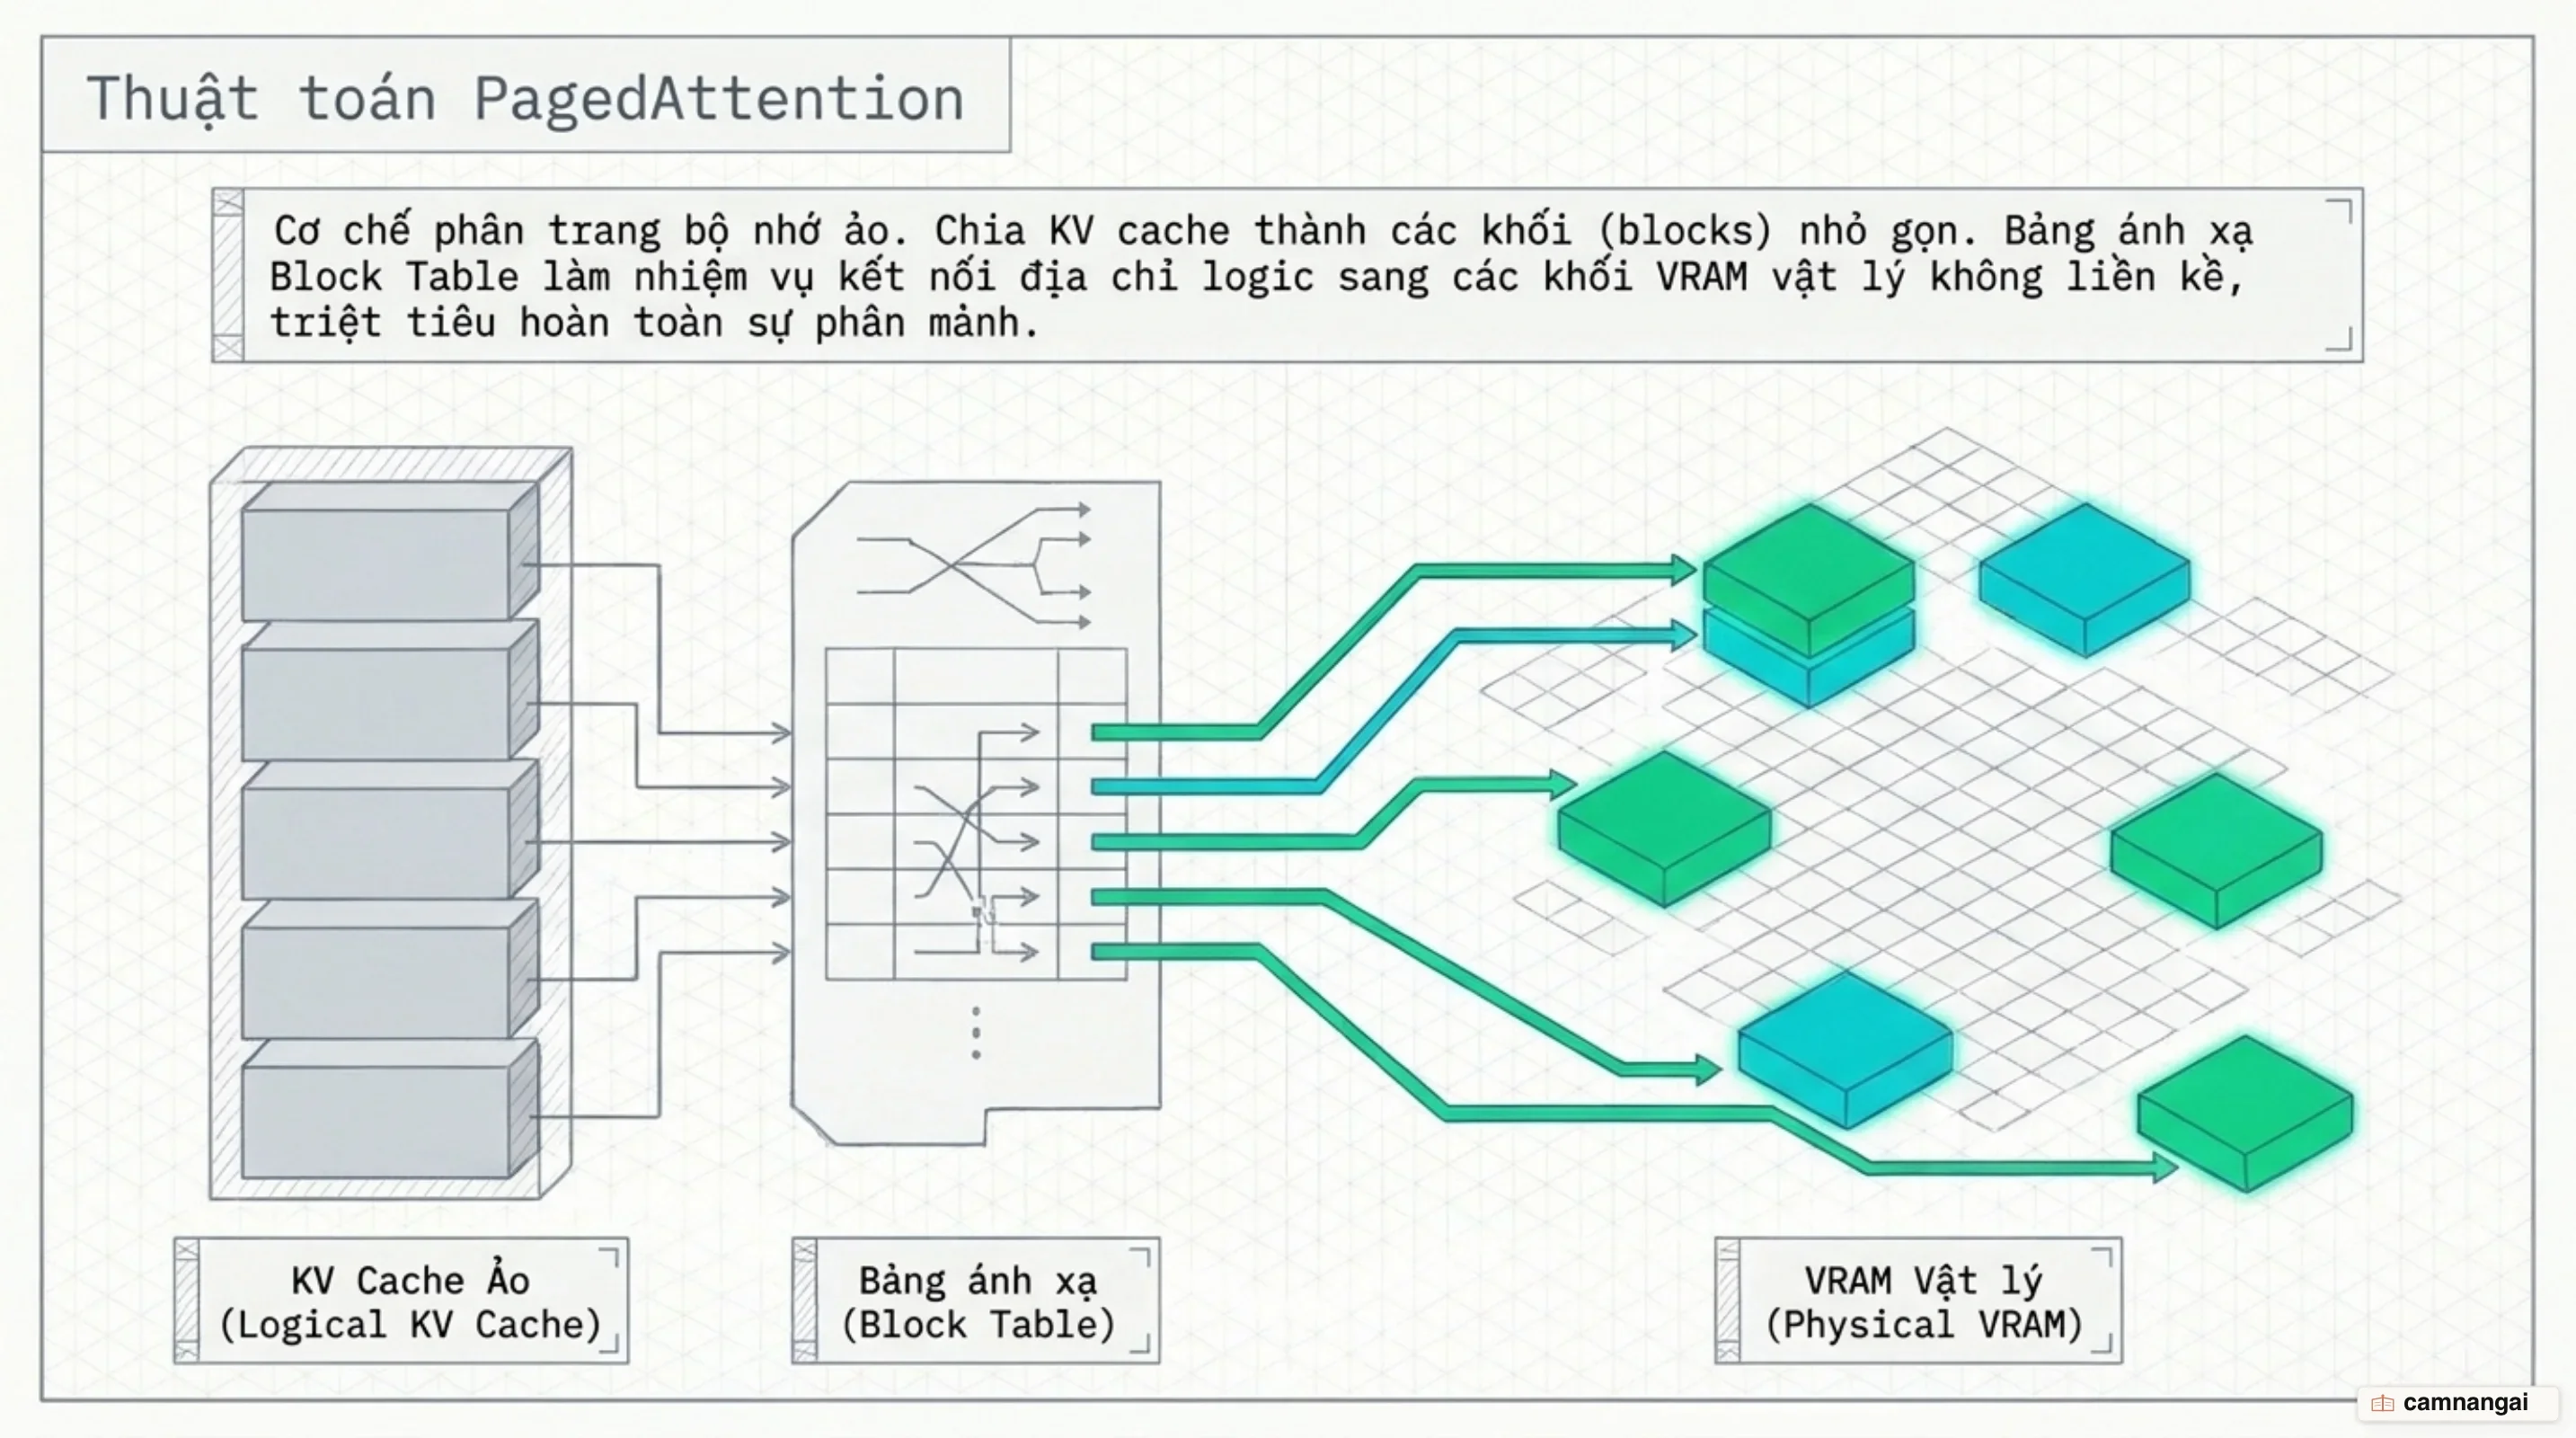
Việc phân trang giúp vLLM giảm mức lãng phí bộ nhớ KV cache xuống dưới 4%, chỉ còn xuất hiện ở khối cuối cùng khi chưa lấp đầy token. Nguồn bộ nhớ VRAM giải phóng được phép mở rộng kích thước batch size lớn hơn đáng kể, giúp tăng tổng lưu lượng xử lý (throughput) từ 2 đến 4 lần so với FasterTransformer và Orca trên cùng cấu hình hạ tầng.
Bên cạnh đó, vLLM tích hợp tính năng Prefix Caching dựa trên PagedAttention. Kỹ thuật này chia chuỗi token thành các đoạn 16 tokens tương ứng với ranh giới khối block. Hàm băm (hash) của block thứ $N$ được tính toán bằng cách kết hợp giá trị băm của block $N-1$ trước đó cùng ID của các token hiện tại. Khi có yêu cầu mới chứa cùng đoạn prefix trùng lặp (như hệ thống prompt mẫu hoặc tài liệu tra cứu trong RAG), vLLM tra cứu chuỗi băm liên kết này để tái sử dụng trực tiếp các khối KV cache đã lưu sẵn trên VRAM mà không cần tính toán lại giai đoạn prefill.
Kiến trúc vLLM V1: Tối ưu độ trễ và loại bỏ CPU overhead
Kiến trúc nâng cấp vLLM V1 được tái thiết kế vòng lặp điều phối chính (engine loop) nhằm giảm thiểu tối đa chi phí xử lý trên CPU (CPU overhead). Trong phiên bản trước, việc chuẩn bị dữ liệu và điều phối các bước suy luận trên CPU chiếm khoảng thời gian đáng kể giữa các bước chạy trên GPU. Kiến trúc V1 loại bỏ điểm nghẽn này, giúp giảm độ trễ giữa các token (Inter-Token Latency - ITL). Bạn có thể kích hoạt kiến trúc mới bằng cách thiết lập biến môi trường VLLM_USE_V1=1.
export VLLM_USE_V1=1Để tối ưu hóa trải nghiệm người dùng, vLLM V1 áp dụng kỹ thuật Chunked Prefill dựa trên bản chất khác biệt giữa hai giai đoạn: prefill mang đặc tính giới hạn bởi năng lực tính toán (compute-bound) khi xử lý hàng loạt token đầu vào song song, trong khi decode lại bị giới hạn bởi băng thông bộ nhớ (memory-bandwidth-bound) khi phải nạp toàn bộ trọng số mô hình để sinh từng token đơn lẻ. Khi nhận các prompt dài, nếu không giới hạn, bước prefill sẽ chiếm dụng toàn bộ tài nguyên tính toán của GPU và làm gián đoạn luồng decode. Kỹ thuật Chunked Prefill cho phép bạn giới hạn số lượng token prefill tối đa trong mỗi bước thông qua tham số long_prefill_token_threshold. Các prompt dài được chia nhỏ thành các chunk và xếp lịch xử lý xen kẽ với bước decode của các yêu cầu khác, giúp giữ độ trễ thời gian phản hồi token đầu tiên (Time-To-First-Token - TTFT) và độ trễ ITL luôn ổn định ở mức thấp.
Song song với kiểm soát độ trễ, vLLM V1 mở rộng hỗ trợ cho các phương pháp suy luận dự đoán (Speculative Decoding) bao gồm n-gram, EAGLE và Medusa, cho phép dự đoán trước $k$ tokens bằng mô hình phụ hoặc đầu dự đoán song song để tăng tốc độ sinh dữ liệu. Đồng thời, cơ chế MultiProcExecutor được đưa vào để quản lý tiến trình GPU thông qua các hàng chờ thông điệp đa tiến trình (multiprocessing message queues), giúp phân chia công việc chính xác giữa các thiết bị mà không tốn chi phí đồng bộ hóa phức tạp.
Triển khai vLLM trong thực tế: Từ lệnh chạy cơ bản đến cụm đa GPU
Thư viện vLLM hỗ trợ cài đặt nhanh thông qua trình quản lý gói uv hoặc pip. Để tối ưu thời gian khởi chạy server trong môi trường sản xuất, bạn nên thực hiện lệnh precompile các kernel ngay sau khi cài đặt:
uv pip install vllm
vllm download-kernels
vllm serve Qwen/Qwen2.5-7B-Instruct
Đối với các mô hình kích thước lớn không thể vừa bộ nhớ của một GPU duy nhất, vLLM hỗ trợ cấu hình phân tán thông qua Tensor Parallelism (TP) và Data Parallelism (DP). Tham số --tensor-parallel-size chia nhỏ các tầng mạng thần kinh trên nhiều GPU trong cùng một node (khai thác băng thông nội node cao như NVLink). Trong khi đó, tham số --data-parallel-size nhân bản toàn bộ mô hình sang các node hoặc máy chủ khác nhau để mở rộng khả năng xử lý lượng truy cập đồng thời lớn:
vllm serve Qwen/Qwen2.5-72B-Instruct --tensor-parallel-size 4 --data-parallel-size 2Khi server khởi chạy, vLLM cung cấp endpoint HTTP tại cổng mặc định (http://localhost:8000). Bạn có thể tích hợp trực tiếp vào ứng dụng sẵn có bằng cách gọi các API tiêu chuẩn như /v1/completions hoặc /v1/chat/completions:
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "Qwen/Qwen2.5-7B-Instruct",
    "messages": [{"role": "user", "content": "vLLM tối ưu bộ nhớ như thế nào?"}]
  }'
So sánh Kỹ thuật: vLLM với Ollama, TGI và TensorRT-LLM
Ollama được thiết kế tập trung vào sự tiện lợi khi đóng gói và khởi chạy mô hình trên môi trường local hoặc máy tính cá nhân. Tuy nhiên, Ollama không tối ưu cho hạ tầng phục vụ doanh nghiệp chịu tải concurrency cao. vLLM tập trung hoàn toàn vào việc tối ưu hóa hạ tầng máy chủ với các thuật toán quản lý bộ nhớ chuyên sâu, cho phép phục vụ hàng nghìn yêu cầu đồng thời.
So với TGI (Text Generation Inference) của Hugging Face và FasterTransformer, vLLM chiếm ưu thế về hiệu năng nhờ PagedAttention và Continuous Batching. Trong điều kiện tải nặng với ngữ cảnh dài, khả năng quản lý bộ nhớ linh hoạt giúp vLLM đạt mức throughput cao hơn từ 2 đến 4 lần so với FasterTransformer và Orca.
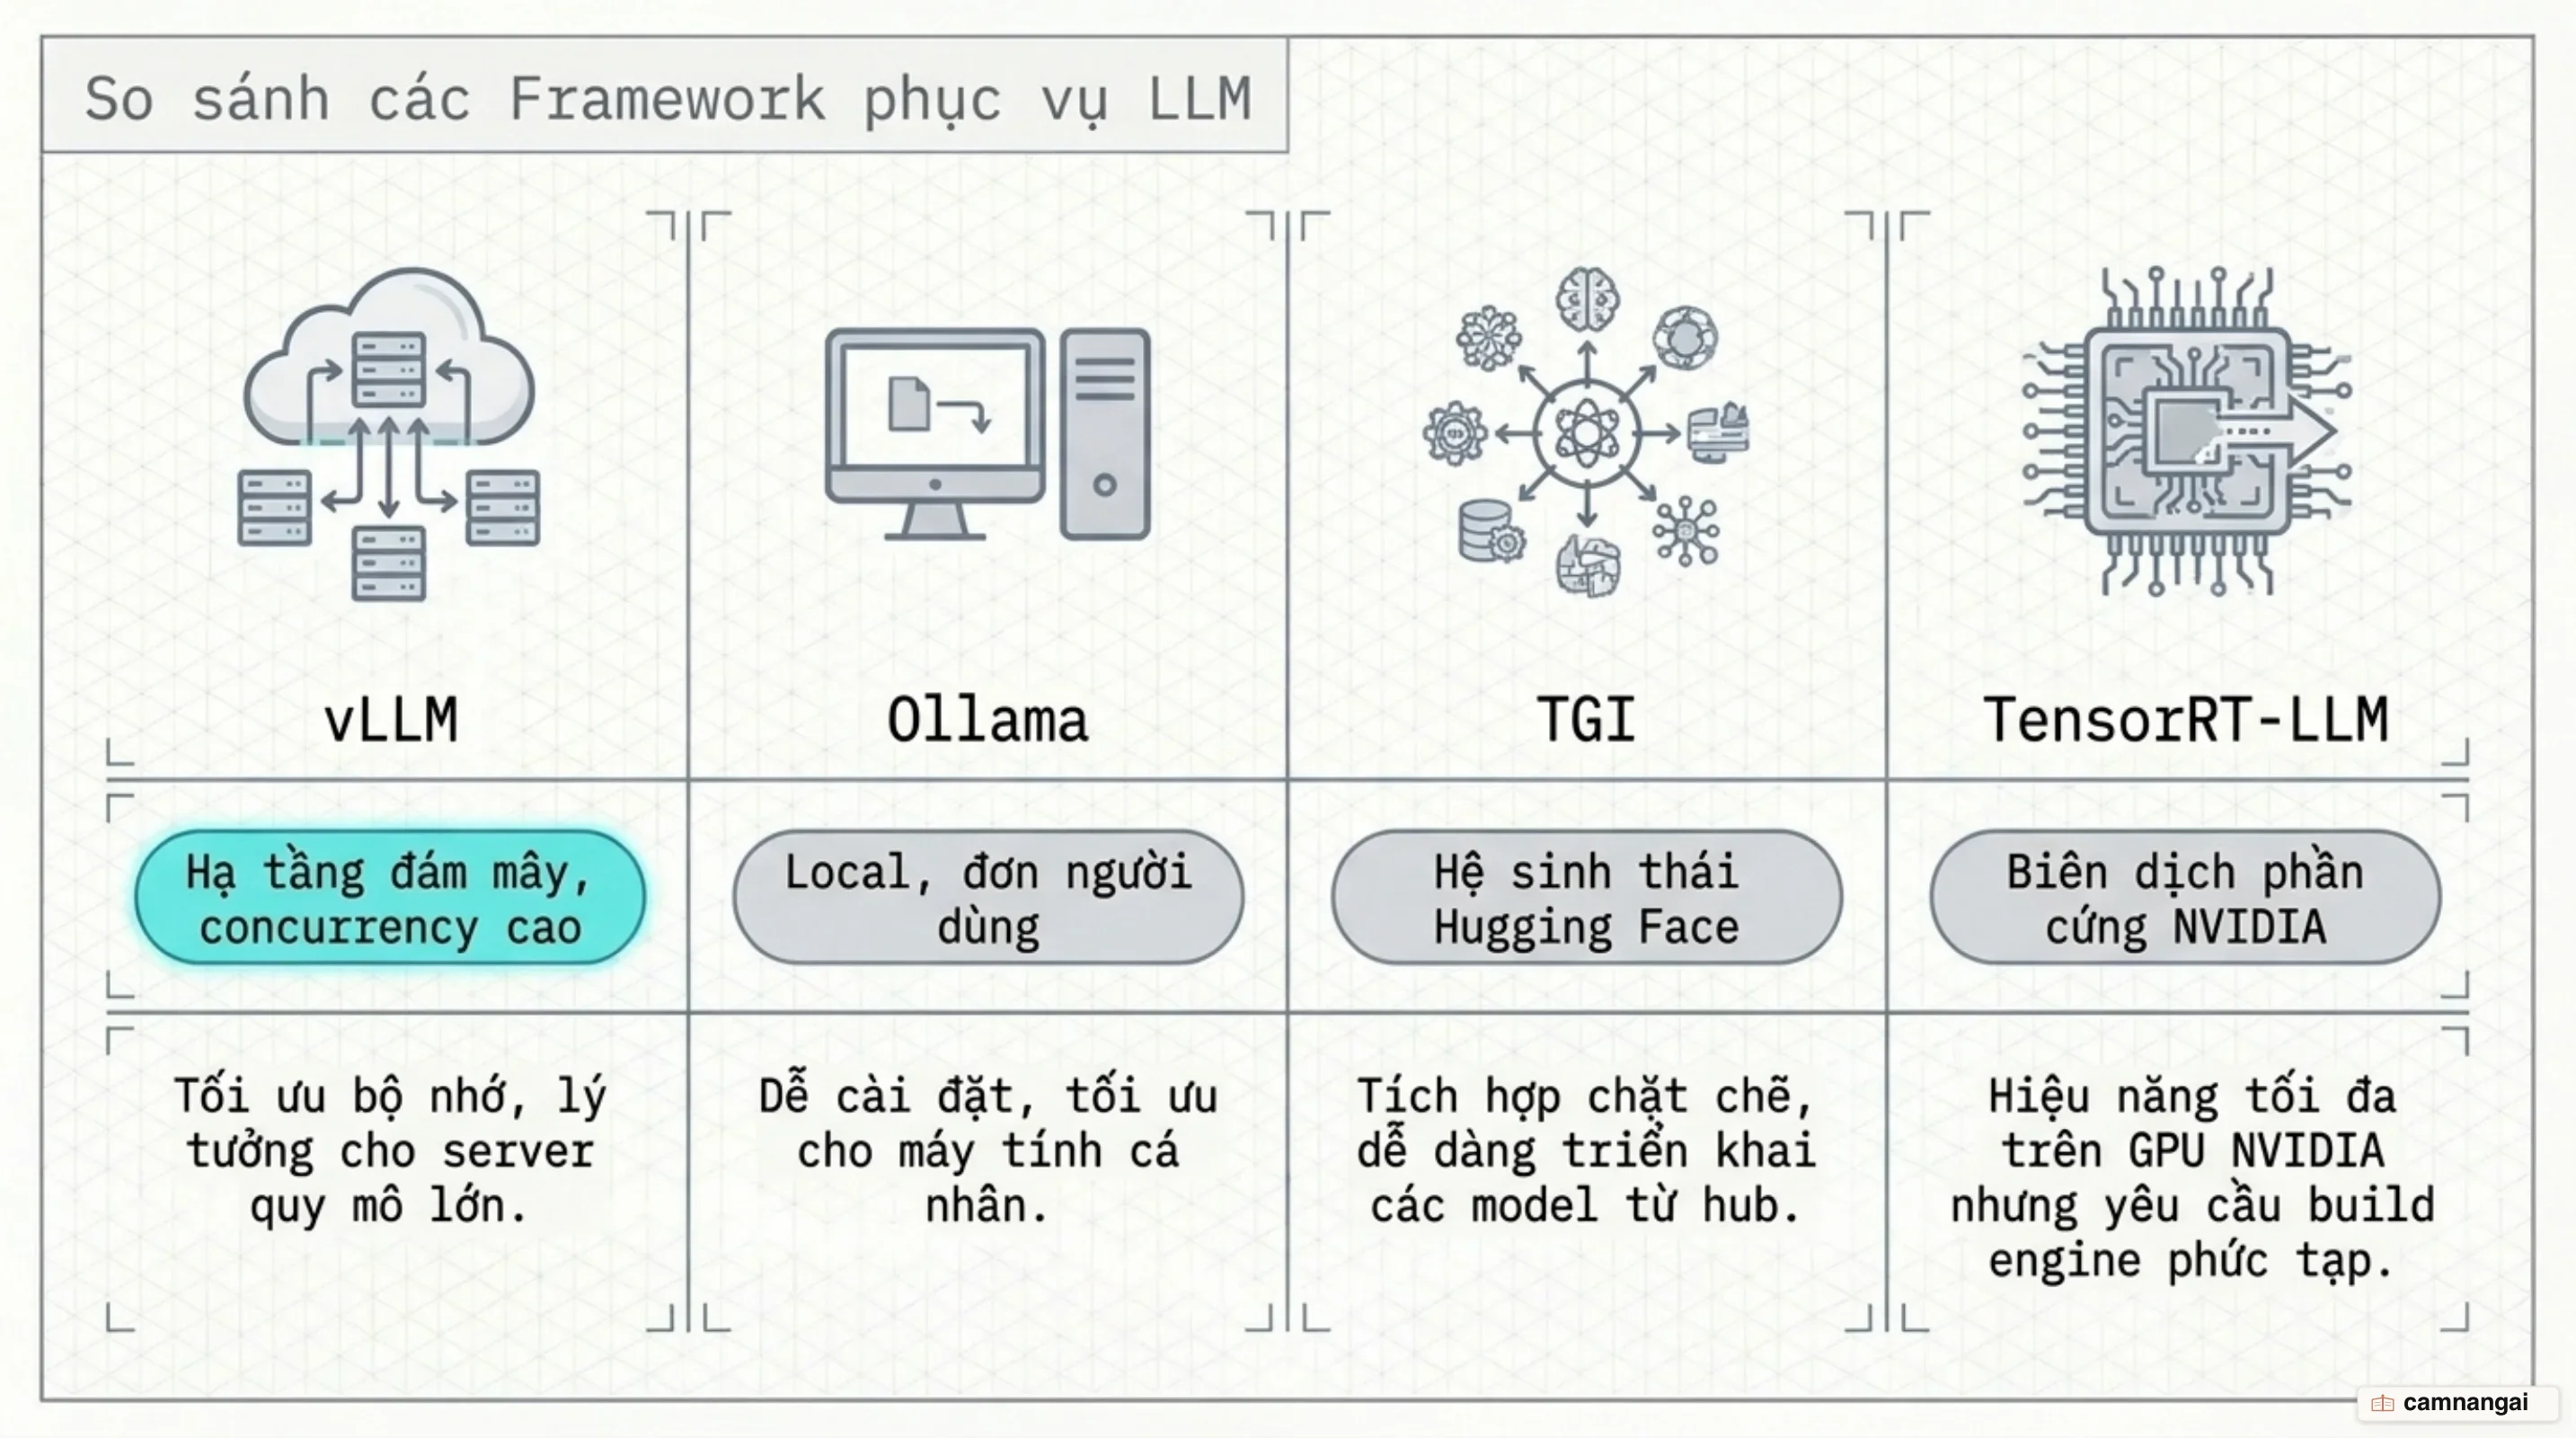
TensorRT-LLM của NVIDIA cung cấp hiệu năng tối đa cho phần cứng NVIDIA thông qua việc tối ưu hóa sâu ở mức biên dịch phần cứng. Mặc dù vậy, TensorRT-LLM đòi hỏi quy trình chuyển đổi và biên dịch mô hình (engine build) phức tạp. Nhờ hỗ trợ hơn 200 kiến trúc mô hình trên Hugging Face, vLLM cho phép triển khai ngay lập tức không cần qua bước biên dịch, đồng thời mở rộng tương thích trên đa dạng phần cứng như NVIDIA GPU, AMD GPU, Google TPU và x86/ARM CPU.
Khi nào bạn nên chọn vLLM cho hạ tầng AI?
Bạn nên lựa chọn vLLM khi vận hành hạ tầng AI trong môi trường sản xuất đòi hỏi các cam kết nghiêm ngặt về chỉ số dịch vụ (SLO) đối với độ trễ TTFT và ITL dưới lưu lượng truy cập đồng thời cao. vLLM đáp ứng bài toán tối ưu chi phí phần cứng bằng cách đẩy mức sử dụng GPU tiệm cận giới hạn lý thuyết, đặc biệt hiệu quả trong các ứng dụng RAG xử lý ngữ cảnh dài, hệ thống phân tích văn bản diện rộng hoặc chatbot doanh nghiệp có biến động KV cache lớn.
Ngoài ra, vLLM là giải pháp phù hợp khi bạn cần vận hành hạ tầng đa người dùng (multi-tenant), triển khai hàng loạt adapter LoRA động trên cùng một mô hình nền, hoặc ưu tiên tính linh hoạt khi triển khai trên các cụm phần cứng không đồng nhất mà không bị khóa chặt vào một hệ sinh thái phần cứng độc quyền.
Tài liệu tham khảo
- Efficient Memory Management for Large Language Model Serving with PagedAttention — Woosuk Kwon et al.
- vLLM: Easy, Fast, and Cheap LLM Serving with PagedAttention — vLLM Blog
- vLLM V1: A Major Upgrade to vLLM's Core Architecture — vLLM Blog
- Inside vLLM: Anatomy of a High-Throughput LLM Inference System — vLLM Blog
- vLLM Documentation — Official Docs
- OpenAI-Compatible Server Guide — vLLM Docs
- vLLM Repository and Ecosystem — GitHub