Khả năng truy vấn hàng tỷ vector trong vài mili-giây của vector database phụ thuộc vào việc thay thế hoàn toàn phương pháp so sánh vét cạn bằng các kỹ thuật Tìm kiếm Láng giềng Gần đúng (Approximate Nearest Neighbor Search, viết tắt là ANNS).
Bằng cách kết hợp phân vùng không gian dữ liệu, xây dựng cấu trúc liên kết đồ thị đa tầng và nén dữ liệu, hệ thống có thể thu hẹp đáng kể phạm vi tính toán.
Thay vì tính khoảng cách giữa vector truy vấn với toàn bộ tập dữ liệu, vector database tổ chức dữ liệu thành các cụm không gian (Voronoi cells) hoặc đồ thị thế giới nhỏ định tuyến được (HNSW). Kết hợp với các giải pháp lượng hóa nén dữ liệu (Quantization) như SQ8, PQ hay Binary Quantization, bộ nhớ RAM được tối ưu hóa tối đa, cho phép thực hiện các phép tính khoảng cách với tốc độ cực cao.
Nhờ đó, thay vì mất hàng chục giây để quét qua hàng terabyte dữ liệu, vector database rút ngắn thời gian xử lý xuống còn vài mili-giây mà vẫn giữ được độ chính xác (Recall) cao.
Vì sao phép so sánh vét cạn sụp đổ trước hàng tỷ vector?
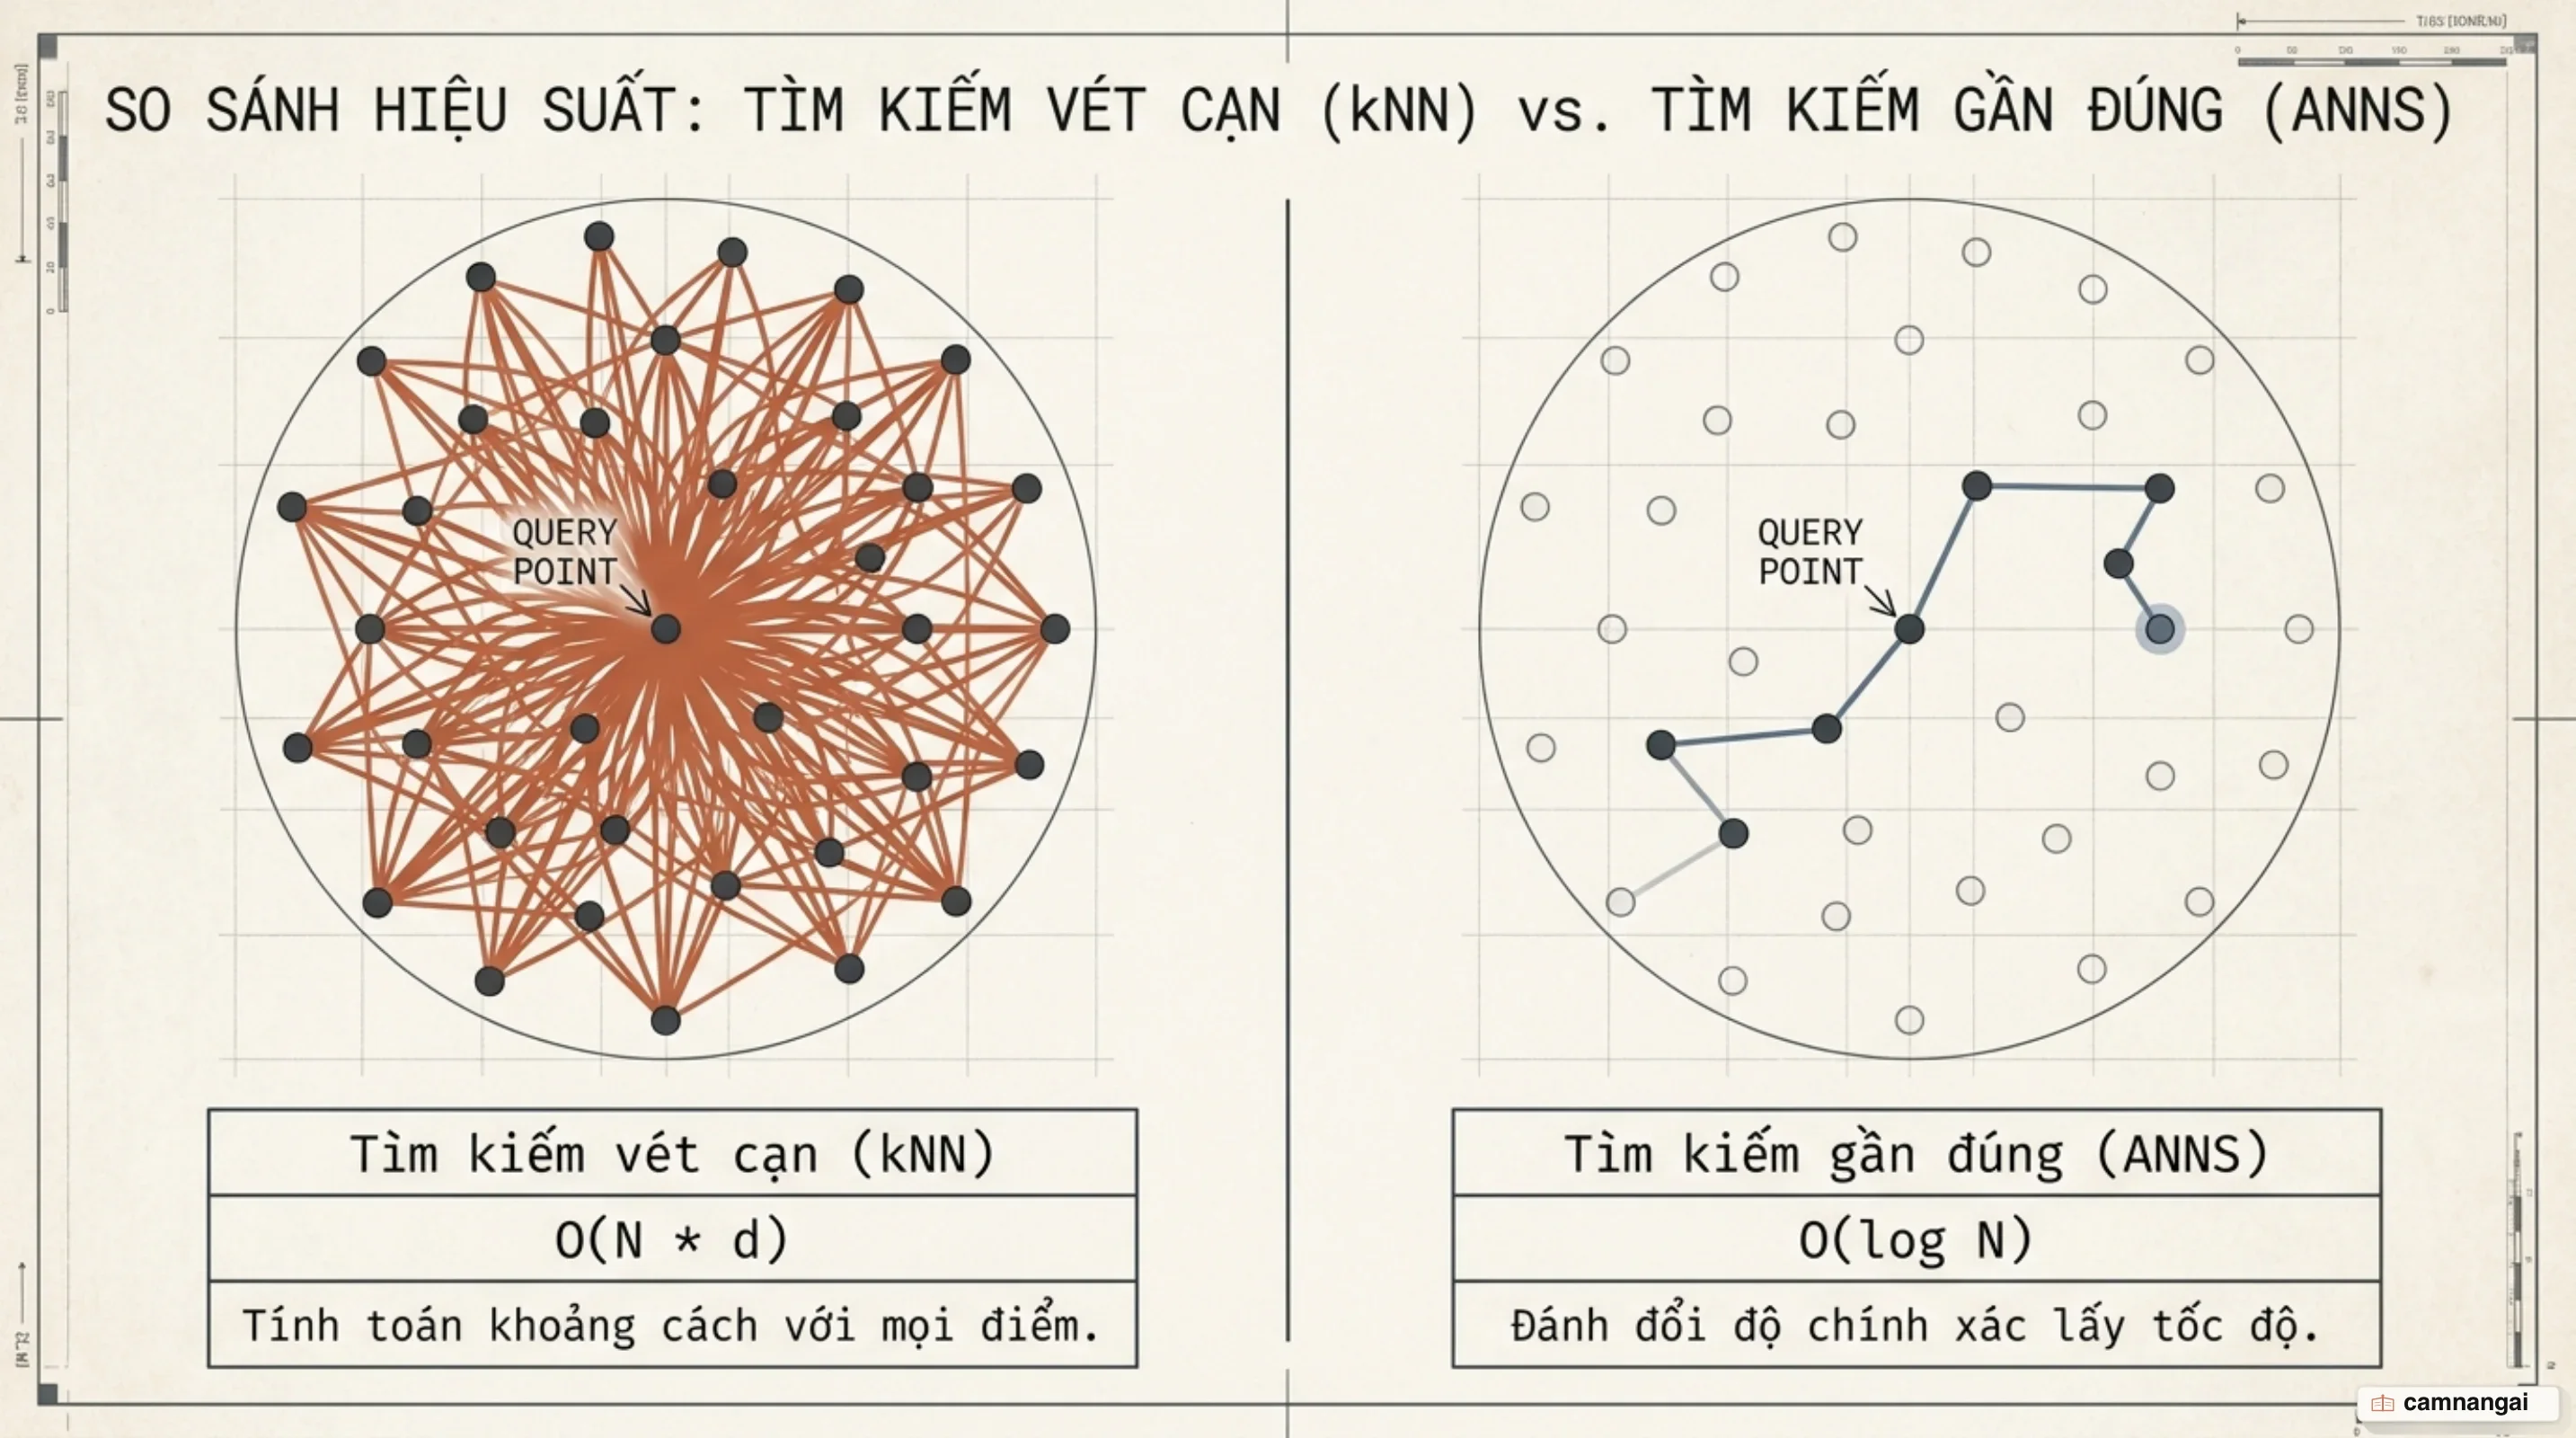
Thuật toán tìm kiếm chính xác Flat (còn gọi là kNN, Brute-force hoặc Exhaustive search) vận hành
bằng cách tính toán khoảng cách hình học trực tiếp giữa vector truy vấn và từng vector lưu trữ trong
cơ sở dữ liệu. Các phép đo phổ biến như khoảng cách Euclidean (L2) hoặc Tích trong (Inner Product, IP)
đòi hỏi phải nhân và cộng dồn từng phần tử thuộc tính của chuỗi số thực dấu phẩy động 32-bit
(float32). Khi mô hình embedding tạo ra các vector có số chiều lớn
(dao động phổ biến từ 128 chiều như tập SIFT1M đến 1536 chiều như OpenAI text-embedding-ada-002),
khối lượng phép tính số học trên mỗi truy vấn là cực kỳ khổng lồ.
Xét về chi phí bộ nhớ, mỗi giá trị float32 chiếm 4 bytes, khiến một vector 512 chiều đơn lẻ tiêu
tốn 2 KB RAM. Để lưu trữ phẳng thuần túy, bộ nhớ thô cần N * d * 4 bytes. Tuy nhiên, khi xây dựng
cấu trúc đồ thị (như HNSW) trên bộ nhớ RAM, công thức ước tính tổng dung lượng bộ nhớ thực tế bao
gồm chi phí overhead là:
Dung lượng bộ nhớ = 1.5 * Số lượng vector * Số chiều * 4 bytesChẳng hạn, một tập dữ liệu gồm 100.000 vector OpenAI ada-002 (1536 chiều) sẽ tiêu tốn khoảng 921 MB
RAM theo công thức này. Khi quy mô tăng lên 1 tỷ vector ở độ dài 1536 chiều, dung lượng bộ nhớ thô
cần thiết để lưu trữ phẳng lên tới hơn 9 TB RAM. Độ phức tạp tính toán của thuật toán này ở mức
O(N · d), trong đó N là số lượng vector và d là số chiều.
Nghẽn cổ chai chính của tìm kiếm vét cạn nằm ở băng thông bộ nhớ và năng lực tính toán của CPU/GPU. Thực nghiệm trên tập dữ liệu 1 triệu vector SIFT1M cho thấy, một truy vấn FlatIP hoặc FlatL2 chạy trên CPU máy trạm tiêu tốn trung bình từ 15 ms đến 60 ms chỉ để xử lý xong 1 triệu điểm dữ liệu. Khi quy mô tuyến tính hóa lên 1 tỷ vector (gấp 1.000 lần), độ trễ truy vấn sẽ vọt lên hàng chục giây cho mỗi câu hỏi. Điều này dẫn đến sự sụp đổ hoàn toàn của các hệ thống production vốn yêu cầu phản hồi trong ngưỡng dưới 50 ms.
Để giải quyết rào cản vật lý này, kiến trúc hệ thống tìm kiếm vector buộc phải chuyển đổi từ tìm kiếm
chính xác tuyệt đối (kNN) sang Tìm kiếm Láng giềng Gần đúng (ANNS). Bằng cách chấp nhận đánh đổi một
tỷ lệ rất nhỏ độ chính xác (Recall), ví dụ đạt 95-99% thay vì 100%, các thuật toán ANNS giảm độ
phức tạp thời gian từ O(N · d) xuống mức O(log N) hoặc O(1), mở ra khả năng xử lý hàng tỷ
vector chỉ trong vài mili-giây.
Phân vùng không gian bằng IVF: Gom cụm để thu hẹp phạm vi
Chỉ mục tệp đảo ngược (Inverted File Index, viết tắt IVF) giải quyết bài toán tốc độ bằng cách phân chia không
gian vector đa chiều thành các khu vực hình học nhỏ hơn gọi là sơ đồ Voronoi (Voronoi cells / Dirichlet
tessellation). Trong giai đoạn huấn luyện (train), thuật toán k-means clustering được áp dụng trên tập
dữ liệu để phân gom toàn bộ vector thành nlist cụm riêng biệt, đồng thời xác định vị trí tâm cụm
(centroids) cho từng ô Voronoi đó.
Khi thực hiện truy vấn, IVF áp dụng quy trình xử lý hai giai đoạn (two-stage query):
Vector truy vấn (xq) ---> So sánh với nlist tâm cụm (Centroids)
                                 |
                                 v
                     Xác định các ô Voronoi gần nhất
                                 |
                                 v
               Chỉ quét các vector nằm trong ô đã chọn
Đầu tiên, vector truy vấn xq được so sánh khoảng cách với nlist tâm cụm để xác định các ô
Voronoi nằm gần xq nhất. Ở giai đoạn hai, thuật toán khoanh vùng và chỉ thực hiện tính toán khoảng
cách chi tiết đối với các vector nằm bên trong các ô Voronoi đã chọn, loại bỏ hoàn toàn phần lớn các
vector còn lại trong cơ sở dữ liệu khỏi phạm vi tính toán.
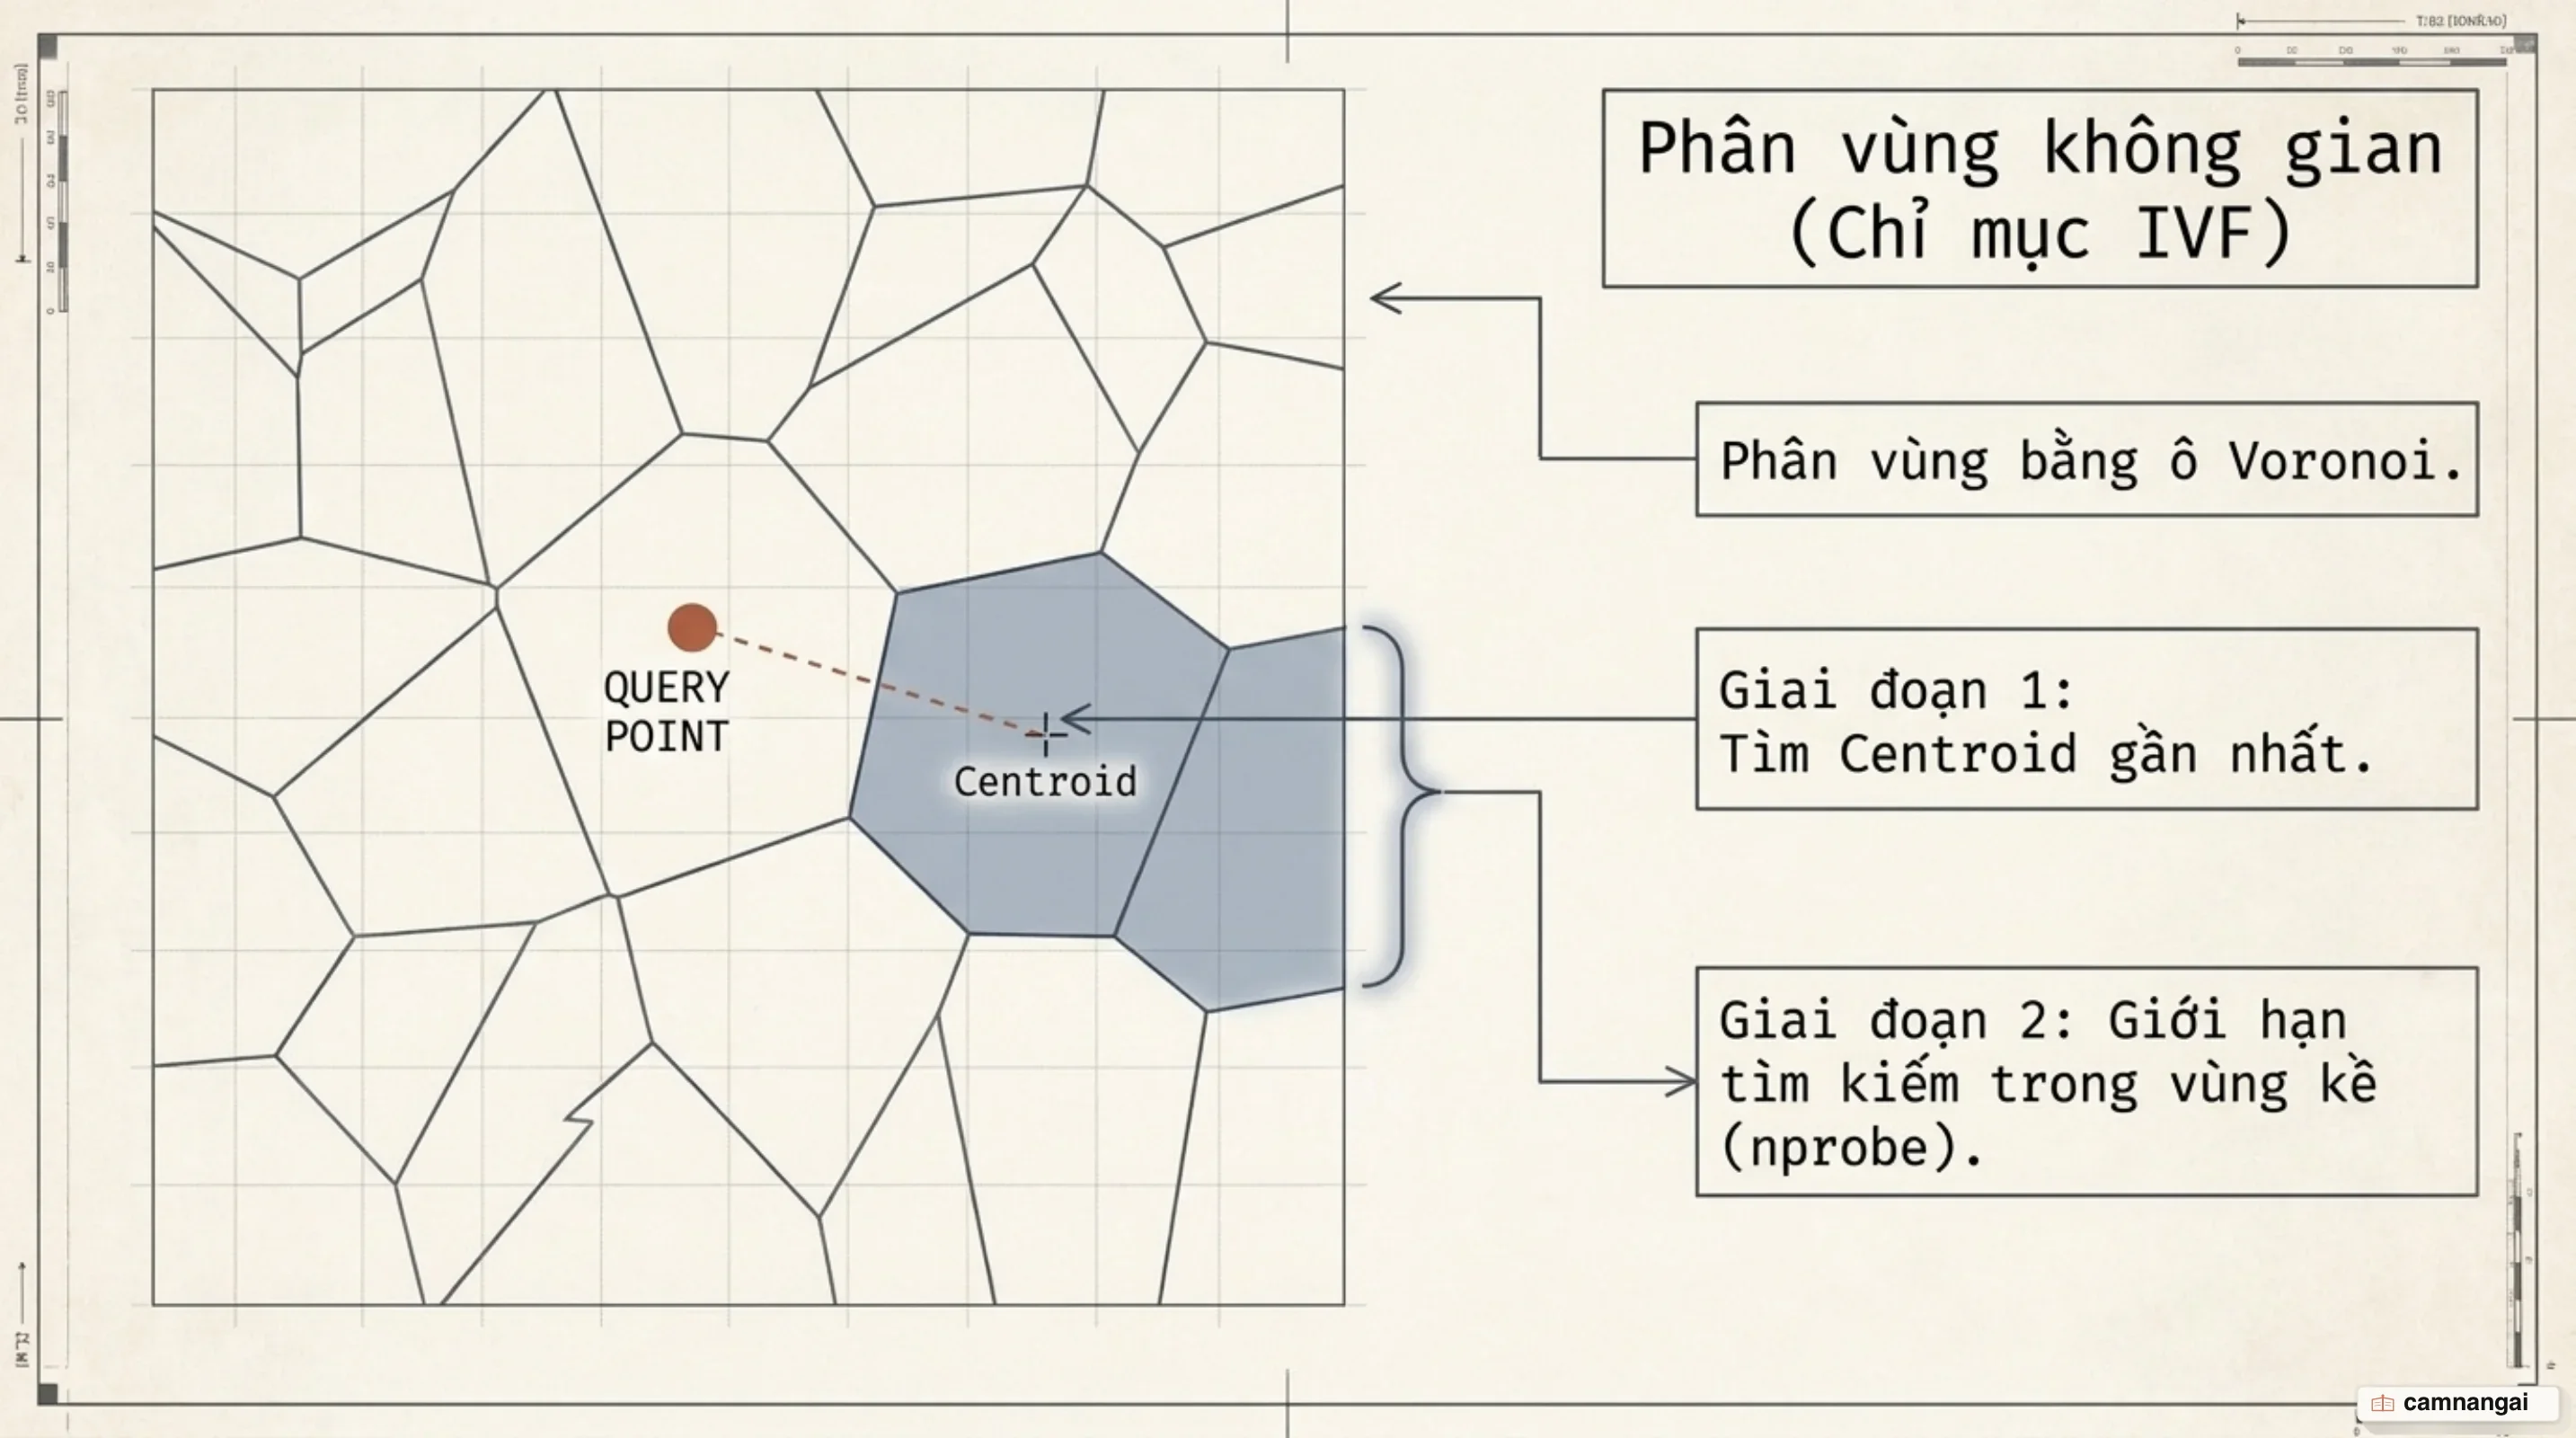
Tuy nhiên, IVF gặp phải "sự cố vùng biên" (edge problem): khi một vector truy vấn nằm sát ranh giới
của một ô Voronoi, điểm dữ liệu gần nó nhất về mặt không gian thực chất lại có thể rơi vào ô
Voronoi lân cận. Để khắc phục, tham số nprobe được cung cấp nhằm điều chỉnh số lượng ô Voronoi được
quét đồng thời khi tìm kiếm. Đánh đổi kỹ thuật ở đây rất rõ ràng:
nlist(Số lượng ô cụm): Tăngnlistgiúp thu nhỏ số lượng vector trong mỗi ô (giảm số phép tính chi tiết), nhưng làm tăng thời gian huấn luyện và chi phí so sánh tâm cụm ban đầu.nprobe(Số lượng ô quét khi truy vấn): Tăngnprobegiúp cải thiện độ chính xác (Recall) vì quét qua nhiều ô lân cận hơn, nhưng làm tăng độ trễ (latency).
Thực nghiệm đo đạc trên tập dữ liệu chuẩn SIFT1M (1 triệu vector, 128 chiều) chứng minh hiệu quả của
phân vùng không gian. So với chỉ mục Flat (đạt Recall 100% với độ trễ ~18 ms), chỉ mục IVF thu hẹp độ
trễ xuống chỉ còn từ 1 ms đến 9 ms, trong khi vẫn duy trì mức Recall ổn định từ 70% đến 95% tùy
thuộc vào cấu hình nprobe và nlist.
Đồ thị HNSW: Đường cao tốc đa tầng trong không gian nhiều chiều
Chỉ mục Đồ thị Thế giới Nhỏ Định tuyến được Phân tầng (Hierarchical Navigable Small World, viết tắt HNSW) lấy cảm hứng từ sự kết hợp giữa cấu trúc danh sách nhảy xác suất (Skip List) và đồ thị thế giới nhỏ định tuyến được (Navigable Small World, NSW). Cấu trúc này giải quyết bài toán tìm kiếm đường đi ngắn nhất trong các mạng lưới kết nối phức tạp có quy mô lớn.
HNSW xây dựng một đồ thị đa tầng (Multi-layer graph):
Layer 2 (Thưa thớt, liên kết xa):
Entry Point ---> [ Nút A ] --------------------------> [ Nút B ]
                     |                                      |
                     v                                      v
Layer 1 (Dày hơn, liên kết tầm trung):
                 [ Nút A ] --------> [ Nút C ] ------> [ Nút B ]
                     |                    |                 |
                     v                    v                 v
Layer 0 (Dày đặc, liên kết ngắn - toàn bộ vector):
                 [ Nút A ] -> [ D ] -> [ C ] -> [ E ] -> [ B ]
Tầng trên cùng chứa các liên kết khoảng cách xa (long-range links) với số lượng nút vô cùng thưa thớt, đóng vai trò như mạng lưới đường cao tốc giúp truy vấn "zoom-in" cực nhanh đến vùng không gian chứa kết quả. Các tầng phía dưới chứa các liên kết khoảng cách ngắn (short-range links) với mật độ nút dày hơn để thực hiện định tuyến chi tiết. Tầng đáy (Layer 0) lưu trữ toàn bộ các nút đại diện cho tất cả vector trong hệ thống.
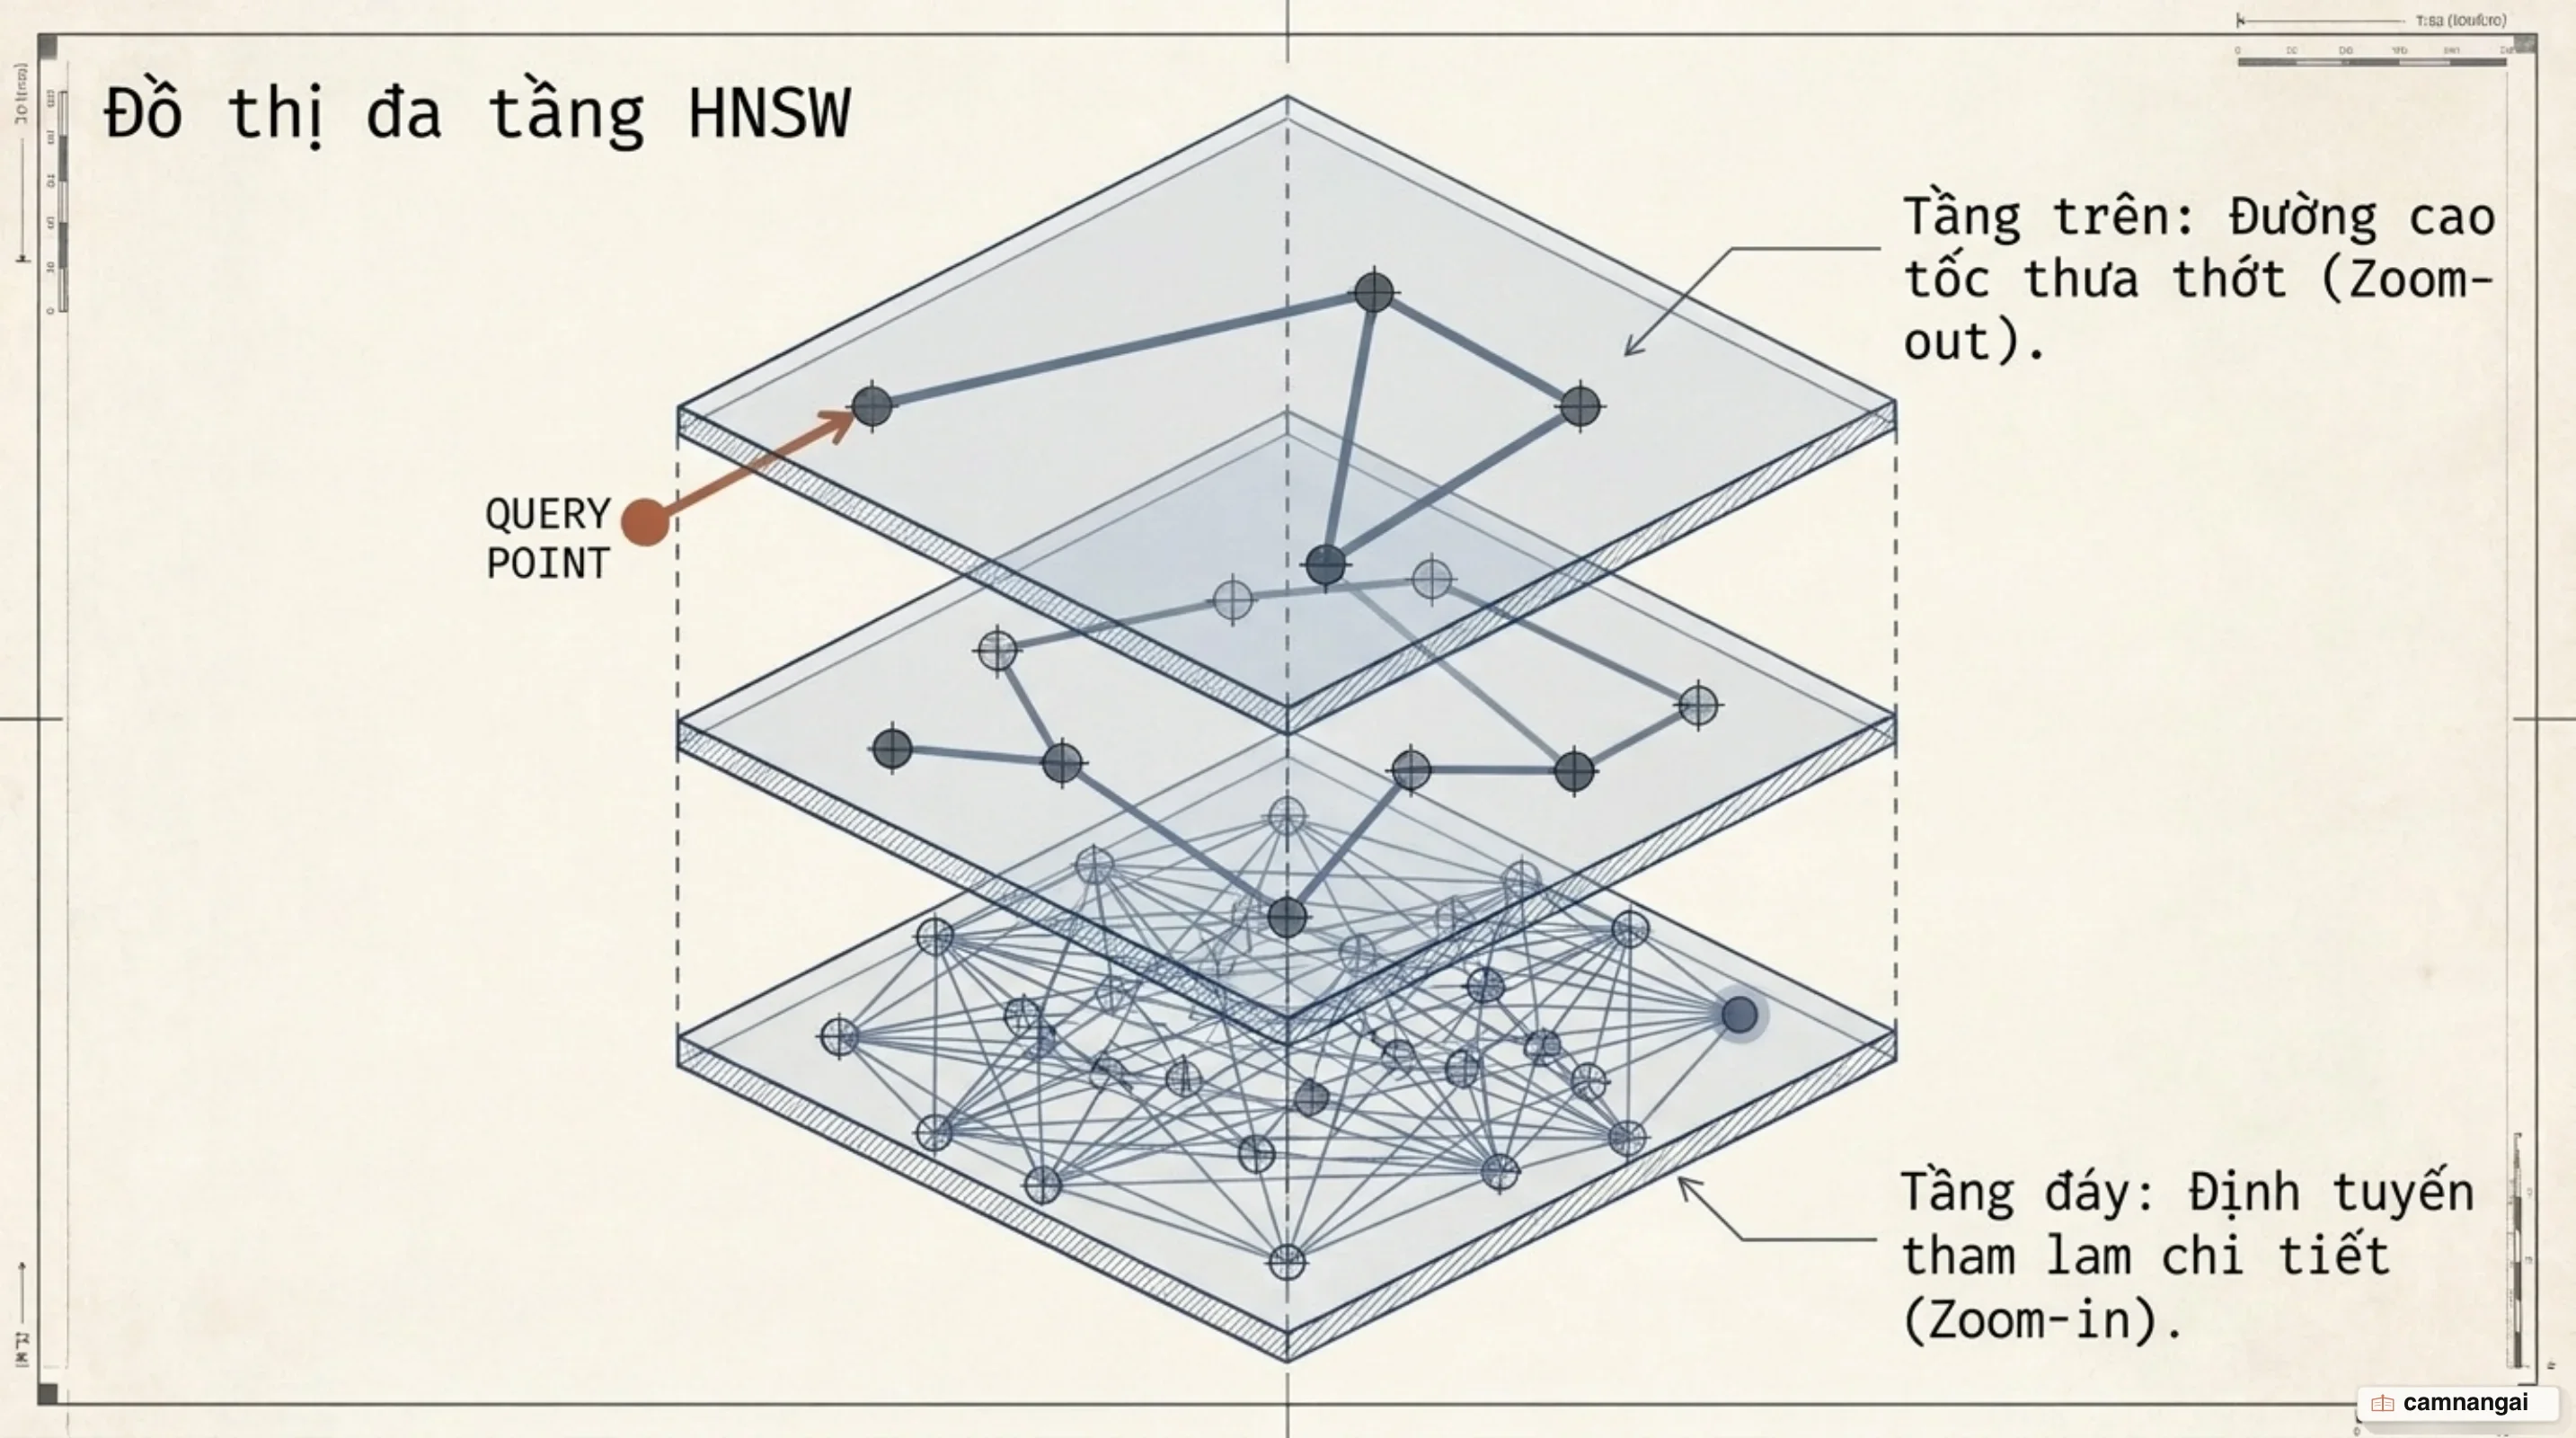
Quá trình tìm kiếm vận hành theo thuật toán duyệt đồ thị tham lam (Greedy routing): bắt đầu từ một
điểm vào (entry point) ở tầng cao nhất, thuật toán chuyển di giữa các đỉnh lân cận để tiến gần nhất
đến vector truy vấn xq. Khi chạm đến một cực tiểu địa phương (local minimum) ở tầng hiện tại, thuật
toán hạ xuống tầng ngay bên dưới tại đúng vị trí nút đó để tiếp tục quá trình định tuyến chi tiết. Quá
trình này lặp lại cho đến Layer 0.
Ba tham số cấu hình cốt lõi chi phối hoạt động của HNSW:
M: Số lượng liên kết tối đa của mỗi đỉnh trên đồ thị (thường từ 16 đến 64).Mcàng lớn, đồ thị càng dày, độ chính xác cao hơn nhưng tốn nhiều bộ nhớ RAM hơn.efConstruction: Độ sâu danh sách ứng viên được đánh giá khi tạo lập liên kết trong giai đoạn xây dựng đồ thị.efSearch: Độ sâu tìm kiếm tại thời điểm thực thi truy vấn. TăngefSearchgiúp tăng Recall nhưng tăng nhẹ độ trễ.
Về mặt vận hành, HNSW đem lại hiệu năng cao với tốc độ truy vấn rất nhanh (thường dưới 1-2 ms
trên tập SIFT1M) và duy trì độ chính xác Recall gần như tuyệt đối (95-100%). Mặc dù vậy, hạn chế lớn
nhất của HNSW là chi phí bộ nhớ RAM rất cao. Với cấu hình M = 64, chỉ mục HNSW có thể tiêu tốn thêm
hàng trăm gigabyte RAM overhead chỉ để chứa cấu trúc con trỏ liên kết của đồ thị.
Nén vector bằng Quantization: Đưa hàng terabyte dữ liệu vào RAM
Lượng hóa (Quantization) là phương pháp nén dữ liệu nhằm giảm độ chính xác bit biểu diễn của các phần tử thay vì giảm số chiều của vector. Hai kỹ thuật lượng hóa phổ biến nhất hiện nay là Lượng hóa Vô hướng (Scalar Quantization, SQ) và Lượng hóa Sản phẩm (Product Quantization, PQ).
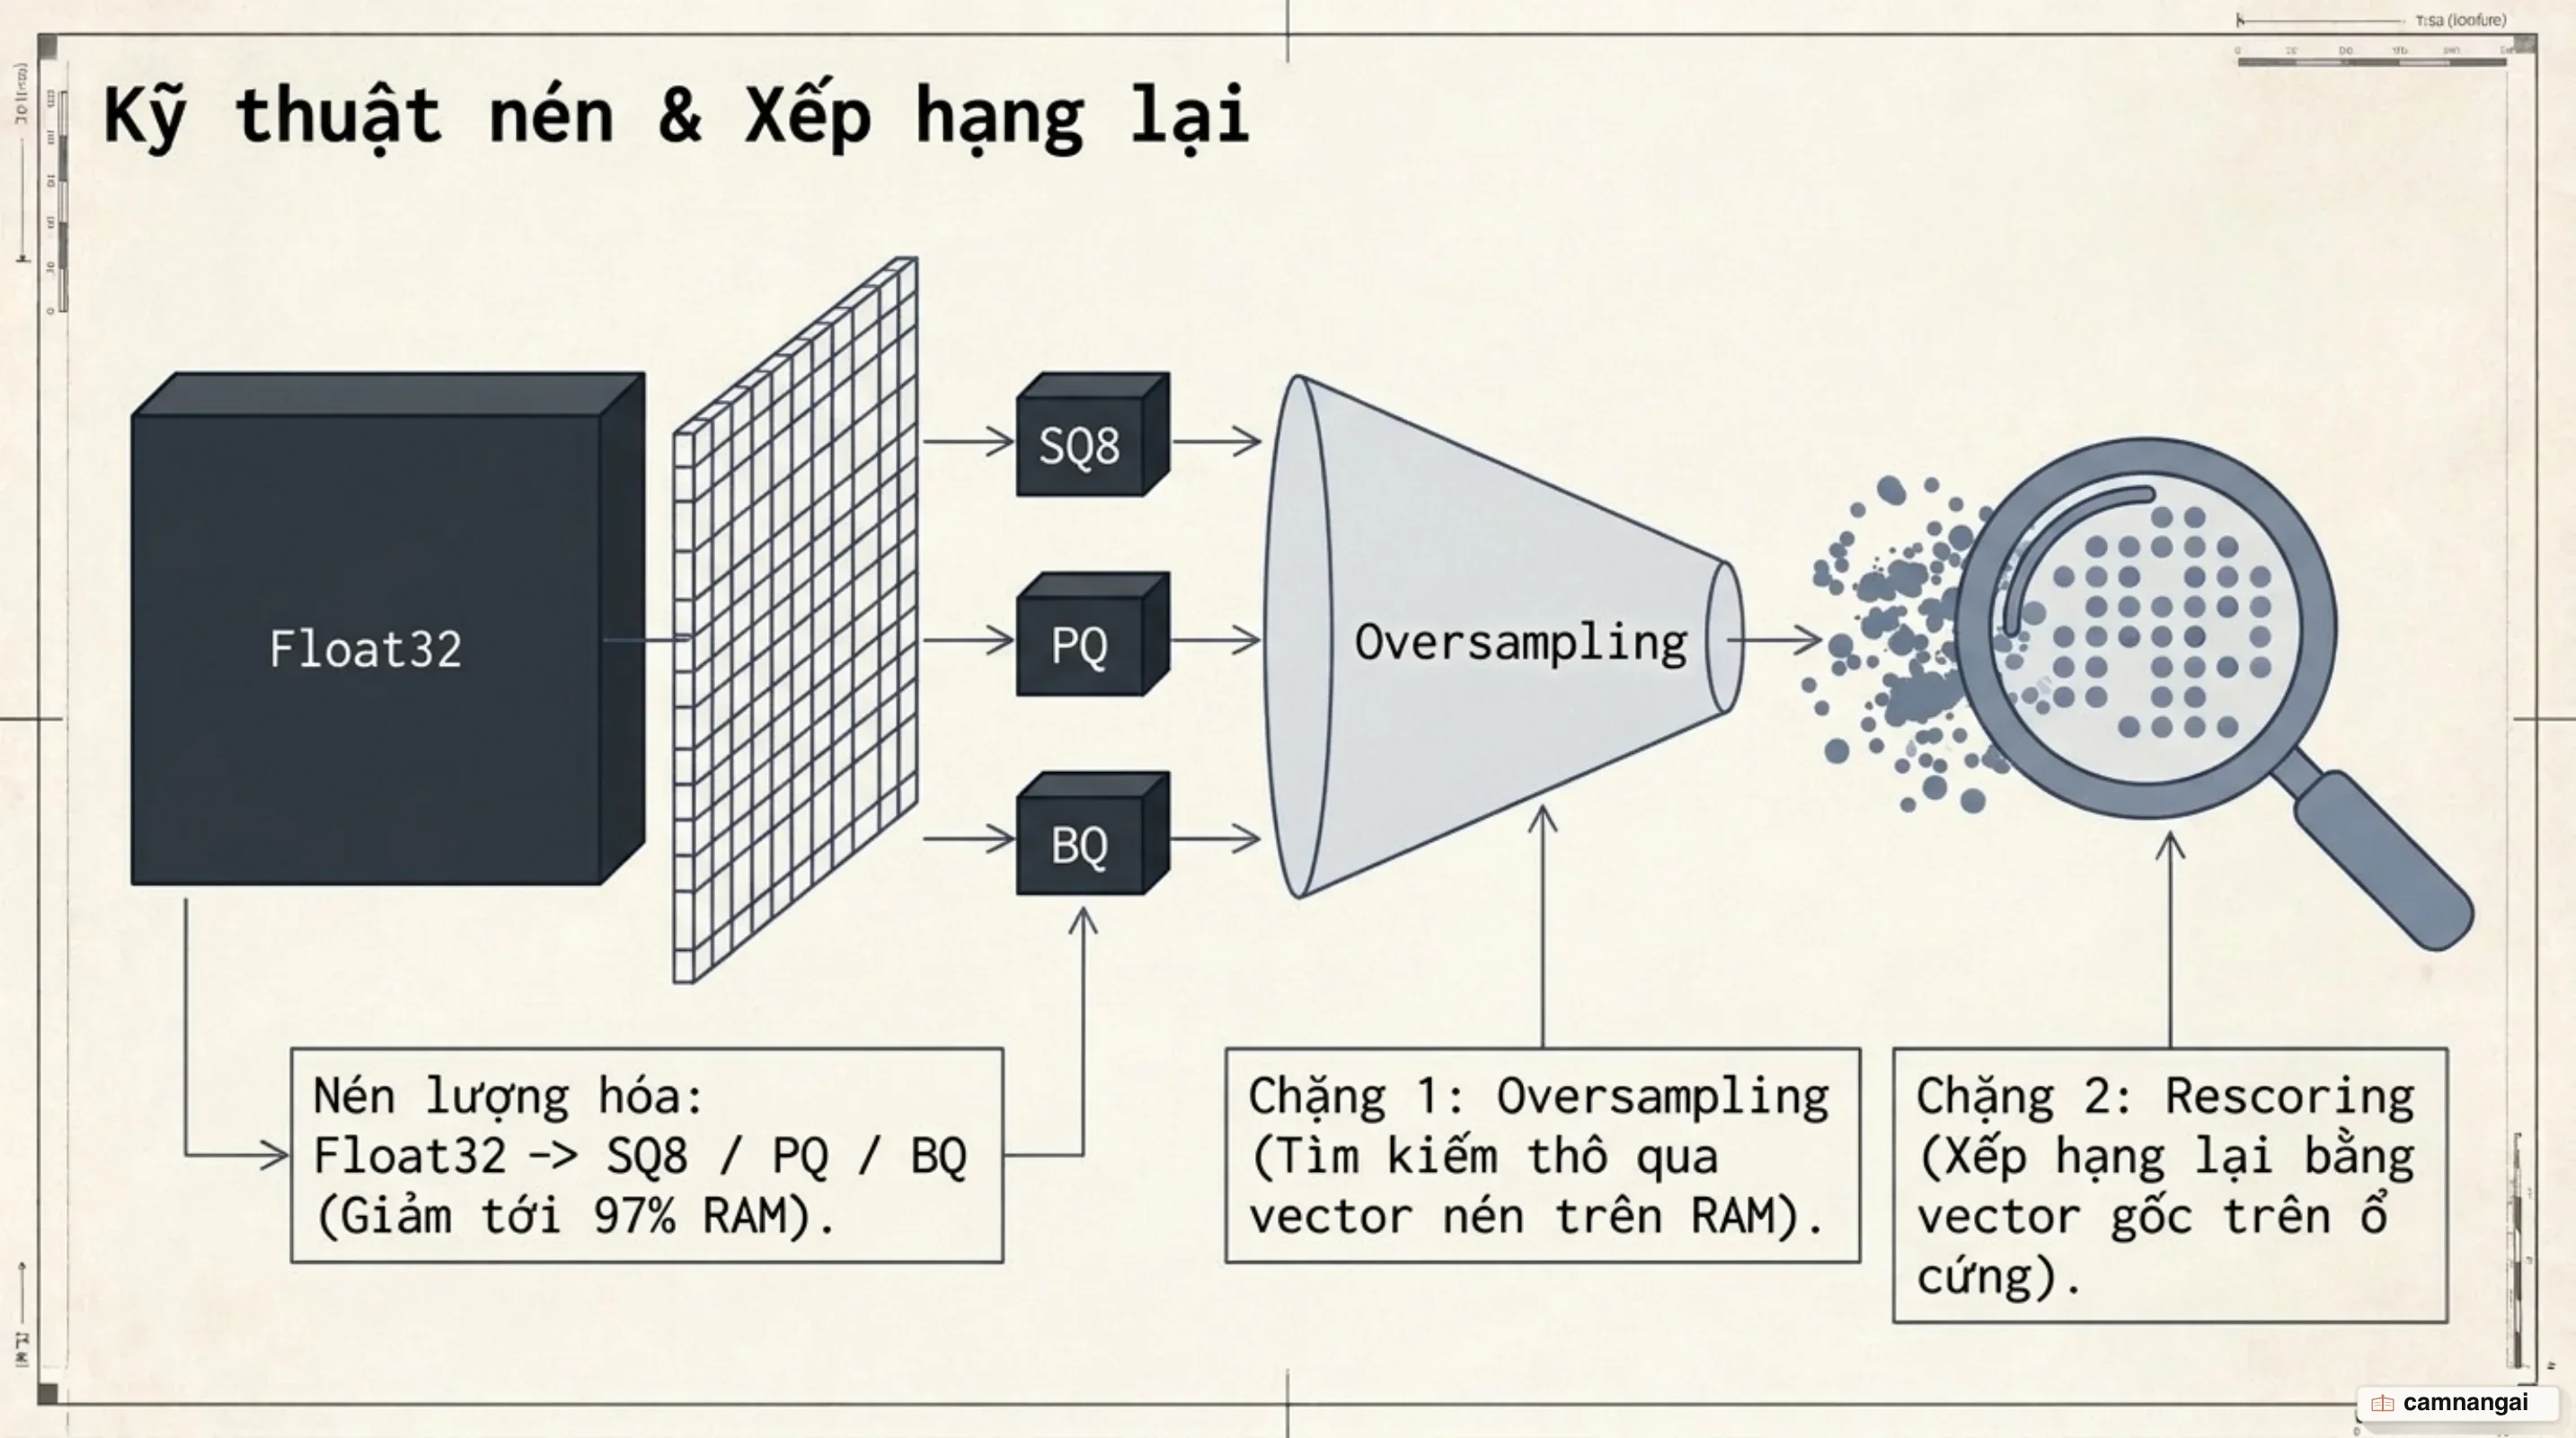
Kỹ thuật Scalar Quantization (SQ8) tiến hành ép kiểu dữ liệu từ float32 (chiếm 4 bytes) xuống int8
(chiếm 1 byte) cho từng phần tử của vector, giúp tiết kiệm ngay lập tức 75% dung lượng bộ nhớ RAM.
Phép chuyển đổi tuân theo công thức tuyến tính:
f32 = alpha * i8 + offsetĐể tránh hiện tượng nhiễu do các giá trị ngoại lệ (outliers), thuật toán sử dụng tham số phân vị
(quantile, thường chọn từ 0.95 đến 0.99) để giới hạn dải biểu diễn. Nhờ khả năng tính toán trước các
hằng số offset và alpha, các lệnh SIMD (như AVX-512 hoặc ARM NEON) có thể xử lý song song các phép
toán trên int8 với tốc độ cao hơn đáng kể. Kết quả benchmark thực tế cho thấy SQ8 giúp giảm 40-60% độ trễ
tìm kiếm trong khi độ suy giảm Recall rất thấp (thường dưới 0.5%).
Đối với các hệ thống quy mô lớn hơn, Product Quantization (PQ) và Binary Quantization (BQ) mang lại tỷ lệ nén sâu hơn:
- Product Quantization (PQ): Chia một vector
Dchiều thànhmsub-vectors nhỏ hơn. Thuật toán tiến hành gom cụm từng không gian con này để tạo ra một bảng mã (Codebook) chứa các tâm cụm sub-space, sau đó thay thế các sub-vector bằng ID đại diện (thường là 1 byte). PQ có khả năng nén dung lượng tập dữ liệu lên đến 95-97% (ví dụ nén tập dữ liệu 1 triệu vector 128 chiều từ 256 MB xuống còn dưới 10 MB trong chỉ mục IVFPQ). - Binary Quantization (BQ): Binarization chuyển đổi từng giá trị
float32thành giá trị 1-bit boolean (lớn hơn 0 thành 1, nhỏ hơn hoặc bằng 0 thành 0). Nhờ đặc tính dư thừa tham số (over-parameterization) của các mô hình embedding lớn (từ 1024 chiều trở lên như OpenAI 1536 chiều), BQ đạt tỷ lệ nén 32x đến 40x. Phép tính khoảng cách chuyển từ nhân số thực sang phép toán XOR kết hợp với lệnh đếm bit bậtPOPCNTcủa CPU, tăng tốc độ tính toán lên tới 40 lần.
Để khắc phục hiện tượng mất mát thông tin khi nén, các hệ thống áp dụng luồng dữ liệu hai chặng với
chiến lược Oversampling và Rescoring (Tái xếp hạng). Ở chặng một, chỉ mục đã lượng hóa (BQ hoặc SQ)
lưu trong RAM được sử dụng để rút ra danh sách ứng viên rộng hơn (top-(k * oversampling) với
oversampling >= 2.0). Ở chặng hai, hệ thống truy xuất các vector gốc float32 lưu dưới đĩa NVMe SSD
hoặc bộ nhớ phụ để tính toán lại điểm số khoảng cách chính xác cho tập ứng viên này, giúp khôi phục
Recall gần như nguyên bản mà vẫn giữ mức tiêu thụ RAM cực thấp.
DiskANN và Vamana: Phá vỡ giới hạn bộ nhớ bằng ổ cứng NVMe SSD
Khi quy mô tập dữ liệu vượt mốc 1 tỷ vector, dung lượng lưu trữ thô và chỉ mục vượt quá hàng Terabyte. Việc duy trì toàn bộ chỉ mục thuần RAM như HNSW trở nên quá đắt đỏ và không khả thi về mặt chi phí hạ tầng cho đại đa số doanh nghiệp.
DiskANN giải quyết rào cản này bằng cách xây dựng đồ thị phẳng Vamana được tối ưu hóa để lưu trữ trực tiếp trên ổ cứng NVMe SSD. Kiến trúc DiskANN chia làm hai thành phần:
- Các vector nén bằng PQ hoặc SQ với dung lượng siêu nhẹ được giữ lại trong RAM để phục vụ việc định tuyến nhảy nút trên đồ thị (graph routing).
- Toàn bộ dữ liệu vector gốc
float32cùng với danh sách kề (adjacency list) đầy đủ của đồ thị Vamana được lưu trữ hoàn toàn dưới đĩa SSD.
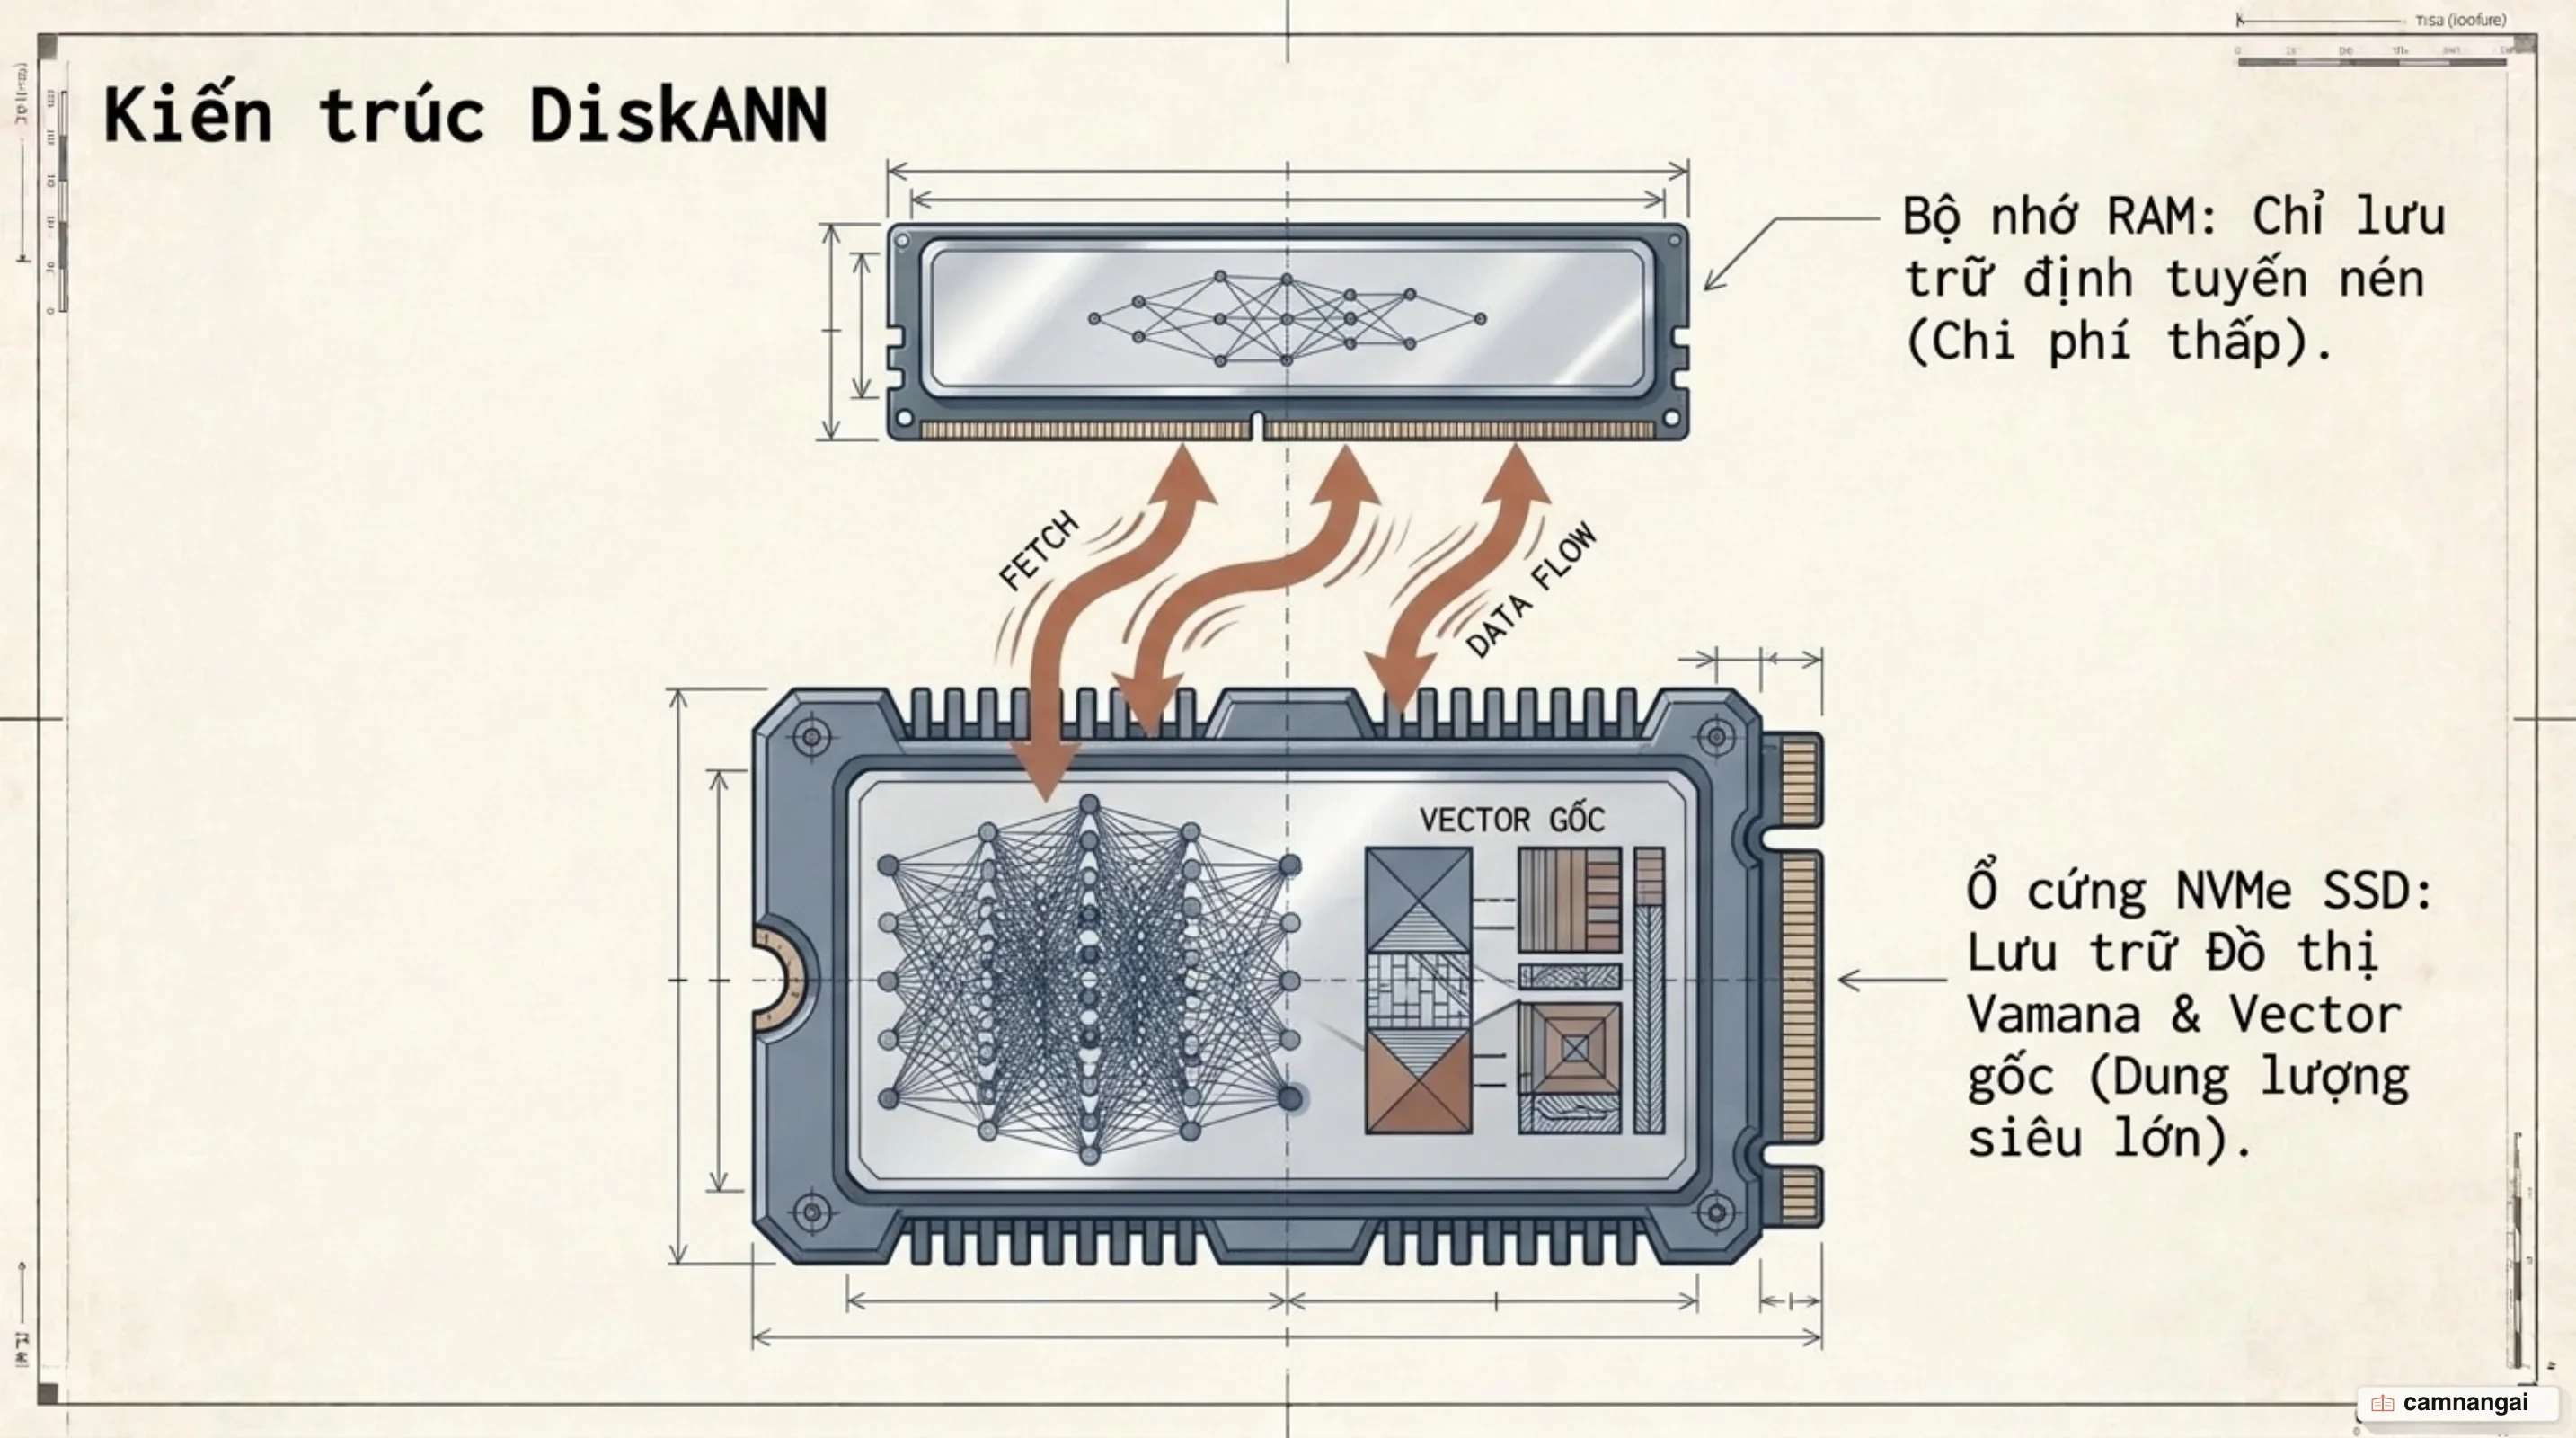
Cơ chế vận hành của DiskANN khai thác triệt để băng thông đọc ngẫu nhiên (random IOPS) rất cao của thế hệ ổ cứng NVMe SSD hiện đại. Trong quá trình duyệt đồ thị, thuật toán phát ra các lệnh đọc dữ liệu không đồng bộ (Asynchronous I/O) song song. Việc này cho phép truy xuất đồng thời danh sách láng giềng của nhiều nút trên đĩa, hạn chế số vòng lặp I/O tuần tự trong suốt luồng truy vấn.
Hiệu năng thực tế chứng minh DiskANN phá vỡ giới hạn bộ nhớ RAM: hệ thống cho phép phục vụ truy vấn trên tập dữ liệu 1 tỷ vector chỉ với một máy chủ có dung lượng RAM 64 GB kết hợp với ổ cứng NVMe SSD thương mại. Mô hình này đạt độ chính xác Recall trên 95% ở tốc độ xử lý hàng nghìn QPS (Queries Per Second) với độ trễ trung bình chỉ duy trì ở mức vài mili-giây.
Lọc metadata theo thời gian thực: Single-stage filtering giải quyết nghịch lý
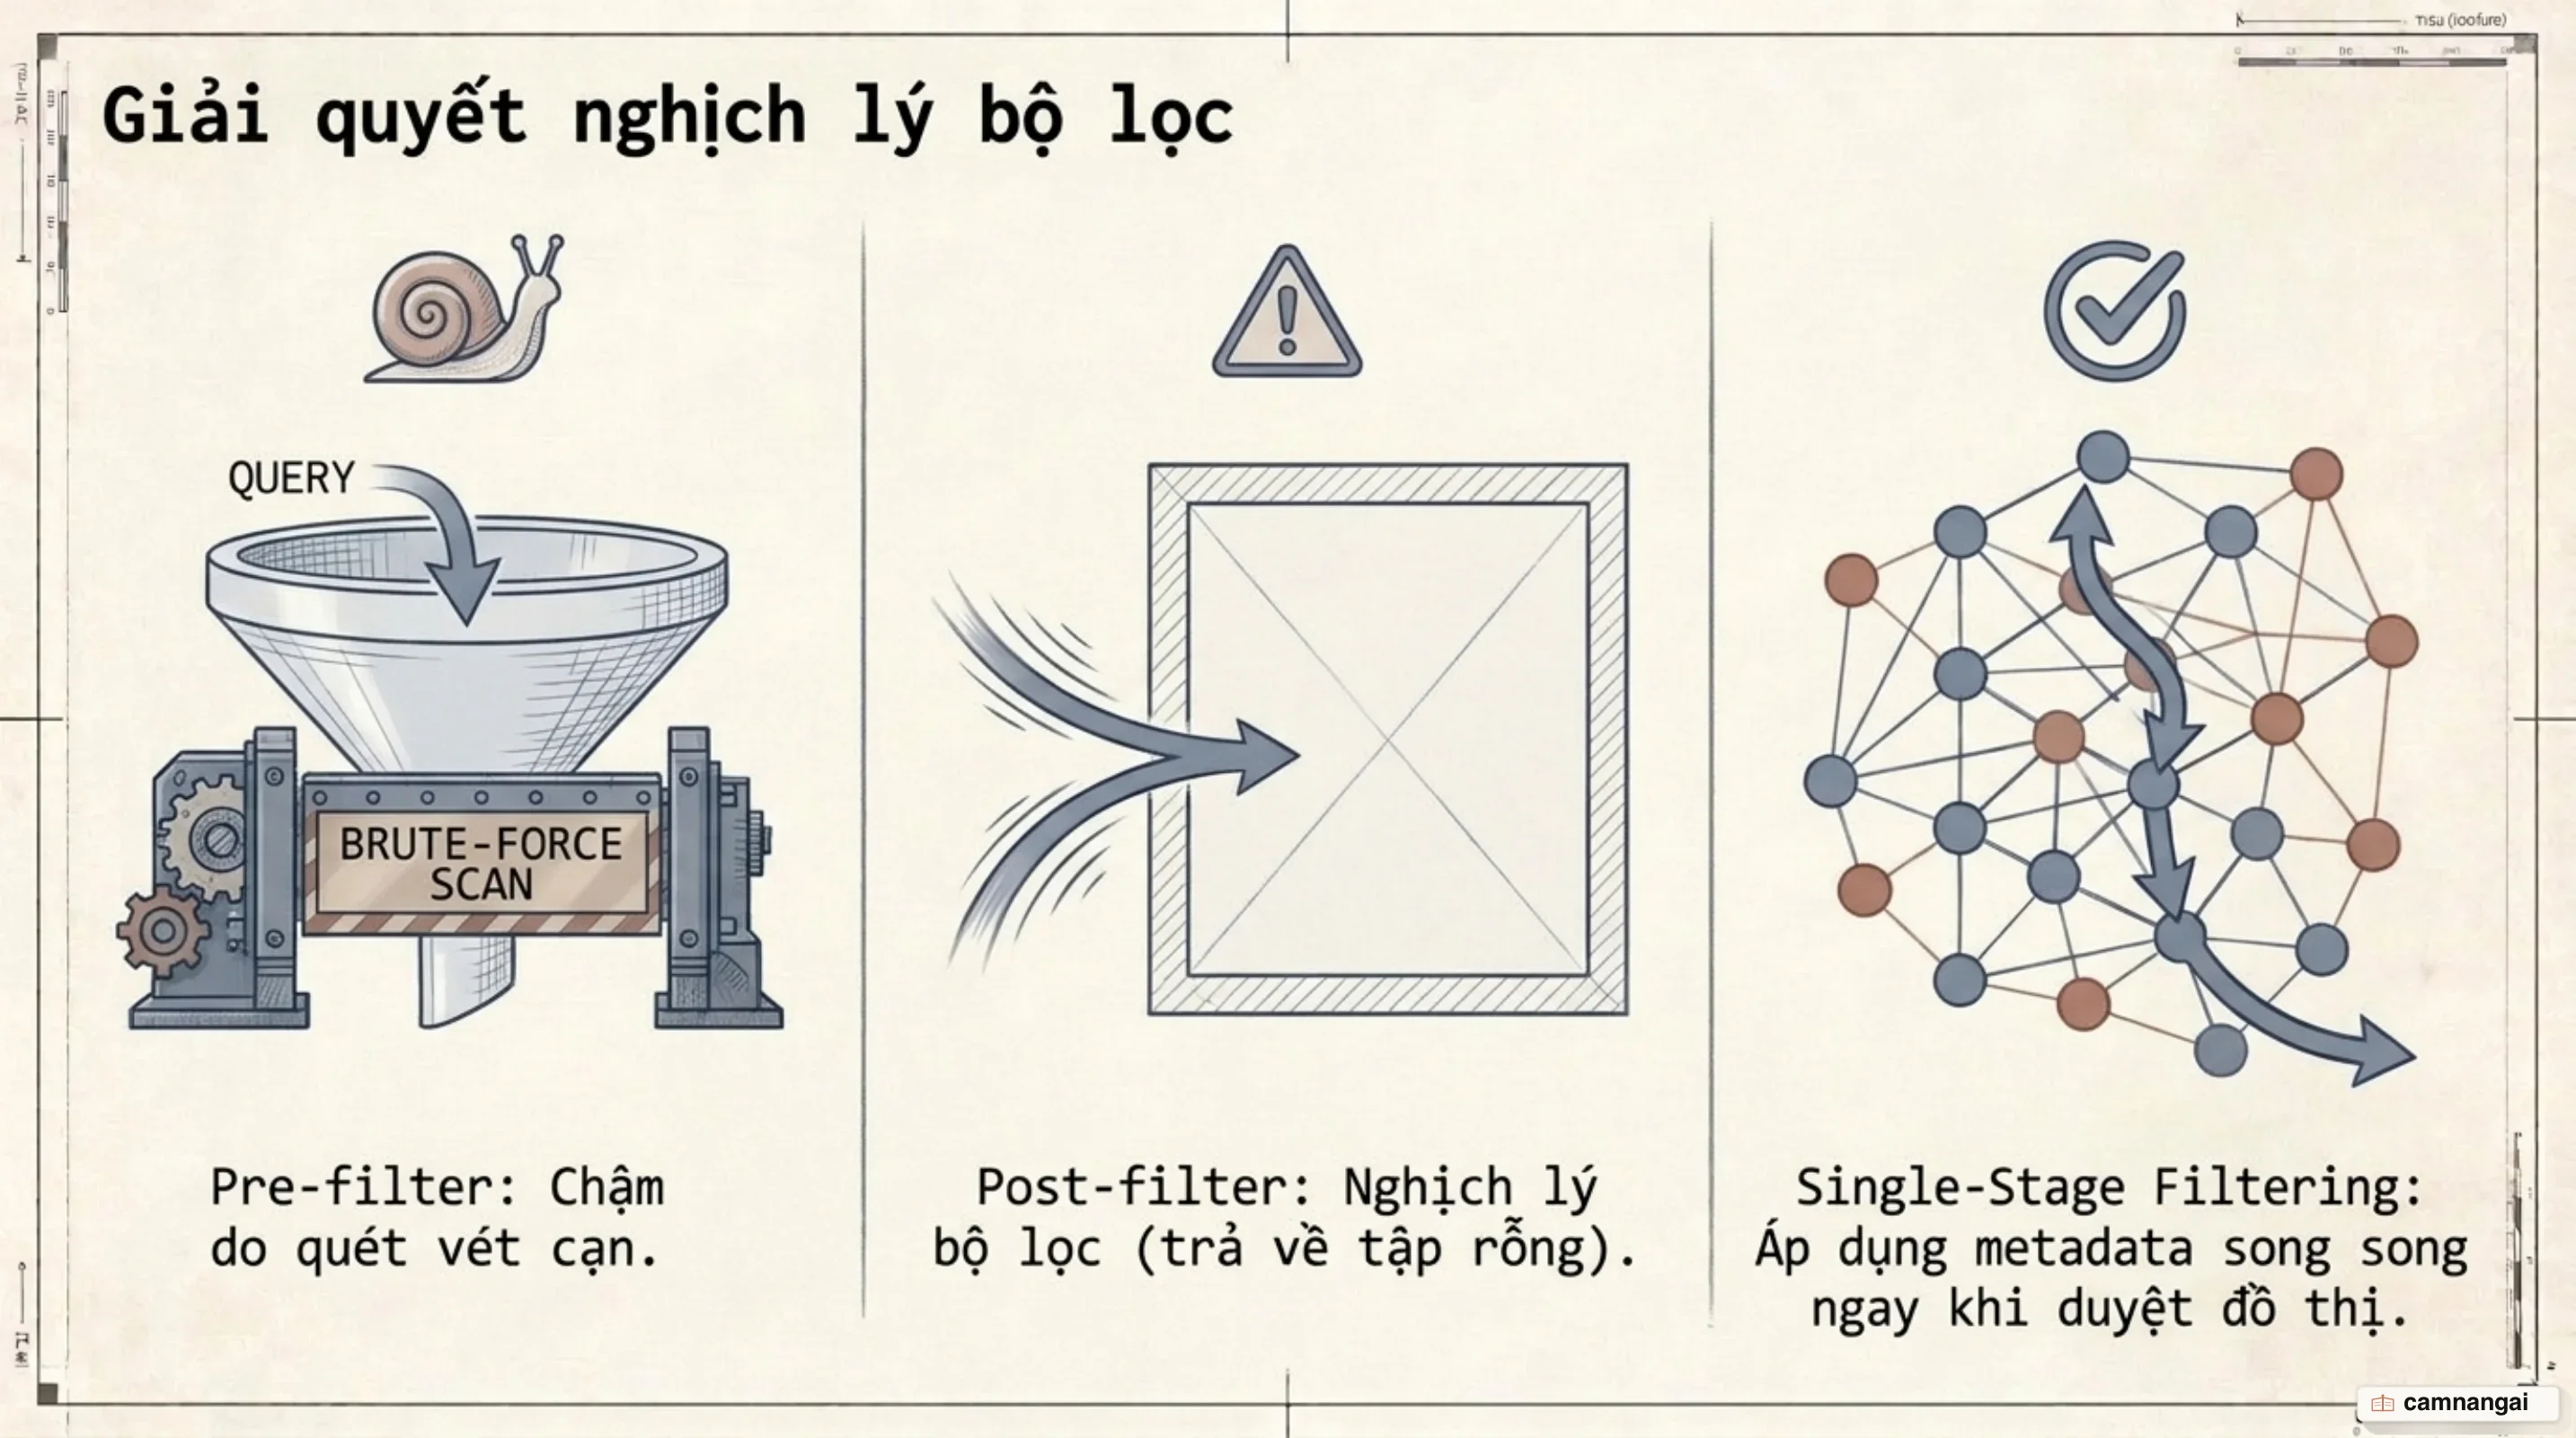
Trong các ứng dụng thực tế, truy vấn vector hiếm khi đứng độc lập mà luôn đi kèm điều kiện lọc thuộc
tính (metadata filtering), ví dụ tìm tài liệu có phong_ban == 'ky_thuat' hoặc nam >= 2024. Vấn
đề này tạo ra nghịch lý bộ lọc và làm sụp đổ hai phương pháp xử lý truyền thống:
- Pre-filtering: Tiến hành lọc metadata trước để lấy danh sách ID hợp lệ, sau đó mới tìm kiếm vector. Việc loại bỏ bớt các nút làm phá vỡ hoàn toàn cấu trúc đồ thị liên kết của chỉ mục ANNS, buộc hệ thống phải quay về chạy kNN vét cạn trên tập dữ liệu còn lại, gây nghẽn nghiêm trọng khi dữ liệu lớn.
- Post-filtering: Thực hiện tìm kiếm vector top-k trước rồi mới áp bộ lọc metadata. Phương pháp này đối mặt với rủi ro lớn là trả về quá ít hoặc thậm chí 0 kết quả nếu tất cả các vector nằm trong top-k ban đầu không thỏa mãn điều kiện lọc.
Giải pháp hiện đại cho bài toán này là cơ chế Single-Stage Filtering (được triển khai trong các hệ thống như Pinecone hay Milvus). Kiến trúc này hợp nhất chỉ mục metadata và chỉ mục vector vào làm một cấu trúc chỉ mục duy nhất:
Luồng xử lý Single-Stage Filtering:
Truy vấn đầu vào + Điều kiện lọc metadata
                    |
                    v
    +------------------------------------+
    | Chỉ mục tích hợp Vector & Metadata |
    +------------------------------------+
                    |
      Kiểm tra điều kiện metadata song song
      trong quá trình duyệt từng cạnh đồ thị
                    |
                    v
  Bỏ qua nút không khớp nhưng giữ nguyên đường đi
Về mặt kỹ thuật, trong quá trình thực thi thuật toán duyệt đồ thị HNSW hoặc quét các ô Voronoi, engine đồng thời kiểm tra điều kiện metadata ngay tại từng nút đang duyệt. Nếu nút hiện tại không thỏa mãn bộ lọc metadata, thuật toán sẽ bỏ qua việc tính điểm khoảng cách vector của nút đó nhưng vẫn sử dụng các cạnh liên kết của nó để nhảy sang nút kề tiếp theo trong đồ thị mà không làm gián đoạn luồng di chuyển ANNS.
Dữ liệu thử nghiệm thực tế cho thấy cơ chế này vừa duy trì độ chính xác cao vừa rút ngắn thời gian phản hồi: khi áp dụng các bộ lọc có tính chọn lọc cao (chỉ giữ lại 1% hoặc 5% dữ liệu), không gian tìm kiếm được thu hẹp tự nhiên, giúp tốc độ truy vấn thậm chí còn nhanh hơn so với khi không áp dụng bộ lọc.
Kiến trúc phân tán: Tách rời lưu trữ và tính toán ở quy mô production
Các kiến trúc đơn khối (monolithic / pod-based / single node) bộc lộ nhiều điểm yếu khi vận hành ở quy mô hàng tỷ vector trong môi trường sản xuất. Việc nâng cấp tài nguyên gặp nhiều hạn chế, chi phí duy trì RAM tốn kém khi dữ liệu ít được truy vấn, và hệ thống dễ bị nghẽn băng thông khi lượng truy cập tăng đột biến.
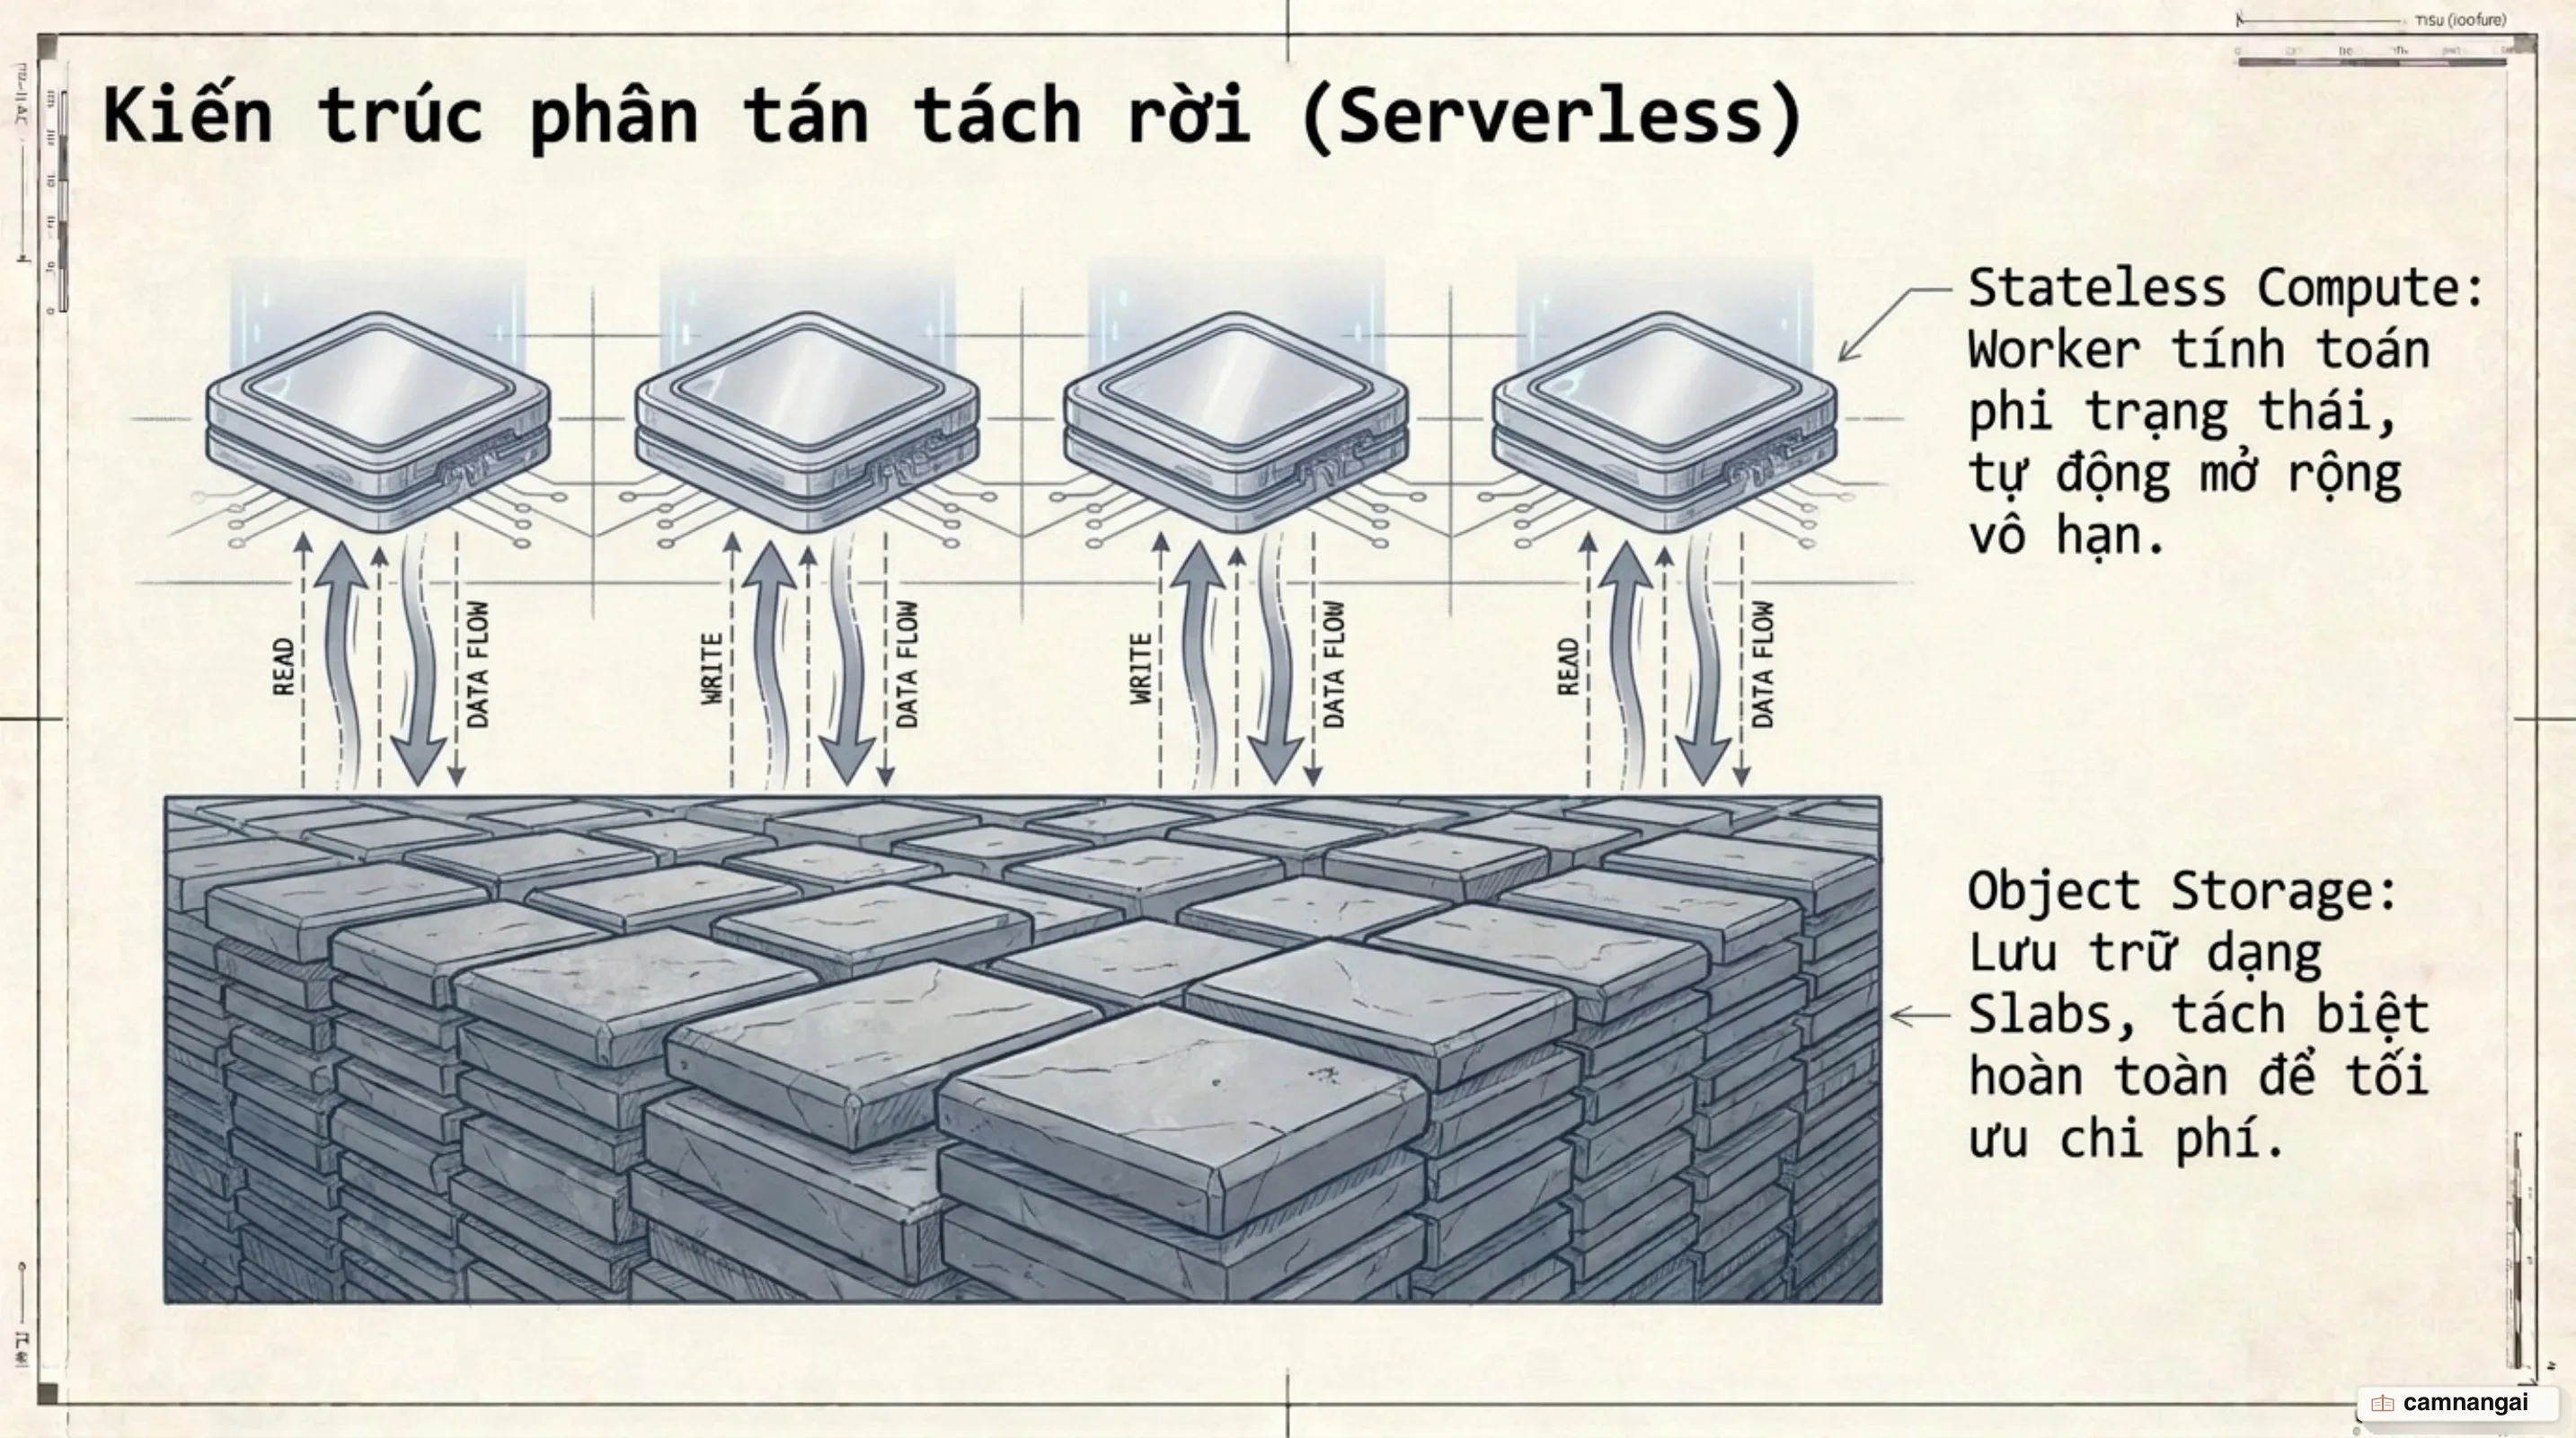
Để vượt qua các rào cản này, các vector database cloud-native hiện đại chuyển sang thiết kế tách rời tài nguyên (Decoupled Storage and Compute Architecture). Cấu trúc hệ thống được chia làm 3 lớp độc lập:
Kiến trúc tách rời Lưu trữ và Tính toán:
                +----------------------------+
                | Lớp Worker Stateless       |
                | (Compute Nodes tính toán)  |
                +----------------------------+
                   /                       \
        Đọc truy vấn /                      \ Ghi dữ liệu /
        Cache cục bộ                         \ Phân vùng
                 v                           v
     +---------------------------------------------------+
     | Lưu trữ đối tượng tập trung (Object/Blob Storage) |
     | (Lưu trữ các phân mảnh dữ liệu dạng Slabs)        |
     +---------------------------------------------------+
Nguyên lý vận hành của kiến trúc phân tán Serverless được tối ưu hóa như sau:
- Dữ liệu phân mảnh dạng Slab: Dữ liệu vector được gom cụm theo không gian hình học và ghi thành các khối dữ liệu bất biến (immutable slabs) lưu trữ trực tiếp trên Object Storage giá rẻ (như AWS S3).
- Lớp tính toán phi trạng thái (Stateless Compute): Các worker node đảm nhận việc tính toán khoảng cách và định tuyến truy vấn mà không cần lưu trữ toàn bộ cơ sở dữ liệu trên đĩa cục bộ.
- Bộ nhớ đệm thông minh (Local Caching): Các worker node tải và lưu cache các tâm cụm và phân vùng đang hoạt động sôi nổi (warm namespaces). Nhờ đó, các truy vấn thường xuyên được phục vụ với độ trễ mili-giây mà không phát sinh chi phí đọc lặp lại từ Object Storage.
Mô hình phân tán tách rời giúp tối ưu hóa chi phí vận hành nhờ cơ chế thanh toán theo lượng sử dụng thực tế (Pay-as-you-go). Khả năng tự động mở rộng (autoscaling) của kiến trúc cho phép phục vụ hàng triệu người dùng trên các tập dữ liệu hàng tỷ tài liệu mà không đòi hỏi kỹ sư phải cấu hình và bảo trì các cụm máy chủ cồng kềnh.
Lựa chọn kiến trúc chỉ mục nào cho hệ thống của bạn?
Để xây dựng một hệ thống tìm kiếm vector tối ưu, bạn cần cân nhắc quy mô dữ liệu và giới hạn ngân sách hạ tầng để lựa chọn chỉ mục phù hợp:
| Quy mô dữ liệu | Ràng buộc chính | Kiến trúc chỉ mục khuyến nghị |
|---|---|---|
| Dưới 10.000 vectors | Yêu cầu 100% độ chính xác | Flat (FlatL2 hoặc FlatIP), không cần tạo chỉ mục |
| Dưới 10 triệu vectors | Độ trễ cực thấp, Recall 95-100% | HNSW thuần in-memory (RAM không giới hạn) |
| 10M - 100M+ vectors | Tiết kiệm RAM, máy chủ đơn | HNSW kết hợp SQ8, hoặc IVF-PQ |
| Trên 1 tỷ vectors | RAM hạn chế, tối ưu chi phí | DiskANN (Vamana trên NVMe SSD) + Oversampling & Rescoring |
| Đa khách hàng, lưu lượng biến thiên | Vận hành đơn giản, co giãn tự động | Kiến trúc phân tán Serverless (Blob Storage + Stateless Compute) |
ANNS trong vector database luôn là bài toán cân bằng giữa 3 yếu tố cốt lõi: Độ trễ truy vấn (Latency), Độ chính xác (Recall) và Chi phí hạ tầng (Memory/Cost). Việc hiểu rõ bản chất kỹ thuật của từng loại chỉ mục giúp bạn đưa ra quyết định kiến trúc chính xác nhất cho ứng dụng AI của mình.
Tài liệu tham khảo
- Faiss: A library for efficient similarity search (Engineering at Meta)
- Hierarchical Navigable Small Worlds (HNSW) (Pinecone)
- Nearest Neighbor Indexes for Similarity Search (Pinecone)
- Product Quantization: Compressing high-dimensional vectors by 97% (Pinecone)
- Scalar Quantization for Vector Search (Qdrant)
- Binary Quantization: 40x Faster Vector Search (Qdrant)
- Disk-based DiskANN: High Recall and QPS on Billion-scale Datasets (Zilliz blog)
- The Missing WHERE Clause in Vector Search (Pinecone)
- Introducing Pinecone Serverless (Pinecone)