Qdrant là máy tìm kiếm vector tương đồng (vector similarity search engine) và cơ sở dữ liệu vector mã nguồn mở được viết hoàn toàn bằng ngôn ngữ Rust.
Hệ thống được thiết kế để cung cấp dịch vụ hạ tầng tìm kiếm hiệu năng cao thông qua các API chuẩn hóa, cho phép bạn lưu trữ, quản lý và truy vấn các tập hợp Point, bao gồm các vector biểu diễn không gian cùng với thông tin bổ sung (payload) đi kèm.
Trong các kiến trúc AI hiện đại như RAG (Retrieval-Augmented Generation) hay hệ thống gợi ý, bài toán không dừng lại ở việc tìm kiếm vector thuần túy mà đòi hỏi kết hợp linh hoạt với các điều kiện lọc dữ liệu thực tế.
Qdrant giải quyết triệt để rào cản này bằng cách tích hợp trực tiếp cơ chế lọc metadata vào quá trình duyệt đồ thị vector, giúp tối ưu hóa tài nguyên phần cứng từ CPU, GPU đến đĩa lưu trữ với độ trễ tối thiểu.
Qdrant là gì và ra đời giải quyết bài toán nào?
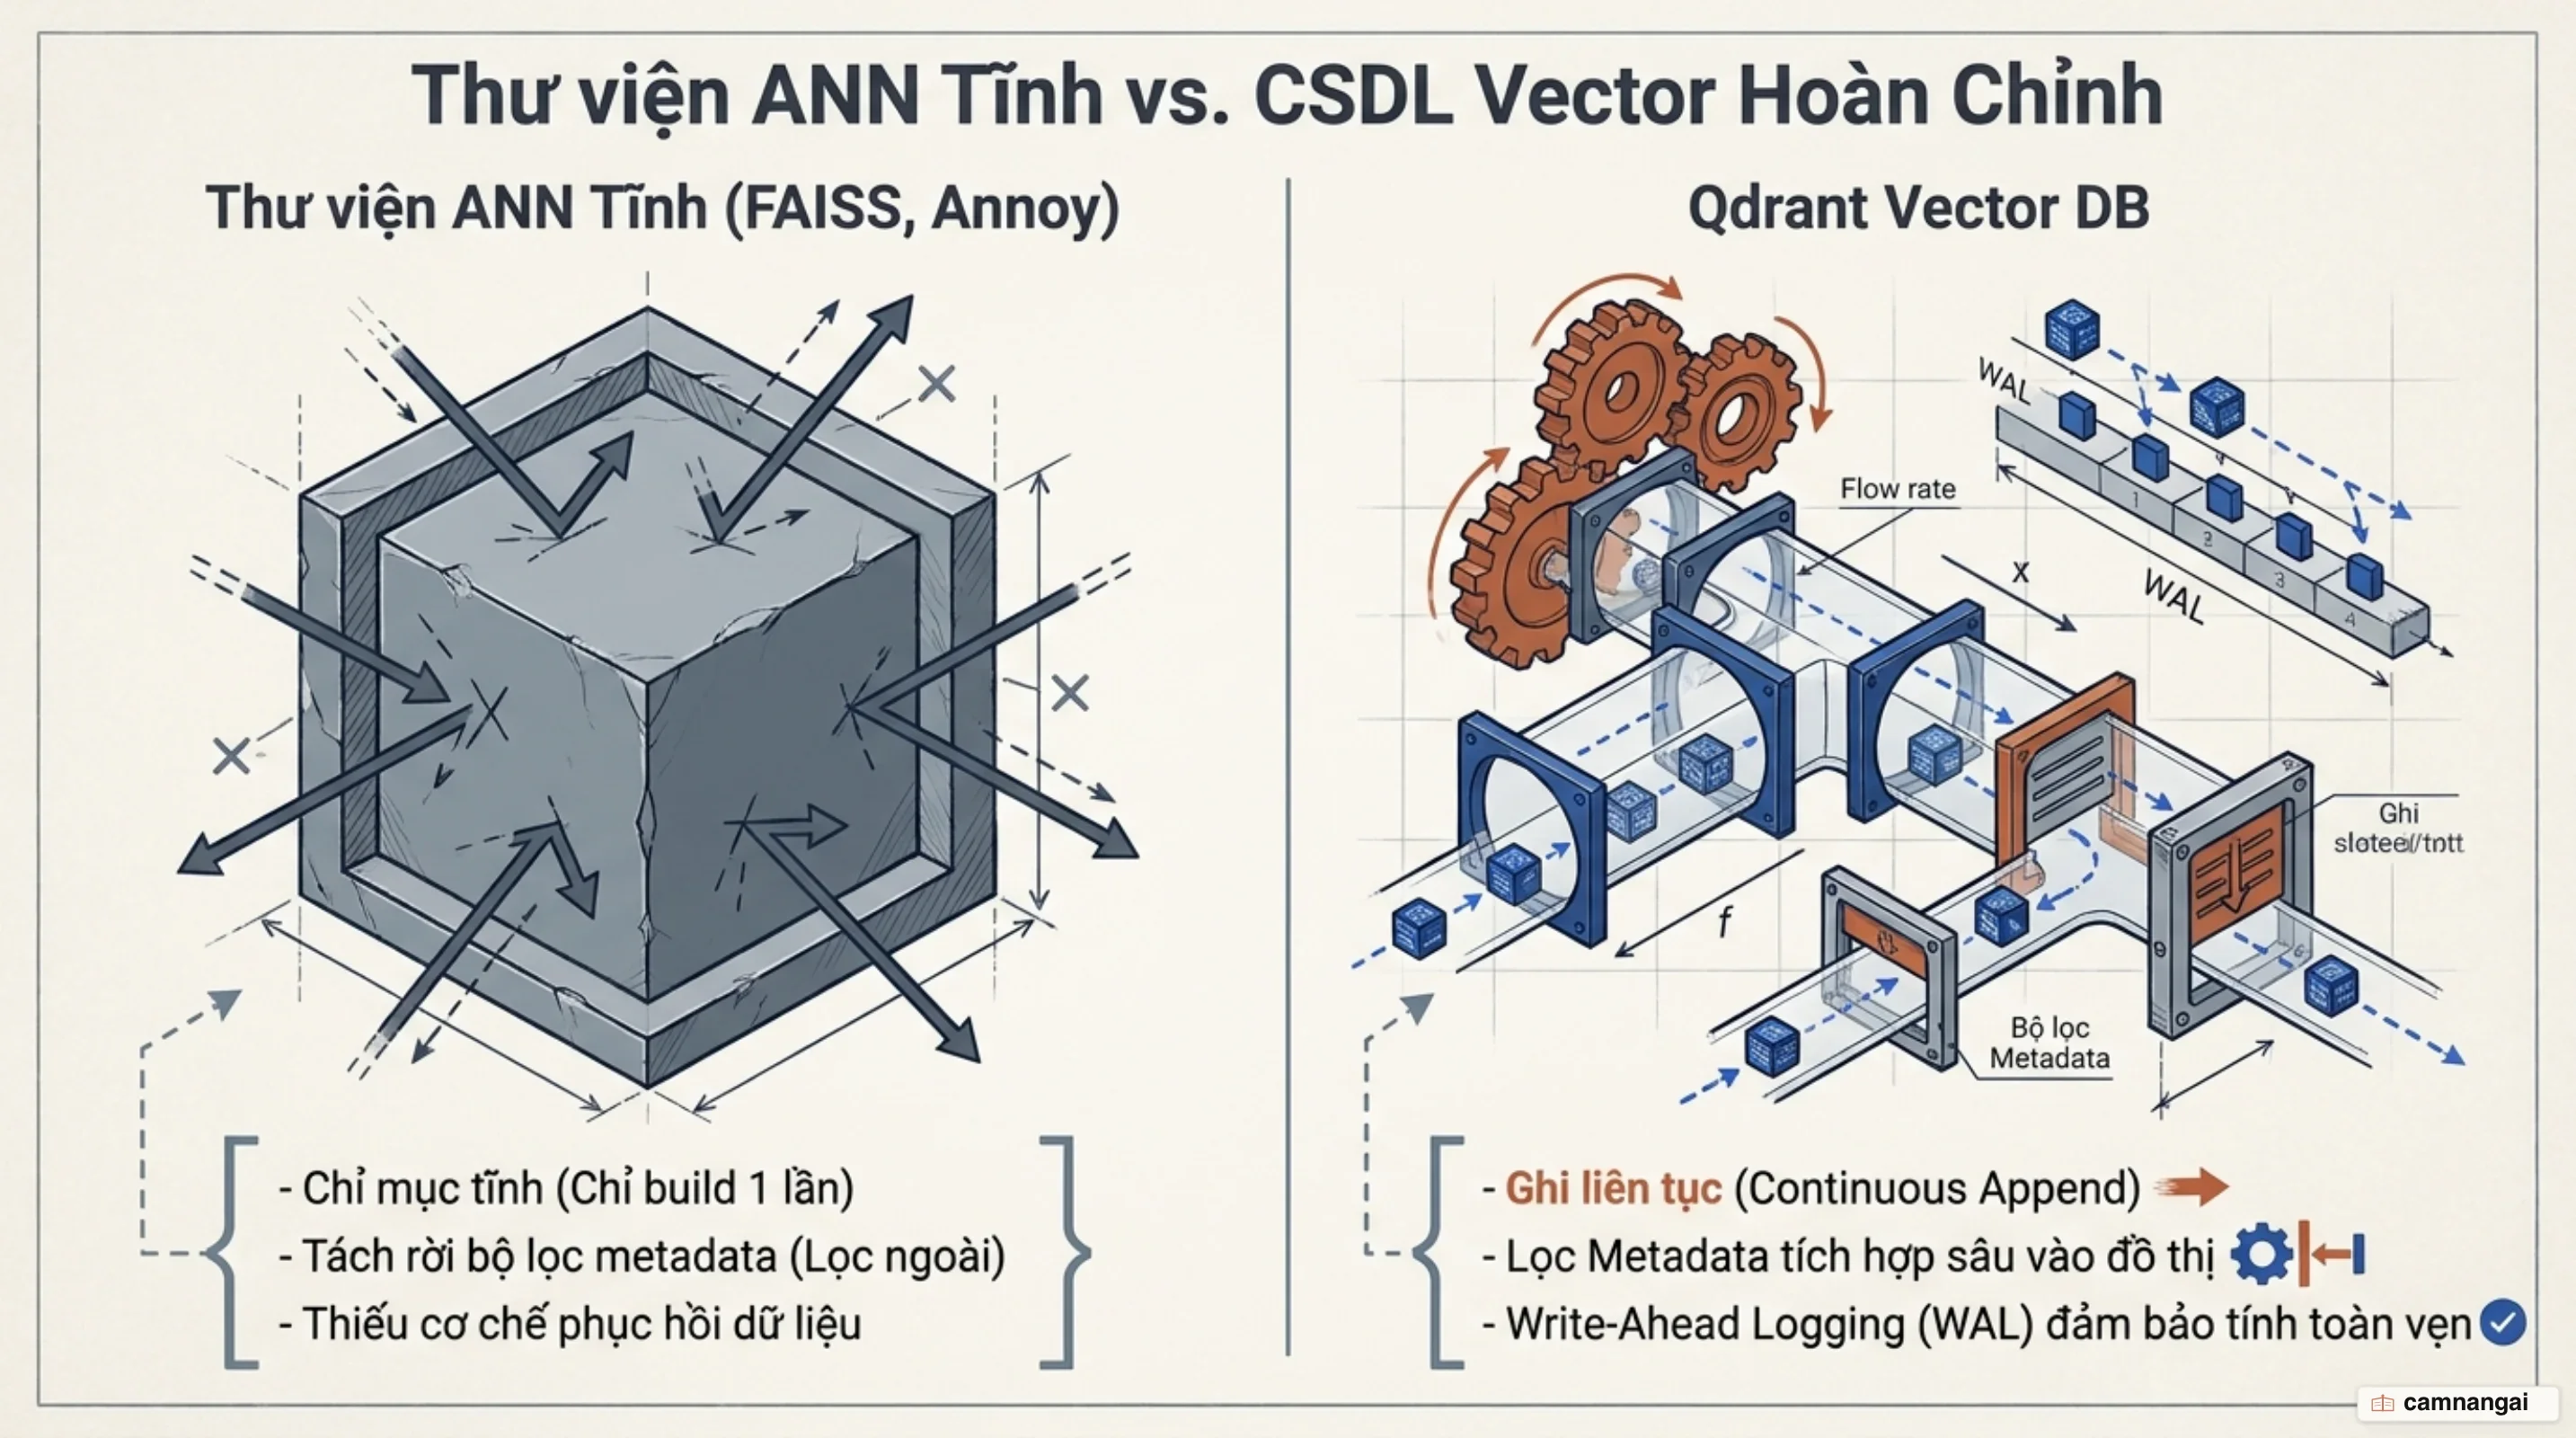
Khi xây dựng hệ thống tìm kiếm vector tương đồng trong không gian đa chiều, các kỹ sư hạ tầng thường bắt đầu với những thư viện ANN (Approximate Nearest Neighbors) truyền thống như Annoy, FAISS hoặc NMSLib. Mặc dù các thư viện này cung cấp tốc độ truy vấn hàng xóm gần nhất rất nhanh, chúng lại bộc lộ hạn chế lớn khi hệ thống cần áp dụng thêm các điều kiện lọc dữ liệu (metadata/payload filtering) — ví dụ như lọc sản phẩm theo danh mục, giới hạn khách hàng theo thương hiệu hoặc lọc tài liệu theo quyền truy cập.
Phương pháp tiếp cận truyền thống là hậu lọc (post-filtering): hệ thống truy vấn ra danh sách top-K vector tương đồng nhất từ chỉ mục vector, sau đó mới duyệt qua kết quả để loại bỏ các phần tử không thỏa mãn điều kiện metadata. Hạn chế cốt lõi của hậu lọc là làm sụt giảm nghiêm trọng độ chính xác (recall), thậm chí không trả về đủ số lượng kết quả yêu cầu nếu toàn bộ top-K vector ban đầu bị loại bỏ ở bước lọc. Ngược lại, các chỉ mục dạng cây như Annoy (sử dụng các phép chiếu ngẫu nhiên - random projection) gặp phải bài toán tương tự cơ sở dữ liệu quan hệ: khi các chỉ mục trường dữ liệu được xây dựng độc lập, hệ thống chỉ có thể lựa chọn và sử dụng một chỉ mục duy nhất tại một thời điểm truy vấn.
Qdrant giải quyết bài toán này bằng cách can thiệp trực tiếp vào cấu trúc duyệt đồ thị vector. Thay vì thực hiện lọc sau, Qdrant tích hợp điều kiện lọc ngay trong giai đoạn tìm kiếm đầu tiên (first search phase) của thuật toán HNSW (Hierarchical Navigable Small World). Cách tiếp cận này đảm bảo quá trình duyệt đồ thị chỉ đi qua các nút thỏa mãn điều kiện logic của metadata, từ đó duy trì độ chính xác, đảm bảo đủ số lượng kết quả trả về mà không làm suy giảm recall.
Mô hình dữ liệu cốt lõi: Collections, Points và Payloads
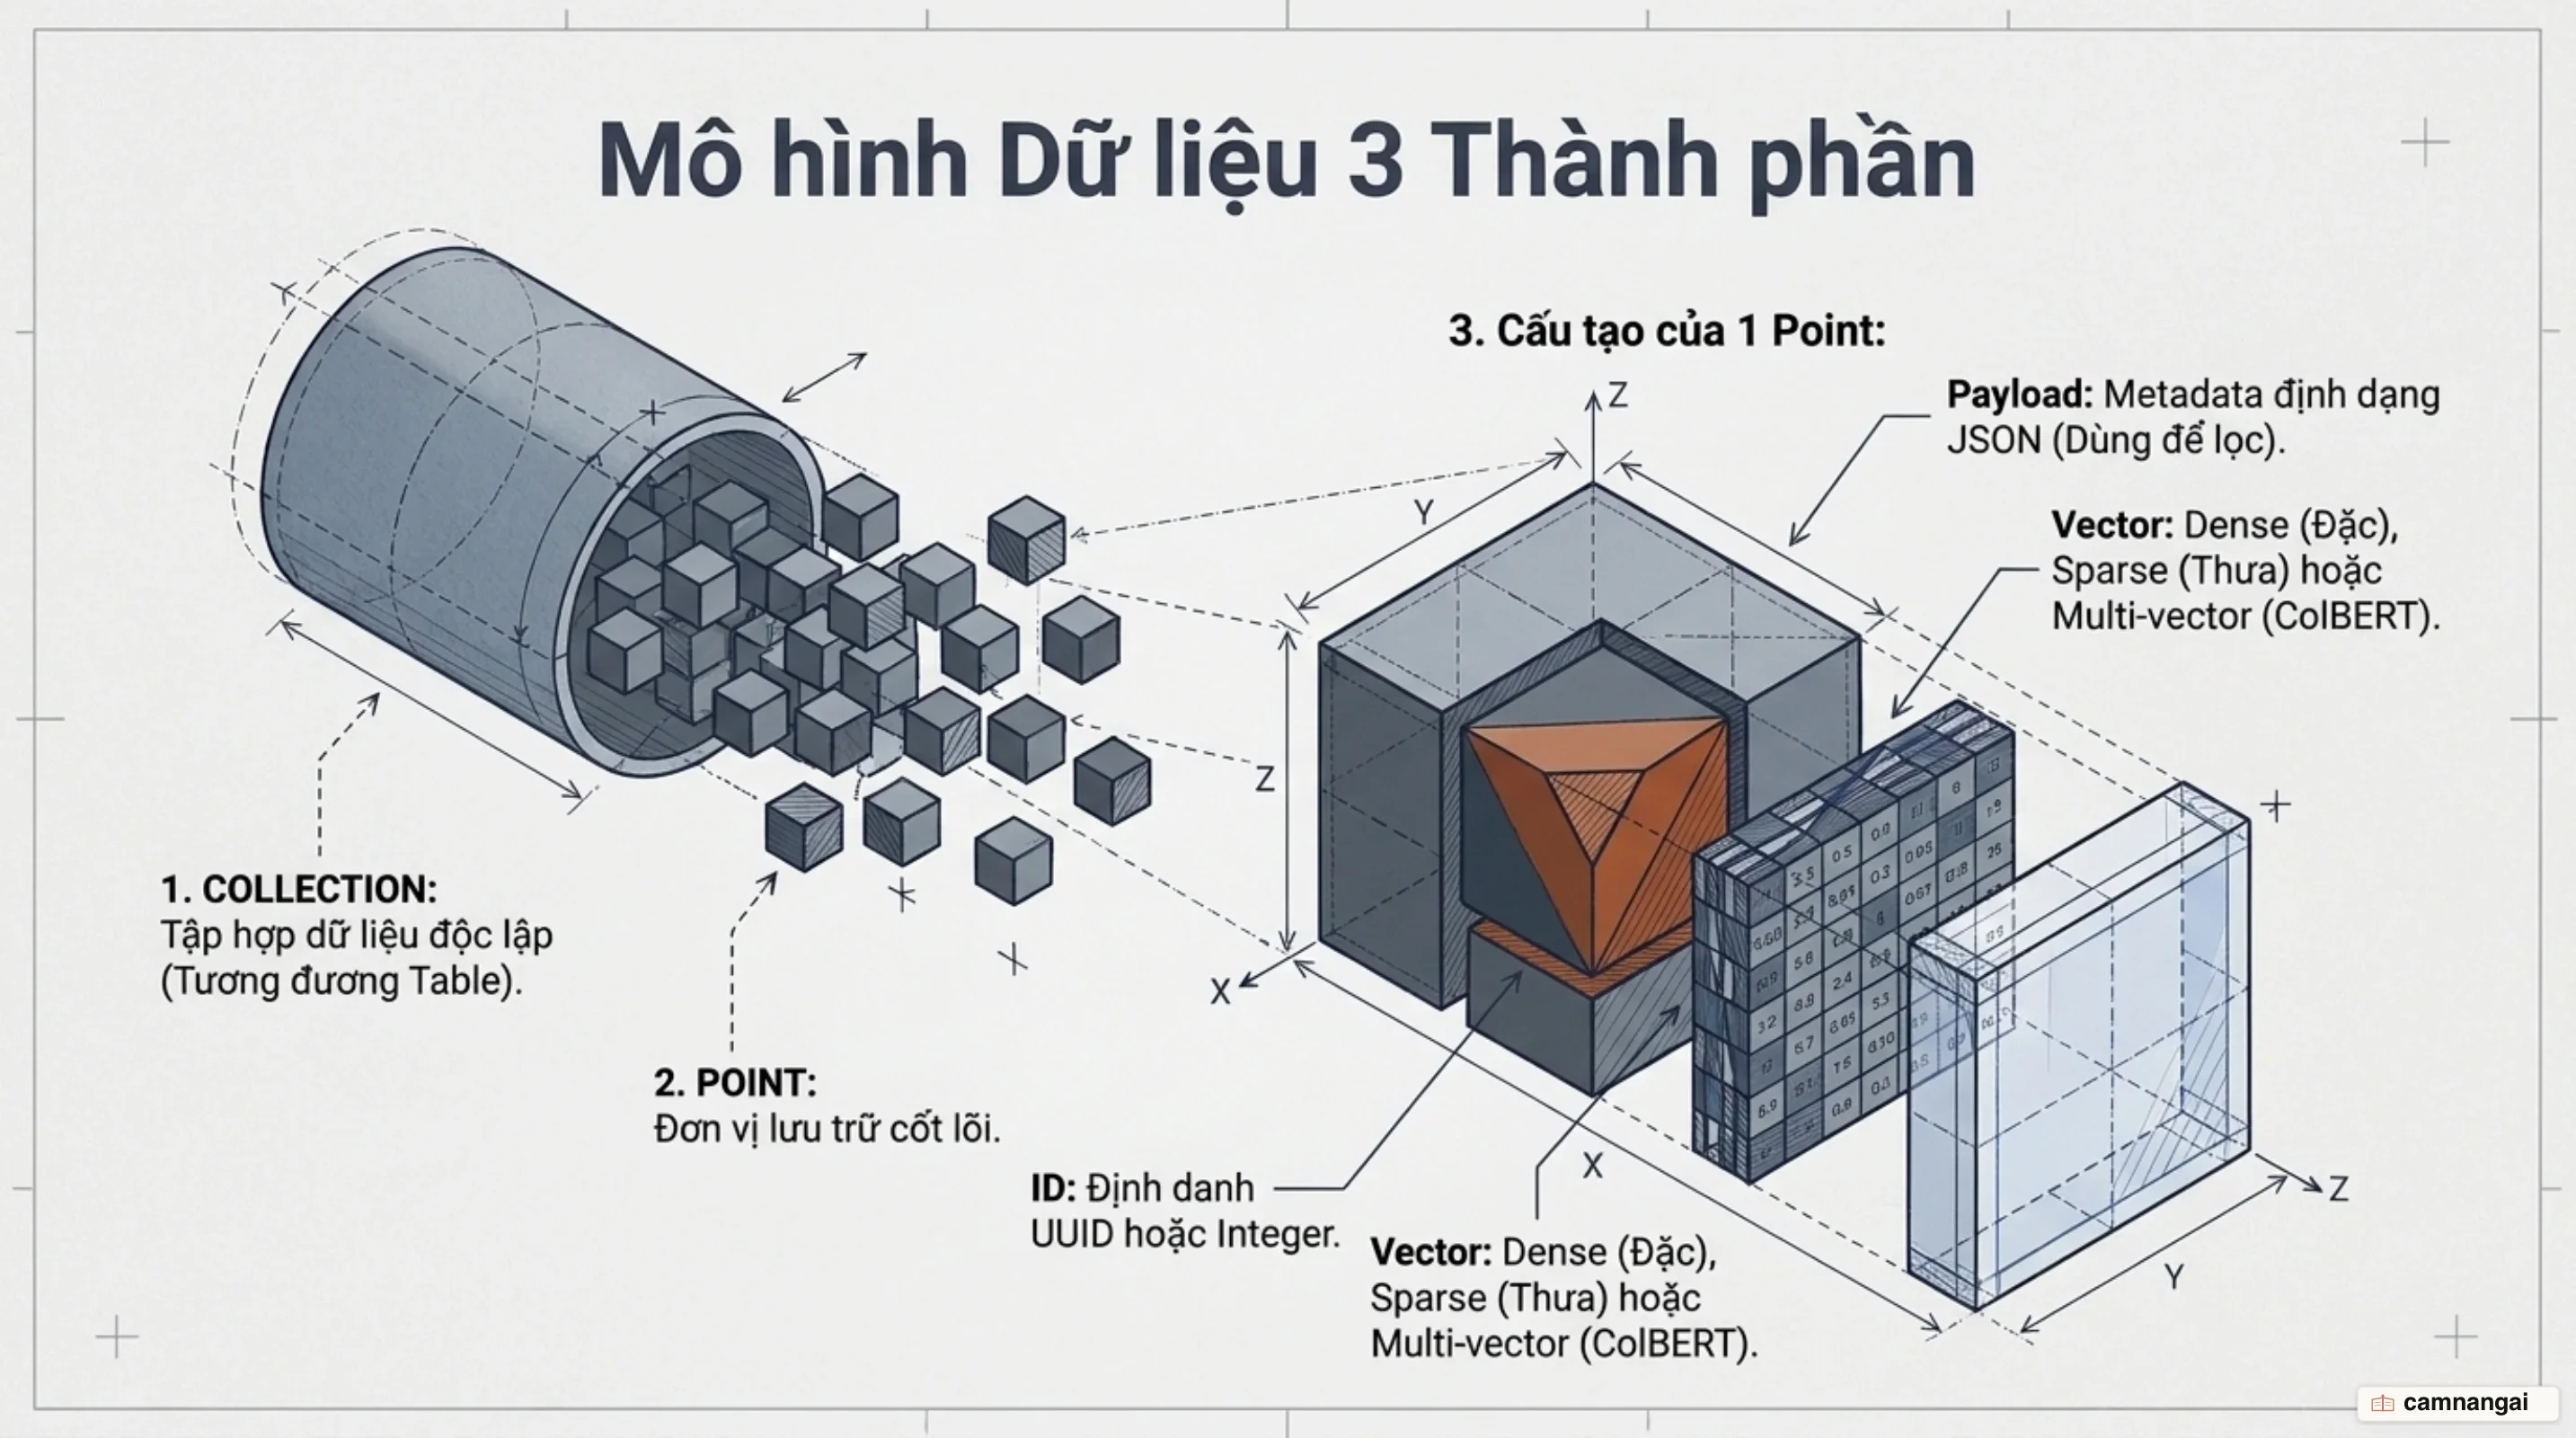
Mô hình lưu trữ dữ liệu trong Qdrant được tổ chức chặt chẽ thông qua ba khái niệm kỹ thuật cốt lõi:
- Points: Đơn vị dữ liệu cơ bản nhất trong Qdrant. Mỗi Point bao gồm một ID định danh, một hoặc nhiều Vector và danh sách Payload đi kèm. Qdrant hỗ trợ đa dạng định dạng vector: Dense Vectors (cho tìm kiếm ngữ nghĩa truyền thống), Sparse Vectors (cho tìm kiếm từ khóa nâng cao từ các mô hình như SPLADE++) và Multi-vector (dành cho các mô hình late interaction như ColBERT).
- Payloads: Thông tin bổ sung dạng JSON được gắn trực tiếp vào từng vector. Payload cho phép bạn lưu trữ cấu trúc dữ liệu đa dạng để thực hiện các điều kiện lọc phức tạp như từ khóa (keyword matching), tìm kiếm toàn văn (full-text search), khoảng giá trị số (numeric ranges) hoặc tọa độ địa lý (geo-locations). Bạn có thể kết hợp linh hoạt các điều kiện lọc này thông qua các mệnh đề logic
should,mustvàmust_not. - Collections: Tập hợp các Points sử dụng chung cấu hình không gian vector và độ đo khoảng cách (distance metric). Qdrant hỗ trợ các độ đo độ tương đồng phổ biến bao gồm Cosine, Dot product và Euclidean.
Kiến trúc bên trong: Bộ máy Rust, Segments và tối ưu I/O
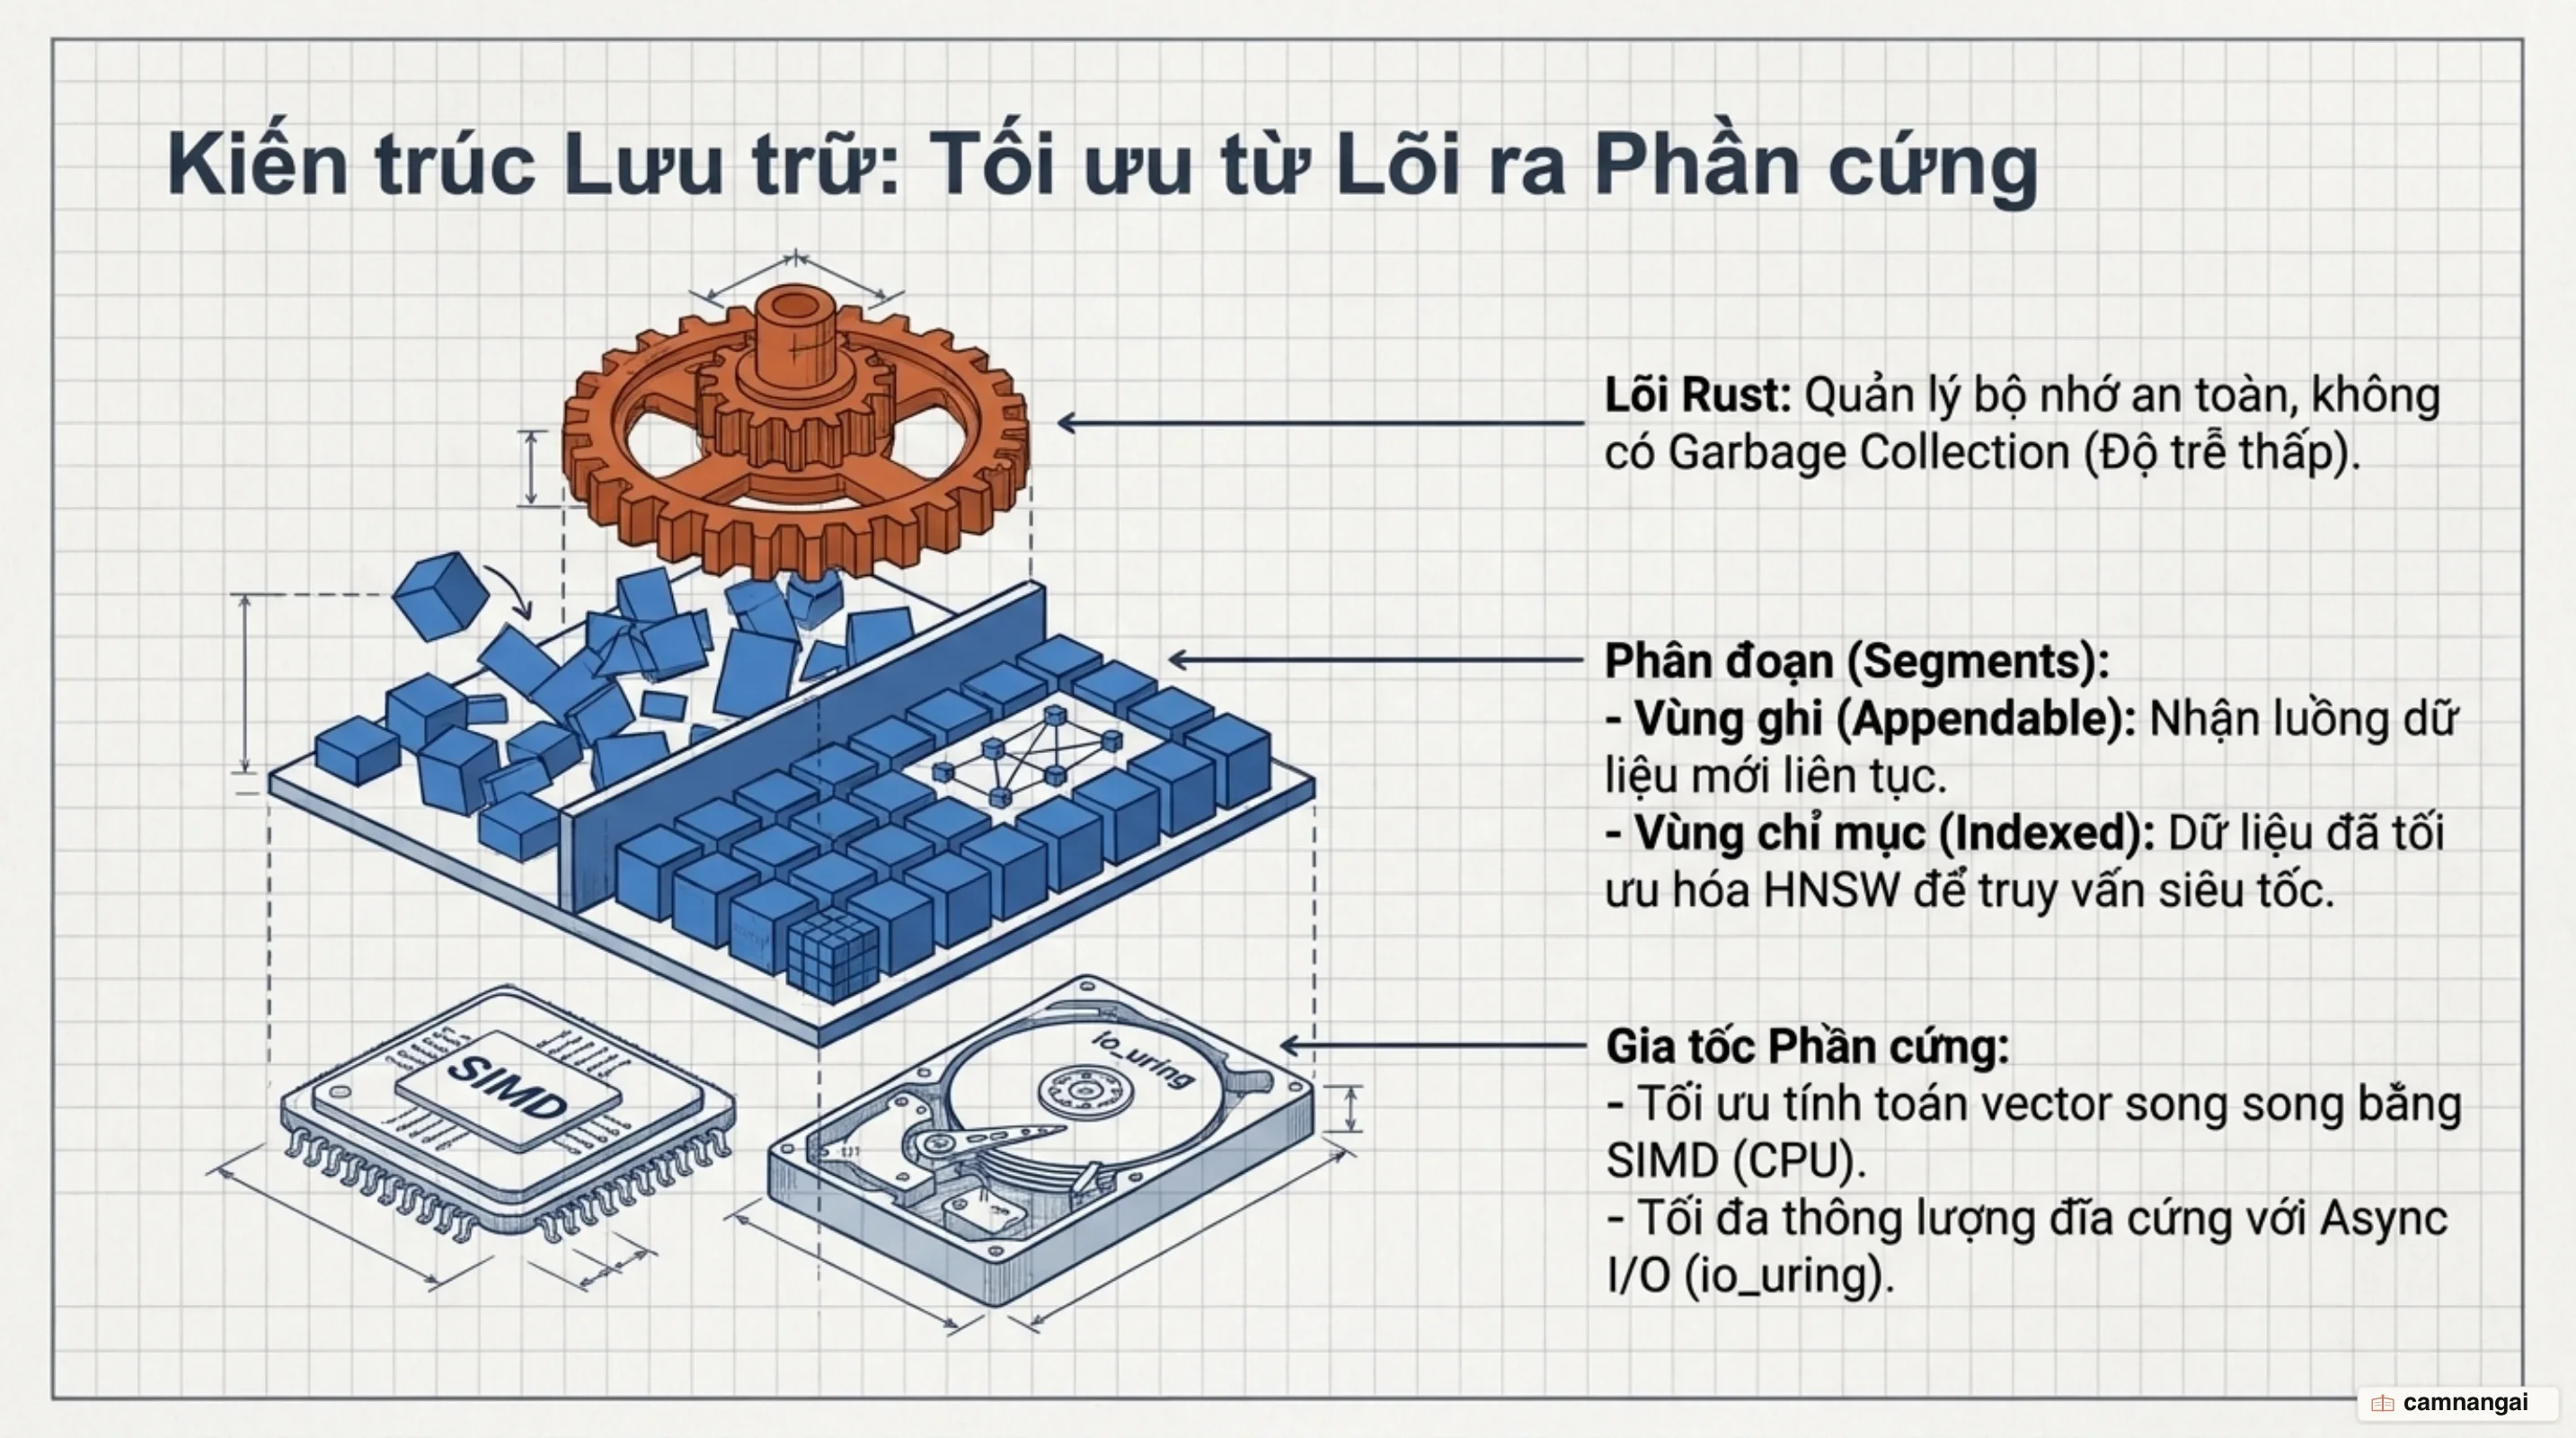
Qdrant được phát triển từ đầu bằng ngôn ngữ Rust. Lựa chọn này giúp hệ thống đạt hiệu năng tính toán cận phần cứng, đảm bảo an toàn bộ nhớ (memory safety) mà không gặp phải vấn đề tạm dừng do dọn rác (garbage collection pauses), từ đó duy trì độ trễ truy vấn ổn định dưới tải lớn.
Về cấu trúc lưu trữ nội bộ, Qdrant chia dữ liệu trong mỗi Collection thành các Segments (phân đoạn) độc lập. Mỗi Segment là một đơn vị lưu trữ tự chứa (self-contained), sở hữu chỉ mục vector HNSW và chỉ mục Payload riêng biệt. Qdrant vận hành các tiến trình tối ưu ngầm (background optimizer threads) để thực hiện gom và hợp nhất (merge) các Segment tự động mà không làm gián đoạn luồng ghi hoặc truy vấn của hệ thống. Kiến trúc phân đoạn này cho phép Qdrant xử lý các thao tác ghi dữ liệu song song cực kỳ hiệu quả, giảm thiểu tranh chấp tài nguyên đĩa và giúp quá trình đánh chỉ mục diễn ra liên tục.
Ở cấp độ giao tiếp phần cứng, Qdrant khai thác tối đa băng thông I/O đĩa bằng cơ chế Async I/O thông qua io_uring, cho phép đạt hiệu năng cao ngay cả trên hạ tầng lưu trữ mạng (NAS). Dữ liệu được ghi vào nhật ký Write-Ahead Logging (WAL) trước khi xác nhận để đảm bảo tính toàn vẹn khi xảy ra sự cố nguồn hoặc sập hệ thống. Về mặt tính toán, Qdrant tận dụng tập lệnh SIMD (trên kiến trúc x86-x64 và ARM Neon) để tăng tốc các phép toán đại số tuyến tính, đồng thời hỗ trợ GPU (NVIDIA và AMD) để đẩy nhanh tốc độ xây dựng chỉ mục HNSW.
Đối với các hệ thống quy mô lớn, Qdrant hỗ trợ cơ chế phân mảnh dữ liệu (sharding) và nhân bản (replication) đồng bộ/bất đồng bộ với khả năng nâng cấp không dừng hệ thống (zero downtime). Bên cạnh mô hình Client-Server, Qdrant cung cấp phiên bản nhẹ Qdrant Edge chạy trực tiếp in-process bên trong tiến trình ứng dụng. Qdrant Edge lưu trữ và truy vấn dữ liệu cục bộ trên thiết bị biên, hỗ trợ đồng bộ snapshot hai chiều với Qdrant Server để phục vụ các kịch bản ngoại tuyến với độ trễ cực thấp.
Filterable HNSW: Tích hợp lọc metadata trực tiếp vào đồ thị vector
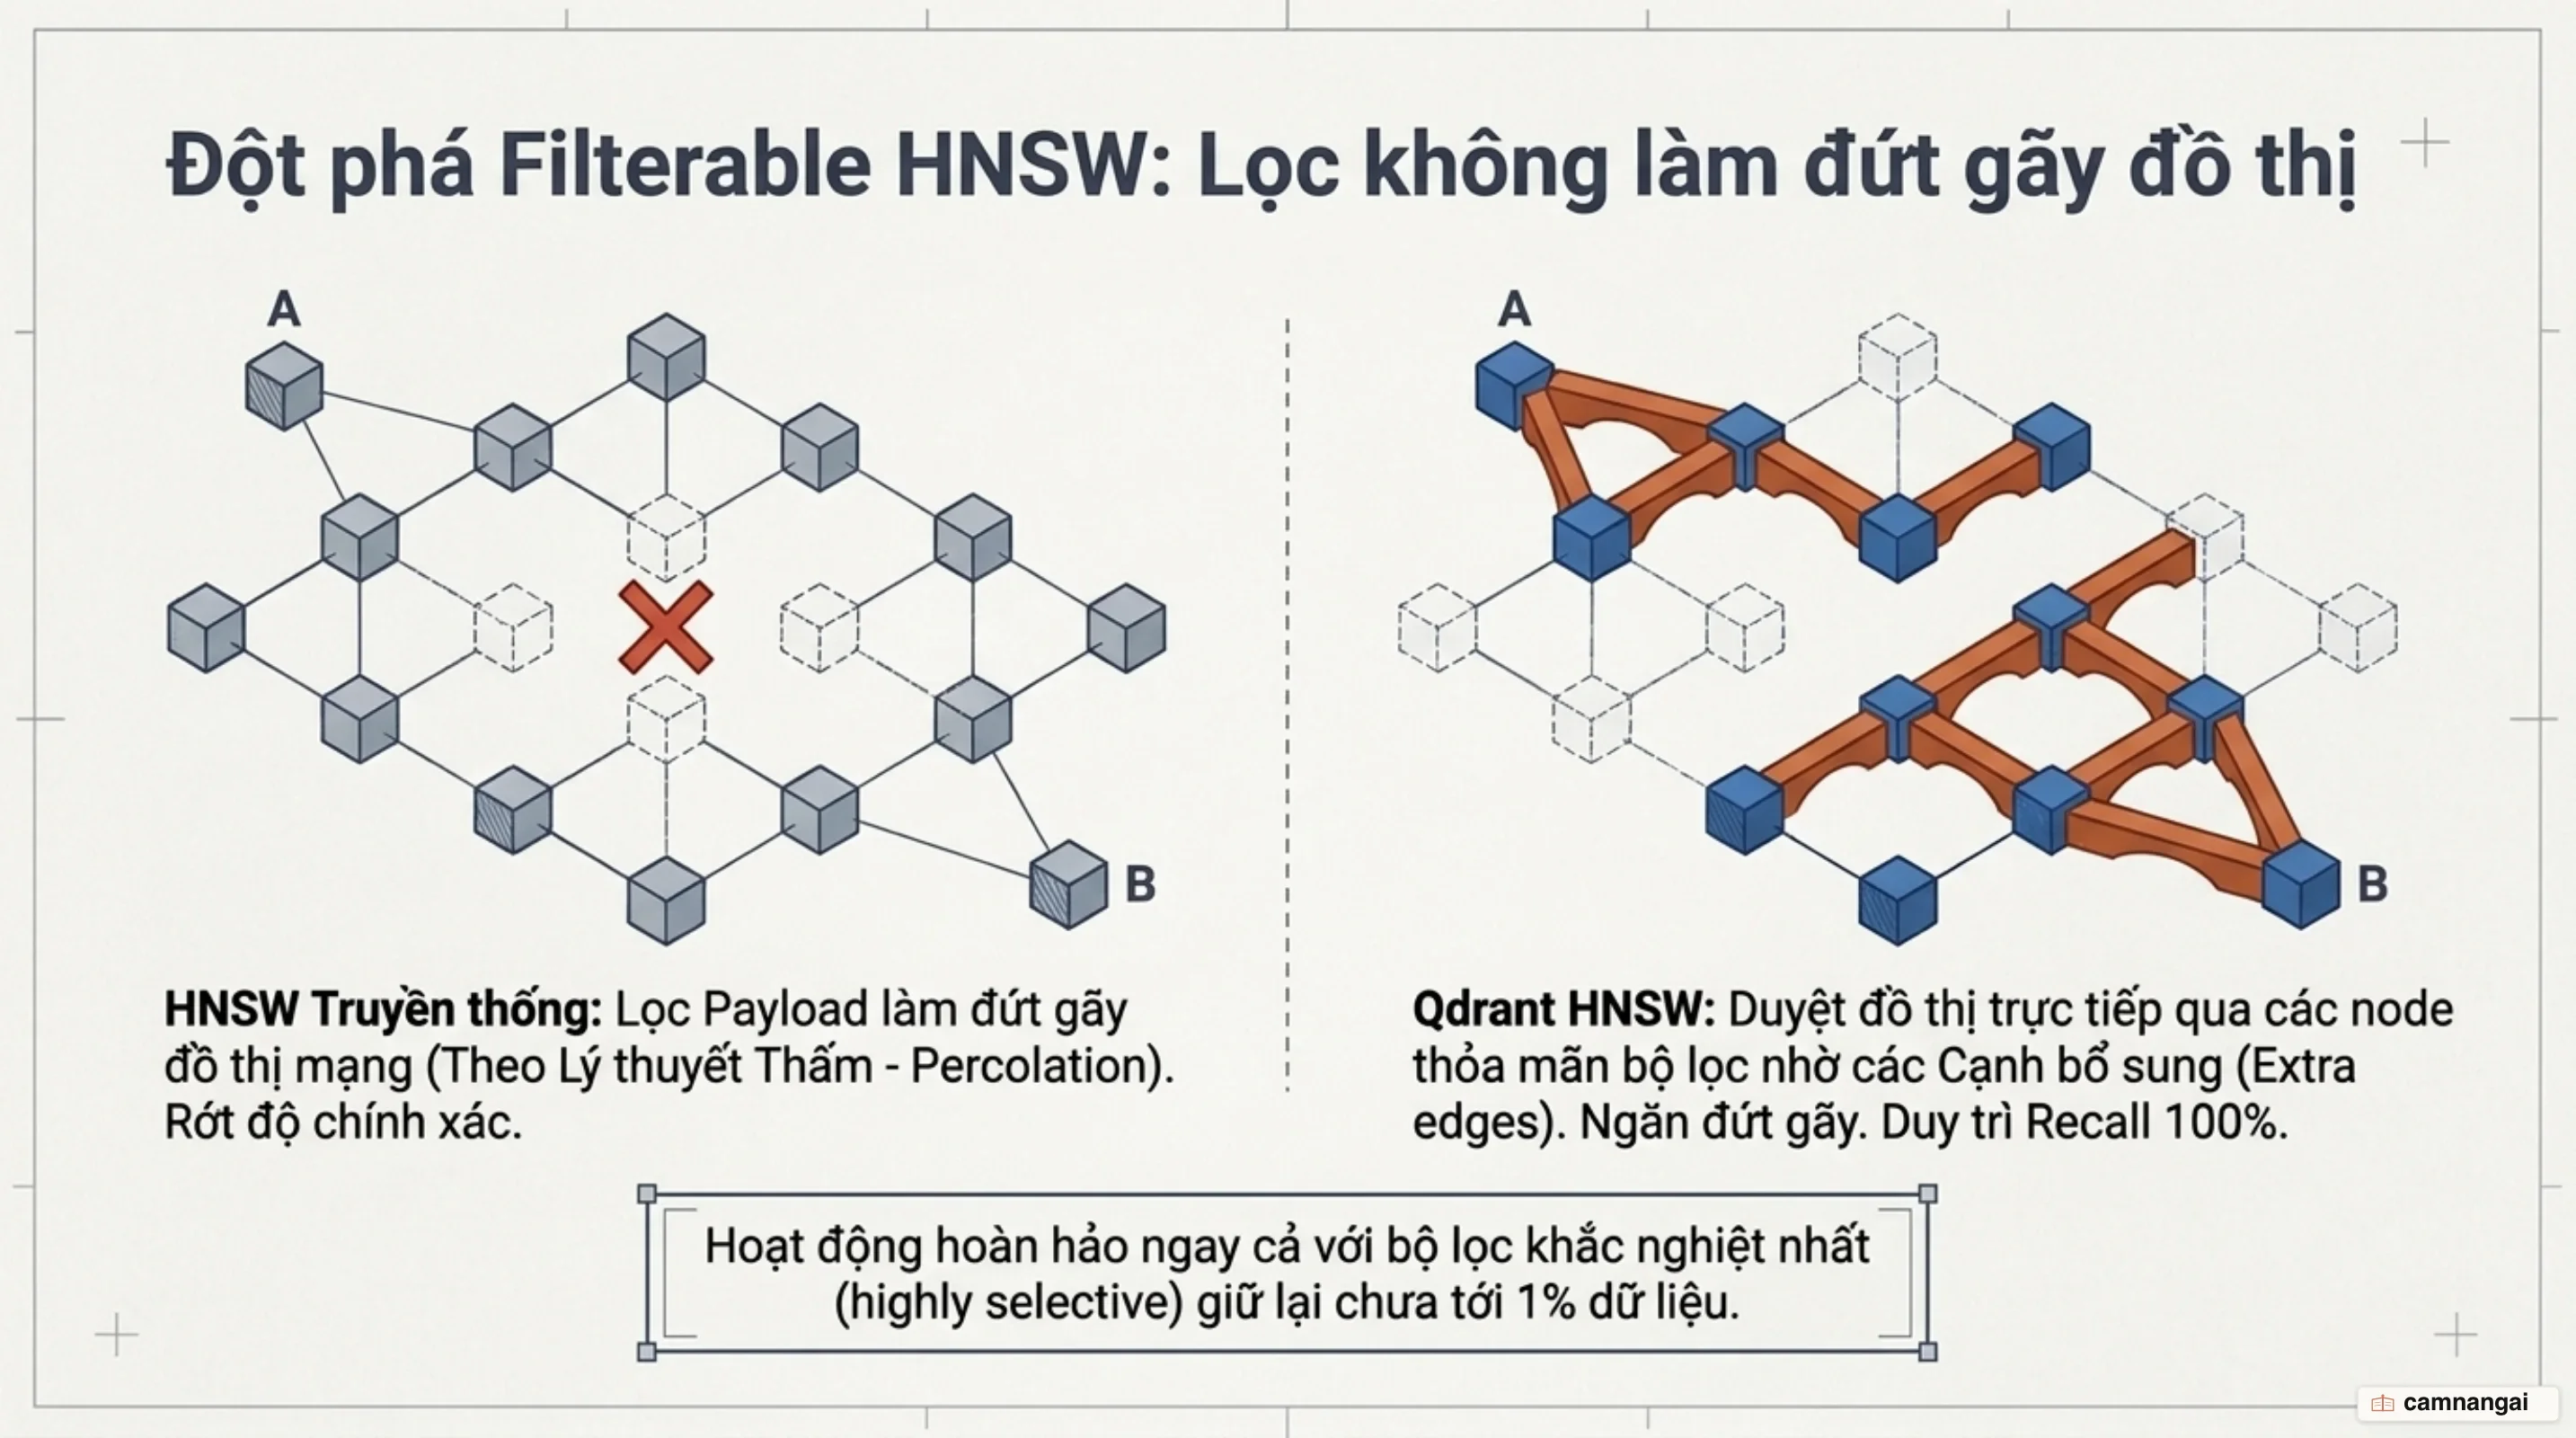
Nền tảng kỹ thuật giúp Qdrant lọc metadata mà không mất recall dựa trên nghiên cứu nguyên bản năm 2019 của Andrei Vasnetsov. Thuật toán HNSW tiêu chuẩn dựng một đồ thị điều hướng phân cấp (Hierarchical Navigable Small World), trong đó các nút đại diện cho vector và các cạnh nối các vector gần nhau, cho phép thực hiện tìm kiếm tham ăn (greedy traversal) để nhanh chóng hội tụ về hàng xóm gần nhất.
Khi áp dụng bộ lọc trực tiếp lên các nút trong quá trình duyệt đồ thị, Lý thuyết Thấm (Percolation Theory) chỉ ra rằng nếu loại bỏ ngẫu nhiên một tỷ lệ 1 - p các nút không thỏa mãn điều kiện lọc, đồ thị sẽ tồn tại một ngưỡng thấm tới hạn:
p_c = 1 / ⟨k⟩
(với ⟨k⟩ là bậc trung bình của các nút trong đồ thị). Nếu tỷ lệ nút còn lại p rơi xuống dưới ngưỡng p_c, đồ thị điều hướng sẽ bị rã thành các thành phần liên thông nhỏ (connected components). Sự đứt gãy này làm thất bại quá trình tìm kiếm tham ăn, khiến thuật toán bị kẹt ở các cực trị địa phương và làm sụt giảm nghiêm trọng chỉ số precision@10 / recall.
Toán học chỉ ra rằng để dịch chuyển ngưỡng rã đồ thị và duy trì tính liên thông khi tỷ lệ lọc tăng cao, giải pháp là tăng tham số m — số lượng cạnh kết nối tối đa của mỗi nút (ví dụ nâng từ m=8 lên m=16, m=24, m=32). Bên cạnh việc điều chỉnh m, Qdrant áp dụng các chiến lược cấu trúc đồ thị cho từng loại bộ lọc:
- Categorical filtering: Xây dựng thêm các cạnh kết nối nội bộ giữa các nút thuộc cùng một danh mục (category) riêng rẽ rồi gộp vào đồ thị chính. Kỹ thuật này làm tăng tối đa không quá 2 lần tổng số cạnh của đồ thị. Trong trường hợp điều kiện lọc quá khắt khe khiến liên kết giữa các danh mục bị đứt gãy, Qdrant tự động chuyển sang cơ chế thực hiện nhiều truy vấn con song song trên từng danh mục hoặc tìm kiếm tuyến tính (linear search) trên tập giao nhỏ để đảm bảo không bỏ sót kết quả.
- Numerical range & Geo: Chia dải số hoặc các ô tọa độ geohash thành các thùng (buckets) chứa số lượng điểm bằng nhau, sau đó tạo liên kết giữa các thùng lân cận. Điều này đảm bảo luôn tồn tại đường đi liên thông trên đồ thị cho bất kỳ khoảng giá trị hay vùng địa lý nào được truy vấn.
Tối ưu tài nguyên: Kỹ thuật nén Vector (Quantization) và Hybrid Search
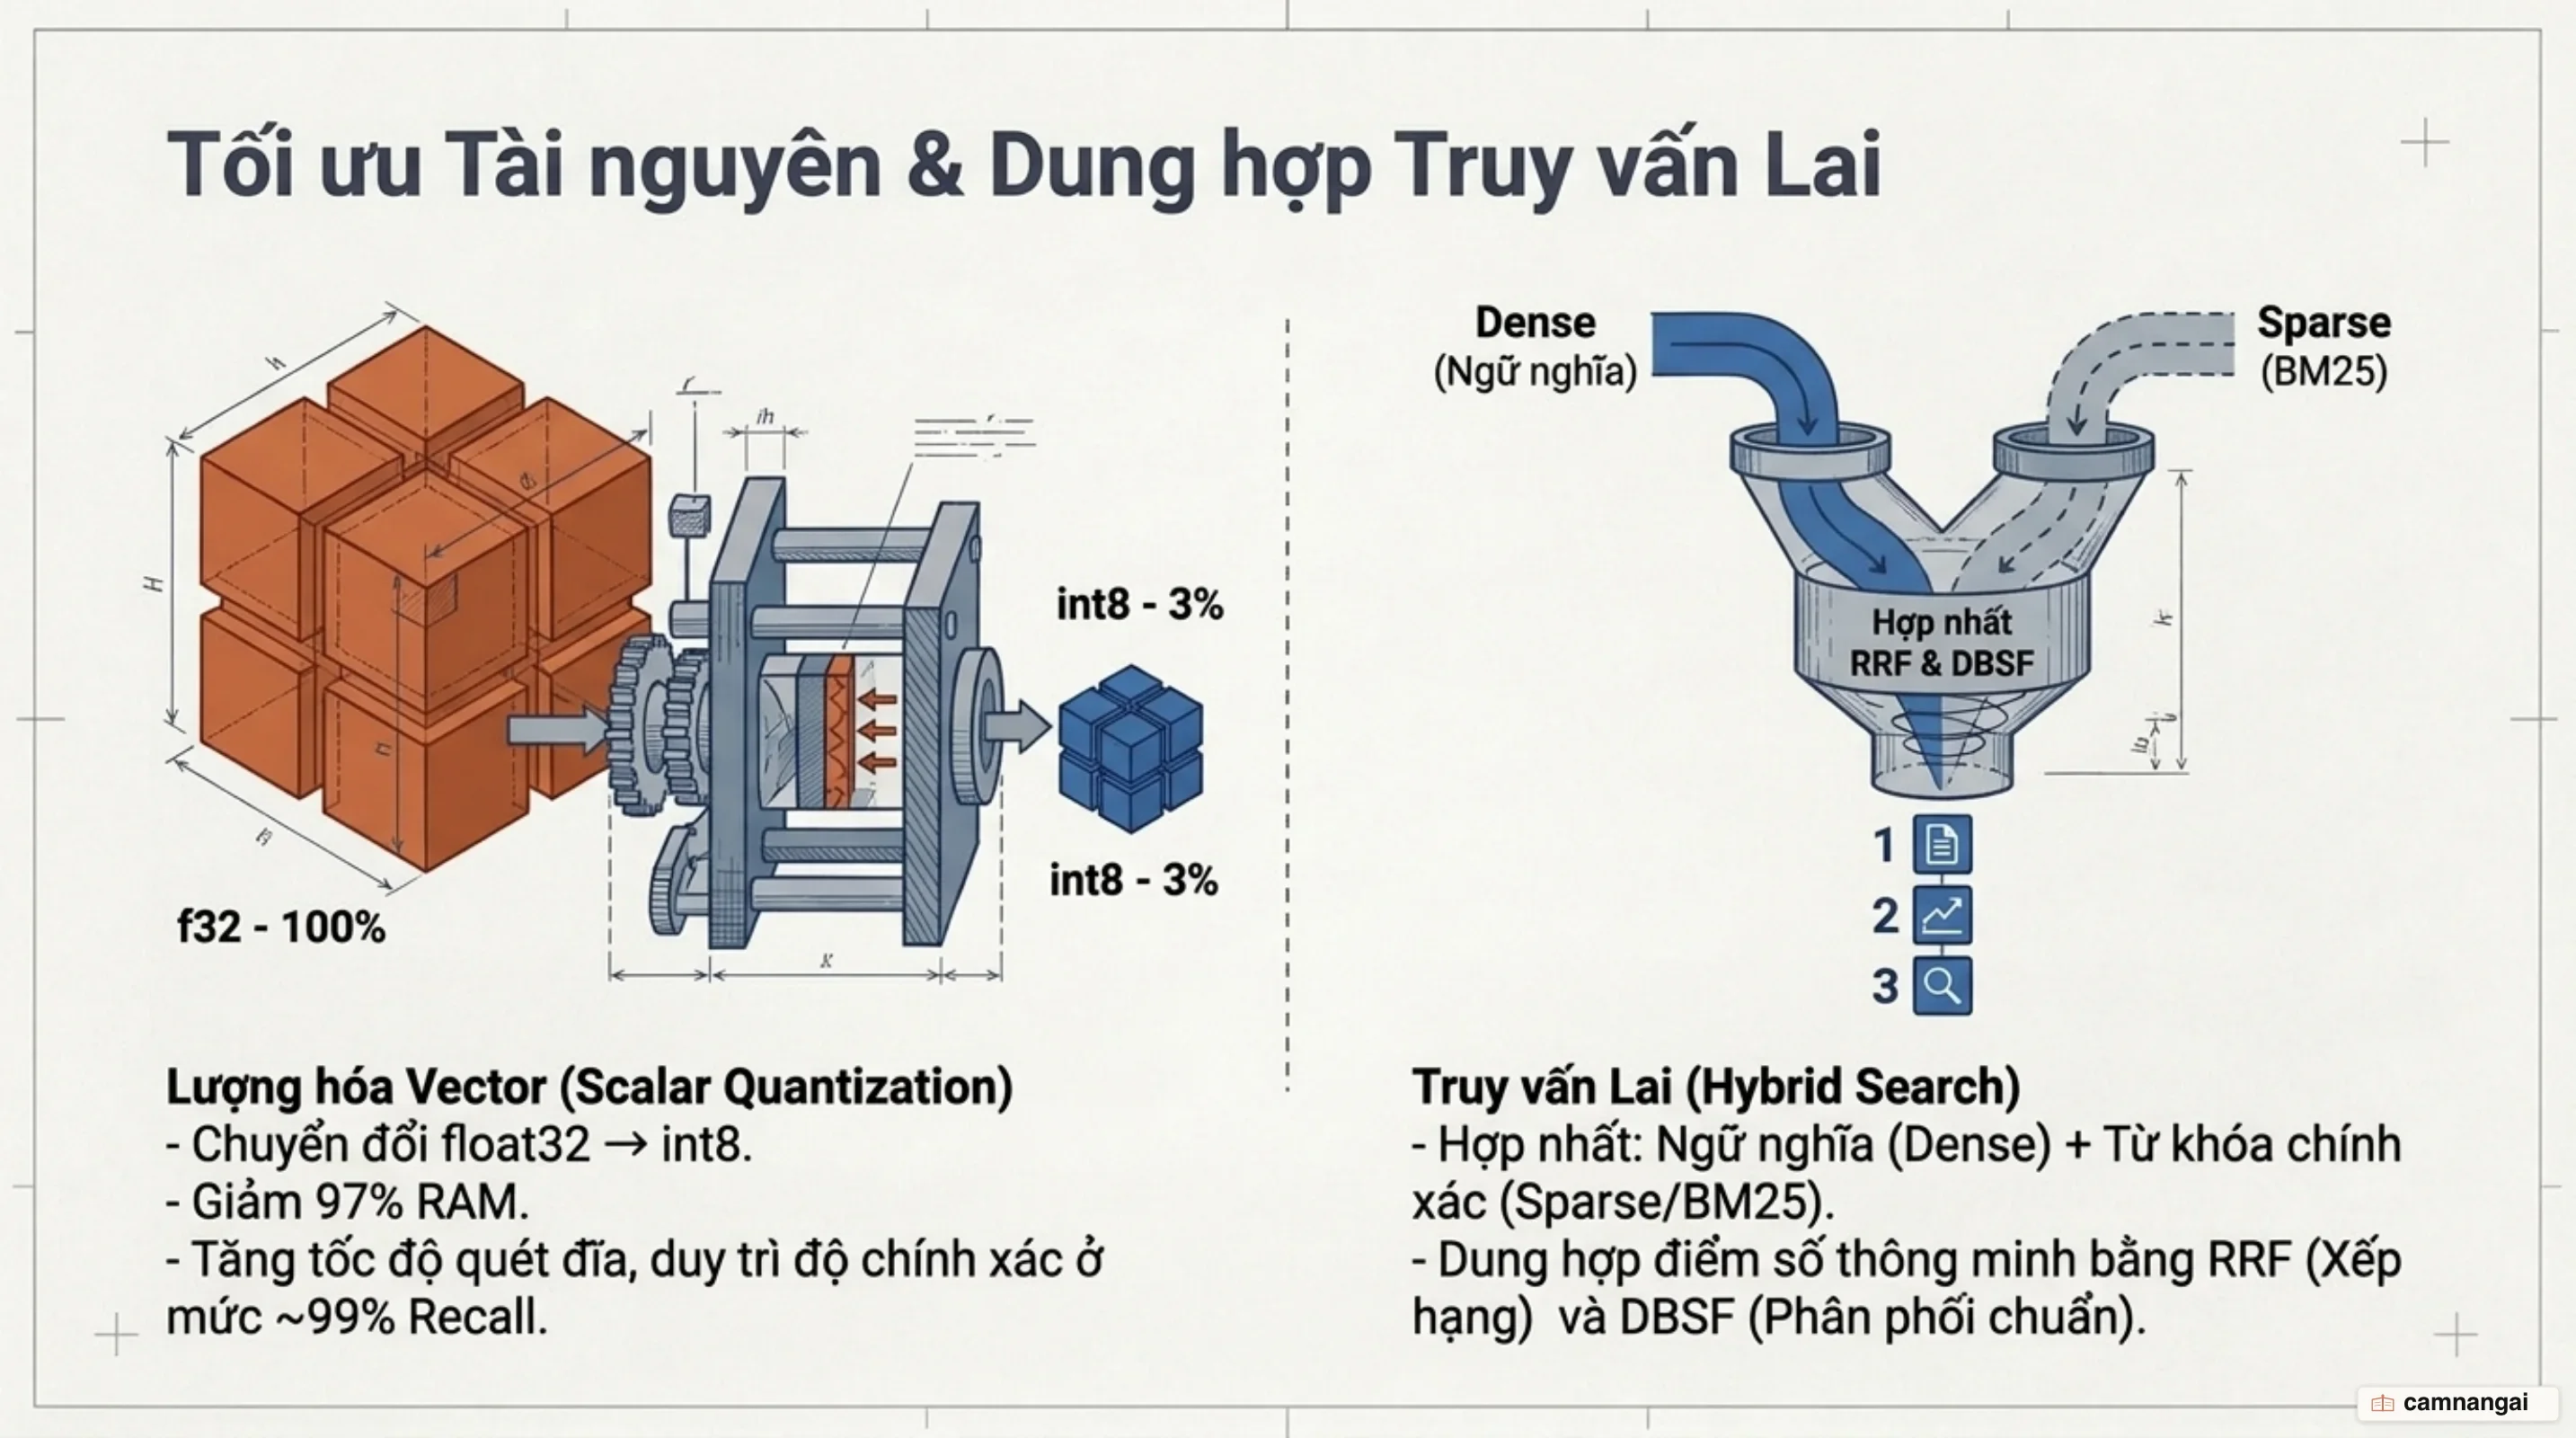
Nhằm giảm chi phí phần cứng RAM khi quy mô dữ liệu lên tới hàng trăm triệu vector, Qdrant tích hợp sẵn các kỹ thuật Lượng hóa Vector (Vector Quantization) kết hợp lưu trữ trên đĩa (On-Disk Storage). Phương pháp nén này giảm tới 97% dung lượng RAM sử dụng, cho phép bạn chủ động điều chỉnh mức độ đánh đổi giữa tốc độ truy vấn và độ chính xác.
Cùng với việc tối ưu lưu trữ, Query API của Qdrant cung cấp khả năng thực hiện Tìm kiếm lai (Hybrid Search) nâng cao. Hệ thống cho phép kết hợp đồng thời Dense Vectors (ngữ nghĩa), Sparse Vectors (như SPLADE++) và BM25 Full-text search thông qua tham số prefetch. Kết quả từ các luồng truy vấn con được dung hợp bằng hai thuật toán chính:
-
Reciprocal Rank Fusion (RRF): Đánh giá vị trí thứ hạng của tài liệu trong từng danh sách trả về. Công thức tổng quát có trọng số (Weighted RRF) được tính như sau:
score(d) = \sum_{r} (w_r / (k + r_d + 1))Trong đó:
r_dlà vị trí thứ hạng của tài liệudtrong danh sáchr. Qdrant sử dụng chỉ số vị trí bắt đầu từ 0 (zero-based rank, tức phần tử đầu tiên cór_d = 0),klà hằng số bình ổn (mặc địnhk=2, có thể tùy chỉnh lênk=60) vàw_rlà trọng số gán cho từng bộ truy vấn. -
Distribution-Based Score Fusion (DBSF): Giữ lại điểm số thô nhưng thực hiện chuẩn hóa phân phối điểm của từng luồng truy vấn dựa trên trung bình mẫu
\muvà độ lệch chuẩn\sigmatheo quy tắc 3-sigma:ŝ = (s - (μ - 3σ)) / (6σ)DBSF không giới hạn điểm số trong khoảng
[0, 1](không bị clip điểm). Nếu tất cả các điểm số trả về trong tập top-K giống hệt nhau, DBSF sẽ gán giá trị mặc định0.5để tránh lỗi chia cho 0.
Để lựa chọn phương pháp dung hợp phù hợp cho hệ thống sản xuất, bạn có thể tham khảo khung quyết định sau:
| Bối cảnh thực tế | Phương pháp đề xuất | Cơ chế vận hành |
|---|---|---|
| Có tập đánh giá (Eval set) | Weighted RRF | Thực hiện grid search tìm tập trọng số w_r tối ưu trên tập dữ liệu kiểm thử. |
| Tin tưởng điểm thô & Không có Eval set | DBSF | Chuẩn hóa phân phối điểm dựa trên \mu và \sigma của tập top-K mà không cần huấn luyện. |
| Không có Eval set & Không rõ phân phối điểm | RRF mặc định | Dùng RRF chuẩn với hằng số k=2 hoặc k=60, đảm bảo an toàn cho mọi mô hình. |
Vị thế kỹ thuật của Qdrant và khung quyết định lựa chọn
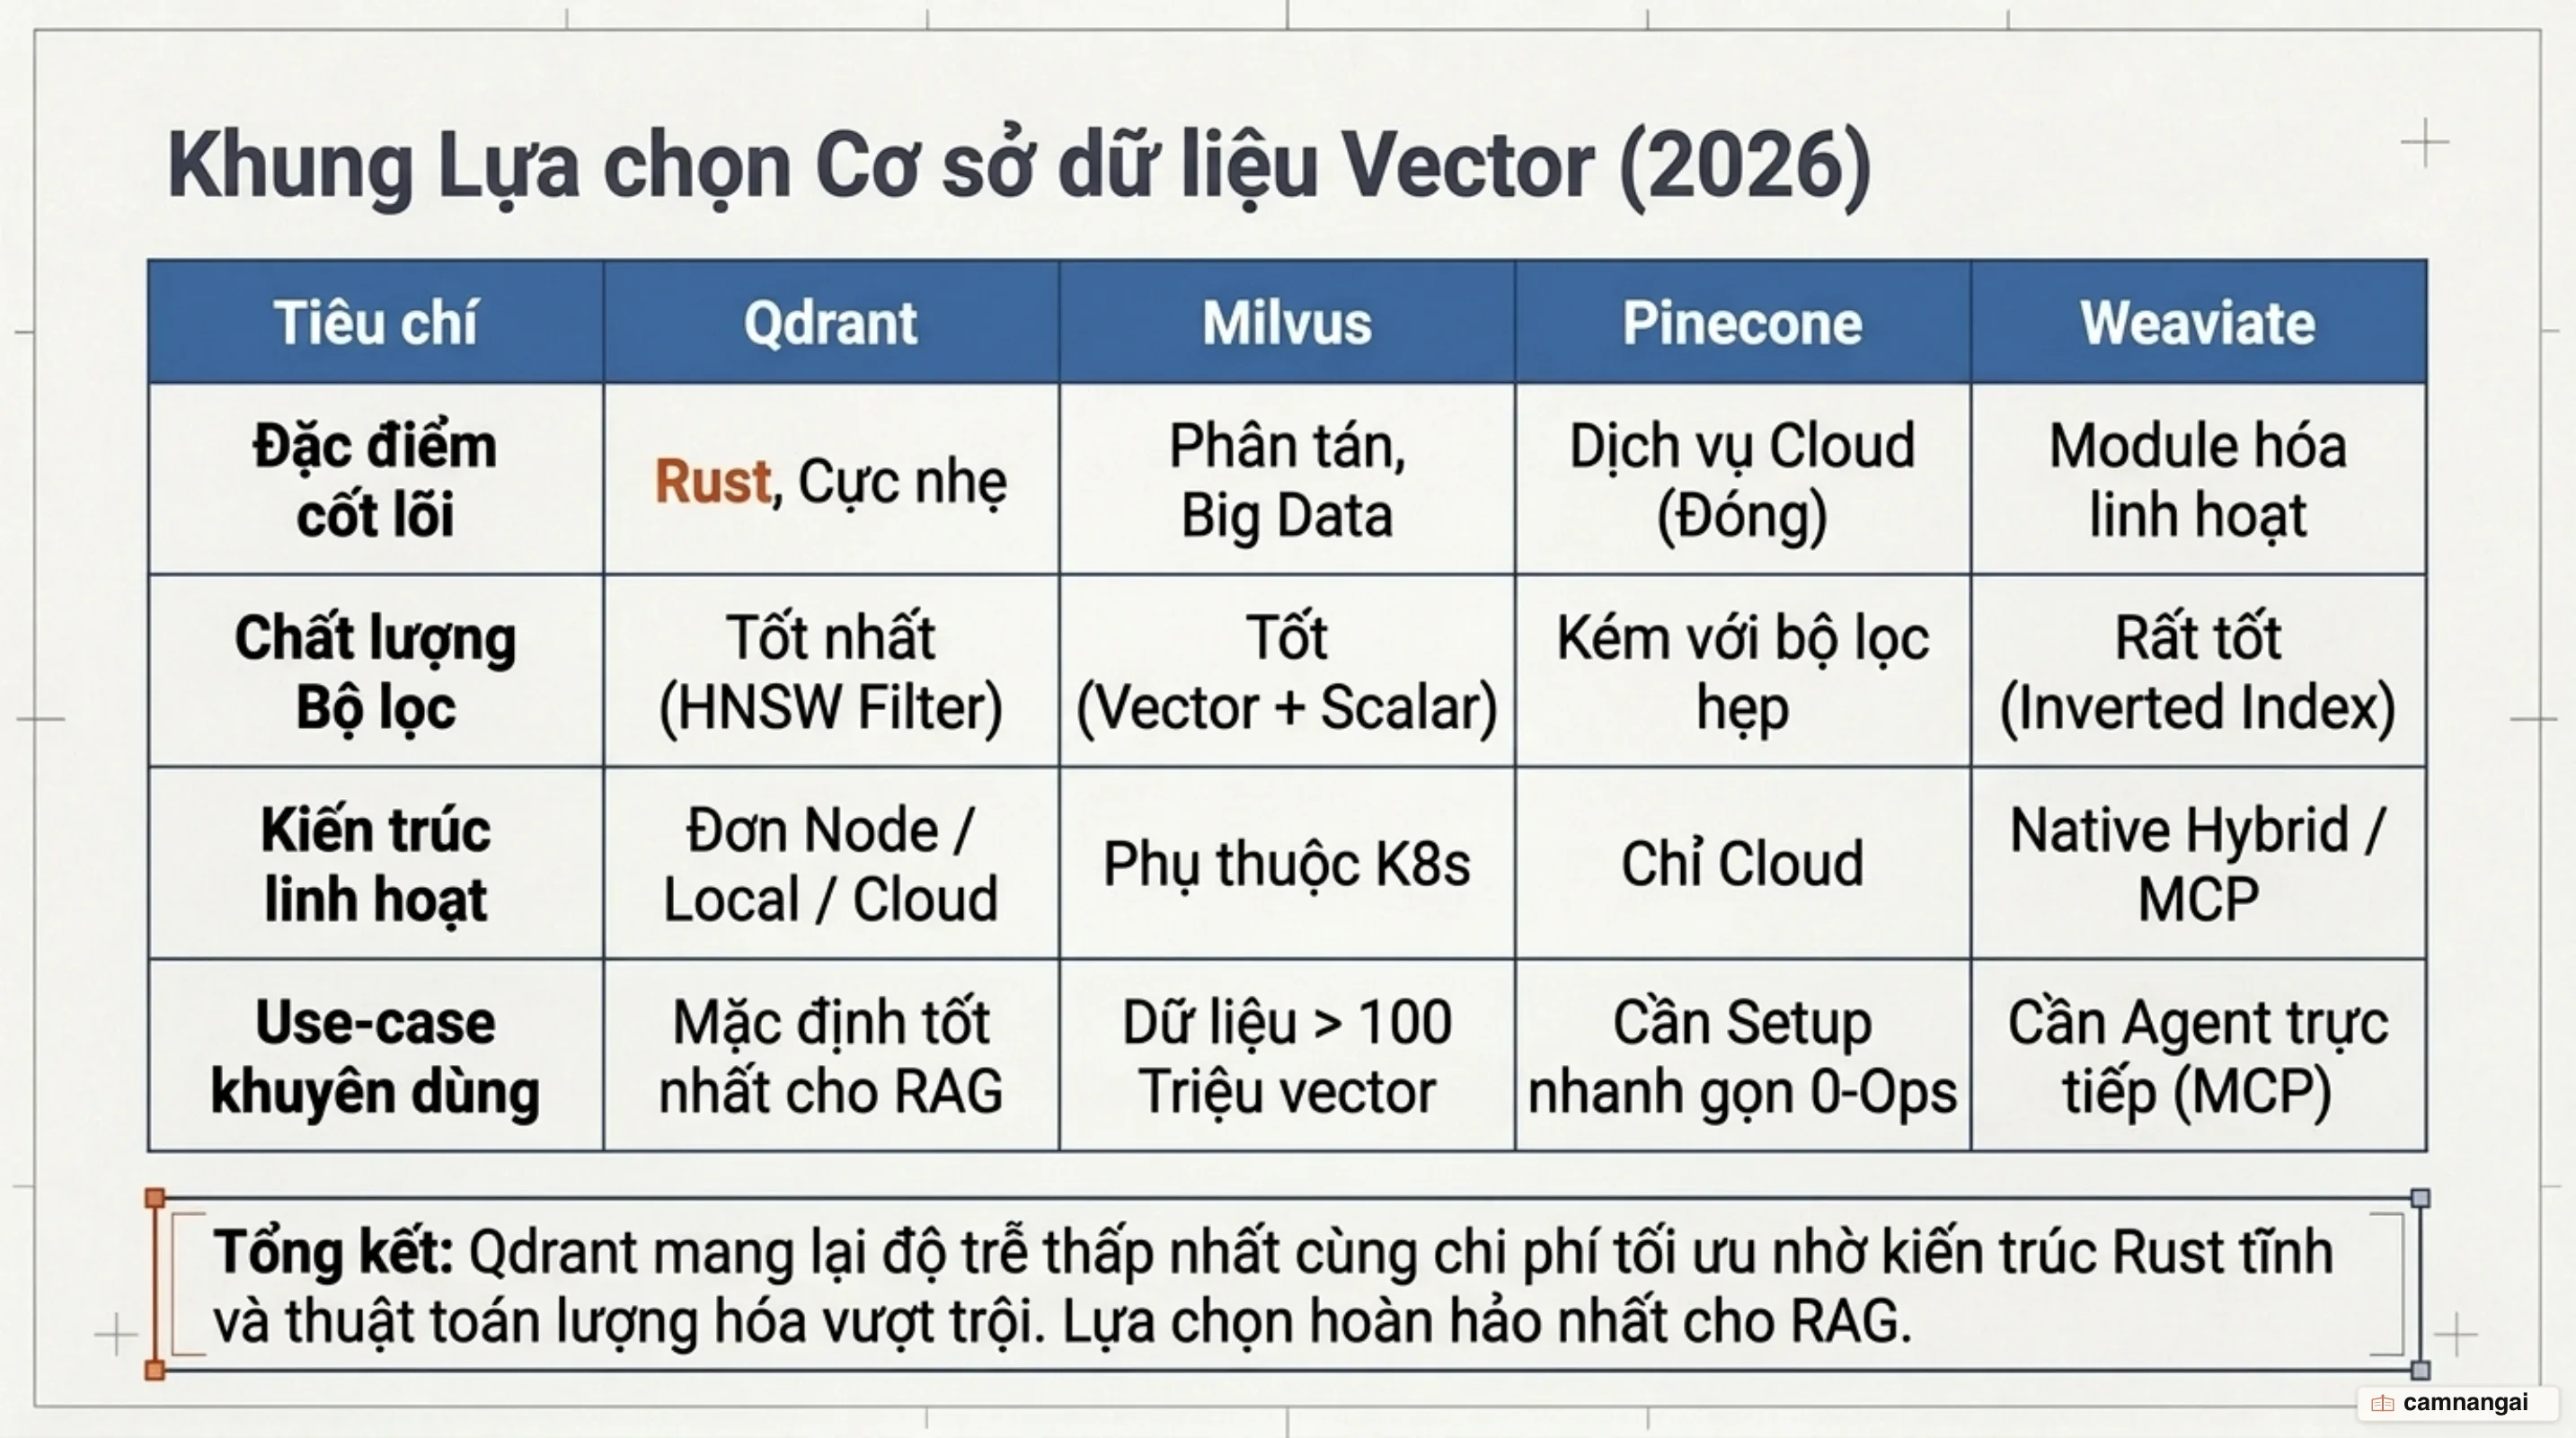
Xét trên khía cạnh hạ tầng dữ liệu, Qdrant sở hữu những đặc tính kỹ thuật riêng biệt so với các giải pháp lưu trữ vector khác như Milvus hay Pinecone trong hệ sinh thái:
- Bản chất mã nguồn mở thuần Rust: Đảm bảo hiệu năng tối đa, kiểm soát tài nguyên bộ nhớ chặt chẽ, hỗ trợ linh hoạt cả hai mô hình triển khai Client-Server tập trung và Embedded/Edge (Qdrant Edge) chạy in-process.
- Lọc Payload trực tiếp không mất Recall: Tích hợp điều kiện lọc phức tạp trực tiếp vào đồ thị HNSW thay vì sử dụng cơ chế hậu lọc (post-filtering) kém hiệu quả.
- Nén bộ nhớ và Truy vấn lai toàn diện: Tích hợp sẵn Vector Quantization giảm 97% RAM, kết hợp bộ máy dung hợp điểm (RRF, DBSF) cho phép thực hiện Hybrid Search giữa Dense, Sparse và BM25 chỉ trong một câu lệnh API.
Khung quyết định khi lựa chọn Qdrant:
- Kịch bản yêu cầu độ trễ truy vấn thấp, cần tự vận hành hạ tầng trên Docker/Kubernetes hoặc sử dụng dịch vụ managed Qdrant Cloud.
- Ứng dụng AI/RAG bắt buộc phải áp dụng các điều kiện lọc metadata khắt khe (danh mục, khoảng số, geohash) mà vẫn phải duy trì chỉ số recall cao.
- Hệ thống cần phân tách dữ liệu đa người dùng (Multitenancy) hoặc phân mảnh tùy chỉnh (custom sharding).
- Cần chạy mô hình Vector Search trên thiết bị biên, ứng dụng di động hoặc môi trường ngoại tuyến cần đồng bộ dữ liệu với máy chủ trung tâm.
Bắt đầu nhanh với Qdrant: Từ Docker đến truy vấn Python
Bạn có thể khởi chạy một thể hiện Qdrant Server cục bộ bằng Docker CLI với lệnh sau:
docker run -p 6333:6333 qdrant/qdrantSau khi container khởi chạy, bạn cài đặt thư viện qdrant-client và kết nối tới máy chủ từ Python:
from qdrant_client import QdrantClient

client = QdrantClient(url="http://localhost:6333")
Đoạn mã dưới đây minh họa cách thiết lập truy vấn Hybrid Search: sử dụng prefetch để thực hiện song song một truy vấn tìm kiếm toàn văn BM25 trên trường title và một truy vấn Dense Vector, sau đó dung hợp kết quả bằng RRF với tham số k=60:
from qdrant_client import QdrantClient, models

client = QdrantClient(url="http://localhost:6333")

client.query_points(
    collection_name="my_collection",
    prefetch=[
        models.Prefetch(
            query=models.TextQuery(text="time travel"),
            using="title",
            limit=20,
        ),
        models.Prefetch(
            query=[0.01, 0.45, 0.67],
            using="dense",
            limit=20,
        ),
    ],
    query=models.RrfQuery(rrf=models.Rrf(k=60)),
    limit=10,
)
Tổng kết: Vị thế của Qdrant trong hạ tầng AI hiện đại
Qdrant là giải pháp hạ tầng tối ưu cho các hệ thống RAG và Semantic Search đòi hỏi xử lý bài toán lọc metadata khắt khe trực tiếp trong giai đoạn truy vấn vector mà không đánh đổi độ chính xác. Việc kết hợp giữa bộ máy viết bằng Rust, kiến trúc Segment tối ưu I/O, kỹ thuật nén lượng hóa vector tiết kiệm bộ nhớ và các thuật toán dung hợp truy vấn lai giúp doanh nghiệp vận hành hệ thống AI quy mô lớn với chi phí phần cứng tối thiểu.
Tài liệu tham khảo
- Tổng quan — Tài liệu Qdrant Vector Search Engine
- Khởi động nhanh với Qdrant — Tài liệu Qdrant
- Filtrable HNSW: Tìm kiếm vector tốc độ cao có điều kiện lọc — Qdrant
- Kiến trúc lập chỉ mục và lưu trữ — Tài liệu Qdrant
- Lượng hóa vô hướng (Scalar Quantization) cho tìm kiếm vector — Qdrant
- Truy vấn lai và kết hợp tìm kiếm — Tài liệu Qdrant
- Qdrant: Cơ sở dữ liệu và công cụ tìm kiếm vector mã nguồn mở (Rust)
- Pinecone vs Weaviate vs Milvus vs Qdrant: Chọn Vector DB nào năm 2026? — DEV Community