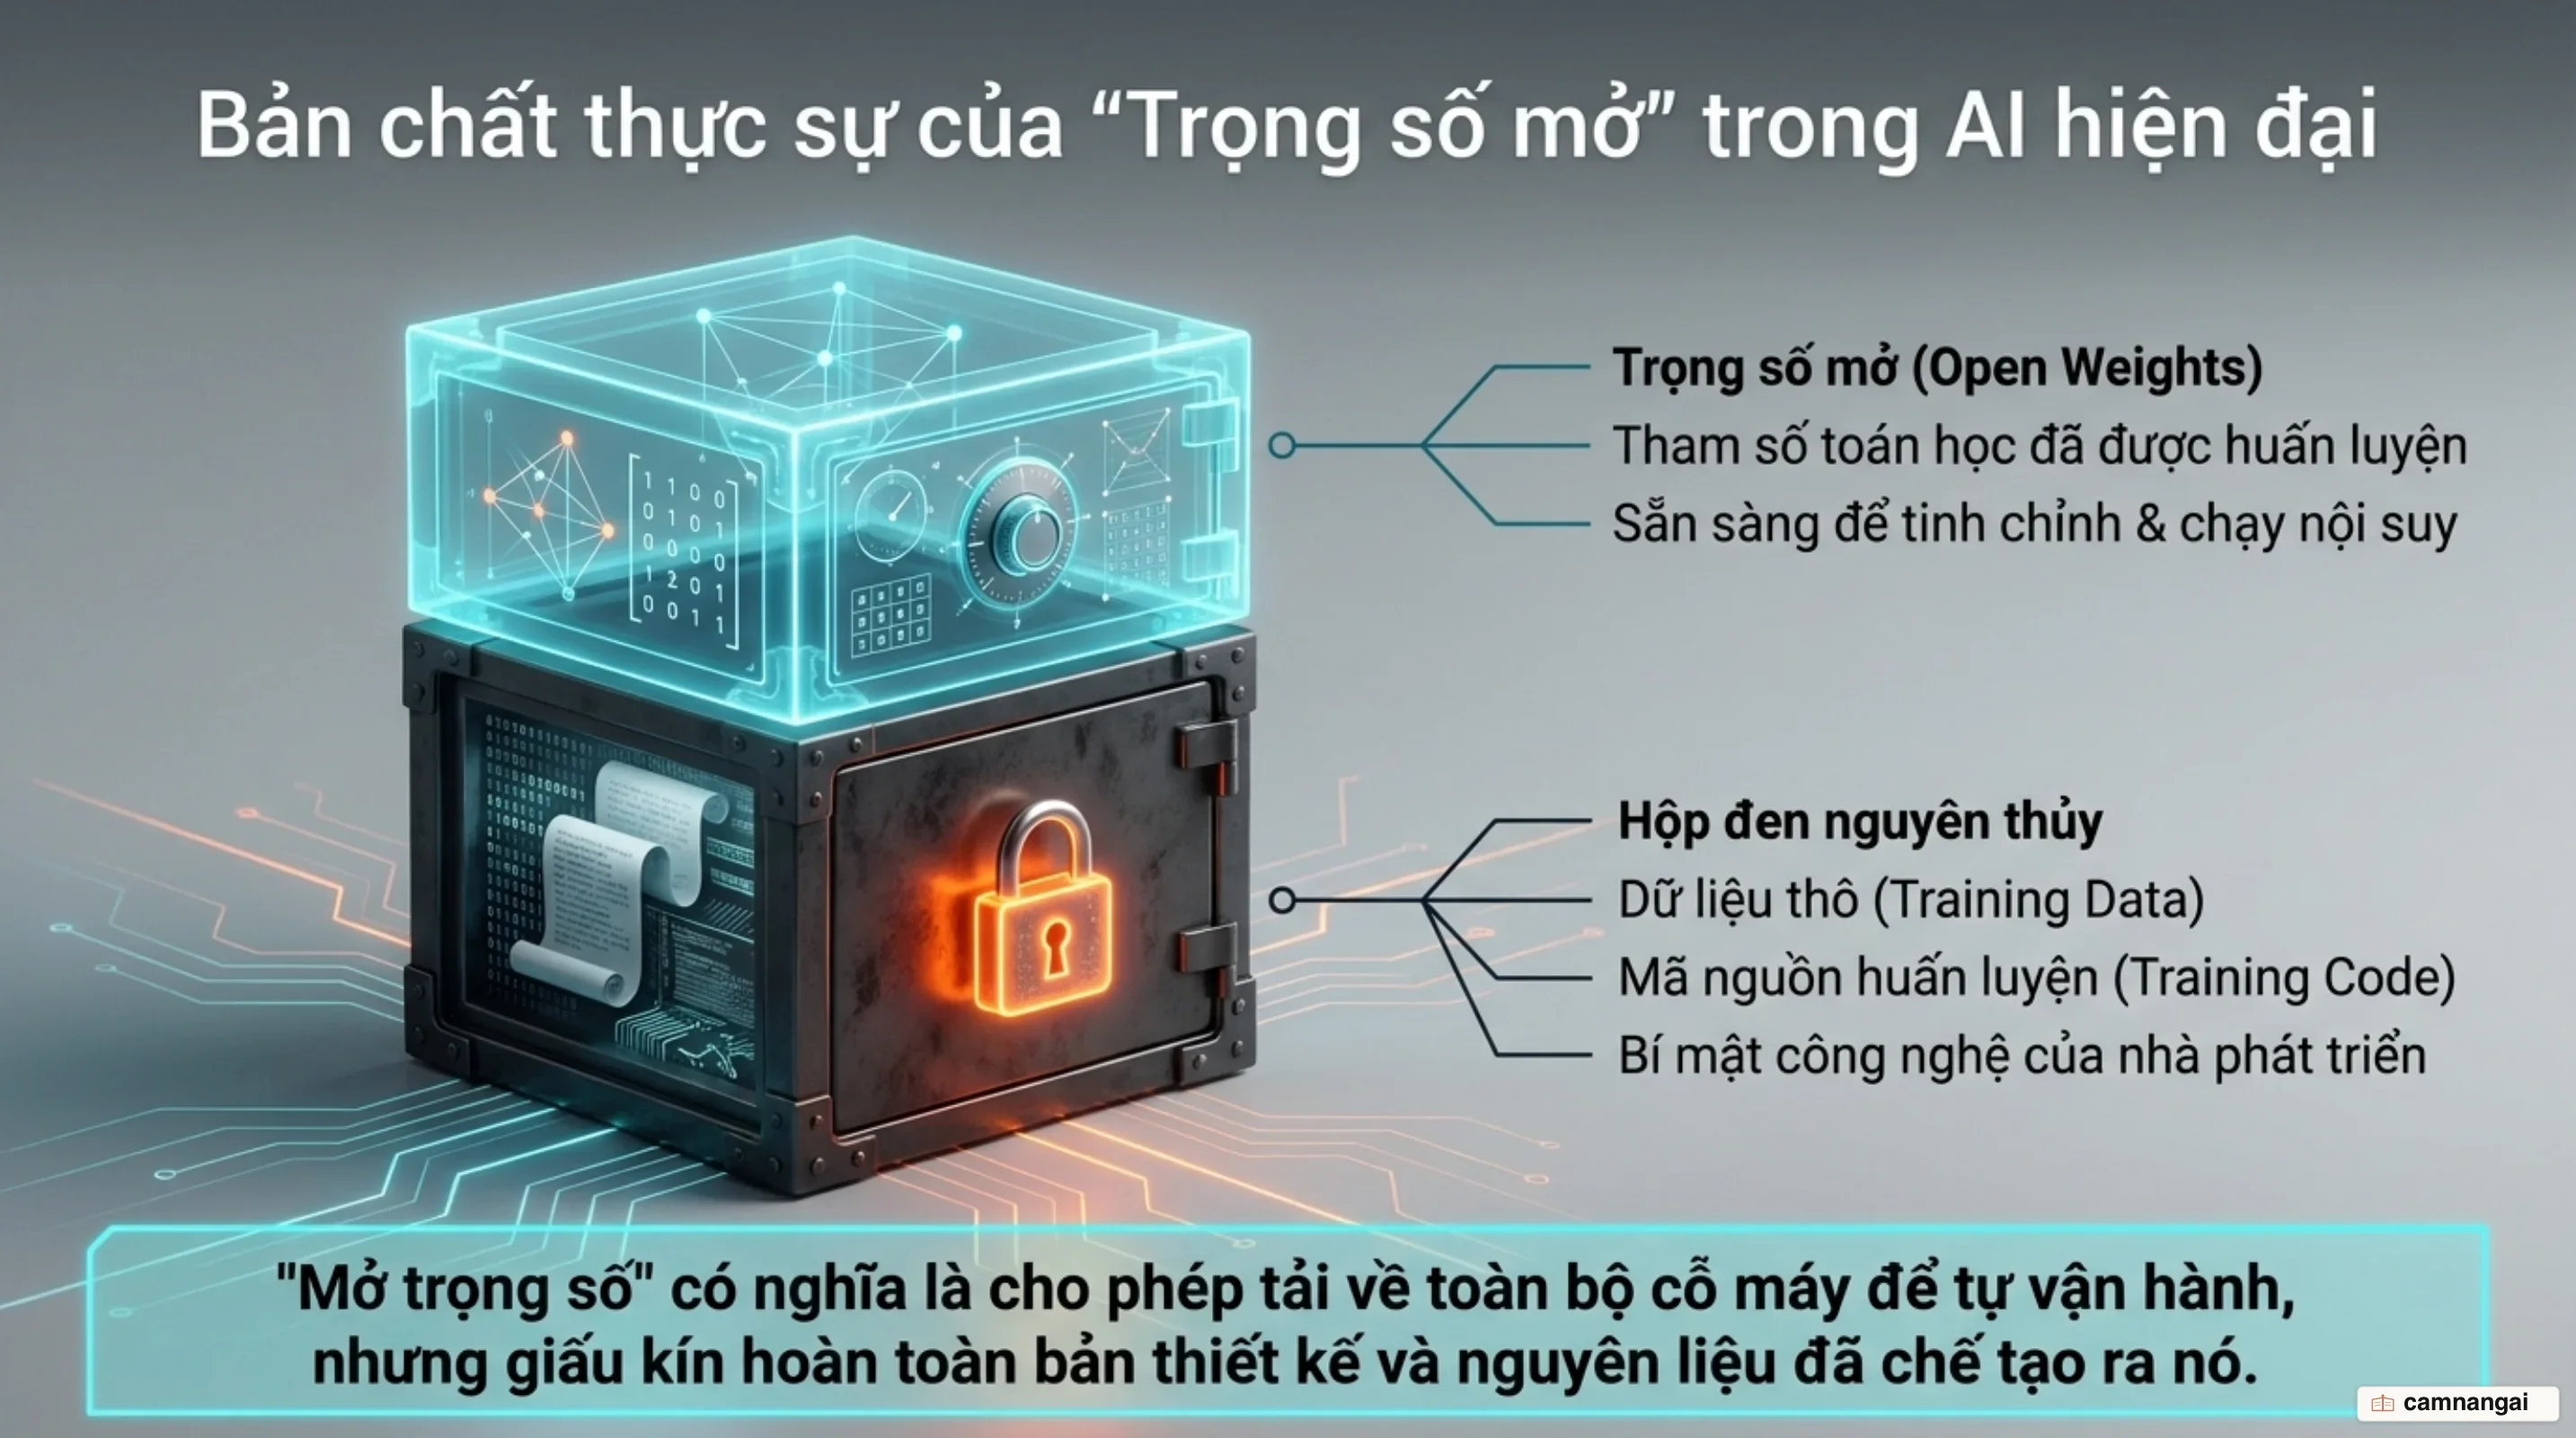
Trọng số mở (open weights) là tập hợp các tham số đã qua huấn luyện (bao gồm trọng số và độ lệch — weights và biases) của một mạng thần kinh nhân tạo được công khai để bạn tải về, tinh chỉnh hoặc tự vận hành trên hạ tầng riêng.
Khác với việc chỉ cung cấp quyền truy cập qua giao diện web hay cổng API đóng, việc phát hành trọng số mở trao cho kỹ sư quyền kiểm soát thực thi trực tiếp đối với mô hình.
Trong kiến trúc học máy, trọng số đại diện cho tài sản tiêu tốn nhiều chi phí tính toán nhất, được trích xuất từ hàng triệu giờ chạy của hệ thống cụm đơn vị xử lý đồ họa (GPU). Dù việc phát hành trọng số mở cho phép bạn nắm giữ kết quả đầu ra của quá trình huấn luyện, nó không đồng nghĩa với việc bạn nhận được toàn bộ mã nguồn huấn luyện hay tập dữ liệu gốc ban đầu.
Nắm giữ trọng số mở trao cho kỹ sư quyền tự chủ vận hành suy luận, nhưng toàn bộ công thức và dữ liệu huấn luyện gốc vẫn là hộp đen.
Trọng số (weights) của mô hình AI thực chất là gì?
Mạng thần kinh nhân tạo trong trí tuệ nhân tạo (AI) về bản chất là một cấu trúc toán học quy mô lớn chứa hàng tỷ hoặc hàng nghìn tỷ tham số số học có thể điều chỉnh. Khi bạn truyền một câu lệnh (prompt) qua mô hình, dữ liệu này sẽ trải qua quá trình lan truyền tiến (forward propagation) qua nhiều lớp thần kinh. Tại mỗi lớp, các giá trị số này sẽ tính toán và định hình kết quả đầu ra. Một giá trị trọng số đơn lẻ không mang bất kỳ ý nghĩa ngữ nghĩa tách biệt nào, nhưng sự kết hợp đồng thời của hàng tỷ trọng số sẽ quyết định chính xác phản ứng của mô hình trước mọi dữ liệu đầu vào.
Huấn luyện mô hình thực chất là chu kỳ tinh chỉnh liên tục các tham số này. Mô hình xử lý dữ liệu đầu vào từ văn bản, mã nguồn đến hình ảnh, dự đoán kết quả và điều chỉnh tăng giảm từng trọng số khi xảy ra sai số. Nói cách khác, tập hợp các trọng số sau cùng chính là tài sản tính toán đắt đỏ nhất: nó kết tinh hàng triệu đô la tiền điện và chi phí hao mòn phần cứng GPU.
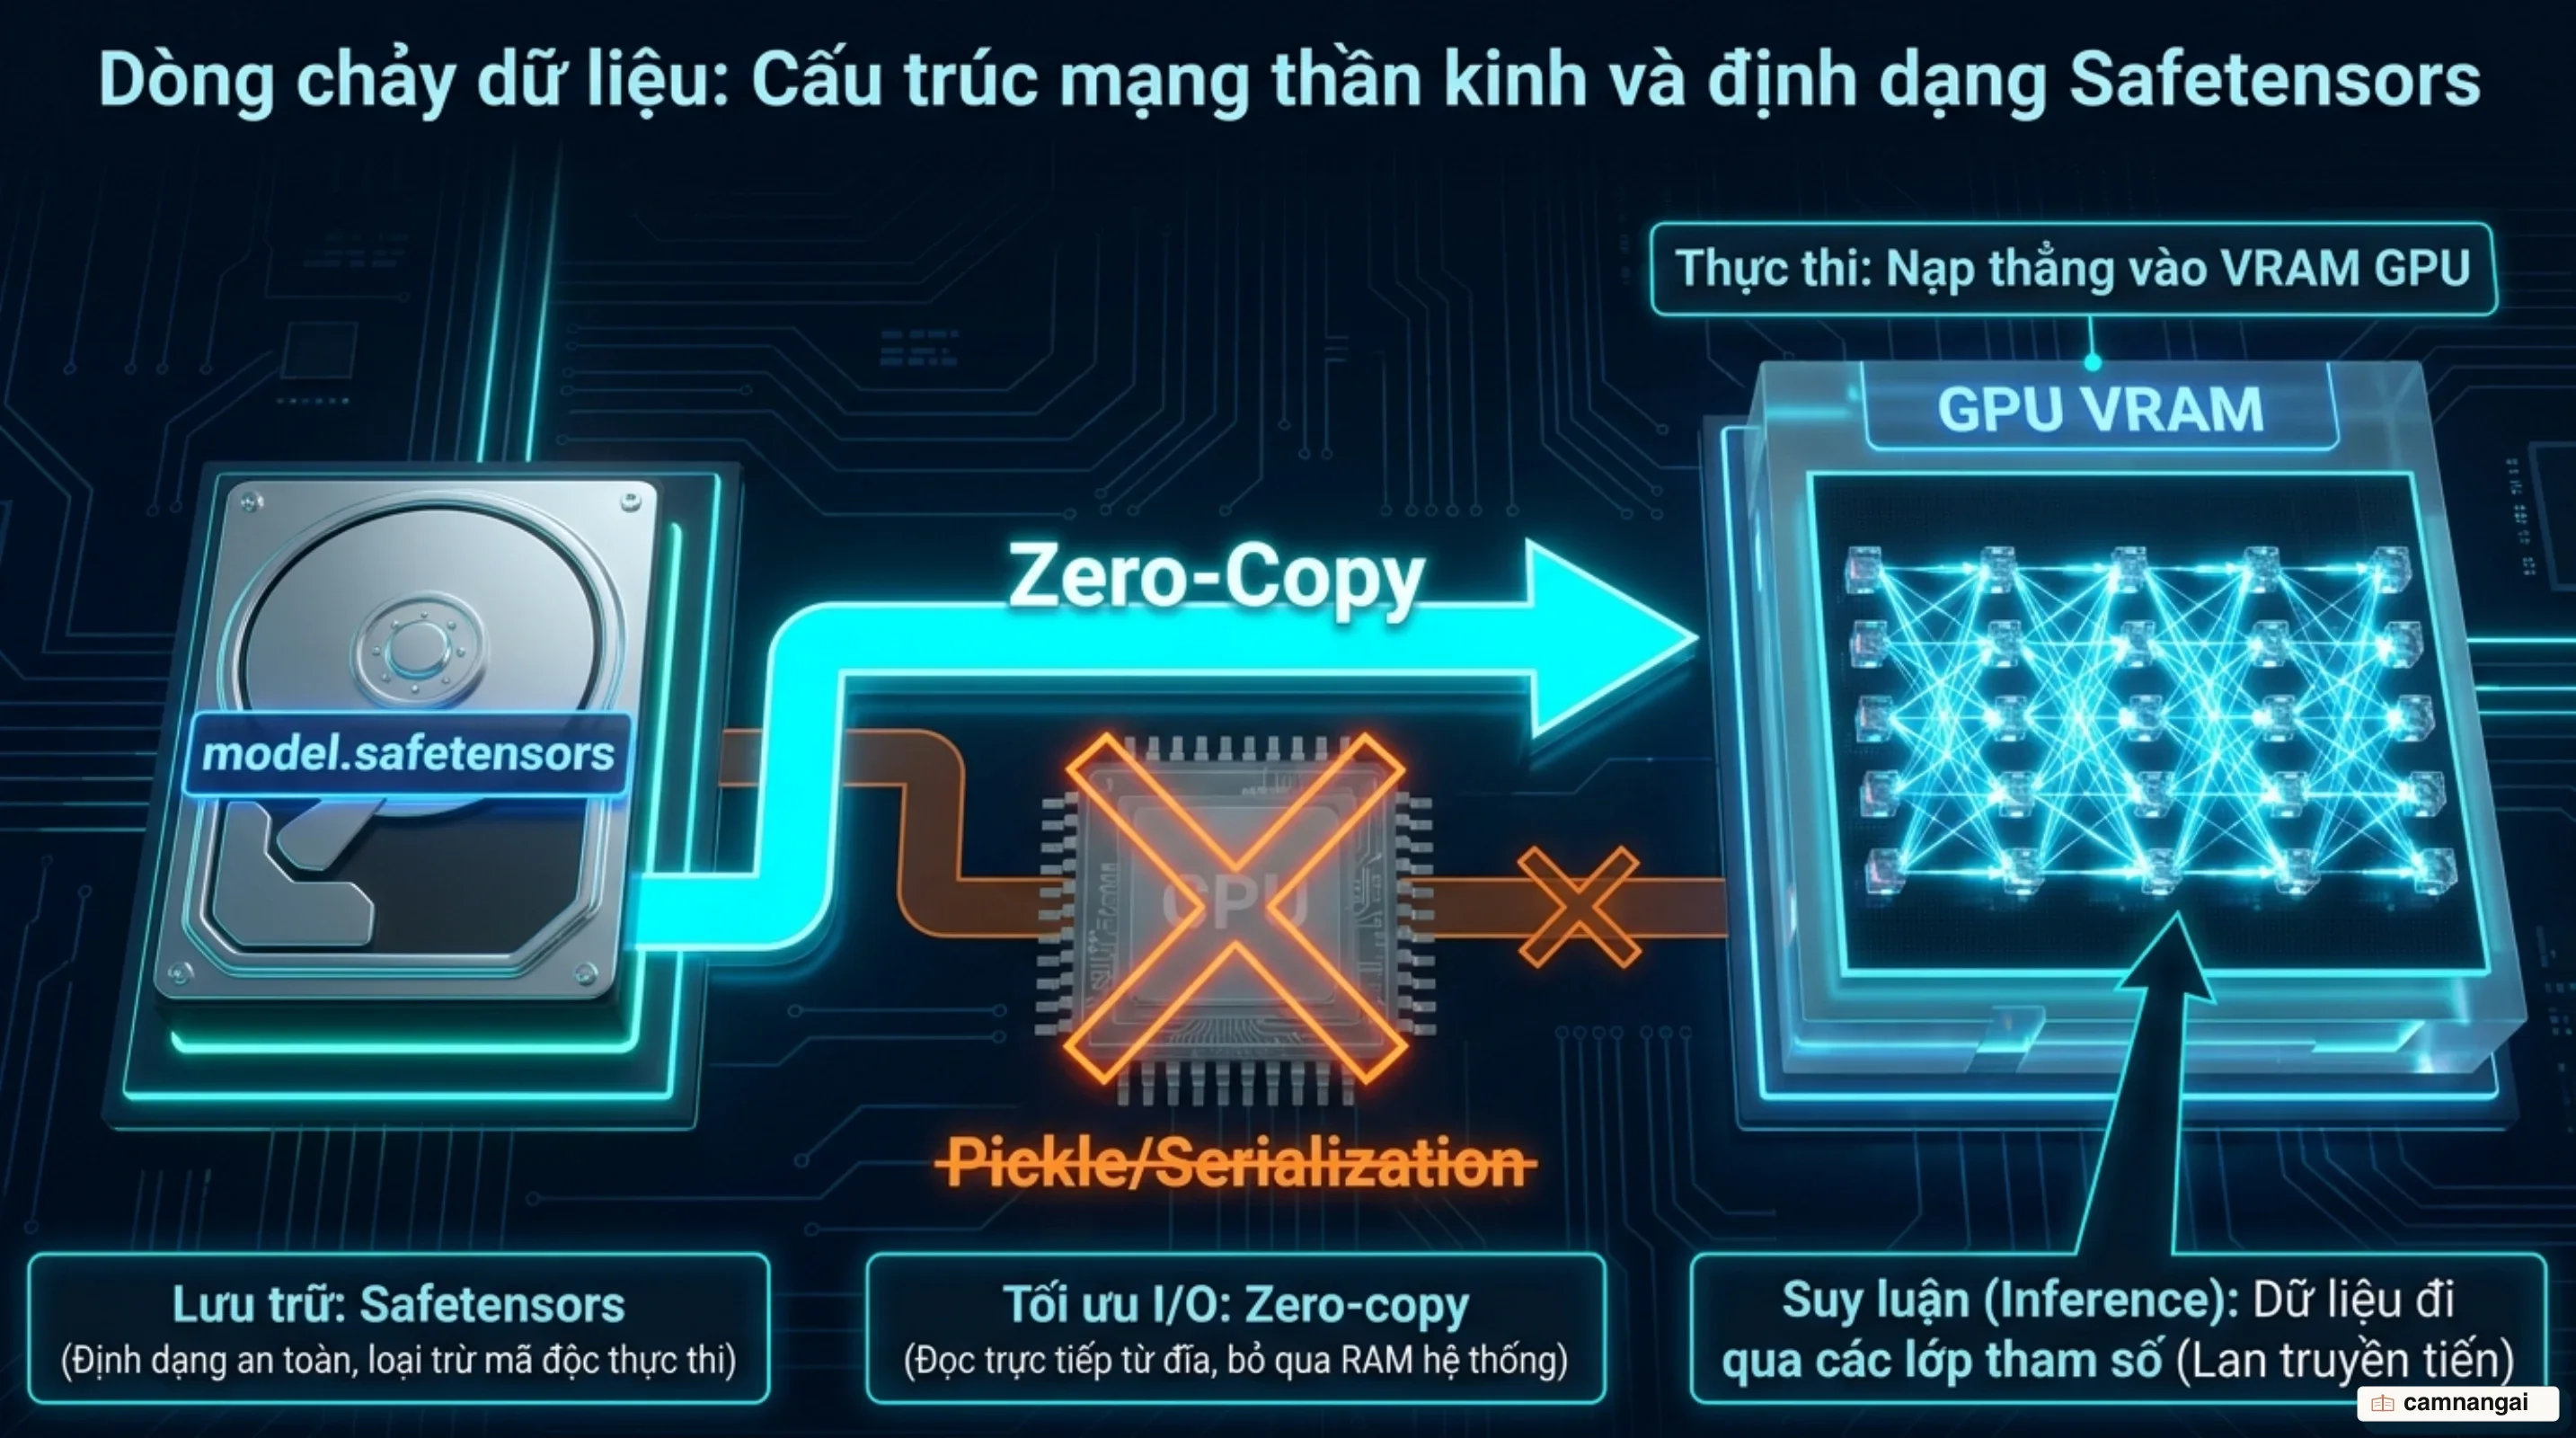
Về mặt đóng gói dữ liệu kỹ thuật, các trọng số mở từng được lưu trữ dưới các tệp tuần tự hóa pickle của Python. Tuy nhiên, ngành công nghiệp đã chuyển dịch nhanh sang định dạng safetensors để đảm bảo an toàn bộ nhớ và đọc dữ liệu trực tiếp dạng zero-copy mà không thực thi các mã Python độc hại. Định dạng này hỗ trợ kỹ thuật cắt lát tensor (tensor slicing), cho phép bạn trích xuất một phần mảng dữ liệu vào bộ nhớ video (VRAM) trên các cụm nhiều GPU (multi-GPU) mà không cần nạp hàng gigabyte tham số không sử dụng vào bộ nhớ:
from safetensors import safe_open

# Tải toàn bộ tensor vào bộ nhớ
tensors = {}
with safe_open("model.safetensors", framework="pt", device=0) as f:
    for k in f.keys():
        tensors[k] = f.get_tensor(k)

# Trích xuất lát cắt tensor (zero-copy slicing) để tối ưu VRAM
with safe_open("model.safetensors", framework="pt", device=0) as f:
    tensor_slice = f.get_slice("embedding")
    vocab_size, hidden_dim = tensor_slice.get_shape()
    tensor = tensor_slice[:, :hidden_dim]
Trọng số mở khác gì với AI nguồn mở thực thụ?
Khái niệm mở trong trí tuệ nhân tạo (AI) hiện nay nằm trên một dải phổ kỹ thuật kéo dài: Truy cập qua cổng lưu trữ (Hosted Access) → Truy cập mở (Open Access) → Trọng số mở (Open Weights) → AI Nguồn mở thực thụ (Open Source AI - OSAID 1.0). Định nghĩa của Sáng kiến Nguồn mở (OSI) chỉ rõ rằng việc đánh đồng một mô hình mở trọng số là "AI nguồn mở" là không chính xác về mặt kỹ thuật. Trọng số mở chỉ cung cấp tham số đóng gói cuối cùng chứ không cung cấp đầy đủ các thành phần cấu thành nên hệ thống.
Một hệ thống AI nguồn mở thực thụ đòi hỏi đáp ứng bốn quyền tự do cơ bản: Sử dụng, Nghiên cứu, Chỉnh sửa và Chia sẻ. Để thực hiện các quyền này, nhà phát triển phải cung cấp "dạng thức ưu tiên để chỉnh sửa" (preferred form for modification). Các bản phát hành trọng số mở thường giữ lại bốn thành phần quan trọng: mã nguồn huấn luyện đầy đủ, tập dữ liệu huấn luyện thô, phương pháp lọc và xử lý dữ liệu, cùng các điểm kiểm tra trung gian (checkpoints) của quá trình huấn luyện.
Sự thiếu minh bạch về dữ liệu và quy trình huấn luyện tạo ra những rào cản lớn cho giới kỹ sư. Nếu không có tập dữ liệu gốc và mã nguồn đầy đủ, bạn gần như không thể tái lập quá trình huấn luyện (reproducibility), không thể kiểm toán nguồn gốc dữ liệu để truy vết bản quyền hay định kiến thuật toán, và càng không thể can thiệp vào giai đoạn tiền huấn luyện (pre-training). Bạn nhận được sản phẩm hoàn thiện, nhưng công thức nấu nướng gốc thì vẫn nằm trong tay nhà phát triển.
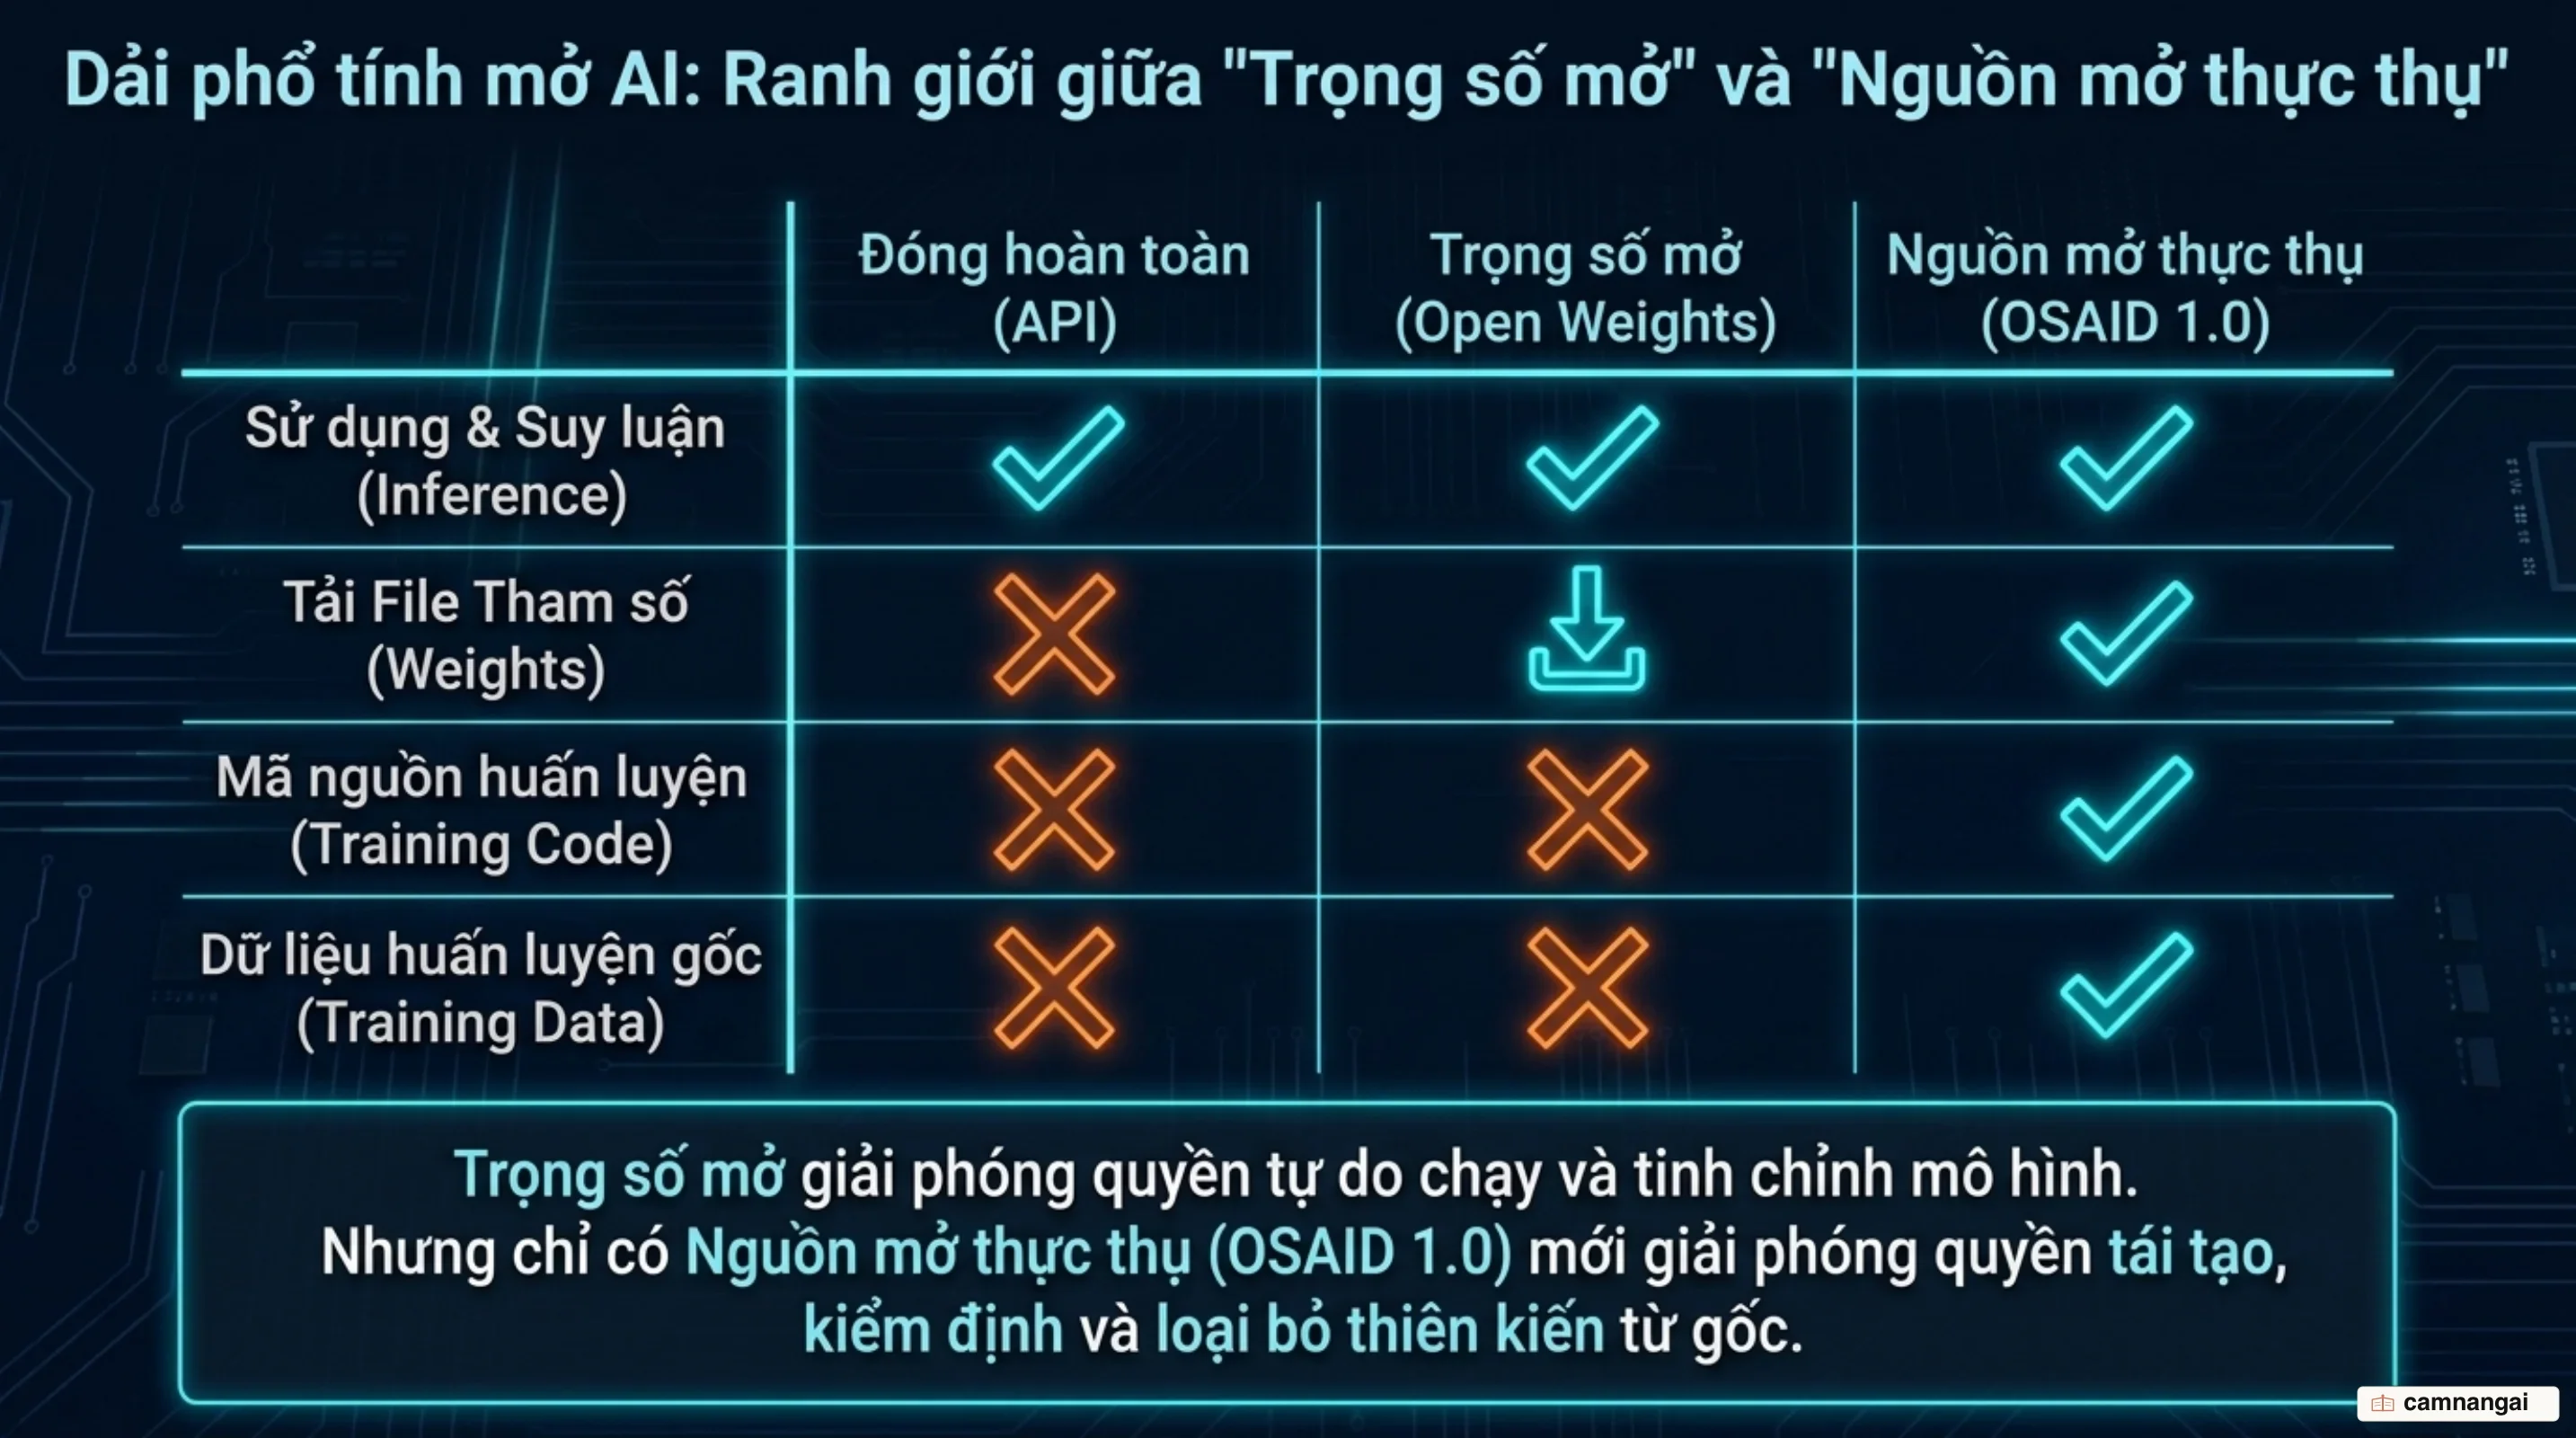
| Thành phần / Đặc tính | Trọng số mở (Open Weights) | AI Nguồn mở thực thụ (Open Source AI) |
|---|---|---|
| Trọng số & Biases (Parameters) | Công khai | Công khai |
| Mã nguồn huấn luyện (Training Code) | Không chia sẻ / Giữ kín | Chia sẻ đầy đủ |
| Checkpoint trung gian (Checkpoints) | Giữ lại | Khuyến khích / Nằm trong gói |
| Tập dữ liệu huấn luyện (Training Dataset) | Không công khai / Bị ẩn | Công khai (khi hợp pháp) |
| Thông tin cấu thành dữ liệu (Data Composition) | Bị ẩn hoặc công khai một phần | Báo cáo minh bạch toàn bộ |
Kỹ sư làm được những gì với mô hình trọng số mở?
Kéo trực tiếp tệp trọng số mở về máy chủ nội bộ giúp bạn giành lại quyền tự chủ hạ tầng hoàn toàn. Toàn bộ câu lệnh và dữ liệu độc quyền của doanh nghiệp như mã nguồn nội bộ, hồ sơ tài chính hay tài liệu y tế đều được xử lý cục bộ hoặc trên hạ tầng đám mây riêng tư. Việc này loại bỏ hoàn toàn rủi ro rò rỉ dữ liệu nhạy cảm ra các cổng kết nối API của bên thứ ba.
Nắm giữ trọng số trong tay mở ra khả năng can thiệp sâu vào cấu trúc mô hình mà phương thức API đóng không bao giờ cho phép. Bạn có thể áp dụng kỹ thuật lượng tử hóa (quantization) để giảm độ chính xác số thực của trọng số, giúp nén dung lượng mô hình khổng lồ xuống mức có thể chạy mượt mà trên phần cứng thương mại, chip Apple silicon hay CPU thông thường. Bằng các phương pháp tinh chỉnh tham số hiệu quả như LoRA (Low-Rank Adaptation), bạn dễ dàng huấn luyện bổ sung một lượng tham số nhỏ để mô hình hiểu sâu thuật ngữ chuyên ngành mà không tốn chi phí huấn luyện lại từ đầu.
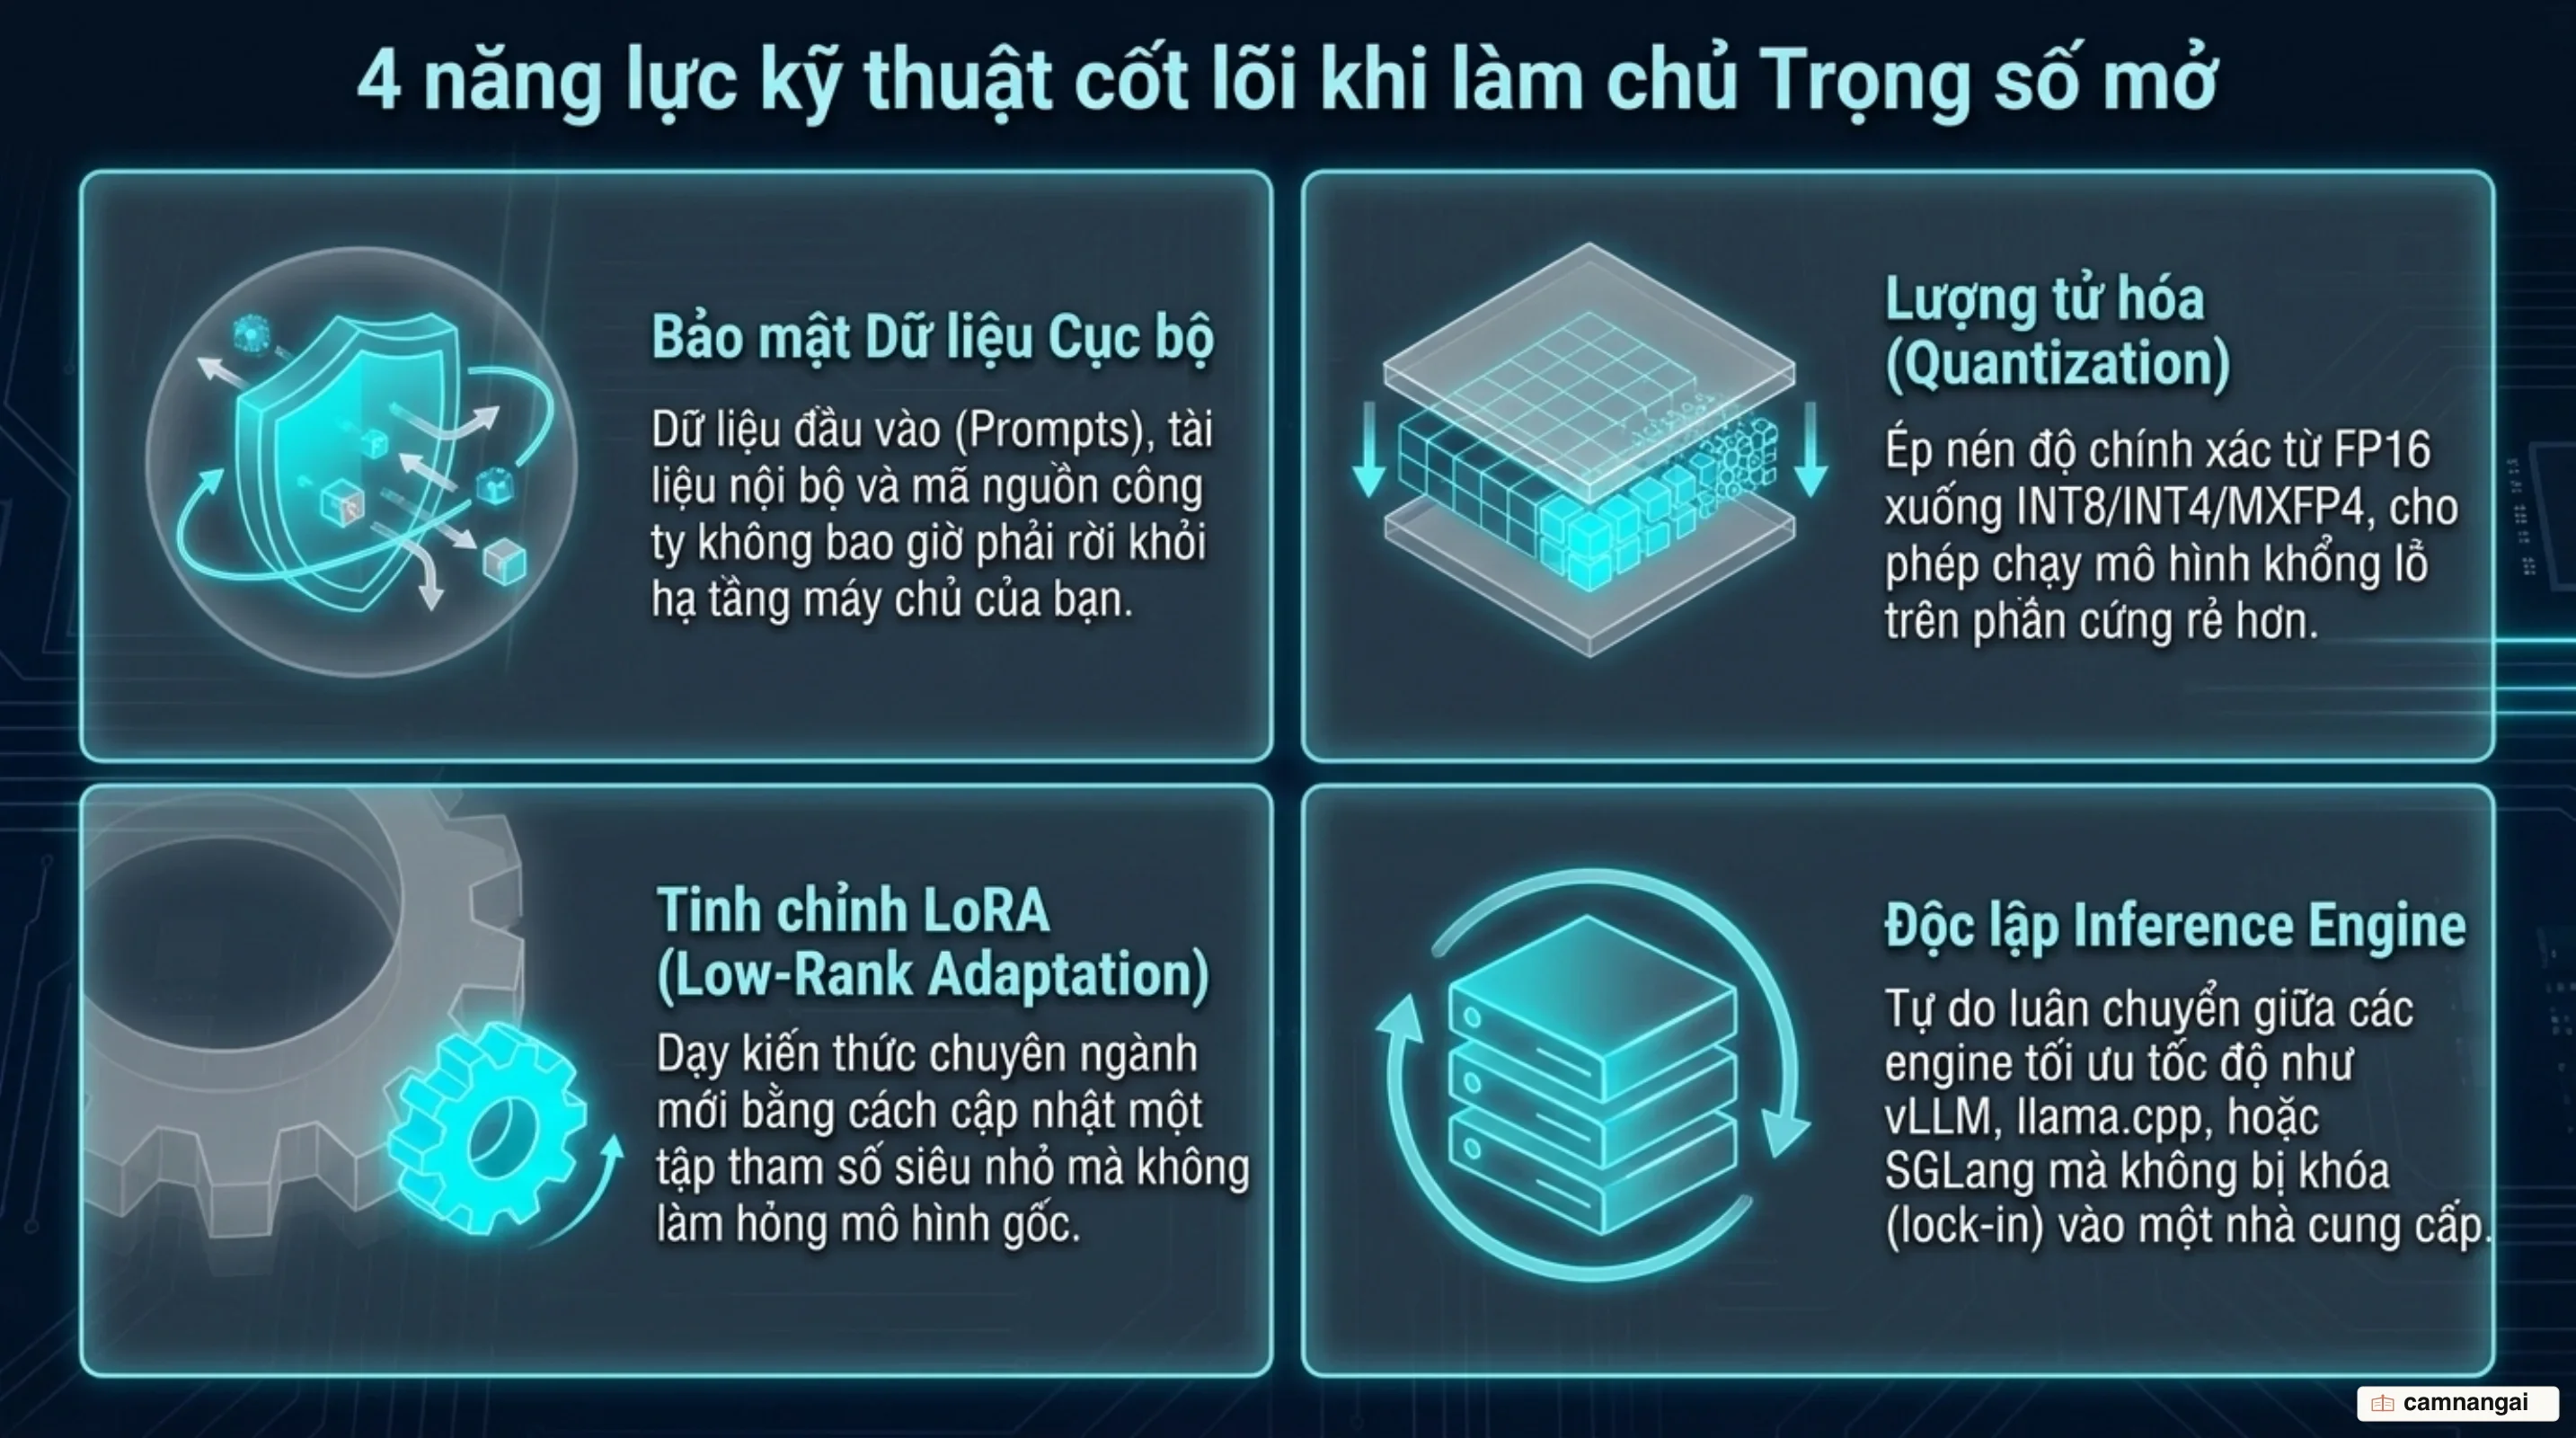
Bên cạnh đó, mô hình trọng số mở mang lại sự linh hoạt tối đa trong việc lựa chọn công cụ thực thi suy luận (inference engine) như vLLM, SGLang, Ollama hoặc LM Studio, tránh hiện tượng khóa chặt vào một nhà cung cấp dịch vụ (vendor lock-in). Quan trọng hơn cả, bạn có thể đóng băng chính xác phiên bản mô hình đang sử dụng, đảm bảo hệ thống không bị ảnh hưởng bởi những đợt cập nhật ngầm hoặc bị ngừng hỗ trợ đột ngột từ các dịch vụ bên ngoài.
Giấy phép và ranh giới pháp lý đằng sau cú nhấp tải về
Hành động tải về một tập tin trọng số mở từ các nền tảng phân phối không đồng nghĩa với việc bạn có quyền tự do sử dụng vô điều kiện. Mọi tệp mô hình đều đi kèm với các điều khoản pháp lý cụ thể quy định ranh giới về việc triển khai thương mại, phân phối lại hoặc tạo ra các sản phẩm phái sinh.
Sự khác biệt thể hiện rõ giữa các giấy phép nguồn mở tự do (như Apache 2.0 hoặc MIT) và các giấy phép cộng đồng hoặc thương mại do doanh nghiệp tự đặt ra (như Llama Community License, Qwen3.8-Max License, hay Kimi K3 License). Những giấy phép tùy chỉnh này thường áp đặt giới hạn dựa trên quy mô người dùng hoạt động hàng tháng (MAU - Monthly Active Users), doanh thu doanh nghiệp, hoặc cấm ứng dụng trong một số ngành công nghiệp và hành vi cụ thể.
Tranh luận pháp lý căng thẳng nhất hiện nay xoay quanh kỹ thuật chưng cất mô hình (distillation) — sử dụng đầu ra của mô hình lớn để huấn luyện các mô hình nhỏ hơn. Thư ngỏ "Open Weights and American AI Leadership" do Microsoft khởi xướng cùng 235 đơn vị đặt chữ ký (bao gồm NVIDIA, Amazon, Y Combinator, The Linux Foundation và OpenAI) đã khẳng định chưng cất là phương pháp học tập công nghệ hợp pháp. Trái ngược lập trường này, một số phòng thí nghiệm tiên phong lại lên tiếng yêu cầu siết chặt kiểm soát và trấn áp các hoạt động chưng cất quy mô công nghiệp do lo ngại rủi ro an ninh và sở hữu trí tuệ.
Trọng số mở không đồng nghĩa với phần cứng dễ tiếp cận
Cần phân biệt rạch ròi giữa tính mở về mặt pháp lý/kỹ thuật (bạn có quyền và tệp tin để tải) và tính dễ tiếp cận về mặt phần cứng (bạn có đủ tài nguyên để vận hành). Việc một mô hình công bố trọng số mở hoàn toàn không cam kết rằng một cá nhân hay doanh nghiệp nhỏ có đủ năng lực phần cứng để chạy mô hình đó.
Các đợt phát hành mô hình quy mô lớn đã minh chứng rõ ranh giới này:
- Qwen3.8-2.4T-A95B: Sở hữu tổng cộng 2,4 nghìn tỷ tham số với kiến trúc hỗn hợp chuyên gia (MoE - Mixture of Experts), trong đó có 95 tỷ tham số kích hoạt cho mỗi token, đi kèm giấy phép thương mại tùy chỉnh Qwen3.8-Max License.
- Kimi K3: Có tổng cộng 2,8 nghìn tỷ tham số, sử dụng 896 chuyên gia (kích hoạt 16 chuyên gia mỗi token) cùng cửa sổ ngữ cảnh 1 triệu token. Tập tin trọng số của Kimi K3 được phân phối tự do trên Hugging Face Hub với dung lượng 1,56 TB dữ liệu
safetensorsđịnh dạng MXFP4 chia thành 96 mảnh (shards). Dù bất kỳ ai cũng có thể tải về, mô hình vẫn đòi hỏi cụm tối thiểu 64 gia tốc phần cứng chuyên dụng để phục vụ suy luận, minh chứng rằng một repository công khai không đảm bảo tính khả thi về mặt vận hành phần cứng.
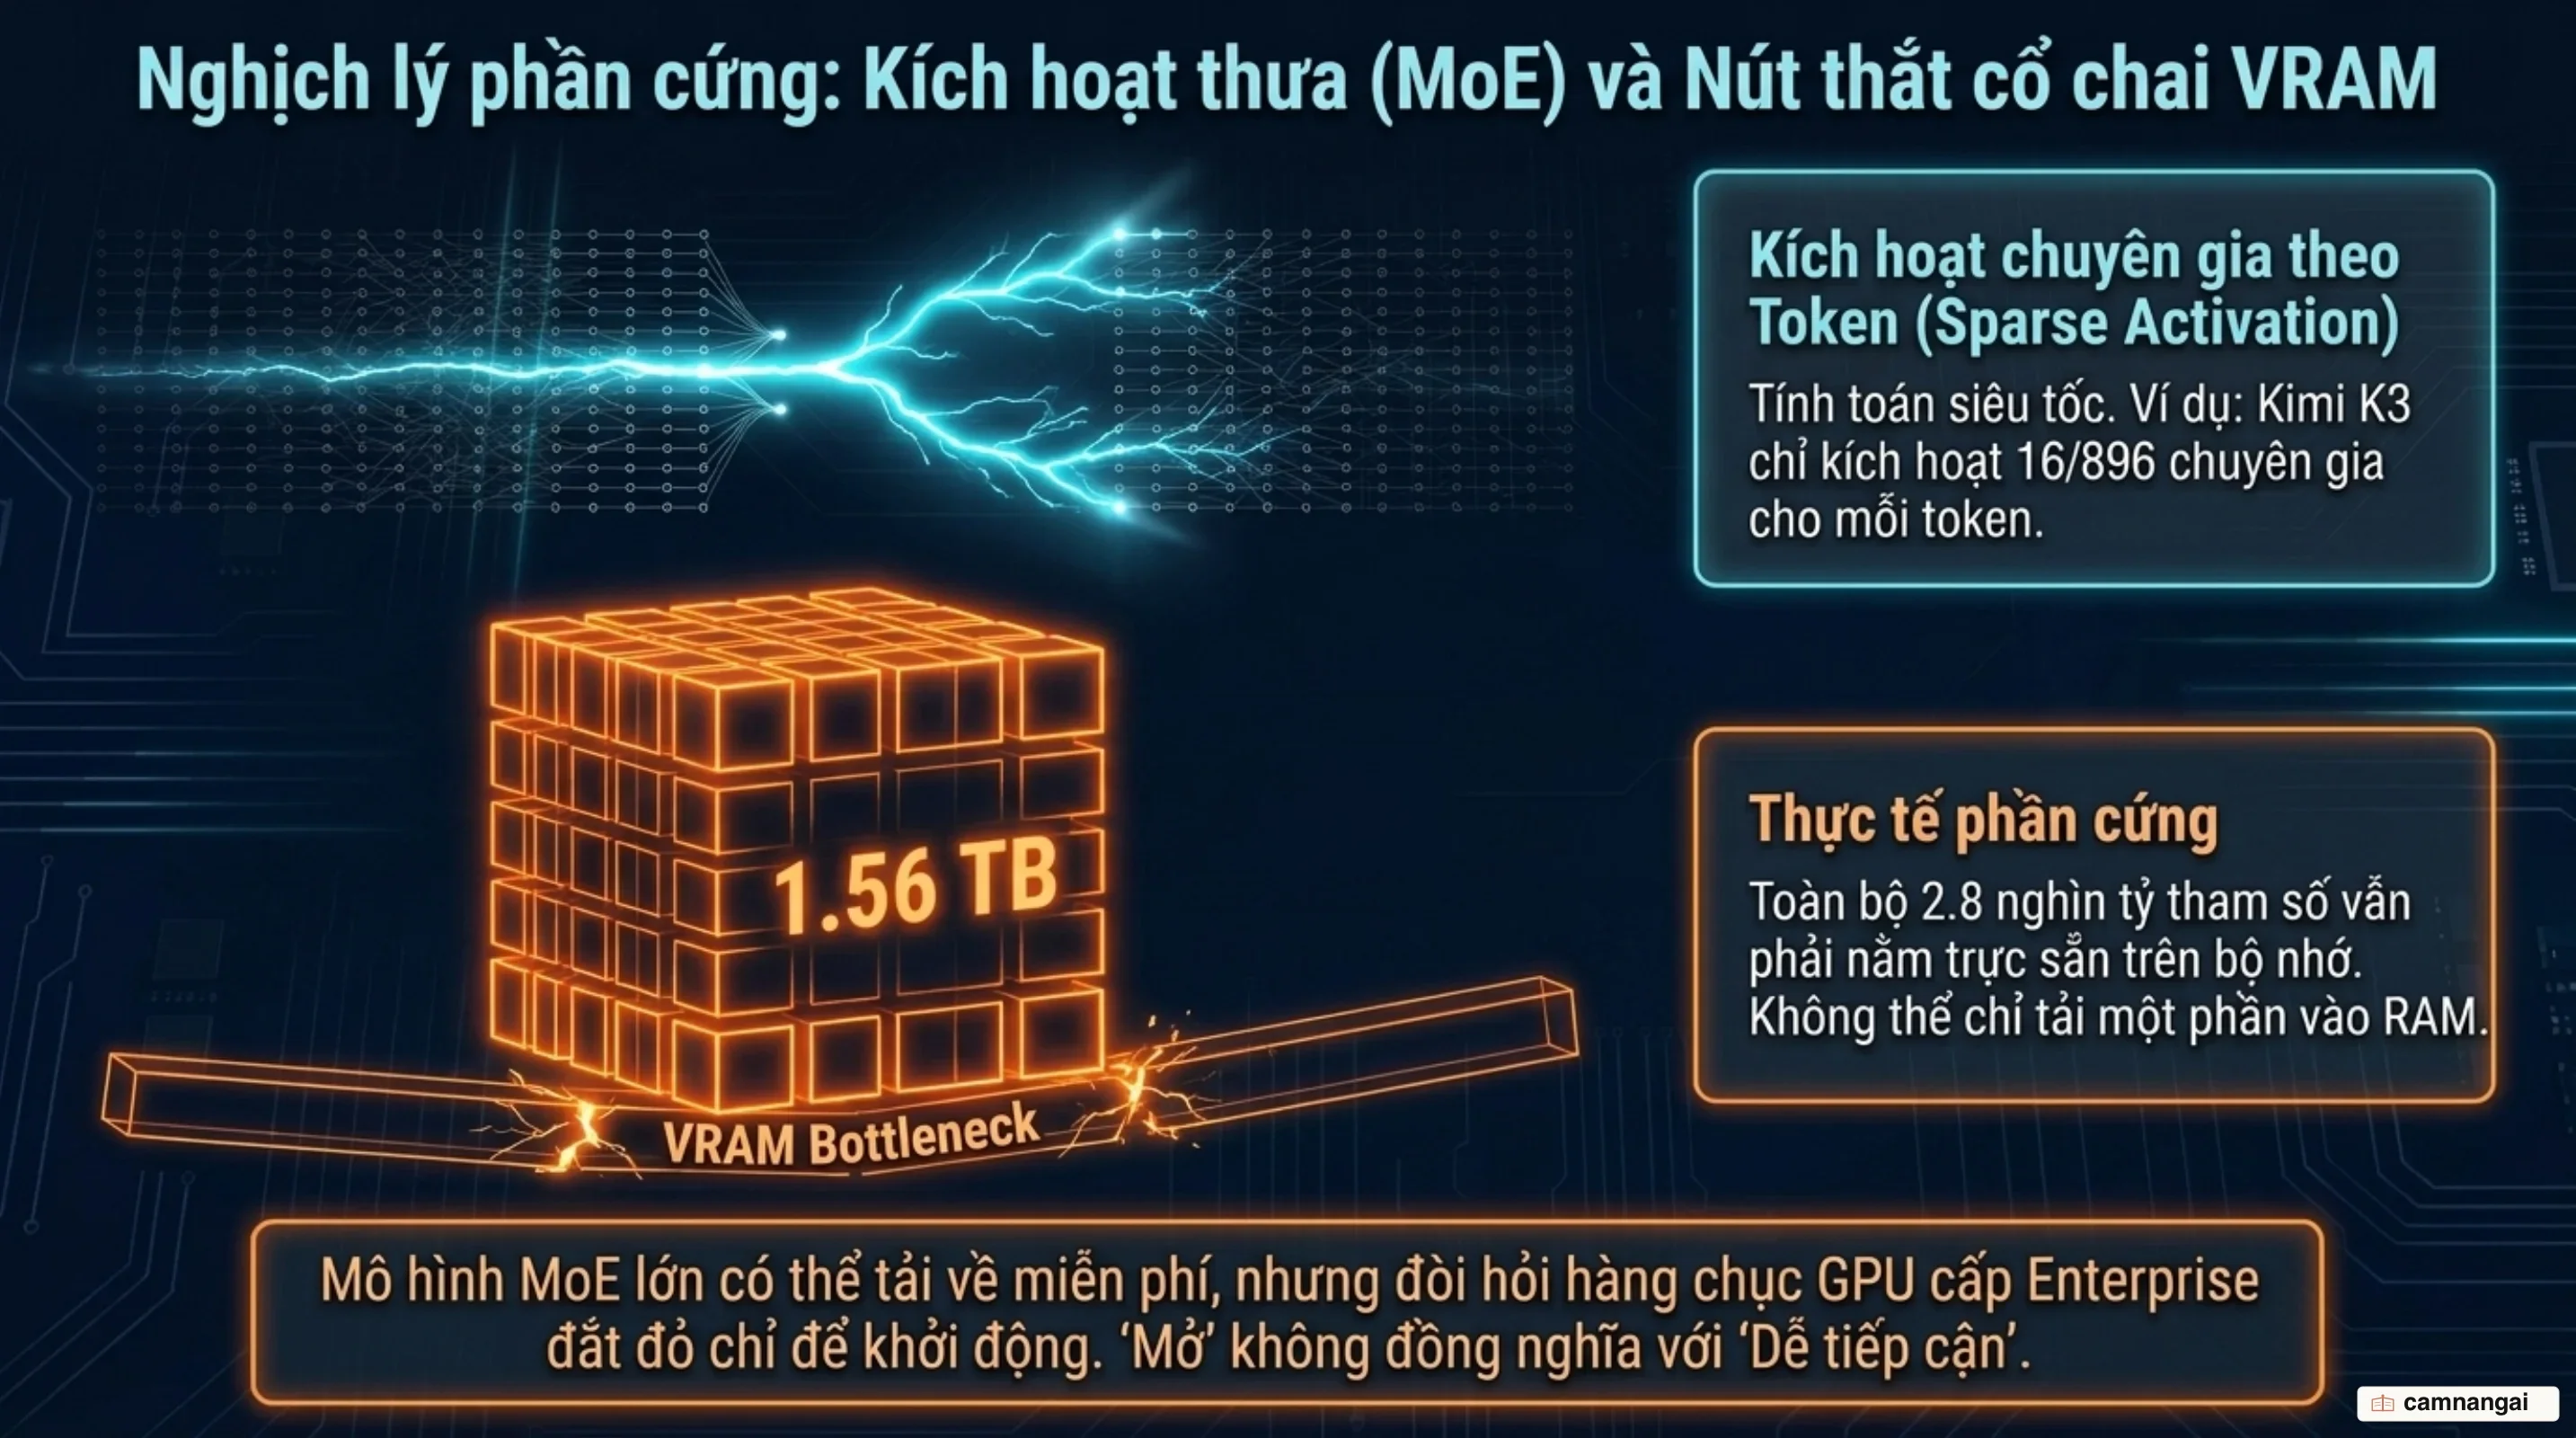
Nhiều đội ngũ lầm tưởng rằng có trọng số miễn phí là có thể tự chạy mô hình với chi phí rẻ. Thực tế, bài toán Tổng chi phí sở hữu (TCO - Total Cost of Ownership) cho thấy điều ngược lại: chi phí thuê cụm máy chủ chứa hàng terabyte VRAM, tiền điện làm mát, đường truyền mạng tốc độ cao và đội ngũ kỹ sư MLOps (vận hành máy học) túc trực có thể ngốn ngân sách gấp nhiều lần tiền cước API hàng tháng.
Khi nào nên dùng mô hình Open Weights thay vì API nguồn đóng?
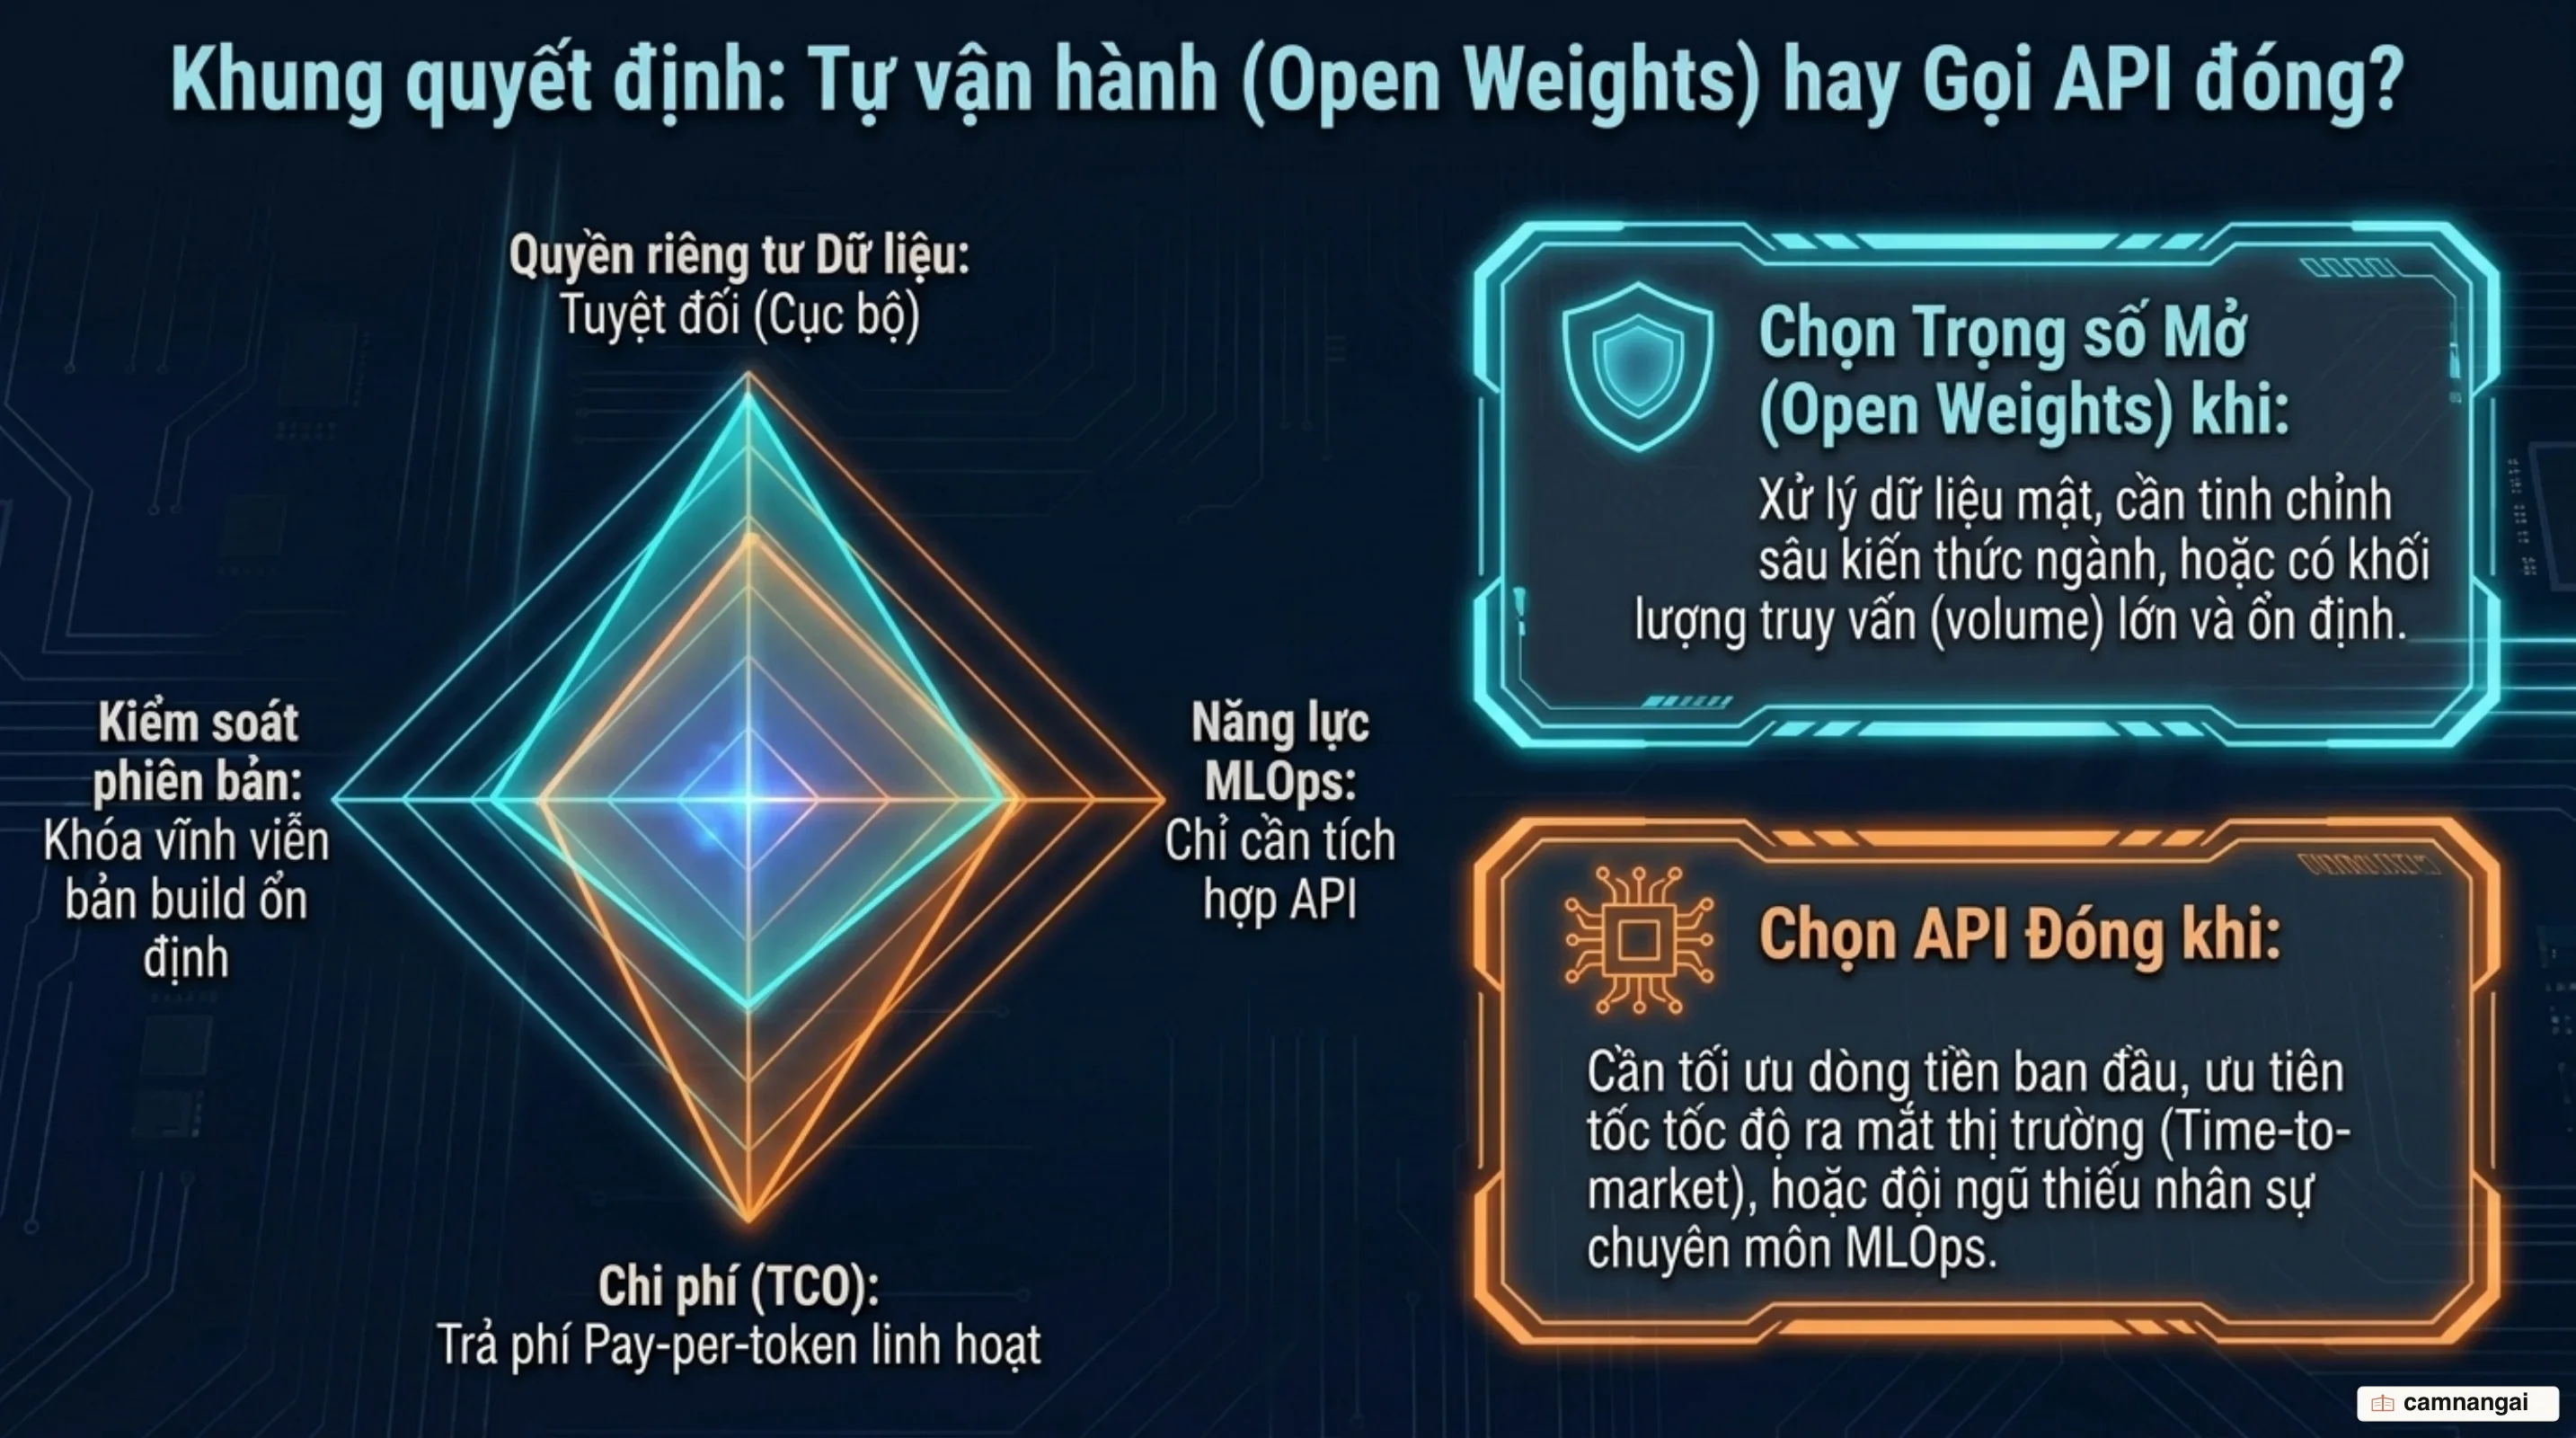
Khi cân nhắc bài toán giữa mô hình nguồn mở và nguồn đóng, lựa chọn trọng số mở là bắt buộc nếu doanh nghiệp đối mặt với các yêu cầu nghiêm ngặt về tuân thủ và bảo mật dữ liệu trong các lĩnh vực như y tế, tài chính, hoặc quản lý mã nguồn cốt lõi. Mô hình trọng số mở cũng phù hợp cho các kịch bản yêu cầu độ trễ suy luận thấp ở môi trường biên (edge devices), hoặc khi hệ thống bắt buộc phải duy trì tính nhất quán tuyệt đối về hành vi mà không chịu sự thay đổi từ bên thứ ba.
Ngược lại, các cổng API nguồn đóng thương mại chiếm ưu thế rõ rệt trong giai đoạn thử nghiệm sản phẩm nhanh (rapid prototyping), dành cho các đội ngũ thiếu hạ tầng MLOps chuyên sâu, hoặc khi lưu lượng truy cập quá thấp khiến chi phí duy trì cụm máy chủ tự nâng cấp trở nên lãng phí. Ngoài ra, API đóng giúp bạn tiếp cận ngay lập tức với các mô hình tiệm cận ranh giới công nghệ mà không phải gánh rủi ro quản lý phần cứng.
Để đưa ra quyết định chính xác, bạn nên thực hiện danh mục kiểm tra kỹ thuật trước khi triển khai:
- Xác minh khả năng tải xuống của các tệp trọng số, tokenizer, cấu hình kiến trúc và mã suy luận.
- Rà soát chính xác các điều khoản giấy phép thương mại và giới hạn người dùng.
- Tính toán dung lượng VRAM thực tế (phân biệt tham số tổng và tham số kích hoạt).
- Kiểm tra các định dạng lượng tử hóa sẵn có (như INT4, MXFP4) và đánh giá độ suy giảm chất lượng.
- Đảm bảo đội ngũ hạ tầng có sẵn công cụ và khung trình chạy (vLLM, SGLang, Ollama) phù hợp.
- Đọc kỹ thẻ mô hình (model card) để nắm bắt thông tin minh bạch về dữ liệu và các kiểm thử an toàn.
Tài liệu tham khảo
- What "Open Weights" Means for AI Models — Flavio Copes
- Open Weights: Not Quite What You've Been Told — Open Source Initiative
- The Open Source AI Definition 1.0 (OSAID) — Open Source Initiative
- Toward an Open Weights Definition — Copyleft Currents
- Safetensors: Fast and Safe Tensor Storage — Hugging Face
- Repository Licenses and Model Cards — Hugging Face
- On the Societal Impact of Open Foundation Models — Kapoor, Narayanan et al. (arXiv:2403.07918)
- Open Letters About AI Development — Simon Willison