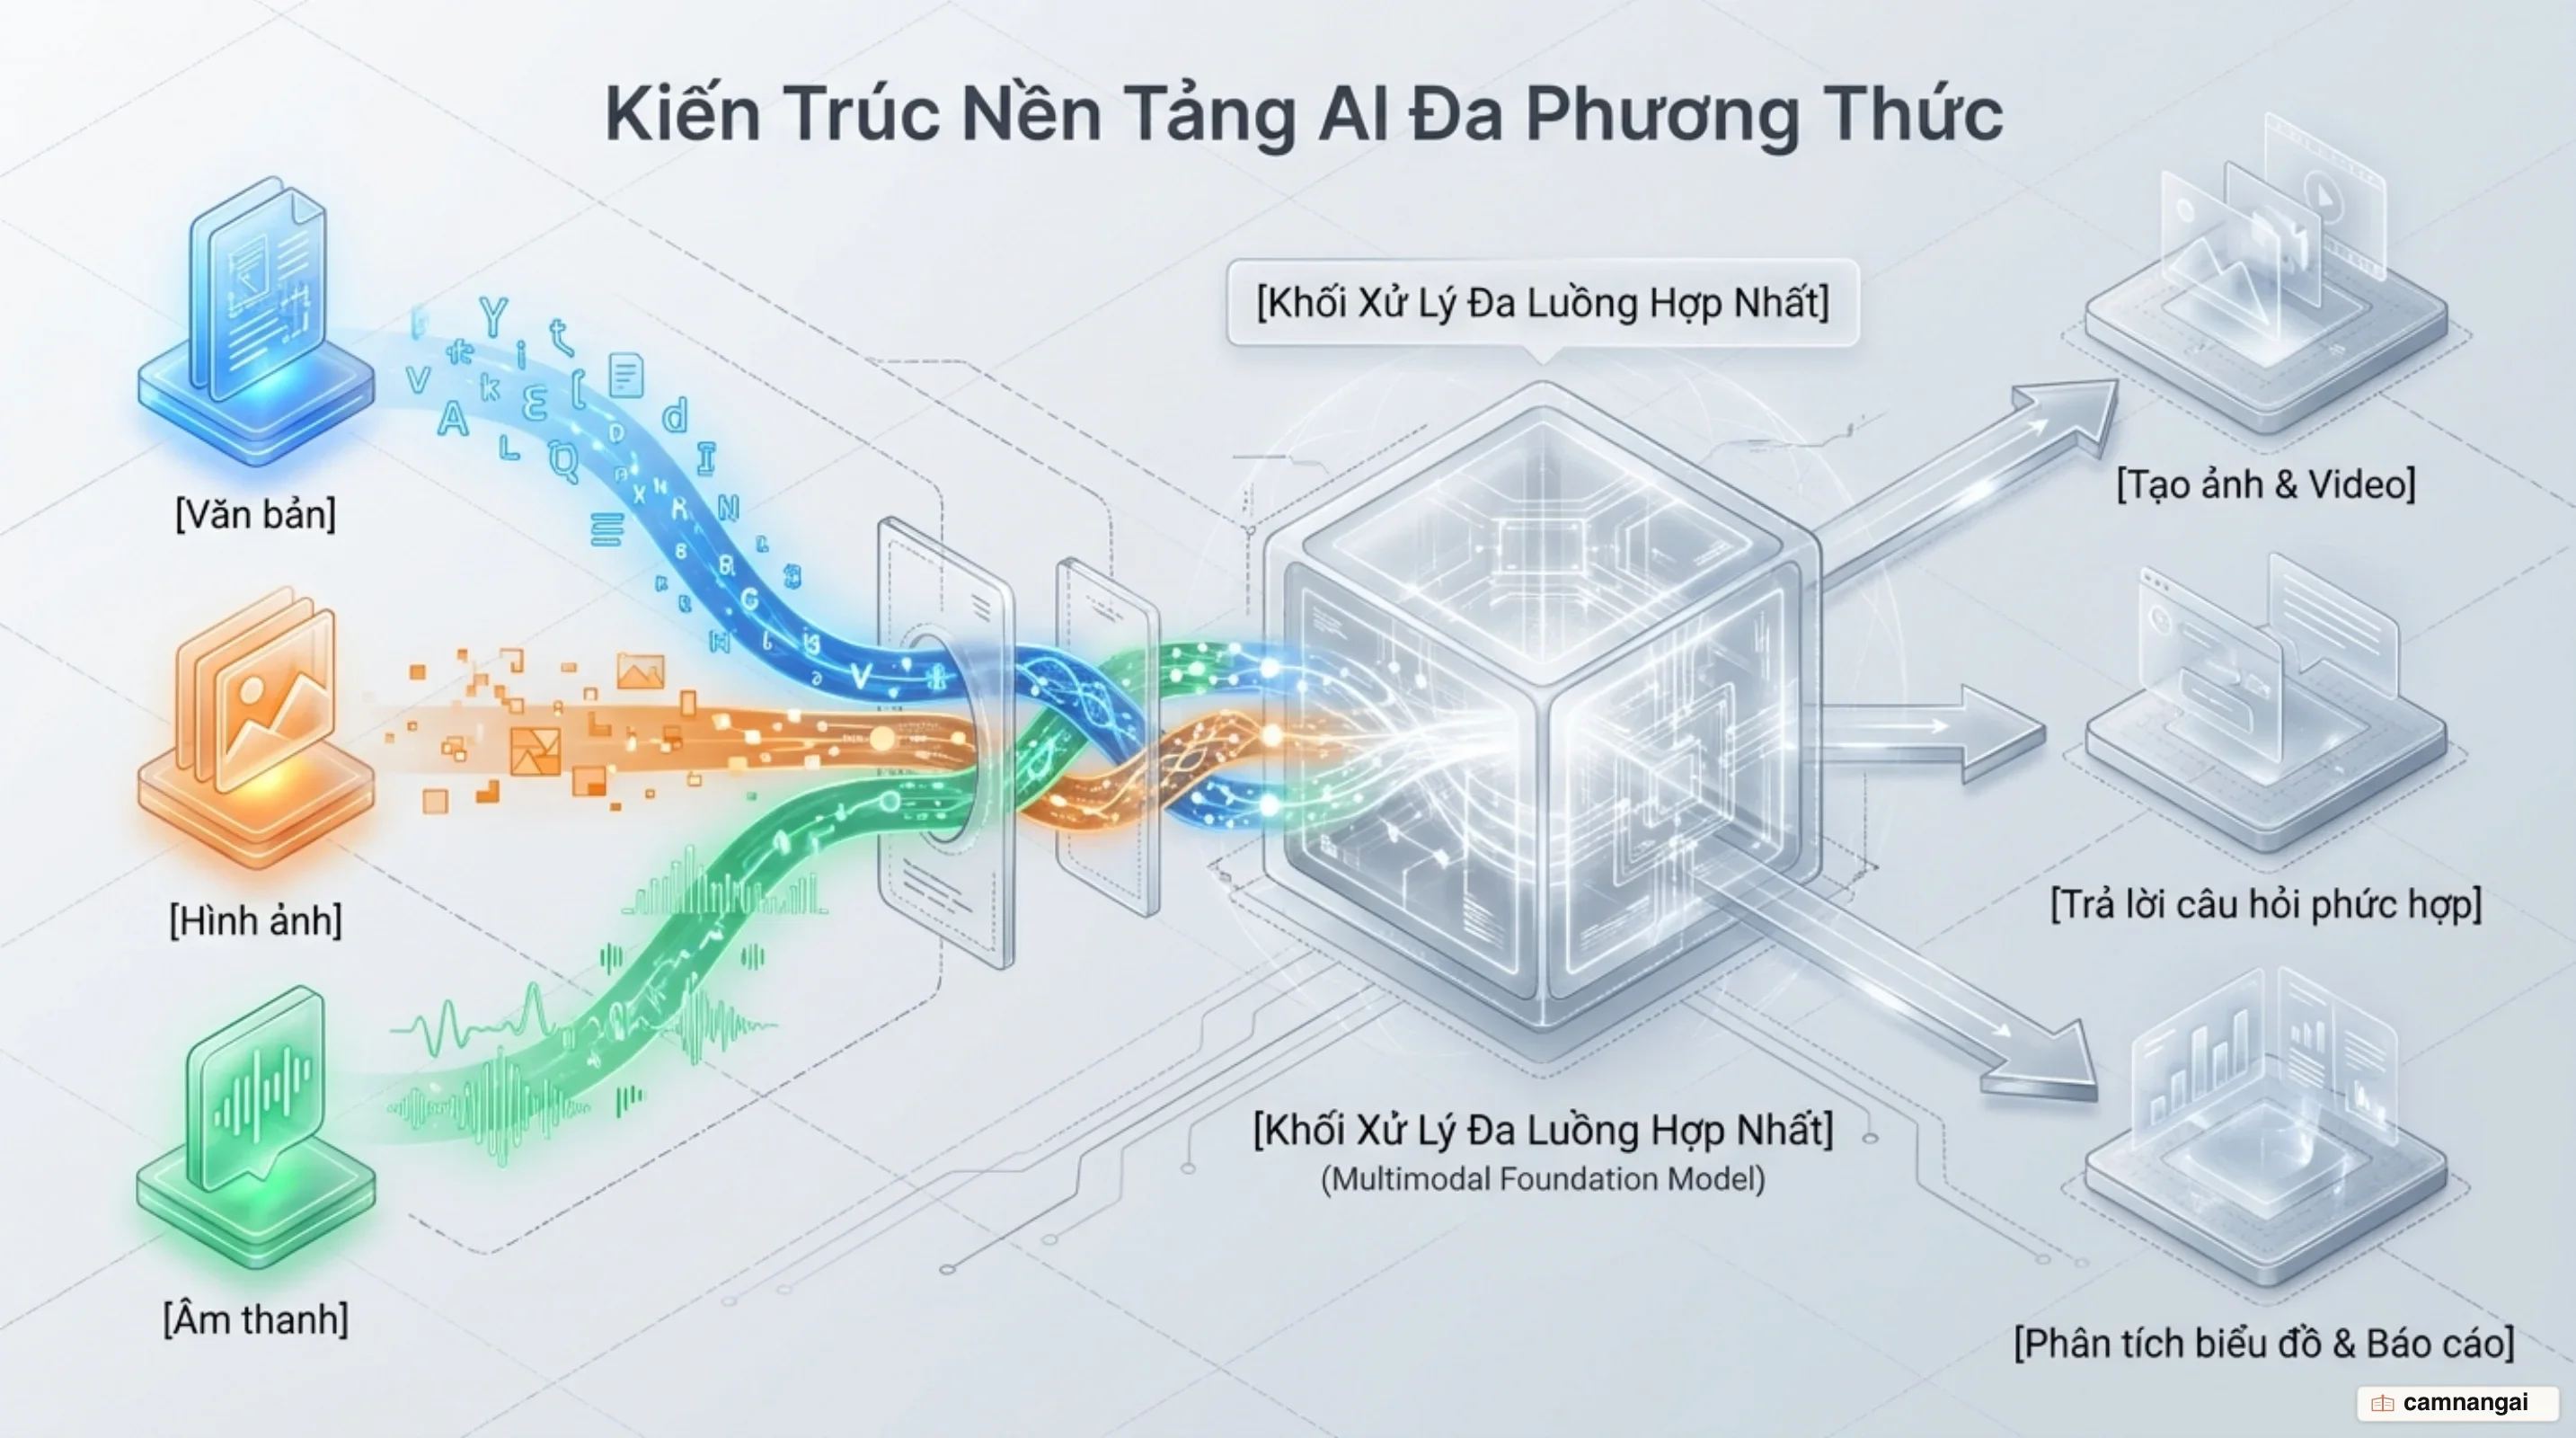
Trí tuệ nhân tạo đa phương thức (Multimodal AI) là hệ thống có khả năng tiếp nhận, xử lý và suy luận đồng thời trên nhiều dạng dữ liệu khác nhau—bao gồm văn bản, hình ảnh, âm thanh và video—bên trong một kiến trúc mô hình hợp nhất.
Thay vì giới hạn trong các (LLM) thuần văn bản, kiến trúc mở rộng không gian đầu vào sang tín hiệu thị giác và thính giác, cho phép thiết lập điều kiện phản hồi dựa trên ngữ cảnh tự nhiên của thế giới thực.
Trong hệ thống phần mềm hiện đại, xử lý đa phương thức cho phép mô hình thu nạp trực tiếp dữ liệu điểm ảnh (raw pixels), dải phổ âm thanh (mel-spectrograms) hoặc chuỗi khung hình video. Cách tiếp cận này loại bỏ hoàn toàn các bước trích xuất trung gian qua văn bản thô, bảo toàn bố cục không gian, quan hệ hình học và các tín hiệu ngữ cảnh tinh tế.
Nắm vững cơ chế mã hóa thị giác, căn chỉnh không gian nhúng và bài toán hình ảnh là yếu tố quyết định giữa một bản demo chắp vá và một hệ thống đa phương thức tối ưu chi phí trong sản xuất.
Multimodal AI là gì? Khác biệt cốt lõi với Unimodal AI
Mô hình đơn phương thức (Unimodal AI) truyền thống chỉ vận hành trên một dạng dữ liệu cô lập: mô hình ngôn ngữ lớn chỉ xử lý văn bản, mô hình mạng tích chập (CNN) chỉ phát hiện vật thể trên ảnh, hoặc bộ nhận dạng giọng nói tự động (ASR) chỉ chuyển âm thanh thành chữ. Ngược lại, Multimodal AI (thường hiện diện dưới dạng Large Multimodal Models - LMMs) tiếp nhận và xử lý đồng thời nhiều luồng tín hiệu số hóa trong một khung làm việc thống nhất.
Về bản chất kỹ thuật, mọi chế độ dữ liệu số đều có thể biểu diễn hoặc xấp xỉ dưới dạng vectơ liên tục hoặc chuỗi byte:
- Âm thanh: Biến đổi thành dải phổ mel-spectrogram hoặc chuỗi token âm thanh rời rạc.
- Hình ảnh: Chia nhỏ thành các mảng điểm ảnh (patches) và chiếu vào không gian vectơ.
- Video: Biểu diễn dưới dạng chuỗi thời gian của các khung hình ảnh kết hợp dải âm thanh đồng bộ.
Trong số các phương thức dữ liệu, hình ảnh là kênh thông tin phong phú bậc nhất vì nó có thể chứa đồng thời văn bản, biểu đồ, sơ đồ quan hệ và cấu trúc phân cấp thị giác.
Nhiệm vụ của AI đa phương thức được phân tách thành hai nhánh chính:
- Thế hệ sinh (Generation): Tổng hợp hình ảnh từ văn bản (text-to-image), hỏi đáp thị giác (Visual Question Answering - VQA), và tự động tạo chú thích (Image Captioning).
- Hiểu ngôn ngữ - thị giác (Vision-Language Understanding - VLU): Các tác vụ không yêu cầu sinh chuỗi mới, bao gồm phân loại zero-shot, truy xuất hình ảnh bằng văn bản (Text-Based Image Retrieval - TBIR), và truy xuất văn bản từ hình ảnh (Image-to-Text Retrieval).
Sự dịch chuyển từ Unimodal sang Multimodal giúp kỹ sư xây dựng các giao diện người dùng tự nhiên—nơi người dùng có thể kết hợp giọng nói, chụp ảnh màn hình hoặc truyền video trực tiếp trong cùng một phiên tương tác.
Từ pipeline chắp vá đến AI đa phương thức gốc (Native Multimodal)
Trước khi các mô hình đa phương thức hiện đại xuất hiện, hệ thống xử lý đa dữ liệu buộc phải sử dụng kiến trúc pipeline chắp vá (chained pipelines). Ở mô hình cũ này, một công cụ nhận dạng ký tự quang học (OCR) hoặc bộ phát hiện vật thể độc lập quét hình ảnh, trích xuất chuỗi văn bản thô, rồi nối chuỗi đó vào prompt của một LLM thông thường.
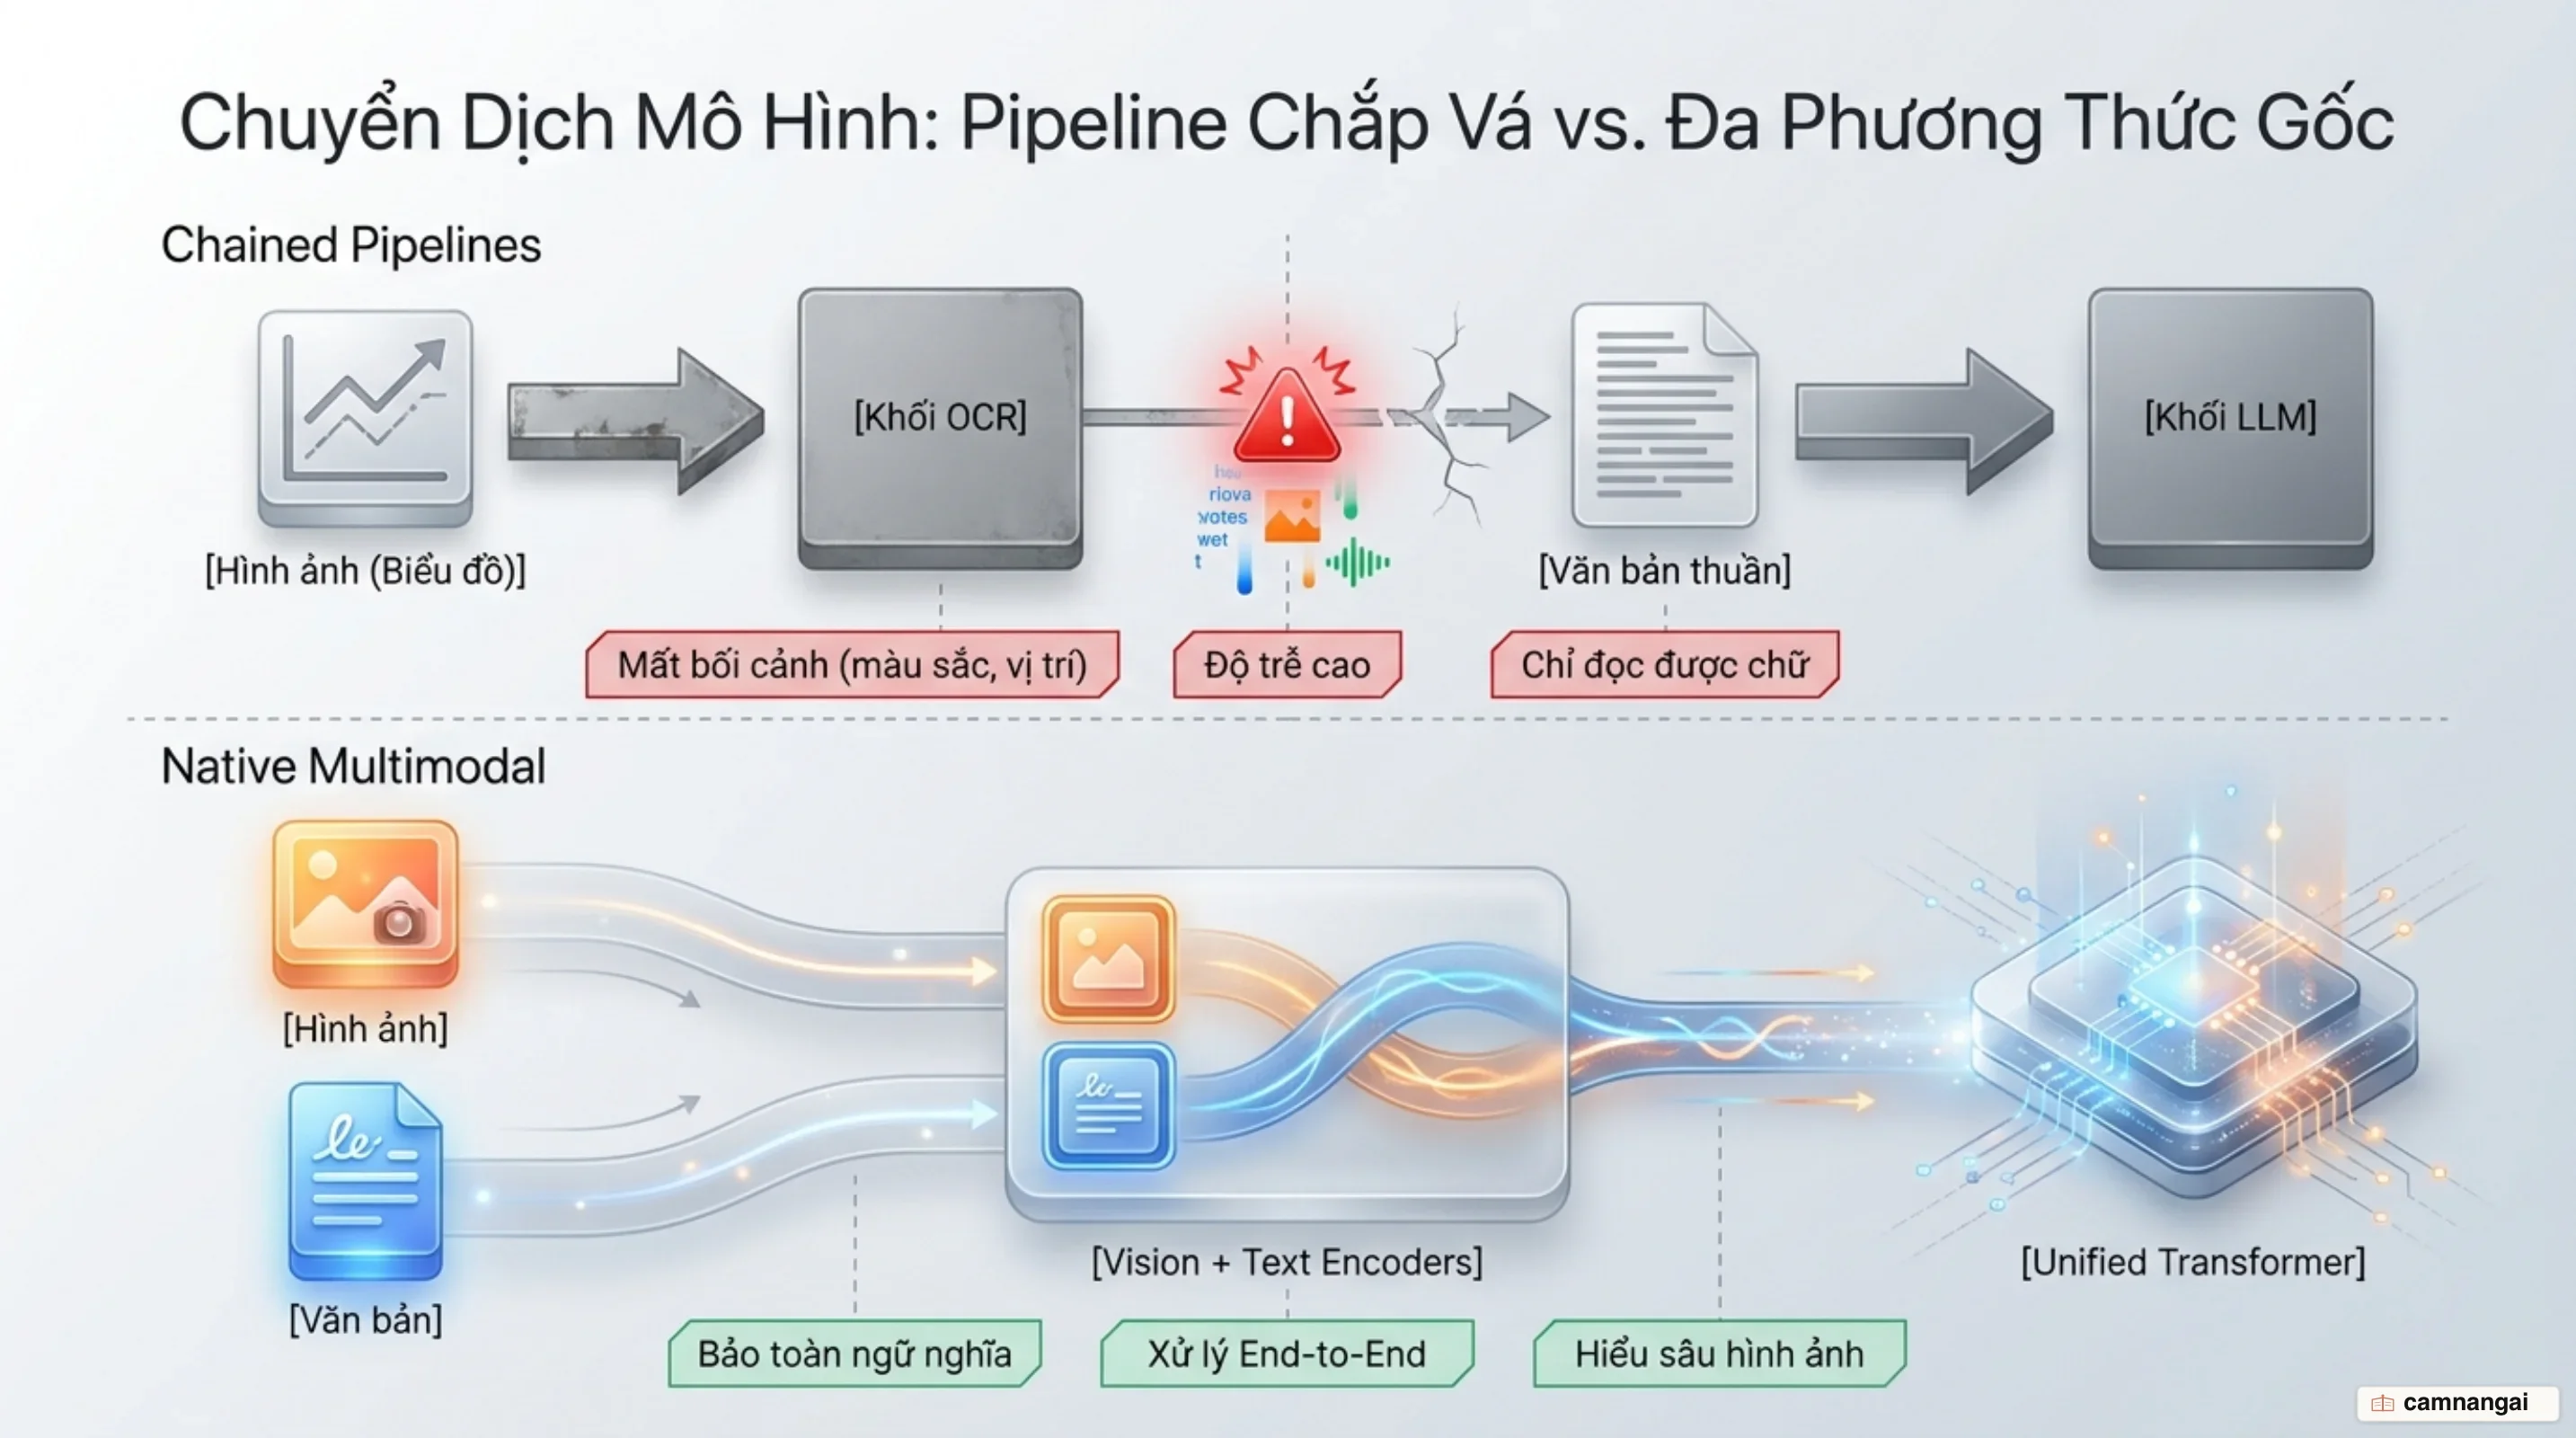
Kiến trúc pipeline chắp vá tồn tại ba điểm nghẽn kỹ thuật nghiêm trọng:
- Hiện tượng tích tụ lỗi (Error Propagation): Nếu module OCR đọc sai chữ số trong bảng biểu tài chính, LLM phía sau sẽ suy luận trên tiền đề sai mà không có cơ chế tự kiểm chứng lại hình ảnh gốc.
- Độ trễ hệ thống (Latency Explosion): Việc truyền dữ liệu qua nhiều mô hình rời rạc làm tăng thời gian phản hồi của toàn bộ hệ thống.
- Mất mát ngữ cảnh thị giác (Loss of Spatial Context): Văn bản thuần túy không thể biểu đạt chính xác mối quan hệ vị trí giữa các khối giao diện, màu sắc cảnh báo, hay độ đậm nhạt của đường nét trên biểu đồ kỹ thuật.
| Tiêu chí kỹ thuật | Pipeline chắp vá (Chained Pipelines) | Đa phương thức gốc (Native Multimodal) |
|---|---|---|
| Cơ chế xử lý | Mô hình OCR/Vision riêng rẽ $\to$ LLM trung gian | Luồng xử lý Transformer nội tại thống nhất |
| Bảo toàn ngữ cảnh | Thấp (mất cấu trúc không gian và bố cục bảng) | Cao (bảo tồn nguyên vẹn vị trí và điểm ảnh) |
| Độ trễ đầu cuối | Cao (chuyển tiếp tuần tự qua nhiều dịch vụ) | Tối ưu (suy luận trực tiếp trên token thị giác) |
| Năng lực Zero-shot | Giới hạn theo năng lực của từng công cụ đơn lẻ | Vượt trội trên nhiều tác vụ thị giác - ngôn ngữ mới |
Các bước tiến đột phá như CLIP (2021) và Flamingo (2022) đã mở đường cho thế hệ Native Multimodal ra đời. Thay vì dựa vào bản dịch văn bản trung gian, các mô hình đa phương thức bản địa tiếp nhận trực tiếp chuỗi token thị giác và token ngôn ngữ bên trong các lớp Attention hợp nhất, cho phép mô hình suy luận trực tiếp trên thuộc tính hình ảnh với độ chính xác cao.
Kiến trúc nền tảng: Mô hình VLM chuyển đổi hình ảnh thành token như thế nào?
Để đưa một bức ảnh 2 chiều vào mô hình ngôn ngữ vốn chỉ đọc chuỗi 1 chiều, hệ thống Vision-Language Model (VLM) sử dụng một bộ mã hóa thị giác—phổ biến nhất là Vision (ViT, ví dụ ViT-L/14@336px) hoặc mạng tích chập ResNet (như NFNet-F6).
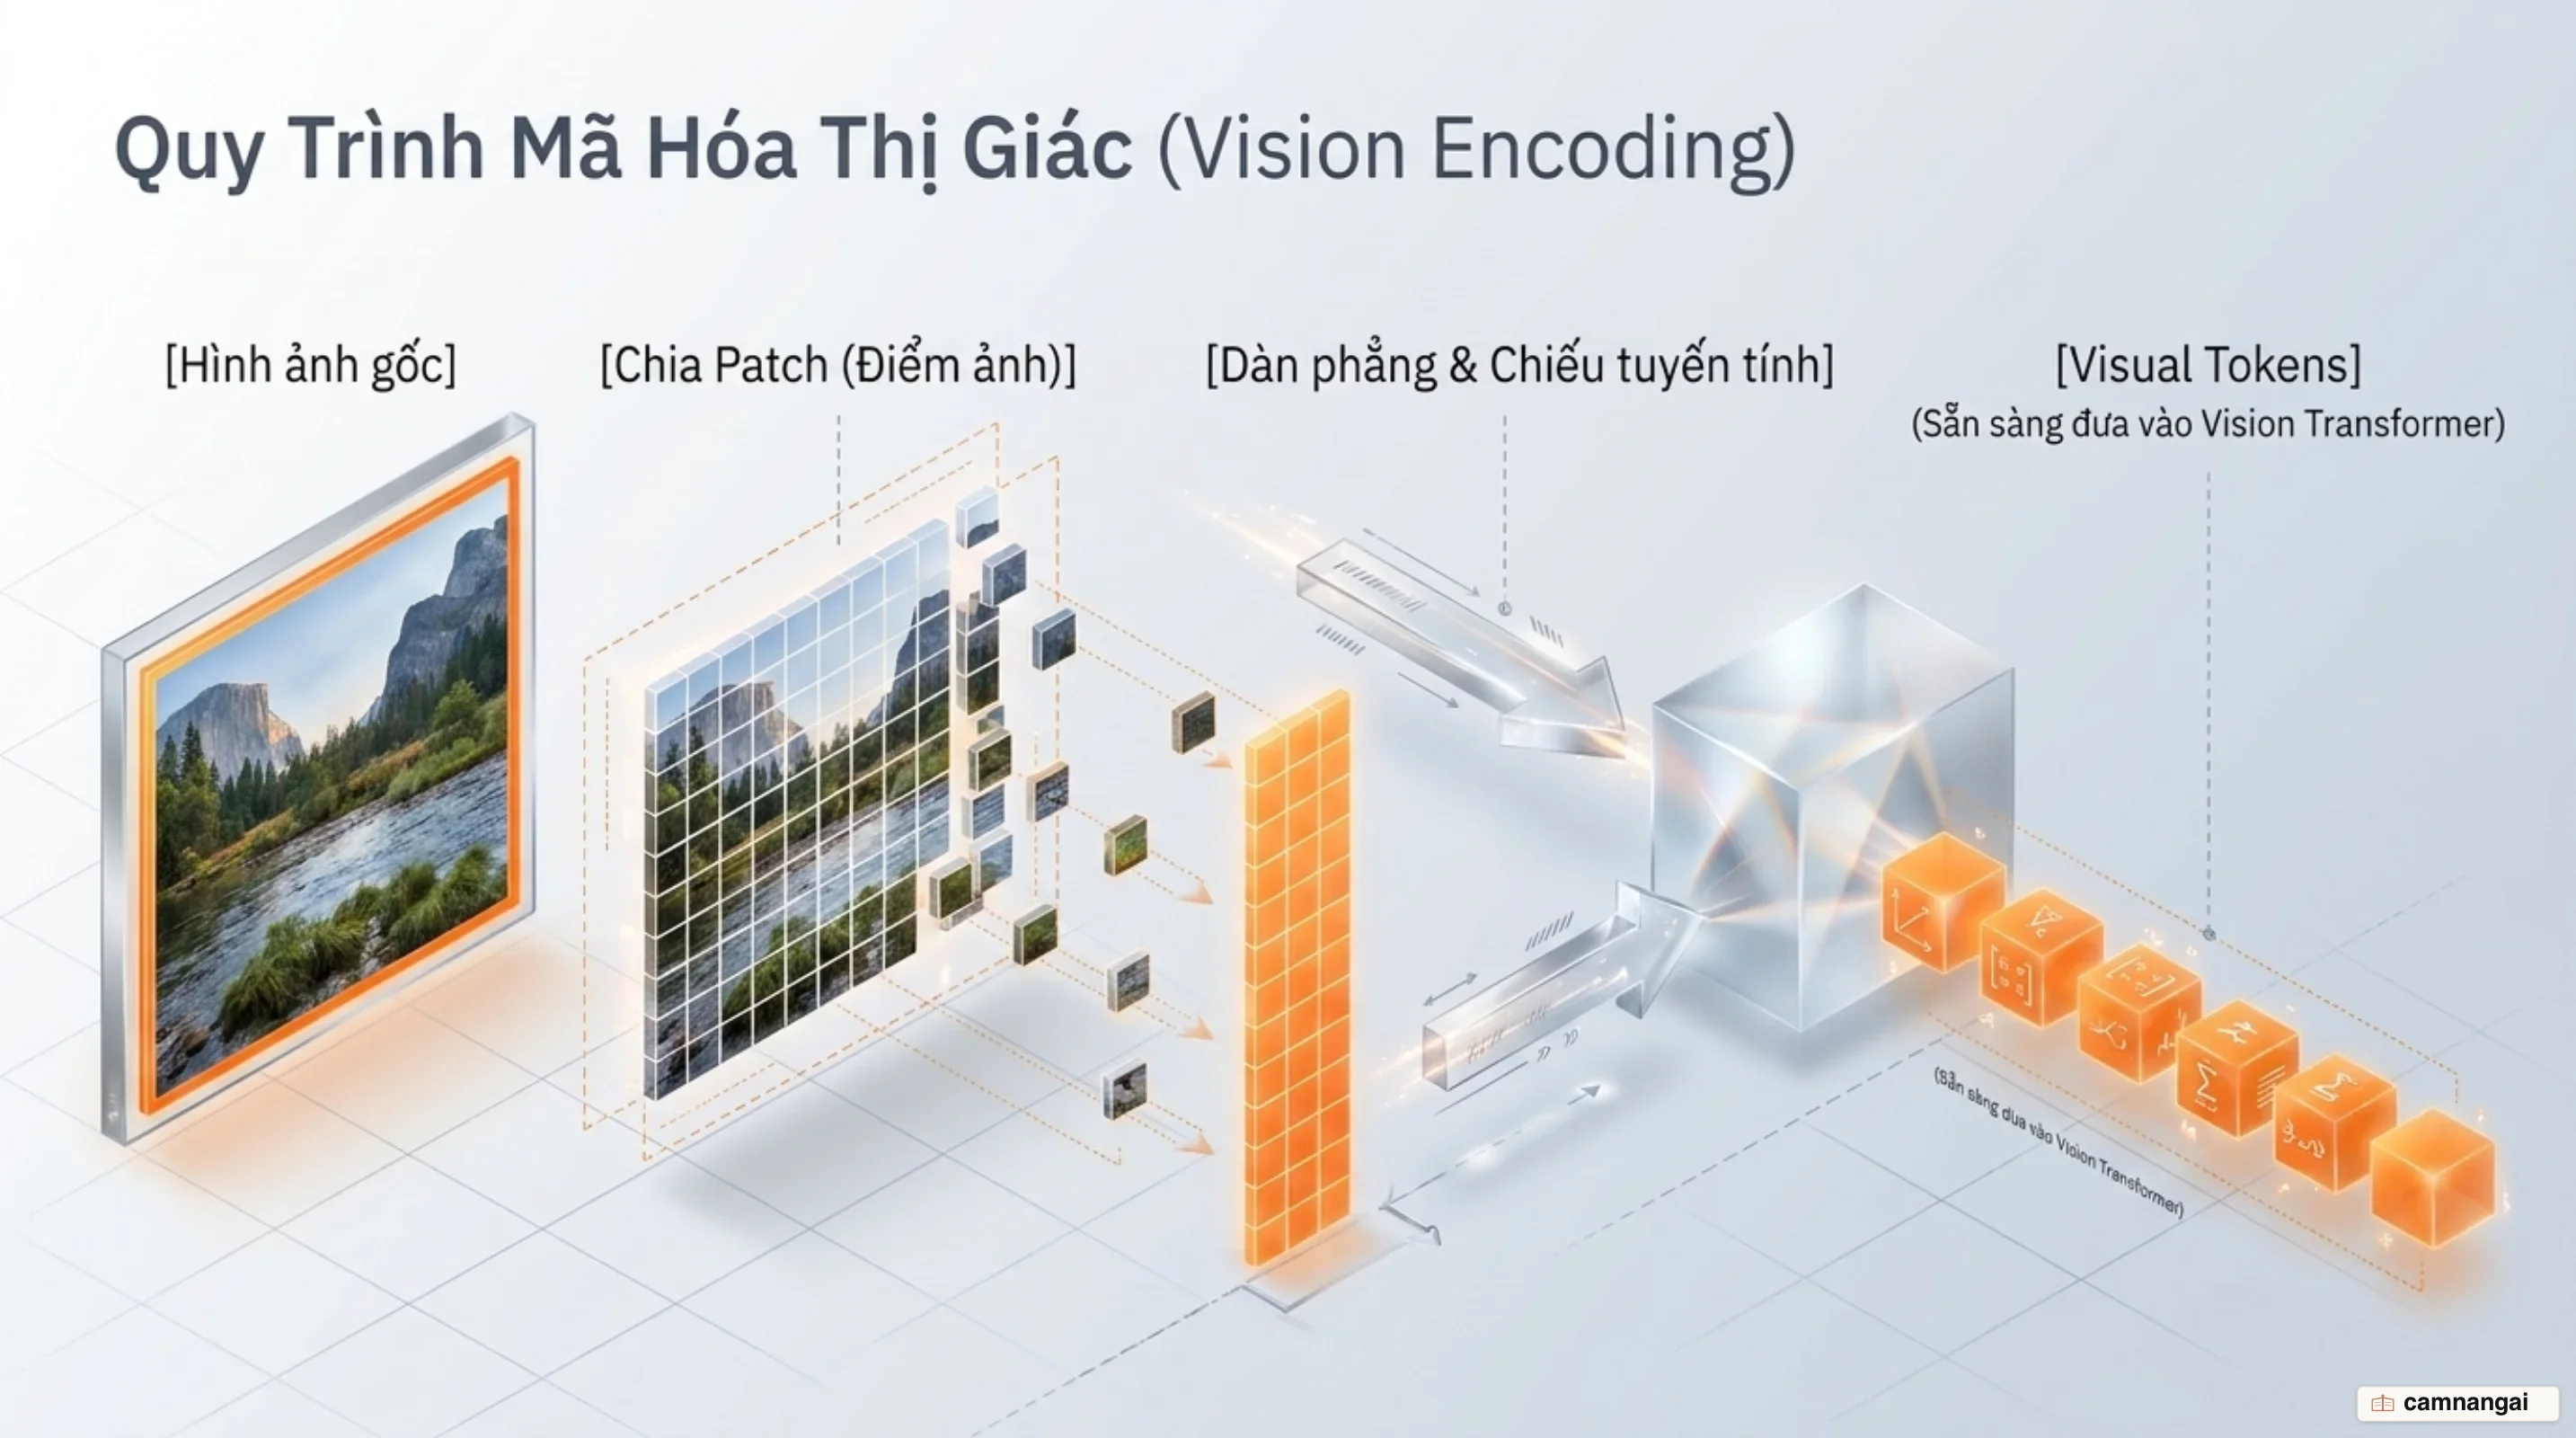
Quy trình biến đổi một bức ảnh thành chuỗi token diễn ra qua 4 bước cụ thể:
- Khởi tạo Tensor đầu vào: Bức ảnh được nạp dưới dạng tensor 3 chiều
C x H x W, trong đóClà số kênh màu (3 kênh RGB),Hlà chiều cao vàWlà chiều rộng ảnh. - Phân đoạn mảng điểm ảnh (Patch Extraction): Ảnh được chia thành
Nmảng không chồng lấn có kích thước cố địnhP x Ppixel (thường là14 x 14hoặc32 x 32), vớiN = floor(H / P) * floor(W / P). - Trải phẳng mảng (Patch Flattening): Mỗi mảng 3 chiều kích thước
C x P x Pđược duỗi thẳng thành một vectơ 1 chiều có độ dàiP^2 * C. Toàn bộ bức ảnh trở thành ma trận kích thướcN x (P^2 * C). - Chiếu tuyến tính (Linear Projection): Một ma trận chiếu tuyến tính
Wkích thước(P^2 * C) x Dchiếu từng vectơ mảng vào không gian ẩnDcủa mô hình ngôn ngữ. Sau khi cộng thêm vectơ nhúng vị trí (positional embeddings), hệ thống thu được chuỗiNtoken thị giác sẵn sàng đưa vào Transformer.
patch_count = ceil(image_width / patch_size) * ceil(image_height / patch_size)Một thách thức lớn trong thực tế là việc nén ép hình ảnh độ phân giải cao về kích thước vuông cố định (như 336px x 336px) sẽ làm nhòe văn bản nhỏ và biểu đồ chi tiết. Để khắc phục, kỹ thuật Dynamic High Resolution (AnyRes) trong LLaVA-NeXT phân chia ảnh gốc thành lưới các mảng linh hoạt theo tỷ lệ khung hình tự nhiên—chẳng hạn các cấu hình 2x2, 1x2, 2x1, 1x3, 3x1—kèm theo một ảnh thu nhỏ toàn cảnh. Kỹ thuật này giữ nguyên độ sắc nét của văn bản mà không làm bùng nổ chi phí tính toán bậc hai.
Tuy nhiên, việc gia tăng số lượng token thị giác ảnh hưởng trực tiếp đến bộ nhớ Key-Value (KV) cache. Một bức ảnh độ phân giải cao có thể sinh ra hơn 2.000 token thị giác, chiếm dung lượng bộ nhớ tương đương 1.500 từ văn bản. Do đó, các kiến trúc như Flamingo sử dụng Perceiver Resampler để nén toàn bộ bản đồ đặc trưng thị giác biến thiên về đúng 64 token thị giác cố định trước khi đưa vào các lớp ngôn ngữ.
Cơ chế căn chỉnh đa phương thức: Không gian nhúng chung và Projection Layer
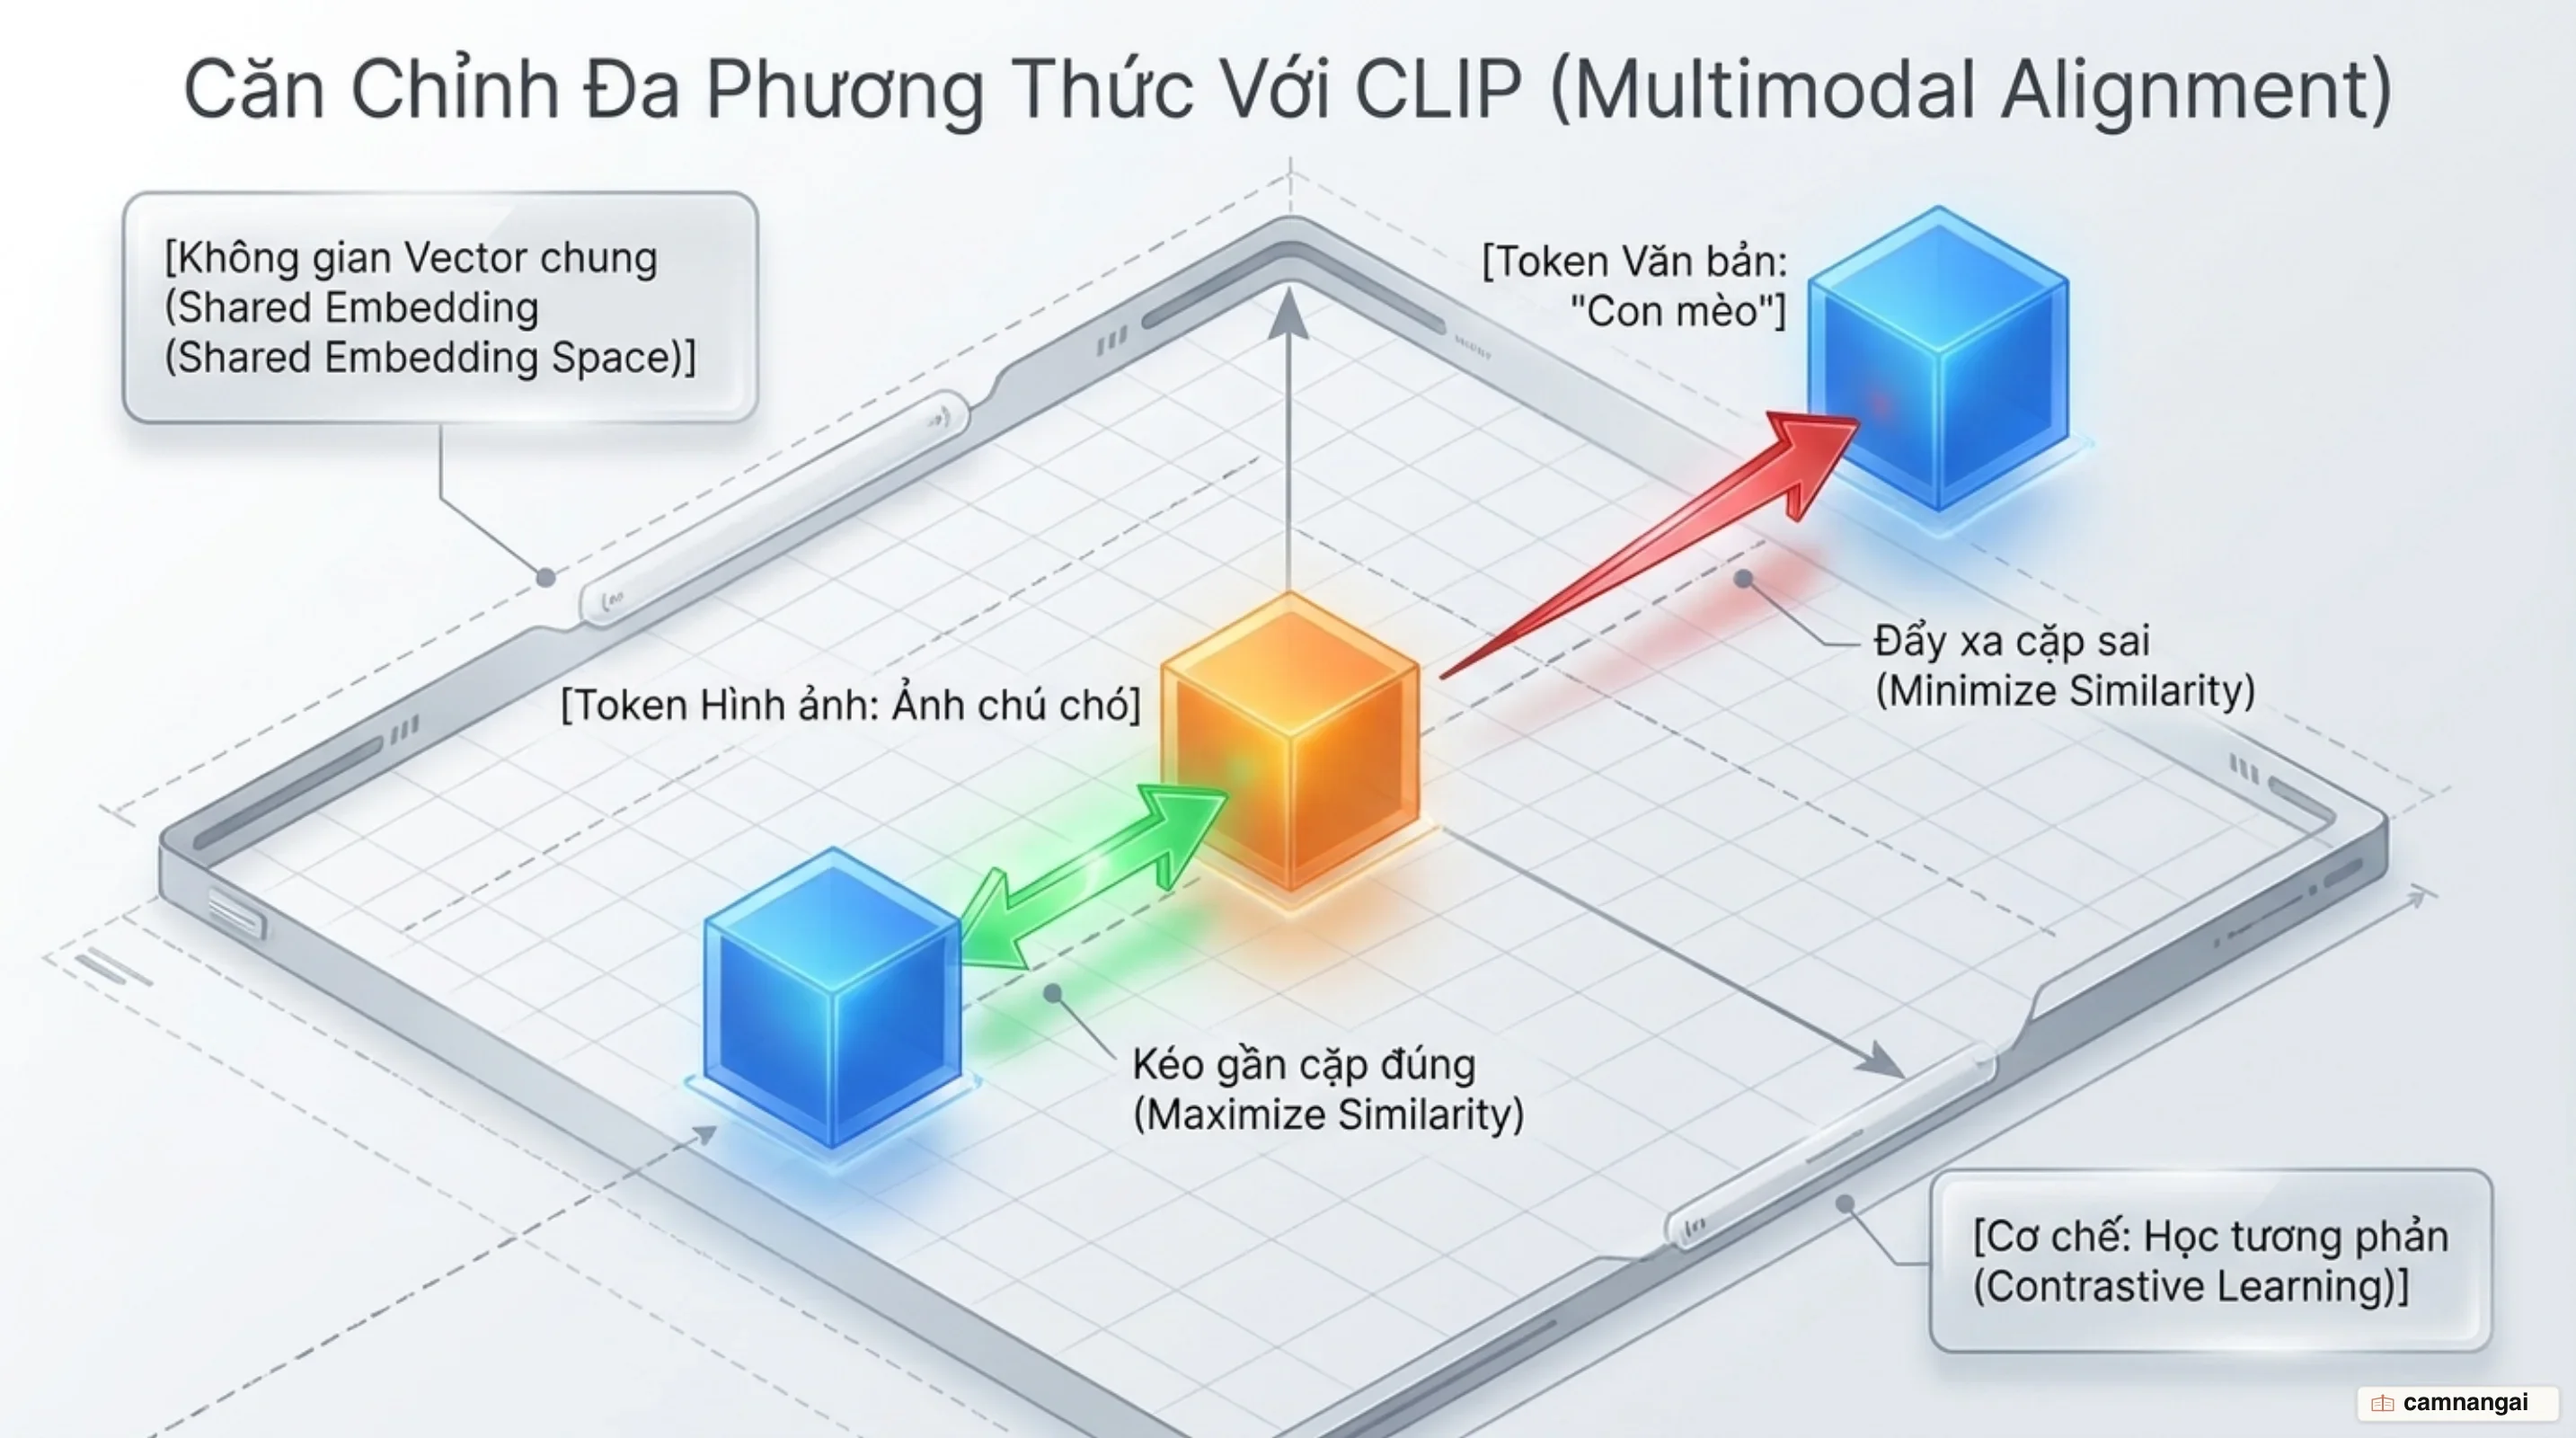
Điểm mấu chốt của Multimodal AI là làm sao để biểu diễn của từ ngữ ("con mèo") và hình ảnh (bức ảnh chụp con mèo) nằm gần nhau trong không gian vector. Quá trình này được gọi là căn chỉnh đa phương thức (Cross-Modal Alignment).
Học tương phản (Contrastive Learning) với CLIP
Mô hình CLIP của OpenAI tiên phong trong việc thiết lập không gian nhúng chung bằng cách huấn luyện đồng thời một Text Encoder và một Image Encoder trên 400 triệu cặp dữ liệu (ảnh, văn bản). Hai ma trận chiếu W_v và W_l đưa đặc trưng ảnh V_i và đặc trưng chữ L_i về cùng một không gian vector.
Trong một batch gồm N cặp dữ liệu (N = 32,768), mô hình tối đa hóa độ tương đồng cosine của N cặp đúng và đẩy lùi N^2 - N cặp sai thông qua hai hàm mất mát đối xứng:
L_txt2im = -(1/N) * sum_i log( exp(L_i^T * V_i / beta) / sum_j exp(L_i^T * V_j / beta) )
L_im2txt = -(1/N) * sum_i log( exp(V_i^T * L_i / beta) / sum_j exp(V_i^T * L_j / beta) )
Các giải pháp kết nối (Connectors & Projection Layers)
Để nối một Vision Encoder đã huấn luyện sẵn với một LLM giải mã, các kiến trúc sử dụng các tầng kết nối khác nhau:
- Linear Projection & Multi-Layer Perceptron (MLP): Mô hình LLaVA sử dụng một lớp chiếu tuyến tính đơn giản hoặc mạng MLP 2 tầng để đổi chiều vector từ Vision Tower sang không gian token của LLM. Giải pháp này gọn nhẹ về mặt tham số nhưng yêu cầu cả backbone ngôn ngữ để đạt hiệu quả suy luận cao.
- Gated Cross-Attention (Flamingo): Giữ đông cứng (freeze) toàn bộ mô hình ngôn ngữ và bộ mã hóa ảnh, chỉ huấn luyện các lớp chú ý chéo
GATED XATTN-DENSEđược chèn xen kẽ vào các block của LLM. Cách làm này bảo toàn hoàn toàn tri thức ngôn ngữ sẵn có của mô hình gốc. - Q-Former & Adapters: Sử dụng một mạng Transformer trung gian với tập truy vấn học được (learned queries) để trích xuất có chọn lọc các thông tin thị giác phù hợp nhất với ngữ cảnh câu hỏi.
Bài toán chi phí và hiệu năng: Cách tính token hình ảnh và kỹ thuật Image Tiling
Khi gửi dữ liệu hình ảnh qua API, nhà cung cấp dịch vụ quy đổi hình ảnh thành token tính phí (input tokens). Nắm rõ công thức tính toán giúp kỹ sư dự toán chính xác ngân sách hạ tầng.
Cơ chế tính token theo Patch (Patch-based Tokenization)
Các dòng mô hình thế hệ mới áp dụng chia ô theo kích thước 32px x 32px. Số lượng patch ban đầu được tính:
patch_count = ceil(width / 32) * ceil(height / 32)Nếu số patch vượt quá ngưỡng ngân sách của chế độ chi tiết (ví dụ budget 2.500 patch cho chế độ high), ảnh được co tỷ lệ thông qua hệ số shrink_factor:
shrink_factor = sqrt((32^2 * patch_budget) / (width * height))Sau khi điều chỉnh theo tỷ lệ làm tròn nguyên pixel (adjusted_shrink_factor), số patch thực tế được nhân với hệ số định giá của từng mô hình (multiplier, thường là 1.2x):
billable_tokens = ceil(resized_patch_count * model_multiplier)| Kích thước ảnh gốc | Chế độ chi tiết | Số patch xử lý | Token tính phí ước tính |
|---|---|---|---|
| 512 x 512 px | low | 256 patches | 85 – 307 tokens |
| 1024 x 1024 px | high | 1.024 patches | ~1.229 tokens |
| 2048 x 2048 px | high | 2.500 patches (đã co tỷ lệ) | ~3.000 tokens |
Ngưỡng từ chối cứng (Hard Limit): Nếu kích thước hình ảnh vượt quá 30.000 patch sau xử lý, API sẽ trả về lỗi HTTP 400 thay vì tiếp tục nén ảnh. Trong kiến trúc sản xuất, kỹ sư nên đặt một middleware xử lý ảnh (bằng Pillow hoặc Sharp) ở phía backend để kiểm tra và thu nhỏ kích thước ảnh trước khi dispatch sang API.
Cơ chế tính token theo Tile (Tile-based Legacy)
Đối với các API truyền thống, chi phí hình ảnh tính theo công thức base token cộng thêm phí cố định cho mỗi tile 512px x 512px (ví dụ: 85 base + 170 tokens/tile). Ảnh được thu nhỏ để cạnh dài không vượt quá 2048px và cạnh ngắn tối đa 768px, sau đó đếm số ô 512px cần thiết để phủ kín diện tích.
Tích hợp đa phương thức trong thực tế: Thiết kế prompt, API và Multimodal RAG
Khi triển khai ứng dụng đa phương thức, dữ liệu hình ảnh có thể truyền vào qua ba hình thức: URL công khai, chuỗi mã hóa Base64 Data URL, hoặc tải trước qua Files API chuyên dụng.
Cấu trúc API Payload chuẩn
Dưới đây là ví dụ về cấu trúc payload JSON gửi ảnh kết hợp câu lệnh chỉ thị:
{
  "model": "gpt-6-astra",
  "messages": [
    {
      "role": "user",
      "content": [
        { "type": "text", "text": "Phân tích sơ đồ kiến trúc hệ thống trong hình vẽ này:" },
        {
          "type": "image_url",
          "image_url": {
            "url": "data:image/jpeg;base64,...",
            "detail": "high"
          }
        }
      ]
    }
  ]
}
Trong thực tế thiết kế prompt, thứ tự đặt nội dung có ảnh hưởng trực tiếp đến chất lượng câu trả lời: hãy đặt khối hình ảnh trước khối văn bản chỉ thị. Điều này giúp mô hình hoàn tất việc nạp ngữ cảnh thị giác vào bộ nhớ trước khi xử lý câu hỏi truy vấn.
Kiến trúc Multimodal RAG (Retrieval-Augmented Generation)
Khi xây dựng hệ thống hỏi đáp trên kho tài liệu gồm cả sơ đồ và văn bản, bạn có hai mô hình kiến trúc chính:
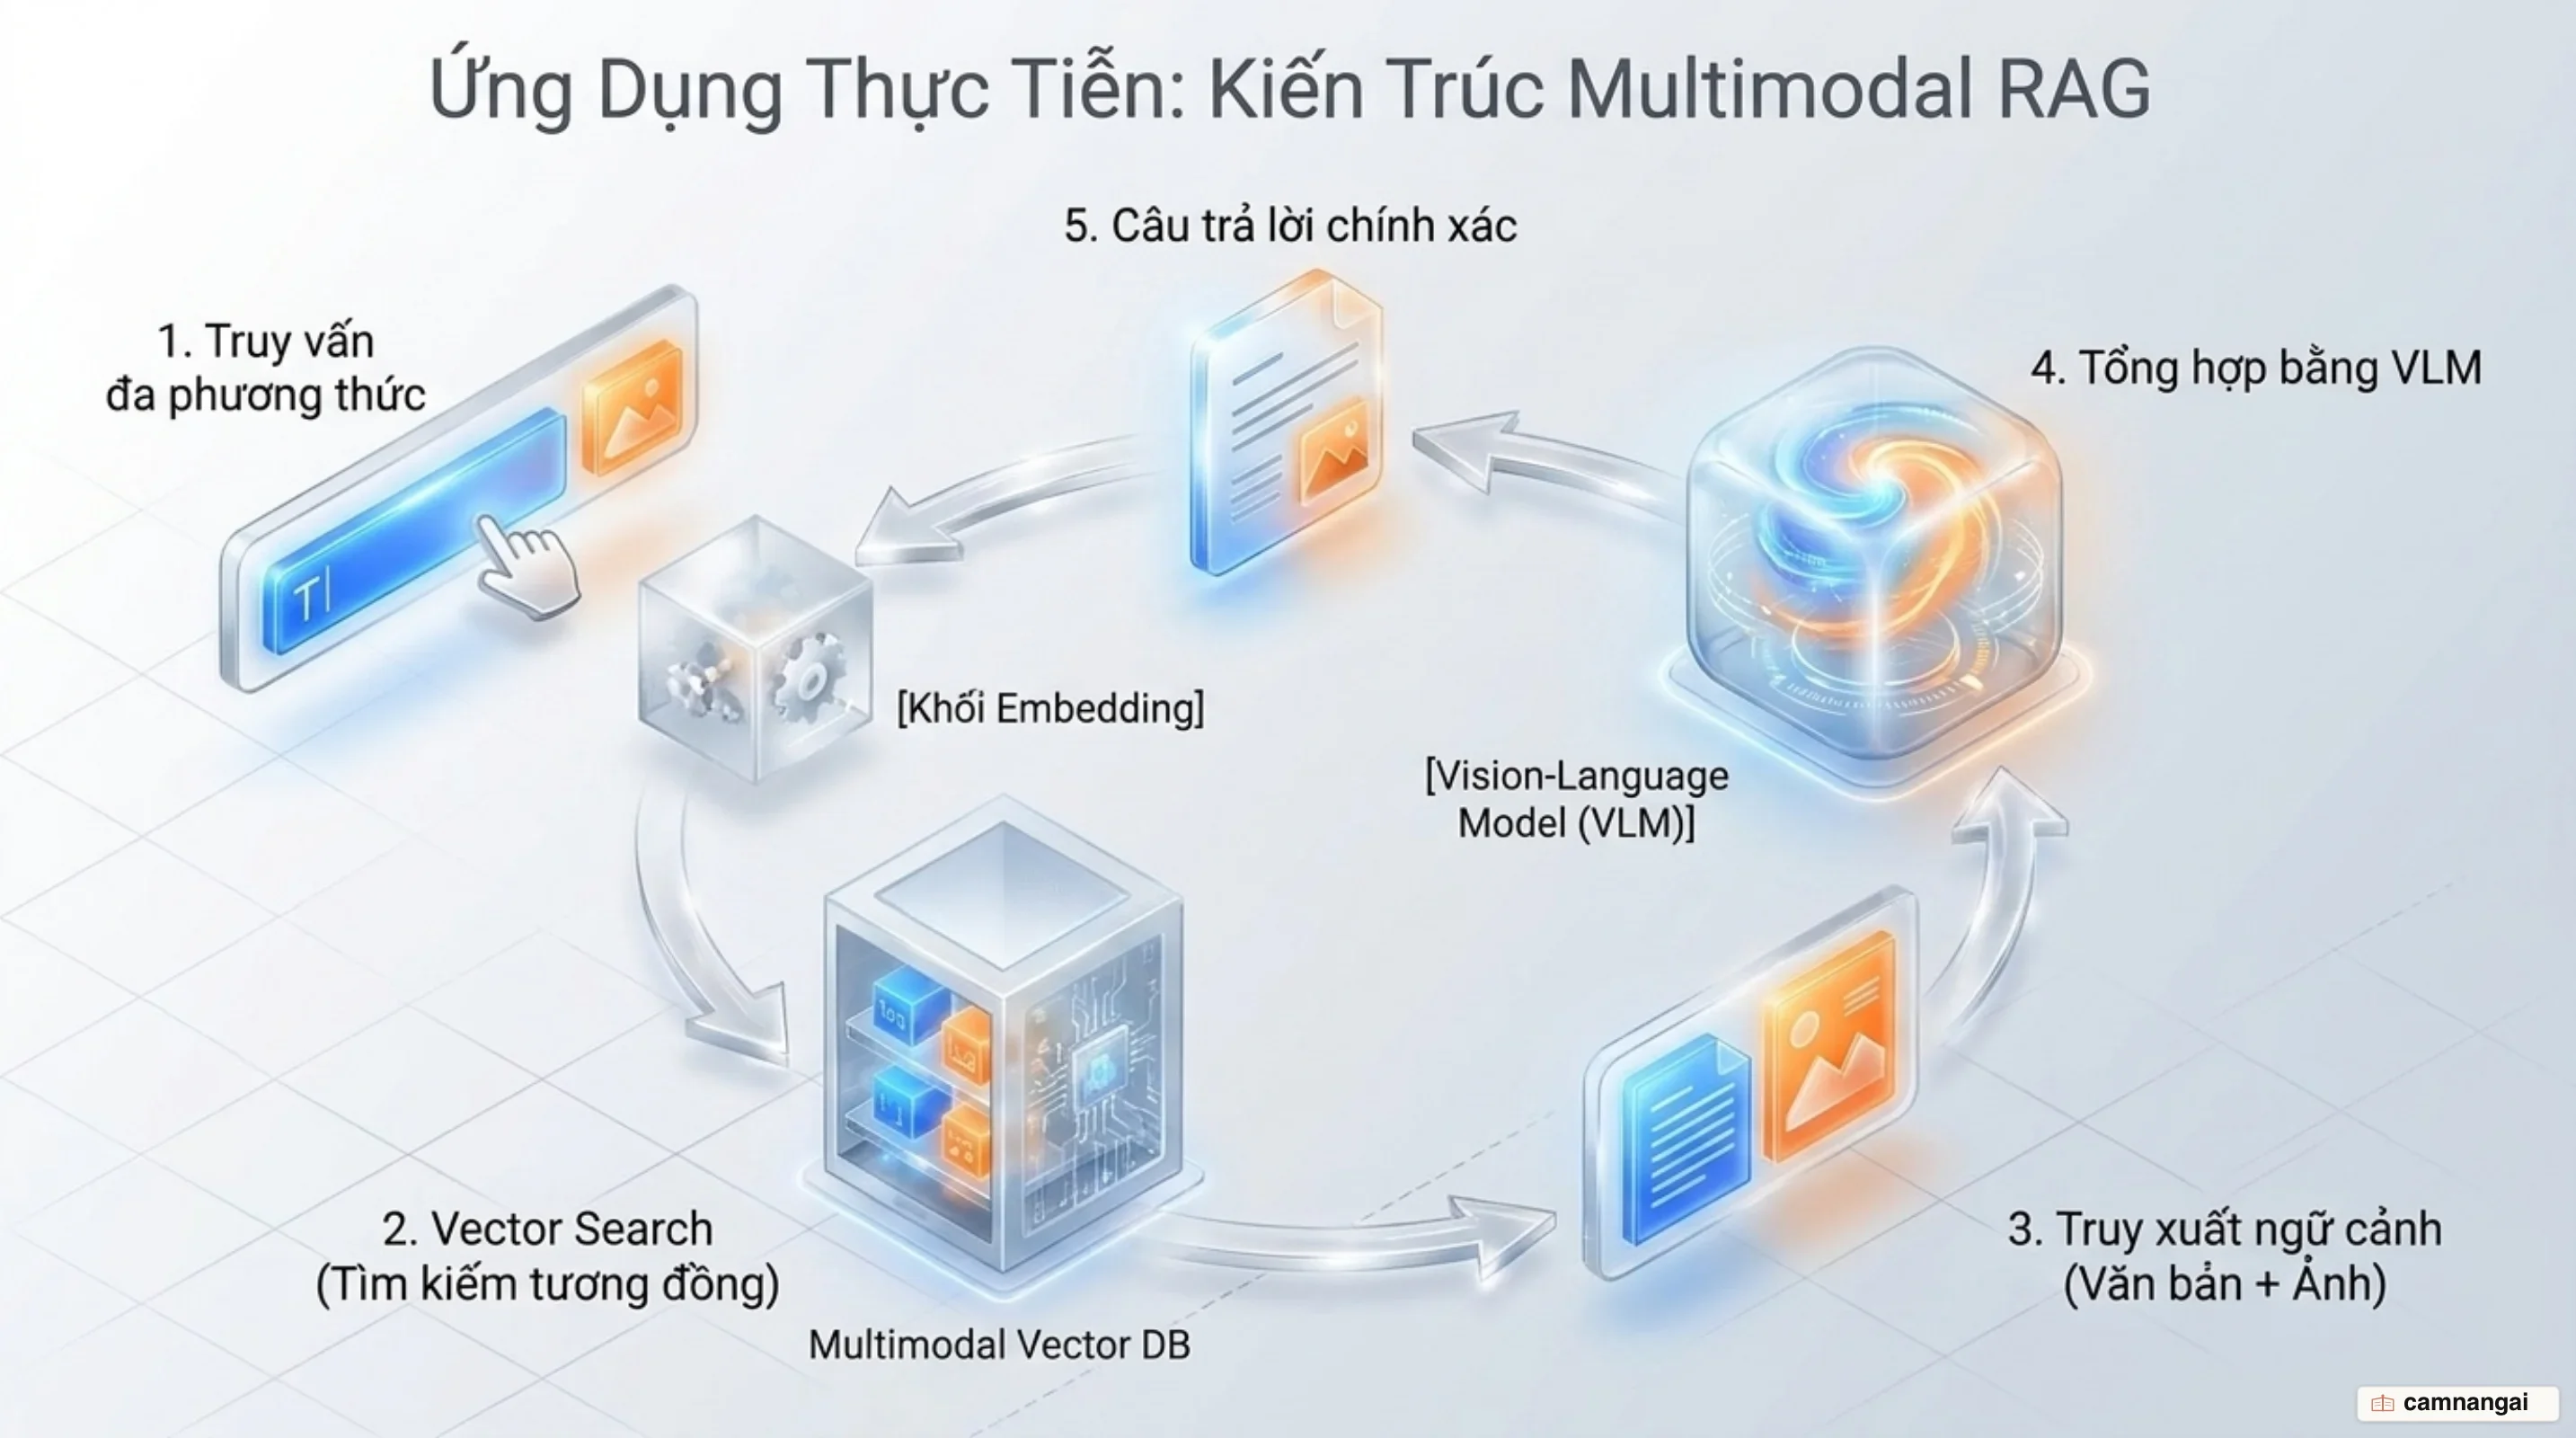
- Pipeline sinh chú thích & trích xuất Metadata: Dùng mô hình VLM chuyên biệt quét qua kho tài liệu, chuyển đổi biểu đồ và hình ảnh thành văn bản mô tả chi tiết, sau đó lưu vào Vector Database văn bản thông thường. Cách tiếp cận này tận dụng được hạ tầng tìm kiếm sẵn có nhưng có thể bỏ sót các chi tiết hình học trực quan.
- Tìm kiếm không gian nhúng chung (Joint Vector Search): Sử dụng mô hình nhúng đa phương thức (như CLIP hoặc mô hình multimodal chuyên dụng) để biến cả ảnh và câu truy vấn thành vector trong cùng một không gian. Khi người dùng đặt câu hỏi, hệ thống truy xuất trực tiếp các đoạn ảnh gốc có độ tương đồng cosine cao nhất và nạp nguyên khối ảnh vào prompt của VLM để tổng hợp câu trả lời.
Thách thức kỹ thuật và ranh giới an ninh của AI đa phương thức
Mặc dù có năng lực phân tích vượt trội, các mô hình thị giác đa phương thức vẫn đối mặt với những hạn chế cố hữu:
- Văn bản kích thước nhỏ và hệ chữ phi Latinh: Khả năng OCR của mô hình suy giảm mạnh trên các đoạn chữ quá nhỏ hoặc văn bản tiếng Nhật, tiếng Hàn phức tạp.
- Định vị không gian và đếm vật thể: Mô hình thường ước lượng con số gần đúng thay vì đếm chính xác số lượng đối tượng dày đặc, đồng thời gặp khó khăn trong việc xác định tọa độ chính xác từng điểm ảnh.
- Biến dạng hình học: Ảnh chụp bằng ống kính góc rộng (fisheye), ảnh toàn cảnh (panorama), hoặc ảnh bị đảo ngược hướng thường khiến mô hình suy luận sai lệch.
Về mặt an ninh thông tin, Multimodal AI mở ra bề mặt tấn công mới:
- Visual Prompt Injection: Kẻ tấn công có thể chèn văn bản độc hại được ngụy trang tinh vi vào hình ảnh (ví dụ chữ trắng trên nền trắng hoặc văn bản kích thước siêu nhỏ). Khi VLM quét ảnh, các chỉ thị ẩn này sẽ ghi đè của hệ thống và chiếm quyền điều khiển đầu ra.
- Dữ liệu riêng tư và PII: Hình ảnh tải lên thường chứa thông tin nhận dạng cá nhân (PII), khuôn mặt nhân viên hoặc tài liệu nội bộ nhạy cảm. Hệ thống sản xuất bắt buộc phải có bước kiểm duyệt và ẩn danh dữ liệu thị giác trước khi chuyển tiếp sang API bên ngoài.
- Chặn giải CAPTCHA: Các nhà cung cấp mô hình thương mại chủ động tích hợp rào chắn an toàn để phát hiện và từ chối xử lý các hình ảnh CAPTCHA nhằm ngăn chặn hành vi lạm dụng bot tự động.
Khi nào AI Engineer nên chọn mô hình đa phương thức?
Bạn nên lựa chọn mô hình Native Multimodal khi luồng nghiệp vụ của phần mềm đòi hỏi:
- Thấu hiểu tài liệu có cấu trúc không gian phức tạp (hóa đơn, chứng từ, báo cáo tài chính chứa bảng biểu đan xen).
- Phân tích trực tiếp biểu đồ kỹ thuật, sơ đồ kiến trúc phần mềm hoặc ảnh chụp mạch điện.
- Tự động hóa tác vụ trên giao diện người dùng (Computer Use / GUI Agent) nơi tọa độ màn hình và yếu tố thị giác là điều kiện tiên quyết.
Ngược lại, hãy kiên quyết giữ lại các mô hình LLM thuần văn bản nếu bài toán có thể giải quyết tốt bằng dữ liệu text thô hoặc cấu trúc JSON sẵn có. Việc lạm dụng đưa hình ảnh vào mô hình khi không cần thiết chỉ làm đội chi phí token lên gấp 5–10 lần, kéo dài độ trễ phản hồi và mở rộng thêm các lỗ hổng an ninh thị giác không đáng có.
Tài liệu tham khảo
- Multimodality and Large Multimodal Models (LMMs) — Chip Huyen
- Vision Language Models Explained — Hugging Face
- Gemini: A Family of Highly Capable Multimodal Models — arXiv
- LLaVA-NeXT: Improved reasoning, OCR, and world knowledge — LLaVA
- Vision with Claude — Anthropic Documentation
- Images and Vision Guide — OpenAI Platform
- Multimodal Concepts — LangChain Documentation
- What is Multimodal AI? — IBM Think