Lượng tử hóa mô hình là kỹ thuật nén mô hình bằng cách chuyển đổi trọng số (weights) và kích hoạt (activations) từ các kiểu dữ liệu số thực độ chính xác cao (như FP32 hay FP16) sang các kiểu dữ liệu số nguyên hoặc số thực bit thấp hơn như INT8, INT4, hoặc FP8.
Quá trình này giải quyết trực tiếp bài toán quá tải VRAM tĩnh và tăng tốc độ tính toán suy luận (inference) trên hạ tầng GPU.
Bằng cách thu hẹp không gian biểu diễn số học, bạn có thể cắt giảm nhu cầu băng thông bộ nhớ và khai thác tối đa năng lực xử lý của các nhân phần cứng chuyên dụng.
Mục tiêu kỹ thuật cốt lõi là giảm dung lượng bộ nhớ từ 2x đến 4x nhưng vẫn bảo toàn tối đa khả năng suy luận và độ chính xác của mô hình ban đầu.
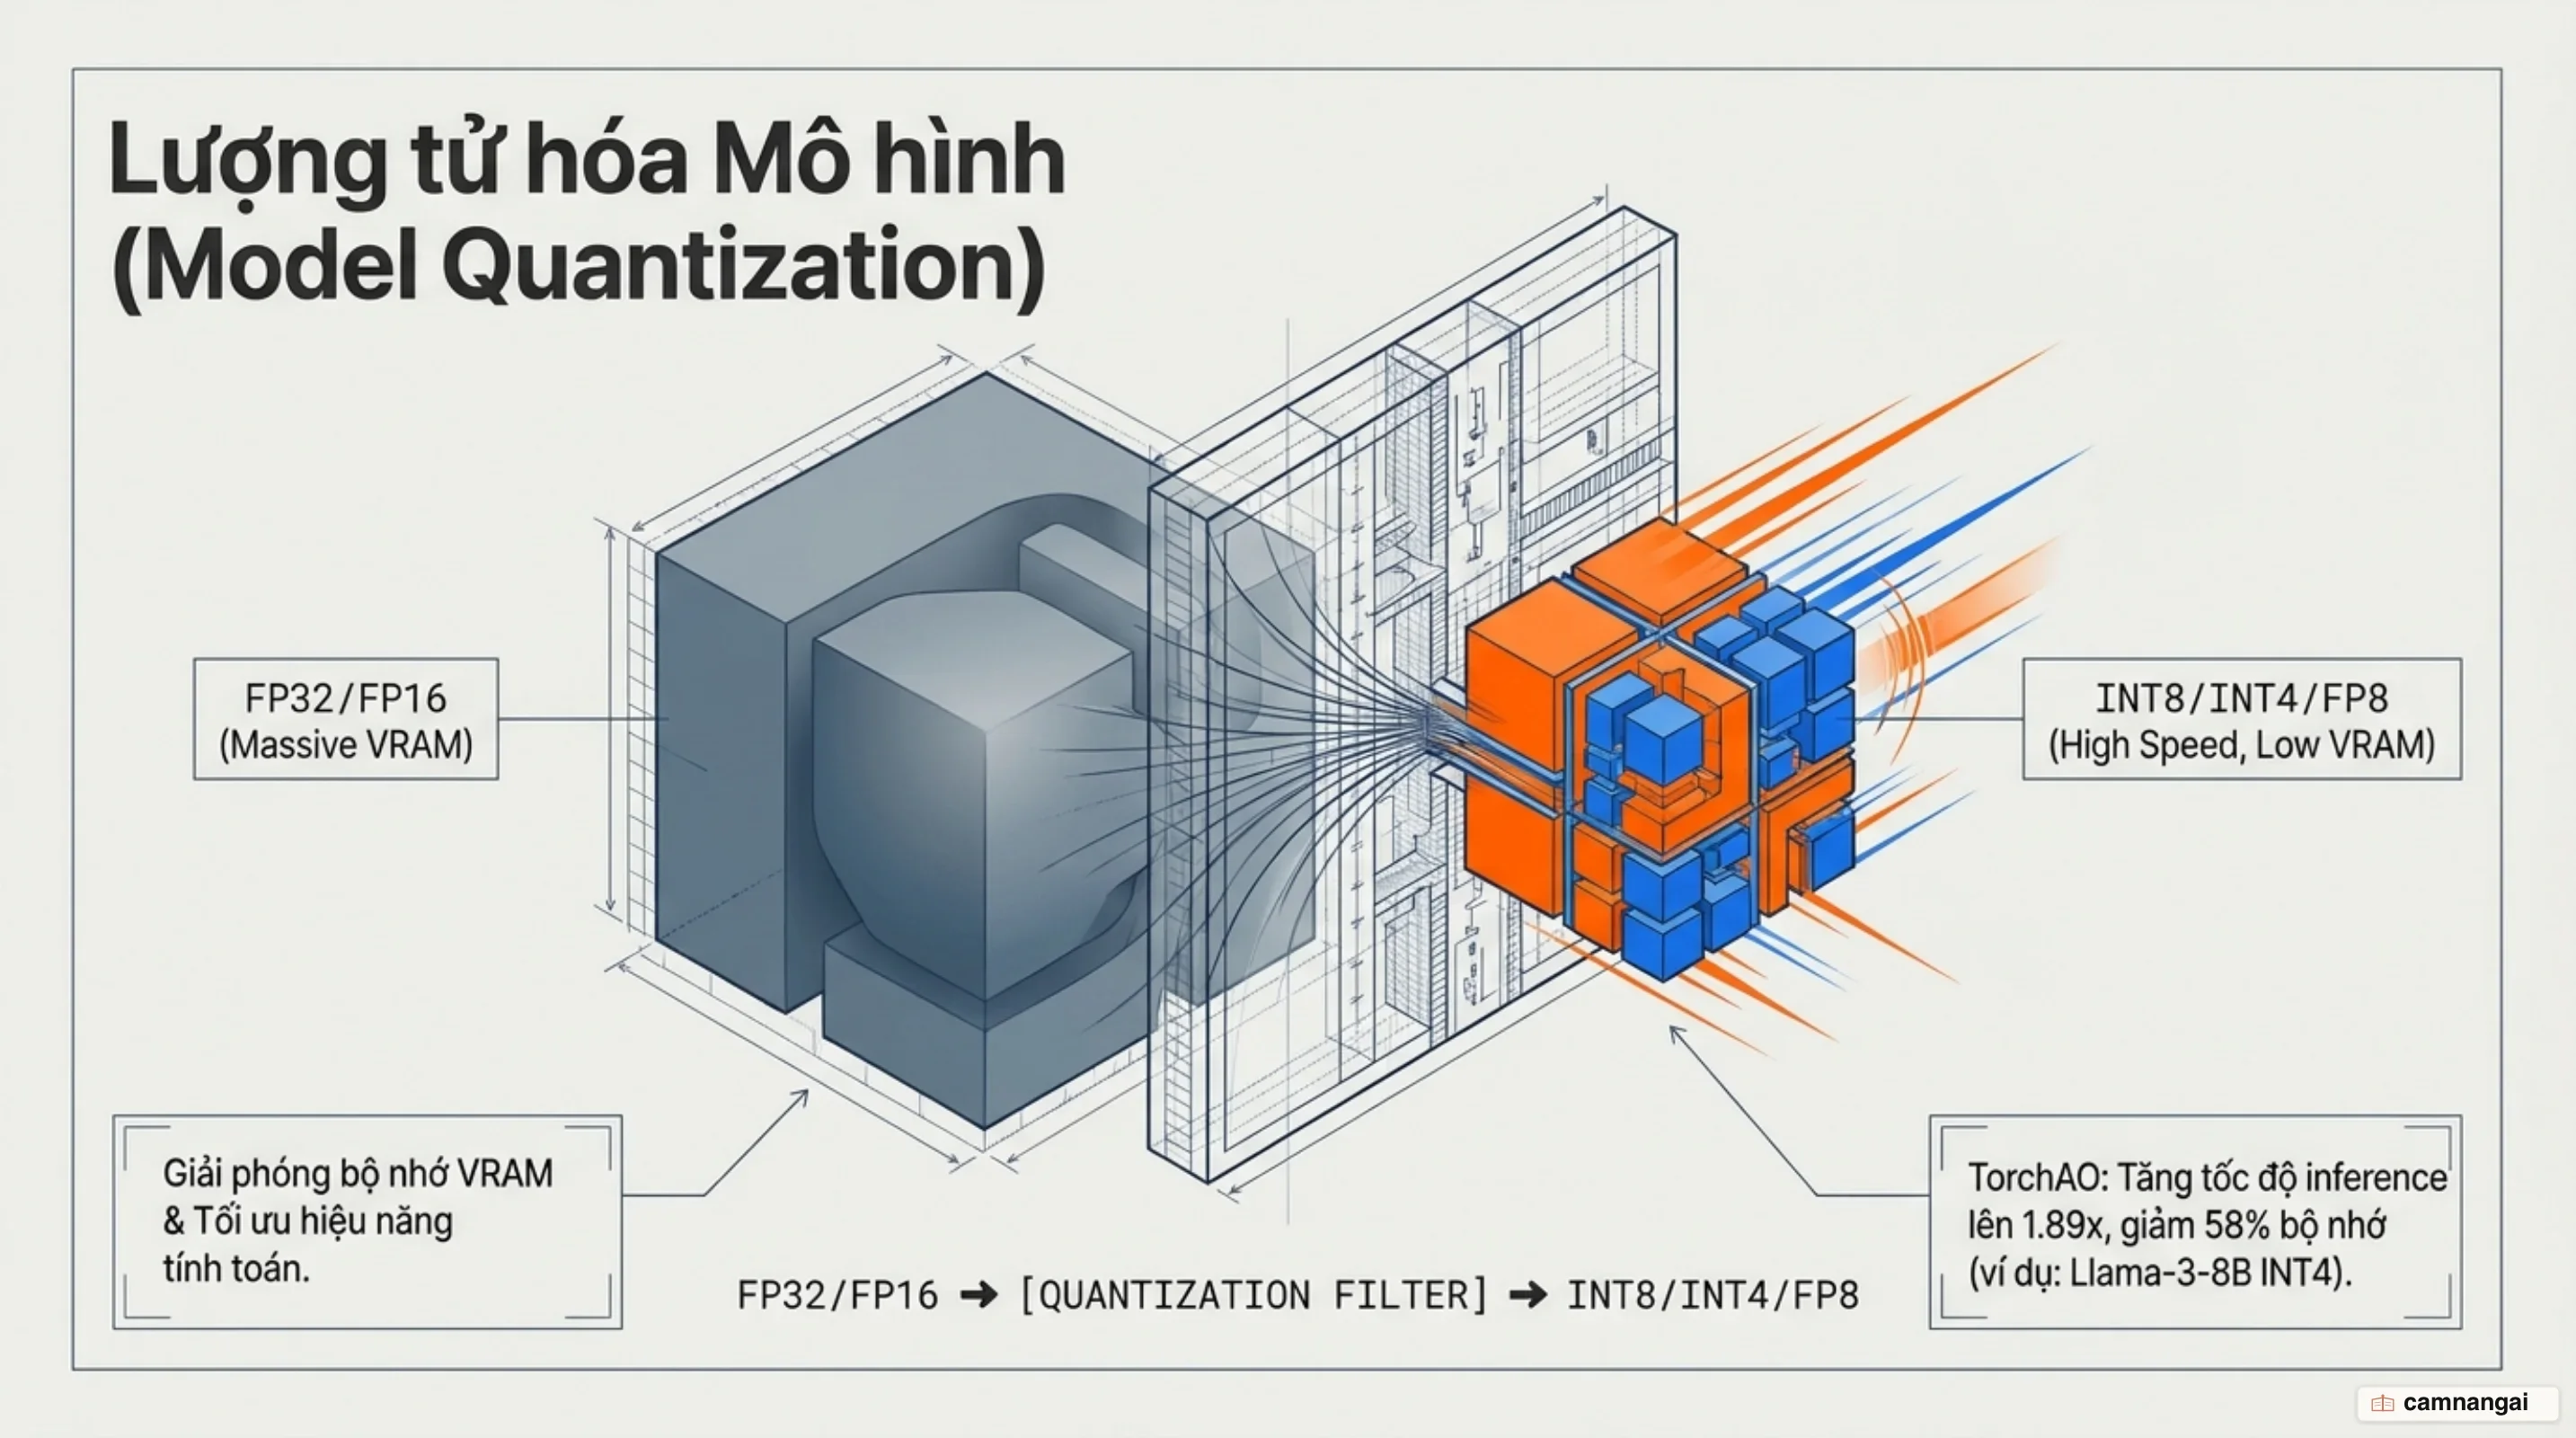
Lượng tử hóa mô hình là gì và vì sao bộ nhớ LLM là nút thắt cổ chai?
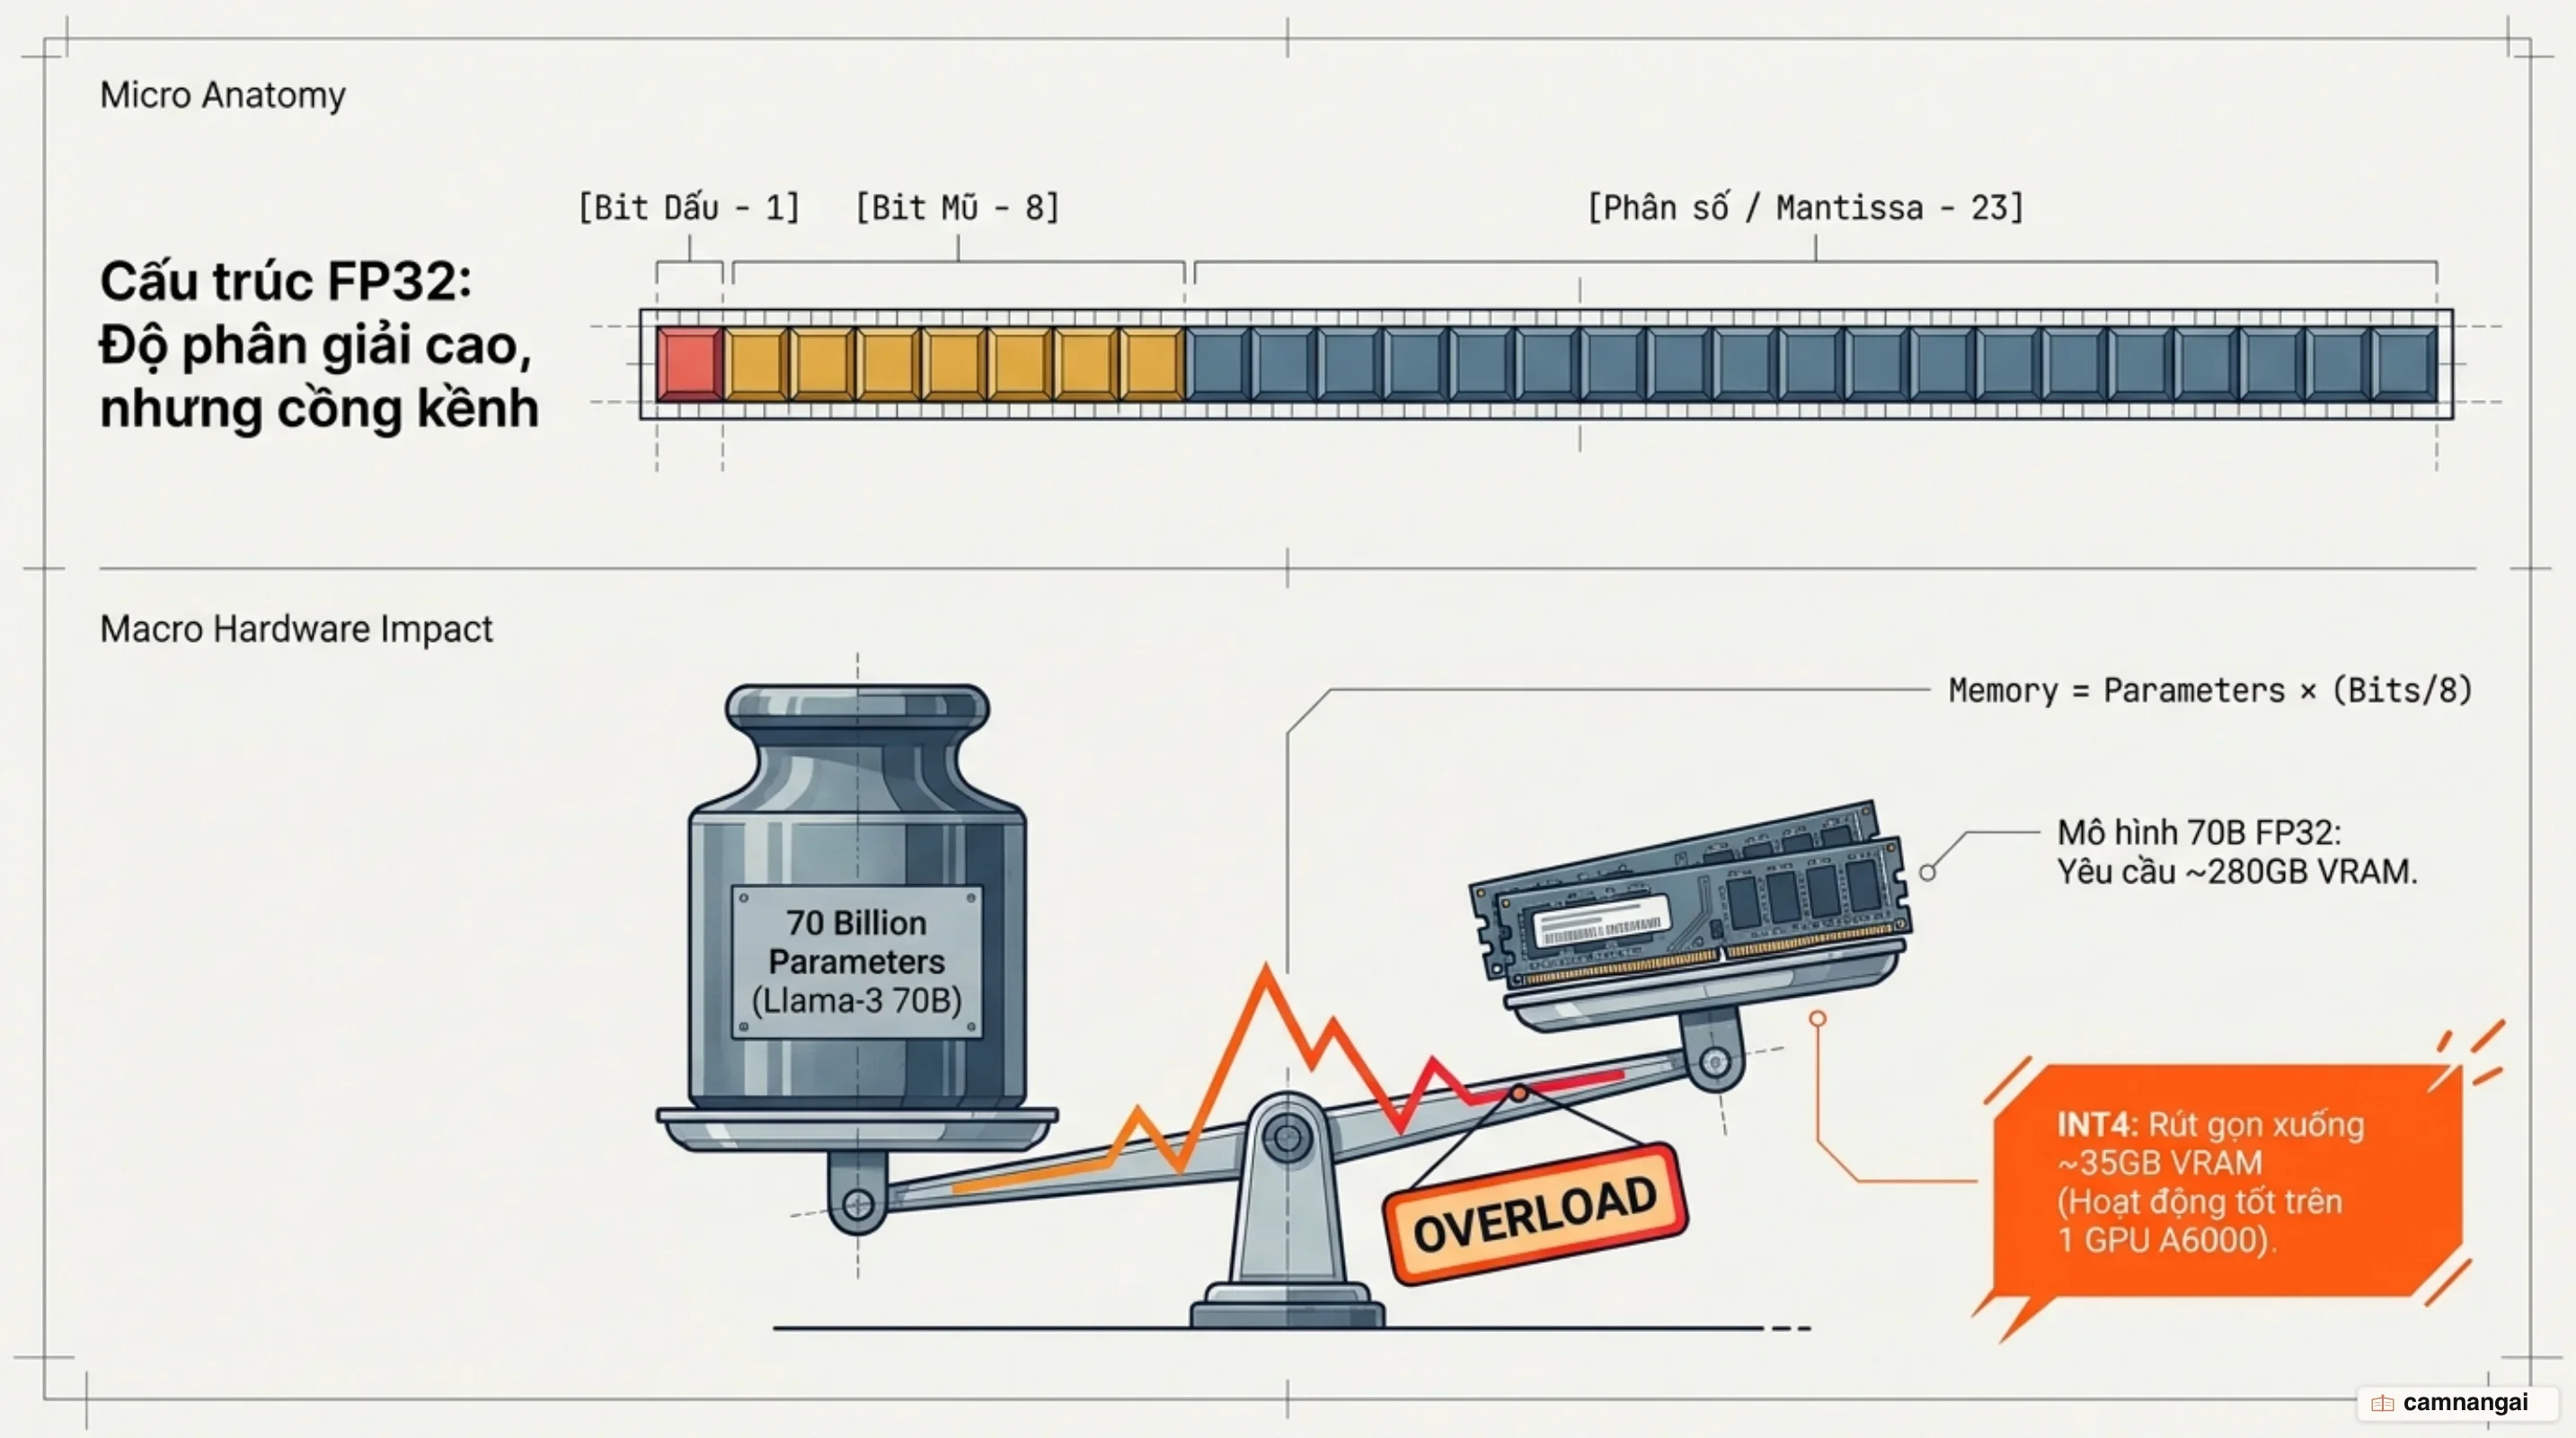
Trong kiến trúc máy tính chuẩn IEEE-754, các số thực được biểu diễn qua ba thành phần: bit dấu (sign), bit mũ (exponent) và bit phân số (mantissa/fraction). Định dạng FP32 (32 bit) tốn 4 bytes cho mỗi tham số với dải giá trị (Dynamic Range) cực rộng [-3.4 × 10^{38}, 3.4 × 10^{38}] và độ phân giải (Precision) cao. Các định dạng FP16 và BF16 dùng 16 bit (2 bytes/tham số) để cắt giảm một nửa bộ nhớ. Hai khái niệm then chốt ở đây là: Dynamic Range quyết định khoảng giá trị xa nhất có thể biểu diễn mà không bị tràn số (overflow/underflow), còn Precision quyết định khoảng cách nhỏ nhất giữa hai số liền kề.
Khi đưa các mô hình ngôn ngữ lớn (LLM) vào vận hành thực tế, VRAM GPU chính là nút thắt cổ chai hạ tầng nghiêm trọng nhất. Xét một mô hình 70 tỷ tham số (70B): ở định dạng FP32, bạn cần 70 × 4 = 280 GB VRAM chỉ để nạp trọng số tĩnh. Nếu dùng FP16, con số này là 140 GB VRAM. Tuy nhiên, khi chạy suy luận, VRAM không chỉ chứa trọng số mà còn phải gánh bộ nhớ động phát sinh từ Activations và KV Cache (tăng tuyến tính theo độ dài ngữ cảnh context length và số lượng truy vấn đồng thời). Do đó, việc triển khai trên hạ tầng phần cứng giới hạn là không thể nếu không có kỹ thuật nén.
Bản chất của lượng tử hóa mô hình là một phép ánh xạ (linear mapping) ép không gian số thực rộng lớn vào không gian số nguyên ít bit hơn như INT8 (256 giá trị) hay INT4 (16 giá trị). Kỹ thuật này tương tự như việc thu hẹp một bảng màu từ hàng triệu màu xuống 8 màu cố định: các giá trị số thực nằm gần nhau sẽ được gom về cùng một mã số nguyên đại diện. Mục tiêu kỹ thuật là giảm kích thước bộ nhớ tĩnh từ 2x đến 4x nhưng vẫn phải bảo toàn tối đa năng lực suy luận và biểu diễn tri thức của mô hình gốc.
Toán học nền tảng: Scale factor, Zero-point và Ánh xạ affine
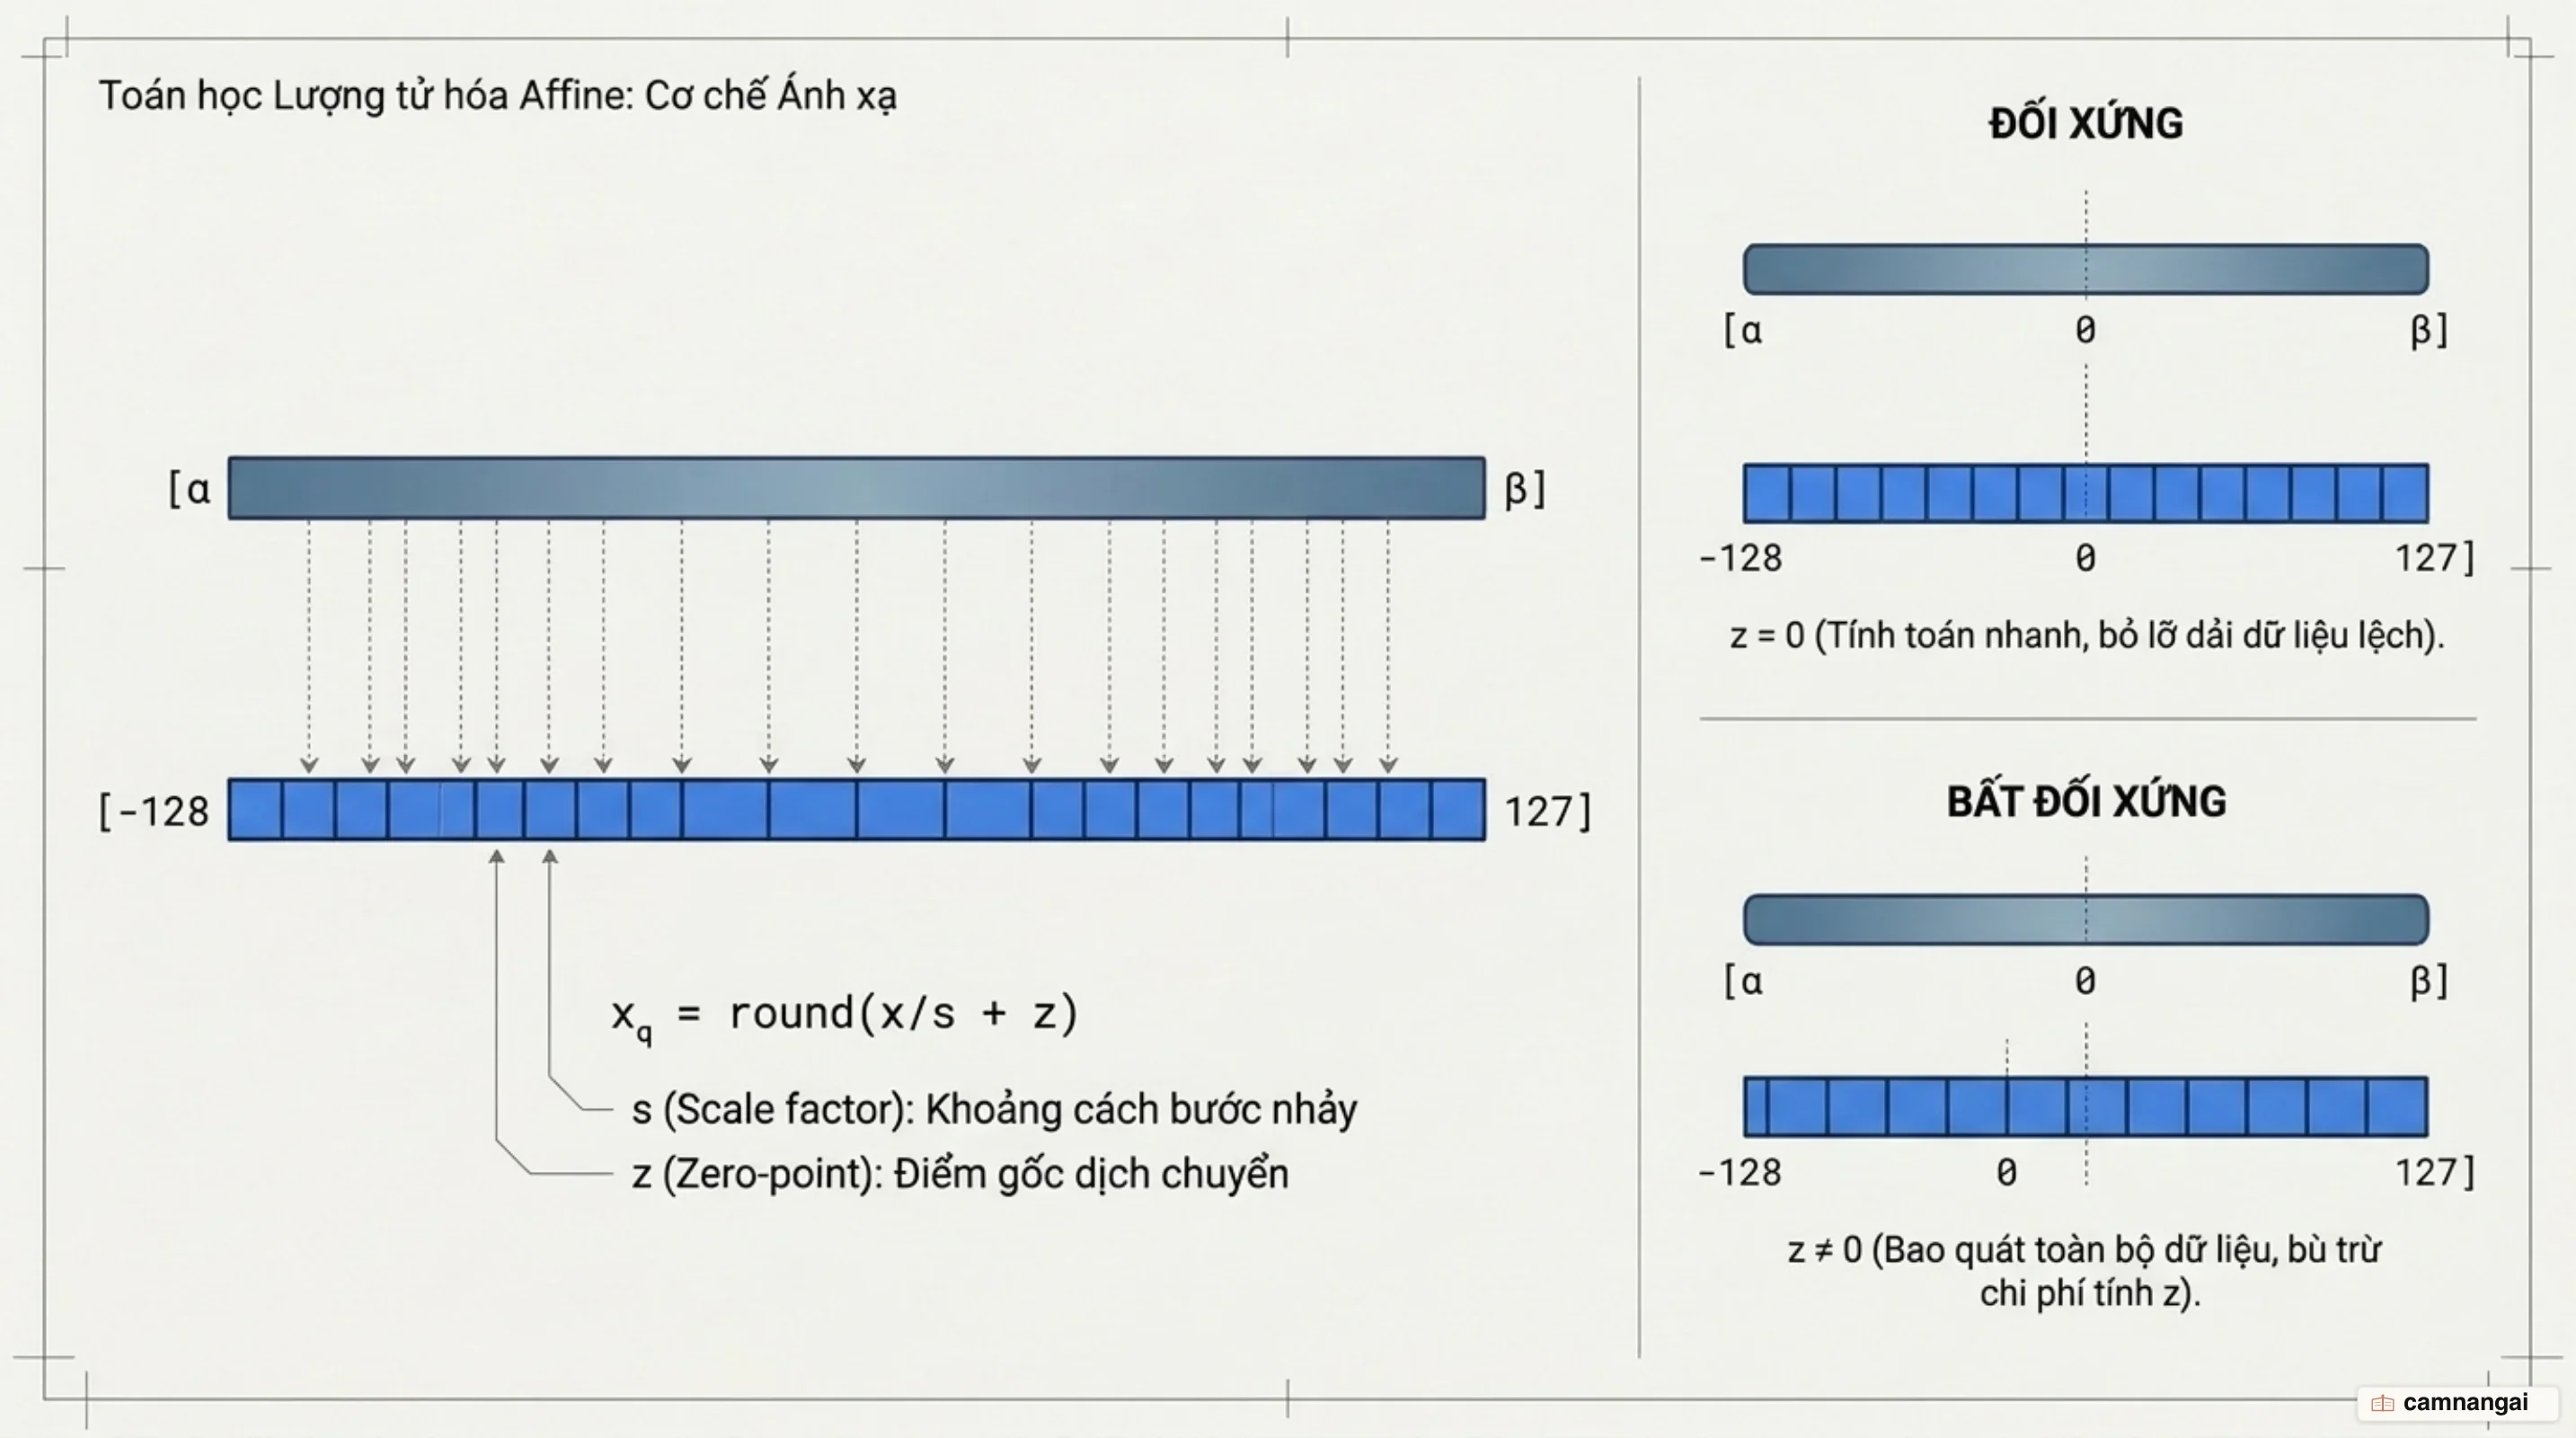
Lượng tử hóa bất đối xứng (Asymmetric Quantization hay Ánh xạ Affine) thực hiện chuyển đổi dải số thực x [α, β] sang dải số nguyên x_q [α_q, β_q]. Công thức lượng tử hóa được biểu diễn như sau:
x_q = \text{clip}\left(\text{round}\left(\frac{1}{s}x + z\right), \alpha_q, \beta_q\right)Trong đó, hàm clip(v, l, u) sẽ ép các giá trị vượt dải về biên l hoặc u. Phép giải lượng tử (dequantization) để khôi phục giá trị thực xấp xỉ được thực hiện qua công thức:
x = s(x_q - z)Hệ số tỷ lệ Scale factor (s) và điểm không Zero-point (z) được xác định chính xác theo dải giá trị thực và dải số nguyên mục tiêu:
s = \frac{\beta - \alpha}{\beta_q - \alpha_q}, \quad z = \text{round}\left(\frac{\beta \alpha_q - \alpha \beta_q}{\beta - \alpha}\right)Trong đó, s là một số thực dương xác định khoảng cách giữa hai giá trị liền kề, còn z là số nguyên biểu diễn giá trị thực 0.0 trong không gian lượng tử.
Lượng tử hóa đối xứng (Symmetric Quantization / Absmax) là trường hợp đặc biệt khi ta ép z = 0, ánh xạ dải đối xứng [-α, α] sang [-α_q, α_q] với α = (|x|). Hệ số scale lúc này là s = (α / α_q). Điểm mạnh của lượng tử đối xứng là triệt tiêu các phép trừ z trong phép nhân ma trận (GEMM), tăng tốc tính toán trên nhân Tensor Core. Tuy nhiên, nhược điểm là nó gây ra sai số lượng tử hóa (quantization error) lớn hơn khi phân bố dữ liệu bị lệch (asymmetric) về một phía.
Hiện tượng giá trị ngoại lệ (outliers) có độ lớn bất thường trong ma trận trọng số làm giãn dải dynamic range, khiến hầu hết các giá trị bình thường bị nén vào một khoảng số nguyên hẹp, suy giảm độ chính xác nghiêm trọng. Để khắc phục, phương pháp Clipping cắt ngọn dải giá trị về [α, β] cố định. Quá trình chọn [α, β] tối ưu gọi là Calibration (hiệu chỉnh), sử dụng các kỹ thuật: Percentile (chọn theo bách phân vị), tối ưu hóa sai số bình phương trung bình (MSE), hoặc giảm thiểu độ lệch KL (Entropy minimization / KL-divergence).
Đối với phép nhân ma trận Y = XW + b, phép biến đổi sang dạng lượng tử thu được công thức Quantized GEMM:
Y_{q,i,j} = z_Y + \frac{s_b}{s_Y}(b_{q,j} - z_b) + \frac{s_X s_W}{s_Y} \left[ \left(\sum_{k=1}^p X_{q,i,k} W_{q,k,j}\right) - z_W \sum_{k=1}^p X_{q,i,k} - z_X \sum_{k=1}^p W_{q,k,j} + p z_X z_W \right]Về mặt kiến trúc hạ tầng, các hằng số chứa z_W, z_X, z_b, z_Y, s_X, s_W, s_Y và tổng các cột ∑ W_{q,k,j} đều được tính toán tĩnh offline trước khi suy luận. Việc tách z_W ∑ X_q và z_X ∑ W_q giúp biến các phép tính liên quan đến Zero-point thành các phép rút gọn theo hàng/cột (vector reduction), giảm độ phức tạp tính toán bù zero-point từ O(M · N · K) xuống O(M · K). Do đó, nhân tính toán cốt lõi trong runtime chỉ còn là phép nhân ma trận số nguyên thuần túy ∑ X_{q,i,k} W_{q,k,j}.
Đoạn mã Python dưới đây minh họa thuật toán lượng tử hóa và giải lượng tử bất đối xứng linh hoạt hỗ trợ đa dạng kiểu dữ liệu:
import numpy as np

def generate_quant_params(alpha: float, beta: float, bit_width: int = 8):
    alpha_q = -(2 ** (bit_width - 1))
    beta_q = (2 ** (bit_width - 1)) - 1
    s = (beta - alpha) / (beta_q - alpha_q)
    z = int(np.round((beta * alpha_q - alpha * beta_q) / (beta - alpha)))
    return s, z, alpha_q, beta_q

def quantize_tensor(x: np.ndarray, s: float, z: int, alpha_q: int, beta_q: int, dtype=np.int8) -> np.ndarray:
    x_q = np.round(x / s + z)
    x_q = np.clip(x_q, alpha_q, beta_q)
    return x_q.astype(dtype)

def dequantize_tensor(x_q: np.ndarray, s: float, z: int) -> np.ndarray:
    return (s * (x_q.astype(np.float32) - z)).astype(np.float32)

# Mô phỏng lượng tử hóa INT8
x_real = np.array([-5.2, 0.0, 3.1, 10.8], dtype=np.float32)
s, z, a_q, b_q = generate_quant_params(alpha=-7.59, beta=10.8, bit_width=8)
x_quant = quantize_tensor(x_real, s, z, a_q, b_q, dtype=np.int8)
x_dequant = dequantize_tensor(x_quant, s, z)

print(f"INT8 Quantized: {x_quant}")
print(f"Dequantized FP32: {x_dequant}")
PTQ và QAT: Nén sau huấn luyện khác gì huấn luyện nhận biết lượng tử hóa?
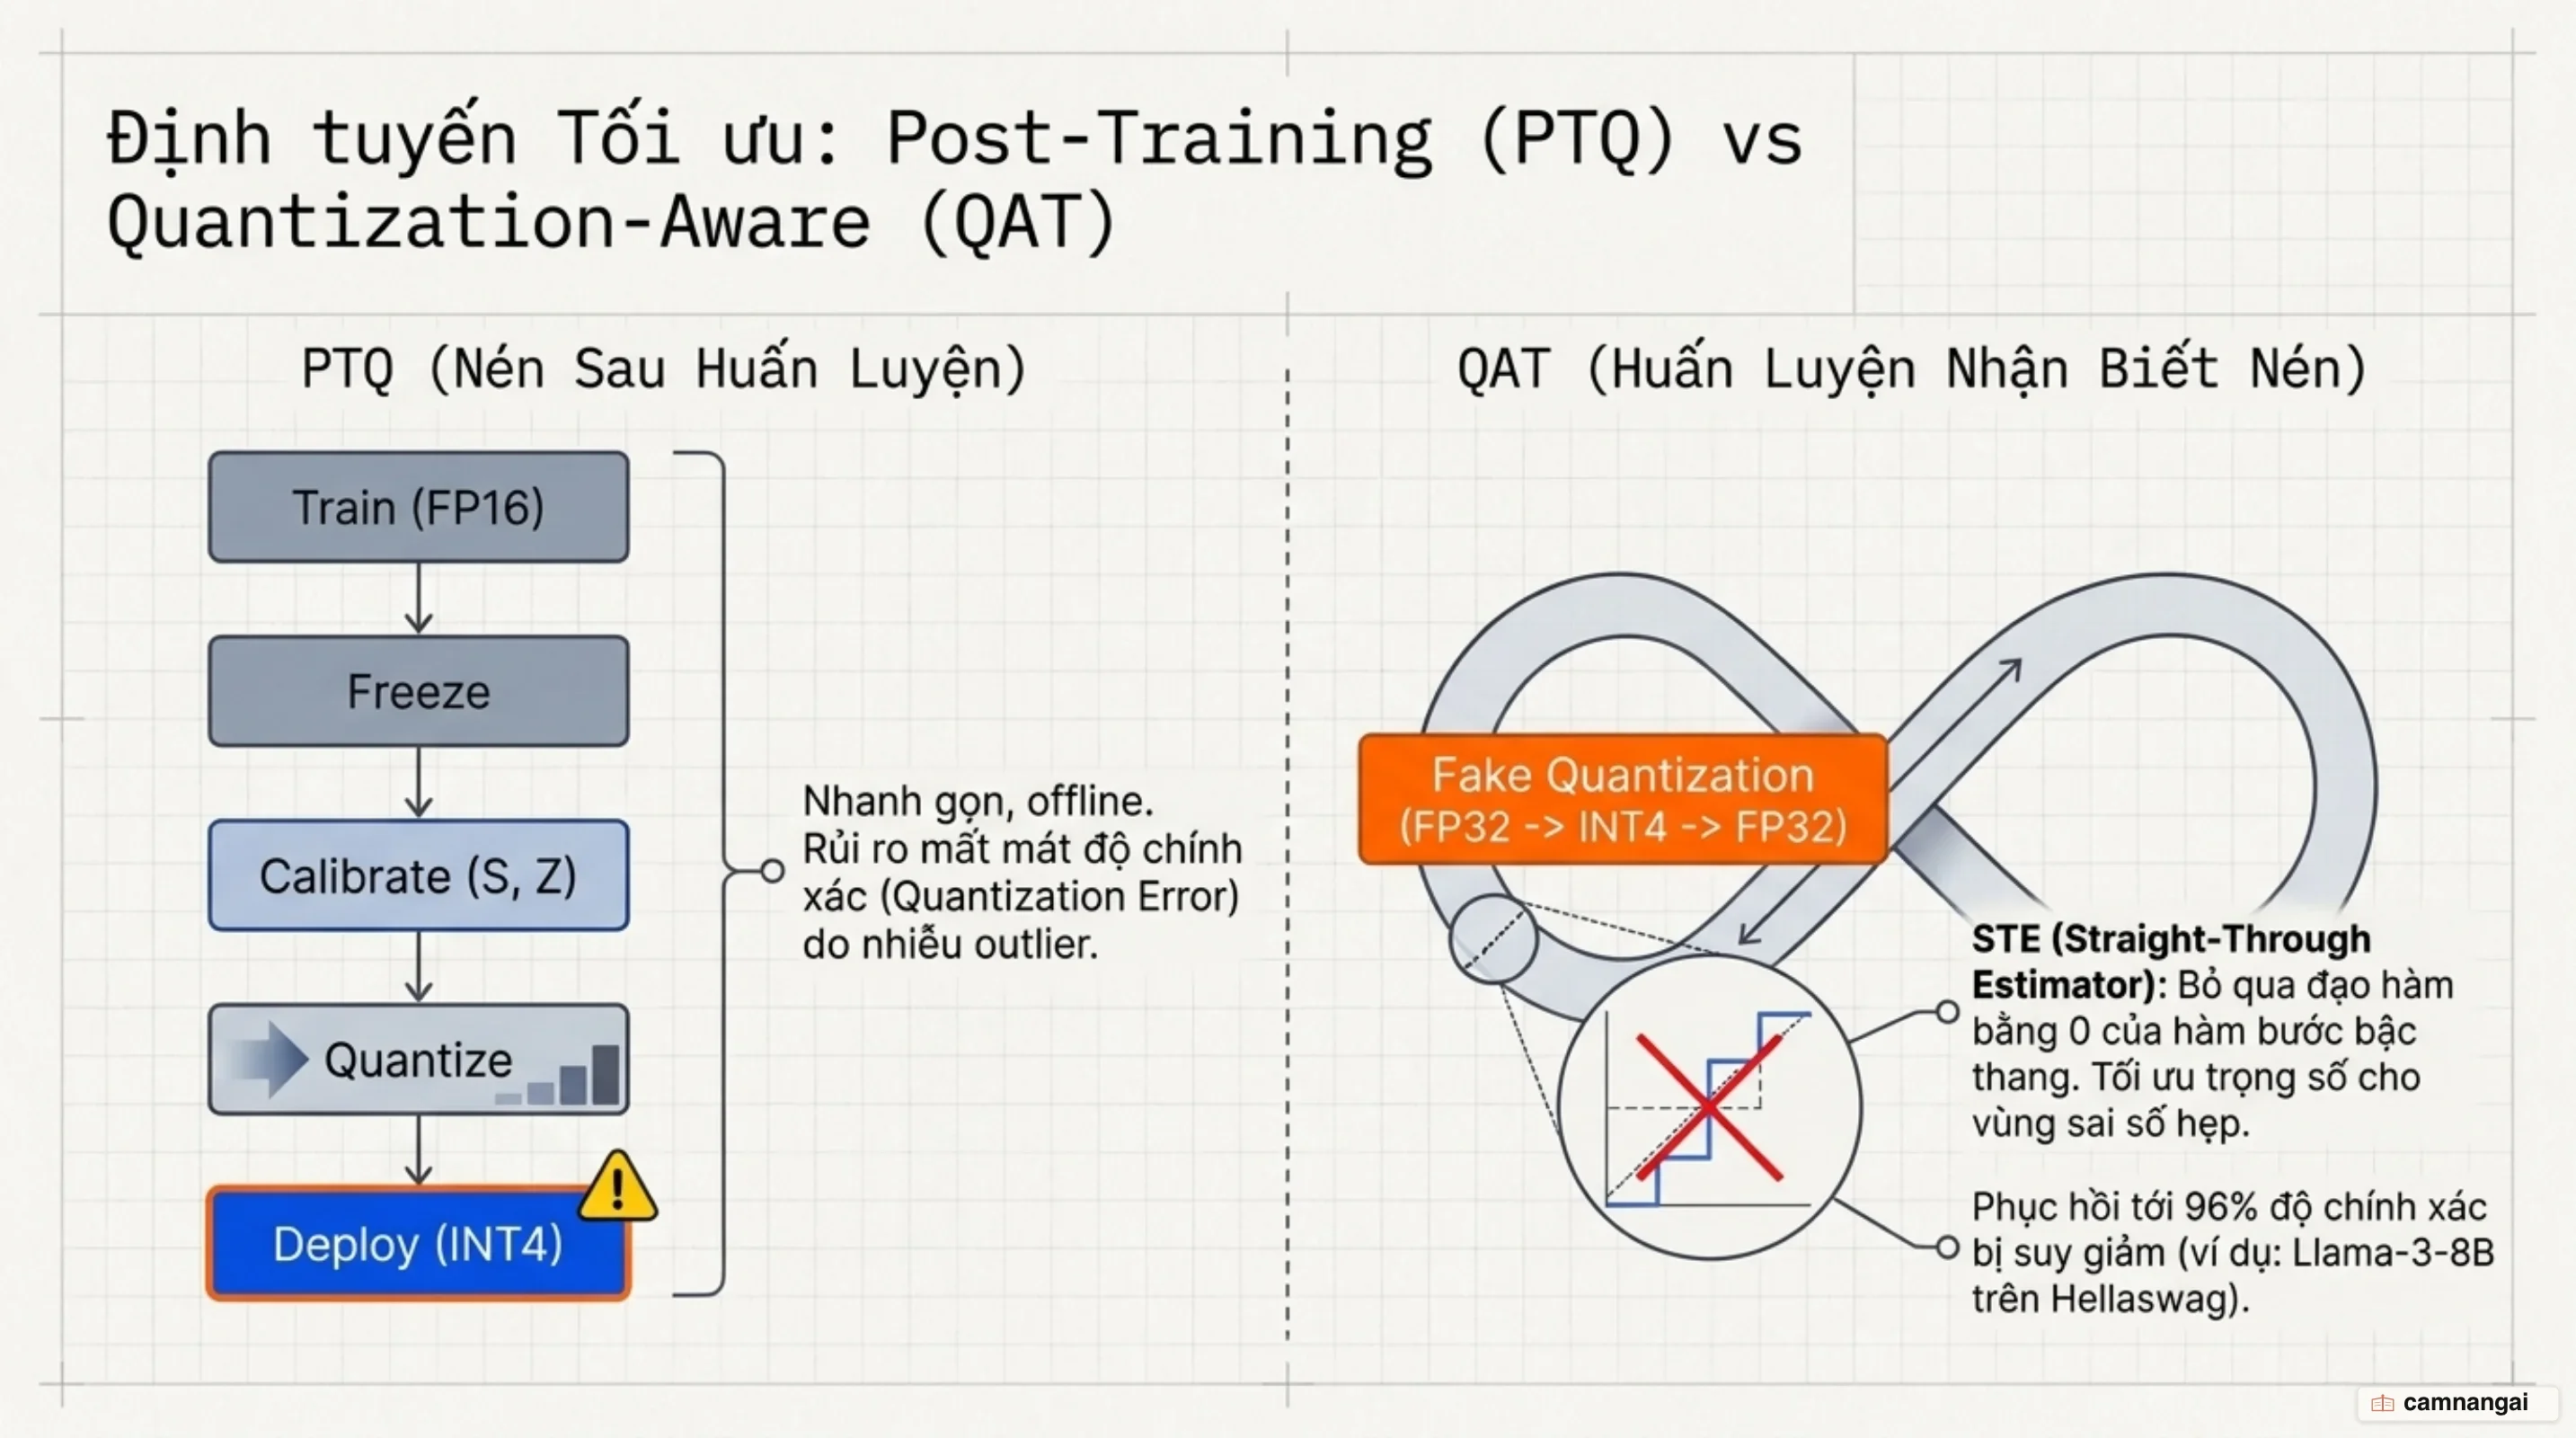
Post-Training Quantization (PTQ) thực hiện nén mô hình sau khi quá trình huấn luyện đã hoàn tất mà không cần huấn luyện lại toàn bộ mạng. PTQ phân thành hai nhánh dựa trên cơ chế xử lý Activations:
- Dynamic Quantization: Trọng số tĩnh được nén trước, còn các thông số
svàzcủa Activations được tính toán động ngay trong quá trình suy luận (runtime) sau mỗi lớp ẩn. Kỹ thuật này đạt độ chính xác cao nhưng làm tăng thời gian tính toán overhead trên runtime. - Static Quantization: Sử dụng một tập dữ liệu hiệu chỉnh (calibration dataset) chạy qua mô hình trước khi triển khai để thu thập phân bố thống kê của Activations. Từ đó, xác định cố định
svàztoàn cục cho Activations. Cách này mang lại tốc độ thực thi tối đa do bỏ qua khâu tính toáns, zở runtime, nhưng chấp nhận dung sai lớn hơn nếu dữ liệu thực tế lệch khỏi tập hiệu chỉnh.
Quantization-Aware Training (QAT) giải quyết sự suy giảm độ chính xác bằng cách đưa các nút lượng tử hóa giả lập ("Fake Quantization" nodes) vào đồ thị tính toán trong quá trình huấn luyện hoặc fine-tuning. Nút Fake Quant thực hiện phép nén giả lập: chuyển trọng số/kích hoạt từ FP32 xuống INT4/INT8 rồi giải lượng tử ngược ngay lập tức về FP32 trong forward pass. Cơ chế này giúp mô hình học cách thích nghi với sai số lượng tử hóa và tìm kiếm các điểm cực tiểu rộng (wide minima) trên không gian mất mát (loss landscape) thay vì cực tiểu hẹp (narrow minima), giữ độ ổn định cao khi nén bit.
 Forward Pass:  [FP32 Weights] -> [Fake Quant: FP32 -> INT4 -> FP32] -> [Loss Calculation]
                                                                                |
 Backward Pass: [STE: Derivative = 1] <- [Gradient Update] <--------------------+
Trong lan truyền ngược (backward pass), các hàm round và clip có đạo hàm bằng 0 hoặc không xác định. QAT vượt qua rào cản này bằng phương pháp Straight-Through Estimator (STE). STE coi nút Fake Quant như một hàm đồng nhất (identity function) trong dải clipping, truyền nguyên vẹn gradient ({∂ {x}}{∂ x} = 1) để cập nhật trọng số gốc FP32. Dữ liệu thực nghiệm từ TorchAO chỉ ra rằng: QAT giúp khôi phục tới 96% mức độ suy giảm độ chính xác (accuracy degradation) trên Llama-3-8B và khôi phục 67% mức suy giảm trên Gemma3-4B so với PTQ thông thường. Việc kết hợp QAT + LoRA còn giúp tăng tốc độ fine-tuning lên 1.89x so with QAT toàn bộ tham số.
Lượng tử hóa chỉ trọng số (Weight-only) và Lượng tử hóa cả kích hoạt (Weight & Activation)
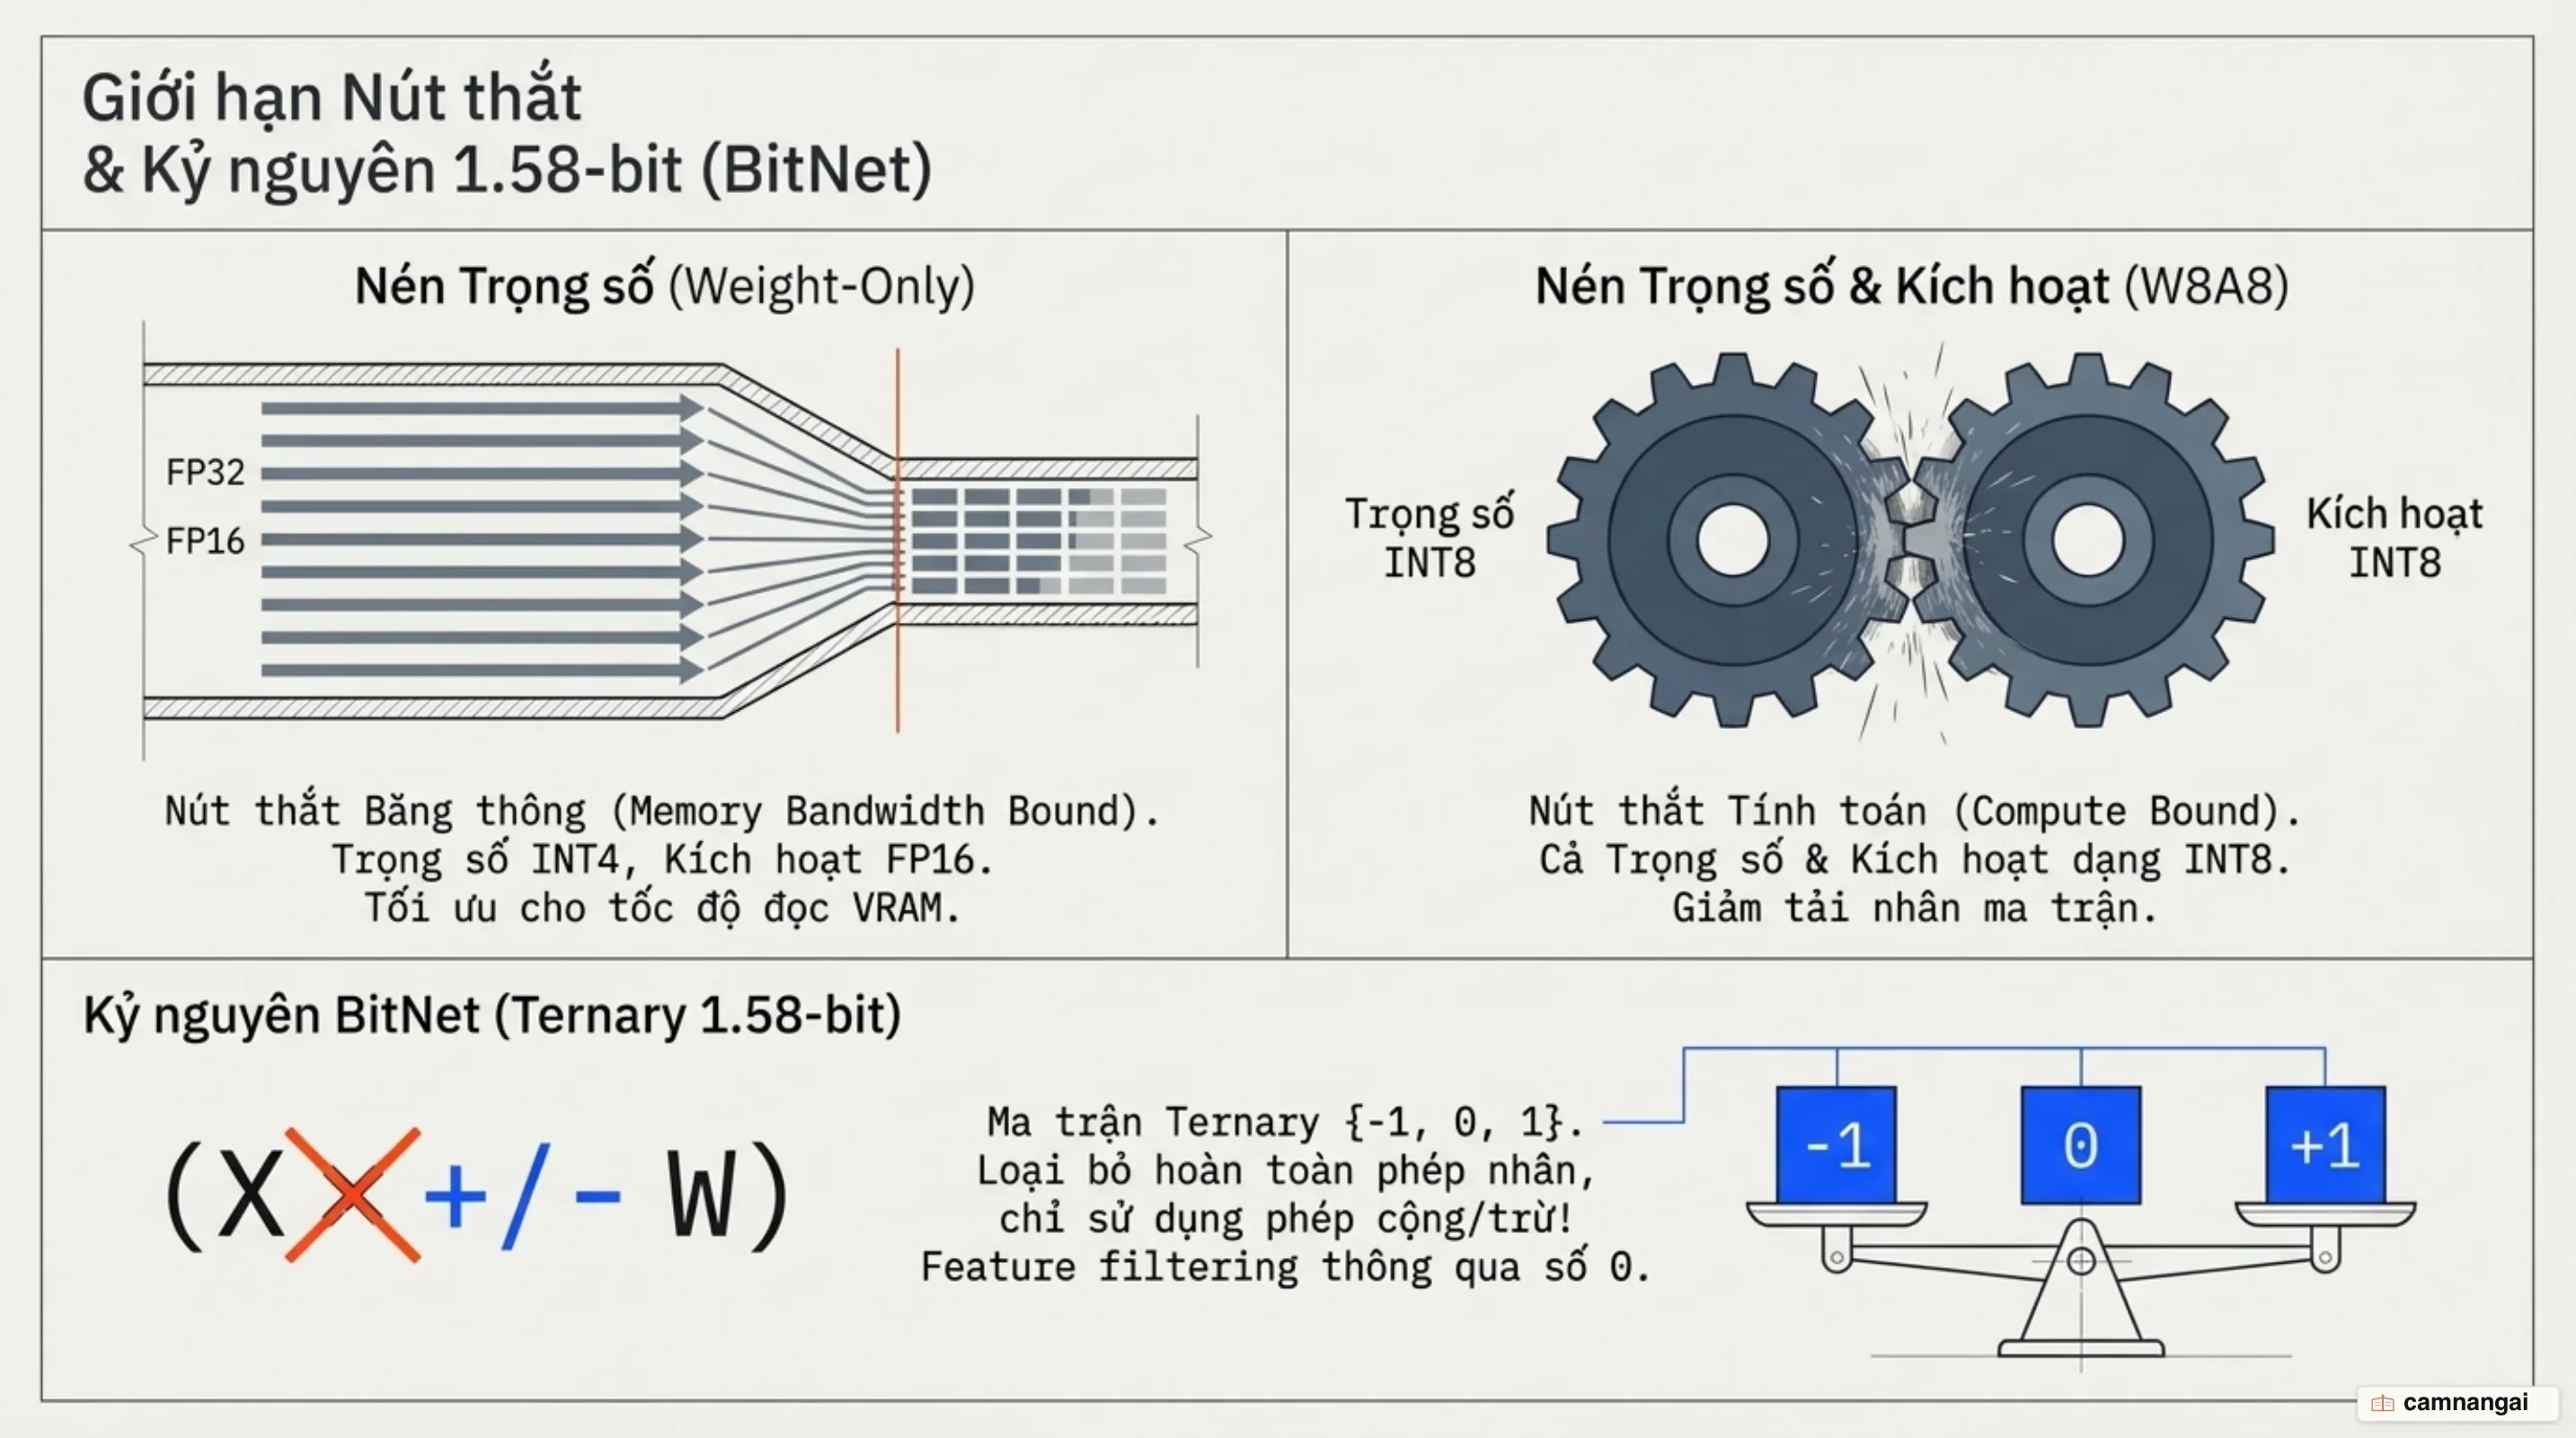
Lượng tử hóa Weight-only (như W4A16, W8A16) giữ nguyên Activations ở định dạng FP16/BF16 và chỉ nén ma trận trọng số tĩnh W xuống INT4 hoặc INT8. Bản chất của việc chọn cấu hình này nằm ở chỉ số Arithmetic Intensity (tỷ lệ FLOPs/Byte). Khi chạy suy luận LLM ở Batch Size = 1 (hoặc batch size nhỏ), tiến trình bị giới hạn hoàn toàn bởi băng thông bộ nhớ GPU (Memory bandwidth-bound) do Arithmetic Intensity thấp. Thời gian xử lý chủ yếu dành cho việc nạp trọng số từ VRAM vào bộ nhớ đệm SRAM. Giảm dung lượng trọng số xuống 4-bit giúp tăng tốc độ nạp ma trận vào SRAM nhanh hơn gấp 2 đến 4 lần.
Ngược lại, lượng tử hóa cả Trọng số và Kích hoạt (Weight & Activation - bao gồm W8A8, W4A8, FP8) nén đồng thời cả hai ma trận đầu vào của phép nhân GEMM. Khi hệ thống phục vụ ứng dụng ở Batch Size lớn, Arithmetic Intensity tăng cao, tiến trình chuyển sang trạng thái bị giới hạn bởi năng lực tính toán (Compute-bound). Việc ép cả Activations và Weights về INT8 hoặc FP8 (NVFP4/MXFP8) cho phép kích hoạt toàn bộ nhân phần cứng chuyên dụng (Tensor Cores) dành cho phép nhân số nguyên/FP8, đạt tổng lượng token xử lý được trên giây (Throughput) cao nhất.
Kiến trúc mô hình cũng ghi nhận sự chuyển dịch sang xu hướng kiến trúc LLM 1-bit và 1.58-bit với việc thay thế lớp Linear truyền thống bằng lớp BitLinear:
- BitNet 1-bit: Trọng số
Wchỉ nhận hai giá trị\{-1, 1\}qua hàmsignum. - BitNet b1.58 (Ternary 1.58-bit): Trọng số nhận ba giá trị
\{-1, 0, 1\}thông qua thuật toán absmean quantization. Sự xuất hiện của giá trị0giúp triệt tiêu hoàn toàn phép nhân trong nhân ma trận, biến toàn bộ phép nhân GEMM thành các phép cộng/trừ đơn giản (1: cộng,-1: trừ,0: bỏ qua) và hỗ trợ lọc tính năng (feature filtering).
Đánh giá thực nghiệm cho thấy mô hình 13B BitNet b1.58 đạt độ trễ thấp hơn, giảm mạnh mức tiêu thụ VRAM và năng lượng so với một mô hình LLM 3B ở định dạng FP16 truyền thống.
Các thuật toán lượng tử hóa hiện đại: GPTQ, AWQ và bitsandbytes
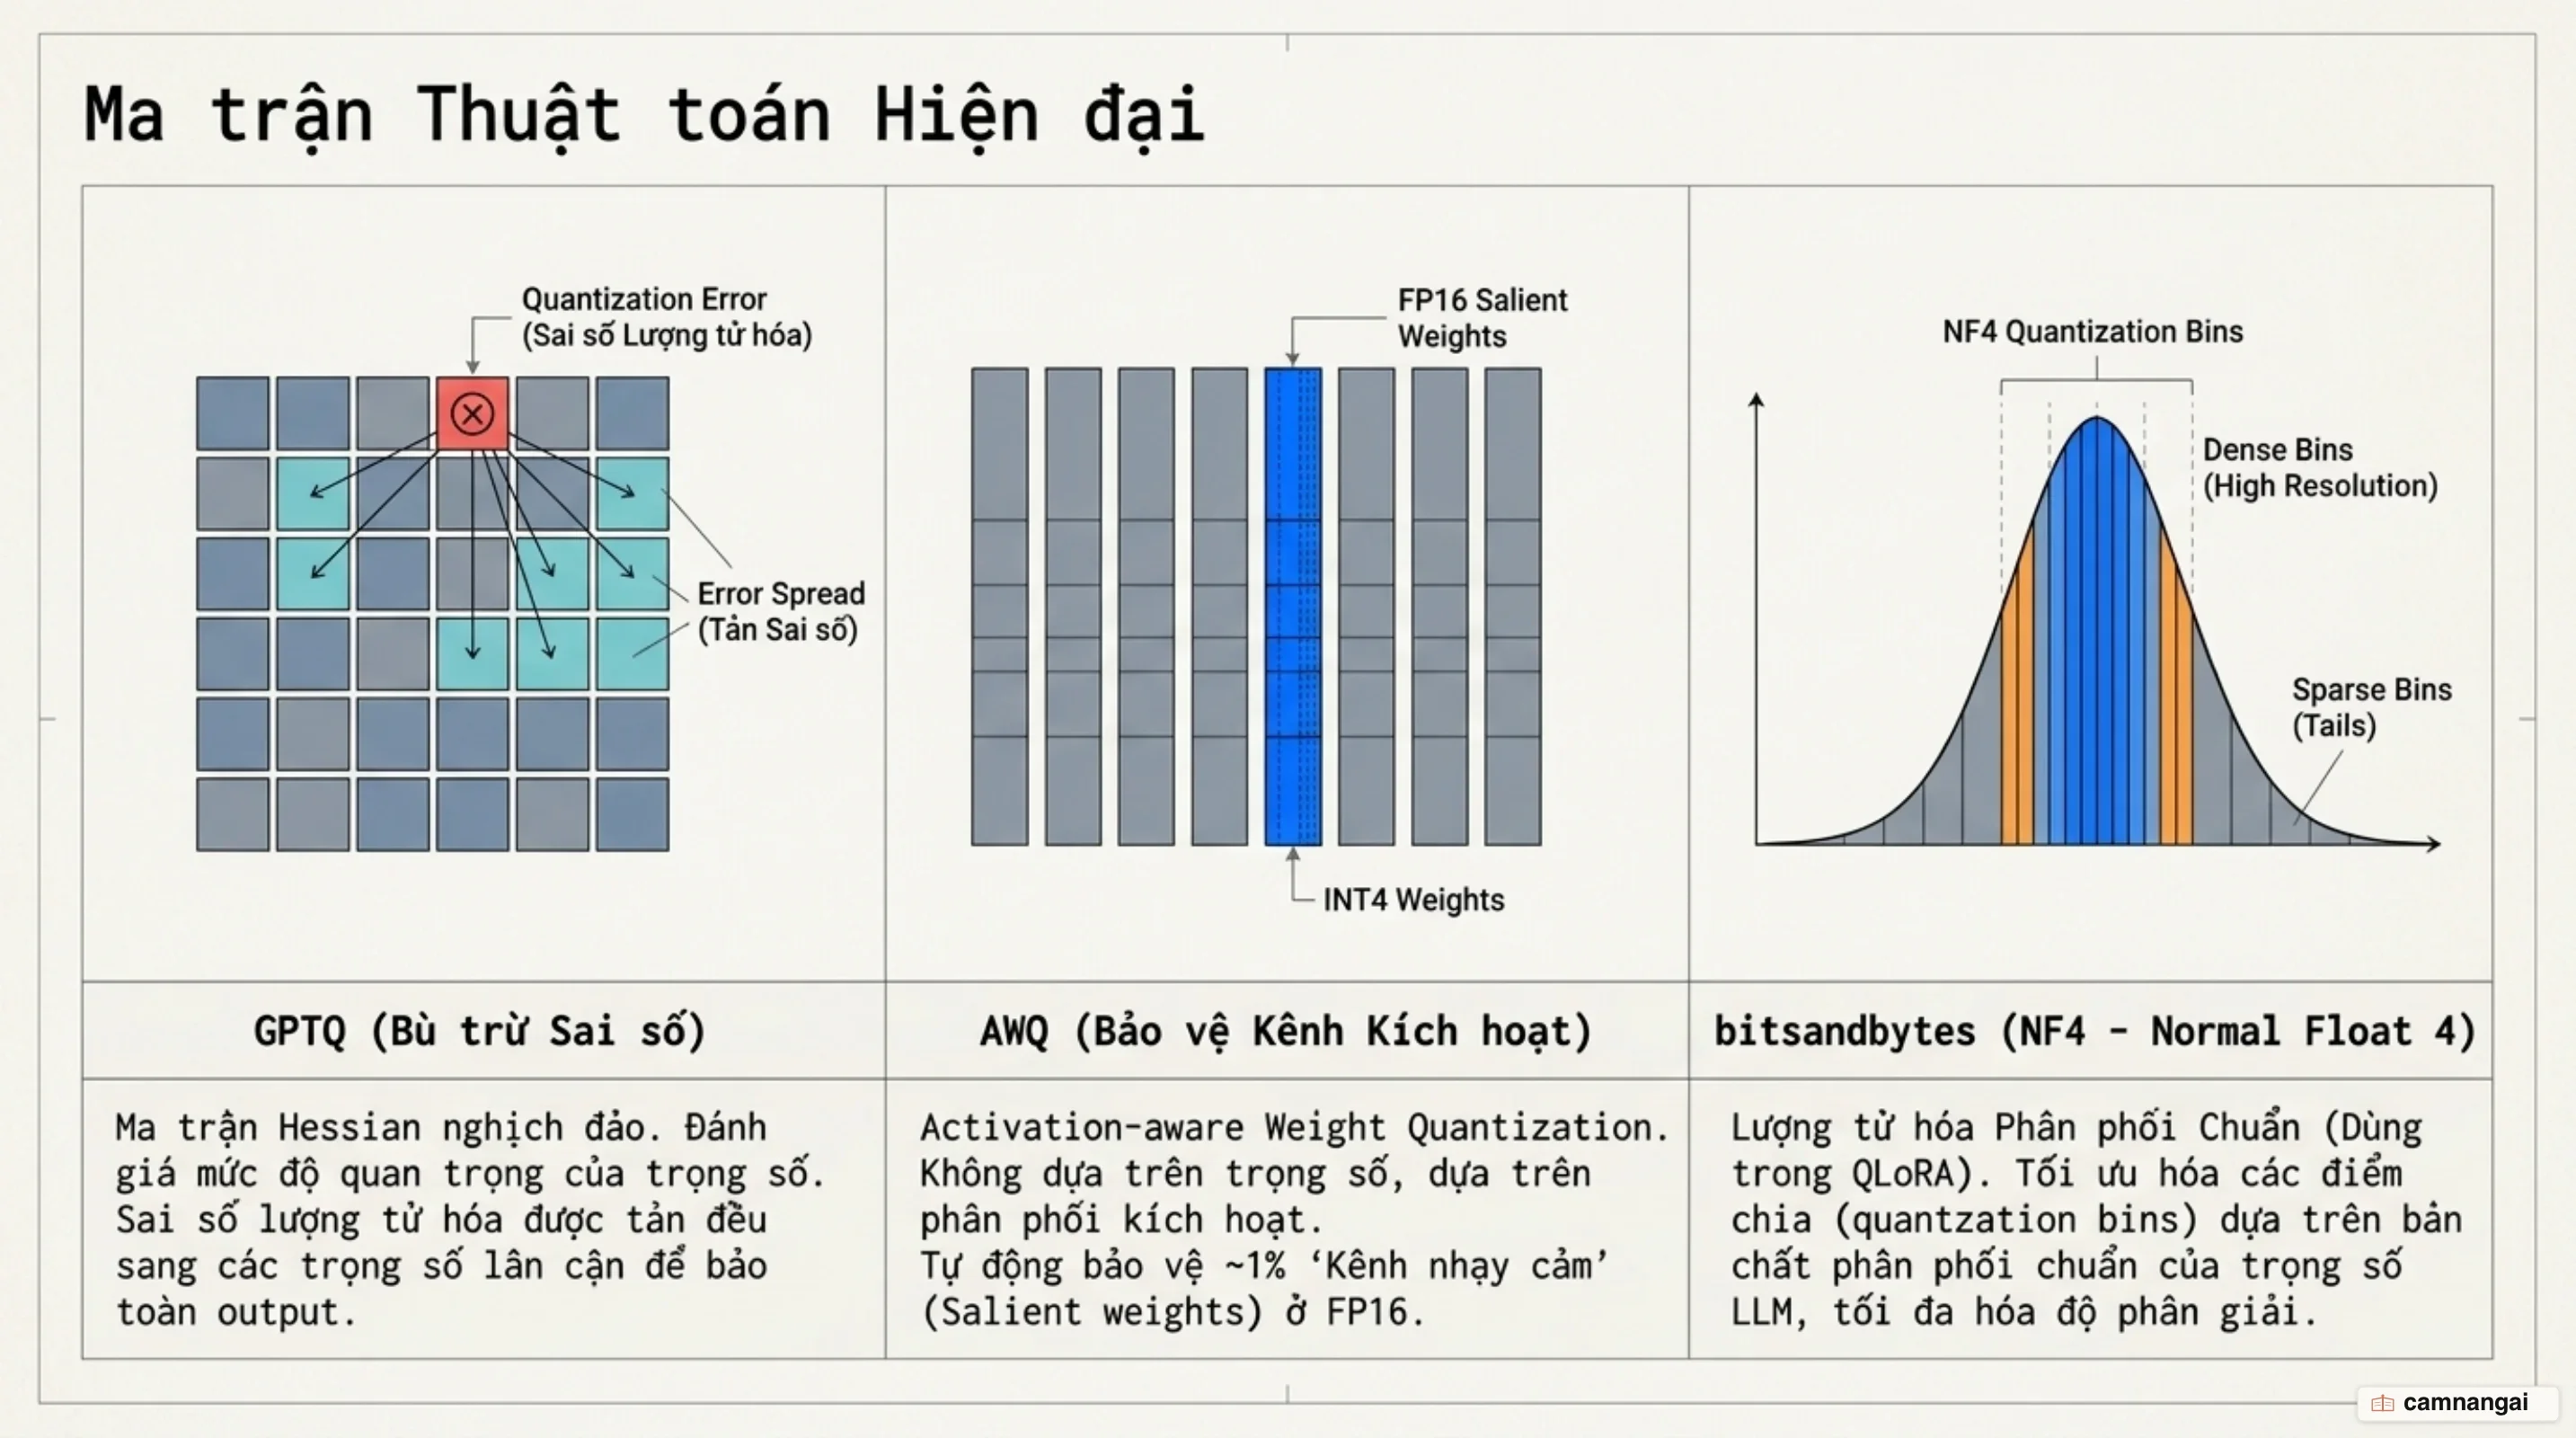
Thuật toán GPTQ áp dụng kỹ thuật nén PTQ từng lớp (layer-wise) dựa trên ma trận Hessian nghịch đảo (H^-1) để đo độ nhạy của hàm mất mát đối với từng trọng số. Cơ chế hoạt động: GPTQ lượng tử hóa từng trọng số trên mỗi hàng, tính toán sai số q, sau đó phân bổ và bù trừ sai số này (q × h) sang các trọng số chưa lượng tử hóa còn lại trong cùng hàng. Việc liên tục bù sai số dựa trên ma trận Hessian giúp GPTQ giữ vững cấu trúc đầu ra của mô hình ngay cả ở mức nén 4-bit.
AWQ (Activation-aware Weight Quantization) cải tiến bằng cách bảo vệ 1% trọng số quan trọng nhất dựa trên độ lớn của ma trận Activations thay vì chỉ nhìn vào giá trị trọng số tĩnh. Trong khi đó, thư viện bitsandbytes cung cấp kỹ thuật LLM.int8() (phân tách vector outlier sang FP16) và NF4 (NormalFloat 4-bit) dùng trong QLoRA. NF4 là kiểu dữ liệu lượng tử hóa dựa trên phân bố quantile tối ưu về mặt lý thuyết thông tin dành riêng cho trọng số có phân bố chuẩn N(0, ^2), giúp duy trì độ chính xác cao mà không cần bước calibration dữ liệu. Điểm mạnh của bitsandbytes là khả năng lượng tử hóa tức thì (zero-shot/on-the-fly) khi nạp mô hình vào VRAM.
| Tiêu chí | GPTQ | AWQ | bitsandbytes (4-bit NF4 / 8-bit) |
|---|---|---|---|
| Cần dữ liệu Calibration? | Có (yêu cầu tập dữ liệu chuẩn hóa) | Có (thu thập thống kê Activations) | Không (Lượng tử hóa zero-shot khi load) |
| Tốc độ Sinh chuỗi (Generate) | Rất nhanh (sử dụng kernel ExLlama/ExLlamaV2) | Rất nhanh (tối ưu hóa phần cứng tốt) | Chậm hơn (chủ yếu tối ưu tiết kiệm VRAM) |
| Fine-tune & Merge Adapter | Hỗ trợ fine-tune; không thể merge trực tiếp lên GPTQ gốc | Hỗ trợ PEFT / Fine-tune | Tối ưu nhất cho QLoRA; cho phép merge adapter lên model gốc |
| Khả năng Lưu trữ (Serialization) | Hỗ trợ lưu checkpoint 4-bit/2-bit cố định | Hỗ trợ lưu checkpoint 4-bit cố định | Hỗ trợ lưu 8-bit; 4-bit lưu qua cấu hình adapter |
Định dạng và triển khai thực tế: GGUF, llama.cpp và vLLM
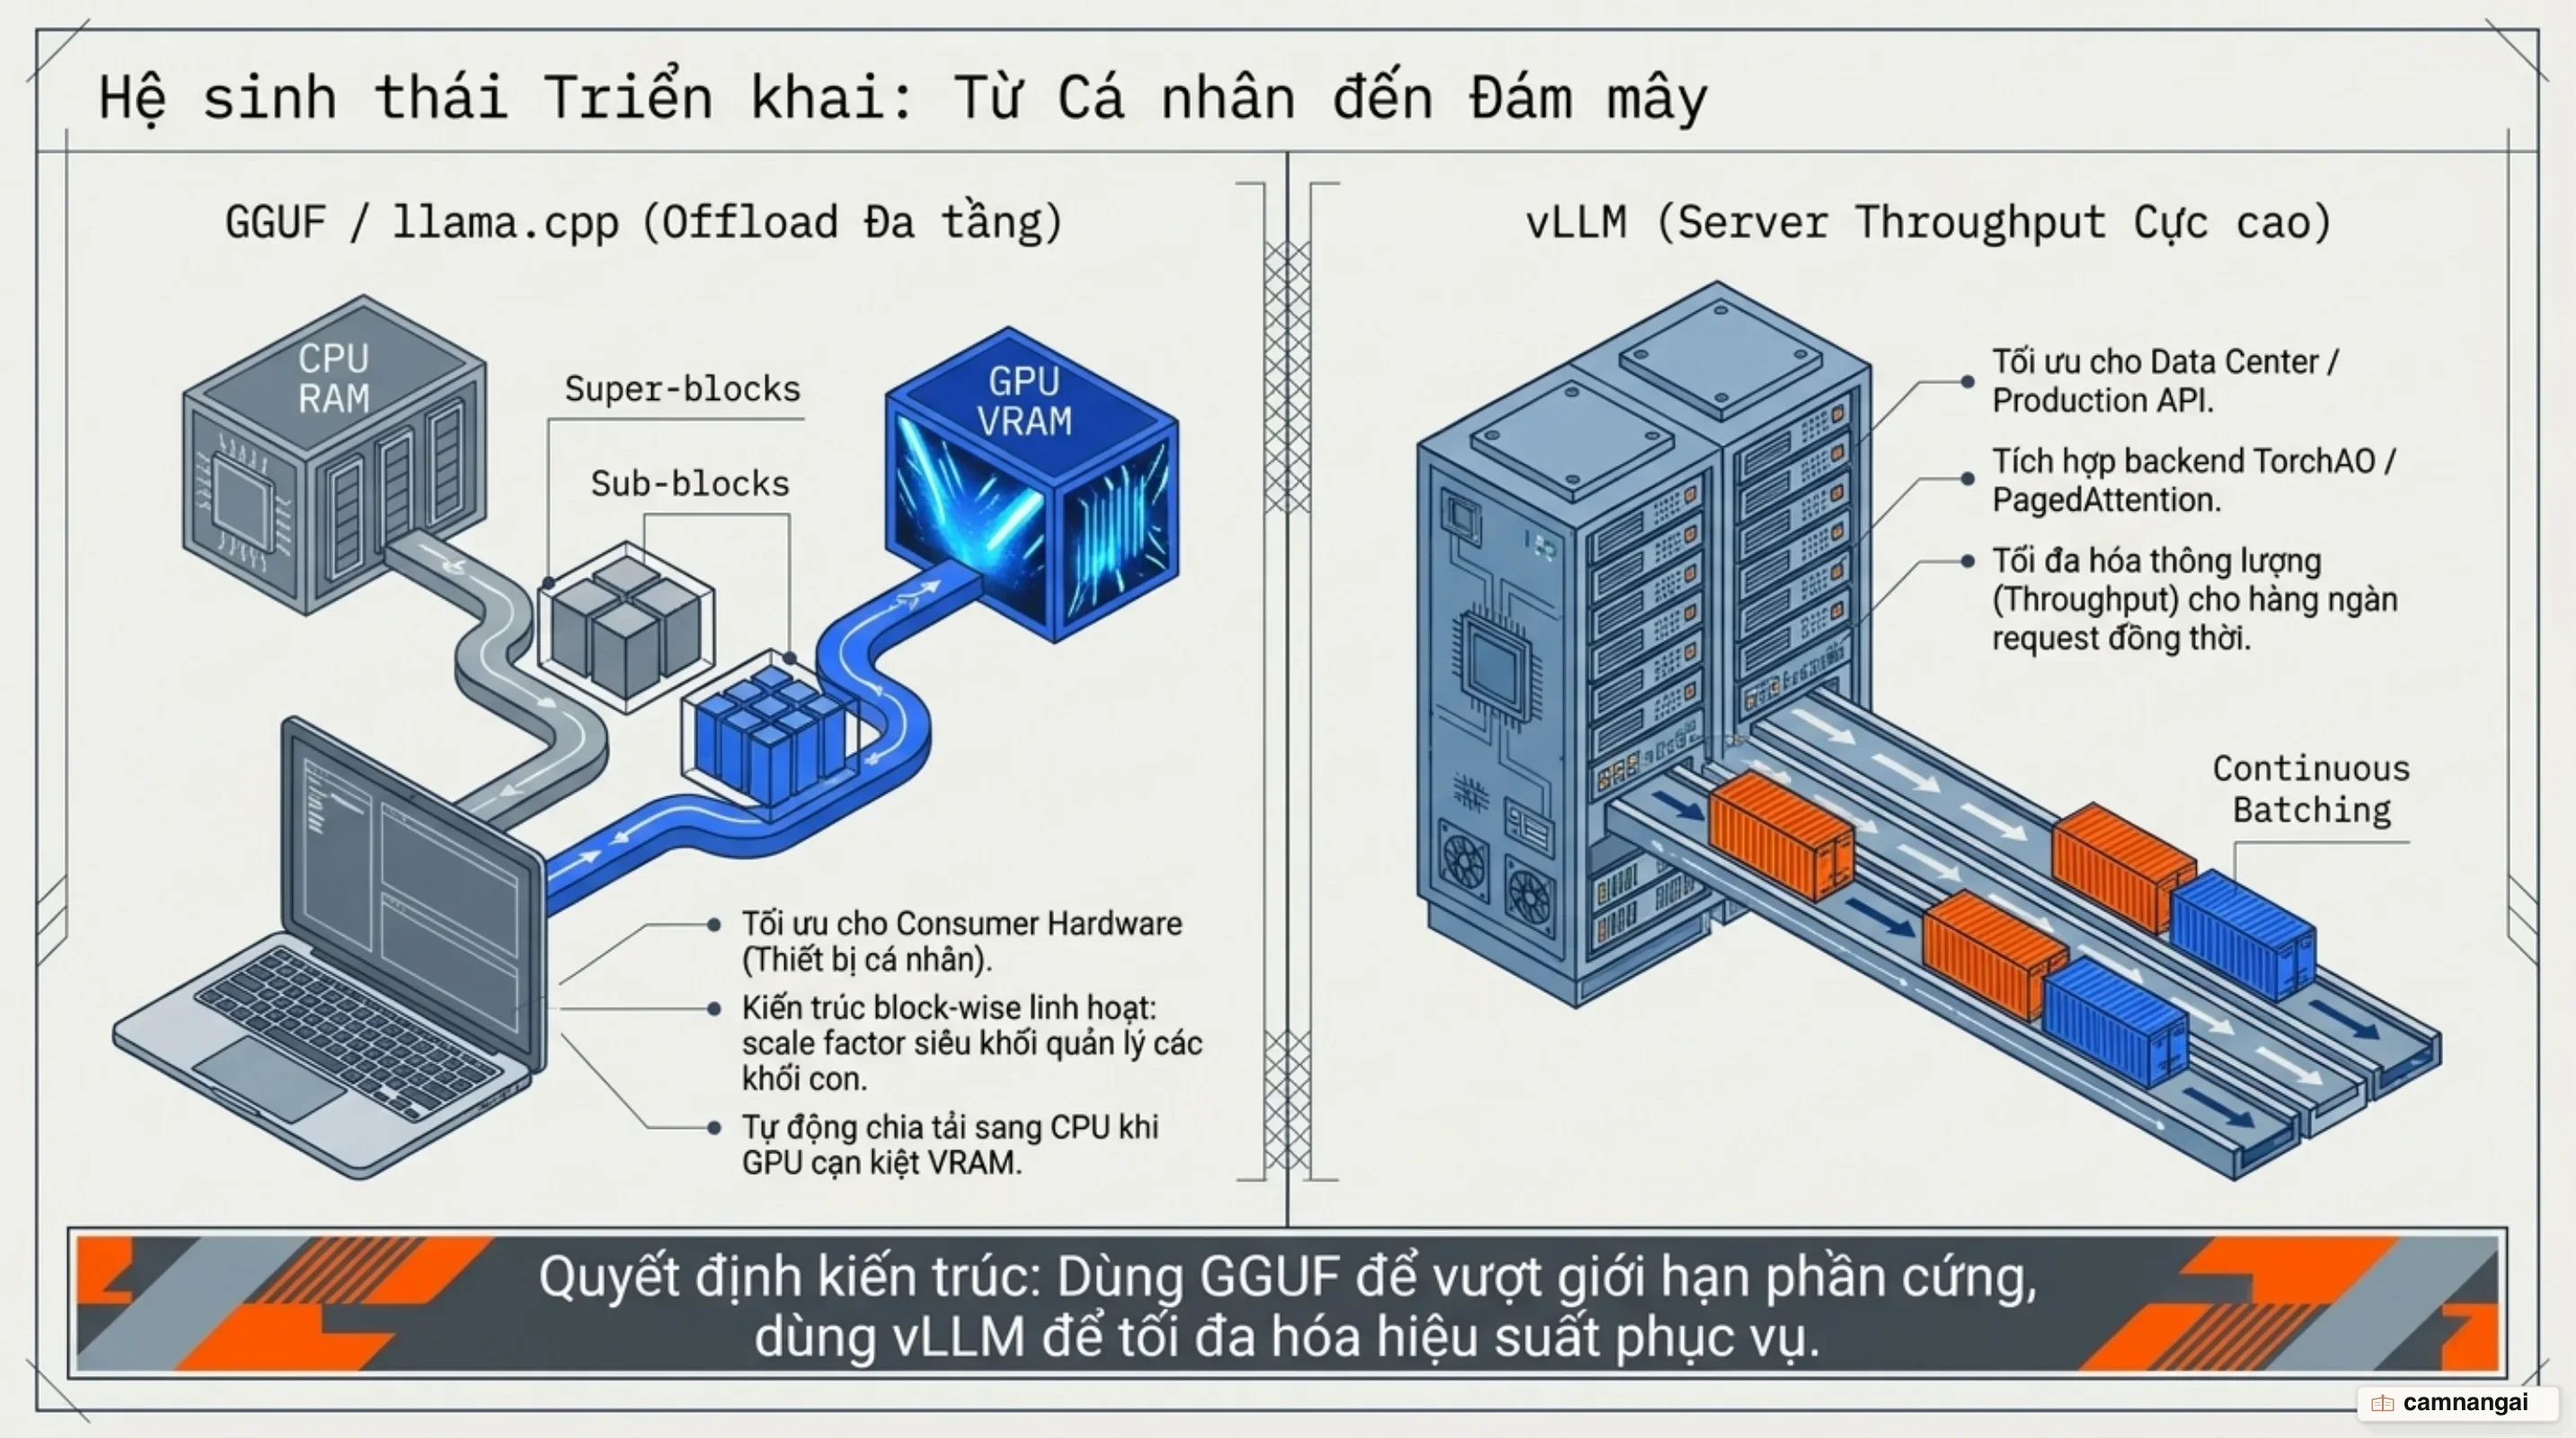
Định dạng GGUF (phát triển cùng hệ sinh thái llama.cpp) áp dụng cơ chế nén theo khối (Block-wise quantization). Trọng số được chia thành các super-blocks chứa nhiều sub-blocks. Hệ số Scale factor s_{sub} của khối nhỏ lại tiếp tục được lượng tử hóa bằng s_{super} của khối lớn, giảm tối đa bộ nhớ chứa hằng số scale. Ưu thế lớn của llama.cpp và GGUF là tính năng Offloading: cho phép đẩy từng phần hoặc toàn bộ các lớp (layers) sang CPU System RAM khi VRAM GPU không đủ chứa, tối ưu hoàn hảo cho các thiết bị Edge và phần cứng cá nhân.
Đối với môi trường Production quy mô lớn, thư viện TorchAO (PyTorch Native Quantization) được tích hợp trực tiếp vào các engine như vLLM hay SGLang. TorchAO cung cấp các cấu hình native như Float8DynamicActivationFloat8WeightConfig (FP8) hoặc Int4WeightOnlyConfig (INT4).
Đoạn mã Python dưới đây minh họa việc cấu hình và nạp một mô hình LLM được lượng tử hóa FP8 thông qua transformers và torchao:
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer, TorchAoConfig
from torchao.quantization import Float8DynamicActivationFloat8WeightConfig, PerRow

# Cấu hình lượng tử hóa FP8 động bằng TorchAO
quant_config = TorchAoConfig(
    quant_type=Float8DynamicActivationFloat8WeightConfig(granularity=PerRow())
)

# Nạp mô hình với torch_dtype=bfloat16 làm định dạng lưu trữ gốc trước khi TorchAO biến đổi các lớp Linear sang FP8 ở runtime
model_id = "Qwen/Qwen3-32B"
tokenizer = AutoTokenizer.from_pretrained(model_id)
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    device_map="auto",
    torch_dtype=torch.bfloat16,
    quantization_config=quant_config
)

# Thực thi suy luận
inputs = tokenizer("Nút thắt cổ chai bộ nhớ VRAM là gì?", return_tensors="pt").to("cuda")
outputs = model.generate(**inputs, max_new_tokens=50)
print(tokenizer.decode(outputs[0], skip_special_tokens=True))
Đánh đổi giữa dung lượng VRAM, độ trễ và độ chính xác (Perplexity)
Dữ liệu thực nghiệm khi lượng tử hóa các mô hình như Gemma3-12b hay Llama-3-8B xuống INT4 cho thấy dung lượng VRAM tiêu thụ giảm từ 58% đến 65%, đồng thời tốc độ suy luận tăng từ 1.73x đến 1.89x trên card đồ họa NVIDIA H100. Trên thiết bị di động như iPhone 15 Pro chạy ExecuTorch, mô hình Qwen3-4B INT8-INT4 đạt tốc độ suy luận 14.8 tokens/giây với dung lượng RAM chiếm dụng chỉ 3379 MB.
Tuy nhiên, việc cắt giảm bit sẽ dẫn đến suy giảm độ chính xác. Bảng điểm Open-LLM Leaderboard (trên các benchmark ARC, Hellaswag, MMLU, TruthfulQA) minh họa rõ ảnh hưởng theo quy mô tham số:
- Dòng 7B (Llama-2-7b): Điểm trung bình ở bản gốc FP16 là
54.32; nén qua 4-bit BNB giảm còn53.4; nén qua 4-bit GPTQ giảm còn53.23. - Dòng 13B (Llama-2-13b): Điểm trung bình ở bản gốc FP16 là
58.66; nén qua GPTQ 4-bit (act_order=True) đạt58.03; GPTQ 4-bit tiêu chuẩn đạt57.56; và BNB 4-bit đạt56.9.
Về mặt hệ thống: Các mô hình có kích thước tham số càng lớn (từ 13B, 30B đến 70B trở lên) càng ít bị suy giảm độ chính xác khi nén xuống 4-bit. Việc lựa chọn phương án thiết kế hệ thống là sự cân bằng giữa ba yếu tố: Độ trễ mỗi token (Per-token latency), Tổng số token/giây (Throughput), và Độ suy hao ngôn ngữ (Perplexity).
Chiến lược chọn phương pháp lượng tử hóa cho môi trường Production
Khung quyết định chọn giải pháp lượng tử hóa dành cho kỹ sư hạ tầng:
[Mục tiêu Hệ thống]
 ├── Thử nghiệm nhanh / Fine-tune GPU yếu  ──> bitsandbytes (4-bit NF4 / QLoRA)
 ├── Production High-Throughput (Server)  ──> GPTQ 4-bit hoặc FP8 (TorchAO / vLLM)
 ├── Chạy Local / Edge / Hybrid CPU-GPU   ──> GGUF qua llama.cpp / ExecuTorch
 └── Cần tối đa độ chính xác ở 4-bit       ──> Quy trình QAT (TorchTune / Unsloth)
- Thử nghiệm nhanh / Fine-tune tài nguyên thấp: Chọn
bitsandbytes(4-bit NF4 / QLoRA), nạp mô hình trực tiếp không cần tập dữ liệu hiệu chỉnh calibration. - Phục vụ Production Throughput cao trên GPU server (vLLM / SGLang): Chọn
GPTQ4-bit hoặcFP8(TorchAO/vLLM), tối ưu nhân Tensor Core, tốc độ sinh chuỗi token nhanh nhất cho nhiều truy vấn đồng thời. - Chạy Local / Edge Device / Hybrid CPU-GPU: Chọn
GGUFquallama.cpphoặc ExecuTorch, tận dụng bộ nhớ RAM hệ thống và offload linh hoạt từng phần mô hình giữa CPU và GPU. - Cần giữ tối đa độ chính xác ở định dạng 4-bit: Áp dụng quy trình
QAT(Quantization-Aware Training qua TorchTune, Unsloth, Axolotl) trước khi đóng gói mô hình triển khai chính thức.
Tài liệu tham khảo
- Quantization Overview — Hugging Face
- Overview of Natively Supported Quantization Schemes in 🤗 Transformers — Hugging Face
- Quantization for Neural Networks — Lei Mao
- A Visual Guide to Quantization — Maarten Grootendorst
- TorchAO: Architecture Optimization and Quantization — PyTorch
- A Survey of Low-bit Large Language Models: Basics, Systems, and Algorithms — arXiv
- AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration — arXiv
- GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers — arXiv