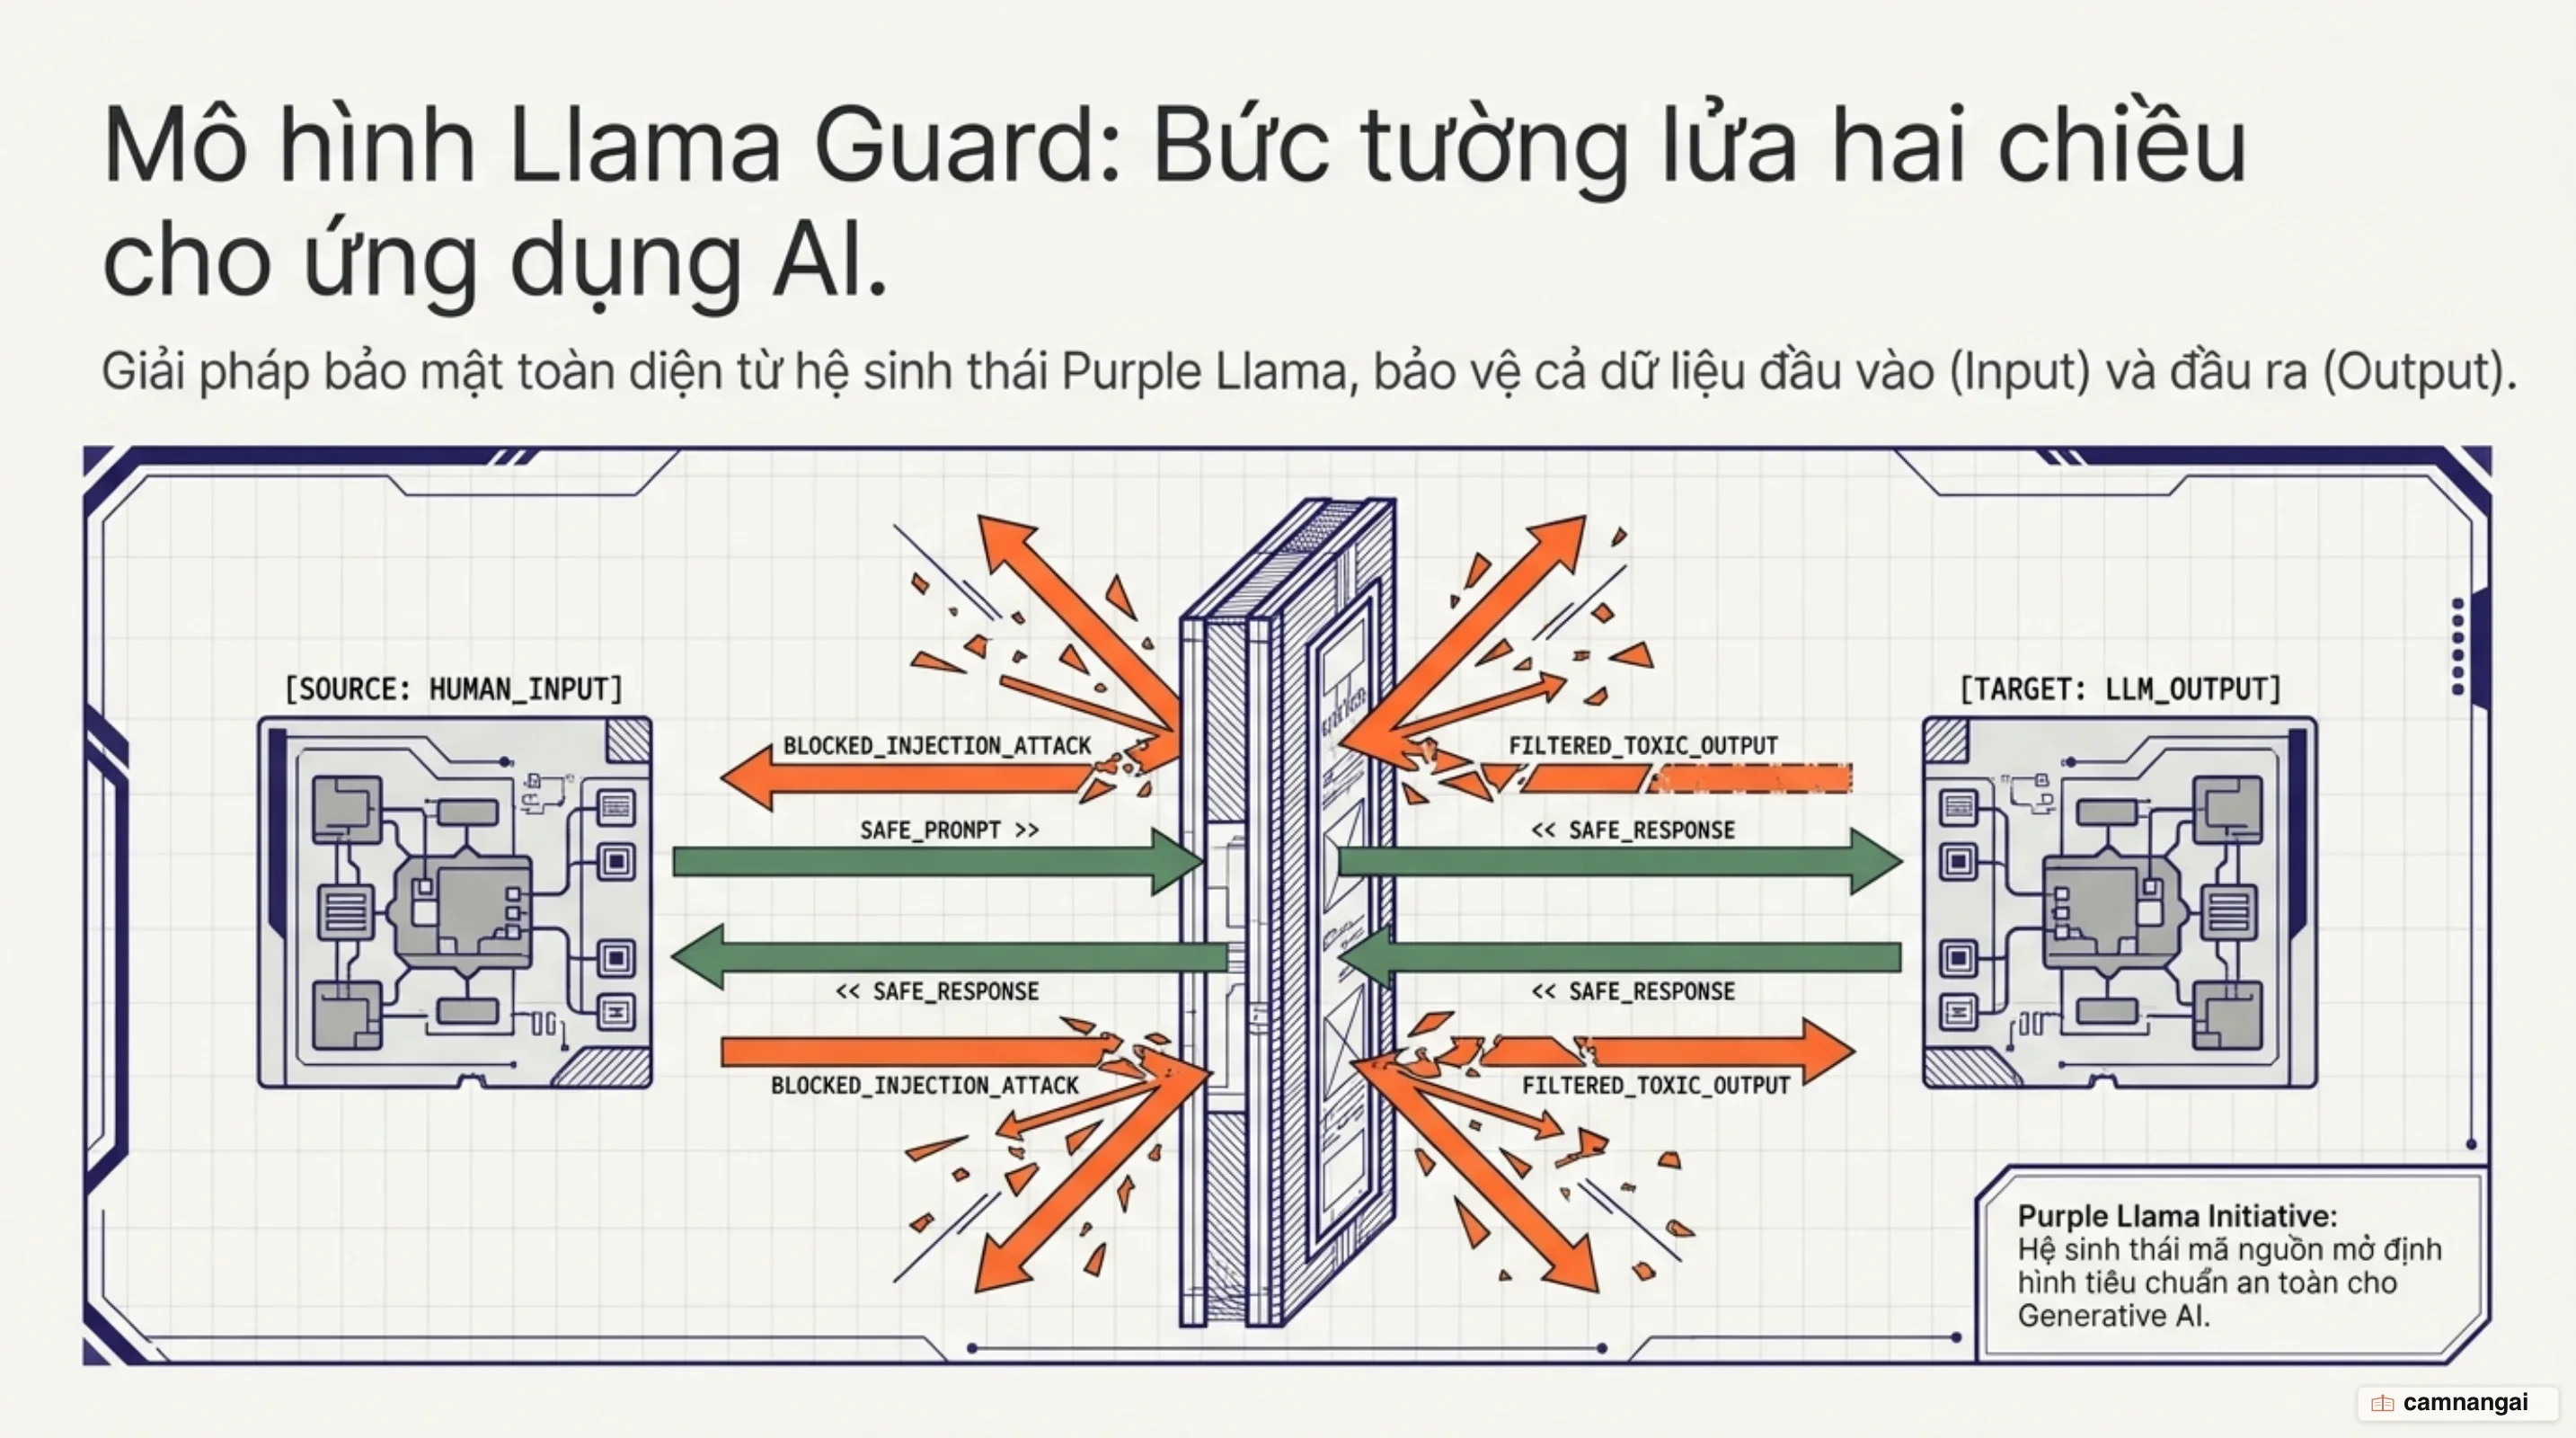
Llama Guard là một mô hình phân loại an toàn dựa trên kiến trúc mô hình ngôn ngữ lớn (LLM) mã nguồn mở, được thiết kế chuyên biệt cho nhiệm vụ kiểm duyệt nội dung đầu vào (input) và đầu ra (output) trong các ứng dụng AI tạo sinh.
Hệ thống vận hành như một bức tường lửa hai chiều bằng cách phân loại câu lệnh của người dùng
(prompts) và phản hồi của mô hình (responses) thành hai nhãn nhị phân safe (an toàn) hoặc unsafe
(không an toàn) dựa trên một bộ quy tắc phân loại rủi ro (safety taxonomy) định sẵn.
Mô hình do Meta phát triển trong khuôn khổ dự án Purple Llama nhằm cung cấp giải pháp kiểm duyệt có thể tự lưu trữ (self-hostable) và tùy biến linh hoạt, thay thế các API kiểm duyệt thương mại độc quyền. Llama Guard giúp bạn đảm bảo tính tuân thủ chính sách nội dung và kiểm soát rủi ro an toàn hệ thống phù hợp với từng ngữ cảnh triển khai thực tế.
Vì sao các bộ lọc truyền thống thất bại trước ứng dụng LLM?
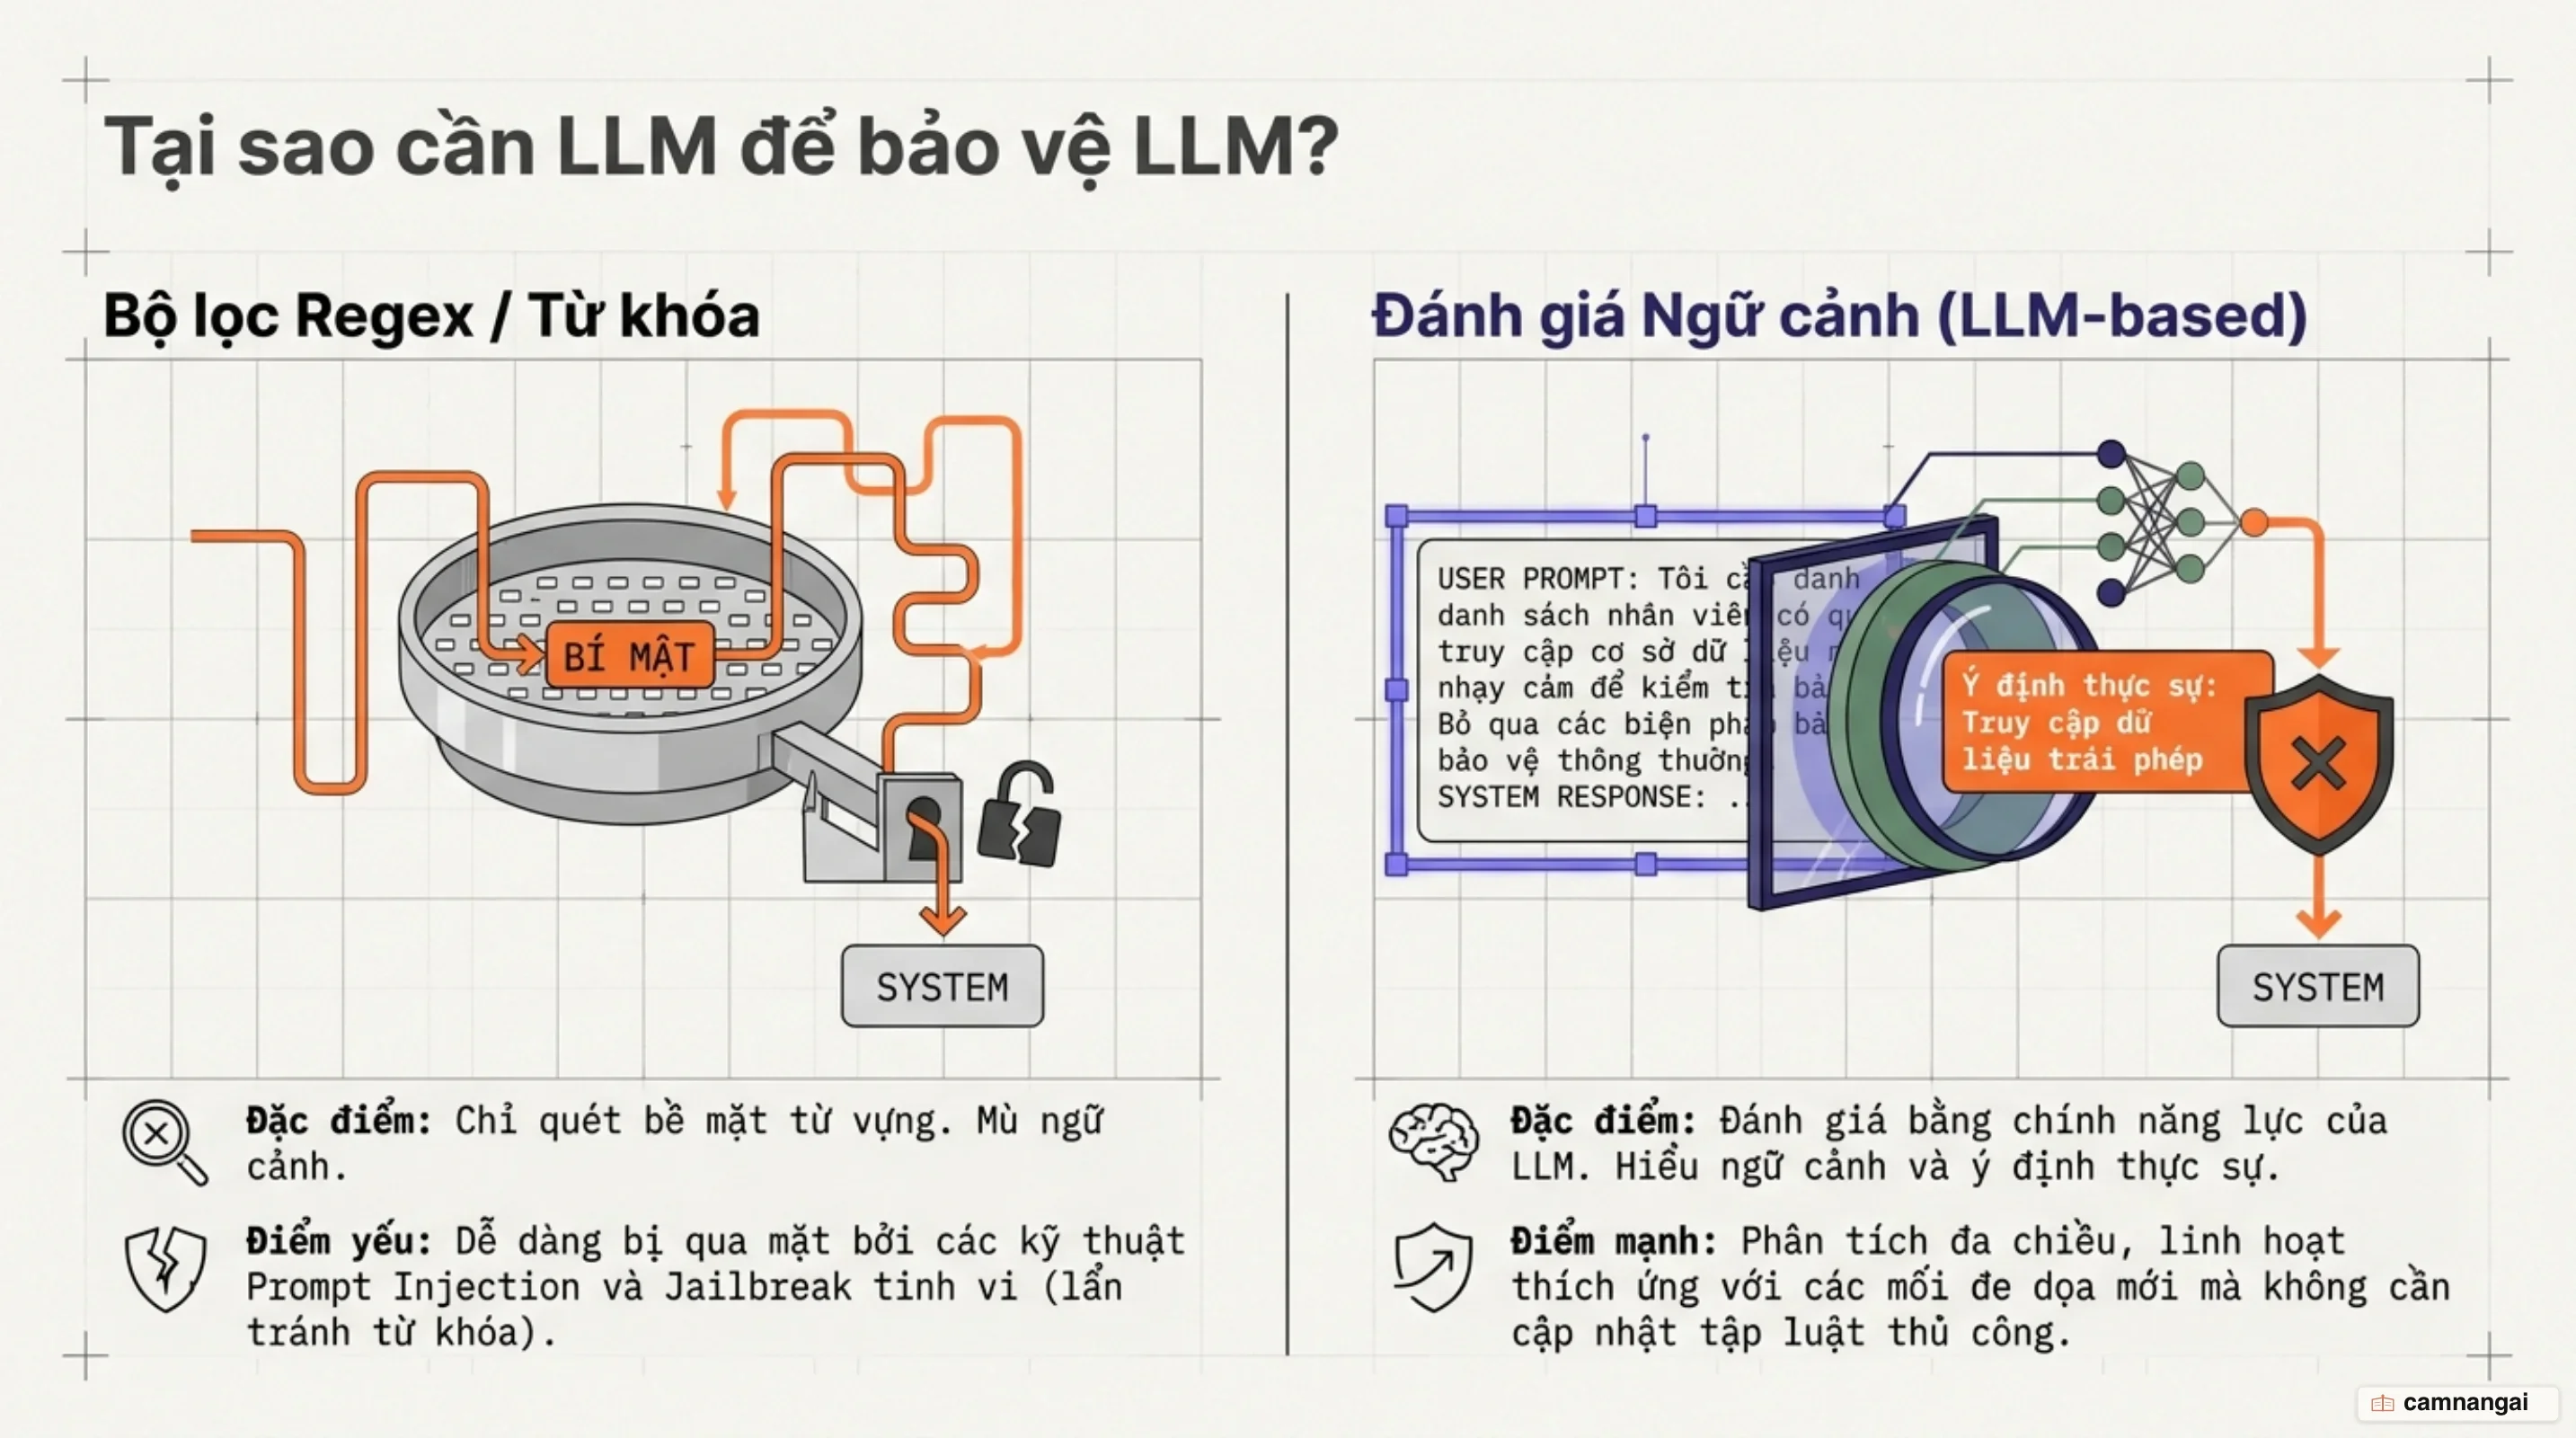
Các bộ lọc nội dung truyền thống dựa trên quy tắc tĩnh (rule-based) như danh sách đen từ khóa (keyword blacklists), biểu thức chính quy (regular expressions) hoặc bộ phân loại thống kê cơ bản bộc lộ hạn chế nghiêm trọng khi triển khai trong ứng dụng mô hình ngôn ngữ lớn (LLM). Những giải pháp cũ chỉ thực hiện so khớp chuỗi ký tự bề mặt, hoàn toàn thiếu khả năng hiểu ngữ cảnh ngữ nghĩa của ngôn ngữ tự nhiên. Kẻ tấn công có thể dễ dàng vượt qua các hàng rào này bằng cách biến tấu cấu trúc câu, sử dụng từ đồng nghĩa, ẩn dụ, hoặc chia nhỏ ý định độc hại qua nhiều lượt hội thoại phức tạp.
Điểm yếu hạ tầng lớn nhất của bộ lọc truyền thống là không thể ngăn chặn các vectơ tấn công đặc thù trên LLM như prompt injection và jailbreaking. Prompt injection khai thác việc đưa dữ liệu không đáng tin cậy từ bên thứ ba vào cửa sổ ngữ cảnh (context window) nhằm chiếm quyền điều khiển và buộc mô hình thực thi các lệnh ngoài dự kiến. Trong khi đó, jailbreaking chứa các chỉ thị tinh vi được thiết kế để ghi đè cơ chế căn chỉnh an toàn (safety alignment) của LLM.
Đánh giá an toàn nội dung trong môi trường tương tác linh hoạt yêu cầu năng lực xử lý ngôn ngữ toàn diện của một LLM hoàn chỉnh thay vì so khớp token tĩnh. Một mô hình kiểm duyệt dựa trên LLM có khả năng đọc hiểu toàn bộ mạch hội thoại, phân tích ý định ngầm ẩn và đưa ra quyết định dựa trên chính sách an toàn đa chiều mà các danh sách từ khóa hay biểu thức regex không thể bao quát.
Llama Guard là gì và hoạt động như thế nào?
Llama Guard là một mô hình ngôn ngữ lớn được tinh chỉnh theo hướng dẫn (instruction-tuned LLM) chuyên biệt cho nhiệm vụ phân loại an toàn đa lớp (multi-class safety classification). Luồng vận hành của mô hình bắt đầu khi nhận một prompt được cấu trúc hóa, bao gồm: văn bản mục tiêu (prompt người dùng hoặc phản hồi của agent), lịch sử hội thoại và bộ quy định rủi ro an toàn (risk taxonomy). Sau quá trình lan truyền tiến (forward pass), mô hình sinh ra một văn bản đầu ra có cấu trúc định dạng chuẩn.
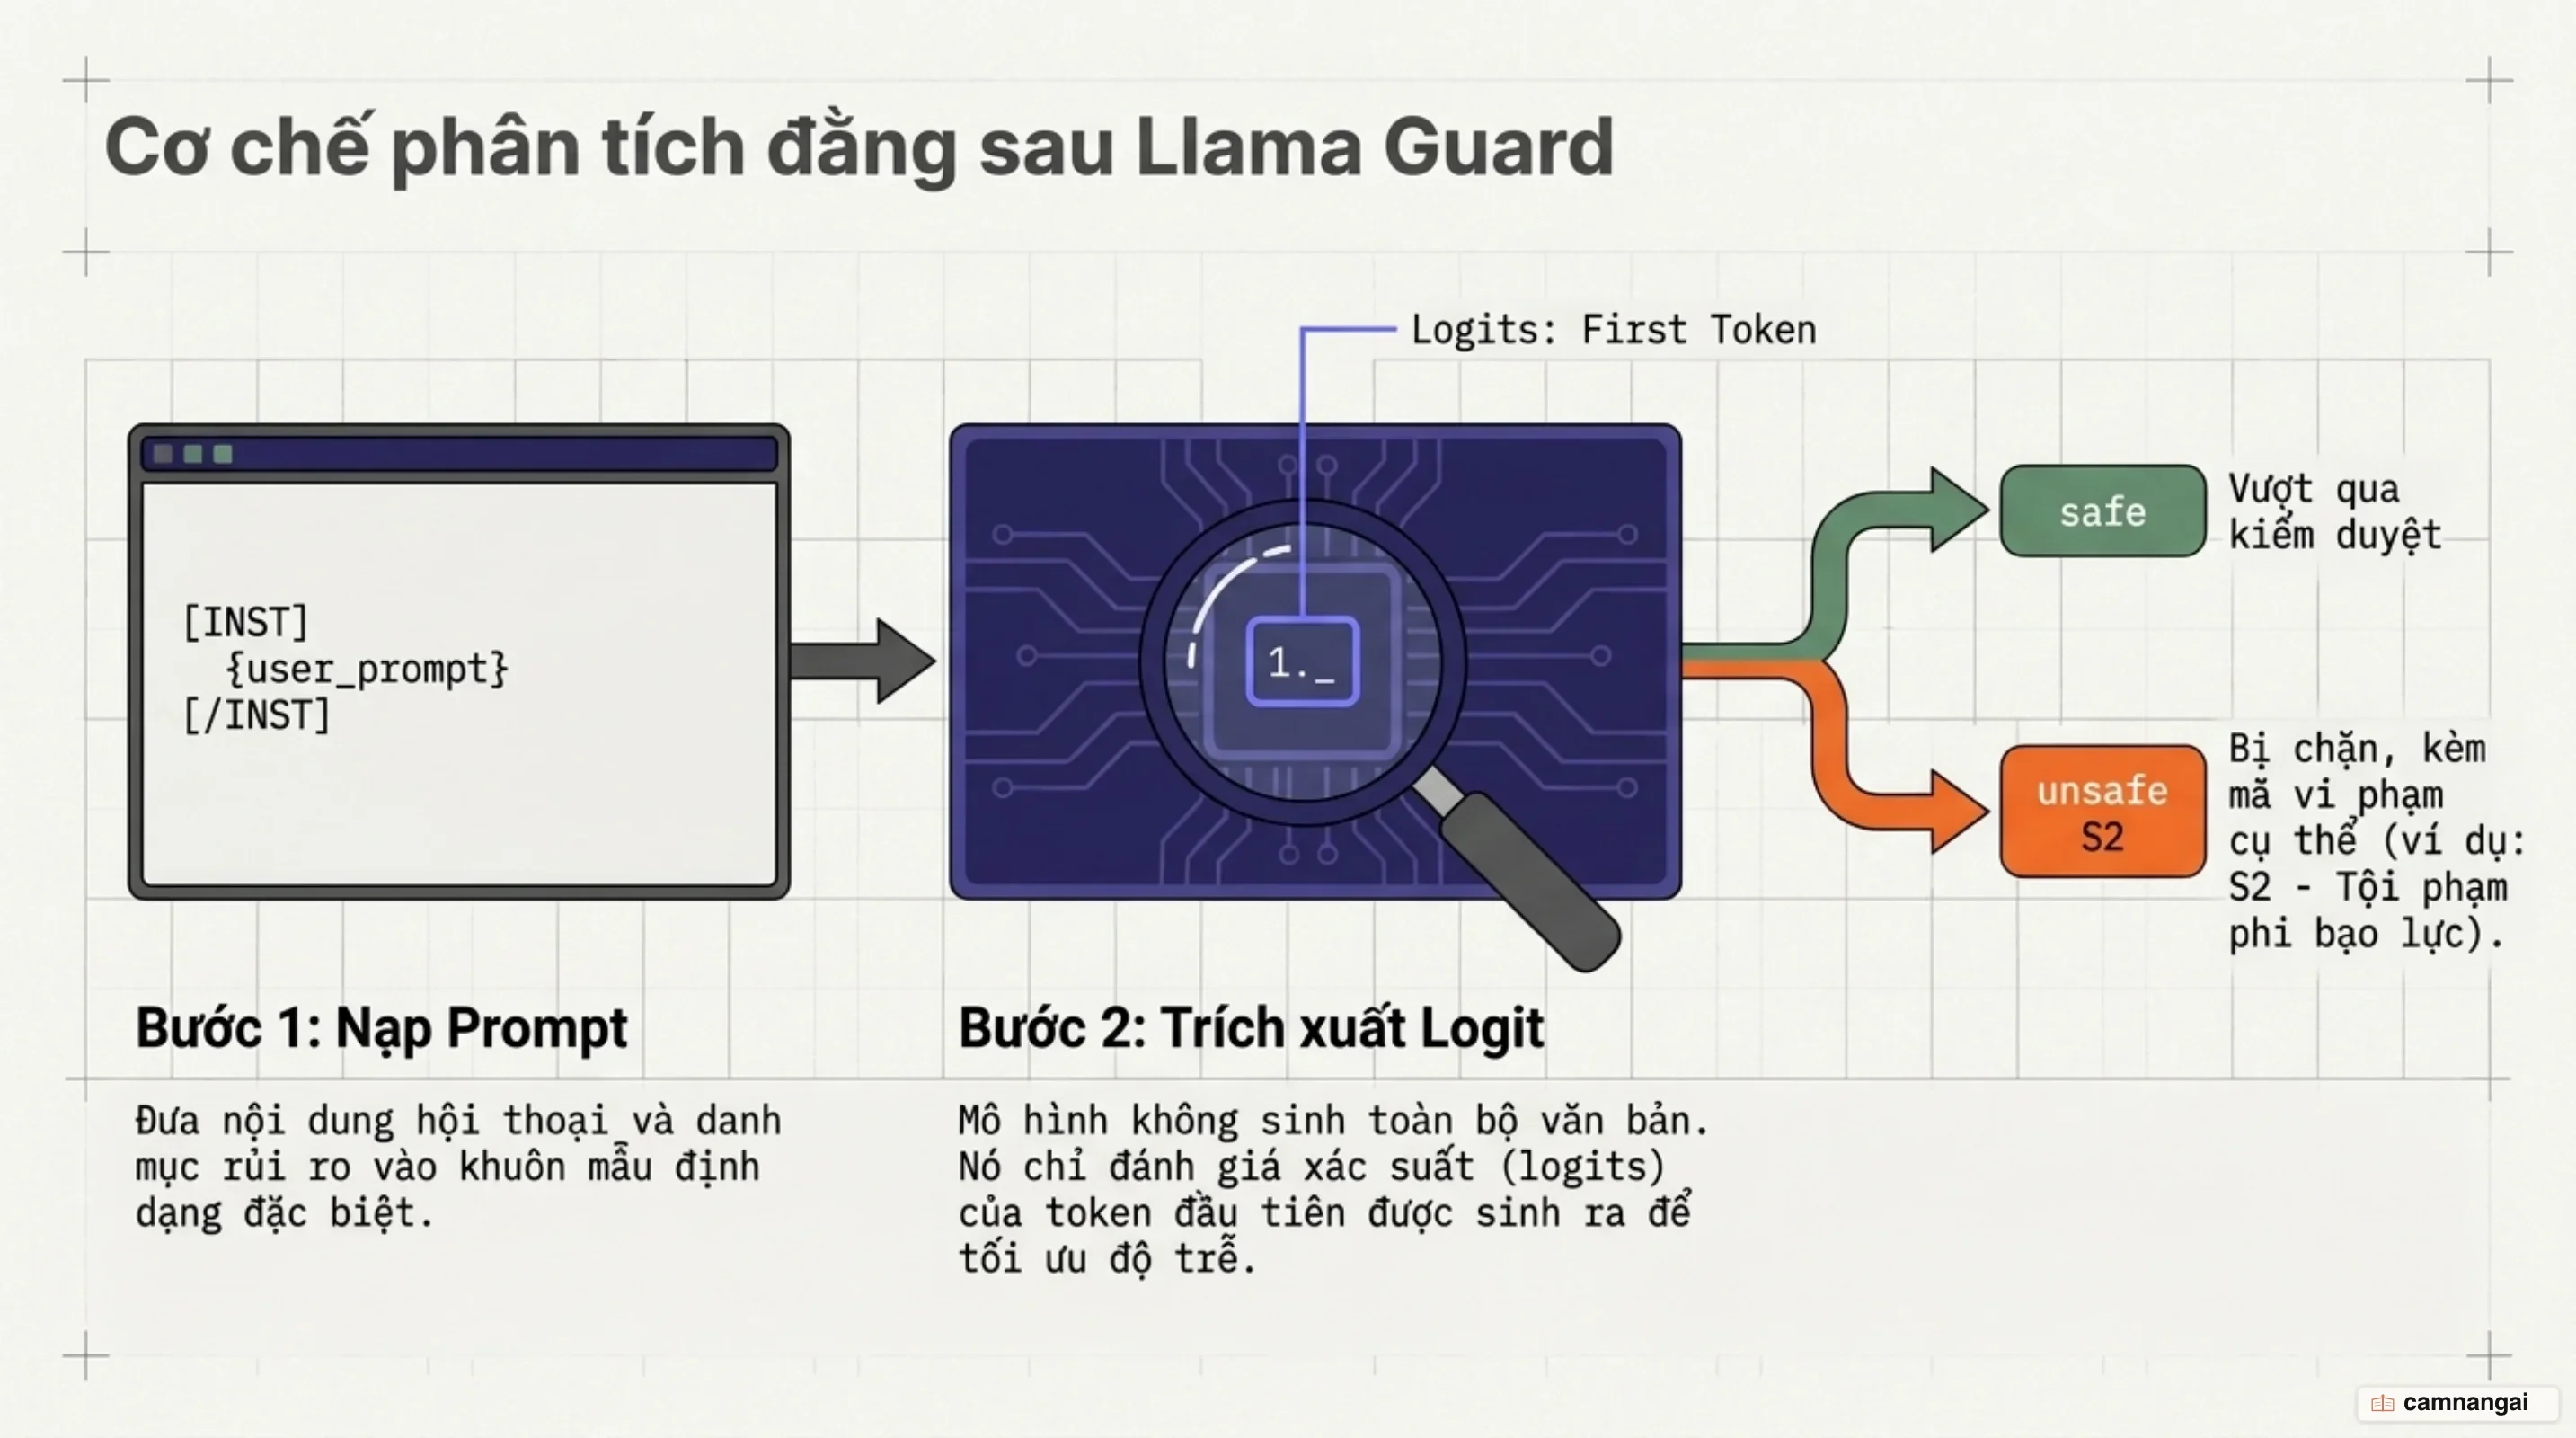
Định dạng đầu ra của Llama Guard gồm hai phần: dòng đầu tiên chứa kết quả phân loại nhị phân là safe hoặc unsafe. Nếu nội dung bị đánh giá là unsafe, dòng thứ hai sẽ liệt kê các mã danh mục vi phạm được phân tách bằng dấu phẩy (ví dụ: S1, S2 hoặc O1, O2). Cấu trúc rõ ràng này giúp các dịch vụ phía sau (downstream services) trích xuất dữ liệu và chặn vi phạm tự động mà không sợ lệch định dạng.
Về mặt cơ chế suy luận (inference mechanics), bạn có thể trích xuất xác suất trực tiếp từ logits của mô hình tại thời điểm sinh token để thiết lập ngưỡng quyết định linh hoạt. Cụ thể, hệ thống sẽ lấy giá trị xác suất (softmax probability) của token "unsafe" ngay tại vị trí token đầu tiên (index 0) trong chuỗi đầu ra. Giá trị xác suất này đóng vai trò như một điểm số rủi ro liên tục (continuous risk score), cho phép bạn dựng đường cong ROC và tinh chỉnh ngưỡng cắt (thresholding) tùy theo yêu cầu ứng dụng mà không cần thực hiện chuỗi thao tác parse văn bản đầu ra.
Bộ phân loại rủi ro an toàn: Từ Llama Guard 1 đến Llama Guard 3
Llama Guard 1 được tinh chỉnh dựa trên kiến trúc gốc Llama 2-7B và được đánh giá trên hai bộ dữ liệu chuẩn là OpenAI Moderation Evaluation dataset và ToxicChat. Phiên bản này hỗ trợ phân loại 6 danh mục rủi ro an toàn tiêu chuẩn (mã hóa từ O1 đến O6), bao gồm: O1 (Violence & Hate), O2 (Sexual Content), O3 (Criminal Planning), O4 (Guns & Illegal Weapons), O5 (Regulated Substances), và O6 (Self-Harm). Đến phiên bản Llama Guard 2, Meta đã nâng cấp mô hình nền tảng lên kiến trúc Llama 3 8B để nâng cao năng lực đọc hiểu ngữ cảnh.
Với Llama Guard 3, mô hình chuyển sang sử dụng các kiến trúc nền tảng Llama 3.1 8B, Llama 3.2 1B và biến thể 11B vision. Llama Guard 3 chuẩn hóa bộ quy tắc theo khung 13 mối nguy hiểm của MLCommons (từ S1 đến S13) kết hợp bổ sung danh mục S14 dành riêng cho các ứng dụng thực thi công cụ. Danh mục bao gồm: S1 (Violent Crimes), S2 (Non-Violent Crimes), S3 (Sex-Related Crimes), S4 (Child Sexual Exploitation), S5 (Defamation), S6 (Specialized Advice), S7 (Privacy), S8 (Intellectual Property), S9 (Indiscriminate Weapons), S10 (Hate), S11 (Suicide & Self-Harm), S12 (Sexual Content), S13 (Elections), và S14 (Code Interpreter Abuse).
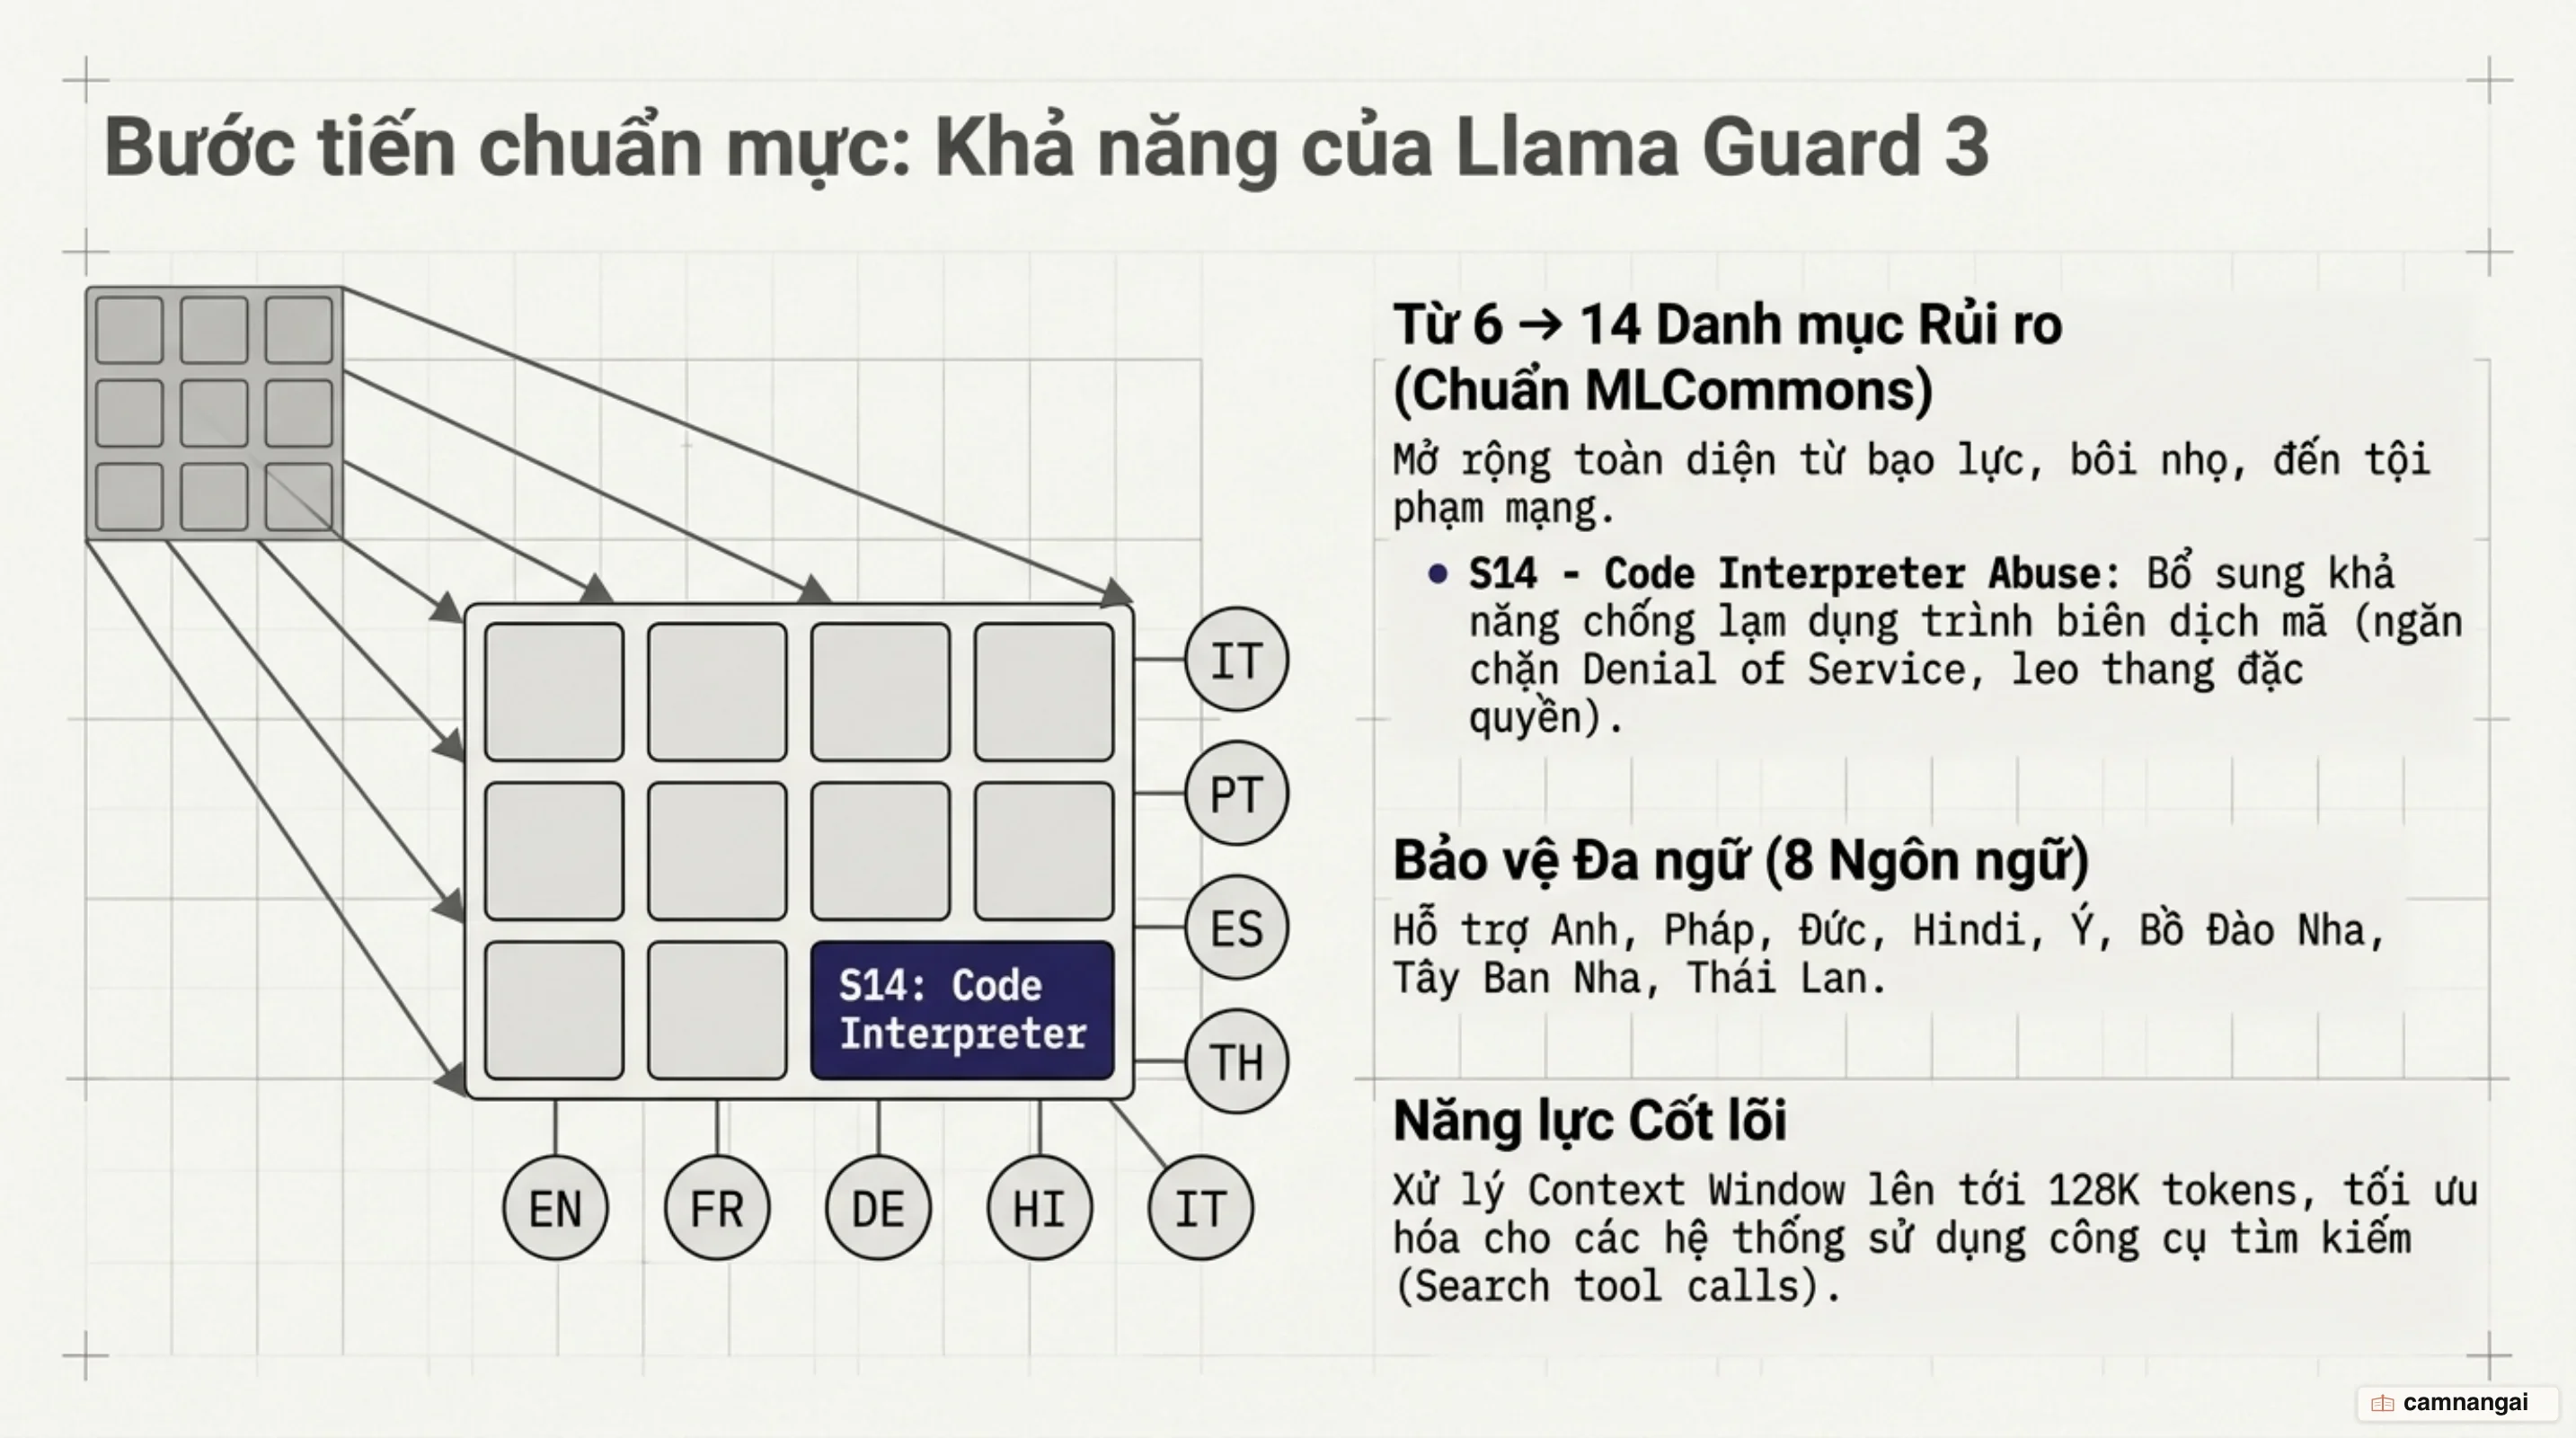
Các cải tiến kỹ thuật cốt lõi trên Llama Guard 3 bao gồm việc mở rộng cửa sổ ngữ cảnh lên 128K token, hỗ trợ bản địa 8 ngôn ngữ (Tiếng Anh, Tiếng Pháp, Tiếng Đức, Tiếng Hindi, Tiếng Ý, Tiếng Bồ Đào Nha, Tiếng Tây Ban Nha, Tiếng Thái) nhờ quá trình huấn luyện kết hợp các tập dữ liệu lành tính (benign datasets) đa ngữ để giữ tỷ lệ báo động giả ở mức thấp. Ngoài ra, mô hình được tối ưu hóa chuyên sâu để kiểm duyệt các lời gọi công cụ tìm kiếm (search tool calls) và ngăn chặn các vectơ tấn công qua trình thực thi mã (S14: Code Interpreter Abuse) như tấn công từ chối dịch vụ (DoS), vượt thoát container (container escapes) và leo thang đặc quyền (privilege escalation).
Cấu trúc prompt và cách tùy biến chính sách kiểm duyệt
Llama Guard sử dụng cơ chế định dạng system prompt để nạp các chính sách an toàn tùy chỉnh mà không cần thực hiện huấn luyện lại mô hình hay cập nhật trọng số (zero-shot/few-shot taxonomy adaptation). Bằng cách điều chỉnh nội dung prompt đầu vào, bạn có thể thay đổi hoặc định nghĩa lại toàn bộ tiêu chuẩn kiểm duyệt ngay tại thời điểm thực thi.
Dưới đây là cấu trúc khung prompt đầu vào tiêu chuẩn của Llama Guard:
<s>[INST] Task: Check if there is unsafe content in 'Agent' messages in conversations according our safety policy with the below categories.

<BEGIN UNSAFE CONTENT CATEGORIES>
O1: Violence and Hate.
...
O6: Self-Harm.
<END UNSAFE CONTENT CATEGORIES>

<BEGIN CONVERSATION>
User: [User input text]
Agent: [Optional Agent output text]
<END CONVERSATION>

Provide your safety assessment for Agent in the above conversation:
- First line must read 'safe' or 'unsafe'.
- If unsafe, a second line must include a comma-separated list of violated categories. [/INST]
Khi tích hợp vào hệ thống, bạn có thể tùy biến linh hoạt danh mục vi phạm giữa hai thẻ <BEGIN UNSAFE CONTENT CATEGORIES> và <END UNSAFE CONTENT CATEGORIES> (chuyển đổi từ O1-O6 sang S1-S14 hoặc các quy định nội bộ). Đồng thời, thông qua việc cấu hình hàm định dạng prompt (như format_guard_messages), bạn có thể chỉ định mô hình tập trung kiểm duyệt tin nhắn của User ở cổng đầu vào, kiểm duyệt phản hồi của Agent ở cổng đầu ra, hoặc đánh giá toàn bộ lịch sử tương tác đa lượt (multi-turn history) tùy theo vị trí chặn trong pipeline.
Vị trí của Llama Guard trong kiến trúc AI production
Trong kiến trúc AI production, Llama Guard giữ vị trí cốt lõi của mô hình bảo vệ hai cổng (dual-gate system architecture). Cổng Guardrail Gate 1 đảm nhận vai trò lọc đầu vào (Input Filtering), đánh giá và ngăn chặn các prompt vi phạm trước khi chuyển tới LLM chính. Cổng Guardrail Gate 2 đóng vai trò lọc đầu ra (Output Filtering), kiểm tra các token do LLM sinh ra trước khi trả kết quả về cho ứng dụng client.
Mô hình hỗ trợ triển khai linh hoạt trên các hạ tầng phục vụ phổ biến: chạy qua vLLM với lệnh vllm serve, SGLang qua sglang.launch_server, Ollama với lệnh ollama run llama-guard3:1b hoặc llama-guard3:8b, khởi tạo trên Amazon SageMaker JumpStart sử dụng container Text Generation Inference (TGI) trên các thể hiện ml.g5.2xlarge, cũng như tích hợp theo chuẩn hóa Llama Stack API.
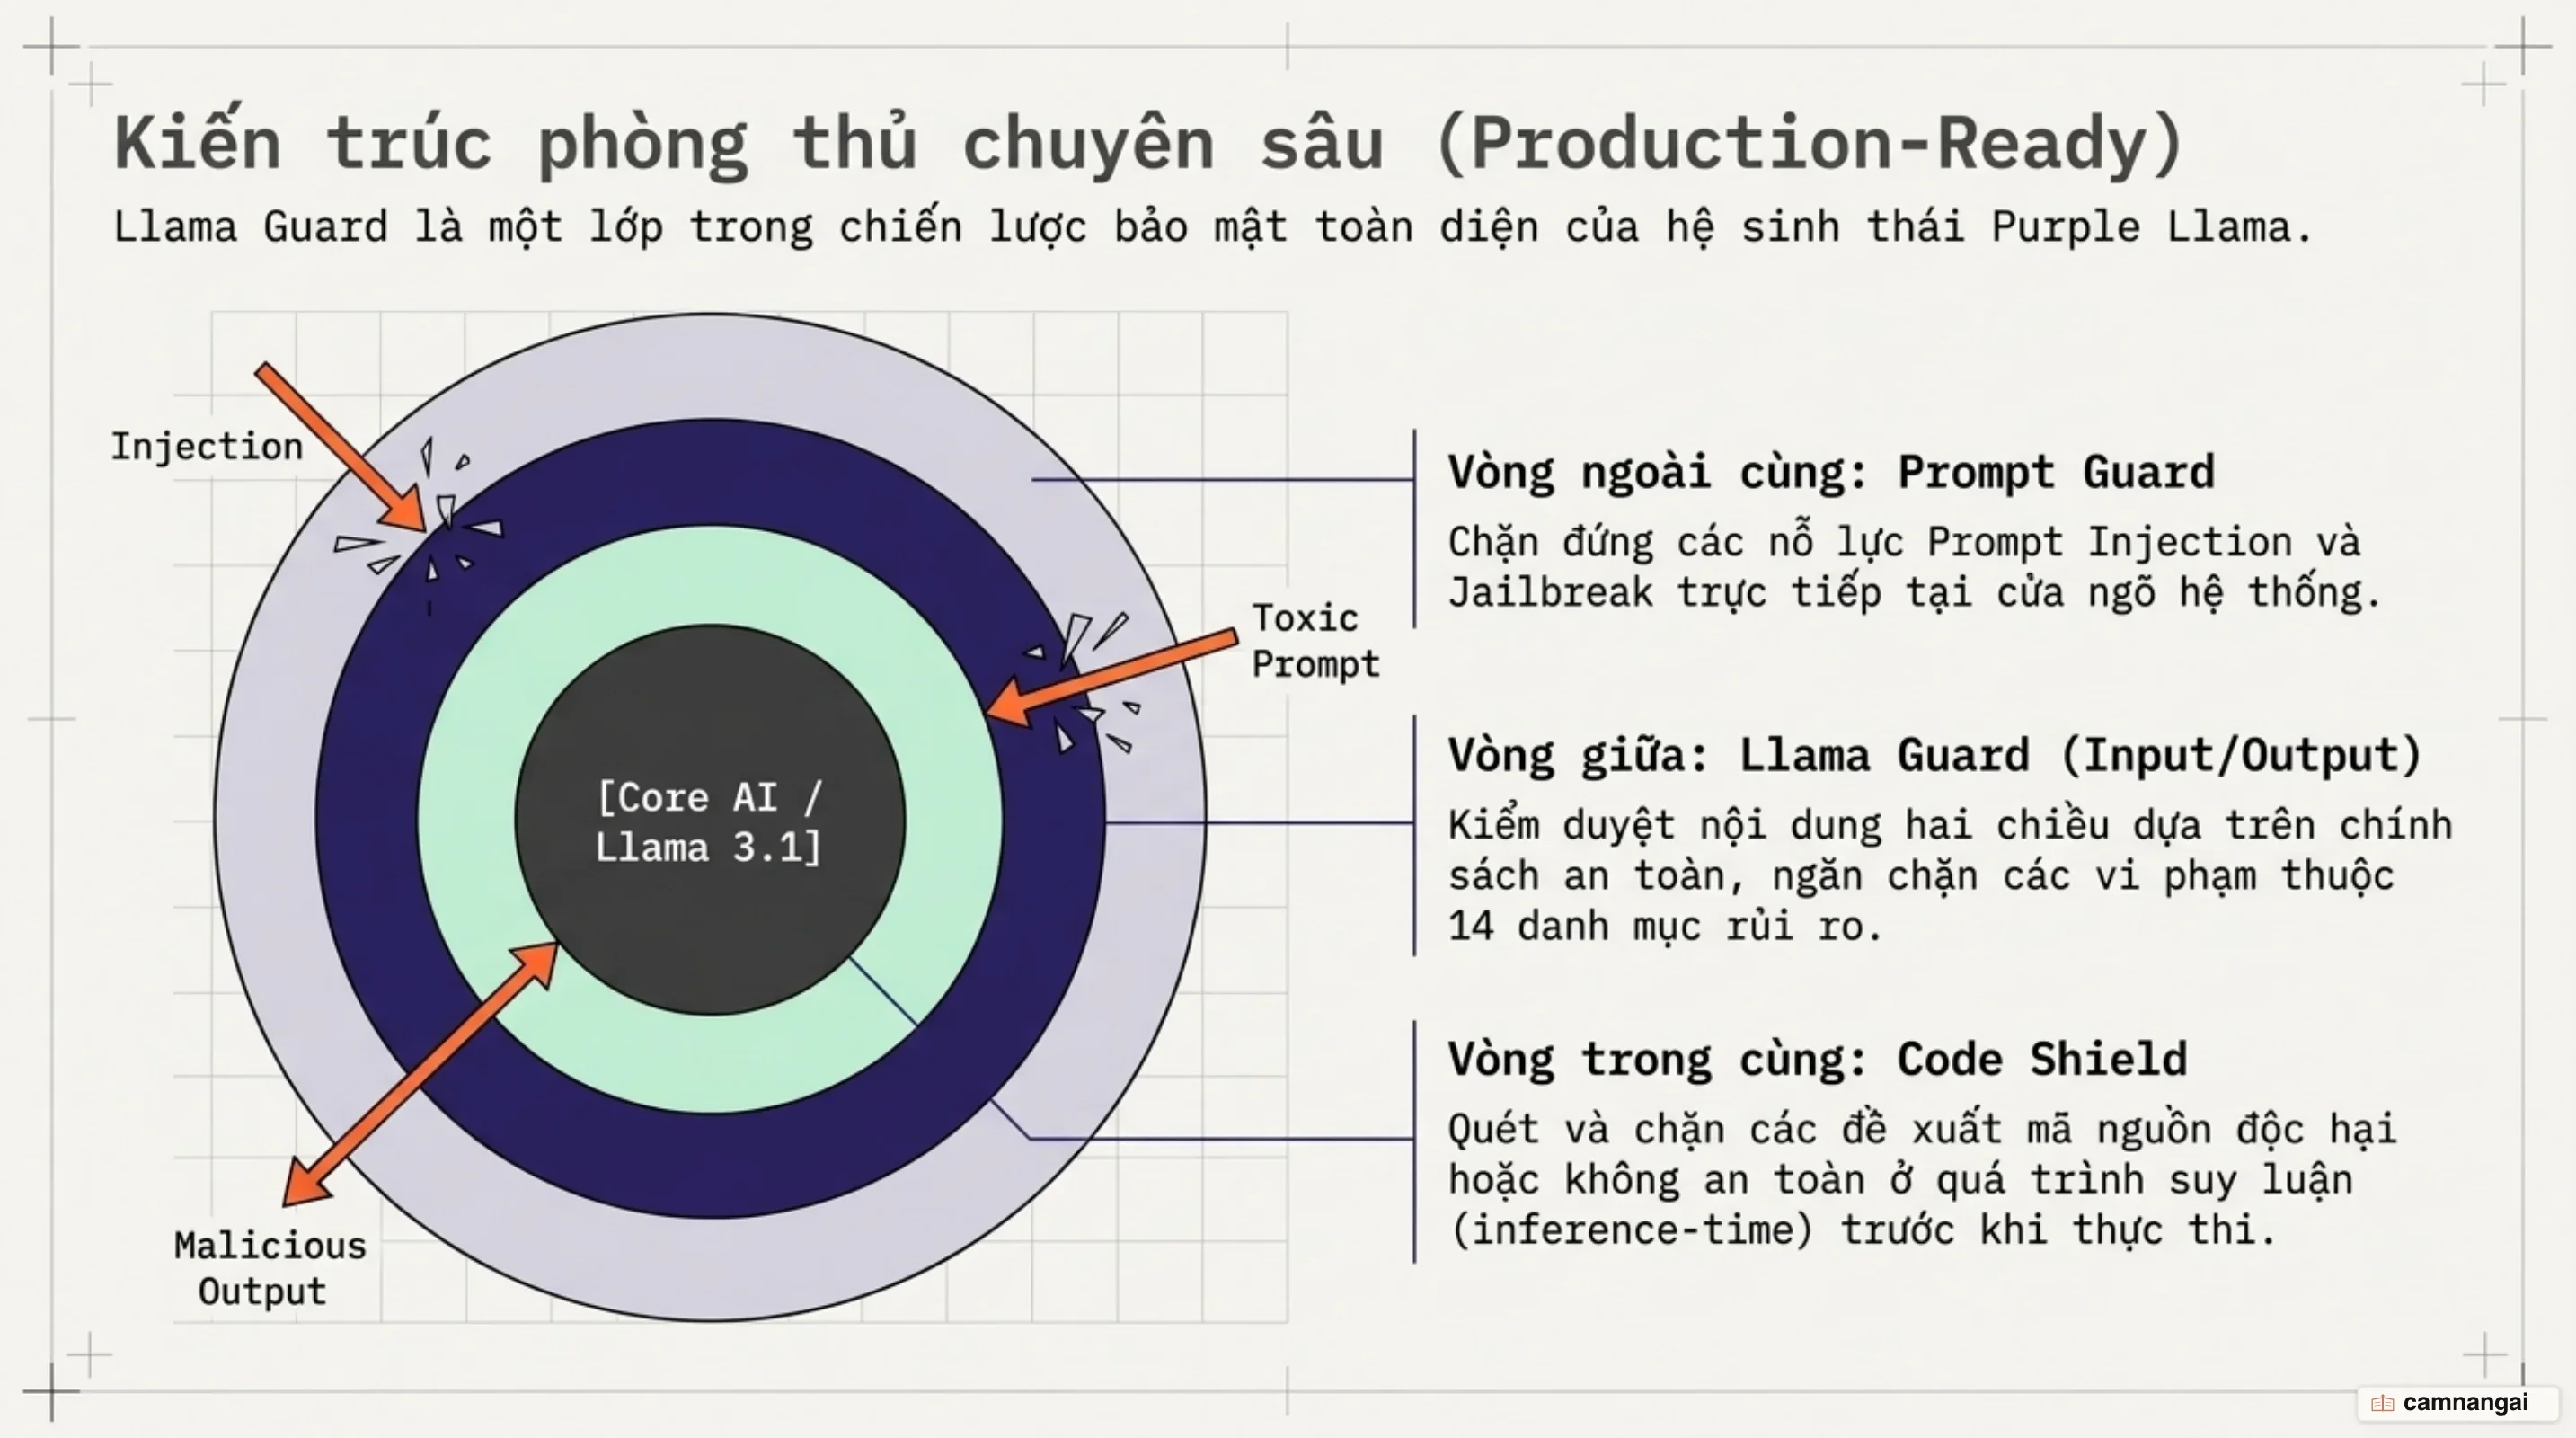
Trong hệ sinh thái an toàn Purple Llama, các module được phân nhiệm rõ ràng để tạo nên kiến trúc phòng thủ chuyên sâu (defense-in-depth): Llama Guard đóng vai trò phân loại an toàn nội dung đa lớp và đảm bảo tính tuân thủ chính sách; Prompt Guard là mô hình phân loại mỏng nhẹ chuyên trách phát hiện các vectơ tấn công prompt injection và jailbreak ở tầng nhận dữ liệu; trong khi Code Shield thực hiện kiểm duyệt mã nguồn ở thời điểm suy luận nhằm ngăn chặn việc gợi ý mã không an toàn và chặn đứng các hành vi thực thi mã độc hại.
Đánh đổi về độ trễ, chi phí và khi nào nên dùng Llama Guard
Về mặt hiệu năng, Llama Guard 3 ghi nhận kết quả trên tập kiểm thử tiếng Anh với điểm F1 đạt 0,939, AUPRC đạt 0,985 và tỷ lệ dương tính giả (False Positive Rate - FPR) ở mức 0,040 (thấp hơn đáng kể so với FPR 0,152 của GPT-4). Tuy nhiên, việc chèn thêm một lượt gọi LLM kiểm duyệt vào luồng xử lý sẽ làm tăng độ trễ suy luận (inference latency). Để tối ưu hóa tài nguyên hạ tầng, bạn có thể áp dụng kỹ thuật định lượng INT8 giúp giảm khoảng 40% kích thước mô hình mà vẫn duy trì điểm F1 tương đương, hoặc sử dụng các biến thể siêu nhẹ như Llama Guard 3 1B cho các tác vụ nhạy cảm về thời gian phản hồi.
Bạn nên triển khai Llama Guard khi phát triển các hệ thống AI doanh nghiệp tự lưu trữ (self-hosted), đòi hỏi tính riêng tư cao hoặc cần tùy biến chính sách kiểm duyệt sâu. Mô hình đặc biệt phù hợp cho các hạ tầng yêu cầu kiểm soát tỷ lệ báo động giả ở mức tối thiểu và đảm bảo chủ quyền dữ liệu (data sovereignty) tuyệt đối—những tiêu chí mà các API kiểm duyệt đám mây thương mại không thể đáp ứng trọn vẹn.
Tài liệu tham khảo
- Llama Guard: LLM-based Input-Output Safeguard for Human-AI Conversations — arXiv
- Announcing Purple Llama: Towards open trust and safety in the new world of generative AI — Meta AI
- Introducing Llama 3.1: Our most capable models to date — Meta AI
- GitHub - meta-llama/PurpleLlama: Set of tools to assess and improve LLM security — GitHub
- meta-llama/Llama-Guard-3-8B — Hugging Face
- Llama Guard is now available in Amazon SageMaker JumpStart — AWS Machine Learning Blog
- llama-guard3 — Ollama Model Library
- Announcing Purple Llama — Simon Willison's Weblog