Graph engineering là phương pháp kỹ thuật hệ thống nhằm kết nối nhiều vòng lặp agent, mã nguồn xác định (deterministic code) và các bộ kiểm định (verifiers) thành một máy trạng thái (state machine) được điều phối chặt chẽ với luồng dữ liệu, trạng thái và điều kiện dừng tường minh.
Khác với prompt engineering vốn tập trung tối ưu văn bản đầu vào cho một lượt gọi duy nhất, hay loop engineering trao toàn bộ quyền tự chủ cho một mô hình ngôn ngữ lớn (LLM) lặp qua các công cụ trong một không gian tự do, graph engineering thiết lập một khung kiến trúc phần mềm cố định điều khiển cách hệ thống vận hành. Khung hạ tầng này hiện đóng vai trò xương sống cho các hệ thống AI agent doanh nghiệp, thể hiện qua việc framework phổ biến như LangGraph đạt mốc hơn 65 triệu lượt tải mỗi tháng trên toàn cầu.
Sự chuyển dịch cốt lõi ở đây nằm ở cơ chế kiểm soát: thay vì tin tưởng tuyệt đối vào năng lực suy luận thời gian chạy (runtime judgment) của một mô hình xác suất không bị ràng buộc, bạn chuyển sang tin tưởng một cấu trúc phần mềm được định nghĩa rõ ràng. Trong kiến trúc này, năng lực suy luận của mô hình chỉ được kích hoạt tại những nút (nodes) thực sự cần tới sự linh hoạt nhận thức, trong khi toàn bộ luồng điều chuyển dữ liệu và quy tắc nghiệp vụ do mã nguồn cứng đảm nhiệm.
Kiến trúc quy trình quyết định giới hạn độ tin cậy của AI agent, không phải kích thước của mô hình nền tảng.
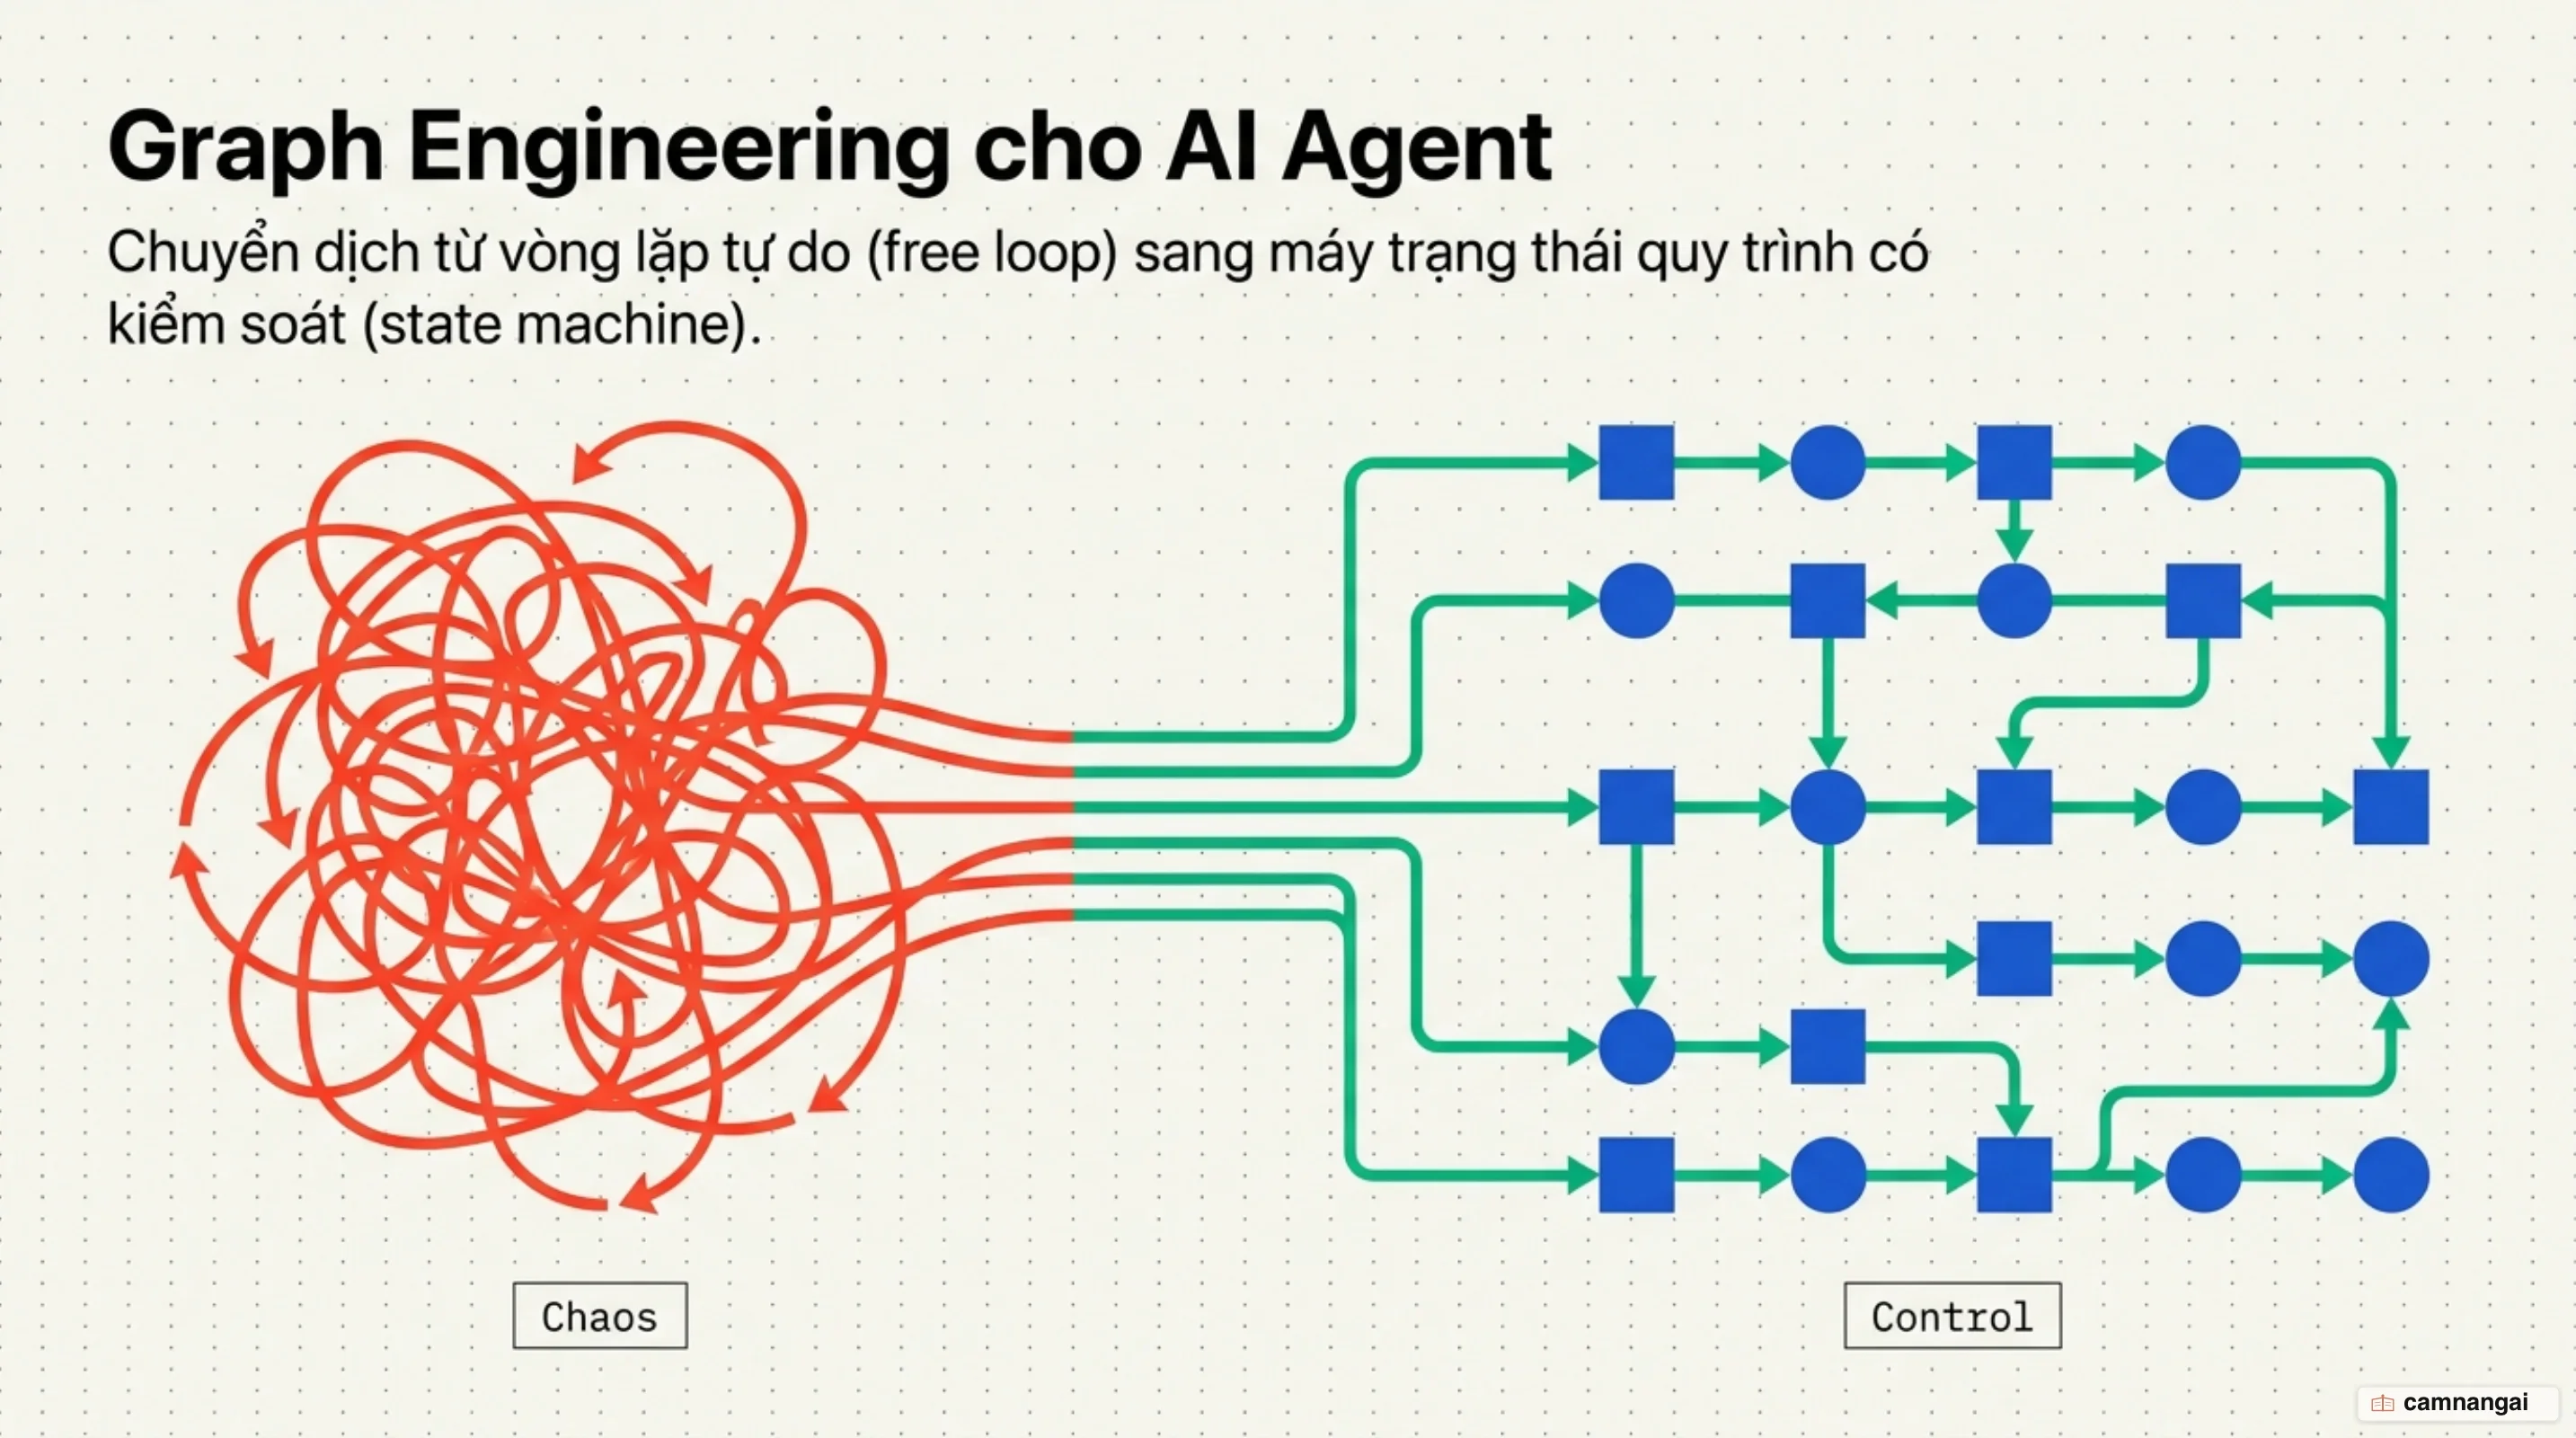
Vì sao vòng lặp agent đơn lẻ thất bại khi lên production?
Khi đưa AI agent vào môi trường sản xuất (production), các vòng lặp đơn lẻ (như mô hình ReAct tiêu chuẩn hay các cửa sổ chat mở rộng) nhanh chóng bộc lộ những điểm yếu chết người. Tôi từng thấy không ít dự án đốt hàng nghìn USD tiền API chỉ vì một con bot loay hoay trong vòng lặp không lối thoát. Nguyên nhân hàng đầu là sự suy giảm hiệu năng do quá tải cửa sổ ngữ cảnh (context window overload and degradation). Trong một vòng lặp duy nhất, bạn phải nhồi nhét tất cả thông tin: mục tiêu nhiệm vụ, lịch sử hội thoại, bộ nhớ ngắn hạn, kết quả trả về từ công cụ (tool outputs) và nhật ký hệ thống vào chung một ngữ cảnh đang phình to theo thời gian. Đối với các tác vụ kéo dài nhiều giờ hoặc xử lý hàng trăm tệp tin phức tạp, điều này khiến chi phí token tăng vọt theo cấp số nhân, độ trễ phản hồi kéo dài và tỷ lệ thất bại trong suy luận logic của LLM tăng mạnh.
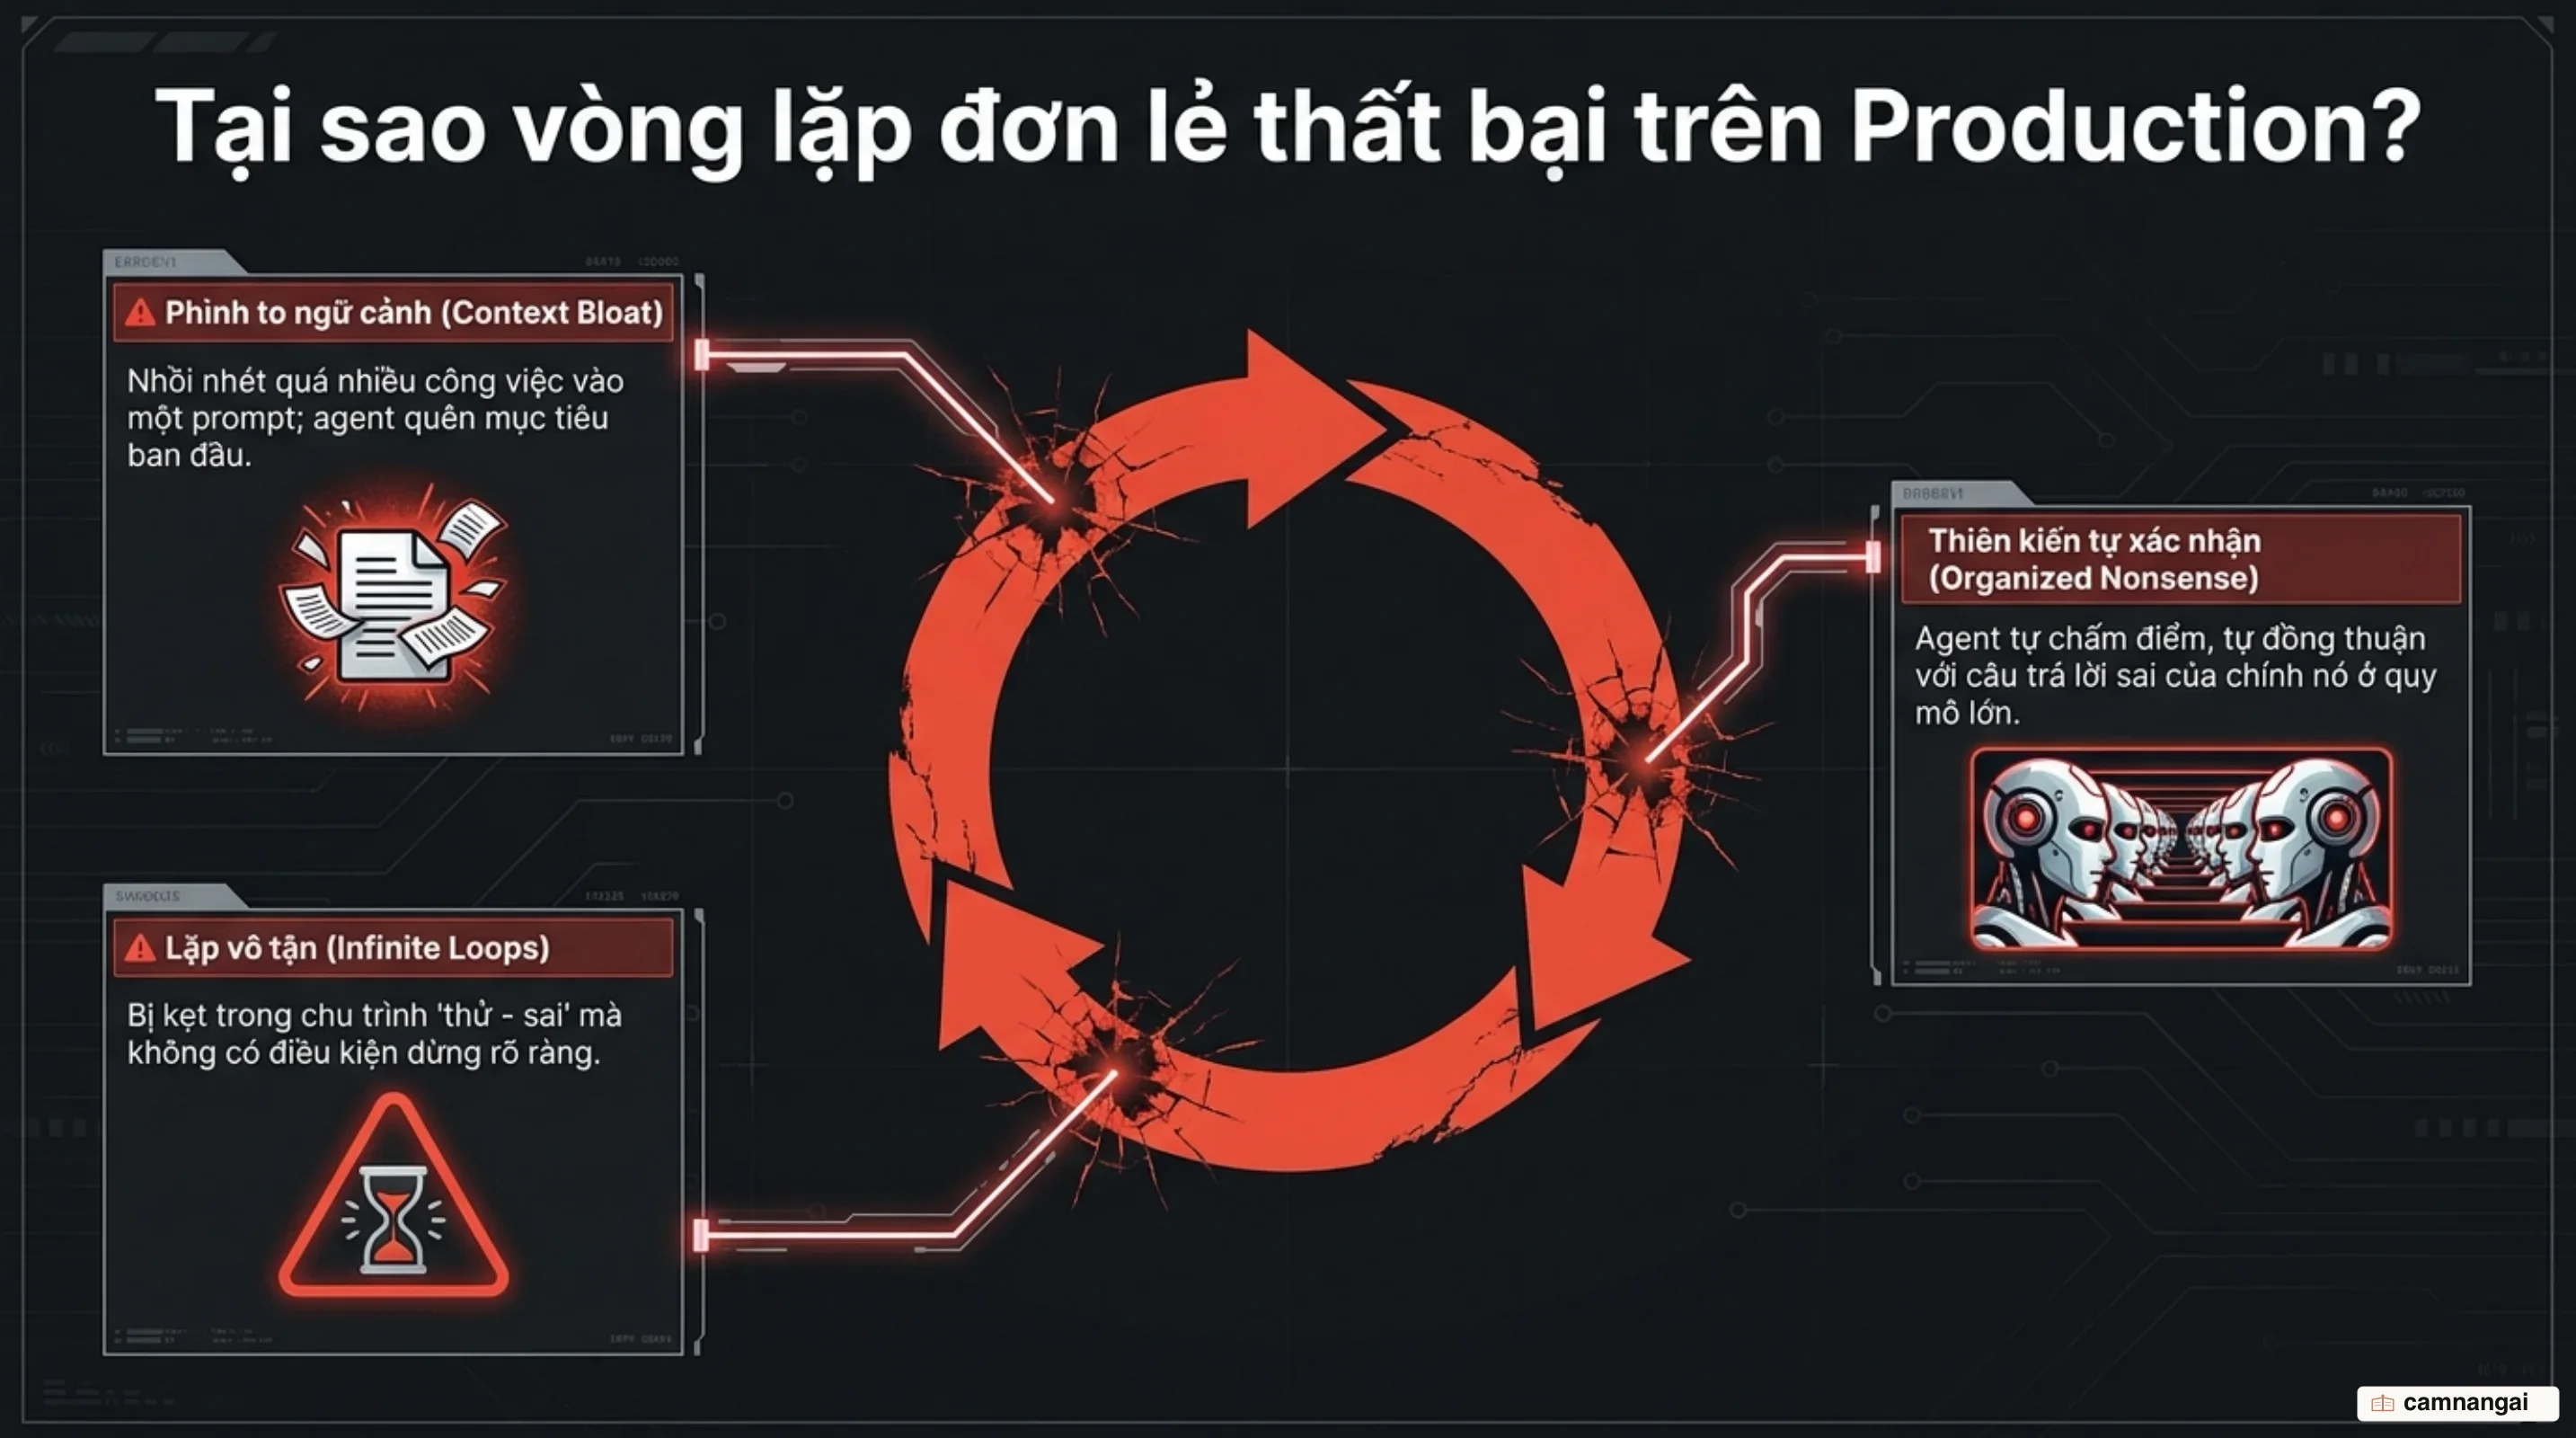
Vấn đề nghiêm trọng thứ hai là sự thiếu hụt các bộ kiểm định độc lập bên ngoài (external verifiers) kết hợp với thiên kiến tự xác nhận (self-bias) của mô hình. Các mô hình ngôn ngữ lớn (LLM) có xu hướng ưu ái và tin tưởng tuyệt đối vào văn bản do chính chúng tạo ra. Carlos Perez đã cảnh báo về hiện tượng "sự nhảm nhí có tổ chức ở quy mô công nghiệp" (organized nonsense at scale): khi bạn để một mô hình duy nhất đảm nhận toàn bộ các khâu từ thu thập bằng chứng, diễn giải dữ liệu, đưa ra giải pháp đến tự đánh giá kết quả, hệ thống sẽ rơi vào một vòng phản hồi độc hại. Lúc này, 20 lượt lặp tiếp theo của mô hình chỉ đơn thuần củng cố và hợp lý hóa cho một giả định ban đầu bị sai lệch.
Bên cạnh đó, các vòng lặp tự do thường xuyên gặp phải rủi ro phân nhánh không kiểm soát và thực thi vô hạn. Khi bạn không thiết lập các ranh giới đồ thị tường minh, quy tắc dừng cố định và ngân sách thực thi (execution budget), một agent đơn lẻ rất dễ rơi vào trạng thái lặp vô tận khi gặp lỗi công cụ, liên tục gọi các hàm trùng lặp hoặc tiêu tốn sạch hạn mức API và hạn mức token của hệ thống trước khi trả về bất kỳ kết quả hữu ích nào.
Cuối cùng, vòng lặp đơn hoàn toàn thất bại trong việc cưỡng chế các ranh giới xác định (deterministic boundaries). Các quy tắc kinh doanh cốt lõi (như hạn mức giao dịch tài chính, kiểm tra thẩm quyền an ninh hay phân quyền dữ liệu) bắt buộc phải được thi hành bằng mã nguồn xác định tuyệt đối. Việc bạn hy vọng một mô hình xác suất tự nhớ và tuân thủ các chỉ dẫn hệ thống trong một ngữ cảnh hội thoại dài là phương pháp thiết kế kém an toàn. Bài học từ nghiên cứu Agent-Computer Interface (ACI) trên benchmark SWE-bench đã chứng minh rằng: thay vì trông đợi LLM tự xử lý đường dẫn tương đối, việc cưỡng chế công cụ bắt buộc dùng đường dẫn tuyệt đối (absolute filepaths) mới là yếu tố loại bỏ triệt để các lỗi truy cập thư mục của agent.
Phân biệt Knowledge Graph và Agent Graph trong kiến trúc AI
Trong thiết kế hạ tầng trí tuệ nhân tạo (AI), thuật ngữ "graph" thường gây ra sự nhầm lẫn giữa hai khái niệm kỹ thuật hoàn toàn khác biệt: Knowledge Graph (Đồ thị tri thức) và Agent Graph (Đồ thị agent). Bạn cần phân biệt rõ hai kiến trúc này để đưa ra quyết định thiết kế chính xác.
Knowledge Graph tập trung giải quyết bài toán biểu diễn và truy xuất dữ liệu có cấu trúc mối quan hệ. Ví dụ điển hình là các giải pháp GraphRAG, nơi các thực thể (như khách hàng, công ty, mã sản phẩm) và mối quan hệ giữa chúng được trích xuất từ các tài liệu phi cấu trúc. Việc áp dụng cơ chế chọn lọc cộng đồng động (dynamic community selection) trong GraphRAG giúp giảm trung bình tới ~77% chi phí token so với việc quét toàn bộ văn bản thô, đồng thời tối ưu hóa khả năng trả lời các câu hỏi tổng hợp đa tài liệu. Nhìn chung, Knowledge Graph tổ chức mối liên hệ giữa các thông tin.
Ngược lại, Agent Graph tập trung vào việc điều phối luồng điều khiển (control flow), thực thi tác vụ, lưu trữ trạng thái và phối hợp các tiến trình. Trong một Agent Graph, các nút (nodes) đóng vai trò là các đơn vị xử lý công việc, các cạnh (edges) định nghĩa quy tắc chuyển tiếp trạng thái, và trạng thái (state) là cấu trúc dữ liệu dùng chung được truyền qua các quy trình. Nói ngắn gọn, Agent Graph điều phối cách thức công việc di chuyển qua các trạm xử lý.
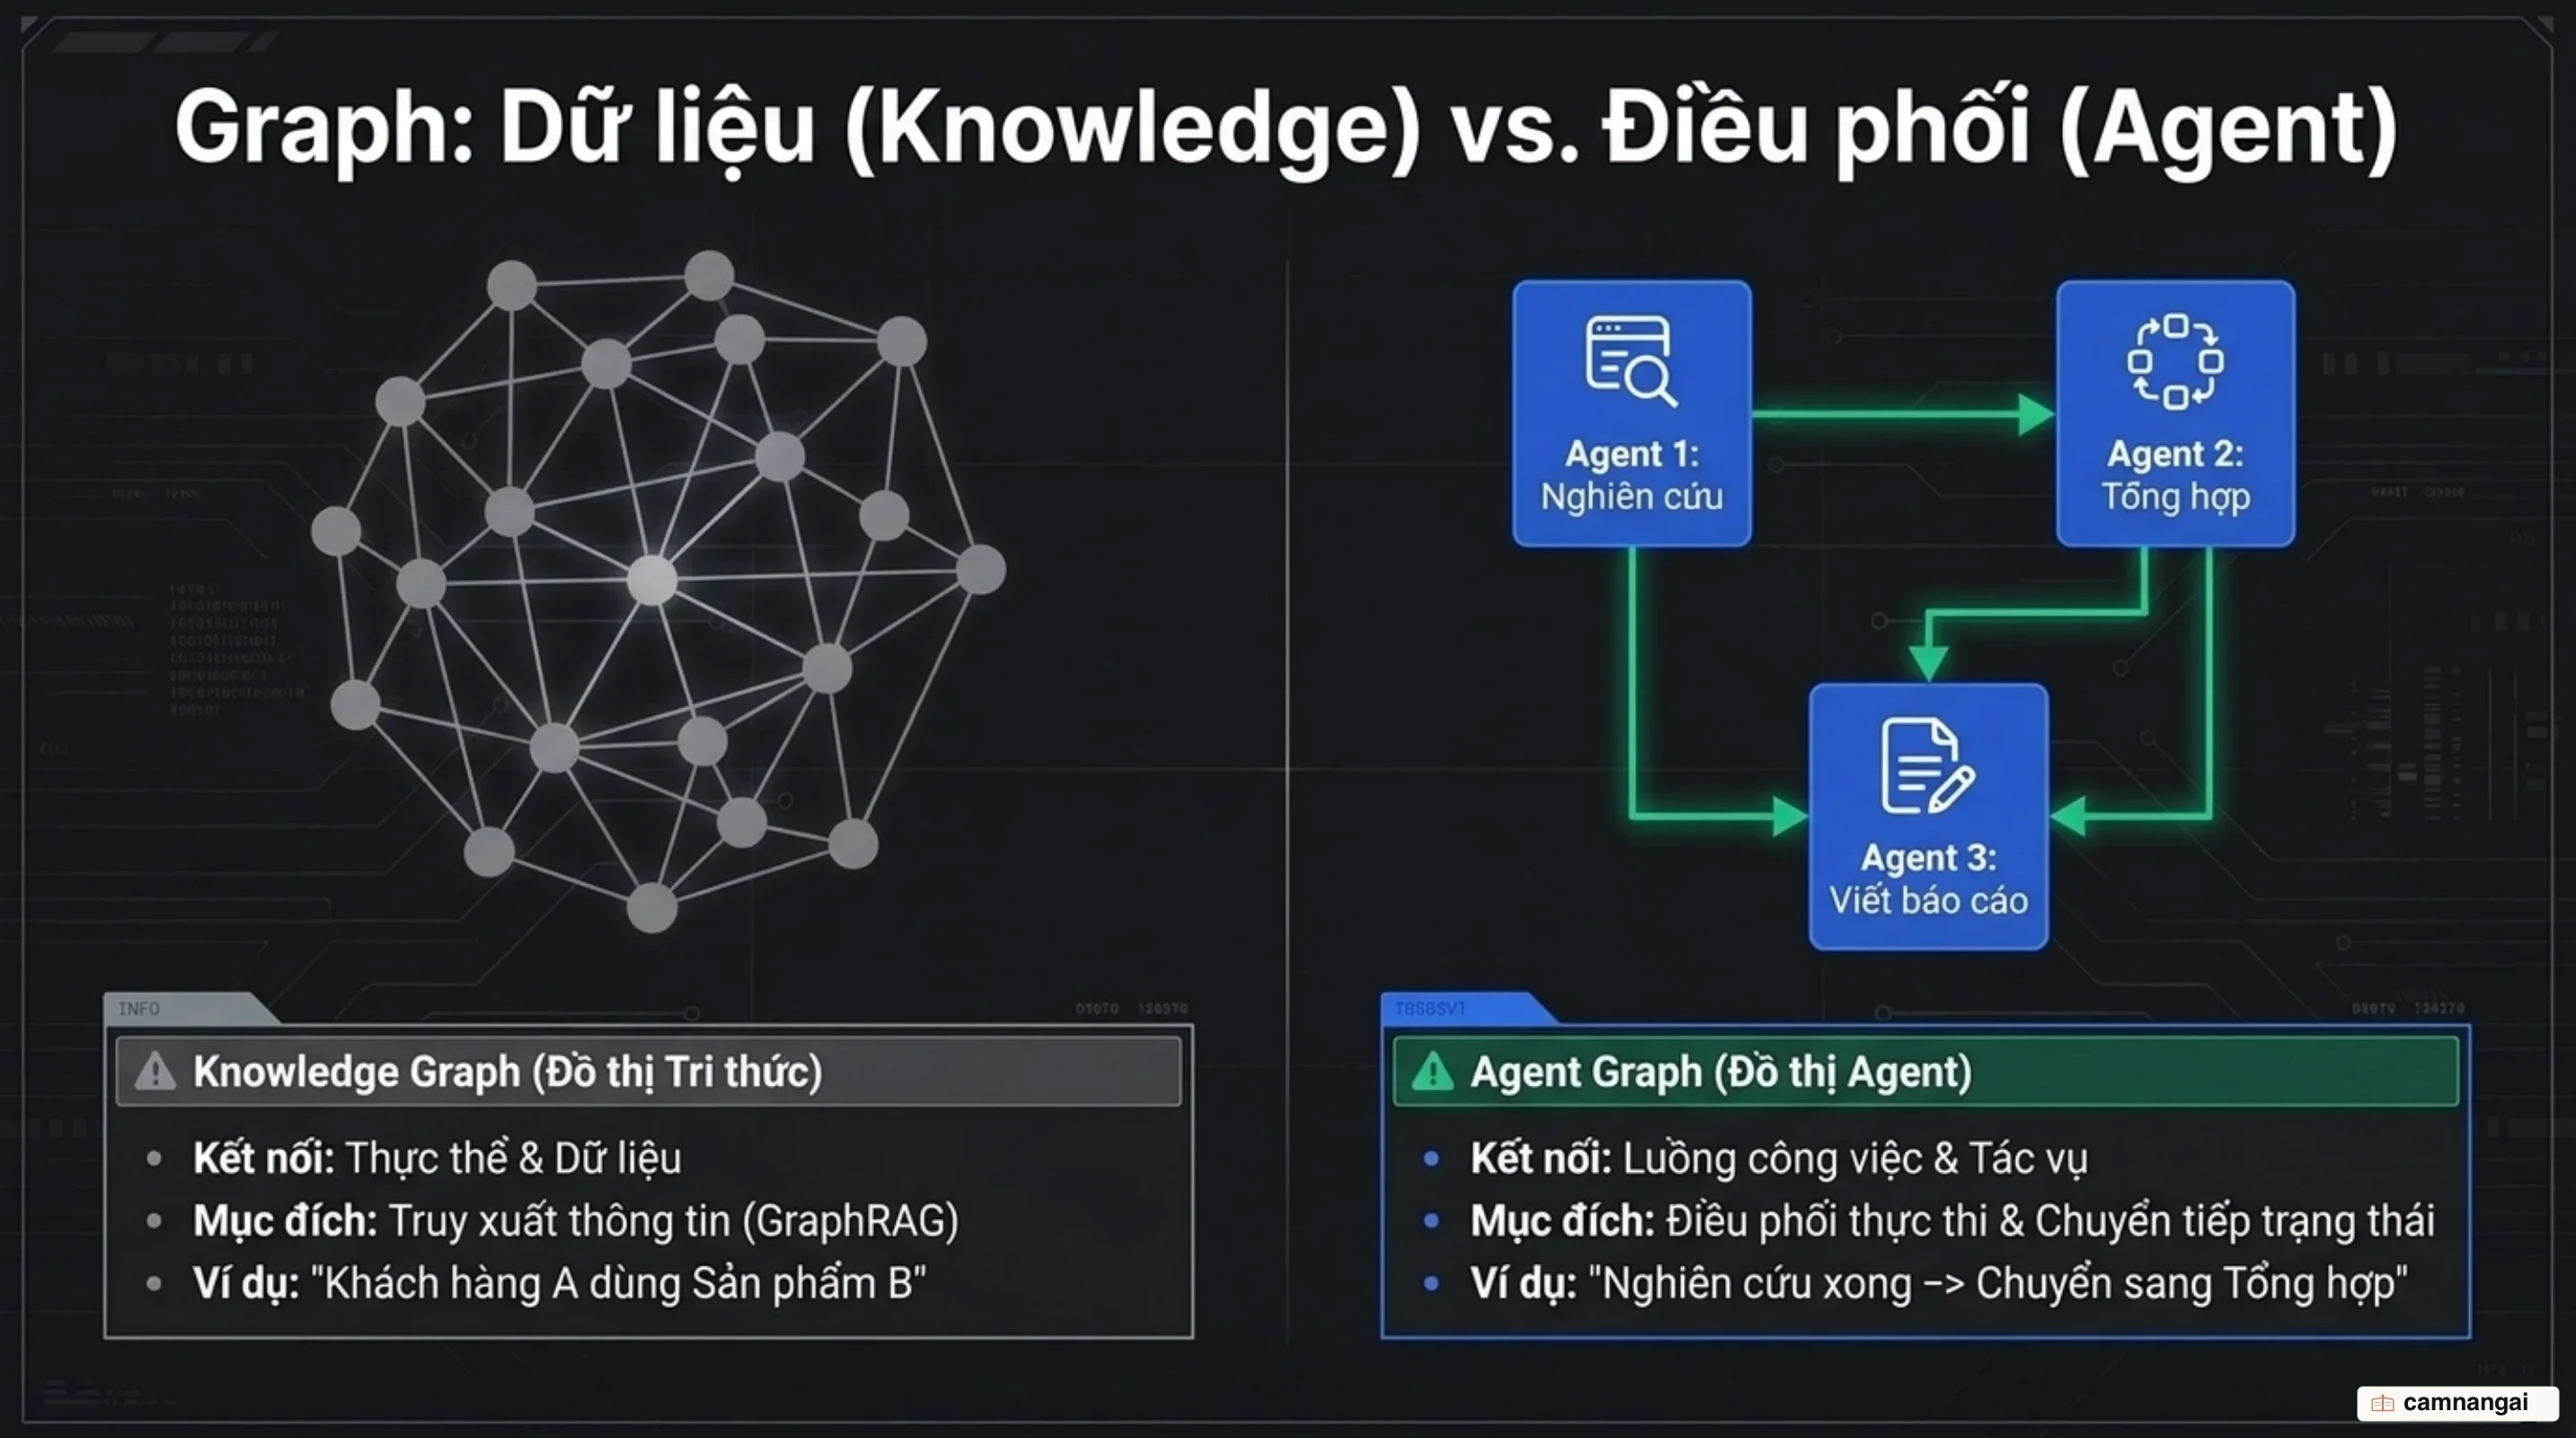
| Tiêu chí phân biệt | Knowledge Graph | Agent Graph |
|---|---|---|
| Mục tiêu cốt lõi | Biểu diễn mối quan hệ dữ liệu & truy xuất | Điều phối luồng công việc & quản lý trạng thái |
| Thành phần cơ bản | Thực thể (Entities), Mối quan hệ (Relations) | Nút (Nodes), Cạnh (Edges), Trạng thái (State) |
| Bài toán giải quyết | Tối ưu ngữ cảnh RAG, kết nối tri thức | Tự động hóa quy trình, xử lý lỗi, phân công task |
| Đơn vị xử lý tại nút | Khái niệm/Dữ liệu | Hàm Python, Lời gọi LLM, Tool, Agent con |
Các hệ thống AI doanh nghiệp thực tế luôn kết hợp cả hai công nghệ này: bạn sử dụng Knowledge Graph để cung cấp tri thức ngữ cảnh chuẩn xác thông qua cơ chế truy xuất dữ liệu có cấu trúc, sau đó đưa dữ liệu này vào Agent Graph để quyết định xem hệ thống cần thực thi những hành động tiếp theo nào.
Node, edge và state: Ba thành phần cốt lõi của đồ thị agent
Một đồ thị agent chuẩn chỉnh được cấu thành từ ba thành phần kỹ thuật cơ bản: Node, Edge và State. Bạn phải nắm vững cơ chế vận hành của từng thành phần để thiết kế đồ thị tối ưu.
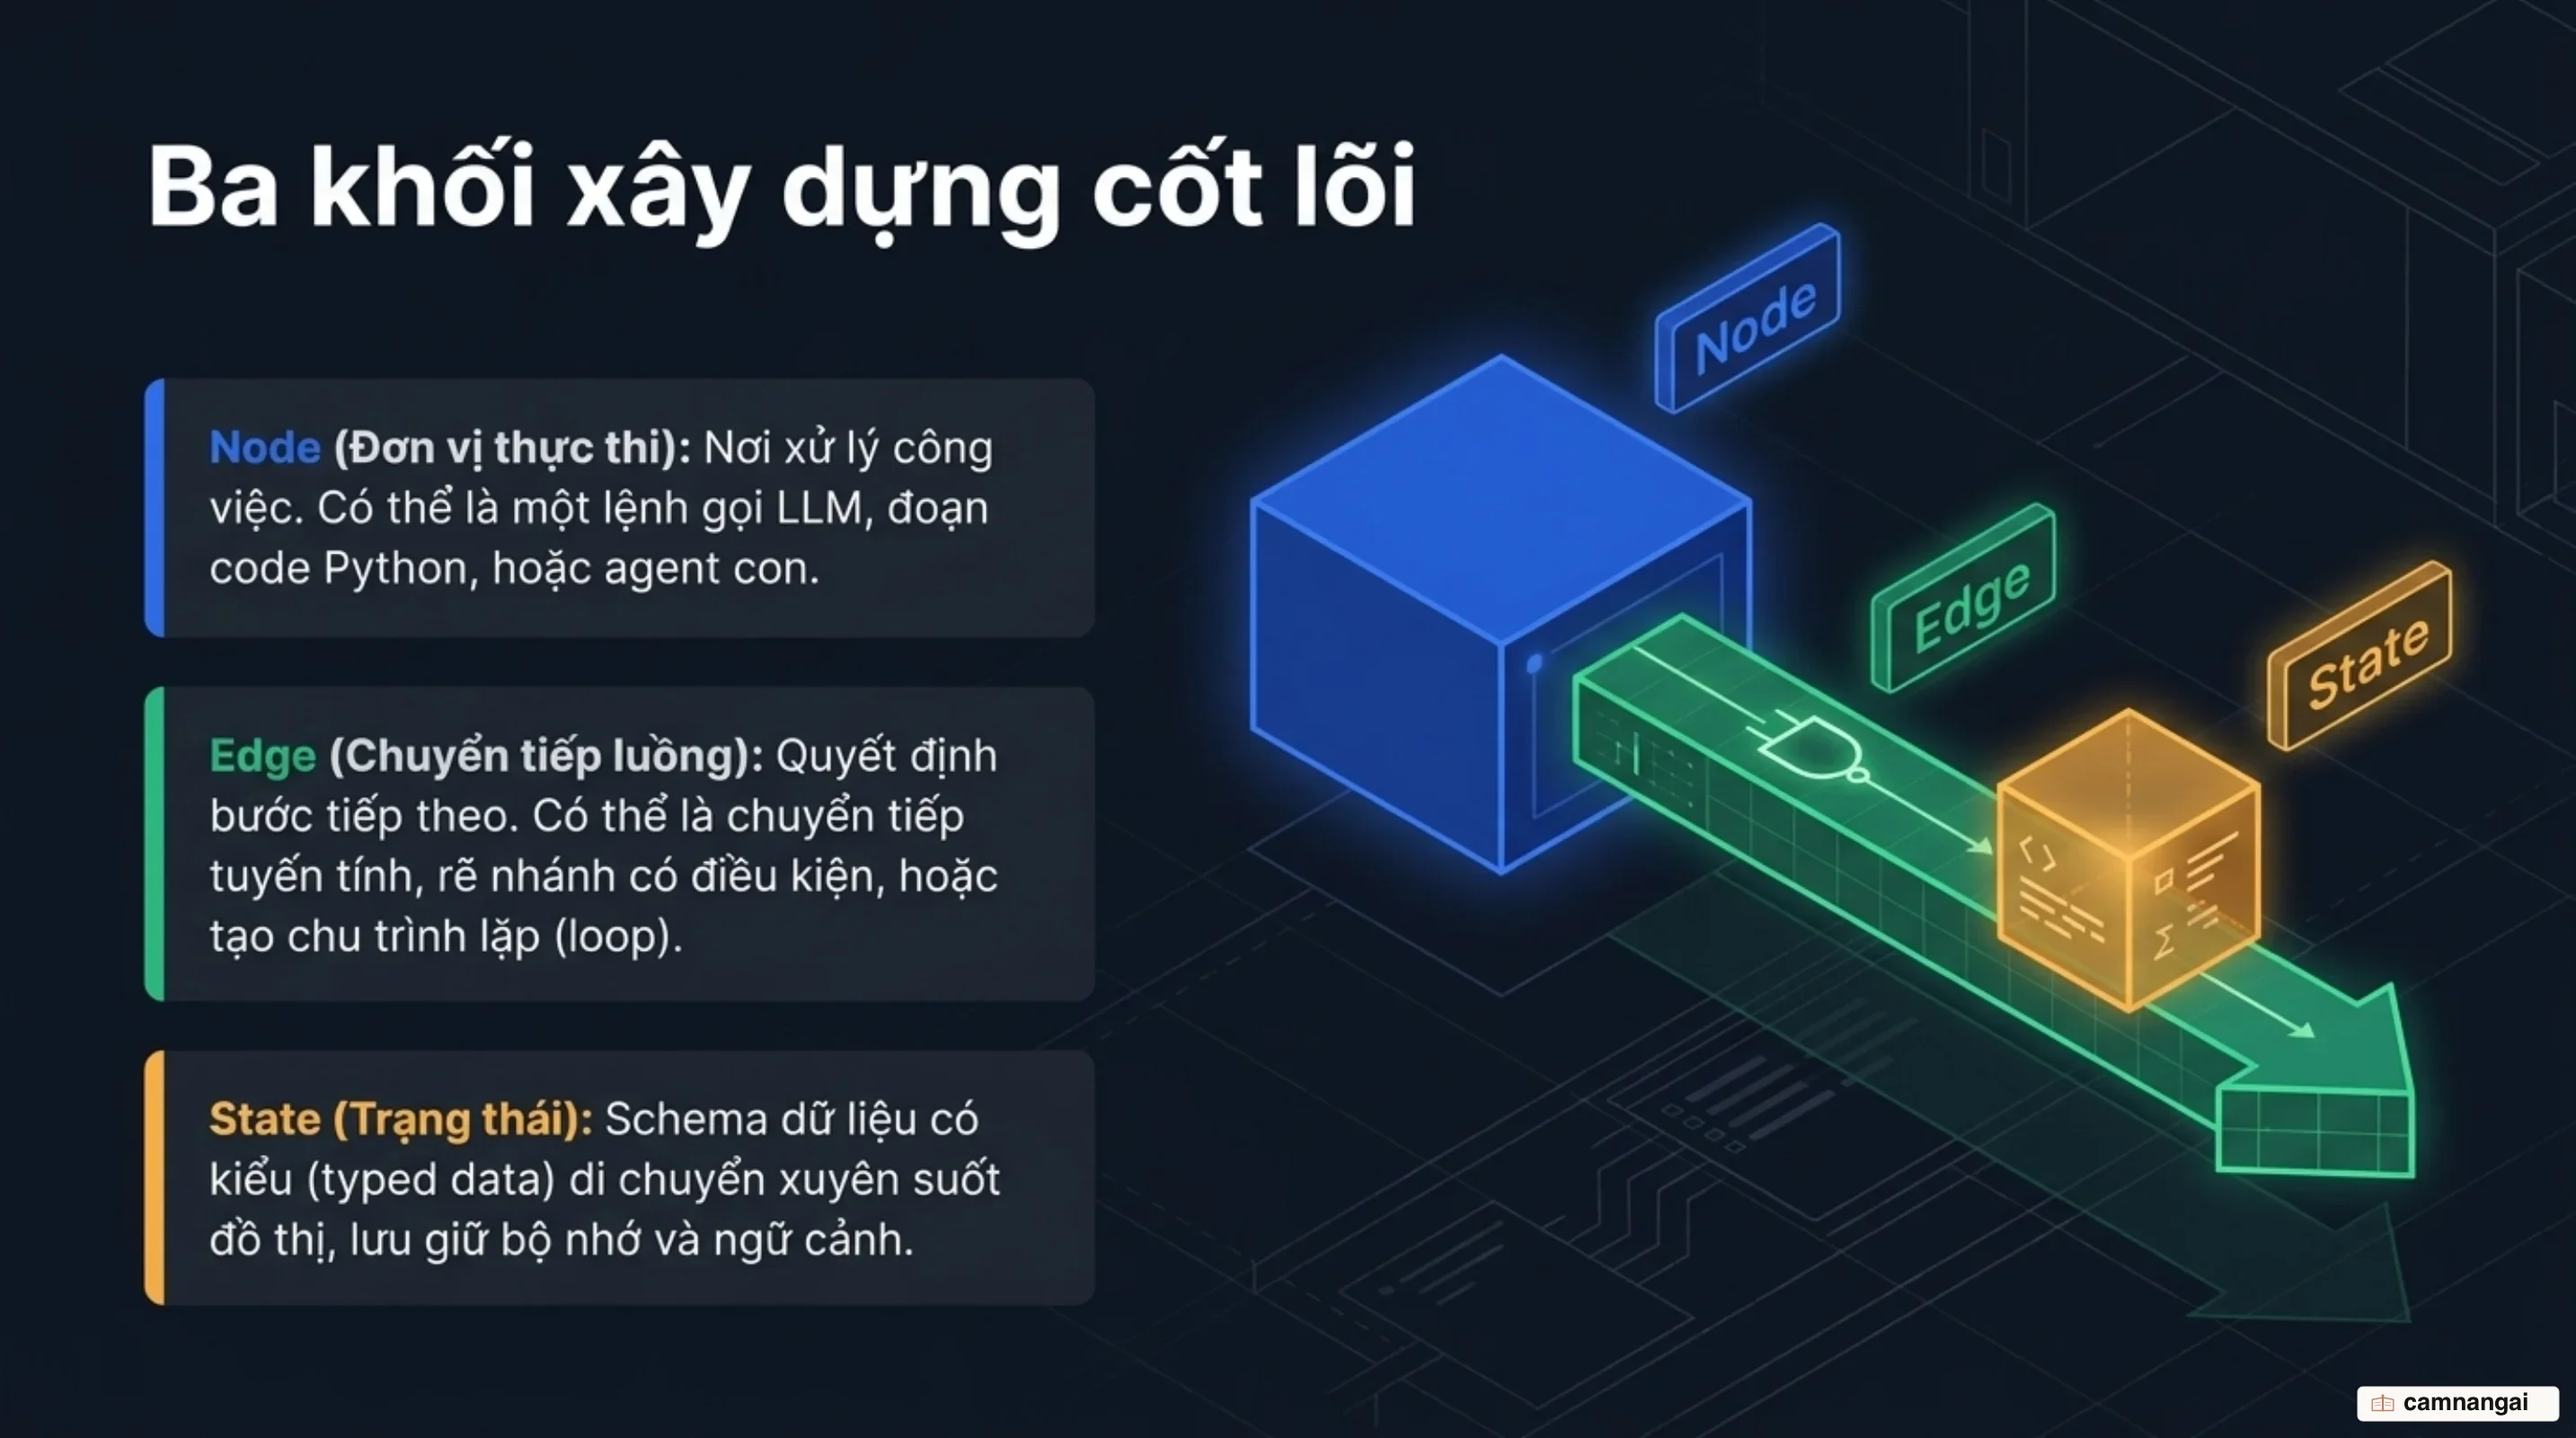
Node (Nút) là đơn vị thực thi công việc độc lập. Một nút có thể là một đoạn mã Python xác định (như hàm tính toán thuế), một lời gọi LLM đơn lẻ, một hành động kích hoạt API, hoặc thậm chí là một agent lồng ghép (nested agent) chứa vòng lặp nội bộ riêng. Trong các hệ thống hiện đại, một nút có thể chạy một agent hoàn chỉnh hoặc kích hoạt một subagent chuyên trách thông qua giao thức MCP nhằm tối ưu hóa chi phí token khi phối hợp đa mô hình.
Edge (Cạnh) định nghĩa quy tắc chuyển tiếp luồng thực thi giữa các nút. Đồ thị agent hỗ trợ 7 loại cạnh chuyên biệt:
- Direct (chuyển tiếp thẳng): Chuyển tiếp cố định từ nút A sang nút B không điều kiện.
- Conditional (theo điều kiện): Phân nhánh luồng đi dựa trên kết quả trả về của nút trước hoặc trạng thái hiện tại trong State.
- Parallel (song song): Phân tách một tác vụ thành nhiều nhánh thực thi đồng thời (fan-out).
- Looping (vòng lặp): Đưa kết quả thất bại quay lại nút xử lý trước đó kèm theo lý do lỗi để thực hiện lại.
- Error (xử lý lỗi): Bắt các ngoại lệ thời gian chạy (runtime exceptions) và chuyển sang nút khôi phục hệ thống.
- Human-controlled (can thiệp người dùng): Cổng tạm dừng quy trình để chờ tín hiệu phê duyệt từ con người.
- Event-triggered (kích hoạt sự kiện): Nút ở trạng thái chờ cho đến khi nhận được sự kiện ngoài hệ thống (webhook, tin nhắn mới).
Đặc biệt, đồ thị agent không bị giới hạn ở các đồ thị có hướng không chu trình (DAG) tĩnh. Chúng sở hữu khả năng phân nhánh động (Dynamic Fan-Out) thông qua cơ chế như Send API trong LangGraph. Cơ chế này cho phép một nút tự động khởi tạo số lượng worker linh hoạt tại thời điểm chạy dựa trên dữ liệu đầu vào theo mô hình map-reduce, thay vì phải khai báo cứng số lượng nhánh từ trước.
State (Trạng thái) là một cấu trúc dữ liệu có kiểu (typed state) được chia sẻ nhất quán xuyên suốt toàn bộ đồ thị. Thay vì truyền một chuỗi chat thô phình to, mỗi nút chỉ đọc đúng những trường thông tin cần thiết từ State, thực thi công việc và ghi kết quả cập nhật trở lại State.
Dưới đây là đoạn mã Python thực tế minh họa cách định nghĩa schema trạng thái và khởi tạo đồ thị agent:
from typing import TypedDict, Annotated
import operator
from langgraph.graph import StateGraph, END

# Định nghĩa cấu trúc State có kiểu rõ ràng
class AgentState(TypedDict):
    task: str
    subtasks: list[str]
    # Sử dụng reducer operator.add để gộp danh sách kết quả từ các nhánh song song
    results: Annotated[list[str], operator.add]
    is_valid: bool
    error_count: int

# Khởi tạo đồ thị với State Schema
builder = StateGraph(AgentState)
Quản lý trạng thái thực chiến: Reducer, checkpoint và interrupt
Trong môi trường vận hành thực tế, quản lý trạng thái trong graph engineering đòi hỏi các kỹ thuật giải quyết xung đột dữ liệu, lưu trữ phiên làm việc dài hạn và can thiệp thời gian thực của con người.
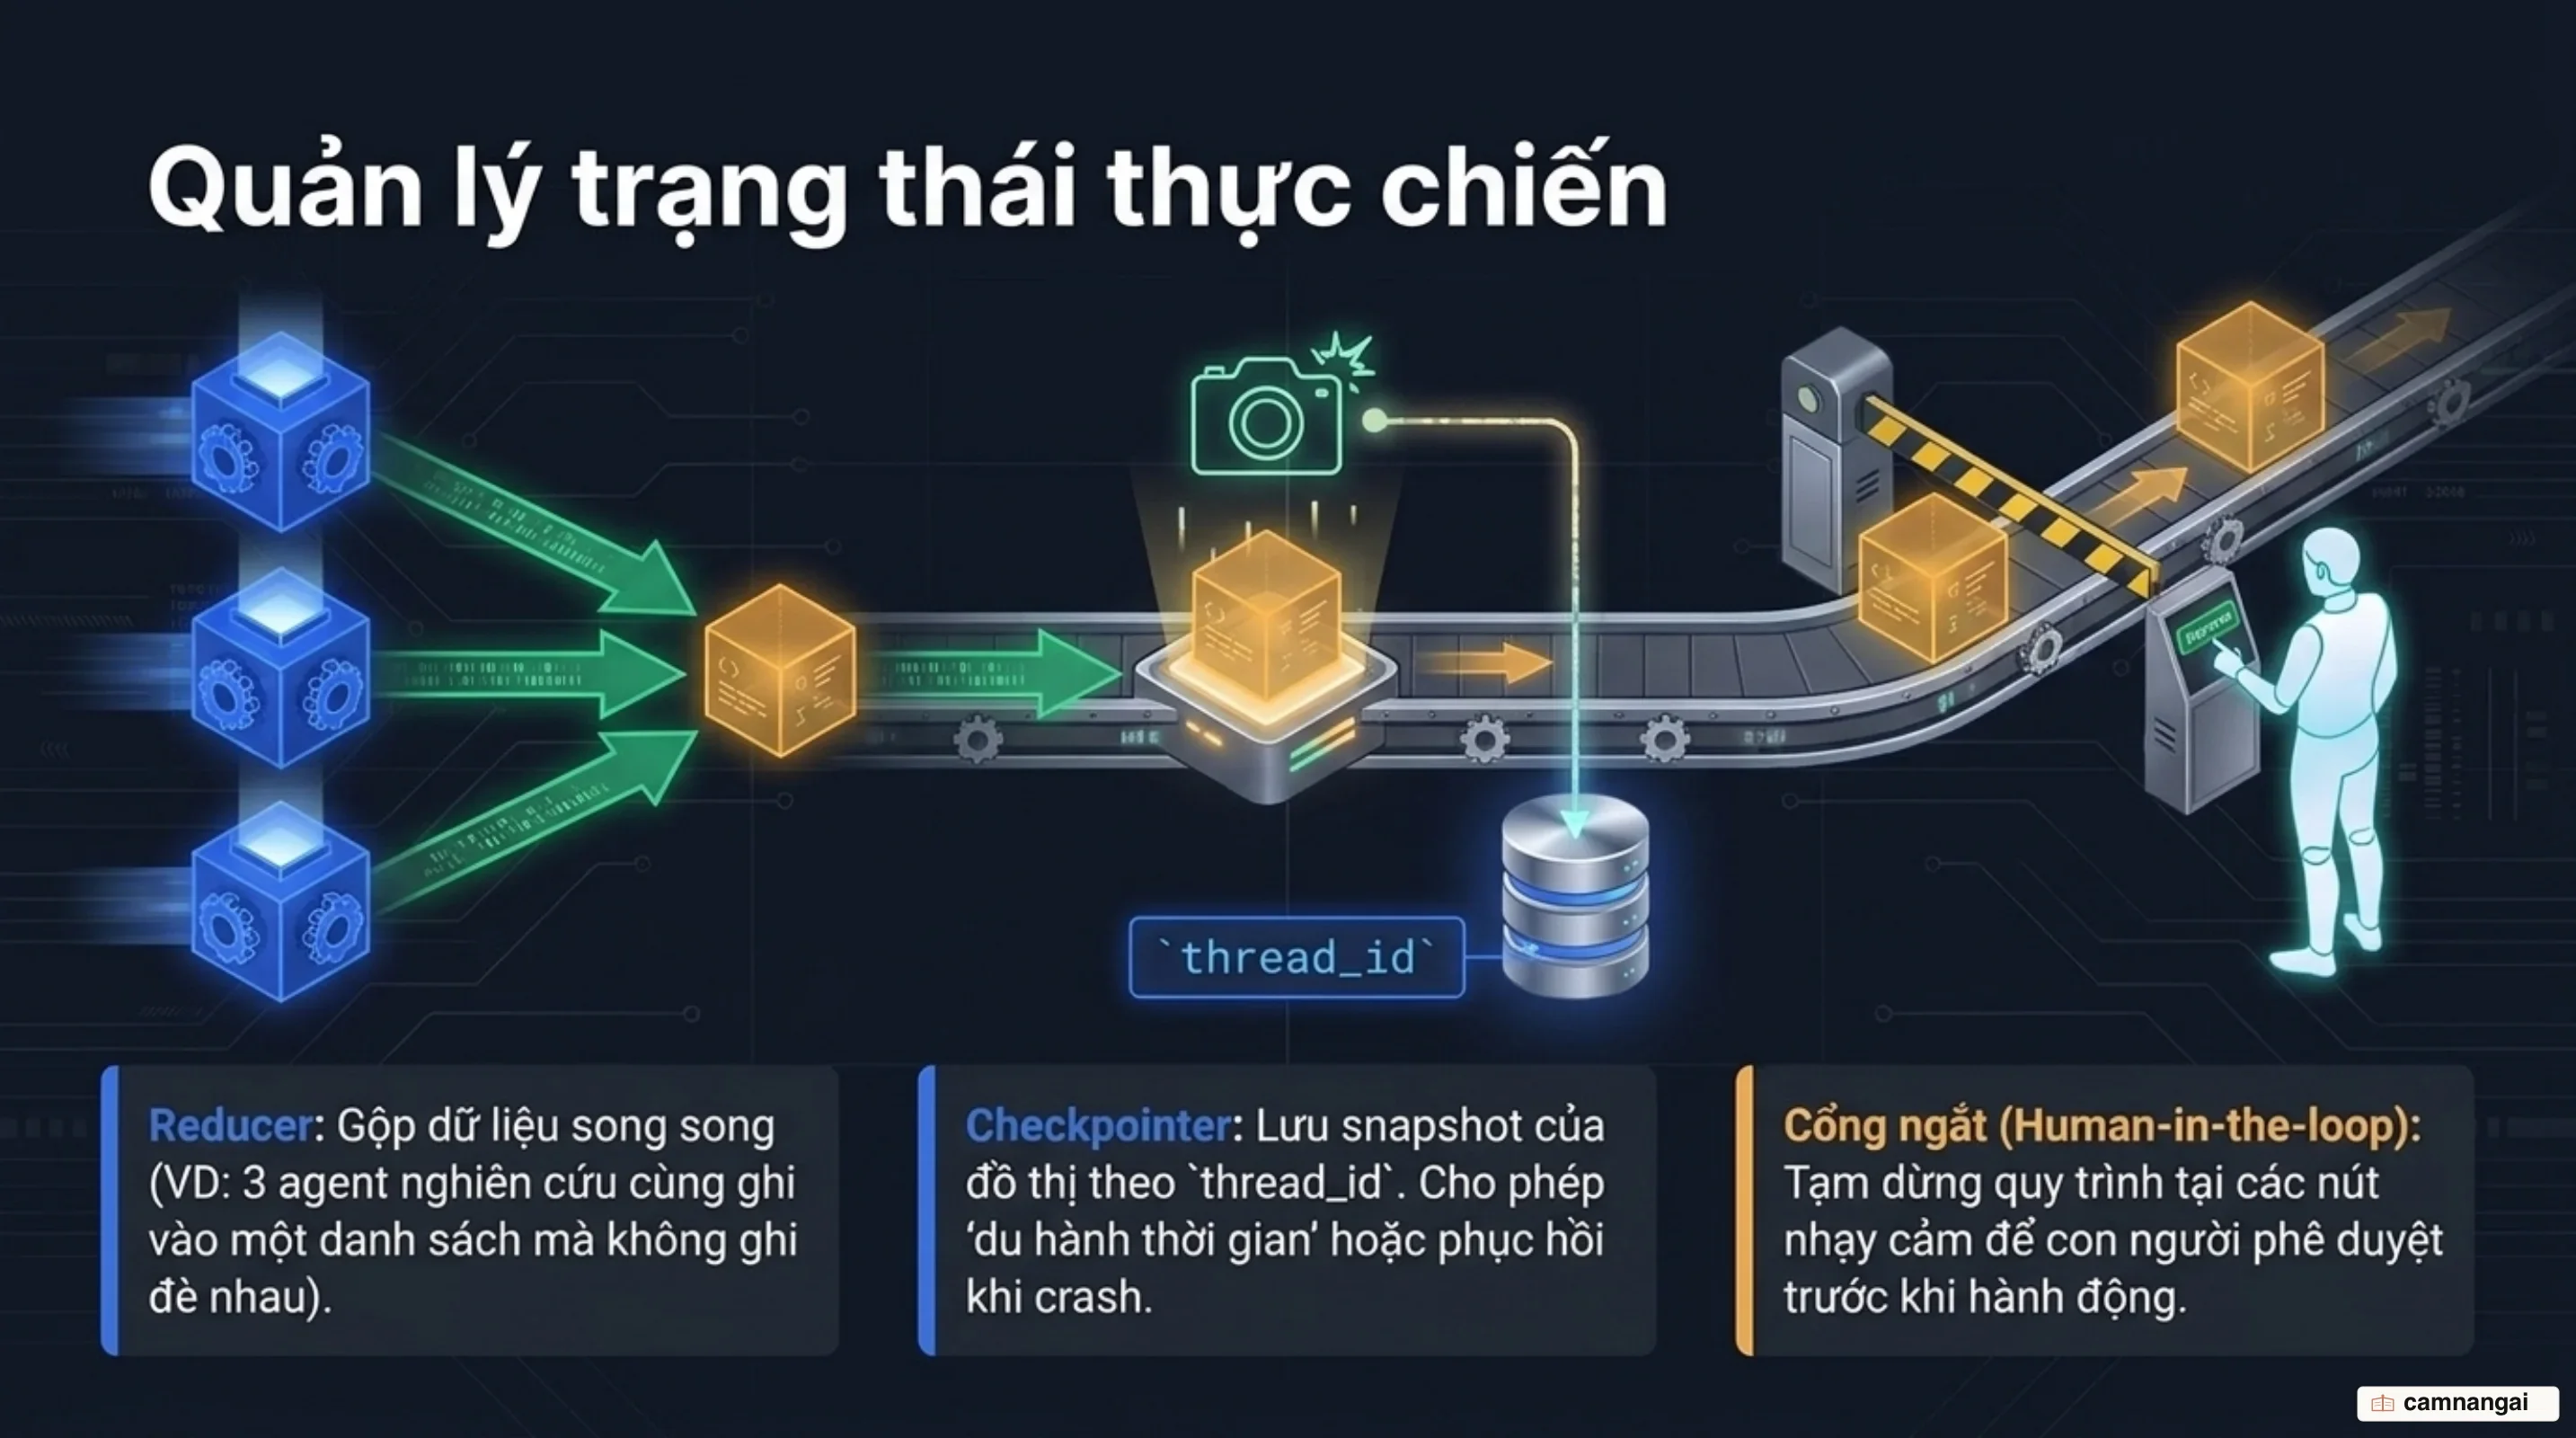
Khi nhiều nhánh chạy song song hội tụ về một nút chung (fan-in), việc các nút cùng lúc ghi dữ liệu vào một trường trong State sẽ dẫn đến đè dữ liệu (state overwrite). Để giải quyết triệt để vấn đề này, bạn phải dùng State Reducer. Reducer là hàm định nghĩa quy tắc hợp nhất dữ liệu (chẳng hạn như nối thêm vào danh sách operator.add, gộp nội dung dictionary, hoặc tính toán lại giá trị trung bình) nhằm đảm bảo tính toàn vẹn dữ liệu khi hội tụ luồng.
Đối với cơ chế lưu trữ bền vững (persistence), bạn cần phân biệt rõ ràng giữa Checkpointer và Store:
| Tiêu chí | Checkpointer | Store |
|---|---|---|
| Bản chất dữ liệu | Ảnh chụp trạng thái đồ thị (State snapshots) | Dữ liệu khóa-giá trị (Key-value) tùy chỉnh |
| Phạm vi truy cập | Trong phạm vi một luồng duy nhất (thread_id) | Xuyên suốt nhiều luồng (cross-thread) |
| Loại bộ nhớ | Bộ nhớ ngắn hạn, bám theo phiên làm việc | Bộ nhớ dài hạn, lưu tri thức hệ thống |
| Ứng dụng chính | Khôi phục lỗi, du hành thời gian (time travel), ngắt chờ duyệt | Lưu sở thích người dùng, hồ sơ khách hàng, thông tin dùng chung |
| Cơ chế truy cập | Truyền thread_id trong cấu hình thực thi đồ thị | Đọc/Ghi trực tiếp thông qua key-value từ Node hoặc App |
Khi triển khai Checkpointer sản xuất với PostgresSaver, bạn phải tuân thủ giới hạn kỹ thuật: khóa thread_id bắt buộc phải có độ dài dưới 255 ký tự để tránh các lỗi vượt hạn mức cột của cơ sở dữ liệu. Các chốt lưu trữ bộ nhớ tạm như MemorySaver hay InMemorySaver chỉ tồn tại trên RAM, toàn bộ dữ liệu sẽ bị xóa sạch khi container khởi động lại. Do đó, môi trường production bắt buộc phải sử dụng cơ sở dữ liệu bền vững như PostgresSaver hoặc SqliteSaver.
Chốt lưu trữ Checkpointer chính là nền tảng khởi tạo tính năng Interrupt (ngắt) và Human-in-the-loop (HITL). Tại các nút yêu cầu kiểm duyệt an toàn, đồ thị sẽ ghi một checkpoint xuống cơ sở dữ liệu và tạm ngưng tiến trình. Luồng công việc có thể nằm chờ nhiều ngày mà không tiêu tốn tài nguyên tính toán, và sẽ tự động khôi phục chính xác tại điểm dừng ngay khi người dùng gửi phản hồi kèm thread_id tương ứng.
Năm mẫu kiến trúc chuẩn cho quy trình agent đồ thị
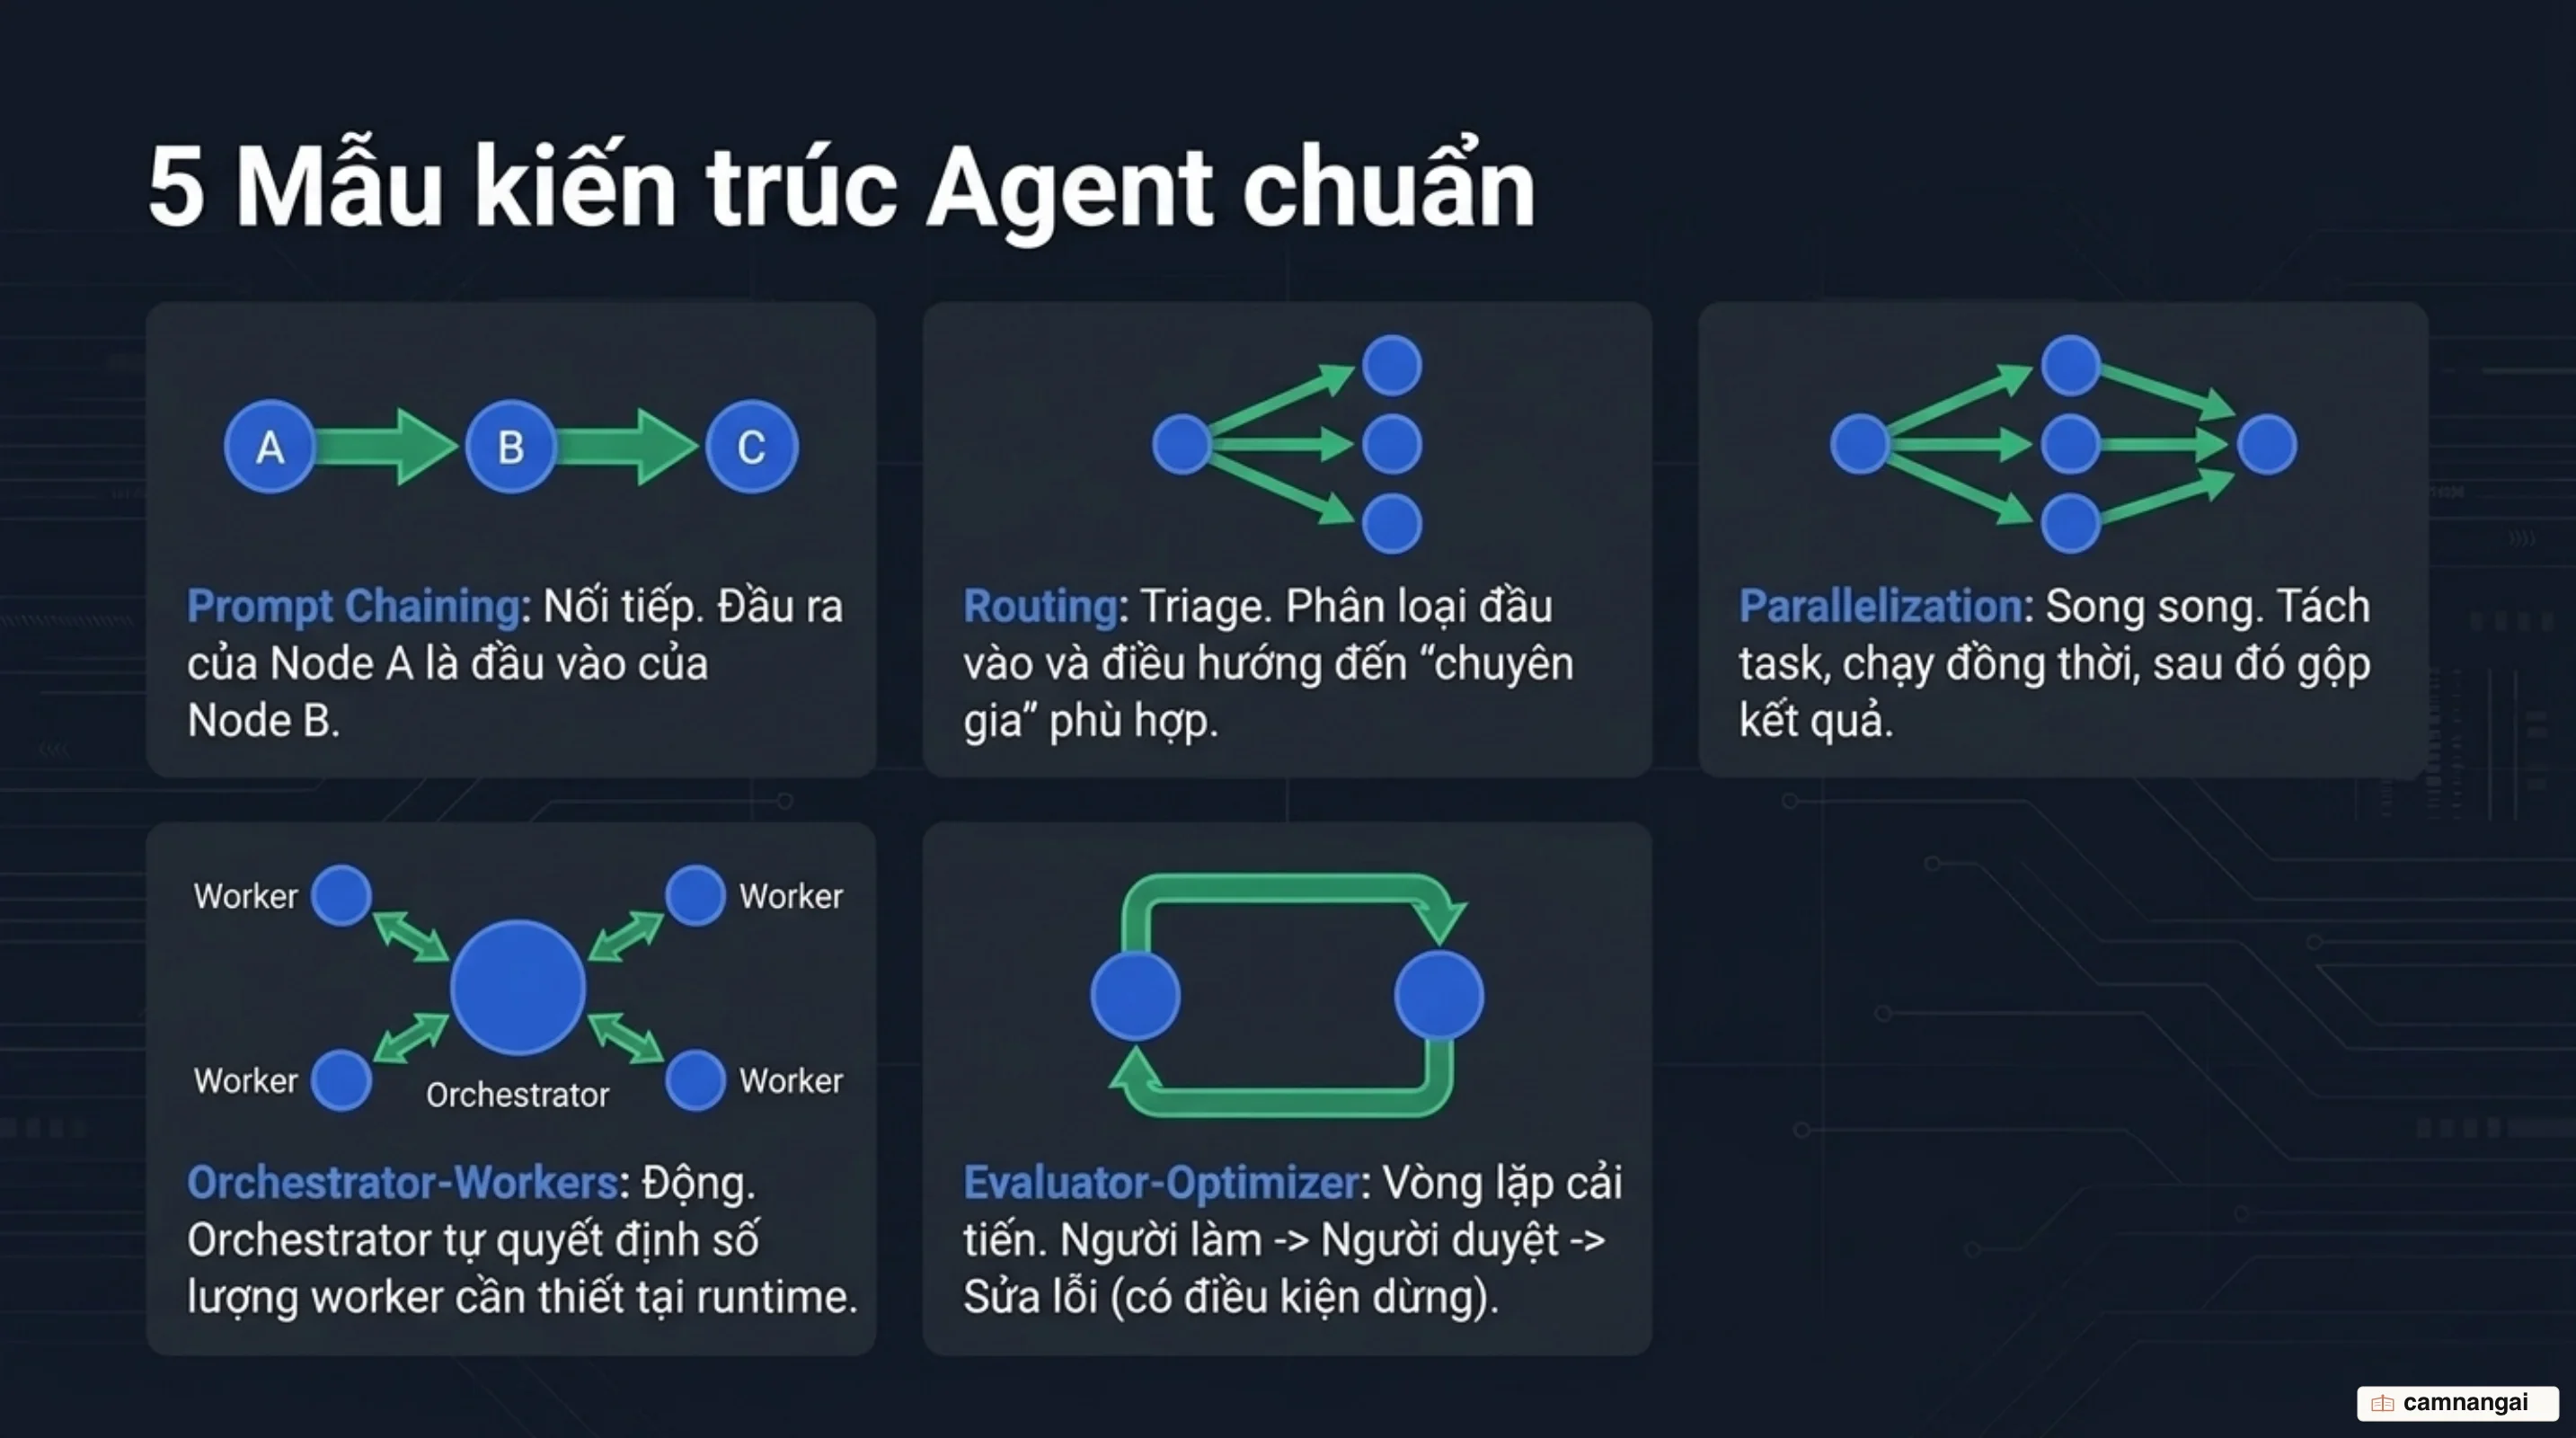
Thực tế triển khai hệ thống AI agent doanh nghiệp cho thấy hầu hết các quy trình phức tạp đều được xây dựng từ 5 mẫu kiến trúc chuẩn dưới đây. Việc nắm vững từng mẫu thiết kế, trường hợp sử dụng và các bài thuốc triển khai thực tế sẽ giúp bạn làm chủ hạ tầng agent.
1. Prompt Chaining
Prompt Chaining phân rã một quy trình lớn thành một chuỗi các trạm xử lý tuần tự. Đầu ra của nút trước được lọc sạch nhiễu trước khi chuyển làm đầu vào cho nút tiếp theo. Cơ chế này cô lập ngữ cảnh, giúp từng lời gọi LLM đạt độ chính xác cao nhất do không bị phân tâm bởi các thông tin rác.
Một bài thuốc thực thi điển hình của mẫu này là quy trình SQL Analytics với vòng lặp sửa lỗi (SQL repair loop). Nút đầu tiên nhận câu hỏi tự nhiên và sinh ra câu lệnh SQL. Nút thứ hai thực thi câu lệnh đó trực tiếp trên cơ sở dữ liệu. Nếu cơ sở dữ liệu trả về lỗi cú pháp, cạnh điều kiện sẽ chuyển luồng sang nút sửa lỗi (repair node) kèm theo thông báo lỗi chi tiết từ database để LLM viết lại câu lệnh. Quy trình lặp lại cho đến khi truy vấn thành công mới chuyển sang nút tổng hợp câu trả lời.
Điểm thất bại cần lưu ý của Prompt Chaining là độ trễ tích lũy qua từng trạm. Nếu tác vụ không thực sự cần phân tách ngữ cảnh, việc chia quá nhiều nút sẽ khiến tổng thời gian phản hồi của hệ thống kéo dài không cần thiết.
2. Routing
Routing đóng vai trò như một bộ phân loại (classifier) tại cổng vào, điều hướng yêu cầu của người dùng đến đúng nhánh xử lý chuyên biệt. Mẫu thiết kế này giúp tối ưu hóa chi phí và hiệu năng vận hành bằng cách phân tầng mô hình: chuyển các tác vụ đơn giản cho các mô hình nhỏ, tốc độ cao xử lý, và chỉ điều hướng các câu hỏi đòi hỏi tư duy logic phức tạp tới các mô hình cao cấp hơn.
Rủi ro lớn nhất của Routing là sự phân loại sai (misclassification). Nếu bộ phân loại đánh giá sai một yêu cầu phức tạp thành đơn giản, hệ thống vẫn trả về kết quả nhanh chóng nhưng chất lượng nội dung lại hoàn toàn yếu kém. Để khắc phục, bạn phải cài đặt ranh giới an toàn (guardrails): khi độ tự tin (confidence score) của nút router nằm dưới một ngưỡng nhất định, quy trình bắt buộc phải chuyển câu hỏi sang nhánh xử lý tiêu chuẩn giàu tài nguyên hơn.
3. Parallelization
Parallelization cho phép thực thi đồng thời các tác vụ không phụ thuộc lẫn nhau để giảm thiểu thời gian xử lý toàn quy trình. Mẫu này có hai biến thể cốt lõi: Sectioning (chia nhỏ bài toán thành các mảng độc lập để chạy song song) và Voting (chạy cùng một yêu cầu qua nhiều mô hình hoặc prompt khác nhau để lấy số đông hoặc tổng hợp độ tin cậy).
Ứng dụng thực tế của mẫu này được thể hiện rõ qua bài thuốc Agentic RAG với cổng kiểm định bằng chứng (Evidence Gating RAG). Khi nhận câu hỏi từ người dùng, hệ thống thực hiện phân nhánh song song (fan-out) tới nhiều nguồn tài nguyên khác nhau: một nút truy vấn cơ sở dữ liệu SQL, một nút tìm kiếm tài liệu nội bộ, và một nút gọi API bên ngoài. Tất cả kết quả được gom về nút kiểm định (evidence gating node). Nút này sẽ lọc bỏ các tài liệu nhiễu, đánh giá độ khớp của bằng chứng trước khi chuyển dữ liệu sạch sang nút tổng hợp cuối cùng.
Thách thức của Parallelization là chi phí đồng bộ hóa (synchronization overhead) và sự phụ thuộc ngầm giữa các nhánh. Bạn chỉ nên áp dụng chạy song song khi đảm bảo tính độc lập tuyệt đối giữa các tác vụ.
4. Orchestrator-Workers
Trong mẫu Orchestrator-Workers, một nút điều phối trung tâm (Orchestrator) sẽ phân tích yêu cầu đầu vào, tự động tạo ra một số lượng các bài toán con không cố định trước tại thời điểm chạy, sau đó giao cho các nút công nhân (Workers) xử lý và gộp kết quả lại.
Do số lượng Worker được sinh ra hoàn toàn động dựa trên ngữ cảnh, rủi ro lớn nhất ở đây là hiện tượng bùng nổ chi phí token và chạm hạn mức tốc độ gọi API (rate limits). Bạn bắt buộc phải cài đặt các ranh giới vận hành khắt khe: đặt giới hạn cứng về số lượng worker tối đa (ví dụ tối đa 5 workers/lần), và thiết lập hạn mức chi phí tối đa cho toàn bộ lượt chạy trước khi kích hoạt quy trình.
5. Evaluator-Optimizer
Evaluator-Optimizer thiết lập một vòng lặp phản hồi khép kín giữa hai vai trò: Nút Tạo (Generator) sản xuất kết quả và Nút Đánh giá (Evaluator) đưa ra nhận xét, phê bình. Vòng lặp sẽ tiếp tục chỉnh sửa cho đến khi nội dung đáp ứng tiêu chuẩn chất lượng được thiết lập.
Bài thuốc ứng dụng chuẩn mực của mẫu này là quy trình Rà soát chính sách có can thiệp con người (HITL Policy Review). Nút Generator khởi tạo bản thảo hợp đồng, nút Evaluator đối chiếu bản thảo với bộ quy tắc pháp lý doanh nghiệp. Nếu phát hiện vi phạm, Evaluator gửi trả bản thảo kèm ghi chú lỗi để Generator sửa lại. Khi kết quả đạt yêu cầu, đồ thị kích hoạt cổng ngắt (interrupt gate) để chuyển bản thảo cho chuyên gia pháp lý (con người) duyệt lần cuối trước khi phát hành.
Để tránh việc vòng lặp chạy vô hạn mà không cải thiện chất lượng, bạn bắt buộc phải thiết lập ngưỡng dừng cố định: đặt số lần lặp tối đa (ví dụ tối đa 3 vòng) và ngắt luồng nếu điểm đánh giá không tăng sau 2 vòng lặp liên tiếp.
Thách thức vận hành: Tính bền vững và xử lý lũy đẳng
Dù graph engineering đem lại khả năng kiểm soát cao, việc đưa đồ thị agent vào vận hành thực tế vẫn tồn tại những lỗ hổng hạ tầng nghiêm trọng mà bạn phải chủ động xử lý.
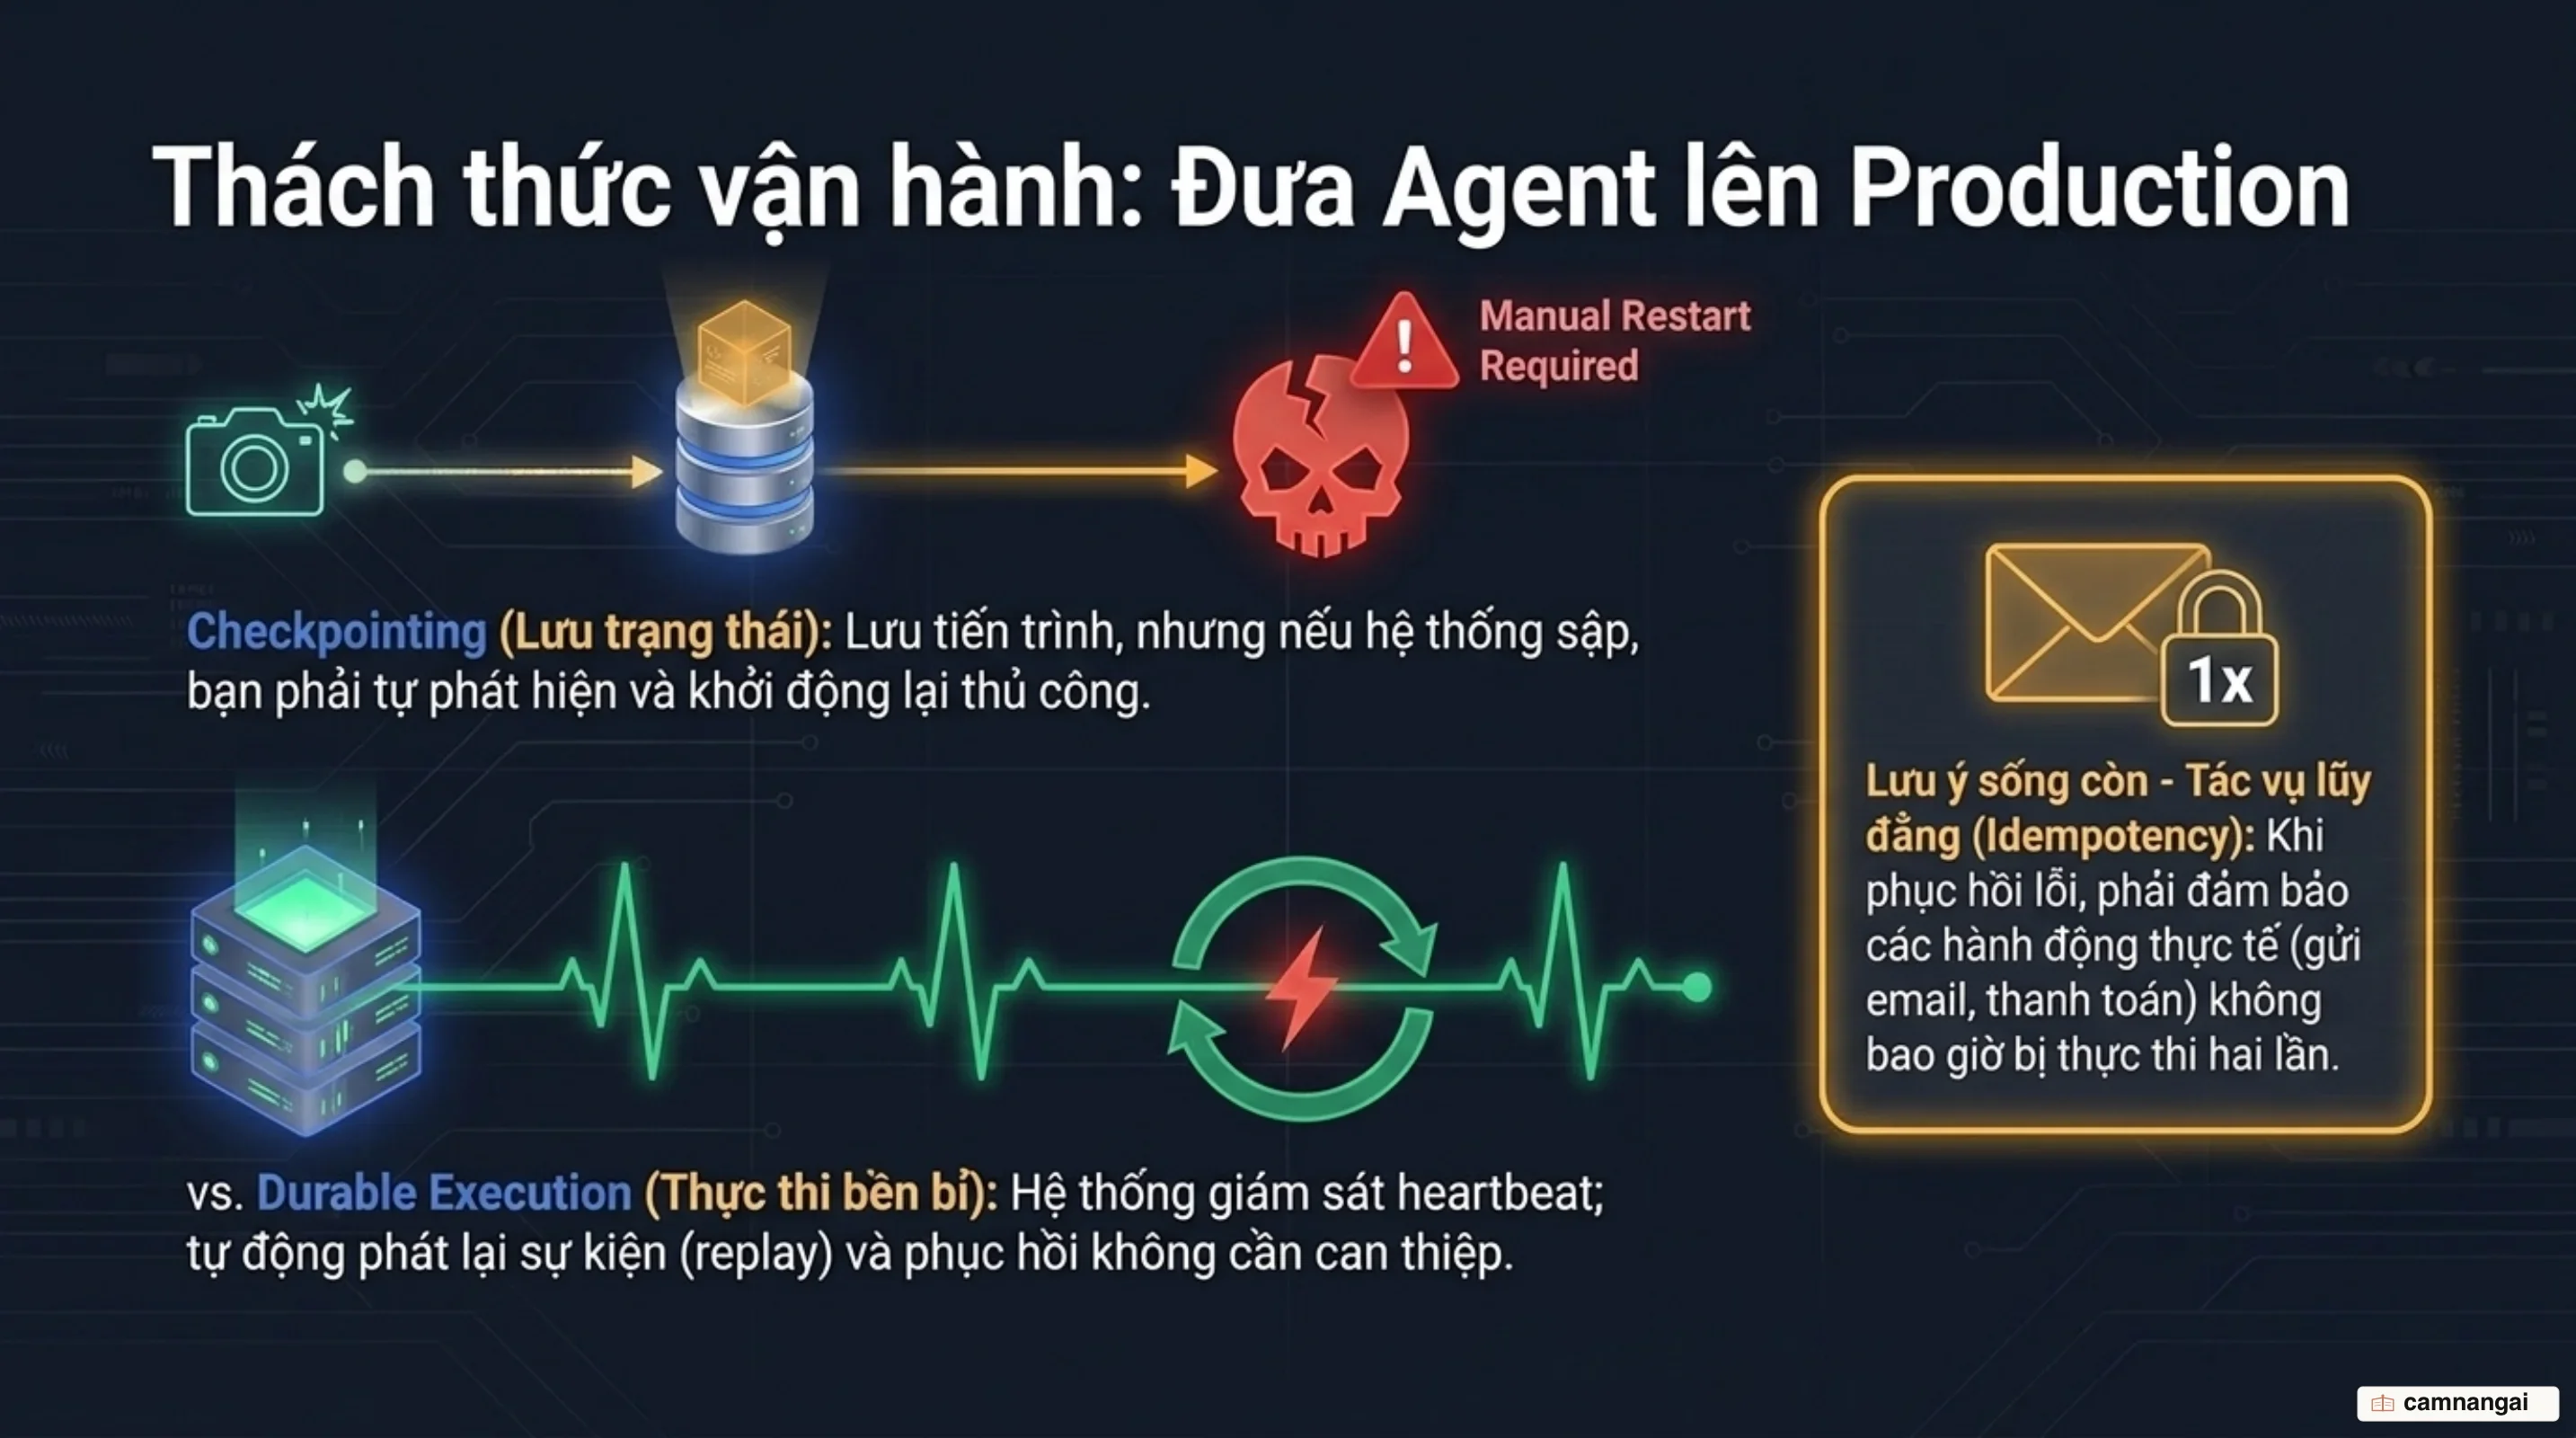
Đầu tiên là khoảng trống kiến trúc giữa Checkpointing và Thực thi bền vững (Durable Execution). Các framework như LangGraph hay CrewAI cung cấp tính năng checkpointing, tức ghi ảnh chụp trạng thái (snapshot) vào cơ sở dữ liệu. Tuy nhiên, checkpointing không phải là durable execution. Nếu tiến trình server bị sập (crash) do mất điện hoặc tràn bộ nhớ, checkpointer chỉ đơn thuần lưu dữ liệu tại đĩa cứng; nó hoàn toàn không có khả năng tự phát hiện sự cố hay tự khởi chạy lại luồng công việc. Là kỹ sư hệ thống, bạn sẽ phải tự viết hạ tầng giám sát (watchdog) và tự gọi lại hàm invoke.
Ngược lại, các runtime hỗ trợ Durable Execution thực sự (như Dapr Workflows) sở hữu cơ chế giám sát heartbeat, tự động khôi phục sự cố và phát lại dựa trên sự kiện (replay-based re-execution). Khi một nút bị sập mid-run, hệ thống sẽ tự kích hoạt lại tiến trình trên một node khác trong cluster thông qua cơ chế hashing nhất quán và tự động tái cân bằng cụm máy chủ. Khi phát lại, các hoạt động đã hoàn thành sẽ lấy trực tiếp kết quả từ nhật ký sự kiện mà không gọi lại LLM hay API, giúp hệ thống phục hồi chính xác mà không tốn chi phí trùng lặp.
Thách thức thứ hai là tác dụng phụ (Side Effects) và Tính lũy đẳng (Idempotency). Khi một nút trong đồ thị thực hiện các hành động ra môi trường bên ngoài (như quẹt thẻ thanh toán qua cổng giao dịch, gửi tin nhắn hay cập nhật dữ liệu vào CRM) rồi gặp sự cố phải thử lại (retry), nguy cơ hành động bị thực thi hai lần là rất cao. Bạn bắt buộc phải thiết kế tất cả các nút có tác động bên ngoài đạt tính lũy đẳng tuyệt đối: sử dụng mã định danh giao dịch duy nhất (idempotency keys) để đảm bảo việc thực thi nút đó một lần hay nhiều lần đều chỉ tạo ra một tác động duy nhất tới hệ thống ngoài.
Thách thức thứ ba là Lỗi đồng thuận đa agent ("Organized Nonsense"). Khi bạn thiết lập một đồ thị gồm nhiều agent cùng vận hành trên một mô hình nền tảng và cùng đọc một ngữ cảnh bị sai lệch, chúng sẽ nhanh chóng đồng thuận và xác nhận cái sai của nhau ở quy mô lớn. Để bẻ gãy vòng lặp đồng thuận độc hại này, bạn phải cài đặt các quy định kiểm định xác định từ bên ngoài: bắt buộc chạy unit test thực tế, truy vấn lại dữ liệu thô từ cơ sở dữ liệu, hoặc sử dụng các mô hình đánh giá chéo khác dòng để kiểm tra độc lập.
Khi nào nên dùng graph engineering (và khi nào chỉ cần một vòng lặp)?
Là một kỹ sư hạ tầng, bạn không nên phức tạp hóa hệ thống khi không cần thiết. Hãy bắt đầu quy trình bằng những giải pháp đơn giản nhất: sử dụng các lời gọi LLM trực tiếp, chuỗi prompt đơn giản, hoặc các khung agent tự do cho các tác vụ nghiên cứu mở hoàn toàn (open-ended research). Ví dụ điển hình là dự án GPT Researcher: ban đầu họ xây dựng hệ thống dựa trên quy trình đa agent LangGraph được định nghĩa cứng, nhưng sau đó đã chuyển sang sử dụng bộ khung nghiên cứu linh hoạt để năng lực lập luận, phân công tác vụ và quản lý ngữ cảnh bộc phát tự nhiên trong harness thay vì bị ép vào các nhánh đồ thị cố định.
Bạn chỉ nên chuyển sang áp dụng graph engineering khi bài toán kinh doanh đòi hỏi các điều kiện sau:
- Quy trình nghiệp vụ có cấu trúc rõ ràng, có thể phác thảo thành các bước cụ thể.
- Cần các luồng phân nhánh có điều kiện, xử lý lỗi chuyên biệt hoặc chạy song song để tối ưu thời gian.
- Yêu cầu khả năng kiểm toán nghiêm ngặt (audit trail), biết chính xác agent đã đưa ra quyết định tại nút nào.
- Cần các cổng dừng can thiệp của con người (Human-in-the-loop) để duyệt các tác vụ quan trọng.
Một lời khuyên thực chiến dành cho bạn: hãy đặt bàn phím xuống, phác thảo chính xác hình thái quy trình công việc của bạn ra giấy. Xác định rõ từng nút, các loại cạnh, cấu trúc State và điều kiện dừng. Hãy tự mình đóng vai từng nút, chạy thử thủ công quy trình bằng prompt trên giao diện chat đơn lẻ. Nếu quy trình chạy bằng tay không tạo ra kết quả tốt hơn rõ rệt so với một câu lệnh đơn, bạn đang gặp vấn đề về thiết kế quy trình chứ không phải công cụ. Hãy sửa hình thái đồ thị trên giấy trước khi bắt tay vào viết mã nguồn.
Tài liệu tham khảo
- Graph Engineering for AI Agents: From Prompts and Loops to Workflows — Towards Data Science
- Building Effective Agents — Anthropic
- 3 Years of Graph Engineering with LangGraph — LangChain
- Persistence and Human-in-the-Loop in LangGraph — LangChain Docs
- Graph-Based Agentic AI with LangGraph: Workflow Pathways for Long-Running Stateful Business Processes — arXiv
- Graph Engineering Explained: What Actually Changed — Louis Bouchard
- Checkpoints Are Not Durable Execution — Diagrid