Để debug AI Agent ở quy mô lớn, các công cụ Application Performance Monitoring (APM) truyền thống hoàn toàn bất lực trước tính chất phi định hình của hệ thống agentic.
APM cổ điển dựa trên các luồng yêu cầu-phản hồi tất định và mã trạng thái HTTP, trong khi agent vận
hành qua các vòng lặp suy luận bất định, nơi một phản hồi HTTP 200 OK vẫn có thể che giấu hoàn
toàn các lỗi logic sâu, ảo giác hay vòng lặp công cụ hỏng.
Mô hình quan sát hệ thống dựa trên OpenTelemetry kết hợp với quy chuẩn ngữ nghĩa GenAI là giải pháp duy nhất để debug ở quy mô lớn đáng tin cậy.
Bằng cách bóc tách cây span phân cấp từ gốc đến ngọn, hạ tầng này mang lại khả năng phân tích nguyên nhân gốc rễ cho từng bước suy luận, lượt gọi công cụ và biến động .
Nếu không chuẩn hóa tầng dữ liệu quan sát, việc vận hành agent trên môi trường sản xuất chỉ là sự phỏng đoán đầy rủi ro.
Vì sao APM truyền thống bất lực trước AI Agent?
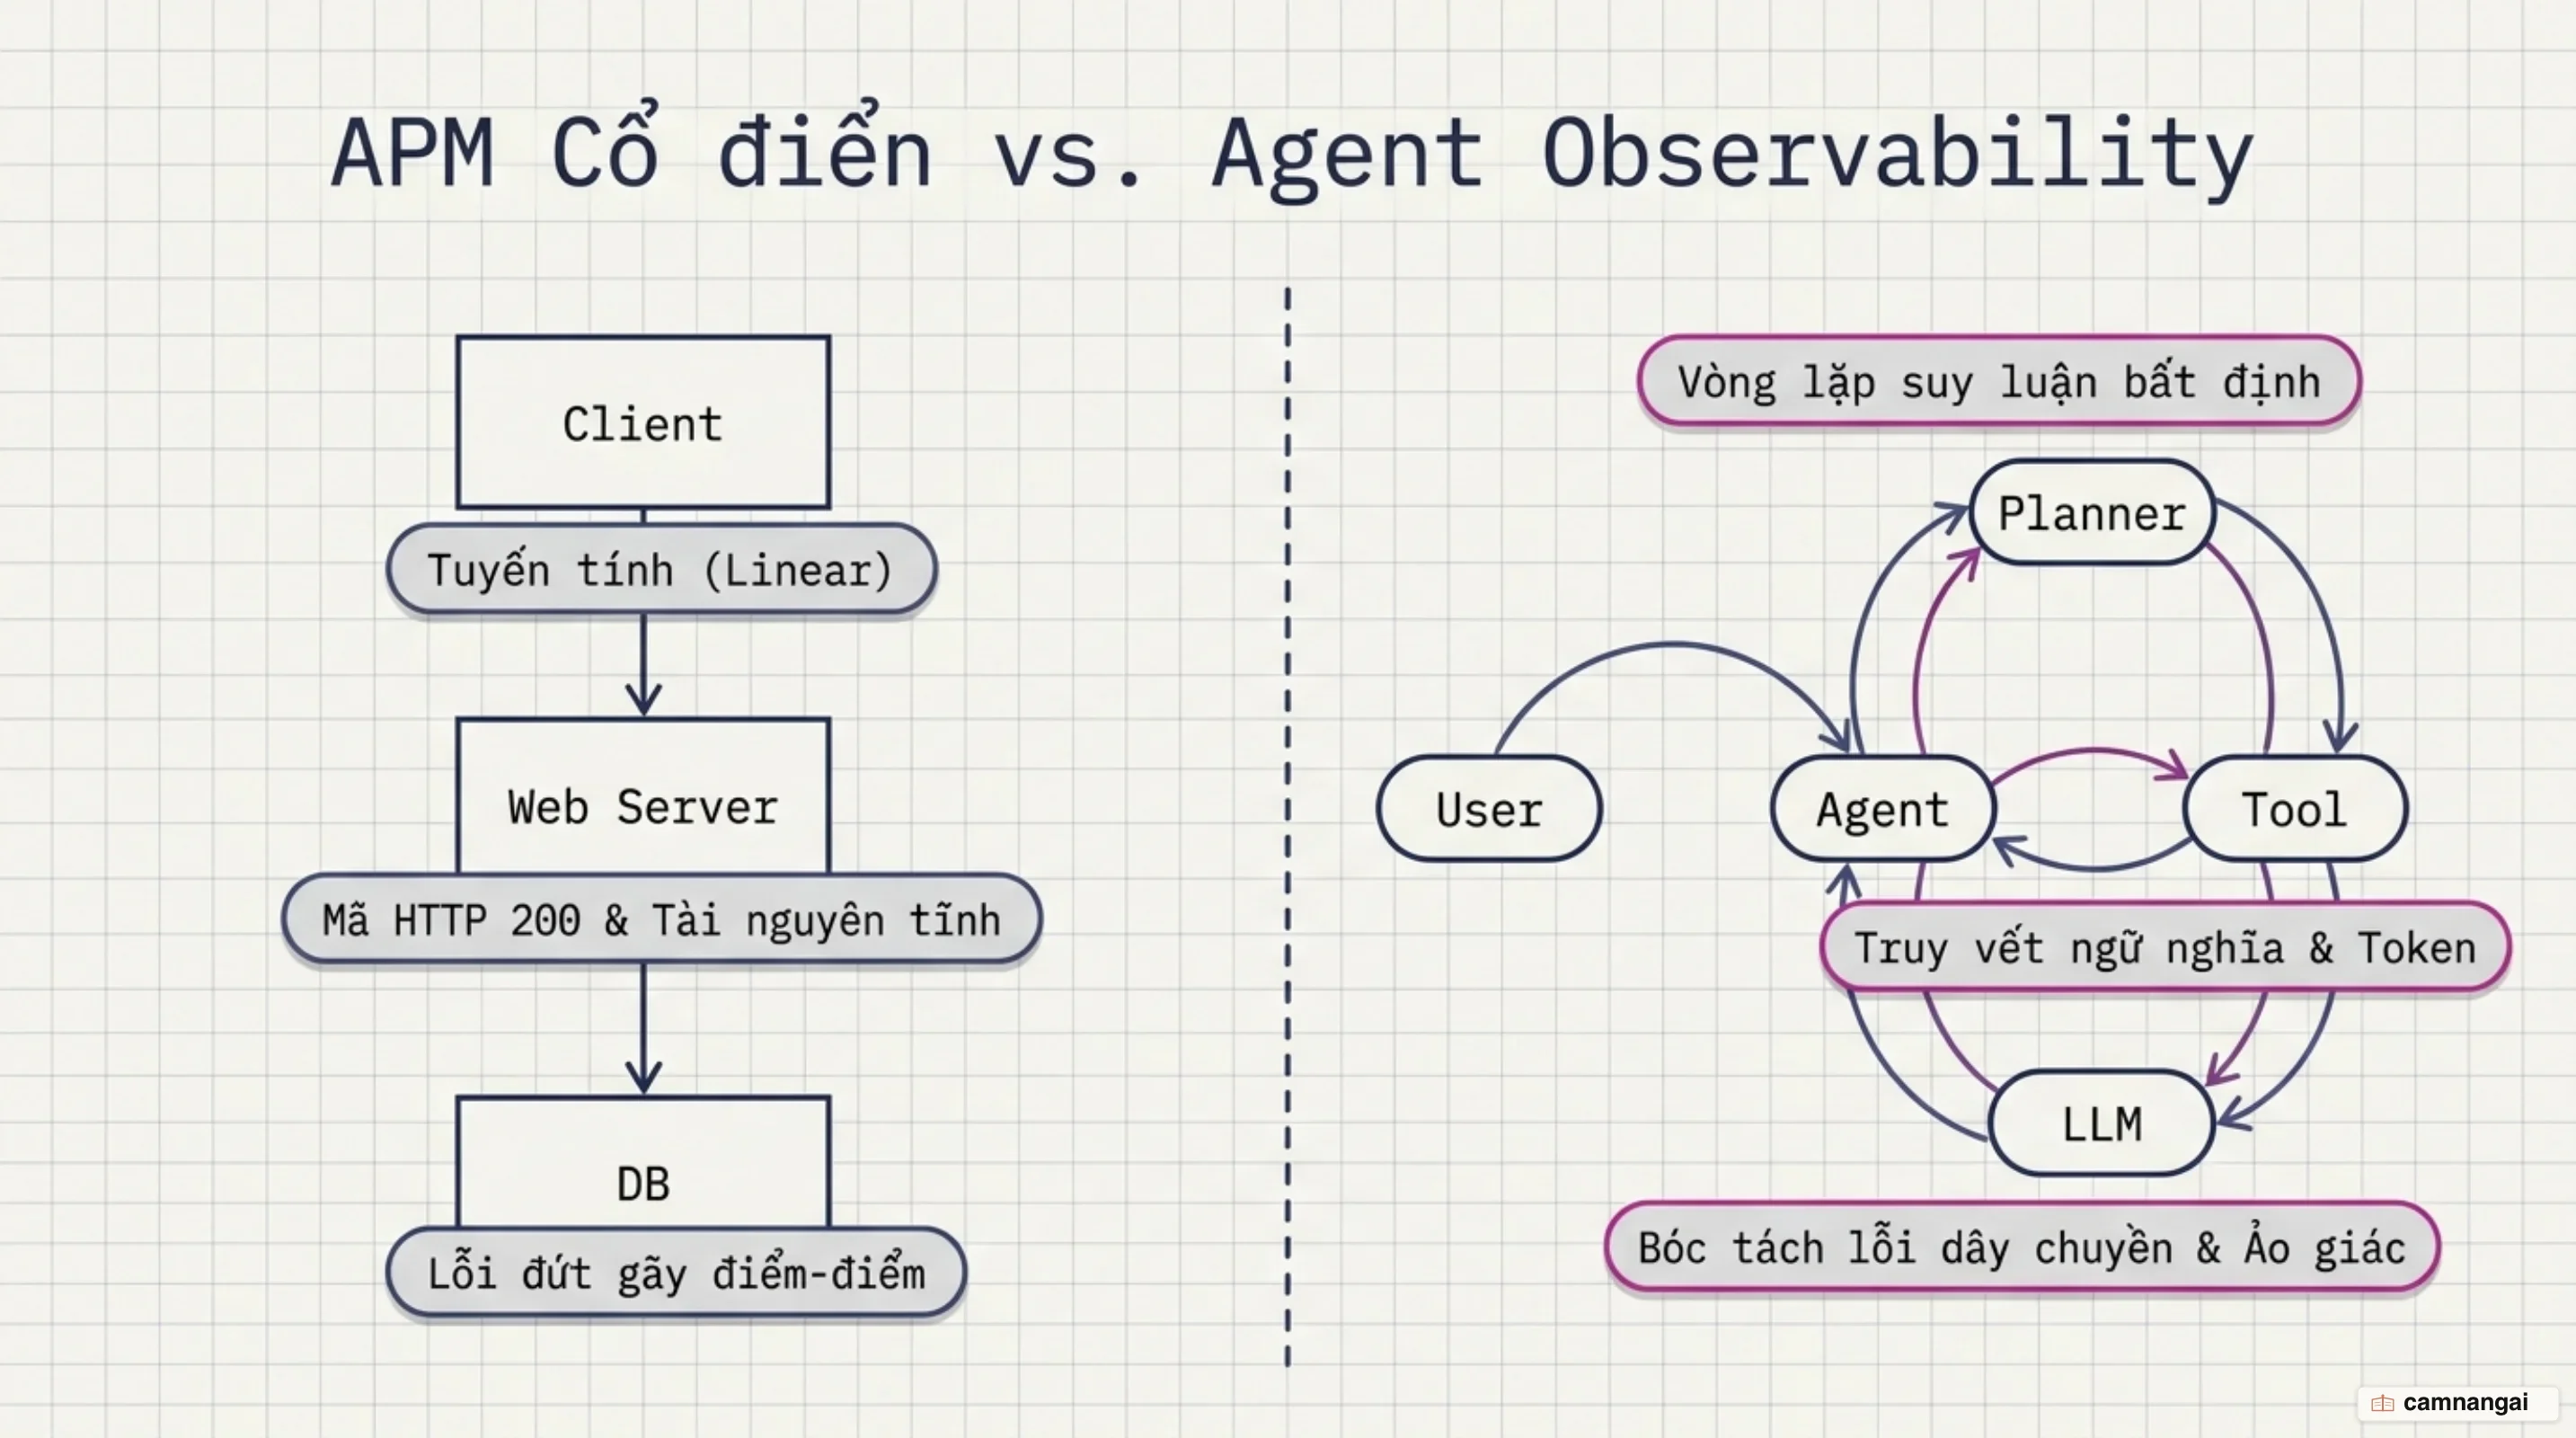
Giới hạn lớn nhất của các hệ thống APM cổ điển nằm ở giả định rằng phần mềm hoạt động theo các luồng thực thi định hình (deterministic execution paths). Trong mô hình microservices truyền thống, một yêu cầu từ người dùng đi qua các tuyến đường HTTP endpoints cố định, thực thi các truy vấn SQL đã định trước và tiêu tốn lượng tài nguyên CPU/RAM có thể dự báo. Trái lại, các hệ thống Agentic (Agentic Systems) vận hành dựa trên các vòng lặp suy luận (reasoning loops) hoàn toàn phi định hình, nơi AI Agent tự lập kế hoạch, tự chọn công cụ (tool calls) và điều hướng luồng công việc (handoffs hoặc trajectories) dựa trên bối cảnh thực tế. Sự biến đổi liên tục của cây thực thi này khiến cho các ma trận số liệu theo thời gian (time-series metrics) của APM không thể ghi nhận được lộ trình tư duy phức tạp của agent. Để khắc phục điểm yếu này, hệ thống cần khả năng ghi nhận các sự kiện rộng chứa thuộc tính có độ biến động cao (high-cardinality wide events), gom nhóm toàn bộ ngữ cảnh thực thi vào một bản ghi duy nhất thay vì chỉ đo đạc các chỉ số trung bình thô sơ.
Một thách thức kỹ thuật đặc thù khác mà hạ tầng giám sát APM truyền thống hoàn toàn bỏ sót là hiện tượng phồng bở ngữ cảnh (Context Explosion).
Trong quá trình xử lý một tác vụ phức tạp qua nhiều vòng lặp suy luận và gọi công cụ liên tiếp, dung lượng của prompt context tăng lên theo cấp số nhân. Thực tế đo đạc telemetry trên các phiên làm việc của agent ghi nhận số lượng có thể tăng vọt từ 18.5k tokens ban đầu lên đến 73.8k tokens (mức tăng thêm 55.3k tokens) chỉ trong một chuỗi tương tác đơn lẻ.
APM truyền thống không được thiết kế để theo dõi sự dịch chuyển và bùng nổ ngữ cảnh này theo thời gian thực, dẫn đến việc không thể xác định điểm nghẽn độ trễ hoặc nguyên nhân khiến chi phí vận hành gia tăng đột biến.
Việc thiếu khả năng phân tích sự thay đổi token qua từng span khiến đội ngũ SRE hoàn toàn mất phương hướng khi tìm kiếm nguyên nhân gốc rễ (Root Cause Analysis - RCA).
Tính bất định trong hành vi suy luận của còn dẫn đến hiện tượng lỗi gợn sóng (Cascading Failure) cực kỳ nguy hiểm và khó bóc tách trên môi trường sản xuất.
Một sai lệch nhỏ ở bước suy luận ban đầu , như hiện tượng ảo giác () hoặc trích xuất tham số đầu vào của công cụ bị hỏng nhẹ, sẽ không làm hệ thống nổ ngoại lệ (exception) hay sụp đổ ngay lập tức. Dữ liệu sai lệch này tiếp tục được truyền dưới dạng ngữ cảnh đầu vào cho các bước xử lý phụ bên dưới, làm trầm trọng hóa sai sót ở các vòng lặp tiếp theo và cuối cùng làm sụp đổ toàn bộ chuỗi nhiệm vụ. Do không sinh ra stack trace tiêu chuẩn của ứng dụng web, APM hoàn toàn không ghi nhận được điểm phát sinh lỗi ban đầu, biến việc điều tra sự cố thành một quá trình đoán mò tốn kém.
Việc cố gắng ứng dụng APM truyền thống để quản trị AI Agent tương tự như việc cố dùng bản đồ đường bộ cố định để dự báo hành trình của một dòng chảy liên tục biến đổi. Các công cụ giám sát cũ chỉ cung cấp cái nhìn bề nổi về hạ tầng máy chủ, trong khi điểm nghẽn thực sự lại nằm ở logic điều phối suy luận và sự tương tác phức tạp giữa agent với các dịch vụ bên ngoài.
Nếu không thiết lập một hạ tầng quan sát phân tán chuyên biệt có khả năng theo dõi liên vết từ cấp độ người dùng đến từng span của LLM, doanh nghiệp sẽ không thể vận hành ổn định hệ thống ở quy mô lớn. Do đó, chuyển đổi sang kiến trúc quan sát hệ thống dựa trên chuẩn OpenTelemetry là bước đi chiến lược mang tính bắt buộc cho mọi nền tảng AI Agent thương mại.
Kiến trúc tham chiếu: Các tầng cần quan sát trong một hệ thống Agentic
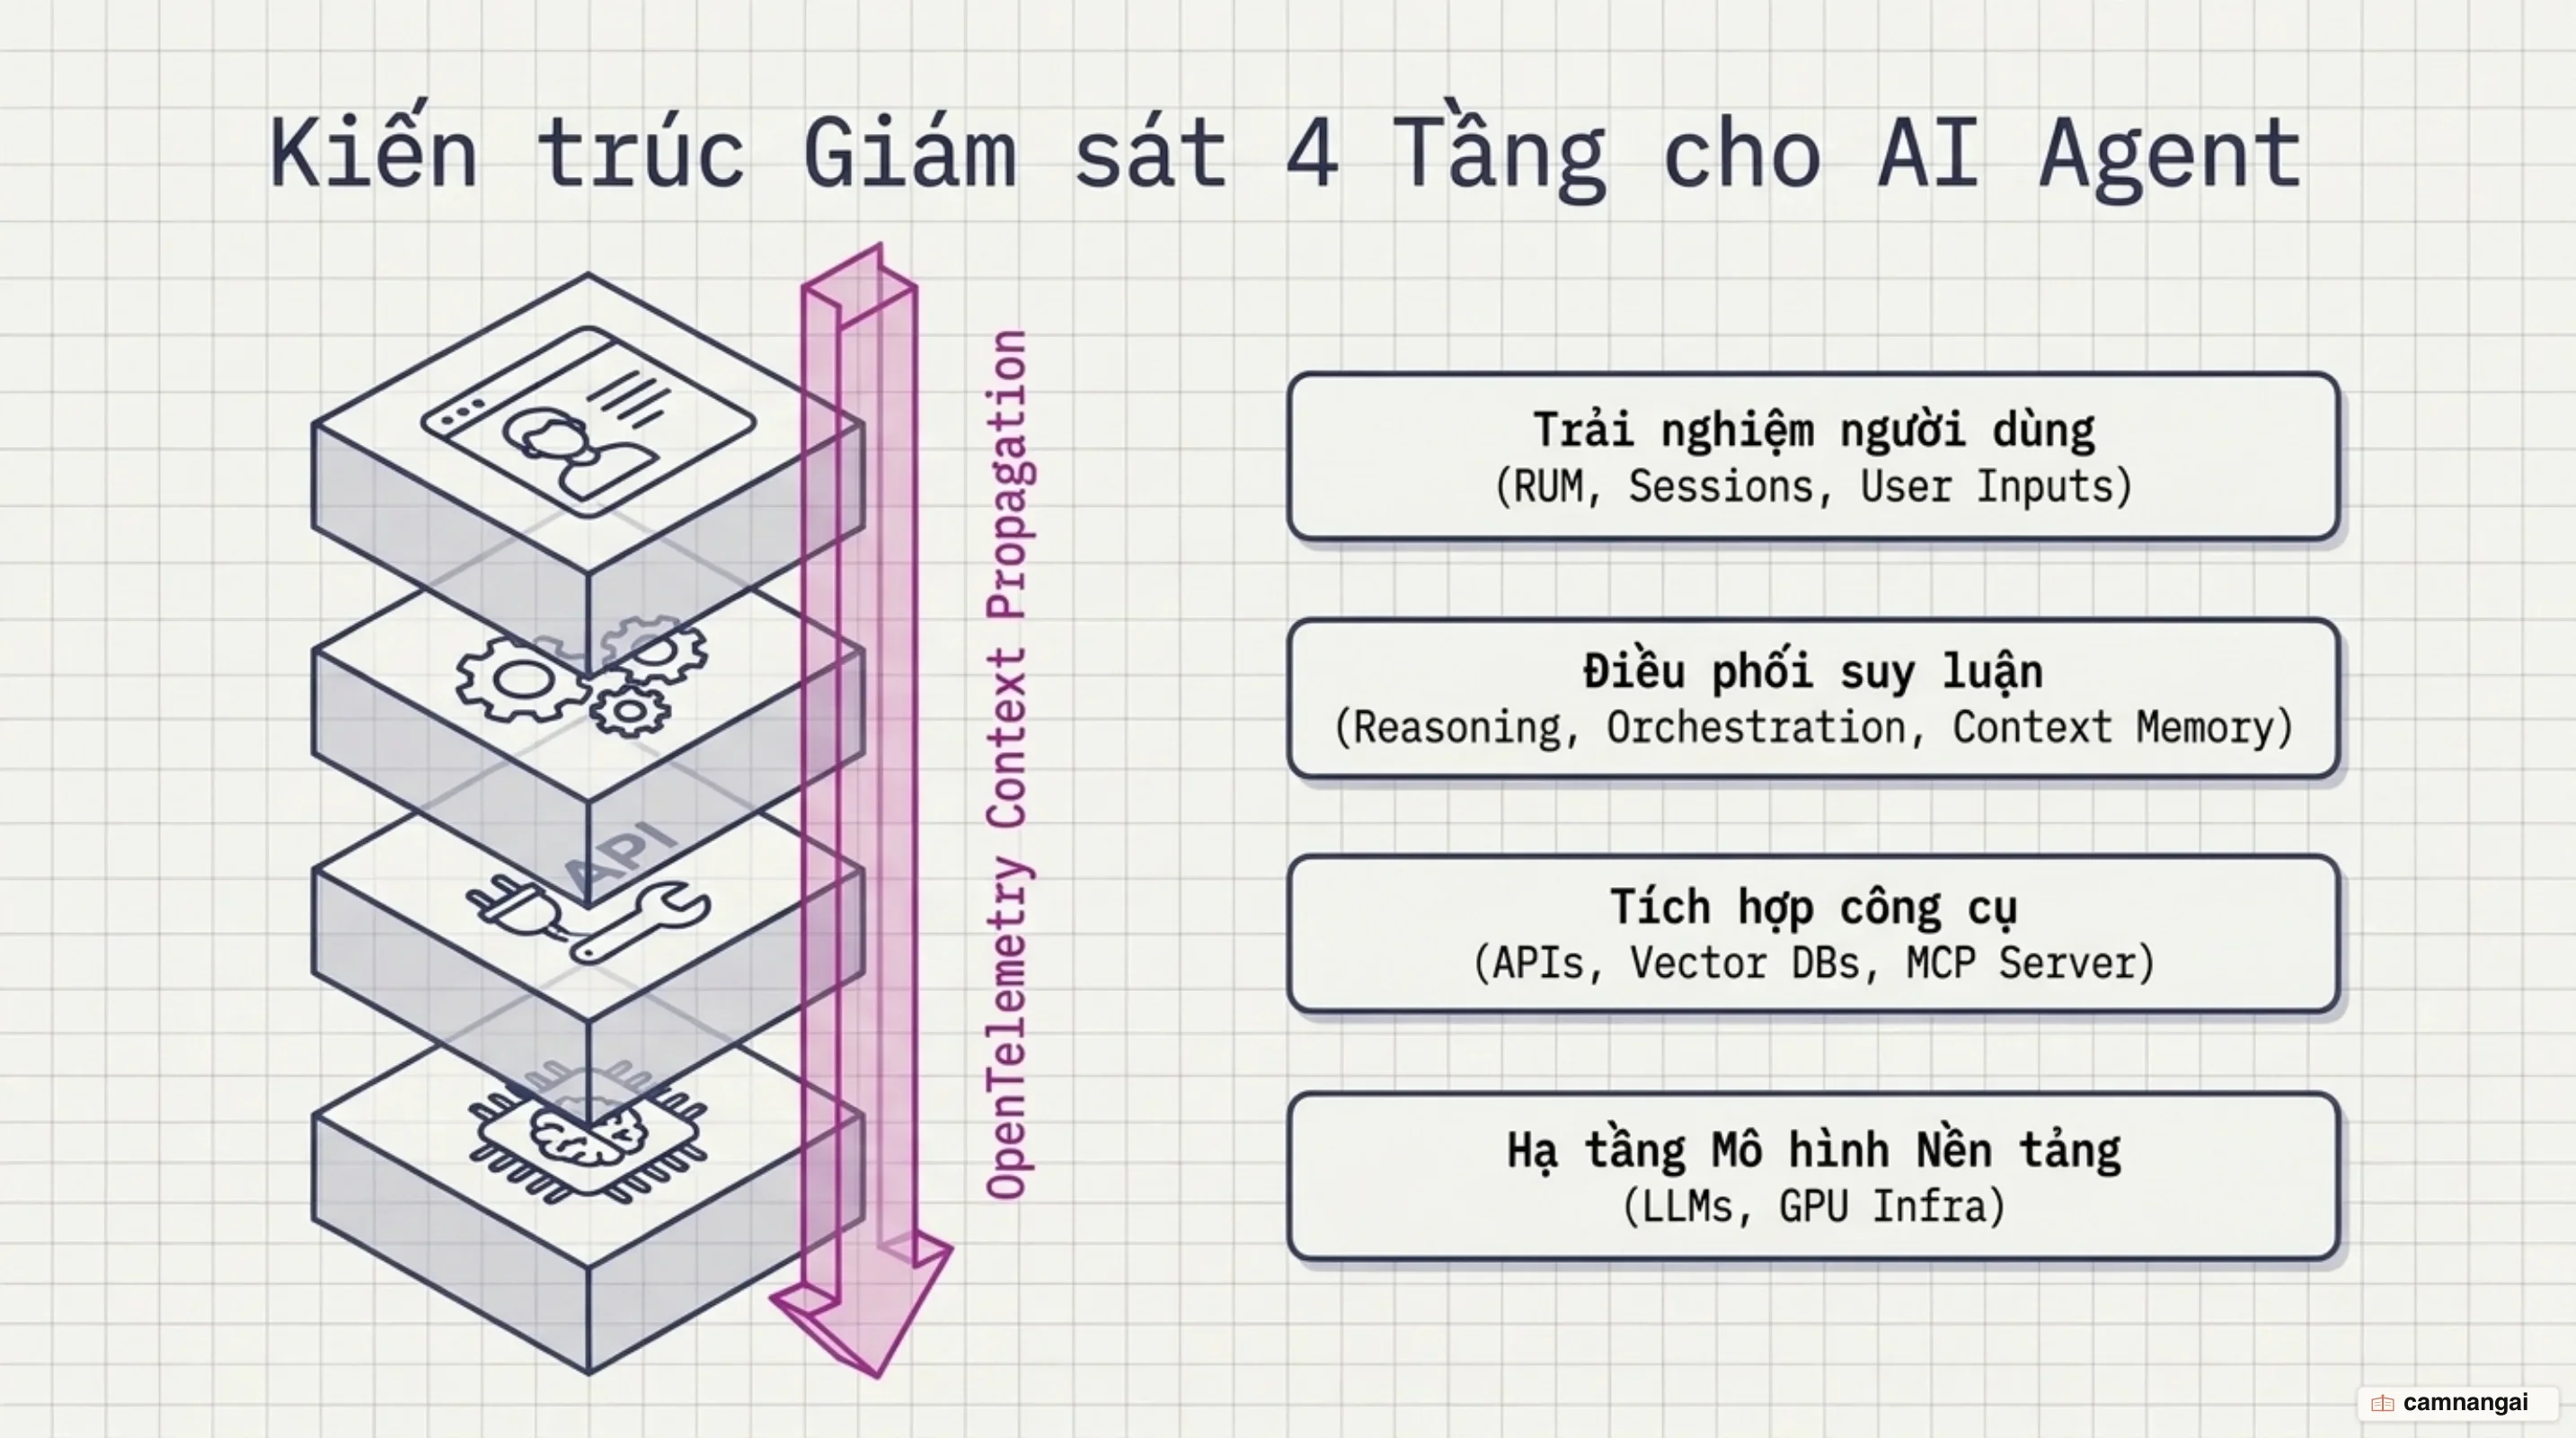
Để xây dựng một hệ thống quan sát toàn diện cho AI Agent, kiến trúc kỹ thuật phải được phân tách thành 4 tầng ranh giới rõ ràng nhưng kết nối dữ liệu thống nhất từ giao diện người dùng đến hạ tầng phần cứng:
+-------------------------------------------------------------------+
| Tầng 1: Trải nghiệm người dùng (Digital Experience & RUM) |
| - User Sessions, Session Replay, Customer Impact, Latency |
+-------------------------------------------------------------------+
 |
 v
+-------------------------------------------------------------------+
| Tầng 2: Khung điều phối Agent (Agent Orchestration Framework) |
| - LangChain, CrewAI, AutoGen, PydanticAI, Agno, LlamaIndex, SDKs |
+-------------------------------------------------------------------+
 |
 v
+-------------------------------------------------------------------+
| Tầng 3: LLM Providers & Vector DB / Tools |
| - OpenAI, Anthropic, Bedrock, Gemini, LiteLLM, Ollama |
| - Pinecone, Qdrant, Milvus, MCP Servers |
+-------------------------------------------------------------------+
 |
 v
+-------------------------------------------------------------------+
| Tầng 4: Hạ tầng tính toán (Backend & Infrastructure) |
| - GPU Utilization, Kubernetes Nodes, APM Services, Databases |
+-------------------------------------------------------------------+
Tầng 1: Trải nghiệm người dùng (Digital Experience & RUM). Tầng này trực tiếp đo đạc các chỉ số tương tác của end-user thông qua Real User Monitoring (RUM) và Session Replay. Ở tầng này, dữ liệu tập trung liên kết một phiên người dùng (User Session) với thời gian phản hồi (latency), số lượng cuộc gọi LLM, số lượng tool call và tổng chi phí phát sinh cho từng câu trả lời. Việc quan sát tại Tầng 1 giúp đội ngũ kỹ sư đánh giá chính xác cảm nhận thực tế của người dùng cuối về chất lượng đầu ra, đồng thời xác định mức độ ảnh hưởng kinh doanh khi hệ thống bị suy giảm hiệu năng hoặc phản hồi sai lệch.
Tầng 2: Khung điều phối Agent (Agent Orchestration Framework). Tầng này trực tiếp can thiệp và thu thập các sự kiện bên trong các framework điều phối như LangChain, CrewAI, AutoGen, PydanticAI, Agno, LlamaIndex, Claude Agent SDK, OpenAI Agents hay BeeAI. Nhiệm vụ cốt lõi của Tầng 2 là ghi lại chuỗi hành động, theo dõi các vòng lặp suy luận, sự phân tách nhiệm vụ của Agentic workflow và các quyết định chuyển giao công việc (handoffs hay trajectories). Việc quan sát chi tiết tầng điều phối giúp minh bạch hóa "hộp đen" trong quy trình tư duy của agent trước khi lệnh gọi được phát hành ra các tài nguyên bên ngoài.
Tầng 3: LLM Providers & Vector DB / Tools. Tầng này giám sát các cuộc gọi tới nhà cung cấp mô hình (OpenAI, Anthropic, Bedrock, Gemini, Ollama, LiteLLM) và các hệ thống phụ trợ như cơ sở dữ liệu vector (Pinecone, Qdrant, Milvus) cùng máy chủ công cụ ngoài ( Servers). Tầng 3 đo đạc chi tiết độ trễ từng yêu cầu mô hình, lượng token tiêu thụ, hiệu năng truy xuất tri thức RAG và tính chính xác trong thực thi lệnh của công cụ.
Tầng 4: Hạ tầng tính toán (Backend & Infrastructure). Đây là tầng cơ sở liên kết các dấu vết (traces) của agent với chỉ số hạ tầng bên dưới như công suất GPU (GPU utilization), trạng thái các nút Kubernetes, microservices backend và điểm nghẽn cơ sở dữ liệu. Việc tích hợp Tầng 4 vào cùng một luồng telemetry OTLP thống nhất cho phép kỹ sư SRE xác định lập tức nguyên nhân chậm trễ xuất phát từ bản thân LLM hay do hạ tầng tính toán bị nghẽn tài nguyên.
Chuẩn OpenTelemetry cho AI Agent: Cây span và cấu trúc phân tầng
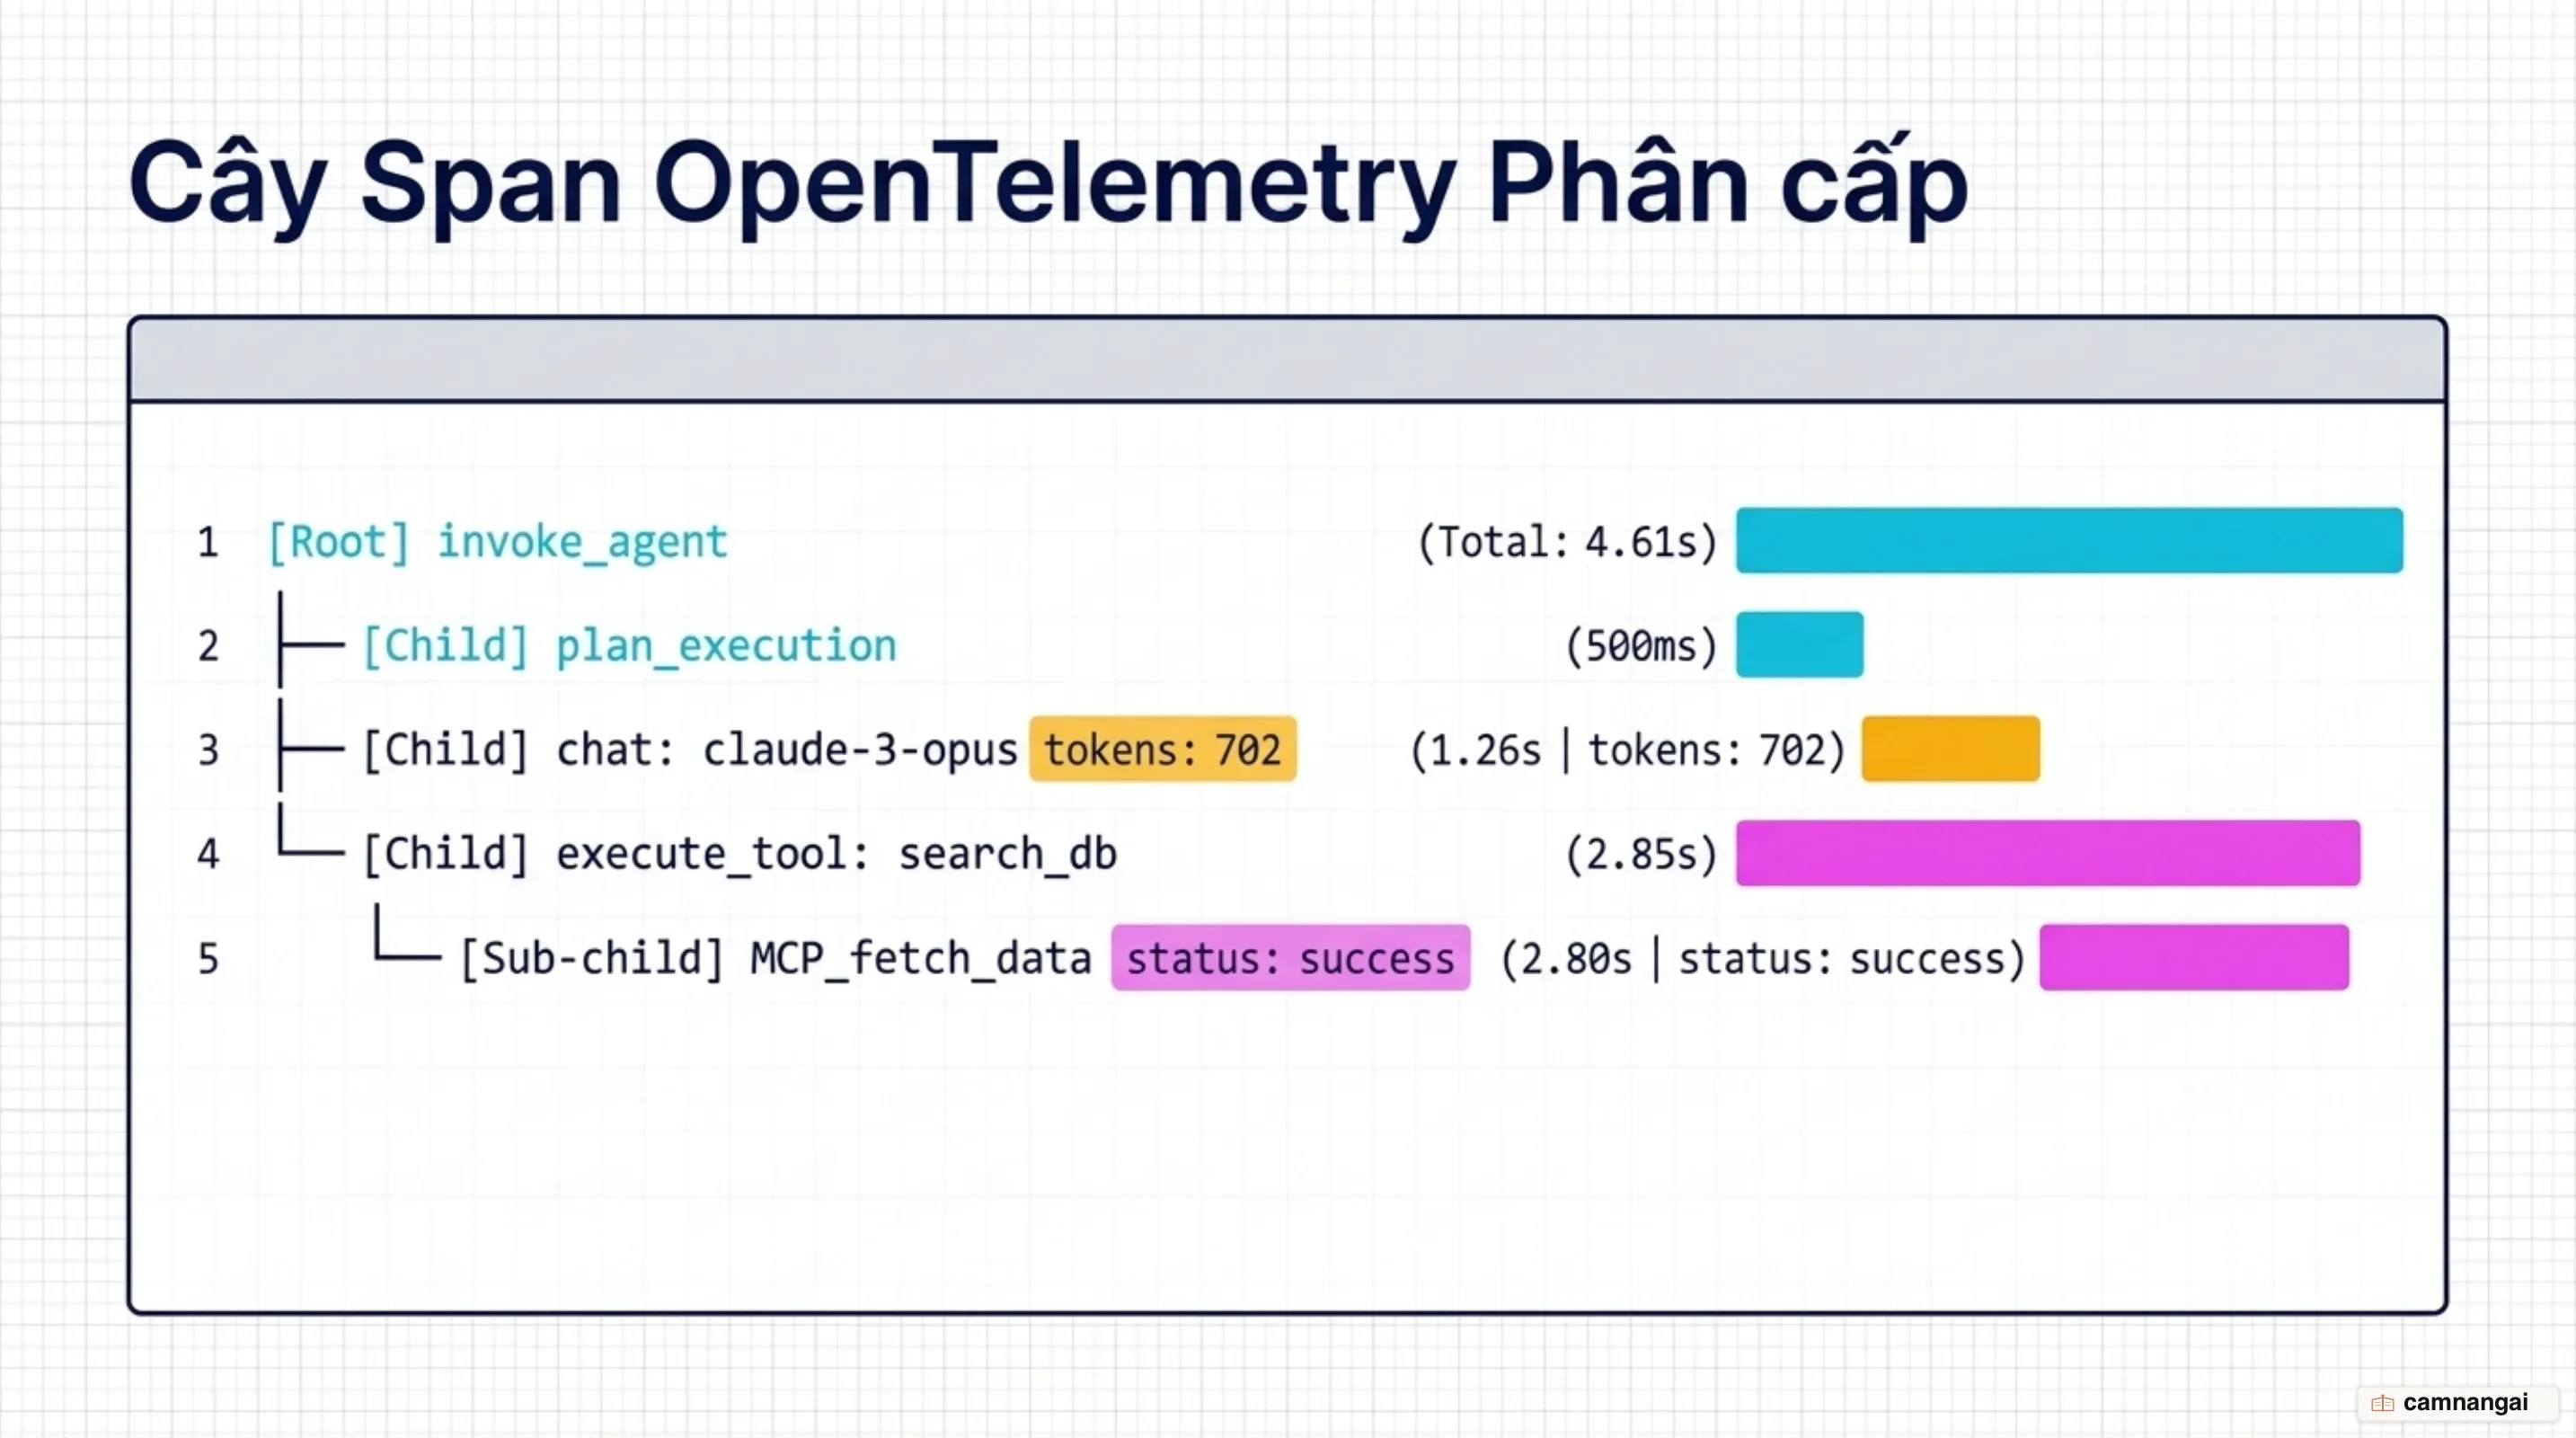
Để tiêu chuẩn hóa dữ liệu quan sát giữa các ngôn ngữ lập trình và backend phân tích khác nhau, mô hình dữ liệu dấu vết phân tán (distributed tracing data model) dựa trên chuẩn OpenInference và OpenTelemetry GenAI Semantic Conventions thiết lập một cấu trúc cây span (Span Tree / Execution Graph) phân cấp minh bạch. Trong mô hình này, một Root Agent Span bao phủ toàn bộ vòng đời thực thi của một tác vụ hoặc một phiên nhiệm vụ cấp cao, đồng thời đóng vai trò làm nút cha chứa các sub-spans con bên dưới. Mỗi nút con đại diện cho một thao tác đơn lẻ trong tiến trình suy luận, từ việc truy vấn bộ nhớ, thực thi mô hình đến việc tương tác với hệ thống bên ngoài. Cấu trúc cây này giúp tái hiện chính xác luồng di chuyển dữ liệu và sự phụ thuộc thời gian giữa các thành phần.
[Root Agent / Chain Span] (fetch.order_agent - 4.61s)
 ├── [LLM / Generation Span] (fetch.parse_order - 1.32s)
 ├── [Tool Call Span] (check_item_availability - 142ms)
 ├── [Tool Call Span] (check_store_hours - 98ms)
 ├── [Tool Call Span] (add_to_cart - 212ms)
 ├── [LLM / Generation Span] (fetch.generate_upsell - 1.56s)
 └── [LLM / Generation Span] (fetch.format_confirmation - 1.26s)
Trong cấu trúc chuẩn hóa của OpenTelemetry, các span được phân loại rõ ràng thông qua thuộc tính langfuse.observation.type hoặc các chỉ dấu ngữ nghĩa tương đương nhằm xác định chức năng cụ thể. Agent / Chain Span đóng vai trò bao phủ toàn bộ luồng công việc hoặc một bước suy luận cấp cao, gom nhóm tất cả thao tác con để đo đạc thời gian xử lý tổng thể và trạng thái thực thi của chuỗi logic. Trong khi đó, LLM / Generation Span tập trung ghi lại chi tiết từng cuộc gọi đến mô hình ngôn ngữ lớn, bao gồm prompt đầu vào, completion đầu ra, các thông số cấu hình (temperature, top_p) và chi tiết lượng token tiêu thụ (gen_ai.usage.input_tokens, gen_ai.usage.output_tokens). Việc phân tách này cho phép hệ thống bóc tách chính xác lượng thời gian tiêu tốn cho việc suy luận mô hình so với thời gian xử lý logic của ứng dụng.
Đối với các tương tác ngoại vi, Tool Call Span ghi lại chi tiết thao tác agent gọi các hàm hoặc API bên ngoài, lưu giữ tên công cụ, tham số đầu vào trích xuất từ LLM (gen_ai.tool.call.arguments) và kết quả thực thi trả về (gen_ai.tool.call.result). Việc theo dõi Tool Span là yếu tố sống còn để phát hiện các truy vấn đắt đỏ, các lỗi định dạng JSON hoặc các điểm nghẽn độ trễ từ API phía thứ ba. Song song với đó, Retriever / Embedding Span đo đạc quá trình chuyển đổi văn bản thành vector và truy xuất tri thức từ Vector DB trong kiến trúc RAG, ghi lại độ trễ câu truy vấn cùng danh sách các đoạn văn bản (text segments) được trả về. Dữ liệu này giúp kỹ sư đánh giá độ chính xác của ngữ cảnh được nạp cho agent ở từng vòng lặp suy luận.
Cuối cùng, Guardrail / Evaluator Span được thiết kế để thực thi các quy tắc kiểm soát an toàn và đánh giá chất lượng hệ thống theo thời gian thực. Span này theo dõi việc quét các nguy cơ tấn công prompt injection, kiểm tra PII, vi phạm chính sách nội dung hoặc phát hiện ảo giác (hallucination) ngay trong luồng thực thi. Việc tích hợp Evaluator Span vào cây vết chuẩn hóa giúp các đội ngũ an ninh mạng và AI Platform liên kết trực tiếp các cảnh báo an toàn với từng bước suy luận cụ thể của agent mà không làm đứt gãy luồng xử lý dữ liệu của OpenTelemetry.
Thuộc tính ngữ nghĩa và bảo mật dữ liệu: gen_ai.* cùng quy tắc Opt-in
Chuẩn OpenTelemetry định nghĩa hệ không gian tên gen_ai.* nhằm đồng nhất dữ liệu quan sát trên toàn hệ sinh thái AI. Các thuộc tính tiêu chuẩn bắt buộc phải được thiết lập đúng định dạng bao gồm gen_ai.system (nhà cung cấp mô hình), gen_ai.request.model (mô hình yêu cầu), gen_ai.response.model (mô hình phản hồi), gen_ai.usage.input_tokens và gen_ai.usage.output_tokens (số lượng token tiêu thụ), cũng như gen_ai.usage.cost (chi phí USD). Khi tích hợp với các nền tảng như Langfuse, hệ thuộc tính được mở rộng với langfuse.user.id và langfuse.session.id để định danh người dùng và phiên làm việc. Dữ liệu quan sát được phân chia thành hai loại: thuộc tính cấp trace (trace-level) mô tả ngữ cảnh dùng chung cho toàn bộ tương tác và thuộc tính cấp observation (observation-level) mô tả chi tiết từng bước riêng biệt.
Để phục vụ việc lọc và truy vấn dữ liệu nâng cao trên các nền tảng phân tích backend, cơ chế ánh xạ thuộc tính (Metadata Mapping) đòi hỏi sự phân biệt chính xác giữa các không gian tên. Khi sử dụng standard OpenTelemetry SDKs, các thuộc tính thông thường được gán trực tiếp lên span sẽ tự động bị gom vào đối tượng catch-all không thể lọc trực tiếp là metadata.attributes.* (ví dụ http.method chuyển thành metadata.attributes.http.method). Nếu kỹ sư muốn trích xuất một thuộc tính thành trường dữ liệu cấp một có thể tìm kiếm và tạo bộ lọc (filterable metadata), thuộc tính đó bắt buộc phải được tiền tố hóa bằng langfuse.trace.metadata.* hoặc langfuse.observation.metadata.* (ví dụ langfuse.trace.metadata.customer_tier sẽ ánh xạ trực tiếp thành metadata.customer_tier). Trong khi đó, các thuộc tính tài nguyên hệ thống sẽ rơi vào metadata.resourceAttributes.*.
[OTel Span Attributes]
 ├── langfuse.trace.metadata.customer_tier ──> [Top-level metadata] (Có thể truy vấn/lọc)
 ├── http.method ──> [metadata.attributes.*] (Gom nhóm catch-all)
 └── gen_ai.prompt.__proto__.foo ──> [Dropped] (Ngăn chặn Prototype Pollution)
Về mặt an toàn hạ tầng và xử lý dữ liệu nhạy cảm, quá trình thu thập telemetry áp dụng các quy tắc bảo mật nghiêm ngặt nhằm chống lại các cuộc tấn công mạng. Trong quá trình tiếp nhận dữ liệu OTLP, bất kỳ khóa thuộc tính nào chứa các phân đoạn đường dẫn nguy hiểm như __proto__, constructor, hoặc prototype (ví dụ gen_ai.prompt.__proto__.foo) sẽ tự động bị hệ thống loại bỏ (silently dropped) nhằm ngăn chặn triệt để rủi ro tấn công Prototype Pollution. Việc kiểm soát này đảm bảo cấu trúc bộ nhớ của backend phân tích không bị thay đổi bất hợp pháp bởi các dữ liệu prompt độc hại từ phía người dùng cuối hoặc từ các phản hồi của LLM.
Cuối cùng, do dữ liệu telemetry của AI Agent chứa toàn bộ prompt đầu vào và completion đầu ra, việc áp dụng nguyên tắc Opt-in kết hợp với bộ quét dữ liệu nhạy cảm (Sensitive Data Scanner) là điều kiện bắt buộc đối với môi trường doanh nghiệp. Sensitive Data Scanner vận hành tự động để phát hiện, che giấu hoặc xóa bỏ (redact) các thông tin định danh cá nhân (PII), API keys, bí mật hệ thống và mật khẩu ngay tại bộ nhớ ứng dụng trước khi đẩy dữ liệu OTLP ra ngoài ranh giới mạng. Cấu hình bảo mật này giúp nền tảng AI Agent tuân thủ triệt để các tiêu chuẩn pháp lý như HIPAA, tích hợp khả năng kiểm soát truy cập dựa trên vai trò (RBAC) và đồng bộ trực tiếp với hệ thống Governance Console của doanh nghiệp.
Bắt lỗi thực chiến: Vòng lặp vô tận, lỗi công cụ và lan truyền ngữ cảnh
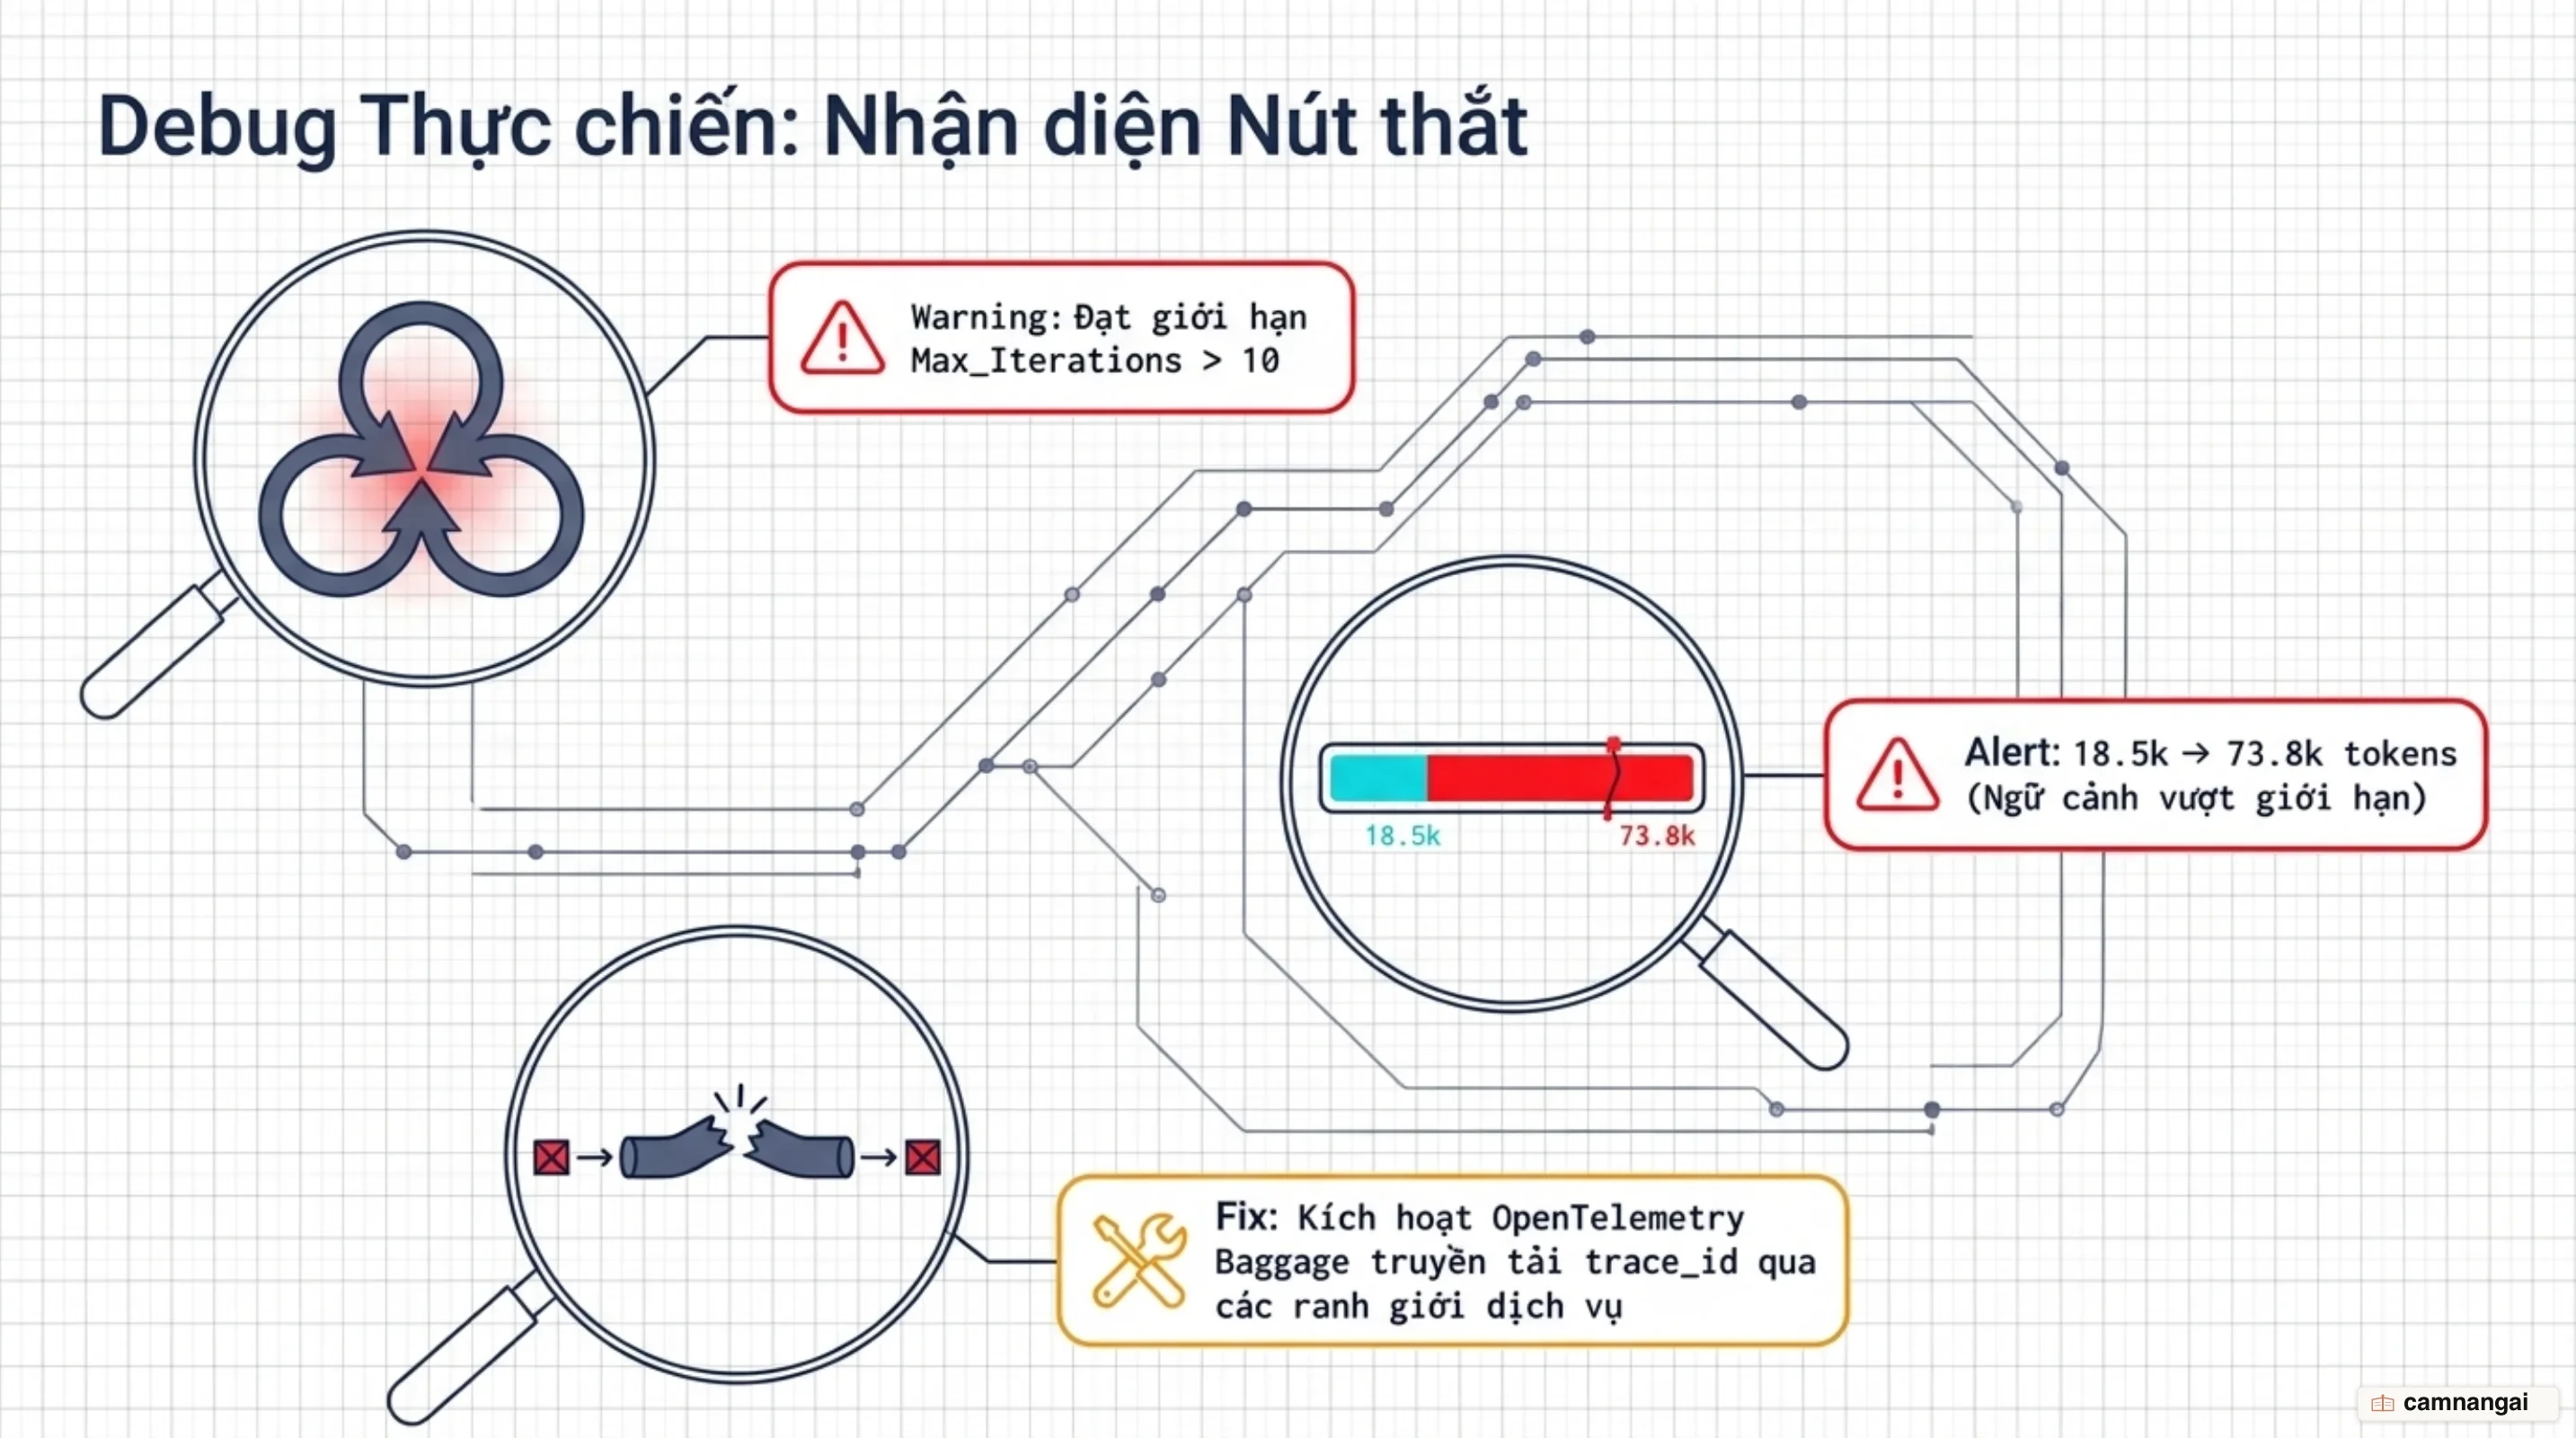
Trong môi trường vận hành thực tế (Production), các đội ngũ kỹ sư SRE và AI Platform thường xuyên đối mặt với các sự cố đặc thù của agentic systems mà chỉ có distributed tracing mới có thể xử lý triệt để. Sự cố nghiêm trọng và tốn kém nhất là hiện tượng vòng lặp vô tận (Infinite Loops), khi agent bị kẹt trong logic suy luận và liên tục đưa ra các quyết định gọi công cụ trùng lặp mà không thể thu thập đủ điều kiện để đưa ra câu trả lời cuối cùng. Bằng cách quan sát đồ thị thực thi (Execution Graph Visualization) của OpenTelemetry, kỹ sư có thể nhận diện ngay lập tức các chuỗi span gọi tool kéo dài bất thường, phân tích nguyên nhân kẹt logic suy luận và kích hoạt bộ ngắt tự động để bảo vệ tài nguyên chi phí.
[Agent Loop Failure]
Root Agent Span
 ├── LLM Span (Suy luận: "Cần lấy danh sách đơn hàng")
 ├── Tool Span: fetch_orders -> OK
 ├── LLM Span (Suy luận: "Cần lấy danh sách đơn hàng") <-- [Phát hiện vòng lặp]
 ├── Tool Span: fetch_orders -> OK <-- [Gọi lặp vô tận]
 └──... (Kẹt logic / Ngốn token)
Kịch bản sự cố phổ biến thứ hai liên quan đến lỗi công cụ và truyền sai tham số (Tool Failure Analysis).
Khi một agent thực thi thất bại, nguyên nhân gốc rễ thường xuất phát từ việc công cụ phụ trợ trả về
lỗi thay vì do bản thân mô hình ngôn ngữ lớn. Bằng cách soi vết chi tiết từ tham số đầu vào
(gen_ai.tool.call.arguments) đến kết quả thực thi (gen_ai.tool.call.result), kỹ sư có thể bóc
tách chính xác các nguyên nhân như: LLM trích xuất chuỗi JSON sai cấu trúc, công cụ gặp điểm nghẽn
truy vấn N+1 (N+1 query bottleneck), API bên ngoài hết hạn token xác thực, hoặc thao tác bị quá hạn
thời gian (timeout).
Để duy trì tính liên tục của vết telemetry xuyên qua ranh giới microservices mà không làm rò rỉ dữ liệu nhạy cảm, giải pháp tiêu chuẩn là áp dụng kỹ thuật lan truyền ngữ cảnh bằng OpenTelemetry Baggage kết hợp với BaggageSpanProcessor. Baggage tự động sao chép các khóa dữ liệu ngữ cảnh không nhạy cảm (như user_id, session_id, release, environment) từ điểm khởi tạo ban đầu và gắn vào mọi span con phát sinh ở các dịch vụ hạ tầng sâu nhất.
# Kỹ thuật khởi tạo Baggage và gắn ngữ cảnh vết trong Python
from opentelemetry import trace, baggage
from opentelemetry.processor.baggage import BaggageSpanProcessor
from opentelemetry.sdk.trace import TracerProvider

# 1. Cấu hình BaggageSpanProcessor vào TracerProvider
provider = TracerProvider()
provider.add_span_processor(BaggageSpanProcessor())
trace.set_tracer_provider(provider)
tracer = trace.get_tracer(__name__)

# 2. Thiết lập thuộc tính ngữ cảnh không nhạy cảm vào Baggage tại điểm khởi tạo
ctx = baggage.set_baggage("user_id", "usr_9982")
ctx = baggage.set_baggage("session_id", "sess_a3f8c2e1")
ctx = baggage.set_baggage("environment", "production")

# 3. Mọi span downstream tự động kế thừa các thuộc tính trên
with tracer.start_as_current_span("agent_reasoning_step", context=ctx) as span:
 # Các thuộc tính user_id, session_id tự động xuất hiện trên span này
 pass
Lưu ý bảo mật: Do dữ liệu Baggage được lan truyền xuyên biên giới dịch vụ thông qua các tiêu đề HTTP (HTTP headers), tuyệt đối không đưa các thông tin nhạy cảm như API keys hay mật khẩu vào Baggage.
Vòng lặp đánh giá và FinOps: Tối ưu chi phí và hiệu quả của Agent
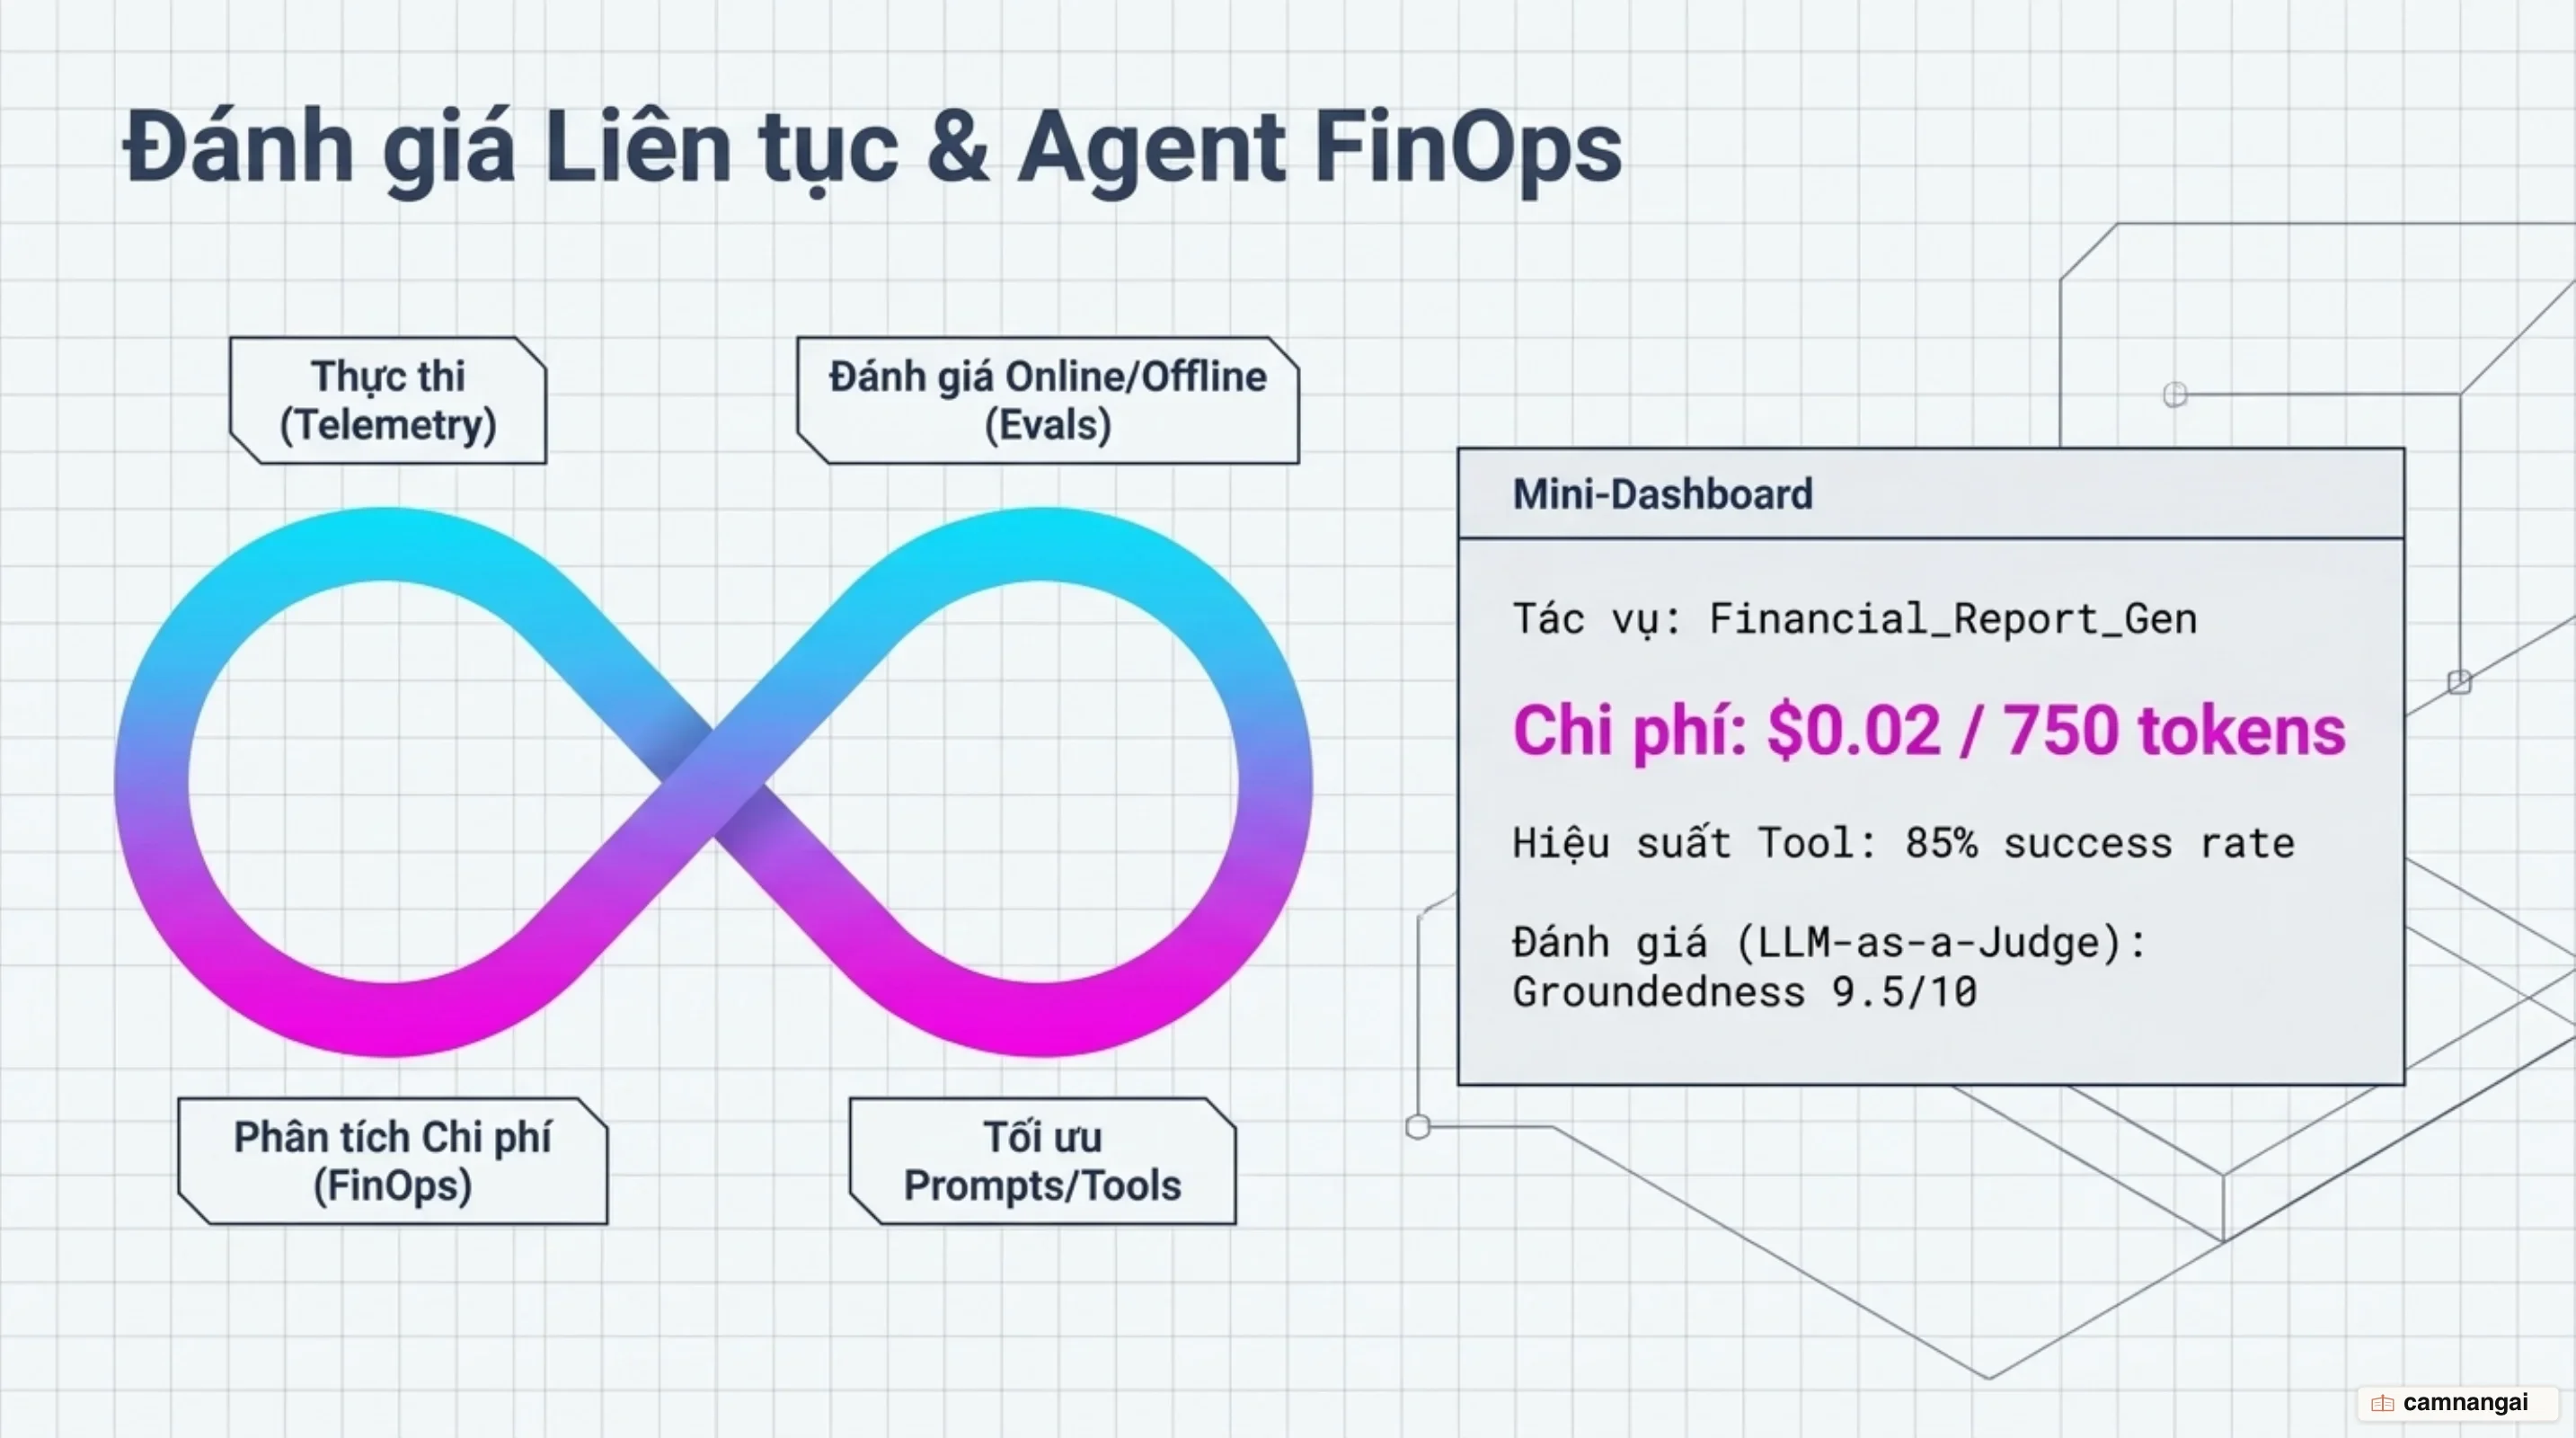
Một trụ cột quan trọng trong việc vận hành AI Agent ở quy mô lớn là quản trị chi phí (FinOps) thông qua Mô hình tính phí LLM Span (LLM Span Billing Model).
Theo tiêu chuẩn hiện đại của các nền tảng quan sát, hệ thống chỉ tính phí trên số lượng LLM Spans
(tức các cuộc gọi trực tiếp tới nhà cung cấp mô hình như OpenAI hay Anthropic). Toàn bộ các span phụ
trợ khác, bao gồm Tool Spans, Workflow Spans, Retrieval Spans và Agent Spans, đều được miễn
phí hoàn toàn. Cơ chế này loại bỏ rào cản tài chính khi ngữ cảnh ứng dụng mở rộng, cho phép đội ngũ
kỹ sư tự do xây dựng các quy trình agent phức tạp với nhiều bước kiểm tra mà không sợ bùng nổ chi
phí giám sát.
+-------------------------------------------------------------------+
| 1. Production Traces (Vận hành thực tế & Thu thập vết) |
+-------------------------------------------------------------------+
 |
 v
+-------------------------------------------------------------------+
| 2. Golden Datasets (Trích xuất các trace chuẩn có phiên bản) |
+-------------------------------------------------------------------+
 |
 v
+-------------------------------------------------------------------+
| 3. Offline Experiments (Thử nghiệm Prompt / Model / Config) |
+-------------------------------------------------------------------+
 |
 v
+-------------------------------------------------------------------+
| 4. Evals & Human Annotation Queue (Chấm điểm tự động & Con người) |
+-------------------------------------------------------------------+
 |
 +--> [Cải thiện & Deploy lại Prod]
Dữ liệu telemetry thu thập từ môi trường sản xuất chính là nguồn nhiên liệu đầu vào để xây dựng quy trình phát triển khép kín (Closed-Loop Development). Từ các vết thực tế (Production Traces), kỹ sư có thể lọc và trích xuất các bản ghi chuẩn để tạo thành bộ dữ liệu kiểm thử có phiên bản (Versioned Golden Datasets). Trên tập dữ liệu này, hệ thống áp dụng quy trình kiểm soát chất lượng hai tầng: tầng đánh giá tự động (built-in và custom evaluators) để chấm điểm hallucination, độ an toàn và độ chính xác KPI; kết hợp với hàng đợi gán nhãn của con người (Annotation Queue) để các chuyên gia trực tiếp kiểm duyệt và dán nhãn các trường hợp biên (edge cases).
Việc kết hợp giữa quan sát thời gian thực và thực nghiệm offline tạo điều kiện cho các đội ngũ triển khai thử nghiệm A/B song song các phiên bản prompt, model và cấu hình agent trước khi tung ra sản xuất. Thông qua số liệu đo đạc thực tế từ hạ tầng quan sát, các tổ chức áp dụng mô hình này đã ghi nhận những cải thiện vượt bậc về mặt kỹ thuật và vận hành:
- Giảm 40% lượng token tiêu thụ trên mỗi nhiệm vụ nhờ loại bỏ các bước suy luận thừa và tối ưu hóa cấu trúc prompt context.
- Cải thiện 400% thời gian trung bình để khắc phục sự cố (MTTR) nhờ khả năng khoanh vùng chính xác điểm lỗi gợn sóng trên cây span phân tán.
- Tăng 15% tốc độ triển khai tính năng mới nhờ có bằng chứng thực nghiệm rõ ràng xác nhận chất lượng trước khi phát hành.
Bằng cách gắn kết FinOps với vòng lặp đánh giá tự động, doanh nghiệp không chỉ chứng minh được hiệu quả đầu tư (ROI) của các sáng kiến AI mà còn thiết lập một rào cản kỹ thuật vững chắc chống lại sự suy giảm chất lượng mô hình (model drift) trên môi trường vận hành thực tế.
Lời kết: Chuẩn hóa tầng dữ liệu quan sát trước khi mở rộng quy mô Agent
Triển khai tầng dữ liệu quan sát (observability layer) dựa trên tiêu chuẩn OpenTelemetry không phải là một tính năng bổ sung tùy chọn hay một giải pháp xử lý tình huống, mà là điều kiện tiên quyết bắt buộc trước khi bất kỳ tổ chức nào bắt đầu mở rộng (scale) AI Agent lên quy mô sản xuất thương mại. Việc đưa agent ra môi trường thực tế mà thiếu hạ tầng distributed tracing chuyên biệt đồng nghĩa với việc chấp nhận vận hành một hệ thống "hộp đen" đắt đỏ, dễ sụp đổ và không thể kiểm soát.
Đội ngũ kỹ sư AI và SRE cần nhất quán sử dụng duy nhất một SDK và Tracer chuẩn hóa xuyên suốt từ môi trường phát triển thử nghiệm (Dev/Playground) tới môi trường vận hành sản xuất (Production). Việc loại bỏ hoàn toàn các công cụ giám sát phân mảnh (tool silos) giúp tạo ra một ngôn ngữ chung và luồng dữ liệu liên tục giữa AI Engineers, Data Scientists và DevOps, từ đó tăng tốc đáng kể quy trình phân tích nguyên nhân gốc rễ (RCA) và tối ưu hóa hệ thống.
Hơn thế nữa, việc chuẩn hóa dữ liệu telemetry theo định dạng chuẩn OpenTelemetry (OTLP) giúp doanh nghiệp hoàn toàn làm chủ tài sản dữ liệu quan sát của mình. Kỹ sư có thể tự do lựa chọn, thử nghiệm hoặc chuyển đổi linh hoạt giữa các nền tảng phân tích backend hàng đầu như Arize Phoenix, Datadog, Honeycomb, Langfuse hay Dynatrace mà không bao giờ rơi vào bẫy khóa chặt nhà cung cấp (vendor lock-in).
Làm chủ tầng quan sát chính là chìa khóa cốt lõi để chuyển dịch từ các bản thử nghiệm agent sơ khai sang các hệ thống agentic cấp doanh nghiệp hoạt động tin cậy, tối ưu chi phí và sẵn sàng mở rộng quy mô không giới hạn.
Tài liệu tham khảo
- AI Agent Observability with OpenTelemetry — System Design One
- OpenTelemetry Semantic Conventions for Generative AI — OpenTelemetry
- Observability for Generative AI with OpenTelemetry — OpenTelemetry
- OpenInference: Semantic Conventions for AI Agents — Arize AI
- OpenTelemetry Native Integration for LLMs & AI Agents — Langfuse
- Observability for AI Agents — Honeycomb
- OpenLLMetry: OpenTelemetry SDK for AI Agents — Traceloop
- AI Agent Observability in Production — Datadog