Chain of Thought (CoT) là một kỹ thuật prompt giúp mô hình ngôn ngữ lớn (LLM) giải quyết các bài toán phức tạp bằng cách chia nhỏ quá trình tư duy thành các bước suy luận trung gian chuỗi logic trước khi đưa ra kết quả cuối cùng.
Thay vì yêu cầu mô hình ánh xạ trực tiếp từ câu hỏi đầu vào sang câu trả lời đầu ra, CoT kích hoạt khả năng suy nghĩ thành lời của LLM, giúp cải thiện đáng kể độ chính xác trong các tác vụ đòi hỏi lý luận đa bước như toán học, logic, lập trình và suy luận thông thường.
Phương pháp này mô phỏng quá trình giải quyết vấn đề của con người: chia một bài toán tổng thể thành nhiều mắt xích nhỏ hơn và giải quyết từng bước theo trình tự. Khi mô hình tạo ra các bước lý giải trung gian trong cửa sổ ngữ cảnh, các token suy luận này trở thành tiền đề ngữ cảnh cho các bước tiếp theo, từ đó giảm thiểu sai số tính toán và hiện tượng nhảy vội đến kết luận.
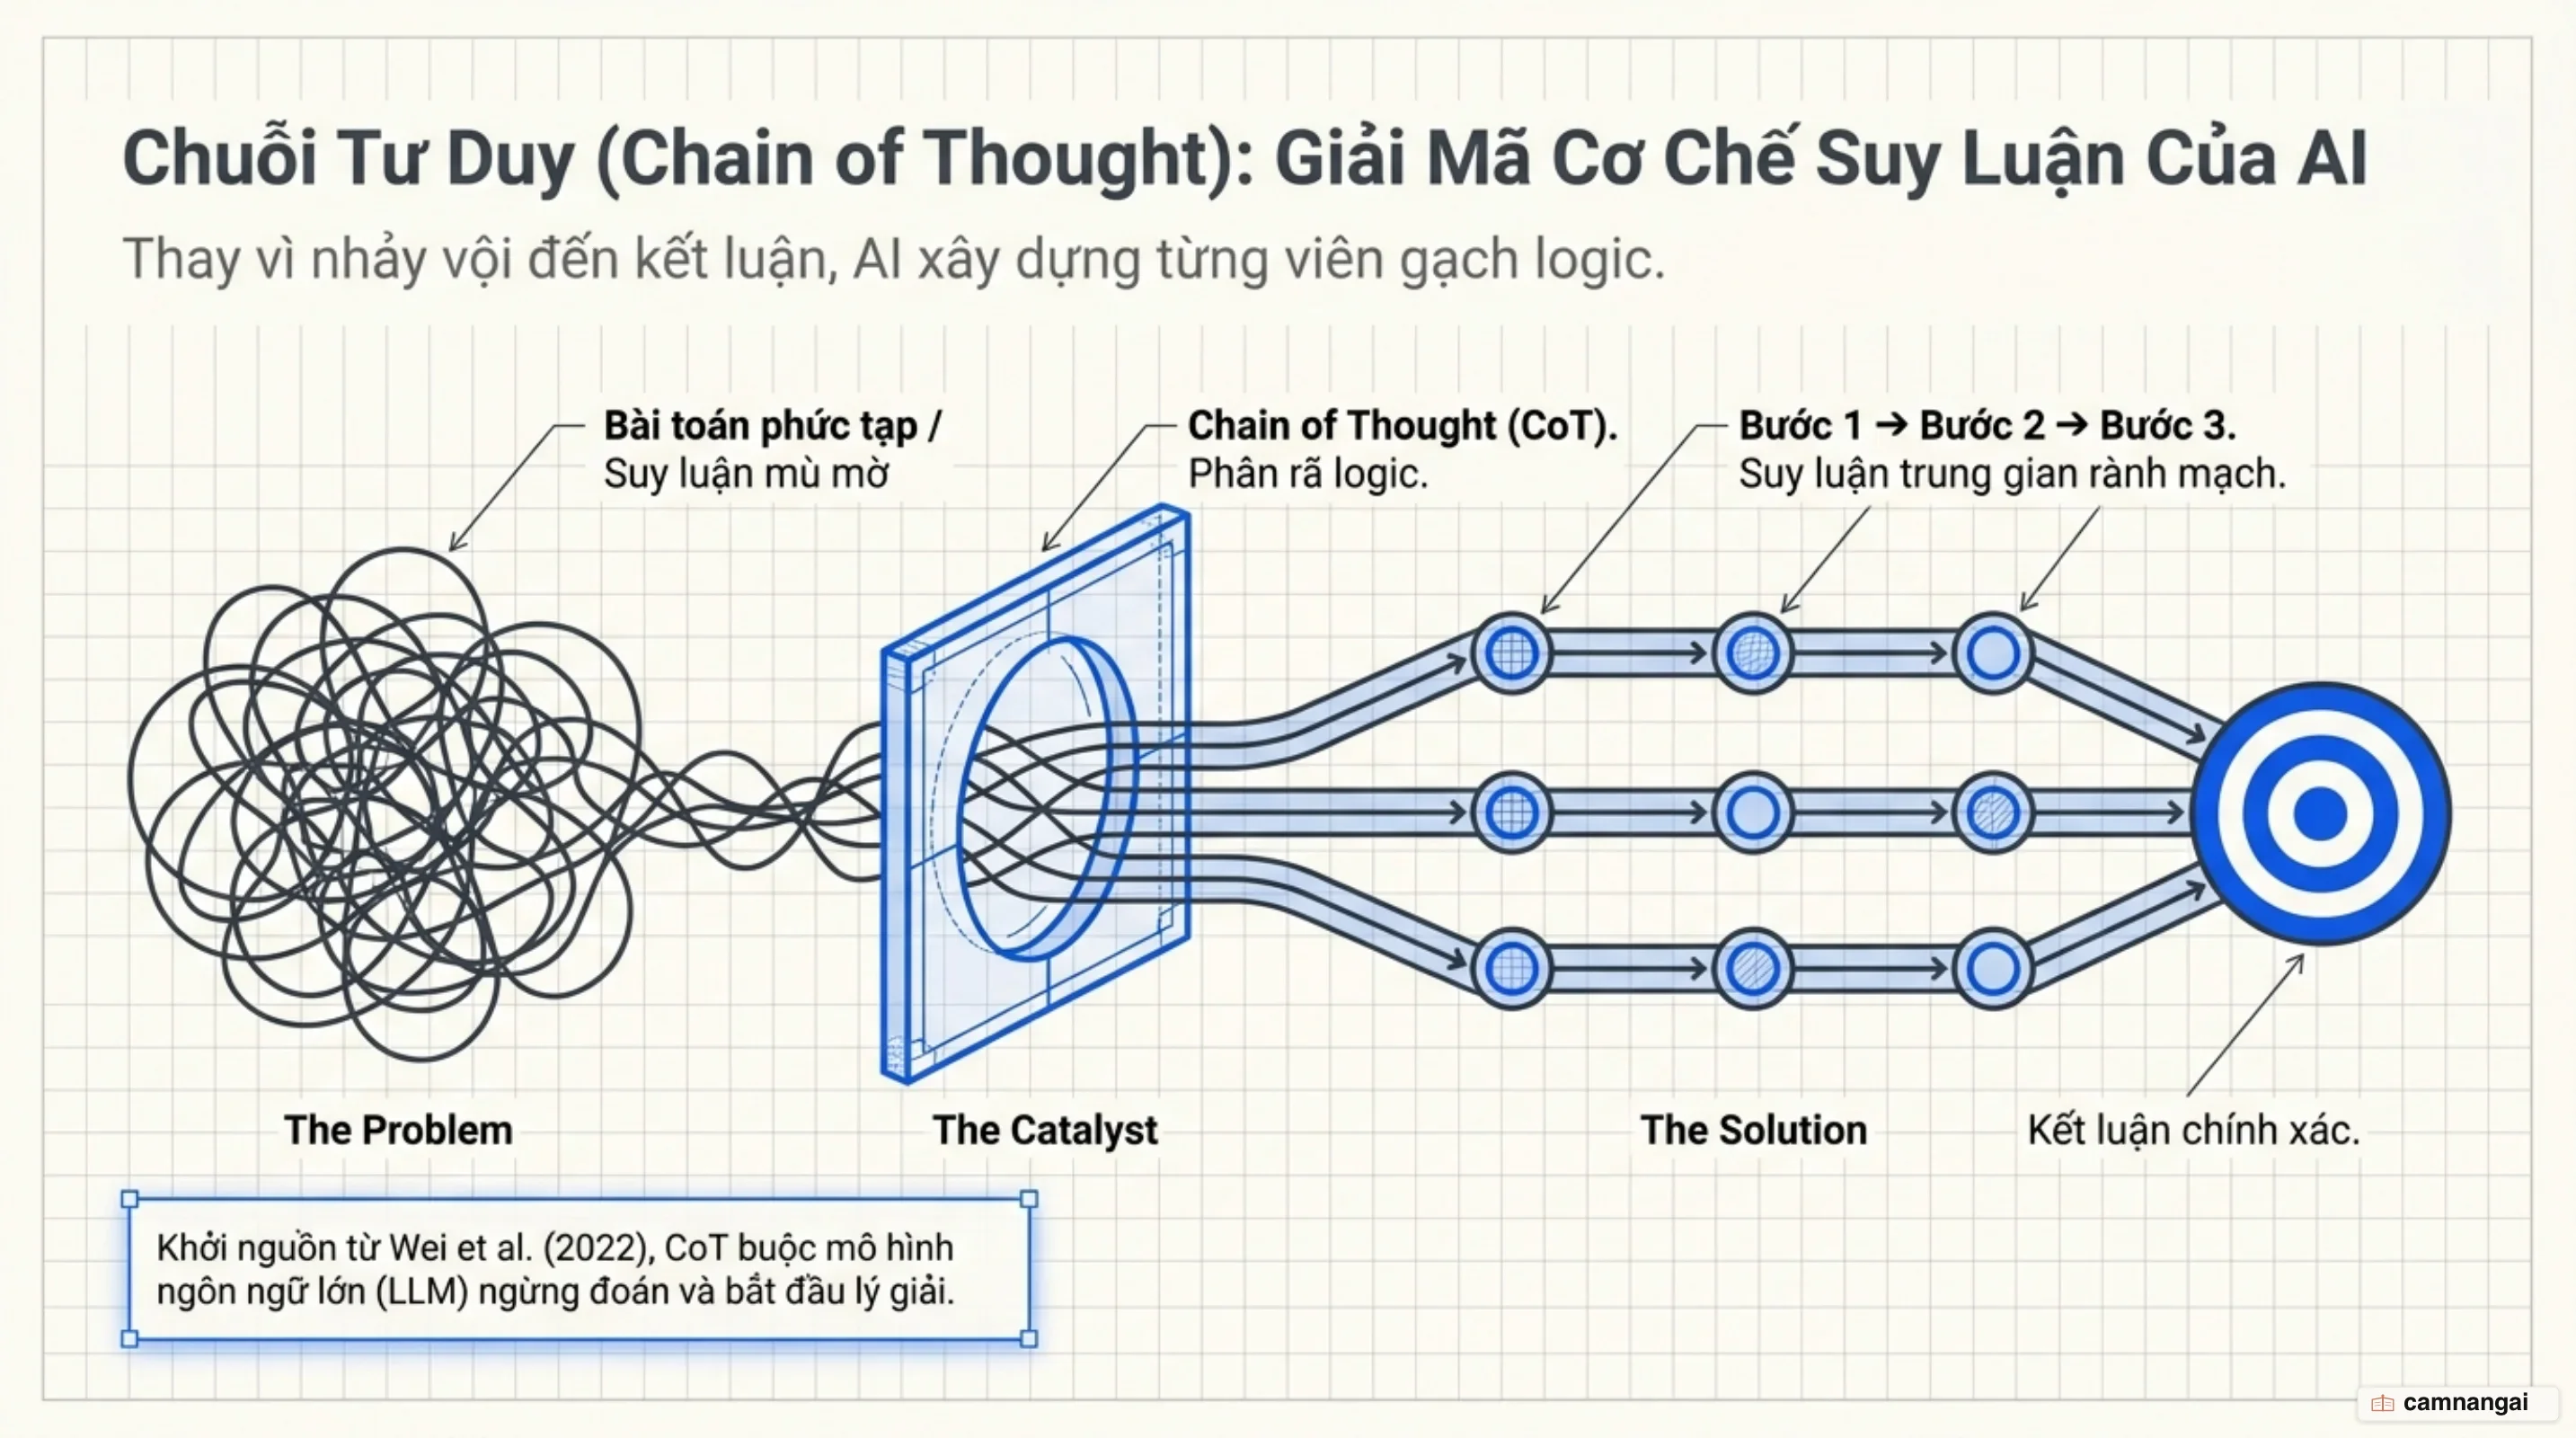
Chain of Thought là gì và vì sao LLM gặp khó khăn với suy luận trực tiếp
Trong kỹ thuật prompt tiêu chuẩn (standard prompting), mô hình ngôn ngữ lớn được yêu cầu tạo ngay lập tức câu trả lời cuối cùng dựa trên chuỗi token đầu vào. Cơ chế dự đoán token tiếp theo theo xác suất hoạt động hiệu quả với các câu hỏi truy vấn thông tin trực tiếp hoặc định dạng lại văn bản. Tuy nhiên, đối với các bài toán phức tạp đòi hỏi suy luận đa bước—như bài toán số học, chứng minh logic, phân tích mã nguồn hay lý luận thông thường—phương pháp ánh xạ trực tiếp này bộc lộ hạn chế nghiêm trọng.
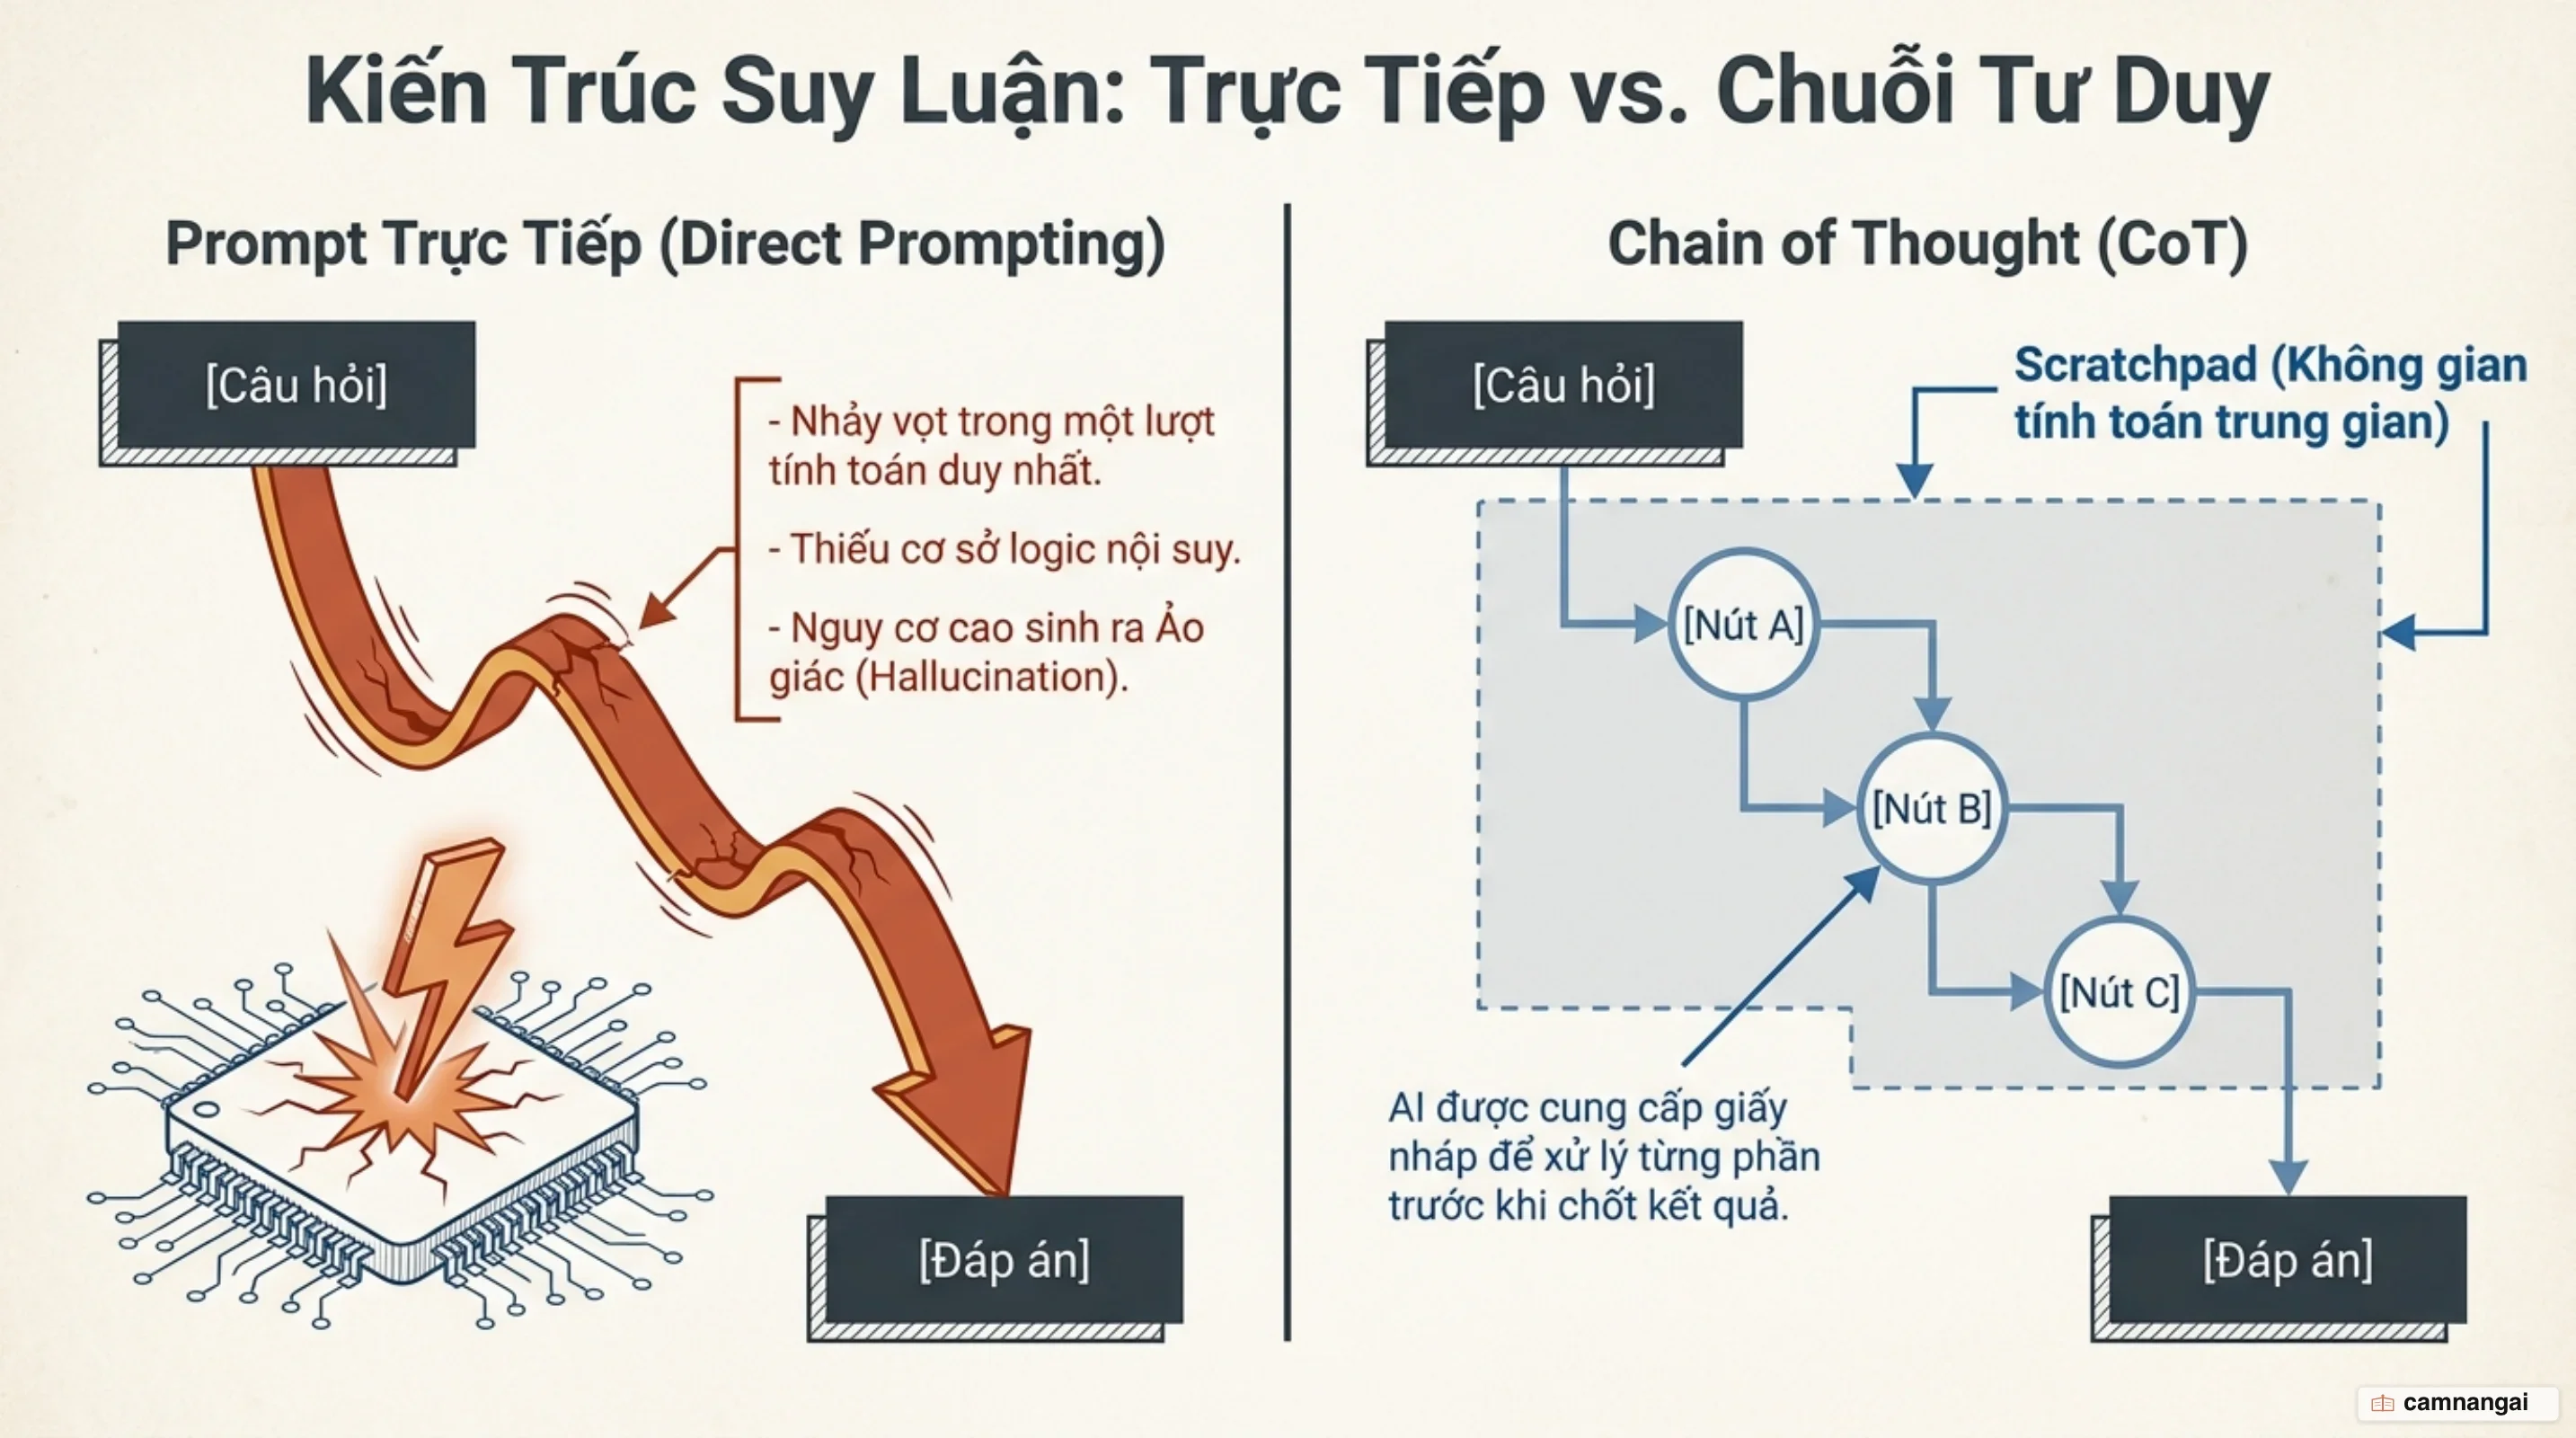
Hạn chế cốt lõi nằm ở hiện tượng "mô hình nhảy ngay đến kết luận" (jumping to conclusions). Khi đối mặt với một câu hỏi phức tạp, nếu bị ép buộc phải sinh ra token đáp án ngay từ những bước đầu tiên, LLM sẽ không có đủ không gian tính toán trung gian (intermediate computation) để xử lý logic. Việc thiếu các trạng thái tính toán trung gian khiến mô hình phụ thuộc hoàn toàn vào kết cấu xác suất tĩnh thu được trong quá trình huấn luyện, dẫn đến sai số chuỗi: một sai lệch nhỏ ở token đầu tiên sẽ kéo theo toàn bộ kết quả phía sau bị hỏng.
Nghiên cứu của Wei và cộng sự (2022) đã chỉ ra rằng Chain of Thought là một khả năng bộc lộ (emergent ability). Khả năng này chỉ xuất hiện rõ rệt khi mô hình ngôn ngữ đạt đến quy mô tham số và dữ liệu đủ lớn, cho phép LLM tự khai thác các mô hình lý giải phức tạp đã học được. Ở các dòng mô hình có kích thước cực lớn, CoT tự động phát huy hiệu quả cao khi nhận được chỉ dẫn phù hợp.
Tuy nhiên, việc gia tăng quy mô tham số không phải là con đường duy nhất để sở hữu khả năng suy luận CoT. Những tiến bộ trong kỹ thuật tinh chỉnh theo chỉ dẫn (instruction tuning) đã cho phép các mô hình nhỏ hơn thực thi suy luận CoT hiệu quả. Ví dụ, các dòng mô hình như IBM Granite Instruct được tinh chỉnh chuyên biệt bằng tập dữ liệu huấn luyện chứa các câu lệnh chỉ dẫn và các ví dụ mẫu (exemplars) cho tác vụ CoT, giúp mô hình quy mô vừa phải vẫn duy trì được chuỗi logic chính xác mà không đòi hỏi tài nguyên tính toán quá lớn.
Cơ chế hoạt động: Phân giải bài toán thành các bước tính toán trung gian
Về bản chất kỹ thuật, Chain of Thought biến đổi hàm ánh xạ trực tiếp từ trạng thái Input -> Output thành một chuỗi các trạng thái chuyển tiếp liên tục: Input -> Reasoning Steps -> Output. Thay vì giải quyết toàn bộ khối lượng logic trong một bước sinh token duy nhất, CoT bắt buộc mô hình phải dàn trải quá trình tính toán qua nhiều token trung gian, trong đó mỗi token được sinh ra sẽ đóng vai trò là điều kiện ngữ cảnh bổ sung cho token tiếp theo.
Cơ chế này tương đương với hành vi "suy nghĩ thành lời" (thinking out loud). Khi mô hình ghi lại từng bước giải thích vào context window, các bước lý giải trước đó trở thành dữ liệu đầu vào (context) cho các bước suy luận sau. Điều này cung cấp không gian bộ nhớ tạm thời giúp LLM duy trì trạng thái logic, kiểm tra các điều kiện ràng buộc và giảm áp lực tính toán tức thời lên mô hình Transformer.
Để minh họa, hãy xét bài toán tìm nghiệm của phương trình bậc hai $x^2 - 5x + 6 = 0$. Nếu sử dụng prompt trực tiếp, mô hình có thể dự đoán ngẫu nhiên một con số và dễ đưa ra đáp án sai do nhầm lẫn dấu hoặc nhẩm sai tích số. Ngược lại, khi áp dụng CoT, quá trình xử lý được phân rã thành các bước rõ ràng: đầu tiên xác định các hệ số $a = 1, b = -5, c = 6$; tiếp theo tìm hai số có tổng bằng $5$ và tích bằng $6$ (là $2$ và $3$); sau đó phân tích phương trình thành nhân tử $(x - 2)(x - 3) = 0$; và cuối cùng suy ra hai nghiệm $x = 2$ hoặc $x = 3$.
Việc chia nhỏ bài toán thành các bước số học trung gian đảm bảo từng phép tính đơn lẻ nằm trong khả năng xử lý chính xác cao nhất của LLM. Do đó, kết quả cuối cùng không phải là một sự đoán mò mang tính xác suất mà là hệ quả logic tất yếu của một chuỗi suy luận chính xác đã được ghi lại đầy đủ trong ngữ cảnh sinh tự động.
Hai hình thái nền tảng: Few-shot CoT và Zero-shot CoT
Kỹ thuật Chain of Thought được triển khai qua hai hình thái nền tảng chính: Few-shot CoT và Zero-shot CoT, cùng với biến thể tự động hóa Auto-CoT. Few-shot CoT (Wei et al. 2022) là phương pháp cung cấp cho mô hình một vài ví dụ mẫu (exemplars) trong prompt. Mỗi ví dụ bao gồm một câu hỏi và một chuỗi lý giải chi tiết từng bước dẫn đến kết quả. Thông qua việc quan sát cấu trúc của các ví dụ này (như bài toán tính tổng các số lẻ trong một tập hợp), LLM học được mô hình biểu diễn tư duy và áp dụng chính xác cấu trúc suy luận đó cho câu hỏi mới.
Zero-shot CoT (Kojima et al. 2022) kích hoạt khả năng suy luận tự nhiên của LLM mà không cần cung cấp bất kỳ ví dụ mẫu nào. Kỹ thuật này đơn giản là thêm cụm từ gợi mở "Let's think step by step" (Hãy suy nghĩ từng bước) vào cuối câu hỏi. Ví dụ, với bài toán đếm và trừ số lượng hoa quả (mua 10 quả táo, cho đi 4 quả, mua thêm 5 quả, ăn 1 quả), prompt thông thường dễ khiến mô hình đưa ra đáp án sai, nhưng việc thêm dòng lệnh kích hoạt Zero-shot CoT sẽ thúc đẩy mô hình tự động trình bày lần lượt từng phép tính cộng trừ trước khi chốt số lượng còn lại.
Bên cạnh hai hình thái thủ công, Automatic Chain-of-Thought (Auto-CoT) do Zhang và cộng sự (2022) đề xuất nhằm loại bỏ công sức xây dựng ví dụ mẫu bằng tay. Auto-CoT hoạt động qua hai giai đoạn: Giai đoạn 1 (Question Clustering) phân chia các câu hỏi trong tập dữ liệu thành các nhóm (cluster) đa dạng; Giai đoạn 2 (Demonstration Sampling) chọn một câu hỏi đại diện từ mỗi nhóm và dùng Zero-shot CoT kết hợp với các quy tắc heuristic đơn giản (như độ dài câu hỏi khoảng 60 token, chuỗi lý giải khoảng 5 bước) để tự động sinh ra chuỗi suy luận mẫu chuẩn xác.
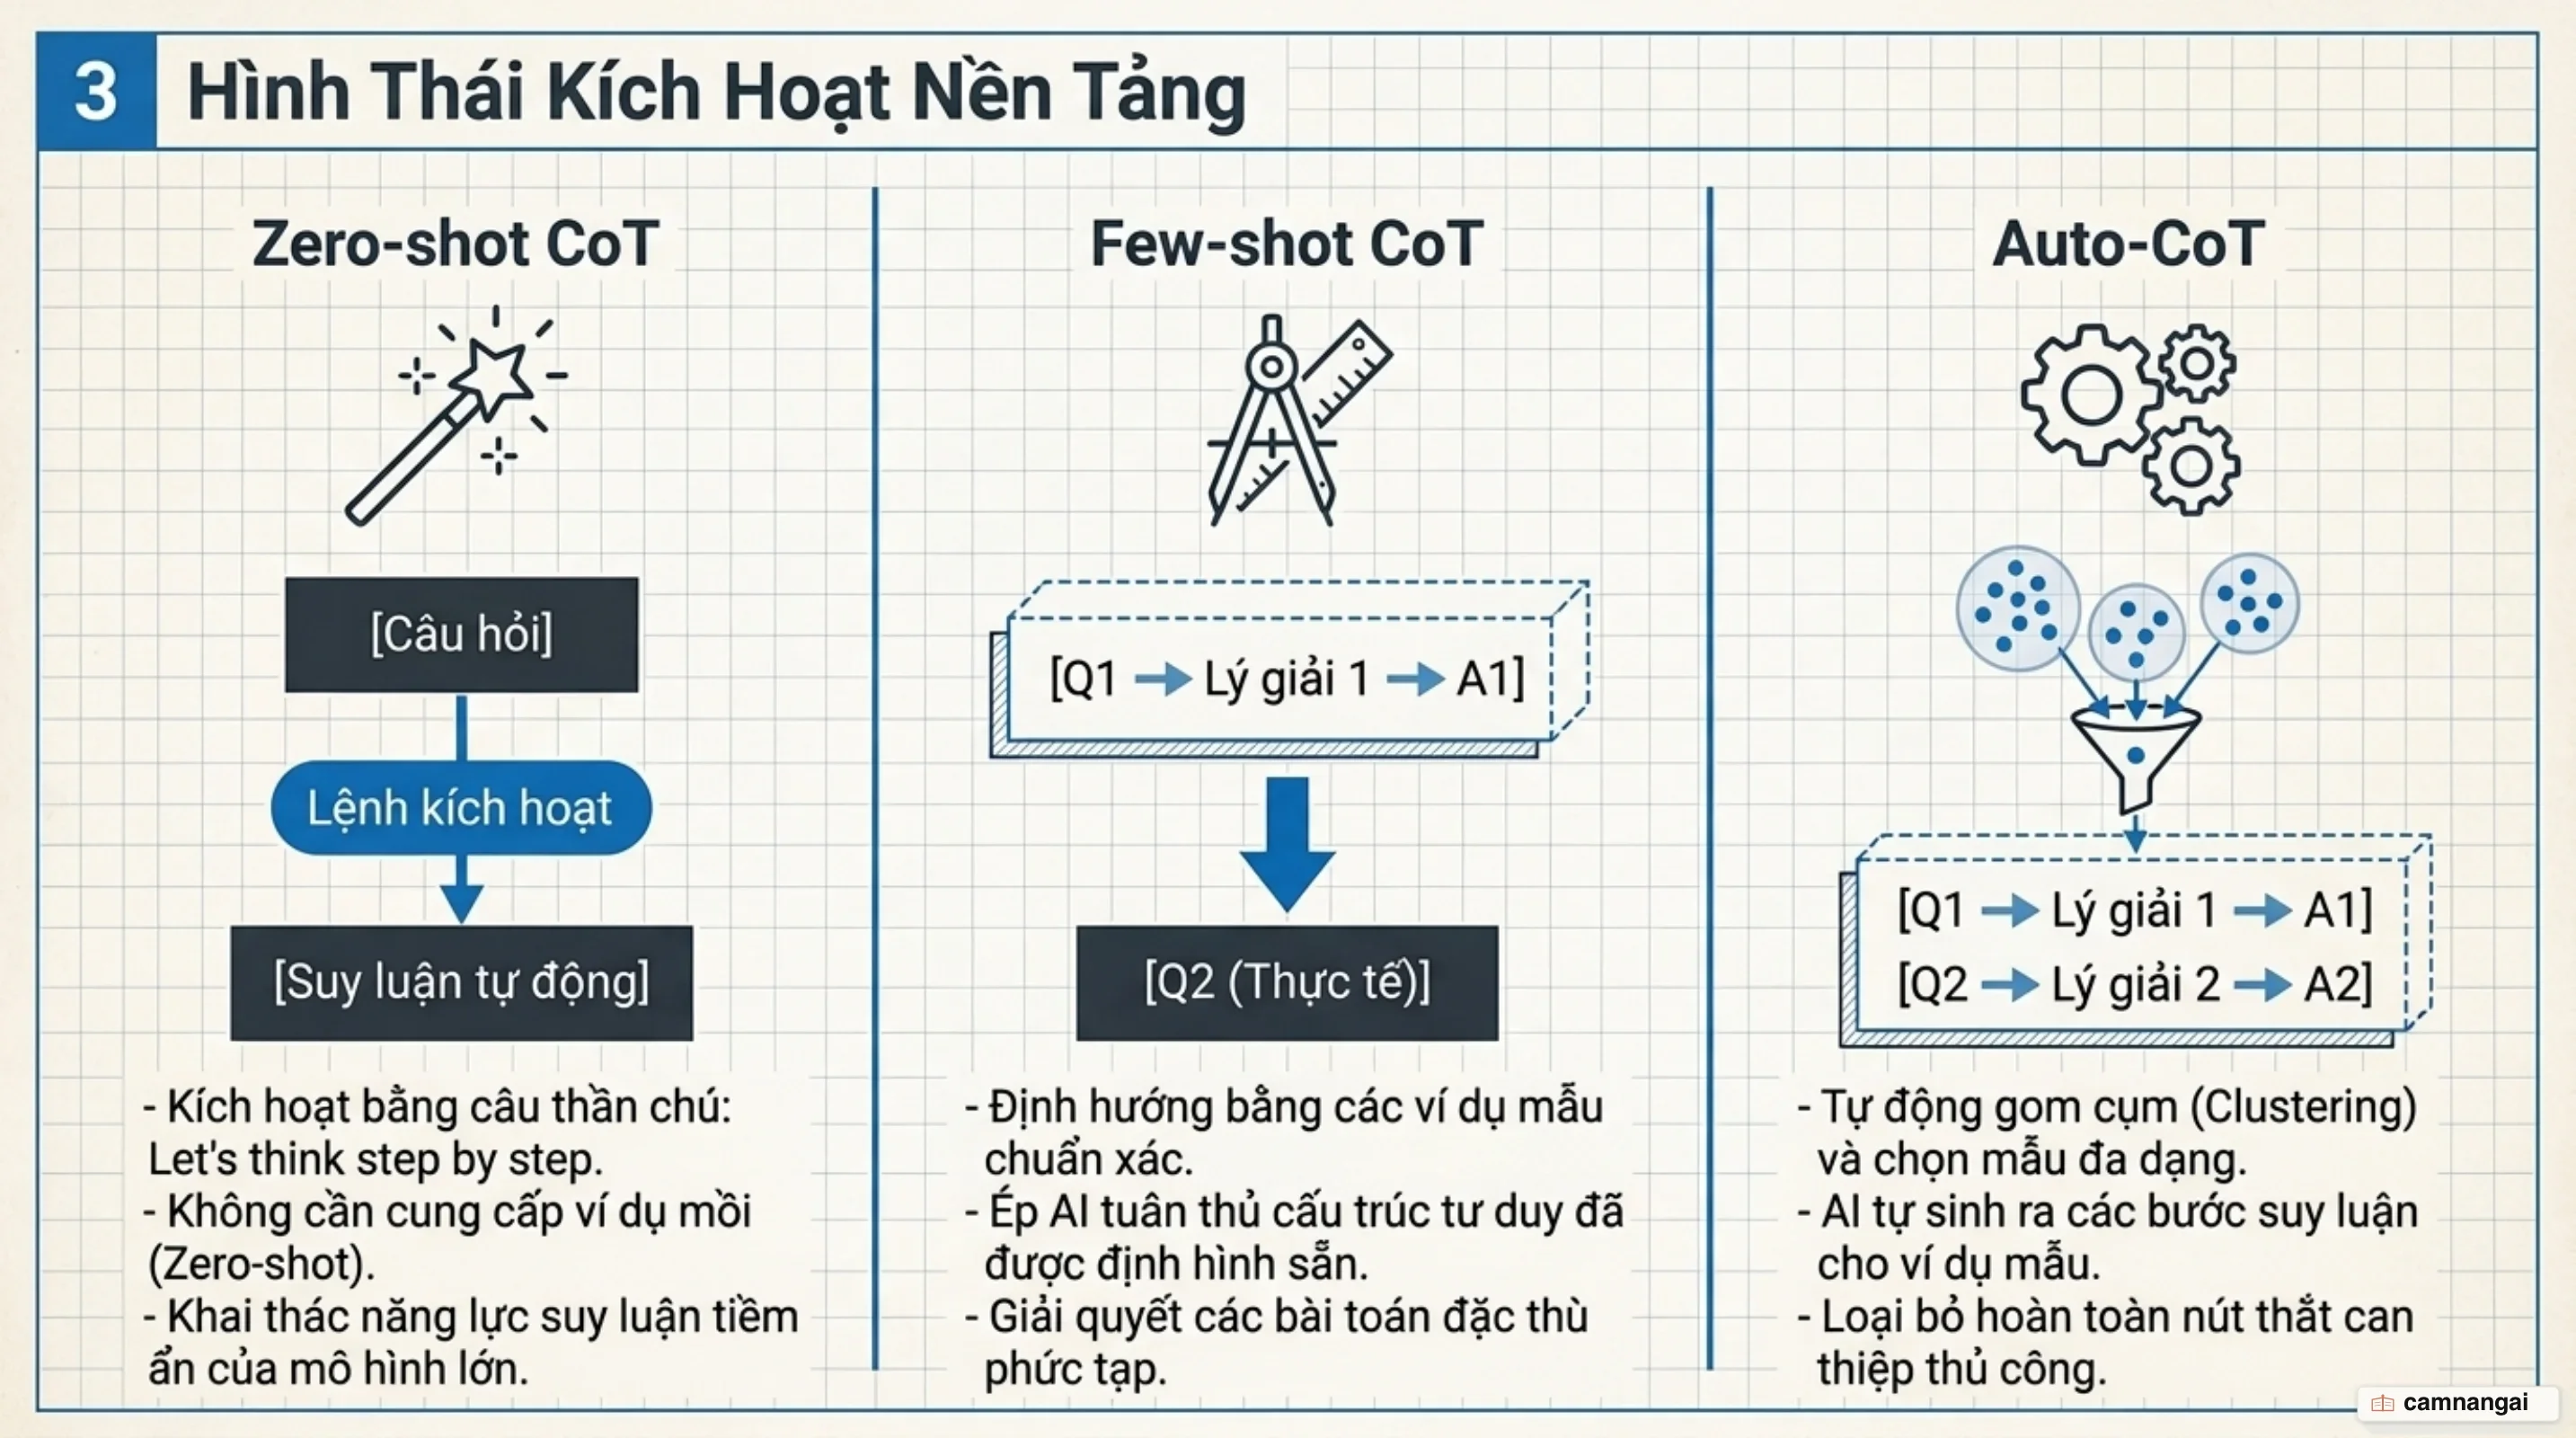
Cấu trúc cơ bản của Few-shot CoT và Zero-shot CoT được thể hiện qua đoạn prompt mẫu dưới đây:
# Ví dụ Few-shot CoT Prompt
Q: Các số lẻ trong nhóm này cộng lại thành số chẵn: 4, 8, 9, 15, 12, 2, 1.
A: Cộng tất cả các số lẻ (9, 15, 1) ta được 25. Đáp án là Sai.

Q: Các số lẻ trong nhóm này cộng lại thành số chẵn: 15, 32, 5, 13, 82, 7, 1.
A:

# Ví dụ Zero-shot CoT Prompt
Tôi mua 10 quả táo. Cho người hàng xóm 2 quả, cho thợ sửa chữa 2 quả. Sau đó tôi mua thêm 5 quả và ăn 1 quả. Hỏi tôi còn lại bao nhiêu quả táo?
Let's think step by step.
Các kỹ thuật mở rộng: Self-Consistency, Least-to-Most và Tree of Thoughts
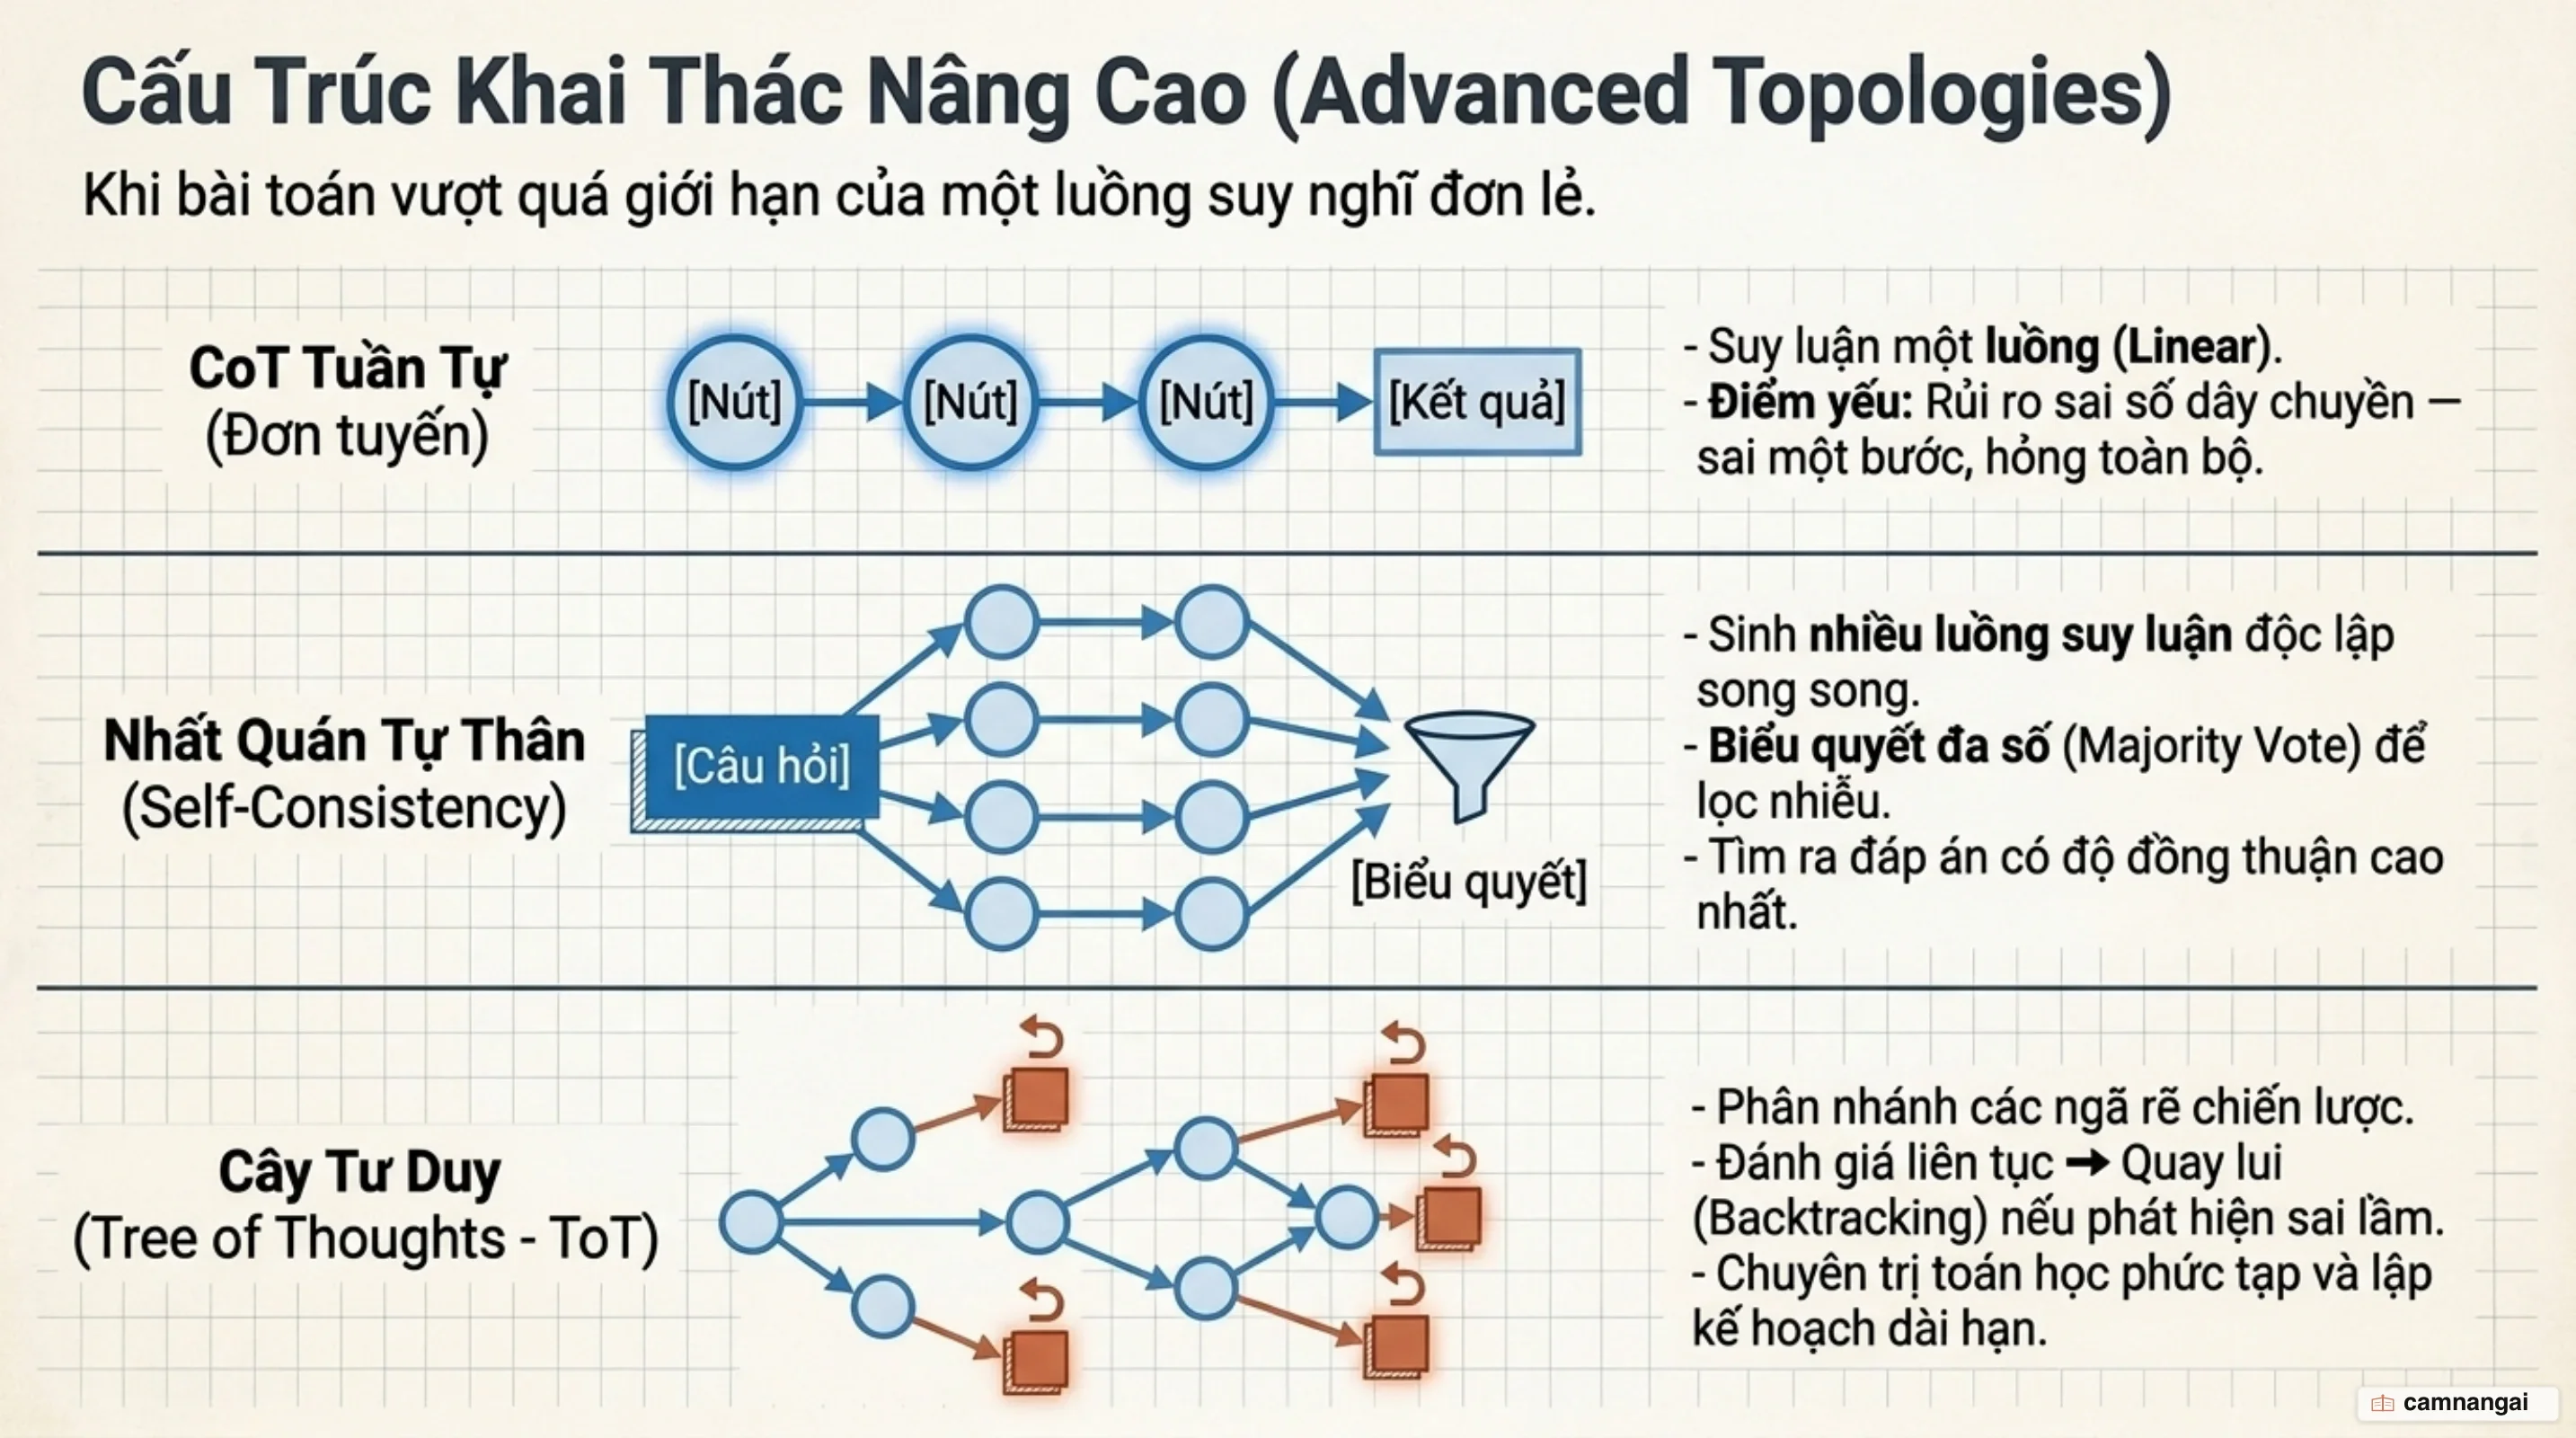
Dựa trên nền tảng CoT cơ bản, các nhà nghiên cứu đã phát triển nhiều kỹ thuật mở rộng nhằm tăng cường độ tin cậy và khả năng xử lý bài toán phức tạp. Phương pháp Self-Consistency giải quyết tính thiếu ổn định của một chuỗi suy luận duy nhất bằng cách lấy mẫu nhiều đường hướng suy luận CoT khác nhau cho cùng một câu hỏi. Bằng cách thiết lập tham số sinh ngẫu nhiên (temperature > 0), mô hình sẽ tạo ra một tập hợp các chuỗi tư duy đa dạng. Sau đó, thuật toán chọn kết quả cuối cùng dựa trên nguyên tắc bỏ phiếu theo đa số (majority vote), giúp loại bỏ các bước suy luận lệch chuẩn hoặc sai sót ngẫu nhiên.
Kỹ thuật Least-to-Most Prompting tập trung vào việc phân rã một bài toán lớn đòi hỏi nhiều bước phức tạp thành một chuỗi các bài toán con (sub-problems) nối tiếp nhau. Mô hình sẽ tiến hành giải từng bài toán con theo thứ tự từ dễ đến khó, trong đó kết quả của bài toán con trước được tự động tích hợp làm dữ liệu đầu vào cho bài toán con tiếp theo. Cách tiếp cận này ngăn chặn tình trạng quá tải ngữ cảnh và giảm thiểu rủi ro chệch hướng logic khi xử lý các vấn đề có quy mô lớn.
Tree of Thoughts (ToT) mở rộng cấu trúc tuyến tính của CoT thành cấu trúc cây suy luận. Trong ToT, mô hình không bị giới hạn ở một chuỗi bước đi cố định mà có thể tự do khám phá nhiều nhánh tư duy khác nhau tại mỗi bước tính toán. Mô hình liên tục đánh giá trạng thái hiện tại của từng nhánh, cho phép thực hiện thuật toán quay xe (backtrack) khi phát hiện nhánh suy luận đi vào bế tắc, hoặc mở rộng các nhánh tiềm năng để tìm ra đường đi tối ưu nhất cho bài toán.
Triển khai trong code: Cấu trúc prompt, phân tách thẻ suy luận và trích xuất kết quả
Khi triển khai CoT trong các ứng dụng thực tế thông qua API, việc kiểm soát định dạng đầu ra của mô hình là yếu tố quyết định. Kỹ sư hệ thống thường áp dụng kỹ thuật đóng gói prompt bằng các thẻ XML (như <instructions>, <context>, <thinking>, <answer>) hoặc cấu trúc tiêu đề Markdown. Việc phân tách rõ ràng ranh giới giữa phần suy luận nội bộ và câu trả lời cuối cùng giúp hệ thống phần mềm dễ dàng phân tích ngữ pháp (parse) và trích xuất dữ liệu mà không bị lẫn lộn giữa văn bản giải thích và kết quả.
Trong kiến trúc gọi API hiện đại, nhà phát triển có thể truyền các câu lệnh điều khiển hệ thống qua vai trò developer (hoặc system message) để thiết lập quy tắc hoạt động nghiêm ngặt cho LLM. Đối với đầu ra, bạn có thể trích xuất chuỗi suy luận và đáp án bằng cách sử dụng biểu thức chính quy (regex) quét các thẻ XML, hoặc bắt buộc mô hình tuân thủ cấu trúc dữ liệu JSON Schema/Structured Outputs để đảm bảo tính an toàn hệ thống.
Đoạn mã Python dưới đây minh họa việc cấu hình một yêu cầu gọi API sử dụng SDK mới, đóng gói prompt với các thẻ XML để phân tách quá trình suy luận <thinking> và trích xuất chính xác câu trả lời trong thẻ <answer> bằng Regex:
import re
from openai import OpenAI

client = OpenAI()

system_prompt = """
Bạn là một chuyên gia giải quyết bài toán logic.
Hãy thực hiện suy luận từng bước bên trong thẻ <thinking>.
Sau đó đưa ra câu trả lời ngắn gọn cuối cùng bên trong thẻ <answer>.
"""

user_query = "Tôi có 3 quả táo, bán đi 1 quả, mua thêm 5 quả rồi chia đều cho 2 người. Mỗi người được mấy quả?"

response = client.chat.completions.create(
    model="gpt-6-astra",
    messages=[
        {"role": "developer", "content": system_prompt},
        {"role": "user", "content": user_query}
    ]
)

content = response.choices[0].message.content
print("--- Raw Model Response ---")
print(content)

# Trích xuất dữ liệu câu trả lời chương trình bằng Regex
answer_match = re.search(r"<answer>(.*?)</answer>", content, re.DOTALL)
if answer_match:
    final_answer = answer_match.group(1).strip()
    print("\n--- Parsed Final Answer ---")
    print(final_answer)
Đánh đổi kỹ thuật: Chi phí token, độ trễ và rủi ro suy luận ngụy biện
Mặc dù mang lại hiệu quả vượt trội về khả năng lý luận, việc áp dụng Chain of Thought trong môi trường sản phẩm đòi hỏi các kỹ sư phải tính toán kỹ lưỡng các yếu tố đánh đổi về hiệu năng kỹ thuật. Yếu tố đầu tiên là sự gia tăng đột biến về chi phí token và độ trễ phản hồi (latency). Việc buộc mô hình sinh thêm hàng trăm token suy luận trung gian trước khi trả về kết quả cuối cùng làm kéo dài thời gian xử lý mỗi request, đồng thời nhân bản chi phí API (token billing) lên nhiều lần so me với phản hồi trực tiếp.
Yếu tố rủi ro thứ hai là hiện tượng ngụy biện (Hallucinated Reasoning). CoT không đảm bảo mô hình luôn suy luận đúng; nó vẫn có thể tạo ra các bước lý luận nghe rất có vẻ logic và thuyết phục nhưng lại chứa thông tin sai sự thật hoặc mắc sai sót tính toán ở một mắt xích giữa chừng. Một bước suy luận ngụy biện ở giữa chuỗi sẽ dẫn toàn bộ quá trình lý luận đi lệch hướng, khiến kết quả cuối cùng hoàn toàn bị sai hỏng dù hình thức lập luận trông rất chỉn chu.
Ngoài ra, CoT tỏ ra vô cùng nhạy cảm với cách thiết kế prompt. Chất lượng của các ví dụ mẫu (exemplars), thứ tự sắp xếp các ví dụ, hoặc chỉ một sự thay đổi nhỏ trong cách đặt câu lệnh kích hoạt cũng có thể làm biến đổi đáng kể độ chính xác của chuỗi suy luận. Điều này đòi hỏi quy trình kiểm thử và đánh giá (evals) phải được thực hiện liên tục và chặt chẽ khi triển khai ứng dụng vào thực tế.
Từ CoT thủ công đến mô hình suy luận bản địa và Test-time Compute
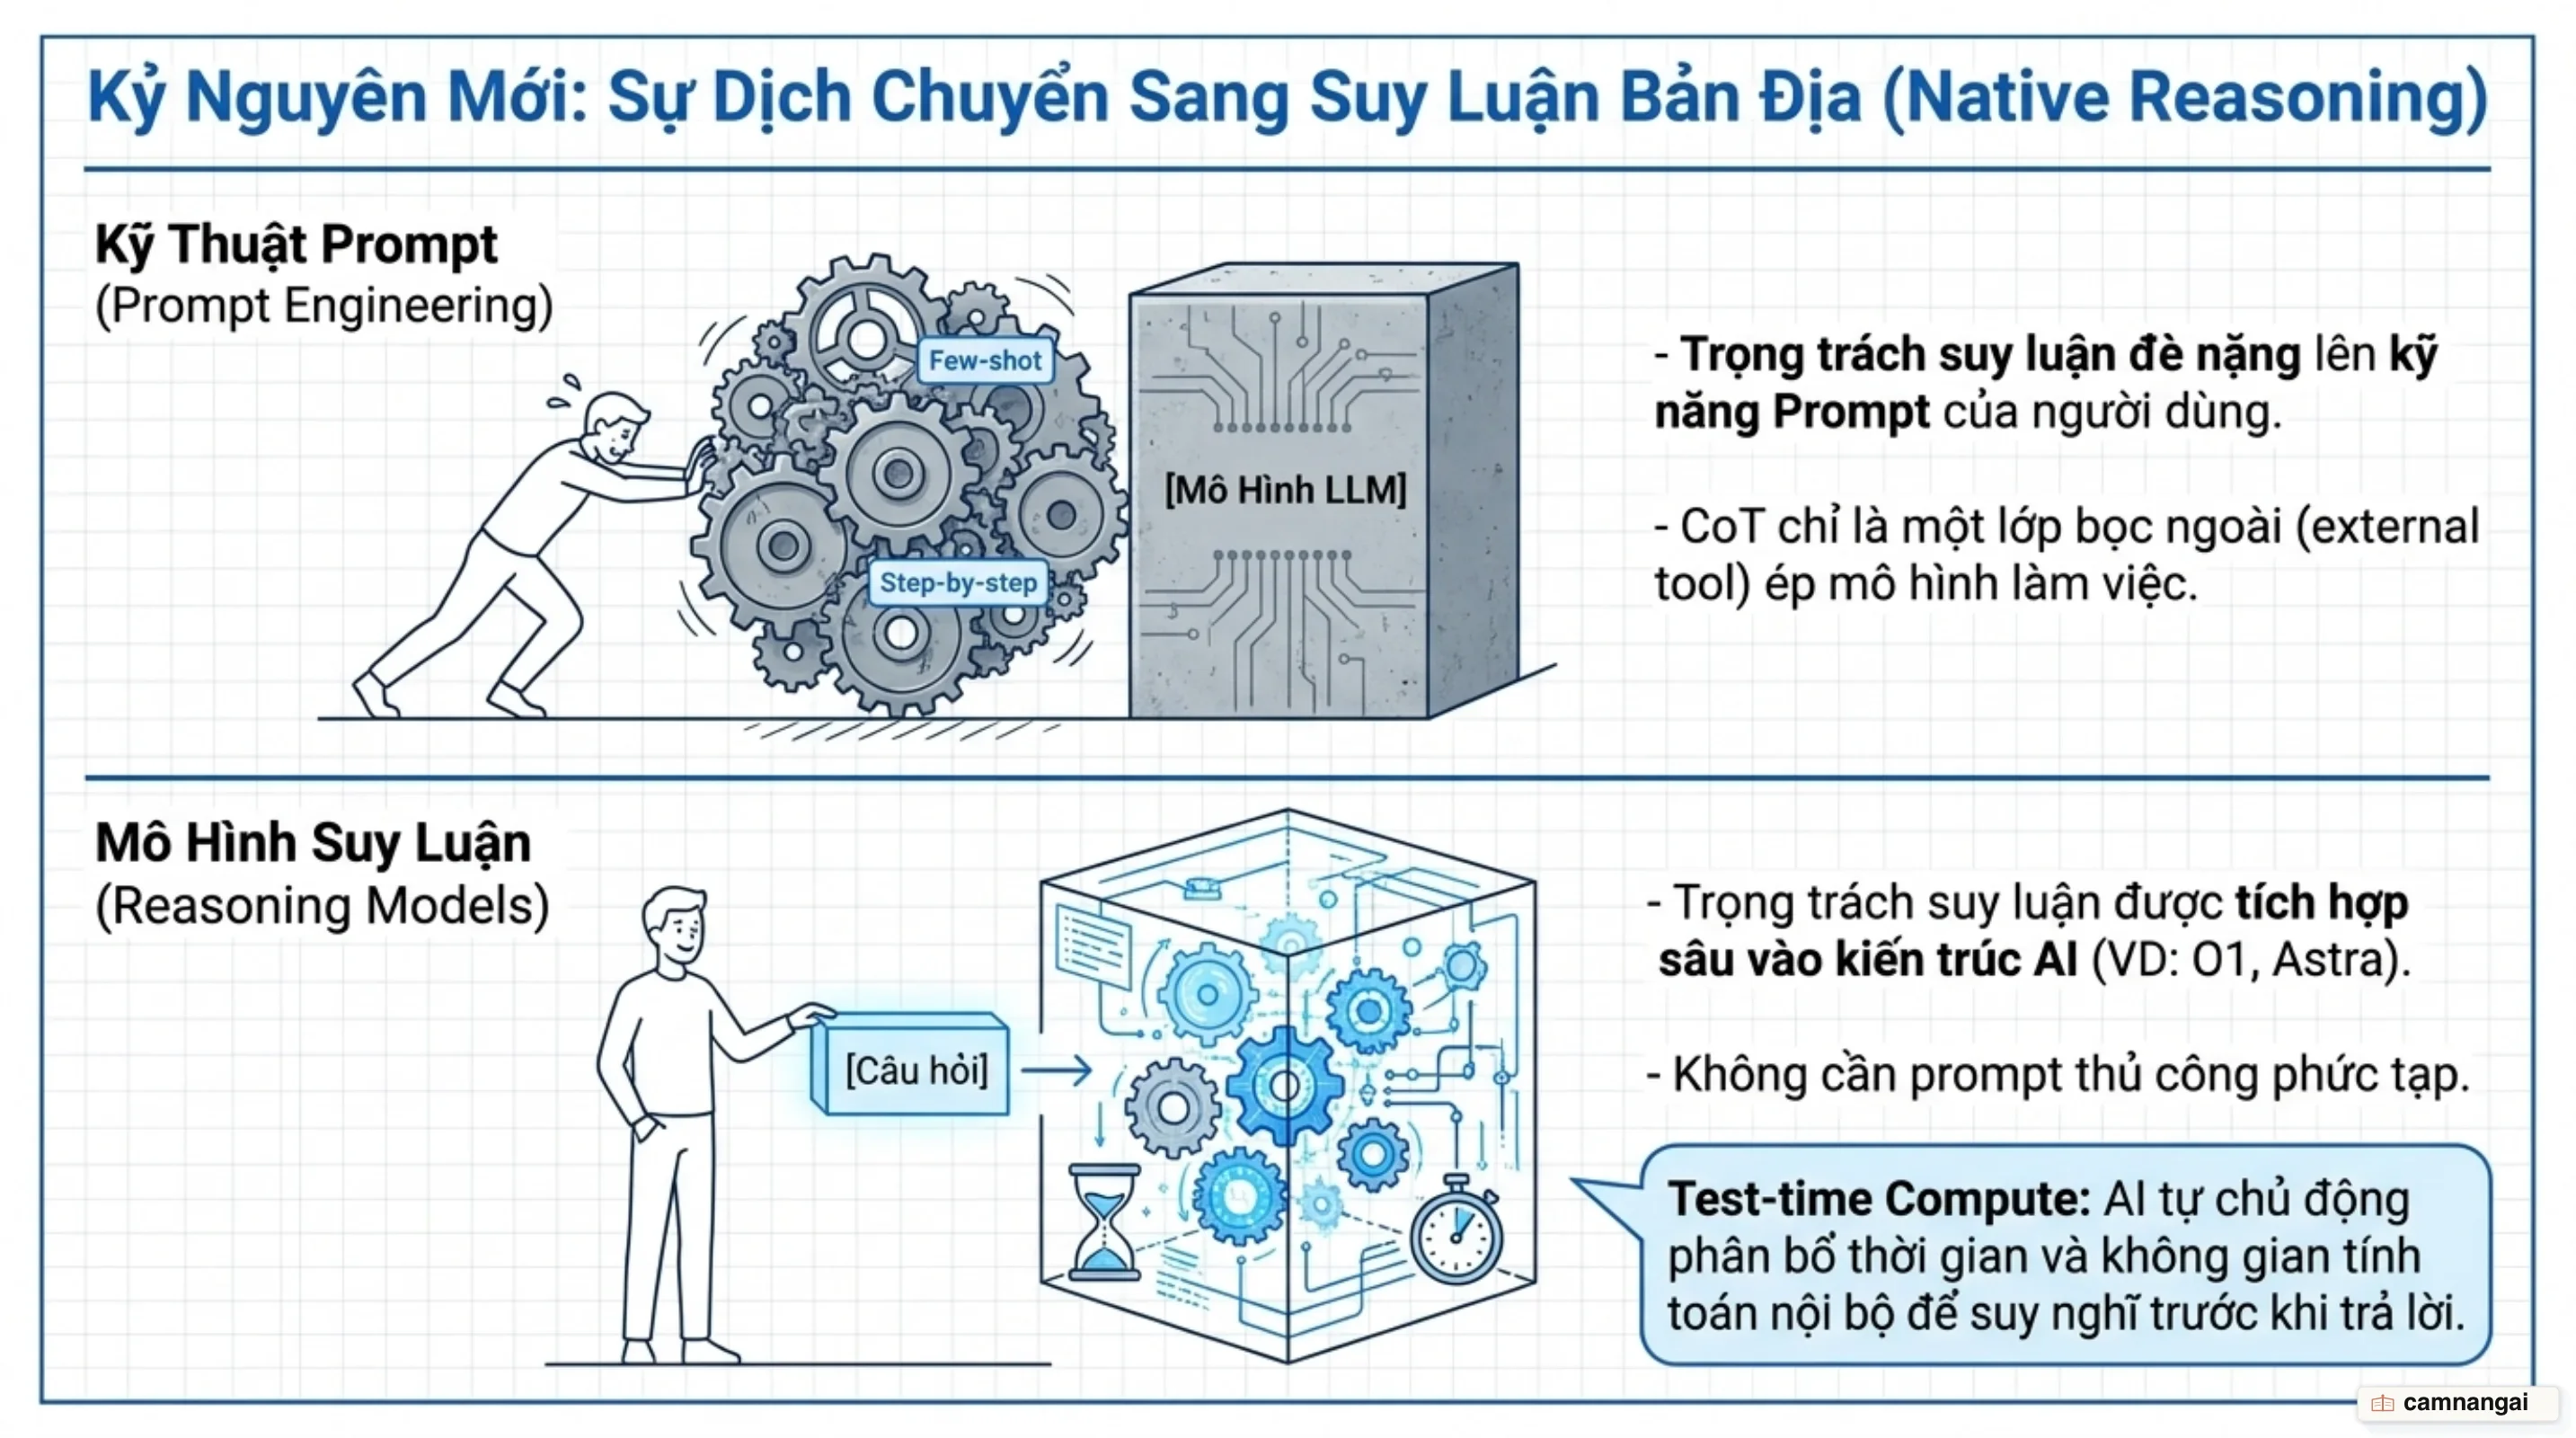
Cụm kỹ thuật CoT đang trải qua bước chuyển dịch quan trọng: từ việc người dùng phải viết prompt kích hoạt CoT thủ công (Prompt-based CoT) sang việc tích hợp các mô hình suy luận chuyên biệt (Reasoning Models). Các mô hình thế hệ mới được thiết kế để tự động tạo ra chuỗi suy luận ẩn/bản địa (native reasoning tokens / internal chain of thought) ngay ở cấp độ kiến trúc phần cứng và mô hình, giải phóng nhà phát triển khỏi việc phải tinh chỉnh câu chữ trong prompt.
Xu hướng này gắn liền với khái niệm Test-time Compute (tính toán tại thời điểm suy luận). Thay vì chỉ tập trung tài nguyên tính toán vào giai đoạn huấn luyện (training-time compute), hệ thống cho phép mô hình dành nhiều tài nguyên tính toán hơn tại thời điểm nhận câu hỏi để "suy nghĩ" sâu hơn trước khi đưa ra câu trả lời. Nhà phát triển có thể can thiệp vào quá trình này thông qua các tham số điều khiển như mức độ nỗ lực suy luận (reasoning_effort hoặc effort level / adaptive thinking).
Tuy nhiên, khi tích hợp các mô hình suy luận bản địa hoặc cơ chế suy luận thích ứng (như Claude Sonnet 5.5/Opus 5.5 hay các dòng GPT reasoning) vào ứng dụng đa lượt (multi-turn), bạn phải tuân thủ nguyên tắc quản lý trạng thái ngữ cảnh chỉ thêm (append-only). Mọi token suy luận (thinking blocks) do API trả về ở các lượt trước bắt buộc phải được giữ nguyên vẹn trong lịch sử hội thoại truyền trở lại API ở các lượt sau. Việc sửa đổi, lược bỏ hoặc tóm tắt lại các khối suy luận này giữa các lượt sẽ làm mất hiệu lực trạng thái nội bộ của mô hình, dẫn đến lỗi API hoặc làm suy giảm nghiêm trọng độ chính xác.
Sự khác biệt này định hình lại chiến lược lựa chọn mô hình trong thực tế. Các mô hình GPT thông thường kết hợp với prompt CoT thủ công phù hợp cho các tác vụ cần kiểm soát minh bạch từng bước giải thích dạng văn bản thô với chi phí linh hoạt. Trong khi đó, các mô hình suy luận chuyên biệt phù hợp cho các bài toán lập trình phức tạp, quy hoạch agent đa bước hoặc toán học cao cấp—nơi khả năng suy luận bản địa tự điều chỉnh thời gian tính toán mang lại độ chính xác tối ưu nhất.
Nguyên tắc thực hành cho AI Engineer
Dưới góc độ triển khai hệ thống, AI Engineer cần áp dụng CoT một cách có chiến lược để cân bằng giữa độ chính xác, chi phí và độ trễ. CoT là lựa chọn bắt buộc đối với các tác vụ phức tạp như giải toán, viết mã nguồn, phân tích logic đa tầng hoặc lập kế hoạch hoạt động cho AI Agent. Trái lại, đối với các tác vụ đơn giản như phân loại cảm xúc văn bản, trích xuất thực thể, hoặc truy vấn thông tin trực tiếp, việc áp dụng CoT là không cần thiết, làm lãng phí tài nguyên tính toán và gia tăng độ trễ hệ thống.
Trước khi đưa bất kỳ cấu trúc CoT nào vào môi trường production, bạn bắt buộc phải xây dựng bộ kiểm thử tự động (benchmark/evals) trên tập dữ liệu thực tế của ứng dụng. Đảm bảo luôn sử dụng các công cụ kiểm soát định dạng đầu ra (Structured Outputs hoặc ràng buộc thẻ XML) để duy trì tính ổn định của hệ thống phần mềm khi tiêu thụ kết quả từ LLM.
Tài liệu tham khảo
- What is chain of thought (CoT) prompting? — IBM
- Chain-of-Thought Prompting Elicits Reasoning in Large Language Models — Wei et al. (2022)
- Large Language Models are Zero-Shot Reasoners — Kojima et al. (2022)
- Chain-of-Thought Prompting — Prompt Engineering Guide (DAIR.AI)
- Chain of thought prompting — Claude Documentation
- Prompt engineering guide: Give models time to think — OpenAI
- Self-Consistency Improves Chain of Thought Reasoning in Language Models — Wang et al. (2022)