# Các Agentic Workflow Pattern phổ biến trong xây dựng AI Agent
> Phân tích các thiết kế agentic workflow pattern giúp nâng cao hiệu năng LLM, tối ưu hóa chi phí và đảm bảo tính tin cậy cho ứng dụng AI production.
Nguồn: https://camnangai.com/ky-thuat/ai-agentic-workflow-patterns
Xuất bản: 2026-11-08
Việc chuyển đổi từ truy vấn đơn lượt (single-turn zero-shot prompting) sang mô hình **agentic workflow pattern** thay đổi căn bản tư duy thiết kế hạ tầng AI hiện đại. Trong các hệ thống production, thay vì bắt mô hình ngôn ngữ lớn (LLM) phải tạo ra toàn bộ kết quả đầu ra trong một lần sinh chuỗi token duy nhất mà không có khả năng tự kiểm tra hay điều chỉnh, một agentic workflow pattern tổ chức các lời gọi LLM, quá trình thực thi công cụ (tools) và các vòng lặp kiểm soát theo cơ chế lặp (iterative loop).
Về bản chất kiến trúc, thiết kế này cho phép hệ thống phân rã tác vụ phức tạp thành chuỗi các nút xử lý nhỏ hơn, thu thập dữ liệu thực tế (ground truth) từ môi trường bên ngoài và liên tục tinh chỉnh trạng thái trung gian dựa trên phản hồi thực tế. Khi xử lý các bài toán doanh nghiệp phức tạp đòi hỏi độ tin cậy cao, việc phụ thuộc vào zero-shot prompting thường dẫn đến tình trạng sai sót không thể thu hồi do mô hình tự tích lũy sai số qua từng bước sinh văn bản.
Áp dụng các thiết kế theo hướng agentic giúp khắc phục các hạn chế vật lý của mô hình transformer
nguyên khối.
Bằng cách kết hợp linh hoạt giữa luồng điều khiển xác định (deterministic control flow) và khả năng
lập kế hoạch động của LLM, các kỹ sư hệ thống có thể xây dựng những giải pháp AI ổn định, tối ưu hóa
khả năng quản lý trạng thái (state persistence) và đáp ứng nghiêm ngặt các yêu cầu về độ chính xác
cũng như khả năng mở rộng.
## Vì sao agentic workflow hiệu quả hơn prompt một lần?
Cơ chế sinh tự hồi quy (autoregressive generation) của kiến trúc Transformer Decoder ép buộc LLM
lấy mẫu và xuất token theo chuỗi nối tiếp từ trái sang phải. Khi một token sai sót hoặc một giả
định lệch lạc được đưa vào bộ đệm Key-Value (KV Cache), nó lập tức trở thành một phần của ngữ cảnh
đầu vào cho tất cả các token tiếp theo.
Mô hình không sở hữu cơ chế tự nhiên ở tầng hạ tầng để "xóa phím" (backspace), thu hồi trạng thái
hoặc tự động tra cứu ngữ cảnh còn thiếu trong khi đang tính toán phân phối xác suất token. Việc ép
buộc LLM giải quyết bài toán đa bước phức tạp ngay trong một lượt sinh duy nhất tương đương với việc
bắt một lập trình viên viết toàn bộ một chương trình hàng nghìn dòng lệnh từ đầu đến cuối mà không
được phép biên dịch thử, sửa lỗi hay tham chiếu tài liệu.
Dữ liệu thực nghiệm cho thấy khoảng cách hiệu năng lớn của cơ chế vòng lặp agentic (iterative agentic loop) so với việc gia tăng quy mô tham số mô hình đơn thuần. Trên bộ kiểm thử lập trình chuẩn HumanEval, mô hình GPT-3.5 khi thực thi ở chế độ zero-shot chỉ đạt tỷ lệ giải quyết bài toán đúng là 48,1%, trong khi mô hình GPT-4 với quy mô lớn hơn nhiều đạt 67,0%. Tuy nhiên, khi wrapped GPT-3.5 vào một vòng lặp agentic có khả năng lập kế hoạch, tự chạy mã kiểm thử, đọc lỗi runtime và tự sửa đổi bản thảo lặp đi lặp lại, hiệu năng của GPT-3.5 đã tăng vọt lên 95,1%. Việc một mô hình thế hệ cũ chạy trong luồng điều phối agentic vượt xa hiệu năng zero-shot của một mô hình thế hệ mới khẳng định rằng: kiến trúc điều phối dữ liệu xung quanh LLM quyết định trực tiếp chất lượng đầu ra không kém gì năng lực nội tại của bản thân mô hình nền tảng.
```
Tỷ lệ chính xác trên HumanEval Benchmark:
[GPT-3.5 Zero-Shot]: 48.1% ===================>
[GPT-4 Zero-Shot]: 67.0% =================================>
[GPT-3.5 Agentic Loop]: 95.1% =======================================================>
```
Tuy nhiên, sự vượt bậc về độ chính xác này đi kèm với các bài toán đánh đổi hạ tầng khắt khe. Mô hình agentic đánh đổi trực tiếp độ trễ thời gian thực (latency) và ngân sách token lấy chỉ số hoàn thành tác vụ (task success rate). Việc chạy lặp qua nhiều lượt gọi API nối tiếp khiến thời gian phản hồi tăng từ hàng trăm millisecond lên hàng chục giây, đồng thời tổng lượng token trao đổi tăng theo bội số. Do đó, mục tiêu của kỹ sư kiến trúc không phải là biến mọi lời gọi LLM thành agentic, mà là xác định chính xác giới hạn mà ở đó chi phí hạ tầng bổ sung tạo ra giá trị kinh doanh tương xứng.
## Ranh giới kiến trúc: Workflow có định nghĩa trước vs Agent tự trị
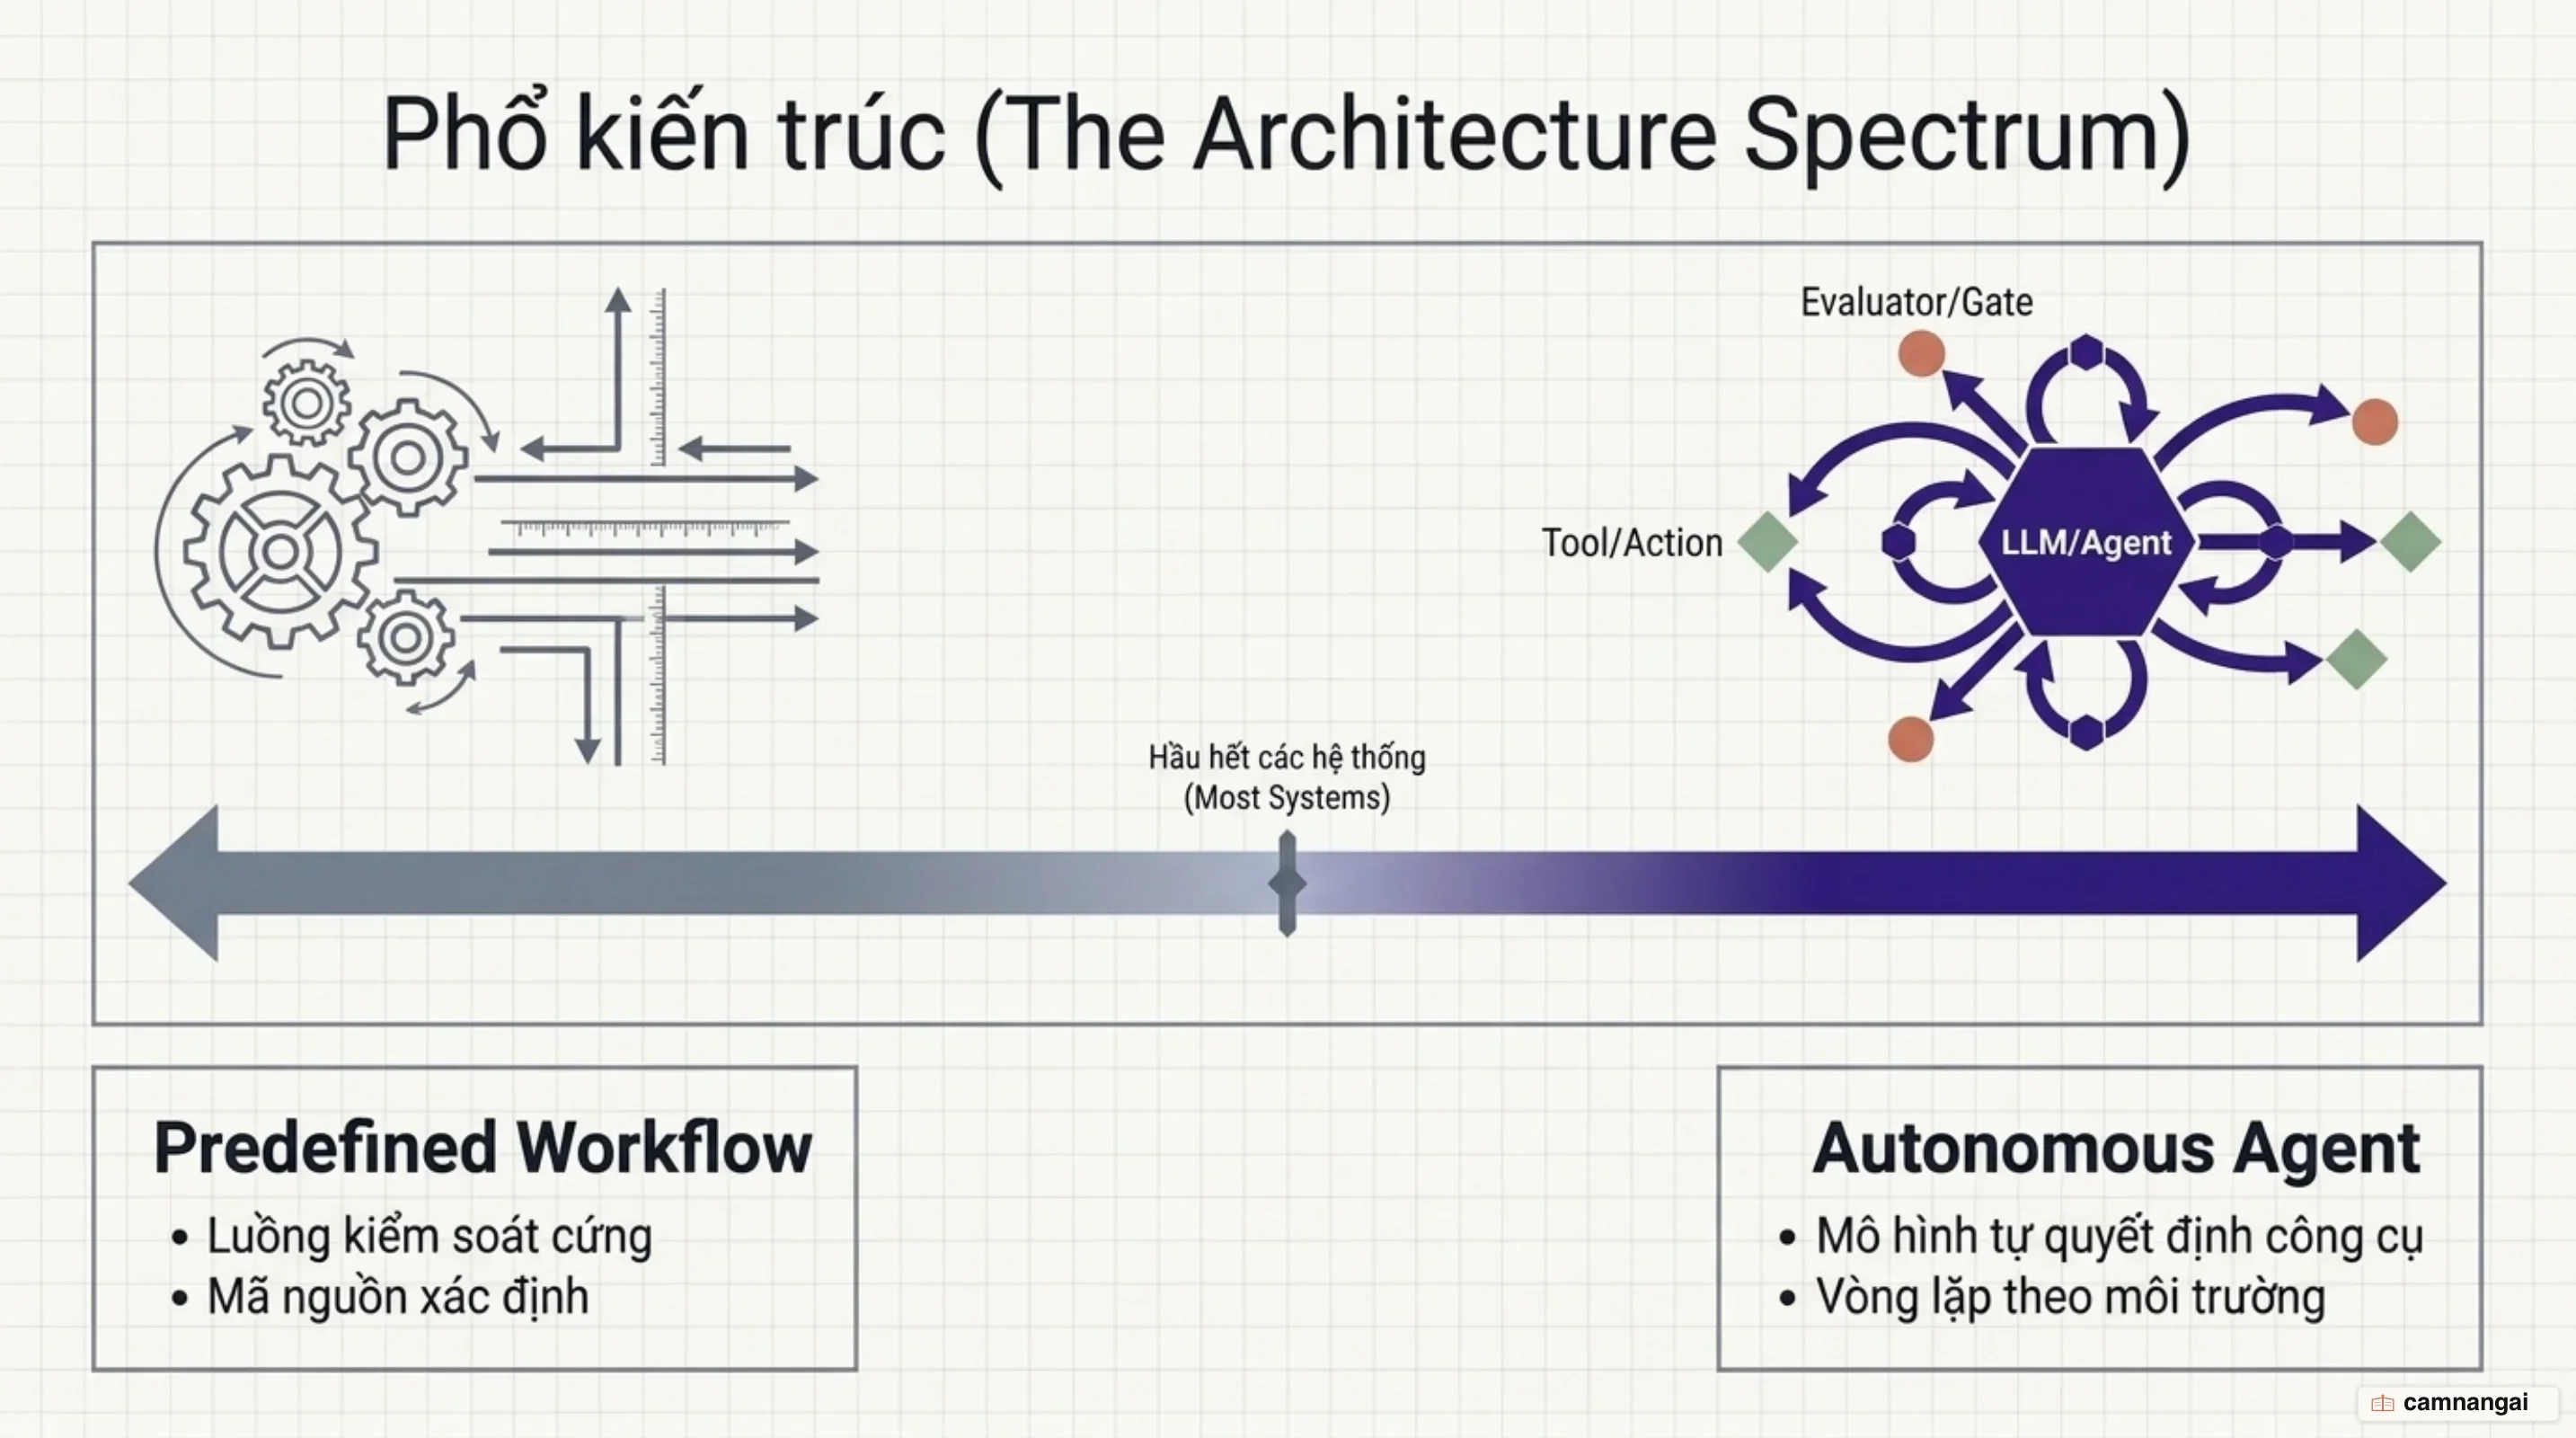
Để thiết kế hệ thống AI đạt chuẩn production, việc phân định rõ ranh giới giữa Workflow và Agent theo định nghĩa kiến trúc của Anthropic và LangChain là bước bắt buộc.
Workflow là các hệ thống trong đó mô hình ngôn ngữ lớn và các công cụ được điều phối thông qua các
tuyến đường mã nguồn được định nghĩa cứng trước (predefined, hardcoded code paths). Trong
workflow, trình tự thực thi giữa các nút xử lý là cố định. LLM chỉ đóng vai trò xử lý biến đổi dữ
liệu tại từng nút cụ thể chứ không nắm quyền quyết định hướng đi của toàn bộ luồng chương trình.
Kiến trúc này mang lại tính xác định tuyệt đối (high determinism), độ trễ có thể tính toán trước và
rủi ro vận hành ở mức thấp nhất.
Ngược lại, Agent đại diện cho các hệ thống mà ở đó LLM được giao quyền tự quản lý luồng điều khiển
(control flow). LLM tự phân tích mục tiêu tổng thể, tự chọn công cụ cần gọi từ một tập hàm được
cung cấp, nhận phản hồi từ môi trường (observation), tự đánh giá tiến độ và quyết định bước tiếp
theo trong một vòng lặp tự trị cho đến khi chạm điều kiện dừng.
Thách thức cốt lõi khiến các agent tự trị thường thất bại trong thực tế nằm ở bài toán Kỹ thuật Quản lý Ngữ cảnh (Context Engineering). Qua phân tích hạ tầng thực tế từ LangChain, nguyên nhân gốc rễ khiến LLM đưa ra quyết định sai lầm trong vòng lặp không phải do mô hình thiếu thông minh, mà xuất phát từ 5 rào cản ngữ cảnh:
1. Thông điệp hệ thống (system prompt) bị thiếu hụt hoặc ngắn mơ hồ.
2. Dữ liệu đầu vào của người dùng chứa các câu lệnh không rõ ràng.
3. Hệ thống không cung cấp đúng các công cụ cần thiết cho bước hiện tại.
4. Mô tả chức năng và tham số của công cụ (tool descriptions) được viết kém chất lượng.
5. Phản hồi trả về từ công cụ bị ô nhiễm thông tin rác hoặc mất định dạng tiêu chuẩn.
Khi chọn lựa khung phát triển (framework), kỹ sư hệ thống phải đối mặt với bài toán đánh đổi giữa hai trường phái:
- **Khung sàn cao / trần thấp (High floor / low ceiling)**: Các thư viện đóng gói sẵn các lớp trừu tượng agent nguyên khối. Chúng giúp dựng mẫu thử nhanh chóng (low entry barrier) nhưng che giấu hoàn toàn lớp xử lý ngữ cảnh bên dưới. Khi ứng dụng đi vào thực tế và phát sinh lỗi biên, việc can thiệp vào bộ đệm ngữ cảnh hoặc tinh chỉnh luồng điều khiển trở nên cực kỳ khó khăn.
- **Khung sàn thấp / trần cao (Low floor / high ceiling)**: Các hạ tầng điều phối ưu tiên mã nguồn và vận hành theo sự kiện (event-driven orchestration) như LangGraph hoặc LlamaIndex Workflows. Chúng đòi hỏi lập trình viên phải tự viết mã cho các quy tắc chuyển trạng thái ban đầu, nhưng bù lại cung cấp khả năng kiểm soát tuyệt đối đối với từng byte dữ liệu đi vào cửa sổ ngữ cảnh của LLM.
| Thông số so sánh | Workflow (Định nghĩa trước) vs Agent (Tự trị) |
| :---------------------------------- | :--------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **Luồng điều khiển (Control Flow)** | **Workflow:** Cố định tuyệt đối qua mã nguồn lập trình (Predefined code paths).
**Agent:** Động, do LLM tự ra quyết định tại thời điểm thực thi (Dynamic runtime execution). |
| **Độ dự đoán (Predictability)** | **Workflow:** Rất cao, luồng thực thi nhất quán và dễ viết Unit Test.
**Agent:** Biến động, phụ thuộc vào năng lực suy luận ngẫu nhiên của mô hình. |
| **Độ trễ & Chi phí (Latency/Cost)** | **Workflow:** Thấp, số lượt gọi LLM là cố định và dễ lập ngân sách.
**Agent:** Cao và biến đổi, nhân lên theo số vòng lặp thực tế. |
| **Trường hợp sử dụng tối ưu** | **Workflow:** Quy trình nghiệp vụ cố định, xử lý tài liệu chuẩn hóa.
**Agent:** Bài toán tìm kiếm mở, lập trình phần mềm tự động, trợ lý đa bước. |
## Pattern 1: Prompt Chaining và Routing: Nền tảng điều phối tuyến tính
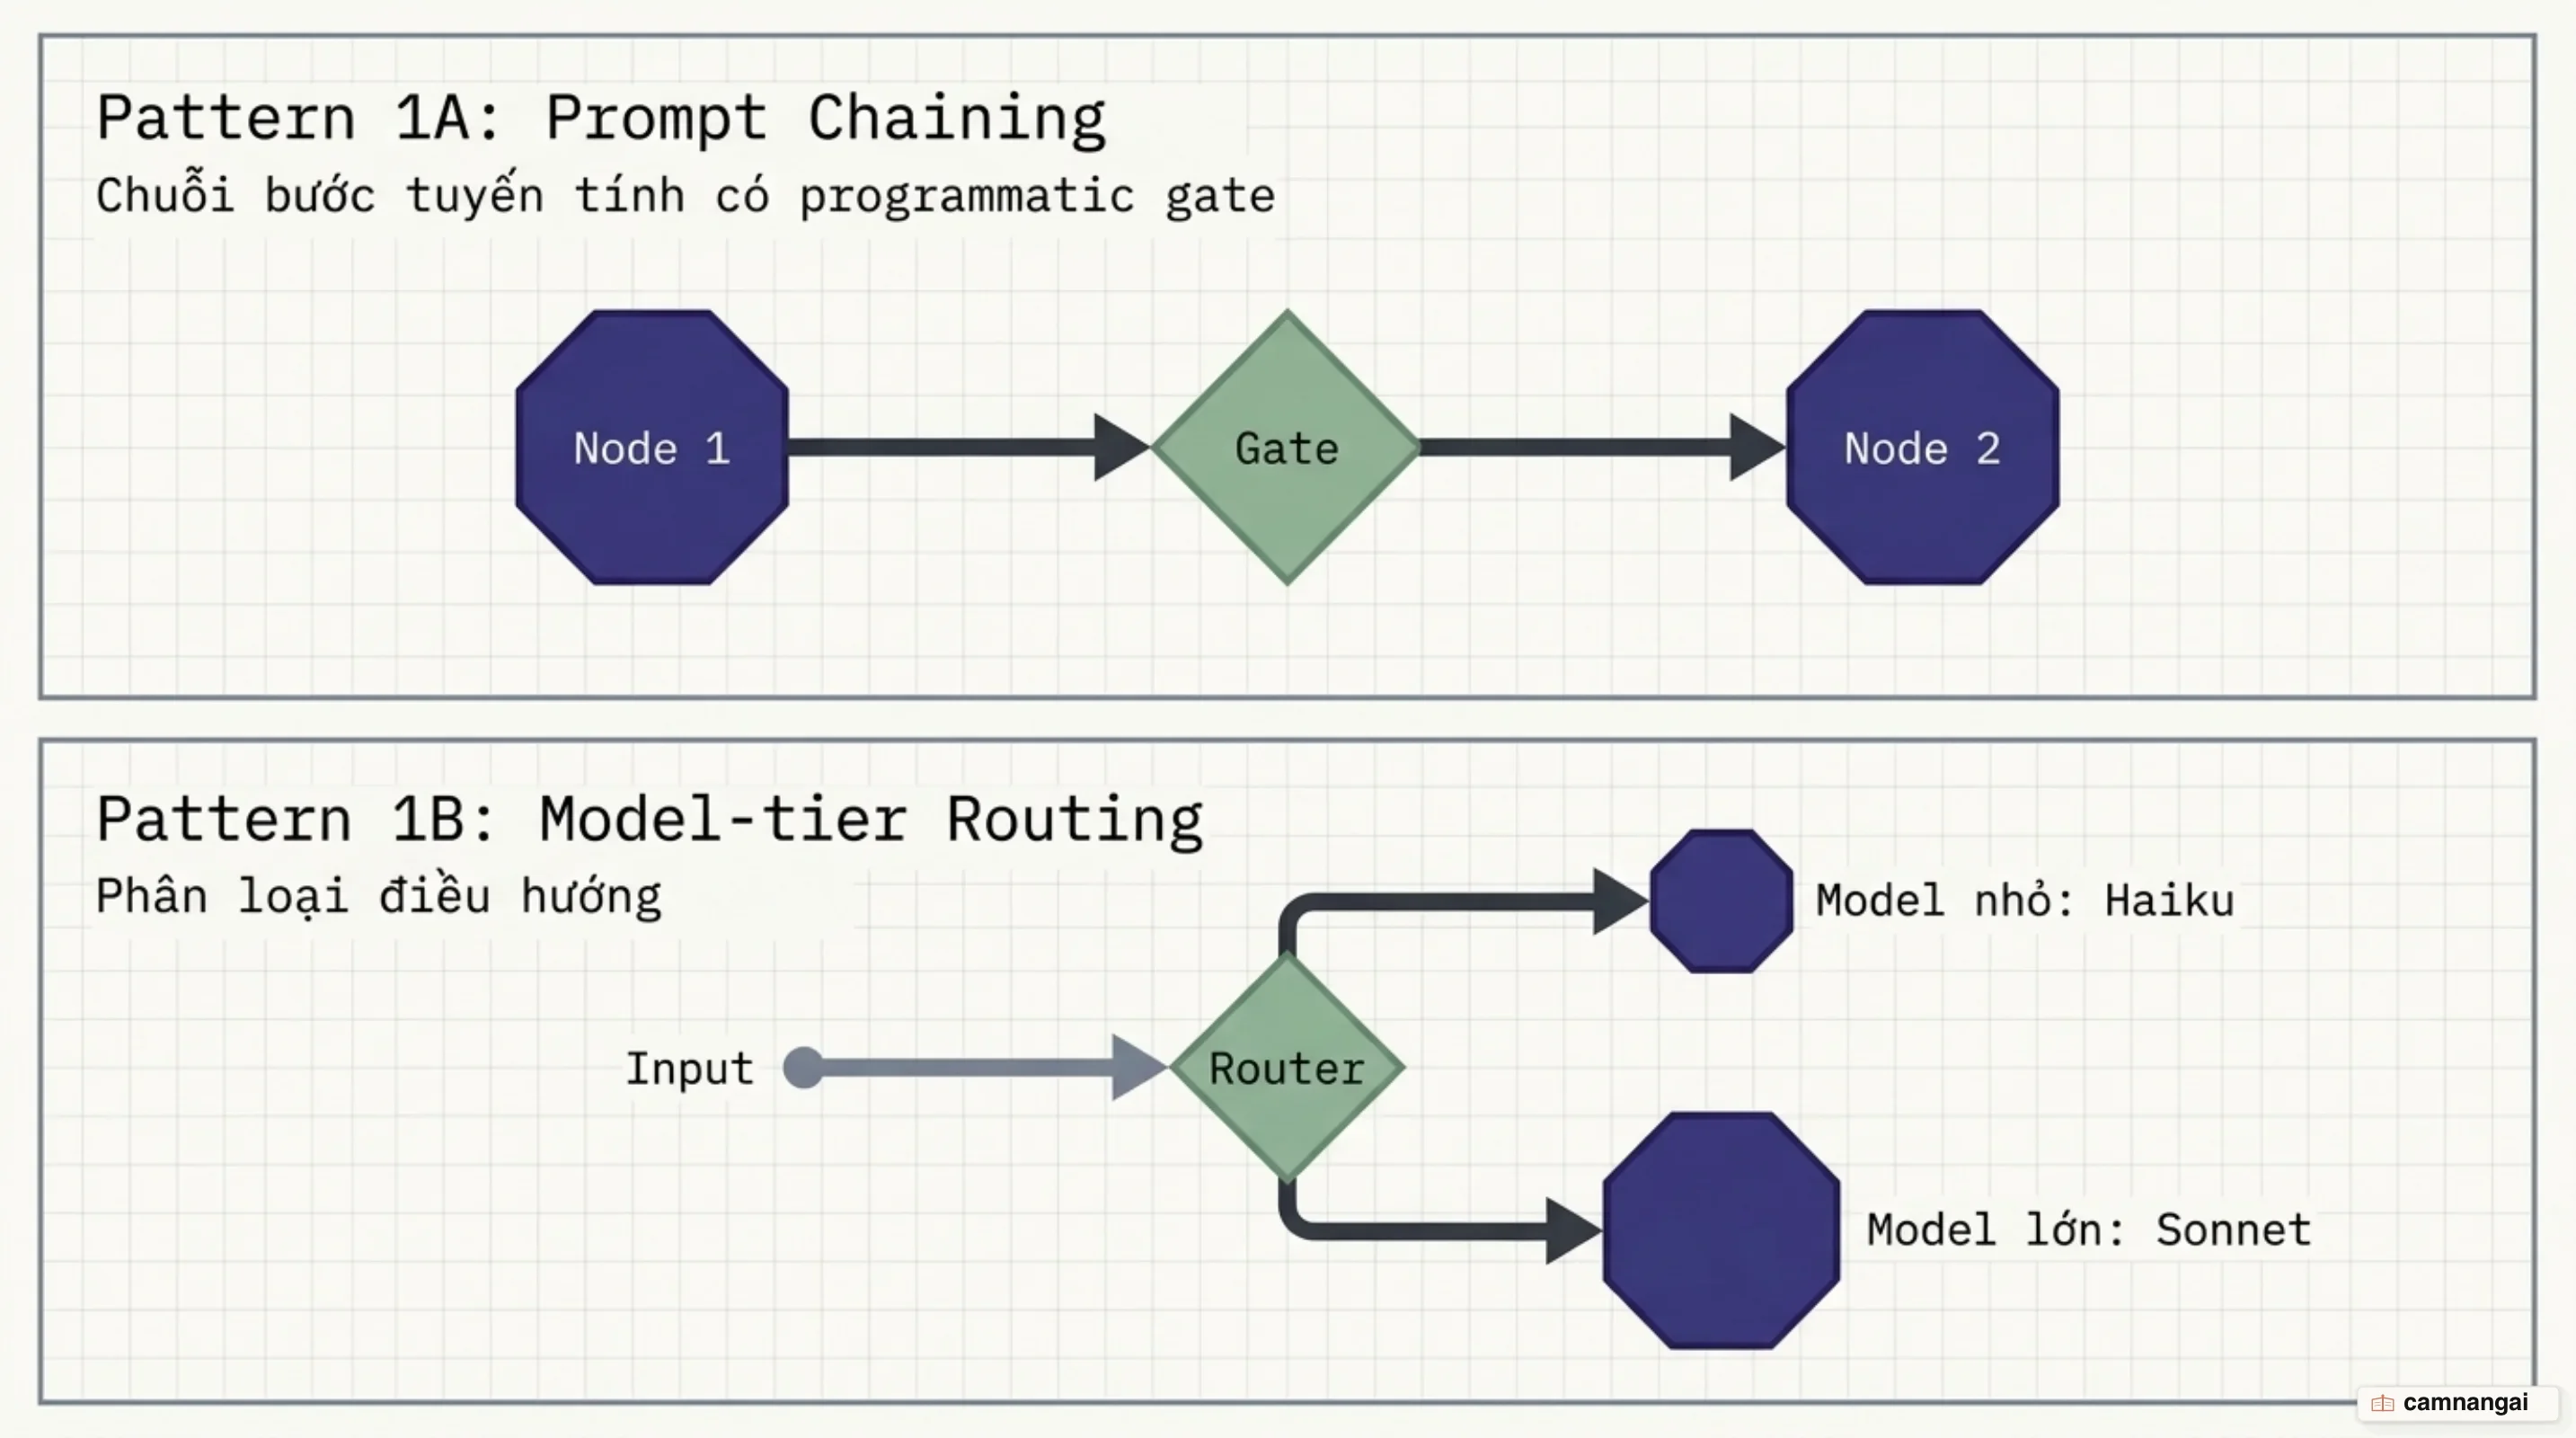
Prompt Chaining là thiết kế nền tảng nhất của các agentic workflow pattern. Pattern này chia nhỏ
một tác vụ tổng thể thành chuỗi các bước tuyến tính nối tiếp nhau, trong đó đầu ra của bước trước
`Output(Step N)` được đóng gói làm đầu vào cho bước tiếp theo `Input(Step N+1)`.
Bằng cách thu hẹp phạm vi nhận thức của từng lượt gọi LLM, hệ thống tối ưu hóa được năng lực xử lý
cho từng nhiệm vụ chuyên biệt.
Để đảm bảo tính bền vững cho hệ thống khi vận hành production, các cổng kiểm soát bằng mã truyền thống (programmatic gates) bắt buộc phải được cài đặt nối giữa các lượt gọi LLM. Nhiệm vụ của cổng kiểm soát là thẩm định tính hợp lệ của dữ liệu trung gian (schema validation, độ dài, tiêu chuẩn an toàn). Nếu dữ liệu không thỏa mãn tiêu chí xác định, cổng kiểm soát sẽ chặn luồng thực thi hoặc kích hoạt cơ chế yêu cầu LLM ở bước trước tạo lại dữ liệu, ngăn chặn tình trạng dữ liệu lỗi lan truyền xuống hạ nguồn.
Routing là pattern sử dụng một bộ phân loại (bằng LLM nhỏ hoặc thuật toán phân loại truyền thống)
để kiểm tra payload đầu vào và điều hướng dữ liệu đến các nhánh xử lý chuyên biệt.
Routing giúp áp dụng nguyên lý tách biệt các mối quan tâm (separation of concerns), loại bỏ việc sử
dụng các system prompt cồng kềnh ôm đồm nhiều nhiệm vụ.
Chiến lược Routing theo phân cấp mô hình (Model-tier Routing) là giải pháp tối ưu hóa chi phí và
độ trễ triệt để.
Các truy vấn mang tính thủ tục hoặc độ phức tạp thấp sẽ được điều hướng đến các mô hình kích thước
nhỏ, chi phí thấp như Claude Haiku 4.5. Ngược lại, các trường hợp biên (edge cases) khó hoặc đòi hỏi
suy luận logic đa tầng sẽ được đẩy lên các mô hình cao cấp như Claude Sonnet 4.5.
Đoạn mã Python dưới đây minh họa việc kết hợp giữa Routing phân cấp và một cổng kiểm soát dữ liệu (Programmatic Gate) sử dụng thư viện `pydantic`:
```python
import json
from pydantic import BaseModel, ValidationError
class AnalysisOutputSchema(BaseModel):
summary: str
risk_score: int
action_required: bool
def programmatic_gate(raw_output: str) -> AnalysisOutputSchema:
"""Cổng kiểm soát dữ liệu: Đảm bảo đầu ra tuân thủ cấu trúc JSON tiêu chuẩn."""
try:
data = json.loads(raw_output)
validated_data = AnalysisOutputSchema(**data)
if not (0 <= validated_data.risk_score <= 100):
raise ValueError("Risk score nằm ngoài phạm vi 0-100")
return validated_data
except (json.JSONDecodeError, ValidationError, ValueError) as e:
raise ValueError(f"Gate Verification Failed: {str(e)}")
def route_and_execute_pipeline(user_query: str) -> dict:
# Bước 1: Routing phân loại truy vấn
classifier_prompt = f"Phân loại truy vấn thành 'ROUTINE' hoặc 'COMPLEX': {user_query}"
category = llm_call(model="claude-haiku-4-5", prompt=classifier_prompt).strip()
# Bước 2: Điều hướng đến Model Tier phù hợp
selected_model = "claude-haiku-4-5" if "ROUTINE" in category else "claude-sonnet-4-5"
worker_prompt = f"Phân tích yêu cầu và trả về JSON chuẩn theo schema (summary, risk_score, action_required): {user_query}"
raw_response = llm_call(model=selected_model, prompt=worker_prompt)
# Bước 3: Thực thi qua Gate
try:
validated_result = programmatic_gate(raw_response)
return {"status": "SUCCESS", "data": validated_result.dict()}
except ValueError as err:
# Retry logic hoặc Fallback đường ống cố định
return {"status": "FAILED_GATE", "reason": str(err)}
```
## Pattern 2: Parallelization và Orchestrator-Workers: Xử lý song song và ủy quyền
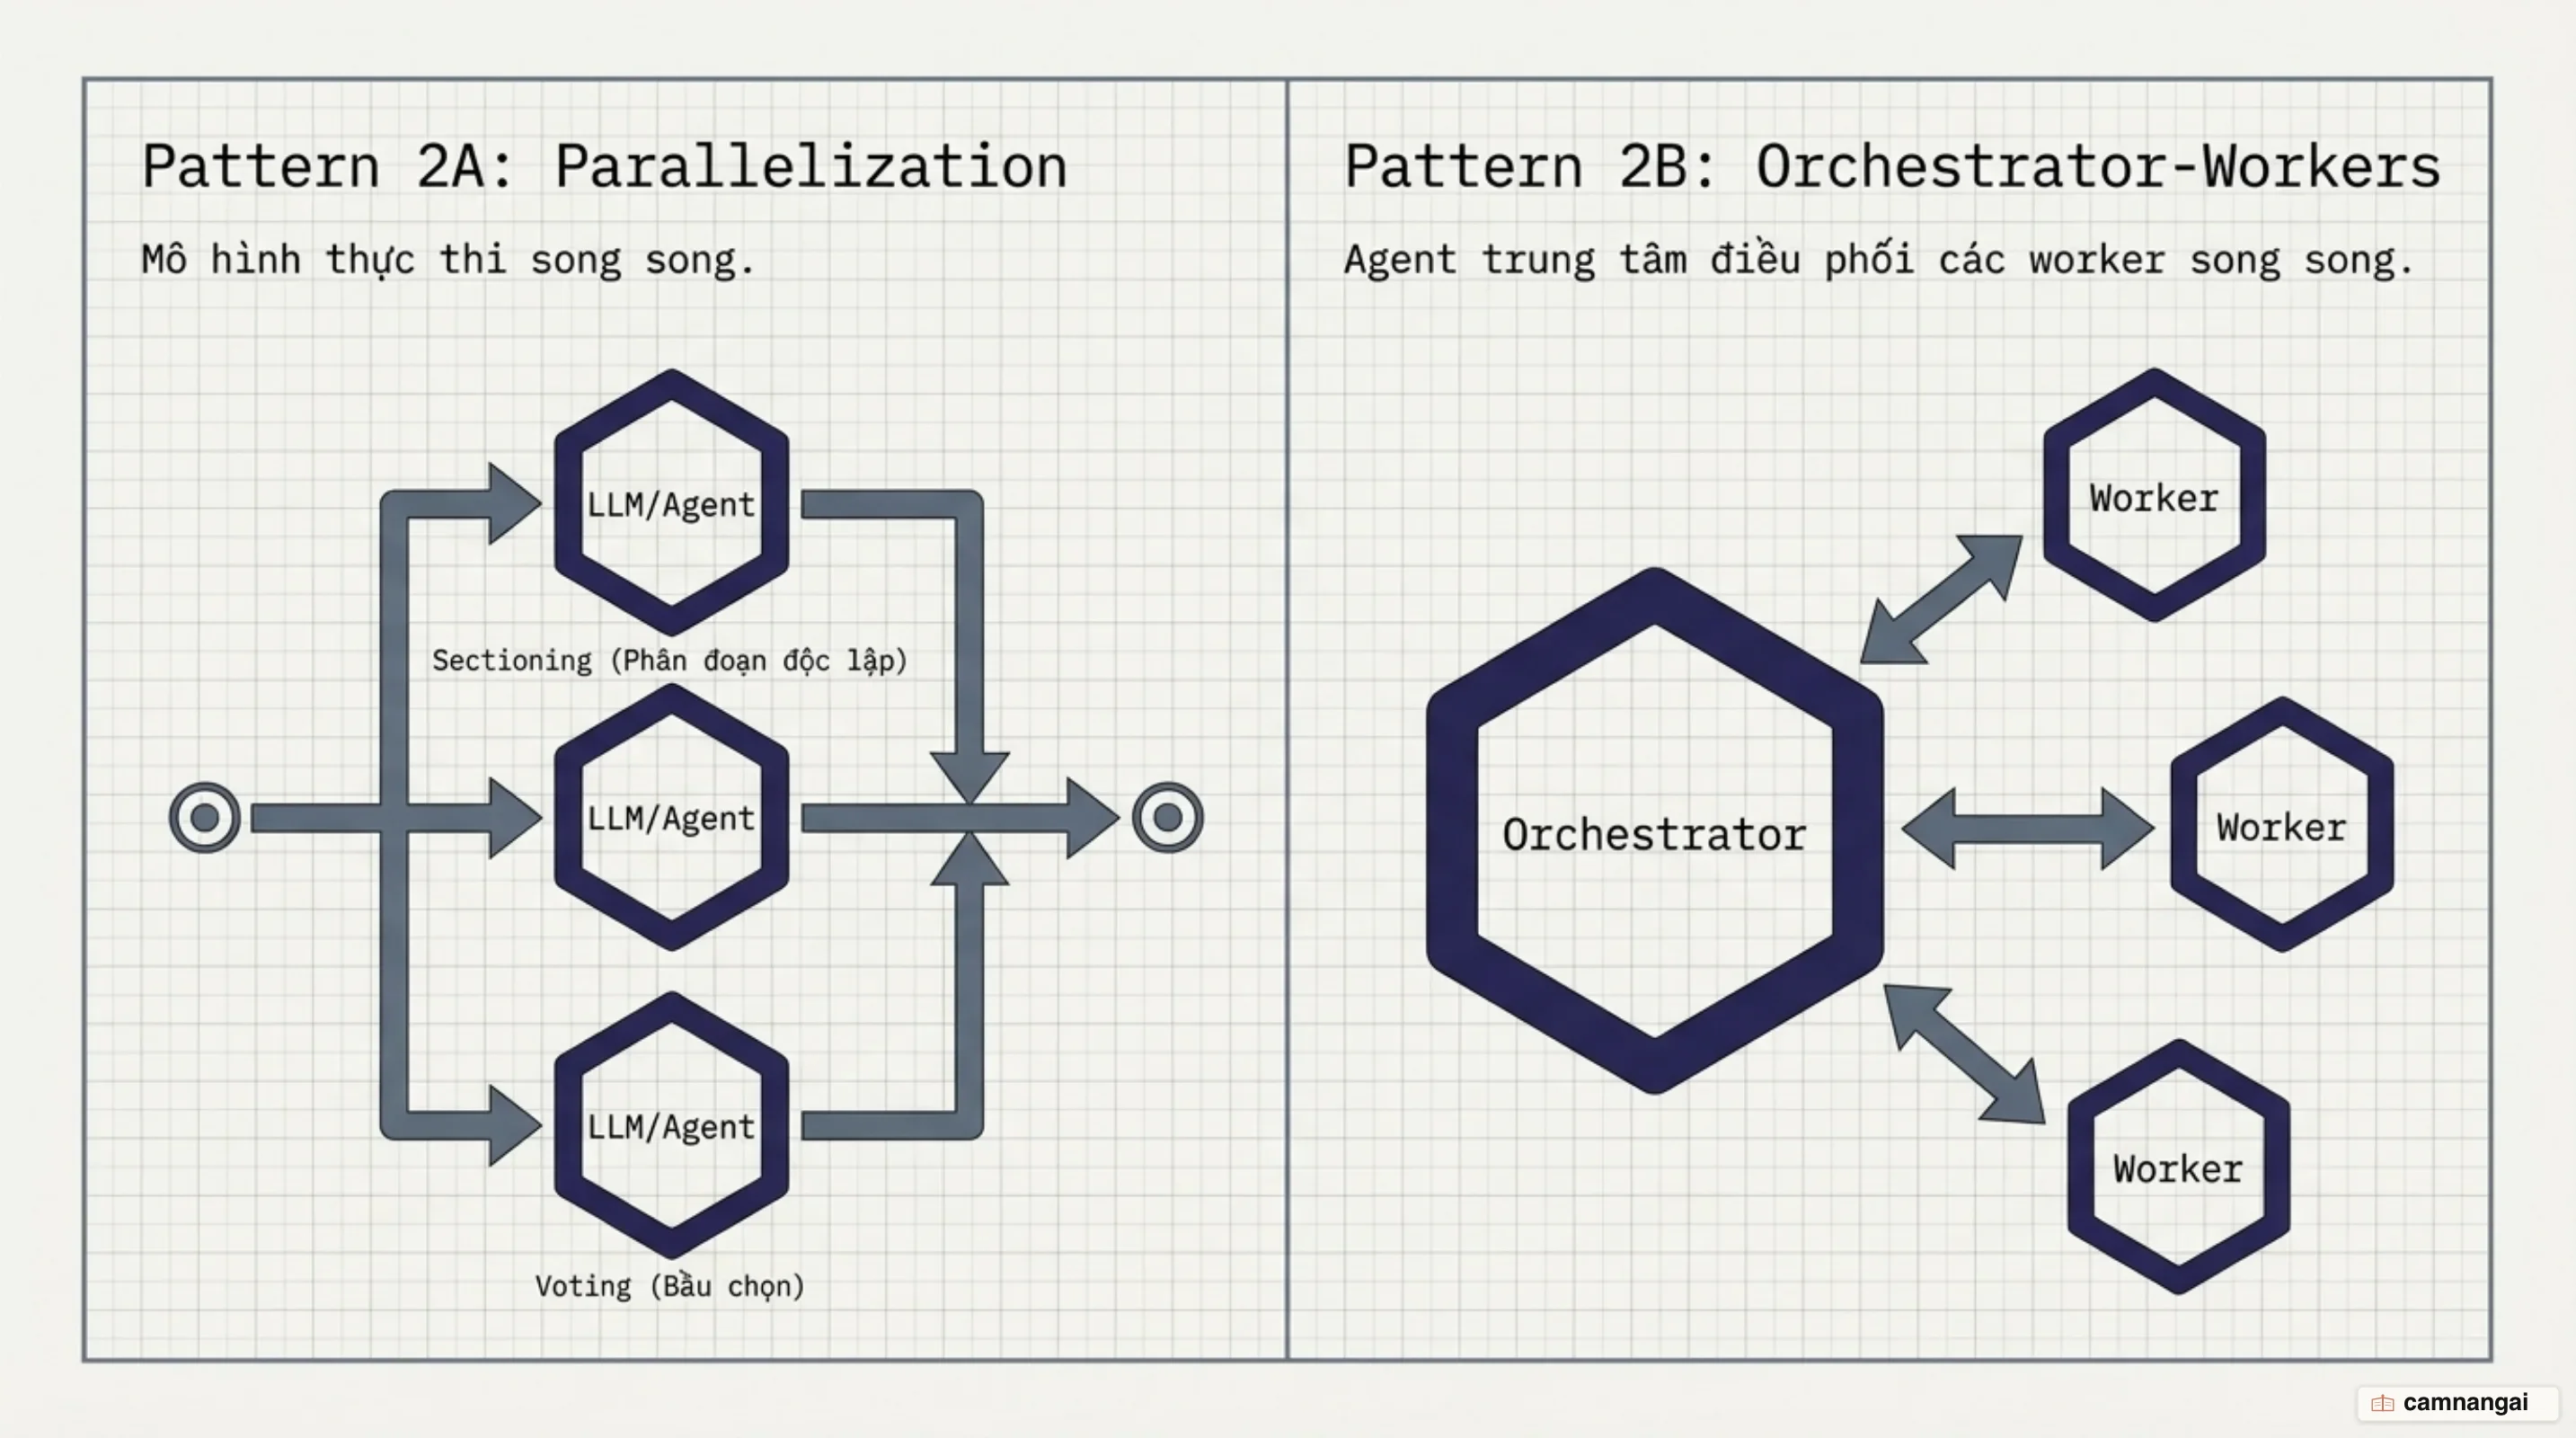
Parallelization khai thác khả năng bất đồng bộ của hạ tầng để thực thi đồng thời các lượt gọi LLM độc lập, giải quyết triệt để nút thắt cổ chai về độ trễ tổng thể. Pattern này được chia làm hai dạng cấu trúc:
- **Sectioning (Phân đoạn)**: Chia một tác vụ lớn thành các tác vụ con độc lập về mặt ngữ cảnh và thực thi song song qua `asyncio.gather`. Ví dụ điển hình trong thiết kế hạ tầng an toàn (guardrails): một lời gọi LLM chịu trách nhiệm sinh nội dung phản hồi chính cho người dùng, trong khi một lời gọi LLM khác chạy song song để quét các rủi ro bảo mật hoặc vi phạm chính sách. Việc tách biệt này giúp mô hình chính không bị phân tán tài nguyên nhận thức.
- **Voting (Bầu chọn)**: Chạy cùng một prompt nhiều lần đồng thời (hoặc biến thể của prompt) để lấy đa dạng các kết quả đầu ra, sau đó dùng thuật toán tổng hợp bỏ phiếu đa số để chọn kết quả tối ưu. Thiết kế này cực kỳ hiệu quả cho các tác vụ đòi hỏi độ tin cậy tuyệt đối như rà soát lỗ hổng bảo mật trong mã nguồn.
```python
import asyncio
async def run_parallel_guardrails(user_prompt: str):
# Thực thi song song tác vụ sinh nội dung và tác vụ kiểm duyệt an toàn
task_generation = llm_async_call(model="claude-sonnet-4-5", prompt=user_prompt)
task_guardrail = llm_async_call(model="claude-haiku-4-5", prompt=f"Screen safety: {user_prompt}")
response, safety_check = await asyncio.gather(task_generation, task_guardrail)
if "UNSAFE" in safety_check:
raise SecurityException("Cảnh báo an toàn: Đầu vào vi phạm chính sách.")
return response
```
Orchestrator-Workers nâng cấp kiến trúc song song lên mức độ động. Trong mô hình này, một LLM
trung tâm (Orchestrator) nhận nhiệm vụ phân tích yêu cầu tổng thể, tự động xác định số lượng tác
vụ con cần thiết ngay tại thời điểm chạy (runtime), khởi tạo và giao việc cho các LLM thành phần
(Workers), sau đó chờ tổng hợp các kết quả trả về.
Sự khác biệt cốt lõi giữa Parallelization và Orchestrator-Workers nằm ở tính chất cố định hay động của luồng xử lý. Trong Parallelization, các điểm chia nhánh (splits) được lập trình viên định nghĩa cứng từ trước. Ngược lại, Orchestrator-Workers không thể biết trước số lượng tác vụ con; số lượng Worker sẽ phụ thuộc hoàn toàn vào phân tích của Orchestrator đối với dữ liệu đầu vào. Cấu trúc này là lựa chọn bắt buộc cho các bài toán phức tạp như thực hiện thay đổi mã nguồn liên quan tới danh sách tập tin chưa biết trước hoặc tổng hợp thông tin từ nhiều nguồn tài liệu đa dạng.
## Pattern 3: Reflection và Evaluator-Optimizer: Vòng lặp tự phê bình và tối ưu
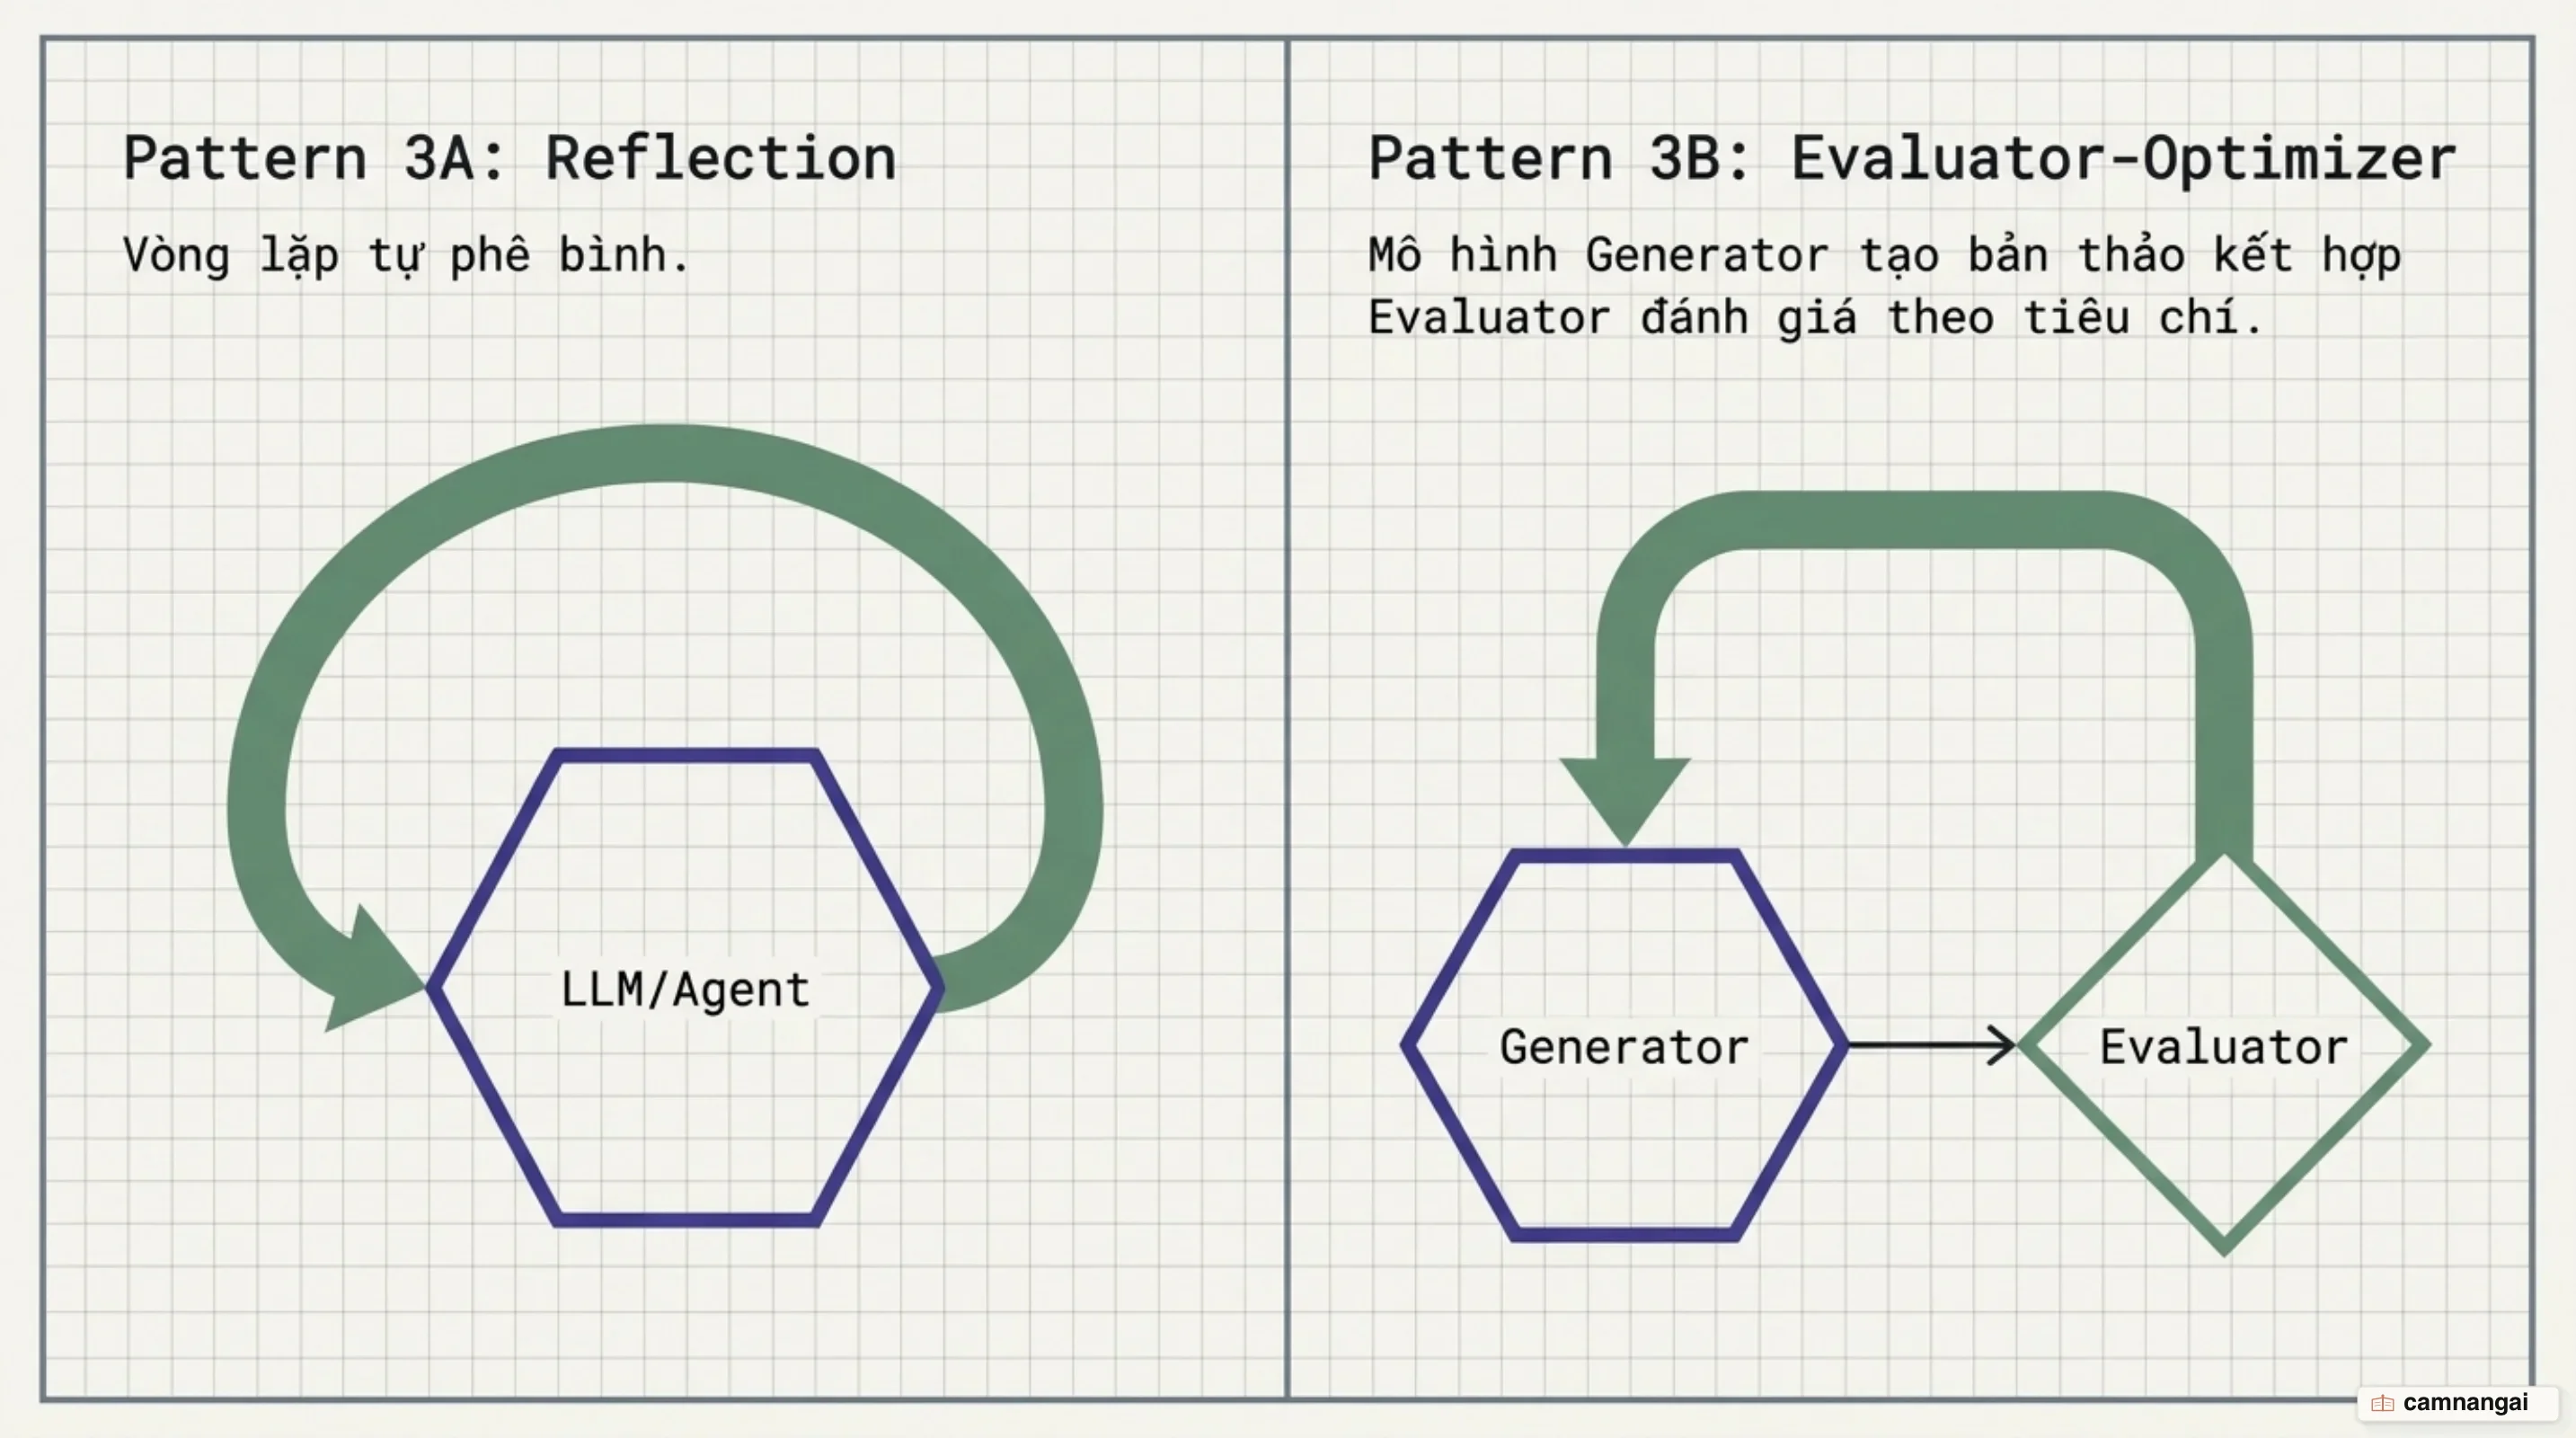
Reflection Pattern vận hành dựa trên cơ chế đơn agent (single-agent loop), trong đó mô hình ngôn
ngữ tự liên tục kiểm tra và điều chỉnh sản phẩm của chính mình. Sau khi tạo ra bản thảo ban đầu
(draft), agent tự chuyển đổi ngữ cảnh sang chế độ tự phê bình (critique mode). Agent đối chiếu bản
thảo vừa tạo với tập tiêu chuẩn định sẵn (độ chính xác, phong cách, lỗ hổng bảo mật) để vạch ra
danh sách các điểm sai sót.
Dựa trên bản nhận xét này, agent tiến hành tạo phiên bản hiệu chỉnh. Vòng lặp tự phản hồi này tiếp
diễn cho đến khi bản thảo đạt yêu cầu hoặc vượt quá giới hạn lặp.
Evaluator-Optimizer Workflow nâng cao tính khách quan bằng cách tách biệt hoàn toàn trách nhiệm
giữa hai mô hình LLM riêng biệt: mô hình Generator (Optimizer) chuyên trách tạo giải pháp và mô
hình Evaluator chuyên trách đánh giá.
Generator tập trung tối đa tài nguyên để sinh ra bản thảo đầu ra. Evaluator tiến hành kiểm tra bản
thảo đó dựa trên các tiêu chí khách quan và cung cấp phản hồi chi tiết về các lỗi logic hoặc các
thông số chưa đạt. Generator tiếp nhận phản hồi, điều chỉnh chiến lược suy luận và xuất ra bản thảo
mới.
```
+-------------------+ Gửi bản thảo +-------------------+
| Generator LLM | ---------------------> | Evaluator LLM |
| (Tạo nội dung/mã) | | (Kiểm tra tiêu chí|
+-------------------+ +-------------------+
^ |
| Nhận bản nhận xét lỗi | Đạt chuẩn?
+--------------------------------------------+
|
(Có) | (Không: Tiếp tục lặp)
v
[Kết quả cuối cùng]
```
Mô hình Evaluator-Optimizer đặc biệt phát huy sức mạnh trong các miền ứng dụng có tiêu chí đánh giá rõ ràng nhưng lại rất khó để LLM tạo ra kết quả hoàn hảo ngay từ lượt đầu tiên. Trong dịch thuật văn học, Evaluator giúp phát hiện các sắc thái ngữ nghĩa mà bản dịch đầu tiên bỏ lỡ. Trong các bài toán nghiên cứu thông tin đa bước (multi-hop research), Evaluator đóng vai trò thẩm định xem lượng dữ liệu thu thập được đã đủ để đưa ra kết luận chưa hay cần tiếp tục truy vấn. Trong lĩnh vực kỹ thuật phần mềm, mô hình này có thể kết hợp với các bộ kiểm thử tự động (automated test suites)—trong đó bộ kiểm thử chạy mã thực tế đóng vai trò làm Evaluator khách quan tuyệt đối.
## Pattern 4: ReAct và Tool Use: Vòng lặp suy luận, hành động và quan sát
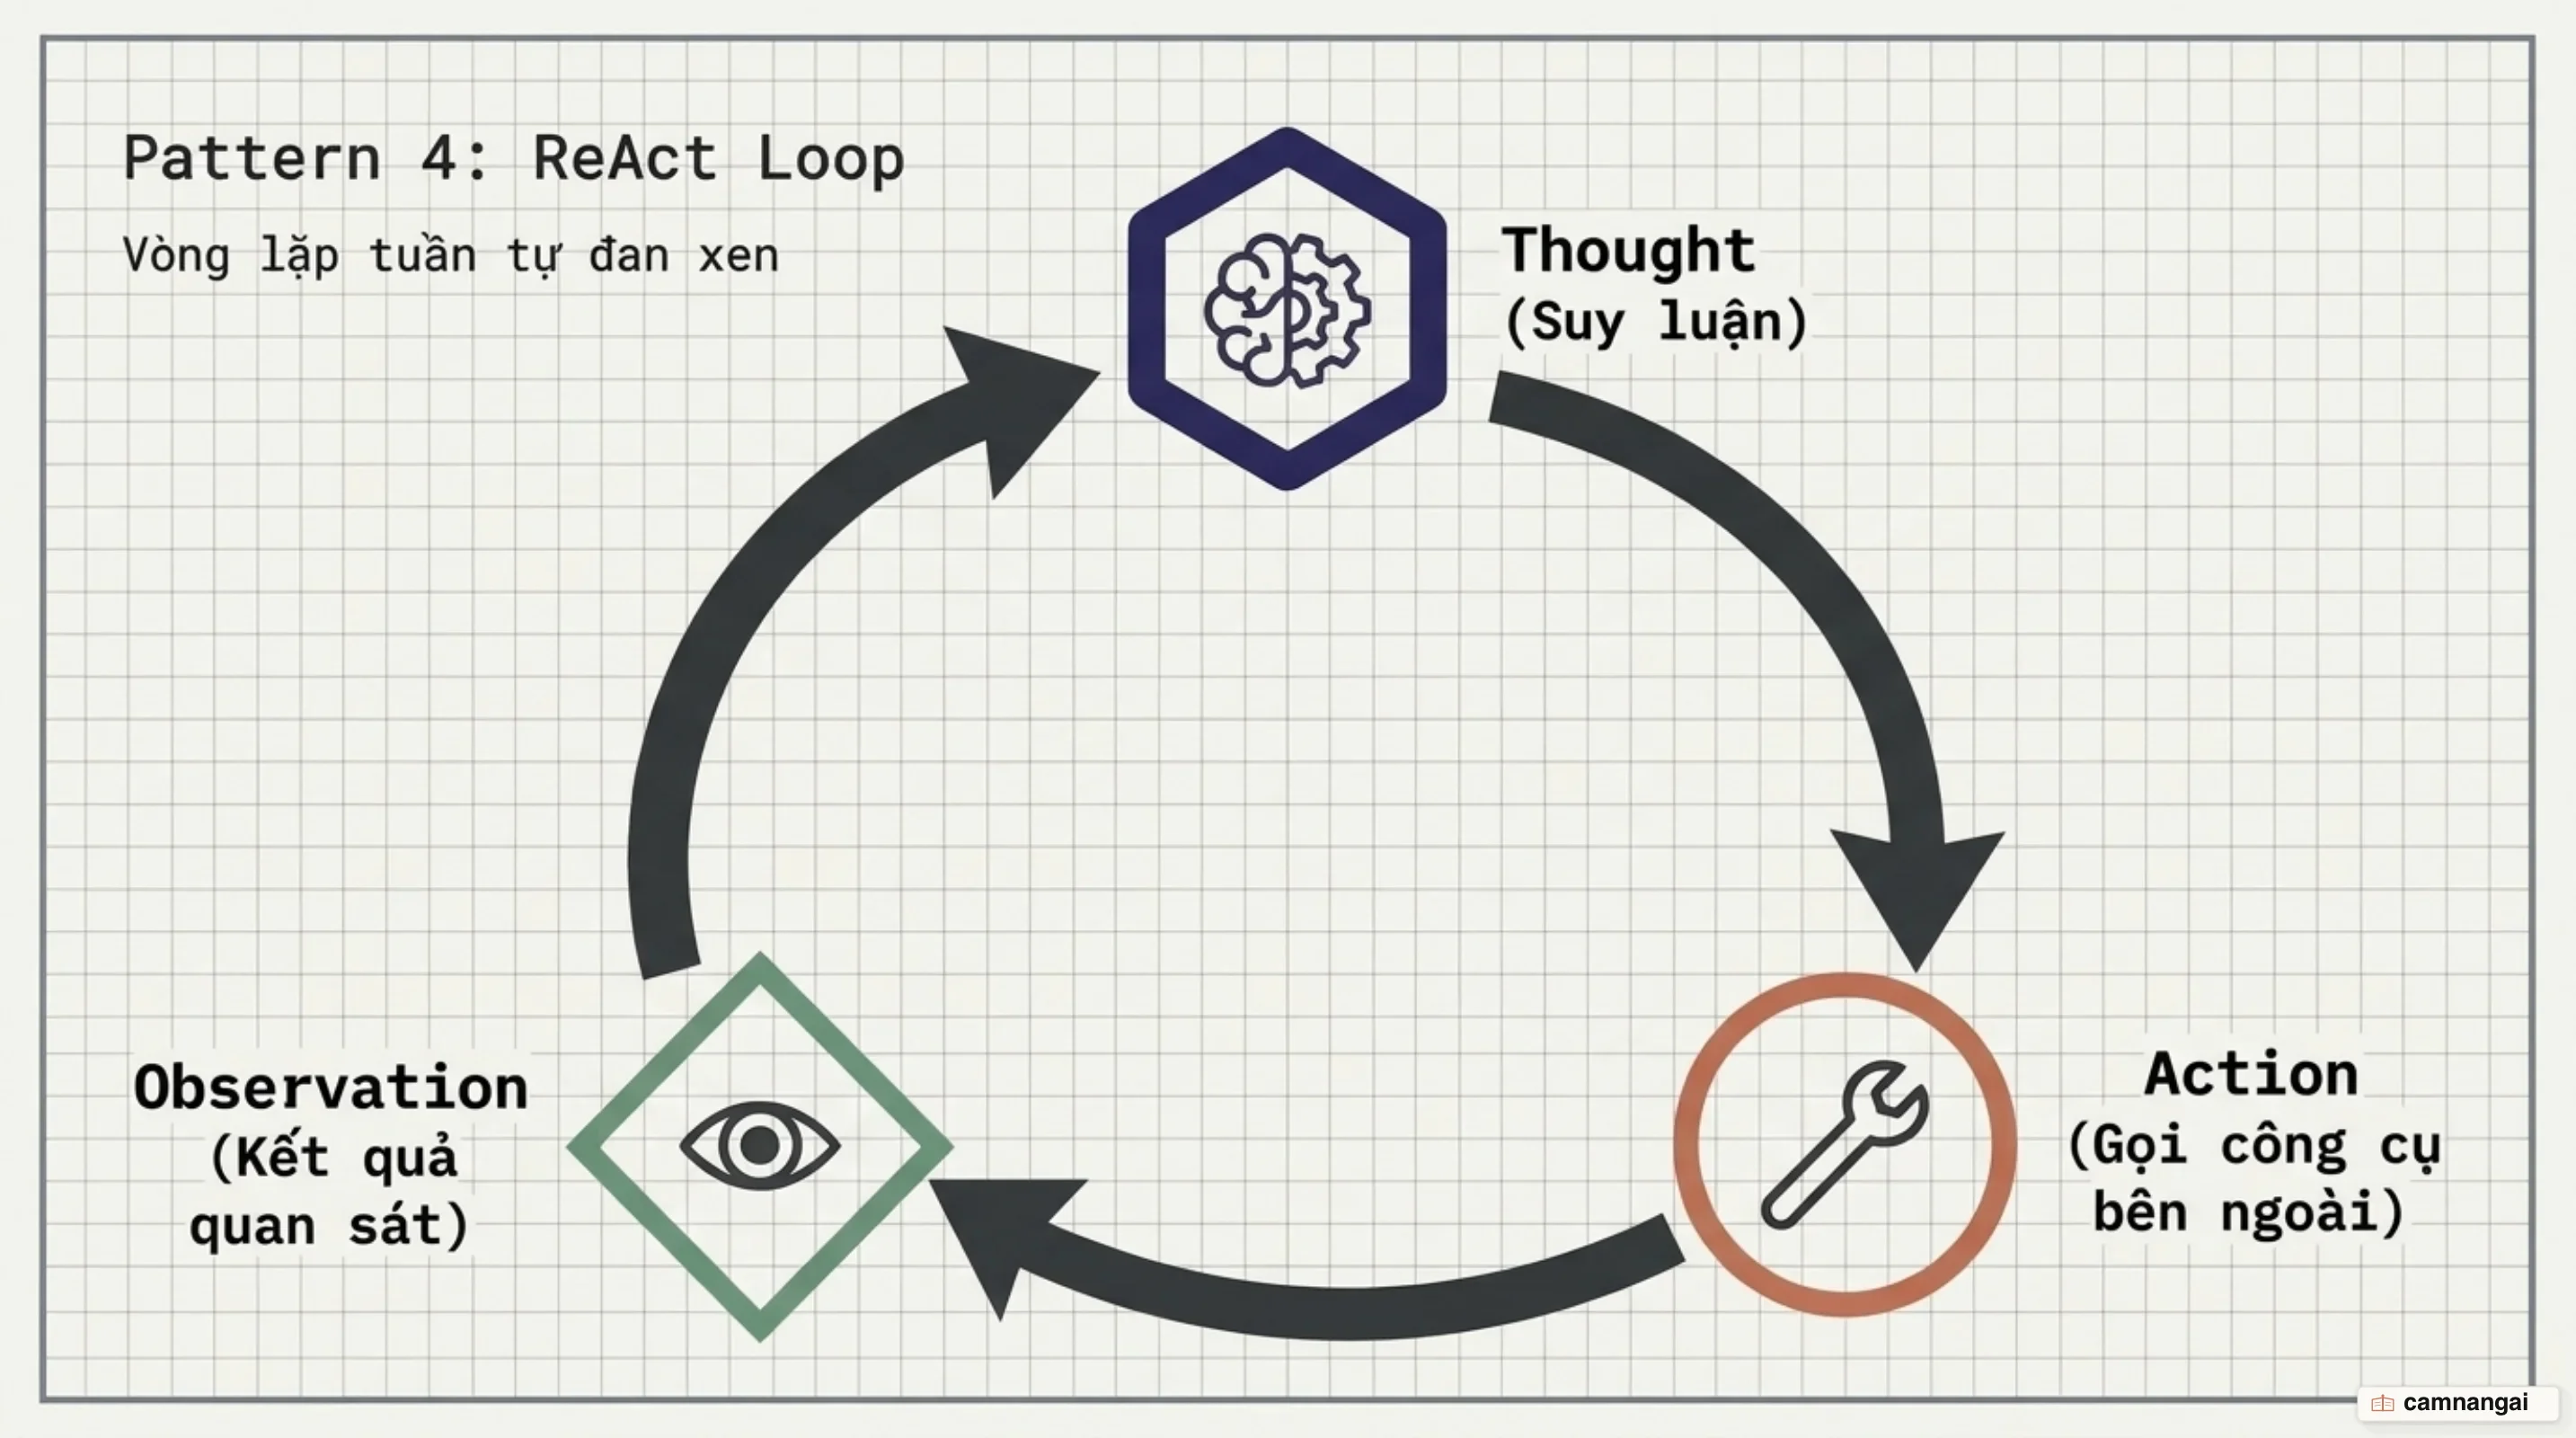
ReAct (Reasoning + Acting) đại diện cho phương pháp luận kết hợp chặt chẽ giữa chuỗi suy luận nội
tại (Chain-of-Thought) và khả năng tương tác trực tiếp với môi trường thực tế thông qua công cụ.
Thay vì bắt LLM dự đoán câu trả lời ngay lập tức hoặc thực hiện chuỗi hành động mù quáng, ReAct
đan xen các bước Suy luận (Thought), Hành động (Action) và Quan sát (Observation) theo chu kỳ lặp.
```
Thought -> Action -> Observation -> Thought -> Action -> Observation -> Final Answer
```
Nhờ các bước Suy luận (Thought), mô hình duy trì được bức tranh tổng thể về mục tiêu, phân tích dữ liệu hiện có và đưa ra quyết định gọi công cụ chính xác. Phản hồi thực tế từ công cụ (Observation) đóng vai trò là dữ liệu thực tại (ground truth), giúp mô hình cập nhật bộ đệm ngữ cảnh và điều chỉnh bước tư duy tiếp theo.
Nghiên cứu thực nghiệm từ Yao và các cộng sự (2022) chứng minh rằng ReAct giải quyết triệt để hiện tượng suy diễn ảo giác (hallucination) và lỗi tích lũy thường gặp trên các bộ kiểm thử tra cứu thông tin đa bước (HotpotQA) cũng như xác minh thực tế (Fever). Bằng cách kết nối với Wikipedia API để lấy dữ liệu thực tế tại từng bước, ReAct duy trì độ chính xác cao vượt bậc. Trên các môi trường kiểm thử tương tác phức tạp như ALFWorld và WebShop, ReAct đánh bại các phương pháp học tăng cường (RL) và học bắt chước (Imitation Learning), nâng tỷ lệ thành công tuyệt đối lên thêm +34% trên ALFWorld và +10% trên WebShop dù chỉ được cung cấp từ 1 đến 2 ví dụ minh họa trong ngữ cảnh (in-context examples).
Hiệu năng vận hành của kiến trúc ReAct phụ thuộc trực tiếp vào kỹ thuật thiết kế Giao diện Agent-Máy tính (Agent-Computer Interface - ACI) và chất lượng viết prompt cho công cụ:
- **Triệt tiêu chi phí định dạng (Formatting Overhead)**: Tránh các công cụ bắt LLM phải tính toán chính xác số lượng dòng thay đổi (như tạo file diff) hoặc thực hiện escape ký tự chuỗi phức tạp (như nhúng mã nguồn vào chuỗi JSON). Hãy ưu tiên các định dạng văn bản tự nhiên trùng khớp với dữ liệu huấn luyện của mô hình.
- **Thao tác tuyệt đối hóa đường dẫn (Absolute Paths)**: Bài học từ quá trình tối ưu hóa agent trên benchmark SWE-bench cho thấy: LLM rất dễ mất phương hướng khi xử lý đường dẫn tương đối sau khi chuyển đổi thư mục làm việc. Yêu cầu bắt buộc mô hình luôn truyền đường dẫn tuyệt đối (absolute filepaths) giúp triệt tiêu dạng lỗi runtime này.
- **Áp dụng nguyên tắc Poka-yoke**: Thiết kế tham số của công cụ theo hướng chống sai sót triệt để. Đặt tên tham số rõ ràng, định nghĩa kiểu dữ liệu nghiêm ngặt và cung cấp ví dụ chi tiết trong phần mô tả công cụ giống như cách viết tài liệu API dành cho lập trình viên sơ cấp.
Dưới đây là vết thực thi (trajectory) thực tế của một ReAct Agent:
```text
Thought: Tôi cần kiểm tra doanh thu năm 2023 của công ty Acme Corp để so sánh với kế hoạch 2024.
Action: search_financial_records(company="Acme Corp", fiscal_year=2023)
Observation: {"status": "SUCCESS", "revenue": "$50M", "net_profit": "$8M"}
Thought: Đã lấy được doanh thu 2023 là $50M. Bây giờ tôi cần tìm kế hoạch doanh thu năm 2024.
Action: search_financial_records(company="Acme Corp", fiscal_year=2024)
Observation: {"status": "SUCCESS", "target_revenue": "$65M"}
Thought: Đã có đủ dữ liệu thực tế. Mức tăng trưởng kế hoạch là ($65M - $50M) / $50M = 30%.
Final Answer: Doanh thu năm 2023 của Acme Corp đạt $50M. Kế hoạch doanh thu năm 2024 đặt mục tiêu $65M, tương ứng mức tăng trưởng 30%.
```
## Pattern 5: Multi-Agent Collaboration: Handoffs và Subagents
Khi độ phức tạp của bài toán doanh nghiệp vượt quá sức chứa nhận thức của một system prompt nguyên khối, việc phân rã hệ thống thành một mạng lưới các Agent chuyên biệt (Multi-Agent Architecture) là lựa chọn tối ưu. Chiến lược chuyên môn hóa giúp mỗi agent sở hữu một tập công cụ thu nhỏ, cửa sổ ngữ cảnh được làm sạch và phạm vi trách nhiệm cô lập, loại bỏ hiện tượng nhiễu ngữ cảnh khi một LLM phải gánh vác quá nhiều mục tiêu xung đột.
Trong hạ tầng công nghiệp (như định hướng của OpenAI Agents SDK), hai mô hình điều phối Multi-Agent được triển khai phổ biến nhất bao gồm:
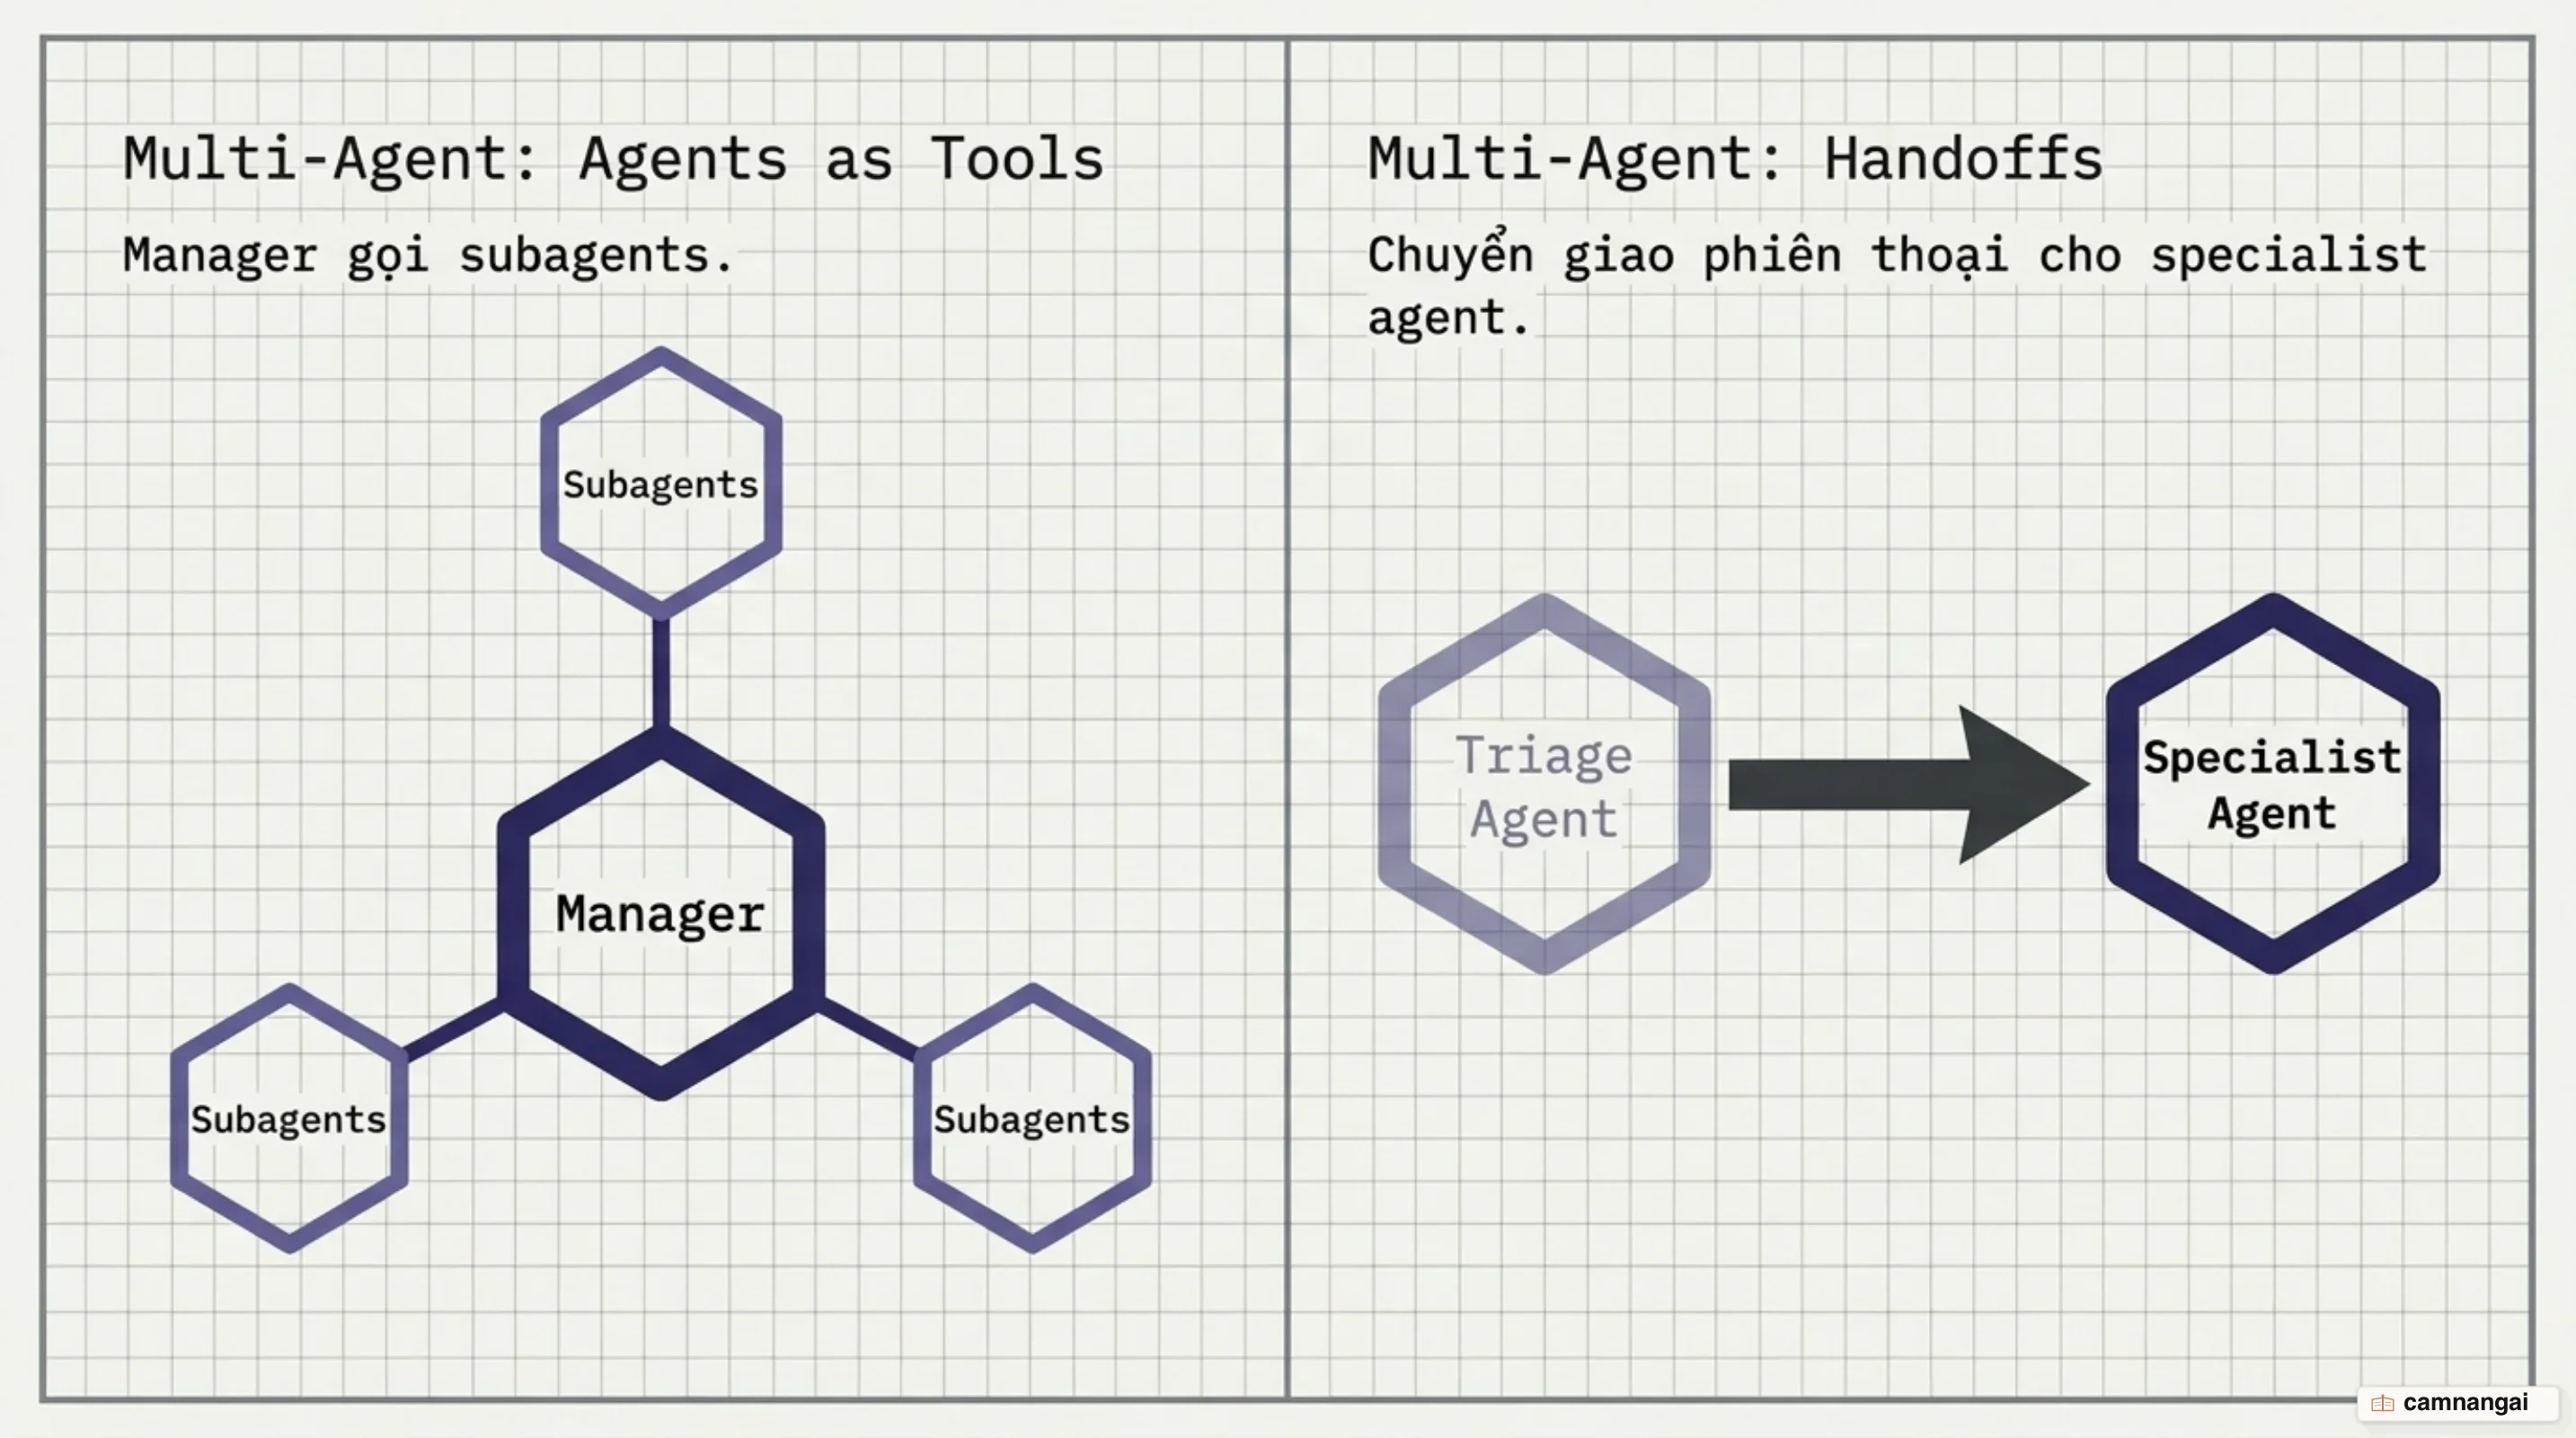
- **Agents as Tools (Agent đóng vai trò công cụ)**: Một Manager Agent chịu trách nhiệm duy trì phiên thoại chính với người dùng. Khi phát sinh tác vụ chuyên sâu nhưng có phạm vi giới hạn, Manager Agent sẽ gọi một Sub-agent chuyên trách dưới dạng một công cụ thông qua giao diện `Agent.as_tool()`. Sub-agent thực thi hoàn tất tác vụ, trả về kết quả cho Manager Agent. Manager Agent vẫn là thực thể duy nhất sở hữu quyền phản hồi trực tiếp cho người dùng.
- **Handoffs (Chuyển giao quyền kiểm soát)**: Một Triage Agent tiếp nhận tương tác ban đầu của người dùng, tiến hành phân loại và thực hiện thao tác Handoff để chuyển giao toàn bộ quyền kiểm soát phiên làm việc cùng lịch sử ngữ cảnh sang cho một Specialist Agent. Sau thời điểm Handoff, Specialist Agent trở thành agent hoạt động chính (active agent), trực tiếp tương tác và xử lý các lượt thoại tiếp theo với người dùng mà không cần thông qua Triage Agent.
```
[Người dùng] <---> [Triage Agent] --(Handoff)--> [Specialist Agent (Active)] <---> [Người dùng]
```
Mặc dù mang lại tính mô-đun hóa cao, kiến trúc Multi-Agent kéo theo các thách thức vận hành hạ tầng không nhỏ. Việc quản lý trạng thái (state management) đồng bộ giữa các agent đòi hỏi các giao thức truyền thông điệp chặt chẽ. Việc chuyển giao qua lại giữa nhiều agent có thể làm bùng nổ lượng token tiêu thụ và làm tích tụ độ trễ. Đồng thời, việc truy vết lỗi (debugging) trở nên vô cùng phức tạp khi sai sót xuất phát từ các tương tác sai lệch giữa các agent độc lập chứ không phải do bản thân một mô hình đơn lẻ.
## Đánh giá chi phí, độ trễ và rủi ro tích lũy khi chạy production
Đưa agentic workflow từ môi trường thử nghiệm ra production đòi hỏi góc nhìn đánh giá khắt khe về mặt hạ tầng kỹ thuật. Vấn đề cốt lõi đầu tiên là sự gia tăng độ trễ và chi phí theo hàm số mũ. Khi hệ thống thực thi N lượt lặp qua lại giữa các LLM, tổng độ trễ bằng tổng độ trễ từng bước cộng lại. Đặc biệt, nếu hệ thống gửi lại toàn bộ lịch sử hội thoại ở mỗi lượt gọi mà không áp dụng cơ chế nén ngữ cảnh, tổng lượng token tiêu thụ sẽ tăng trưởng theo đường cong bậc hai O(N^2), gây bùng nổ chi phí API nhanh chóng.
```text
Total Token Cost ∝ Σ (Prompt Tokens_k + Completion Tokens_k) ≈ O(N^2)
```
Rủi ro tích lũy sai số (Compounding Errors) là hiện tượng nguy hiểm nhất trong các hệ thống tự
trị. Nếu một lượt gọi LLM ở bước đầu phát sinh ảo giác (hallucination) hoặc trả về thông số sai mà
không bị chặn lại, dữ liệu sai lệch này sẽ biến thành ngữ cảnh đầu vào cho các bước suy luận tiếp
theo.
Càng về các vòng lặp sau, mức độ thô lệch của mô hình càng bị phóng đại, khiến agent đưa ra các hành
động phá hoại hệ thống hoặc rơi vào vòng lặp vô tận (infinite execution loop).
Để vận hành các agentic workflow tin cậy trên production, hệ thống hạ tầng bắt buộc phải tích hợp 4 thành phần nền tảng:
1. **Bộ lưu trữ trạng thái bền vững (State Persistence):** Xây dựng hệ thống bộ nhớ phân cấp, bao gồm bộ nhớ ngắn hạn (thread-level storage) quản lý trạng thái phiên hiện tại và bộ nhớ dài hạn (cross-thread memory) giúp agent truy xuất tri thức từ các tương tác lịch sử.
2. **Logic xử lý lỗi cố định (Deterministic Fallback):** Khi mô hình vượt quá ngưỡng số vòng lặp tối đa (max iterations) hoặc gọi công cụ thất bại liên tiếp, hệ thống phải tự động ngắt quyền của LLM và chuyển hướng sang mã lập trình cố định để xử lý lỗi an toàn.
3. **Điểm can thiệp của con người (Human-in-the-loop checkpoints):** Thiết lập các điểm ngắt bắt buộc người dùng phê duyệt (human approval interrupts) trước khi agent được phép thực thi các công cụ có rủi ro cao như xóa cơ sở dữ liệu, chuyển tiền hoặc gửi email hàng loạt.
4. **Khung thực thi bền bỉ (Durable Execution):** Sử dụng các hạ tầng hỗ trợ checkpoint trạng thái từng nút trong đồ thị thực thi. Khả năng này đảm bảo nếu hệ thống gặp sự cố mất mạng hoặc lỗi Rate Limit (HTTP 429) từ nhà cung cấp LLM, quy trình có thể khôi phục và chạy tiếp ngay tại nút bị gián đoạn mà không phải thực thi lại các lượt gọi LLM đắt đỏ trước đó.
## Khung quyết định: Khi nào nên dùng pattern nào?
Nguyên tắc vàng trong kiến trúc hệ thống AI là luôn bắt đầu với phương pháp đơn giản nhất có thể,
từ các kỹ thuật tối ưu prompt đơn lượt cho đến các luồng workflow tuyến tính cố định, và chỉ bổ
sung thêm tính tự trị (agency) khi tính xác định (determinism) của mã nguồn truyền thống không đủ
để đáp ứng yêu cầu bài toán.
Đối với các quy trình nghiệp vụ có luồng xử lý cố định và tiêu chuẩn đầu ra rõ ràng, hãy ưu tiên
kết hợp Prompt Chaining, Routing hoặc Parallelization cùng với mã lập trình truyền thống để đạt
được độ trễ thấp nhất, chi phí tối ưu và độ tin cậy tuyệt đối.
Chỉ khi phải giải quyết các bài toán mở, nơi tập hợp các bước thực thi không thể dự đoán trước tại
runtime (như tự động sửa lỗi mã nguồn phức tạp hay nghiên cứu thông tin đa nguồn không cấu trúc),
việc triển khai các vòng lặp ReAct, Evaluator-Optimizer hoặc mạng lưới Multi-Agent mới mang lại giá
trị kỹ thuật vượt bậc so với chi phí hạ tầng bổ sung.
## Tài liệu tham khảo
- [Top AI Agentic Workflow Patterns — ByteByteGo](https://blog.bytebytego.com/p/top-ai-agentic-workflow-patterns)
- [Building Effective Agents — Anthropic](https://www.anthropic.com/research/building-effective-agents)
- [Four AI Agent Strategies That Improve GPT-4 and GPT-3.5 Performance — DeepLearning.AI](https://www.deeplearning.ai/the-batch/how-agents-can-improve-llm-performance)
- [How to Think About Agent Frameworks — LangChain](https://www.langchain.com/blog/how-to-think-about-agent-frameworks)
- [Agent Orchestration: Multi-Agent Architectures — OpenAI Agents SDK](https://openai.github.io/openai-agents-python/multi_agent/)
- [Announcing Workflows 1.0: A Lightweight Framework for Agentic Systems — LlamaIndex](https://www.llamaindex.ai/blog/announcing-workflows-1-0-a-lightweight-framework-for-agentic-systems)
- [ReAct: Synergizing Reasoning and Acting in Language Models — Shunyu Yao et al.](https://arxiv.org/abs/2210.03629)